Gemini 4 Carbonの自動アノテーション:VLM Leaderboardの新たな首位モデル
Gemini 4 Carbonは、36データセットの物体検出ベンチマークで45種類のVLMの中で首位に立ち、0.584 mAP50と最高の適合率・再現率を記録しました。GPT-6.1 Terraのほうがコストパフォーマンスに優れる場合もあります。
 Glenn Jocher13 分で読めます
Gemini 4 Carbonは、UL37(36種類のデータセットで構成される物体検出ベンチマーク)の自動アノテーションで45モデル中1位となり、2026年11月11日のUltralytics VLM Leaderboardのスナップショットで首位に立っています。mAP50は0.584、mAP50-95は0.371で、適合率と再現率の両方の列でも首位を獲得しました。10月の結果では、この2つの指標は別々のモデルが首位でした。前回首位だったGPT-6.1 Terraは、Carbonの約3分の1の画像あたりプロバイダーコストで、mAP50 0.560を記録して2位です。
そのため、データセットにラベルを付ける人にとって重要なのは、総合スコアが最も高いモデルはどれかではなく、Carbonの価格が3倍に見合うのはどんな場合かです。以下では、Carbonが新たな最高スコアを記録した分野、Terraが依然として優位な分野、Googleの12月の価格改定前後の各モデルの費用、そしてUltralytics Platformで自分のデータにCarbonを適用する方法を紹介します。
Gemini 4 Carbonが、料金を支払うすべての開発者に公開されました#
Googleは10月末、サイバーセキュリティの防御担当者を対象とした小規模グループにCarbonを初めて公開しました。2026年11月10日には、すべての有料開発者と企業にモデルを開放し、Google AI Ultraの加入者にも順次提供を開始しました。Googleの提供状況に関する投稿によると、CarbonはGoogle AI StudioとGemini for businessのAPI、およびUltra加入者向けのGeminiアプリ、AI Mode、Antigravityから利用できます。防御担当者は、GoogleのFairwind Programを通じて引き続き専用アクセスを利用できます。
GoogleはCarbonを最も強力なモデルと位置付け、サイバーセキュリティと長期的なエージェント型タスクを対象としています。Gemini 4 Carbonのモデルカードによると、このモデルはGemini 4 Argonをベースとしており、「仮説を徹底的に検討し、深く推論し、長時間にわたる検証ループを実行する」ために、Argonより多くの思考トークンを使用します。テキスト、画像、音声、動画を読み取り、最大100万トークンのコンテキストウィンドウを備え、テキストで回答します。
Googleの発表では、Carbonを検出器として宣伝していません。データラベリングで重要なのは、追加の推論がバウンディングボックスにどのような影響を与えるかであり、それを測定するのがUL37です。すべての結果はGemini 4 Carbonのモデルページで確認できます。
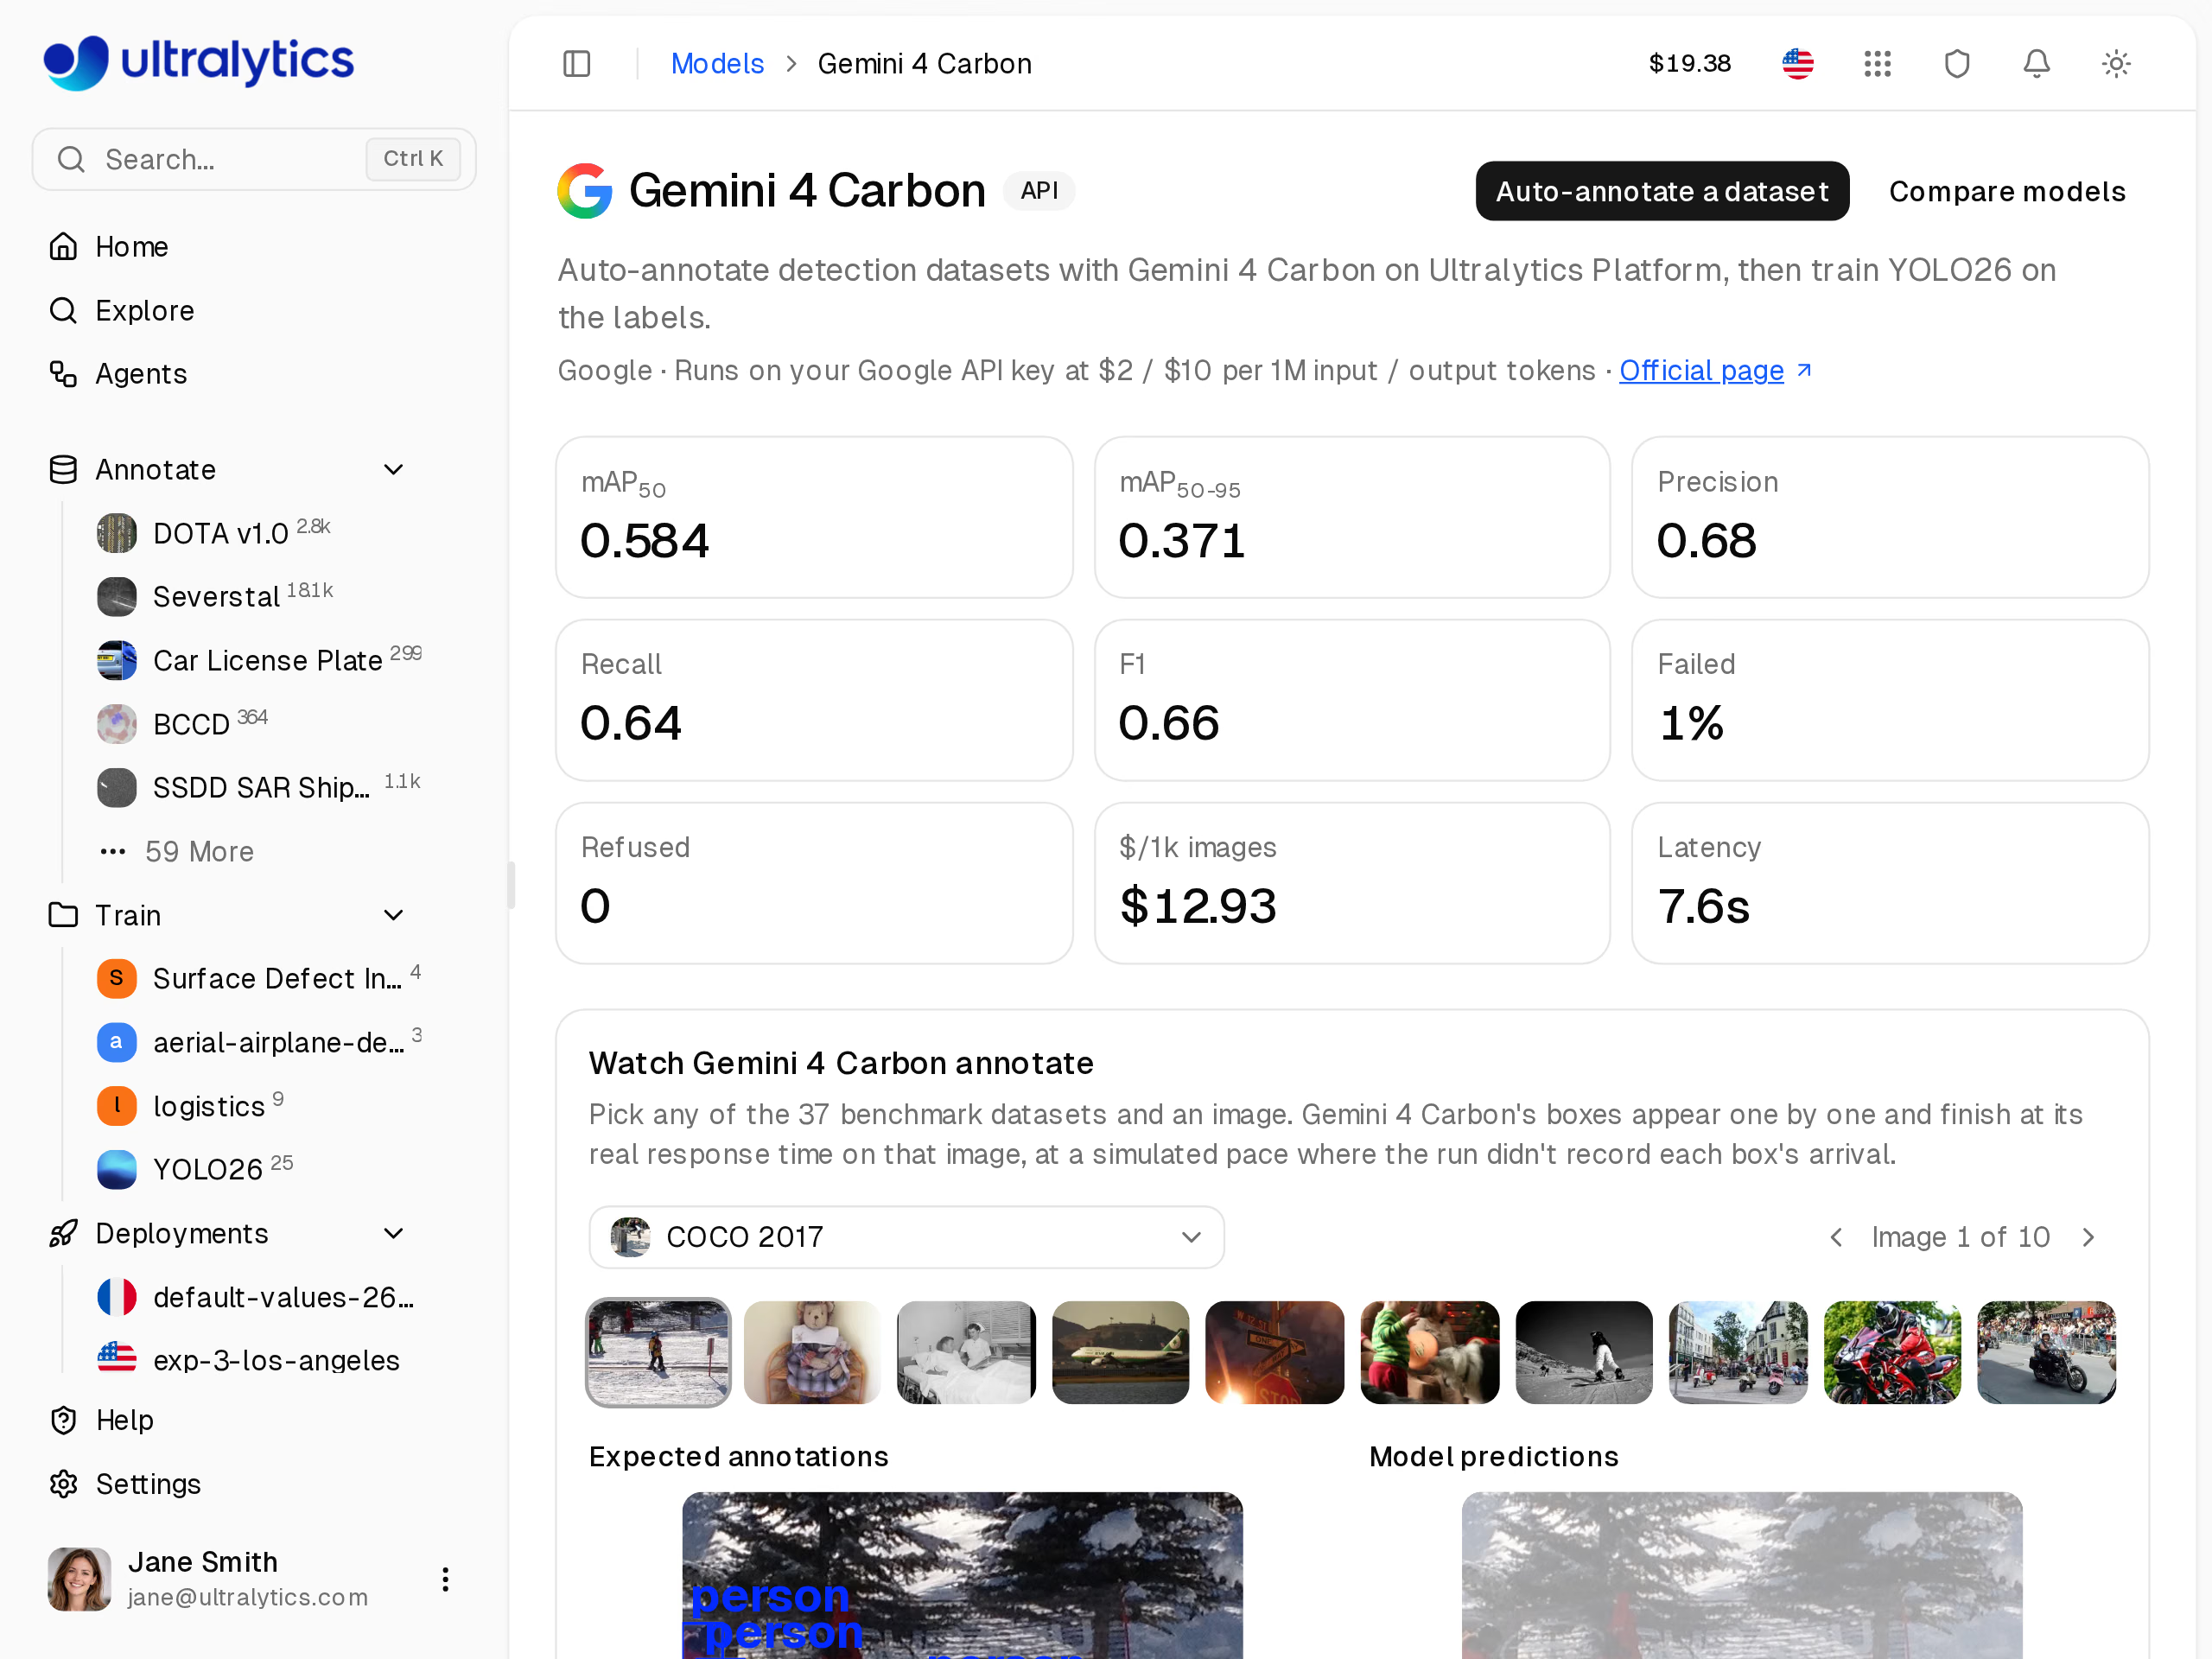
Ultralytics PlatformのGemini 4 Carbonモデルページ。UL37のスコアと、データセットを自動アノテーションするためのリンクが表示されています。
Gemini 4 Carbonの物体検出:すべての精度指標で首位#
UL37では、36種類の実際の物体検出データセットから各10枚、計360枚の画像を使い、モデルのボックスが各データセットの正解ラベルにどれほど近いかを評価します。対象には医療画像、航空画像、熱画像、小売店の棚、スポーツ、文書、回路基板などが含まれます。すべての画像は、Platformユーザーが利用するものと同じ本番パイプラインで処理され、各データセット固有のクラス名が使われます。また、ユーザーの場合と同様、SAM 3.1はSAM 3以外のすべてのモデルのボックスを調整します。各データセットは同じ重みで評価されます。詳しくはUL37ベンチマークの方法論をご覧ください。
Carbonと次点の4モデルを比較すると、次のようになります。
CarbonはGPT-6.1 TerraをmAP50で0.024上回っています。物体の輪郭に沿ったボックスをより高く評価する厳しい指標mAP50-95でも、同様の差があります。Carbonは0.371で、従来の最高スコアであるClaude Fable 5.2の0.347と、Terraの0.345を上回ります。
Carbonは、ベースとなったモデルよりも性能が向上しています。Gemini 4 ArgonのスコアはmAP50が0.537、mAP50-95が0.343で、同じベンチマークとアノテーションパイプラインにおいて、Carbonはそれぞれ0.047、0.028上回ります。
Gemini 4 CarbonはUL37で最高の適合率と再現率を記録#
10月の結果では、リーダーボード上位のモデルは2つのグループに分かれていました。適合率と再現率を基準にVLMを選ぶ方法のガイドで説明しているとおりです。Gemini 4 Argonは最高の適合率0.667を記録しました。ボックスの多くは正解でしたが、一部のラベル付きオブジェクトを見落としていました。GPT-6 Astraは最高の再現率0.627を記録しました。より多くのラベル付きオブジェクトを検出する一方で、正しいボックスの割合は低くなっていました。
2026年11月11日のリーダーボードのスナップショットでは、Carbonの適合率は0.685、再現率は0.642で、45モデルすべての中で最も高い平均値を記録し、Argonの適合率とAstraの再現率を上回りました。
レビュー担当者にとって、これはベンチマークで示される最良の組み合わせです。適合率が高いほど、作成されたボックスのうち正しいものの割合が高くなります。再現率が高いほど、実際のオブジェクトのうち、すでにボックスが付いているものの割合が高くなります。適合率が低いと削除すべきボックスが残り、再現率が低いと描画すべきオブジェクトが残るため、Carbonの初回出力ではどちらの修正も比較的少なくて済みます。
SKU110Kを見ると、密集した画像でこの差が重要な理由が分かります。スーパーマーケットの棚を写したベンチマーク画像10枚には、1クラスに分類されるラベル付き商品が合計1,666点あります。CarbonはここでmAP50 0.671を記録し、Terraが持っていた従来の最高スコア0.619を上回って、全モデル中1位です。このような棚では、余分なボックスが1つあるだけで、レビュー担当者は数十個の正しいボックスの中からそれを見つける必要があります。
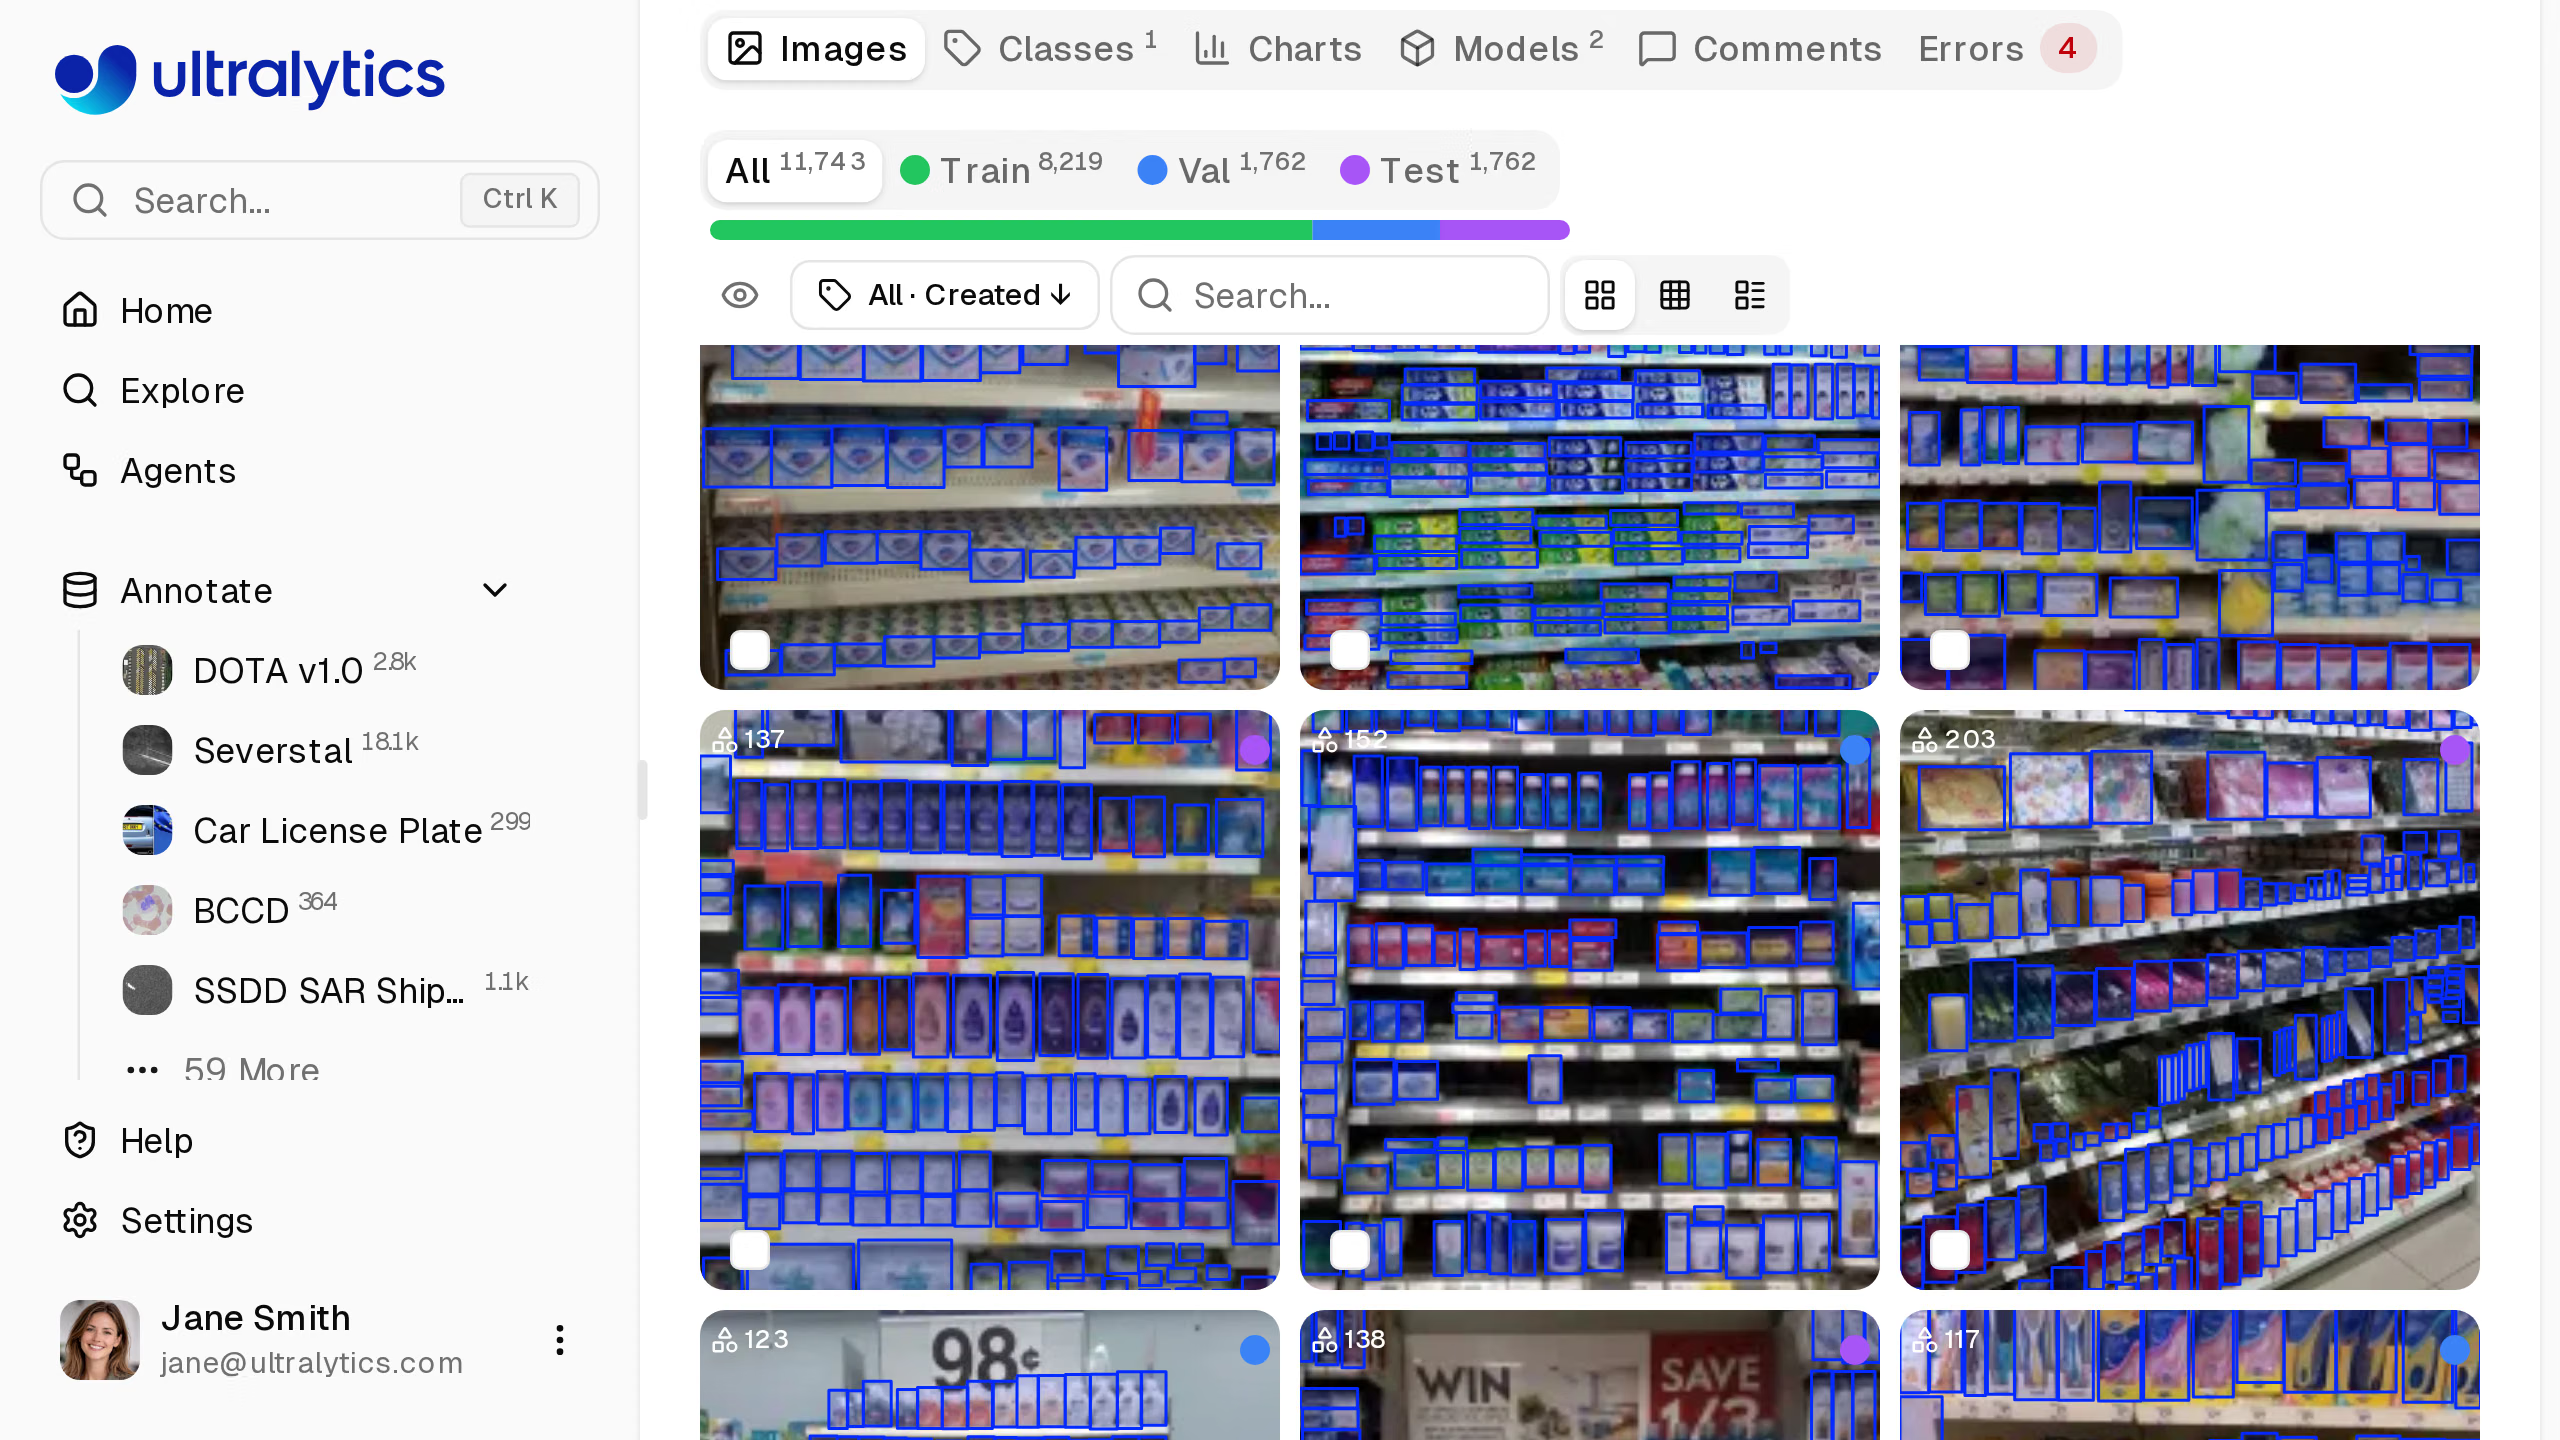
Ultralytics Platform上のSKU110K Dense Retail Shelf Detection 2データセット。CarbonはUL37で最高スコアとなるmAP50 0.671を記録しています。
Gemini 4 Carbonは9分野で最高スコアを記録#
Platformのモデルページに掲載されたデータセット別の結果によると、Carbonは現在、UL37の多くのデータセットで全モデル中最高スコアを獲得しています。従来の最高スコアと並べると、次のとおりです。
| データセット | 分野 | Gemini 4 CarbonのmAP50 | 従来の最高mAP50 |
|---|---|---|---|
| LLVIP赤外線画像 | 熱画像/低照度 | 0.955 | Gemini 4 Argon、0.915 |
| Cheng Brain Tumor MRI | 医療 | 0.942 | GPT-6.1 Terra、0.904 |
| RPC Retail Checkout | 小売 | 0.935 | GPT-6 Astra、0.935(同率) |
| CeyMo Road Markings | 道路/交通 | 0.905 | Gemini 4 Argon、0.905(同率) |
| Basketball and Hoop | スポーツ | 0.882 | Claude Fable 5.2、0.849 |
| FloorPlanCAD 2 | 文書/UI/CAD | 0.821 | GPT-6 Astra、0.726 |
| RUOD Underwater | 水中 | 0.788 | Gemini 4 Argon、0.757 |
| HIT-UAV熱画像ドローン | 航空/リモートセンシング | 0.689 | Gemini 4 Argon、0.582 |
| SKU110Kの棚 | 小売 | 0.671 | GPT-6.1 Terra、0.619 |
| PlantDoc | 自然/農業 | 0.594 | Claude Fable 5.2、0.521 |
| Airbus Oil Storage | 航空/リモートセンシング | 0.381 | Gemini 4 Argon、0.347 |
| DDR網膜病変 | 医療 | 0.133 | Claude Opus 5.5、0.132 |
3つの傾向が見られます。Carbonは熱画像、航空画像、水中画像におけるArgonの強みを引き継ぎ、それぞれの性能をさらに高めています。特にHIT-UAVの熱画像ドローン映像で大きく向上しました。フロアプランではGPT-6 Astraを約0.1上回っています。また、髄膜腫、神経膠腫、下垂体腫瘍のクラスを含む脳腫瘍MRIでは、Terraをわずかに上回ります。
各データセットの画像は10枚ずつであるため、単一のスコアは調査のきっかけにはなりますが、結論を示すものではありません。CarbonはRPCとCeyMoで既存の記録に並び、DDRでは0.001上回っていますが、いずれもモデル間の差を見分けるには小さすぎます。
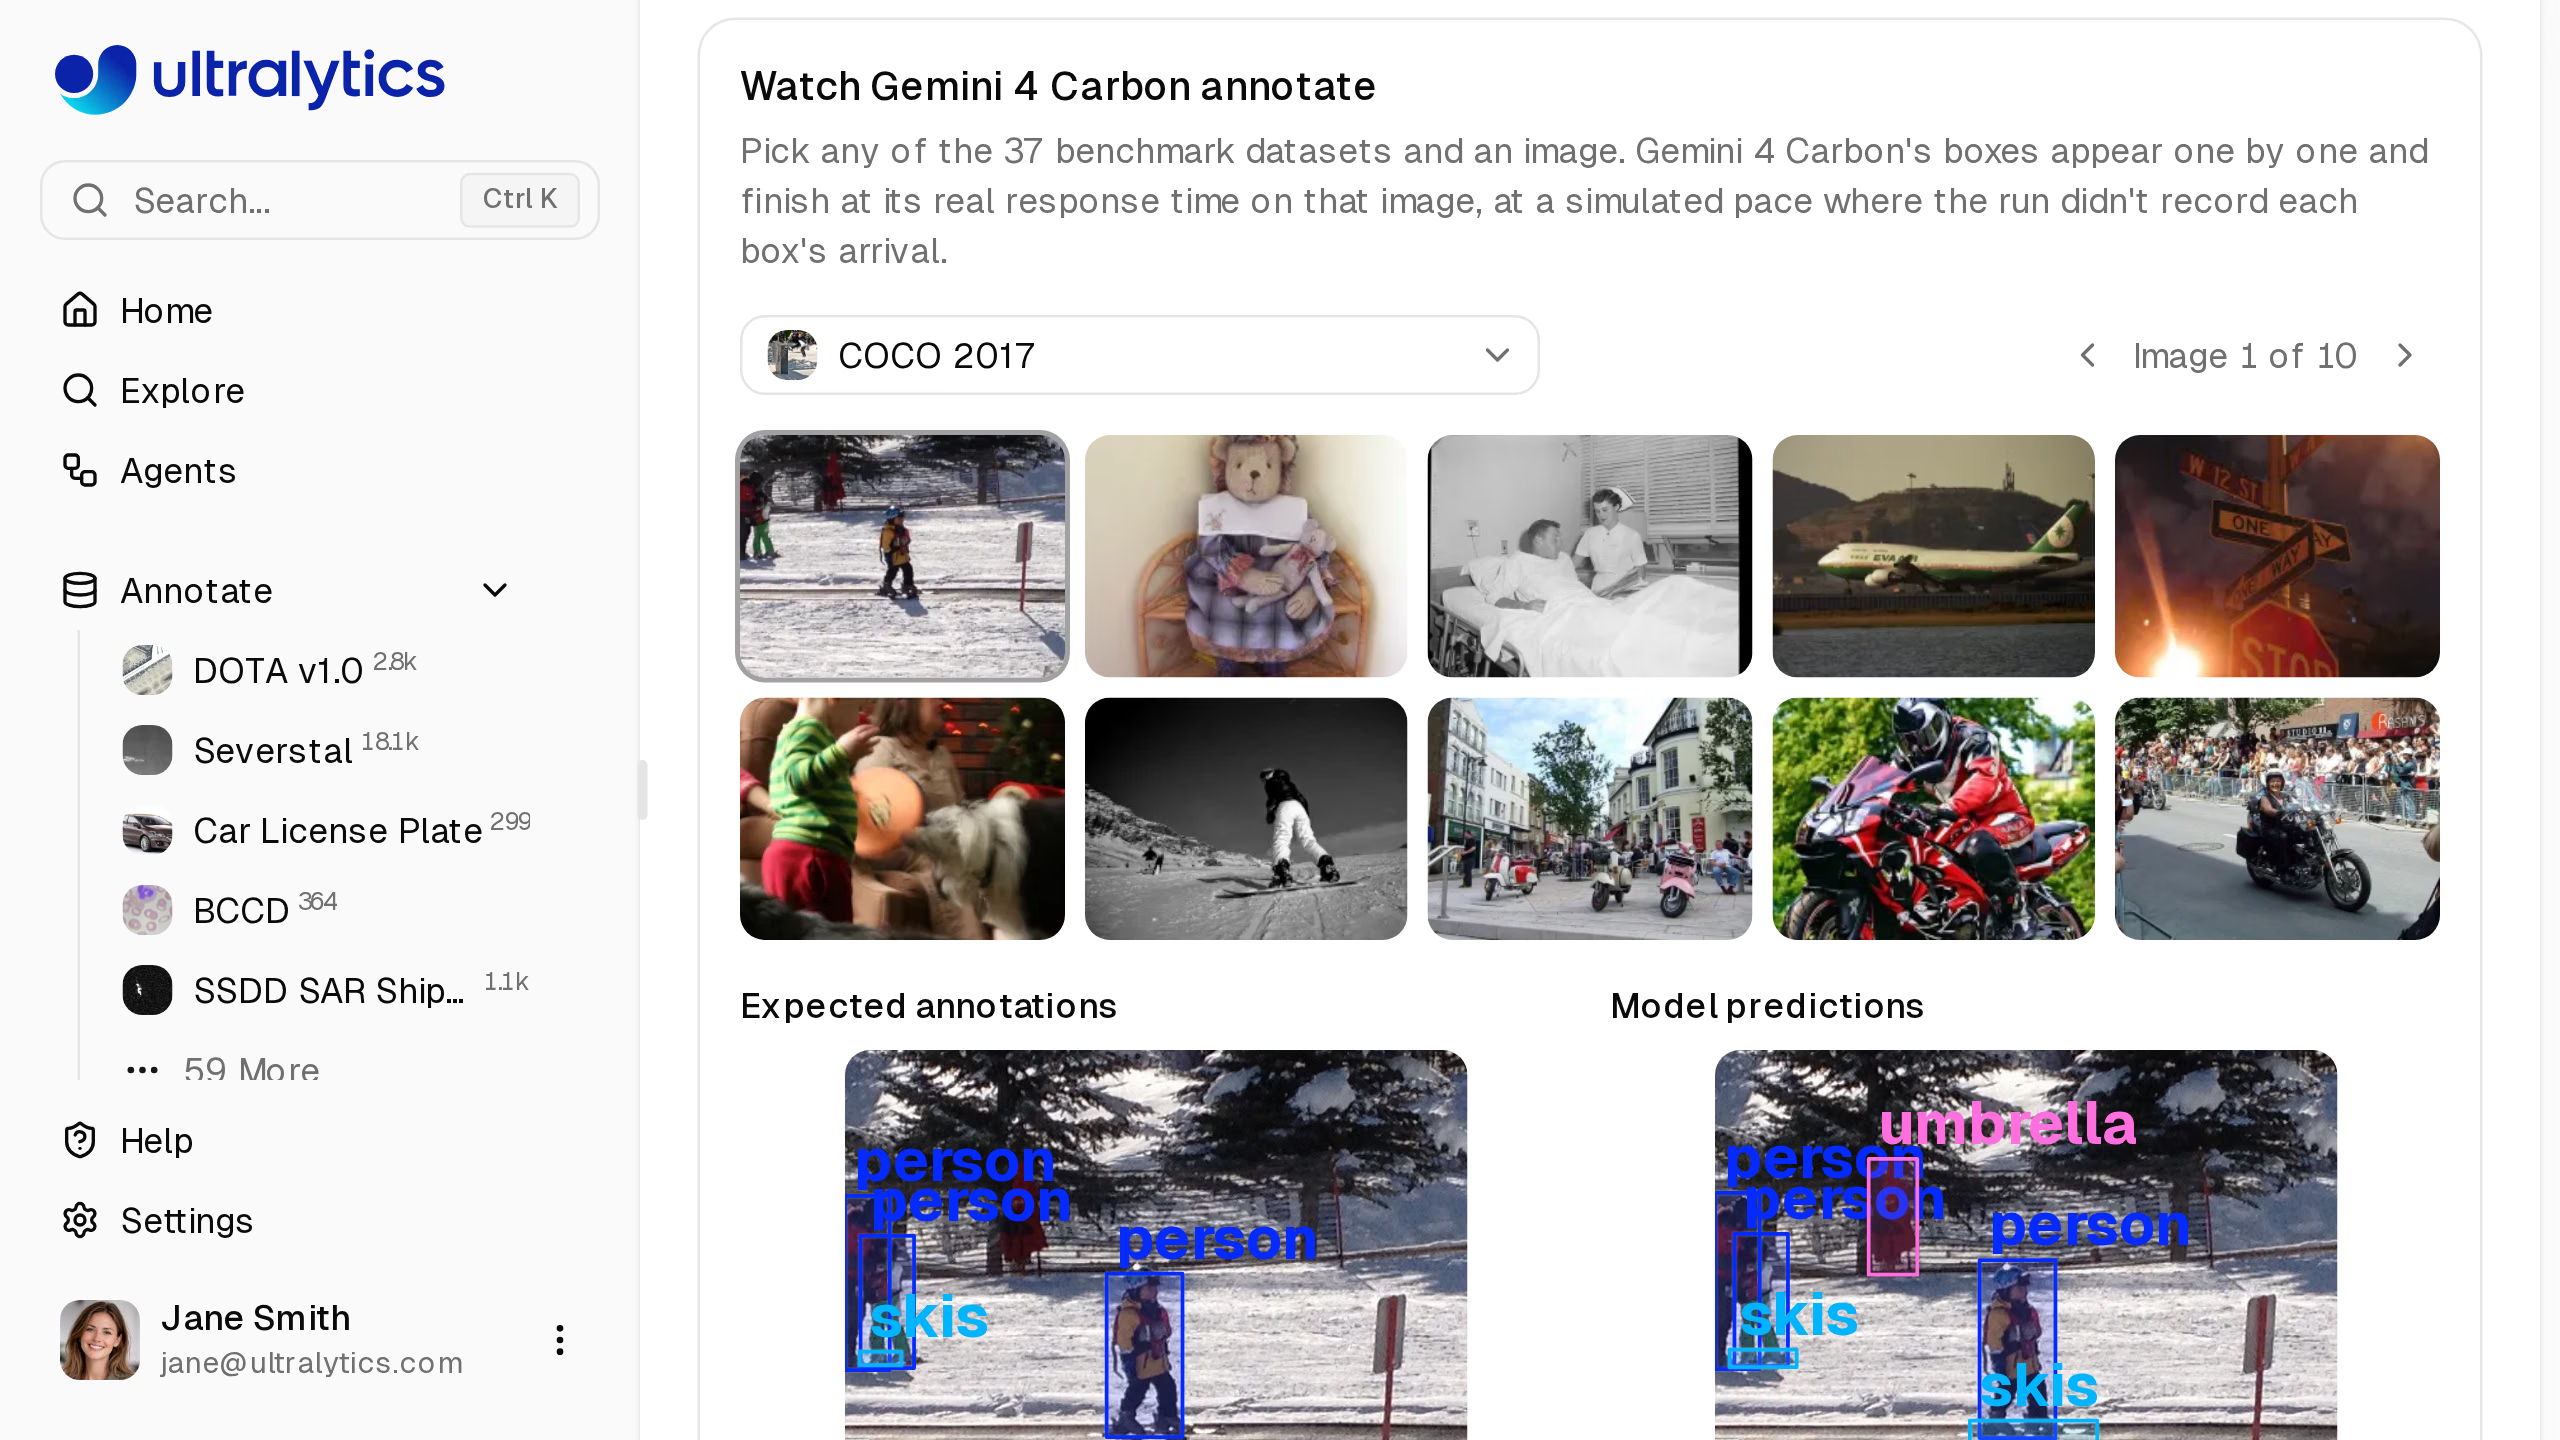
モデルページでは、各ベンチマークデータセットとCOCOについて、Carbonが記録したUL37のボックスを正解アノテーションと並べて再生表示します。
Gemini 4 CarbonとGPT-6.1 Terraの比較:Terraが依然として優位な分野#
Terraは医療分野の最高スコアを2つ保持しています。リーダーボードのデータセット表では、TN5000の甲状腺超音波画像で0.935、TXL-PBCの血球顕微鏡画像で0.889を記録し、現在も最良のモデルとして掲載されています。データがどちらかのデータセットに似ている場合は、選択する前に両モデルのページでスコアを比較してください。
Terraのより大きな優位点は価格です。UL37での直接比較は次のとおりです。
| UL37の結果 | Gemini 4 Carbon | GPT-6.1 Terra |
|---|---|---|
| mAP50 | 0.584 | 0.560 |
| mAP50-95 | 0.371 | 0.345 |
| プロバイダーの1,000枚あたりのコスト | $12.93 | $4.36 |
| 画像1枚あたりの中央値 | 7.6 s | 5.1秒 |
| 失敗したリクエスト | 1% | 0% |
費用は、料金表価格に基づき、正常にアノテーションされたベンチマーク画像1,000枚あたりのプロバイダー報告トークン使用量から推定しています。TerraはCarbonの約3分の1の費用で、mAP50の約96%を実現し、応答も速く、リクエストの失敗はありませんでした。どちらのモデルもリーダーボードの「Best value」ライン上にあり、費用と精度の両方で他のモデルに上回られていません。
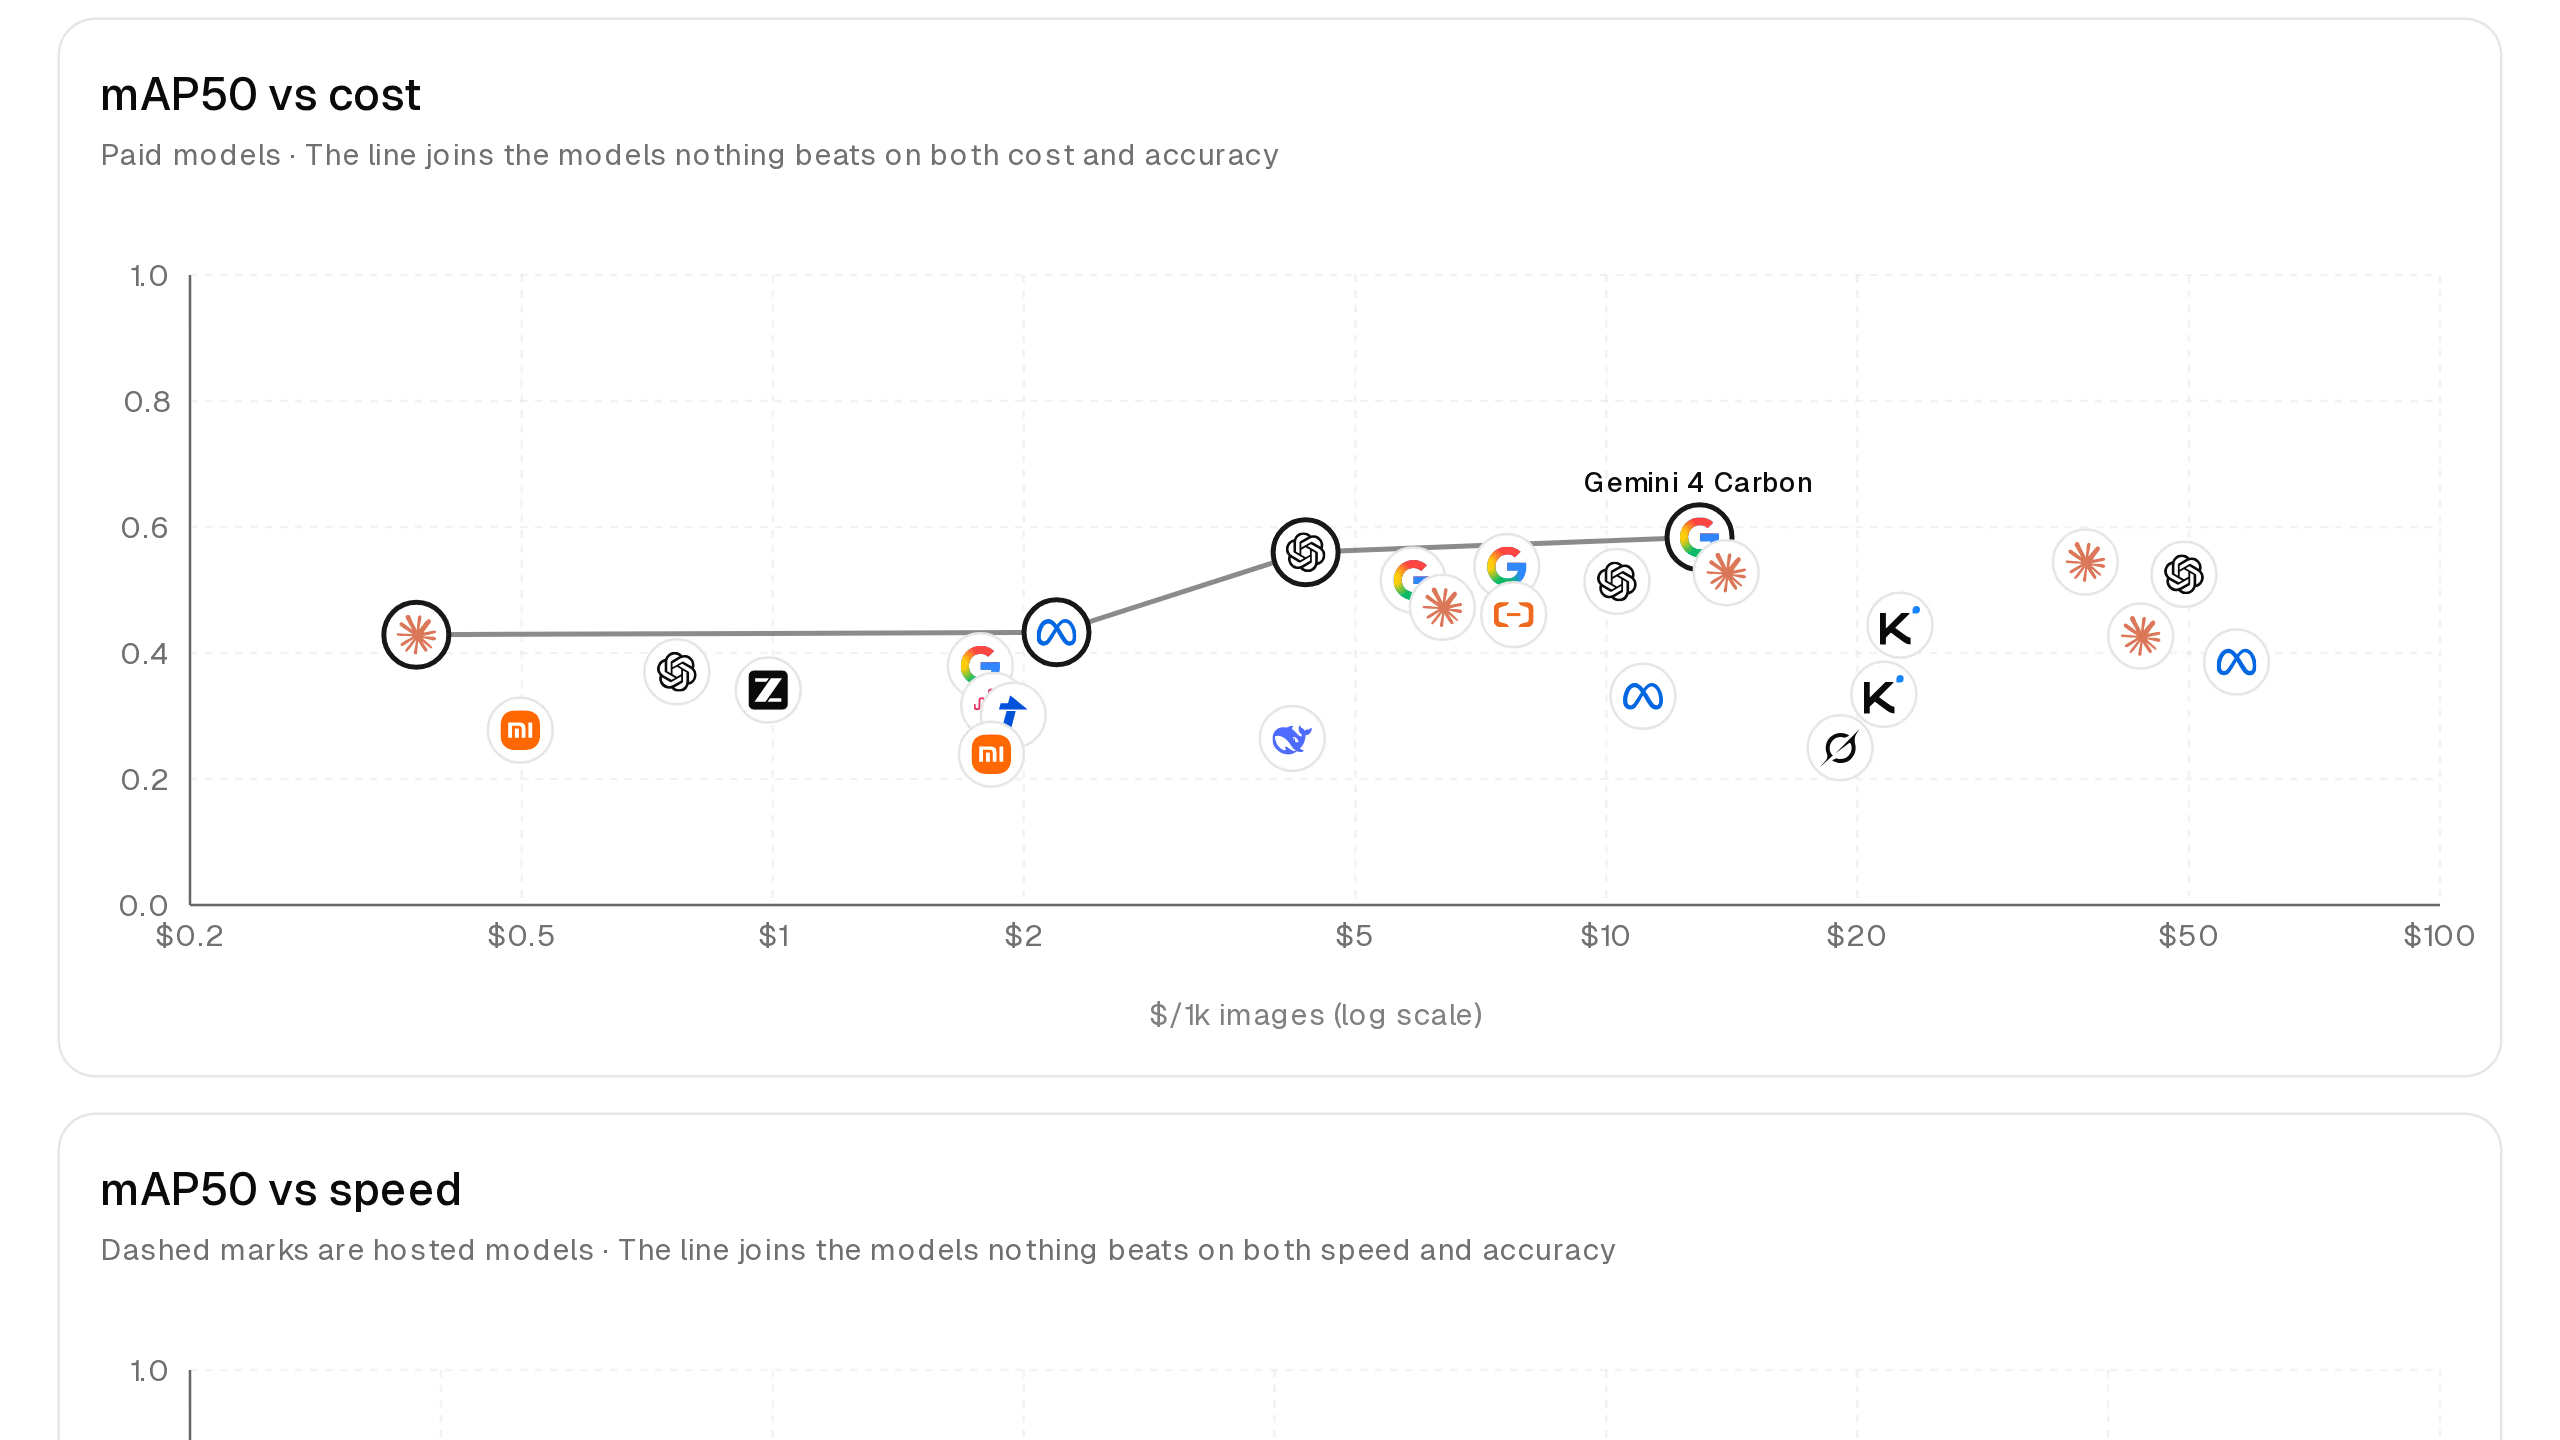
現在の料金表価格に基づく、UL37の有料モデルのmAP50対費用のグラフです。
価格差はさらに広がります。Googleの提供状況に関する投稿によると、Carbonは2026年11月30日まで導入価格として入力トークン100万個あたり2ドル、出力トークン100万個あたり10ドルで提供され、その後はそれぞれ4ドルと20ドルになります。同じトークン使用量の場合、画像1,000枚あたり12.93ドルのCarbonの費用は、12月1日には約26ドルになります。
実用上の使い分けは次のとおりです。
- ラベル品質に費用をかける価値がある場合はCarbonを選びます。小売店の棚のような密集したシーン、熱画像や航空画像、フロアプランやCAD図面、モデルページでCarbonが大きくリードしているデータセットが対象です。
- 予算を0.024 mAP50の差より重視する大規模な汎用バッチ処理や、TN5000の甲状腺超音波画像、TXL-PBCの血球画像のようなデータにはTerraを選びます。
- Carbonを使う予定がある場合は、導入価格が適用される12月1日より前に大規模な処理を実行します。
どちらを選んでも、Batch AnnotationではUltralytics Platformの処理料金として処理画像1,000枚あたり1.00ドルが加算され、1回の実行につき最低0.01ドルかかります。プロバイダー料金はご自身のキーに直接請求されます。Ultralyticsはトークンにマークアップを加算しません。全体的な費用の内訳については、画像アノテーションソフトウェアの費用ガイドをご覧ください。より安価な有料モデルでは、Claude Haiku 5.5が画像1,000枚あたり0.37ドルで0.429を記録します。また、Qwen3.8 27BやSAM 3.1 Textなどのホスト型モデルは、キーが不要です。
データセットにGemini 4 Carbonで自動アノテーションを実行する方法#
Carbonは、1~200クラスの検出データセットに対応する、クラスプロンプト方式のモデルです。データセット固有のクラス名に対応したバウンディングボックスを返します。Platformはこれらのクラス名をGeminiのy-first形式でリクエストし、SAM 3.1で調整します。
- Google AI StudioでGemini APIキーを作成します。Carbonは有料APIティアで動作するため、キーで課金を有効にする必要があります。
- データセットを所有するPlatformワークスペースで、Settings > API Keysからキーを追加します。詳細はプロバイダーキーのドキュメントをご覧ください。
- アノテーションエディターで画像を開き、Smartモードに切り替えて、モデル選択メニューのGoogleからGemini 4 Carbonを選びます。
- Predictを押すか、
Pを実行して、現在の画像にラベルを付けます。処理を拡大する前に、まずデータを代表する数枚の画像で試してください。 - データセットページでMore actions > Batch Annotationを選ぶと、ラベルのないすべての画像を一度にアノテーションできます。Platformは最初にデータセットのバージョンを保存するため、以前の状態に戻すことができます。
- ボックスを確認して修正します。エディターは変更を自動保存します。その後、同じワークスペースで結果を使ってUltralytics YOLO26モデルをトレーニングします。
開発者はコードからCarbonを呼び出すこともできます。Platform SDK v0.1.109のリリースで、画像予測モデルとしてgemini-4-carbonが追加されました。全体像については、Ultralytics PlatformがAIでアノテーションを自動化する方法と、人間参加型レビューがワークフローに欠かせない理由をご覧ください。医療画像解析では、あらゆるモデルのボックスを臨床専門家が確認・承認するための下書きとして扱い、診断として使用しないでください。
Gemini 4 Carbonの利用が適しているユーザー#
プロバイダー料金よりもラベル品質を重視する場合は、Gemini 4 Carbonを使用してください。これは、当社がベンチマークした自動アノテーションモデルの中で最も精度が高く、適合率と再現率の両方で現在首位に立ち、熱画像、航空画像、水中画像、小売店の棚、フロアプラン、脳MRIの各データセットで最高スコアを記録しています。
すでにArgonを利用しているチームは、導入時のトークン価格が同じでありながら、全体スコアが向上し、Argonが特に強い分野でも新たな最高スコアを得られます。ただし、その価格でもCarbonの画像あたりの費用は高くなります。予算を重視し、大規模な汎用バッチにラベルを付けるチームは、GPT-6.1 Terraをデフォルトとして使い続け、モデルページで明確な差が確認できるデータセットごとにCarbonへ切り替えるのがおすすめです。Argonについて詳しくは、Gemini 4 Argonの自動アノテーション結果をご覧ください。
よくある質問
当社のUL37ベンチマークで、Gemini 4 CarbonはmAP50 0.584、mAP50-95 0.371を記録し、Ultralytics VLM Leaderboardで45モデル中1位です。また、平均適合率と平均再現率の両方で最高値を記録しています。熱画像、航空画像、水中画像、小売店の棚、フロアプラン、脳MRIの各データセットでも、全モデル中最高スコアを獲得しています。
全体的な精度では上回っています。mAP50はTerraの0.560に対して0.584、mAP50-95は0.345に対して0.371です。一方、Terraは画像1,000枚あたり4.36ドルで、Carbonの12.93ドルより安く、応答も速いほか、TN5000の甲状腺超音波画像とTXL-PBCの血球画像データセットでは、現在もリーダーボードで最良のモデルです。密集した棚や熱画像のように、Carbonが大きくリードする分野でCarbonを選びましょう。
UL37の総合結果では、はい。CarbonはArgonをベースとし、mAP50で0.047高いスコアを記録しています(0.537に対して0.584)。また、LLVIP赤外線画像、HIT-UAVの熱画像ドローン画像、RUOD水中画像、Airbus Oil Storage画像でArgonの従来の最高スコアを上回っています。両モデルの導入時のトークン価格は同じですが、Carbonはリクエストごとにより多くの思考トークンを使用します。
Googleは、2026年11月30日までは入力トークン100万個あたり2ドル、出力トークン100万個あたり10ドルの導入価格を提示しており、その後はそれぞれ4ドルと20ドルになります。当社のベンチマークでは、導入価格でのCarbonのプロバイダー料金は画像1,000枚あたり12.93ドルとなり、12月1日以降に同じ使用量で利用すると約26ドルになります。Ultralytics PlatformのBatch Annotationでは、処理した画像1,000枚あたり1.00ドルが追加されます。
2026年11月10日以降、有料の開発者と企業はGoogle AI StudioのGemini APIおよびGemini for businessを通じてCarbonを呼び出せます。また、GeminiアプリではGoogle AI Ultraの加入者への提供が順次開始されています。サイバーセキュリティの防御担当者は、引き続きGoogleのFairwind Programを通じて専用アクセスを利用できます。Ultralytics Platformでは、ご自身の有料Gemini APIキーを使用して利用します。
はい。最上位モデルでさえ、UL37での平均mAP50は0.584であり、最も難しいデータセットでのスコアは大幅に低く、たとえばAirbus Oil Storageではベンチマーク画像10枚で0.381です。すべての画像をレビューし、医療データについては臨床専門家にボックスを承認してもらってください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









