精度と再現率を使って自動アノテーション用のVLMを選ぶ方法
精度と再現率を基準に自動アノテーション用のVLMを選びます。誤検出のボックスが少ないモデル、見逃す物体が少ないモデルを確認し、自分のデータでテストする方法を紹介します。
 Sergiu Waxmann15 分で読めます
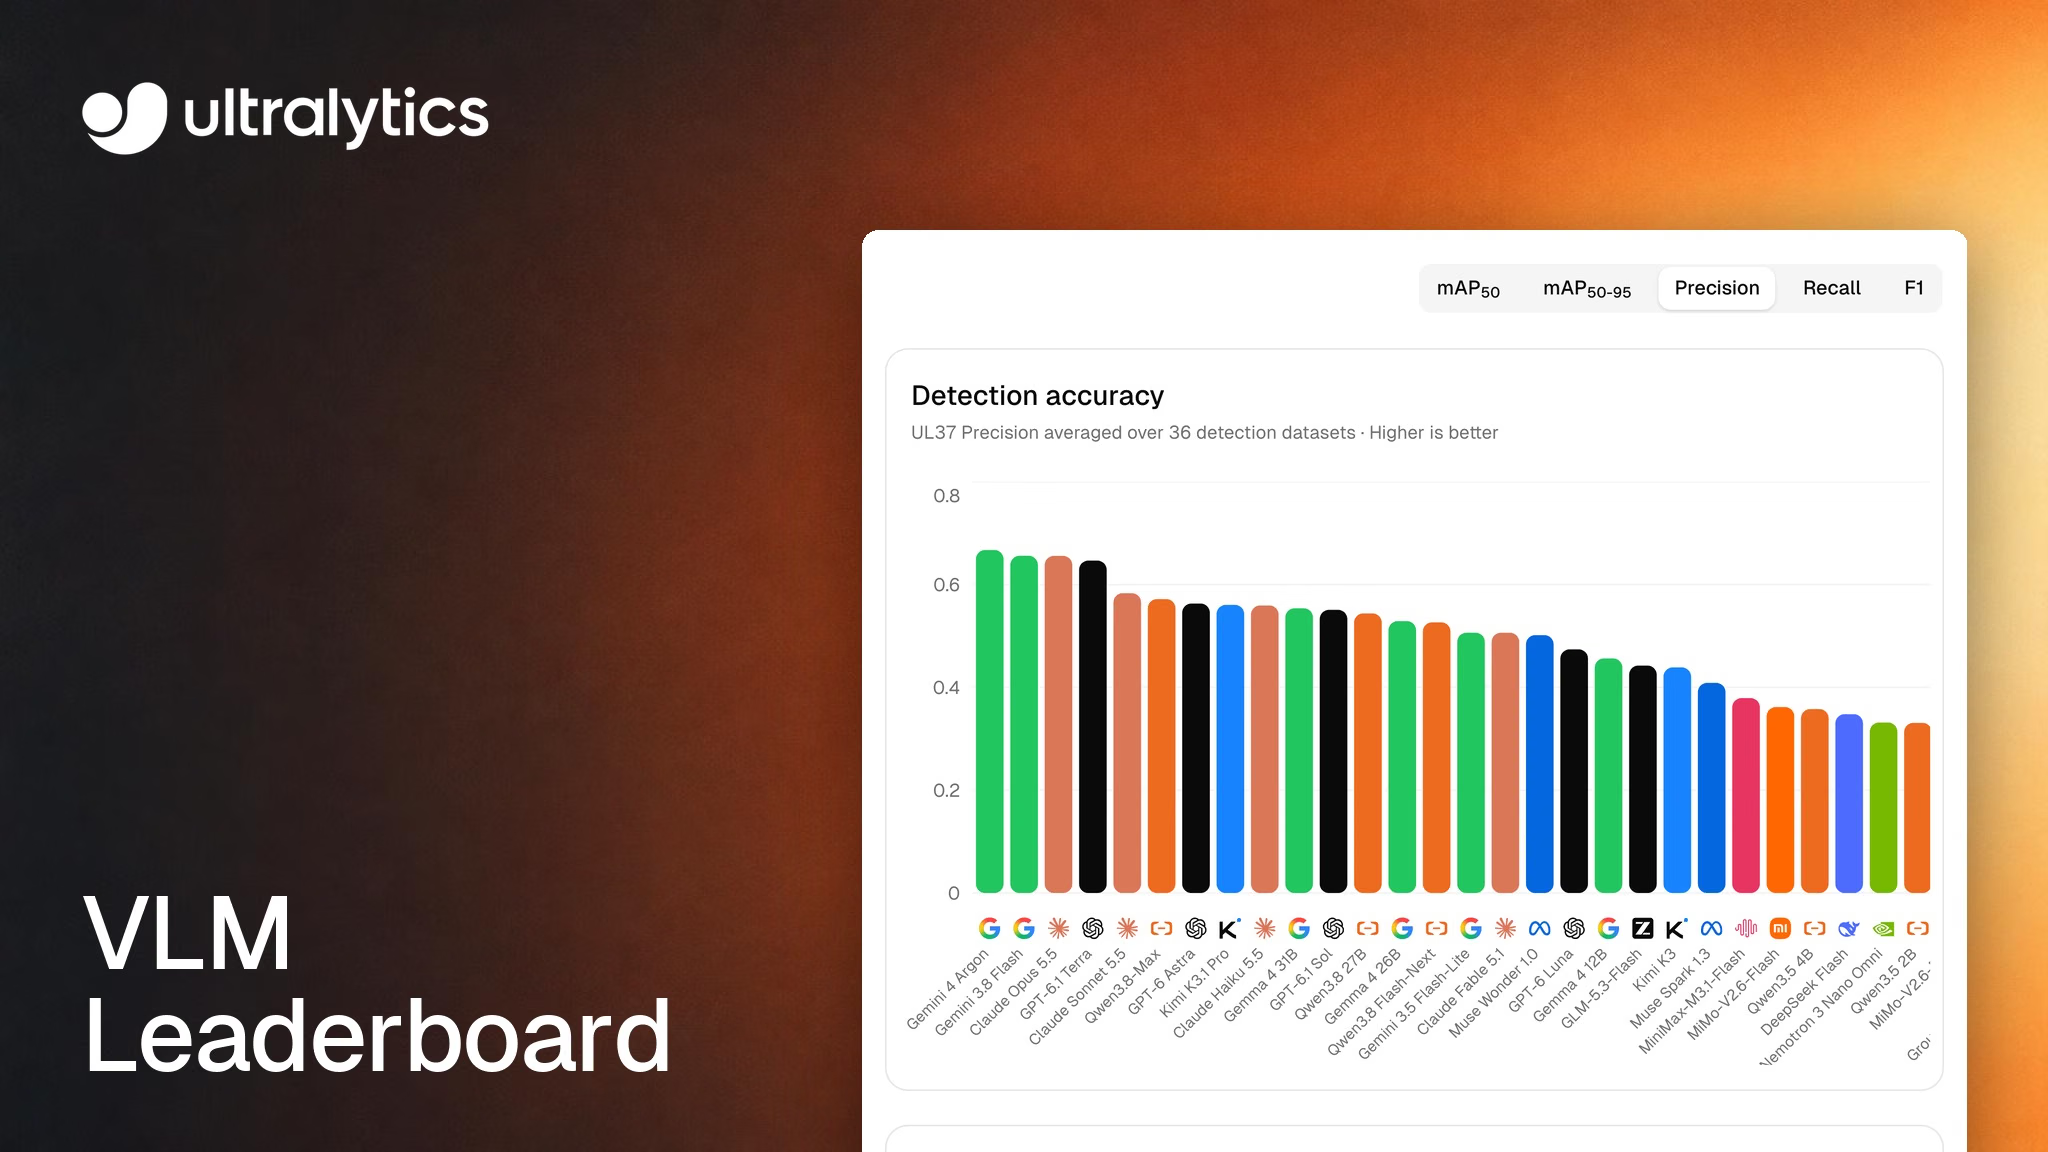
データセットの自動アノテーションに使うモデルは、レビュー担当者がどちらの修正を優先したいかで選びます。余分なボックスを削除するのか、モデルが見逃したオブジェクトを追加するのかです。Ultralytics VLM Leaderboardでは、各モデルについて、適合率(モデルが予測したボックスのうち正しいものの割合)と再現率(ラベル付けされたオブジェクトのうち検出できたものの割合)で、このトレードオフを確認できるようになりました。ベンチマーク結果は2026年10月28日に公開されました。
最もクリーンな初稿を得るには、Gemini 4 Argonから始めてください。見逃すオブジェクトを最小限に抑えるには、GPT-6 Astraから始めてください。バランスの良さと、上位6モデルの中で最も低いコストを重視する場合は、GPT-6.1 Terraを選んでください。独自のAIプロバイダーAPIキーがない場合は、ホスト型のQwen3.8 27Bから始めてください。混雑したシーンで余分な検出を削除するほうがよい場合は、SAM 3.1 Textを選んでください。
このガイドでは、数値の読み方、各モデルの適した用途、自分の画像で選択を検証する方法を説明します。ランキングと価格は実行のたびに変わるため、ここに掲載した数値は2026年10月時点の例として扱い、最新の結果はリーダーボードで確認してください。
クラスプロンプト型モデルには信頼度スライダーがないため、モデルの選択がしきい値になります#
アノテーションエディターでUltralytics YOLOモデルを使う場合は、トレードオフを自分で調整できます。信頼度しきい値を上げると誤検出のボックスが減る一方で見逃しが増え、下げるとその逆になります。クラスプロンプト型のビジョン言語モデル(VLM)は動作が異なります。アノテーションエディターのドキュメントで説明しているように、これらのモデルはモデル固有のしきい値を使ってデータセットのクラスを検出し、信頼度スコアを返しません。そのため、選択中はUltralytics Platformで信頼度とIoUの設定が非表示になります。
この違いにより、リーダーボードの精度と再現率の意味も変わります。ベンチマークの手法に従い、精度と再現率はIoU 0.5でモデルが返すすべてのボックスを数え、内部に隠れた動作点はありません。これらの指標は、レビュアーが実際に受け取るボックスを表します。
リーダーボードの基盤となるベンチマークはUL37 v2です。Platform上の36種類の実物体検出データセットから各10枚の画像を使用し、COCO 2017の参照画像10枚を別途評価した、合計370枚の画像と7,268個のボックスで構成されます。各画像はSmart AnnotationおよびBatch Annotationと同じ本番パイプラインで処理され、データセット固有のクラス名が使われます。また、SAM 3のボックスを除くすべてのモデルのボックスをSAM 3.1で調整します。評価にはUltralyticsパッケージ独自の検出指標、つまりYOLOモデルの検証に使われるコードを用い、平均では各データセットを同じ重みで扱います。
精度は未対応のボックスを、再現率は未検出の物体を追跡します#
精度は、モデルのボックスのうち、IoU 0.5で正しいクラスのラベル付き物体と一致するものの割合です。再現率は、ラベル付けされた物体のうちモデルが一致させたものの割合です。レビュー作業で考えると、次のようになります。
- 精度が低い場合は、一致するまで削除、再ラベル付け、またはサイズ変更が必要なボックスが増えます。
- 再現率が低い場合は、ボックスの追加、サイズ変更、または再ラベル付けが必要なラベル付き物体が増えます。
- F1は、2つの指標の調和平均(2 x P x R / (P + R))であり、両方を1つの数値にまとめます。レビューにかかる時間を測る指標ではありません。
- mAP50とmAP50-95は、クラス全体の平均適合率に基づいてモデルを順位付けします。IoU 0.5と、0.50から0.95までのより厳しいしきい値全体で評価します。リーダーボードの並べ替えにはmAP50を使います。
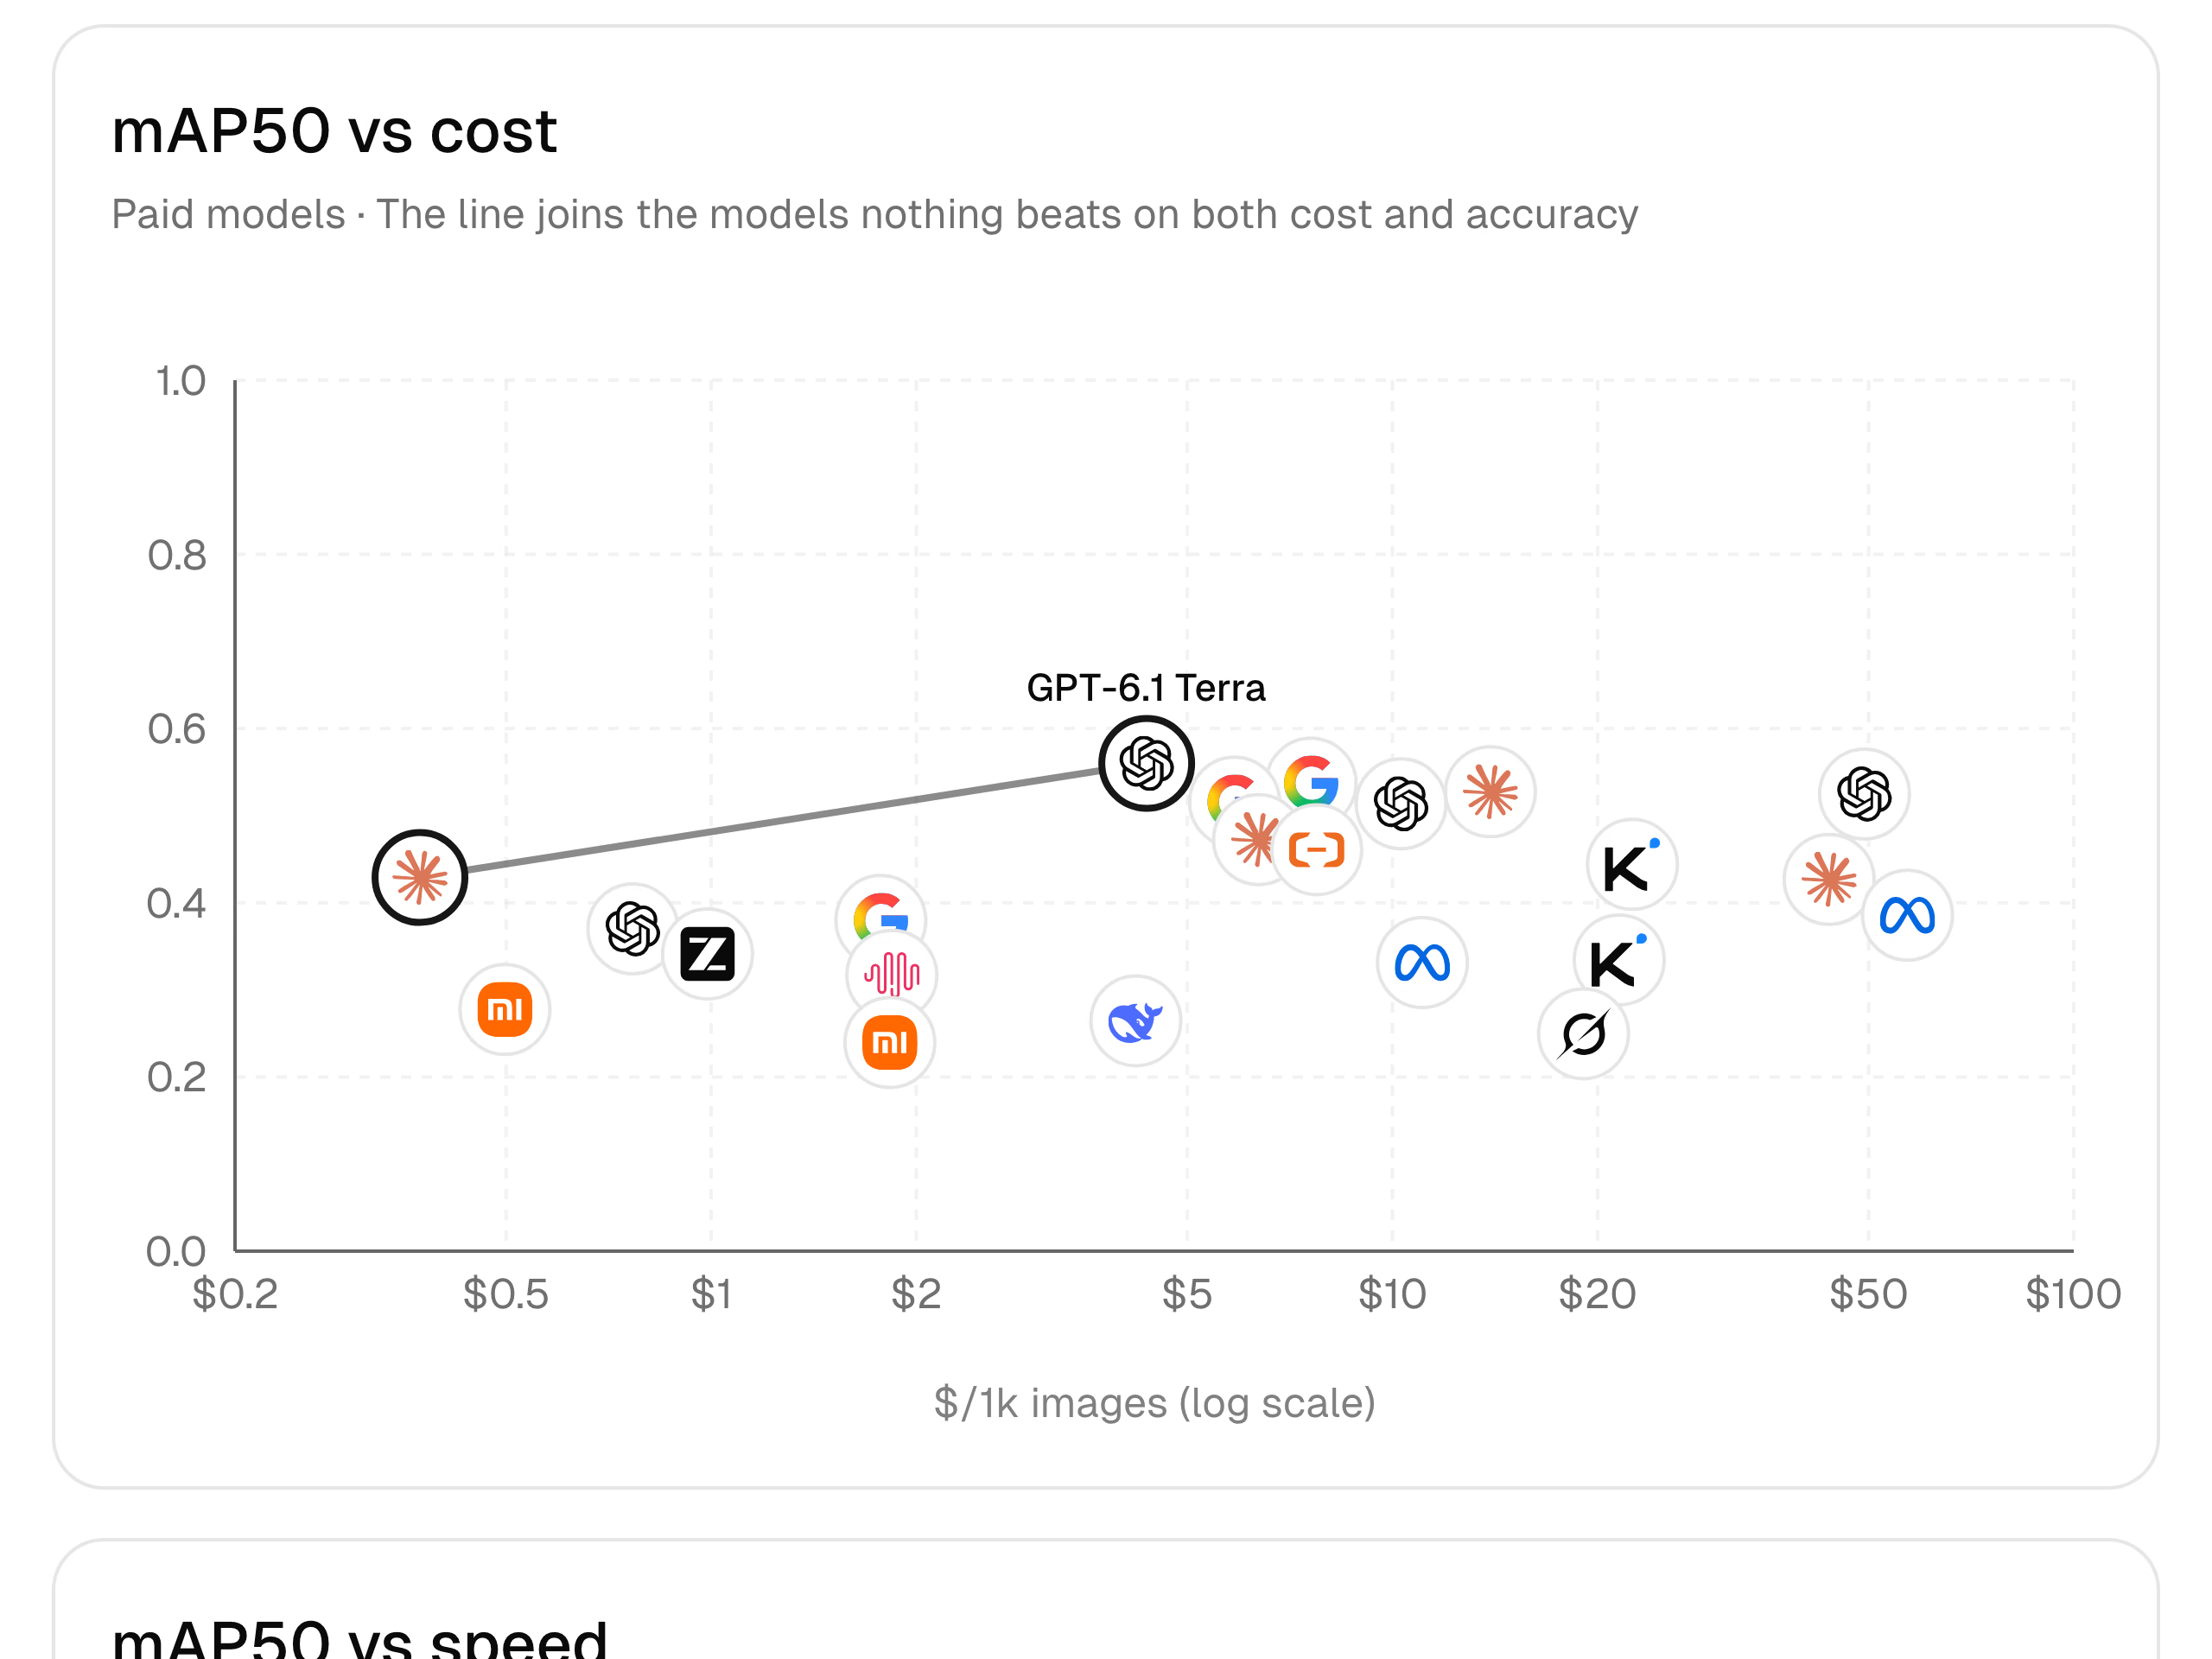
mAP50が0.51を超える6つのモデルを以下に示します。コストは、ベンチマーク画像1,000枚のアノテーション成功あたりにプロバイダーが報告したトークン使用量から推定し、レイテンシはリクエスト時間の中央値です。
| モデル | mAP50 | mAP50-95 | 適合率 | 再現率 | F1 | プロバイダー料金 / 画像1,000枚(ベンチマーク使用量) | レイテンシ |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*Gemini 4 Argonの推定額には、2026年11月30日まで適用されるGoogleの導入価格を使用しています。12月1日からはGoogleの標準料金が2倍になり、同じ使用量で画像1,000枚あたり約15ドルになります。Ultralytics PlatformのBatch Annotationでは、ホスト型モデルを含むすべてのモデルで、処理画像1,000枚あたり1.00ドルが加算されます。
6モデルは2つのグループに分かれます。Argon、Opus 5.5、Gemini 3.8 Flashは精度が0.66~0.67で、再現率は0.60未満です。つまり、ボックスの高い割合が一致する一方で、ラベル付き物体との一致数は少なくなります。AstraとSolは再現率が0.62~0.63に達し、精度は0.55~0.56です。ラベル付き物体との一致割合は高い一方で、ボックスの一致割合は低くなります。Terraは両グループの中間に位置し、mAP50とF1で首位です。
誤検出の修正コストが高い場合は精度を優先します#
Gemini 4 Argonの全体精度は0.667で、ベンチマーク対象40モデルの中で最高です。そのトレードオフとして、平均再現率は0.585で、再現率の上位モデルを下回っています。
一致しないボックスを見つけにくい場合は、精度が特に重要です。物体が密集した画像では、レビュアーは修正前に多くの正しいボックスの中から誤ったボックスを探す必要があります。SKU110Kの密集した小売店の棚画像は、こうした画像で精度がどれほど変わり得るかを示しています。GPT-6.1 Terraの結果では、Terraはこのデータセットで精度0.79、再現率0.73を記録したのに対し、GPT-6.1 Solはそれぞれ0.49と0.77でした。
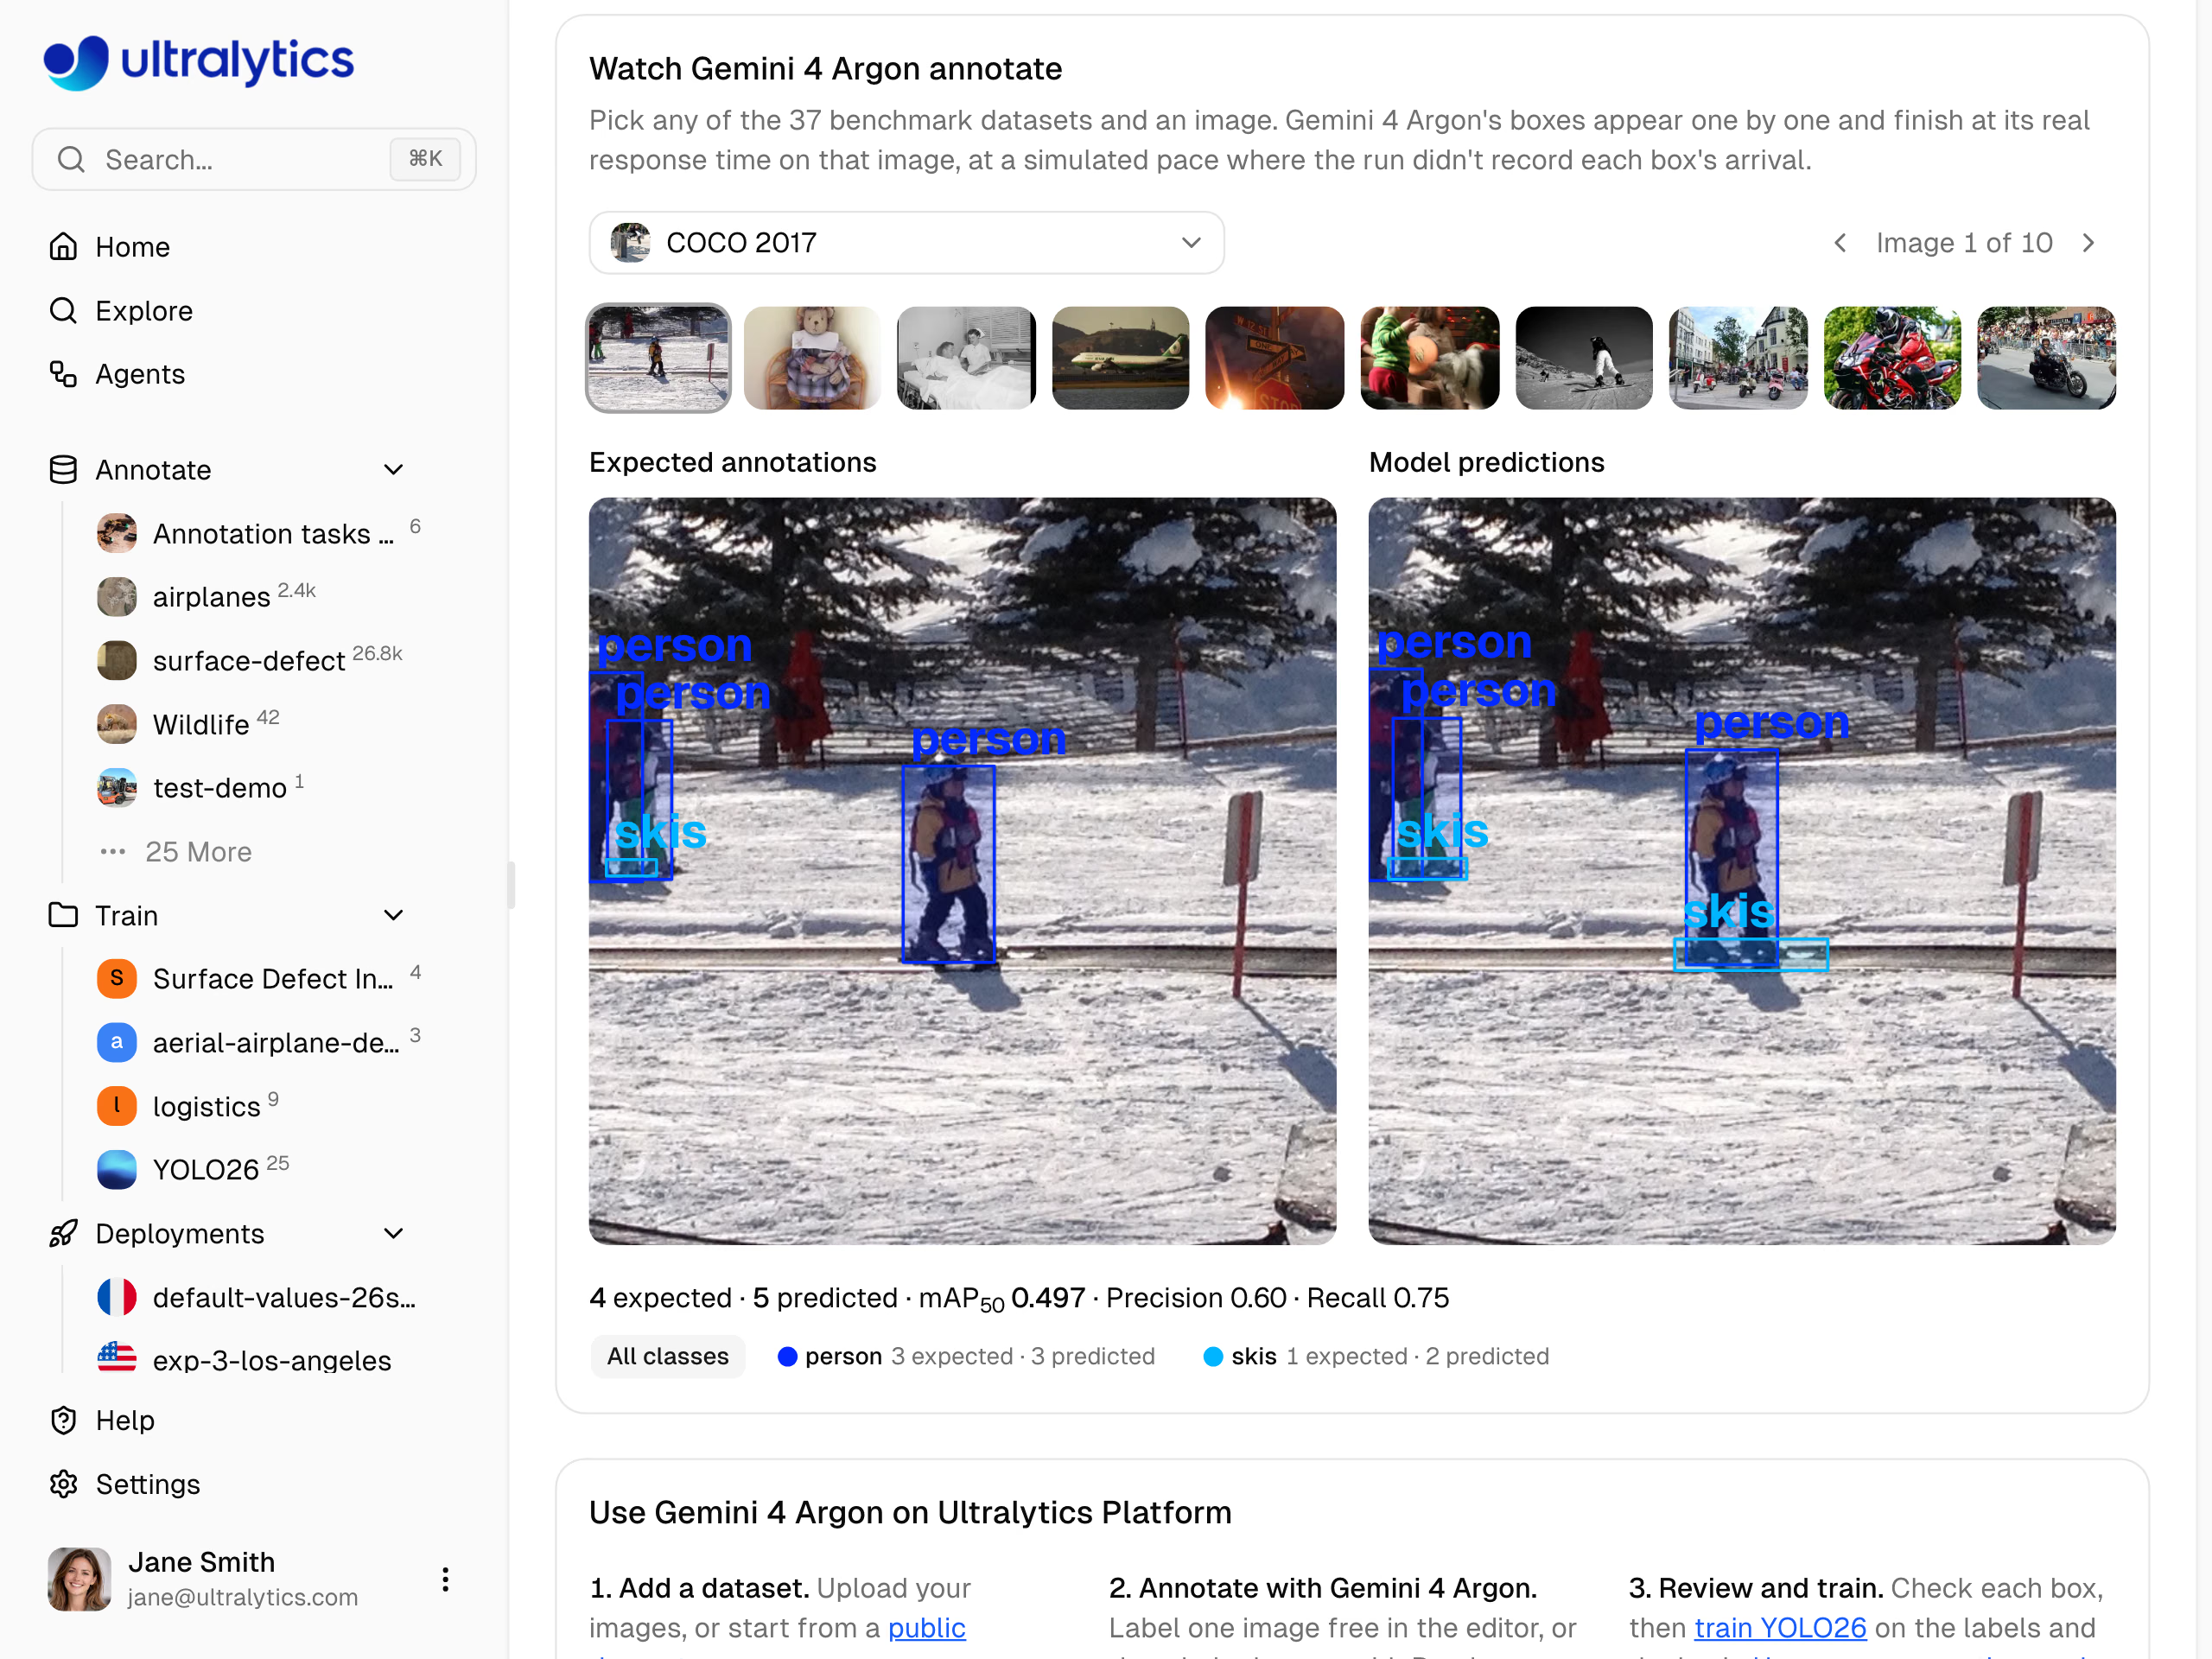
Gemini 4 Argon:ラベル付き物体4個に対して5個のボックスを予測し、精度は0.60、再現率は0.75です。
Argonはベンチマークでリクエストの失敗がなく、中央値4.6秒は上位2モデルの中で最速でした。データがArgonの得意な分野、つまり航空画像、水中画像、熱画像、セキュリティ用X線画像に似ている場合(セキュリティスキャンのIEDXrayで最高のmAP50となる0.298を記録)、また、余分なボックスを探すより、見逃したオブジェクトをいくつか追加するほうがよい場合に選んでください。
物体の見逃しによるエラーコストが高い場合は再現率を優先します#
GPT-6 Astraはリーダーボードで最も高い平均再現率0.627を記録しています。精度0.56がその代償です。
ラベル漏れのほうが大きな問題となる場合は、再現率を優先したラベリングが適しています。トレーニングセットで欠陥や病変を見逃すと、検出器はそのオブジェクトを背景として学習します。また、欠けたボックスを見つけるには、印が付いていないオブジェクトを探してすべての画像を確認する必要があります。Astraは、TBX11Kの胸部X線画像(0.330)、GRAZPEDWRI-DXの小児手首X線画像(0.354)、DsPCBSD+のPCB表面欠陥(0.394)を含む36データセットのうち7つで、最高のmAP50を記録しています。これは類似データでテストする理由にはなりますが、お客様のデータで見逃しが少ないことの証明にはなりません。
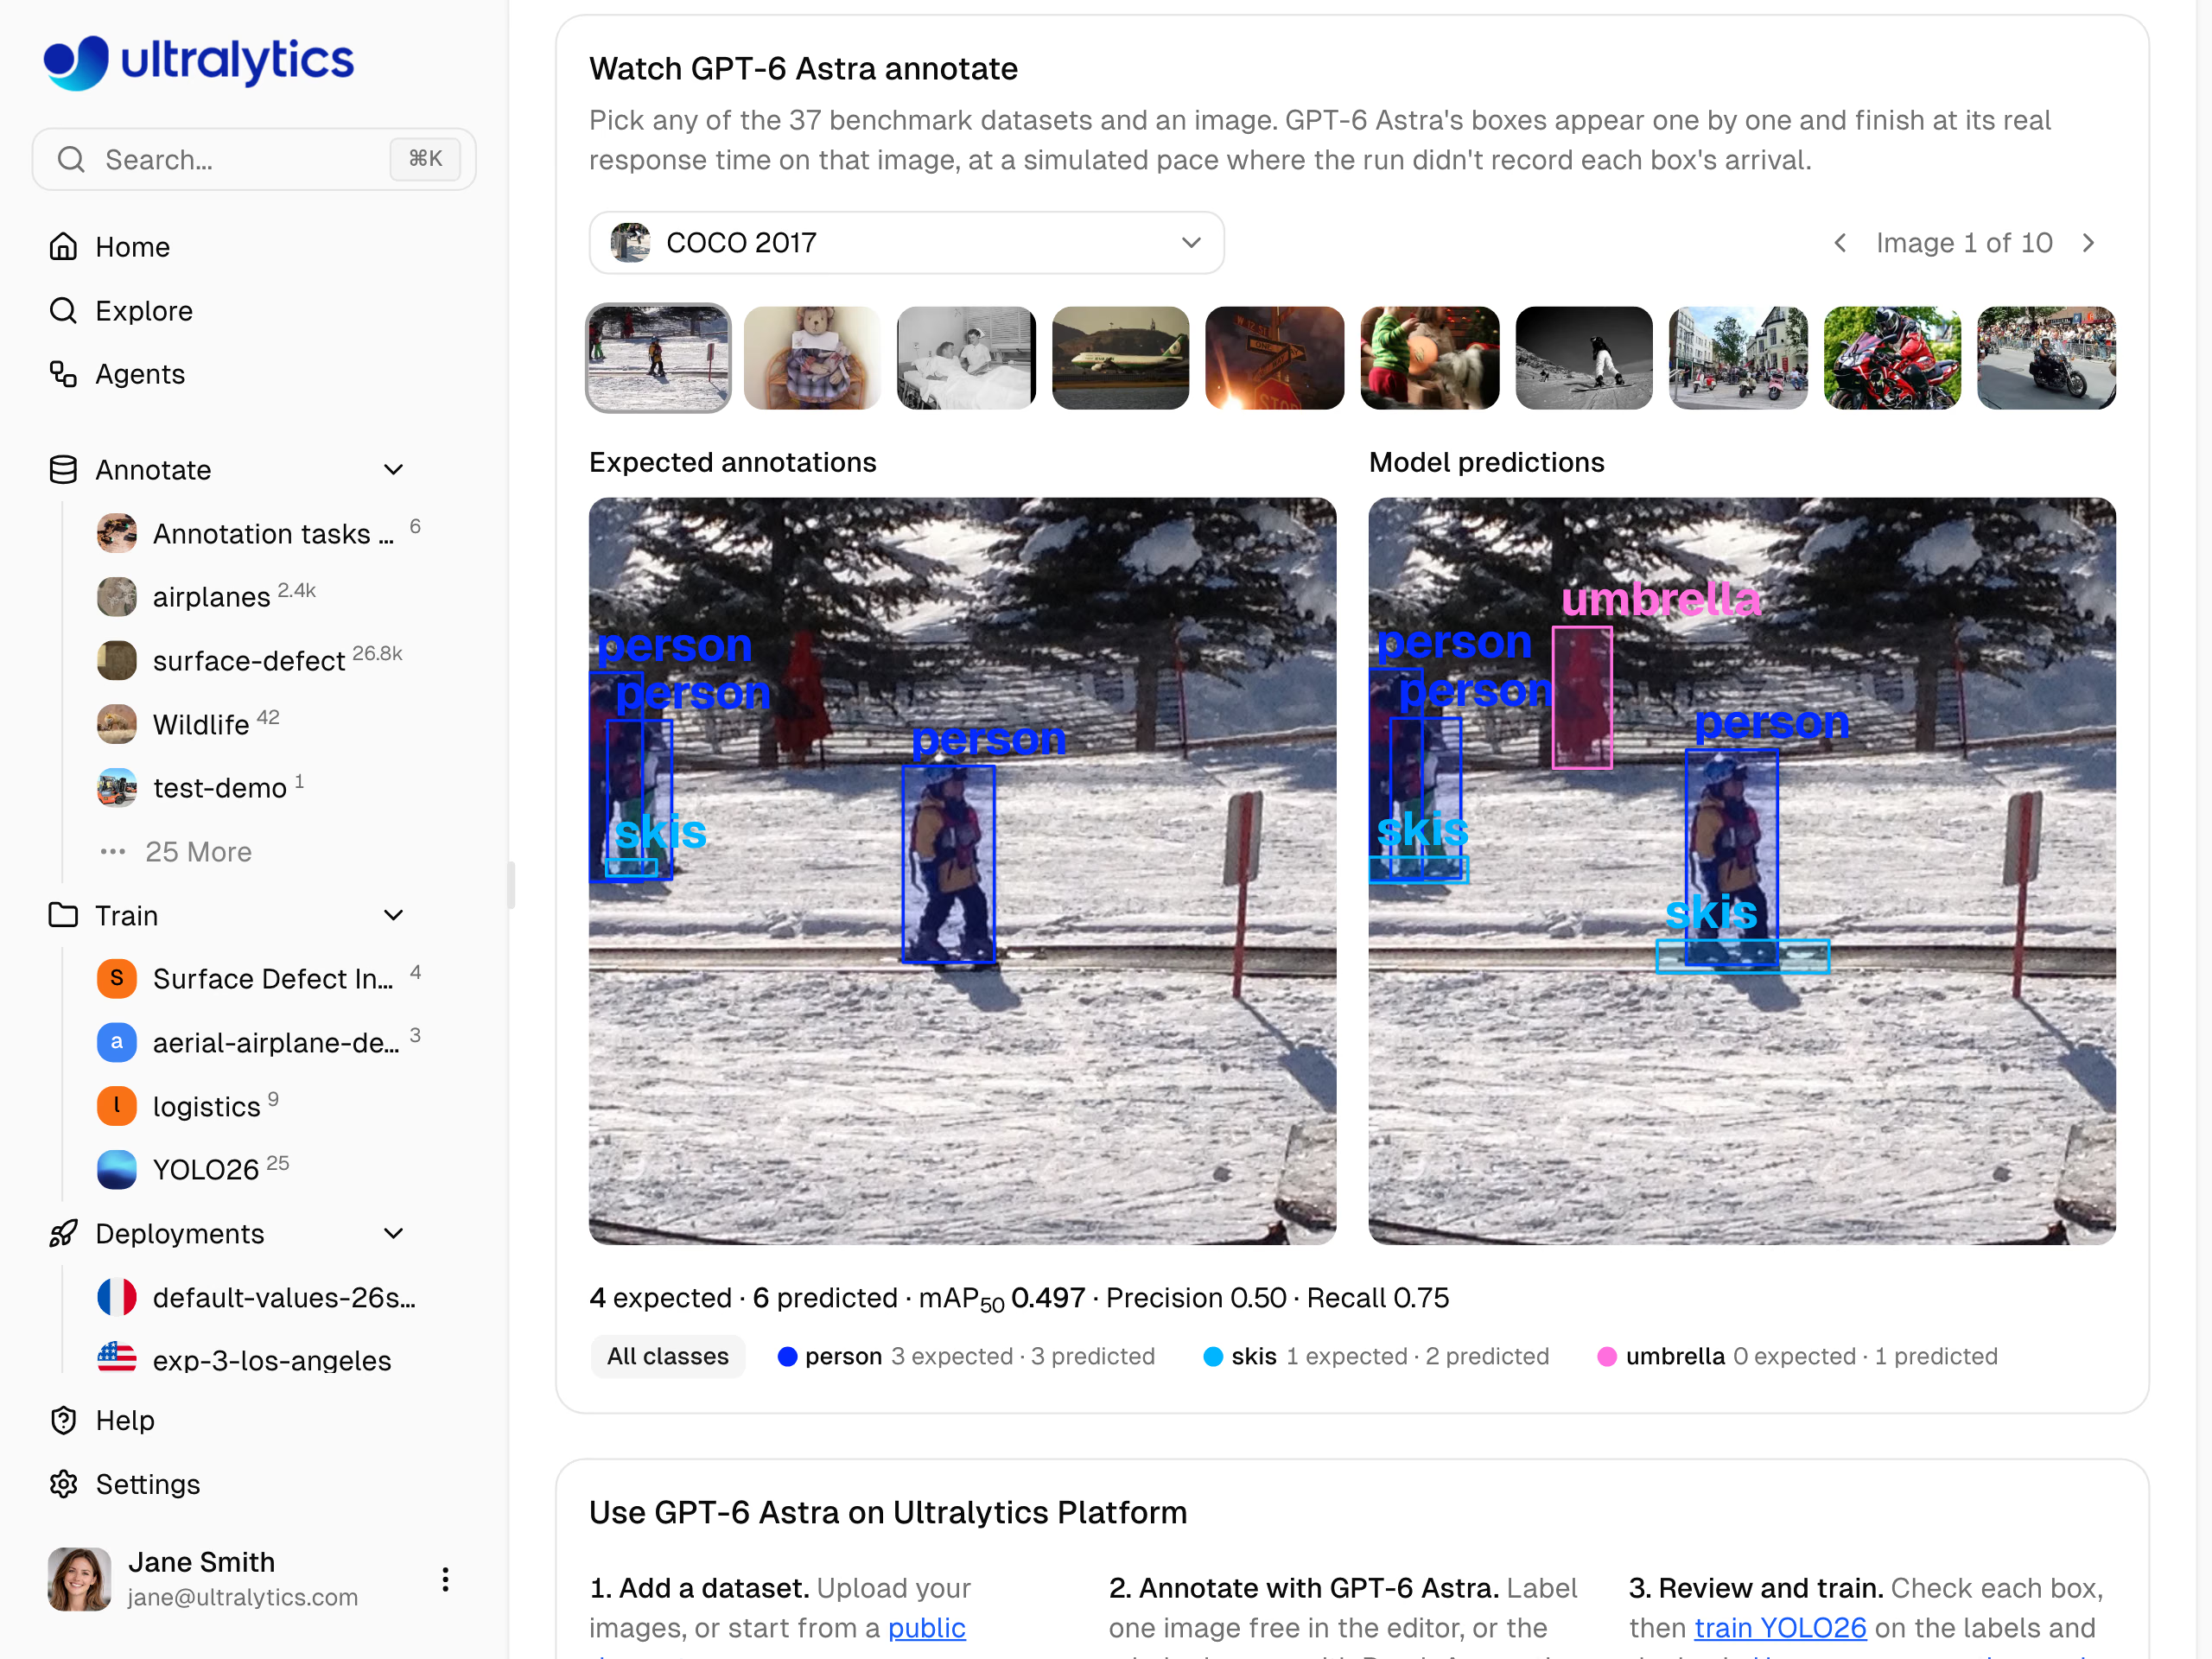
GPT-6 Astra:同じ4つのオブジェクトに対して6個のボックスを予測し、COCOのラベルには含まれていない傘も検出しています。適合率は0.50、再現率は0.75です。
Astraは上位6モデルの中で最も高額な推定コストで、画像1,000枚あたり49.31ドルです。中央値は11.6秒で、画像の1%でリクエストが失敗しました。再現率では、他の2つのOpenAIモデルも近い結果です。GPT-6.1 Solは0.62で推定10.30ドル、GPT-6.1 Terraは0.61で推定4.36ドルです。
mAP50-95とF1で両方のエラーを考慮します#
GPT-6.1 TerraはmAP50 0.560、mAP50-95 0.345でリーダーボードの首位です。精度0.646と再現率0.613はいずれも各指標の首位と数百分の一の差で、F1は0.63と、6モデル中最高です。ArgonとOpus 5.5は0.62で続きます。F1の差がこれほど小さく、しかもF1ではレビュー時間が分からないため、ドメイン別の結果と自分の画像でのテストを基に選んでください。
mAP50-95で首位であることも、もう1つの判断材料になります。mAP50-95は重なりのしきい値を最大0.95まで平均するため、正しい物体を検出するだけでなく、一致したボックスがどれだけ正確に合っているかも評価します。Terraはこの指標でも首位です。また、上位6モデルの中で推定コストが最も低く、リクエストの失敗もありませんでした。リーダーボードでは「最もお得」と評価されています。
プロバイダーキーなしでラベリングする:ホスト型モデルとオープンボキャブラリー検出器#
有料プロバイダーキーを使いたくないチームもあります。Platformのホスト型モデルはプロバイダーキーなしで実行でき、それぞれの指標は有料モデルとは異なる傾向を示します。
- SAM 3.1 Text: mAP50 0.332、精度0.19、再現率0.47、画像あたり0.2秒です。VisDrone(mAP50 0.479)とFisheye8K交通画像(0.478)では、40モデル中で最高の結果です。
- Qwen3.8 27B: mAP50 0.351、精度0.54、再現率0.40、1.5秒です。
- Gemma 4 26B: mAP50 0.344、精度0.53、再現率0.39、0.9秒です。
オープンボキャブラリー検出器もホスト型です。このベンチマークでは、OWLv2 LargeはmAP50 0.133、Grounding DINO Baseは0.104で、いずれも画像あたり0.2秒でした。SAM 3.1 Textは0.332です。これらのスコアは、各モデルの元の設定ではなく、SAM 3.1によるボックス調整を含むPlatformのクラスプロンプト型パイプラインを評価しています。
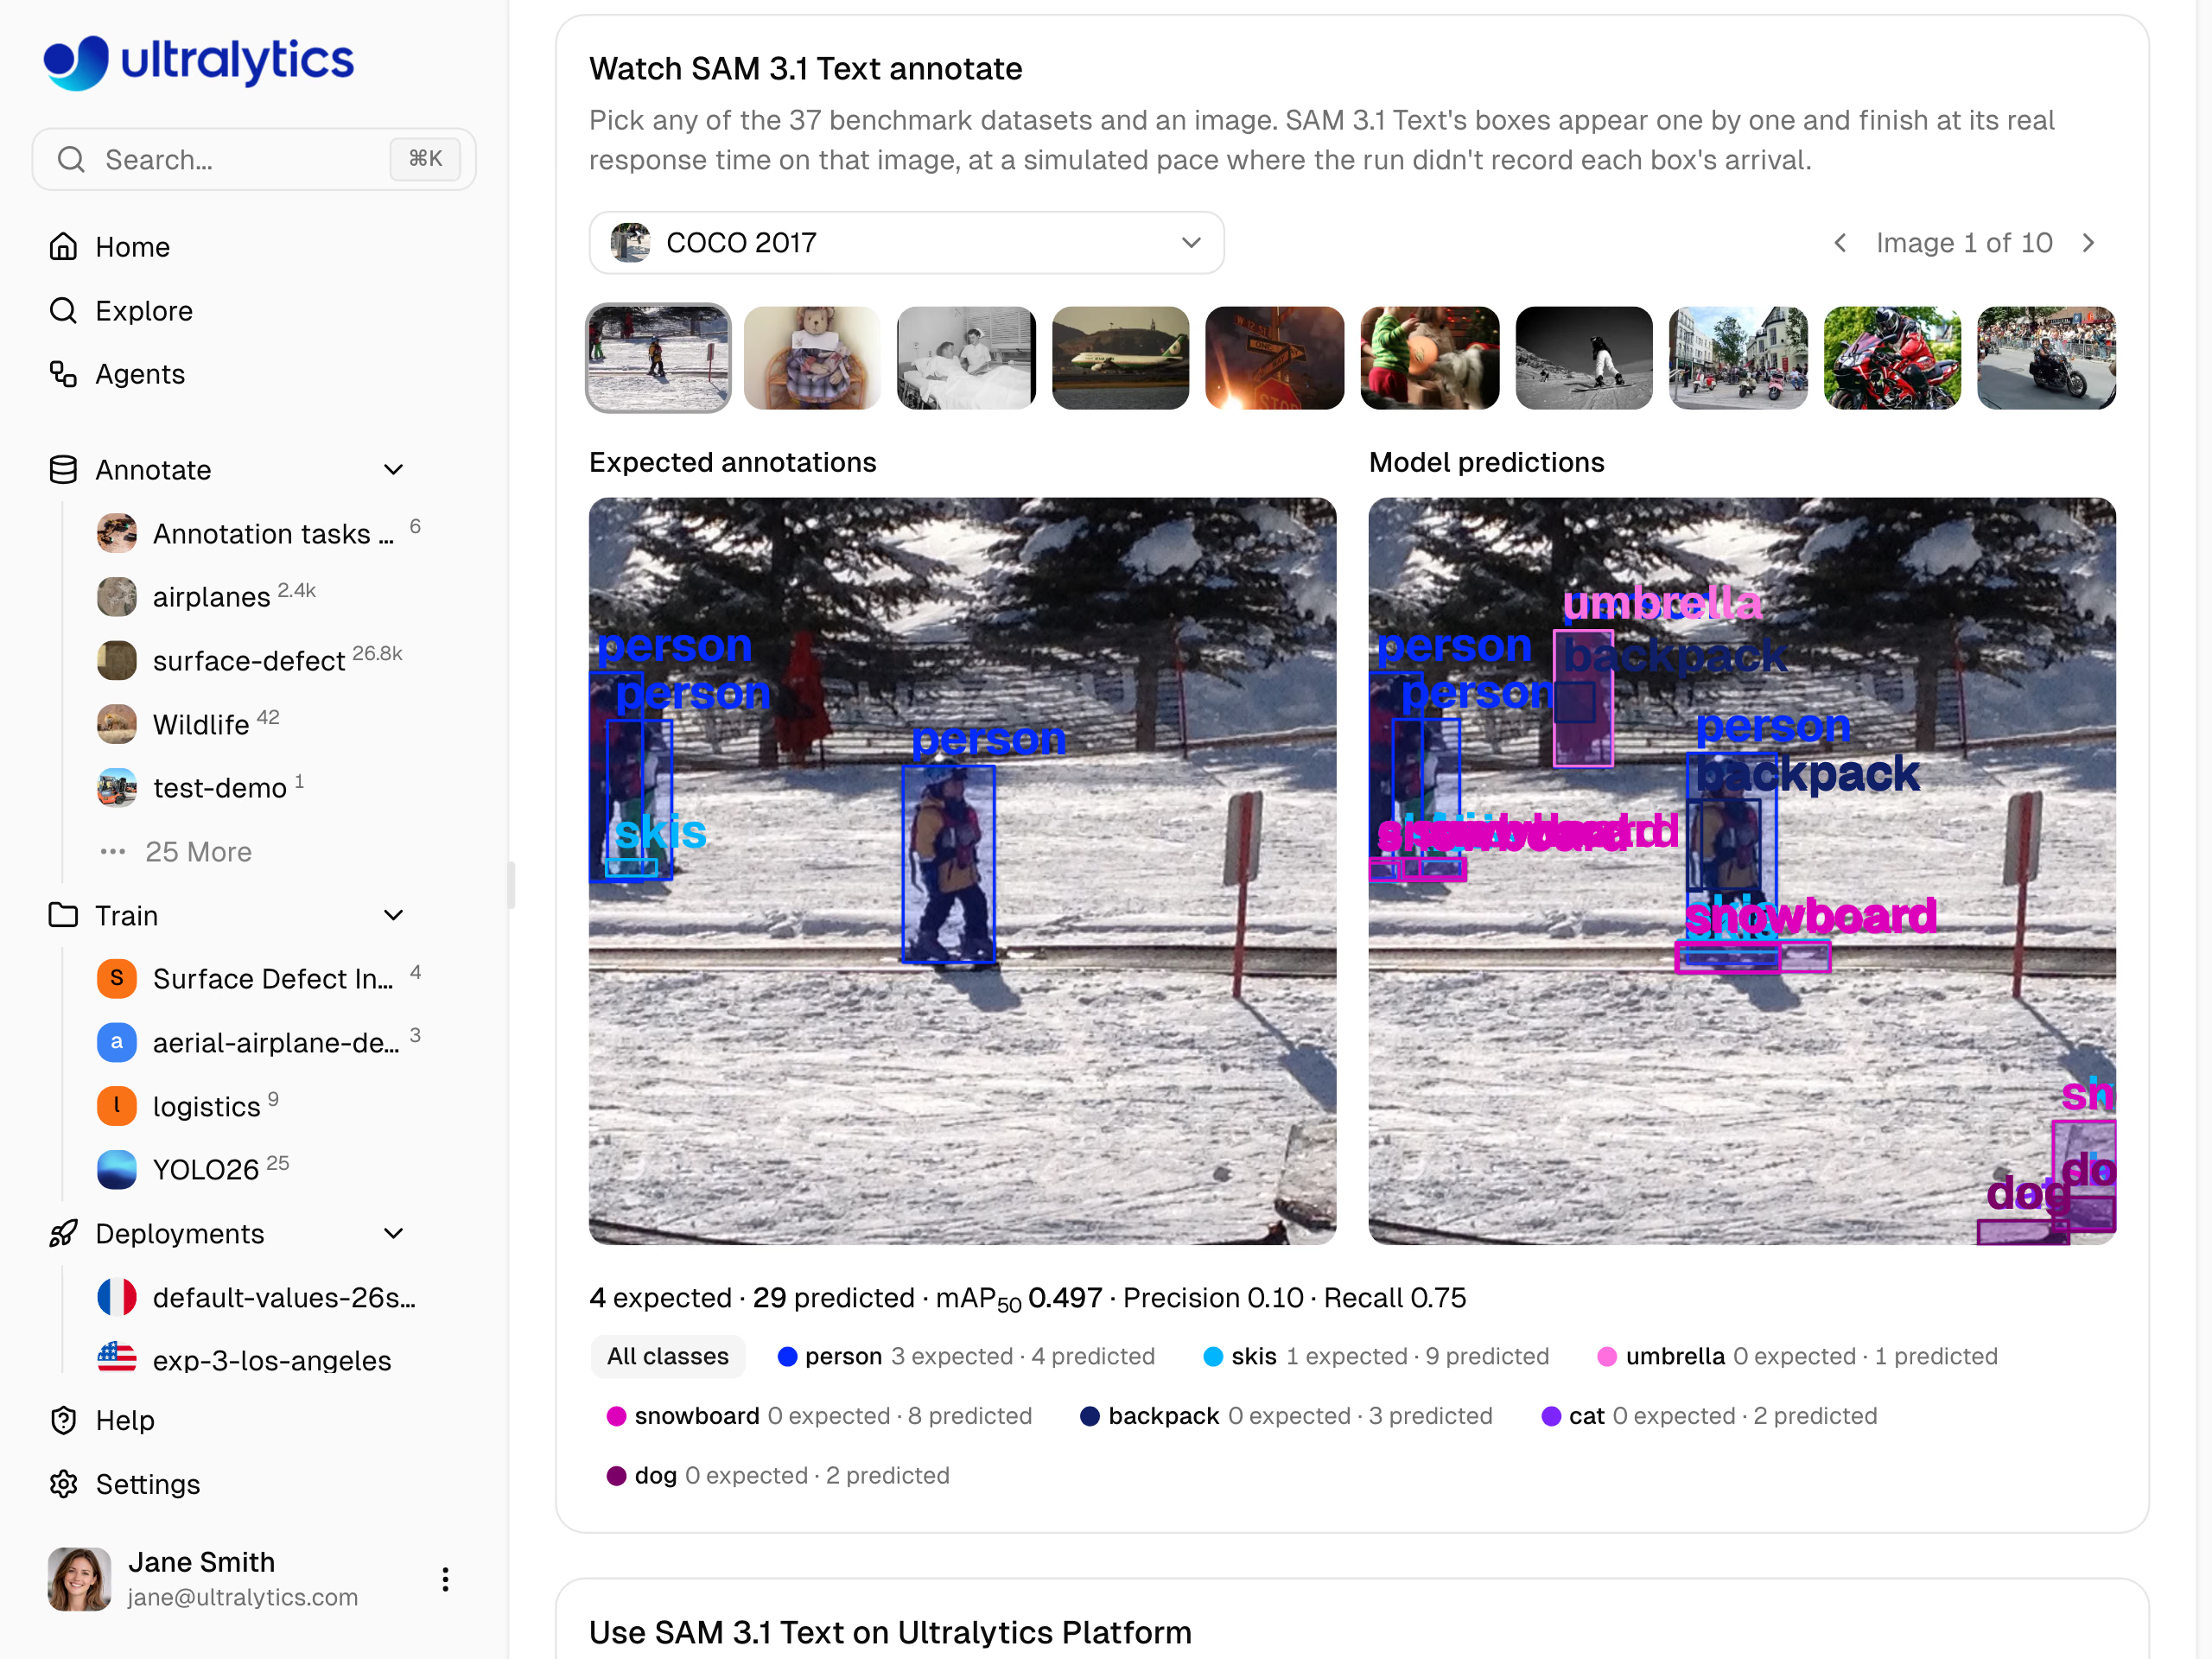
SAM 3.1 Text:4個の物体に対して29個のボックスを検出し、精度は0.10、再現率は0.75です。3つの再生結果はいずれも4個の物体のうち3個を検出しています。違いは、レビュアーが削除する余分なボックスの数です。
SAM 3.1 Textは、レビュアーが余分なボックスを削除することを前提に、広めの初稿を作成する場合に向いています。密集した空撮や交通のシーンに適しています。Qwen3.8 27BとGemma 4 26Bは、精度が低めの慎重なグループと同様の動作をします。低コストの有料モデルでは、Claude Haiku 5.5がmAP50 0.429、精度0.56、再現率0.47を記録し、画像1,000枚あたりの推定コストは0.37ドルです。このモデルもリーダーボードで「最もお得」と評価されています。
リーダーボード全体の平均では自分のドメインが分からないため、データセット表を確認してください#
各モデルの精度と再現率は36データセットの平均値ですが、自分のデータはそのうちの1つのドメインに属します。VLMリーダーボードのデータセット表では、難易度の高い順に各データセットの平均精度と平均再現率を40モデルすべてについて示し、各データセットで最良のモデルも掲載しています。
警戒すべき兆候を確認してください。10枚の画像に合計2,267個のタンクがラベル付けされたAirbus Oil Storage Detectionでは、モデルの平均精度は0.39、平均再現率は0.11で、mAP50の最高値はGemini 4 Argonの0.347です。DeepPCBでは、平均精度と平均再現率はそれぞれ0.03と0.04で、GPT-6.1 SolがmAP50 0.393で際立っています。
これらの数値は判断の結論ではなく、候補の絞り込みに使ってください。手法の説明によると、データセットあたり10枚の画像でモデルやドメインの順位付けはできますが、単一データセットのスコアを確定するには不十分です。また、実行を繰り返すと個々の数値は数ポイント変動します。Platformの各モデルページでは、ベンチマークデータセットとCOCO上で、モデルが記録したボックスを正解ボックスと並べて再生できます。実行を始める前に、自分のデータに最も近いデータセットを確認できます。
5つの手順でモデルをレビューのワークフローに合わせる#
まず選択の優先事項を決め、自分の画像で選択を確認してください。
| 優先事項 | 候補(2026年10月の結果) |
|---|---|
| 精度を優先 | Gemini 4 Argon |
| 再現率を優先 | GPT-6 AstraまたはGPT-6.1 Sol |
| 両方を考慮 | GPT-6.1 Terra |
| プロバイダーキーなし | ホスト型:Qwen3.8 27BまたはSAM 3.1 Text |
クラスプロンプト型アノテーションは、クラス数が1~200の物体検出データセットで利用できます。
- リーダーボードで候補を絞り込みます。 物体検出用のVLMリーダーボードで、PaidまたはHostedモデルに絞り込み(Not on Platformと表示されたモデルは除外)、優先事項に合う列を確認し、データセットの表で対象分野を確認してください。
- プロバイダーキーを追加する。 有料モデルを使う場合は、データセットを所有するワークスペースのSettings > API Keysにキーを保存してください。料金はプロバイダーからキーに直接請求されます。プロバイダーキーのドキュメントで設定方法を確認できます。
- レビュー済みのサンプルでテストする。 自分のデータを代表する画像を数枚選び、手作業でラベル付けします。アノテーションエディターを開き、Smartモードに切り替え、モデルピッカーでプロバイダーの下にあるモデルを選び、Predict(
P)を押します。削除したボックス、追加したボックス、レビューにかかった時間を記録してください。 - データセットにラベルを付ける。 データセットページでMore actions > Batch Annotationを選択します。この機能は、最大3つの画像チャンネルを持つPlatformホスト型データセットで利用できます。デフォルトでは未ラベルの画像にラベルを付け、既存のラベルは変更せず、ロールバックできるように先にデータセットのバージョンを保存します。開始前にダイアログで推定コストを確認してください。Batch Annotationの料金は、プロバイダー料金に加えて、処理画像1,000枚あたり1.00ドルです。
- レビューしてからトレーニングする。 モデルの弱点を考慮してボックスを確認し、保存してから、同じワークスペースで結果を使ってUltralytics YOLOモデルをトレーニングしてください。
背景情報については、Ultralytics PlatformがAIを使ってアノテーションを自動化する方法と、人間参加型のレビューが引き続き必要な理由をご覧ください。ツール間で自動ラベリングとアクティブラーニングを比較するには、自動ラベリングとアクティブラーニングの比較をお読みください。
チーム別の候補(2026年10月の結果)#
- 初稿を整理するより、補完したいレビュアー: 全体で最も精度が高く、空撮、水中、熱画像、セキュリティX線画像に最も強いGemini 4 Argon。
- 見逃しが訓練データを損なう希少物体: 再現率を最大化するならGPT-6 Astra、僅差で続くGPT-6.1 Sol。
- 特定の優先事項がない汎用ラベリング: mAP50、mAP50-95、F1で首位のGPT-6.1 Terra。
- プロバイダーキーを持たないチーム: 密集したシーンで再現率重視の初回処理を行うならSAM 3.1 Text、より慎重な初稿を作るならQwen3.8 27B。
どのモデルを選んでも、リーダーボードを使えば開始前にレビュー内容を予測できます。これらの指標の理論的背景については、精度、適合率、再現率のガイドで基本を、Academyの検出指標の読み方のレッスンで詳しい説明をご覧ください。
よくある質問
誤ったボックスの削除に時間がかかる場合は、精度を優先してください。たとえば、誤検出のボックスが正しいボックスに紛れ込む密集画像が該当します。希少な欠陥や病変など、物体の見逃しによるコストが高い場合は、再現率を優先してください。ラベルのない物体があると、検出器はその物体を背景として学習するためです。その後、自分の画像を手作業でレビューしたサンプルで選択を確認してください。
クラスプロンプト型モデルは信頼度スコアなしでボックスを返し、モデル固有のしきい値を使用するため、選択中はPlatformで信頼度とIoUの設定が非表示になります。そのため、リーダーボードの精度と再現率は、IoU 0.5でモデルが返すすべてのボックスを数えます。一致しないボックスと未検出の物体のバランスを変えるには、別のモデルを選択してください。
mAP50はモデルが正しい物体を検出してラベル付けするかどうかの確認に使い、mAP50-95はより厳しい重なりしきい値を加えて、ボックスが正確に合うモデルを評価します。どちらも見逃しと誤検出を反映するため、精度と再現率と併せて確認してください。2026年10月の結果では、GPT-6.1 Terraがそれぞれ0.560と0.345で首位です。
はい。UL37 v2で最上位のモデルでも平均mAP50は0.560(2026年10月)で、PCB欠陥や胸部X線画像など最も難しいデータセットでは、40モデルの平均が0.05を下回ります。すべての画像をレビューし、モデルの弱点を特に注意して確認してください。再現率重視のモデルでは余分なボックスを、精度重視のモデルでは見逃した物体を確認します。
費用は2種類あります。Ultralytics PlatformのBatch Annotationは、ホスト型モデルを含むすべてのモデルで、処理画像1,000枚あたり1.00ドル(最低0.01ドル)です。エディターでホスト型モデルを使った単一の予測は無料です。有料プロバイダーモデルは、ユーザー自身のAPIキーを通じてプロバイダーからも請求されます。2026年10月のベンチマークでは、このガイドに掲載したモデルのプロバイダー料金の推定額は、画像1,000枚あたり0.37ドル(Claude Haiku 5.5)から49.31ドル(GPT-6 Astra)でした。実行を停止した場合、すでに処理済みの画像分は請求されます。
はい。SAM 3.1 Text、Qwen3.8 27B、Gemma 4 26Bなどのホスト型モデルは、プロバイダーキーなしでUltralytics Platform上で実行できます。独自のYOLOモデルも同様です。バッチ実行には処理画像1,000枚あたり1.00ドルがかかり、実行前に毎回ダイアログに推定額が表示されます。
用途によって異なります。クラスプロンプト型VLMは、クラス名だけを指定して新しいクラスのラベルを作成できますが、2026年10月のベンチマークで最高スコアを記録した6モデルは、画像1枚あたり2.7~11.6秒かかり、トークン単位で課金されます。リアルタイム検出では、VLMで自動アノテーションを行い、ラベルをレビューしてから、それを使ってUltralytics YOLOモデルをトレーニングする方法が一般的です。すでにトレーニング済みのYOLOモデルを使って、同じエディターで新しい画像を自動アノテーションすることもできます。
執筆者
コメント2
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









