Ultralytics YOLO와 NVIDIA Cosmos Data Factory: 결함 탐지를 위한 합성 데이터
NVIDIA Cosmos Data Factory의 합성 데이터와 NVIDIA가 지원하는 자동화된 에이전트형 데이터 강화 학습 루프를 활용하면 Ultralytics YOLO는 전체 데이터셋의 정확도를 일부 라벨만으로 달성할 수 있습니다.
Ultralytics와 NVIDIA는 타깃 학습 데이터가 Ultralytics YOLO에 어떤 성과를 가져올 수 있는지 보여주기 위해 협력했습니다. NVIDIA의 에이전트형 데이터 강화 학습 루프는 모델에 필요한 이미지를 식별하고, NVIDIA Cosmos Data Factory는 아직 존재하지 않는 이미지를 생성하며, Ultralytics YOLO는 그 결과물로 학습되는 모델입니다. 머신러닝(ML) 팀은 이 조합을 19개의 공개 산업 검사 벤치마크에서 평가하여, NVIDIA의 에이전트형 파이프라인과 Cosmos Data Factory 합성 데이터로 학습한 Ultralytics YOLO26을 기존 방식으로 학습한 동일 모델과 비교했습니다. 이 게시물에서 그 결과를 소개합니다.
데이터를 더 많이 확보하는 것이 답은 아닙니다. 적합한 데이터가 답입니다.#
모든 검사 팀은 이런 상황을 잘 알고 있습니다. 결함 탐지 모델은 자주 본 결함에서는 성능이 뛰어나지만, 생산 라인에서 가장 중요한 희귀한 긁힘, 이례적인 조명, 특이한 카메라 각도는 놓칩니다. 일반적인 해결책은 모든 종류의 데이터를 더 많이 수집하고 라벨링하는 것이지만, 이는 느리고 비용이 많이 들며 모델이 이미 잘 처리하는 이미지만 대부분 추가하게 됩니다.
NVIDIA가 지원하는 자동화된 에이전트형 학습은 다른 접근 방식을 취합니다. 데이터셋의 구체적인 취약점을 찾아 이미 존재하는 실제 이미지나 실제 사례가 없는 경우 Cosmos Data Factory가 생성한 합성 이미지로 보완합니다. Ultralytics YOLO와 결합하면 모델에 부족한 데이터를 정확히 학습시킬 수 있습니다.
NVIDIA의 데이터 강화 학습 루프는 어떻게 작동하나요?#
Ultralytics YOLO를 위한 NVIDIA의 에이전트형 데이터 강화 학습 루프는 학습 루프를 감싸고 모델에 다음으로 필요한 데이터를 결정하는 모델 개선 파이프라인입니다:
• 실제 데이터를 탐색합니다. 기존 이미지 풀을 검색해 학습 세트의 구체적인 공백을 메우는 실제 사례를 찾습니다.
• 합성 데이터를 생성합니다. 실제 사례가 없는 경우 Cosmos Data Factory로 엣지 케이스 이미지를 생성합니다.
• 자동으로 라벨링합니다. AnomalyGen이라는 구성 요소가 합성 이미지에 라벨을 지정하므로 재학습 전에 수동 주석 작업을 할 필요가 없습니다.
핵심 아이디어는 데이터 효율성보다 타깃 데이터입니다. 목표는 단순히 더 적은 데이터로 학습하는 것이 아닙니다. 데이터셋에서 모델이 취약한 공백을 탐색하거나 생성해 정확히 채우고, 보강된 데이터로 재학습하는 것입니다. 아래 결과에서 볼 수 있듯이, 이를 잘 수행하면 학습 이미지 수가 줄어드는 효과도 얻을 수 있습니다.
이 파이프라인은 Ultralytics YOLO를 사용해 심층적으로 벤치마킹했으며, 이 문서의 모든 결과에는 Ultralytics YOLO26을 사용했습니다.
NVIDIA Cosmos Data Factory의 역할#
Cosmos Data Factory는 NVIDIA의 Cosmos 월드 모델을 기반으로 구축된 데이터 큐레이션, 처리 및 생성 플랫폼입니다. 에이전트형 학습 루프에서 Cosmos Data Factory는 실제 데이터셋이 충분히 다루지 못하는 시나리오의 이미지를 생성합니다. 예를 들면 제조 과정의 특정 결함 유형이나 교통 영상의 어안 렌즈 왜곡이 있습니다.
인계 과정은 간단합니다. Cosmos가 엣지 케이스 이미지를 생성하고, AnomalyGen이 라벨을 지정한 다음, Ultralytics YOLO를 표준 Ultralytics 학습 파이프라인을 사용해 실제 데이터와 합성 데이터를 결합한 세트로 재학습합니다.
공개 데이터셋 19개로 Cosmos Data Factory 테스트하기#
Cosmos Data Factory와 Ultralytics YOLO의 성능을 확인하기 위해 ML 팀은 에이전트형 데이터 강화 파인튜닝 파이프라인을 19개의 공개 산업 검사 데이터셋에서 실행했습니다. 이 데이터셋은 강철, PCB, 직물, 금속 표면 및 소비재를 다루며, 학습 이미지는 총 약 91,000개입니다. 모든 실행은 8-GPU 호스트 한 대에서 수행했습니다.
비교 기준은 의도적으로 엄격하게 설정했습니다. 베이스라인과 Cosmos Data Factory 모델은 동일한 학습 설정으로 학습했습니다. Ultralytics YOLO26x, 100 에폭, 동일한 옵티마이저와 학습률, 시드를 사용했으며 두 모델 모두 동일한 홀드아웃 테스트 세트로 평가했습니다. 차이는 각 모델이 학습에 사용한 이미지뿐입니다. 베이스라인은 라벨이 지정된 모든 이미지로 학습합니다(합성 데이터 테스트에서는 실제 이미지만 사용).
1. 라벨의 일부만 사용해 동일한 정확도 달성#
19개 데이터셋 중 11개에서 에이전트형 파이프라인으로 학습한 Ultralytics YOLO26x는 전체 데이터셋으로 학습한 동일 모델과 동등한 성능을 보였습니다. 이 11개 데이터셋에서는 라벨이 지정된 이미지의 53%가 필요하지 않았습니다.
| 데이터셋 | 라벨 지정됨 | 사용됨 | 불필요 | 전체 데이터 mAP@0.5 | 큐레이션 데이터 mAP@0.5 |
|---|---|---|---|---|---|
| DAGM 클래스 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| DAGM 클래스 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| DAGM 클래스 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| DAGM 클래스 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| DAGM 클래스 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| DAGM 클래스 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| DAGM 클래스 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| DAGM 클래스 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
표 1. Cosmos Data Factory가 전체 데이터 모델과 동등한 성능을 달성한 데이터셋입니다. 동일한 홀드아웃 세트에서 측정한 mAP@0.5입니다.
DAGM 데이터셋에서는 에이전트형 파이프라인이 라벨의 10분의 1만으로 동일한 mAP@0.5에 도달했으며, 두 클래스에서는 전체 데이터 모델보다 약간 높은 성능을 보였습니다. pcb-defect에서는 이미지 20,924개 중 7,000개를 제외했지만, 정확도 차이는 실행 간 변동성보다 4배 작았습니다.
주석 작업에 비용을 지출하는 팀에 가장 중요한 점은 다음과 같습니다. 이 데이터셋에서 라벨링 예산의 대부분은 결과를 바꾸지 않는 이미지에 사용되었습니다.
2. 최대 74% 더 빠른 학습#
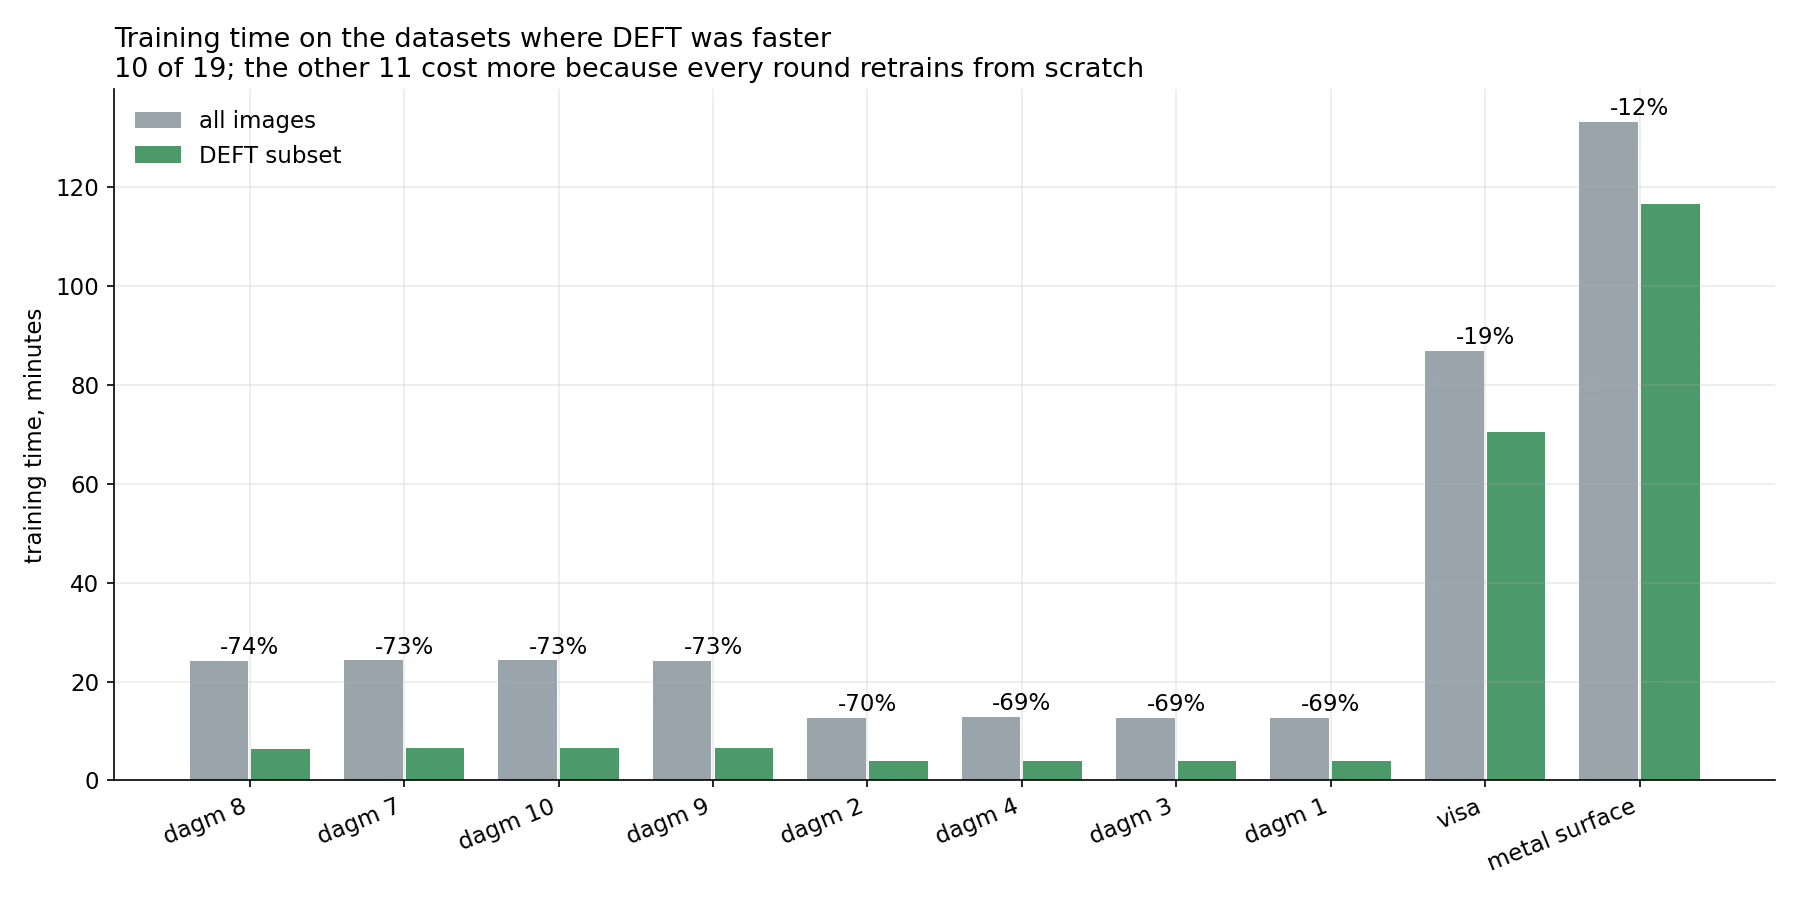
그림 1. Cosmos Data Factory가 더 빨랐던 데이터셋에서 전체 데이터셋과 Cosmos Data Factory 하위 집합의 학습 시간입니다.
더 작고 타깃을 명확히 한 세트로 Ultralytics YOLO를 학습하면 컴퓨팅 리소스도 절감됩니다. 19개 데이터셋 중 10개에서 에이전트형 파이프라인의 학습 속도가 더 빨랐습니다. DAGM에서는 학습 시간이 13~24분에서 4~7분으로 줄어 69~74% 단축되었습니다. 규모가 큰 데이터셋에서도 VisA는 19%, metal-surface-defect는 12%의 실질적인 시간 절감 효과를 보였습니다.
이러한 절감 효과가 모든 경우에 나타나는 것은 아닙니다. 나머지 9개 데이터셋에서는 큐레이션을 거친 각 라운드마다 처음부터 재학습하므로 에이전트형 파이프라인이 전체 데이터 실행 한 번보다 오래 걸렸습니다. 큐레이션된 하위 집합이 원본보다 충분히 작지 않으면 추가 라운드에 드는 시간이 절감 효과를 상쇄합니다.
3. 생성된 결함으로 바운딩 박스 정밀도 향상#
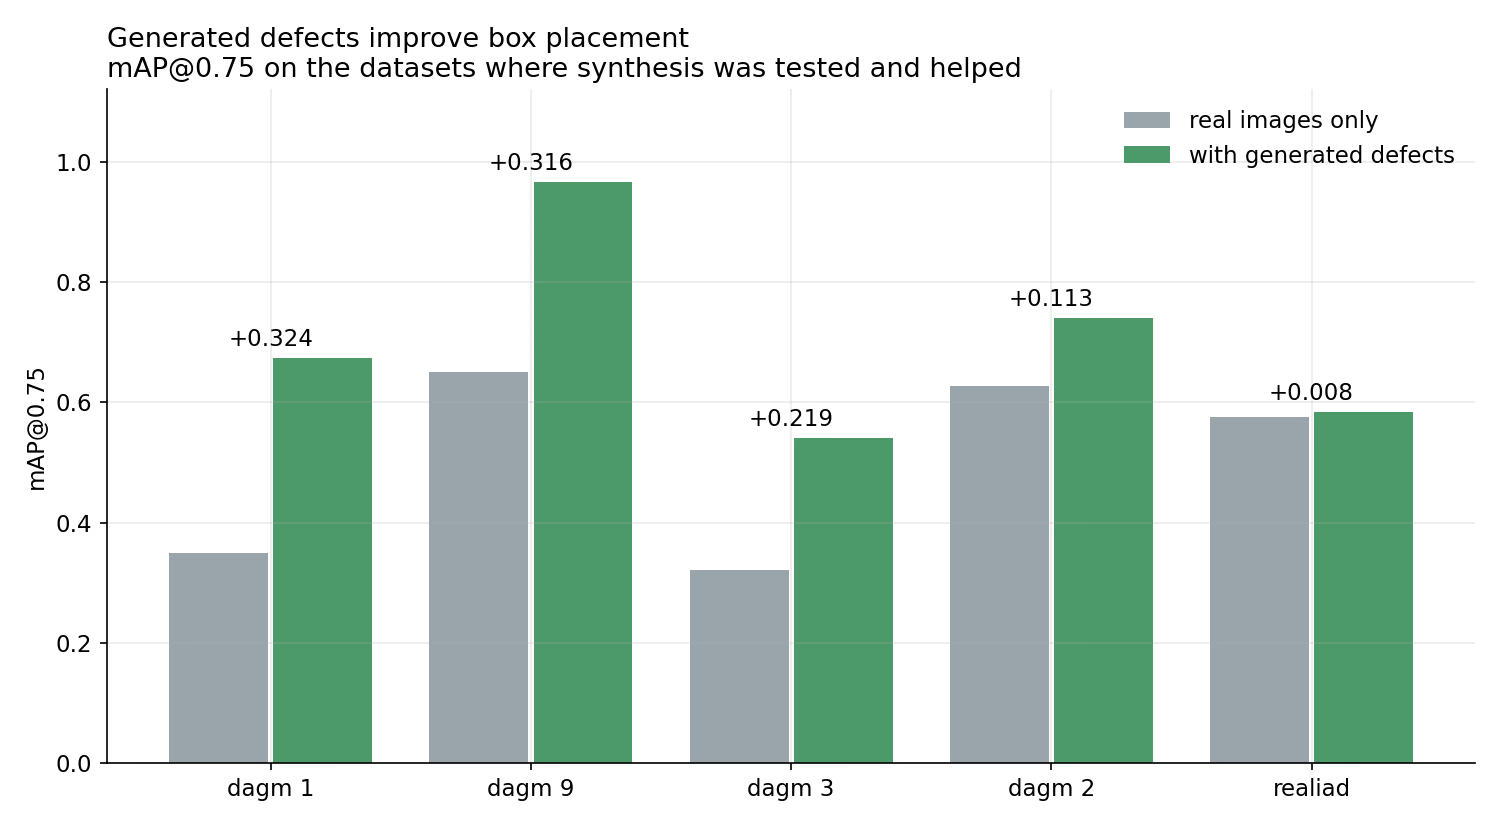
그림 2. 합성 데이터 생성 테스트를 거쳐 효과가 확인된 데이터셋에서 실제 이미지만 사용한 경우와 생성된 결함을 추가한 경우의 mAP@0.75입니다.
세 번째 테스트에서는 합성 데이터의 효과만 따로 살펴봤습니다. 폴리곤 주석이 있는 데이터셋에 Cosmos Data Factory로 생성하고 AnomalyGen이 라벨을 지정한 결함을 추가한 다음, 그 결과로 학습한 Ultralytics YOLO 모델을 실제 이미지만으로 학습한 모델과 비교했습니다.
mAP@0.75는 mAP@0.5보다 엄격한 지표입니다. 예측 바운딩 박스가 실제 결함과 최소 75% 겹치는 경우에만 정답으로 판정합니다. 이 지표는 모델이 결함을 찾았는지만이 아니라 얼마나 정밀하게 위치를 파악하는지를 측정합니다. 생성된 결함을 추가하자 DAGM 클래스의 mAP@0.75가 0.11~0.32 상승했고, 테스트한 모든 데이터셋에서 재현율이 개선되었습니다. 가장 큰 상승 폭은 DAGM 클래스 9로, 0.650에서 0.966으로 향상되었습니다. Real-IAD의 향상 폭은 미미했습니다(+0.008).
결함은 본질적으로 드물기 때문에 특정 유형의 실제 사례는 언제나 부족합니다. 이미 라벨이 지정된 결함을 생성하면 누군가 폴리곤을 직접 그리지 않아도 Ultralytics YOLO가 결함의 정확한 형태와 범위를 학습할 수 있습니다.
투입된 합성 데이터의 양#
각 생성 과정은 세 단계로 진행됩니다. 먼저 Cosmos Data Factory가 실제 이미지에서 가능성 있는 결함 위치를 찾습니다(배치됨). 생성기가 해당 위치에 결함 이미지를 그린 다음(생성됨), 설정한 한도에 따라 일부 이미지만 학습 세트에 포함됩니다(유지됨). 두 가지 한도를 테스트했습니다. 학습 세트의 실제 이미지 수 대비 합성 이미지 수를 25% 또는 100%로 설정했습니다.
총 18회의 생성 라운드(베이스라인 9회, 합성 데이터 9회)에서 파이프라인은 이미지 11,448개를 생성했습니다. 이 중 1,481개, 약 8분의 1만 유지되었습니다. 따라서 각 Ultralytics YOLO 모델에 제공되는 합성 데이터의 양은 생성기의 출력이 아니라 한도에 따라 결정되었습니다. 한도를 100%로 설정하면 각 학습 세트에는 실제 이미지 한 장당 합성 이미지 한 장이 포함되었고, 25%에서는 실제 이미지 4장당 합성 이미지 약 한 장이 포함되었습니다. 절대적인 양은 적습니다. DAGM의 경우 실제 이미지 90~180장에 최대 같은 수의 합성 이미지가 추가되었습니다.
| 데이터셋 | 한도 | 배치됨 | 생성됨 | 차단됨 | 유지됨 | 실제 | 비율 |
|---|---|---|---|---|---|---|---|
| DAGM 클래스 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| DAGM 클래스 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| DAGM 클래스 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| DAGM 클래스 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| DAGM 클래스 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| DAGM 클래스 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| DAGM 클래스 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| 합계 | 11,448 | 0 | 1,481 |
표 2. 각 실행의 생성 및 학습 데이터 포함 기록에 따른 생성 이미지 수와 실제 이미지 대 합성 이미지 비율입니다.
검사 모델을 개발하는 팀에 주는 의미#
이미 Ultralytics YOLO를 학습하는 팀은 Cosmos Data Factory와 NVIDIA가 지원하는 자동화된 에이전트형 학습을 기존 워크플로에 적용할 수 있습니다. 익숙한 모델과 학습 설정은 그대로 사용하면서 더 적합한 데이터를 투입하면 됩니다.
• 수집할 수 없는 엣지 케이스를 보완합니다. 자동으로 라벨링된 합성 결함을 활용하면 실제 사례가 부족한 상황에서도 Ultralytics YOLO가 결함 위치를 파악할 수 있습니다.
• 라벨링 예산을 중요한 곳에 사용합니다. 테스트한 데이터셋의 절반 이상에서 대부분의 라벨은 중복된 정보였습니다. 타깃 데이터 선택을 통해 중요한 이미지를 찾을 수 있습니다.
• 더 빠르게 반복합니다. 더 작고 큐레이션된 학습 세트를 사용하면 Ultralytics YOLO의 학습 실행 시간이 줄어들고 다양한 데이터셋에서 더 빠르게 실험할 수 있습니다.
이용 가능 여부#
Cosmos 기반 합성 데이터 생성 단계는 현재 샘플 및 데모로 제공되며, 아직 정식 통합 기능으로 출시되지는 않았습니다.
Cosmos Data Factory를 자체 Ultralytics YOLO 모델과 함께 사용해 보려면 Ultralytics 팀에 문의하세요. 합성 데이터 생성 단계가 완전한 통합 기능으로 발전하는 동안 NVIDIA와의 협력을 이어갈 예정입니다.
부록: 테스트 설정 및 데이터셋#
모든 실행에서 Ultralytics YOLO26x, 100 에폭, 베이스라인과 Cosmos Data Factory에 동일한 옵티마이저, 학습률 및 시드를 사용했습니다. 8-GPU 호스트 한 대에서 실행하고 데이터셋마다 동일한 홀드아웃 테스트 세트로 평가했습니다. 폴리곤 주석이 있는 11개 데이터셋에는 생성된 결함을 사용할 수 있습니다.
| 데이터셋 | 학습 이미지 | 주석 | 출처 |
|---|---|---|---|
| DAGM 클래스 1, 2, 3, 4 | 각 1,035개 | 폴리곤 | DAGM 2007 |
| DAGM 클래스 7, 8, 9, 10 | 각 2,070개 | 폴리곤 | DAGM 2007 |
| pcb-defect | 20,924 | 박스 | PCB 결함 |
| dspcbsd | 6,575 | 박스 | DsPCBSD+ |
| deeppcb | 1,000 | 박스 | DeepPCB |
| hripcb | 559 | 박스 | HRIPCB |
| 금속 표면 결함 | 11,845 | 박스 | NEU 표면 결함 |
| tianchifabric | 10,332 | 박스 | Tianchi 직물 |
| severstal | 10,061 | 폴리곤 | Severstal 강철 |
| mvtec-ad | 4,637 | 박스 | MVTec AD |
| visa | 7,794 | 폴리곤 | VisA |
| realiad-bottle-cap | 3,581 | 폴리곤 | Real-IAD |
| crack | 1,290 | 박스 | crack segmentation |
표 3. 19개 데이터셋(DAGM은 클래스별로 하나씩, 총 8개로 계산).









