정밀도와 재현율을 활용해 자동 주석용 VLM을 선택하는 방법
정밀도와 재현율을 기준으로 자동 주석용 VLM을 선택하는 방법: 어떤 모델이 불필요한 박스를 더 적게 생성하고, 어떤 모델이 객체를 더 적게 놓치는지, 그리고 자체 데이터로 테스트하는 방법을 알아봅니다.
 Sergiu Waxmann14 분 읽기
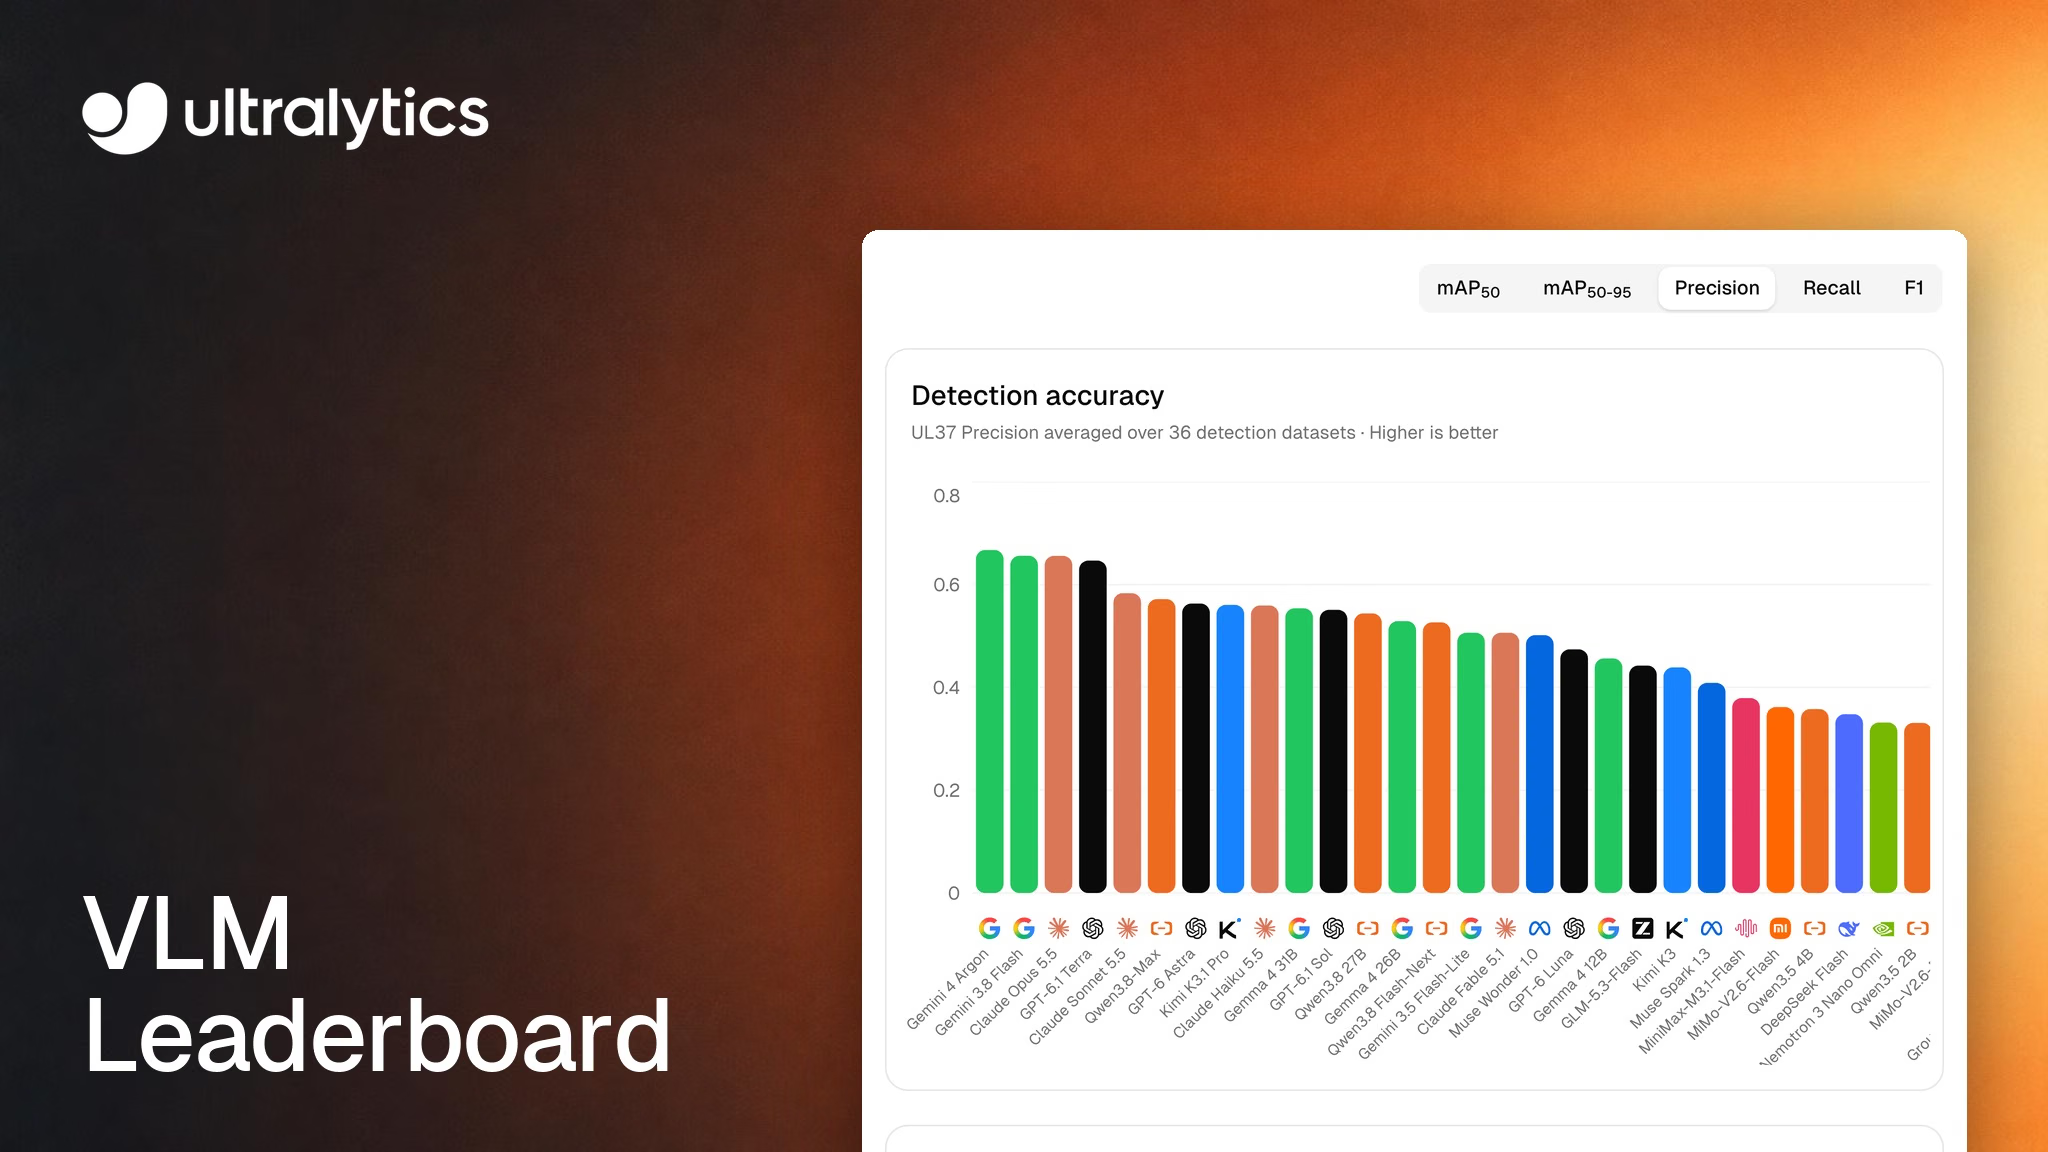
데이터셋에 자동으로 주석을 달 모델을 고를 때는 검토자가 어떤 정리 작업을 선호하는지가 관건입니다. 추가된 박스를 삭제하는 작업인지, 모델이 놓친 객체를 추가하는 작업인지 말입니다. Ultralytics VLM Leaderboard에는 이제 2026년 10월 28일에 발표된 벤치마크 결과를 바탕으로 모든 모델의 정밀도(모델이 예측한 박스 중 올바른 박스의 비율)와 재현율(라벨이 지정된 객체 중 모델이 찾아낸 비율)을 통해 이러한 절충 관계가 표시됩니다.
가장 깔끔한 초안을 원한다면 Gemini 4 Argon으로 시작하세요. 놓치는 객체를 최소화하려면 GPT-6 Astra로 시작하세요. 가장 높은 점수를 받은 6개 모델 중 비용이 가장 저렴하면서 균형도 가장 좋은 모델을 원한다면 GPT-6.1 Terra를 선택하세요. 자체 AI 공급자 API 키가 없다면 호스팅형 Qwen3.8 27B로 시작하거나, 객체가 밀집된 장면에서 검토자가 불필요한 박스를 정리하는 편을 선호한다면 SAM 3.1 Text로 시작하세요.
이 가이드에서는 수치를 해석하는 방법, 각 모델이 적합한 용도, 자체 이미지에서 모델 선택을 확인하는 방법을 설명합니다. 순위와 가격은 실행할 때마다 달라지므로, 여기에 제시된 수치는 2026년 10월 기준 예시로 보고 최신 결과는 리더보드에서 확인하세요.
클래스 프롬프트 기반 모델에는 신뢰도 슬라이더가 없으므로, 모델 선택이 곧 임계값 설정입니다.#
주석 편집기에서 Ultralytics YOLO 모델을 사용하면 직접 절충 관계를 조정할 수 있습니다. 신뢰도 임계값을 높이면 오탐 박스와 누락이 모두 줄어들고, 낮추면 그 반대가 됩니다. 클래스 프롬프트 기반 비전 언어 모델(VLMs)은 다르게 작동합니다. 주석 편집기 문서에 설명된 것처럼, 클래스 프롬프트 기반 VLM은 모델별 임계값으로 데이터셋의 클래스를 감지하고 신뢰도 점수를 반환하지 않습니다. 따라서 Ultralytics Platform에서는 해당 모델을 선택한 동안 신뢰도 및 IoU 설정이 숨겨집니다.
이에 따라 리더보드의 정밀도와 재현율이 의미하는 바가 달라집니다. 벤치마크 방법론에 따르면, 정밀도와 재현율은 모델이 반환한 모든 박스를 IoU 0.5에서 집계하며, 숨겨진 작동 지점은 없습니다. 이 지표는 검토자가 실제로 받게 되는 박스를 나타냅니다.
리더보드의 기반이 되는 벤치마크는 UL37 v2입니다. Platform의 실제 객체 감지 데이터셋 36개에서 각각 이미지 10개를 사용하고, COCO 2017 참조 이미지 10개는 별도로 점수를 산출하여 총 370개 이미지와 7,268개 박스를 평가합니다. 각 이미지는 데이터셋 고유의 클래스 이름을 사용해 Smart 및 Batch Annotation과 동일한 프로덕션 파이프라인을 거치며, SAM 3.1은 SAM 3을 제외한 모든 모델의 박스를 보정합니다. 점수 산출에는 YOLO 모델을 검증하는 코드인 Ultralytics 패키지 자체의 객체 감지 지표를 사용하며, 평균을 계산할 때 각 데이터셋에 동일한 가중치를 적용합니다.
정밀도는 매칭되지 않은 박스를, 재현율은 매칭되지 않은 객체를 추적합니다.#
정밀도는 IoU 0.5에서 올바른 클래스의 라벨 객체와 일치하는 모델 박스의 비율입니다. 재현율은 모델이 일치시킨 라벨 객체의 비율입니다. 검토 작업의 관점에서 보면 다음과 같습니다.
- 정밀도가 낮으면 일치할 때까지 삭제하거나 라벨을 다시 지정하거나 크기를 조정해야 하는 박스가 많다는 뜻입니다.
- 재현율이 낮으면 박스를 추가하거나 크기를 조정하거나 라벨을 다시 지정해야 하는 라벨 객체가 많다는 뜻입니다.
- F1은 두 지표의 조화 평균인 2 x P x R / (P + R)이며, 두 지표를 하나의 수치로 요약합니다. 검토에 걸리는 시간은 측정하지 않습니다.
- mAP50 및 mAP50-95는 클래스별 평균 정밀도를 기준으로 모델의 순위를 매깁니다. IoU 0.5에서, 그리고 0.50부터 0.95까지의 더 엄격한 임계값에서 평균 정밀도를 계산합니다. 리더보드는 mAP50 순으로 정렬됩니다.
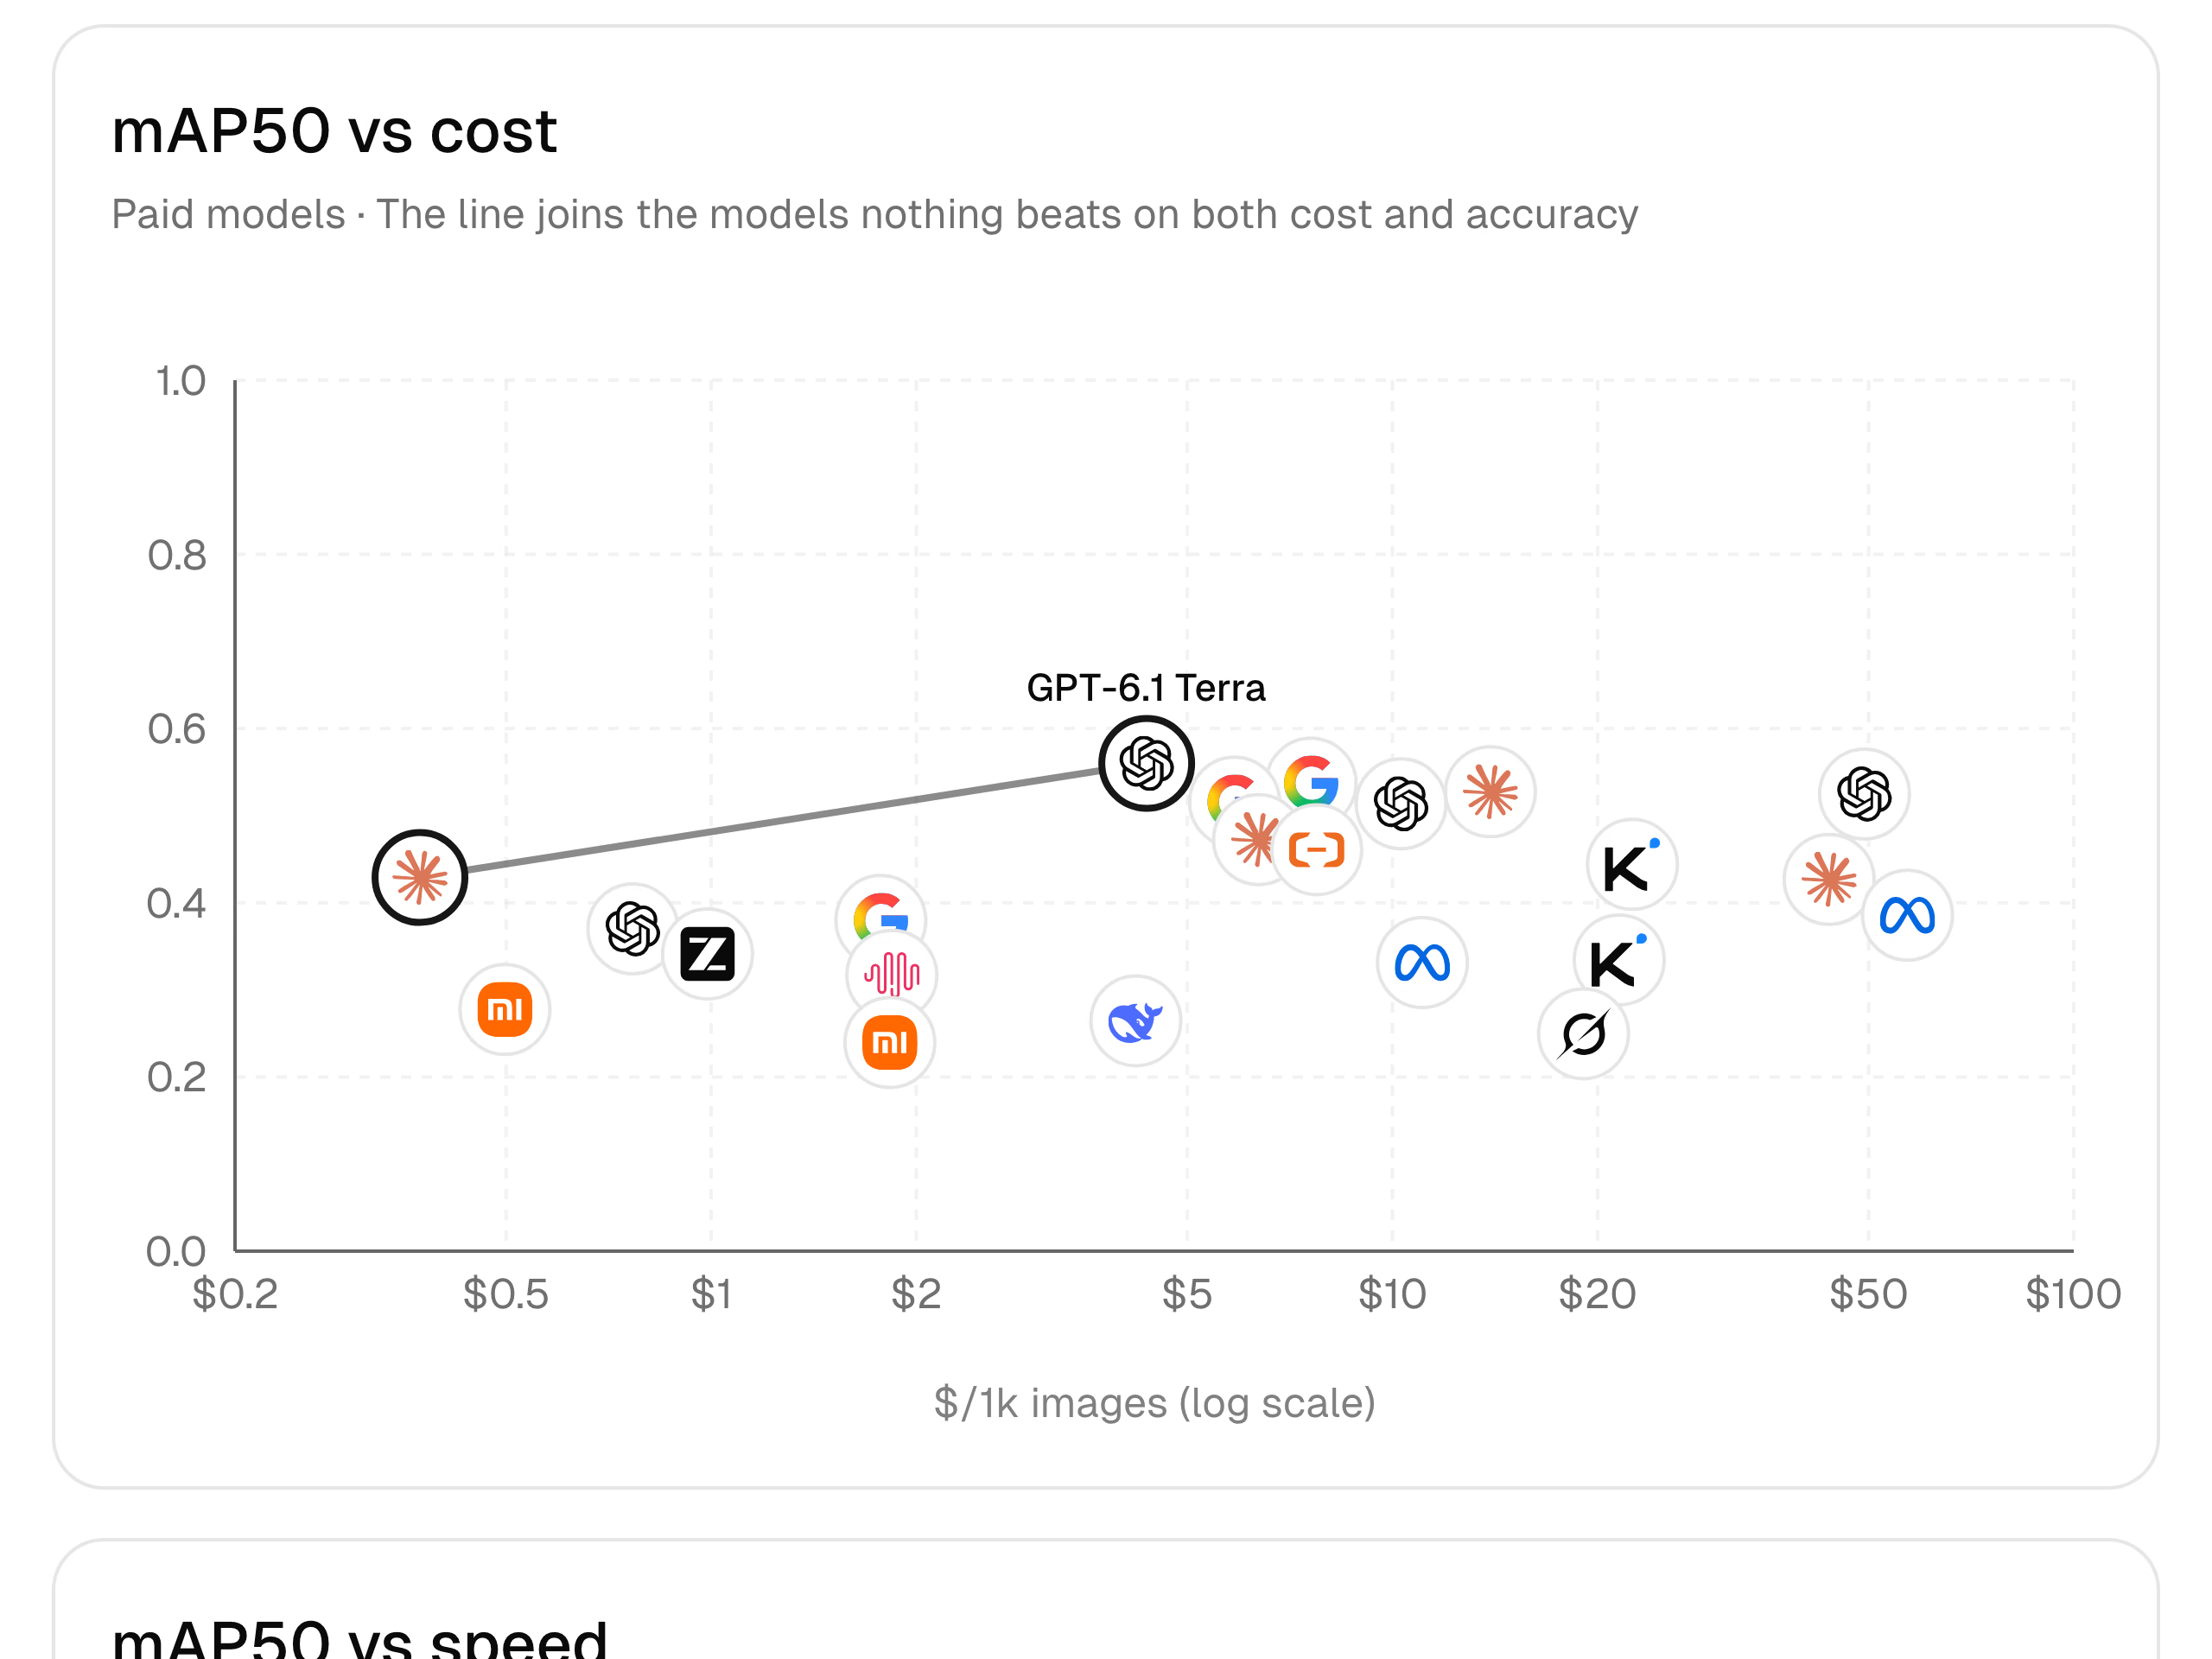
다음은 mAP50 점수가 0.51을 넘는 6개 모델입니다. 비용은 성공적으로 주석 처리된 벤치마크 이미지 1,000개당 공급자가 보고한 토큰 사용량을 기준으로 추정했으며, 지연 시간은 요청 시간의 중앙값입니다.
| 모델 | mAP50 | mAP50-95 | 정밀도 | 재현율 | F1 | 공급자 비용 / 이미지 1,000개(벤치마크 사용량 기준) | 지연 시간 |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*Gemini 4 Argon의 추정 비용은 2026년 11월 30일까지 적용되는 Google의 출시 기념 요금을 기준으로 합니다. 12월 1일부터 Google의 표준 요금은 두 배로 올라 동일한 사용량 기준 이미지 1,000개당 약 $15가 됩니다. Ultralytics Platform의 Batch Annotation을 사용하면 호스팅 모델을 포함한 모든 모델에 처리 이미지 1,000개당 $1.00의 비용이 추가됩니다.
6개 모델은 두 그룹으로 나뉩니다. Argon, Opus 5.5 및 Gemini 3.8 Flash는 정밀도 0.66~0.67, 재현율 0.60 미만입니다. 즉, 이 모델들의 박스 중 높은 비율이 일치하지만 라벨이 지정된 객체 중 일치시키는 비율은 더 낮습니다. Astra와 Sol은 정밀도 0.55~0.56, 재현율 0.62~0.63입니다. 즉, 라벨이 지정된 객체 중 더 높은 비율을 일치시키지만, 이 모델들의 박스 중 일치하는 비율은 더 낮습니다. Terra는 두 그룹의 중간에 있으며 mAP50과 F1에서 앞섭니다.
불필요한 박스를 수정하는 비용이 큰 경우 정밀도를 우선하세요.#
Gemini 4 Argon은 0.667로 벤치마크의 40개 모델 가운데 전체 정밀도가 가장 높습니다. 절충점은 평균 재현율이 0.585로, 재현율이 가장 높은 모델들보다 낮다는 것입니다.
매칭되지 않은 박스를 찾기 어려울 때는 정밀도가 가장 중요합니다. 객체가 빽빽한 이미지에서는 검토자가 잘못된 박스를 수정하기 전에 여러 개의 올바른 박스 사이에서 잘못된 박스를 찾아야 합니다. SKU110K의 빽빽한 소매점 진열대 이미지에서는 이런 이미지에서 정밀도 차이가 얼마나 커질 수 있는지 확인할 수 있습니다. GPT-6.1 Terra 결과에서 Terra는 해당 데이터셋에서 정밀도 0.79와 재현율 0.73을 기록한 반면, GPT-6.1 Sol은 각각 0.49와 0.77을 기록했습니다.
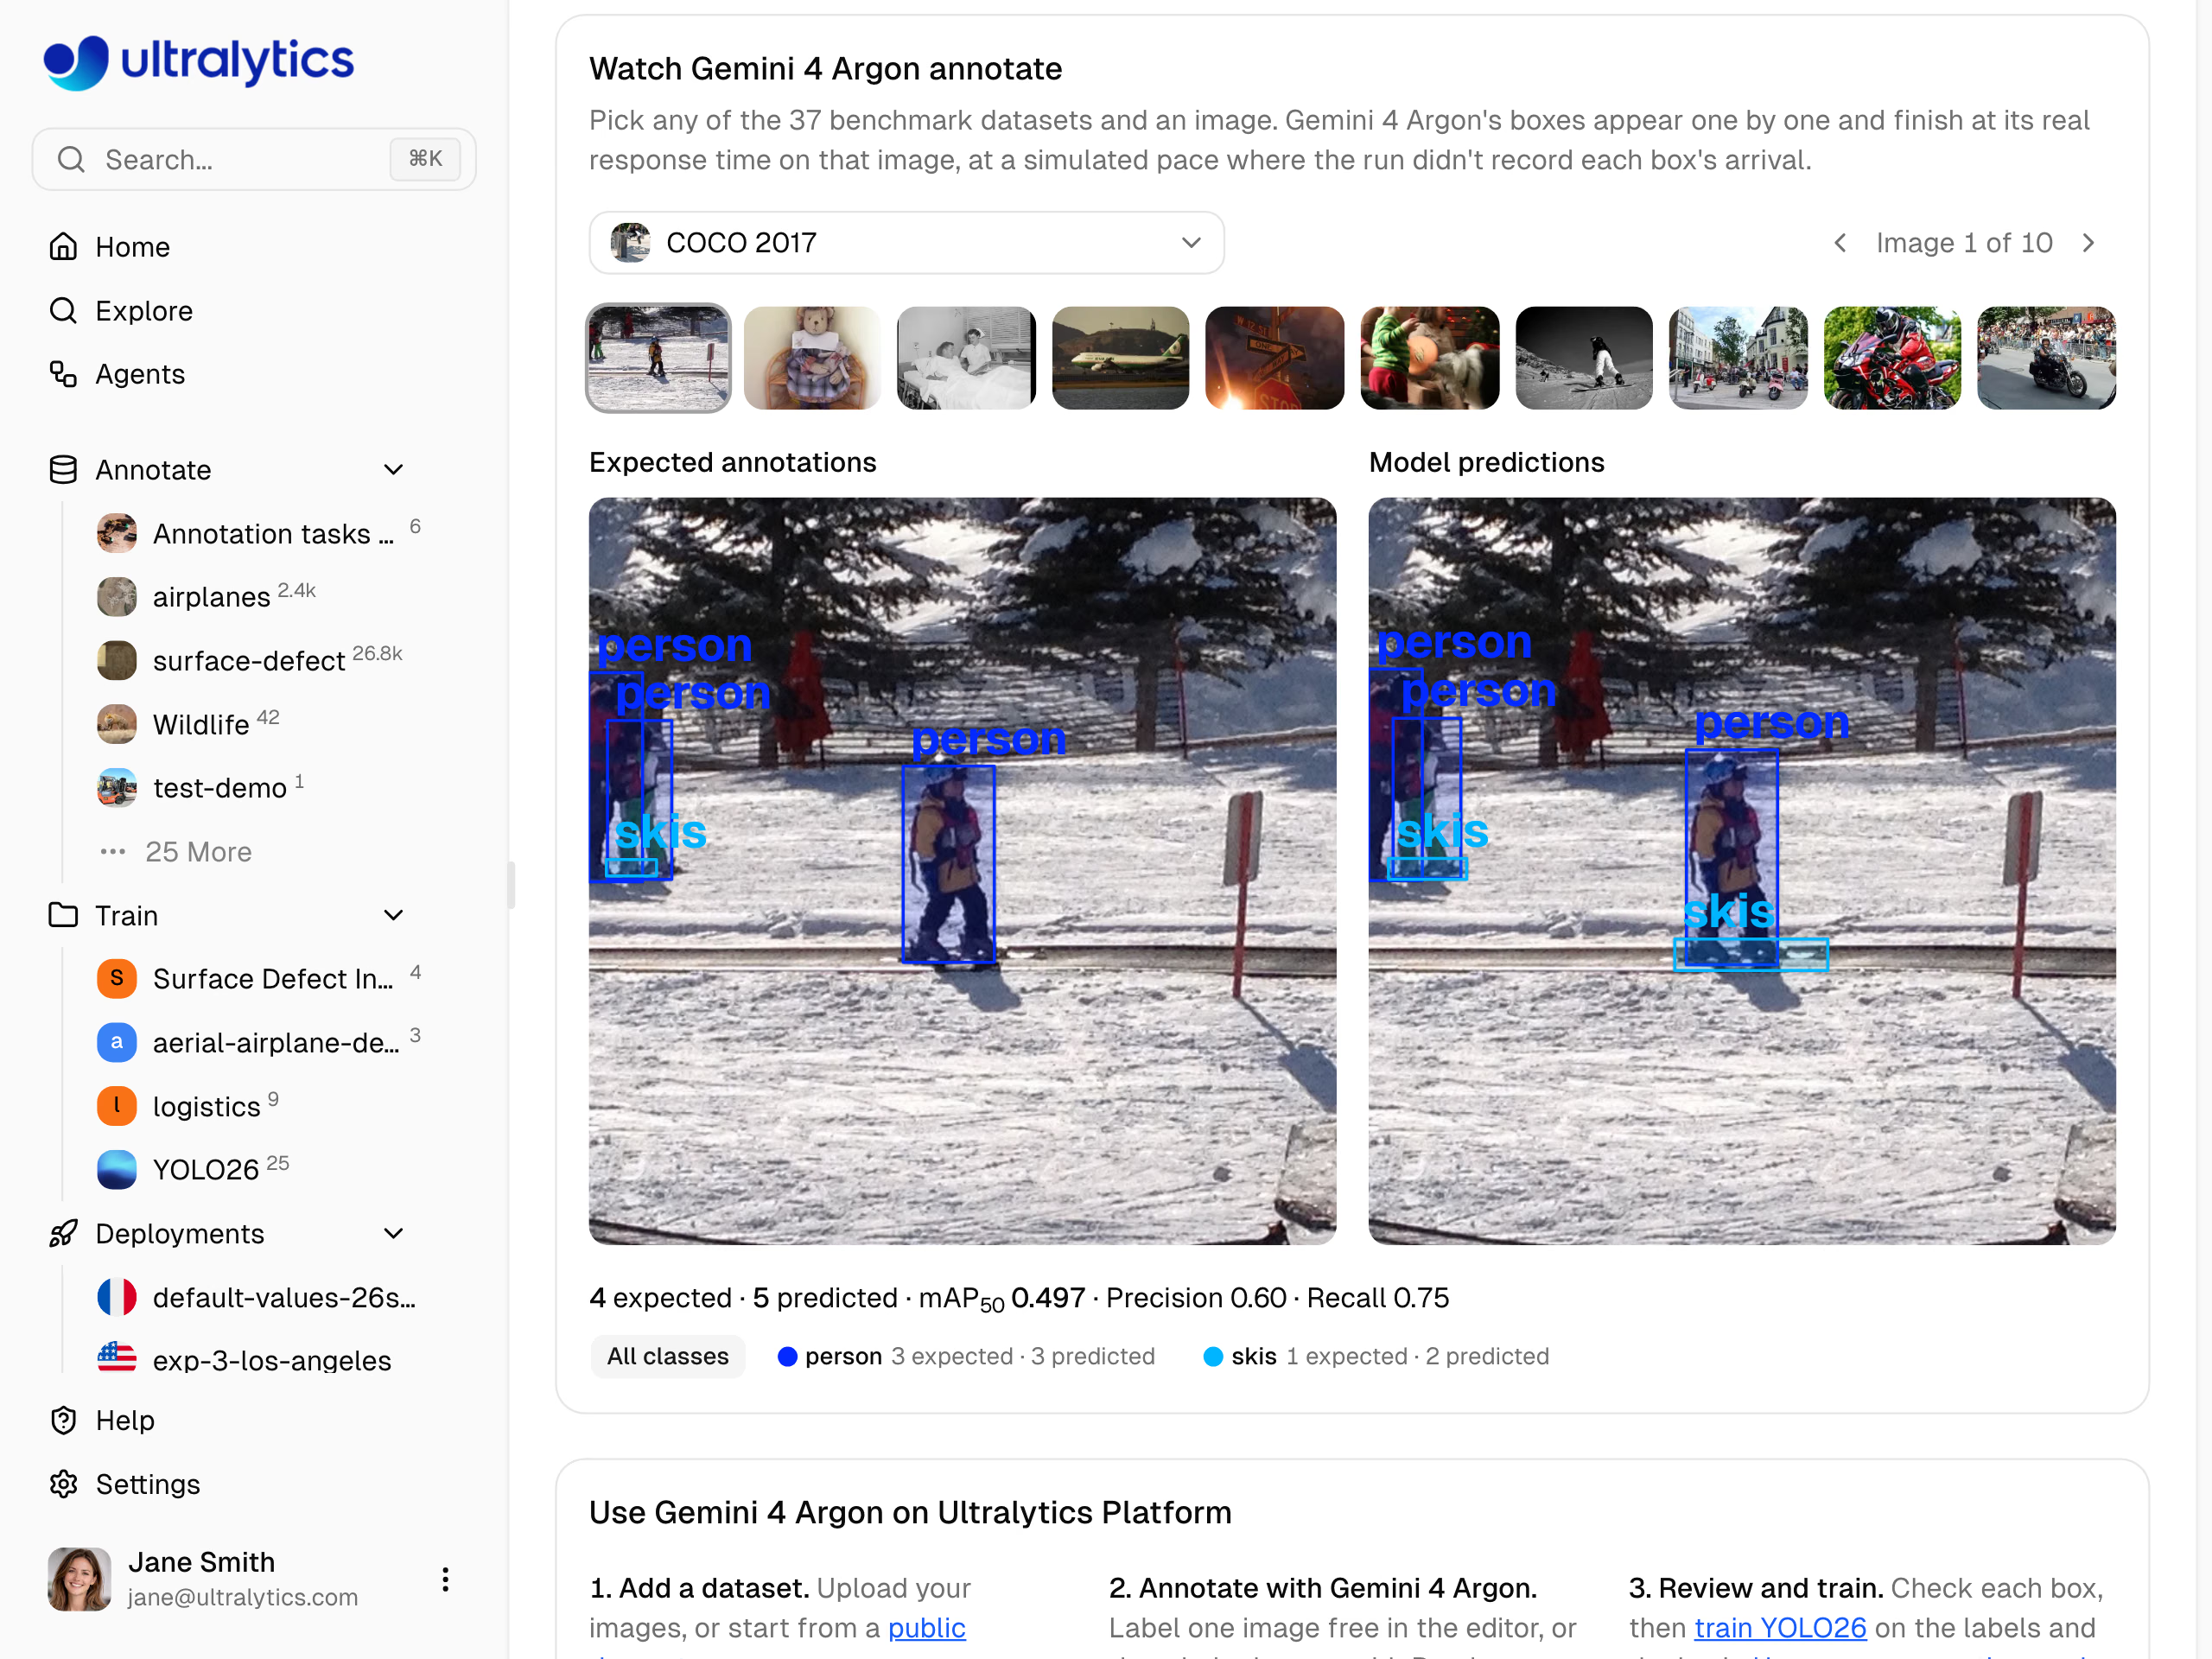
Gemini 4 Argon: 라벨 객체 4개에 대해 박스 5개를 예측했으며, 정밀도는 0.60, 재현율은 0.75입니다.
Argon은 벤치마크에서 실패한 요청이 없었으며, 중앙값 4.6초로 상위 두 모델 중 가장 빠릅니다. 데이터가 Argon이 우수한 성능을 보인 도메인, 즉 항공, 수중, 열화상 및 보안 X선 이미지와 유사한 경우(IEDXray 보안 스캔에서 mAP50 0.298로 최고 성능) 이를 선택하고, 팀에서 불필요한 박스를 찾아내기보다 누락된 객체 몇 개를 추가하는 작업을 선호하는 경우에도 선택하세요.
객체 누락으로 인한 오류의 비용이 큰 경우 재현율을 우선하세요.#
GPT-6 Astra는 0.627로 전체 재현율이 가장 높습니다. 그 대가로 정밀도는 0.56입니다.
라벨링에서 재현율을 우선하는 것은 객체를 라벨링하지 않는 오류가 더 큰 비용을 초래할 때 합리적입니다. 학습 데이터셋에서 결함이나 병변을 놓치면 검출기는 해당 객체를 배경으로 학습하며, 누락된 박스를 찾으려면 표시되지 않은 객체를 찾아 모든 이미지를 살펴봐야 합니다. Astra는 TBX11K 흉부 X선(0.330), GRAZPEDWRI-DX 소아 손목 X선(0.354), DsPCBSD+ PCB 표면 결함(0.394)을 포함해 36개 데이터셋 중 7개에서 최고 mAP50을 기록했으므로, 유사한 데이터로 테스트해 볼 근거는 되지만 여러분의 데이터에서 객체를 덜 놓친다는 증거는 아닙니다.
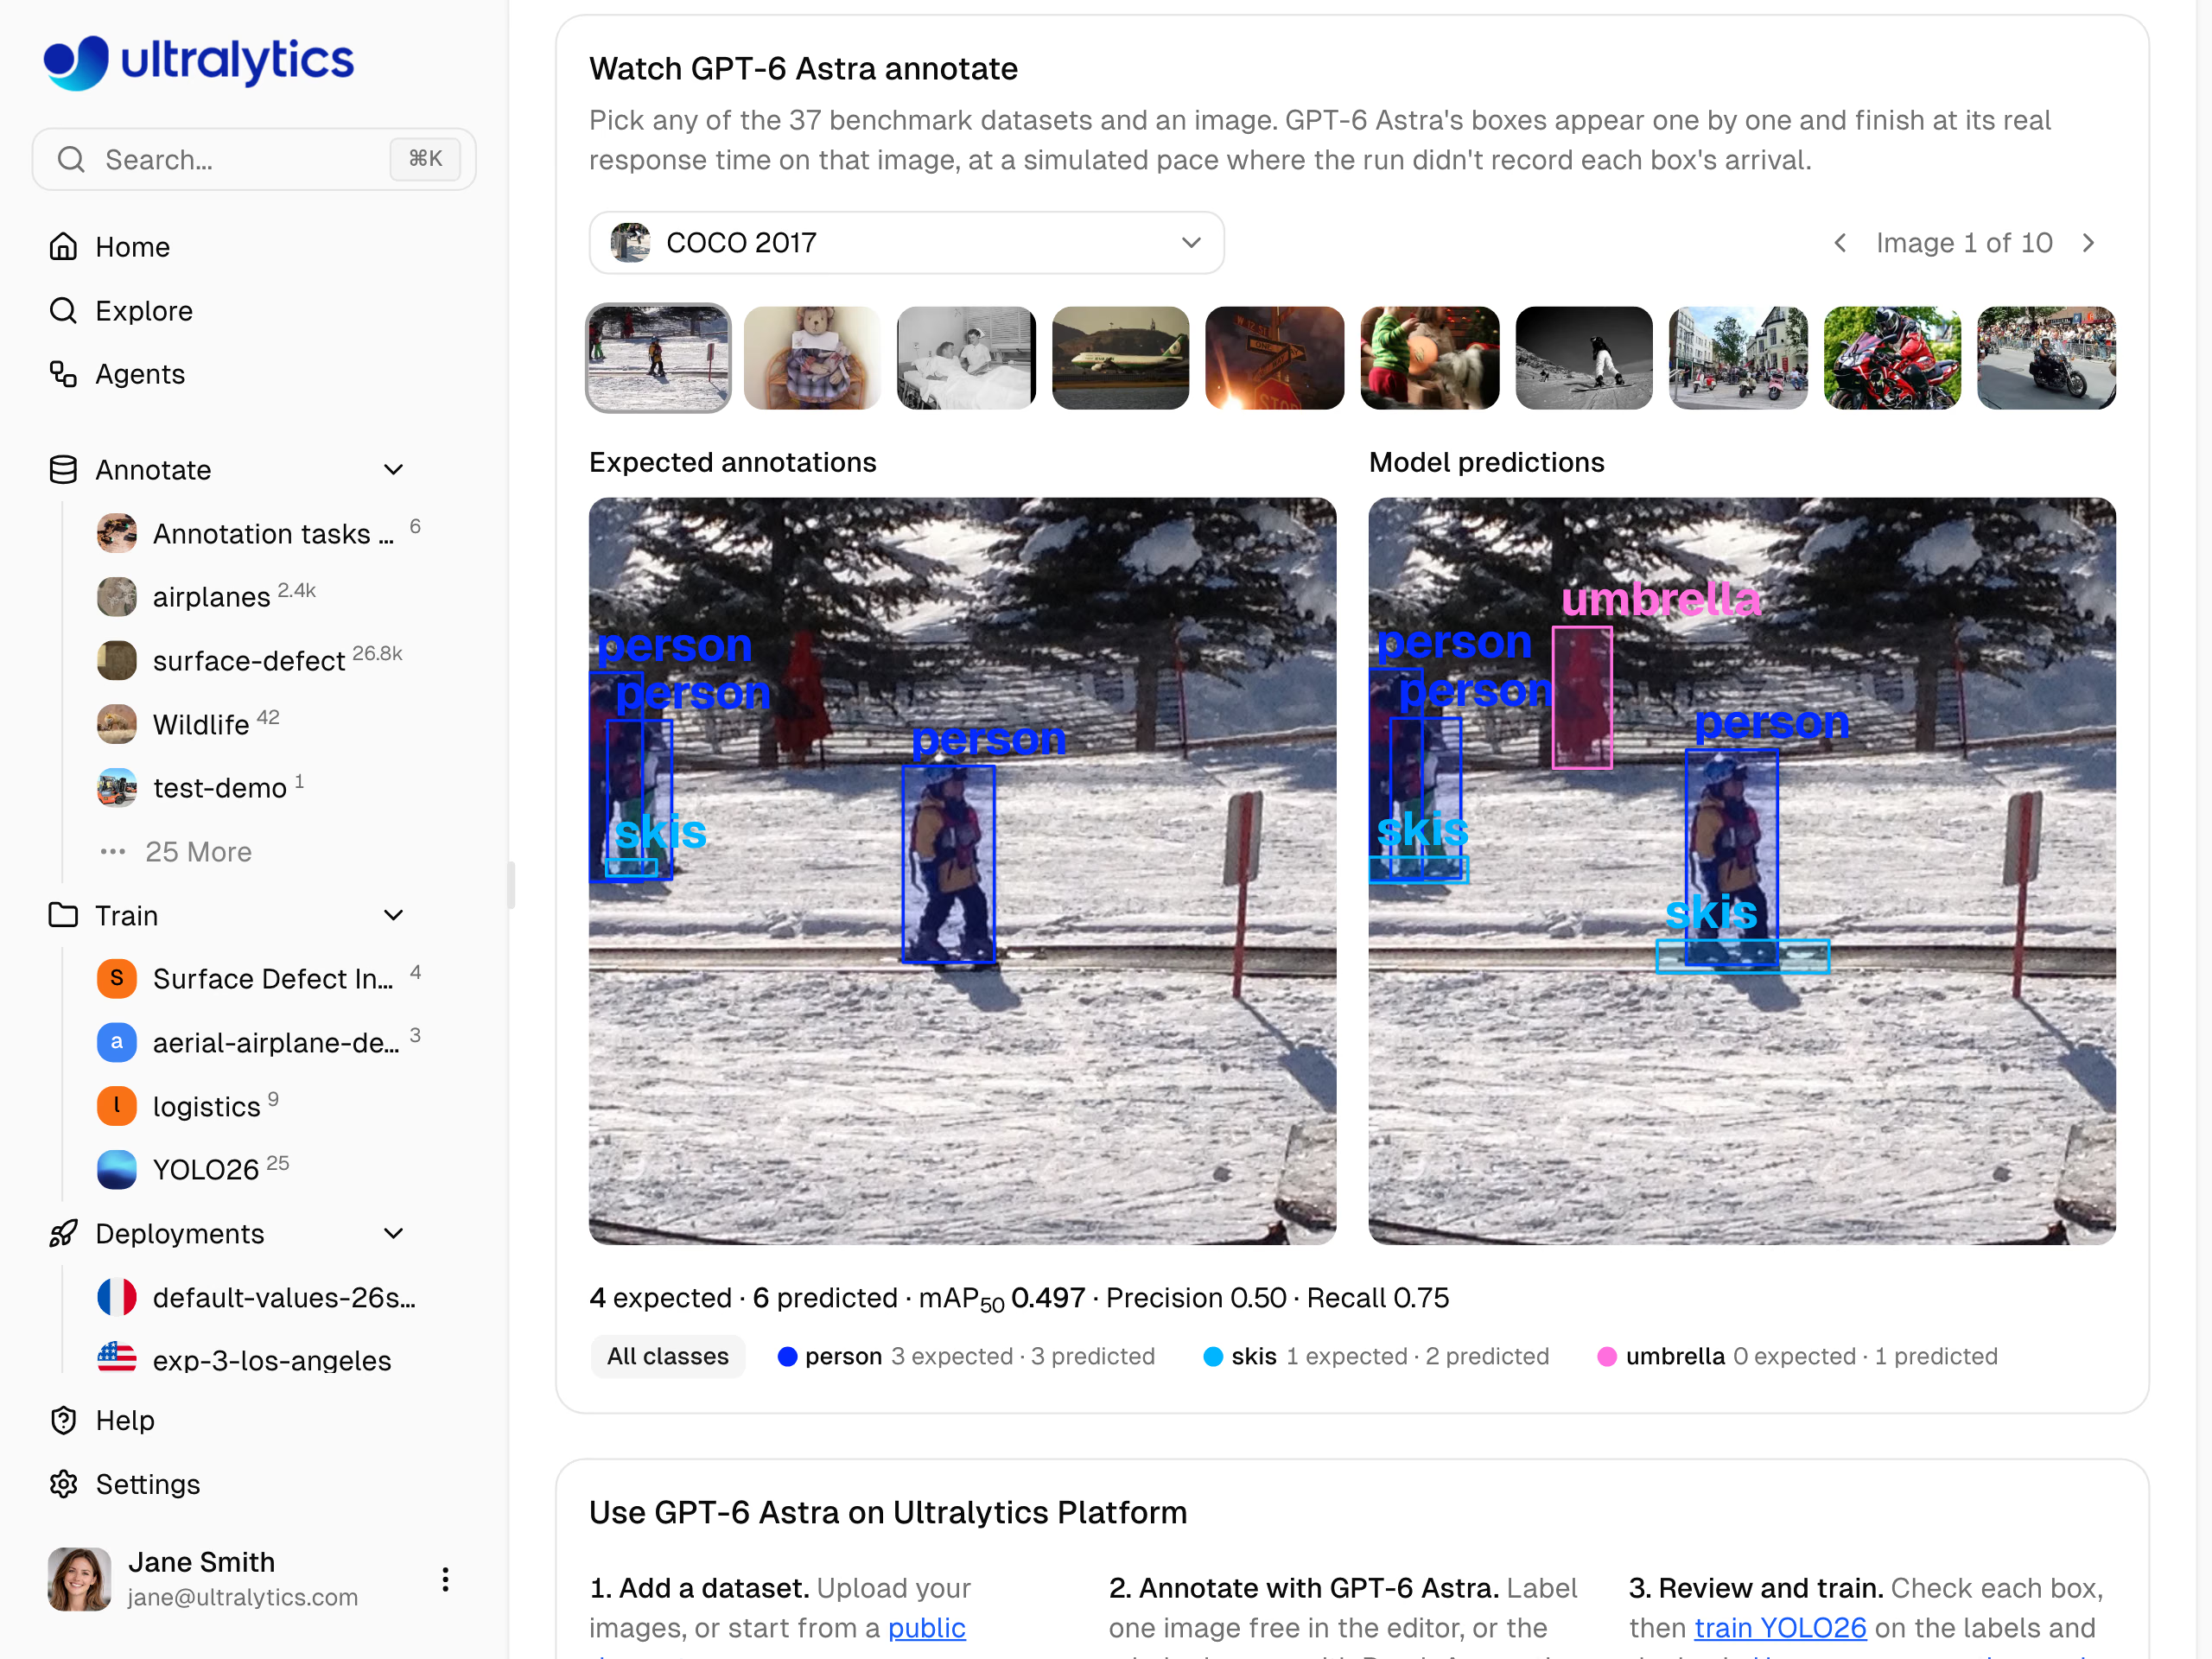
GPT-6 Astra: 동일한 객체 4개에 박스 6개를 표시했으며, COCO 라벨에서 빠진 우산도 포함합니다. 정밀도는 0.50, 재현율은 0.75입니다.
Astra는 상위 6개 모델 중 비용 추정치가 가장 높아 이미지 1,000개당 $49.31이며, 중앙값은 11.6초이고 이미지의 1%에서 요청이 실패했습니다. 다른 두 OpenAI 모델도 재현율이 비슷합니다. GPT-6.1 Sol은 0.62이며 비용은 $10.30으로 추정되고, GPT-6.1 Terra는 0.61이며 비용은 $4.36으로 추정됩니다.
mAP50-95와 F1로 두 가지 오류를 함께 고려하세요.#
GPT-6.1 Terra는 mAP50 0.560과 mAP50-95 0.345로 전체 1위를 차지합니다. 정밀도 0.646과 재현율 0.613은 각각 선두 모델과 불과 몇 백분의 일 차이이며, F1 0.63은 0.62를 기록한 Argon과 Opus 5.5를 근소한 차이로 앞서 6개 모델 중 가장 높습니다. F1 차이가 이 정도로 작고 F1으로 검토 시간을 알 수 없으므로, 도메인별 결과와 자체 이미지 테스트를 통해 모델을 선택하세요.
mAP50-95에서 앞선다는 점은 추가적인 근거가 됩니다. mAP50-95는 겹침 임계값을 최대 0.95까지 평균하므로, 올바른 객체를 찾는 모델뿐 아니라 매칭된 박스가 객체에 정확히 맞는 모델에도 높은 점수를 줍니다. Terra는 이 지표에서도 1위입니다. 또한 상위 6개 모델 중 비용 추정치가 가장 낮고 요청 실패도 없었으며, 리더보드에서 "가성비 최고"로 표시됩니다.
공급자 키 없이 라벨링하기: 호스팅 모델과 개방형 어휘 검출기#
모든 팀이 유료 공급자 키를 원하는 것은 아닙니다. Platform의 호스팅 모델은 공급자 키 없이 실행되며, 각 열은 다른 양상을 보여줍니다.
- SAM 3.1 Text: mAP50 0.332, 정밀도 0.19, 재현율 0.47, 이미지당 0.2초입니다. VisDrone에서 0.479 mAP50으로 40개 모델 중 가장 높은 점수를 기록했으며, Fisheye8K 교통 데이터에서도 0.478을 기록했습니다.
- Qwen3.8 27B: mAP50 0.351, 정밀도 0.54, 재현율 0.40, 1.5초입니다.
- Gemma 4 26B: mAP50 0.344, 정밀도 0.53, 재현율 0.39, 0.9초입니다.
개방형 어휘 검출기도 호스팅 방식으로 제공됩니다. 이 벤치마크에서 OWLv2 Large는 mAP50 0.133, Grounding DINO Base는 0.104를 기록했으며, 두 모델 모두 이미지당 0.2초가 걸렸습니다. SAM 3.1 Text는 0.332를 기록했습니다. 이 점수는 각 모델의 원래 설정이 아닌, SAM 3.1 박스 보정을 적용한 Platform의 클래스 프롬프트 기반 파이프라인을 측정합니다.
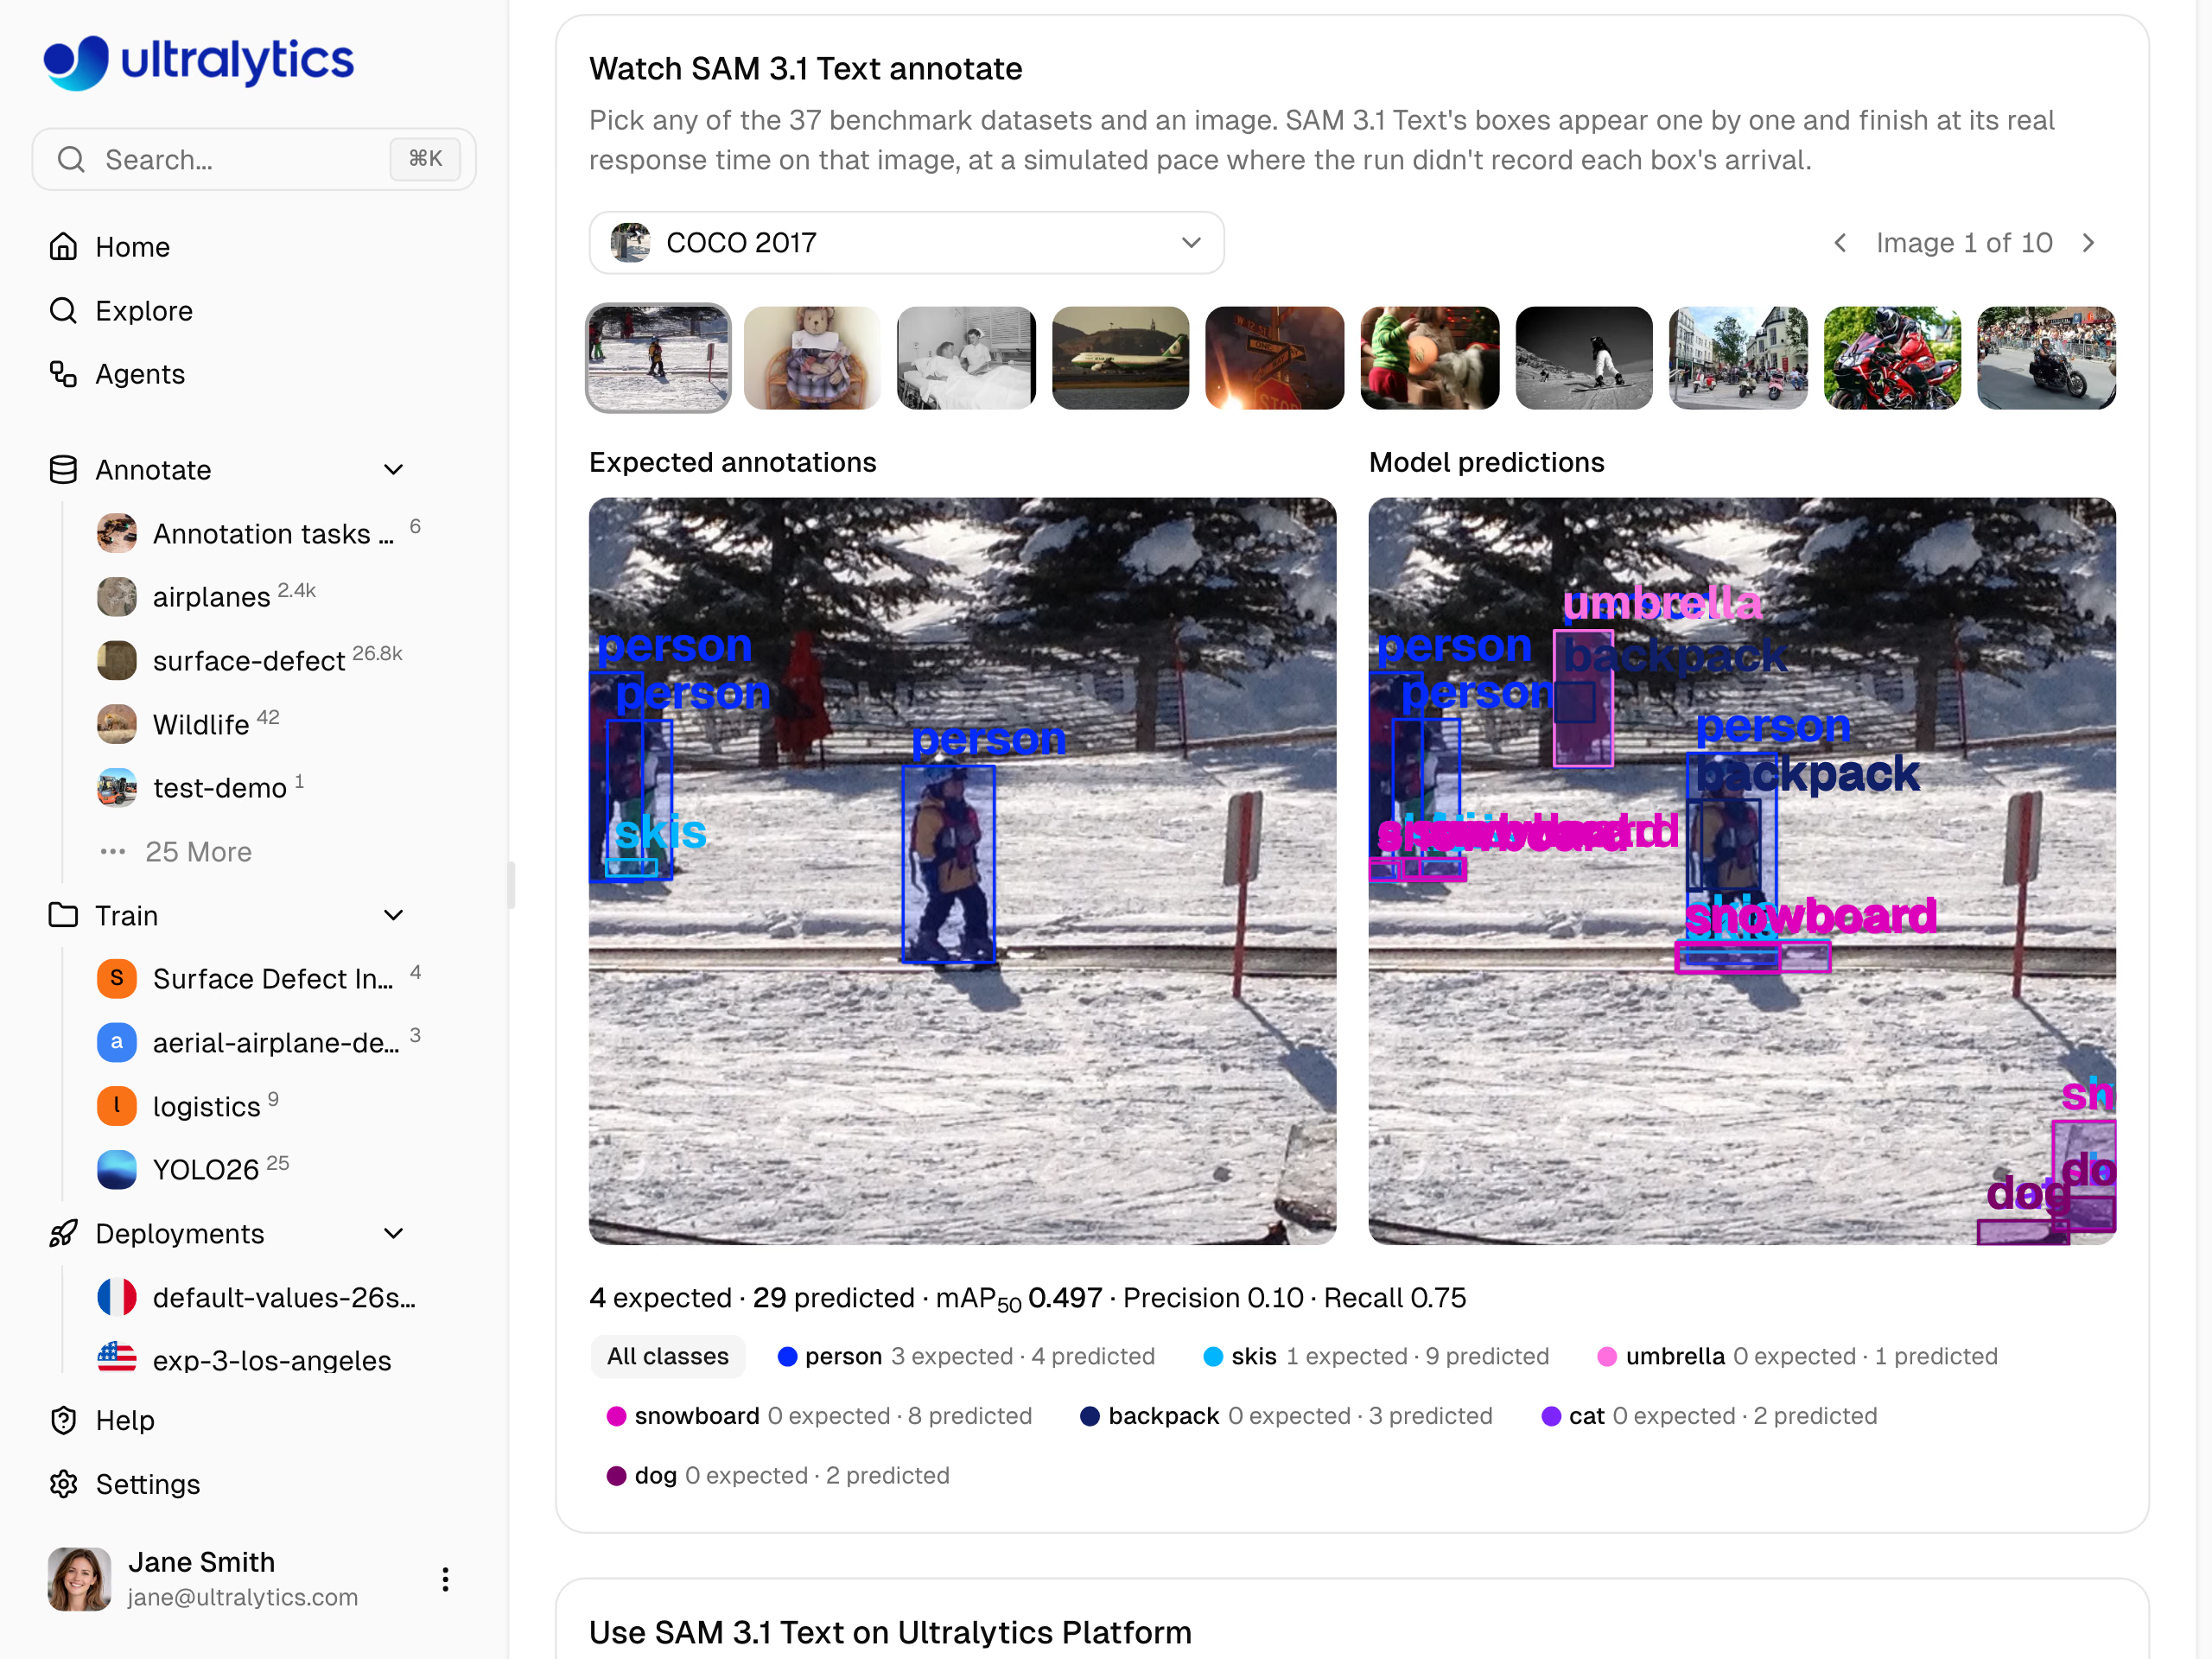
SAM 3.1 Text: 객체 4개에 박스 29개를 생성했으며, 정밀도는 0.10, 재현율은 0.75입니다. 세 모델 모두 객체 4개 중 3개를 찾았습니다. 차이는 검토자가 삭제해야 하는 추가 박스의 수입니다.
SAM 3.1 Text는 검토자가 넉넉한 초안을 정리할 것으로 예상되는 복잡한 항공 및 교통 장면에 적합합니다. Qwen3.8 27B와 Gemma 4 26B는 정확도가 더 낮지만 신중한 그룹과 비슷한 양상을 보입니다. 저비용 유료 모델 중에서는 Claude Haiku 5.5가 mAP50 0.429, 정밀도 0.56, 재현율 0.47을 기록하며, 이미지 1,000개당 비용은 $0.37로 추정됩니다. 이 모델 역시 리더보드에서 "가성비 최고"로 표시됩니다.
전체 평균은 데이터 도메인의 특성을 가리므로 데이터셋 표를 확인하세요.#
각 모델의 정밀도와 재현율은 36개 데이터셋의 평균이며, 자체 데이터는 그중 하나의 도메인에 해당합니다. VLM 리더보드의 데이터셋 표에는 40개 모델 전체의 데이터셋별 평균 정밀도와 재현율이 어려운 순서대로 나열되어 있고, 각 데이터셋에서 가장 높은 점수를 기록한 모델도 표시됩니다.
주의 신호를 확인하세요. 이미지 10개에 라벨이 지정된 탱크 2,267개가 있는 Airbus Oil Storage Detection에서 모델 평균 정밀도는 0.39, 재현율은 0.11이며, mAP50 최고 기록은 Gemini 4 Argon의 0.347입니다. DeepPCB에서는 평균 정밀도와 재현율이 각각 0.03과 0.04이며, GPT-6.1 Sol이 mAP50 0.393으로 두드러집니다.
이 수치는 판정 결과가 아니라 후보 목록으로 활용하세요. 방법론에 따르면 데이터셋당 이미지 10개는 모델과 도메인의 순위를 매기기에는 충분하지만, 단일 데이터셋 점수를 확정하기에는 부족하며 반복 실행 시 개별 수치는 몇 퍼센트포인트씩 달라집니다. Platform의 각 모델 페이지에서는 벤치마크 데이터셋 및 COCO에서 해당 모델이 기록한 박스와 정답 박스를 나란히 재생하므로, 실행을 시작하기 전에 자체 데이터와 가장 유사한 데이터셋을 살펴볼 수 있습니다.
5단계로 모델을 검토 워크플로에 맞추세요.#
먼저 선택 우선순위를 정한 다음, 자체 이미지로 선택을 확인하세요.
| 우선순위 | 후보 모델(2026년 10월 결과) |
|---|---|
| 정밀도 우선 | Gemini 4 Argon |
| 재현율 우선 | GPT-6 Astra 또는 GPT-6.1 Sol |
| 두 지표 모두 고려 | GPT-6.1 Terra |
| 공급자 키 없음 | 호스팅형: Qwen3.8 27B 또는 SAM 3.1 Text |
클래스 프롬프트 기반 주석은 클래스가 1~200개인 객체 감지 데이터셋에서 사용할 수 있습니다.
- 리더보드에서 후보를 추리세요. 객체 감지용 VLM 리더보드에서 유료 또는 호스팅형 모델을 필터링하고(플랫폼 미지원으로 표시된 모델은 제외), 우선순위에 맞는 열을 확인한 다음 해당 도메인의 데이터셋 표를 살펴보세요.
- 공급자 키를 추가하세요. 유료 모델을 사용하려면 데이터셋을 소유한 워크스페이스의 설정 > API 키에 키를 저장하세요. 공급자가 해당 키로 직접 요금을 청구합니다. 설정 방법은 공급자 키 문서를 참조하세요.
- 검토한 샘플로 테스트하세요. 자체 데이터를 대표하며 직접 라벨링한 이미지 몇 개를 선택하세요. 주석 편집기를 열고 Smart 모드로 전환한 뒤, 모델 선택기에서 공급자 아래에 있는 모델을 선택하고 Predict를 누르세요(
P). 삭제한 박스 수, 추가한 박스 수, 검토에 걸린 시간을 기록하세요. - 데이터셋에 라벨을 지정하세요. 데이터셋 페이지에서 추가 작업 > Batch Annotation을 선택하세요. 이미지 채널이 최대 3개인 Platform 호스팅 데이터셋에서 사용할 수 있습니다. 기본 설정에서는 라벨이 없는 이미지에 라벨을 지정하고, 기존 라벨은 변경하지 않으며, 롤백할 수 있도록 먼저 데이터셋 버전을 저장합니다. 시작하기 전에 대화 상자에서 예상 비용을 확인하세요. Batch Annotation 비용은 처리 이미지 1,000개당 $1.00이며, 공급자 요금은 별도로 부과됩니다.
- 검토한 다음 학습하세요. 모델의 취약점을 고려해 박스를 확인하고 저장한 다음, 같은 워크스페이스에서 결과를 사용해 Ultralytics YOLO 모델을 학습하세요.
배경 정보는 Ultralytics Platform에서 AI를 사용해 주석 작업을 자동화하는 방법과 휴먼 인 더 루프 검토가 계속 필요한 이유를 참조하세요. 여러 도구에서 자동 라벨링과 액티브 러닝이 어떻게 비교되는지 알아보려면 자동 라벨링과 액티브 러닝 비교를 읽어보세요.
팀별 후보 모델(2026년 10월 결과)#
- 초안을 정리하기보다 완성하는 편을 선호하는 검토자: 전체 정밀도가 가장 높은 Gemini 4 Argon은 항공, 수중, 열화상 및 보안 X선 데이터에서 특히 강점을 보입니다.
- 누락되면 학습 데이터에 악영향을 주는 희귀 객체: 재현율을 최대로 높이려면 GPT-6 Astra를, 그에 가까운 성능을 원한다면 GPT-6.1 Sol을 선택하세요.
- 특별히 선호하는 지표가 없는 범용 라벨링: mAP50, mAP50-95 및 F1에서 1위인 GPT-6.1 Terra를 선택하세요.
- 공급자 키가 없는 팀: 복잡한 장면에서 재현율 중심의 첫 번째 라벨링을 원한다면 SAM 3.1 Text를, 더 신중한 초안을 원한다면 Qwen3.8 27B를 선택하세요.
어떤 모델을 선택하든 리더보드를 활용하면 검토를 시작하기 전에 필요한 작업을 예상할 수 있습니다. 이러한 지표의 이론적 배경은 정확도, 정밀도 및 재현율 가이드에서 기본 내용을 확인하고, Academy 강의인 객체 감지 지표 읽기에서 더 자세히 알아보세요.
자주 묻는 질문
잘못된 박스를 삭제하는 작업이 더 오래 걸리는 경우 정밀도를 우선하세요. 예를 들어 객체가 많은 이미지에서는 잘못된 박스가 올바른 박스 사이에 섞여 보이지 않을 수 있습니다. 희귀 결함이나 병변처럼 객체를 놓치는 비용이 더 큰 경우에는 재현율을 우선하세요. 라벨이 없는 객체는 검출기에 해당 객체가 배경이라고 학습시키기 때문입니다. 그런 다음 직접 검토한 자체 이미지 샘플로 선택을 확인하세요.
클래스 프롬프트 기반 모델은 신뢰도 점수 없이 박스를 반환하고 모델별 임계값을 사용하므로, Platform에서는 모델을 선택한 동안 신뢰도 및 IoU 설정이 숨겨집니다. 따라서 리더보드의 정밀도와 재현율은 모델이 IoU 0.5에서 반환한 모든 박스를 집계합니다. 매칭되지 않은 박스와 매칭되지 않은 객체 간의 균형을 조정하려면 다른 모델을 선택해야 합니다.
모델이 올바른 객체를 찾아 라벨링하는지 확인하려면 mAP50을 사용하고, 박스가 객체에 정확히 맞을수록 높은 점수를 주는 더 엄격한 겹침 임계값까지 반영하려면 mAP50-95를 사용하세요. 두 지표 모두 누락과 오탐도 반영하므로 정밀도 및 재현율과 함께 확인하세요. 2026년 10월 결과에서는 GPT-6.1 Terra가 각각 0.560과 0.345로 두 지표 모두에서 앞섭니다.
예. UL37 v2에서 최고 모델의 평균 mAP50은 0.560(2026년 10월 기준)이며, PCB 결함과 흉부 X선처럼 가장 어려운 데이터셋에서는 40개 모델의 평균이 0.05 미만입니다. 모든 이미지를 검토하고 모델의 취약점을 특히 주의 깊게 살펴보세요. 재현율을 우선하는 모델은 추가 박스를, 정밀도를 우선하는 모델은 누락된 객체를 확인해야 합니다.
비용은 두 부분으로 나뉩니다. Ultralytics Platform의 Batch Annotation은 호스팅 모델을 포함한 모든 모델에 대해 처리 이미지 1,000개당 $1.00(최소 $0.01)이며, 편집기에서 호스팅 모델을 사용한 단일 예측은 무료입니다. 유료 공급자 모델은 사용자의 API 키를 통해 공급자가 별도로 청구합니다. 2026년 10월 벤치마크에서 이 가이드에 나온 모델의 공급자 비용 추정치는 이미지 1,000개당 Claude Haiku 5.5의 $0.37부터 GPT-6 Astra의 $49.31까지였습니다. 실행을 중지하면 이미 처리된 이미지에 대한 비용이 청구됩니다.
예. SAM 3.1 Text, Qwen3.8 27B 및 Gemma 4 26B와 같은 호스팅 모델은 공급자 키 없이 Ultralytics Platform에서 실행할 수 있으며, 자체 YOLO 모델도 마찬가지입니다. 배치 실행 비용은 처리 이미지 1,000개당 $1.00이며, 실행을 시작할 때마다 대화 상자에 예상 비용이 표시됩니다.
작업에 따라 다릅니다. 클래스 프롬프트 기반 VLM은 클래스 이름만으로 새로운 클래스의 라벨 초안을 만들 수 있지만, 2026년 10월 벤치마크에서 점수가 가장 높은 6개 모델은 이미지당 2.7~11.6초가 걸리고 토큰 단위로 비용이 청구됩니다. 실시간 감지의 경우 VLM으로 자동 주석을 생성하고 라벨을 검토한 다음, 이를 사용해 Ultralytics YOLO 모델을 학습하는 방식이 일반적입니다. 이미 학습한 YOLO 모델로 같은 편집기에서 새 이미지에 자동 주석을 생성할 수도 있습니다.
작성자
댓글2
질문하거나 결과를 공유하거나 다른 사람을 도와주세요.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









