Ultralytics YOLO e NVIDIA Cosmos Data Factory: dados sintéticos para deteção de defeitos
Dados sintéticos da NVIDIA Cosmos Data Factory e um ciclo automatizado de treino agentivo, enriquecido com dados e desenvolvido pela NVIDIA, ajudam o Ultralytics YOLO a alcançar a precisão obtida com todo o conjunto de dados usando apenas uma fração das anotações.
A Ultralytics e a NVIDIA estabeleceram uma parceria para demonstrar o que os dados de treino direcionados podem fazer pelo Ultralytics YOLO. O ciclo de treino agentivo e enriquecido com dados da NVIDIA identifica as imagens de que um modelo precisa, a NVIDIA Cosmos Data Factory gera as que ainda não existem e o Ultralytics YOLO é o modelo treinado com o resultado. A nossa equipa de aprendizagem automática (ML) avaliou esta combinação em 19 benchmarks públicos de inspeção industrial, comparando o Ultralytics YOLO26 treinado com o pipeline agentivo da NVIDIA e dados sintéticos da Cosmos Data Factory com o mesmo modelo treinado da forma convencional. Esta publicação apresenta os resultados.
Mais dados não são a resposta. Os dados certos são.#
Todas as equipas de inspeção conhecem este padrão. Um modelo de deteção de defeitos tem um bom desempenho nos defeitos que já viu muitas vezes, mas depois não deteta o raro risco, a iluminação invulgar ou o ângulo estranho da câmara que mais importa na linha de produção. A solução habitual é recolher e anotar mais dados de tudo, o que é lento, dispendioso e, na maior parte dos casos, apenas acrescenta imagens que o modelo já trata bem.
O treino agentivo automatizado desenvolvido pela NVIDIA segue uma abordagem diferente: identifica os pontos fracos específicos de um conjunto de dados e corrige-os com imagens reais que já existem ou com imagens sintéticas da Cosmos Data Factory quando não há exemplos reais. Em conjunto com o Ultralytics YOLO, isto significa que o modelo é treinado precisamente com os dados que lhe faltam.
Como funciona o ciclo de treino enriquecido com dados da NVIDIA?#
O ciclo de treino agentivo e enriquecido com dados da NVIDIA para o Ultralytics YOLO é um pipeline de melhoria de modelos que envolve o ciclo de treino e decide de que dados o modelo precisa a seguir:
• Procura dados reais. Pesquisa conjuntos de imagens existentes para encontrar exemplos reais que preencham lacunas específicas do conjunto de treino.
• Gera dados sintéticos. Quando não existem exemplos reais, gera imagens de casos-limite com a Cosmos Data Factory.
• Anota automaticamente. Um componente chamado AnomalyGen anota as imagens sintéticas, pelo que não é necessária anotação manual antes de voltar a treinar.
A ideia orientadora é privilegiar dados direcionados em vez da eficiência dos dados. O objetivo não é simplesmente treinar com menos dados. É preencher com precisão as lacunas de um conjunto de dados onde o modelo é fraco, procurando ou gerando dados, e voltar a treinar com esse conjunto enriquecido. Treinar com menos imagens é muitas vezes um efeito secundário de fazer isto bem, como mostram os resultados abaixo.
O pipeline foi submetido a benchmarks aprofundados com o Ultralytics YOLO, e todos os resultados deste artigo usam o Ultralytics YOLO26.
O papel da NVIDIA Cosmos Data Factory#
A Cosmos Data Factory é a plataforma da NVIDIA para curadoria, processamento e geração de dados, criada com base nos modelos de mundo Cosmos da NVIDIA. No ciclo de treino agentivo, a sua função é gerar imagens de cenários que um conjunto de dados real não abrange bem, como tipos específicos de defeitos no fabrico ou distorções de lentes olho de peixe em gravações de transportes.
A transferência é simples. A Cosmos gera as imagens de casos-limite, o AnomalyGen anota-as e o Ultralytics YOLO volta a ser treinado com o conjunto combinado de dados reais e sintéticos, usando o pipeline de treino da Ultralytics padrão.
Avaliámos a NVIDIA Cosmos Data Factory em 19 conjuntos de dados públicos#
Para ver até onde a Cosmos Data Factory + Ultralytics YOLO podem chegar, a nossa equipa de ML executou o pipeline de ajuste fino agentivo e enriquecido com dados em 19 conjuntos de dados públicos de inspeção industrial, abrangendo aço, placas de circuito impresso, tecido, superfícies metálicas e produtos de consumo, com cerca de 91.000 imagens de treino no total. Cada execução usou um anfitrião com 8 GPUs.
A comparação é deliberadamente rigorosa. O modelo de referência e o modelo da Cosmos Data Factory foram treinados com uma receita idêntica: Ultralytics YOLO26x, 100 épocas, o mesmo otimizador, taxa de aprendizagem e semente, e ambos foram avaliados no mesmo conjunto de teste reservado. A única diferença está nas imagens usadas para treinar cada modelo. O modelo de referência é treinado com todas as imagens anotadas (e, no teste com dados sintéticos, apenas com imagens reais).
1. A mesma precisão com uma fração das anotações#
Em 11 dos 19 conjuntos de dados, o Ultralytics YOLO26x treinado com o pipeline agentivo igualou o desempenho do mesmo modelo treinado com o conjunto de dados completo. Nesses 11 conjuntos, não foi necessário usar 53% das imagens anotadas.
| conjunto de dados | anotadas | usadas | não necessárias | mAP@0.5 completa | mAP@0.5 selecionada |
|---|---|---|---|---|---|
| dagm classe 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| dagm classe 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| dagm classe 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| dagm classe 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| dagm classe 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| dagm classe 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| dagm classe 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| dagm classe 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
Tabela 1. Conjuntos de dados em que a Cosmos Data Factory igualou o modelo treinado com todos os dados. mAP@0.5 no mesmo conjunto reservado.
Nos conjuntos de dados DAGM, o pipeline agentivo alcançou a mesma mAP@0.5 usando um décimo das anotações e, em duas classes, superou ligeiramente o modelo treinado com todos os dados. Em pcb-defect, descartou 7.000 das 20.924 imagens, com uma diferença de precisão quatro vezes menor do que a variação entre execuções.
Para as equipas que pagam pela anotação, esta é a principal conclusão: a maior parte do orçamento de anotação destes conjuntos de dados foi gasta em imagens que não alteraram o resultado.
2. Treino até 74% mais rápido#
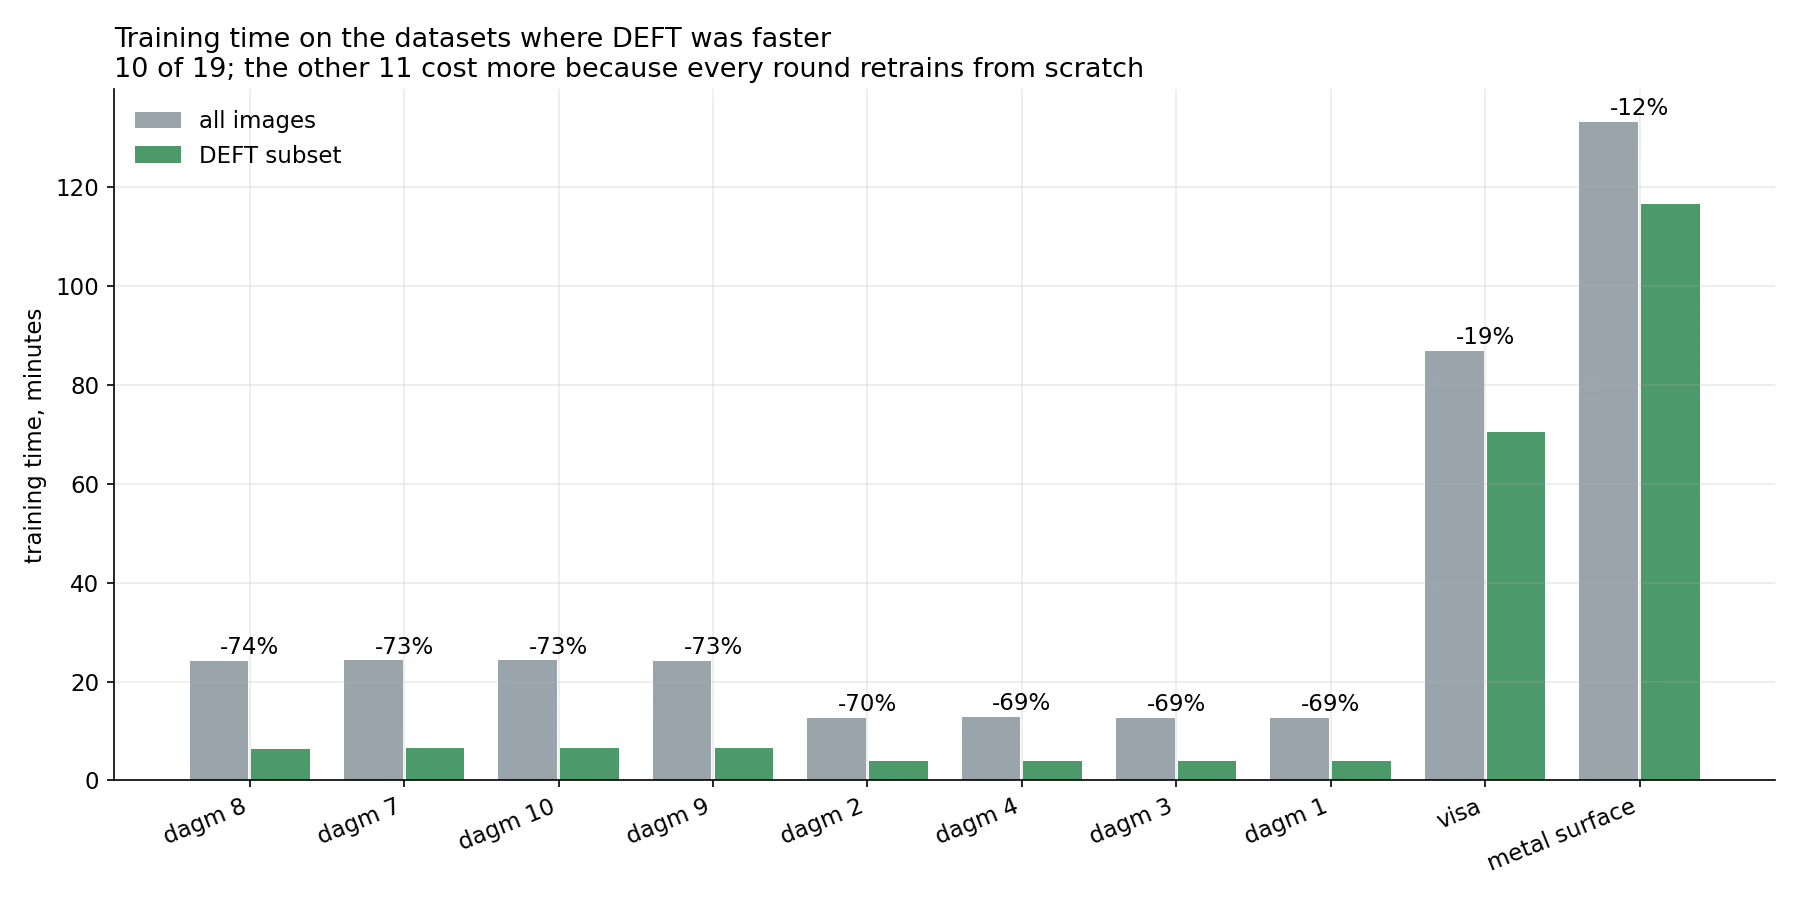
Figura 1. Tempo de treino com o conjunto de dados completo vs. subconjunto da Cosmos Data Factory, nos conjuntos de dados em que a Cosmos Data Factory foi mais rápida.
Treinar o Ultralytics YOLO com um conjunto de dados mais pequeno e direcionado também reduz o custo computacional. Em 10 dos 19 conjuntos de dados, o treino foi mais rápido com o pipeline agentivo. Nos conjuntos DAGM, o tempo de treino passou de 13–24 minutos para 4–7 minutos, uma redução de 69–74%. Os conjuntos de dados maiores também tiveram poupanças menores, mas reais: 19% em VisA e 12% em metal-surface-defect.
A poupança não é universal. Nos outros nove conjuntos de dados, o pipeline agentivo demorou mais do que uma única execução com todos os dados, porque cada ronda de curadoria volta a treinar o modelo desde o início. Quando o subconjunto selecionado não é muito mais pequeno do que o original, essas rondas adicionais anulam a poupança.
3. Os defeitos gerados melhoram a precisão das caixas delimitadoras#
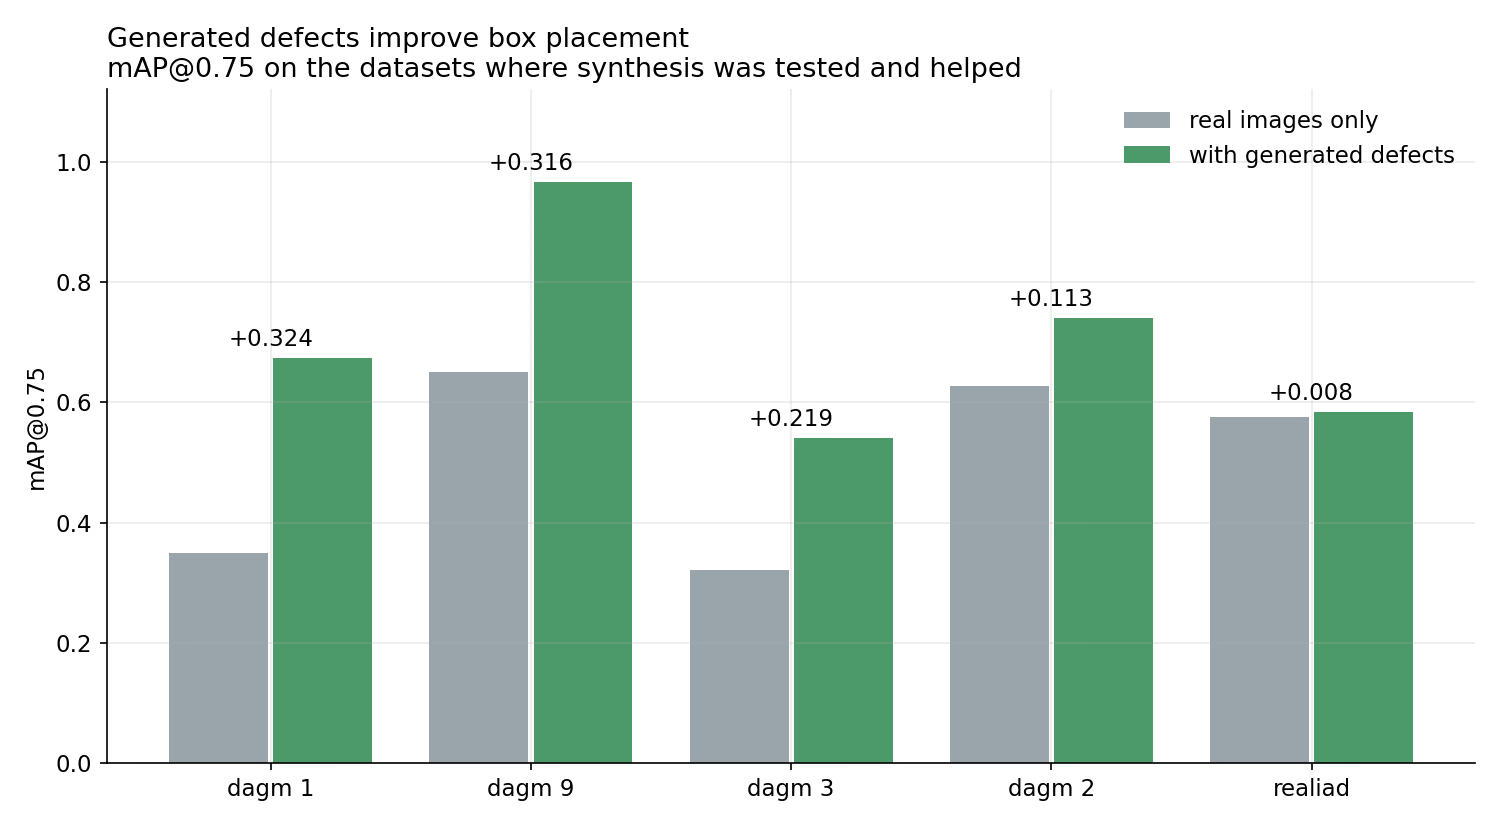
Figura 2. mAP@0.75 apenas com imagens reais vs. com defeitos gerados, nos conjuntos de dados em que a síntese foi testada e produziu melhorias.
O terceiro teste isola os dados sintéticos. Nos conjuntos de dados com anotações poligonais, adicionámos defeitos gerados pela Cosmos Data Factory, anotados pelo AnomalyGen, e comparámos o modelo Ultralytics YOLO resultante com um modelo treinado apenas com imagens reais.
Apresentamos a mAP@0.75, uma métrica mais rigorosa do que a mAP@0.5: uma previsão só conta se a caixa se sobrepuser ao defeito verdadeiro em, pelo menos, 75%. A métrica mede a precisão com que o modelo localiza um defeito, não apenas se o deteta. A adição de defeitos gerados aumentou a mAP@0.75 entre 0.11 e 0.32 nas classes DAGM, e a revocação melhorou em todos os conjuntos de dados testados. O maior aumento ocorreu na classe 9 do DAGM, de 0.650 para 0.966. No Real-IAD, o ganho foi marginal (+0.008).
Os defeitos são raros por natureza, pelo que os exemplos reais de um determinado tipo de defeito são sempre escassos. Gerá-los já anotados permite ao Ultralytics YOLO aprender a forma e a extensão exatas de um defeito sem que ninguém tenha de desenhar um polígono.
Quantidade de dados sintéticos utilizados#
Cada geração decorre em três etapas. Primeiro, a Cosmos Data Factory encontra localizações plausíveis para defeitos nas imagens reais (colocados); o gerador desenha imagens de defeitos nessas localizações (gerados); e apenas até ao limite definido são incluídos no conjunto de treino (mantidos). Testámos dois limites: imagens sintéticas equivalentes a 25% ou 100% das imagens reais no conjunto de treino.
Ao longo de 18 rondas de geração (9 de referência e 9 sintéticas), o pipeline gerou 11.448 imagens. Apenas 1.481 dessas imagens, cerca de uma em cada oito, foram mantidas; assim, o limite determinou a quantidade de dados sintéticos que cada modelo Ultralytics YOLO viu, não a saída do gerador. Com o limite de 100%, cada conjunto de treino continha uma imagem sintética por cada imagem real; com 25%, aproximadamente uma por cada quatro. Em termos absolutos, as quantidades são pequenas: nos conjuntos DAGM, 90–180 imagens reais e, no máximo, o mesmo número de imagens sintéticas.
| conjunto de dados | limite | colocados | gerados | bloqueados | mantidos | reais | proporção |
|---|---|---|---|---|---|---|---|
| dagm classe 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| dagm classe 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| dagm classe 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| dagm classe 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| dagm classe 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| dagm classe 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| dagm classe 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| Total | 11,448 | 0 | 1,481 |
Tabela 2. Imagens geradas e proporção entre imagens reais e sintéticas, com base nos registos de geração e admissão de cada execução.
O que isto significa para as equipas que criam modelos de inspeção#
Para as equipas que já treinam o Ultralytics YOLO, a Cosmos Data Factory e o treino agentivo automatizado desenvolvido pela NVIDIA integram-se no fluxo de trabalho que já conhecem: os mesmos modelos, a mesma receita de treino e dados de entrada mais inteligentes.
• Abranja os casos-limite que não consegue recolher. Os defeitos sintéticos anotados automaticamente ajudam o Ultralytics YOLO a localizar defeitos quando os exemplos reais são escassos.
• Invista o orçamento de anotação onde é mais importante. Em mais de metade dos conjuntos de dados testados, a maioria das anotações era redundante. A seleção direcionada encontra as imagens que importam.
• Itere mais depressa. Conjuntos de treino menores e selecionados significam execuções de treino do Ultralytics YOLO mais curtas e experiências mais rápidas em muitos conjuntos de dados.
Disponibilidade#
A etapa de geração sintética baseada em Cosmos está atualmente disponível como exemplo e demonstração, mas ainda não foi lançada como integração.
Para experimentar a Cosmos Data Factory com os seus próprios modelos Ultralytics YOLO, contacte as equipas da Ultralytics. Continuaremos a trabalhar com a NVIDIA à medida que a etapa de geração sintética avança para uma integração completa.
Apêndice: configuração dos testes e conjuntos de dados#
Todas as execuções: Ultralytics YOLO26x, 100 épocas, otimizador, taxa de aprendizagem e semente idênticos para o modelo de referência e para a Cosmos Data Factory; um anfitrião com 8 GPUs; o mesmo conjunto de teste reservado para cada conjunto de dados. Os 11 conjuntos de dados com anotações poligonais podem usar defeitos gerados.
| conjunto de dados | imagens de treino | anotação | origem |
|---|---|---|---|
| dagm classe 1, 2, 3, 4 | 1,035 cada | polígono | DAGM 2007 |
| dagm classe 7, 8, 9, 10 | 2,070 cada | polígono | DAGM 2007 |
| pcb-defect | 20,924 | caixa | PCB defect |
| dspcbsd | 6,575 | caixa | DsPCBSD+ |
| deeppcb | 1,000 | caixa | DeepPCB |
| hripcb | 559 | caixa | HRIPCB |
| metal-surface-defect | 11,845 | caixa | NEU surface defect |
| tianchifabric | 10,332 | caixa | Tianchi fabric |
| severstal | 10,061 | polígono | Severstal steel |
| mvtec-ad | 4,637 | caixa | MVTec AD |
| visa | 7,794 | polígono | VisA |
| realiad-bottle-cap | 3,581 | polígono | Real-IAD |
| trinca | 1,290 | caixa | segmentação de trincas |
Tabela 3. Os 19 conjuntos de dados (DAGM conta como oito, um por classe).









