Como escolher um VLM para anotação automática usando precisão e revocação
Escolhe um VLM para anotação automática com base em precisão e revocação: que modelos deixam menos caixas excedentes, quais deixam passar menos objetos e como testar com os teus próprios dados.
 Sergiu Waxmann17 min de leitura
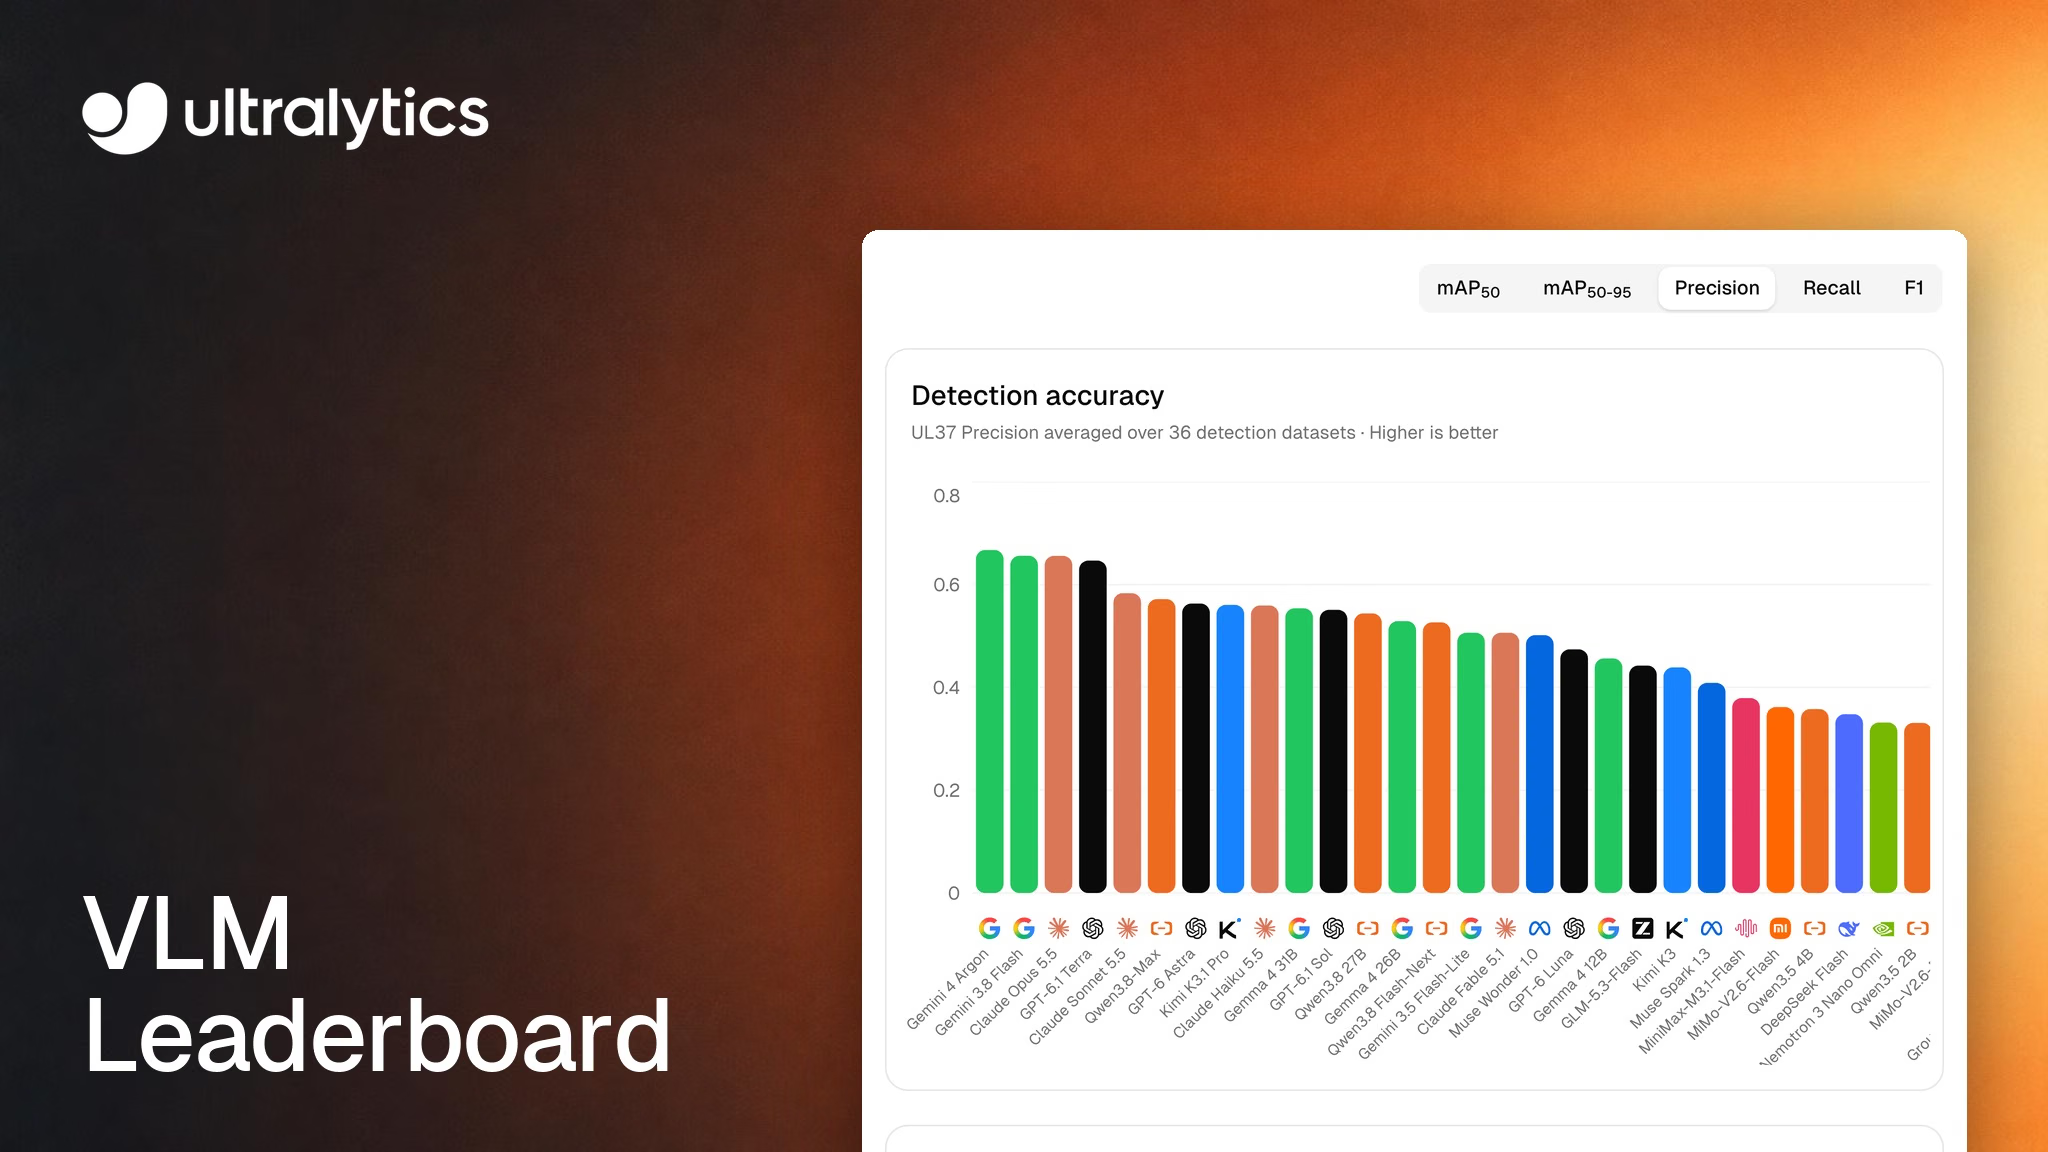
A escolha de um modelo para anotar automaticamente um conjunto de dados depende do tipo de revisão que seus revisores preferem fazer: excluir caixas extras ou adicionar as que o modelo não detectou. O Ranking de VLMs da Ultralytics agora mostra essa compensação para cada modelo, com precisão (a proporção de caixas do modelo que estão corretas) e revocação (a proporção de objetos rotulados que ele encontra), com base nos resultados do benchmark publicados em 28 de outubro de 2026.
Para obter os rascunhos iniciais mais limpos, comece com Gemini 4 Argon. Para deixar passar o menor número de objetos, comece com GPT-6 Astra. Para obter o melhor equilíbrio e o menor custo entre os seis modelos com pontuação mais alta, escolha GPT-6.1 Terra. Se você não tiver sua própria chave de API de um provedor de IA, comece com o Qwen3.8 27B hospedado ou com o SAM 3.1 Text para cenas lotadas que você prefira depurar.
Este guia explica como interpretar os números, onde cada modelo se encaixa e como confirmar sua escolha usando suas próprias imagens. As classificações e os preços mudam após cada execução, então considere os valores aqui como exemplos de outubro de 2026 e consulte o ranking para ver os resultados atuais.
Os modelos guiados por classes não têm um controlo deslizante de confiança, por isso a escolha do modelo define o teu limiar#
Com um modelo Ultralytics YOLO no editor de anotações, ajustas tu a relação entre as duas métricas. Aumenta o limiar de confiança e obténs menos caixas falsas, mas deixas passar mais objetos; diminui-o e acontece o inverso. Os modelos de visão e linguagem (VLMs) guiados por classes funcionam de outra forma. Como explicam os documentos do editor de anotações, detetam as classes do teu conjunto de dados com limiares específicos de cada modelo e não devolvem pontuações de confiança, por isso a Ultralytics Platform oculta as definições de confiança e IoU enquanto um destes modelos está selecionado.
Isso altera o significado da precisão e da revocação no leaderboard. De acordo com a metodologia do benchmark, a precisão e a revocação contabilizam todas as caixas devolvidas por um modelo com IoU de 0,5, sem qualquer ponto de funcionamento oculto. Estas métricas descrevem as caixas que os teus revisores recebem efetivamente.
O benchmark por trás do leaderboard é o UL37 v2: 10 imagens de cada um dos 36 conjuntos de dados reais de deteção de objetos na Platform, mais 10 imagens de referência do COCO 2017 avaliadas separadamente, num total de 370 imagens e 7.268 caixas. Cada imagem passa pelo mesmo pipeline de produção que a Smart Annotation e a Batch Annotation, usando os nomes de classes do próprio conjunto de dados, e o SAM 3.1 refina as caixas de todos os modelos, exceto as do SAM 3. A avaliação usa as próprias métricas de deteção do pacote Ultralytics, o código que valida os modelos YOLO, e cada conjunto de dados tem o mesmo peso na média.
A precisão acompanha as caixas sem correspondência; a revocação acompanha os objetos sem correspondência#
A precisão é a proporção de caixas de um modelo que correspondem a um objeto anotado da classe correta com IoU de 0,5. A revocação é a proporção de objetos anotados com que o modelo estabeleceu correspondência. Na prática da revisão:
- Precisão baixa significa mais caixas que têm de ser apagadas, reclassificadas ou redimensionadas até corresponderem.
- Revocação baixa significa mais objetos anotados aos quais é preciso adicionar uma caixa, ou cujas caixas têm de ser redimensionadas ou reclassificadas.
- F1 é a média harmónica das duas métricas, 2 x P x R / (P + R), um único valor que resume ambas. Não mede o tempo necessário para a revisão.
- mAP50 e mAP50-95 classificam os modelos pela precisão média entre classes, com IoU de 0,5 e nos limiares mais rigorosos de 0,50 a 0,95. A mAP50 determina a ordem de classificação no leaderboard.
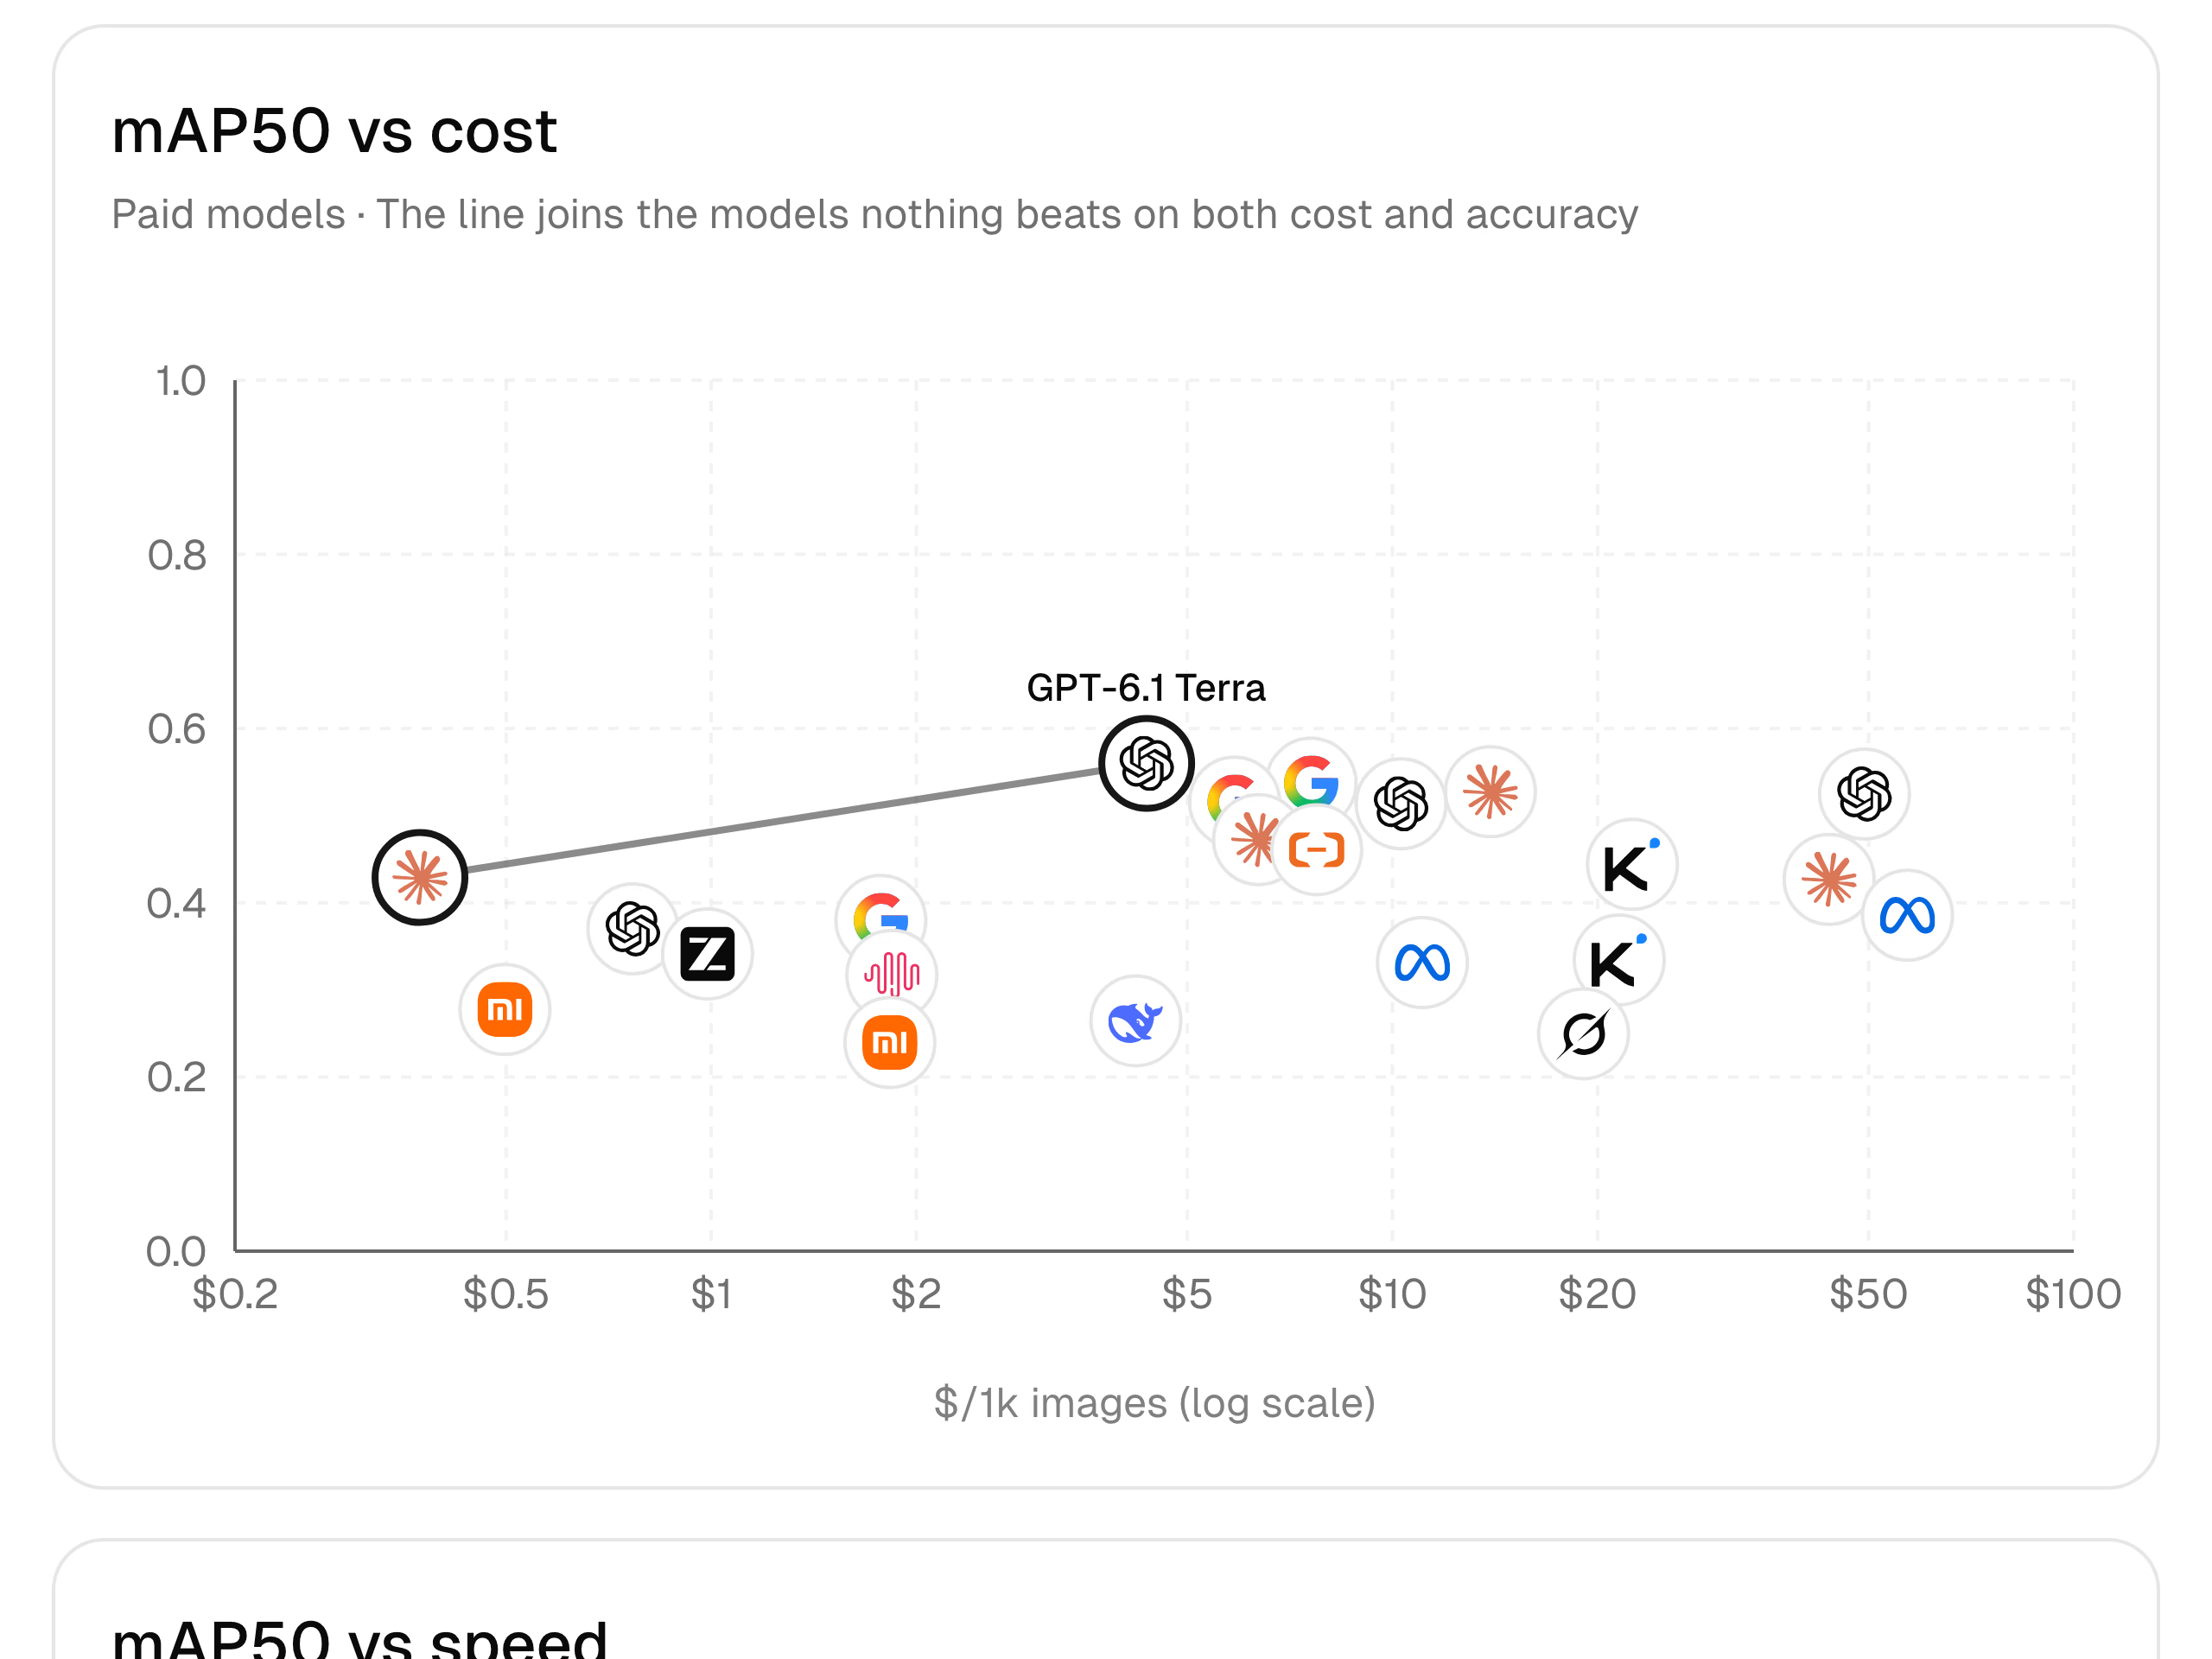
Estes são os seis modelos com pontuação superior a 0,51 mAP50. O custo é estimado com base na utilização de tokens comunicada pelos fornecedores por cada 1.000 imagens do benchmark anotadas com sucesso, e a latência corresponde ao tempo mediano das solicitações:
| Modelo | mAP50 | mAP50-95 | Precisão | Revocação | F1 | Custo do fornecedor / 1 mil imagens (utilização no benchmark) | Latência |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*A estimativa do Gemini 4 Argon usa os preços promocionais da Google, em vigor até 30 de novembro de 2026. A partir de 1 de dezembro, a tarifa normal da Google duplica, passando para cerca de $15 por 1.000 imagens com a mesma utilização. A Batch Annotation na Ultralytics Platform acrescenta $1.00 por cada 1.000 imagens processadas, independentemente do modelo, incluindo os alojados.
Os seis modelos dividem-se em dois grupos. Argon, Opus 5.5 e Gemini 3.8 Flash têm precisão entre 0,66 e 0,67 e revocação inferior a 0,60: uma grande proporção das caixas corresponde, mas estes modelos identificam menos objetos anotados. Astra e Sol atingem uma revocação entre 0,62 e 0,63, com precisão entre 0,55 e 0,56: identificam uma proporção maior dos objetos anotados, mas uma proporção menor das caixas corresponde. Terra fica entre os dois grupos e lidera em mAP50 e F1.
Dá prioridade à precisão quando as caixas excedentes são o erro mais dispendioso de corrigir#
Com 0,667, o Gemini 4 Argon tem a precisão geral mais elevada dos 40 modelos do benchmark. A contrapartida é uma revocação média de 0,585, inferior à dos líderes em revocação.
A precisão é mais importante quando é difícil detetar caixas sem correspondência. Numa imagem cheia de elementos, o revisor tem de encontrar uma caixa incorreta entre muitas corretas antes de a corrigir. As prateleiras densas de produtos do SKU110K mostram o quanto a precisão pode variar nessas imagens: nos nossos resultados do GPT-6.1 Terra, Terra obteve 0,79 de precisão e 0,73 de revocação, contra 0,49 e 0,77, respetivamente, do GPT-6.1 Sol.
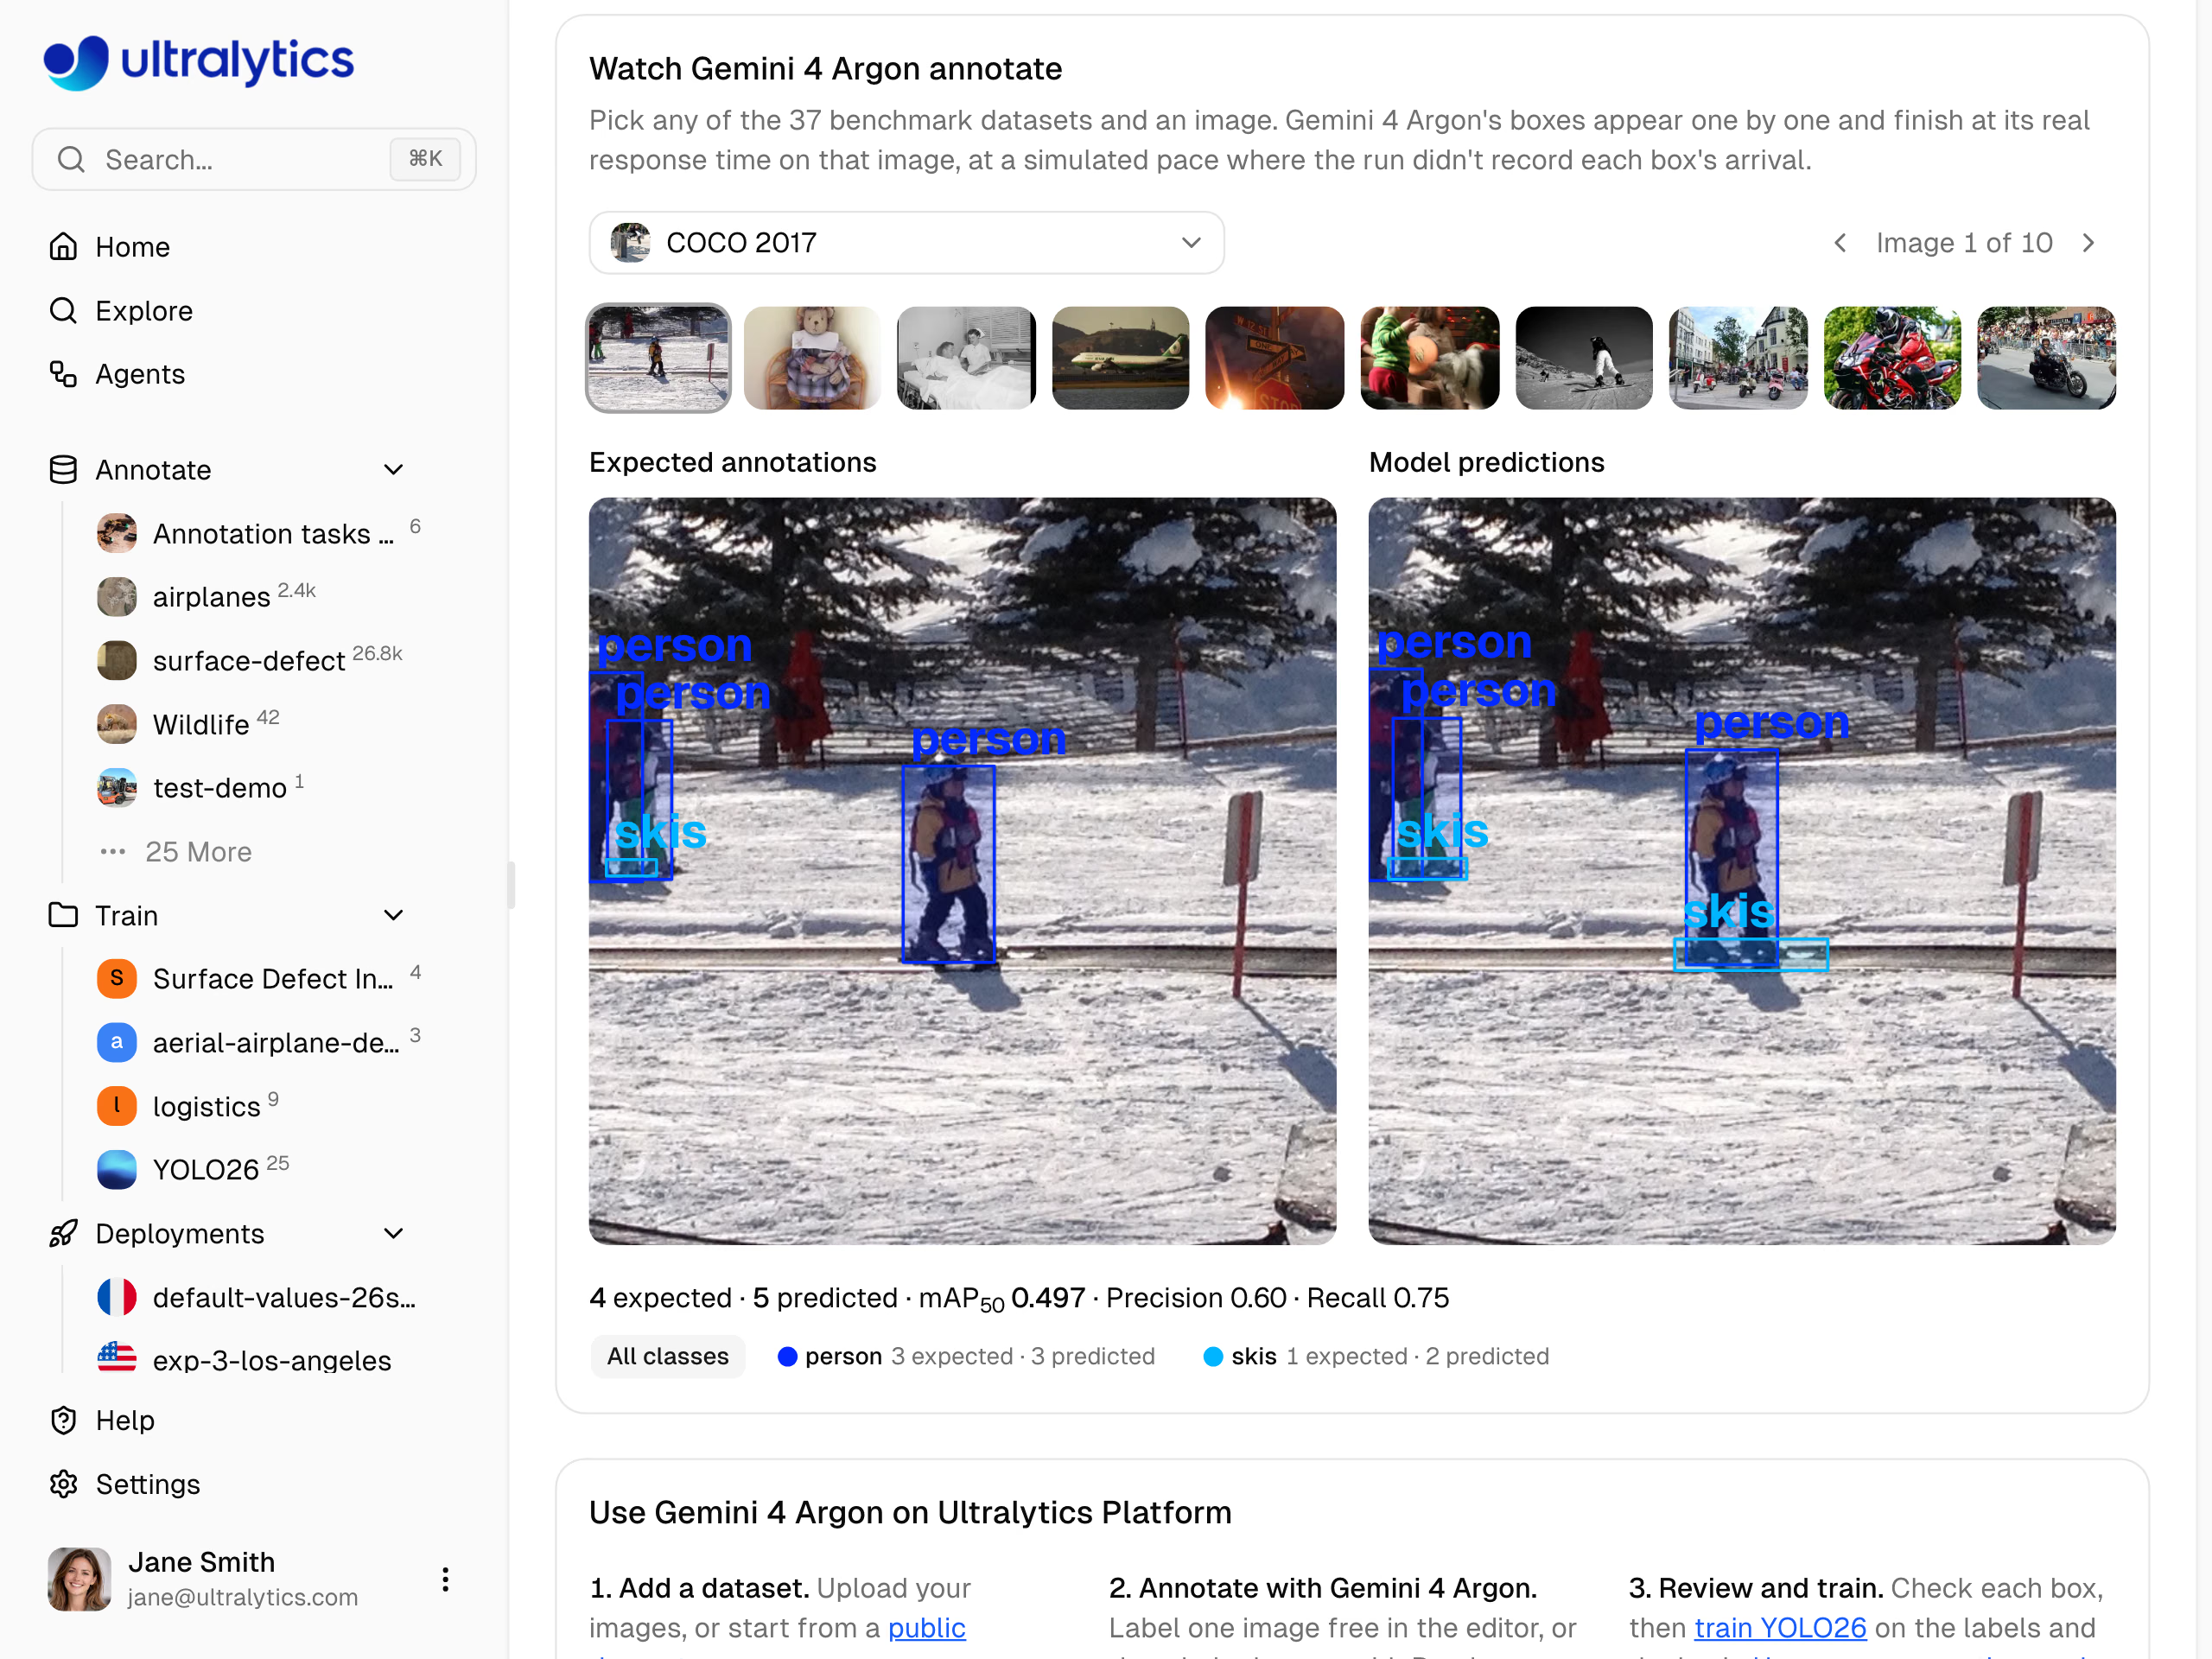
Gemini 4 Argon: 5 caixas previstas para 4 objetos anotados, precisão de 0,60, revocação de 0,75.
Argon também não teve nenhuma solicitação com falha no benchmark, e sua mediana de 4,6 segundos é a mais rápida entre os dois primeiros. Escolha-o quando seus dados forem semelhantes aos domínios em que se destaca — imagens aéreas, subaquáticas, térmicas e de raios X de segurança (ele registra o melhor mAP50 nas imagens de segurança por raios X do IEDXray, 0.298) — e quando sua equipe preferir completar alguns objetos não detectados a procurar caixas indevidas.
Dá prioridade à revocação quando deixar passar um objeto é o erro mais dispendioso#
GPT-6 Astra tem a maior revocação média do leaderboard, 0,627. A sua precisão de 0,56 é o preço a pagar.
A rotulagem que prioriza a revocação faz sentido quando deixar um objeto sem rótulo é o erro mais custoso. Um defeito ou uma lesão não detectados no seu conjunto de treinamento ensinam ao detector que o objeto é parte do fundo, e encontrar uma caixa ausente significa examinar cada imagem em busca de algo que não esteja marcado. Astra registra o melhor mAP50 em 7 dos 36 conjuntos de dados, incluindo radiografias de tórax da TBX11K (0.330), radiografias pediátricas de punho da GRAZPEDWRI-DX (0.354) e defeitos na superfície de placas de circuito impresso da DsPCBSD+ (0.394): um motivo para testá-lo em dados semelhantes, não uma prova de que ele deixará passar menos objetos nos seus dados.
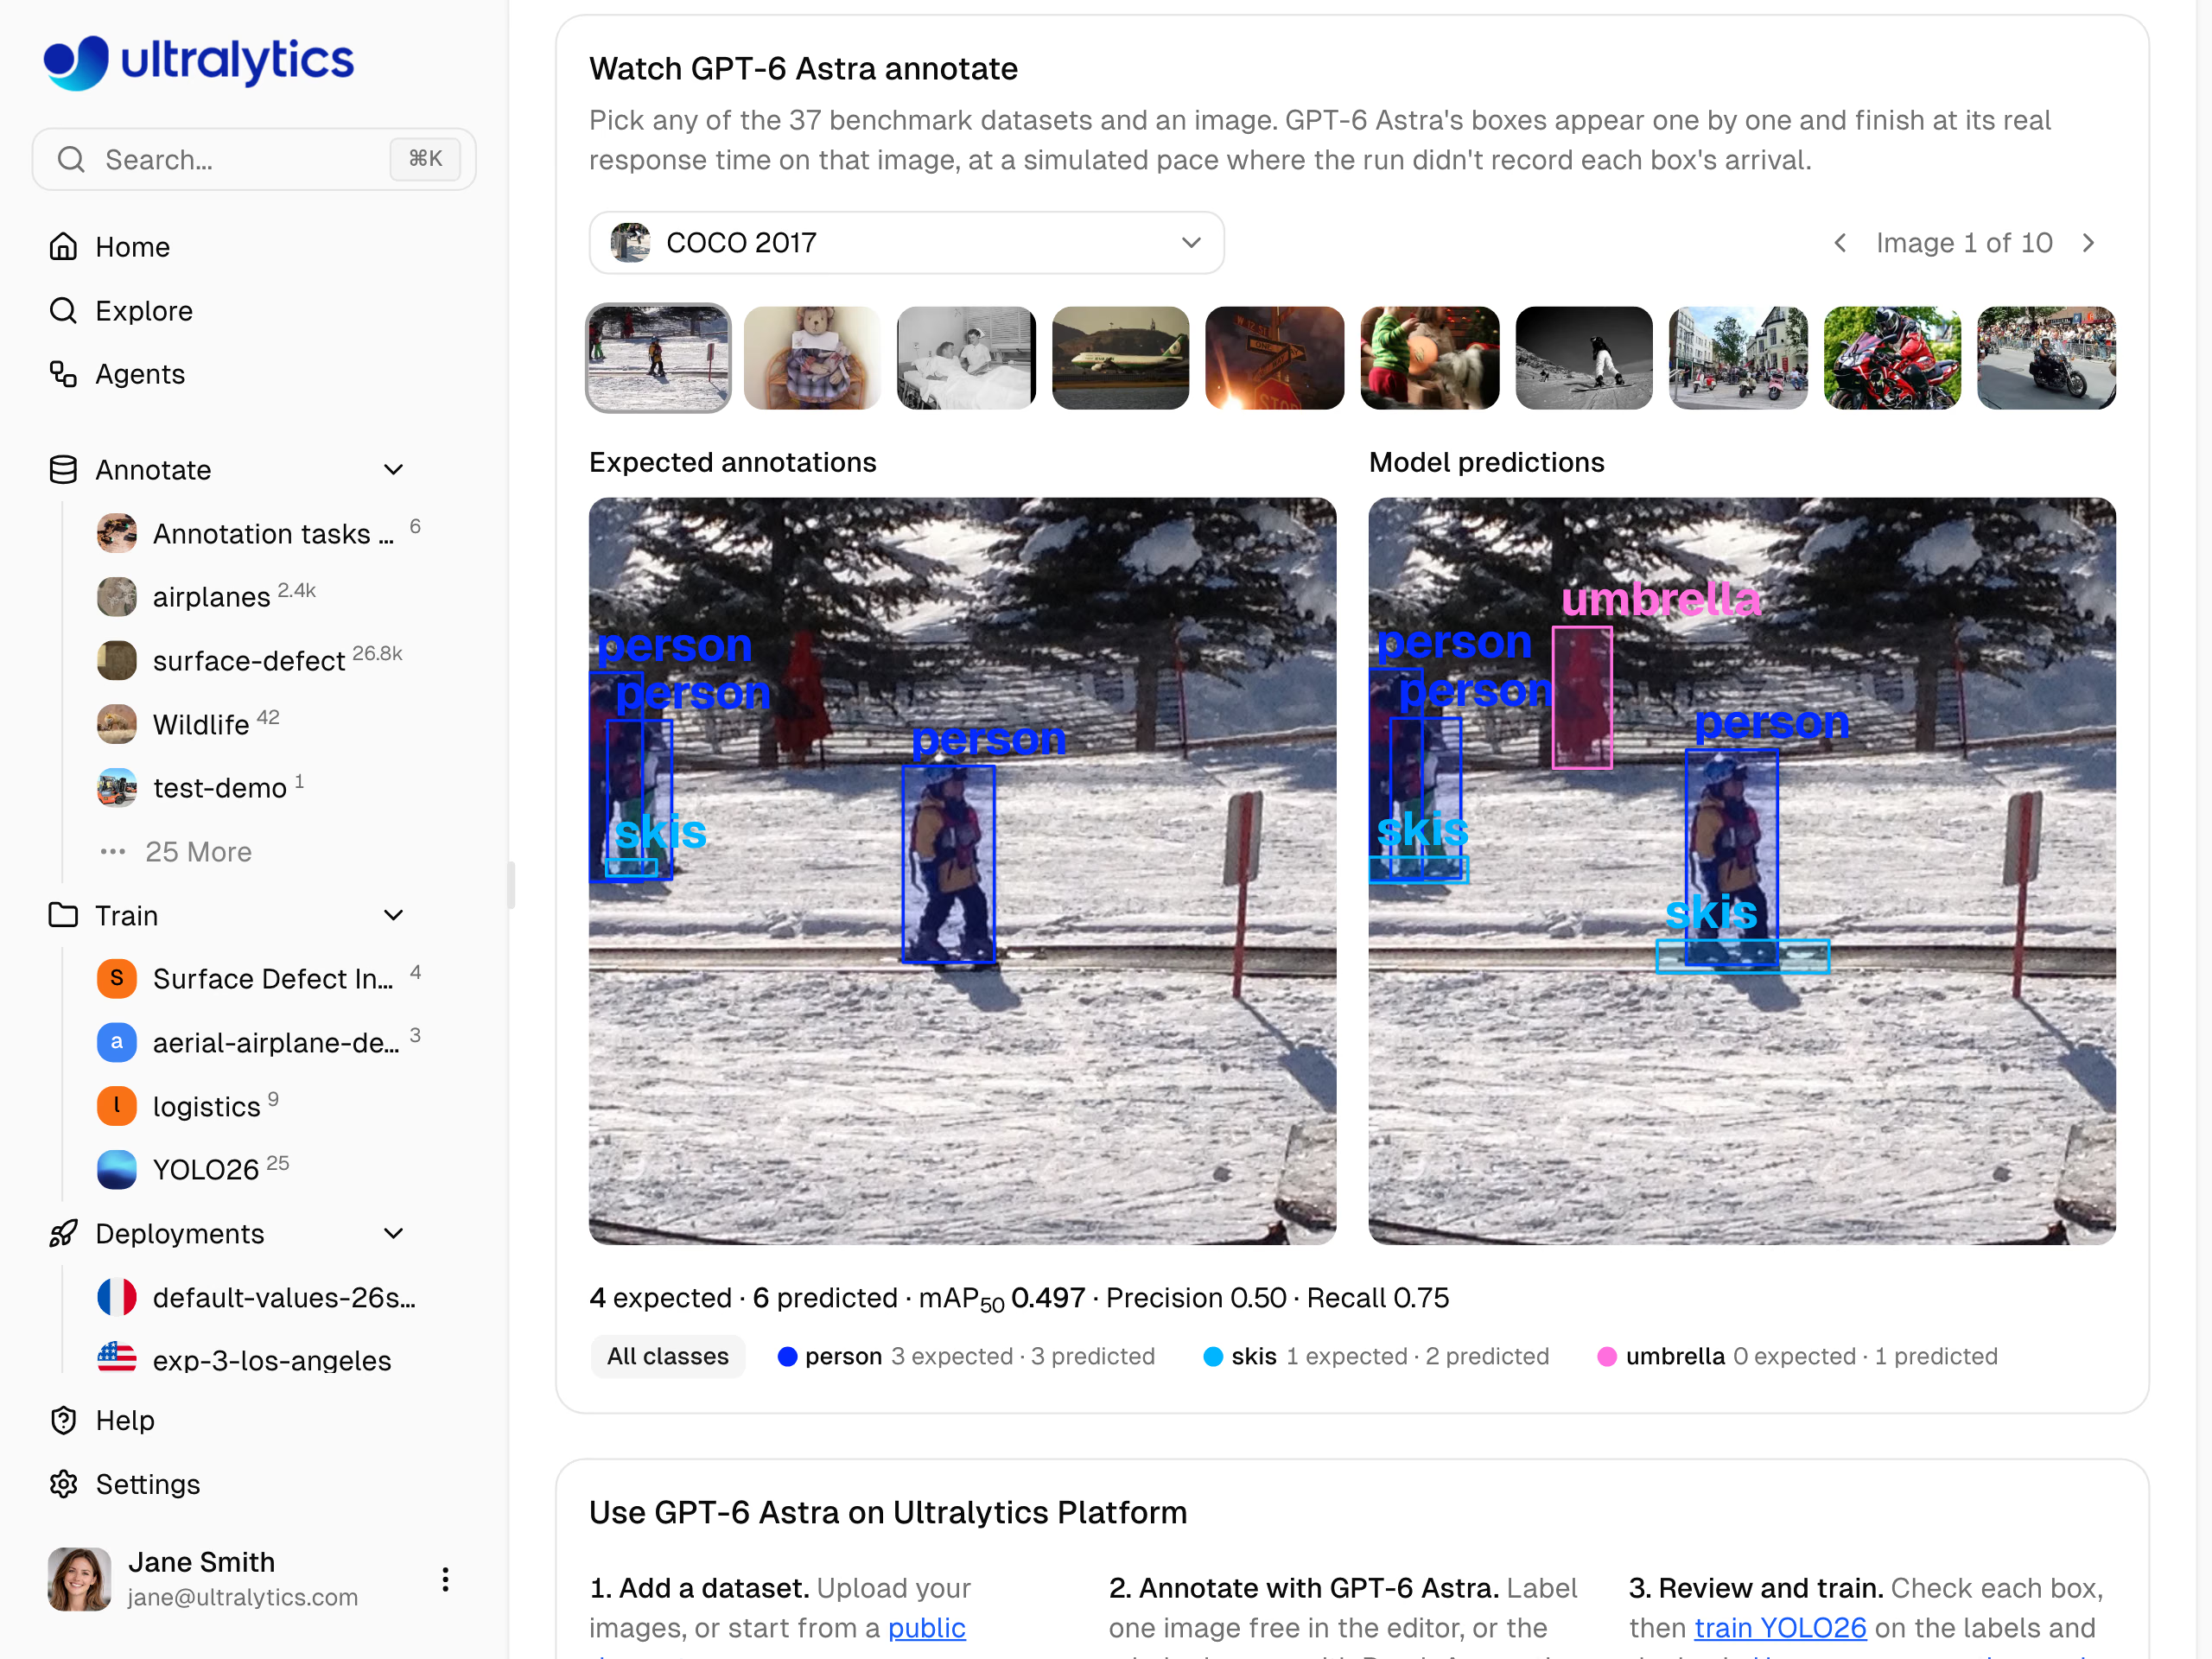
GPT-6 Astra: 6 caixas para os mesmos 4 objetos, incluindo um guarda-chuva que os rótulos do COCO deixam de fora, precisão 0.50, revocação 0.75.
A estimativa de custo do Astra é a mais alta entre os seis primeiros: $49.31 por 1.000 imagens, com um tempo mediano de 11,6 segundos e pedidos falhados em 1% das imagens. Dois outros modelos da OpenAI têm uma revocação semelhante: GPT-6.1 Sol, com 0,62 e um custo estimado de $10.30, e GPT-6.1 Terra, com 0,61 e um custo estimado de $4.36.
Pondera os dois tipos de erro com mAP50-95 e F1#
GPT-6.1 Terra lidera o leaderboard com 0,560 mAP50 e 0,345 mAP50-95. Os seus valores de precisão, 0,646, e revocação, 0,613, ficam ambos a poucos centésimos dos líderes, e o seu F1 de 0,63 é o mais elevado dos seis, ligeiramente acima dos 0,62 de Argon e Opus 5.5. Como os valores de F1 são tão próximos e o F1 não diz nada sobre o tempo de revisão, deixa que os resultados por domínio e um teste com as tuas próprias imagens determinem a escolha.
A liderança em mAP50-95 acrescenta um segundo indicador. Como a mAP50-95 calcula a média em limiares de sobreposição até 0,95, favorece tanto os modelos cujas caixas correspondentes se ajustam bem como os que detetam os objetos corretos, e Terra também lidera nesta métrica. Além disso, tem a estimativa de custo mais baixa entre os seis primeiros e não teve pedidos falhados; o leaderboard identifica-o como "Melhor relação qualidade-preço".
Anota sem uma chave de fornecedor: modelos alojados e detetores de vocabulário aberto#
Nem todas as equipas querem uma chave de fornecedor paga. Os modelos alojados na Platform funcionam sem uma, e os respetivos valores contam uma história diferente:
- SAM 3.1 Text: 0,332 mAP50, 0,19 de precisão, 0,47 de revocação, 0,2 s por imagem. É o melhor modelo dos 40 no VisDrone (0,479 mAP50) e no tráfego do Fisheye8K (0,478).
- Qwen3.8 27B: 0,351 mAP50, 0,54 de precisão, 0,40 de revocação, 1,5 s.
- Gemma 4 26B: 0,344 mAP50, 0,53 de precisão, 0,39 de revocação, 0,9 s.
Os detetores de vocabulário aberto também são alojados. Neste benchmark, OWLv2 Large obteve 0,133 mAP50 e Grounding DINO Base obteve 0,104, ambos a 0,2 segundos por imagem, em comparação com os 0,332 do SAM 3.1 Text. Estas pontuações avaliam o pipeline da Platform guiado por classes, com refinamento de caixas pelo SAM 3.1, e não a configuração original de cada modelo.
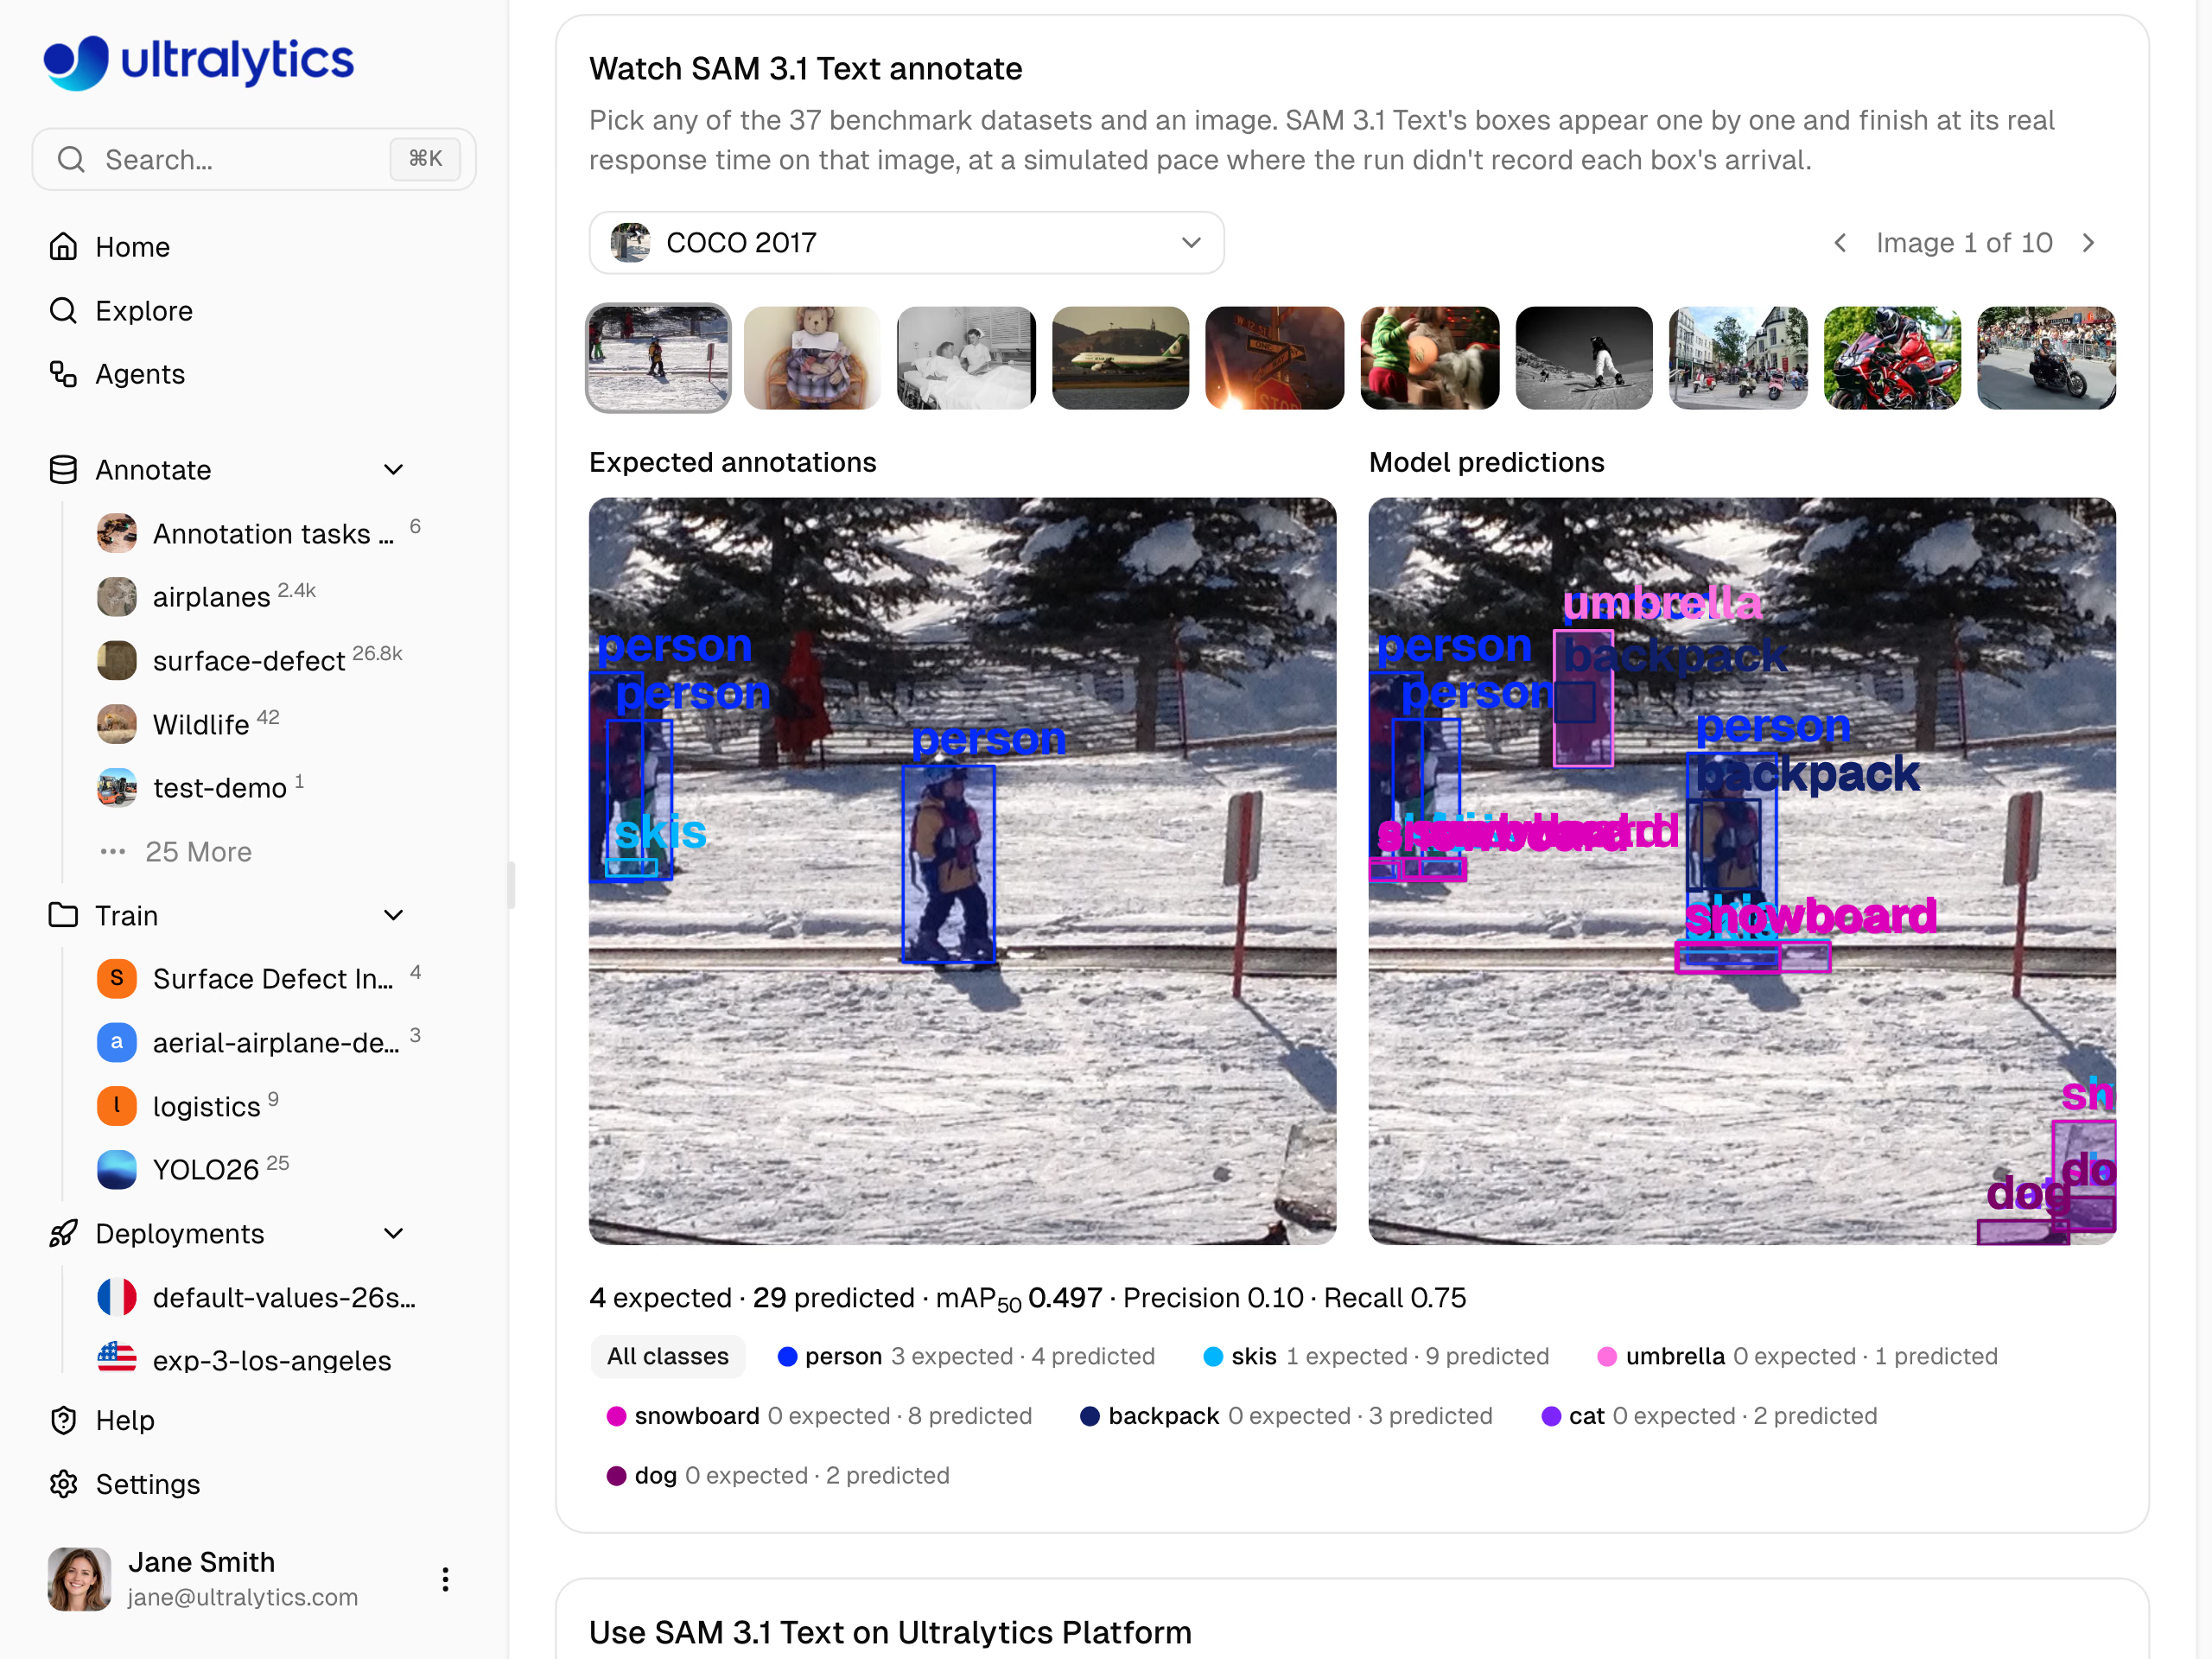
SAM 3.1 Text: 29 caixas para 4 objetos, precisão de 0,10, revocação de 0,75. As três reproduções detetam 3 dos 4 objetos; o que muda é o número de caixas a mais que os revisores apagam.
SAM 3.1 Text é adequado para cenas de tráfego e aéreas com muitos elementos, onde os revisores esperam reduzir um rascunho generoso. Qwen3.8 27B e Gemma 4 26B comportam-se como o grupo mais cuidadoso, mas com menor precisão. Entre os modelos pagos de baixo custo, Claude Haiku 5.5 atinge 0,429 mAP50, com 0,56 de precisão e 0,47 de revocação, a um custo estimado de $0.37 por 1.000 imagens; é o outro modelo que o leaderboard assinala como "Melhor relação qualidade-preço".
As médias gerais do leaderboard ocultam o teu domínio; consulta a tabela dos conjuntos de dados#
A precisão e a revocação de cada modelo são médias de 36 conjuntos de dados, mas os teus dados pertencem a um único domínio. A tabela de conjuntos de dados do VLM leaderboard apresenta a precisão e a revocação médias de cada conjunto de dados nos 40 modelos, começando pelos mais difíceis, além do melhor modelo em cada um.
Consulta-a para identificar sinais de alerta. No Airbus Oil Storage Detection, com 2.267 depósitos anotados nas suas 10 imagens, os modelos têm uma média de 0,39 de precisão e 0,11 de revocação, e a melhor mAP50 é os 0,347 do Gemini 4 Argon. No DeepPCB, a precisão e a revocação médias são 0,03 e 0,04, e GPT-6.1 Sol destaca-se com 0,393 mAP50.
Considera estes valores uma lista restrita, não uma conclusão definitiva. A metodologia indica que 10 imagens por conjunto de dados bastam para classificar os modelos e os domínios, mas não para certificar a pontuação de um único conjunto de dados; além disso, execuções repetidas podem alterar os valores individuais em alguns pontos. Cada página de modelo na Platform mostra, lado a lado, as caixas registadas pelo modelo e as caixas esperadas nos conjuntos de dados do benchmark e no COCO, para que possas inspecionar o conjunto mais parecido com o teu antes de iniciar uma execução.
Escolhe o modelo adequado ao teu fluxo de revisão em cinco passos#
Começa pela tua prioridade de seleção e, depois, confirma a escolha com as tuas próprias imagens:
| A tua prioridade | Lista restrita (resultados de outubro de 2026) |
|---|---|
| Dar prioridade à precisão | Gemini 4 Argon |
| Dar prioridade à revocação | GPT-6 Astra ou GPT-6.1 Sol |
| Ponderar ambas | GPT-6.1 Terra |
| Sem chave de fornecedor | Hospedados: Qwen3.8 27B ou SAM 3.1 Text |
A anotação guiada por classes funciona em conjuntos de dados de deteção com 1 a 200 classes.
- Pré-selecione no ranking. Filtre o ranking de VLMs para detecção de objetos para exibir os modelos pagos ou hospedados (ignore os marcados como Não disponível na plataforma), leia a coluna correspondente à sua prioridade e consulte a tabela de conjuntos de dados do seu domínio.
- Adiciona uma chave de fornecedor. Para usar um modelo pago, guarda a tua chave em Definições > Chaves de API no espaço de trabalho que contém o conjunto de dados. O fornecedor cobra diretamente à tua chave; consulta a documentação das chaves de fornecedor para saberes como a configurar.
- Testa com uma amostra revista. Escolhe algumas imagens representativas dos teus dados que tenhas anotado manualmente. Abre o editor de anotações, muda para o modo Smart, escolhe o modelo na lista de modelos, sob o respetivo fornecedor, e prime Predict (
P). Conta as caixas que apagas, as que adicionas e os minutos que a revisão demora. - Anota o conjunto de dados. Na página do conjunto de dados, escolhe Mais ações > Batch Annotation, disponível para conjuntos de dados alojados na Platform com até três canais de imagem. Por predefinição, anota as imagens sem anotações, nunca altera as anotações existentes e guarda primeiro uma versão do conjunto de dados para que possas reverter as alterações. Consulta o custo estimado na caixa de diálogo antes de começares: a Batch Annotation custa $1.00 por cada 1.000 imagens processadas, além dos custos cobrados pelo fornecedor.
- Revê e, depois, treina. Verifica as caixas tendo em conta o ponto fraco do teu modelo, guarda-as e treina um modelo Ultralytics YOLO com o resultado no mesmo espaço de trabalho.
Para saberes mais, consulta como a Ultralytics Platform usa IA para automatizar a anotação e por que razão a revisão com intervenção humana continua a fazer parte do processo. Para veres como a anotação automática se compara à aprendizagem ativa em diferentes ferramentas, lê a nossa comparação entre anotação automática e aprendizagem ativa.
Lista restrita por equipa (resultados de outubro de 2026)#
- Revisores que preferem completar um rascunho a limpá-lo: Gemini 4 Argon, o modelo mais preciso no geral, com melhores resultados em dados aéreos, subaquáticos, térmicos e de raios X de segurança.
- Objetos raros cuja omissão contamina os dados de treino: GPT-6 Astra para obter a revocação máxima ou GPT-6.1 Sol, logo atrás.
- Anotação de uso geral, sem uma preferência marcada: GPT-6.1 Terra, líder em mAP50, mAP50-95 e F1.
- Equipas sem uma chave de fornecedor: SAM 3.1 Text para primeiras passagens que priorizam a revocação em cenas com muitos elementos ou Qwen3.8 27B para um rascunho mais cuidadoso.
Seja qual for a tua escolha, o leaderboard permite-te antecipar a revisão antes de a iniciares. Para conheceres a teoria por trás destas métricas, o nosso guia sobre exatidão, precisão e revocação explica os conceitos básicos, e a aula da Academy sobre como interpretar métricas de deteção aprofunda o tema.
Perguntas frequentes
Dá prioridade à precisão quando apagar caixas incorretas é a correção mais demorada, por exemplo, em imagens com muitos elementos, onde uma caixa excedente pode passar despercebida entre as corretas. Dá prioridade à revocação quando deixar passar um objeto tem um custo maior, como no caso de defeitos ou lesões raros, porque um objeto sem anotação ensina ao detetor que faz parte do fundo. Depois, confirma a escolha com uma amostra das tuas próprias imagens revista manualmente.
Os modelos guiados por classes devolvem caixas sem pontuações de confiança e usam limiares específicos de cada modelo, por isso a Platform oculta as definições de confiança e IoU enquanto um destes modelos está selecionado. Assim, a precisão e a revocação do leaderboard contabilizam todas as caixas que o modelo devolve com IoU de 0,5. Para alterar o equilíbrio entre caixas e objetos sem correspondência, escolhe outro modelo.
Usa mAP50 para verificar se um modelo deteta e anota os objetos corretos, e mAP50-95 para acrescentar limiares de sobreposição mais rigorosos, que favorecem caixas bem ajustadas. Ambas as métricas também refletem objetos não detetados e falsos positivos, por isso analisa-as juntamente com a precisão e a revocação. Nos resultados de outubro de 2026, GPT-6.1 Terra lidera em ambas, com 0,560 e 0,345.
Sim. O melhor modelo no UL37 v2 tem uma média de 0,560 mAP50 (outubro de 2026) e, nos conjuntos de dados mais difíceis, como os de defeitos em PCB e radiografias torácicas, os 40 modelos têm uma média inferior a 0,05. Revê todas as imagens e presta especial atenção ao ponto fraco do modelo: caixas a mais num modelo que favorece a revocação ou objetos não detetados num modelo que favorece a precisão.
Há dois componentes. A Batch Annotation na Ultralytics Platform custa $1.00 por cada 1.000 imagens processadas (mínimo de $0.01), qualquer que seja o modelo, incluindo os alojados; as previsões individuais com um modelo alojado no editor são gratuitas. Os modelos pagos de fornecedores também são cobrados pelo fornecedor à tua própria chave de API. No benchmark de outubro de 2026, as estimativas dos fornecedores para os modelos deste guia variaram entre $0.37 por 1.000 imagens (Claude Haiku 5.5) e $49.31 (GPT-6 Astra). Se interromperes uma execução, serás cobrado pelas imagens já processadas.
Sim. Os modelos alojados, como SAM 3.1 Text, Qwen3.8 27B e Gemma 4 26B, funcionam na Ultralytics Platform sem uma chave de fornecedor, tal como os teus próprios modelos YOLO. As execuções em lote continuam a custar $1.00 por cada 1.000 imagens processadas, e a caixa de diálogo apresenta a estimativa antes de cada execução.
Depende da tarefa. Um VLM guiado por classes pode criar um rascunho de anotações para novas classes apenas com os respetivos nomes, mas os seis modelos com melhor pontuação no benchmark de outubro de 2026 demoraram entre 2,7 e 11,6 segundos por imagem e cobram por token. Para deteção em tempo real, uma abordagem comum é fazer a anotação automática com um VLM, rever as anotações e treinar um modelo Ultralytics YOLO com elas. Um modelo YOLO que já tenhas treinado também pode fazer a anotação automática de novas imagens no mesmo editor.
Escrito por
Engenheiro de software líder · Ultralytics
Comentários2
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









