GPT-6.1 Terra занимает первое место в авторазметке, обойдя флагманские модели OpenAI
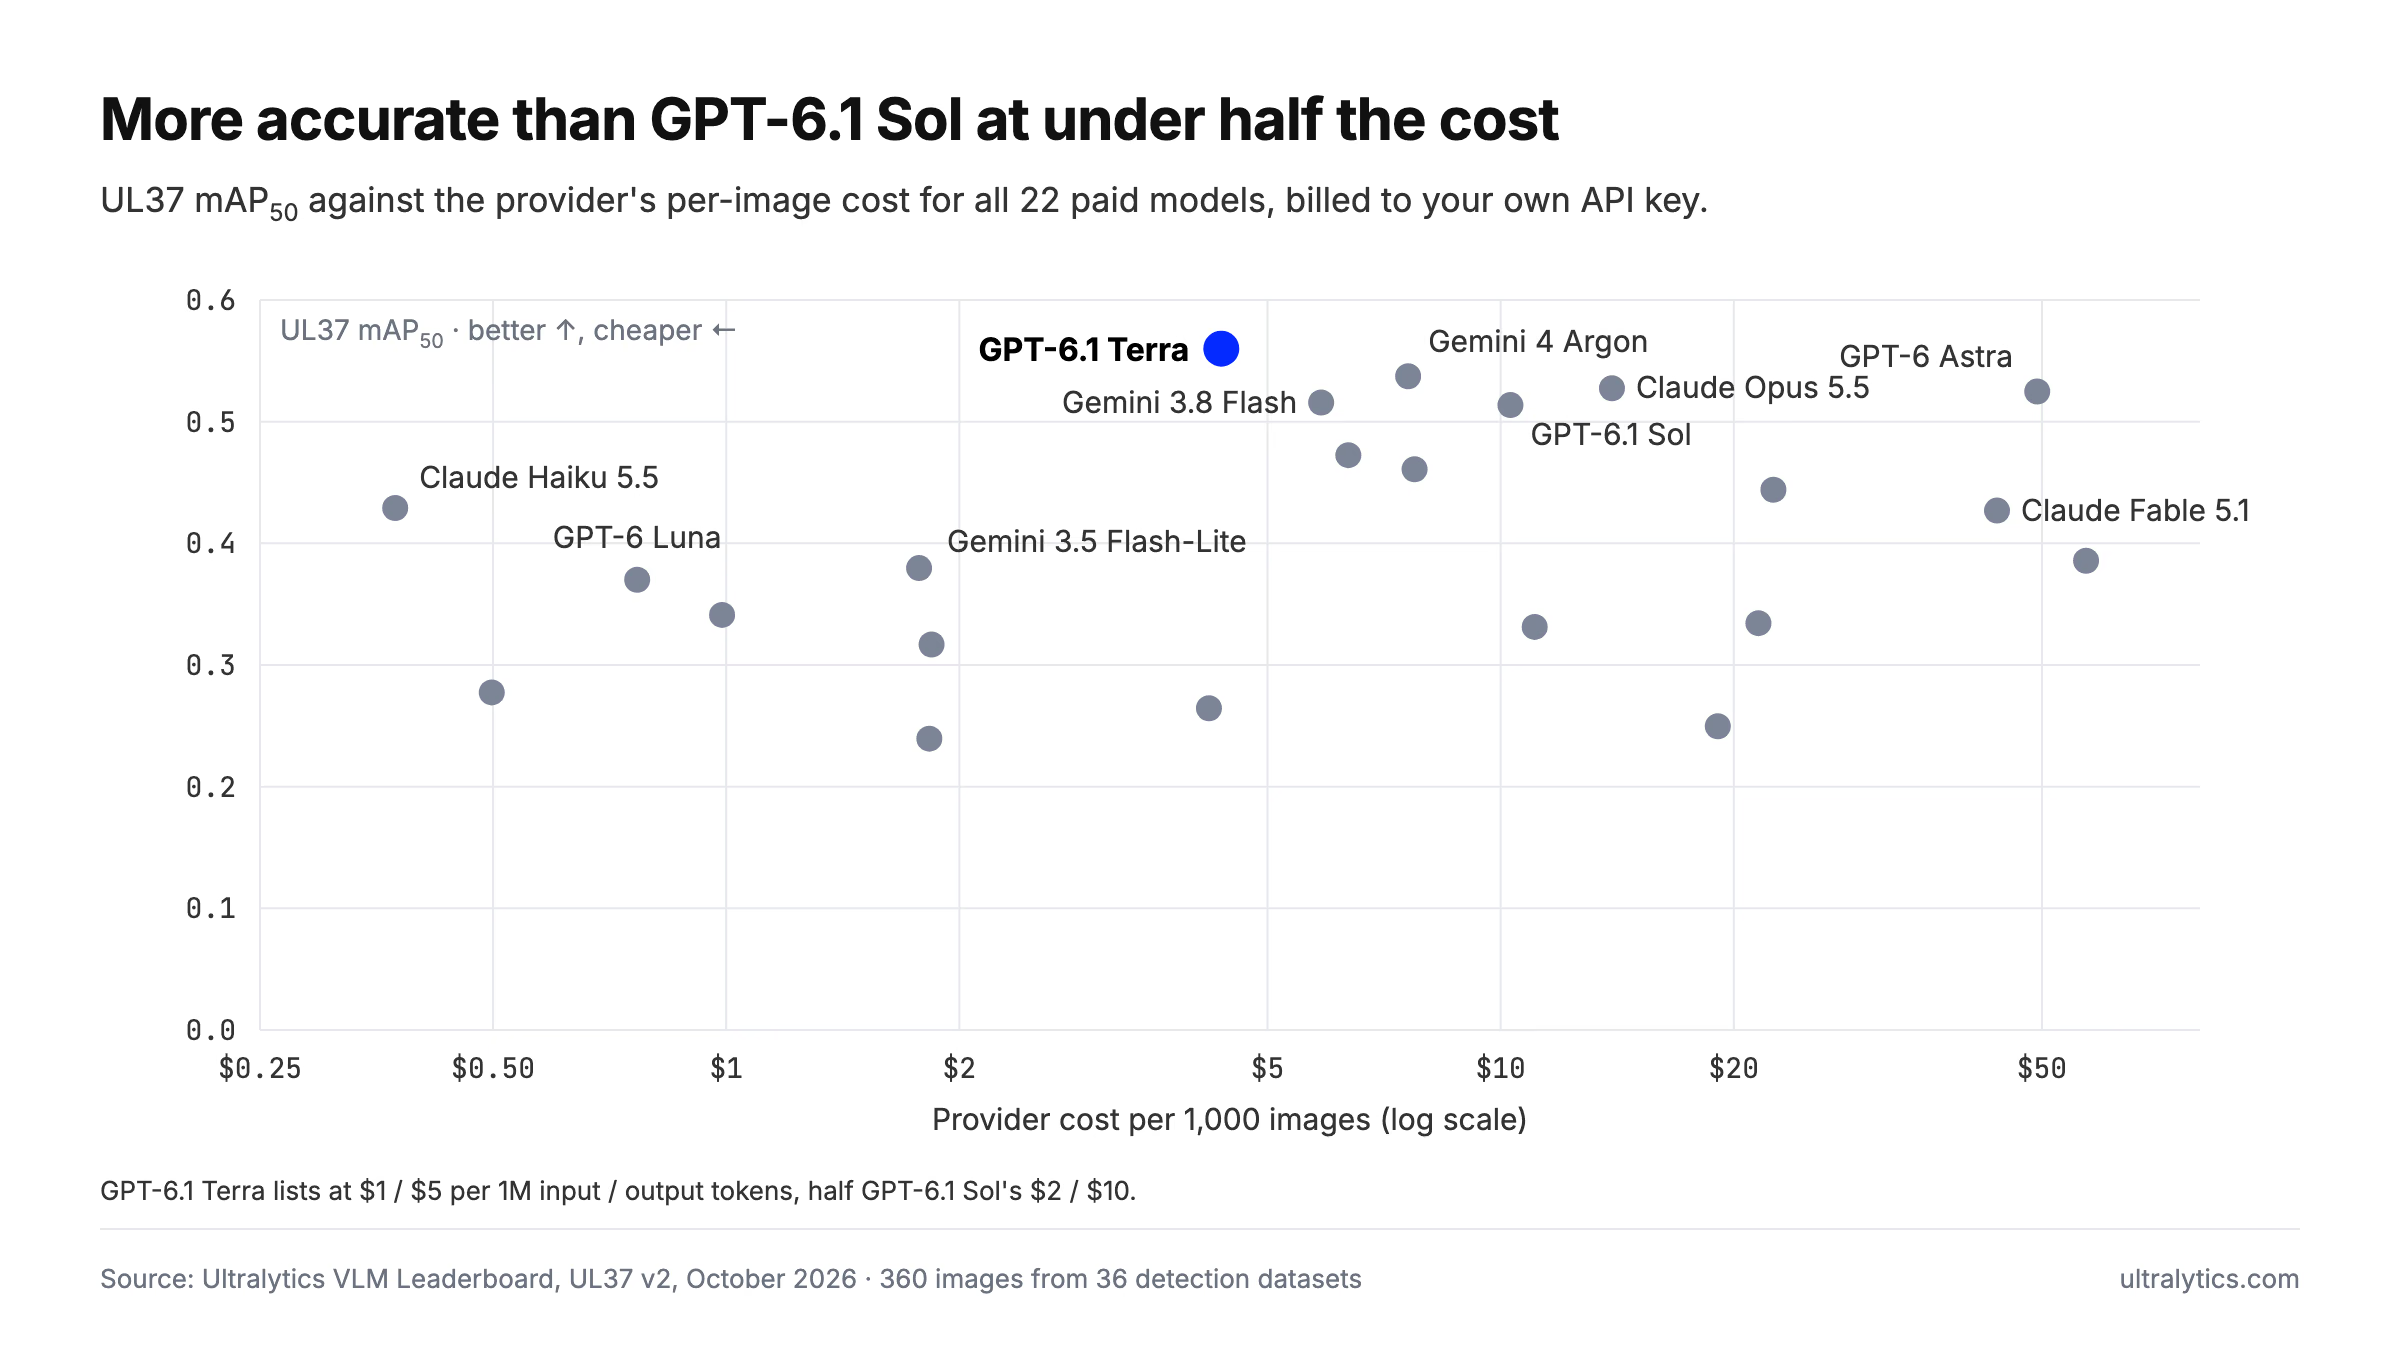
Авторазметка GPT-6.1 Terra обходит 39 моделей в нашем рейтинге VLM: 0.560 mAP50 за $4.36 на 1 000 изображений — впереди GPT-6.1 Sol и Gemini 4 Argon.
В материалах о запуске OpenAI говорится, что GPT-6.1 Terra почти не уступает более крупным моделям семейства в визуальном рассуждении. Когда мы попросили модель нарисовать ограничивающие рамки, слово «почти» оказалось неуместным.
26 октября 2026 года, в день выхода GPT-6.1 Terra, мы проверили её авторазметку на UL37 — нашем бенчмарке детекции на 36 наборах данных benchmark. Модель набрала 0.560 mAP50 — лучший результат среди всех 39 моделей в нашем рейтинге VLM. Модель OpenAI среднего ценового сегмента обошла GPT-6.1 Sol, флагманскую GPT-6 Astra и Gemini 4 Argon, которая удерживала первое место до этой недели.
Модель добилась этого результата за $4.36 на 1 000 изображений, обрабатывая каждое изображение за 5.1 секунды и не допустив ни одного сбоя запроса. Уже сегодня ты можешь использовать её в Ultralytics Platform. Ниже рассказываем, в чём её сильные стороны, где она ошибается и как решить, подходит ли она для твоего рабочего процесса разметки.
GPT-6.1 Terra занимает первое место на UL37#
UL37 оценивает, насколько рамки модели совпадают с человеческой разметкой на 360 изображениях: по 10 из каждого из 36 реальных наборов данных для детекции объектов, охватывающих медицинские снимки, аэрофотосъёмку, магазинные полки, спорт, документы, печатные платы и многое другое. Каждое изображение проходит через один и тот же производственный конвейер, доступный пользователям Platform; используются названия классов из самого набора данных, а SAM 3.1 уточняет каждую рамку. Методология открыта.
Вот результаты Terra:
- mAP50: 0.560, № 1 из 39
- mAP50-95: 0.345, тоже № 1: рамки модели подогнаны точно, а не приблизительно
- Точность и полнота: 0.646 и 0.613
- Стоимость у провайдера: $4.36 на 1 000 изображений
- Медианное время обработки изображения: 5.1 с
- Сбои запросов: отсутствуют
Шесть моделей набрали на UL37 больше 0.51, в том числе Claude Opus 5.5, занявшая третье место. Terra — самая точная из шести и одновременно самая дешёвая.
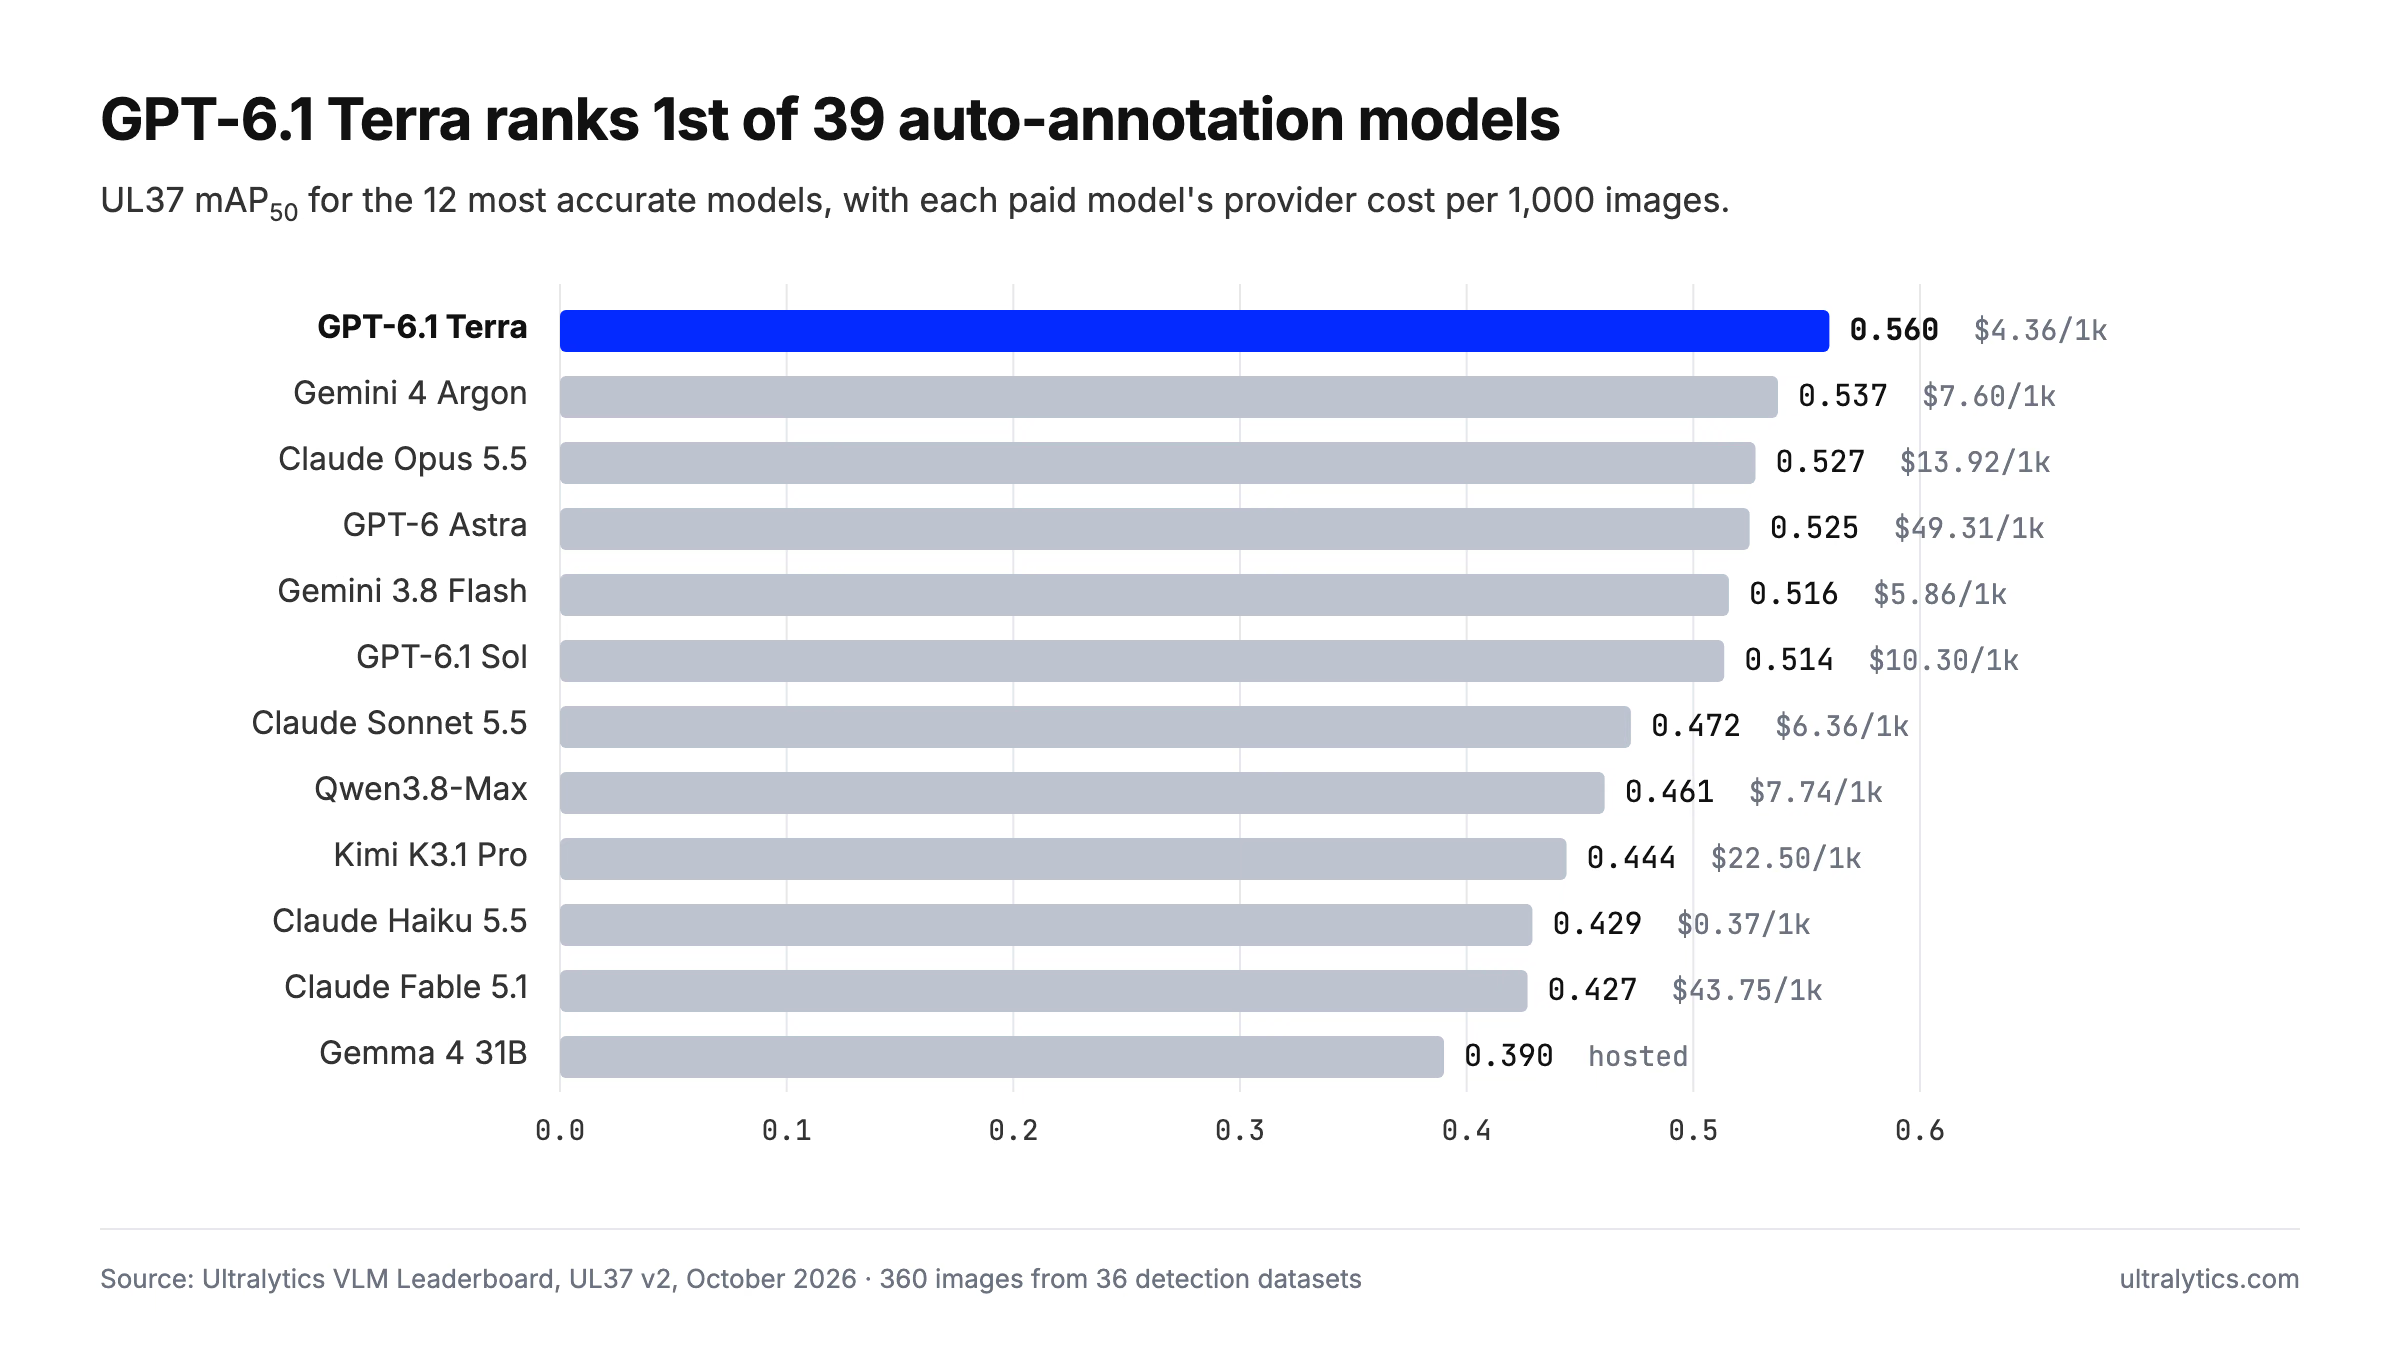
Результат не стал следствием сложной настройки. Terra работает с установленным по умолчанию уровнем рассуждений OpenAI, который в документации модели указан как средний. В Platform модель получает тот же запрос, что и все остальные модели OpenAI, а координаты рамок задаются на сетке от 0 до 1000. Мы подключили модель — и она сразу вышла на первое место.
Модель среднего ценового сегмента обходит флагманы OpenAI#
OpenAI позиционирует GPT-6.1 Terra как быструю и эффективную модель среднего уровня в своей линейке. Согласно материалам о запуске от The Decoder и BleepingComputer, она пришла на смену GPT-5.6 Terra и предназначена для работы с компьютером, визуального рассуждения, программирования и повседневных задач. Модель доступна в API под именем gpt-6.1-terra, а также в ChatGPT Work и Codex для пользователей Plus, Pro, Enterprise и Edu. В документации OpenAI модель описана как «быстрая и эффективная модель для визуального рассуждения, точной работы с компьютером и ясного, естественного письма»; она принимает текст и изображения и поддерживает контекстное окно на 1 050 000 токенов.
Цена составляет $1 за миллион входных токенов и $5 за миллион выходных токенов; входные токены из кэша стоят $0.05. Это вдвое меньше, чем $2 и $10 у GPT-6.1 Sol, и в десять раз меньше, чем $10 и $50 у GPT-6 Astra, согласно страницам OpenAI о GPT-6.1 Sol и GPT-6 Astra.
В опубликованных при запуске бенчмарках OpenAI представляет Terra как модель, почти не уступающую старшим моделям семейства, но не превосходящую их. В тесте визуального рассуждения MMMU-Pro OpenAI сообщает, что Terra почти сравнялась с Astra и Sol. В Terminal-Bench 4.0 её результат составляет 50.3% против 21.5% у GPT-5.6 Terra. При этом для самых сложных задач программирования OpenAI по-прежнему рекомендует Sol или Astra.
На бумаге Terra — компромиссный выбор. В нашем бенчмарке это лучшая модель OpenAI для детекции.
| Модель OpenAI | UL37 mAP50 | Стоимость на 1 000 изображений | Медианное время на изображение |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5.1 с |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Одно изображение с Terra обходится менее чем в половину цены GPT-6.1 Sol и менее чем в десятую часть цены GPT-6 Astra. Кроме того, Terra отвечает примерно вдвое быстрее каждой из них. При прямом сравнении Terra обходит Sol на 22 из 36 наборов данных.
По словам OpenAI, Terra выполняет задачи более чем втрое быстрее Sol и Astra; речь идёт о нагрузках с агентами. Разметка — другая задача, и здесь мы измерили примерно двукратное ускорение относительно Sol. Это заметная экономия, когда нужно разметить тысячи изображений.
Преимущество Terra перед Sol — в точности#
Обе модели находят примерно одинаковую долю размеченных объектов. Полнота Terra — 0.613, а Sol — 0.618. Разница проявляется в точности: 0.646 у Terra против 0.551 у Sol. Значительно большая доля рамок Terra приходится на реальные объекты с правильной меткой.
На SKU110K разницу легко заметить. На изображениях этого набора данных — плотно заставленные товарами полки супермаркетов; все товары относятся к одному классу. Обе модели показывают примерно одинаковую полноту: 0.73 у Terra и 0.77 у Sol. Но точность Sol на этих полках составляет 0.49, а Terra — 0.79. Примерно половина рамок Sol — ложные срабатывания, а у Terra — около одной из пяти. Показатель Terra на SKU110K — 0.62 mAP50, это лучший результат среди всех моделей.
Это важно для разметки данных, потому что цена ошибок неодинакова. Если модель пропустила товар, нужно нарисовать одну рамку. Если модель поставила ложную рамку, её надо найти среди десятков правильных и удалить. Чем меньше ложных срабатываний, тем чище первоначальный вариант для проверки.
Медицинские изображения — главная сильная сторона GPT-6.1 Terra#
Самая заметная особенность результатов Terra — работа с медицинскими изображениями. В UL37 входят восемь медицинских наборов данных; средний результат Terra на них — 0.505 mAP50, № 1 из 39. Далее идут Gemini 3.8 Flash с 0.387 и Gemini 4 Argon с 0.379. Ни в одной другой области ни одна модель из рейтинга не имеет такого преимущества.
Вот результаты на всех восьми наборах данных в сравнении с лучшей из остальных 38 моделей на каждом:
| Набор данных | GPT-6.1 Terra | Лучшая другая модель |
|---|---|---|
| УЗИ щитовидной железы (TN5000) | 0.94 | Gemini 3.8 Flash, 0.88 |
| МРТ опухолей головного мозга (Cheng) | 0.90 | Gemma 4 31B, 0.80 |
| Микроскопия клеток крови (TXL-PBC) | 0.89 | Gemini 4 Argon, 0.78 |
| Эндоскопия полипов толстой кишки (Kvasir-SEG) | 0.71 | Семь моделей делят первое место, в том числе Gemini 4 Argon, 0.81 |
| Рентгеновские снимки запястья у детей (GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0.35 |
| Рентген грудной клетки, туберкулёз (TBX11K) | 0.14 | GPT-6 Astra, 0.33 |
| Поражения сетчатки (DDR) | 0.13 | Claude Opus 5.5, 0.13 |
| Стоматологический рентген (DENTEX) | 0.06 | Gemini 4 Argon, 0.21 |
Результат определяют первые три строки, и дело не только в том, чтобы найти нужное место. В TN5000 каждая рамка также содержит метку узла — доброкачественный или злокачественный, — которую должен подтвердить врач. Gemini 4 Argon набирает здесь 0.29, а GPT-6.1 Sol — 0.53. Классы на снимках МРТ головного мозга — менингиома, глиома и опухоль гипофиза; результат Sol — 0.52. В наборе с клетками крови Terra должна классифицировать лейкоциты, эритроциты и тромбоциты.
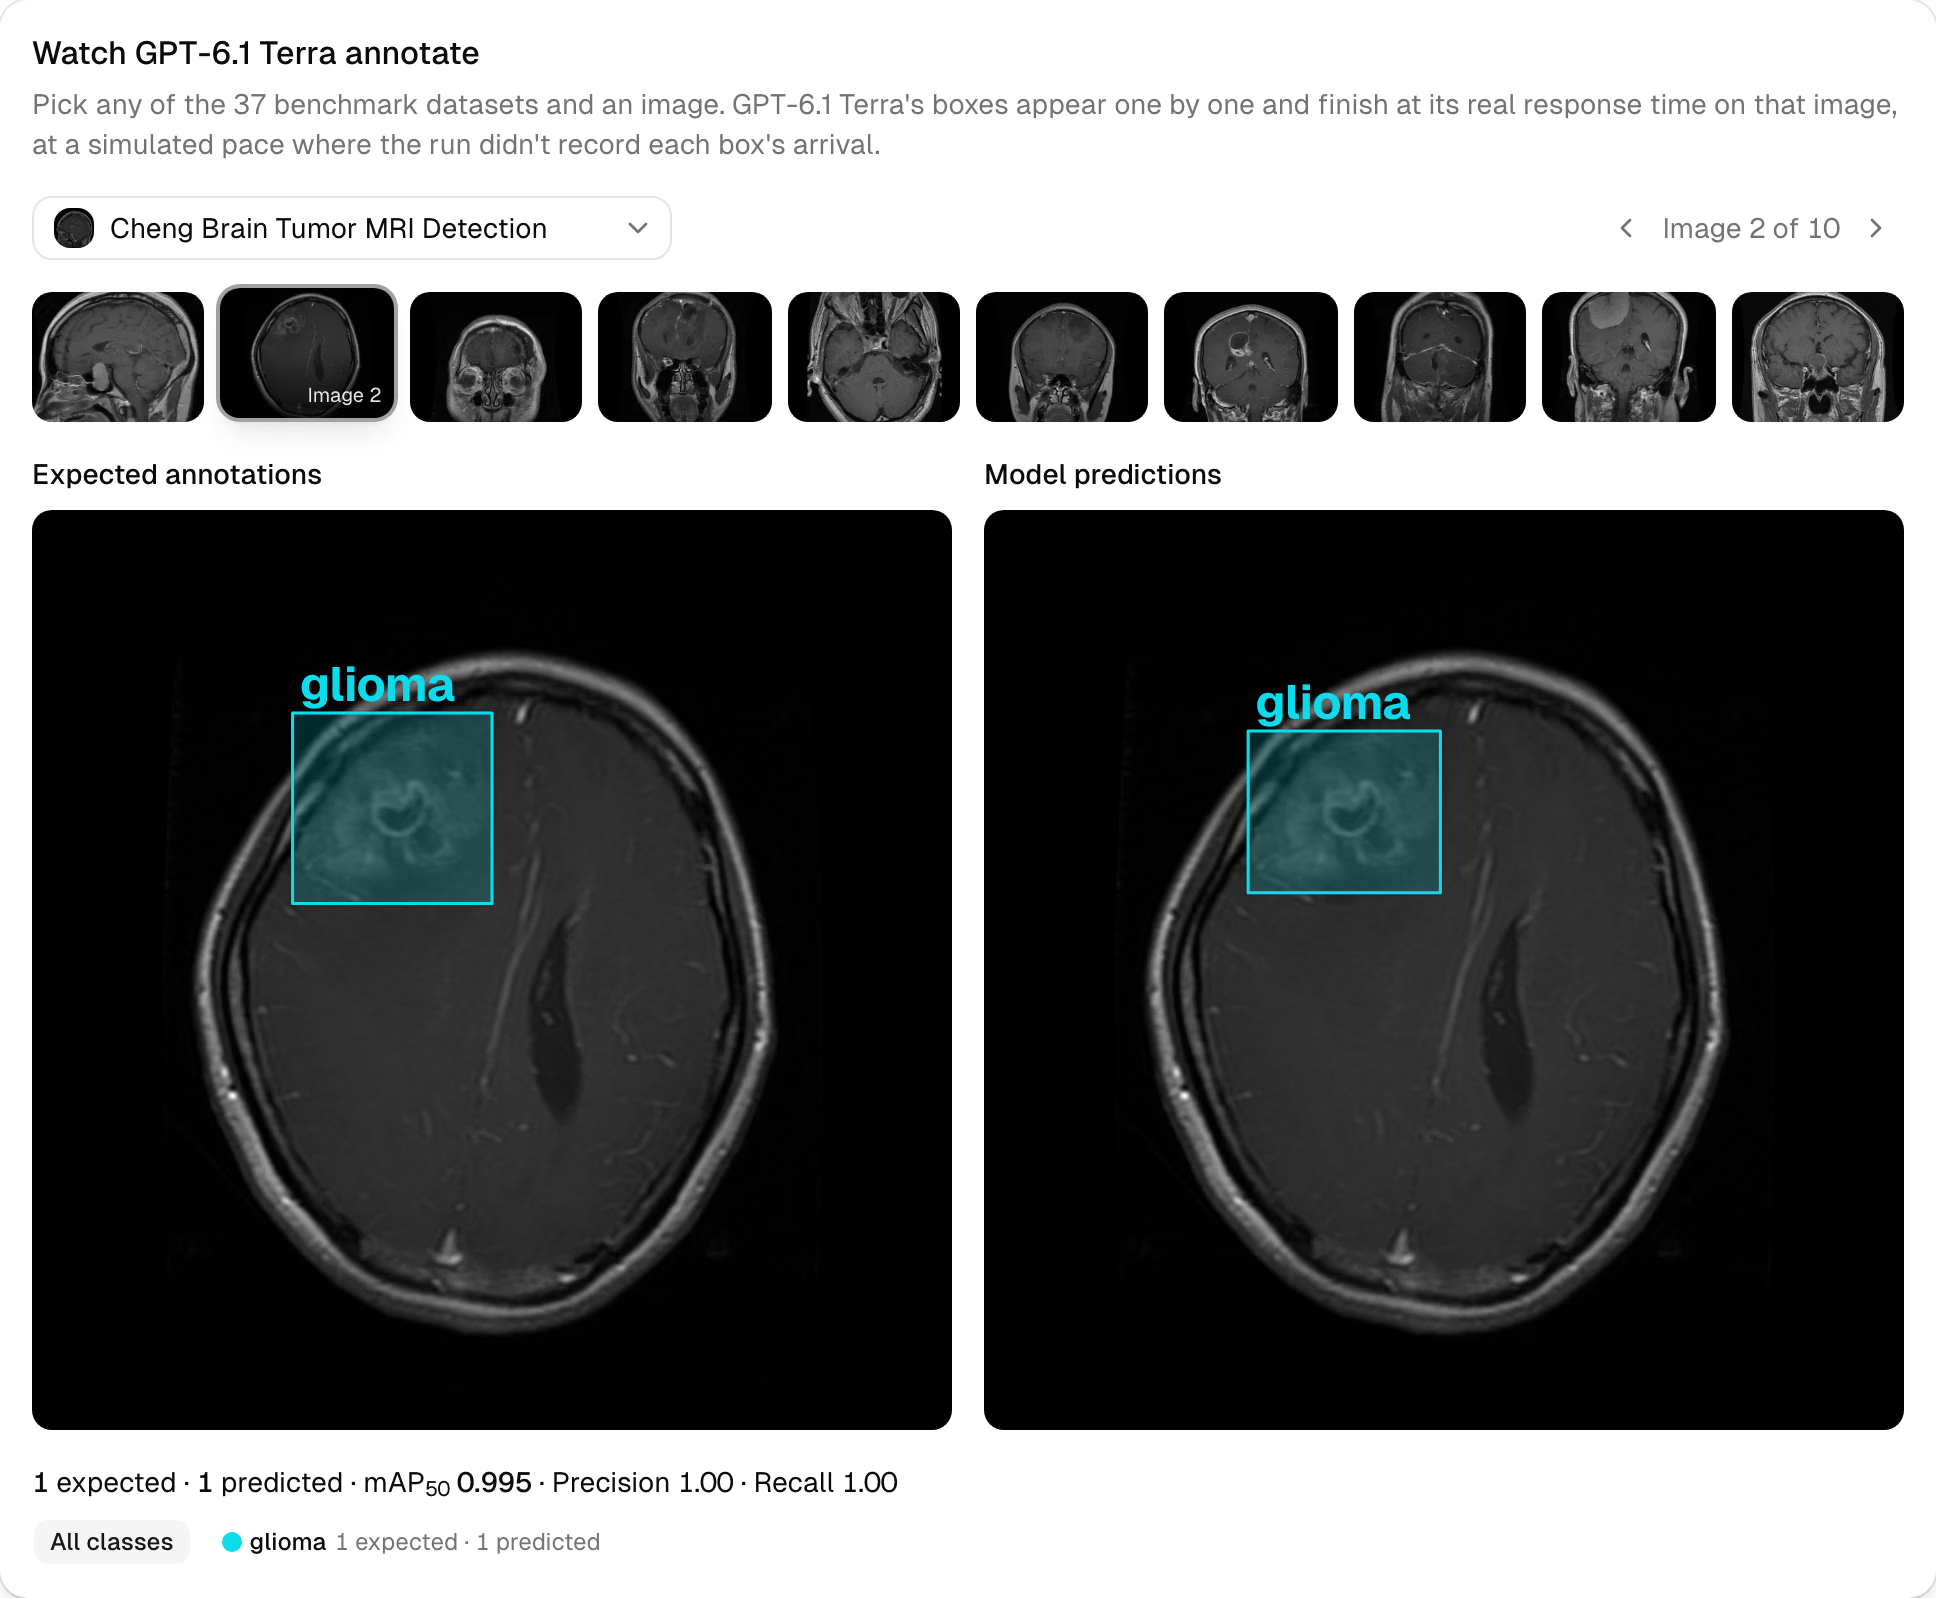
Пример выше, показанный на странице модели Terra, демонстрирует типичное успешное предсказание: одна глиома на снимке МРТ головного мозга, одна рамка Terra, размещённая и размеченная в соответствии с ожидаемой аннотацией.
К этим цифрам стоит добавить два замечания. Во-первых, каждый набор данных включает 10 изображений, поэтому результат на отдельном наборе — повод для проверки, а не окончательный вывод. Во-вторых, речь не идёт о постановке диагноза. Для команды, работающей с анализом медицинских изображений, Terra — быстрый способ подготовить черновые рамки на УЗИ, МРТ и микроскопических изображениях, которые затем проверят, исправят и утвердят медицинские специалисты. Такая проверка с участием человека — основа рабочего процесса, а не дополнительная опция.
Где GPT-6.1 Terra уступает: рентгеновские снимки и печатные платы#
В нижней части таблицы прослеживается явная закономерность. На каждом наборе данных с рентгеновскими снимками в UL37 — медицинскими и другими — лучше справляется другая модель. Terra уступает лидеру на рентгеновских снимках запястья у детей, грудной клетки и зубов, а на рентгеновских снимках для досмотра результат ещё хуже: 0.00 на IEDXray, тогда как Gemini 4 Argon набирает 0.30.
На IEDXray Terra ошибается сильнее всего. На снимках этого набора изображены ноутбуки, телефоны, пейджеры, батареи и самодельные устройства; Terra не смогла правильно поставить ни одной рамки.
Ещё одна слабая сторона — печатные платы. Средний результат Terra на наших промышленных наборах данных с печатными платами — 0.13, а GPT-6.1 Sol набирает 0.39. На DeepPCB, где представлены дефекты голых плат — обрывы цепей, короткие замыкания, выкусы и заусенцы, — результат Terra составляет 0.03 против 0.39 у Sol. Для данных проверки печатных плат лучше выбрать Sol от OpenAI.
Прежде чем размечать большой набор данных в любой из этих областей, открой страницу модели GPT-6.1 Terra. На ней воспроизводятся записанные предсказанные рамки Terra на всех 36 наборах данных бенчмарка и COCO рядом с ожидаемыми рамками, а также указан результат модели на каждом наборе.
GPT-6.1 Terra против Gemini 4 Argon: результаты ближе, чем кажется по рейтингу#
Gemini 4 Argon возглавляла рейтинг до появления Terra, и разрыв между моделями невелик. Terra показывает лучший результат на 19 наборах данных, Argon — на 16, ещё на одном у них ничья.
Большую часть преимущества Terra в 0.023 даёт один набор данных. На снимках УЗИ щитовидной железы из TN5000 Terra набирает 0.94, а Argon — 0.29. Если исключить этот набор данных, средние результаты составят 0.549 у Terra и 0.544 у Argon — практически одинаково. Первое место Terra заслужено, но во многом оно обусловлено медицинскими изображениями.
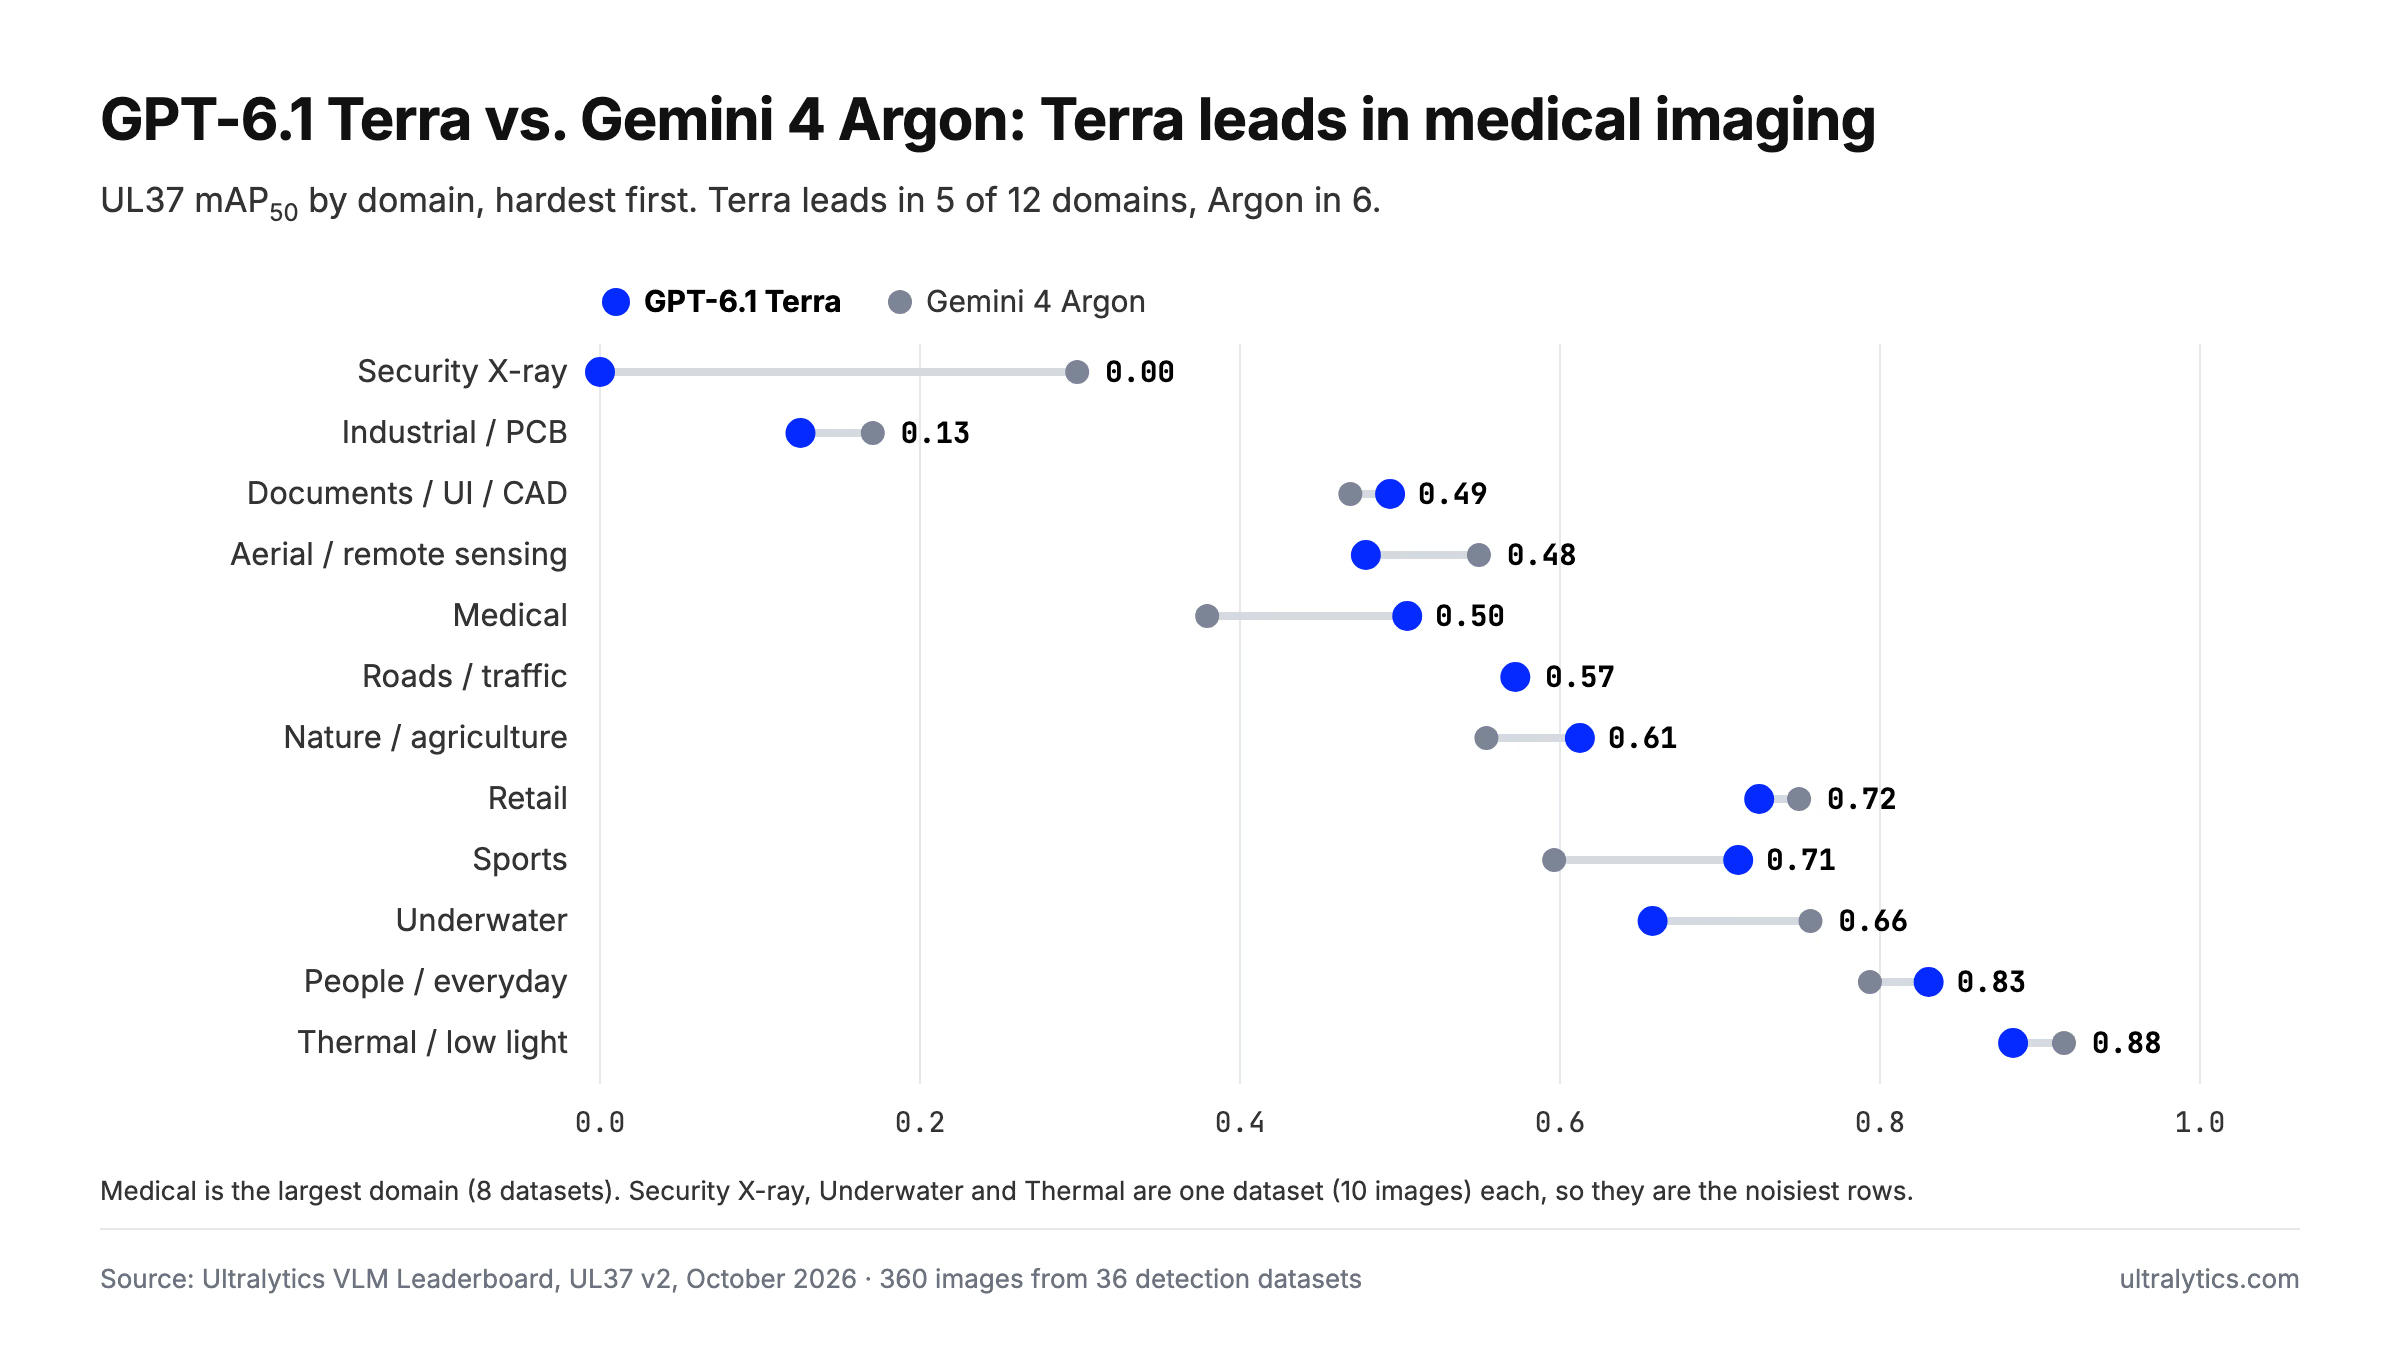
В разрезе областей Terra лидирует в пяти и занимает первое место среди всех 39 моделей в двух из них: медицине, а также документах, интерфейсах и CAD. Argon лидирует в шести областях и сохраняет первенство в категориях аэрофотоснимков, подводных и тепловизионных изображений. В категории дорог и транспортной обстановки — ничья.
Кроме того, модели допускают разные ошибки. Точность Argon немного выше: 0.667 против 0.646, а Terra находит больше объектов: её полнота составляет 0.613 против 0.585. При начальной цене Google Terra стоит $4.36 на 1 000 изображений против $7.60 у Argon. Argon немного быстрее: 4.6 с на изображение.
Практический вывод: выбирай Terra для медицинских изображений, документов и спортивных снимков. Для аэрофотоснимков, подводных, тепловизионных изображений и снимков для досмотра выбирай Argon. В нашем материале о результатах авторазметки Gemini 4 Argon подробнее рассказывается о её возможностях.
Сколько стоит пакетная обработка GPT-6.1 Terra#
$4.36 на 1 000 изображений — это счёт провайдера, рассчитанный по опубликованному OpenAI расходу токенов и стандартным тарифам. На одно изображение в среднем приходится около 1 300 входных и 370 выходных токенов. За пакетную разметку Platform взимает плату за обработку в размере $1.00 на 1 000 изображений, поэтому обработка 1 000 изображений обойдётся примерно в $5.36.
Ещё три детали результатов:
- Ни одного сбоя запросов. Все запросы Terra в бенчмарке завершились в пределах 115-секундного лимита Platform. У GPT-6.1 Sol не удалось обработать 2 изображения, а у GPT-6 Astra — 4.
- Исходные рамки уже точны. До уточнения с помощью SAM 3.1 рамки Terra набирают 0.559 mAP50. После уточнения показатель достигает 0.560, то есть практически всю работу выполняет сама модель.
- Настраивать ничего не нужно. Модели хватило стандартного запроса OpenAI и уровня рассуждений по умолчанию.
Если бюджет важнее последних пунктов точности, есть варианты дешевле. Claude Haiku 5.5 набирает 0.429 и стоит $0.37 на 1 000 изображений, а Gemini 3.5 Flash-Lite набирает 0.380 за $1.77. Для размещённых моделей, таких как Qwen3.8 27B, Gemma 4 26B и SAM 3.1 Text, ключ API не нужен. Он не нужен и для твоих собственных моделей Ultralytics YOLO.
От ключа OpenAI до размеченного набора данных#
GPT-6.1 Terra — модель детекции, использующая подсказки с названиями классов; она подходит для наборов данных с числом классов от 1 до 200. Модель возвращает ограничивающие рамки с названиями классов из твоего набора данных, а ты проверяешь их перед сохранением. Чтобы начать:
- Создай ключ на странице ключей API OpenAI.
- Добавь его в разделе Настройки > Ключи API рабочего пространства Platform, в котором хранится твой набор данных. OpenAI выставляет счёт напрямую, Ultralytics не добавляет наценку на токены. Подробности смотри в документации по ключам провайдера.
- В редакторе разметки переключись в режим Smart и выбери GPT-6.1 Terra в разделе OpenAI в списке моделей.
- Нажми Predict или
P, чтобы разметить текущее изображение. Перед масштабированием попробуй модель на нескольких изображениях, характерных для твоих данных. - Когда результат тебя устроит, перейди на страницу набора данных и выбери Другие действия > Пакетная разметка, чтобы разметить сразу все изображения без аннотаций. Перед этим Platform сохраняет версию набора данных, чтобы ты мог откатиться.
- Проверь и сохрани рамки, а затем обучи модель Ultralytics YOLO26 на полученном наборе данных в том же рабочем пространстве. В документации по обучению процесс описан пошагово.
Подробнее о том, как эти модели используются в редакторе, читай в статье как Ultralytics Platform автоматизирует разметку с помощью ИИ и в нашем вводном материале о визуально-языковых моделях.
Кому стоит перейти на GPT-6.1 Terra#
Сделай GPT-6.1 Terra своей основной платной моделью для разметки данных детекции объектов общего назначения. Это самая точная модель из тех, что мы тестировали, самая дешёвая среди шести лидеров, и во время нашего тестирования ни один запрос не завершился с ошибкой.
Эта модель особенно хорошо подходит для создания черновой разметки на УЗИ, МРТ и микроскопических изображениях, которые затем проверят специалисты, а также на плотных магазинных полках, где быстро накапливаются ложные рамки. Для рентгеновских снимков любого типа и дефектов печатных плат лучше выбрать другую модель: здесь лучше справляются Gemini 4 Argon, GPT-6 Astra или GPT-6.1 Sol.
Если ты сейчас платишь за Sol или Astra только ради разметки изображений, перейти будет просто: Terra выдаёт более точные рамки, обходясь менее чем в половину стоимости Sol.
Часто задаваемые вопросы
Да. На нашем бенчмарке UL37 средний результат GPT-6.1 Terra по 36 реальным наборам данных для детекции составляет 0.560 mAP50 — это лучший показатель среди 39 моделей в рейтинге VLM Ultralytics. По более строгой метрике mAP50-95 модель также занимает первое место с результатом 0.345. Её самые слабые области — рентгеновские изображения и дефекты печатных плат.
По результатам нашего бенчмарка — да. Terra набирает 0.560 mAP50 против 0.514 у Sol, обходит её на 22 из 36 наборов данных, стоит $4.36 на 1 000 изображений против $10.30 и работает примерно вдвое быстрее. Для детекции дефектов печатных плат Sol остаётся лучшим вариантом OpenAI.
Terra лидирует с результатом 0.560 против 0.537 mAP50 и стоит дешевле за изображение, но разрыв невелик: Terra выигрывает на 19 наборах данных, Argon — на 16, ещё на одном у них ничья. Без набора данных TN5000 со снимками УЗИ щитовидной железы их результаты почти одинаковы. Выбирай Terra для медицинских изображений и документов, а Argon — для аэрофотоснимков, подводных, тепловизионных изображений и рентгеновских снимков для досмотра.
Около $4.36 за услуги OpenAI по тарифам провайдера: $1 за миллион входных токенов и $5 за миллион выходных токенов. Пакетная аннотация в Ultralytics Platform стоит дополнительно $1.00 за обработку 1 000 изображений. Ты платишь OpenAI напрямую со своим API-ключом.
Это самая сильная модель на восьми наших медицинских наборах данных: средний показатель mAP50 составляет 0.505, а лучшие результаты модель показывает на УЗИ щитовидной железы, МРТ опухолей мозга и микроскопических изображениях клеток крови. На рентгеновских снимках модель справляется значительно хуже, а при эндоскопии полипов толстой кишки уступает другим моделям. Используй её для подготовки рамок, которые затем проверят специалисты, но никогда не используй её для диагностики.
Нет. Platform вызывает модель с установленным по умолчанию в OpenAI средним уровнем усилий при рассуждении, используя тот же запрос на создание рамок, что и для всех моделей OpenAI, а затем SAM 3.1 уточняет каждую рамку. В нашем тесте медианное время обработки запроса составило 5.1 секунды, и ни один запрос не завершился с ошибкой.









