GPT-6.1 Terra otomatik anotasyonda 1. sıraya yerleşti ve OpenAI'nin kendi amiral gemisi modellerini geride bıraktı
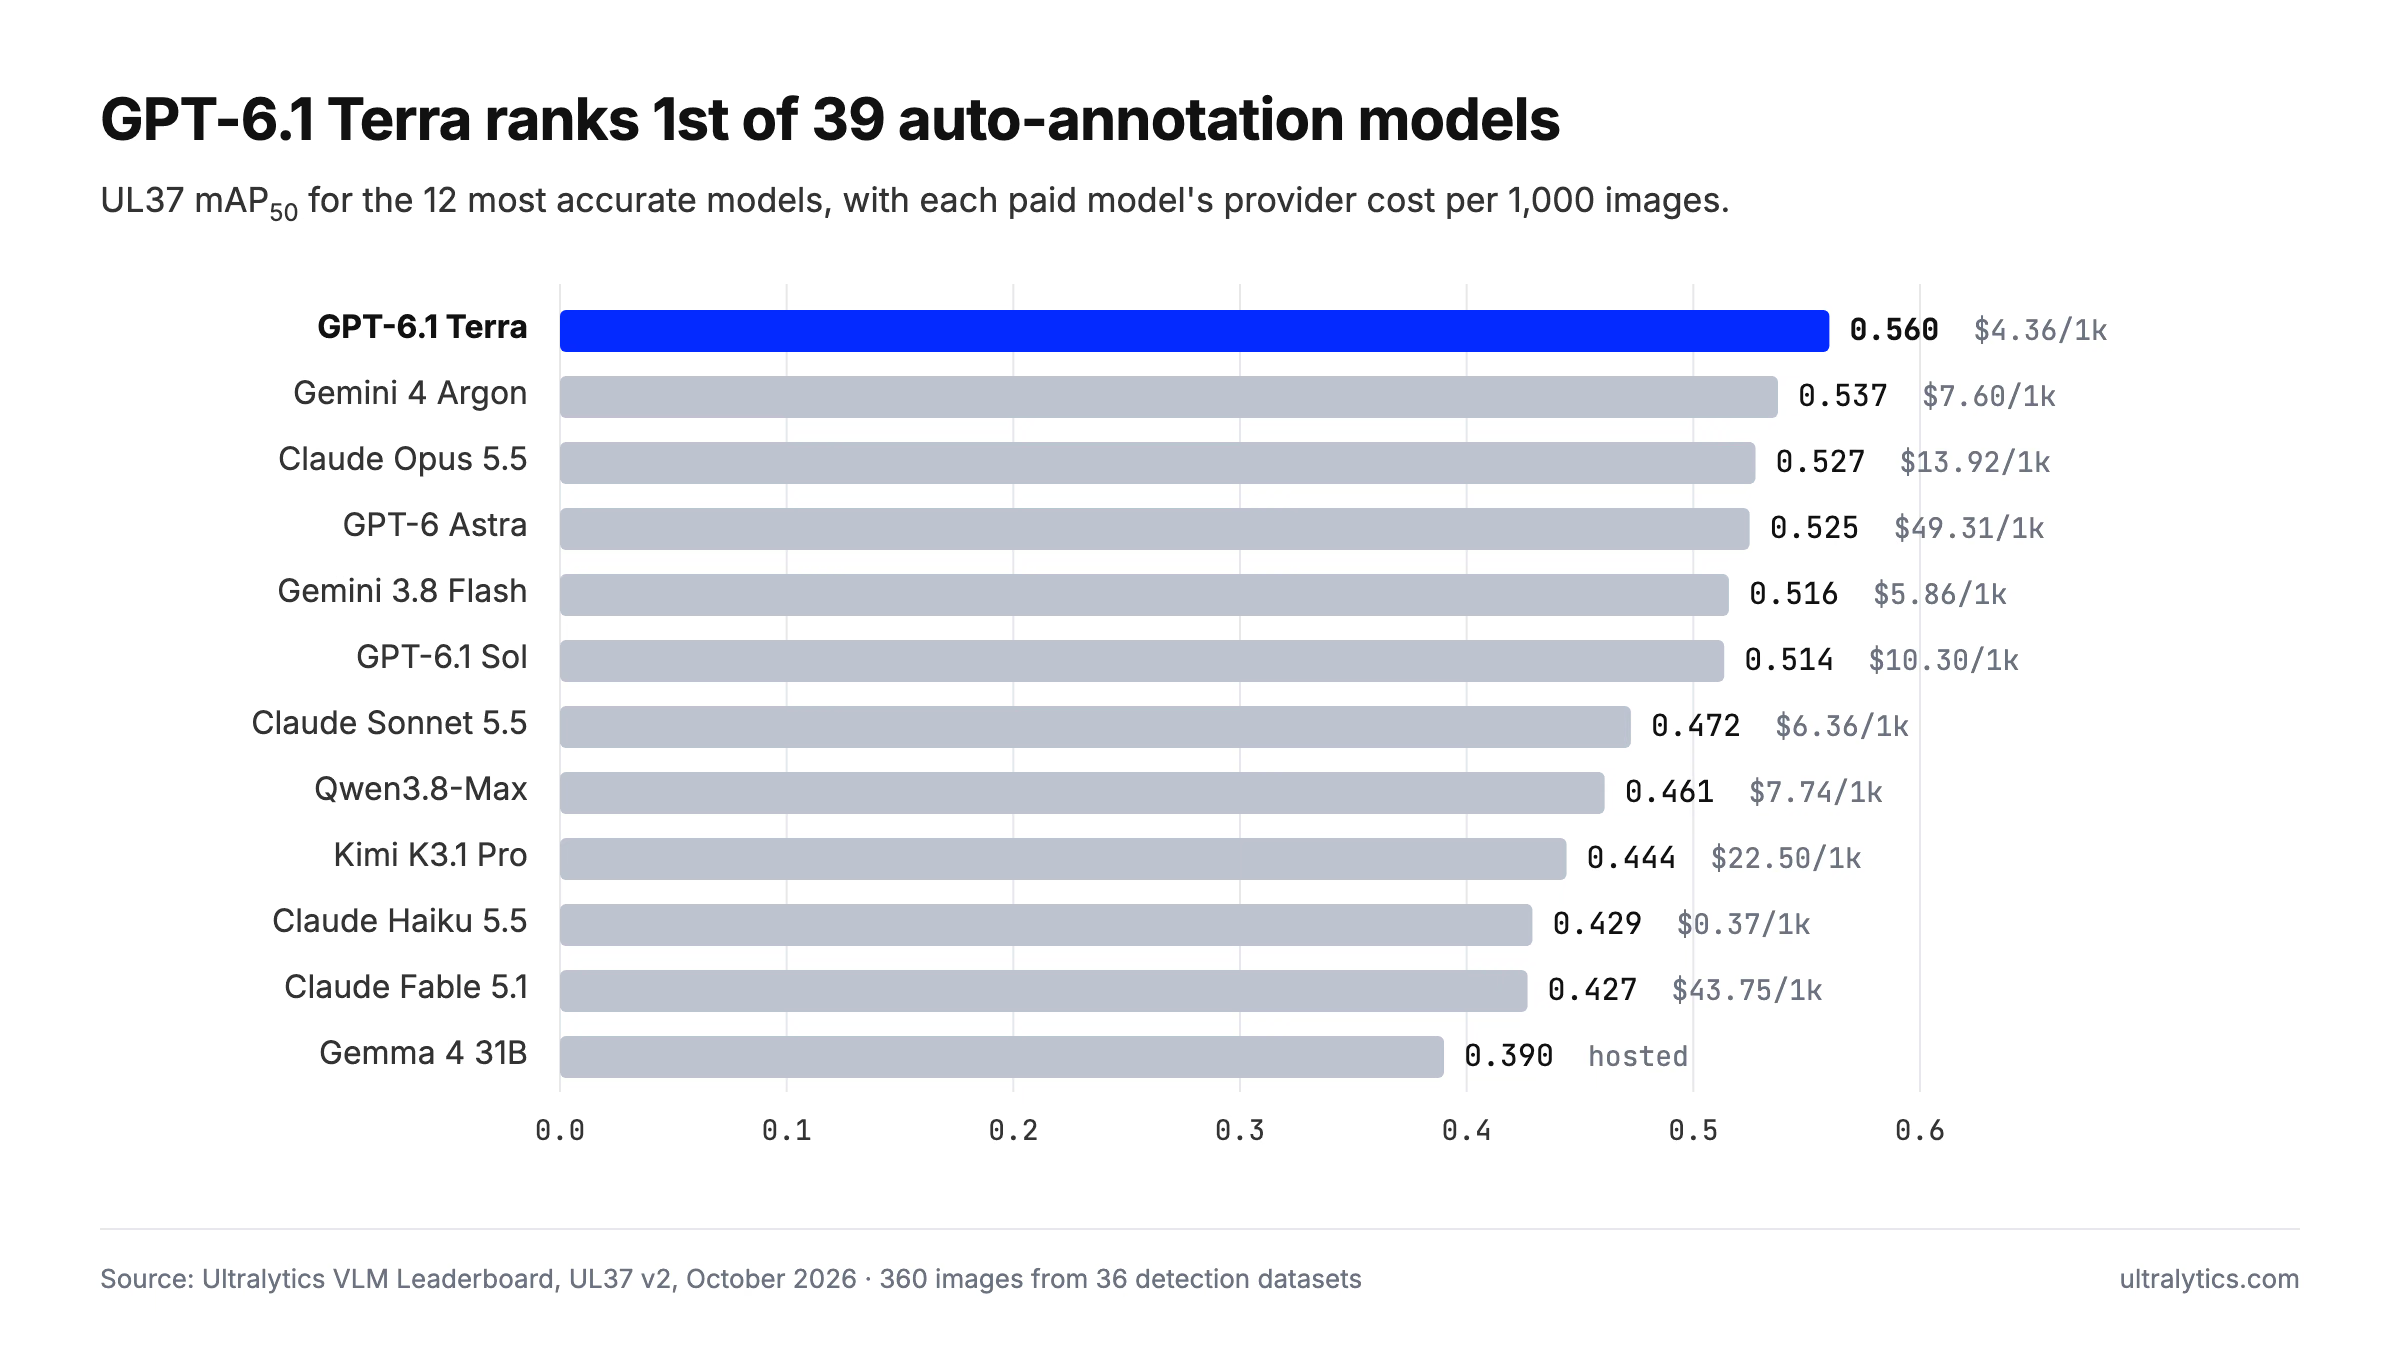
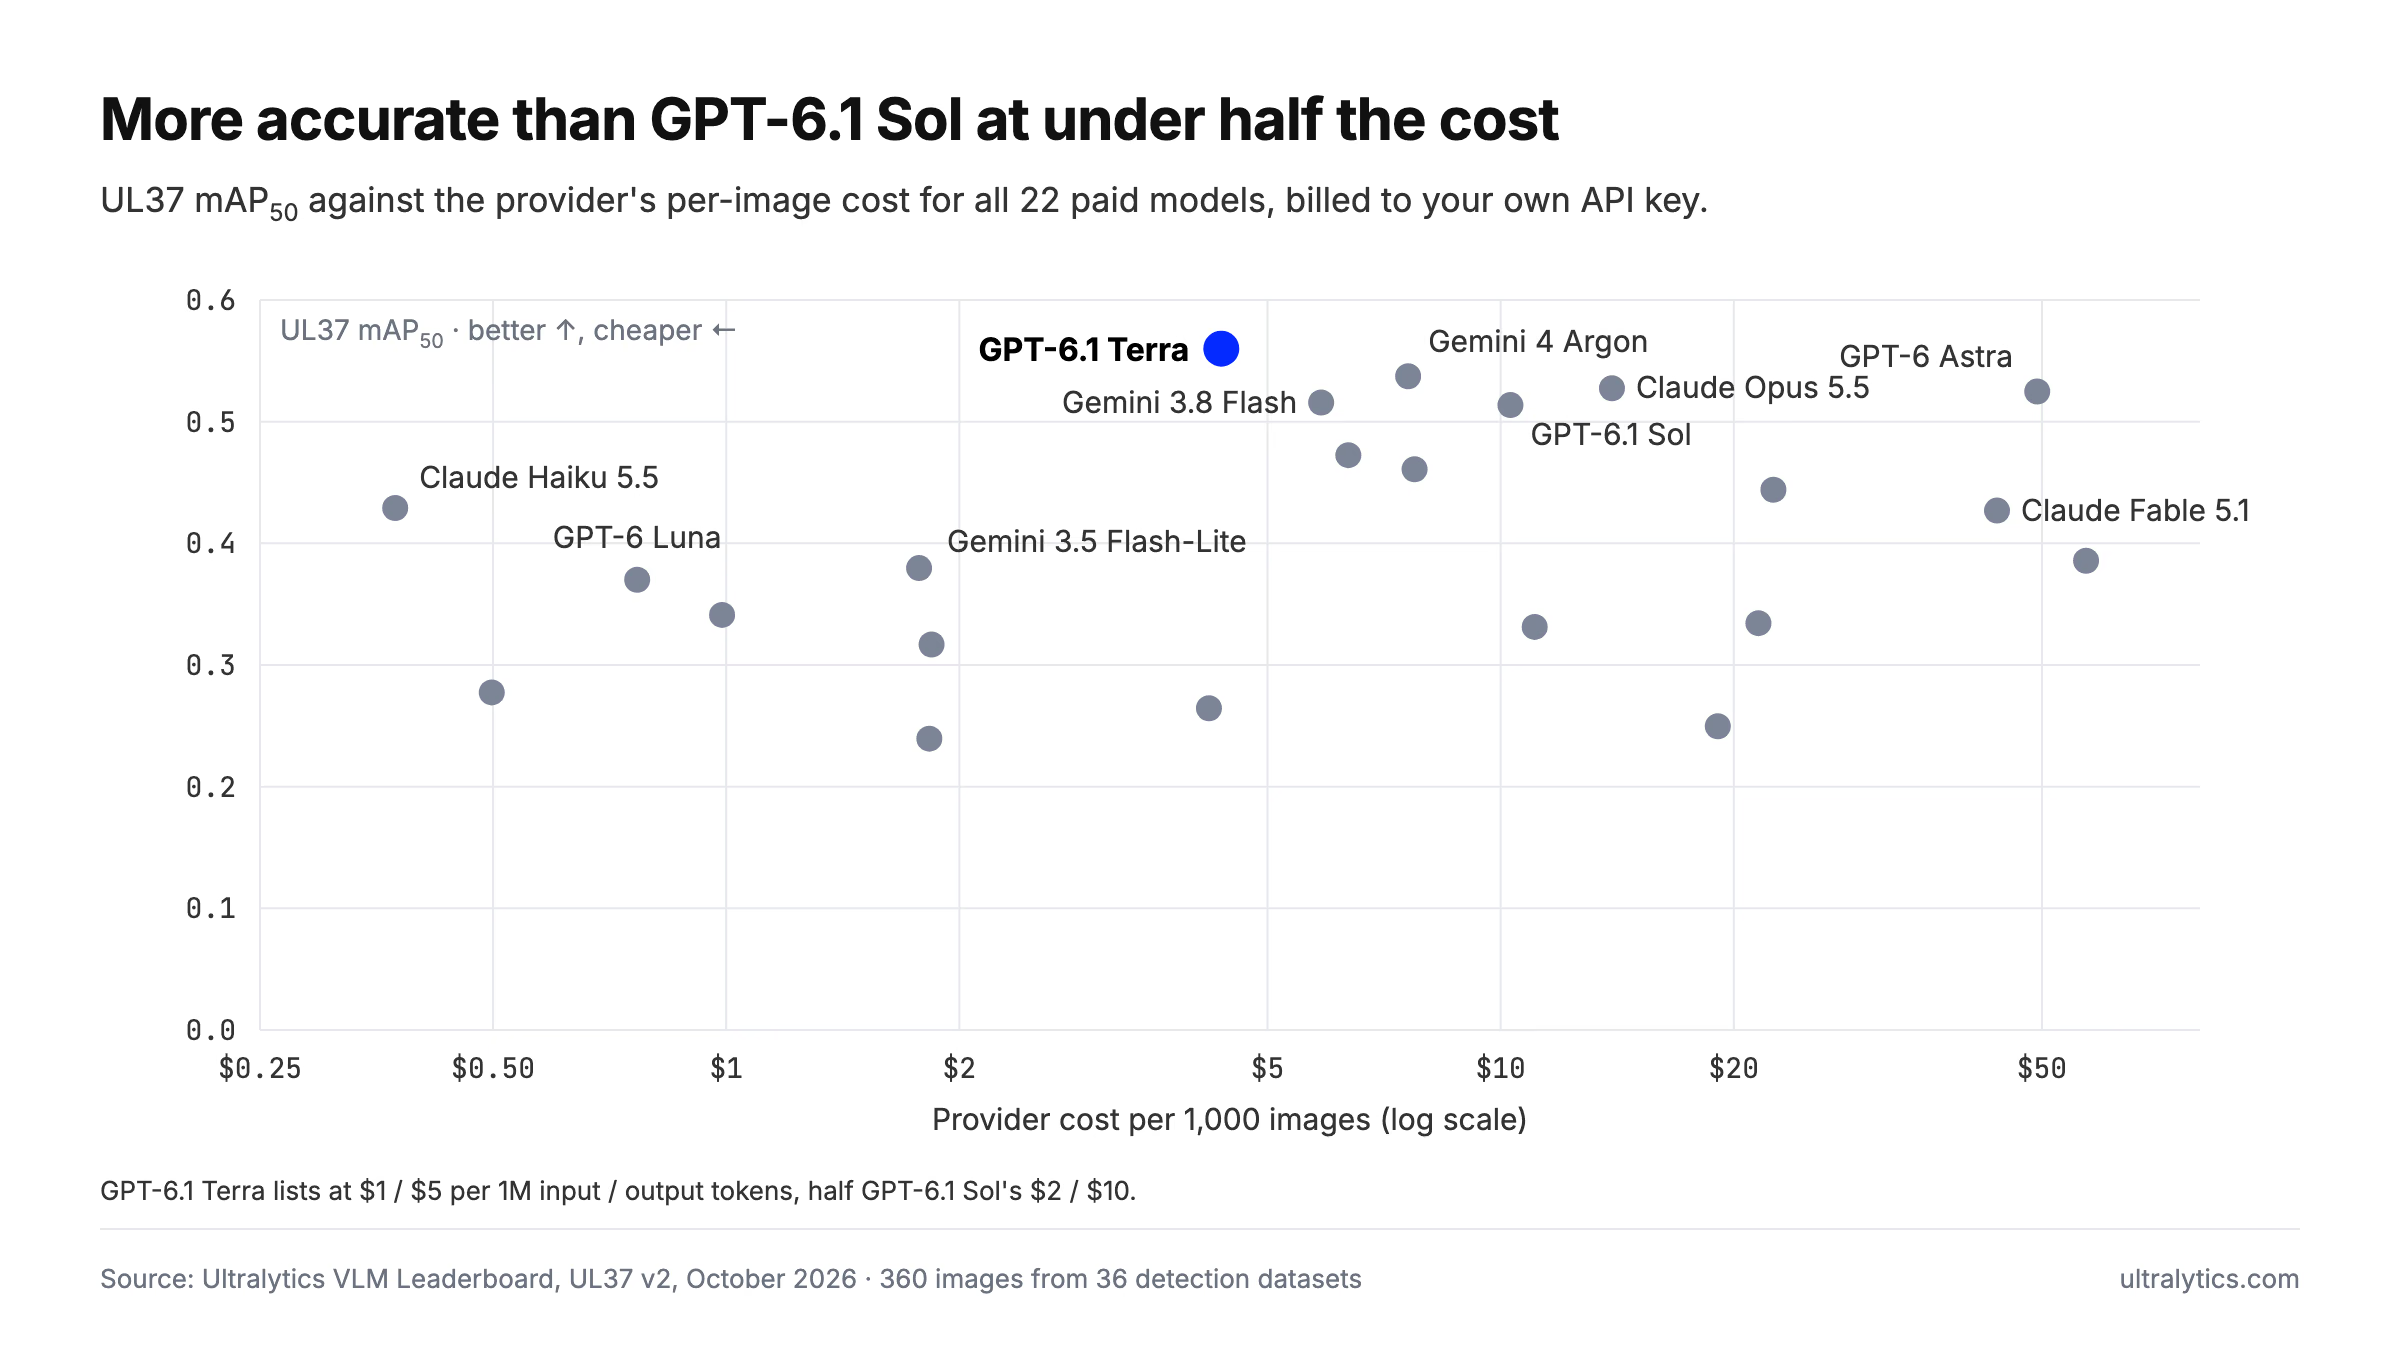
GPT-6.1 Terra otomatik anotasyonda Liderlik Tablomuzdaki 39 modeli geride bıraktı: 1.000 görüntü başına 4,36 $ maliyetle 0,560 mAP50; GPT-6.1 Sol ve Gemini 4 Argon'un önünde.
OpenAI'nin lansman materyallerinde GPT-6.1 Terra'nın görsel akıl yürütmede kendisinden büyük kardeşleriyle neredeyse aynı seviyede olduğu söyleniyor. Ondan sınırlayıcı kutular çizmesini istediğimizde, “neredeyse” sözcüğünün yanlış olduğu ortaya çıktı.
GPT-6.1 Terra otomatik anotasyonunu, OpenAI'nin yayımladığı gün olan 26 Ekim 2026'da, 36 veri kümesinden oluşan nesne tespiti kıyaslamamızdan UL37'ye dahil ettik. 0,560 mAP50 puanıyla VLM Liderlik Tablomuzdaki 39 modelin tamamı arasında en iyi sonucu aldı. OpenAI'nin orta fiyatlı modeli GPT-6.1 Sol'u, amiral gemisi GPT-6 Astra'yı ve bu haftaya kadar ilk sırada olan Gemini 4 Argon'u geride bıraktı.
Bunu 1.000 görüntü başına 4,36 $ maliyetle, görüntü başına 5,1 saniyede ve tek bir başarısız istek olmadan başardı. Bugün Ultralytics Platform üzerinden kullanabilirsin. Aşağıda hangi alanlarda öne çıktığını, nerelerde zorlandığını ve etiketleme iş akışına uygun olup olmadığına nasıl karar vereceğini bulabilirsin.
GPT-6.1 Terra, UL37'de ilk sırada#
UL37, bir modelin kutularının 360 görüntüdeki insan etiketleriyle ne kadar örtüştüğünü ölçer: gerçek hayattaki 36 nesne tespiti veri kümesinin her birinden 10 görüntü; bu veri kümeleri tıbbi taramaları, hava görüntülerini, perakende raflarını, spor etkinliklerini, belgeleri, devre kartlarını ve daha fazlasını kapsar. Her görüntü, Platform kullanıcılarının yararlandığı üretim hattının aynısından geçirilir; veri kümesinin kendi sınıf adları kullanılır ve SAM 3.1 her kutuyu hassaslaştırır. Metodoloji herkese açıktır.
Terra'nın puan tablosu şöyle:
- mAP50: 0,560, 39 model arasında 1. sıra
- mAP50-95: 0,345; yine 1. sırada. Bu, kutularının yalnızca kabaca değil, hassas biçimde oturduğu anlamına geliyor.
- Kesinlik ve duyarlılık: 0,646 ve 0,613
- Sağlayıcı maliyeti: 1.000 görüntü başına 4,36 $
- Görüntü başına medyan süre: 5,1 sn
- Başarısız istekler: yok
UL37'de altı model 0,51'in üzerinde puan alıyor; üçüncü sıradaki Claude Opus 5.5 da bunlardan biri. Terra bu altı model arasında en isabetlisi ve aynı zamanda en ucuzu.
Bu sonucun arkasında herhangi bir ayar bulmacası yoktu. Terra, model belgelerinde orta olarak belirtilen varsayılan akıl yürütme eforuyla çalışıyor. Platform'daki diğer tüm OpenAI modelleriyle aynı isteği alıyor ve kutu koordinatları 0–1000 ölçeğinde veriliyor. Modeli ekledik ve doğrudan zirveye çıktı.
OpenAI'nin amiral gemisi modellerinden daha yüksek puan alan orta fiyatlı bir model#
OpenAI, GPT-6.1 Terra'yı ürün ailesinin hızlı ve verimli orta segment modeli olarak konumlandırıyor. The Decoder ve BleepingComputer lansman haberlerine göre model, GPT-5.6 Terra'nın yerini alıyor ve bilgisayar kullanımını, görsel akıl yürütmeyi, kodlamayı ve günlük işleri hedefliyor. API'de gpt-6.1-terra adıyla, ayrıca Plus, Pro, Enterprise ve Edu kullanıcıları için ChatGPT Work ve Codex'te mevcut. OpenAI'nin belgelerinde model “görsel akıl yürütme, hassas bilgisayar kullanımı ve açık, doğal yazım için hızlı ve verimli bir model” olarak tanımlanıyor; metin ve görüntü girdisini ve 1.050.000 tokenlık bağlam penceresini destekliyor.
Fiyatlandırma, milyon girdi tokenı başına 1 $ ve milyon çıktı tokenı başına 5 $; önbelleğe alınmış girdi içinse 0,05 $. OpenAI'nin GPT-6.1 Sol ve GPT-6 Astra sayfalarına göre bu, GPT-6.1 Sol'un 2 $ ve 10 $ fiyatlarının yarısı, GPT-6 Astra'nın 10 $ ve 50 $ fiyatlarının ise onda biri.
OpenAI'nin lansman kıyaslamaları, Terra'yı daha büyük kardeşlerinin üstünde değil, onlara yakın gösteriyor. Görsel akıl yürütme testi olan MMMU-Pro'da OpenAI, Terra'nın Astra ve Sol'la neredeyse aynı seviyede olduğunu bildiriyor. Terminal-Bench 4.0'da ise GPT-5.6 Terra'nın %21,5'lik sonucundan %50,3'e çıktığını belirtiyor. En zorlu kodlama işleri için yine Sol veya Astra'yı öneriyor.
Kağıt üzerinde Terra, uzlaşmacı tercih. Kıyaslamamızda ise OpenAI'nin en iyi tespit modeli.
| OpenAI modeli | UL37 mAP50 | 1.000 görüntü başına maliyet | Görüntü başına medyan süre |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5,1 sn |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terra, görüntü başına GPT-6.1 Sol'dan yarıdan daha az, GPT-6 Astra'dan ise onda birden daha az maliyetlidir. Ayrıca her ikisinden de yaklaşık iki kat hızlı yanıt verir. Bire bir karşılaştırmada 36 veri kümesinin 22'sinde Sol'u geçer.
OpenAI, Terra'nın görevleri Sol ve Astra'dan üç kattan daha hızlı tamamladığını söylüyor; bu, aracı iş yükleriyle ilgili bir iddia. Anotasyon farklı bir iş ve burada Sol'dan yaklaşık 2 kat daha hızlı olduğunu ölçtük. Binlerce görüntüyü etiketlerken bu fark yine de önemli.
Terra'nın Sol karşısındaki üstünlüğü kesinlikte#
İki model de etiketlenmiş nesnelerin benzer bir oranını buluyor. Terra'nın duyarlılığı 0,613, Sol'unki 0,618. Fark kesinlikte ortaya çıkıyor: Terra'da 0,646, Sol'da 0,551. Terra'nın kutularının çok daha büyük bir bölümü, doğru etiketle gerçek bir nesnenin üzerine oturuyor.
Farkı SKU110K'de görmek kolay. Görüntülerinde, tamamı tek bir sınıfa ait ürünlerle ağzına kadar dolu süpermarket rafları var. Her iki model de burada benzer duyarlılık değerine ulaşıyor: Terra 0,73, Sol 0,77. Ancak bu raflardaki kesinlik Sol'da 0,49 iken Terra'da 0,79. Sol'un kutularının yaklaşık yarısı yanlış alarm; Terra'da ise bu oran yaklaşık beşte bir. Terra'nın SKU110K'deki 0,62 mAP50 puanı, şimdiye kadar herhangi bir modelin aldığı en yüksek puan.
Bu, veri etiketleme için önemli; çünkü hataların maliyeti aynı değil. Atlanan bir ürün, bir kutu çizmek demek. Yanlış bir kutuysa onlarca doğru kutunun arasından onu bulup silmek demek. Daha az yanlış alarm, incelemeyi yapanlara daha temiz bir ilk taslak sunar.
GPT-6.1 Terra'nın öne çıkan gücü tıbbi görüntüleme#
Terra'nın sonuçlarındaki en belirgin örüntü tıbbi görüntüleme. UL37, sekiz tıbbi veri kümesi içeriyor ve Terra bu veri kümelerinde ortalama 0,505 mAP50 alarak 39 model arasında 1. sıraya yerleşiyor. Sıradaki en iyi sonuçlar 0,387 ile Gemini 3.8 Flash'a, 0,379 ile Gemini 4 Argon'a ait. Liderlik tablosundaki hiçbir model başka bir alanda daha geniş bir farkla önde değil.
İşte sekiz veri kümesinin tamamındaki puanları ve her birinde kalan 38 model arasından en iyi olanlar:
| Veri kümesi | GPT-6.1 Terra | En iyi diğer model |
|---|---|---|
| Tiroid ultrasonu (TN5000) | 0.94 | Gemini 3.8 Flash, 0,88 |
| Beyin tümörü MR'ı (Cheng) | 0.90 | Gemma 4 31B, 0,80 |
| Kan hücresi mikroskopisi (TXL-PBC) | 0.89 | Gemini 4 Argon, 0,78 |
| Kolon polipi endoskopisi (Kvasir-SEG) | 0.71 | Gemini 4 Argon dahil yedi model berabere, 0,81 |
| Çocuk bileği röntgeni (GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0,35 |
| Tüberküloz göğüs röntgeni (TBX11K) | 0.14 | GPT-6 Astra, 0,33 |
| Retina lezyonları (DDR) | 0.13 | Claude Opus 5.5, 0,13 |
| Diş röntgeni (DENTEX) | 0.06 | Gemini 4 Argon, 0,21 |
Sonucun temelini tablonun ilk üç satırı oluşturuyor ve bunların hiçbiri yalnızca doğru yeri bulmaktan ibaret değil. TN5000'de her kutu, klinisyenin doğrulaması gereken türden bir etiket olan nodülün iyi huylu ya da kötü huylu olduğunu da belirtiyor. Gemini 4 Argon burada 0,29, GPT-6.1 Sol ise 0,53 puan alıyor. Beyin MR'ı sınıfları menenjiyom, gliom ve hipofiz tümörü; Sol bu veri kümesinde 0,52 puan alıyor. Kan hücresi veri kümesinde Terra'dan beyaz kan hücrelerini, kırmızı kan hücrelerini ve trombositleri sınıflandırması isteniyor.
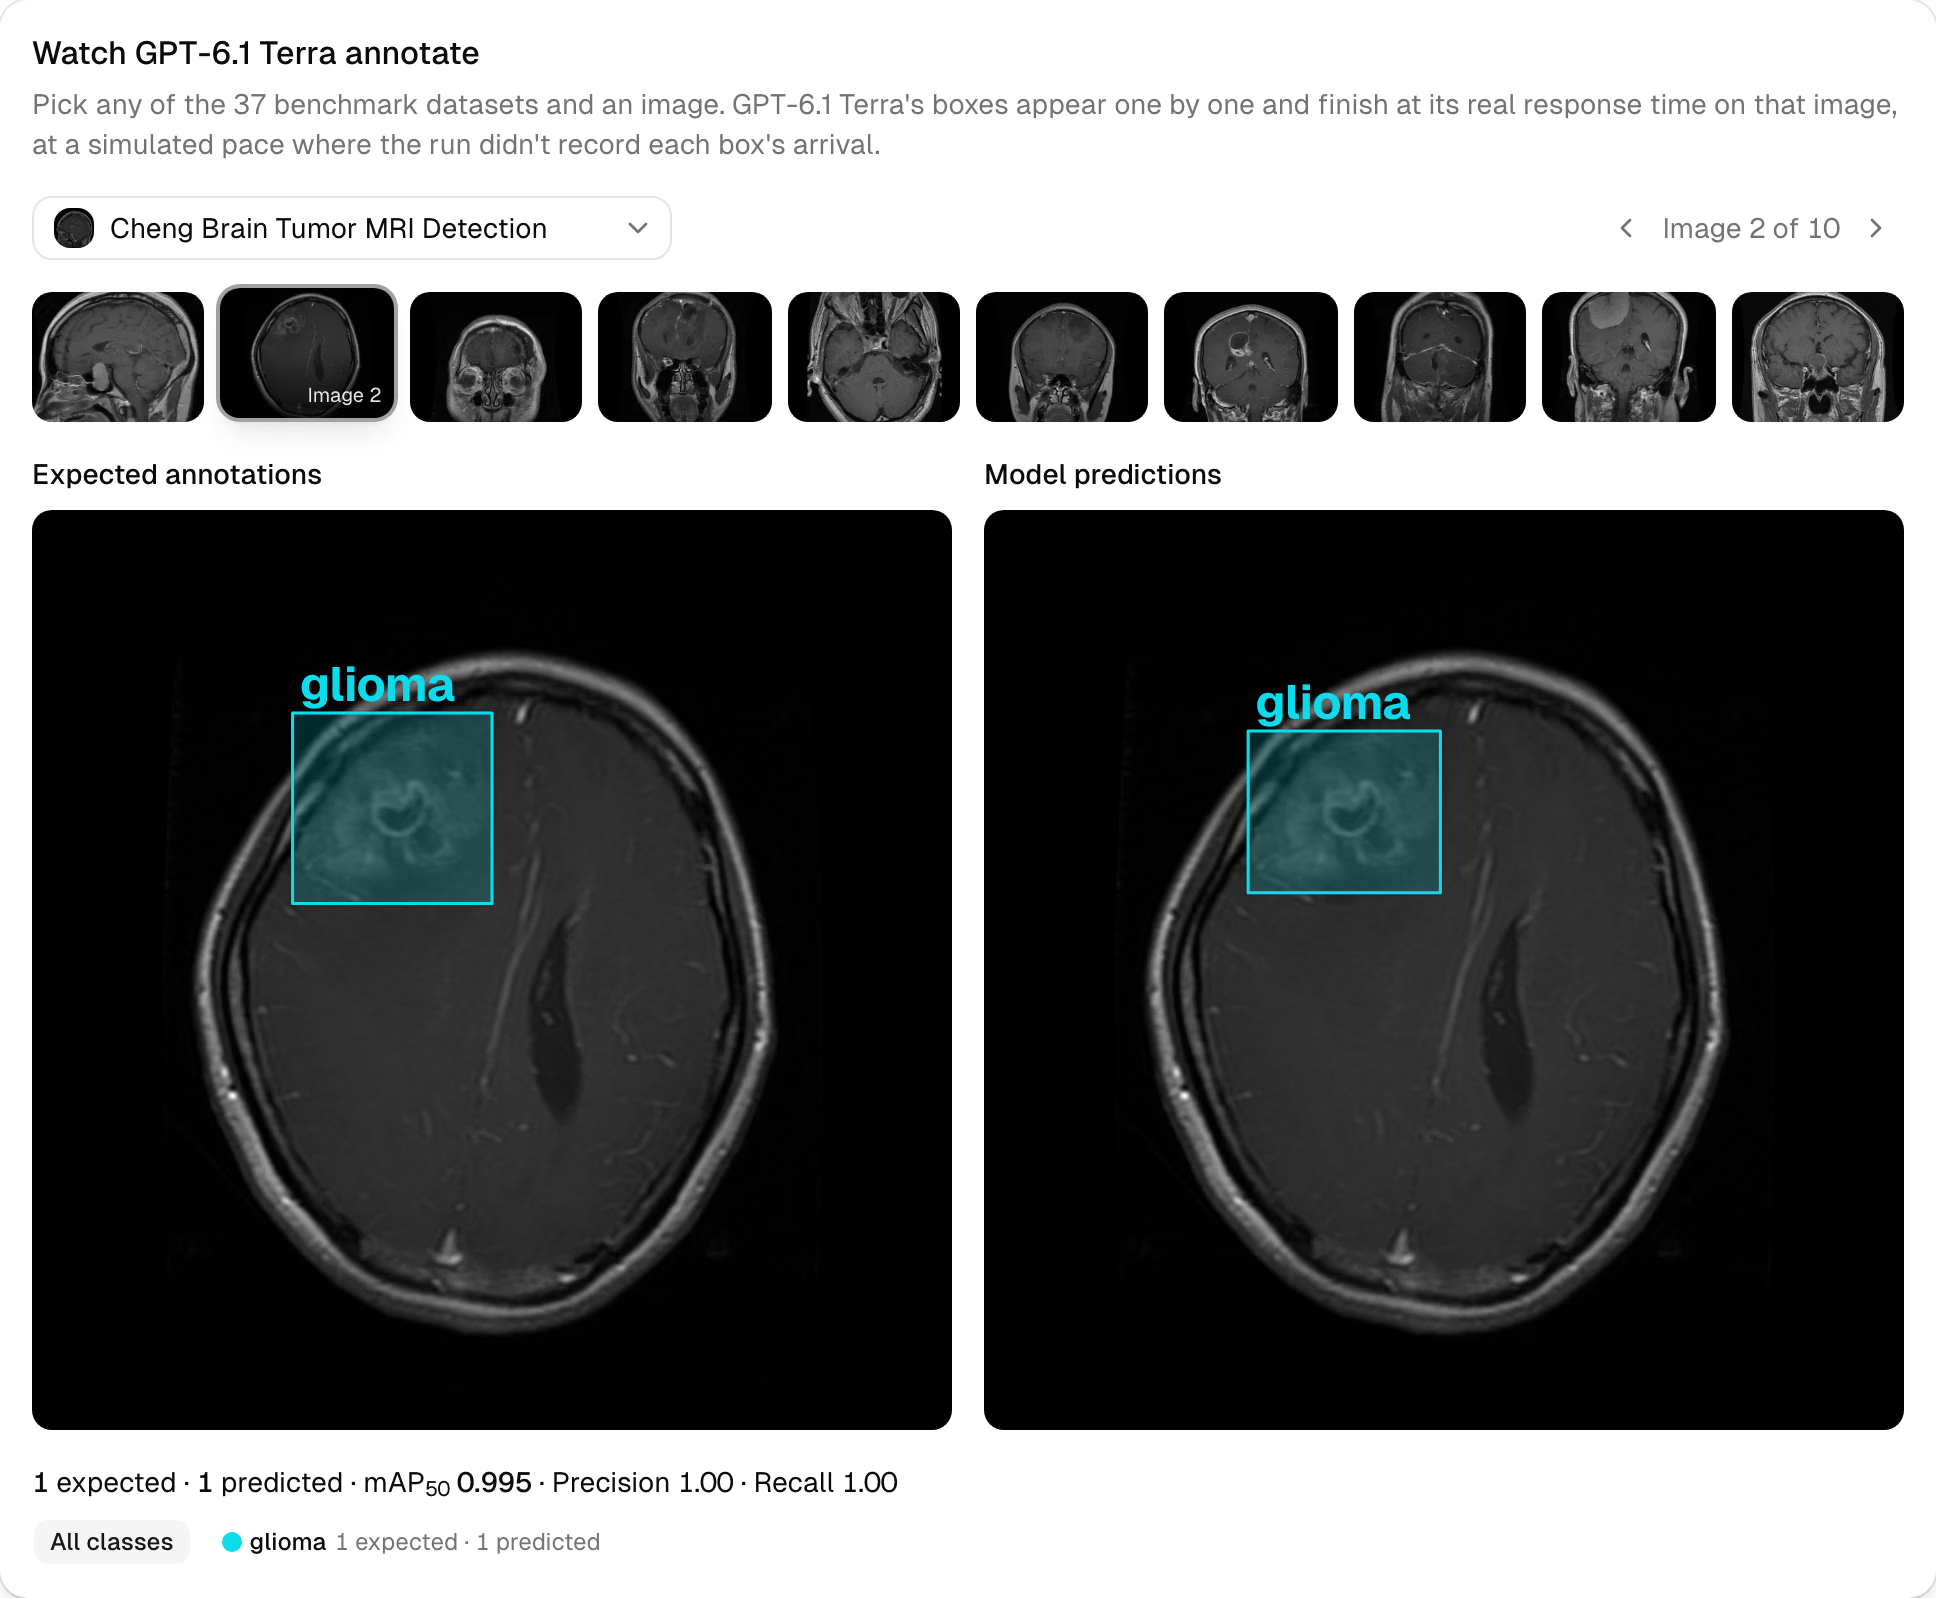
Yukarıdaki, Terra'nın model sayfasından alınan yeniden oynatma tipik bir doğru sonucu gösteriyor: beyin MR'ında bir gliom, Terra'dan beklenen anotasyonla eşleşecek şekilde yerleştirilmiş ve etiketlenmiş tek bir kutu.
Bu sayıların yanında iki önemli uyarı var. Birincisi, her veri kümesinden 10 görüntü kullanılıyor; dolayısıyla tek bir veri kümesinin puanı kesin hüküm değil, araştırılması gereken bir işaret. İkincisi, bunların hiçbiri tanı koyma amacı taşımıyor. Tıbbi görüntü analizi ekibi için Terra; klinik uzmanların daha sonra kontrol edip düzelterek onaylayacağı ultrason, MR ve mikroskopi görüntülerine hızlıca taslak kutular çizmenin bir yolu. Bu iş akışının amacı insan denetimli inceleme; bu, isteğe bağlı bir ek değil.
GPT-6.1 Terra'nın eksik kaldığı alanlar: röntgenler ve devre kartları#
Tablonun alt kısmında belirgin bir örüntü var. UL37'deki her röntgen veri kümesinde, tıbbi olsun olmasın, başka bir model daha iyi sonuç veriyor. Terra; çocuk bileği, göğüs ve diş röntgenlerinde liderin gerisinde kalıyor. Güvenlik röntgenlerinde sonuç daha da kötü: IEDXray'de 0,00 alırken Gemini 4 Argon 0,30'a ulaşıyor.
IEDXray en çarpıcı başarısızlık. Bu taramalarda dizüstü bilgisayarlar, telefonlar, çağrı cihazları, piller ve el yapımı düzenekler yer alıyor; Terra hiçbirinde doğru kutu üretemedi.
Devre kartları diğer kör nokta. Terra, endüstriyel PCB veri kümelerimizde ortalama 0,13 alırken GPT-6.1 Sol 0,39'a ulaşıyor. Açık devre, kısa devre, fare ısırığı ve çapak gibi çıplak kart kusurlarını kapsayan DeepPCB'de Terra 0,03, Sol ise 0,39 puan alıyor. PCB inceleme verileri için Sol, OpenAI'nin daha iyi tercihi.
Bu alanlardan herhangi birinde büyük bir veri kümesini etiketlemeden önce GPT-6.1 Terra model sayfasını aç. Sayfada Terra'nın kaydedilmiş kutuları, 36 kıyaslama veri kümesinin ve COCO'nun tamamında beklenen kutuların yanında yeniden oynatılıyor ve her bir veri kümesine ait puanı gösteriliyor.
GPT-6.1 Terra ve Gemini 4 Argon: sıralamanın düşündürdüğünden daha yakın bir yarış#
Terra gelene kadar liderlik tablosunun başında Gemini 4 Argon vardı ve iki model birbirine yakın. Terra 19 veri kümesinde, Argon 16 veri kümesinde daha yüksek puan alıyor; birinde berabere kalıyorlar.
Terra'nın 0,023 puanlık farkının büyük bölümü tek bir veri kümesinden geliyor. TN5000 tiroid ultrasonunda Terra 0,94, Argon ise 0,29 puan alıyor. Bu veri kümesini hesaptan çıkarınca ortalamalar Terra için 0,549, Argon için 0,544 oluyor; neredeyse aynı seviyedeler. Terra'nın birinciliği gerçek, ancak büyük ölçüde tıbbi görüntülemeye dayanıyor.
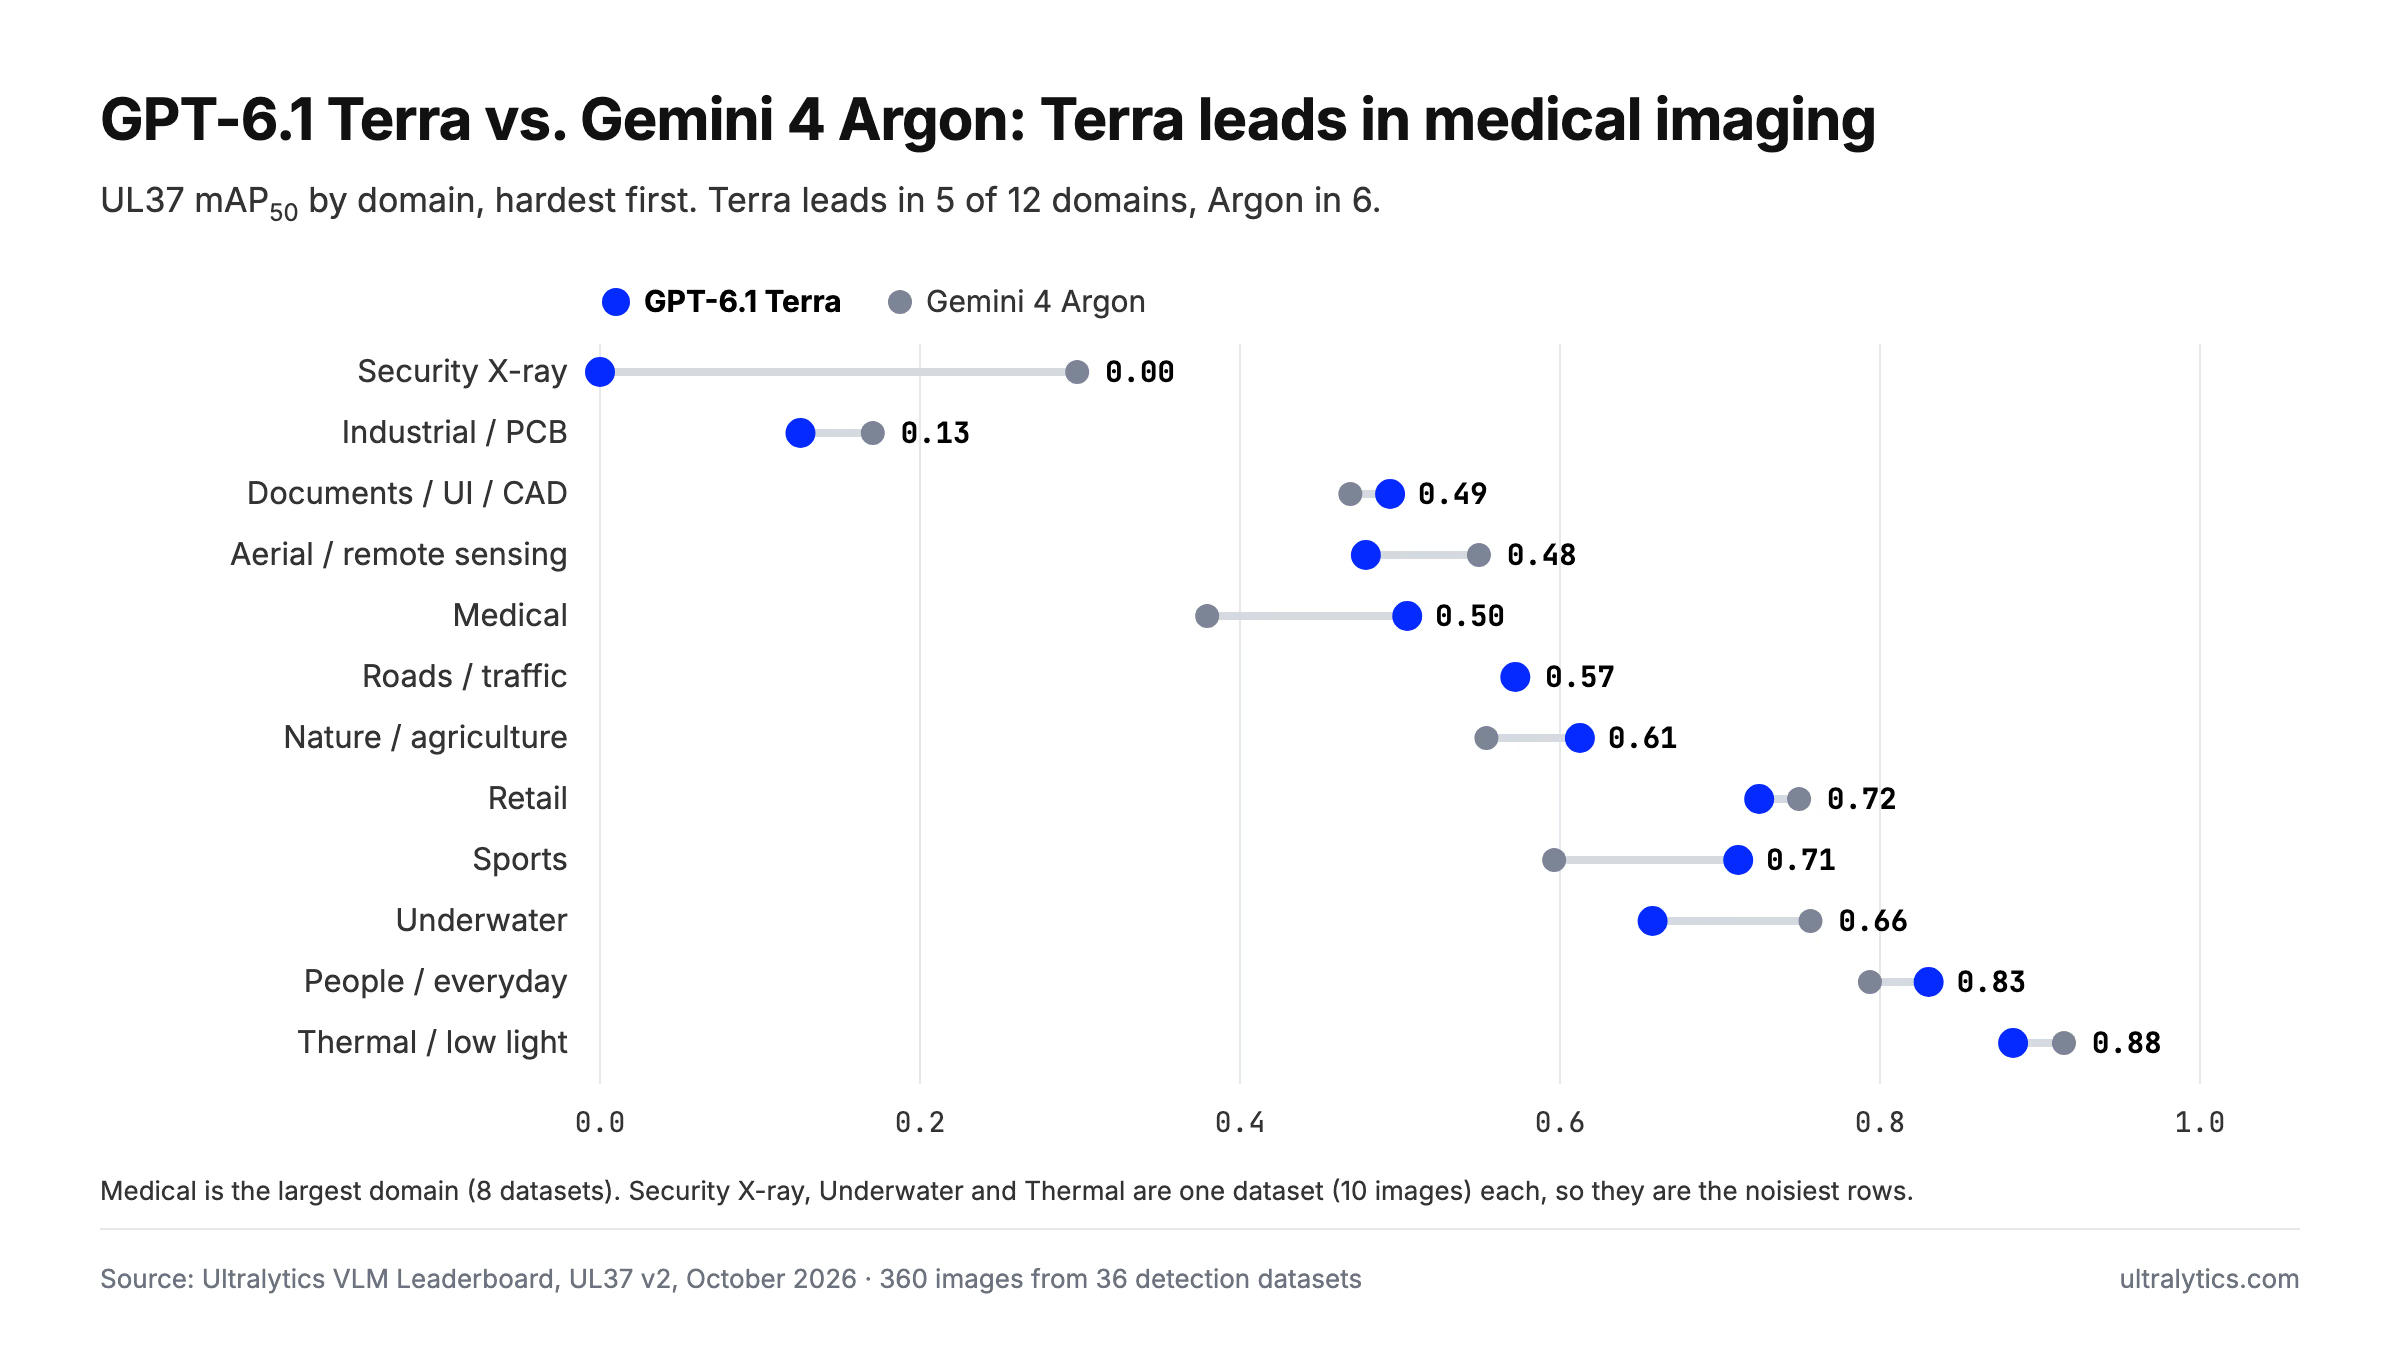
Alanlara göre Terra beşinde önde ve bunların ikisinde 39 modelin tamamı arasında ilk sırada: tıp ve belgeler, kullanıcı arayüzü ile CAD. Argon altı alanda önde ve hava, su altı ve termal kategorilerindeki liderliğini koruyor. Yol ve trafik alanında berabere kalıyorlar.
İki model farklı türde hatalar da yapıyor. Argon'un kesinliği biraz daha yüksek: 0,646'ya karşı 0,667. Terra ise 0,613'e karşı 0,585 duyarlılıkla nesnelerin daha fazlasını buluyor. Google'ın lansman fiyatlandırmasına göre Argon'un 1.000 görüntü başına 7,60 $ maliyetine karşılık Terra 4,36 $ tutuyor. Argon, görüntü başına 4,6 saniyeyle biraz daha hızlı.
Pratik ayrım şöyle: tıbbi, belge ve spor görüntülerinde Terra'yı; hava, su altı, termal ve güvenlik görüntülerinde Argon'u tercih et. Gemini 4 Argon otomatik anotasyon sonuçlarımız Argon'un performansını ayrıntılı olarak ele alıyor.
GPT-6.1 Terra'yla bir işlem grubunun maliyeti#
1.000 görüntü başına 4,36 $, OpenAI'nin bildirdiği token kullanımına ve liste fiyatına göre hesaplanan sağlayıcı ücretidir. Medyan bir görüntü yaklaşık 1.300 girdi ve 370 çıktı tokenı kullandı. Toplu Anotasyon, 1.000 görüntü başına 1,00 $ Platform işlem ücreti ekler; dolayısıyla 1.000 görüntülük bir çalıştırmanın toplam maliyeti yaklaşık 5,36 $ olur.
Çalıştırmadan öne çıkan üç ayrıntı daha:
- Başarısız istek yok. Terra'nın tüm kıyaslama istekleri Platform'un 115 saniyelik sınırı içinde tamamlandı. GPT-6.1 Sol'da 2, GPT-6 Astra'da ise 4 görüntü başarısız oldu.
- Ham kutuları zaten iyi. SAM 3.1 iyileştirmesinden önce Terra'nın kutuları 0,559 mAP50 puan alıyor. İyileştirme bu puanı 0,560'a çıkarıyor; yani işin neredeyse tamamını model kendi başına yapıyor.
- Yapılandırma gerekmiyor. Varsayılan akıl yürütme eforu ve standart OpenAI isteği yeterli oldu.
Bütçe, doğruluktaki son birkaç puandan daha önemliyse daha ucuz seçenekler var. Claude Haiku 5.5, 1.000 görüntü başına 0,37 $ ile 0,429 puan alıyor; Gemini 3.5 Flash-Lite ise 1,77 $ ile 0,380 puan alıyor. Qwen3.8 27B, Gemma 4 26B ve SAM 3.1 Text gibi barındırılan modellerde API anahtarına gerek yok; kendi Ultralytics YOLO modellerin için de gerekmez.
OpenAI anahtarından etiketlenmiş veri kümesine#
GPT-6.1 Terra, 1 ila 200 sınıf içeren tespit veri kümeleri için sınıf istemli bir modeldir. Veri kümenin kendi sınıf adlarıyla sınırlayıcı kutular döndürür; sen de bunları kaydetmeden önce incelersin. Kurulum için:
- OpenAI API anahtarları sayfasında bir anahtar oluştur.
- Anahtarı, veri kümenin bulunduğu Platform çalışma alanında Ayarlar > API Anahtarları bölümüne ekle. Faturalandırmayı doğrudan OpenAI yapar; Ultralytics tokenlara ek ücret uygulamaz. Ayrıntılar için sağlayıcı anahtarı belgelerine bak.
- Anotasyon düzenleyicisinde Akıllı moda geç ve model seçicisinde OpenAI bölümünün altından GPT-6.1 Terra'yı seç.
- Geçerli görüntüyü etiketlemek için Tahmin et düğmesine veya
Pseçeneğine bas. Ölçeği büyütmeden önce verilerini temsil eden birkaç görüntüde dene. - Sonuçtan memnun kaldığında veri kümesi sayfasına git ve etiketlenmemiş tüm görüntüleri aynı anda etiketlemek için Diğer işlemler > Toplu Anotasyon seçeneğini kullan. Platform önce veri kümesinin bir sürümünü kaydeder; böylece önceki sürüme dönebilirsin.
- Kutuları incele, kaydet ve ardından aynı çalışma alanında sonuçla bir Ultralytics YOLO26 modeli eğit. Eğitim belgeleri adımları ayrıntılı olarak açıklar.
Bu modellerin düzenleyiciye nasıl entegre edildiğine daha geniş bir açıdan bakmak için Ultralytics Platform'un anotasyonu otomatikleştirmek üzere yapay zekâyı nasıl kullandığını ve görsel dil modelleri hakkındaki başlangıç yazımızı incele.
GPT-6.1 Terra'yı kimler tercih etmeli#
Genel nesne tespiti etiketlemesinde GPT-6.1 Terra'yı varsayılan ücretli modelin yap. Kıyasladığımız modeller arasında en isabetlisi, ilk altı modelin en ucuzu ve denememizde tek bir isteği bile başarısız olmadı.
Uzman incelemesine gönderilecek ultrason, MR ve mikroskopi görüntüleri için ve yanlış kutuların hızla biriktiği yoğun perakende raflarında özellikle güçlü bir ilk taslak anotatörü. Her türlü röntgen ve PCB kusurları için başka modellere bak; bu alanlarda Gemini 4 Argon, GPT-6 Astra veya GPT-6.1 Sol daha iyi.
Şu anda yalnızca görüntü etiketlemek için Sol veya Astra'ya ödeme yapıyorsan geçiş kolay: Terra, Sol'un maliyetinin yarısından daha azına daha iyi kutular sunuyor.
Sık sorulan sorular
Evet. GPT-6.1 Terra, gerçek dünyadan 36 tespit veri kümesinin ortalamasını alan UL37 kıyaslamamızda 0,560 mAP50 puanıyla Ultralytics VLM Liderlik Tablosundaki 39 model arasında en yüksek sonucu alıyor. Daha sıkı ölçüt olan mAP50-95'te de 0,345 puanla ilk sırada. En zayıf olduğu alanlar röntgen görüntüleri ve devre kartı kusurları.
Kıyaslamamızda evet. Terra 0,560 mAP50, Sol ise 0,514 puan alıyor; Terra 36 veri kümesinin 22'sinde kazanıyor ve yaklaşık iki kat hızlı çalışırken 1.000 görüntü başına 10,30 $ yerine 4,36 $ tutuyor. PCB kusuru tespitinde Sol, OpenAI'nin daha iyi seçeneği olmaya devam ediyor.
Terra 0,560'a karşı 0,537 mAP50 ile önde ve görüntü başına daha ucuz; ancak yarış yakın: Terra 19, Argon 16 veri kümesinde kazanıyor, birinde berabere kalıyorlar. TN5000 tiroid ultrasonu veri kümesi olmadan iki model neredeyse aynı seviyede. Tıbbi ve belge görüntüleri için Terra'yı; hava, su altı, termal ve güvenlik röntgeni görüntüleri için Argon'u seç.
Liste fiyatı olan bir milyon giriş tokenı başına 1 $, bir milyon çıkış tokenı başına 5 $ ve sağlayıcının bildirdiği token kullanımına göre OpenAI ücretleri yaklaşık 4,36 $ tutar. Ultralytics Platform'daki Toplu Etiketleme, her 1.000 görüntü için 1,00 $ işlem ücreti ekler. OpenAI'ye doğrudan kendi API anahtarın üzerinden ödeme yaparsın.
Sekiz tıbbi veri kümemizdeki en güçlü model; ortalama 0,505 mAP50 değerine ulaşıyor ve tiroid ultrasonu, beyin tümörü MRI'ı ve kan hücresi mikroskopisinde en yüksek puanları alıyor. X-ışınlarında çok daha zayıf ve kolon polipi endoskopisinde geride kalıyor. Uzman incelemesi için kutu taslakları oluşturmak üzere kullan; asla tanı aracı olarak kullanma.
Hayır. Platform, modeli OpenAI'nin varsayılan orta akıl yürütme düzeyinde, her OpenAI modeli için kullandığı aynı kutu isteğiyle çağırır ve ardından SAM 3.1 her kutuyu iyileştirir. Kıyaslamamızda isteklerin medyan süresi 5,1 saniyeydi ve hiçbir istek başarısız olmadı.









