So sánh các nền tảng huấn luyện được quản lý với GPU tự lưu trữ cho thị giác máy tính
So sánh các nền tảng huấn luyện GPU được quản lý, dịch vụ ML đám mây, GPU thuê và phần cứng riêng cho thị giác máy tính: chi phí, thiết lập, điểm hòa vốn và thời điểm phù hợp với từng lựa chọn.
 Miles Deans13 phút đọc
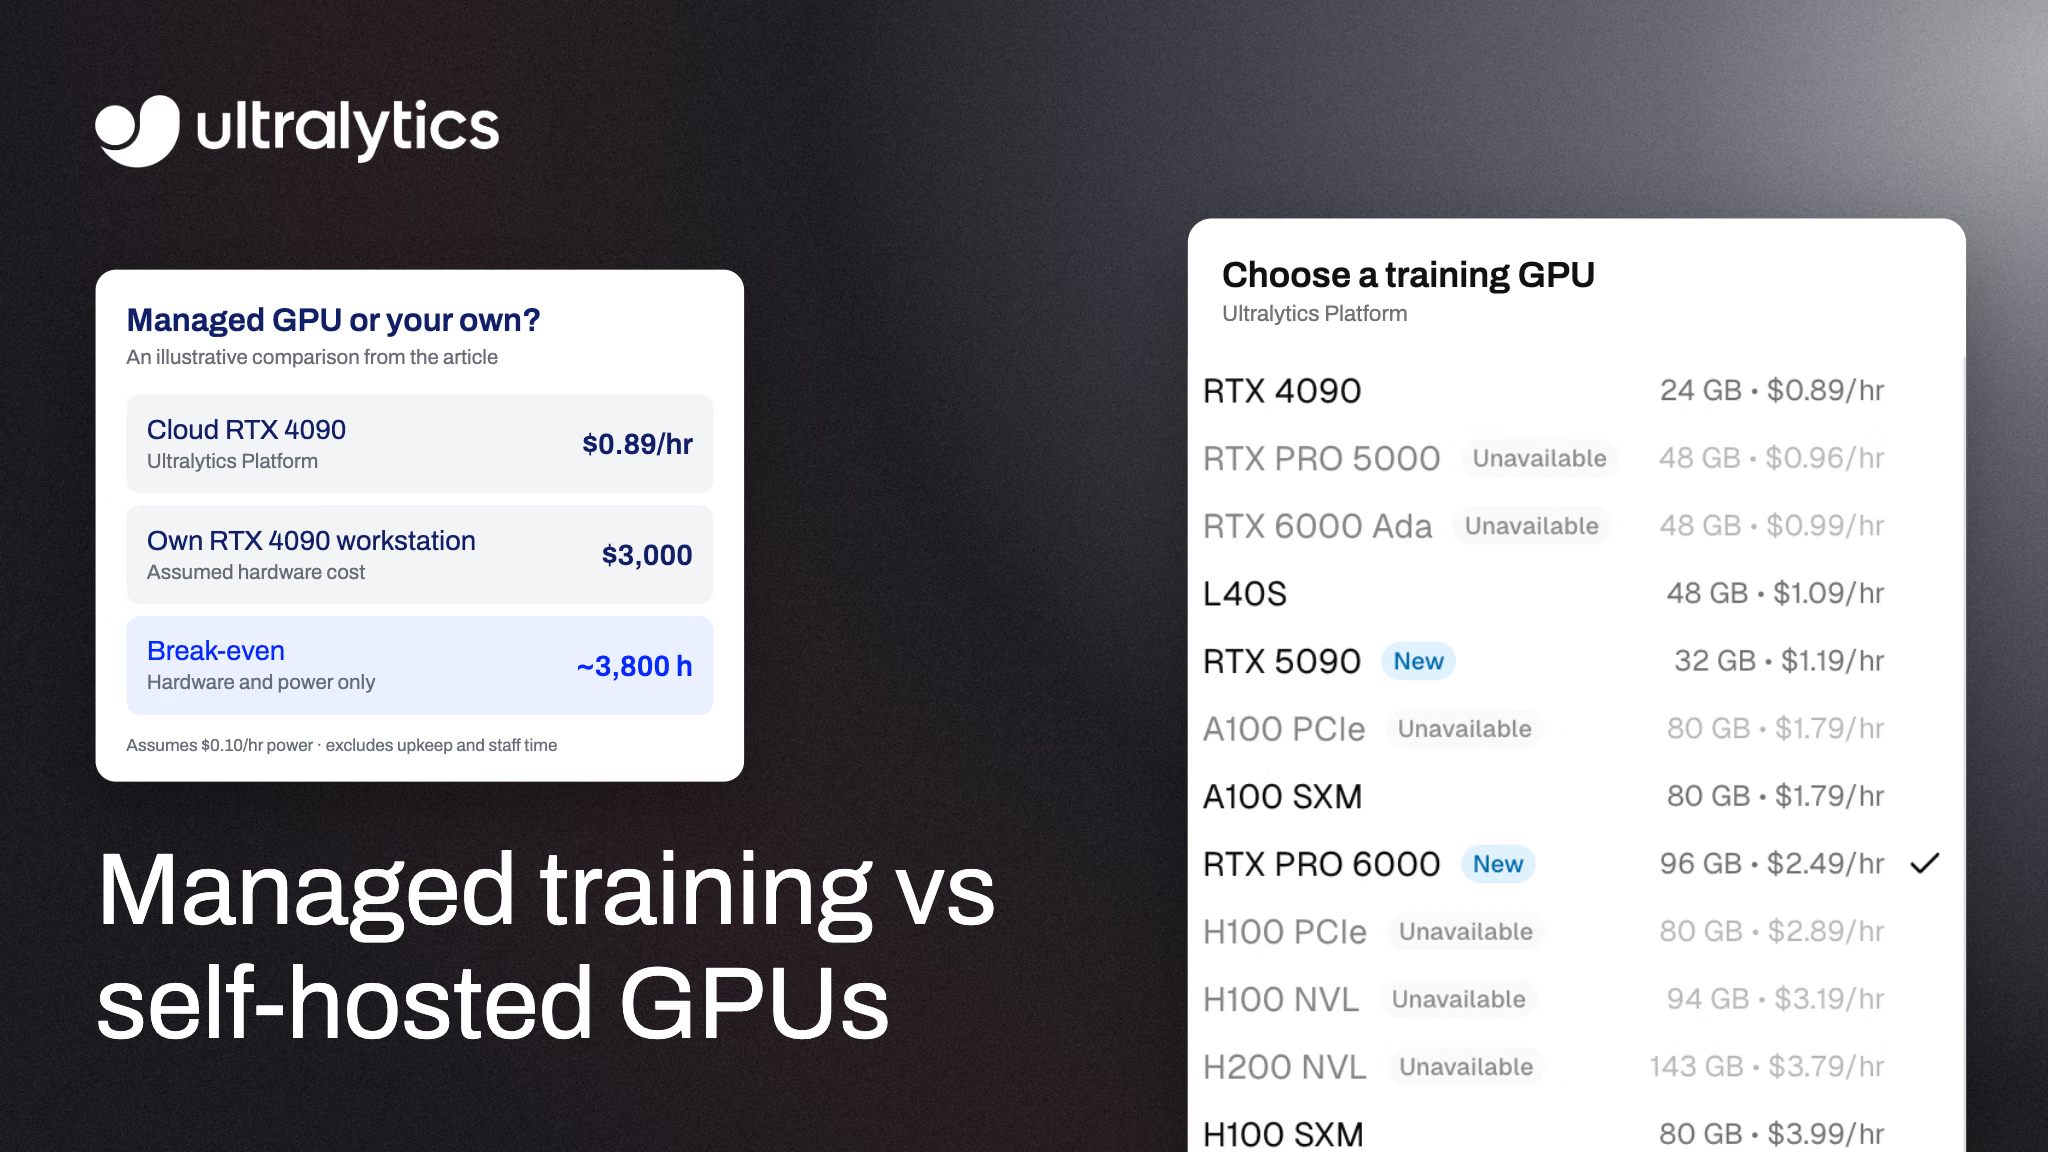
Các nền tảng huấn luyện được quản lý vận hành hạ tầng huấn luyện thay bạn và tính phí theo thời gian sử dụng GPU; với GPU tự lưu trữ, nhóm của bạn chịu trách nhiệm về phần cứng và môi trường, dù bạn thuê máy hay sở hữu chúng. Huấn luyện được quản lý thường phù hợp với khối lượng công việc không liên tục và các nhóm muốn giảm công việc vận hành hạ tầng. Sở hữu GPU có thể giảm chi phí khi mức sử dụng duy trì cao, nhưng kết quả phụ thuộc vào thời gian phần cứng hoạt động, tuổi thọ hữu ích, điện năng và thời gian của đội ngũ kỹ thuật.
Hướng dẫn này so sánh bốn lựa chọn phổ biến để huấn luyện model thị giác vào năm 2026, chỉ cách tính điểm hòa vốn cho khối lượng công việc của riêng bạn và giải thích vị trí của Ultralytics Platform.
Bốn lựa chọn để huấn luyện model thị giác#
Cụm từ “được quản lý hay tự lưu trữ” thường gộp chung bốn mô hình triển khai khác nhau:
- Nền tảng huấn luyện thị giác được quản lý. Bạn tải lên hoặc kết nối dataset, chọn model và GPU, rồi nền tảng sẽ chạy huấn luyện. Ultralytics Platform hoạt động theo cách này với các model YOLO.
- Nền tảng ML đa dụng. Các dịch vụ như Amazon SageMaker, Google Vertex AI và Azure Machine Learning chạy các job huấn luyện trên instance đám mây cho nhiều framework. Bạn cấu hình job huấn luyện, môi trường, quyền và bộ nhớ, còn chi phí điện toán và các dịch vụ liên quan được tính riêng; vì vậy, hãy đối chiếu trang giá chính thức của từng nhà cung cấp thay vì chỉ so sánh đơn giá GPU.
- GPU đám mây thuê. Các dịch vụ GPU đám mây như RunPod và Lambda cho thuê máy tính theo thời gian sử dụng. Trừ khi image của nhà cung cấp đã bao gồm những gì bạn cần, bạn phải thiết lập driver, CUDA, package Python và mã huấn luyện, rồi dừng instance khi hoàn tất.
- GPU của riêng bạn. Máy trạm hoặc server tại văn phòng hay trung tâm dữ liệu. Bạn mua phần cứng một lần và trả chi phí điện, làm mát, bảo trì cũng như thời gian duy trì hoạt động.
So sánh nhanh huấn luyện được quản lý và GPU tự lưu trữ#
| Yếu tố quyết định | Nền tảng thị giác được quản lý | Nền tảng ML đa dụng | GPU đám mây thuê | GPU riêng |
|---|---|---|---|---|
| Có cần mua phần cứng hay không | Không | Không | Không | Có |
| Bạn trả tiền cho | Thời gian sử dụng GPU | Thời gian sử dụng instance và các dịch vụ liên quan | Thời gian instance hoạt động | Phần cứng, điện năng, bảo trì |
| Thiết lập trước lần chạy đầu tiên | Chọn dataset, model và GPU | Cấu hình job, môi trường, quyền và bộ nhớ | Thiết lập hoặc xác minh môi trường, mã và các dependency | Phần cứng, hệ điều hành, driver, package |
| Môi trường huấn luyện | Nền tảng vận hành; bạn chọn các thiết lập | Trách nhiệm được chia sẻ giữa dịch vụ và nhóm của bạn | Phần lớn do nhóm của bạn phụ trách | Đội ngũ của bạn |
| Nâng cấp lên GPU mạnh hơn | Chọn GPU khác trong danh sách hiện có | Chọn loại instance khác | Thuê máy khác | Mua GPU khác |
| Vị trí dữ liệu | Bộ nhớ của nền tảng, bucket đám mây được kết nối (Pro và Enterprise) hoặc dữ liệu tại chỗ (Enterprise) | Tài khoản đám mây của bạn | Nơi bạn sao chép dữ liệu đến | Tại cơ sở của bạn |
| Phù hợp khi | Cần huấn luyện thị giác nhanh và có thể lặp lại | Các nhóm đã chuẩn hóa quy trình trên bộ công cụ ML của một nhà cung cấp đám mây | Kỹ sư thành thạo quản lý máy tính | Huấn luyện ổn định, gần như liên tục hoặc có quy định nghiêm ngặt về dữ liệu tại chỗ |
Cách tính phí huấn luyện GPU được quản lý#
Trên Ultralytics Platform, chi phí GPU của một lượt huấn luyện rất dễ ước tính:
GPU cost = selected GPU hourly rate × billable GPU hoursKhi so sánh các nhà cung cấp, hãy dùng cùng một khối lượng công việc và độ chính xác mục tiêu, đồng thời cộng thêm mọi khoản phí thuê bao, lưu trữ, truyền dữ liệu và thời gian của đội ngũ kỹ thuật.
Ultralytics Platform cung cấp 26 loại GPU NVIDIA với giá từ $0.24/giờ, không yêu cầu mức tối thiểu hay cam kết; gói Free sử dụng được 24 loại, còn Pro và Enterprise sử dụng được cả 26 loại. Một số lựa chọn phổ biến:
| GPU | VRAM | Giá mỗi giờ |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000 (lựa chọn mặc định được đề xuất) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200 (gói Pro và Enterprise) | 180 GB | $7.99 |
Tính phí dựa trên thời gian GPU thực tế. Các lượt chạy hoàn tất, bị hủy và thất bại sau khi GPU khởi động đều bị tính phí theo thời gian GPU đã sử dụng; nếu lỗi xảy ra trước khi GPU khởi động thì không mất phí. Hộp thoại huấn luyện ước tính thời lượng và chi phí trước khi bạn bắt đầu, đồng thời mỗi ước tính giữ lại tối thiểu 15 phút sử dụng GPU trong số dư của bạn; khoản giữ lại này xác định số dư cần có để bắt đầu, còn phí được tính theo thời gian GPU thực tế.
Để dễ hình dung, thời gian huấn luyện điển hình của Ultralytics cho 1.000 ảnh và 100 epoch trên RTX PRO 6000 là khoảng 15 phút với YOLO26m và khoảng 30 phút với YOLO26x. Với giá $2.49/giờ, chi phí GPU tương ứng xấp xỉ $0.62 và $1.25. Thời gian chạy thực tế thay đổi theo kích thước ảnh, augmentation và batch size, vì vậy hãy xem đây là số liệu tham khảo ban đầu, không phải báo giá.
Chi phí thực tế của GPU tự lưu trữ#
GPU bạn sở hữu không có hóa đơn tính theo giờ, nhưng mỗi lượt chạy vẫn phát sinh chi phí. Tổng chi phí bao gồm:
- Phần cứng, cùng với các thành phần khác của máy trạm hoặc server sử dụng GPU.
- Điện năng và làm mát trong mỗi giờ huấn luyện.
- Thời gian của đội ngũ kỹ thuật để xử lý driver, phiên bản CUDA, xung đột package và môi trường bị lỗi.
- Thời gian nhàn rỗi. GPU chỉ huấn luyện hai giờ mỗi ngày sẽ nhàn rỗi trong thời gian còn lại, khiến chi phí trên mỗi giờ huấn luyện tăng tương ứng.
- Giới hạn dung lượng. Khi model cần nhiều VRAM hơn mức bạn có, hoặc cần chạy đồng thời nhiều thử nghiệm, bạn phải chờ hoặc mua thêm phần cứng.
So sánh đơn giản giữa chi phí phần cứng và điện năng, giả định GPU sở hữu có tốc độ huấn luyện bằng GPU đám mây, như sau:
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)Lấy ví dụ minh họa với các con số giả định: máy trạm RTX 4090 có giá $3,000 và điện năng tiêu thụ tốn khoảng $0.10 cho mỗi giờ huấn luyện. So với RTX 4090 có giá thuê $0.89/giờ, máy trạm đạt điểm hòa vốn sau khoảng 3,800 giờ huấn luyện: tương đương khoảng 5.3 tháng sử dụng liên tục 24/7, hoặc 15.8 tháng nếu dùng tám giờ mỗi ngày. Con số này chưa bao gồm làm mát, điện năng khi nhàn rỗi, sửa chữa, chi phí tài chính, giá trị bán lại và thời gian của bạn; việc sở hữu chỉ có lợi nếu có đủ khối lượng huấn luyện trong tuổi thọ hữu ích của phần cứng. Hãy dùng báo giá phần cứng, giá điện và số giờ huấn luyện dự kiến thực tế của bạn; kết quả thay đổi đáng kể tùy theo mức sử dụng.
Khi nào GPU tự lưu trữ là lựa chọn phù hợp#
Sở hữu phần cứng phù hợp hơn khi:
- GPU của bạn luôn bận. Huấn luyện lại liên tục, tìm kiếm siêu tham số quy mô lớn hoặc để cả nhóm dùng chung một máy suốt ngày đều làm tăng mức sử dụng, tiến gần điểm hòa vốn.
- Dữ liệu không thể rời khỏi cơ sở của bạn. Một số môi trường chịu sự quản lý hoặc cách ly mạng hoàn toàn không cho phép huấn luyện trên đám mây.
- Bạn đã có phần cứng. Nếu GPU đủ năng lực đang nhàn rỗi, hãy so sánh chi phí vận hành và thời gian huấn luyện với các lựa chọn đám mây trước khi mua thêm.
- Bạn cần toàn quyền kiểm soát driver, kernel hoặc mã huấn luyện tùy chỉnh mà nền tảng được quản lý không hỗ trợ.
Khi nào huấn luyện được quản lý là lựa chọn phù hợp#
Nền tảng được quản lý phù hợp hơn khi:
- Huấn luyện không diễn ra liên tục. Bạn huấn luyện khi dữ liệu thay đổi, rồi không chạy gì trong nhiều ngày.
- Bạn muốn bắt đầu ngay hôm nay. Không cần cài driver, xử lý sai khác phiên bản CUDA hay gỡ lỗi môi trường trước lần chạy đầu tiên.
- Kích thước model thay đổi. Bạn có thể huấn luyện model nano trên GPU nhỏ và model lớn trên GPU 80 GB trở lên mà không cần mua cả hai.
- Nhiều người cùng huấn luyện. Các lượt chạy, metric và checkpoint được lưu ở một nơi thay vì trên từng máy riêng lẻ.
Lựa chọn kết hợp: GPU riêng và dashboard được quản lý#
Bạn không nhất thiết phải chọn một trong hai. Ultralytics Platform hỗ trợ huấn luyện từ xa: bạn huấn luyện trên GPU riêng bằng package ultralytics, truyền metric trực tiếp đến cùng dashboard Platform dùng cho các lượt chạy trên đám mây và tải trọng số cuối cùng lên khi huấn luyện kết thúc. Các lượt chạy từ xa sử dụng GPU của bạn chứ không dùng GPU đám mây của Ultralytics, nên không tiêu tốn thời gian GPU đám mây.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=100,
    project="username/my-project",  # dự án Platform của bạn
    name="local-gpu-run",
)
Trước tiên, hãy thiết lập khóa API bằng export ULTRALYTICS_API_KEY="YOUR_API_KEY". Tích hợp Platform yêu cầu Python 3.11 trở lên và ultralytics phiên bản 8.4.120 trở lên. Một cách làm phổ biến là chạy các thử nghiệm nhanh trên GPU cục bộ, sau đó chuyển những lượt chạy lớn hơn hoặc cần hoàn tất gấp sang GPU đám mây khi máy cục bộ đang bận.
Cách huấn luyện YOLO26 trên GPU được quản lý với Ultralytics Platform#
- Tạo tài khoản tại platform.ultralytics.com. Tài khoản mới nhận được $5 tín dụng đăng ký, hoặc $25 sau khi xác minh email công việc.
- Thêm dataset bằng cách tải ảnh và nhãn lên, hoặc kết nối bucket Amazon S3 nếu dùng gói Pro hoặc Enterprise.
- Mở hộp thoại huấn luyện, chọn model YOLO26 và thiết lập số epoch cùng kích thước ảnh.
- Chọn GPU. RTX PRO 6000 là lựa chọn mặc định được đề xuất; xem cách chọn GPU đám mây để tìm hiểu các phương án đánh đổi.
- Kiểm tra ước tính chi phí, bắt đầu huấn luyện và theo dõi metric trực tiếp đến khi lượt chạy kết thúc.
Gói Free chạy đồng thời tối đa 3 job huấn luyện trên đám mây. Gói Pro, có giá $29 mỗi chỗ ngồi mỗi tháng, tăng giới hạn lên 10 job và bao gồm $30 tín dụng mỗi tháng cho mỗi chỗ ngồi.
Sau khi huấn luyện xong, bạn có thể xuất model hoặc triển khai model dưới dạng API. Nếu bạn cũng đang quyết định nơi chạy suy luận, hướng dẫn AI thị giác trên đám mây và tự lưu trữ của chúng tôi so sánh chi phí, độ trễ và khả năng kiểm soát dữ liệu khi triển khai.
Câu hỏi thường gặp
Có thể, đặc biệt khi việc huấn luyện không diễn ra liên tục, vì bạn chỉ trả tiền cho số giờ GPU đã sử dụng. Hãy so sánh tổng chi phí và thời gian hoàn tất của cùng một khối lượng công việc; phép tính điểm hòa vốn ở trên (chi phí phần cứng chia cho đơn giá GPU đám mây theo giờ trừ đi chi phí điện mỗi giờ) chỉ là điểm khởi đầu, không phải bảo đảm.
GPU đám mây thuê cung cấp cho bạn một máy tính, còn nhóm của bạn cấu hình khối lượng công việc huấn luyện và kiểm tra hoặc thiết lập môi trường. Nền tảng huấn luyện được quản lý vận hành nhiều công đoạn hơn: trên Ultralytics Platform, bạn chọn dataset, model và GPU, còn nền tảng cấp phát GPU, chạy huấn luyện, truyền metric trực tiếp và lưu checkpoint.
Trên Ultralytics Platform, lượt chạy thất bại sau khi GPU đám mây khởi động sẽ bị tính phí theo thời gian GPU đã sử dụng; nếu lỗi xảy ra trước khi GPU khởi động thì không mất phí. Lượt chạy bị hủy được tính phí GPU đến thời điểm hủy.
Có. Huấn luyện từ xa chạy trên phần cứng của bạn, truyền metric trực tiếp đến Platform và tải trọng số cuối cùng lên, nên không sử dụng thời gian GPU đám mây.
RTX PRO 6000 (96 GB) là lựa chọn mặc định được đề xuất cho hầu hết job. Ultralytics khuyến nghị RTX 4090 cho huấn luyện thông thường, A100 SXM cho batch size lớn hoặc model lớn hơn, còn GPU H100, H200, B200 và B300 phù hợp với các job cần hoàn tất gấp, cần nhiều bộ nhớ hoặc có quy mô lớn nhất.
Tài khoản Ultralytics Platform mới nhận được khoản tín dụng đăng ký trị giá $5, tăng lên $25 sau khi xác minh email công việc. Các gói Pro bao gồm $30 tín dụng mỗi tháng cho mỗi chỗ ngồi.
Không. Kubernetes có thể lập lịch các workload GPU, nhưng tài liệu lập lịch GPU yêu cầu phải cài đặt driver GPU và plugin thiết bị của nhà cung cấp trên các node. Một cụm huấn luyện tự quản lý vẫn cần người phụ trách môi trường, quyền truy cập, giám sát job và checkpoint, vì vậy hãy dự trù công việc này cùng với chi phí điện toán.
Được viết bởi
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









