ONNX so với TensorRT cho suy luận thị giác máy tính: benchmark và cách lựa chọn
ONNX Runtime so với TensorRT cho suy luận thị giác máy tính: đo tốc độ và độ chính xác của Ultralytics YOLO26 trên 19 GPU NVIDIA và cách lựa chọn.
 Miles Deans14 phút đọc
ONNX và TensorRT thực ra không phải đối thủ cạnh tranh. ONNX là định dạng model, còn TensorRT là inference engine của NVIDIA, thường nhận tệp ONNX làm đầu vào. Lựa chọn thực sự là cách bạn chạy tệp đó: bằng ONNX Runtime, hoạt động trên nhiều loại phần cứng và thậm chí có thể chuyển công việc sang TensorRT, hoặc biên dịch thành TensorRT engine độc lập, chỉ chạy trên GPU NVIDIA. Trong các benchmark của Ultralytics Platform về Ultralytics YOLO26 trên 19 GPU NVIDIA, TensorRT FP16 nhanh hơn các kết quả ONNX FP16 đã công bố trên mọi GPU và kích thước model, với độ chính xác chênh lệch không quá 0.001 mAP50-95. Mức tăng tốc trung vị dao động từ 1.85x đến 2.55x tùy kích thước model. Trang benchmark không cho biết execution provider nào của ONNX Runtime tạo ra kết quả ONNX, vì vậy các kết quả này không xác định ONNX Runtime nói chung, hoặc ONNX Runtime với TensorRT execution provider, có hiệu năng ra sao. Với Ultralytics YOLO26 trên GPU NVIDIA, hãy bắt đầu với TensorRT FP16 khi độ trễ là yếu tố quan trọng, và dùng ONNX Runtime khi cần chạy một tệp model trên nhiều loại phần cứng. Ultralytics YOLO có thể xuất sang cả hai định dạng chỉ với một tham số.
Bắt đầu với Ultralytics YOLO ở đâu:
| Triển khai | Bắt đầu với | Xuất Ultralytics YOLO |
|---|---|---|
| GPU NVIDIA, độ trễ là yếu tố quan trọng | TensorRT FP16 | format="engine", quantize=16 |
| CPU, phần cứng không phải NVIDIA hoặc hệ thống phần cứng hỗn hợp | ONNX Runtime | format="onnx" |
| API của ONNX Runtime trên GPU NVIDIA | ONNX Runtime với TensorRT execution provider | format="onnx" |
ONNX so với TensorRT: định dạng, runtime và engine#
Có ba khái niệm khác nhau trong phép so sánh này:
- ONNX (Mạng trao đổi mạng nơ-ron mở) là định dạng tệp lưu trữ graph và weights của model đã huấn luyện theo cách độc lập với framework. Bạn xuất từ PyTorch sang ONNX để các công cụ khác có thể đọc model.
- ONNX Runtime chạy các model ONNX. ONNX Runtime chuyển công việc cho các backend phần cứng gọi là execution provider, chẳng hạn CPU, CUDA và TensorRT, nhờ đó cùng một tệp có thể chạy trên CPU laptop hoặc GPU cloud.
- TensorRT đọc model, thường là tệp ONNX, thông qua ONNX parser. TensorRT hợp nhất các layer, chọn kernel nhanh nhất cho từng phép toán trên GPU được xây dựng cho nó, rồi tạo một engine đã tối ưu.
Vì vậy, câu hỏi thực sự là ONNX Runtime so với TensorRT. ONNX Runtime cũng có thể gọi TensorRT thông qua TensorRT execution provider, cho phép bạn tiếp tục dùng API của ONNX Runtime trong khi TensorRT chạy các subgraph mà TensorRT hỗ trợ. ONNX Runtime khuyến nghị đăng ký CUDA execution provider sau TensorRT execution provider, để những node TensorRT không hỗ trợ có thể chạy bằng CUDA.
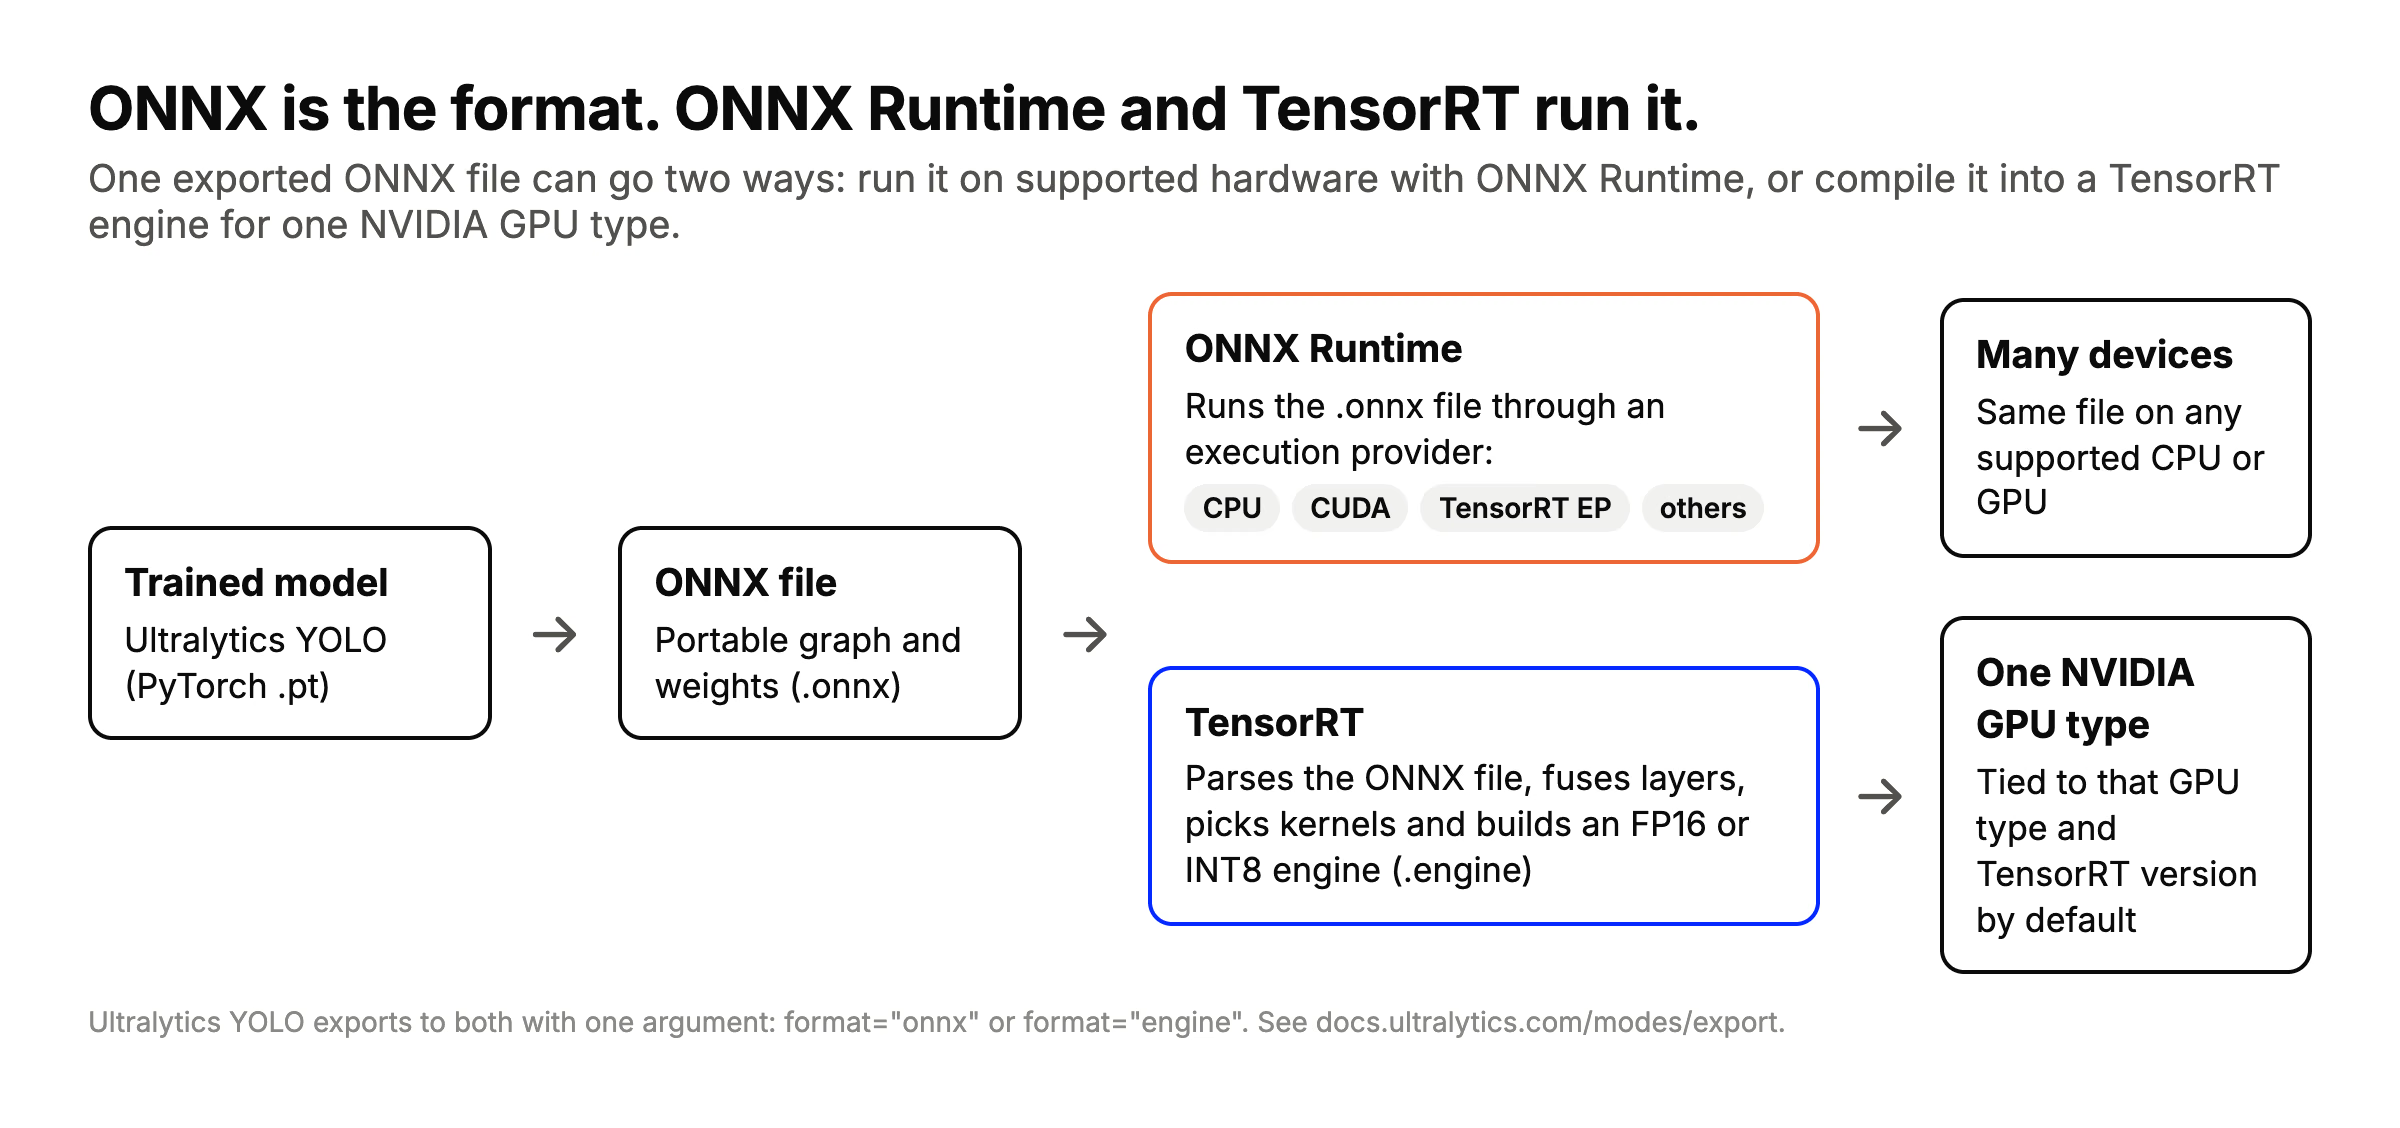
Một tệp ONNX, hai cách chạy: ONNX Runtime chạy tệp trên phần cứng được hỗ trợ, còn TensorRT biên dịch tệp thành engine cho một loại GPU NVIDIA. Ultralytics YOLO xuất được sang cả hai.
Benchmark: YOLO26 trên ONNX Runtime so với TensorRT#
Các số liệu dưới đây lấy từ benchmark suy luận của Ultralytics Platform. Mỗi model phát hiện Ultralytics YOLO26 được xuất sang định dạng hiển thị, sau đó độ trễ suy luận được đo trên GPU của Ultralytics Platform với batch 1 và kích thước 640 pixel trên COCO val2017; thời gian warm-up không được tính và thời gian mỗi lần chạy được lọc bằng phương pháp sigma-clipping. Độ chính xác là mAP50-95 trên COCO val2017, được đo một lần cho mỗi định dạng và precision. Phép so sánh sử dụng 19 GPU NVIDIA (Ampere, Ada và Hopper) có kết quả cho cả bốn định dạng.
Trang benchmark không xác định execution provider ONNX Runtime nào đã tạo ra kết quả ONNX, cũng không ghi nhãn kết quả nào là sử dụng TensorRT execution provider của ONNX Runtime, vốn chuyển các phần model được hỗ trợ sang TensorRT. Các kết quả ONNX này phản ánh cấu hình được benchmark; hiệu năng có thể thay đổi tùy execution provider của ONNX Runtime. Nếu muốn dùng API của ONNX Runtime với TensorRT làm backend, hãy benchmark tổ hợp đó trên phần cứng của bạn.
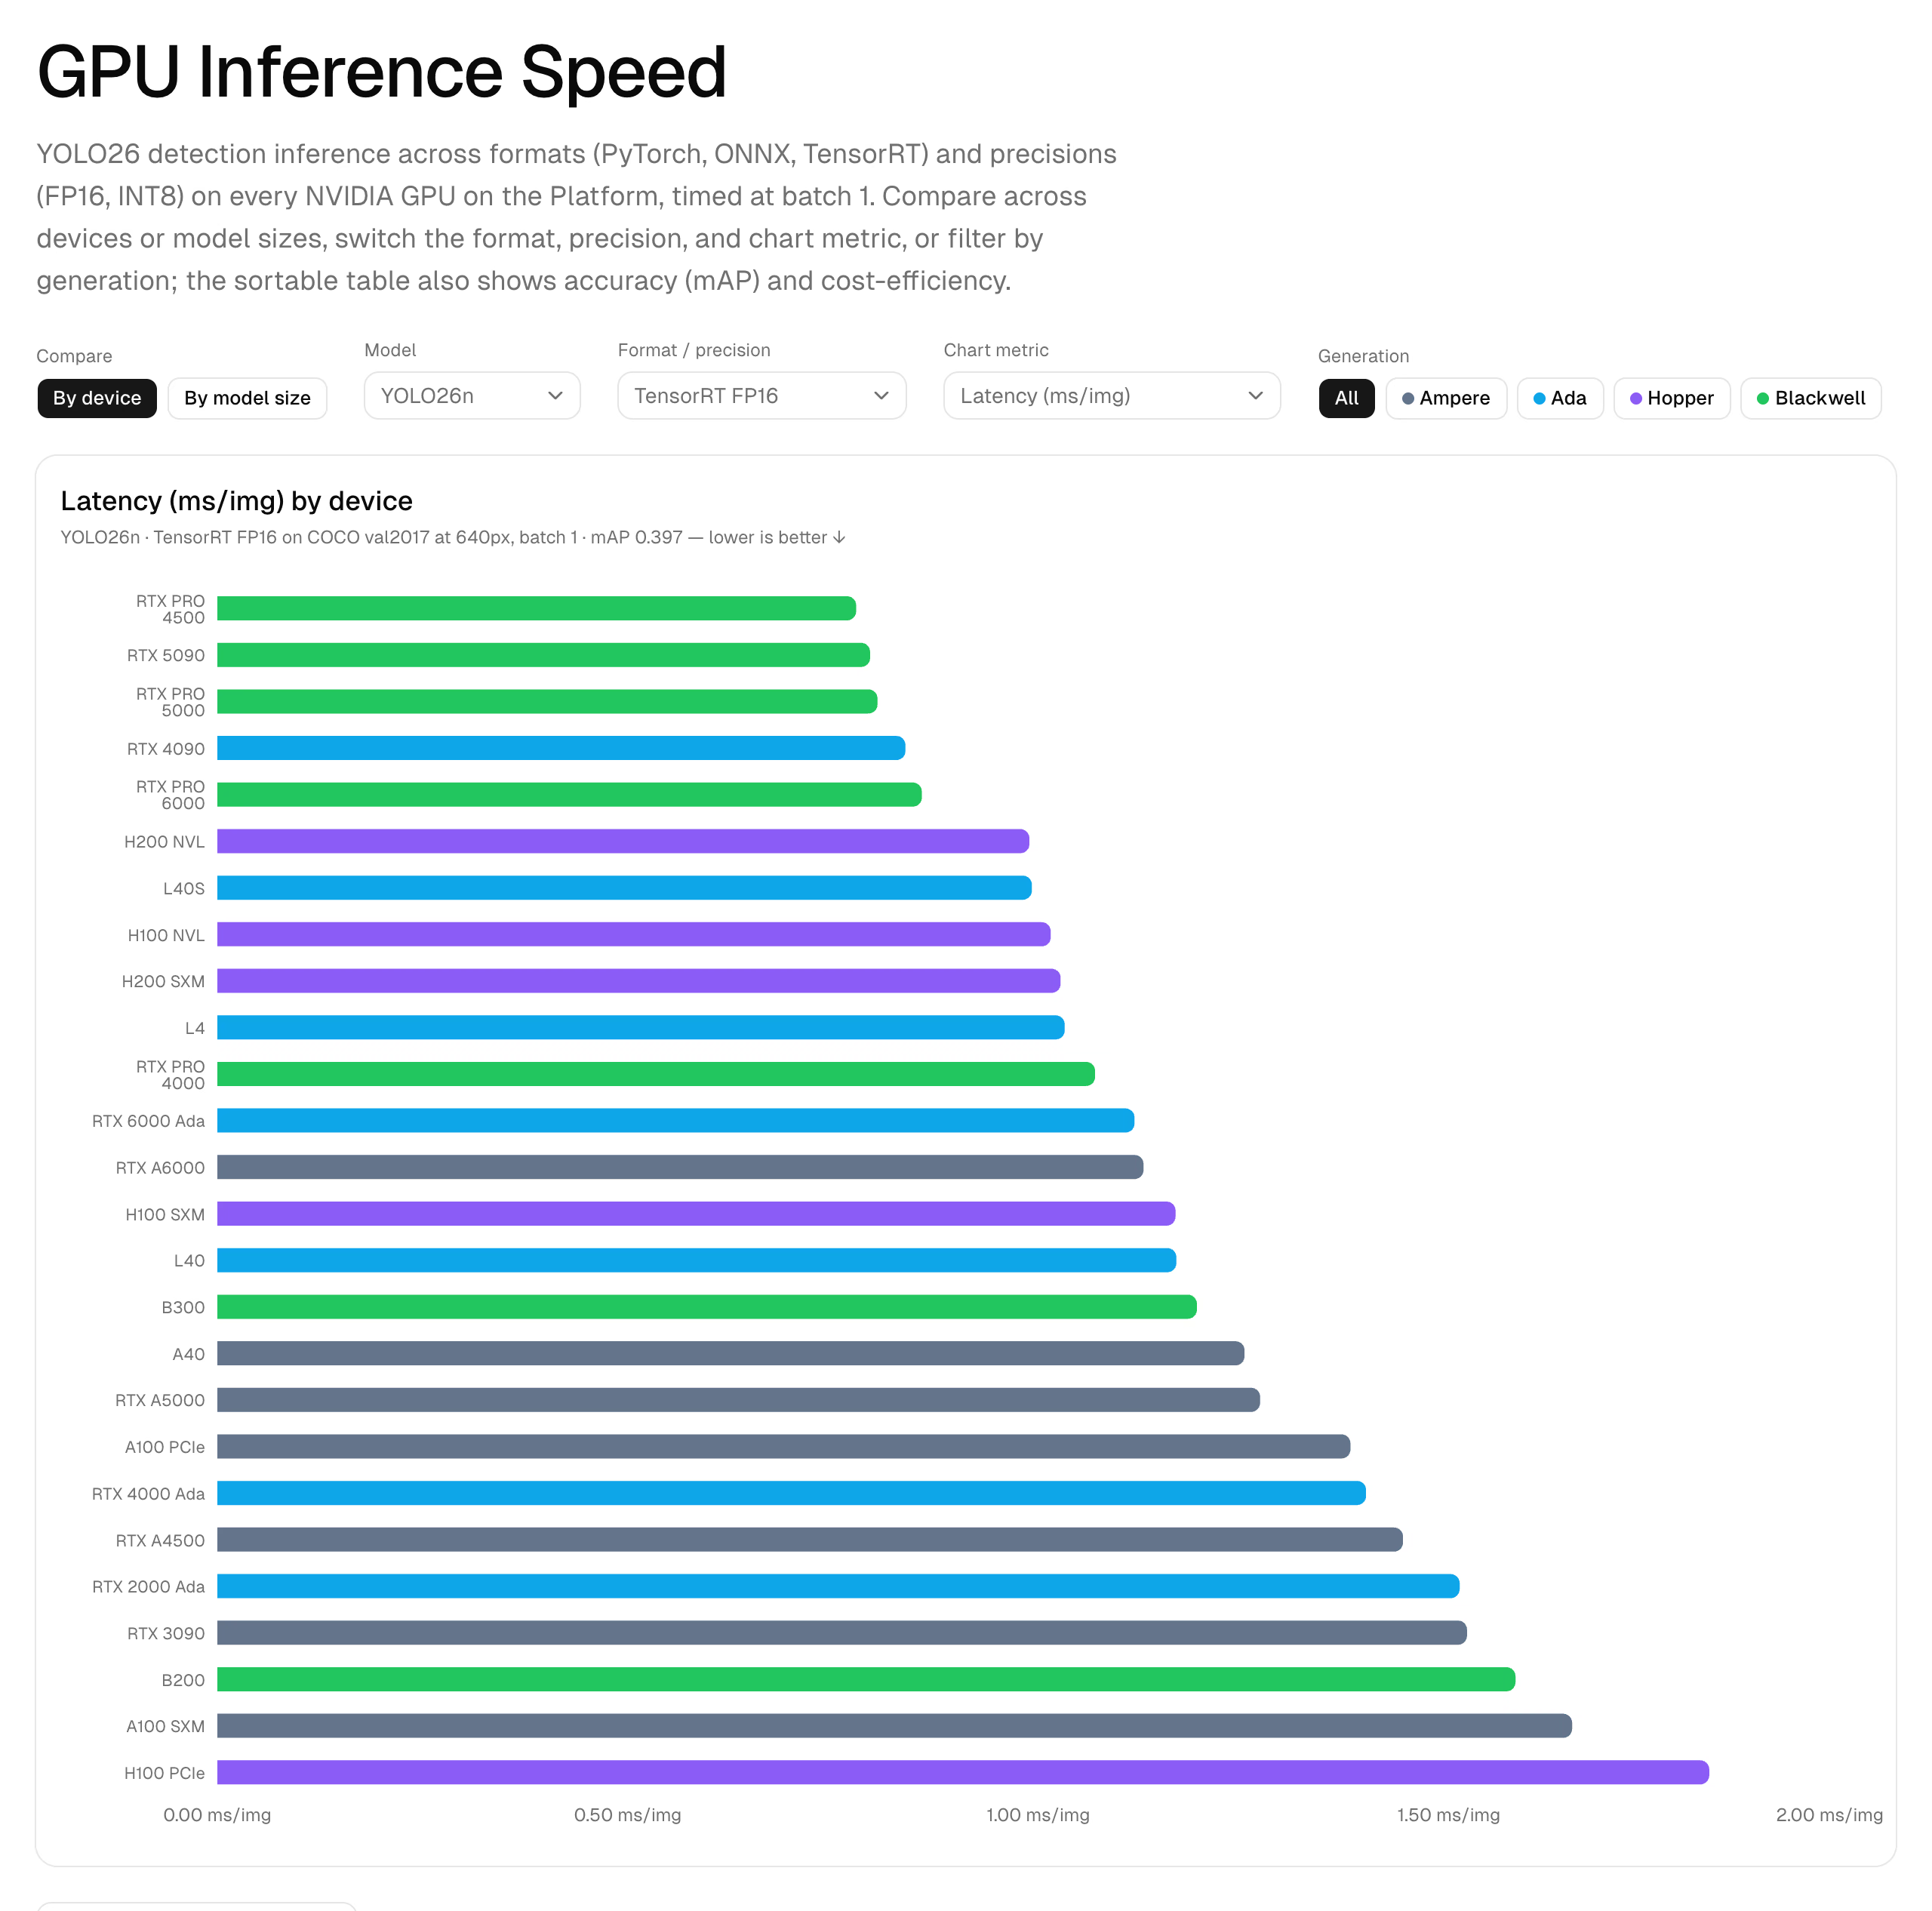
Trong tab Inference, bạn có thể chuyển đổi kích thước model, định dạng và precision, sau đó sắp xếp các GPU theo độ trễ, độ chính xác hoặc chi phí.
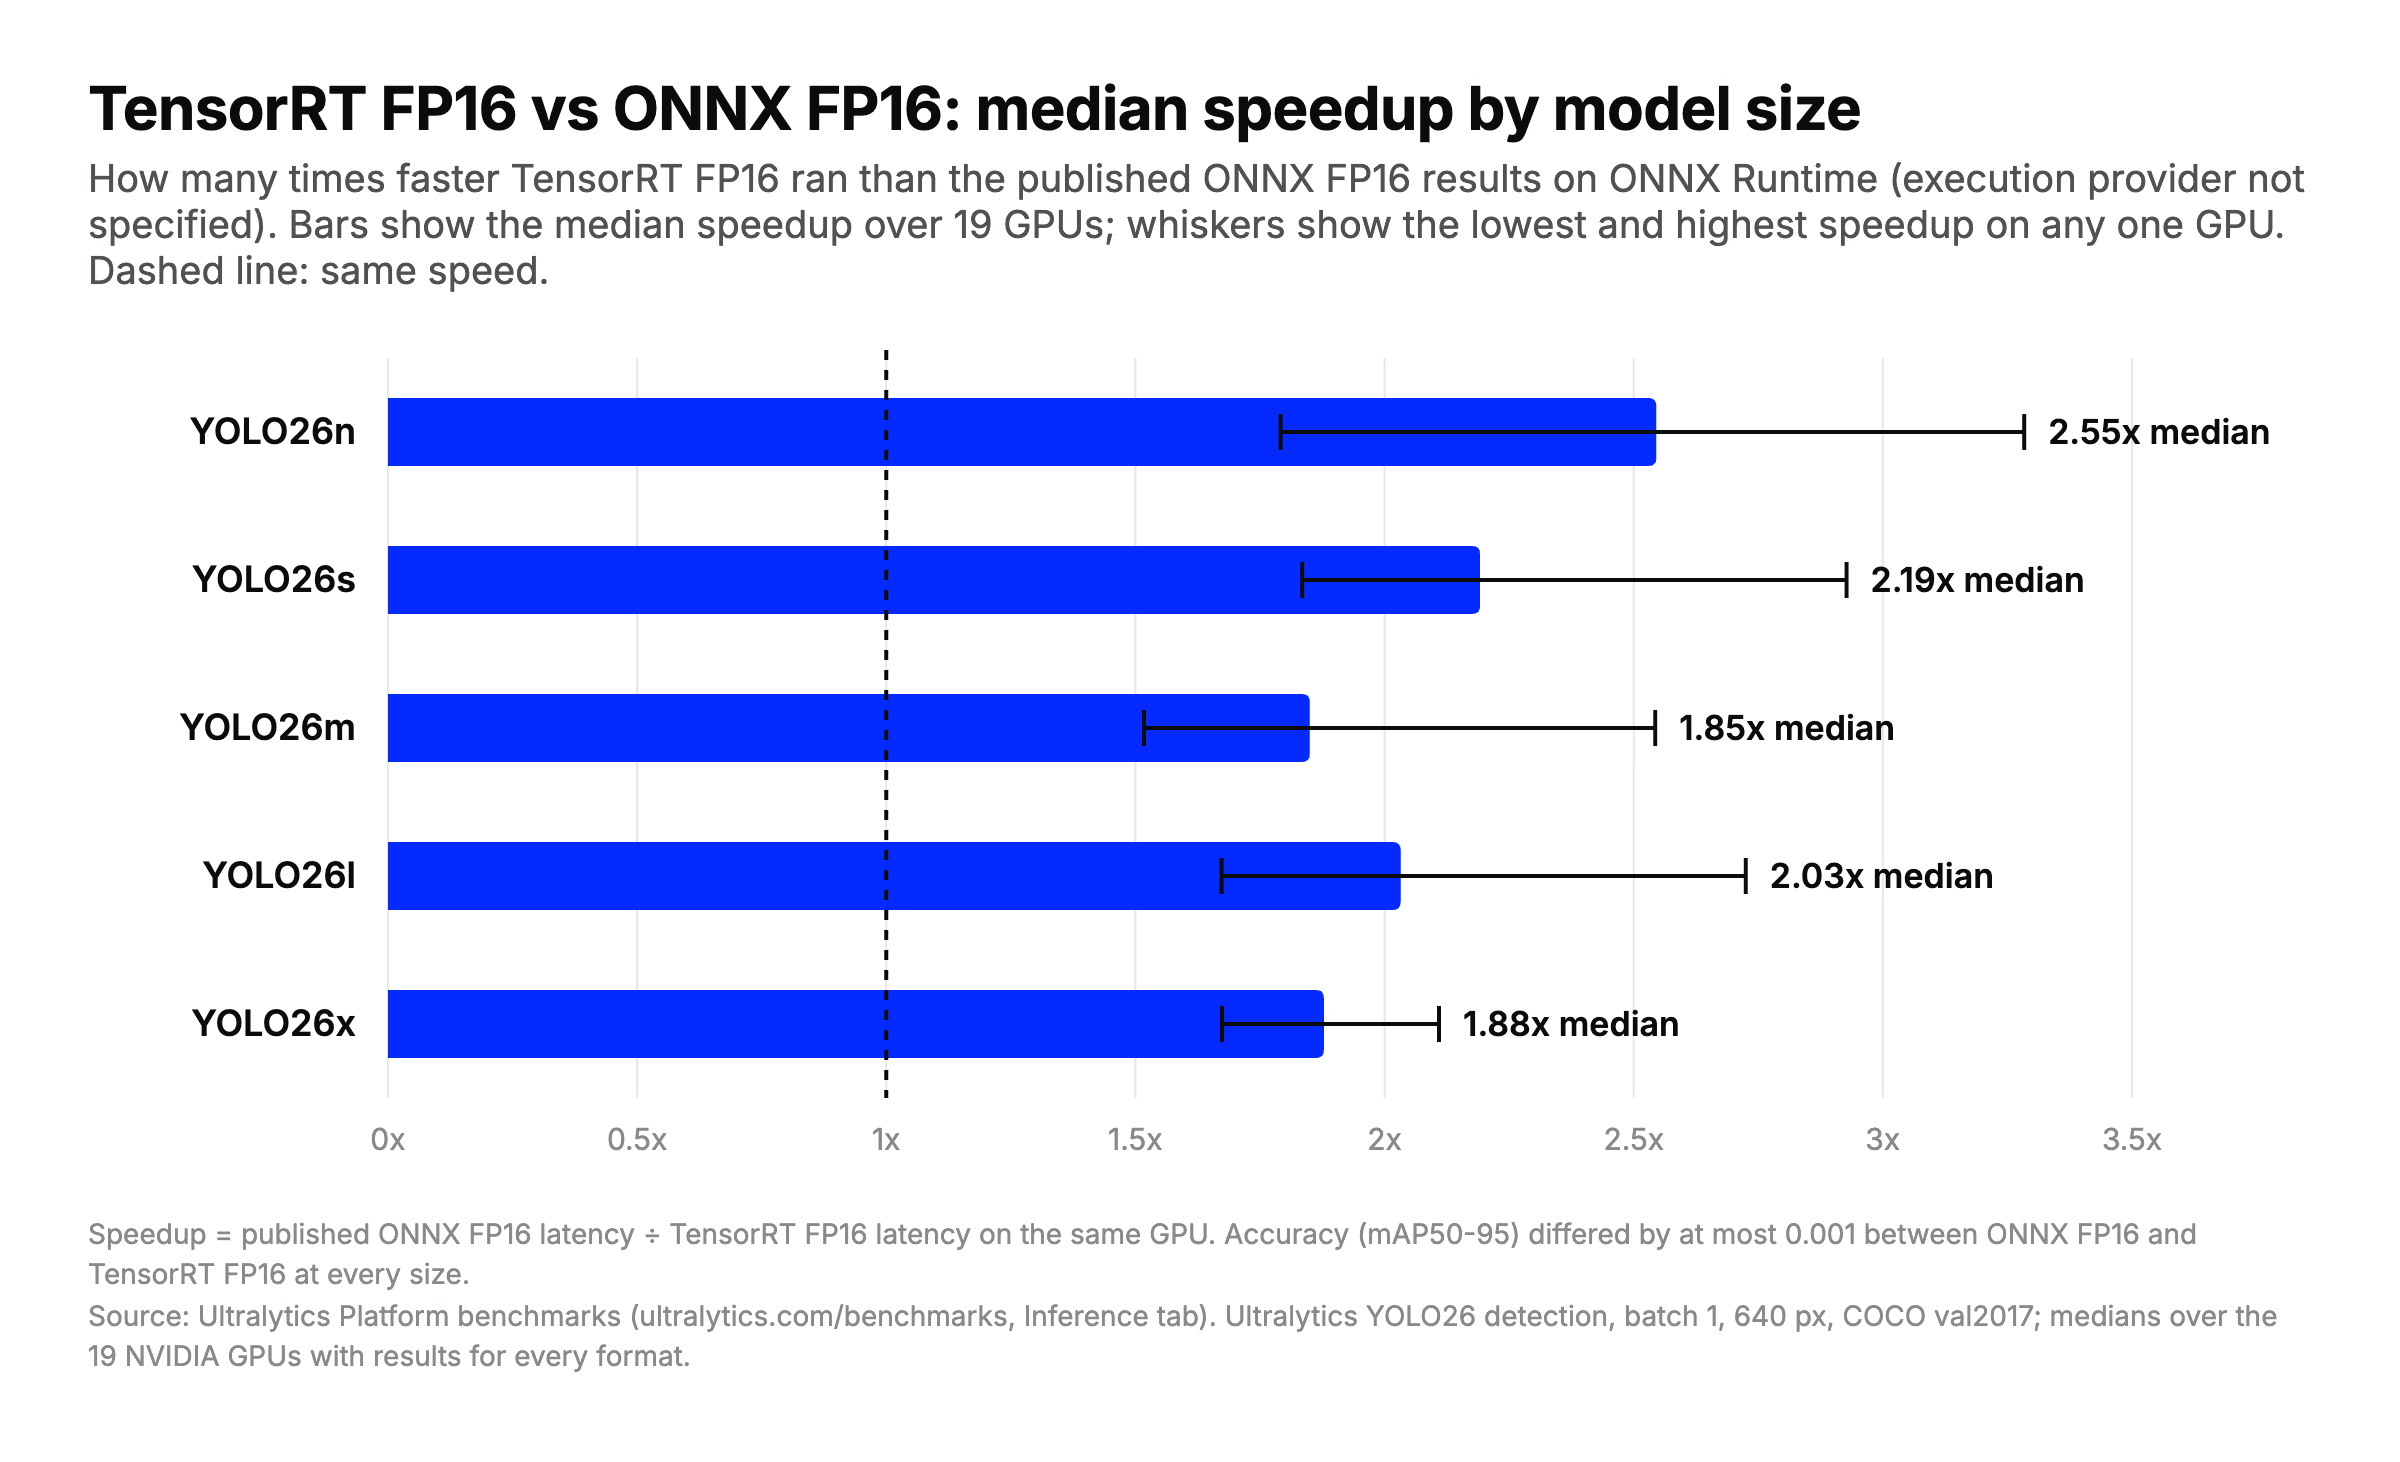
TensorRT FP16 nhanh hơn các kết quả ONNX FP16 đã công bố trên mọi GPU ở mọi kích thước model; trang benchmark không nêu execution provider ONNX Runtime nào tạo ra các kết quả đó. Các cột thể hiện mức tăng tốc trung vị trên 19 GPU; thanh sai số thể hiện mức tăng tốc thấp nhất và cao nhất trên một GPU bất kỳ. Tính toán từ benchmark suy luận của Ultralytics Platform.
| Model | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | Mức tăng tốc TensorRT FP16 so với ONNX FP16 (trung vị, khoảng) | Mức tăng tốc TensorRT INT8 so với TensorRT FP16 (trung vị, khoảng) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
Tính toán từ benchmark suy luận của Ultralytics Platform. Mức tăng tốc được tính bằng độ trễ ONNX FP16 ÷ độ trễ TensorRT FP16, hoặc độ trễ TensorRT FP16 ÷ độ trễ TensorRT INT8, trên cùng một GPU; vì vậy, giá trị lớn hơn 1x nghĩa là TensorRT FP16 (hoặc INT8) nhanh hơn. Trung vị được tính trên 19 GPU NVIDIA có kết quả cho cả bốn định dạng; khoảng giá trị là tỷ số nhỏ nhất và lớn nhất trong các GPU đó. Độ chính xác là mAP50-95 được báo cáo cho từng định dạng và precision. ONNX FP16 là các kết quả ONNX Runtime đã công bố, nhưng execution provider không được nêu rõ.
Độ trễ trên bốn GPU phổ biến, tính bằng mili giây mỗi ảnh, theo số liệu được công bố trên trang benchmark:
| GPU | Model | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
Có ba điểm đáng chú ý:
- TensorRT FP16 nhanh hơn các kết quả ONNX FP16 đã công bố trên mọi GPU và mọi kích thước model, với độ chính xác chênh lệch không quá 0.001 mAP50-95. Nếu triển khai trên các GPU NVIDIA này và cần độ trễ thấp, hãy bắt đầu với TensorRT FP16.
- INT8 không phải lúc nào cũng tốt hơn. Với YOLO26n, INT8 chậm hơn TensorRT FP16 trên 17 trong số 19 GPU và làm giảm 0.04 mAP50-95. INT8 hữu ích hơn với các model lớn; mức tăng tốc lên đến 1.67x với YOLO26x trên L4, nhưng làm giảm 0.034 đến 0.076 mAP50-95.
- Không có kết quả ONNX cho bảy GPU Blackwell. Trang benchmark cho biết nguyên nhân là ONNX Runtime không có kernel Blackwell trong môi trường thử nghiệm. TensorRT chạy được trên cả bảy GPU.
Các kết quả này áp dụng cho cấu hình trên trang benchmark, với batch 1 và kích thước 640 pixel; vì vậy, hãy benchmark model của bạn trên thiết bị triển khai và dữ liệu của chính bạn trước khi lựa chọn.
FP16 so với INT8 với TensorRT#
Giảm precision là một cách tối ưu quan trọng khác, và benchmark cho thấy vì sao cần kiểm thử:
- FP16 (độ chính xác bán phần) giảm một nửa kích thước weights và activations so với FP32. Trong benchmark của Ultralytics Platform, TensorRT FP16 có độ chính xác tương đương ONNX FP16 và PyTorch FP16, với chênh lệch không quá 0.003 mAP50-95.
- INT8 lưu weights và activations dưới dạng số nguyên 8 bit, một hình thức lượng tử hóa model. INT8 cần calibration: chạy một tập ảnh đại diện qua model để đo các dải activation. Benchmark của Ultralytics Platform dùng NVIDIA ModelOpt với COCO128 làm dữ liệu calibration.
Như phương pháp benchmark đã nêu, INT8 có lợi nhất với các model lớn bị giới hạn bởi năng lực tính toán. Với model nhỏ nhất, phần xử lý lượng tử hóa bổ sung có thể ngang bằng hoặc thậm chí làm chậm FP16. Hãy calibration bằng ảnh thuộc miền dữ liệu của bạn, sau đó xác thực độ chính xác trên dữ liệu của chính bạn trước khi triển khai engine INT8.
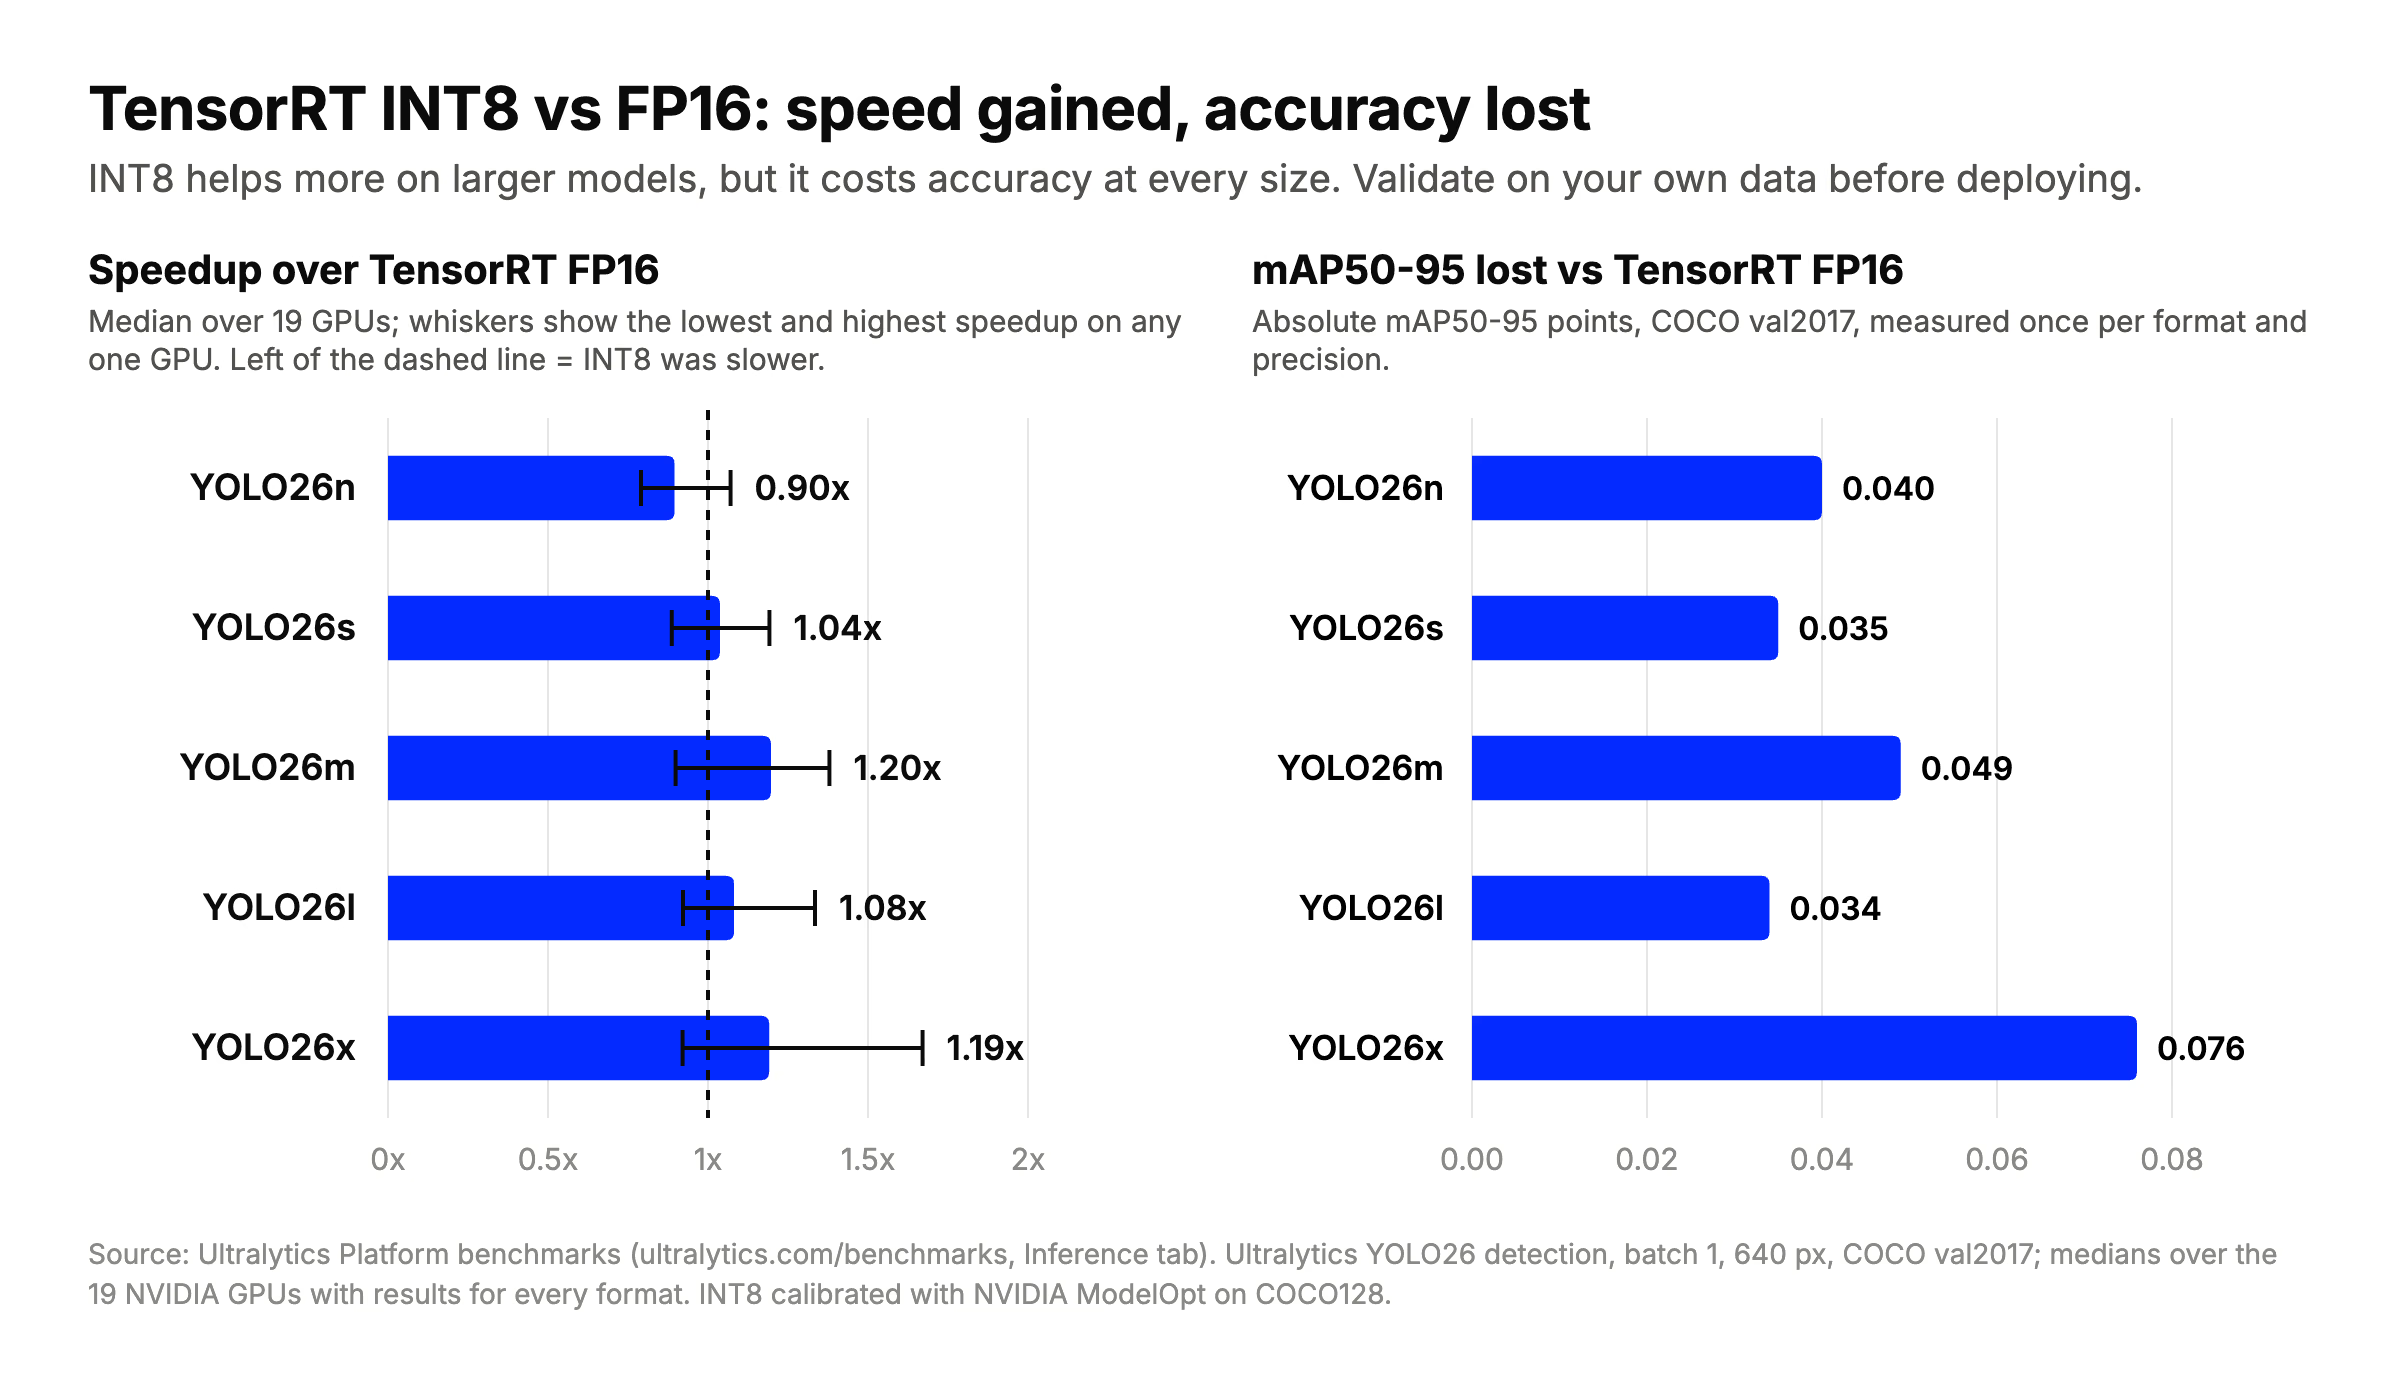
Ở mức trung vị, INT8 chậm hơn FP16 trên YOLO26n và nhanh hơn tối đa khoảng 1.2x trên các model lớn hơn trong 19 GPU, đồng thời làm giảm 0.034 đến 0.076 mAP50-95 ở mọi kích thước. Tính toán từ benchmark suy luận của Ultralytics Platform.
Tính di động của engine và kích thước đầu vào động#
Theo mặc định, TensorRT engine gắn với GPU và phiên bản TensorRT dùng để tạo engine; vì vậy, engine tạo trên RTX 4090 không предназнач để sao chép sang H100 hoặc Jetson. TensorRT có các tùy chọn tương thích phần cứng và phiên bản giúp giảm ràng buộc này, nhưng cách an toàn nhất là tạo engine trên thiết bị triển khai hoặc cho thiết bị đó, đồng thời tạo lại engine sau khi nâng cấp TensorRT. Trên Ultralytics Platform, tab Export yêu cầu chọn loại GPU khi xuất TensorRT vì lý do này. Tệp ONNX không bị ràng buộc như vậy: cùng một tệp có thể chạy ở nơi có ONNX Runtime và execution provider phù hợp.
Cả hai định dạng đều hỗ trợ kích thước đầu vào thay đổi. Với TensorRT, dynamic shape cần một optimization profile xác định kích thước đầu vào tối thiểu, tối ưu và tối đa; đầu vào khi chạy phải nằm trong phạm vi đó. Khi xuất model Ultralytics YOLO, dynamic=True bật dynamic input shape cho ONNX và TensorRT. NVIDIA giải thích trong hướng dẫn dynamic shape rằng kích thước cố định giúp TensorRT có nhiều cơ hội tối ưu hơn; vì vậy, chỉ dùng dynamic shape khi đầu vào thực sự thay đổi và hãy benchmark cả hai cách.
Khi nào nên chọn ONNX Runtime và khi nào nên chọn TensorRT#
- GPU NVIDIA trên cloud hoặc tại chỗ, độ trễ là yếu tố quan trọng: dùng TensorRT, bắt đầu với FP16. Hãy thử INT8 trên các model lớn hơn sau khi calibration và xác thực.
- NVIDIA Jetson ở edge: dùng TensorRT. Xem hướng dẫn NVIDIA Jetson.
- CPU, phần cứng không phải NVIDIA hoặc hệ thống phần cứng hỗn hợp: dùng ONNX với ONNX Runtime, chọn execution provider được từng máy hỗ trợ.
- Chưa biết phần cứng triển khai: trước tiên hãy xuất sang ONNX. Sau này, bạn có thể tạo TensorRT engine từ cùng model.
- CPU, GPU hoặc NPU Intel: cân nhắc OpenVINO, bộ công cụ inference của Intel.
Để xem danh sách đầy đủ các định dạng và cách so sánh, hãy xem hướng dẫn các tùy chọn triển khai model. Precision không phải yếu tố duy nhất cần cân nhắc: kích thước model và độ phân giải đầu vào cũng quan trọng; hướng dẫn pruning và lượng tử hóa của chúng tôi trình bày thêm hai cách thu gọn model.
Xuất Ultralytics YOLO sang ONNX và TensorRT#
Ultralytics YOLO xuất được sang cả hai định dạng với một tham số format; bạn cũng có thể chạy prediction hoặc validation trực tiếp trên model đã xuất:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX FP16, dùng cho ONNX Runtime
model.export(format="engine", quantize=16)  # TensorRT FP16 engine, được tạo trên GPU này
# Thay vào đó, để dùng INT8, hãy calibration bằng tệp YAML của dataset (coco8.yaml là tập demo nhỏ; hãy dùng dataset của bạn):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 chọn FP16 và quantize=8 chọn INT8. Cả hai lệnh xuất engine đều tạo yolo26n.engine, vì vậy hãy chạy một trong hai lệnh. Với INT8, đặt data trỏ đến tệp YAML dataset của bạn để calibration sử dụng ảnh tương tự dữ liệu triển khai. Xem các tham số export và hướng dẫn tích hợp ONNX, TensorRT để biết mọi tùy chọn, hoặc làm theo các bài hướng dẫn từng bước về xuất sang ONNX và tối ưu hóa với TensorRT. Bạn cũng có thể xuất model đã huấn luyện ngay trên trình duyệt bằng Ultralytics Platform.
Câu hỏi thường gặp
ONNX là định dạng model, không phải engine, nên phép so sánh hợp lý là ONNX Runtime với TensorRT. Trong benchmark của Ultralytics Platform về Ultralytics YOLO26 trên 19 GPU NVIDIA, TensorRT FP16 nhanh hơn các kết quả ONNX FP16 đã công bố trên ONNX Runtime ở mọi GPU; mức tăng tốc trung vị tính được dao động từ 1.85x đến 2.55x tùy kích thước model, còn chênh lệch mAP50-95 tối đa là 0.001. Benchmark không cho biết execution provider ONNX Runtime nào tạo ra kết quả ONNX, và không có kết quả nào được ghi nhãn là sử dụng TensorRT execution provider của ONNX Runtime; vì vậy, hãy tự kiểm thử tổ hợp đó nếu bạn cần API của ONNX Runtime.
Có. ONNX thường là đầu vào của TensorRT: ONNX parser đọc model và tạo engine từ model đó. ONNX Runtime cũng có thể gọi TensorRT thông qua TensorRT execution provider.
Không. Trong benchmark của Ultralytics Platform, TensorRT INT8 chậm hơn TensorRT FP16 với YOLO26n trên 17 trong số 19 GPU. INT8 thường nhanh hơn với các model lớn; mức tăng tốc trung vị đạt khoảng 1.2x với YOLO26m và YOLO26x trên 19 GPU chạy đủ mọi định dạng. Mỗi lần dùng INT8, mAP50-95 giảm 0.034 đến 0.076; vì vậy, trước tiên hãy xác thực model INT8 trên dữ liệu của bạn.
Đừng mặc định rằng có thể. Theo mặc định, TensorRT engine gắn với GPU và phiên bản TensorRT dùng để tạo engine; vì vậy, hãy tạo engine trên thiết bị triển khai hoặc cho thiết bị đó. Giữ lại tệp ONNX làm bản sao có thể di chuyển và tạo lại engine cho từng thiết bị đích.
TensorRT thường là lựa chọn phù hợp: NVIDIA JetPack có tích hợp TensorRT, và tạo engine ngay trên Jetson giúp tối ưu engine cho thiết bị đó. Các benchmark ở trên không bao gồm Jetson, vì vậy hãy đo hiệu năng trên module của bạn trước khi quyết định. Hướng dẫn NVIDIA Jetson trình bày các bước thiết lập và xuất Ultralytics YOLO.
Được viết bởi
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









