Qwen4-Max cho gán nhãn tự động: bộ dữ liệu nổi bật, mức cải thiện không đồng đều
Qwen4-Max xếp thứ 13/51 trong benchmark gán nhãn tự động của chúng tôi, đứng đầu ở ảnh X-quang cổ tay và thứ hai ở kệ hàng bán lẻ. Độ chính xác, chi phí và cách chạy model.
 Miles Deans15 phút đọc
Alibaba phát hành Qwen4-Max vào ngày 16 tháng 11 năm 2026, gọi đây là model mạnh nhất từ trước đến nay trong dòng Qwen, với khả năng xử lý hình ảnh gốc và cửa sổ ngữ cảnh một triệu token. Cùng ngày, chúng tôi chạy model này trên UL37, benchmark phát hiện gồm 36 bộ dữ liệu của chúng tôi.
Nhìn chung, Qwen4-Max xếp thứ 13 trong 51 model trên VLM Leaderboard của chúng tôi, đạt 0.474 mAP50 với chi phí $5.68 cho mỗi 1.000 ảnh. Điểm trung bình này che khuất một kết quả nổi bật hơn. Trên ảnh X-quang cổ tay trẻ em, model đạt điểm cao nhất trong số các model chúng tôi đã thử nghiệm; model cũng chỉ đứng sau Gemini 4 Carbon trên cảnh dưới nước và kệ hàng bán lẻ xếp dày đặc.
Qwen4-Max hiện là lựa chọn của Alibaba để gán nhãn tự động trong Ultralytics Platform, thay thế Qwen3.8-Max. Dưới đây là những điểm mạnh, hạn chế, cách so sánh với các model bạn có thể cân nhắc và chi phí cho một batch gán nhãn.
Qwen4-Max xếp thứ 13/51 trên UL37 và đứng đầu ở ảnh X-quang cổ tay#
UL37 đo mức độ khớp giữa các bounding box của model và nhãn do con người tạo trên 360 ảnh: 10 ảnh từ mỗi trong số 36 bộ dữ liệu phát hiện vật thể thực tế, từ ảnh quét y tế và ảnh chụp từ trên không đến kệ hàng bán lẻ, thể thao và bo mạch. Mỗi bộ dữ liệu có trọng số như nhau trong điểm trung bình; mọi ảnh đều đi qua cùng một pipeline production mà người dùng Platform sử dụng, với tên lớp riêng của bộ dữ liệu và SAM 3.1 tinh chỉnh từng bounding box, vì vậy điểm số phản ánh pipeline đã tinh chỉnh chứ không phải đầu ra thô của model. Phương pháp luận được công khai.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| Thứ hạng trên bảng xếp hạng | #13/51 | #15/51 | #3/51 | #11/51 | #16/51 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| Độ chính xác | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| Độ bao phủ | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| Chi phí của nhà cung cấp cho mỗi 1.000 ảnh | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| Thời gian trung vị mỗi ảnh | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| Yêu cầu thất bại | 0% | 1.7% | 0% | 0% | 6.4% |
Kết quả UL37 từ Ultralytics VLM Leaderboard, cập nhật ngày 19 tháng 11 năm 2026. Qwen3.8-Max không còn được cung cấp trên Platform.
Qwen4-Max cải thiện trên mọi chỉ số chính so với Qwen3.8-Max, có chi phí thấp hơn trên mỗi ảnh và hoàn tất mọi yêu cầu benchmark. Tuy vậy, xét điểm trung bình, model vẫn kém xa các model dẫn đầu: GPT-6.1 Terra đạt 0.560 với chi phí thấp hơn và thời gian chưa bằng một nửa.
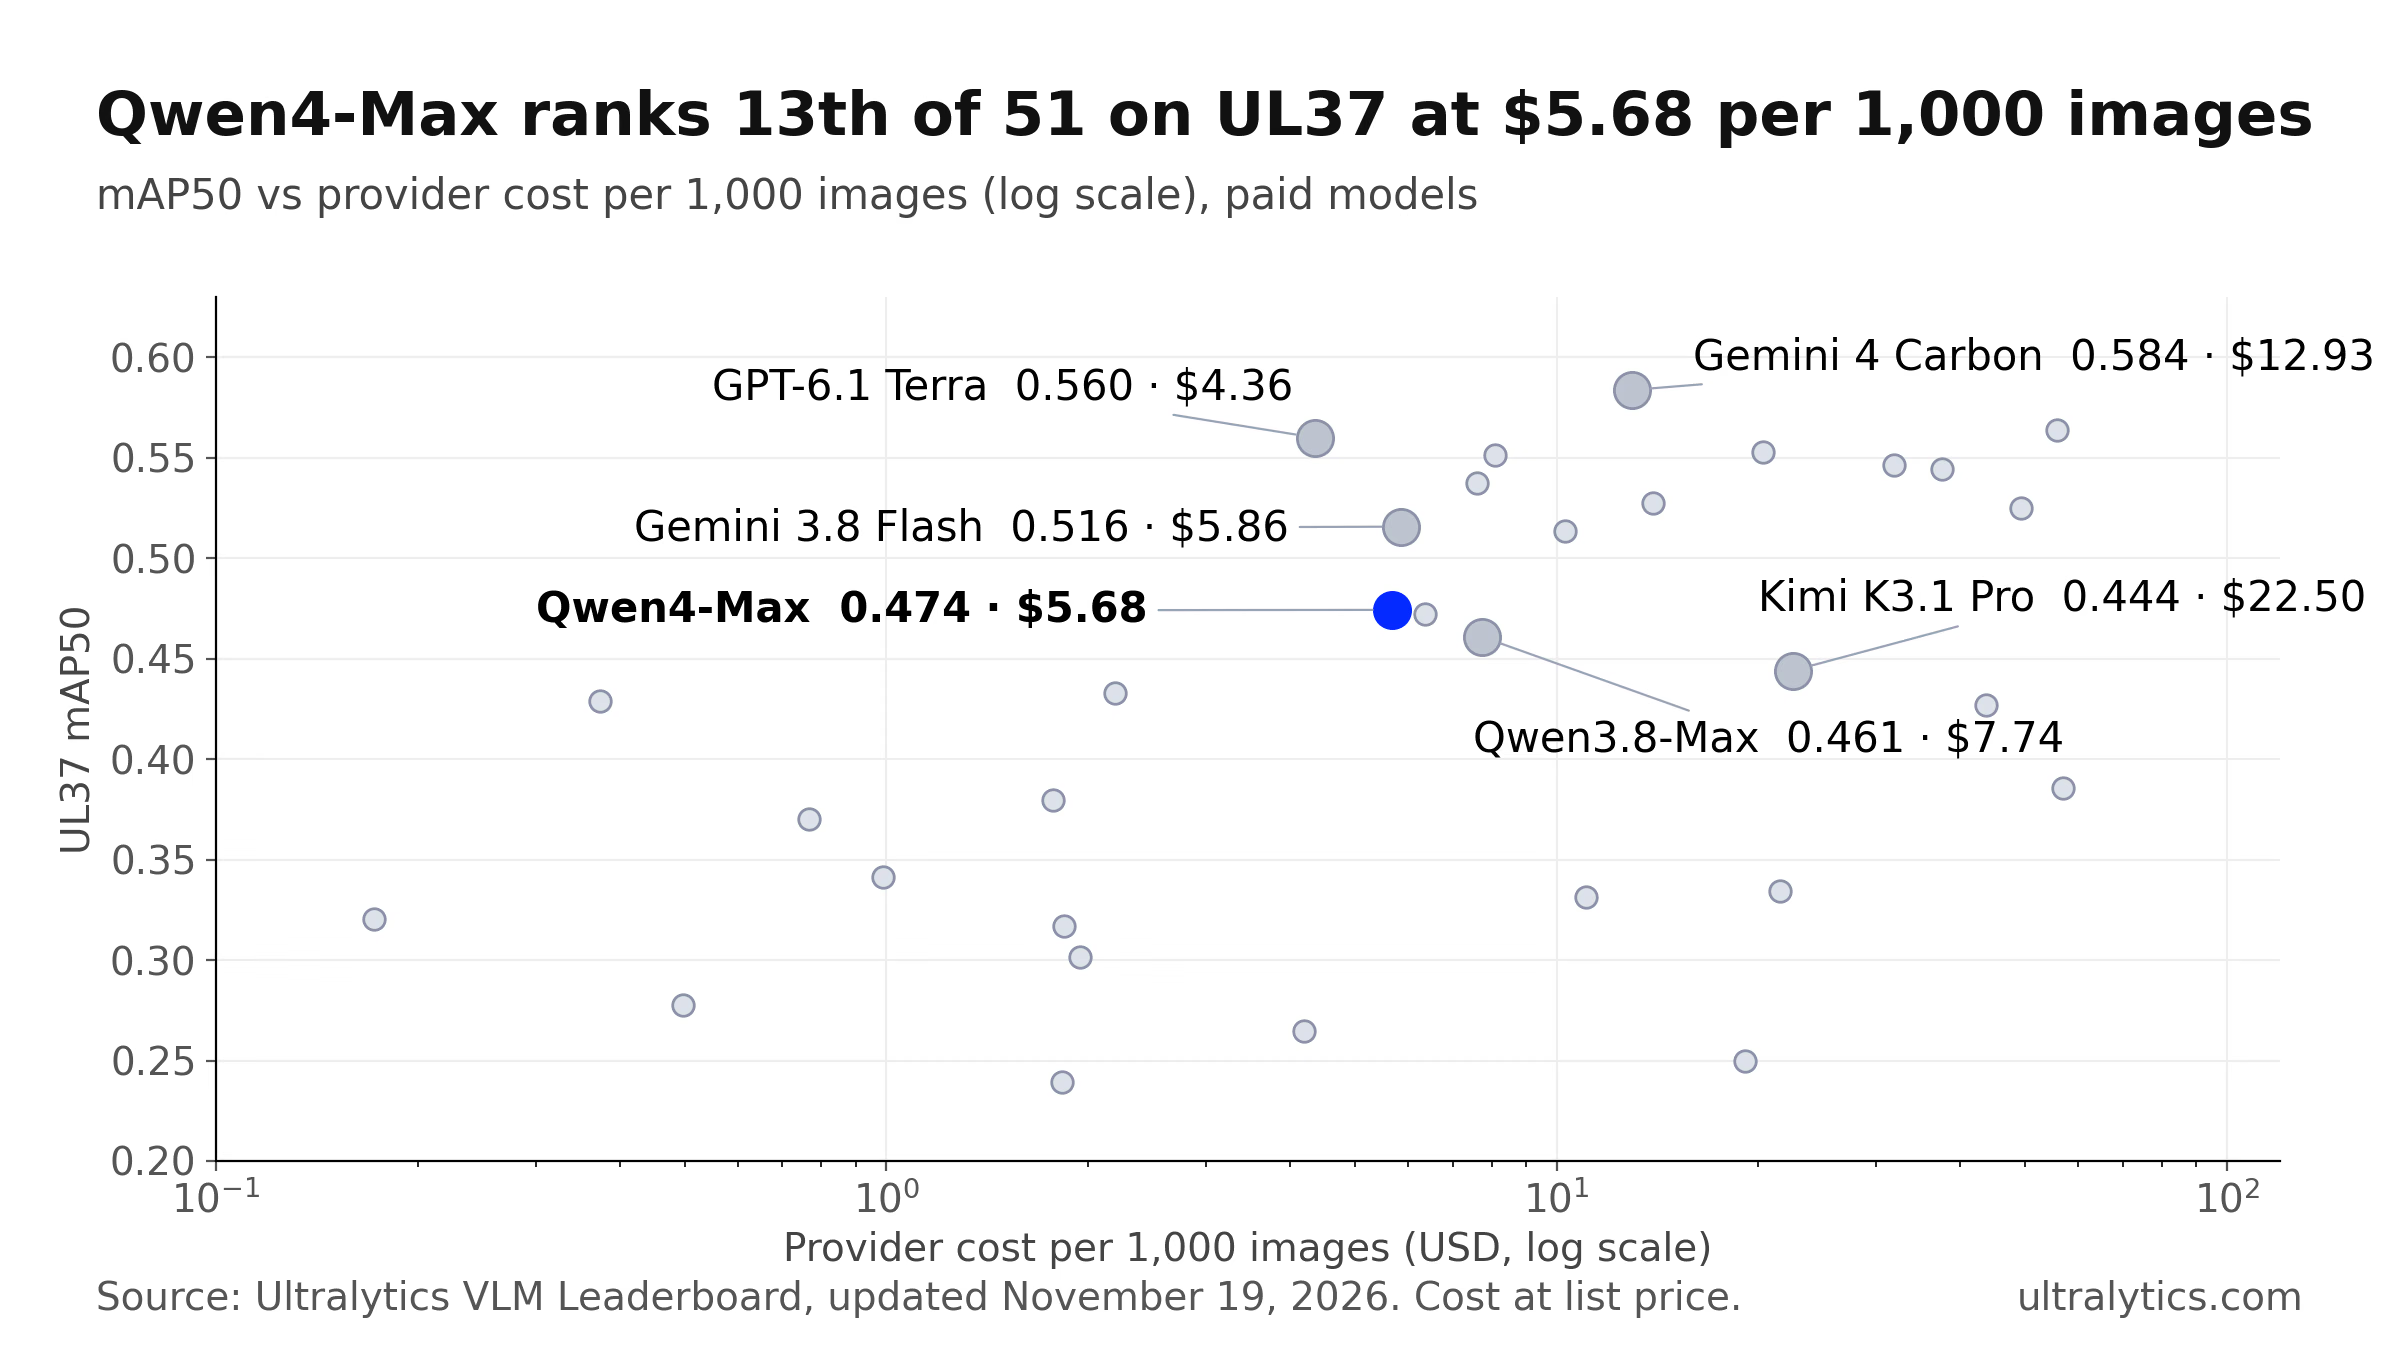
Mỗi điểm biểu thị một model trả phí trên Ultralytics VLM Leaderboard.
Alibaba phát triển Qwen4-Max cho mục đích gì#
Trong thông báo ra mắt, Alibaba mô tả Qwen4-Max là model Mixture-of-Experts thưa, có tổng cộng 2.4 nghìn tỷ tham số, trong đó 71 tỷ tham số được kích hoạt cho mỗi token, cùng khả năng xử lý hình ảnh gốc. Alibaba nhấn mạnh khả năng lập trình, tác vụ agentic và suy luận hình ảnh, đồng thời báo cáo rằng trên benchmark Work360 của riêng mình, Qwen4-Max vượt trội hơn Qwen3.8-Max trong khi giảm khoảng 60% chi phí trung bình mỗi tác vụ.
Ghi chú phát hành của Alibaba Cloud Model Studio mô tả model là “model đa phương thức flagship thế hệ tiếp theo trong dòng Qwen, kết hợp tạo văn bản, hiểu hình ảnh và video, cùng khả năng suy luận sâu”. Giá quốc tế của model là $1.50 cho mỗi triệu token đầu vào và $4.50 cho mỗi triệu token đầu ra, giảm từ mức $2 và $6 của Qwen3.8-Max. Model được cung cấp thông qua API của Alibaba; Alibaba cho biết các model Qwen4 nhỏ hơn với trọng số mở sẽ ra mắt sau.
Cả thông báo lẫn ghi chú phát hành đều không báo cáo kết quả phát hiện vật thể, vì vậy chúng tôi đã đo lường khía cạnh đó.
Qwen4-Max so với Qwen3.8-Max: rẻ hơn, mức cải thiện không đồng đều#
Qwen4-Max vượt trội hơn phiên bản tiền nhiệm trên 19 bộ dữ liệu, kém hơn trên 16 bộ và hòa trên một bộ. Mức tăng trung bình 0.013 mAP50 đến từ những cải thiện lớn ở một số bộ dữ liệu, bù lại các mức giảm rõ rệt ở những bộ khác.
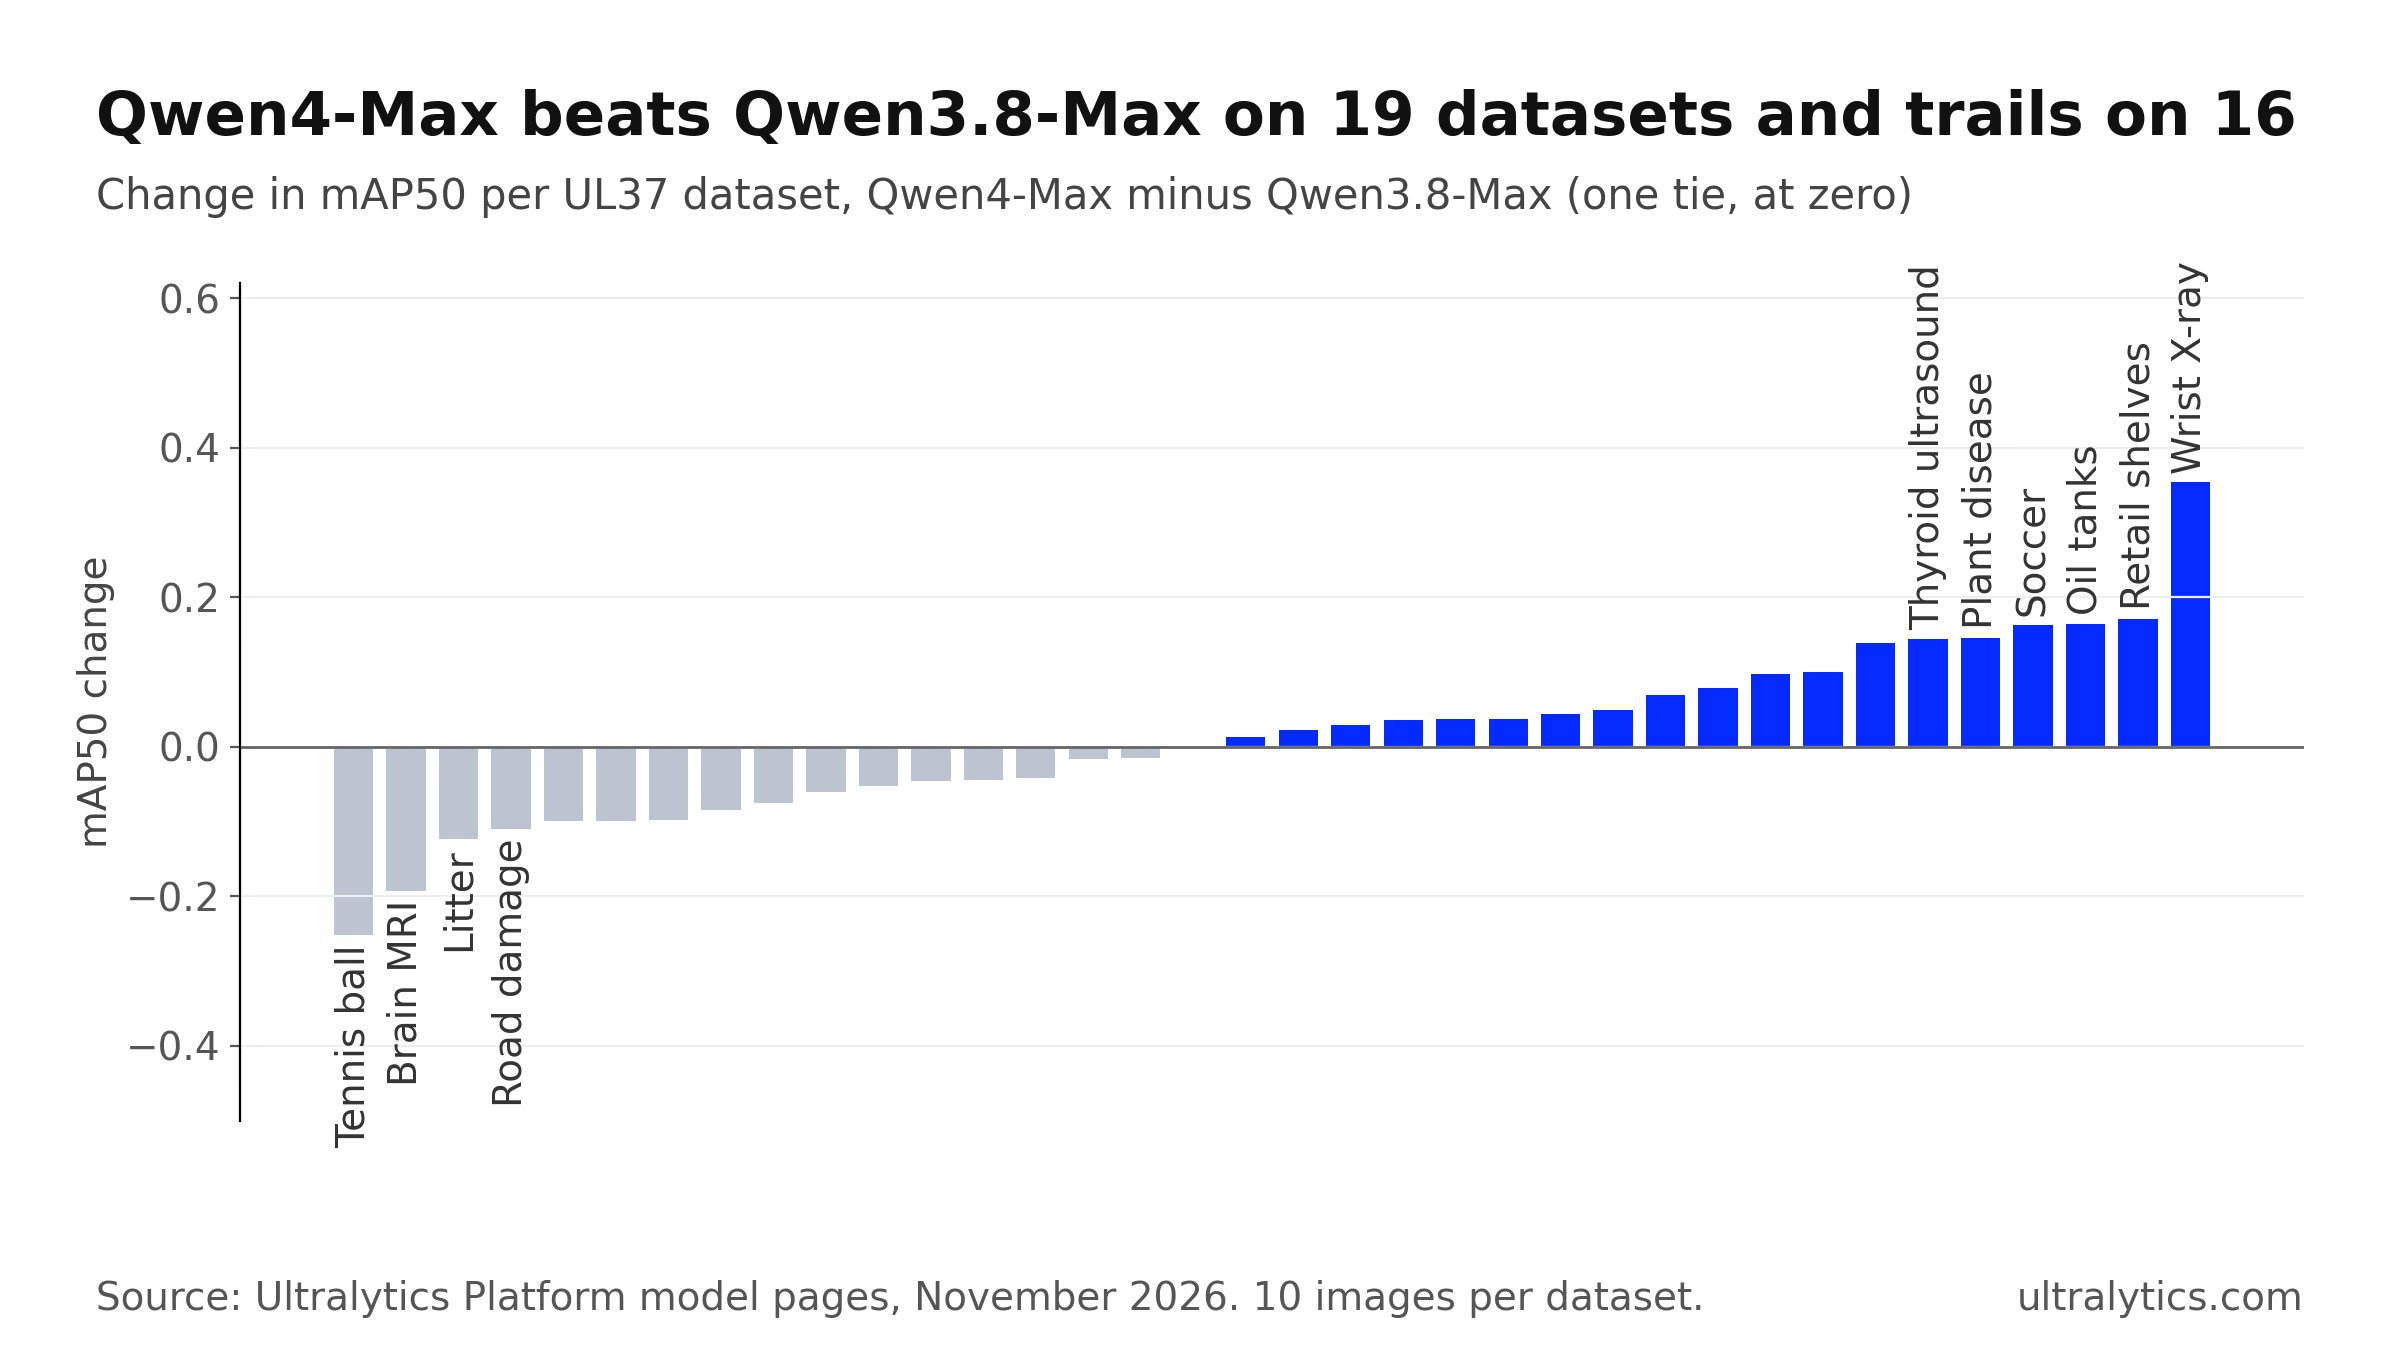
Mỗi cột biểu thị một bộ dữ liệu UL37, được sắp xếp từ mức giảm lớn nhất đến mức tăng lớn nhất.
| Bộ dữ liệu | Qwen4-Max | Qwen3.8-Max | Thay đổi |
|---|---|---|---|
| GRAZPEDWRI-DX ảnh X-quang cổ tay trẻ em | 0.4975 | 0.1437 | +0.3538 |
| SKU110K kệ bán lẻ xếp dày đặc | 0.6230 | 0.4516 | +0.1714 |
| Airbus bồn chứa dầu | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB bóng đá | 0.8345 | 0.6715 | +0.1630 |
| RacketVision bóng tennis | 0.3775 | 0.6299 | −0.2524 |
| Cheng MRI khối u não | 0.4421 | 0.6350 | −0.1929 |
mAP50 trên UL37 theo từng bộ dữ liệu, mỗi bộ gồm 10 ảnh; số liệu được hiển thị đến bốn chữ số thập phân để mức thay đổi khớp với hai điểm số.
Mức giảm chi phí rõ ràng hơn. Với mức $5.68 cho mỗi 1.000 ảnh so với $7.74, Qwen4-Max có chi phí thấp hơn khoảng 27% trên mỗi ảnh trong lần chạy của chúng tôi. Con số khoảng 60% do Alibaba công bố được tính trên một benchmark khác với thiết lập khác, nên không thể so sánh trực tiếp.
Điểm nổi bật của Qwen4-Max#
Ba kết quả đưa Qwen4-Max lên gần đầu bảng xếp hạng tổng thể, chứ không chỉ trong dòng Qwen.
| Bộ dữ liệu | Qwen4-Max | Thứ hạng trong 51 model | Model dẫn đầu |
|---|---|---|---|
| GRAZPEDWRI-DX ảnh X-quang cổ tay trẻ em | 0.4975 | 1st | Qwen4-Max (tiếp theo: Muse Ember 1.0, 0.378) |
| RUOD vật thể dưới nước | 0.774 | 2nd | Gemini 4 Carbon, 0.788 |
| SKU110K kệ bán lẻ xếp dày đặc | 0.623 | 2nd | Gemini 4 Carbon, 0.671 |
mAP50 trên UL37 theo từng bộ dữ liệu. Thứ hạng trong tổng số 51 model trên Ultralytics VLM Leaderboard.
Ảnh X-quang cổ tay. Trên ảnh X-quang chấn thương cổ tay ở trẻ em, Qwen4-Max đạt 0.4975, cao hơn mọi model khác mà chúng tôi đã thử nghiệm và hơn ba lần Qwen3.8-Max. Mỗi bộ dữ liệu chỉ đóng góp 10 ảnh, vì vậy hãy xem đây là tín hiệu đáng để thử nghiệm, không phải kết luận cuối cùng. Đây cũng không phải chẩn đoán hay xác nhận lâm sàng: trong nghiên cứu gán nhãn phân tích ảnh y tế, Qwen4-Max có thể tạo bản nháp bounding box để chuyên gia lâm sàng kiểm tra và chỉnh sửa.
Kệ bán lẻ. Tính trung bình trên hai bộ dữ liệu bán lẻ của UL37, Qwen4-Max đạt 0.752, cao hơn 0.724 của GPT-6.1 Terra. Trên SKU110K, nơi các kệ xếp kín sản phẩm từ mép này sang mép kia và tất cả thuộc cùng một lớp, model chỉ đứng sau Gemini 4 Carbon.
Cảnh dưới nước. Với các vật thể dưới nước trong RUOD, model đạt 0.774, xếp thứ hai trong 51 model và cao hơn mức 0.658 của GPT-6.1 Terra.
Hạn chế của Qwen4-Max#
Khoảng cách cũng rõ rệt như những điểm mạnh. Qwen4-Max đạt 0.000 trên ảnh lỗi bo mạch trần trong DeepPCB và 0.05 trên ảnh quét an ninh trong IEDXray, trong khi các model Gemini 4 đạt khoảng 0.30. Điểm trên ảnh X-quang ngực phát hiện bệnh lao là 0.037; trên bộ dữ liệu MRI khối u não, model kém GPT-6.1 Terra với điểm 0.442 so với 0.904.
Tính trung bình theo lĩnh vực, model cũng kém GPT-6.1 Terra ở tài liệu, giao diện người dùng và bản vẽ CAD (0.357 so với 0.494), đường sá và giao thông (0.396 so với 0.572), cũng như lĩnh vực hình ảnh y tế nói chung (0.325 so với 0.505). Trước khi gán nhãn một bộ dữ liệu lớn thuộc bất kỳ lĩnh vực nào trong số này, hãy mở trang model Qwen4-Max, nơi phát lại các bounding box đã ghi nhận của model trên mọi bộ dữ liệu benchmark bên cạnh nhãn tham chiếu.
Qwen4-Max so với GPT-6.1 Terra, Gemini 3.8 Flash và Kimi K3.1 Pro#
| Đối đầu trên 36 bộ dữ liệu UL37 | Qwen4-Max thắng | Thua | Hòa |
|---|---|---|---|
| so với GPT-6.1 Terra | 11 | 23 | 2 |
| so với Gemini 3.8 Flash | 17 | 18 | 1 |
| so với Kimi K3.1 Pro | 21 | 14 | 1 |
| so với Qwen3.8-Max | 19 | 16 | 1 |
GPT-6.1 Terra là lựa chọn tổng quát mạnh hơn: model thắng trên 23 bộ dữ liệu so với 11 bộ của Qwen4-Max, có chi phí thấp hơn và thời gian phản hồi trung vị chưa bằng một nửa. Gemini 3.8 Flash có kết quả gần như ngang bằng trên các bộ dữ liệu với mức giá tương đương, nhưng điểm trung bình cao hơn. Khi so với Kimi K3.1 Pro, Qwen4-Max thắng trên 21 bộ dữ liệu so với 14 bộ, với chi phí mỗi ảnh chỉ bằng khoảng một phần tư.
Ultralytics Platform chạy Qwen4-Max như thế nào#
Hai thiết lập ảnh hưởng đến kết quả của Qwen4-Max trên Platform. Thứ nhất, model chạy với mức suy luận “low” của Alibaba thay vì mức mặc định “high”. Trong thử nghiệm của Ultralytics trên 370 ảnh benchmark (360 ảnh được chấm điểm cộng 10 ảnh tham chiếu COCO), mức mặc định vượt quá giới hạn 115 giây cho mỗi yêu cầu ở 11 ảnh, còn mức “low” vượt giới hạn ở 3 ảnh; mAP50 không đổi. Thứ hai, Platform yêu cầu các model Qwen trả về JSON gọn, vì thiếu thiết lập này thì điểm mAP50 giảm khoảng 0.02.
Bạn không cần thao tác gì để áp dụng hai thiết lập này: chỉ cần chọn Qwen4-Max trong bộ chọn model, Platform sẽ tự áp dụng cả hai.
Chi phí cho một batch gán nhãn bằng Qwen4-Max#
Chi phí nhà cung cấp được tính từ mức sử dụng token do Alibaba báo cáo, áp dụng mức giá của model trên Platform cho mỗi 1.000 ảnh được gán nhãn thành công; ảnh của bạn có thể sử dụng nhiều hoặc ít token hơn. Batch Annotation tính thêm phí xử lý Platform là $1.00 cho mỗi 1.000 ảnh, tối thiểu $0.01 cho mỗi lần chạy.
| Mỗi 1.000 ảnh | Qwen4-Max |
|---|---|
| Alibaba tính phí | $5.68 |
| Phí xử lý của Ultralytics Platform | $1.00 |
| Tổng cộng | $6.68 |
Bạn thanh toán trực tiếp cho Alibaba bằng API key của mình, bao gồm cả các dự đoán thử nghiệm bạn chạy trước; Ultralytics không cộng thêm phí vào token. Nếu không muốn dùng API key trả phí, bạn có thể dùng Qwen3.8 27B được lưu trữ trên Platform mà không cần API key, đạt 0.351 mAP50 trên UL37.
Cách chạy gán nhãn tự động bằng Qwen4-Max trên Ultralytics Platform#
Qwen4-Max là model phát hiện dựa trên prompt lớp, dành cho các bộ dữ liệu có từ 1 đến 200 lớp. Model trả về bounding box theo tên lớp riêng của bộ dữ liệu; sau đó bạn xem xét và chỉnh sửa.
- Tạo API key trong Alibaba Cloud Model Studio cho khu vực quốc tế (Singapore), là endpoint mà Platform sử dụng.
- Yêu cầu chủ sở hữu workspace thêm API key trong mục Alibaba tại Settings > API Keys của workspace chứa bộ dữ liệu. Tài liệu về API key của nhà cung cấp giải thích chi tiết.
- Trong trình chỉnh sửa gán nhãn, chuyển sang chế độ Smart và chọn Qwen4-Max trong mục Alibaba của bộ chọn model.
- Nhấn Predict, hoặc
P, trên một vài ảnh đại diện cho dữ liệu của bạn. - Khi đã hài lòng, mở trang bộ dữ liệu và chọn More actions > Batch Annotation để gán nhãn mọi ảnh chưa có nhãn. Batch Annotation hoạt động với bộ dữ liệu lưu trữ trên Platform có tối đa ba kênh ảnh; Platform sẽ lưu phiên bản bộ dữ liệu trước để bạn có thể khôi phục.
- Xem lại các box, lưu chúng, rồi huấn luyện model Ultralytics YOLO26 trên kết quả ngay trong cùng workspace.
Tài liệu gán nhãn giải thích đầy đủ về chế độ Smart và Batch Annotation; hướng dẫn chọn VLM dựa trên độ chính xác và độ bao phủ của chúng tôi giúp bạn chọn model phù hợp với quy trình duyệt nhãn.
Ai nên dùng Qwen4-Max#
| Nếu bạn cần… | Bắt đầu với |
|---|---|
| Model gán nhãn trả phí đa dụng | GPT-6.1 Terra: điểm UL37 cao hơn, chi phí thấp hơn và nhanh hơn Qwen4-Max |
| Bản nháp ảnh X-quang cổ tay trẻ em để chuyên gia xem xét | Qwen4-Max: điểm UL37 cao nhất trong 51 model trên bộ dữ liệu này |
| Kệ bán lẻ xếp dày đặc hoặc cảnh dưới nước | Qwen4-Max; hãy so sánh với Gemini 4 Carbon trên ảnh của bạn |
| Cần dùng model của Alibaba hoặc chuyển từ Qwen3.8-Max | Qwen4-Max: điểm cao hơn, chi phí mỗi ảnh thấp hơn, không có yêu cầu nào thất bại trong lần chạy của chúng tôi |
| Không có API key trả phí | Qwen3.8 27B, Gemma 4 26B hoặc SAM 3.1 Text được lưu trữ trên Platform |
Với phần lớn công việc gán nhãn, GPT-6.1 Terra vẫn là lựa chọn mặc định tốt hơn. Qwen4-Max phù hợp khi dữ liệu của bạn giống các bộ dữ liệu nổi bật của model, vì vậy trước tiên hãy thử nghiệm trên một mẫu ảnh của riêng bạn.
Câu hỏi thường gặp
Model xếp thứ 13/51 trên benchmark của chúng tôi và có một vài kết quả nổi bật. Trên benchmark UL37, model đạt 0.474 mAP50, xếp thứ 13 trong 51 model và không có yêu cầu nào thất bại. Model đứng đầu trong 51 model trên ảnh X-quang cổ tay trẻ em, đứng thứ hai trên vật thể dưới nước và kệ bán lẻ xếp dày đặc, nhưng đạt điểm thấp trên lỗi bo mạch và ảnh X-quang an ninh.
Xét trung bình thì có. Qwen4-Max đạt 0.474 mAP50 so với 0.461, có chi phí $5.68 cho mỗi 1.000 ảnh so với $7.74, đồng thời hoàn tất mọi yêu cầu trong khi Qwen3.8-Max thất bại ở 1.7% yêu cầu. Mức cải thiện không đồng đều: Qwen4-Max vượt Qwen3.8-Max trên 19 bộ dữ liệu và kém hơn trên 16 bộ, với mức giảm lớn ở tác vụ phát hiện bóng tennis và MRI não.
Đối với tác vụ gán nhãn tổng quát, GPT-6.1 Terra đạt 0.560 mAP50, thắng Qwen4-Max trên 23 trong số 36 dataset, có chi phí $4.36 cho mỗi 1.000 ảnh và thời gian phản hồi trung vị là 5.1 giây. Hãy chọn Qwen4-Max khi dữ liệu của bạn tương tự các dataset mà model hoạt động tốt nhất, chẳng hạn như ảnh X-quang cổ tay, kệ bán lẻ chứa nhiều sản phẩm hoặc cảnh dưới nước, rồi xác minh bằng ảnh của chính bạn.
Model có thể tạo bản nháp bounding box để chuyên gia rà soát trong quá trình gán nhãn nghiên cứu; model không chẩn đoán bệnh. Model đạt điểm UL37 cao nhất trong số 51 model trên ảnh X-quang cổ tay trẻ em, với 0.4975 mAP50, nhưng điểm trung bình trên tám dataset y tế của chúng tôi là 0.325, thấp hơn mức 0.505 của GPT-6.1 Terra; model cũng đạt kết quả kém trên ảnh X-quang ngực.
Chi phí Alibaba vào khoảng $5.68: mức phí này được tính từ lượng token Alibaba báo cáo, áp dụng mức giá của Platform dành cho model, cho mỗi 1.000 ảnh được gán nhãn thành công. Giá niêm yết quốc tế của Alibaba là $1.50 cho mỗi triệu token đầu vào và $4.50 cho mỗi triệu token đầu ra. Ultralytics Platform tính thêm phí Batch Annotation $1.00 cho mỗi 1.000 ảnh, đưa tổng chi phí lên khoảng $6.68.
Tạo API key Alibaba Cloud Model Studio dành cho thị trường quốc tế, yêu cầu chủ sở hữu workspace thêm key trong mục Alibaba tại Settings > API Keys, sau đó chọn Qwen4-Max ở chế độ Smart trong trình chỉnh sửa chú thích. Thử nghiệm với một vài ảnh, chạy Batch Annotation, rà soát các bounding box rồi huấn luyện model Ultralytics YOLO26 trong cùng workspace.
Được viết bởi
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









