So wählst du ein VLM für die automatische Annotation anhand von Präzision und Recall aus
Ein VLM für die automatische Annotation anhand von Präzision und Recall auswählen: Welche Modelle erzeugen weniger überflüssige Boxen, übersehen weniger Objekte und wie testest du sie mit deinen eigenen Daten?
 Sergiu Waxmann15 Min. Lesezeit
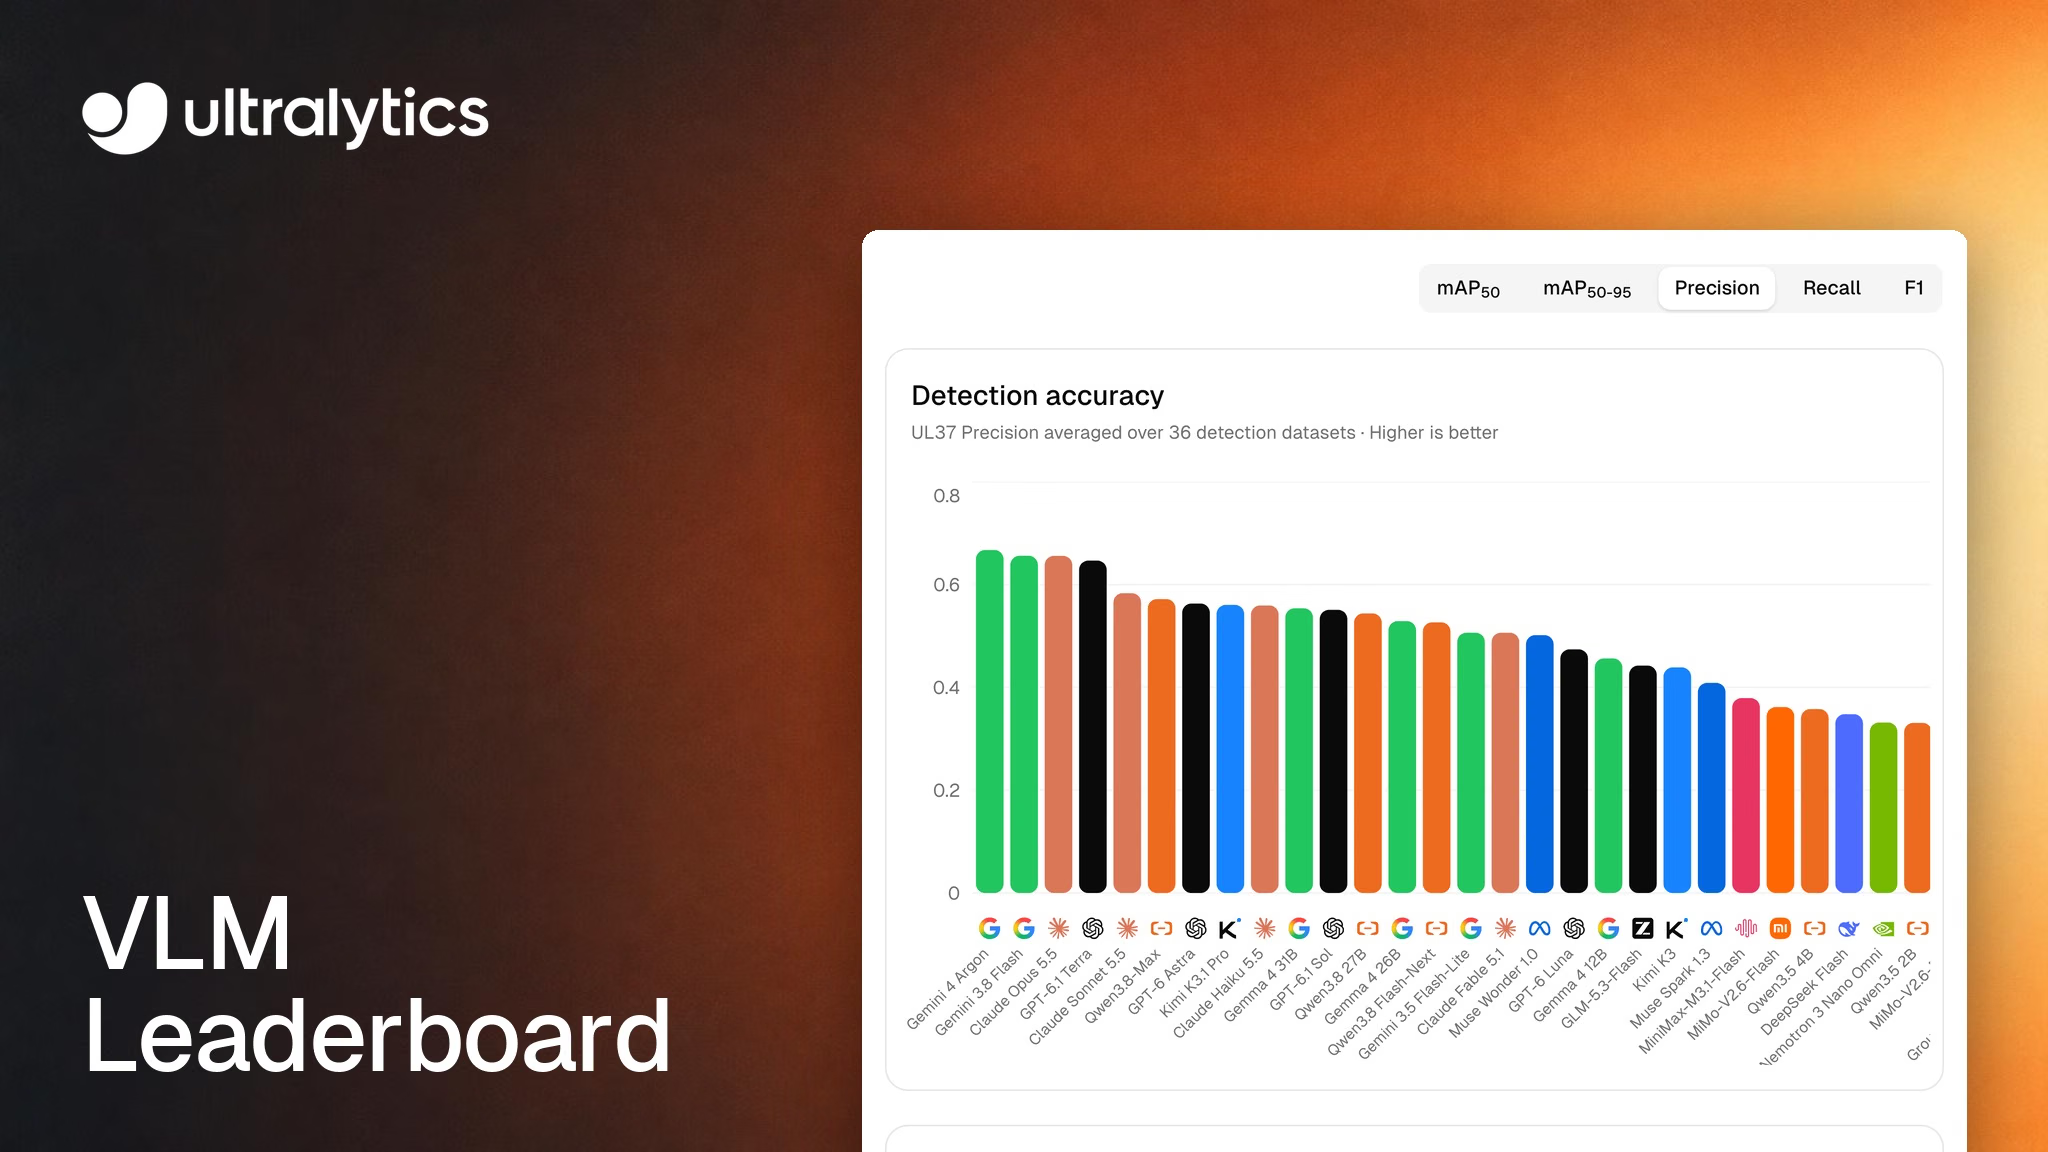
Bei der Auswahl eines Modells zur automatischen Annotation eines Datensatzes kommt es darauf an, welche Nacharbeit deine Prüfer lieber übernehmen: überzählige Boxen löschen oder die vom Modell übersehenen Boxen ergänzen. Die Ultralytics-VLM-Bestenliste zeigt diesen Zielkonflikt jetzt für jedes Modell anhand von Präzision (dem Anteil der Modell-Boxen, die korrekt sind) und Recall (dem Anteil der annotierten Objekte, die das Modell findet) – basierend auf den am 28. Oktober 2026 veröffentlichten Benchmark-Ergebnissen.
Für die saubersten ersten Entwürfe solltest du mit Gemini 4 Argon beginnen. Wenn möglichst wenige Objekte übersehen werden sollen, starte mit GPT-6 Astra. Für die beste Ausgewogenheit und die niedrigsten Kosten unter den sechs Modellen mit den höchsten Ergebnissen wähle GPT-6.1 Terra. Wenn du keinen API-Schlüssel für einen eigenen KI-Anbieter hast, beginne mit dem gehosteten Qwen3.8 27B oder SAM 3.1 Text für überfüllte Szenen, bei denen du lieber überzählige Boxen entfernst.
Diese Anleitung erklärt, wie du die Zahlen liest, wofür sich die einzelnen Modelle eignen und wie du deine Wahl anhand eigener Bilder bestätigst. Ranglisten und Preise ändern sich nach jedem Durchlauf. Betrachte die Zahlen hier daher als Beispiele aus dem Oktober 2026 und prüfe die aktuellen Ergebnisse in der Bestenliste.
Bei Modellen mit Klassenabfrage gibt es keinen Konfidenzregler – deine Wahl des Modells bestimmt den Schwellenwert.#
Mit einem Ultralytics-YOLO-Modell im Annotationseditor kannst du den Zielkonflikt selbst einstellen. Erhöhst du den Konfidenzschwellenwert, erhältst du weniger falsch-positive Boxen, übersiehst dafür aber mehr Objekte; senkst du ihn, passiert das Gegenteil. Modelle für visuelle Sprachverarbeitung (VLMs) mit Klassenabfrage funktionieren anders. Wie in der Dokumentation zum Annotationseditor erklärt, erkennen sie die Klassen deines Datensatzes anhand modellspezifischer Schwellenwerte und geben keine Konfidenzwerte zurück. Deshalb blendet die Ultralytics Platform die Einstellungen für Konfidenz und IoU aus, solange ein solches Modell ausgewählt ist.
Dadurch ändert sich die Bedeutung von Präzision und Recall in der Rangliste. Laut der Benchmark-Methodik zählen Präzision und Recall jede vom Modell zurückgegebene Box bei einem IoU von 0,5 – ohne verborgenen Betriebspunkt. Die Kennzahlen beschreiben die Boxen, die deine Prüfer tatsächlich erhalten.
Dem Benchmark hinter der Rangliste liegt UL37 v2 zugrunde: 10 Bilder aus jeweils 36 realen Objekterkennungsdatensätzen auf der Platform sowie 10 separat ausgewertete Referenzbilder aus COCO 2017, insgesamt also 370 Bilder und 7.268 Boxen. Jedes Bild durchläuft dieselbe Produktionspipeline wie Smart und Batch Annotation, wobei die Klassennamen des jeweiligen Datensatzes verwendet werden. SAM 3.1 verfeinert die Boxen aller Modelle außer denen von SAM 3. Die Auswertung verwendet die Erkennungsmetriken des Ultralytics-Pakets, also denselben Code, mit dem YOLO-Modelle validiert werden. Jeder Datensatz erhält in der Durchschnittsberechnung das gleiche Gewicht.
Präzision erfasst nicht zugeordnete Boxen, Recall nicht zugeordnete Objekte.#
Präzision ist der Anteil der Modellboxen, die bei einem IoU von 0,5 einem annotierten Objekt der richtigen Klasse entsprechen. Recall ist der Anteil der annotierten Objekte, denen das Modell eine Box zugeordnet hat. Für die Prüfung bedeutet das:
- Niedrige Präzision bedeutet, dass mehr Boxen gelöscht, neu beschriftet oder angepasst werden müssen, bis sie passen.
- Niedriger Recall bedeutet, dass mehr annotierte Objekte eine hinzugefügte, angepasste oder neu beschriftete Box benötigen.
- F1 ist das harmonische Mittel der beiden Werte, 2 x P x R / (P + R), und fasst beide in einer Kennzahl zusammen. Die Kennzahl sagt nichts darüber aus, wie lange eine Prüfung dauert.
- mAP50 und mAP50-95 ordnen Modelle anhand der durchschnittlichen Präzision über alle Klassen ein: bei IoU 0,5 sowie über die strengeren Schwellenwerte von 0,50 bis 0,95. Die Rangliste ist nach mAP50 sortiert.
Hier sind die sechs Modelle mit einem mAP50 über 0,51. Die Kosten sind anhand der vom Anbieter gemeldeten Token-Nutzung pro 1.000 erfolgreich annotierte Benchmark-Bilder geschätzt; die Latenz ist die mediane Antwortzeit:
| Modell | mAP50 | mAP50-95 | Präzision | Trefferquote | F1 | Anbieterkosten / 1.000 Bilder (Benchmark-Nutzung) | Latenz |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*Die Kostenschätzung für Gemini 4 Argon basiert auf dem Einführungspreis von Google, der bis zum 30. November 2026 gilt. Ab dem 1. Dezember verdoppelt sich der reguläre Preis von Google bei gleicher Nutzung auf etwa 15 $ pro 1.000 Bilder. Batch Annotation auf der Ultralytics Platform kostet zusätzlich 1,00 $ pro 1.000 verarbeitete Bilder – unabhängig vom Modell, auch bei gehosteten Modellen.
Die sechs Modelle teilen sich in zwei Gruppen. Argon, Opus 5.5 und Gemini 3.8 Flash erreichen eine Präzision von 0,66 bis 0,67, aber einen Recall unter 0,60: Ein hoher Anteil ihrer Boxen stimmt, doch sie finden weniger der annotierten Objekte. Astra und Sol erreichen einen Recall von 0,62 bis 0,63 bei einer Präzision von 0,55 bis 0,56: Sie finden einen höheren Anteil der annotierten Objekte, aber ein geringerer Anteil ihrer Boxen stimmt. Terra liegt zwischen den Gruppen und führt bei mAP50 und F1.
Präzision hat Vorrang, wenn überflüssige Boxen teuer zu korrigieren sind#
Mit 0,667 hat Gemini 4 Argon die höchste Gesamtpräzision der 40 Modelle im Benchmark. Der Kompromiss ist ein durchschnittlicher Recall von 0,585, der unter dem der Recall-Spitzenmodelle liegt.
Präzision ist besonders wichtig, wenn falsch zugeordnete Boxen schwer zu entdecken sind. Bei einem überfüllten Bild muss ein Prüfer eine falsche Box unter vielen richtigen finden, bevor sie korrigiert werden kann. Die dicht bestückten Verkaufsregale in SKU110K zeigen, wie stark die Präzision bei solchen Bildern schwanken kann: In unseren Ergebnissen für GPT-6.1 Terra erreichte Terra dort eine Präzision von 0,79 und einen Recall von 0,73, gegenüber 0,49 und 0,77 bei GPT-6.1 Sol.
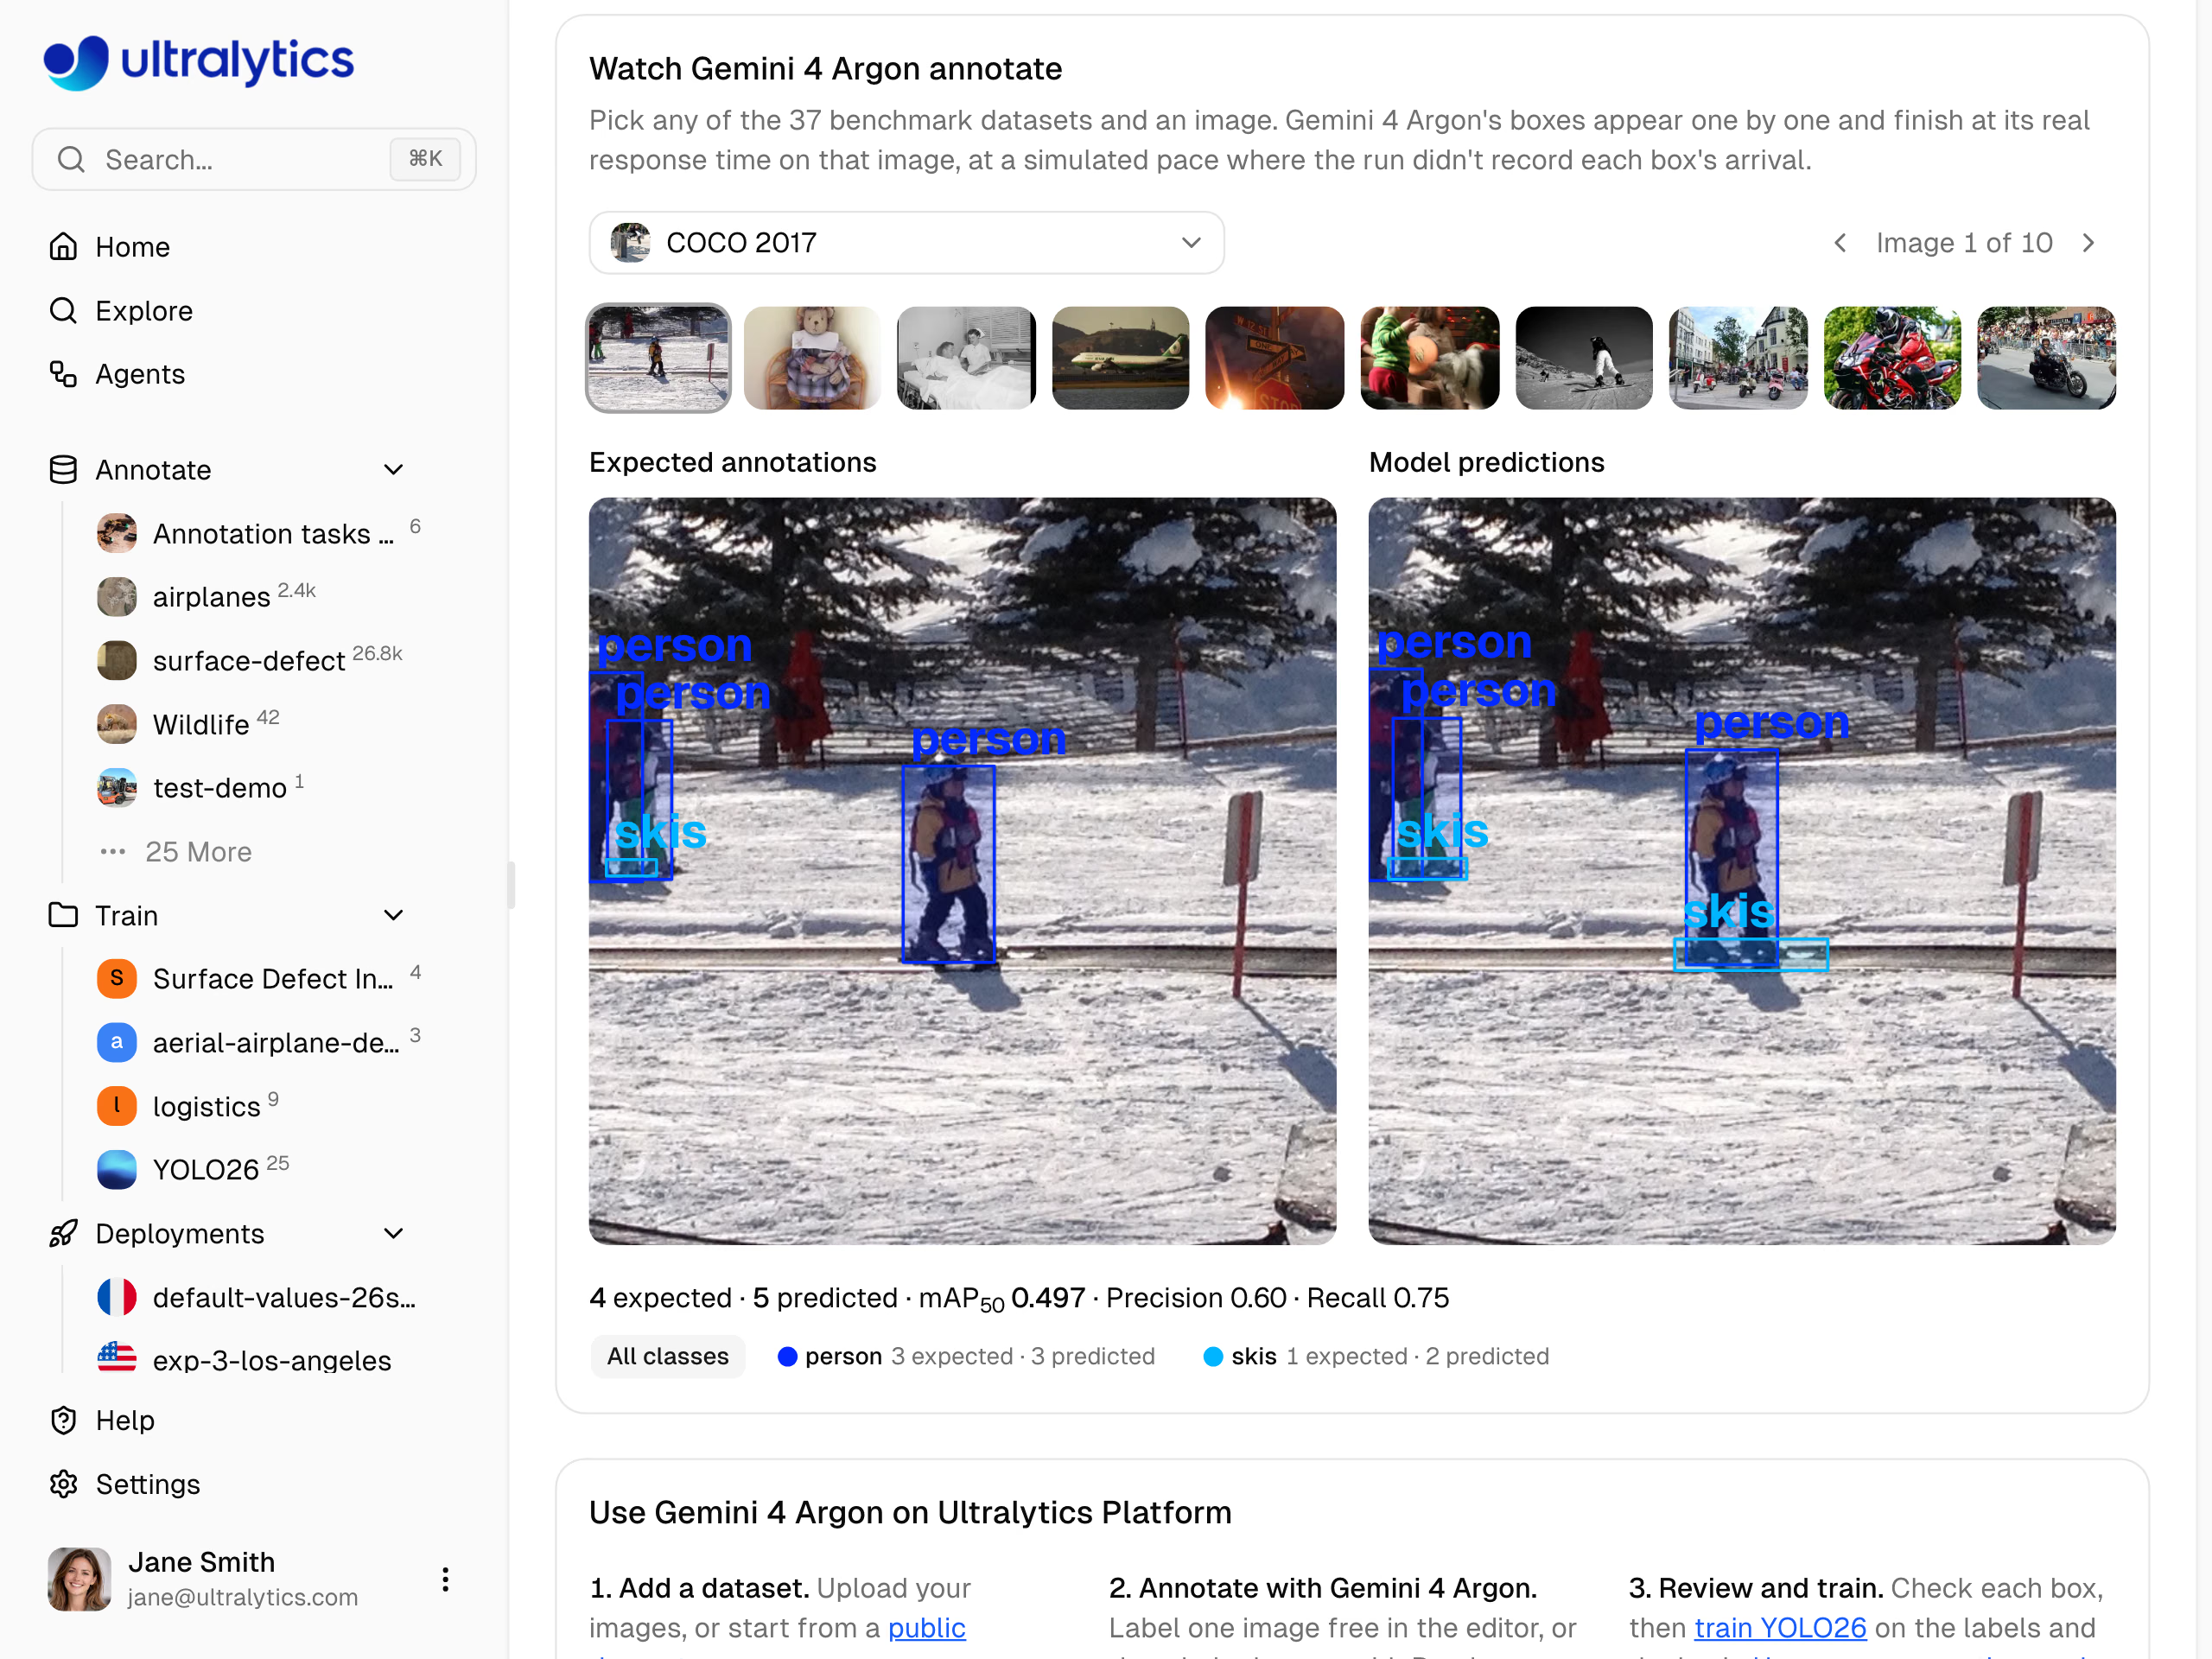
Gemini 4 Argon: 5 vorhergesagte Boxen für 4 annotierte Objekte, Präzision 0,60, Recall 0,75.
Bei Argon gab es im Benchmark außerdem keine fehlgeschlagenen Anfragen, und der Median von 4,6 Sekunden ist der schnellste unter den beiden bestplatzierten Modellen. Wähle Argon, wenn deine Daten den Bereichen ähneln, in denen das Modell besonders gut abschneidet – Luftbildern, Unterwasseraufnahmen, Wärmebildern und Sicherheitsröntgenbildern (bei den Sicherheitsaufnahmen aus dem IEDXray-Datensatz erzielt es mit 0,298 den besten mAP50-Wert) – und wenn dein Team lieber einige übersehene Objekte ergänzt, als nach vereinzelten überzähligen Boxen zu suchen.
Recall hat Vorrang, wenn übersehene Objekte besonders schwerwiegend sind#
GPT-6 Astra hat mit 0,627 den höchsten durchschnittlichen Recall in der Rangliste. Der Preis dafür ist eine Präzision von 0,56.
Eine auf Recall ausgerichtete Annotation ist sinnvoll, wenn ein nicht annotiertes Objekt den kostspieligeren Fehler darstellt. Ein übersehener Defekt oder eine übersehene Läsion in deinen Trainingsdaten bringt dem Detektor bei, das Objekt als Hintergrund zu behandeln. Um eine fehlende Box zu finden, musst du jedes Bild nach etwas durchsuchen, das nicht markiert ist. Astra erzielt bei 7 der 36 Datensätze den besten mAP50-Wert, darunter bei den Röntgenaufnahmen von Handgelenken aus dem Datensatz TBX11K (0,330), den pädiatrischen Röntgenaufnahmen von Handgelenken aus dem Datensatz GRAZPEDWRI-DX (0,354) und den Leiterplattenoberflächendefekten aus dem Datensatz DsPCBSD+ (0,394): Das ist ein Grund, Astra mit ähnlichen Daten zu testen, aber kein Beleg dafür, dass Astra bei deinen Daten weniger Objekte übersieht.
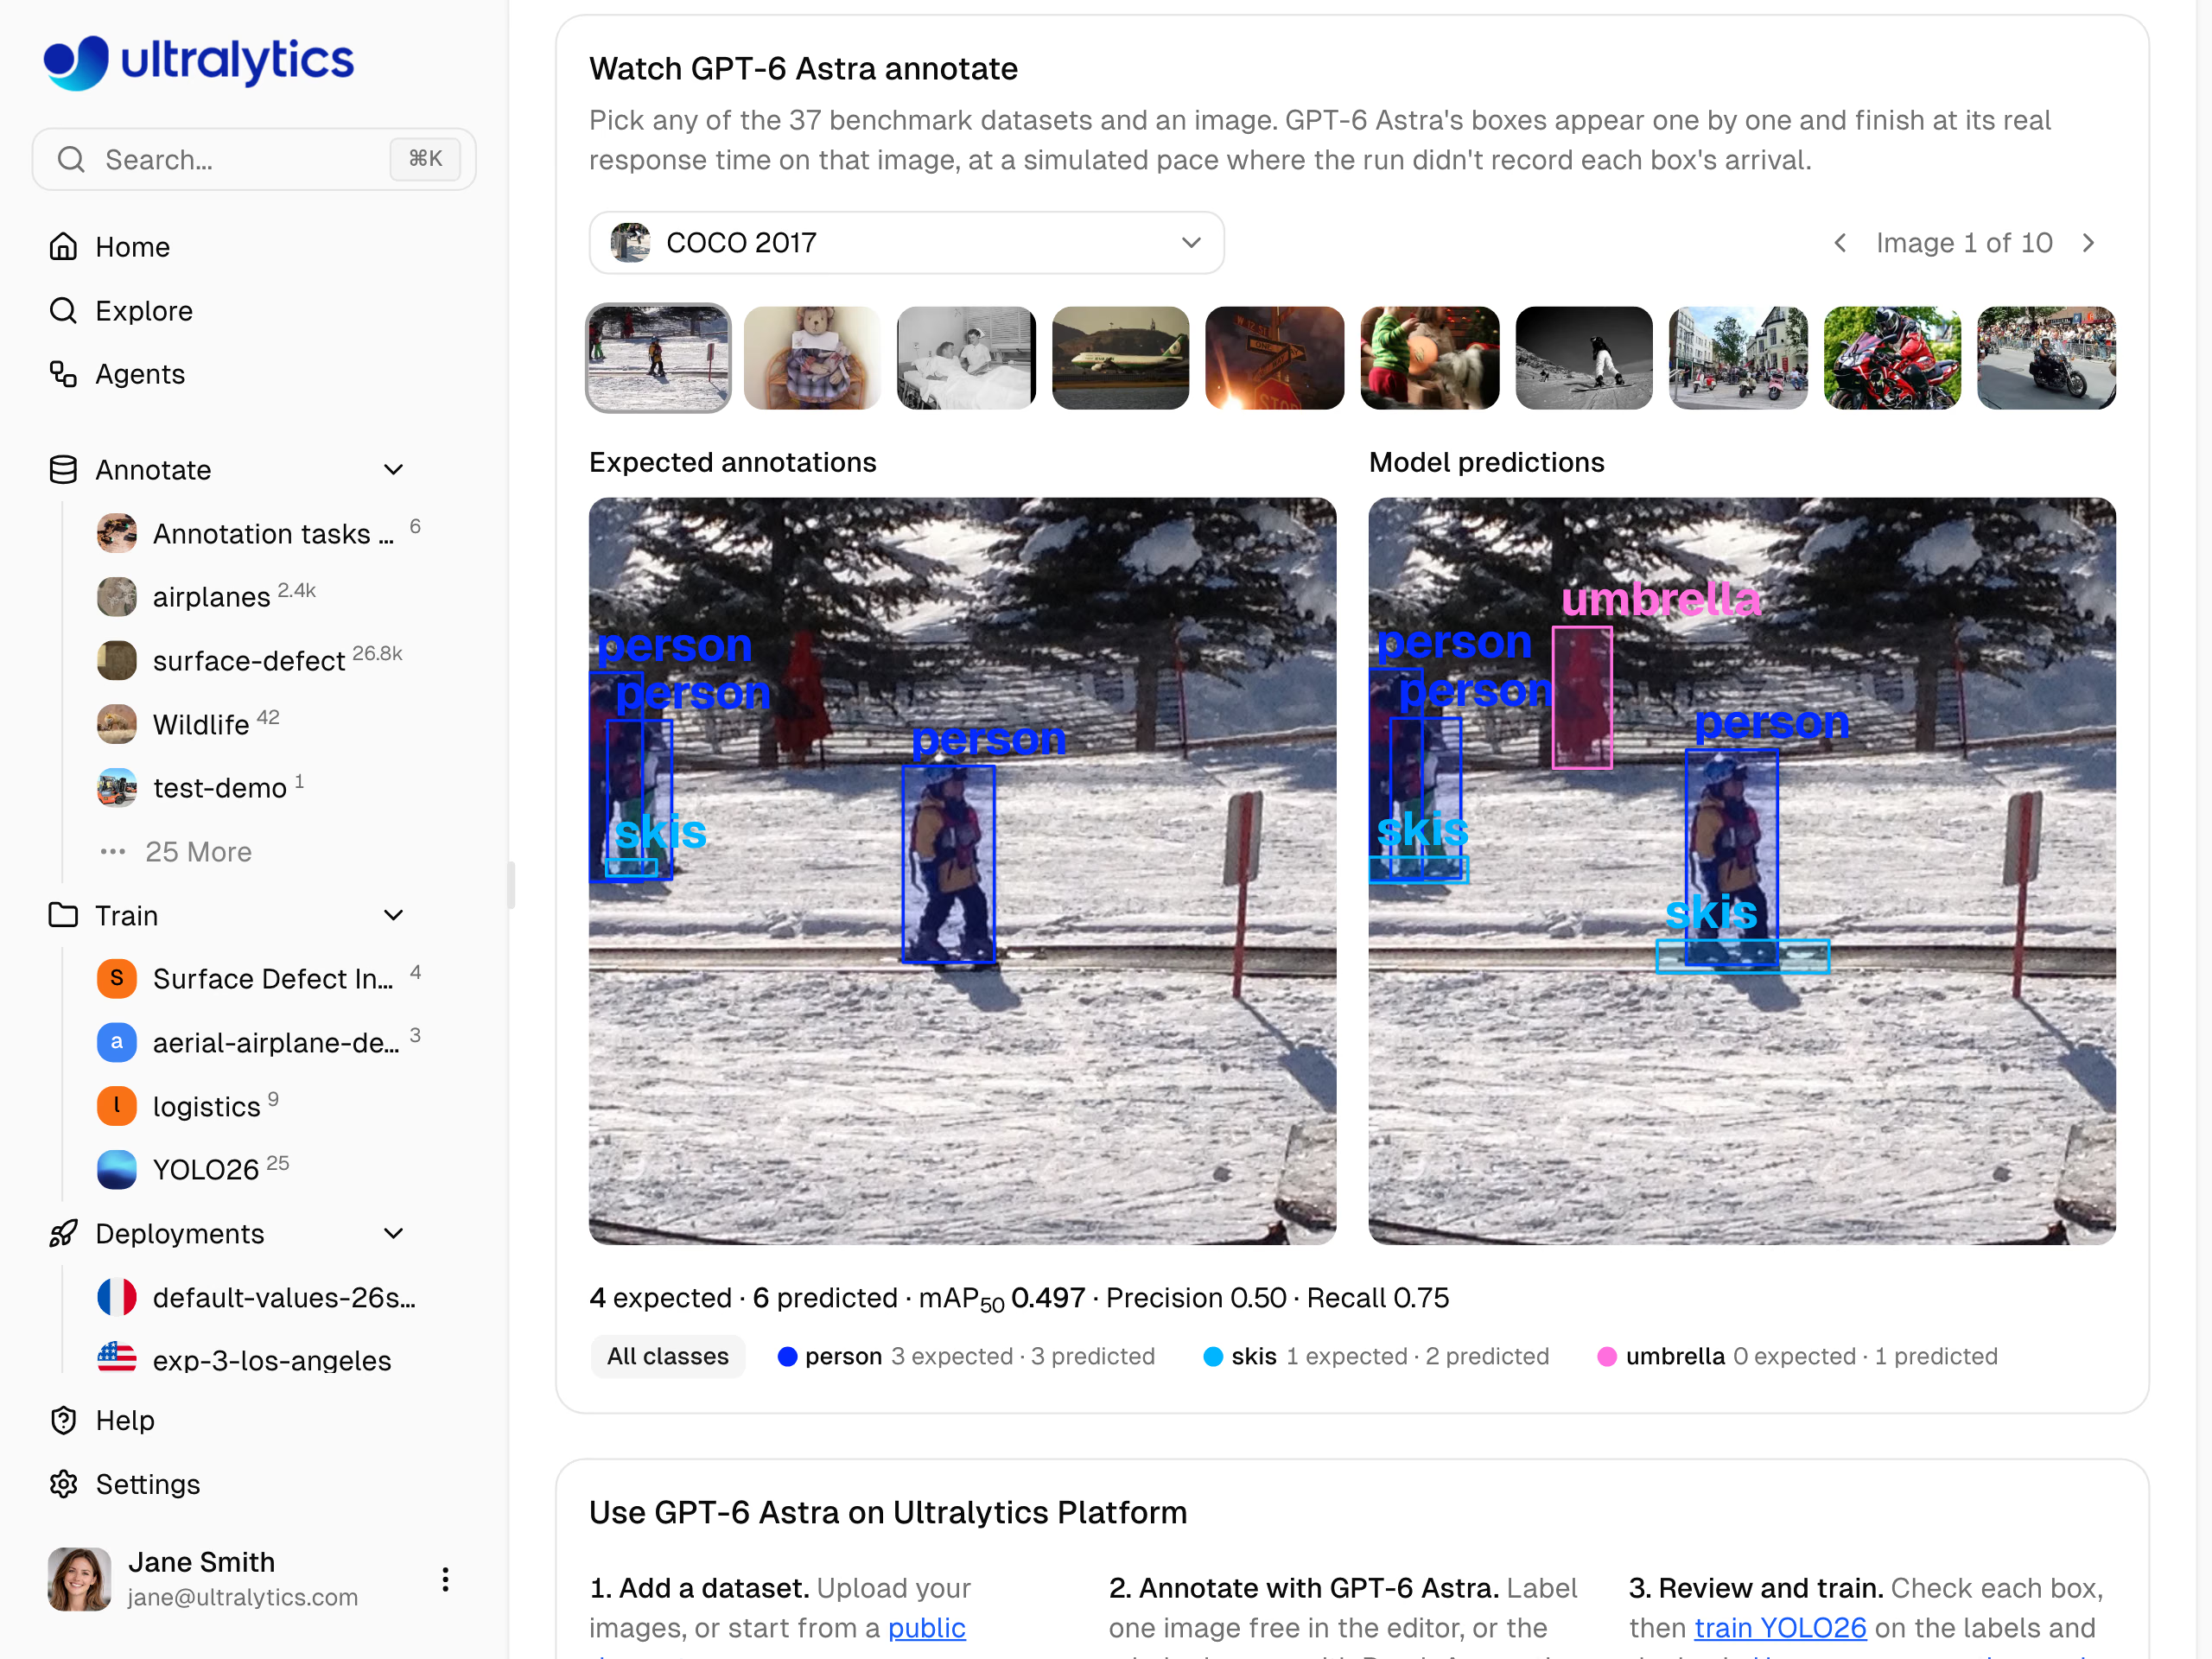
GPT-6 Astra: 6 Boxen für dieselben 4 Objekte, darunter ein Regenschirm, der in den COCO-Labels fehlt; Präzision 0,50, Recall 0,75.
Astra hat unter den sechs Spitzenmodellen die höchste Kostenschätzung: 49,31 $ pro 1.000 Bilder. Der Median beträgt 11,6 Sekunden; bei 1 % der Bilder schlugen Anfragen fehl. Zwei weitere OpenAI-Modelle kommen beim Recall nahe heran: GPT-6.1 Sol mit 0,62 bei geschätzten Kosten von 10,30 $ und GPT-6.1 Terra mit 0,61 bei geschätzten Kosten von 4,36 $.
Berücksichtige beide Fehlerarten mit mAP50-95 und F1#
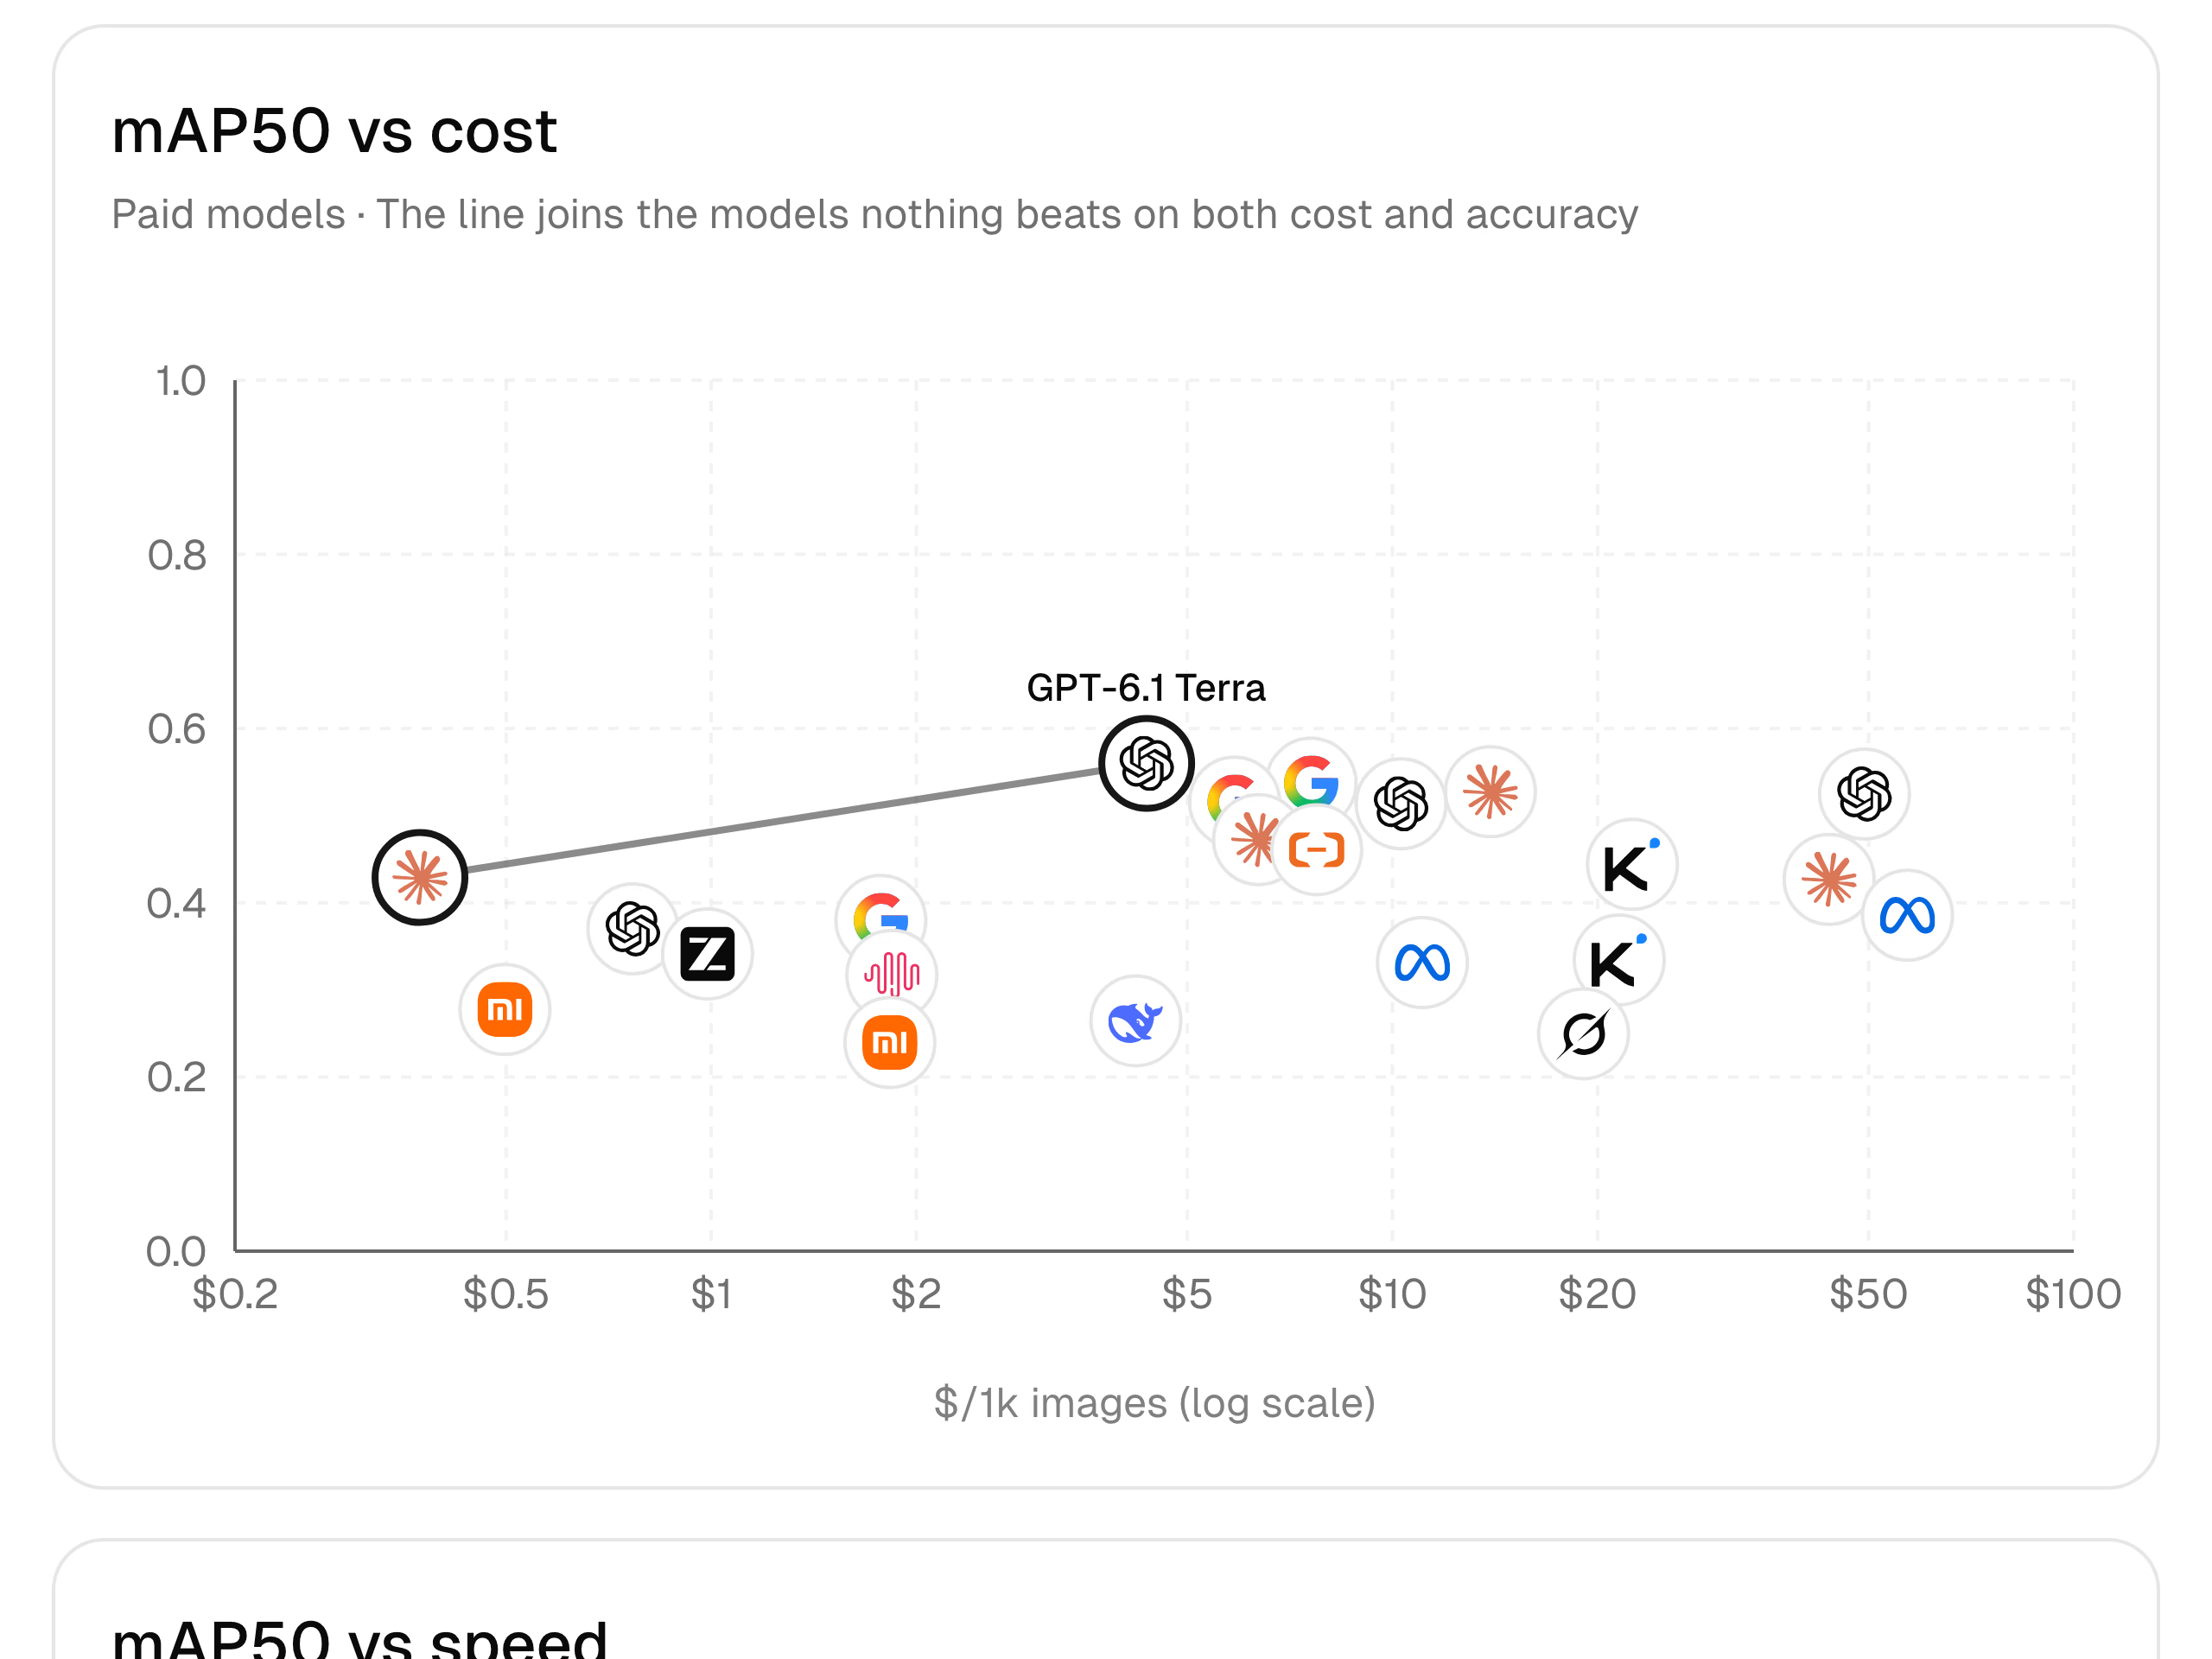
GPT-6.1 Terra führt die Rangliste mit 0,560 mAP50 und 0,345 mAP50-95 an. Seine Präzision von 0,646 und sein Recall von 0,613 liegen jeweils nur wenige Hundertstel hinter den Spitzenwerten. Mit einem F1-Wert von 0,63 liegt Terra unter den sechs Modellen an erster Stelle, knapp vor Argon und Opus 5.5 mit 0,62. Da die F1-Werte so nahe beieinanderliegen und F1 nichts über die Prüfungsdauer aussagt, solltest du die Ergebnisse für die jeweiligen Anwendungsbereiche und einen Test mit deinen eigenen Bildern entscheiden lassen.
Der Vorsprung bei mAP50-95 liefert ein weiteres Signal. Da mAP50-95 den Durchschnitt über IoU-Schwellenwerte bis 0,95 bildet, belohnt die Kennzahl sowohl Modelle, deren passende Boxen genau sitzen, als auch Modelle, die die richtigen Objekte finden. Auch hier steht Terra an erster Stelle. Außerdem hat Terra unter den sechs Spitzenmodellen die niedrigste Kostenschätzung und es gab keine fehlgeschlagenen Anfragen. In der Rangliste ist das Modell als „Bestes Preis-Leistungs-Verhältnis“ gekennzeichnet.
Ohne Anbieterschlüssel annotieren: gehostete Modelle und Detektoren mit offenem Vokabular#
Nicht jedes Team möchte einen kostenpflichtigen Anbieterschlüssel verwenden. Die gehosteten Modelle auf der Platform laufen ohne einen solchen Schlüssel, und ihre Werte erzählen eine andere Geschichte:
- SAM 3.1 Text: 0,332 mAP50, 0,19 Präzision, 0,47 Recall, 0,2 s pro Bild. Unter allen 40 Modellen erzielt es den besten Wert auf VisDrone (0,479 mAP50) und bei Fisheye8K-Verkehrsaufnahmen (0,478).
- Qwen3.8 27B: 0,351 mAP50, 0,54 Präzision, 0,40 Recall, 1,5 s.
- Gemma 4 26B: 0,344 mAP50, 0,53 Präzision, 0,39 Recall, 0,9 s.
Auch die Detektoren mit offenem Vokabular werden gehostet. In diesem Benchmark erreichte OWLv2 Large 0,133 mAP50 und Grounding DINO Base 0,104, jeweils bei 0,2 Sekunden pro Bild. SAM 3.1 Text erzielte dagegen 0,332. Diese Werte messen die klassenbasierte Pipeline der Platform mit Box-Verfeinerung durch SAM 3.1, nicht die ursprüngliche Konfiguration der einzelnen Modelle.
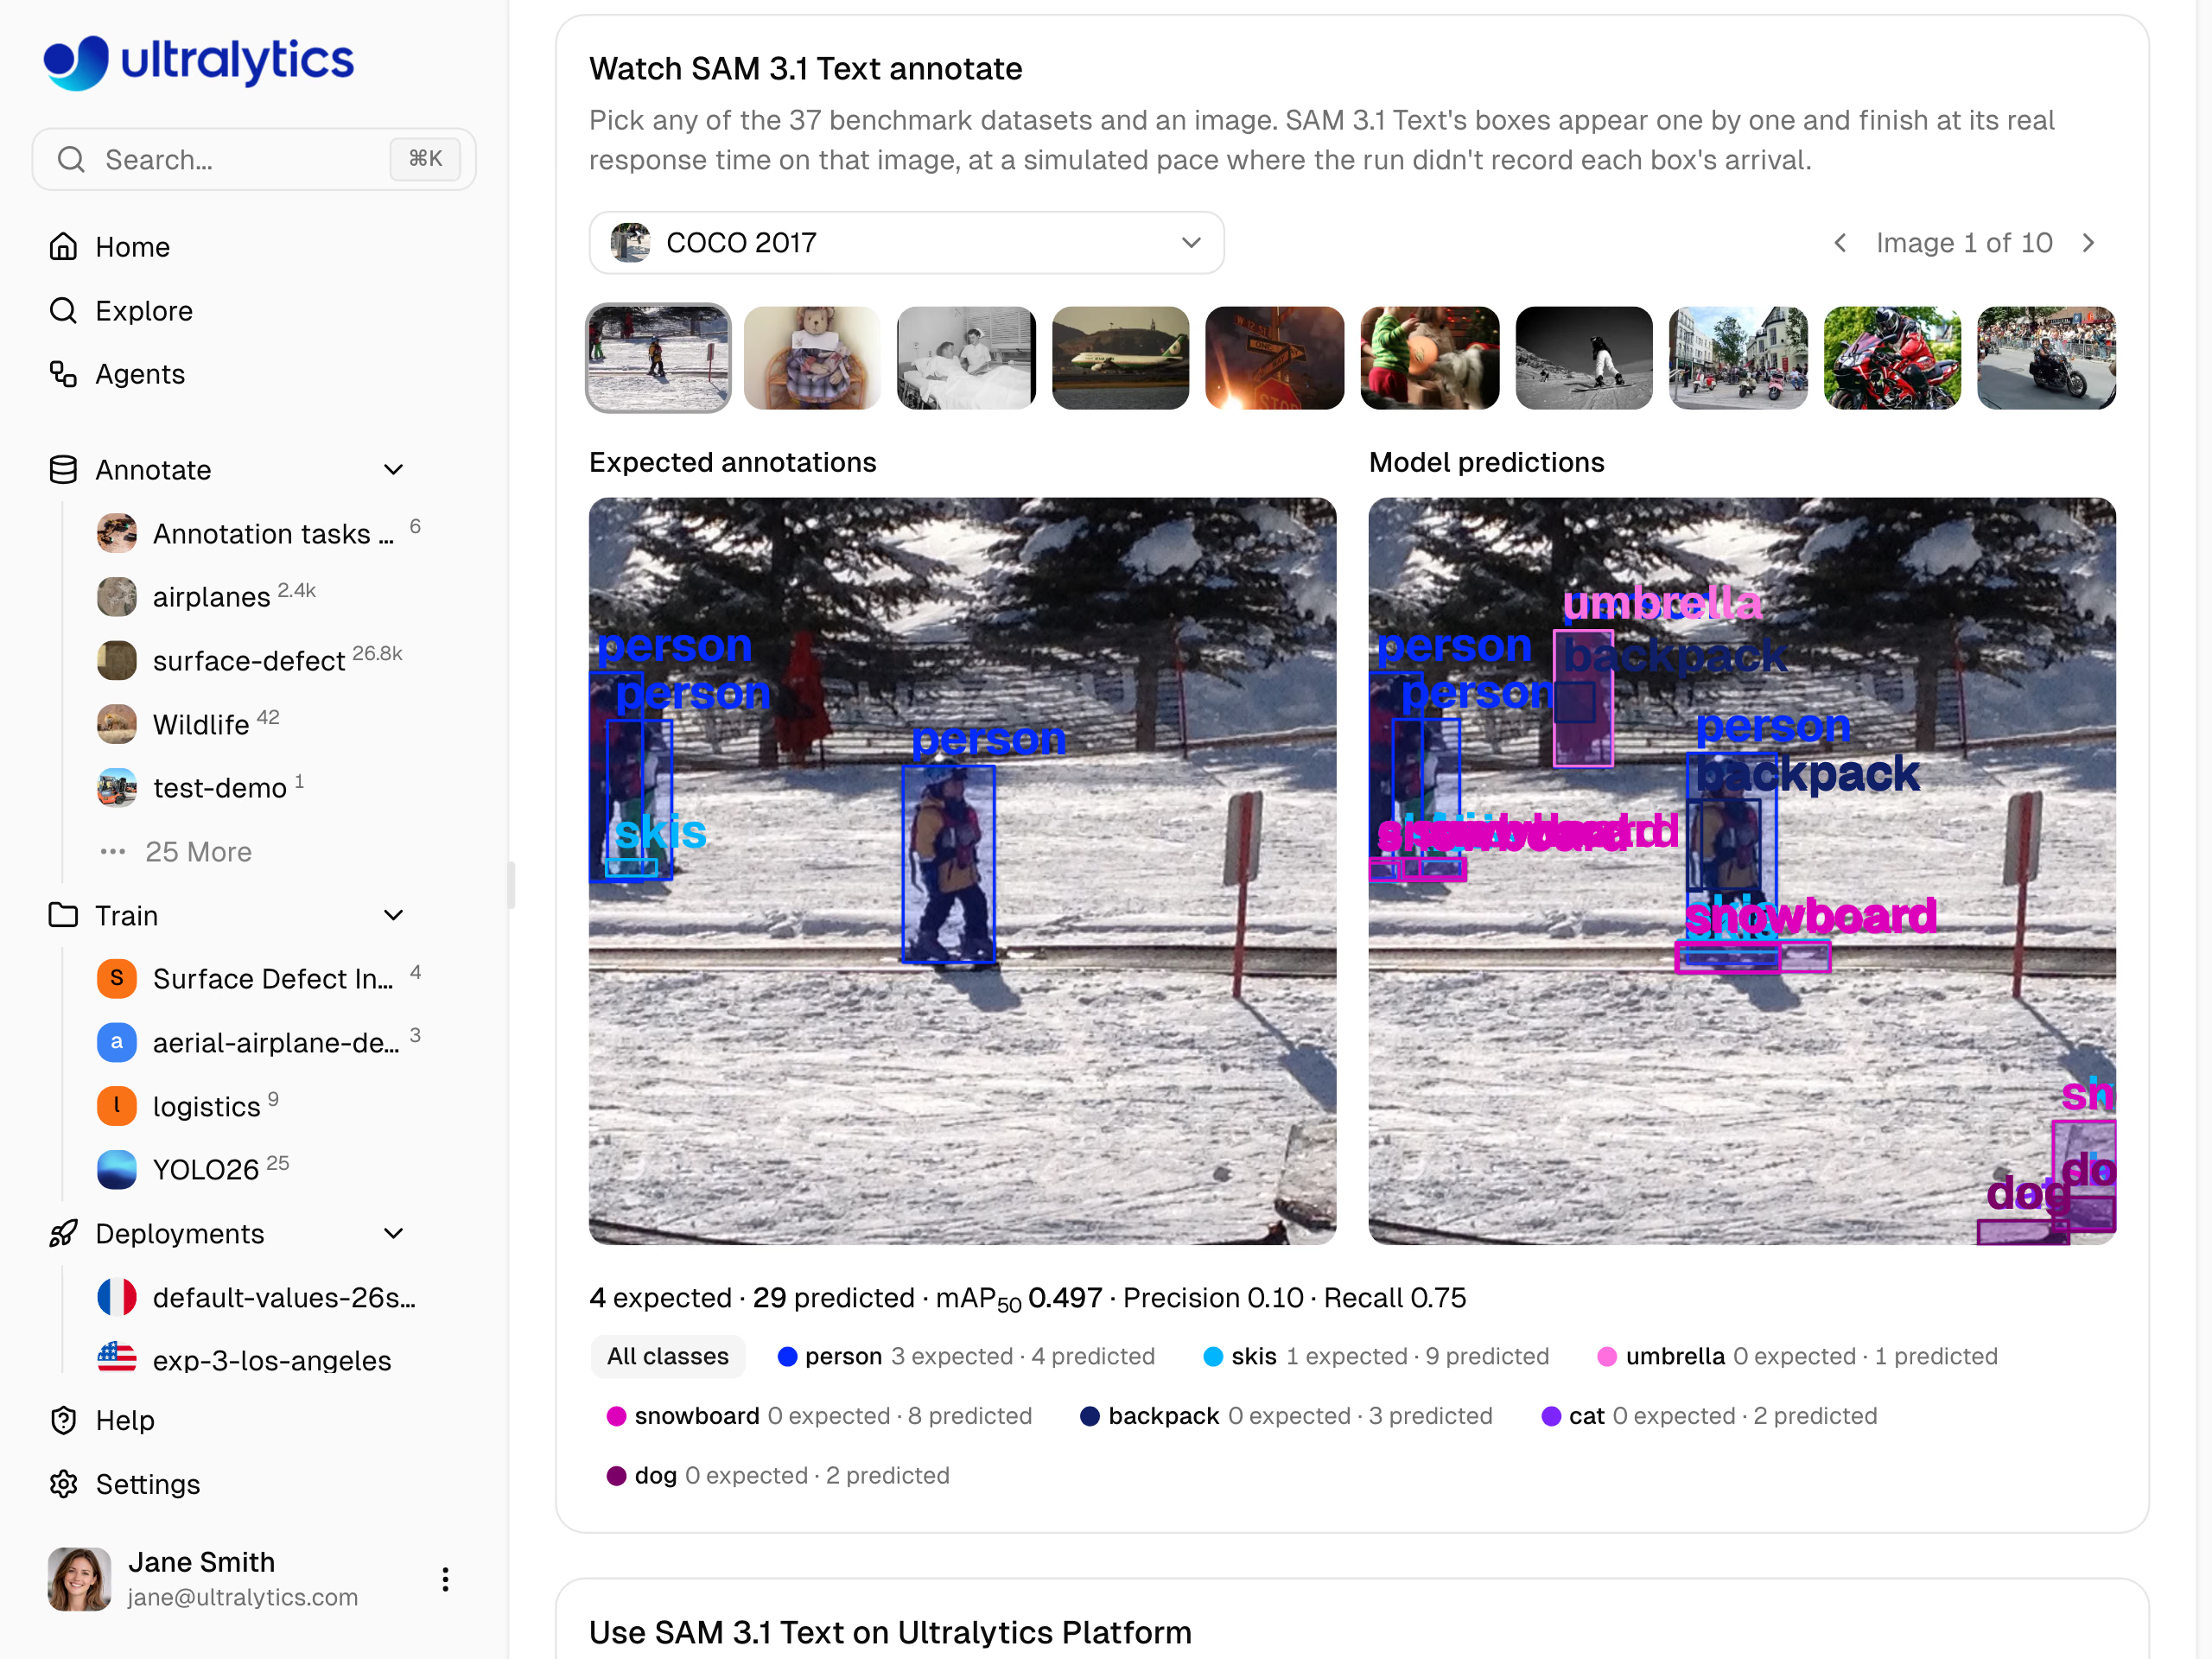
SAM 3.1 Text: 29 Boxen für 4 Objekte, Präzision 0,10, Recall 0,75. Alle drei Wiedergaben finden 3 der 4 Objekte; der Unterschied liegt darin, wie viele zusätzliche Boxen die Prüfer löschen müssen.
SAM 3.1 Text eignet sich für überfüllte Luft- und Verkehrsszenen, bei denen die Prüfer mit einem großzügigen ersten Entwurf rechnen und Boxen entfernen. Qwen3.8 27B und Gemma 4 26B verhalten sich wie die sorgfältige Gruppe, erzielen aber eine geringere Genauigkeit. Unter den kostengünstigen kostenpflichtigen Modellen erreicht Claude Haiku 5.5 0,429 mAP50 bei 0,56 Präzision und 0,47 Recall. Die Kostenschätzung beträgt 0,37 $ pro 1.000 Bilder. Es ist das andere Modell, das die Rangliste als „Bestes Preis-Leistungs-Verhältnis“ kennzeichnet.
Durchschnittswerte über alle Datensätze verdecken die Besonderheiten deiner Daten – prüfe daher die Datensatztabelle#
Die Präzisions- und Recall-Werte jedes Modells sind Durchschnittswerte über 36 Datensätze; deine Daten gehören zu einem bestimmten Bereich. Die Datensatztabelle der VLM-Rangliste enthält für jeden Datensatz die durchschnittliche Präzision und den durchschnittlichen Recall aller 40 Modelle, beginnend mit den schwierigsten, sowie das jeweils beste Modell.
Achte auf Warnsignale. Bei Airbus Oil Storage Detection mit 2.267 annotierten Tanks in 10 Bildern erreichen die Modelle im Durchschnitt 0,39 Präzision und 0,11 Recall. Den besten mAP50 erzielt Gemini 4 Argon mit 0,347. Bei DeepPCB liegen die durchschnittliche Präzision und der durchschnittliche Recall bei 0,03 und 0,04. GPT-6.1 Sol sticht mit 0,393 mAP50 hervor.
Betrachte diese Zahlen als Vorauswahl, nicht als endgültiges Urteil. Laut Methodik genügen 10 Bilder pro Datensatz, um Modelle und Anwendungsbereiche einzuordnen, aber nicht, um den Wert für einen einzelnen Datensatz zu bestätigen. Wiederholte Durchläufe können die einzelnen Werte um einige Punkte verschieben. Auf jeder Modellseite der Platform kannst du die aufgezeichneten Modellboxen neben den erwarteten Boxen für die Benchmark-Datensätze und COCO anzeigen lassen. So kannst du den Datensatz prüfen, der deinen Daten am ähnlichsten ist, bevor du einen Durchlauf startest.
Stimme das Modell in fünf Schritten auf deinen Prüfungsablauf ab#
Beginne mit deinem wichtigsten Auswahlkriterium und bestätige deine Wahl anschließend mit eigenen Bildern:
| Deine Priorität | Vorauswahl (Ergebnisse vom Oktober 2026) |
|---|---|
| Präzision priorisieren | Gemini 4 Argon |
| Recall priorisieren | GPT-6 Astra oder GPT-6.1 Sol |
| Beide abwägen | GPT-6.1 Terra |
| Kein Anbieterschlüssel | Gehostet: Qwen3.8 27B oder SAM 3.1 Text |
Annotation mit Klassenabfrage funktioniert bei Erkennungsdatensätzen mit 1 bis 200 Klassen.
- Erstelle eine Vorauswahl in der Bestenliste. Filtere die VLM-Bestenliste für Objekterkennung nach Paid oder Hosted (überspringe alle Einträge mit der Kennzeichnung Not on Platform), lies die Spalte ab, die deiner Priorität entspricht, und prüfe die Tabelle mit den Datensätzen für deinen Anwendungsbereich.
- Anbieterschlüssel hinzufügen. Wenn du ein kostenpflichtiges Modell verwendest, speichere deinen Schlüssel unter Einstellungen > API-Schlüssel in dem Arbeitsbereich, zu dem der Datensatz gehört. Der Anbieter stellt die Kosten direkt deinem Schlüssel in Rechnung. Informationen zur Einrichtung findest du in der Dokumentation zu Anbieterschlüsseln.
- Anhand einer geprüften Stichprobe testen. Wähle einige repräsentative Bilder aus deinen Daten, die du von Hand annotiert hast. Öffne den Annotationseditor, wechsle in den Modus Smart, wähle das Modell unter dem jeweiligen Anbieter in der Modellauswahl aus und klicke auf Vorhersagen (
P). Zähle die gelöschten und hinzugefügten Boxen sowie die Minuten, die die Prüfung dauert. - Datensatz annotieren. Wähle auf der Datensatzseite Weitere Aktionen > Batch Annotation. Die Funktion ist für auf der Platform gehostete Datensätze mit bis zu drei Bildkanälen verfügbar. Standardmäßig annotiert sie nicht annotierte Bilder, ändert nie vorhandene Annotationen und speichert vorher eine Datensatzversion, sodass du Änderungen rückgängig machen kannst. Prüfe vor dem Start die geschätzten Kosten im Dialogfeld: Batch Annotation kostet 1,00 $ pro 1.000 verarbeitete Bilder, zuzüglich etwaiger Gebühren des Anbieters.
- Prüfen und anschließend trainieren. Prüfe die Boxen unter Berücksichtigung der Schwachstellen deines Modells, speichere sie und trainiere im selben Arbeitsbereich ein Ultralytics-YOLO-Modell mit dem Ergebnis.
Hintergrundinformationen findest du unter Wie die Ultralytics Platform KI zur Automatisierung der Annotation nutzt und warum die Prüfung durch Menschen weiterhin dazugehört. Wie sich automatische Annotation und aktives Lernen in verschiedenen Tools vergleichen, erfährst du in unserem Vergleich von automatischer Annotation und aktivem Lernen.
Vorauswahl nach Team (Ergebnisse vom Oktober 2026)#
- Für Prüfer, die lieber einen Entwurf vervollständigen, statt ihn zu bereinigen: Gemini 4 Argon, insgesamt das präziseste Modell und besonders stark bei Luftbildern, Unterwasseraufnahmen, Wärmebildern und Sicherheitsröntgenbildern.
- Für seltene Objekte, deren Übersehen die Trainingsdaten verfälscht: GPT-6 Astra für maximalen Recall oder knapp dahinter GPT-6.1 Sol.
- Für allgemeine Annotation ohne klare Präferenz: GPT-6.1 Terra, an erster Stelle bei mAP50, mAP50-95 und F1.
- Für Teams ohne Anbieterschlüssel: SAM 3.1 Text für erste Durchläufe mit hohem Recall bei überfüllten Szenen oder Qwen3.8 27B für einen sorgfältigeren Entwurf.
Unabhängig von deiner Wahl hilft dir die Rangliste, den Prüfungsaufwand abzuschätzen, bevor du loslegst. Die Grundlagen zu diesen Kennzahlen findest du in unserem Leitfaden zu Genauigkeit, Präzision und Recall. Die Lektion der Academy zum Interpretieren von Erkennungsmetriken geht weiter ins Detail.
Häufig gestellte Fragen
Priorisiere Präzision, wenn das Löschen falscher Boxen länger dauert – zum Beispiel bei überfüllten Bildern, in denen sich eine überflüssige Box zwischen vielen richtigen versteckt. Priorisiere Recall, wenn ein übersehenes Objekt schwerer wiegt, etwa bei seltenen Defekten oder Läsionen, denn ein nicht annotiertes Objekt bringt dem Detektor bei, es als Hintergrund zu behandeln. Bestätige deine Wahl anschließend anhand einer von Hand geprüften Stichprobe deiner eigenen Bilder.
Modelle mit Klassenabfrage geben Boxen ohne Konfidenzwerte zurück und verwenden modellspezifische Schwellenwerte. Deshalb blendet die Platform die Einstellungen für Konfidenz und IoU aus, solange ein solches Modell ausgewählt ist. Präzision und Recall in der Rangliste zählen daher jede Box, die das Modell bei einem IoU von 0,5 zurückgibt. Um das Verhältnis zwischen nicht zugeordneten Boxen und nicht zugeordneten Objekten zu verändern, wählst du ein anderes Modell.
Mit mAP50 kannst du prüfen, ob ein Modell die richtigen Objekte findet und annotiert. mAP50-95 berücksichtigt zusätzlich strengere IoU-Schwellenwerte und belohnt genauer passende Boxen. Beide Kennzahlen spiegeln auch übersehene Objekte und falsch-positive Erkennungen wider. Betrachte sie daher zusammen mit Präzision und Recall. In den Ergebnissen vom Oktober 2026 liegt GPT-6.1 Terra bei beiden vorn: mit 0,560 und 0,345.
Ja. Das beste Modell im UL37 v2 erreicht im Durchschnitt 0,560 mAP50 (Oktober 2026). Bei den schwierigsten Datensätzen, etwa mit Leiterplattendefekten und Röntgenaufnahmen des Brustkorbs, liegt der Durchschnitt der 40 Modelle unter 0,05. Prüfe jedes Bild und achte besonders auf die Schwachstelle des Modells: zusätzliche Boxen bei einem Modell mit hohem Recall und übersehene Objekte bei einem Modell mit hoher Präzision.
Die Kosten setzen sich aus zwei Teilen zusammen. Batch Annotation auf der Ultralytics Platform kostet bei jedem Modell, auch bei gehosteten Modellen, 1,00 $ pro 1.000 verarbeitete Bilder (mindestens 0,01 $). Einzelne Vorhersagen mit einem gehosteten Modell im Editor sind kostenlos. Für kostenpflichtige Modelle stellt der Anbieter die Nutzung zusätzlich direkt über deinen eigenen API-Schlüssel in Rechnung. Im Benchmark vom Oktober 2026 reichten die geschätzten Anbieterkosten für die Modelle in diesem Leitfaden von 0,37 $ pro 1.000 Bilder (Claude Haiku 5.5) bis zu 49,31 $ (GPT-6 Astra). Wenn du einen Durchlauf stoppst, werden die bereits verarbeiteten Bilder trotzdem berechnet.
Ja. Gehostete Modelle wie SAM 3.1 Text, Qwen3.8 27B und Gemma 4 26B laufen auf der Ultralytics Platform ohne Anbieterschlüssel. Das gilt auch für deine eigenen YOLO-Modelle. Batch-Durchläufe kosten weiterhin 1,00 $ pro 1.000 verarbeitete Bilder; das Dialogfeld zeigt vor jedem Durchlauf eine Kostenschätzung.
Das hängt von der Aufgabe ab. Ein VLM mit Klassenabfrage kann anhand der Klassennamen allein Entwürfe für neue Klassen erstellen. Die sechs Modelle mit den höchsten Werten im Benchmark vom Oktober 2026 benötigten jedoch 2,7 bis 11,6 Sekunden pro Bild und rechnen pro Token ab. Für die Echtzeiterkennung ist ein gängiger Ansatz, mit einem VLM automatisch zu annotieren, die Annotationen zu prüfen und darauf ein Ultralytics-YOLO-Modell zu trainieren. Ein bereits trainiertes YOLO-Modell kann im selben Editor auch neue Bilder automatisch annotieren.
Verfasst von
Leitender Softwareentwickler · Ultralytics
Kommentare2
Stelle eine Frage, teile deine Ergebnisse oder hilf anderen.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









