Exporter Ultralytics YOLO avec LiteRT
Découvre comment la nouvelle intégration d’export LiteRT permet d’exécuter l’inférence Ultralytics YOLO sur mobile, dans les systèmes embarqués, en périphérie et dans les navigateurs, dans un format unifié.
Chez Ultralytics, nous constatons une tendance croissante à exécuter les modèles de vision par ordinateur directement sur les appareils où ils sont nécessaires, plutôt que de dépendre d’une connexion au cloud. Les applications mobiles, les systèmes embarqués, les capteurs IoT et les outils basés sur navigateur doivent de plus en plus souvent exécuter l’inférence localement, souvent sur du matériel soumis à des contraintes strictes de consommation d’énergie et de puissance de calcul. C’est pourquoi nous sommes ravis d’annoncer que les modèles Ultralytics YOLO peuvent désormais être exportés directement au format LiteRT.
Répondre à cette demande nécessite un format de modèle compatible avec tous ces environnements, sans obliger les développeurs à maintenir des pipelines d’export distincts pour chacun d’eux.
Cette fonctionnalité était déjà disponible par l’intermédiaire d’un package tiers non officiel, mais cette nouvelle intégration est le fruit d’une collaboration officielle avec Google. Nous avons travaillé en étroite collaboration avec l’équipe LiteRT pour créer un pipeline de bout en bout permettant d’exporter les modèles Ultralytics YOLO vers TFLite via LiteRT. Grâce à cette intégration, un seul modèle Ultralytics YOLO exporté peut être déployé sur mobile, dans les systèmes embarqués, à la périphérie et dans les navigateurs, réunissant dans un format unique et simplifié les usages auparavant pris en charge séparément par les anciens formats d’export TFLite et TF.js.
Qu’est-ce que LiteRT ?#
LiteRT (abréviation de Lite Runtime) est l’environnement d’exécution haute performance de Google pour l’IA embarquée. Il s’agit de la nouvelle génération et du nouveau nom de TensorFlow Lite (TFLite), et il utilise le même format de modèle .tflite que les développeurs connaissent déjà.
LiteRT est un framework open source conçu spécialement pour l’inférence embarquée, également appelée informatique en périphérie. Il fournit aux développeurs les outils nécessaires pour exécuter des modèles entraînés sur des appareils mobiles, embarqués et IoT, des ordinateurs traditionnels et, grâce à LiteRT.js, directement dans les navigateurs web et Node.js. Le format d’export LiteRT optimise les modèles pour des tâches telles que la détection d’objets, la segmentation, l’estimation de pose et la classification, afin qu’ils s’exécutent rapidement et hors ligne sur un large éventail d’appareils.
Pourquoi exporter les modèles Ultralytics YOLO vers LiteRT ?#
Désormais, un seul format de modèle couvre toutes les cibles de déploiement :
• Mobile et systèmes embarqués. Android, iOS, ordinateurs de bureau, Linux embarqué et microcontrôleurs (MCU).
• Accélérateurs périphériques. Compatible avec le Coral Edge TPU pour une accélération supplémentaire.
• Navigateurs et Node.js. LiteRT.js exécute le même modèle .tflite sur le web avec l’accélération WebGPU/WASM, ce qui évite d’avoir besoin d’un export TensorFlow.js distinct.
• Ordinateurs de bureau
Cette consolidation est importante, car elle élimine une véritable source de friction dans les déploiements en production. Au lieu de maintenir un pipeline d’export pour le mobile, un autre pour le navigateur et un troisième pour les accélérateurs périphériques, les équipes peuvent désormais exporter une seule fois et déployer partout où LiteRT fonctionne.
Principales fonctionnalités des modèles LiteRT#
• Optimisation embarquée. Réduit la latence en traitant les données localement, renforce la confidentialité en évitant de transmettre des données personnelles et réduit la taille du modèle pour économiser de l’espace.
• Prise en charge de plusieurs plateformes. Fonctionne sur Android, iOS, Linux embarqué, les microcontrôleurs et les navigateurs web modernes.
• Accélération matérielle. Exploite XNNPACK sur CPU et l’accélération GPU via OpenCL, Metal et WebGPU. Par défaut, l’accélération GPU utilise FP16 pour offrir une vitesse supplémentaire.
• Quantification. Prend en charge FP32, INT8 statique, les activations INT16 statiques et INT8 dynamique afin de compresser les modèles et d’accélérer l’inférence avec une perte de précision minimale.
• Prise en charge de nombreux langages. Compatible avec Java/Kotlin, Swift, Objective-C, C++, Python et JavaScript.
Bien démarrer avec l’export LiteRT#
Le package Python Ultralytics et Ultralytics Platform fournissent un environnement complet et unifié pour entraîner, évaluer et déployer des modèles YOLO sur les cinq tâches de vision par ordinateur. Le format d’export LiteRT prend en charge les modes Exportation, Prédiction et Validation, ce qui permet d’exporter un modèle puis de l’utiliser immédiatement pour l’inférence ou la validation de précision en local.
L’exportation d’un modèle se fait en une seule commande :
from ultralytics import YOLO

# Charger un modèle YOLO26
model = YOLO("yolo26n.pt")

# Exporter le modèle au format LiteRT
model.export(format="litert") # crée 'yolo26n.tflite'
Pour les équipes qui déploient leurs modèles sur du matériel aux ressources limitées, LiteRT prend également en charge l’export quantifié, qui permet de compresser les modèles pour accélérer l’inférence avec une perte de précision minimale :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# INT8 dynamique : poids int8, activations FP32 - aucune donnée d’étalonnage nécessaire
model.export(format="litert", quantize="w8a32")

# INT8 statique : poids int8 + activations int8 - données d’étalonnage nécessaires
model.export(format="litert", quantize=8, data="coco8.yaml")
Une fois exporté, le modèle peut être chargé et exécuté directement pour l’inférence :
from ultralytics import YOLO

# Charger le modèle LiteRT exporté
model = YOLO("yolo26n.tflite")

# Lancer l’inférence
results = model("https://ultralytics.com/images/bus.jpg")
L’export LiteRT est actuellement pris en charge sur Linux x86_64 et macOS. Le modèle .tflite exporté fonctionne sur toutes les plateformes compatibles avec LiteRT, notamment les plateformes mobiles, embarquées et périphériques, ainsi que les navigateurs.
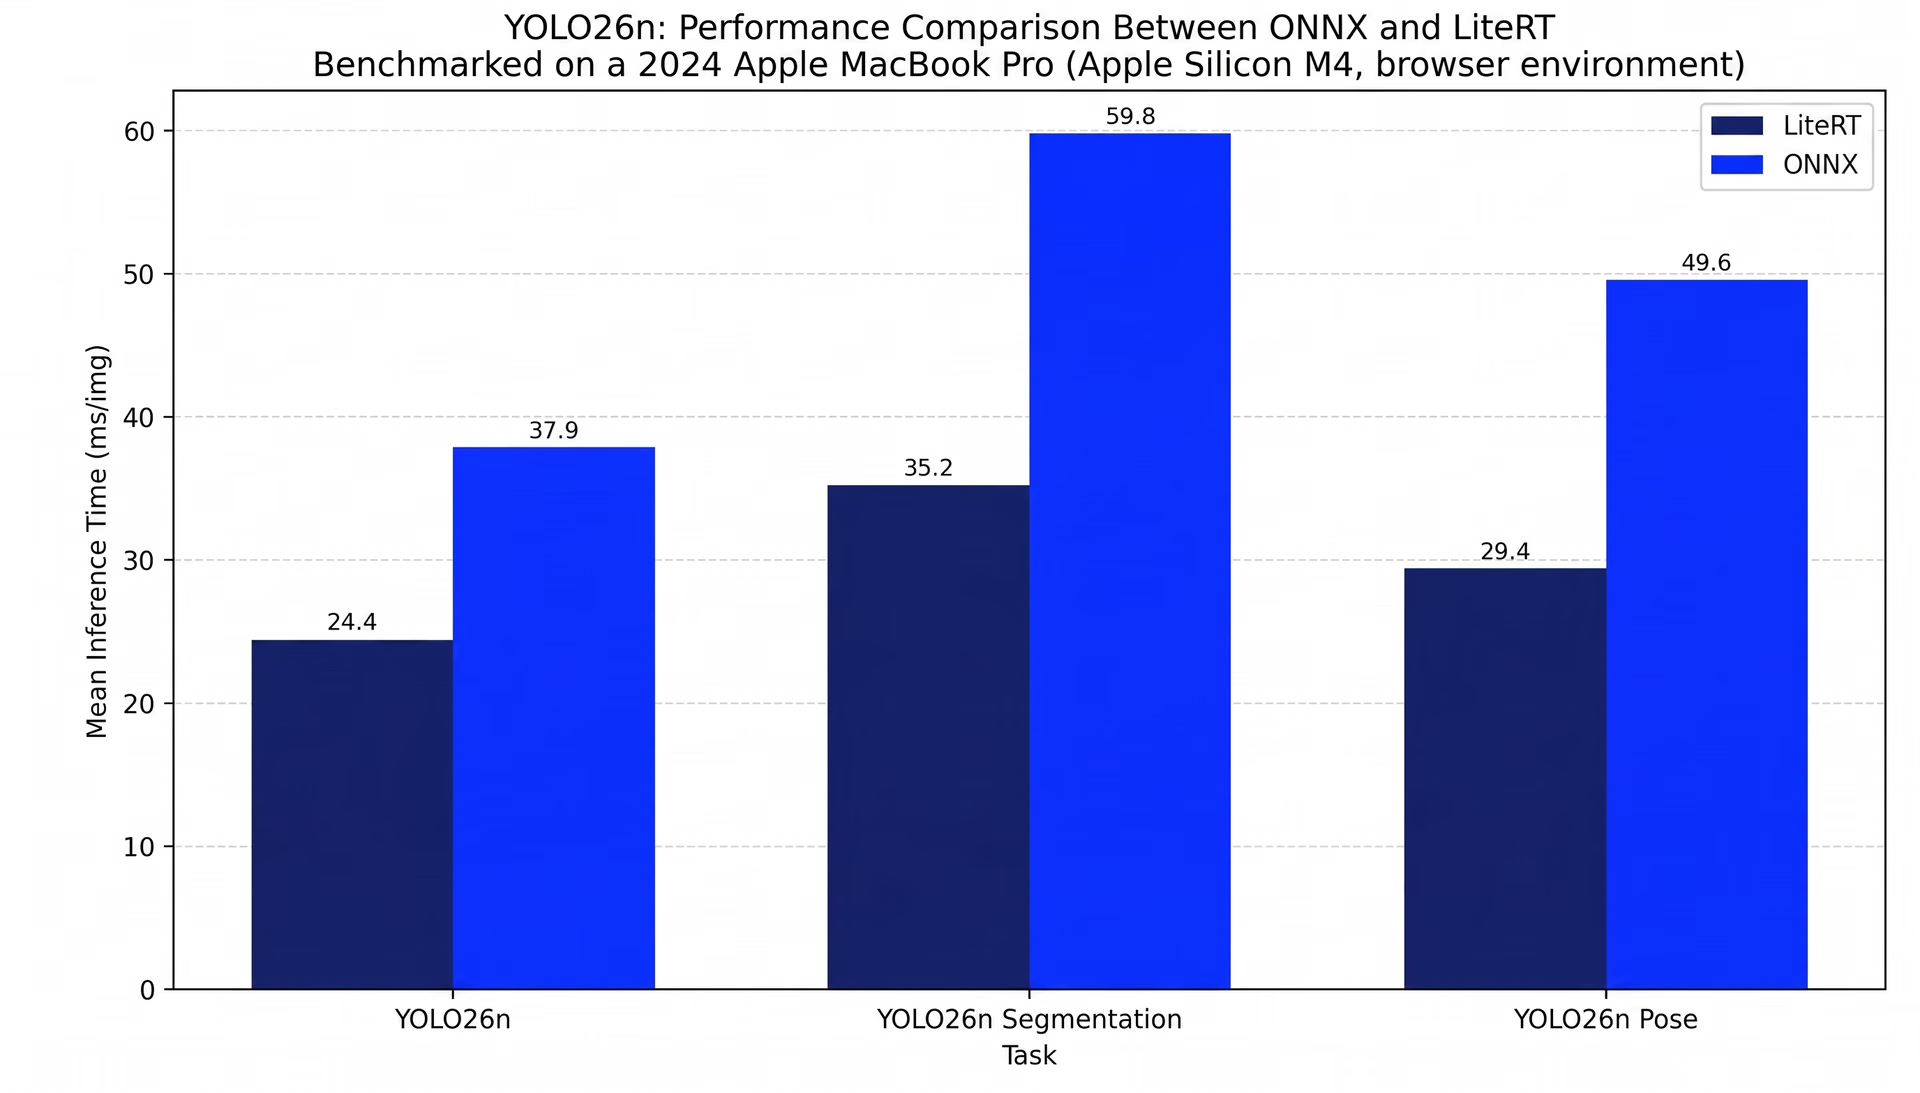 Fig 1. Comparaison des performances entre ONNX et LiteRT.
L’image ci-dessus compare le temps moyen d’inférence pour la détection, la segmentation et l’estimation de pose avec YOLO26n, exécuté dans le navigateur via @ultralytics/yolo, le package npm d’Ultralytics pour l’inférence côté client sur WebGPU/WASM via ONNX Runtime Web. Les tests ont été effectués dans un environnement de navigateur contrôlé sur un Apple MacBook Pro 2024 (Apple Silicon M4).
Amener Ultralytics YOLO à la périphérie#
Avec LiteRT, le déploiement des modèles Ultralytics YOLO sur mobile, dans les systèmes embarqués, à la périphérie et dans les navigateurs ne nécessite plus de pipelines d’export distincts pour chaque cible. Un seul export, un seul format de modèle et un parcours cohérent de l’entraînement à la production, où que l’inférence doive être effectuée.
Tu t’intéresses à l’IA visuelle ? Découvre nos options de licence pour intégrer la vision par ordinateur à tes projets. Consulte notre dépôt GitHub pour découvrir toutes les intégrations d’export Ultralytics, et explore Ultralytics Platform pour commencer à créer tes propres workflows d’IA visuelle de bout en bout.









