Segmentazione Ultralytics YOLO in scene dense: 1.000 maschere
In Ultralytics 8.4.213, YOLO26n-seg prevede e riepiloga 1.000 maschere su un'immagine sintetica a 1080p in 56.4 ms, rispetto agli 821.2 ms precedenti.
 Glenn Jocher12 min di lettura
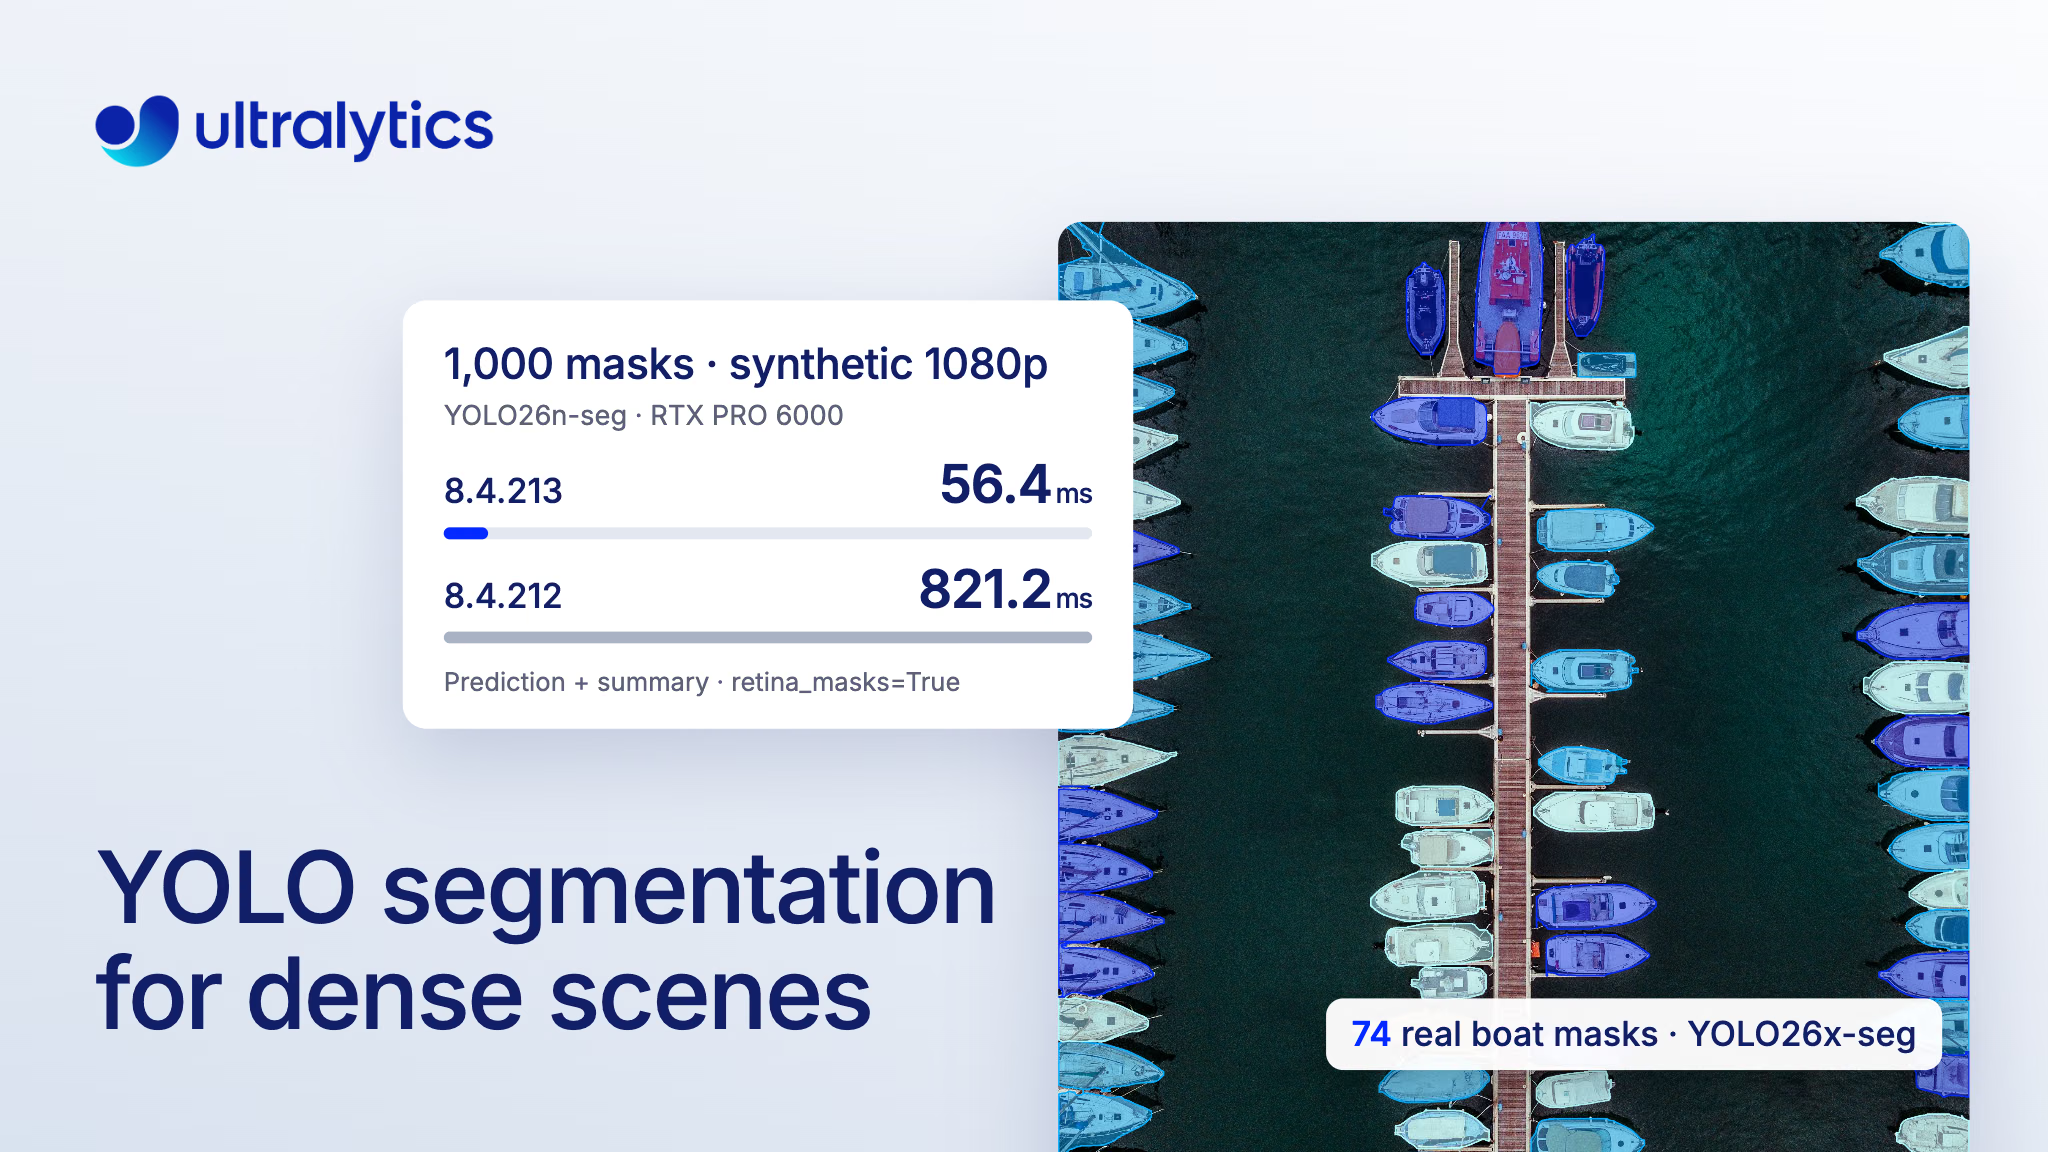
Ultralytics 8.4.213, rilasciato il 14 novembre 2026, velocizza la segmentazione YOLO nelle scene dense decodificando grandi stack di maschere all'interno di ciascun riquadro di rilevamento. Se segmenti scaffali, pacchi, folle o immagini aeree, probabilmente hai già incontrato il limite in cui un modello di segmentazione individua gli oggetti, ma la fase successiva di elaborazione delle maschere esaurisce tempo o memoria; questa versione sposta molto più avanti quel limite. Nel nostro benchmark su un'immagine sintetica a 1080p con tassellatura densa, YOLO26n-seg ha restituito 1.000 maschere di istanza a piena risoluzione (retina_masks=True), includendo la previsione e un riepilogo dei risultati, in 56.4 ms e con un picco di memoria GPU di 321 MiB su una RTX PRO 6000, rispetto agli 821.2 ms e ai 4,291 MiB di 8.4.212.
Il modello in sé non è cambiato. È cambiato il modo in cui la segmentazione YOLO trasforma l'output del modello in maschere: ora gli stack di maschere di grandi dimensioni vengono decodificati all'interno del riquadro di ciascun oggetto, anziché sull'intero fotogramma. In Ultralytics Platform, la scheda Predict e l'API restituiscono fino a 1.000 risultati per immagine. Questo articolo spiega perché le scene dense erano costose, cosa fa diversamente la 8.4.213, i risultati misurati e come eseguire previsioni con 1.000 maschere.
Nelle scene dense si pagavano pixel che ricadevano al di fuori di ogni riquadro#
La segmentazione di istanze assegna a ogni oggetto una maschera distinta, necessaria per misurare le aree, ritagliare gli oggetti o distinguere elementi a contatto. Un modello di segmentazione YOLO prevede un piccolo insieme di maschere prototipo condivise e alcuni coefficienti per rilevamento; la post-elaborazione li combina in una maschera per ogni oggetto.
Finora, questo passaggio generava ogni maschera a dimensione del fotogramma: per impostazione predefinita, alla dimensione di inferenza del modello, oppure alla dimensione dell'immagine originale con retina_masks=True o il tiling. Per N oggetti in un fotogramma H x W, allocava, ritagliava, filtrava e scansionava uno stack N x H x W, anche se ogni maschera è zero ovunque al di fuori del relativo riquadro di delimitazione. In una scena densa a 1080p, l'area totale dei 1.000 riquadri, contando le sovrapposizioni, è circa il doppio dell'area del fotogramma, mentre lo stack era 1.000 volte l'area del fotogramma. Il costo aumentava con max_det e con la dimensione dell'immagine, anziché in base ai riquadri presenti nell'immagine.
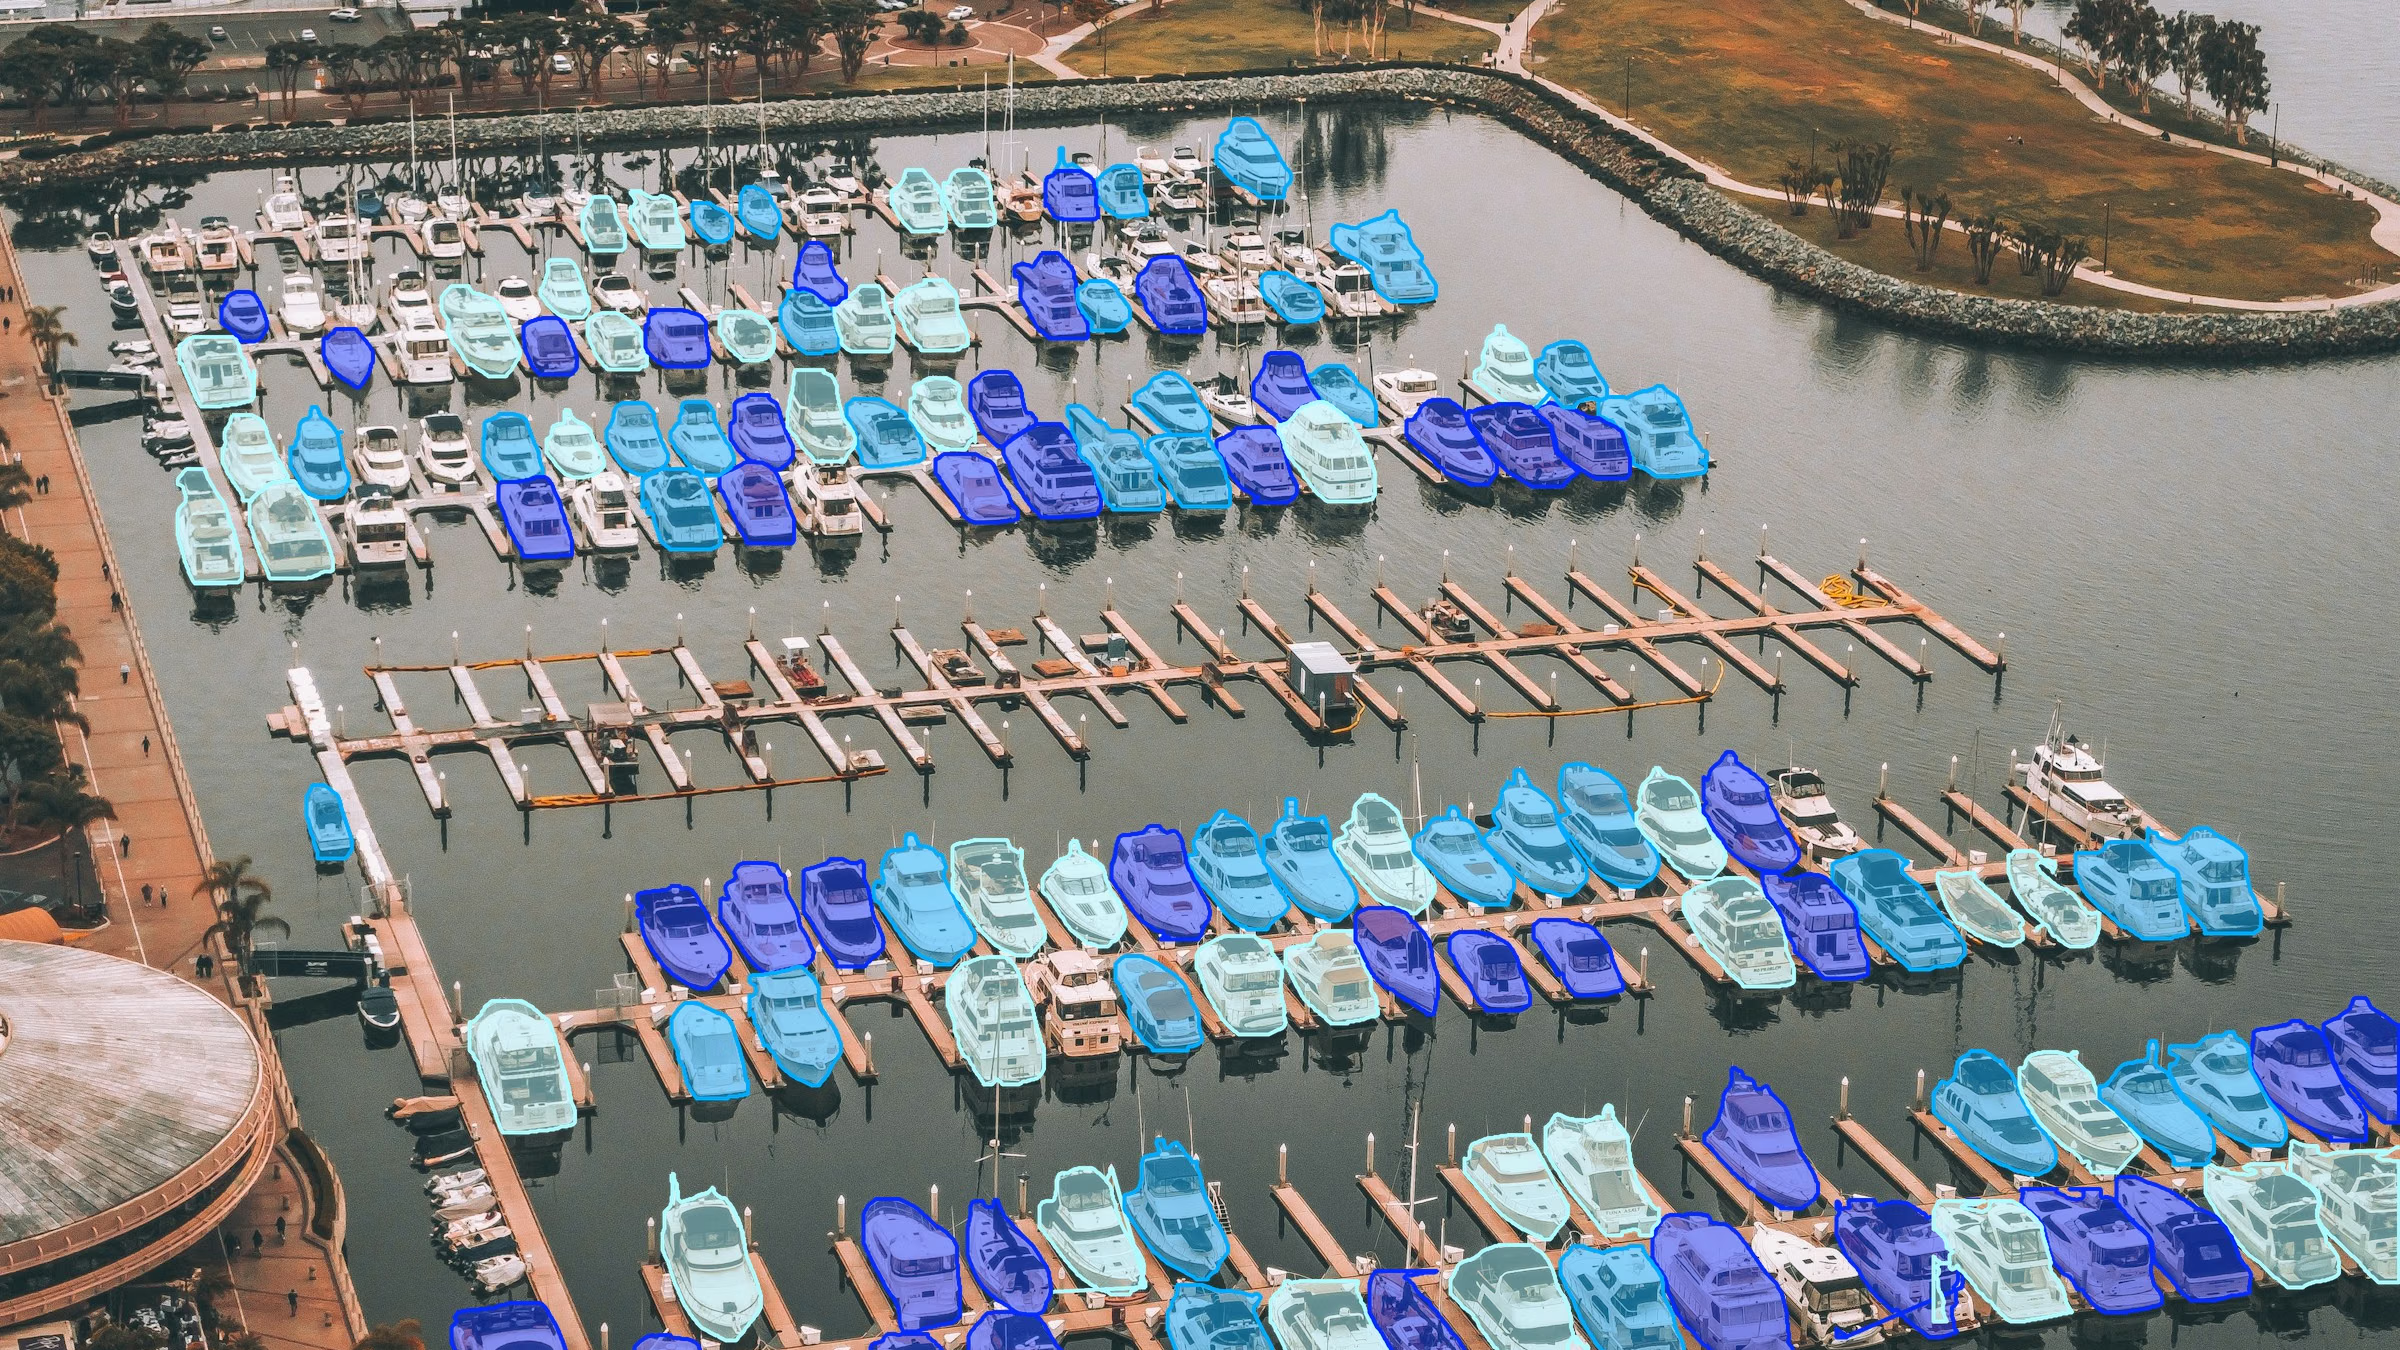
YOLO26x-seg ha restituito 127 maschere di barche in questa foto del porto turistico, mostrate ritagliate (imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). Foto: Unsplash.
Ecco perché aumentare max_det oltre il valore predefinito di 300 era impraticabile per la segmentazione e perché le immagini grandi con molte istanze potevano esaurire la memoria. Scaffali affollati come quelli di SKU-110K, pile di pacchi e fotogrammi aerei sono proprio le scene in cui serve poter superare i 300 oggetti.
Ultralytics 8.4.213 decodifica gli stack di maschere di grandi dimensioni all'interno di ciascun riquadro#
Il nuovo percorso, introdotto con la PR #27197, interpola i logit dei prototipi solo sui pixel di ciascun riquadro. Usa il campionamento bilineare separabile, lo stesso tipo di campionamento usato dall'interpolazione di PyTorch, e raggruppa i riquadri di dimensioni simili. Per gli stack di grandi dimensioni, il costo di decodifica segue ora l'area totale dei riquadri.
Nella pratica contano tre dettagli:
- Si attiva oltre una dimensione fissa dello stack di maschere. Il predictor di segmentazione usa maschere locali ai riquadri quando lo stack denso supererebbe 33.554.432 pixel su CUDA o 4.194.304 pixel su CPU e altri dispositivi. Gli stack più piccoli mantengono il percorso denso esistente, altrettanto veloce o più veloce quando le maschere sono poche.
- In questo percorso, i contorni vengono ricavati direttamente dalle maschere locali ai riquadri.
masks.xyemasks.xyntracciano poligoni per ogni riquadro, quindisummary(),to_json()esave_txtnon costruiscono lo stack completo. - Il formato di output non cambia.
masks.datacontinua a restituire un tensore denso N x H x W. Nel percorso con maschere locali ai riquadri, viene creato la prima volta che lo leggi.
Leggere il tensore denso comporta comunque il costo della sua allocazione, ma la PR ha misurato un costo inferiore: su GPU, leggere masks.data per 300 maschere a 1080p con retina_masks=True è passato da 14,1 ms e 1.366 MiB a 9,1 ms e 795 MiB.
1.000 maschere a 1080p: da 821,2 ms a 56,4 ms su GPU#
La PR confronta le prestazioni di YOLO26n-seg nell'intera model.predict(...) più result.summary() (riquadri e poligoni), riportando la mediana di esecuzioni a regime con un processo per riga. Le scene dense sono un'immagine sintetica composta da riquadri a conf=0.01 e imgsz=1280; la scena tipica è il normale bus.jpg con le impostazioni predefinite, con 5 maschere. «Prima» indica la versione 8.4.212. Sono misurazioni in cui la post-elaborazione è il carico principale: includono la previsione e il riepilogo, e non rappresentano una misura generale della velocità di inferenza.
| Scena (GPU, RTX PRO 6000) | Maschere | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
Tipica (bus.jpg) | 5 | False | 4,3 ms, 59 MiB | 4,4 ms, 59 MiB |
| 1920 x 1080 | 300 | False | 118,5 ms, 1.673 MiB | 16,3 ms, 174 MiB |
| 1920 x 1080 | 300 | True | 248,7 ms, 1.366 MiB | 18,0 ms, 201 MiB |
| 1920 x 1080 | 1,000 | True | 821,2 ms, 4.291 MiB | 56,4 ms, 321 MiB |
| 4000 x 3000 | 300 | True | 1.352,1 ms, 7.070 MiB | 26,5 ms, 172 MiB |
| 4000 x 3000 | 1,000 | True | 4.323,1 ms, 23.305 MiB | 130,7 ms, 258 MiB |
Tempo e picco di memoria GPU, PyTorch 2.15.0 con CUDA 13.2. Fonte: PR #27197.
L'immagine tipica con cinque maschere non cambia, come previsto. I vantaggi si vedono quando lo stack precedente diventava grande e sono maggiori con le maschere alla risoluzione originale, che prima erano il caso più costoso.
Le immagini grandi richiedono solo una frazione della memoria#
A 4000 x 3000 pixel con 1.000 maschere previste, il percorso precedente raggiungeva un picco di 23.305 MiB di memoria GPU. Il nuovo percorso ha raggiunto un picco di 258 MiB e ha terminato in 130,7 ms invece di 4.323,1 ms. Questa riduzione lascia più memoria GPU per il resto della pipeline quando lavori con fotogrammi da 12 megapixel acquisiti da droni, satelliti o durante ispezioni.
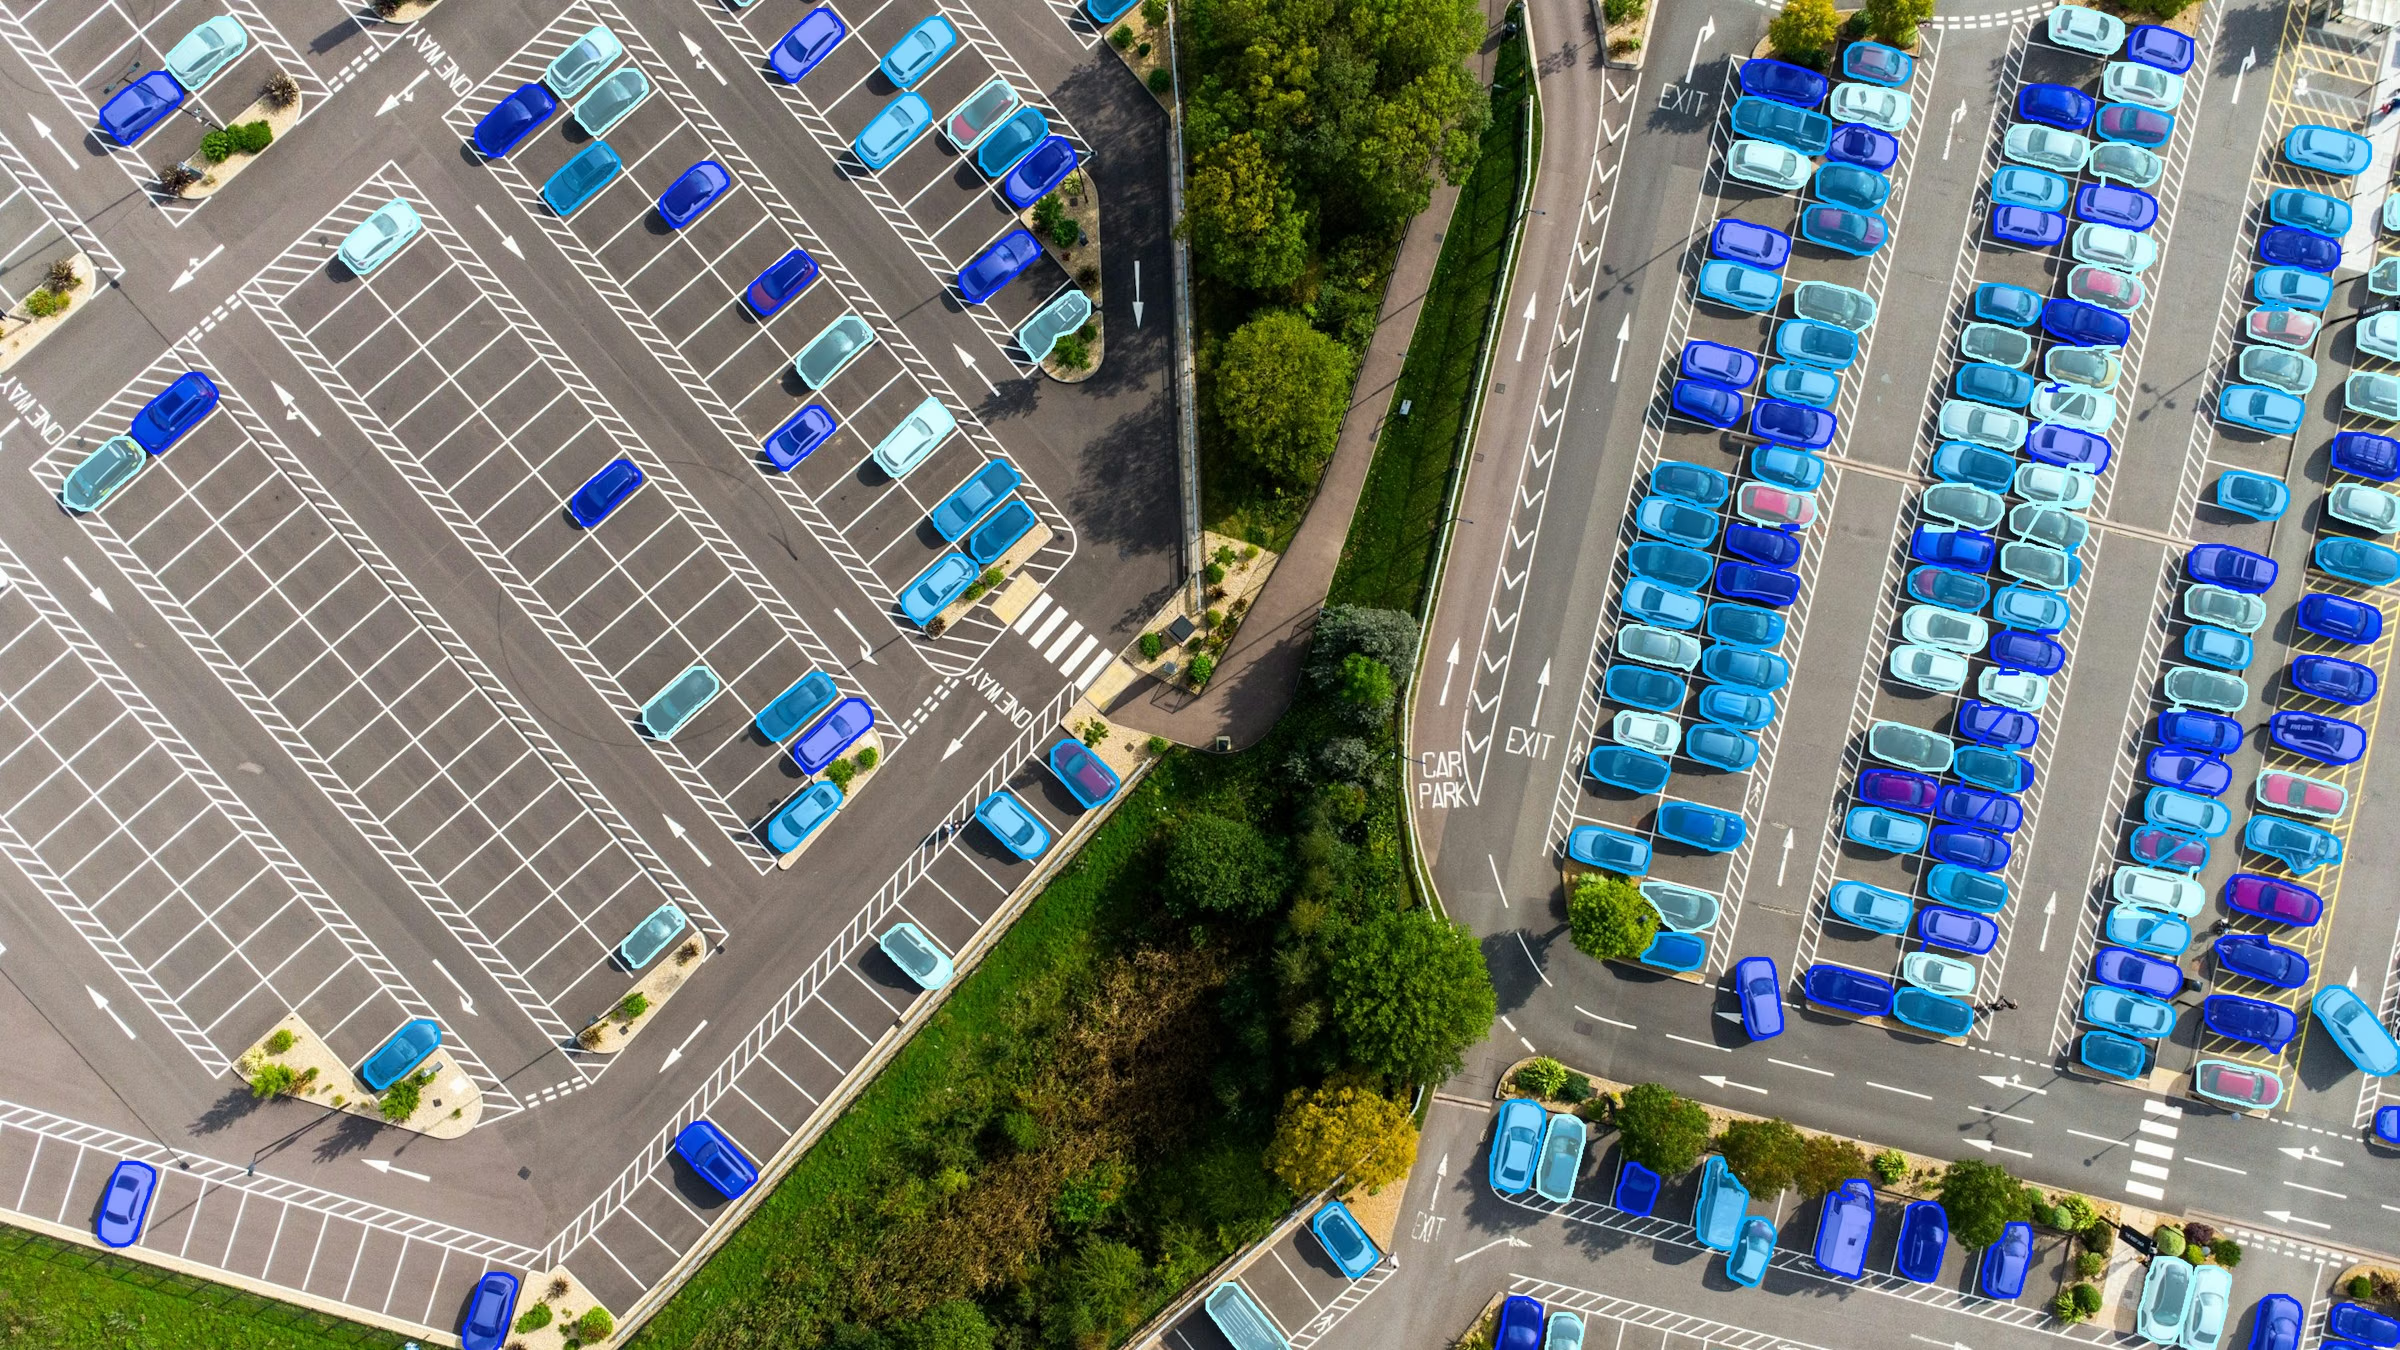
YOLO26x-seg ha restituito 222 maschere di auto in questo fotogramma aereo (imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). Foto: Unsplash.
Anche le previsioni su CPU diventano molto più veloci#
Su una CPU Linux x86 con 8 thread, il processo occupa circa 840 MiB prima ancora di creare le maschere. A 1080p con 1.000 maschere a piena risoluzione, il picco di memoria del processo è sceso da 5.217 MiB a 1.072 MiB e i tempi sono diminuiti come mostrato di seguito.
300 e 1.000 maschere a 1920 x 1080 e 300 maschere a 4000 x 3000 (12 MP). YOLO26n-seg, previsione più riepilogo, versione 8.4.212 prima e 8.4.213 dopo. Fonte: PR #27197.
Le maschere corrispondono a quelle della versione 8.4.212, con lievi differenze sui bordi in una modalità#
Un percorso più veloce è utile solo se restituisce lo stesso risultato. La PR ha confrontato la versione 8.4.213 con la 8.4.212 su 96 previsioni, usando YOLO26n-seg e YOLO11n-seg su due immagini a sei dimensioni, conf pari a 0.25 e 0.01, entrambe le modalità di maschera e il percorso locale ai riquadri attivato forzatamente:
- Maschere predefinite (
retina_masks=False): riquadri, maschere e poligoni sono identici; nessuno dei 7,6 milioni di pixel delle maschere è diverso. - Maschere a piena risoluzione (
retina_masks=True): identiche ogni volta che il codice precedente interpolava una sola volta. Per le altre forme delle immagini, lo 0,07% dei pixel delle maschere è diverso (18.105 su 24,8 milioni), tutti sui bordi delle maschere, perché in quei casi il codice precedente interpolava due volte, mentre quello nuovo campiona i prototipi una sola volta alle coordinate esatte. - Apple MPS: maschere, riquadri e poligoni sono identici in una scena densa a 1080p con 179 maschere, in entrambe le modalità.
Come segmentare 1.000 oggetti per immagine in Python#
Aggiorna con pip install -U ultralytics (versione 8.4.213 o successiva), poi porta max_det oltre il valore predefinito di 300. Il resto del codice non cambia.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # Classi COCO; carica il tuo modello addestrato per scaffali o pacchi
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # un array (P, 2) per oggetto, in pixel dell'immagine originale
rows = r.summary()  # riquadri e poligoni
max_det è un limite massimo, non un obiettivo: il numero di oggetti restituiti dipende comunque dal modello, dall'immagine e dalla soglia di confidenza. Per sfruttare al meglio questa modifica:
- Quando puoi, leggi i contorni.
masks.xy(pixel) emasks.xyn(normalizzate) provengono dalle maschere locali ai riquadri nel percorso con stack di grandi dimensioni, così cometo_json()esave_txt. Il riferimento di Results elenca tutti gli attributi. - Leggi
masks.dataper eseguire direttamente calcoli sui pixel. Le aree e le sovrapposizioni si calcolano più facilmente sul tensore denso; puoi ricavare i ritagli anche dai contornimasks.xy. La nostra lezione Academy su come usare le maschere nel codice spiega quando usare ciascuna rappresentazione e la guida all'isolamento degli oggetti mostra come creare ritagli dai contorni. - Usa
retina_masks=Truequando ti servono maschere alla risoluzione della sorgente. Nel benchmark GPU a 1080p con 300 maschere, ora richiede 18,0 ms rispetto ai 16,3 ms delle maschere predefinite. Per oggetti minuscoli in fotogrammi molto grandi, consulta il nostro articolo sul rilevamento di oggetti piccoli con il tiling delle immagini e la guida al tiling ad alta risoluzione. La previsione con tiling restituisce maschere della dimensione della sorgente, quindi anche un'esecuzione con tiling richiede memoria proporzionale all'immagine originale. - Regola
confeiouper le scene affollate. Aumentandomax_detmantieni più rilevamenti tra quelli che superano giàconf; abbassandoconfammetti rilevamenti meno sicuri. Le impostazioni di predict spieganoconf,iouemax_det, mentre la nostra guida alla soglia IoU di NMS spiega come gestire gli oggetti a contatto.
La modifica avviene nella post-elaborazione Python, quindi si applica al modello PyTorch e ai modelli esportati eseguiti tramite l'API predict di Ultralytics. La PR ha testato YOLO26n-seg e YOLO11n-seg; la stessa post-elaborazione è utilizzata da ogni modello di segmentazione YOLO26 e YOLO11, da YOLO26n-seg con 2,7 M di parametri fusi a YOLO26x-seg con 62,8 M. Per addestrarne uno sui tuoi dati densi, segui la nostra guida all'addestramento personalizzato di YOLO26 per la segmentazione di istanze.
Ultralytics Platform ora restituisce fino a 1.000 risultati per immagine#
Lo stesso limite massimo si applica ora in Ultralytics Platform. La scheda Predict di un modello restituisce fino a 1.000 risultati per immagine, così come la REST API che la alimenta. I modelli RT-DETR fanno eccezione: il limite è 300, pari al numero di query nel loro decoder.
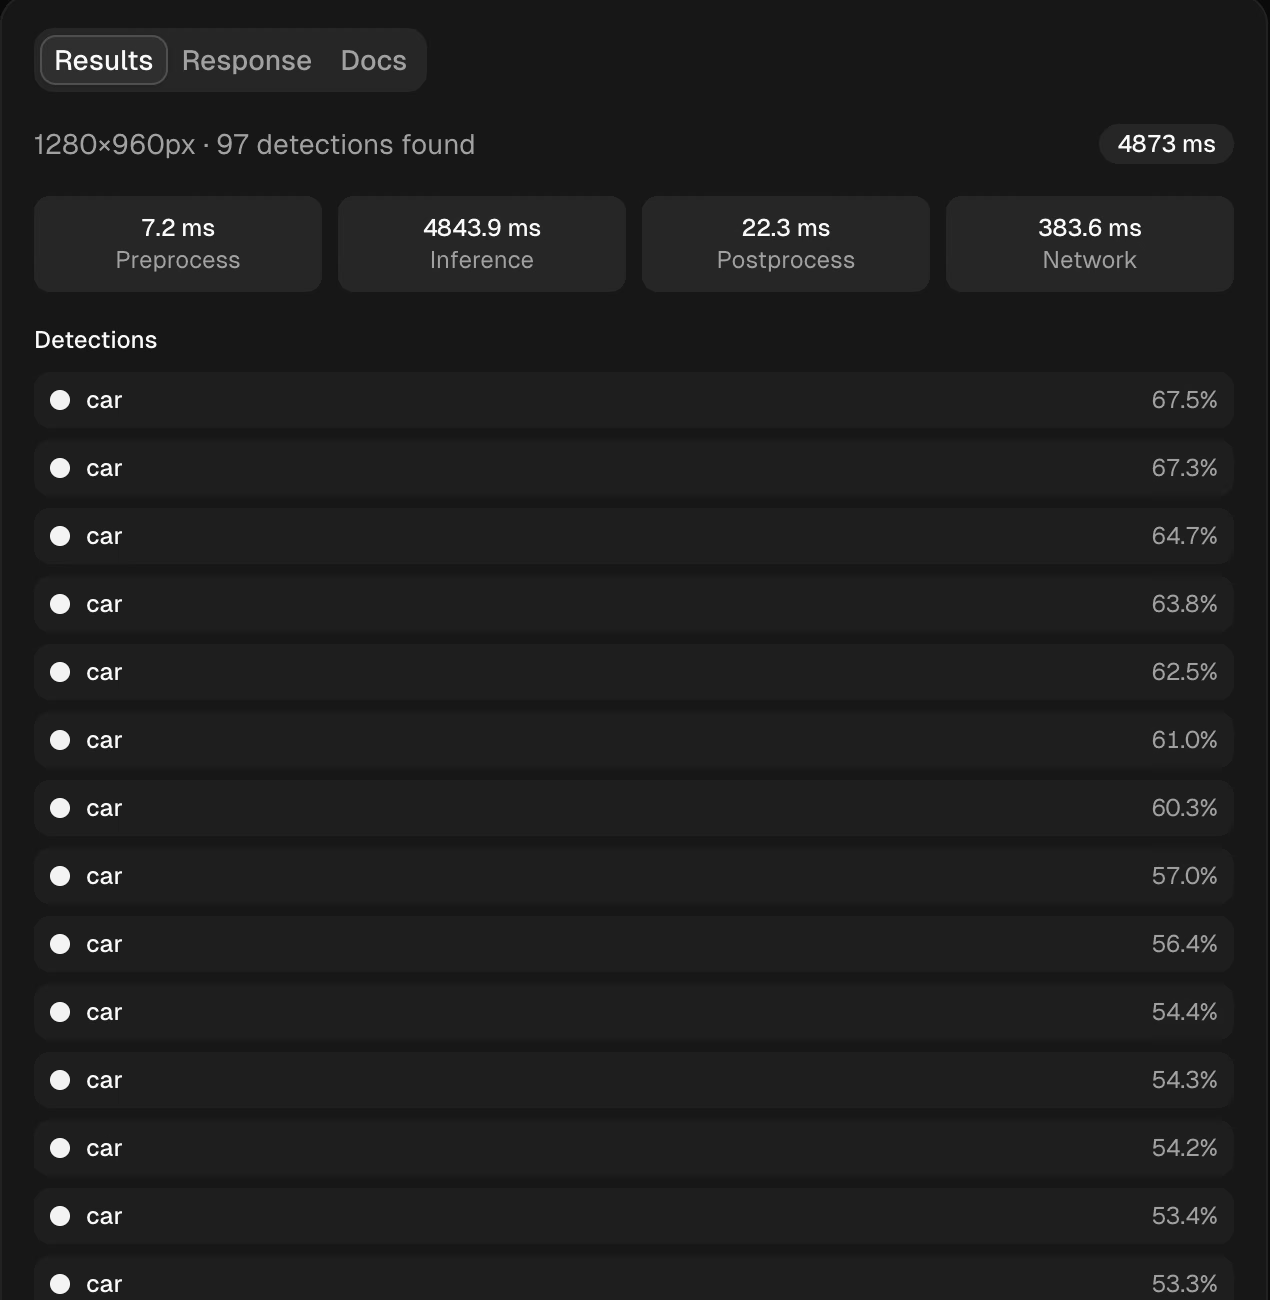
La scheda Predict per YOLO26x-seg con dimensione dell'immagine pari a 1280, che mostra 97 rilevamenti di auto nella foto aerea qui sopra. La documentazione sull'inferenza di Platform descrive nel dettaglio il pannello.
Il pannello dei risultati è stato progettato per elenchi lunghi. Quando i risultati sono più di 10, l'immagine mostra i riquadri senza etichette, così non nascondono gli oggetti; l'elenco identifica ogni risultato e l'immagine ingrandita mantiene le etichette. Passa il cursore su una riga per evidenziare l'oggetto corrispondente oppure su un oggetto per trovare la relativa riga.
Per provarlo sui tuoi dati, parti dal dataset di segmentazione dei pacchi Package-Seg, addestra il modello nel cloud ed esegui il risultato nella scheda Predict o dietro un endpoint dedicato.
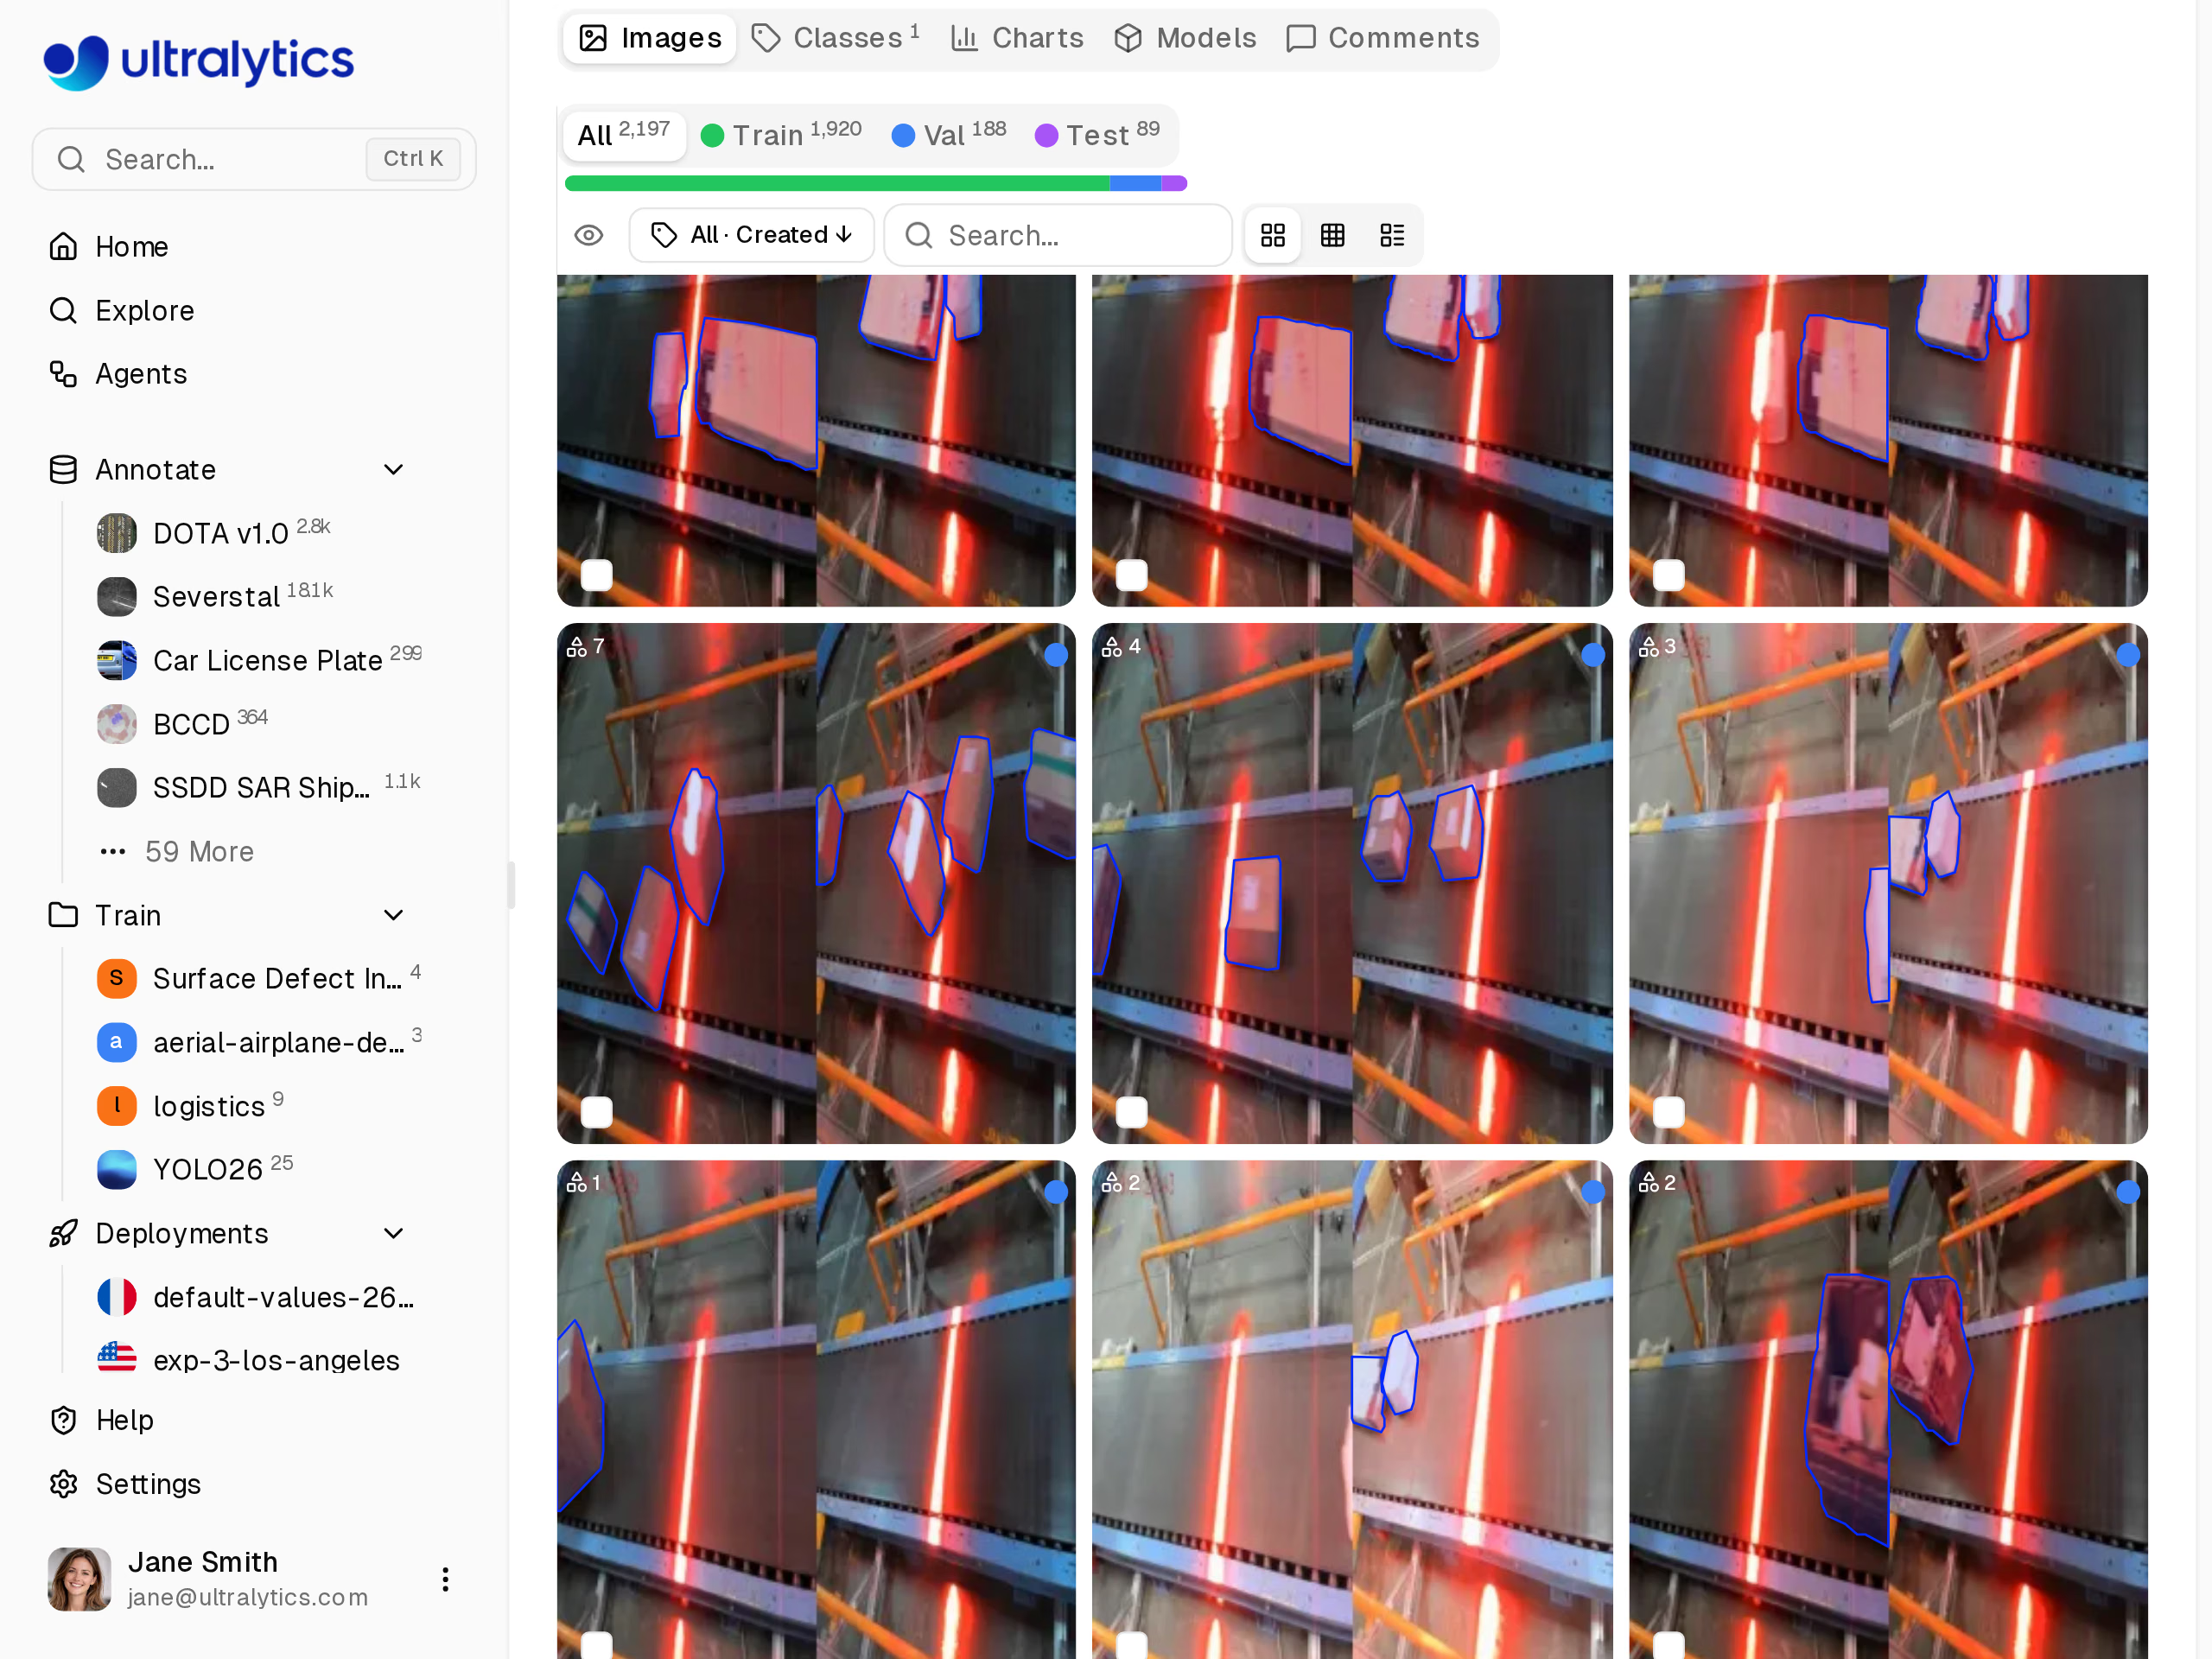
Il dataset Package-Seg su Ultralytics Platform, un punto di partenza pronto all'uso per la segmentazione in ambito logistico.
Chi dovrebbe aggiornare#
Aggiorna subito se esegui la segmentazione di scene affollate o immagini grandi: scaffali di negozi, smistamento di pacchi, rilevamenti aerei e con droni, microscopia cellulare o qualsiasi altro caso in cui hai dovuto limitare max_det, ridurre le dimensioni delle immagini o scartare retina_masks per rientrare nei limiti di memoria. Ora puoi riconsiderare queste soluzioni alternative.
Se i tuoi stack di maschere restano sotto la soglia, continuano a usare il percorso denso esistente; ricorda che la soglia dipende dal numero di oggetti moltiplicato per la dimensione dell'immagine, quindi anche poche maschere su un'immagine molto grande possono superarla. Se la tua pipeline legge sempre masks.data, il tensore denso viene comunque creato; nel test GPU della PR con 300 maschere a 1080p, ha richiesto meno tempo e memoria rispetto a prima. Per ripassare quando servono davvero le maschere di istanza, consulta segmentazione semantica vs segmentazione di istanze.
Domande frequenti
La segmentazione YOLO è l'attività di segmentazione di istanze di Ultralytics YOLO: per ogni oggetto, il modello restituisce una classe, un riquadro, un punteggio di confidenza e una maschera di pixel. I modelli di segmentazione YOLO26 sono disponibili in cinque dimensioni, da YOLO26n-seg a YOLO26x-seg, preaddestrati sulle 80 classi di COCO e pronti per il fine-tuning sui tuoi dati.
max_detstabilisce il limite massimo, 300 per impostazione predefinita; il numero restituito dipende anche dal modello, dall'immagine e dalla soglia di confidenza. Dalla versione 8.4.213, un limite massimo di 1.000 è pratico per carichi di lavoro come quello del benchmark: su un'immagine sintetica a 1080p, YOLO26n-seg ha previsto e riepilogato 1.000 maschere a piena risoluzione in 56,4 ms, con un picco di memoria di 321 MiB su una RTX PRO 6000. Ultralytics Platform restituisce fino a 1.000 risultati per immagine.Le versioni precedenti generavano ogni maschera alla dimensione del fotogramma, quindi la memoria aumentava in proporzione al numero di oggetti moltiplicato per l'area del fotogramma. Nel benchmark sintetico a 4000 x 3000 con 1.000 maschere a piena risoluzione, il picco era di 23.305 MiB di memoria GPU. La versione 8.4.213 decodifica gli stack di grandi dimensioni all'interno di ciascun riquadro e, nello stesso caso, ha raggiunto un picco di 258 MiB.
Aggiorna a
ultralyticsversione 8.4.213 o successiva; non serve modificare altro codice, perché il percorso locale ai riquadri si attiva automaticamente per gli stack di maschere di grandi dimensioni.masks.datamantiene lo stesso formato denso, quindi il codice esistente continua a funzionare; leggeremasks.xyo chiamaresummary()evita invece di costruirlo in questo percorso.retina_masks=Truerestituisce le maschere alla risoluzione dell'immagine originale anziché a quella di inferenza del modello, allineando così la maschera densa all'immagine originale. Con 300 maschere su un'immagine sintetica a 1080p e questa impostazione attiva, la previsione più il riepilogo di YOLO26n-seg su una RTX PRO 6000 hanno richiesto 248,7 ms nella versione 8.4.212 e 18,0 ms nella versione 8.4.213.
Scritto da
Fondatore e CEO · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









