Data Curation
La cura dei dati è il processo continuo di organizzazione, convalida, documentazione e manutenzione di dataset affidabili per il machine learning e la valutazione.
La curatela dei dati è il processo continuo di selezione, organizzazione, verifica, documentazione e manutenzione dei dati affinché restino utili per uno scopo specifico. Nel machine learning, determina gli esempi da cui un modello apprende e le evidenze usate per valutarlo. Un dataset curato combina campioni pertinenti, etichette coerenti per le attività supervisionate, informazioni contestuali e versioni tracciabili.
Curatela, pulizia e preelaborazione#
La curatela copre l'intero ciclo di vita del dataset. La pulizia dei dati corregge gli errori e rimuove i record inutilizzabili; la preelaborazione dei dati trasforma gli input tramite operazioni come il ridimensionamento o la normalizzazione. L'annotazione dei dati, detta anche etichettatura dei dati, aggiunge i target usati nell'apprendimento supervisionato. La curatela coordina queste attività, decidendo quali campioni includere, come definire le categorie e come aggiornare la raccolta nel tempo. Definizioni coerenti delle categorie e regole di etichettatura aiutano i modelli ad apprendere relazioni affidabili tra immagini e target.
Questo rende la curatela una componente pratica dell'IA centrata sui dati, che migliora i sistemi migliorandone i dati.
Come funziona la curatela dei dati#
Il processo inizia con una specifica del dataset: l'attività di previsione, le categorie target, le condizioni operative e i criteri di inclusione. Per il rilevamento di oggetti, questa specifica comprende le regole per i riquadri di delimitazione e gli oggetti parzialmente visibili. Esaminare la frequenza delle categorie e le condizioni di acquisizione fa emergere le distorsioni del dataset, comprese le classi o gli ambienti sottorappresentati.
I controlli di qualità combinano l'ispezione automatizzata con la revisione umana. I controlli sui file individuano le immagini illeggibili; quelli sulle annotazioni identificano coordinate non valide e classi incoerenti. Gli hash dei file individuano le copie identiche, mentre gli embedding—rappresentazioni numeriche del contenuto delle immagini—aiutano a trovare campioni visivamente simili. La revisione distingue gli errori correggibili dai record inutilizzabili e conserva esempi validi e difficili che rappresentano l'attività.
Un controllo degli hash dei file può conservare un percorso per ogni file univoco. Questo esempio controlla le immagini incluse nel pacchetto ultralytics, installato con pip install ultralytics:
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
I conteggi mostrano quanti file restano dopo la deduplicazione esatta; conteggi uguali indicano che tutti i file campionati hanno hash distinti.
La suddivisione tutela l'indipendenza dei dati di addestramento, dei dati di validazione e dei dati di test. I fotogrammi video ravvicinati condividono contenuti della scena, quindi distribuirli tra le suddivisioni introduce una fuga di dati e gonfia i punteggi di valutazione. Raggrupparli per sessione di registrazione, telecamera o sito fa sì che la valutazione rifletta l'attività di generalizzazione prevista. Una versione fissa del dataset mantiene queste assegnazioni insieme alle etichette.
Ultralytics Platform supporta la curatela con grafici della distribuzione delle classi e raggruppamenti di immagini che evidenziano lacune di copertura, duplicati e valori anomali. I suoi strumenti di gestione dei dataset consentono ai team di esaminare questi gruppi e aggiornare immagini, etichette e assegnazioni alle suddivisioni.
Cosa fa un curatore dei dati#
Un curatore dei dati mantiene il significato e l'utilizzabilità della raccolta. Le responsabilità comprendono documentare le fonti, coordinare le linee guida per l'annotazione, risolvere i disaccordi sull'etichettatura e registrare le modifiche. I metadati—informazioni che descrivono i campioni—registrano l'ora di acquisizione, il sensore, la posizione e lo stato dell'annotazione. Mantenere dati riutilizzabili significa conservare le descrizioni e la documentazione di supporto.
La provenienza dei dati registra l'origine dei campioni e le trasformazioni a cui sono stati sottoposti. Collegare le versioni dei dataset al tracciamento degli esperimenti rende riproducibili i confronti tra modelli. Dopo la distribuzione, l'apprendimento attivo assegna la priorità ai campioni informativi da rivedere; il monitoraggio rileva la deriva dei dati, che può motivare nuove raccolte.
Esempi nella visione artificiale#
Nella percezione automobilistica, la raccolta originale BDD100K contiene 100.000 video di guida girati in diverse località degli Stati Uniti, condizioni meteorologiche e momenti del giorno e della notte. I suoi attributi ambientali consentono la valutazione in diverse condizioni di acquisizione. L'edizione di Platform contiene 99.996 immagini di fotogrammi chiave per il rilevamento.
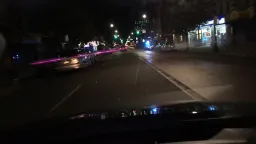 anteprima 1 di BDD100K
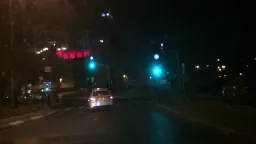 anteprima 2 di BDD100K
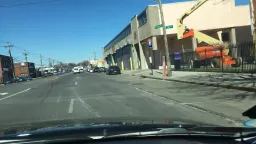 anteprima 3 di BDD100K
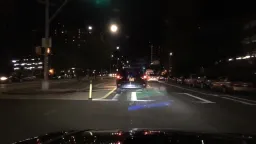 anteprima 4 di BDD100K
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
Per la classificazione delle immagini, la correzione ciFAIR ha sostituito i quasi-duplicati nei set di test originali di CIFAR-10 e CIFAR-100. Le corrispondenze con le immagini di addestramento o con altre immagini di test interessavano rispettivamente il 3,25% e il 10% dei set di test originali. Lasciando invariato l'addestramento, l'errore di classificazione di ResNeXt-29 (8x64d) è salito dal 3,56% su CIFAR-10 al 3,95% su ciFAIR-10.









