PythonからRustまで、Ultralytics YOLOで画像タイル化による小物体検出を行う方法
画像タイル化がYOLOの小さな物体検出に役立つ場面やコストを確認し、SAHIを使わずにPythonまたはRustで組み込みのタイル推論を実行する方法を説明します。
 Onuralp Sezer15 分で読めます
通常の写真では問題なく動作する検出器が、ドローン映像ではなぜほとんどの人を見落とすのでしょうか。多くの場合、物体を十分な大きさで見ていないためです。デフォルトのimgsz=640では、Ultralytics YOLOはモデルが画像を見る前に1920 x 1080のフレームを3回縮小するため、高さ15ピクセルの歩行者は約5ピクセルになります。
画像タイル化では、フル解像度画像を重なり合うウィンドウに分割してモデルに入力し、結果を統合することで、小物体の細部を保持できます。ドキュメント内のVisDroneの1フレームでは、Ultralytics YOLO26sの検出数が35件から161件に増えました。その代わり、フレームごとの処理量は増えます。このフレームでは画像1枚ではなく、8個のタイルを入力します。
デプロイの両側で、タイル化が組み込みで利用できるようになりました。Pythonパッケージでは、11月6日のUltralytics 8.4.204以降、tile引数を使用できます。Rustクレートでは、11月9日のUltralytics Inference 0.0.57で--tileフラグが追加されました。このガイドでは、タイル化によって小物体を検出できる場面、コスト、各環境での実行方法を説明します。
リサイズによって小物体が見えにくくなります#
小物体検出が難しい理由は単純です。物体が持つピクセル数は決まっています。物体検出モデルは、物体ごとのわずかなピクセルから形状を学習します。フレーム全体を長辺640ピクセルに縮小すると、遠くにいる人や車両、欠陥は、ネットワークがテクスチャやノイズから区別できる限界を下回ります。
この問題は、空撮画像、衛星画像解析、広角の交通・監視カメラ、高解像度の検査写真で特に顕著です。VisDroneは広く使われている公開空撮ベンチマークです。ドキュメントによると、画像内で数十ピクセルしかない物体が、密集し、強く遮蔽された状態で写っています。
タイル化はこれらのピクセルを保持します。tileにモデルの入力サイズを設定すると、縮小したフレーム全体を1回処理する代わりに、モデルは複数のウィンドウをネイティブ解像度で認識します。この考え方は、SAHIの論文でスライス支援型ハイパー推論と呼ばれており、著者らはVisDroneとxViewの空撮データセットで評価しています。
高解像度タイル化ガイドでは、1920 x 1080のVisDroneフレームに対して、デフォルトの信頼度しきい値を使用したYOLO26sが、imgsz=640では画像全体から35件を検出し、tile=640では遠くにいる歩行者、自転車利用者、車を含む161件を検出します。ガイドでは2つの画像を並べて示しています。これらは予測数であり、スコアを算出した評価結果ではありません。どちらの件数も同じ重みで得られていますが、タイル化によって各ウィンドウが見るコンテキストも変わります。
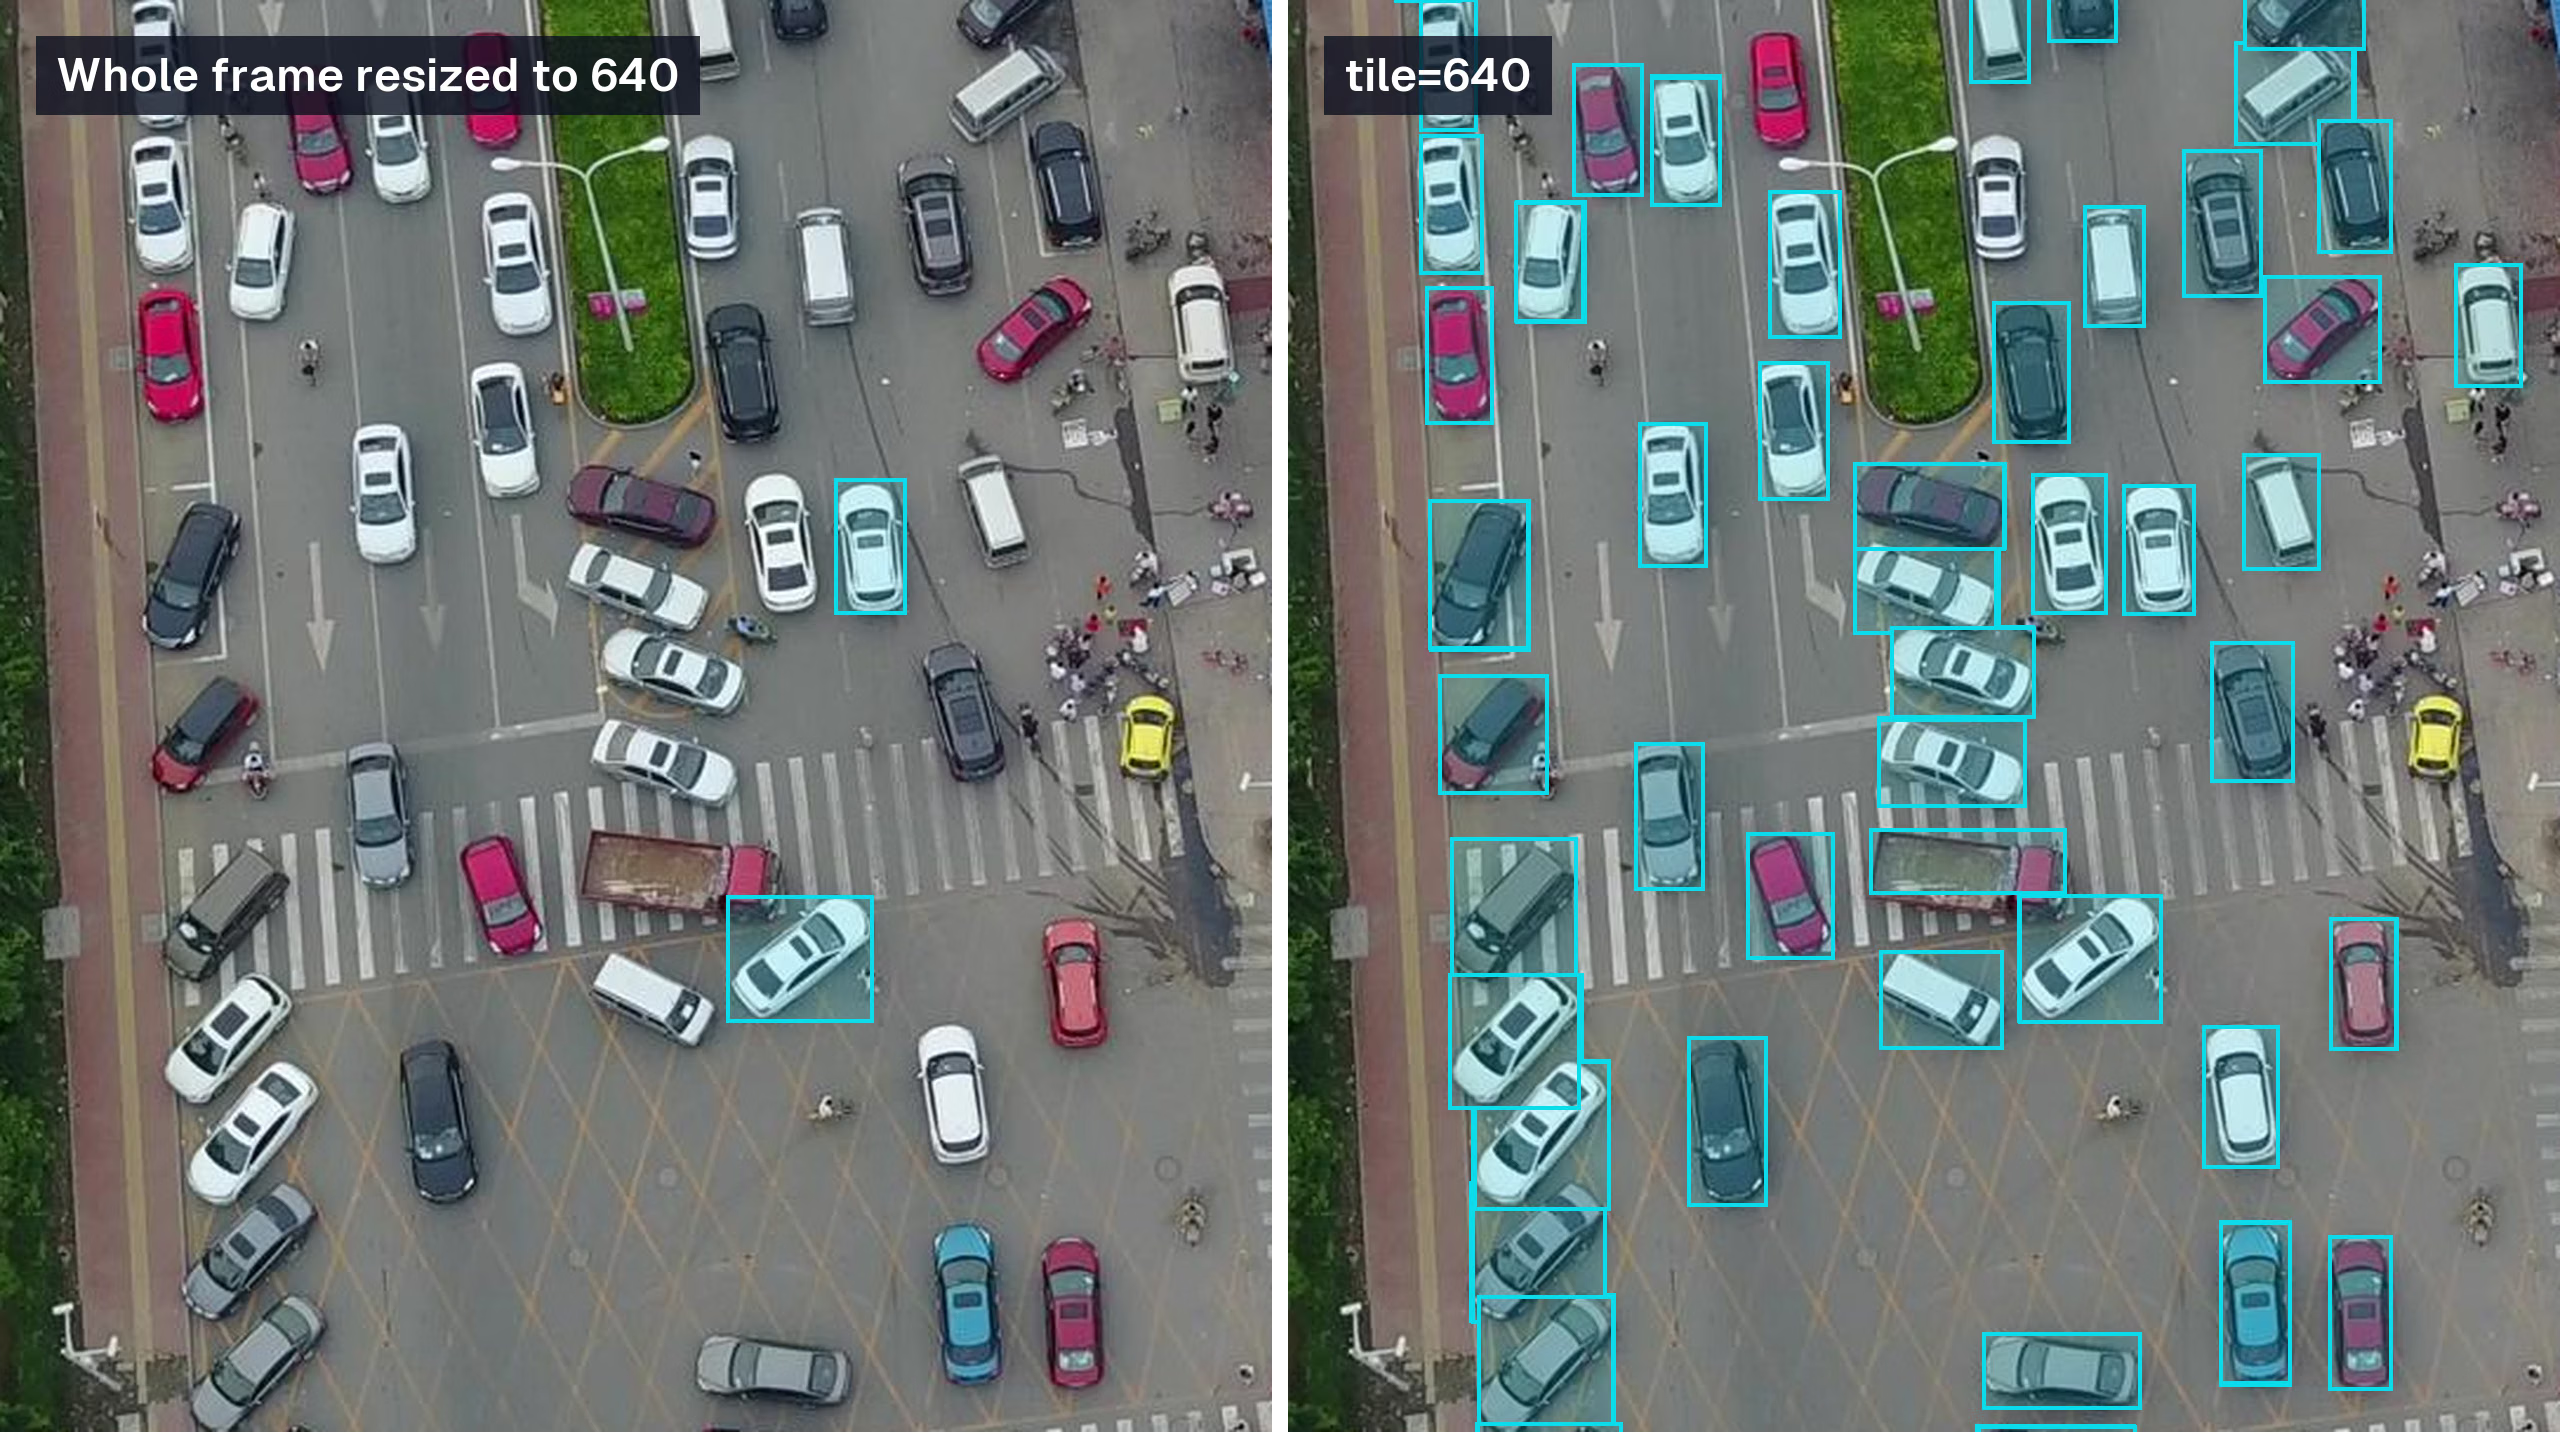
別の1920 x 1080のVisDrone検証フレームで、デフォルトの信頼度を使用したYOLO26sの結果:フレーム全体をimgsz=640で処理すると8件、tile=640では128件を検出しています。道路部分を切り出し、クラスラベルのないボックスを表示しています。
タイル化ではウィンドウごとにモデル入力が1つ追加されます#
ガイドではウィンドウ分割の仕様を明確に定義しています。ウィンドウは基本的に20%重なり、最後の行と列は画像の境界に合わせるため、端のウィンドウはそれ以上に重なる場合があります。ウィンドウより小さい画像は、画像全体を1つのウィンドウとして扱います。
これによりコストを簡単に見積もれます。tile=640で1920 x 1080のフレームを処理すると、横4列、縦2行の計8ウィンドウになります。tile=1280で3840 x 2160のフレームを処理する場合も8ウィンドウです。同じ20%のルールをtile=640で3840 x 2160のフレームに適用すると、横8列、縦4行の計32ウィンドウになります。つまり、4Kフレームでウィンドウサイズを半分にすると、タイル入力数は4倍になります。
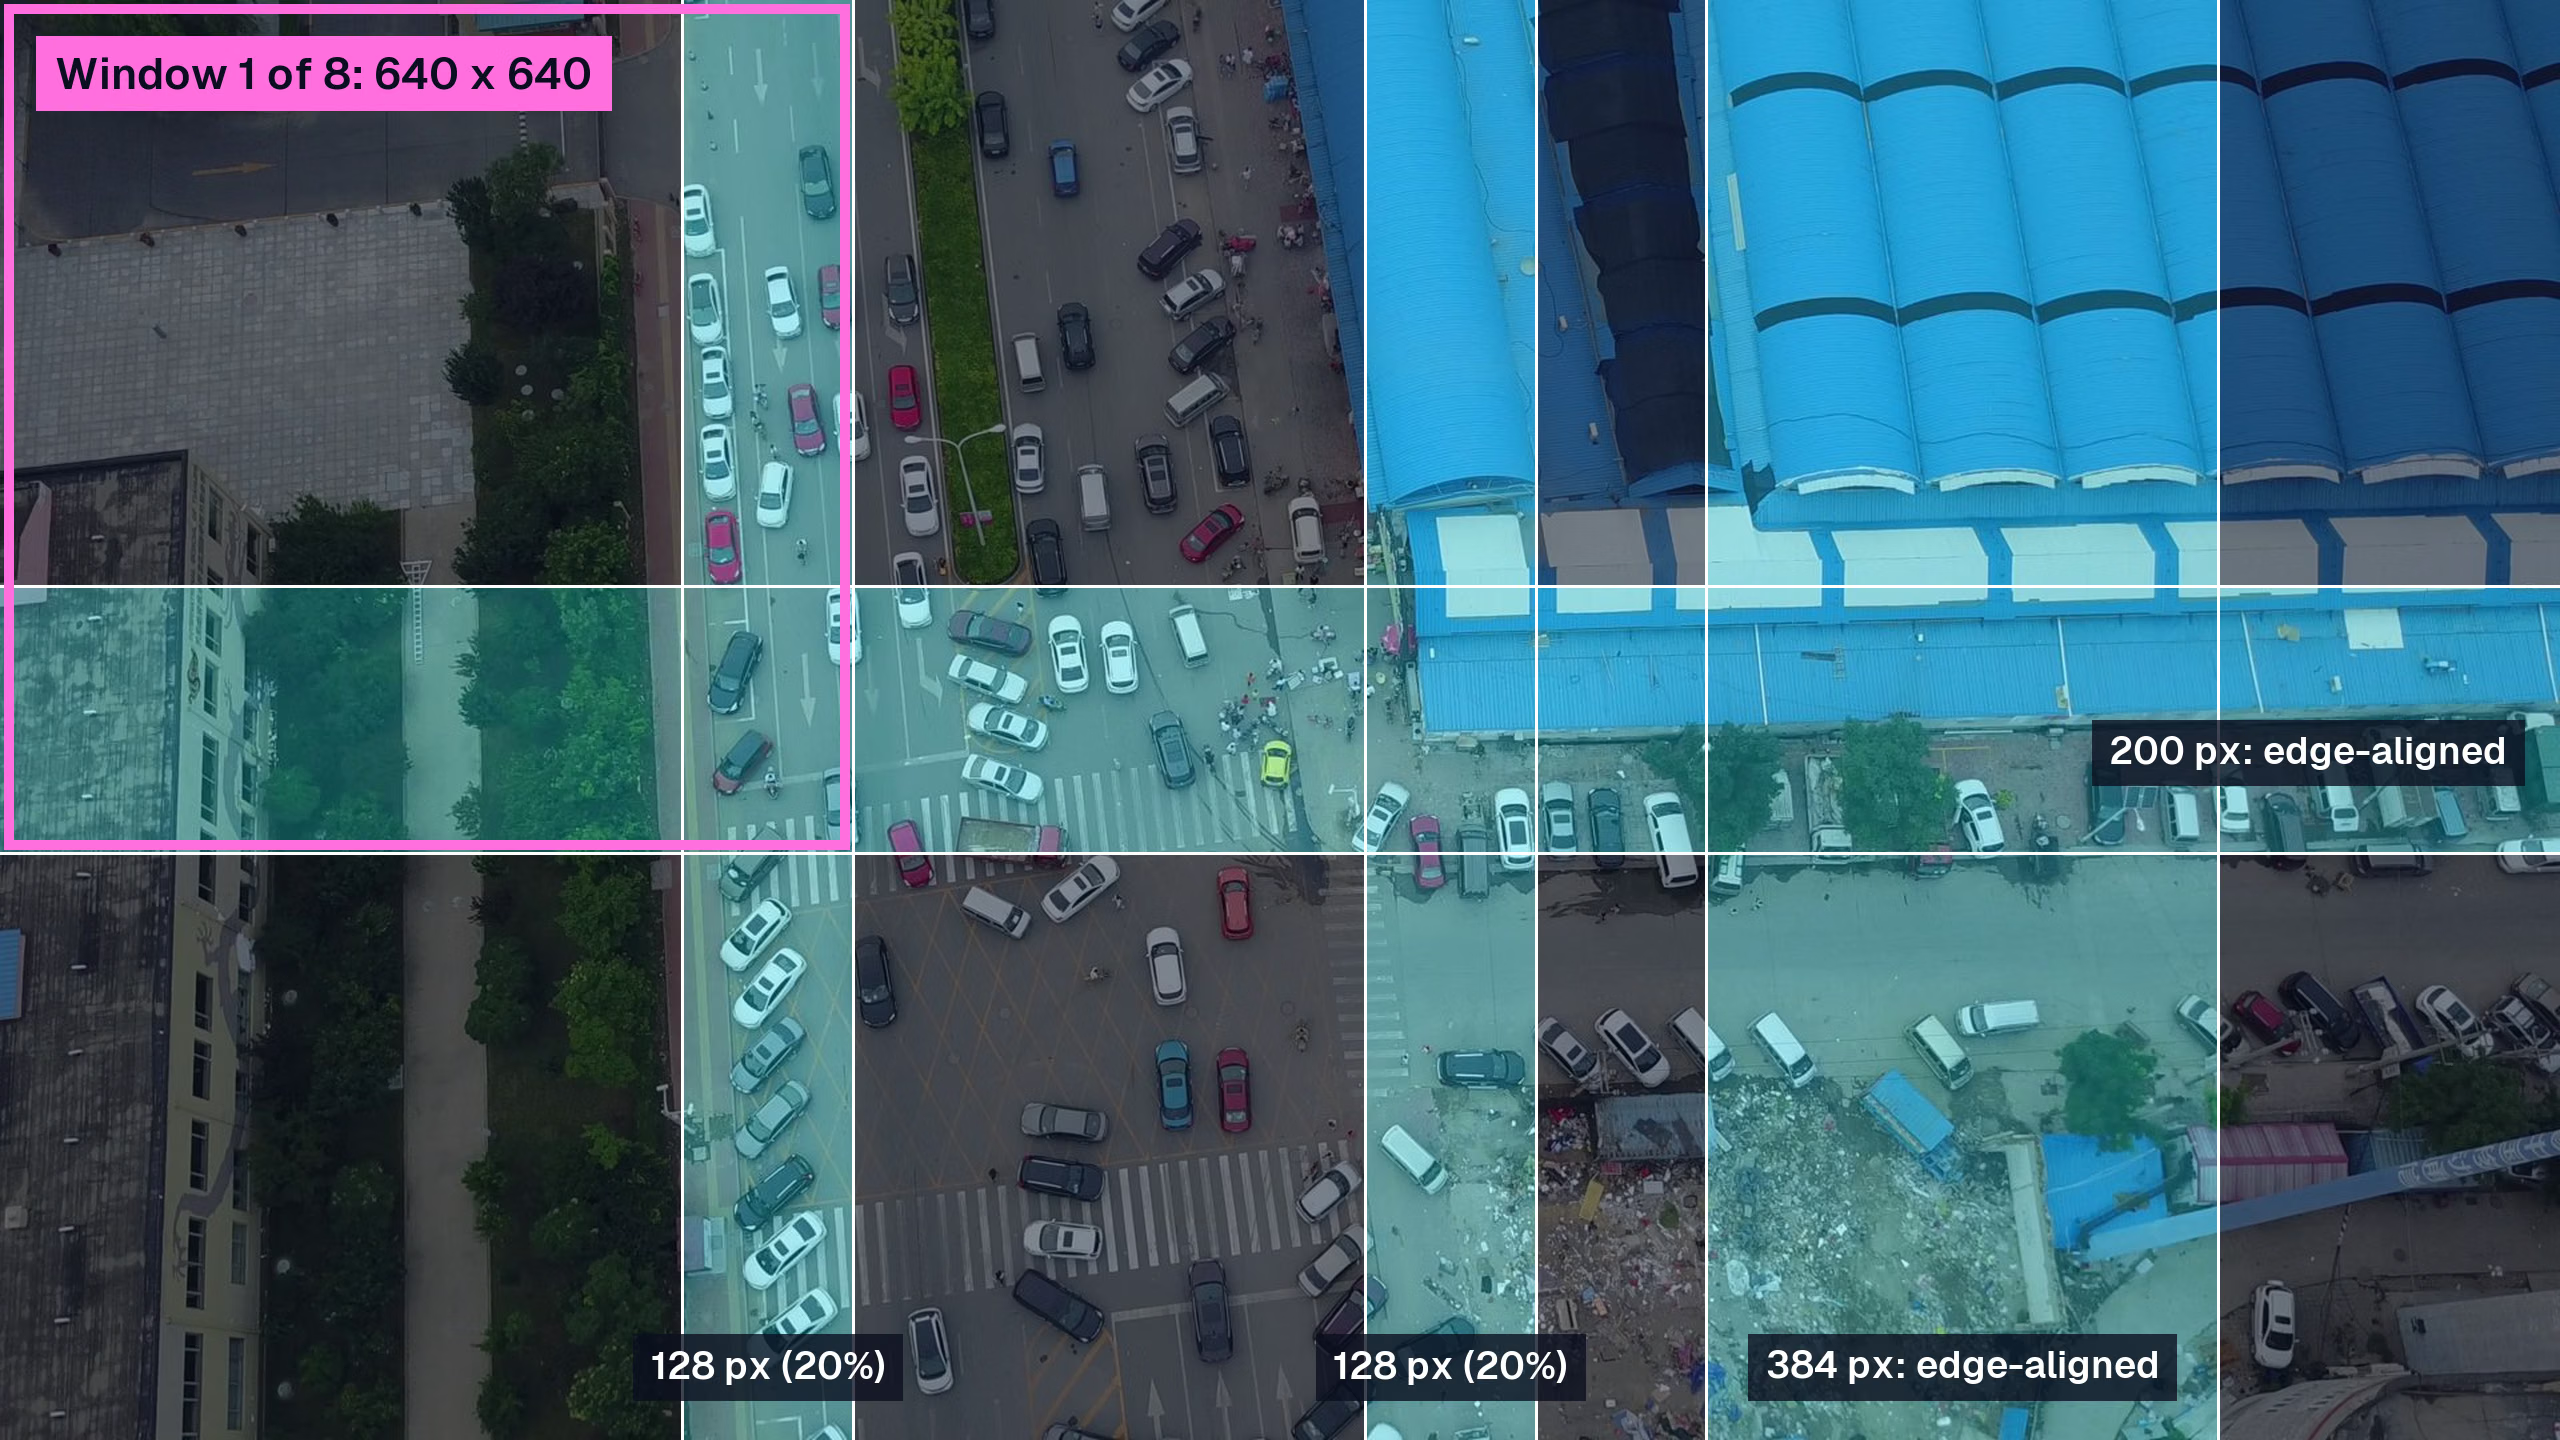
1920 x 1080のフレームでtile=640を使った場合の8つのウィンドウ:列の開始位置はx = 0、512、1024、1280、行の開始位置はy = 0、440です。網掛け部分は複数のウィンドウに含まれます。
バッチ処理によって、これらの入力をモデルに渡す方法が変わります。Pythonでは、batchで1回の推論呼び出しで同時に処理するウィンドウ数を設定します。Rustクレートでも、動的バッチのエクスポートで--batchを使って同様に設定できます。バッチ処理によってスループットが向上する場合がありますが、レイテンシは使用するハードウェアで測定してください。Ultralytics YOLOによるバッチ推論のガイドでは、その理由を説明しています。
小物体により多くのピクセルを与える他の方法と、タイル化を比較します。
| アプローチ | 1920 x 1080のフレームに対するモデル入力 | モデルに見える内容 | 最適なケース |
|---|---|---|---|
画像全体、imgsz=640 | 1 | フレームを3分の1に縮小 | リサイズ後も物体がはっきり見えます |
画像全体、imgsz=1280 | 1。計算量は640の場合の約4倍です | フレームを3分の2に縮小 | メモリとレイテンシに余裕があれば、より大きな入力を使用できます |
tile=Trueとimgsz=640 | 8 | ネイティブ解像度の640ピクセルウィンドウ | モデル入力より数倍大きい画像 |
tile=400とimgsz=640 | 8個超 | ウィンドウを640ピクセルに拡大 | ネイティブ解像度でも、物体の幅はわずか数ピクセルです |
各タイルは通常サイズのモデル入力なので、imgszを大きくしなくても、タイル化で非常に大きな画像を処理できます。マスクや深度マップなど、元画像と同じサイズの出力には、元画像に比例したメモリが引き続き必要です。また、max_detによって保持するインスタンスマスクの数が制限されます。
タイル化が役立つ場合と逆効果になる場合#
物体がフレームに対して小さく、フレームがモデル入力より大幅に大きい場合、タイル化が役立ちます。ドローンや衛星画像、上空からの交通画像、群衆、広角で撮影した小売店の棚、基板やパネル全体を撮影した外観検査画像などが該当します。
物体が大きい場合は逆効果になります。フレームの半分を占めるトラックはウィンドウに一部しか写りません。ガイドでも明記されているとおり、ウィンドウが物体全体を捉えられないため、重なり幅を超える大きさの物体は分割されることがあります。また、統合処理で別々の断片が結合されることはありません。さらに、画像全体のコンテキストが失われます。タイルごとの出力が画像全体で一致しないことがあるため、分類や深度では特に問題になります。
ウィンドウを小さくすると、もう1つトレードオフが生じます。400ピクセルのウィンドウを640ピクセルに拡大すると、幅が数ピクセルしかない物体を検出しやすくなりますが、背景のノイズも拡大され、誤検出につながる可能性があります。独自の検証セットでタイルサイズを2~3種類比較し、適合率と再現率の両方を確認してください。
タイルを統合して1つの結果に戻す方法#
各ウィンドウは、ウィンドウ座標で独自の予測を生成します。タイル化では予測を元画像の座標に戻し、元画像ごとに1つのResultsオブジェクトを返すため、result.boxesを読み取る下流コードはそのまま動作します。
ウィンドウが重なるため、境界付近の物体が重複して検出される場合があります。物体検出では、iou、agnostic_nms、max_detの設定を使った非最大抑制で重複を抑制するため、NMSのIoUしきい値の調整に関するガイドはタイル化した出力にもそのまま適用できます。ウィンドウの端で切れたボックスは、別のウィンドウが物体全体を捉え、そのボックスが切れたボックスを覆っている場合に破棄されます。これにより、境界部分ではより完全な予測が残ります。より適切な一致がない場合は、切れたボックスも保持されます。
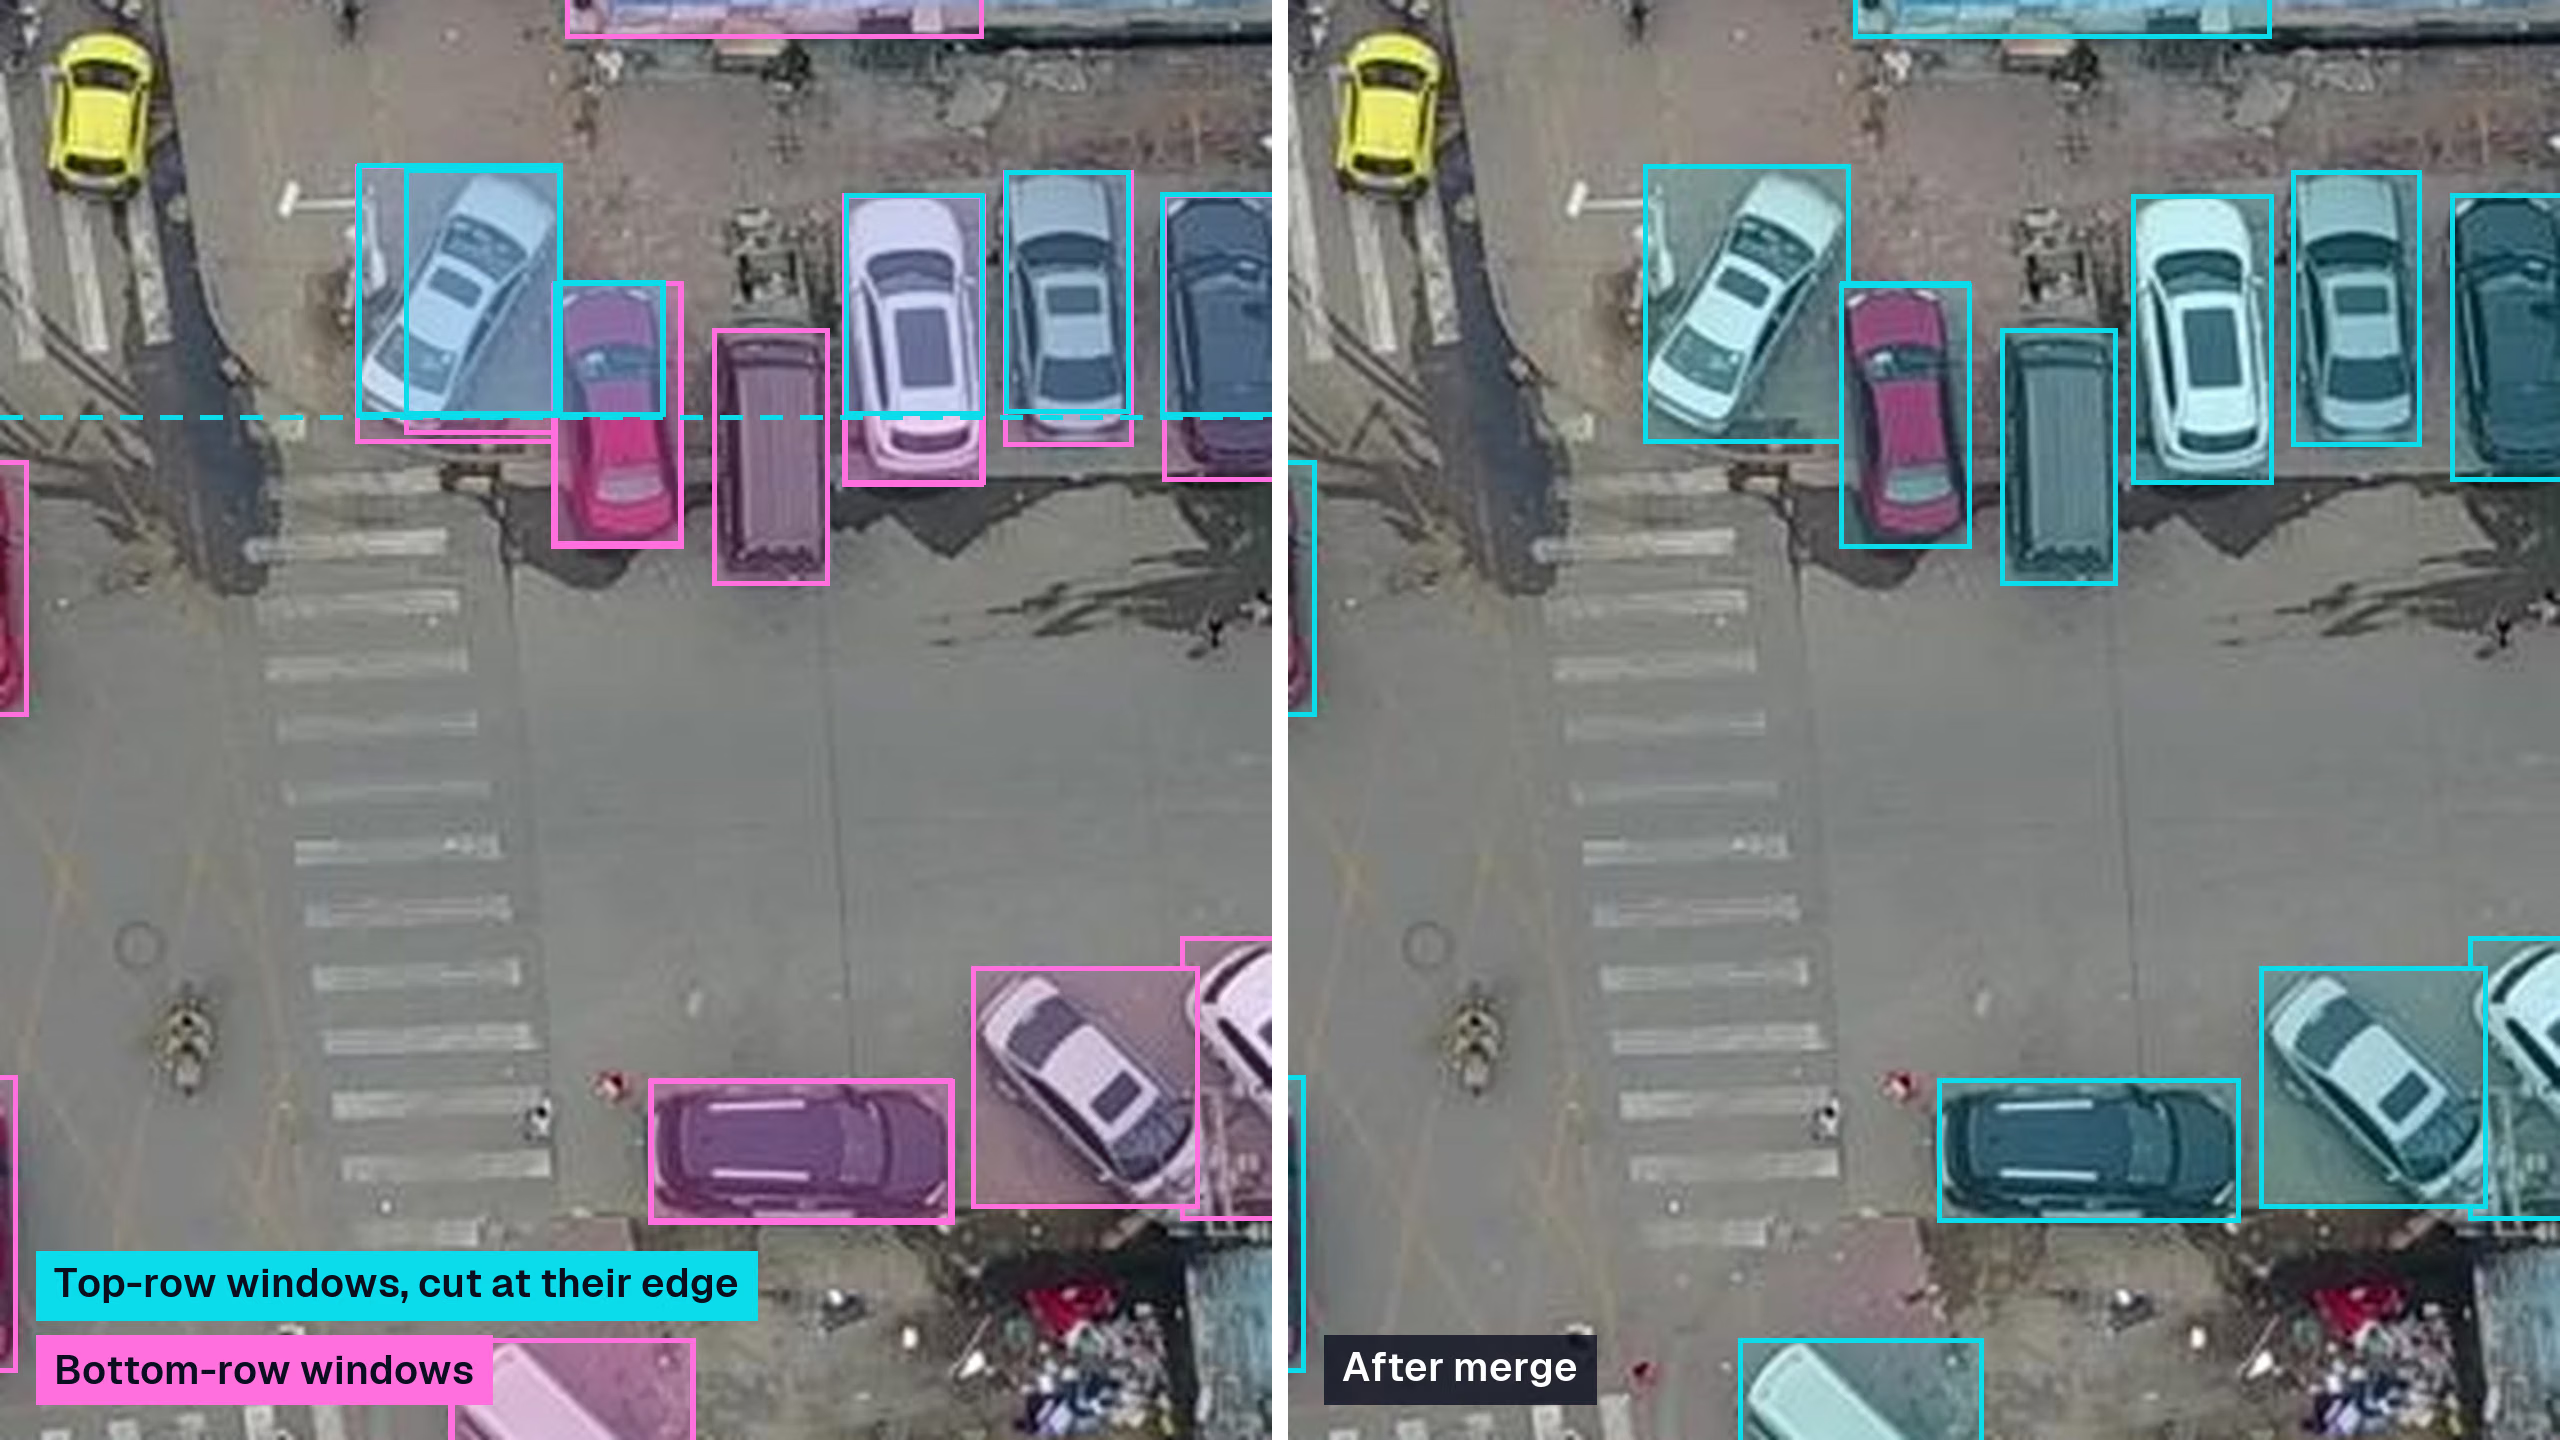
同じフレームのy = 640における境界処理の図です。水色のボックスは上段ウィンドウの下端で切れたもの、マゼンタのボックスは下段ウィンドウから得たものです。右側のパネルでは、統合後に各車についてより完全なボックスが残っています。
Ultralytics YOLOでは、タスクごとに異なる方法で結果を統合します。
- Detect、segment、pose、OBBでは、ボックス、マスク、キーポイント、または回転ボックスを元画像の座標に戻し、ボックス選択を適用します。OBBでは回転NMSを使用します。
- セマンティックセグメンテーションではクラスマップをつなぎ合わせ、ウィンドウが重なる部分では最も中央にあるタイルを選択します。
- 深度推定では、タイルの中心に近いほど重みを大きくして、重なり合う深度マップをブレンドします。
- 分類では、タイルごとの確率を平均します。
Pythonのパイプラインでは、YOLO-World、YOLOE、RT-DETR、FastSAMの予測にもタイル化を適用できます。SAMは独自のクロップパイプラインを使い、tileは受け付けません。
tile引数を使ったPythonでのタイル推論#
タイル化にはUltralytics 8.4.204以降が必要ですが、追加パッケージは不要です。predictモードでは、tile=Trueを渡すとウィンドウサイズにimgszを使用し、整数を渡すとウィンドウサイズを個別に設定できます。
from ultralytics import YOLO

model = YOLO("yolo26s.pt")

# ベースライン:フレームを640ピクセルに縮小して1回だけ処理します
full = model.predict("intersection.jpg", imgsz=640)

# タイル化:ネイティブ解像度の640ピクセルウィンドウを使い、1バッチあたり8ウィンドウを処理します
tiled = model.predict("intersection.jpg", imgsz=640, tile=640, batch=8)

print(len(full[0].boxes), len(tiled[0].boxes))CLIでもyolo predict model=yolo26s.pt source=large-image.tif tile=640 imgsz=640 batch=8を使えば同じ引数を使用できます。動画の場合は、メモリ使用量を一定範囲に抑えるため、stream=Trueを渡してください。trackモードでは、統合済みの予測に対してフレームごとに1回、トラッカーが実行されます。
タイル化は推論だけに使うものではありません。画像がimgszより大幅に大きい場合は、同じ設定で学習と検証を行ってください。
- タイルで学習するには、
model.train(data="aerial.yaml", tile=True, imgsz=640)を使います。ラベルは各ウィンドウに合わせて切り詰められ、元のボックス面積の10%未満しか残らないインスタンスは削除されます。空のウィンドウも負例として残ります。 - 統合結果で検証するには、
model.val(data="aerial.yaml", tile=True, imgsz=640)を使います。予測は元のアノテーションと照合してスコアを算出する前に統合されるため、mAPはデプロイ時の性能を反映します。 - 学習時にタイルをシャッフルするため、同じ大きな画像を何度もデコードしないよう、
cache="ram"を使って大きな元画像をキャッシュします。 - タイル化モデルを採用する前に、同じ検証データ分割で画像全体を使ったベースラインと比較してください。小物体のスコアを向上させる方法については、小物体mAPチェックリストをご覧ください。
タイルで学習すると、タイル化推論時と同じスケールで物体をモデルに見せることができます。ドローン検出データセットのガイドでは、4Kフレームを使って学習、タイル化、評価の一連の流れを説明しています。
エクスポートしたモデルもタイル化できます。タイル化はPythonの予測パイプラインで実行されるため、モデルをONNXまたはTensorRTにエクスポートしても通常の入力グラフは維持され、固定のエクスポートバッチサイズや最後の不完全なバッチを含め、YOLO("yolo26s.onnx").predict(source, tile=640)は通常どおり動作します。
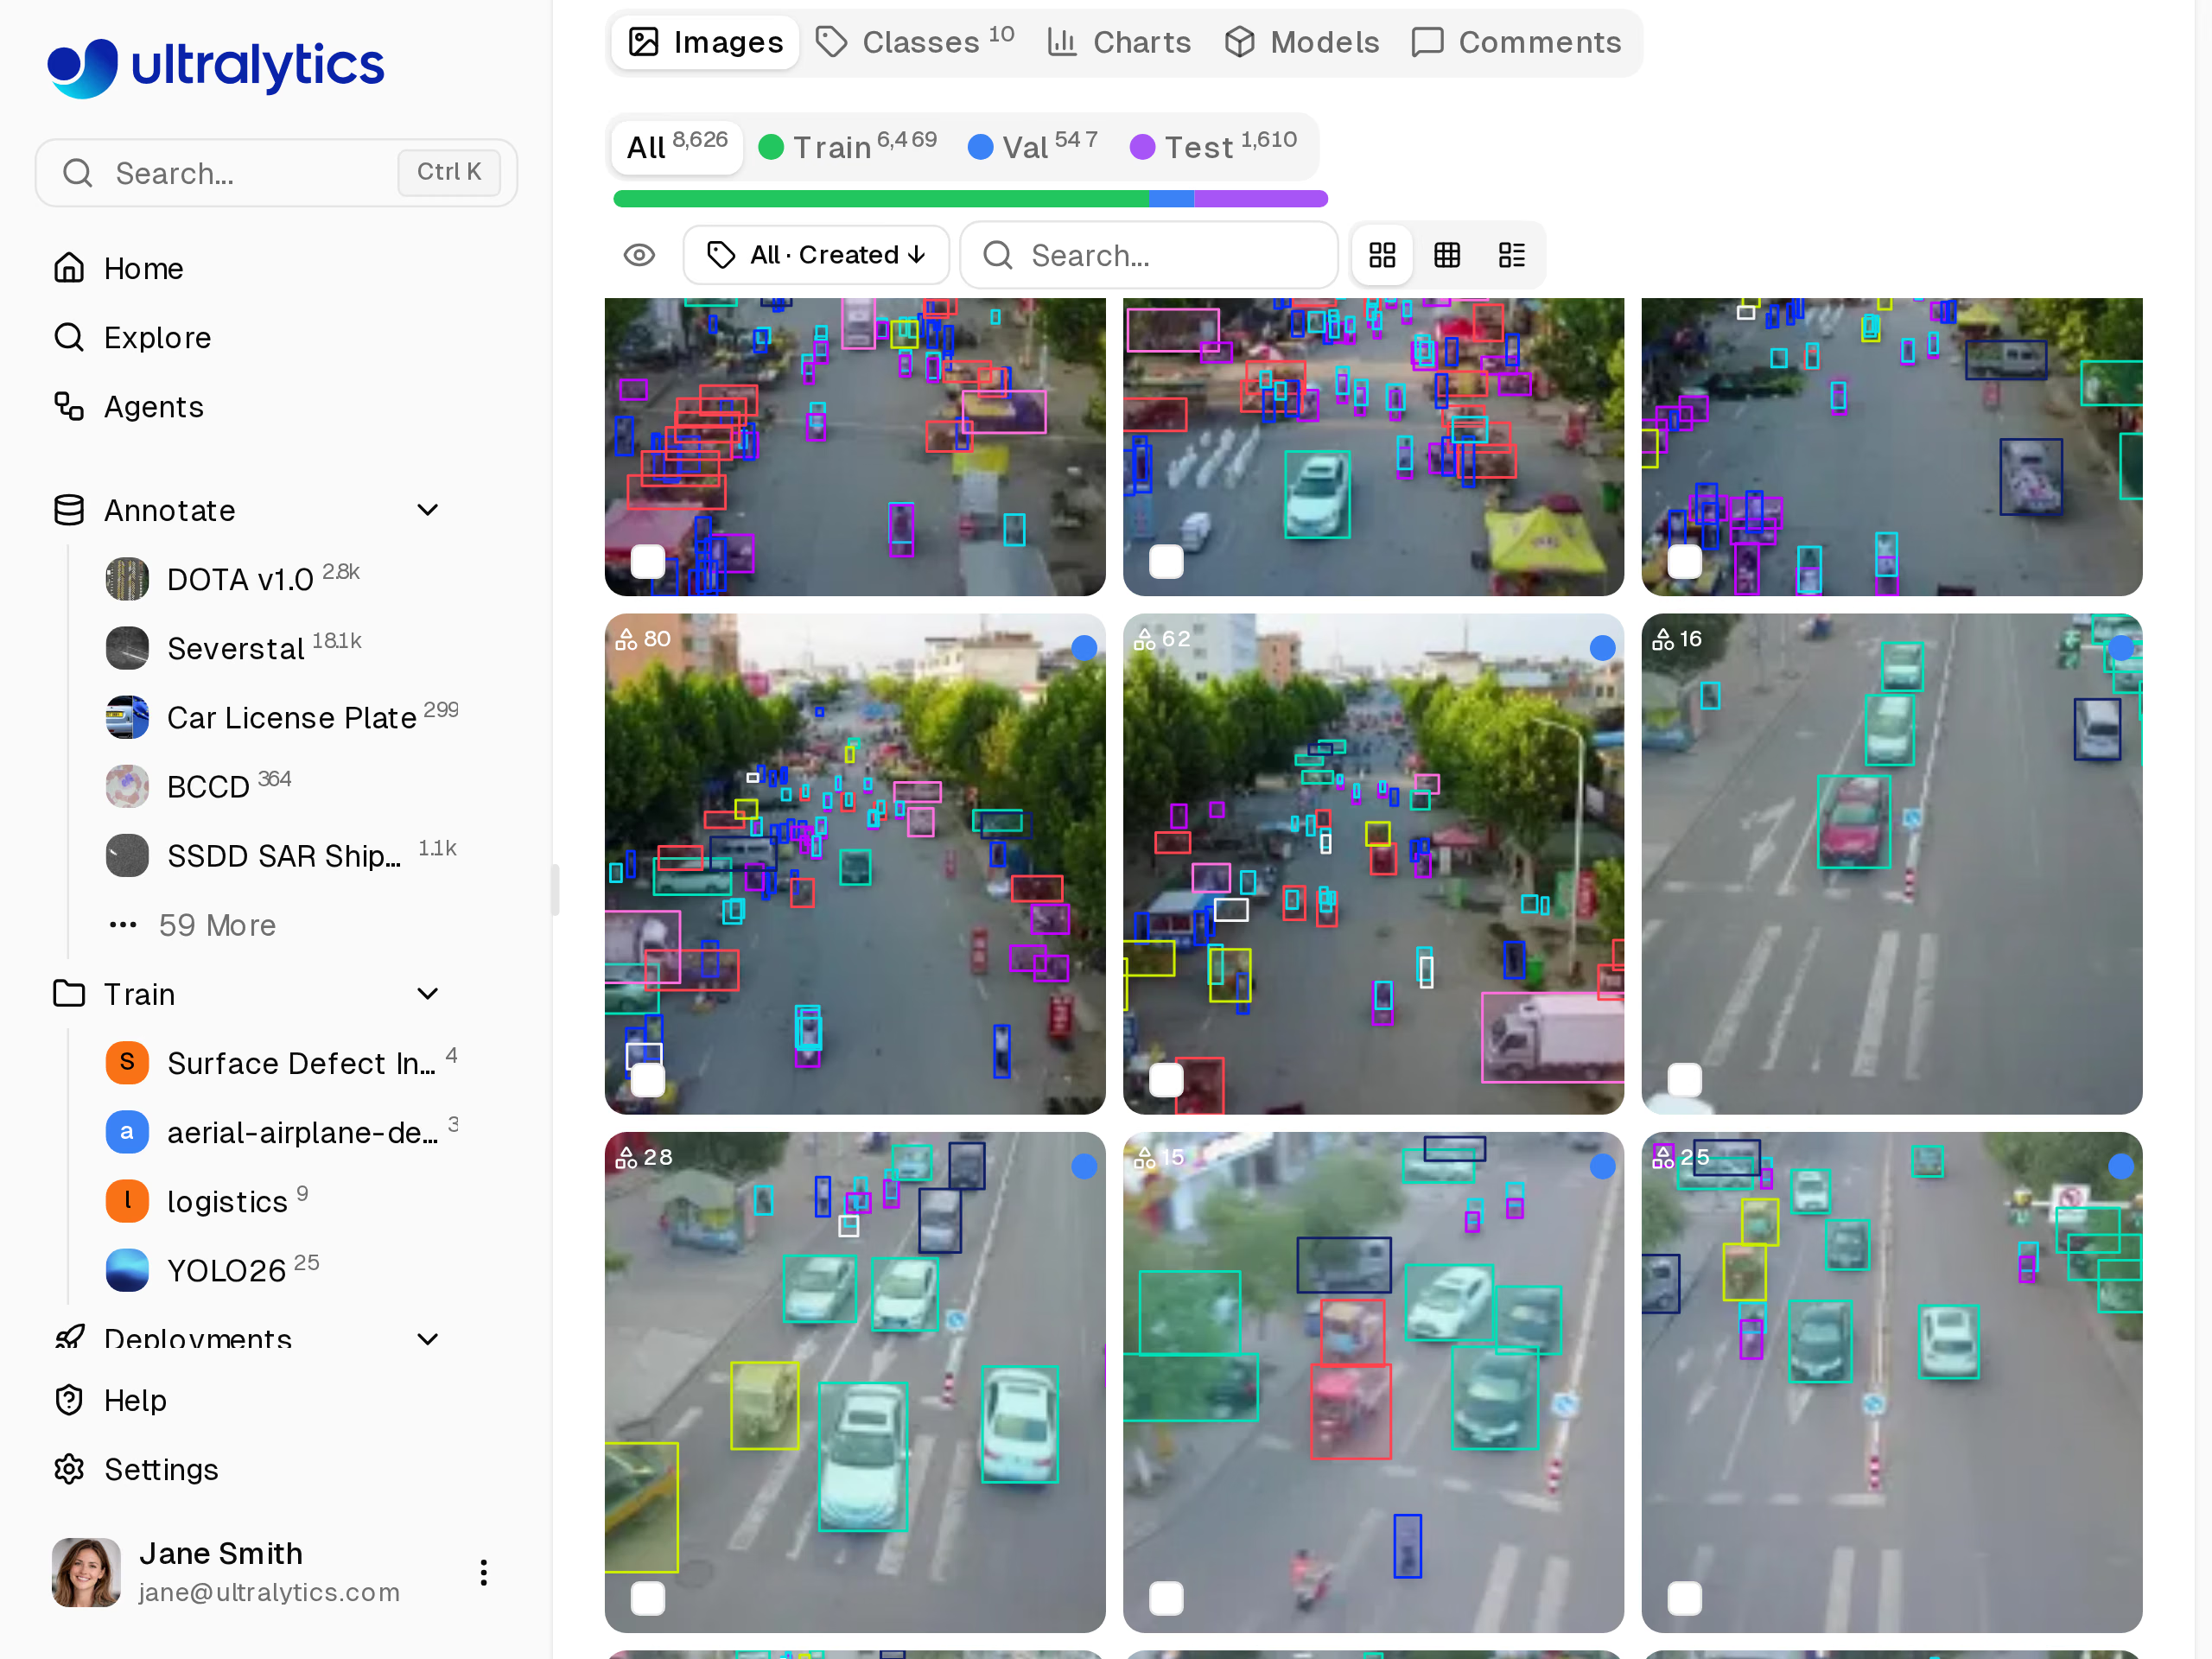
Ultralytics PlatformのVisDroneデータセットは、自分のデータにラベルを付ける前にタイルサイズを試せる、すぐに使えるベンチマークです。
まず公開データでタイルサイズを試すには、Ultralytics PlatformのVisDroneデータセットから始めてください。タイル化した実行をベースラインと並べて記録するには、Platformのトレーニングダイアログからローカルトレーニングコマンドをコピーし、projectにベースラインのPlatformプロジェクトを設定して、tile=Trueを追加し、タイル化した実行のメトリクスを同じプロジェクトに送信します。
新しい--tileフラグを使ったRustでのタイル推論#
Ultralytics Inferenceは、RustクレートおよびCLIです。推論時にPythonランタイムを使わず、エクスポート済みのONNXモデルをONNX Runtime経由で、OpenVINO IRモデルをネイティブに実行します。サーバー、コンテナ、CPU、CUDA、TensorRT、CoreML、OpenVINOなどの実行プロバイダーを使うエッジデバイスを対象としています。バージョン0.0.57では、Pythonと同じタイル化方式が導入されました。基本のウィンドウ重複率は20%で、結果を元画像の座標に戻し、クラスごとに重複を削除します。
イメージ図です。Rustクレートが対象とする、Pythonを使わないデプロイ向けのエッジコンピューター付き路側カメラです。
チームは、ONNX Runtime CPU、OpenVINO CPU、GPU、NPU、CUDA、TensorRTを使い、画像、動画、Webカメラでタイル化した出力をUltralytics Pythonと比較しました。物体検出、セグメンテーション、セマンティックセグメンテーション、深度推定、分類、姿勢推定、OBBの各モデルに対応しています。
CLIでは、ウィンドウサイズを指定して--tileを追加するか、フラグだけを指定して--imgszを使用します。モデルのエクスポートはPythonで一度行うだけで済み、推論自体はRustバイナリだけで実行できます。
# One-time export in Python: a dynamic-batch ONNX model so several windows run per call
pip install -U "ultralytics[export-base]>=8.4.204"
yolo export model=yolo26s.pt format=onnx dynamic=True

# Install the Rust CLI
cargo install ultralytics-inference

# Tiled inference on a large image: 640-pixel windows, 8 per batch
ultralytics-inference predict --model yolo26s.onnx --source aerial.jpg --tile 640 --batch 8ライブラリとして使う場合は、InferenceConfigで一度タイル化を設定すると、すべてのpredict呼び出しでタイル化が適用されます。with_tile(0)では推論サイズを使用します。
use ultralytics_inference::{InferenceConfig, YOLOModel};

fn main() -> Result<(), Box<dyn std::error::Error>> {
    let config = InferenceConfig::new().with_tile(640);
    let mut model = YOLOModel::load_with_config("yolo26s.onnx", config)?;
    let results = model.predict("aerial.jpg")?;
    if let Some(ref boxes) = results[0].boxes {
        println!("{} detections", boxes.len());
    }
    Ok(())
}ウィンドウ間で重複したボックスは、設定した--iouでクラスごとにNMSを適用して削除されます。同じリリース以降のデフォルト値は0.5で、Ultralyticsの予測時のデフォルトと一致します。ウィンドウごとにモデル入力が追加されるため、タイル化はデフォルトで無効です。細部が重要な場合に有効にし、対象デバイスで推論レイテンシを測定して、適切な実行プロバイダーを選択してください。ONNXとTensorRTの比較はNVIDIAハードウェアの選定に役立ち、NVIDIA Jetsonガイドではデバイス上のセットアップを説明しています。
SAHIユーザーは組み込みのtile引数に切り替えられます#
すでにSAHIライブラリで画像をスライスしている場合、組み込み引数を使えば、別のパッケージや異なる結果形式を必要とせず、Ultralytics内で同じ処理を実行できます。SAHI連携ガイドは、現在tileを推奨する形で非推奨になっています。
SAHIのスクリプトから移行する際に必要なのは、ほとんどの場合、引数の変更だけです。
| SAHI | 組み込みのタイル化 |
|---|---|
AutoDetectionModel.from_pretrained(model_type="ultralytics", ...) | YOLO("yolo26s.pt") |
get_sliced_prediction(image, model, slice_height=256, slice_width=256, ...) | model.predict(image, tile=256) |
overlap_height_ratio, overlap_width_ratio | 基本の重複率は20%で固定され、端のウィンドウは画像の境界に合わせて配置されます |
SAHIのPredictionResult | 標準のUltralytics Results |
ウィンドウは正方形です。また、重なりと統合は上記のルールに従い、SAHIで設定可能な後処理とは異なるため、ボックスは同一ではなく類似した結果になります。切り替え後は、検証セットでしきい値を再確認してください。
実用上の違いは統合のしやすさです。tileは同じ引数でUltralyticsの学習、検証、予測、トラッキングに組み込め、標準のResultsオブジェクトを返します。Rustクレートにも対応するオプションがあるため、ノートブックで検証したタイルサイズをエッジ上のRustバイナリでも使えます。
タイル化を有効にするべきユーザー#
モデル入力より数倍大きい画像でUltralytics YOLOを実行しており、検証で小物体の見落としが確認された場合は、タイル化を有効にしてください。対象となるのは、ドローンや衛星画像を扱うチーム、広角カメラを使う交通・監視システムのインテグレーター、基板、パネル、棚全体を撮影する検査チームです。RustユーザーはPythonランタイムなしで、エッジハードウェア上でも同じタイル化方式を利用できます。
物体がフレームに対して大きい場合、より大きなimgszで1回の処理ですでに検出できる場合、または1フレームあたり複数のタイル入力を処理する余裕がレイテンシ予算にない場合は、タイル化を無効にしてください。いずれの場合も、同じ検証データ分割と信頼度しきい値を使い、タイル化と画像全体の結果を比較して、再現率、誤検出、レイテンシを確認してください。追加の処理量に見合う効果がある場合にのみ、タイル化を使用します。
Ultralytics Platformなら、比較結果を1か所で管理できます。高解像度の独自画像にラベルを付けるかVisDroneを使い、クラウドGPUで画像全体を使ったベースラインを学習し、さらに大きなimgszでもう1つのベースラインを学習します。その後、自分のマシンからタイル化した実行を同じプロジェクトに記録します。高解像度タイル化ガイドではタイル化のオプションを、Ultralytics InferenceのドキュメントではRustによるデプロイを説明しています。
PythonパッケージとRustクレートは、どちらもAGPL-3.0ライセンスで提供されています。クローズドソース製品や顧客に出荷するエッジデバイスにタイル化検出を組み込む場合、Ultralytics Enterprise Licenseを利用すると、規約に従い、対象のUltralyticsソフトウェアをAGPL-3.0のソースコード開示要件なしで商用利用できます。
よくある質問
画像タイル化では、大きな画像を重なり合うウィンドウに分割し、各ウィンドウで検出器を実行して、ボックスを元画像上で統合します。ウィンドウサイズをモデルの入力サイズに合わせると、画像全体をリサイズした場合に失われるピクセルを小物体について保持できます。Ultralytics YOLOでは、
tile引数を使って基本の重複率20%でタイル化し、画像ごとに1つの結果を返します。まず、問題がリサイズにあるか確認します。
imgsz=640で物体が数ピクセルに縮小される場合は、より大きなimgszまたはtile=Trueを試してください。モデルがデプロイ時と同じスケールで物体を学習できるよう、予測時と同じ設定で学習し、サイズ別・クラス別に検証します。タイル化は、モデル入力より数倍大きい画像に適しています。ウィンドウごとにモデル入力が1つ追加されます。
tile=640で1920 x 1080のフレームを処理すると、画像1枚ではなく8個のタイル入力が生成されます。複数のタイルを1回のバッチ呼び出しで実行すると、スループットが向上する場合があります。Pythonではbatchを、Rustでは動的バッチのエクスポートとともに--batchを使用できます。対象ハードウェアでレイテンシを測定してください。いいえ。Ultralytics 8.4.204以降、組み込みの
tile引数で追加パッケージなしにスライス推論を実行でき、学習、検証、トラッキングもタイル化できます。ドキュメントのSAHIガイドは、tileを推奨する形で非推奨になっています。はい。Pythonでは、エクスポート済みモデルは通常の入力グラフを維持し、通常どおり
tileをpredictに渡します。RustではUltralytics Inference 0.0.57で、CLIに--tileが、InferenceConfigにwith_tileが追加されました。ONNX Runtime CPU、OpenVINO、CUDA、TensorRTでPythonとの比較検証を行っています。tile=Trueから始めます。この設定では、imgszをウィンドウサイズとして使用します。ネイティブ解像度でも物体の幅が数ピクセルしかない場合は、tile=400とimgsz=640のように、より小さなウィンドウを使用します。物体がタイル境界で切れる恐れがある場合は、より大きなウィンドウを使用します。検証セットでいくつかのサイズを比較し、再現率と誤検出の両方を確認してください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









