OCR на Python с Ultralytics YOLO26: читай документы, фотографии и PDF под любым углом
Читай текст на изображениях и страницах PDF под любым углом с помощью Ultralytics YOLO26-Text и PP-OCRv6 — всего в несколько строк Python, на CPU или GPU, с поддержкой TensorRT.
 Jing Qiu13 мин. чтения
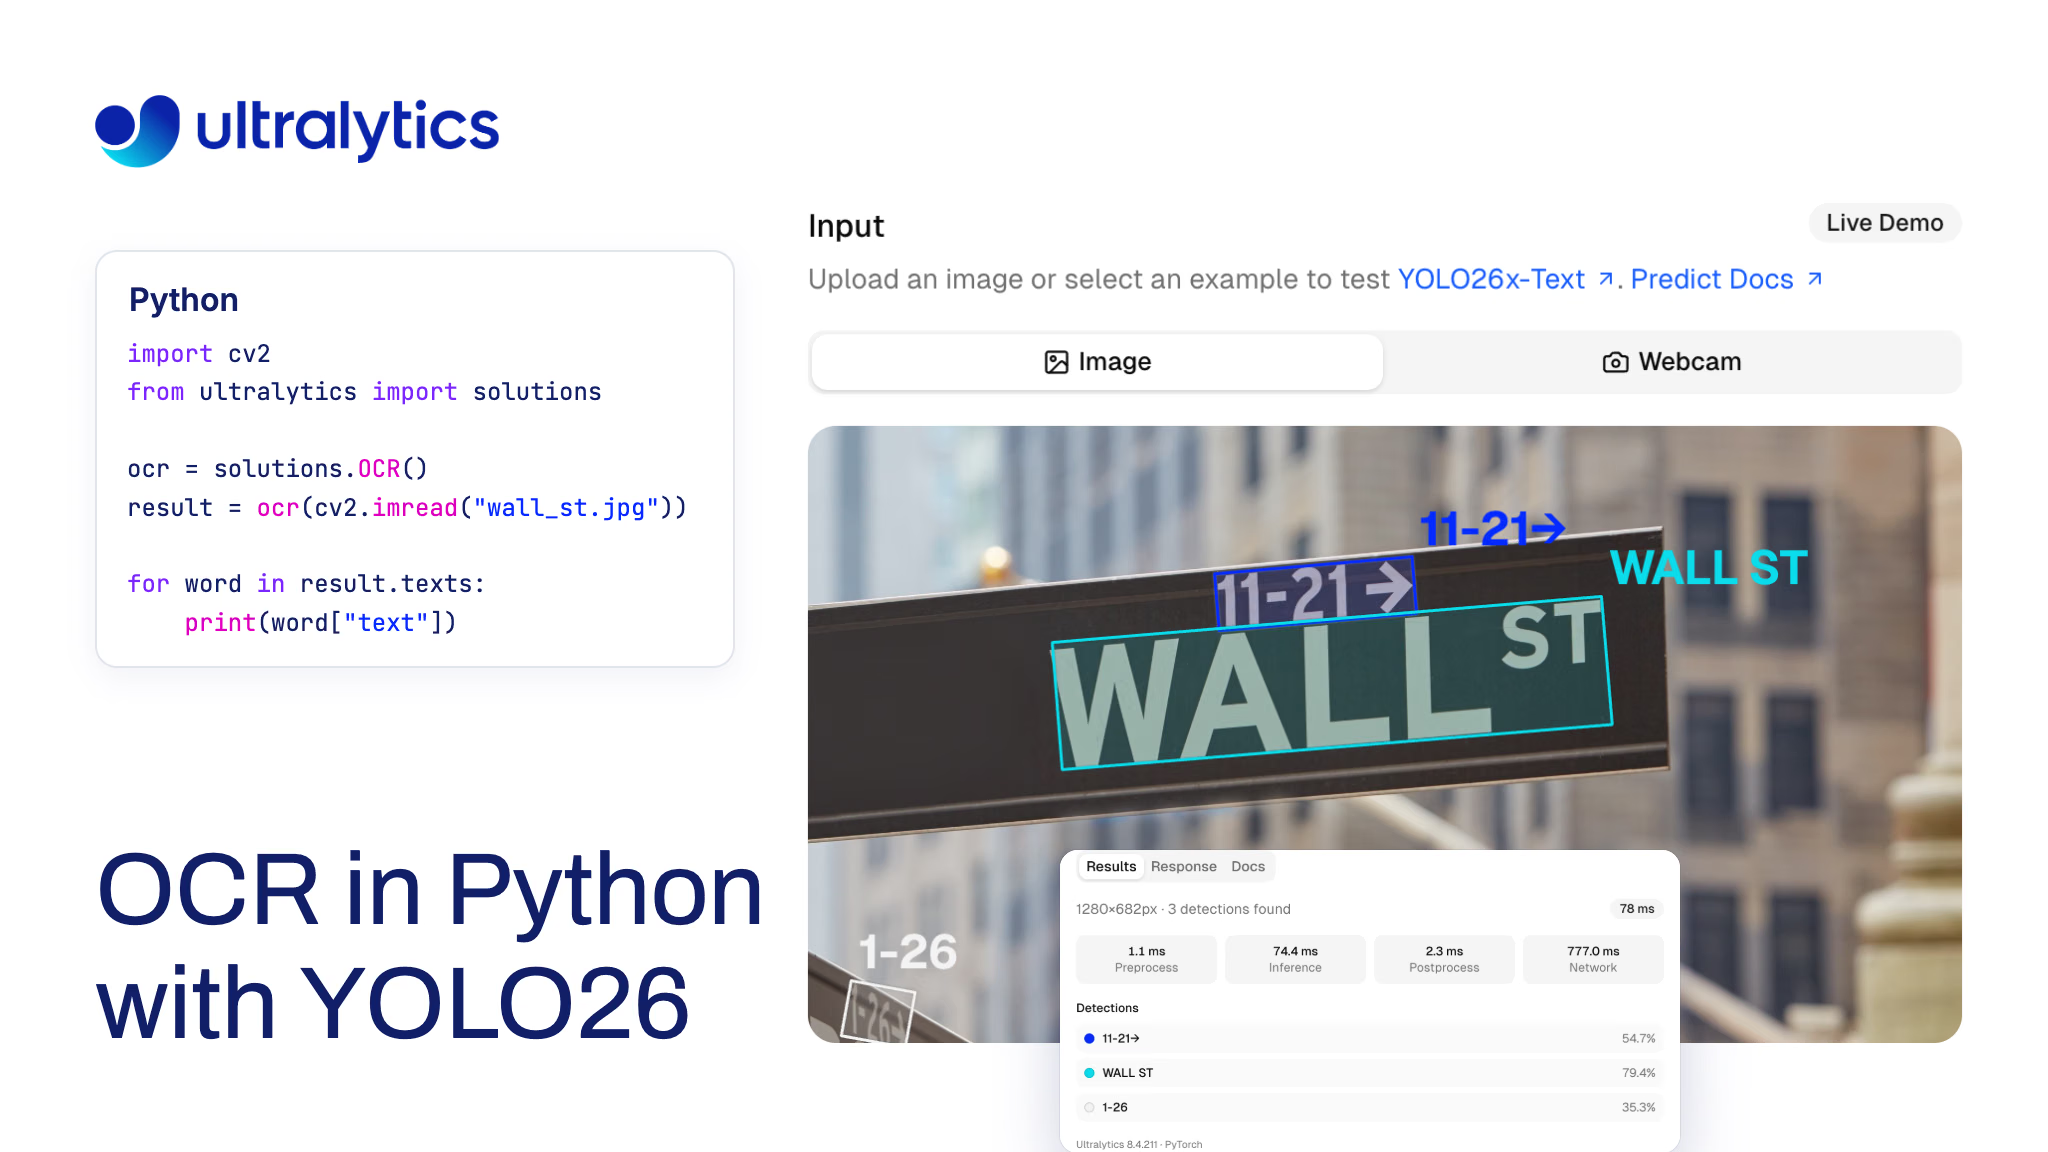
Как выполнить OCR на Python для повернутого скана, фотографии вывески с телефона или страницы PDF и получить слова в том порядке, в котором их прочитал бы человек? С пакетом Ultralytics для этого нужен один класс: solutions.OCR() обнаруживает текст с помощью модели YOLO26-Text от Ultralytics, распознаёт каждое слово с помощью распознавателя PP-OCRv6 из PaddleOCR и возвращает распознанные слова построчно при любом повороте страницы, на CPU или GPU.
Этот конвейер появился недавно. Ultralytics 8.4.210 перестроил OCR-решение на базе PP-OCRv6 и ONNX Runtime, добавив обработку поворота и порядка чтения, а в 8.4.211 появился дополнительный распознаватель TensorRT. В нашем тестировании при размере изображения 1280 стандартная конфигурация набрала F1 по словам 0.931 на шести страницах PDF и 0.722 на 80 фотографиях HierText. На RTX PRO 6000 движок TensorRT FP16 с кэшированием распознал 251 слово, обнаруженное на одной фотографии, за 82 мс против 249 мс с ONNX Runtime на CUDA.
В этом руководстве рассказывается, как работает конвейер, как запускать его на изображениях и PDF, какова его скорость и какие языки он распознаёт на данный момент. Ultralytics разрабатывает один из сравниваемых ниже вариантов OCR, поэтому сравнение опирается на задокументированные возможности каждого проекта.
YOLO26 OCR распознаёт страницу в два этапа, а затем упорядочивает слова#
У оптического распознавания символов (OCR) две задачи: найти текст, а затем прочитать его. Решение Ultralytics для OCR чётко разделяет эти задачи:
- Обнаружение: модель YOLO26-Text — детектор ориентированных ограничивающих рамок — обводит текст повёрнутыми рамками. Доступны размеры n, s, m, l и x; по умолчанию используется модель x.
- Распознавание: модель PP-OCRv6 medium читает каждый фрагмент. Она работает на базе ONNX Runtime, включённого в выпуск ресурсов Ultralytics, поэтому устанавливать PaddlePaddle не нужно. Фрагменты, в которых ничего не удалось распознать, отбрасываются.
- Упорядочивание: слова объединяются в строки и возвращаются сверху вниз и слева направо; каждому слову присваивается номер строки.
Каждое слово возвращается в виде записи с текстом, оценкой уверенности распознавания, оценкой уверенности детектора, номером строки и полигоном в координатах исходного изображения. Поскольку две оценки уверенности хранятся отдельно, слово, которое было обнаружено с высокой уверенностью, но распознано с низкой, можно отправить на проверку человеку, а не полагаться на него.
Эти два этапа остаются независимыми. Ты можешь заменить детектор на более компактный, использовать собственную модель обнаружения или сегментации либо другой распознаватель — обработка поворота и порядок чтения продолжат работать. До установки чего-либо ты можешь опробовать тот же код в браузере на нашей странице обработки документов.
Поворот и переворот страниц не мешают читать их в правильном порядке#
Решение определяет поворот страницы по обнаруженному тексту, поэтому предварительно выравнивать или поворачивать страницы не нужно:
- Определи направление текста. Вычисляется средний угол длинной стороны обнаруженных рамок с весом, зависящим от их вытянутости. Рамки с соотношением сторон меньше 2:1, например с одиночными цифрами, не учитываются.
- Поверни страницу. Страница поворачивается так, чтобы текст шёл слева направо; затем каждое слово обрезается в правильной ориентации, а слова объединяются в строки.
- Определи, где 0°, а где 180°. По рамке нельзя понять, в какую сторону ориентирован текст, поэтому решение читает 8 самых широких слов в обоих направлениях и выбирает поворот с более высокой уверенностью распознавания. Перевёрнутый текст распознаётся как шум с низкой уверенностью, поэтому правильный вариант выделяется.
Мы поворачивали 8 документов и снимков экрана, а также 12 фотографий на 90°, 180° и 270°: F1 по словам составил 0.925 для документов и 0.654 для фотографий. На пустой форме IRS Form 8802 решение распознало 404, 401 и 399 слов при повороте на 0°, 180° и 90° соответственно, причём первые строки совпали. В предыдущей версии предполагалось, что все страницы ориентированы правильно.
Параметры по умолчанию выбраны по результатам тестирования, а не наугад#
Мы выбрали основные значения по умолчанию на основе измерений. Тестирование проходило на RTX PRO 6000 с рабочим образом Platform; изображения загружались в формате JPEG, причём длинная сторона составляла не более 1280 пикселей. Использовались 80 валидационных фотографий из набора данных HierText Google с транскрипциями разборчивых слов, 6 страниц PDF, оценённых по текстовым слоям (4 страницы из статьи arXiv, а также пустые формы IRS 1040 и 8802), синтетический снимок экрана и синтетическое изображение. Метрика — оценка F1 на уровне слов, баланс точности и полноты; учитывались слова в нижнем регистре длиной не менее 2 буквенно-цифровых символов.
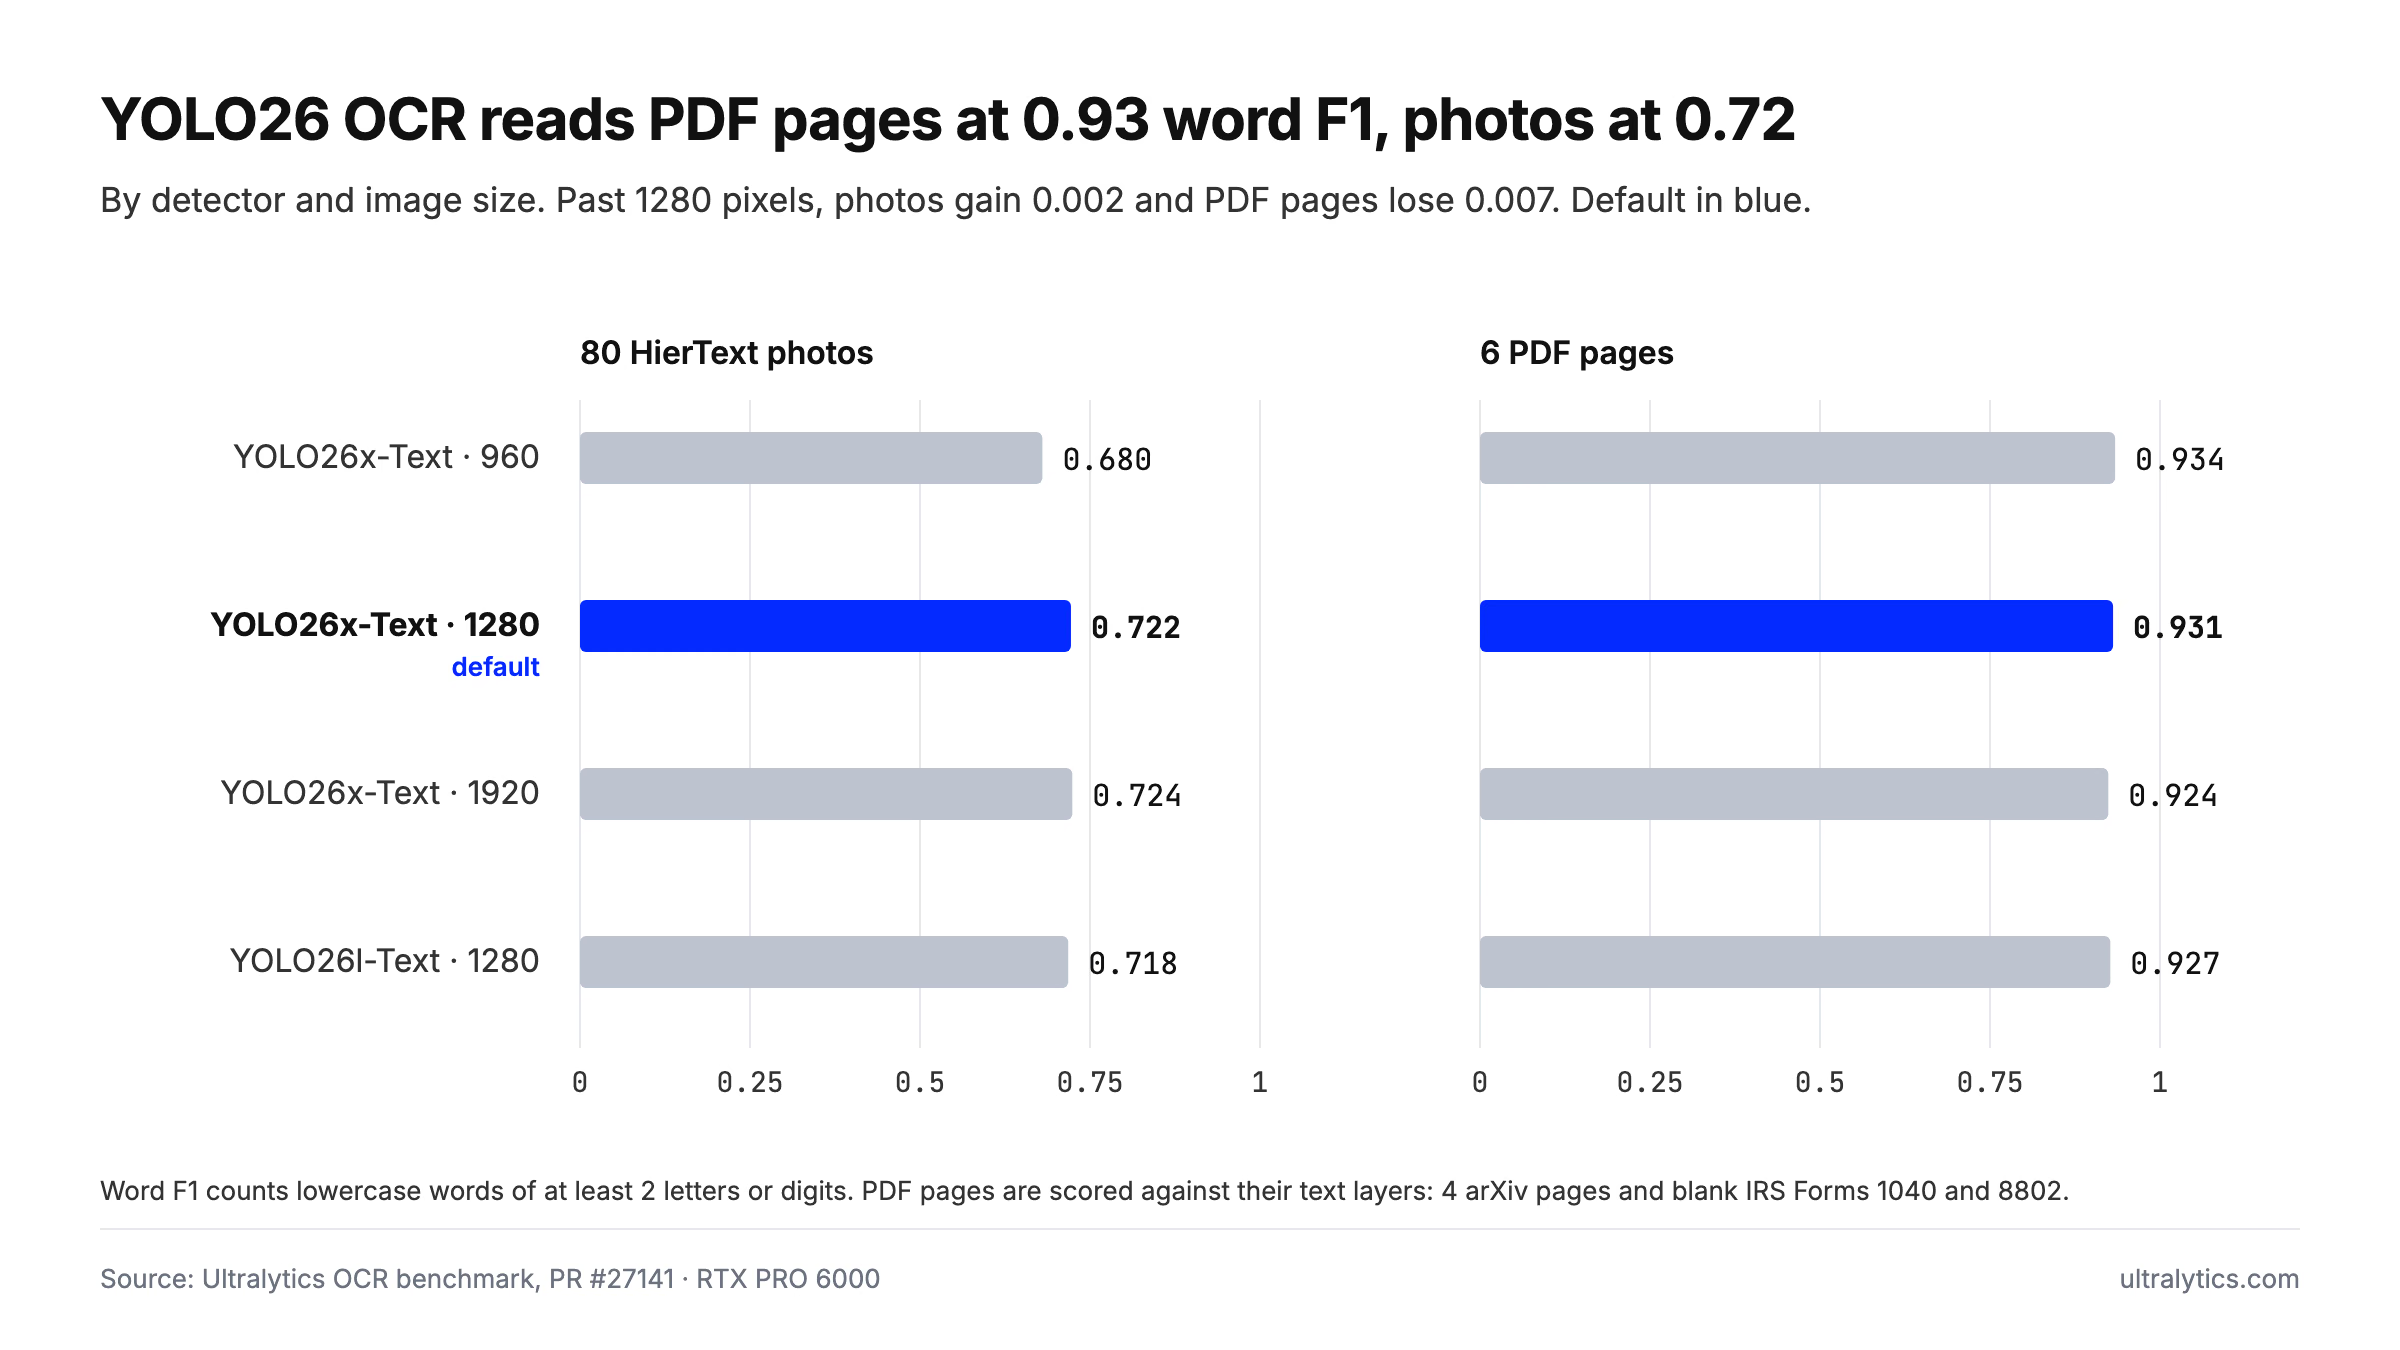
F1 по словам для YOLO26-Text с PP-OCRv6 на 80 фотографиях HierText и 6 страницах PDF в зависимости от детектора и размера изображения; тестирование проводилось на RTX PRO 6000.
При любых настройках чистые страницы PDF распознаются гораздо лучше, чем фотографии текста в естественной среде; из результатов следуют три значения по умолчанию:
yolo26x-textприimgsz=1280. Переход на 960 снизил F1 на фотографиях на 0.042, а 1920 прибавил на фотографиях 0.002 и снизил F1 на страницах PDF на 0.007. Изображения меньше 1280 не увеличиваются: они обрабатываются в исходном размере, округлённом вверх до шага модели в 32 пикселя.- Распознавай по одному слову. Распознавание отдельных слов дало на фотографиях результат на 4 пункта F1 выше, чем распознавание целых строк.
max_det=1000. На плотной странице документа помещается больше стандартных 300 обнаружений.
Если нужен более лёгкий детектор, YOLO26l-Text уступает модели x менее чем на полпункта на обоих наборах.
Как запускать OCR на Python с YOLO26#
Установи или обнови пакет командой pip install -U "ultralytics>=8.4.211". При первом вызове OCR загружаются YOLO26x-Text и PP-OCRv6 и устанавливается ONNX Runtime; если доступна CUDA, используется onnxruntime-gpu. Для стандартного распознавателя ONNX Runtime нужны Python 3.11+ и ONNX Runtime 1.26+.
Распознавание изображения#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text при imgsz=1280 с PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # изображение с аннотациями

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
Из командной строки yolo solutions ocr source="path/to/video.mp4" выполняет ту же операцию для каждого кадра. Каждый кадр обрабатывается независимо, без трекинга.
Распознавание PDF#
Решение принимает изображения, поэтому сначала преобразуй каждую страницу PDF в изображение. Для этого можно использовать PyMuPDF:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # уже в порядке чтения
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
Поскольку result.texts уже отсортирован, восстановить обычный текст можно с помощью словаря и объединения строк. Полигоны позволяют сделать больше — например, проверить, что сумма расположена рядом со словом "Total".
Выбор модели, устройства и распознавателя#
- Компактный детектор:
solutions.OCR(model="yolo26s-text.pt")загружает более компактный и быстрый детектор; проверь его точность на собственных страницах. Все пять вариантов размера загружаются автоматически. - CPU или GPU: распознаватель работает на CUDA, если выбрана CUDA GPU и доступен провайдер CUDA для ONNX Runtime, а в противном случае — на CPU. Поэтому один и тот же скрипт запускается и на ноутбуке, и на сервере.
- Собственный распознаватель: передай функцию как
recognizer. Она получает фрагмент слова в BGR и возвращает(text, confidence); решение продолжает выполнять обнаружение, поворот и упорядочивание.
def recognize(crop):
    # Запусти любую модель распознавания на фрагменте слова в BGR
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
TensorRT распознаёт слова в плотных фотографиях в 2,5–3 раза быстрее#
В наших тестах на GPU с плотными страницами большую часть времени занимало распознавание, а не обнаружение. В предыдущей оптимизации измерили, что обнаружение занимает около 11 мс из 250 мс запроса, а в запросе на добавление TensorRT выяснили, что значительная часть оставшегося времени распознавания приходится на 33 небольших пакета, где основная задержка вызвана запуском, а не вычислениями. В Ultralytics 8.4.211 для этого добавили один аргумент:
ocr = solutions.OCR(recognizer="tensorrt") # Движок TensorRT FP16 на GPU NVIDIAПри первом запуске примерно за 30 секунд создаётся движок TensorRT FP16 и кэшируется рядом с моделью PP-OCRv6 — отдельно для каждой версии TensorRT и архитектуры GPU. При последующих загрузках уходит 0,05–0,2 секунды. Согласно данным выпуска, на плотных страницах он работает примерно в 2,5 раза быстрее ONNX Runtime.
Мы замерили время работы read_words — этапа после обнаружения, который обрезает и поворачивает фрагменты, распознаёт и упорядочивает слова, — на четырёх фотографиях текста в естественной среде. На трёх фотографиях с 195–263 словами движок FP16 оказался в 2,5–3 раза быстрее ONNX Runtime на CUDA; на фотографии с 48 словами — в 1,4 раза быстрее:
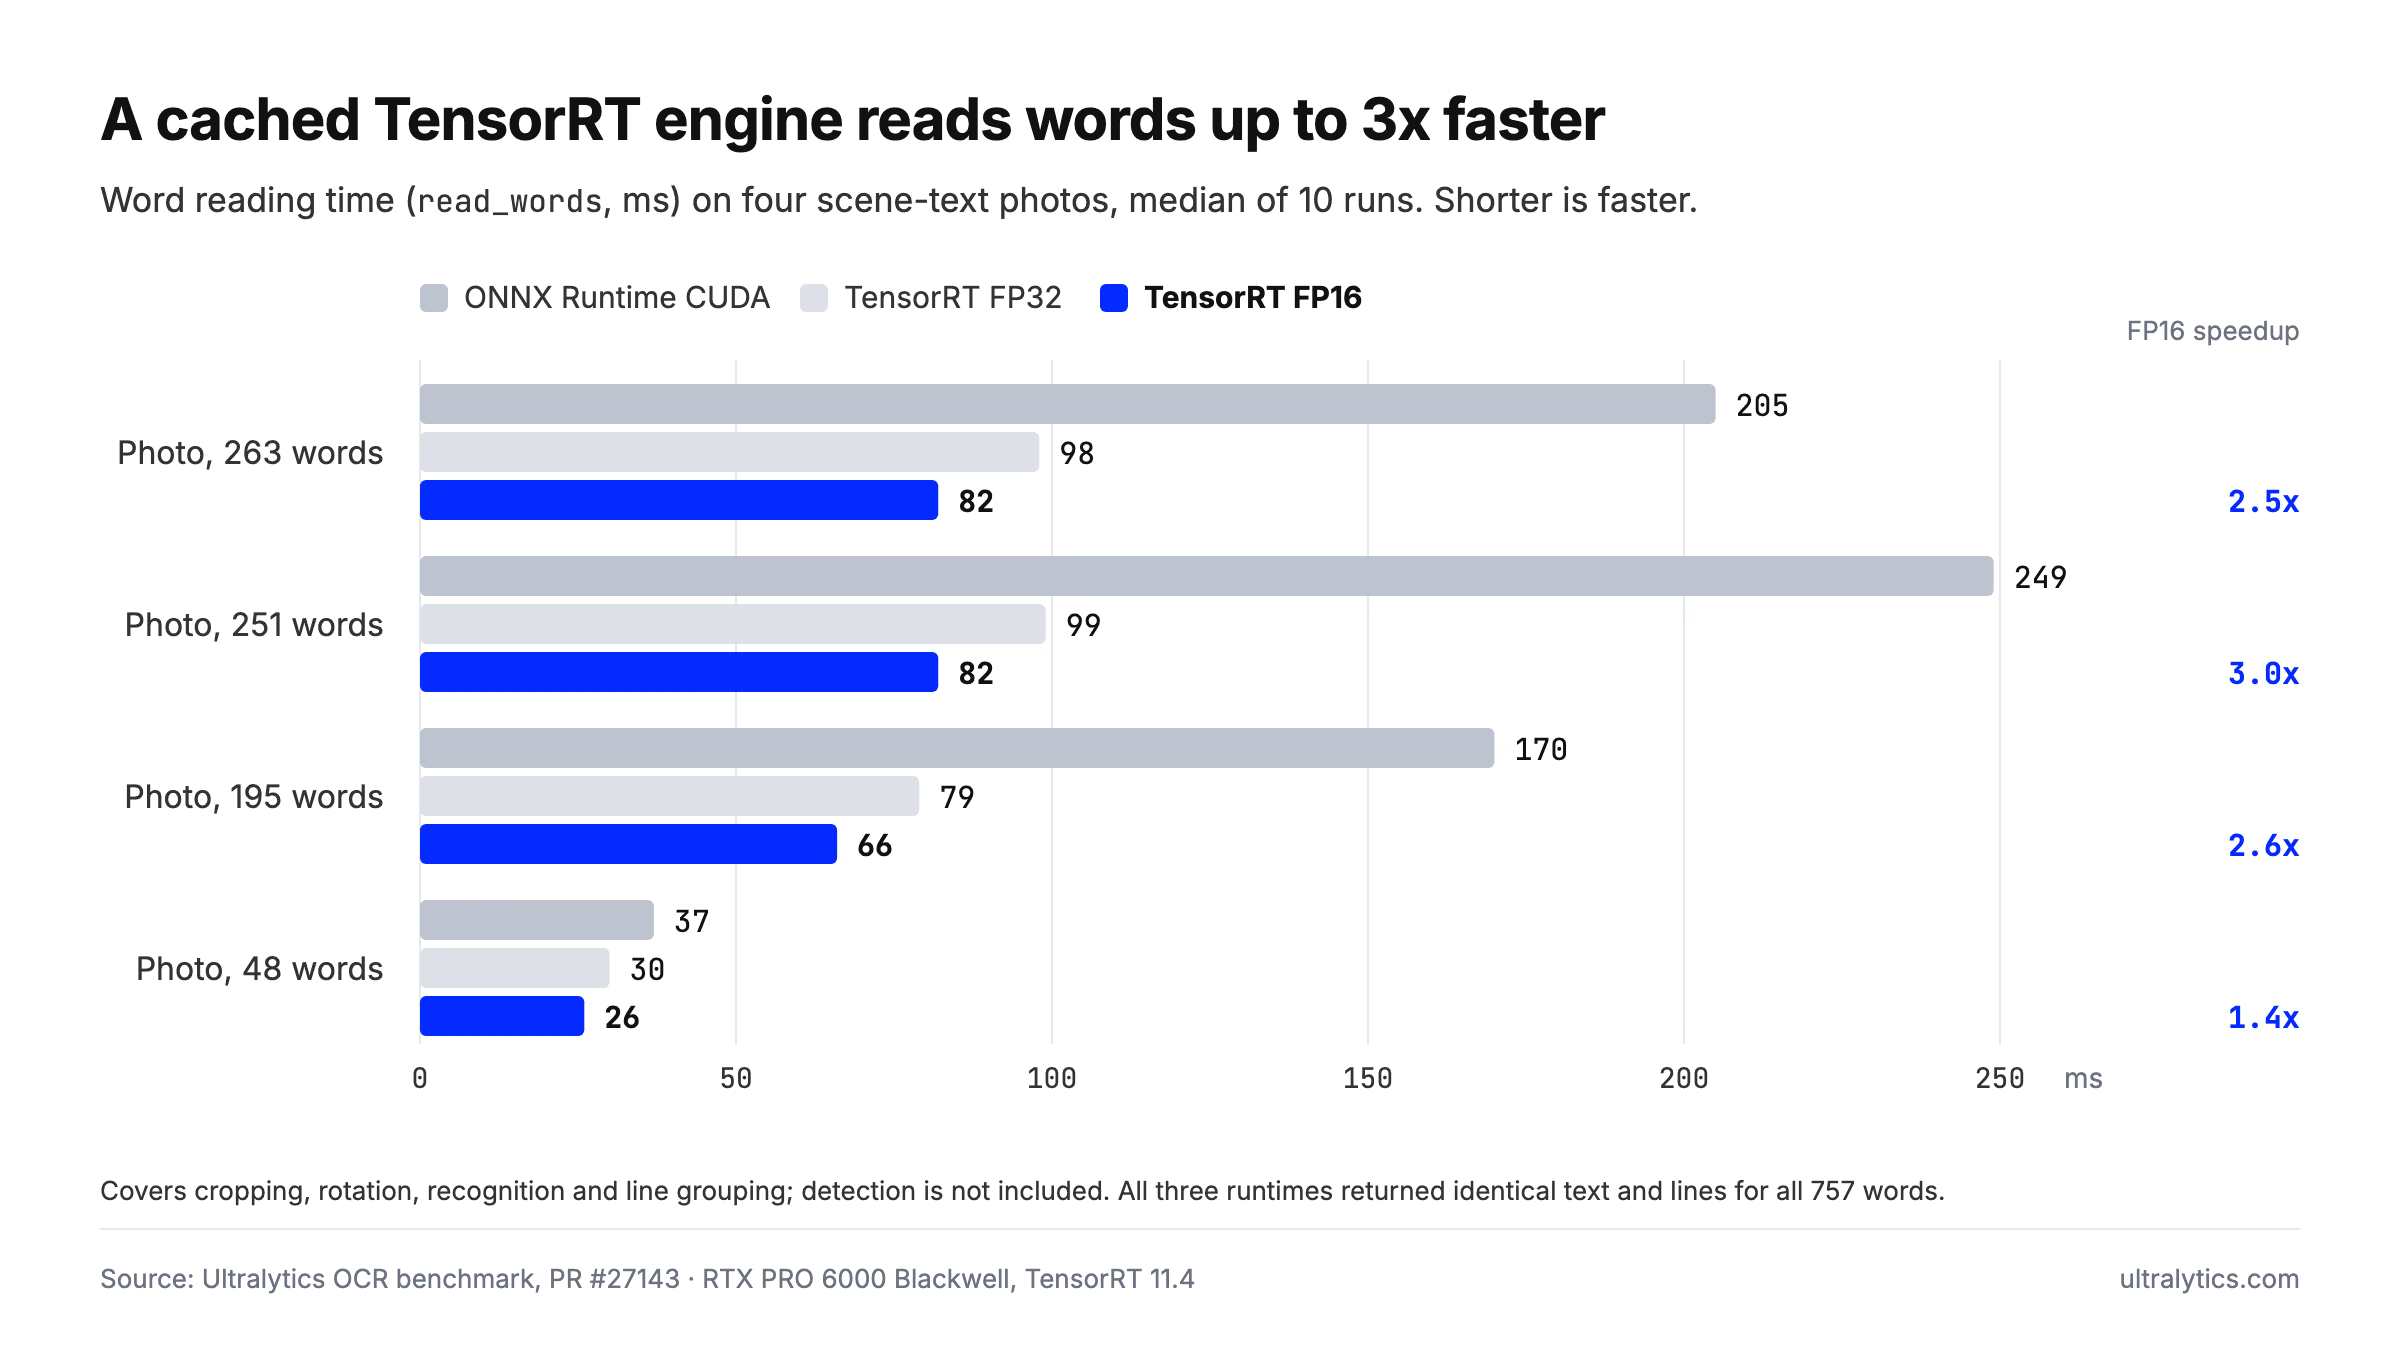
Время распознавания слов на четырёх фотографиях текста в естественной среде с ONNX Runtime CUDA и движками TensorRT FP32 и FP16; медиана 10 запусков на RTX PRO 6000 Blackwell с TensorRT 11.4.
Полный вызов OCR для плотной страницы стал выполняться за 94 мс вместо 182 мс. На этих четырёх фотографиях ускорение не повлияло на результат: для всех 757 слов ONNX Runtime и оба движка вернули одинаковый текст и одинаковое разбиение на строки.
Оставь стандартный recognizer="paddleocr", если не можешь ждать первой сборки или используешь не оборудование NVIDIA. Он ничего не собирает и запускается примерно за секунду. В нашем сравнении ONNX и TensorRT рассмотрен такой же компромисс для моделей обнаружения, а в руководстве по интеграции TensorRT описана настройка.
Поддерживаются китайская, японская и латинская письменности#
PP-OCRv6 может выдавать только символы из встроенного набора, состоящего из 18 708 символов. Детектор YOLO26-Text не зависит от этого набора и по-прежнему находит слова на других письменностях, но слова с символами вне набора распознаются как похожие на них символы. Например, русское слово ТЕКСТ распознаётся как "TEKCT", часто с высокой уверенностью.
- Поддерживаются: упрощённый и традиционный китайский (около 15 600 иероглифов CJK), японский (хирагана, катакана и кандзи), а также языки с латинской письменностью, включая английский, французский, немецкий, испанский, португальский, итальянский, нидерландский, шведский, финский, датский, норвежский, польский, чешский, венгерский, румынский, турецкий, хорватский, индонезийский и малайский. Поддерживаются все буквы, в том числе с диакритическими знаками, кроме заглавной немецкой ẞ и испанского ¡.
- Частичная поддержка: вьетнамский — отсутствует большинство гласных с диакритикой; греческий — поддерживаются только основные буквы.
- Пока не поддерживаются: кириллица, корейский (хангыль), арабский, иврит, деванагари и тайский.
Для неподдерживаемой письменности оставь детектор YOLO26-Text и передай распознаватель, обученный для этой письменности, через recognizer. Полная таблица поддержки приведена в разделе о поддерживаемых языках руководства по OCR.
Сравнение библиотек OCR для Python по задокументированным возможностям#
Не существует единственной лучшей модели OCR: выбор зависит от твоих страниц, языков и среды запуска кода. В таблице сравниваются задокументированные возможности, а не результаты измерений; данные взяты с общедоступных страниц каждого проекта по состоянию на 12 ноября 2026 года. Варианты перечислены в алфавитном порядке.
| Решение | Среда выполнения | Поворот текста | Задокументированные языки | Результат |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info проверяет повороты 90°, 180° и 270° для каждого блока текста | Более 80, включая кириллицу, арабский, деванагари, корейский и тайский | Рамки, текст и оценка уверенности |
| PaddleOCR | PaddlePaddle | Дополнительная классификация ориентации | Более 100 (PP-OCRv6 поддерживает 50 в одной модели) | Рамки, текст и оценка уверенности |
| Tesseract (pytesseract) | Нативный бинарный файл, CPU | Определение ориентации и письменности (image_to_osd); перед распознаванием изображение нужно повернуть | 100+ | Текст и необязательные данные о словах |
| Ultralytics YOLO26 OCR | Детектор на PyTorch; распознаватель на ONNX Runtime или TensorRT на GPU NVIDIA | Поворот страницы оценивается по обнаруженному тексту; ориентация 0° или 180° определяется автоматически | Китайская, японская и латинская письменности; для остальных нужен пользовательский распознаватель | Слова в порядке чтения с номерами строк, полигонами и отдельными оценками уверенности обнаружения и распознавания |
Актуальные возможности можно проверить в документации EasyOCR, репозитории PaddleOCR, документации Tesseract и pytesseract. Чтобы узнать, как работают эти движки, прочитай наш обзор популярных моделей OCR с открытым исходным кодом.
Какую роль играет Ultralytics#
Ultralytics YOLO26 OCR создан для разработчиков Python, которым нужно извлекать текст из разных источников, например отсканированных форм, страниц PDF, снимков экрана и фотографий этикеток и вывесок, получая слова в порядке чтения вместе с координатами для проверки. Решение подойдёт, если страницы поступают под непредсказуемыми углами, если ты хочешь запускать OCR на собственных машинах или уже используешь модели Ultralytics YOLO26 и хочешь добавить OCR в тот же пакет. Для обработки больших объёмов на GPU NVIDIA добавь recognizer="tensorrt".
Детектор — обычная модель Ultralytics, поэтому он обучается, проходит валидацию и экспортируется так же, как любая другая модель. В проекте YOLO26-Text на Ultralytics Platform доступны все пять вариантов размера — от n до x; там можно сравнить кривые обучения и клонировать проект, чтобы начать с готовой модели.
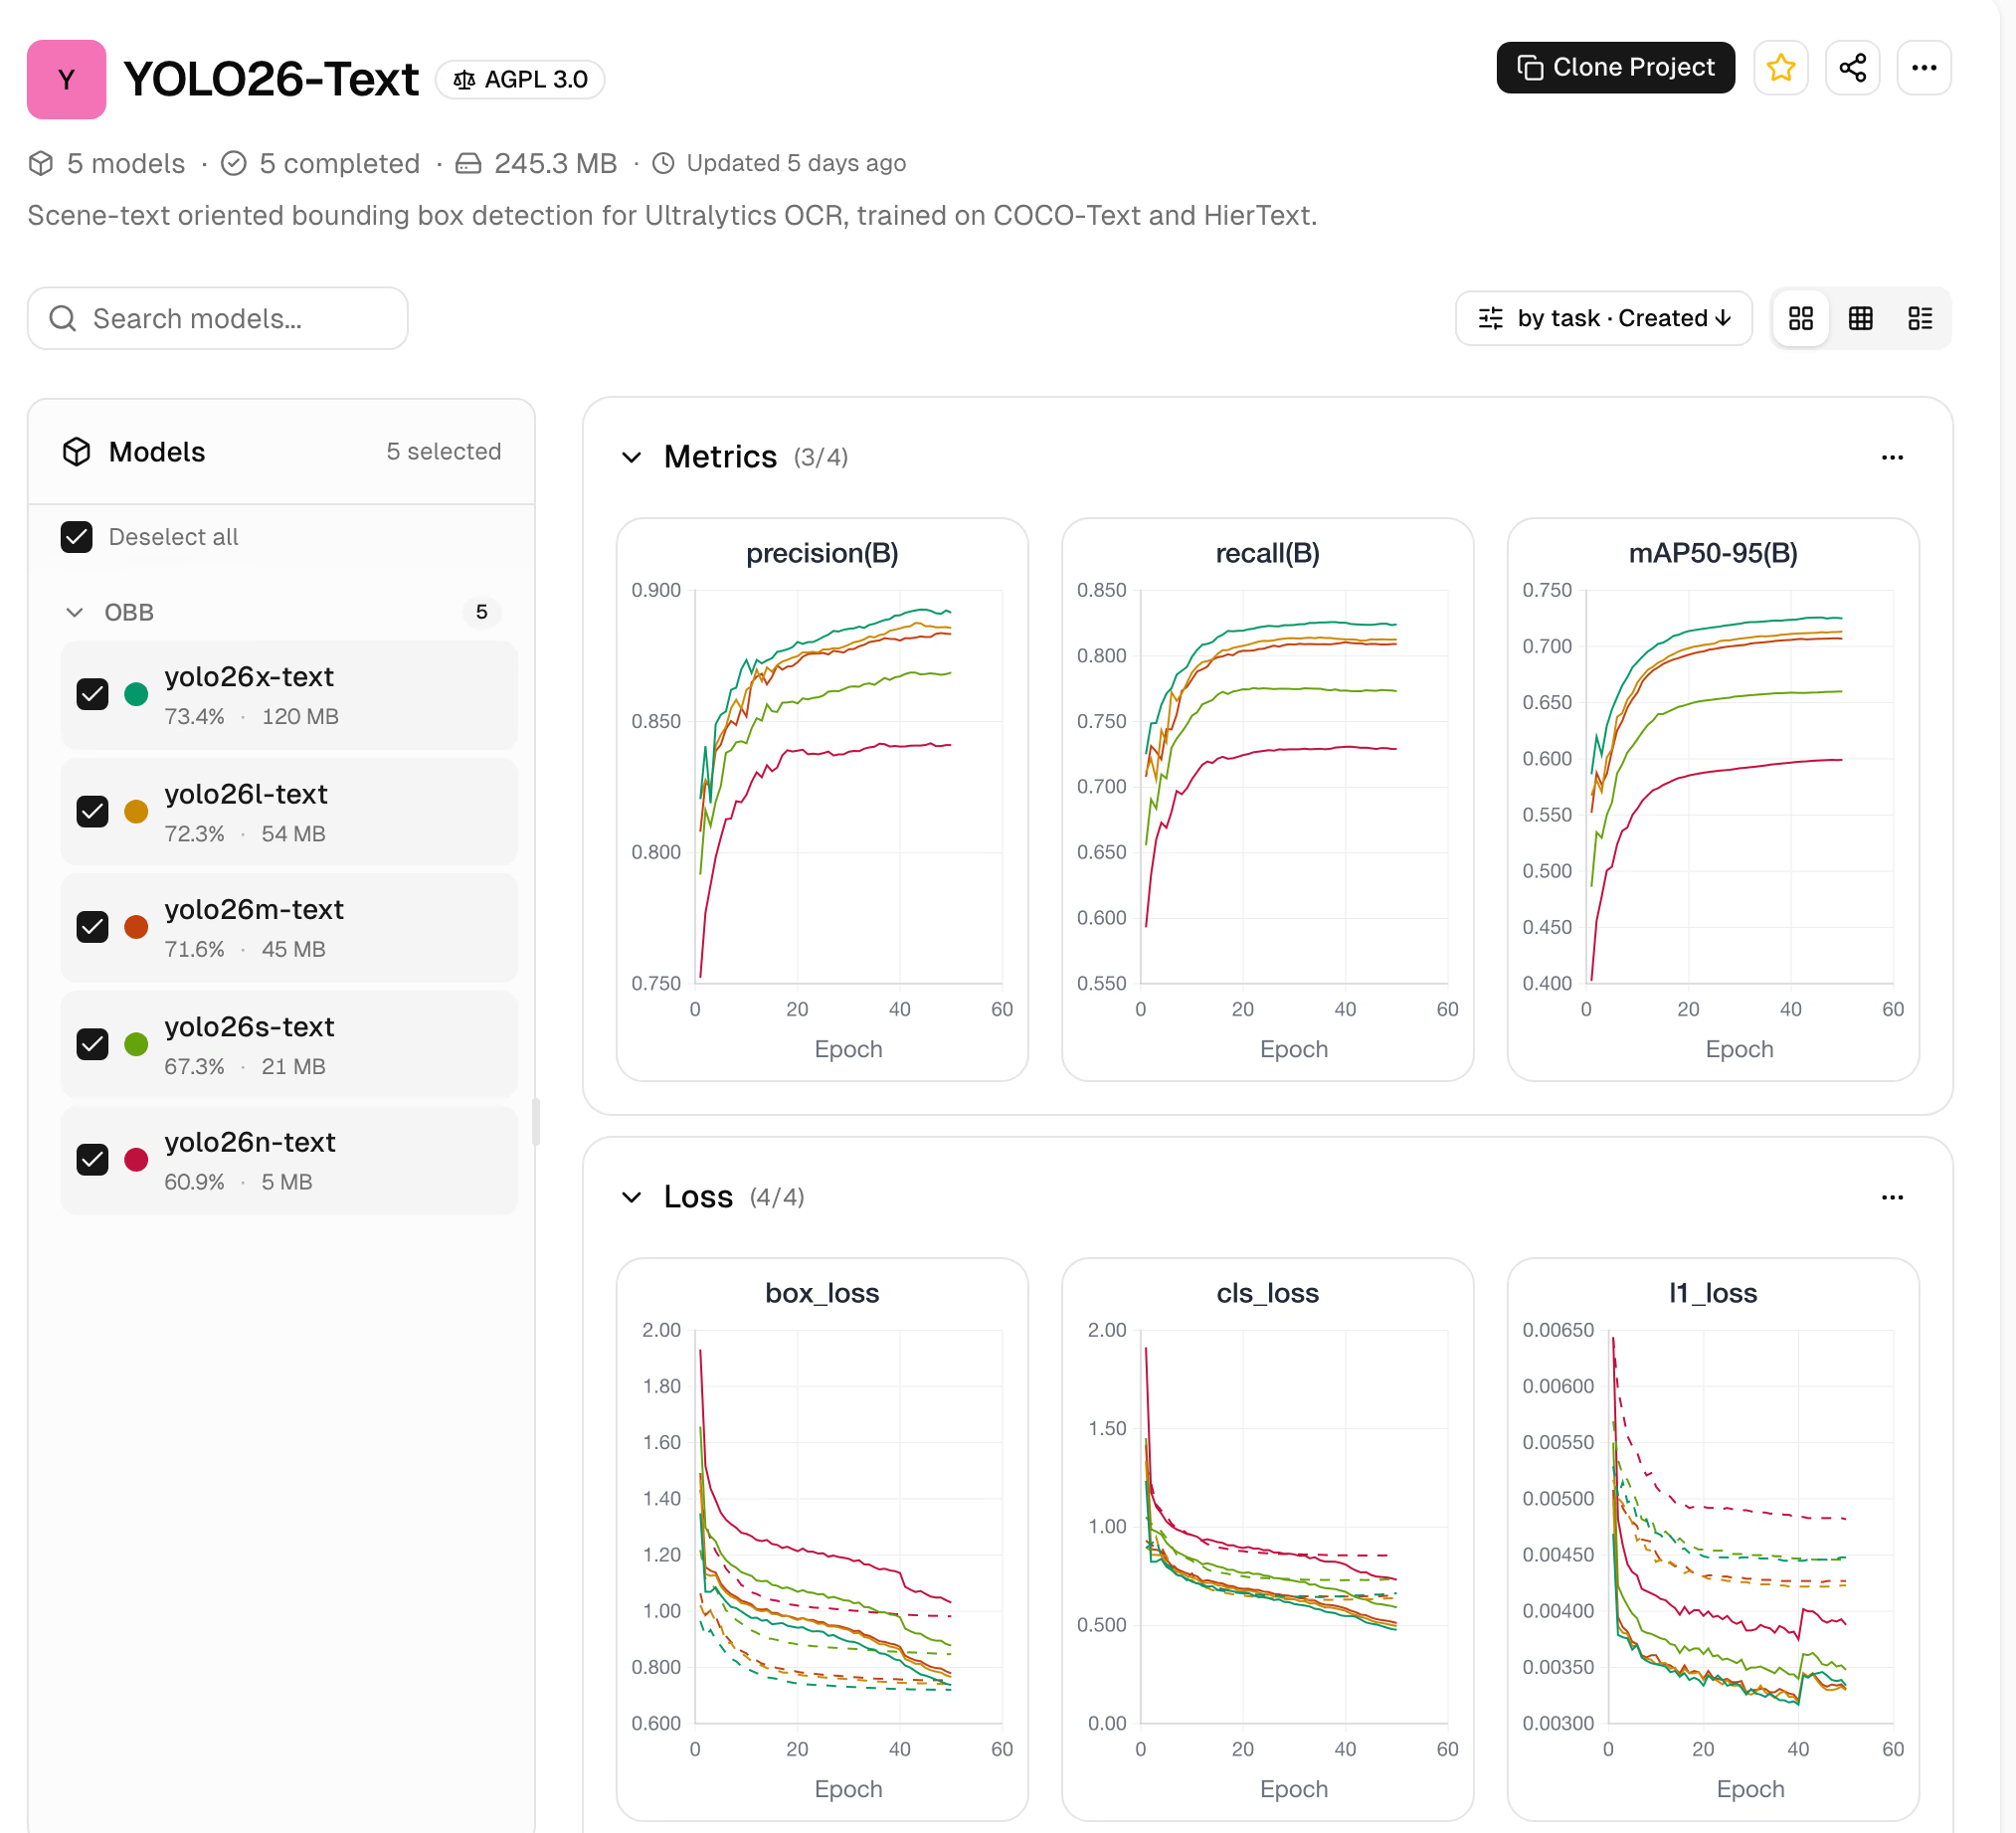
Проект YOLO26-Text на Ultralytics Platform: все пять вариантов размера детектора, кривые точности, полноты, mAP50-95 и функции потерь в процессе обучения.
Чтобы адаптировать модель для своих документов, начни с набора данных Scene Text OBB, который объединяет COCO-Text и HierText: в нём 65 325 изображений и около 1,29 миллиона полигонов слов.
Ограничения решения:
- Письменности. Стандартный распознаватель пока не читает кириллицу, корейский, арабский, иврит, деванагари и тайский. Используй вместе с детектором собственный распознаватель или выбери движок с поддержкой этих письменностей.
- Разные направления текста. Решение поворачивает всю страницу в соответствии с основным направлением текста, поэтому текст, идущий в нескольких направлениях на одной странице, например вертикальная заметка на полях, может распознаваться хуже.
- Экспорт. Распознаватель не включается в экспортированный файл детектора, поэтому развёртывай детектор и среду выполнения распознавания вместе либо используй решение на Python в качестве связующего компонента.
- Rust. Ultralytics Inference распознаёт текст в естественной среде на Rust с тем же распознавателем PP-OCRv6 через
ultralytics-inference predict --ocr, но для обработки ориентации использует классификатор, а не этап поворота страницы из решения на Python. - Конфиденциальность. Решение на Python работает на твоём оборудовании, поэтому страницы не нужно никуда отправлять; браузерная демонстрация загружает страницы для инференса. Если некоторые поля нельзя распознавать, перед запуском OCR закрой известные области непрозрачной маской.
Для форм и договоров сначала можно использовать собственную модель YOLO, чтобы найти поля, таблицы, подписи и печати, а затем распознавать только нужные области. В качестве отправных точек подойдут набор данных Signature на Ultralytics Platform и наше руководство по интеллектуальному анализу документов, а Ultralytics Platform позволяет размечать страницы и обучать эту модель в одном месте. Чтобы сначала проверить OCR на собственной странице, загрузи изображение или PDF в демонстрацию OCR в реальном времени.
Часто задаваемые вопросы
Установи пакет Ultralytics командой
pip install -U "ultralytics>=8.4.211", затем вызовиsolutions.OCR()для изображения, загруженного с помощью OpenCV. Он возвращает распознанные слова с текстом, оценкой уверенности, номером строки и полигоном в порядке чтения. При первом запуске автоматически загружаются детектор YOLO26-Text и распознаватель PP-OCRv6.Это зависит от твоих документов, языков и оборудования; в нашем обзоре популярных моделей OCR с открытым исходным кодом сравниваются основные варианты. В нашем тестировании при размере изображения 1280 на RTX PRO 6000 модель YOLO26x-Text с PP-OCRv6 набрала F1 по словам 0.931 на шести страницах PDF и 0.722 на 80 фотографиях HierText; также она распознаёт страницы при любом повороте. Для пока не поддерживаемых письменностей, например кириллицы или корейского, используй распознаватель, обученный для соответствующей письменности.
Модель YOLO обнаруживает текст, но не читает его. Ultralytics YOLO26-Text обнаруживает текст в виде ориентированных рамок, а решение OCR передаёт каждый фрагмент распознавателю PP-OCRv6, поэтому вместе они выполняют полный цикл OCR за один вызов.
Да. Преобразуй каждую страницу PDF в изображение, например с помощью
get_pixmapиз PyMuPDF, преобразуй изображение в BGR и передай его вsolutions.OCR(). В браузере демо и вкладка Platform Predict принимают PDF и считывают первую страницу.Да. PP-OCRv6 работает с ONNX Runtime на CPU или графических процессорах CUDA, и один и тот же скрипт подходит для обоих вариантов. Для необязательного распознавателя TensorRT нужен графический процессор NVIDIA.
Пока нет, если использовать распознаватель по умолчанию. PP-OCRv6 поддерживает китайский, японский и языки на основе латиницы, но не кириллицу, хангыль, арабское письмо, иврит, деванагари или тайское письмо. Можно оставить детектор YOLO26-Text и передать ему распознаватель, обученный для нужной письменности.
Автор
Старший инженер по машинному обучению · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









