Ultralytics YOLO26 ile Python'da OCR: belgeleri, fotoğrafları ve PDF'leri her açıdan oku
Ultralytics YOLO26-Text ve PP-OCRv6 ile CPU veya GPU üzerinde, isteğe bağlı TensorRT desteğiyle, Python'da birkaç satır kodla her açıdaki görüntülerden ve PDF sayfalarından metin oku.
 Jing Qiu11 dakikalık okuma
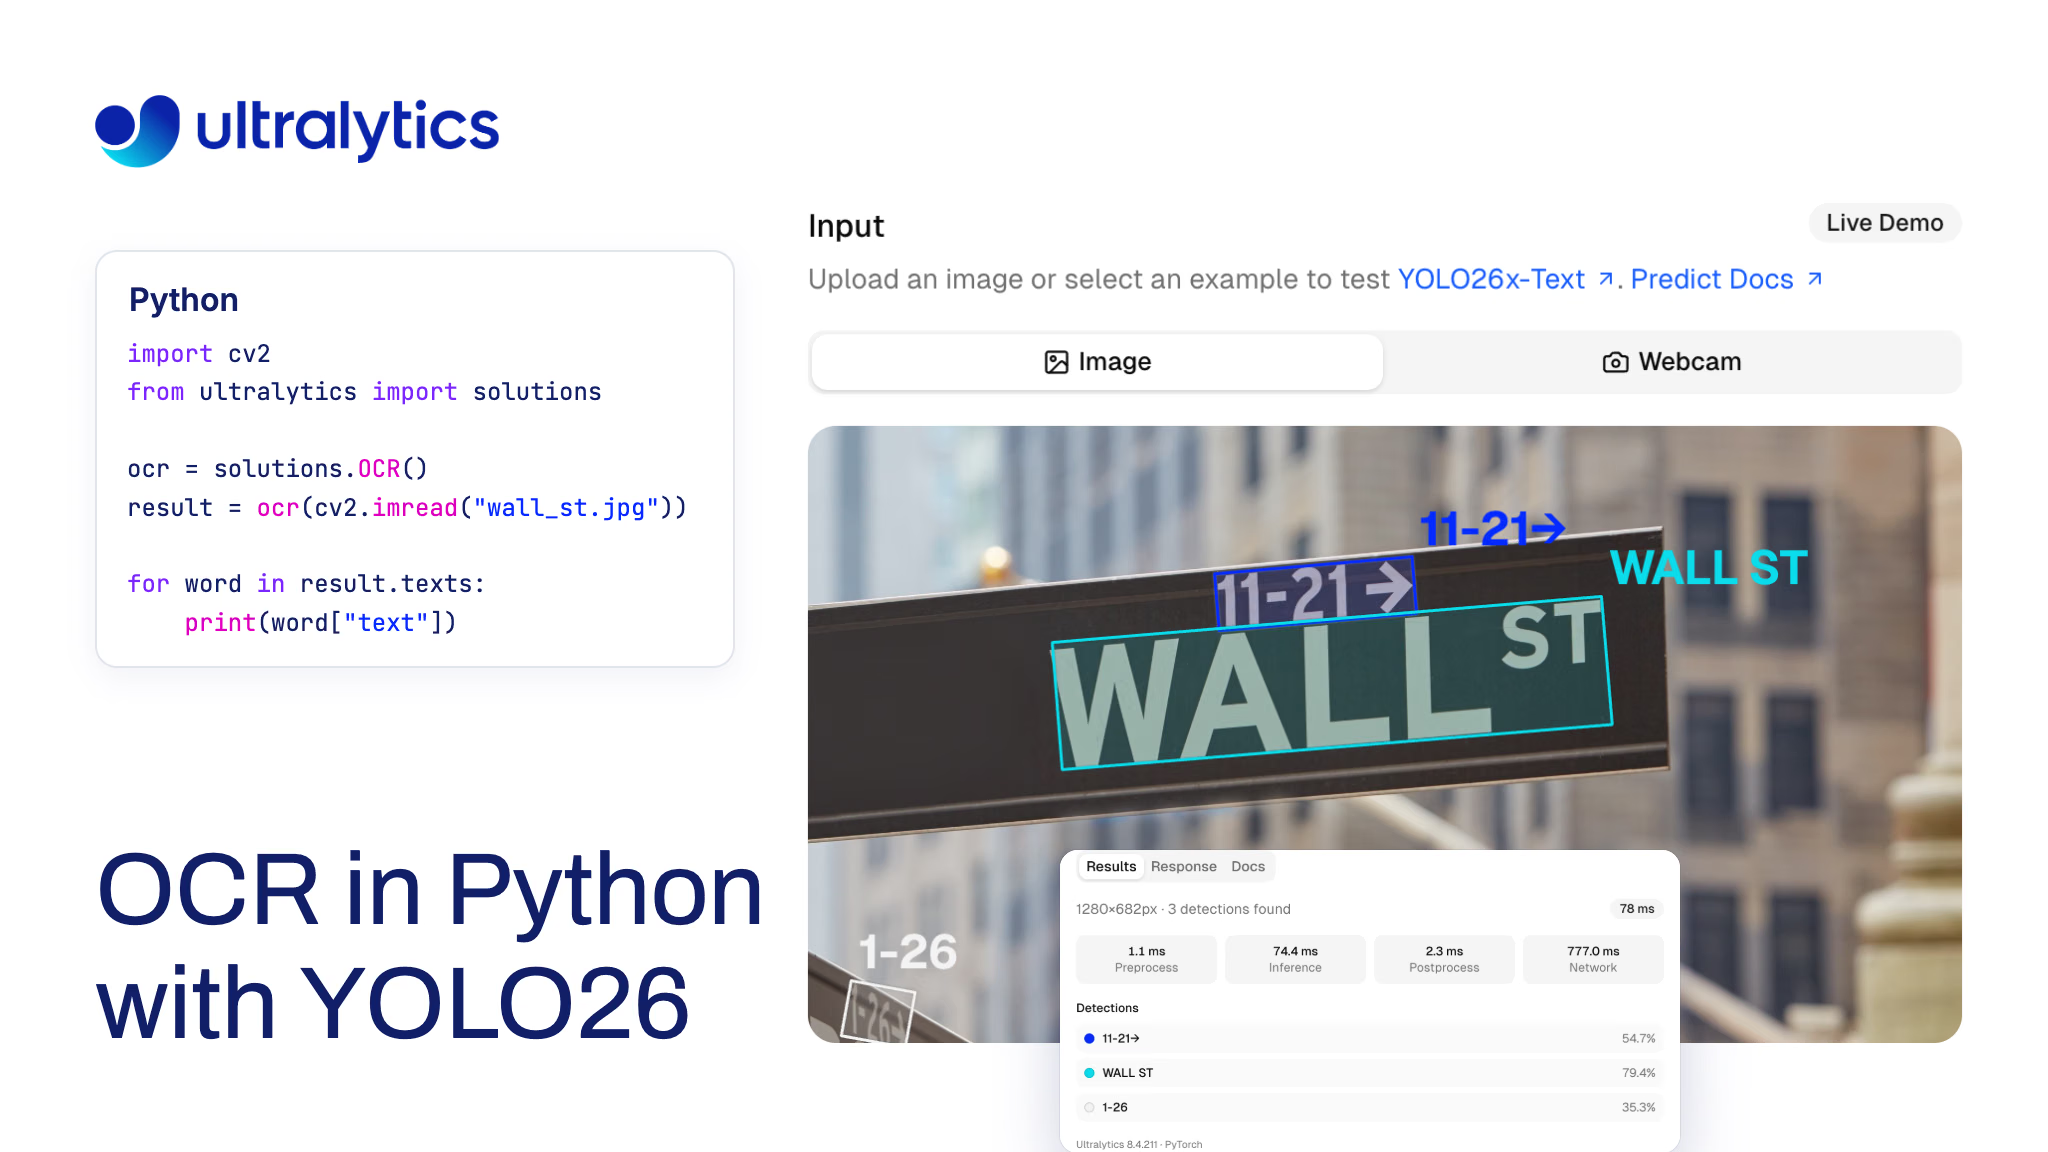
Yan çevrilmiş bir taramada, tabelanın telefonla çekilmiş fotoğrafında veya PDF'den alınmış bir sayfada Python ile OCR'ı nasıl çalıştırıp sözcükleri bir insanın okuyacağı sırayla alırsın? Ultralytics paketiyle bunu tek bir sınıf üzerinden yapabilirsin: solutions.OCR(), bir Ultralytics YOLO26-Text modeliyle metni algılar, her sözcüğü PaddleOCR'ın PP-OCRv6 tanıyıcısıyla okur ve tanınan sözcükleri satır satır, sayfanın açısı ne olursa olsun, CPU veya GPU'da döndürür.
Bu işlem hattı yeni. Ultralytics 8.4.210, OCR çözümünü dönme ve okuma sırası desteğiyle ONNX Runtime üzerindeki PP-OCRv6 etrafında yeniden oluşturdu; 8.4.211 ise isteğe bağlı bir TensorRT tanıyıcısı ekledi. Görüntü boyutunun 1280 olduğu kıyaslamamızda, varsayılan kurulum altı PDF sayfasında 0.931, 80 HierText fotoğrafında 0.722 sözcük F1 puanı aldı. RTX PRO 6000 üzerinde önbelleğe alınmış bir FP16 TensorRT motoru, bir fotoğrafta algılanan 251 sözcüğü 82 ms'de okudu; CUDA üzerindeki ONNX Runtime ise 249 ms sürdü.
Bu kılavuzda işlem hattının nasıl çalıştığını, görüntülerde ve PDF'lerde nasıl çalıştırılacağını, ne kadar hızlı olduğunu ve bugün hangi dilleri okuyabildiğini ele alıyoruz. Aşağıda karşılaştırılan OCR seçeneklerinden biri Ultralytics tarafından geliştirildiği için karşılaştırmada her projenin belgelenmiş özellikleri esas alınıyor.
YOLO26 OCR bir sayfayı iki adımda okur, ardından sözcükleri sıralar#
Optik karakter tanıma (OCR) iki iş yapar: metni bulur, sonra okur. Ultralytics OCR çözümü bu işleri birbirinden net biçimde ayırır:
- Algılama: Yönlendirilmiş bir sınırlayıcı kutu algılayıcısı olan YOLO26-Text modeli, metnin çevresine döndürülmüş kutular çizer. Model n, s, m, l ve x boyutlarında sunulur; varsayılan olarak x modeli kullanılır.
- Tanıma: PP-OCRv6 medium, kırpılan her parçayı okur. Ultralytics varlık sürümündeki ONNX Runtime üzerinden çalıştığı için PaddlePaddle yüklemen gerekmez. Boş okunan kırpımlar atılır.
- Sıralama: Sözcükler satırlar halinde gruplandırılır ve her birine satır numarası eklenerek yukarıdan aşağıya, soldan sağa döndürülür.
Her sözcük; metnini, tanıma güven puanını, algılayıcının güven puanını, satır numarasını ve özgün görüntü koordinatlarındaki bir çokgeni içeren bir kayıt olarak döndürülür. İki güven puanı ayrı tutulduğu için güvenle bulunmuş ama belirsiz biçimde okunmuş bir sözcüğü, ona güvenmek yerine insan incelemesine gönderebilirsin.
İki aşama birbirinden bağımsız kalır. Daha küçük bir algılayıcı, kendi algılama veya segmentasyon modelin ya da farklı bir tanıyıcı kullanabilirsin; dönme işleme ve okuma sırası yine çalışır. Bir şey yüklemeden önce aynı kod yolunu tarayıcıda belge işleme sayfamızda deneyebilirsin.
Döndürülmüş ve baş aşağı sayfalar doğru sırayla okunur#
Çözüm, algıladığı metinden sayfanın yönünü belirler; bu nedenle önceden eğiklik düzeltmesi yapman veya sayfaları döndürmen gerekmez:
- Metnin yönünü bul. Algılanan kutuların uzun kenar açılarını, her kutunun ne kadar uzamış olduğuna göre ağırlıklandırıp ortalamasını alır. Tek basamaklı sayılar gibi 2:1 oranından daha az uzamış kutular değerlendirmeye katılmaz.
- Sayfayı döndür. Metin soldan sağa ilerleyecek şekilde sayfayı döndürür, her sözcüğü dik konumda kırpar ve sözcükleri satırlar halinde gruplandırır.
- 0° veya 180° yönünü belirle. Bir kutu, içindeki metnin hangi tarafının yukarı baktığını gösteremez; bu nedenle çözüm en geniş 8 sözcüğü iki yönde de okur ve daha yüksek güvenle okunan yönü seçer. Baş aşağı metin düşük güvenli gürültü gibi okunur; böylece doğru seçenek öne çıkar.
8 belge ve ekran görüntüsünü, ayrıca 12 fotoğrafı 90°, 180° ve 270° döndürdüğümüzde sözcük F1 puanı belgelerde 0.925, fotoğraflarda 0.654 oldu. Boş bir IRS Form 8802 üzerinde çözüm 0°, 180° ve 90° yönlerinde sırasıyla 404, 401 ve 399 sözcük okudu; ilk satırlar aynıydı. Önceki sürüm her sayfanın doğru yönde olduğunu varsayıyordu.
Varsayılan değerler tahmine değil, kıyaslamaya dayanıyor#
Ana varsayılan değerleri ölçümlerimize göre belirledik. Kıyaslama, üretim Platform görüntüsüyle RTX PRO 6000 üzerinde çalıştırıldı; yüklemeler uzun kenarı en fazla 1280 piksel olacak şekilde JPEG olarak gönderildi. Google'ın HierText veri kümesinden okunabilir sözcük transkripsiyonları bulunan 80 doğrulama fotoğrafı, metin katmanlarına göre puanlanan 6 PDF sayfası (arXiv makalesinden 4 sayfa ve boş IRS Form 1040 ile Form 8802), sentetik bir ekran görüntüsü ve sentetik bir görüntü kullanıldı. Ölçüt, en az 2 alfasayısal karakter içeren küçük harfli sözcükleri sayan sözcük düzeyinde F1 puanıdır; kesinlik ile duyarlılık arasındaki dengeyi ölçer.
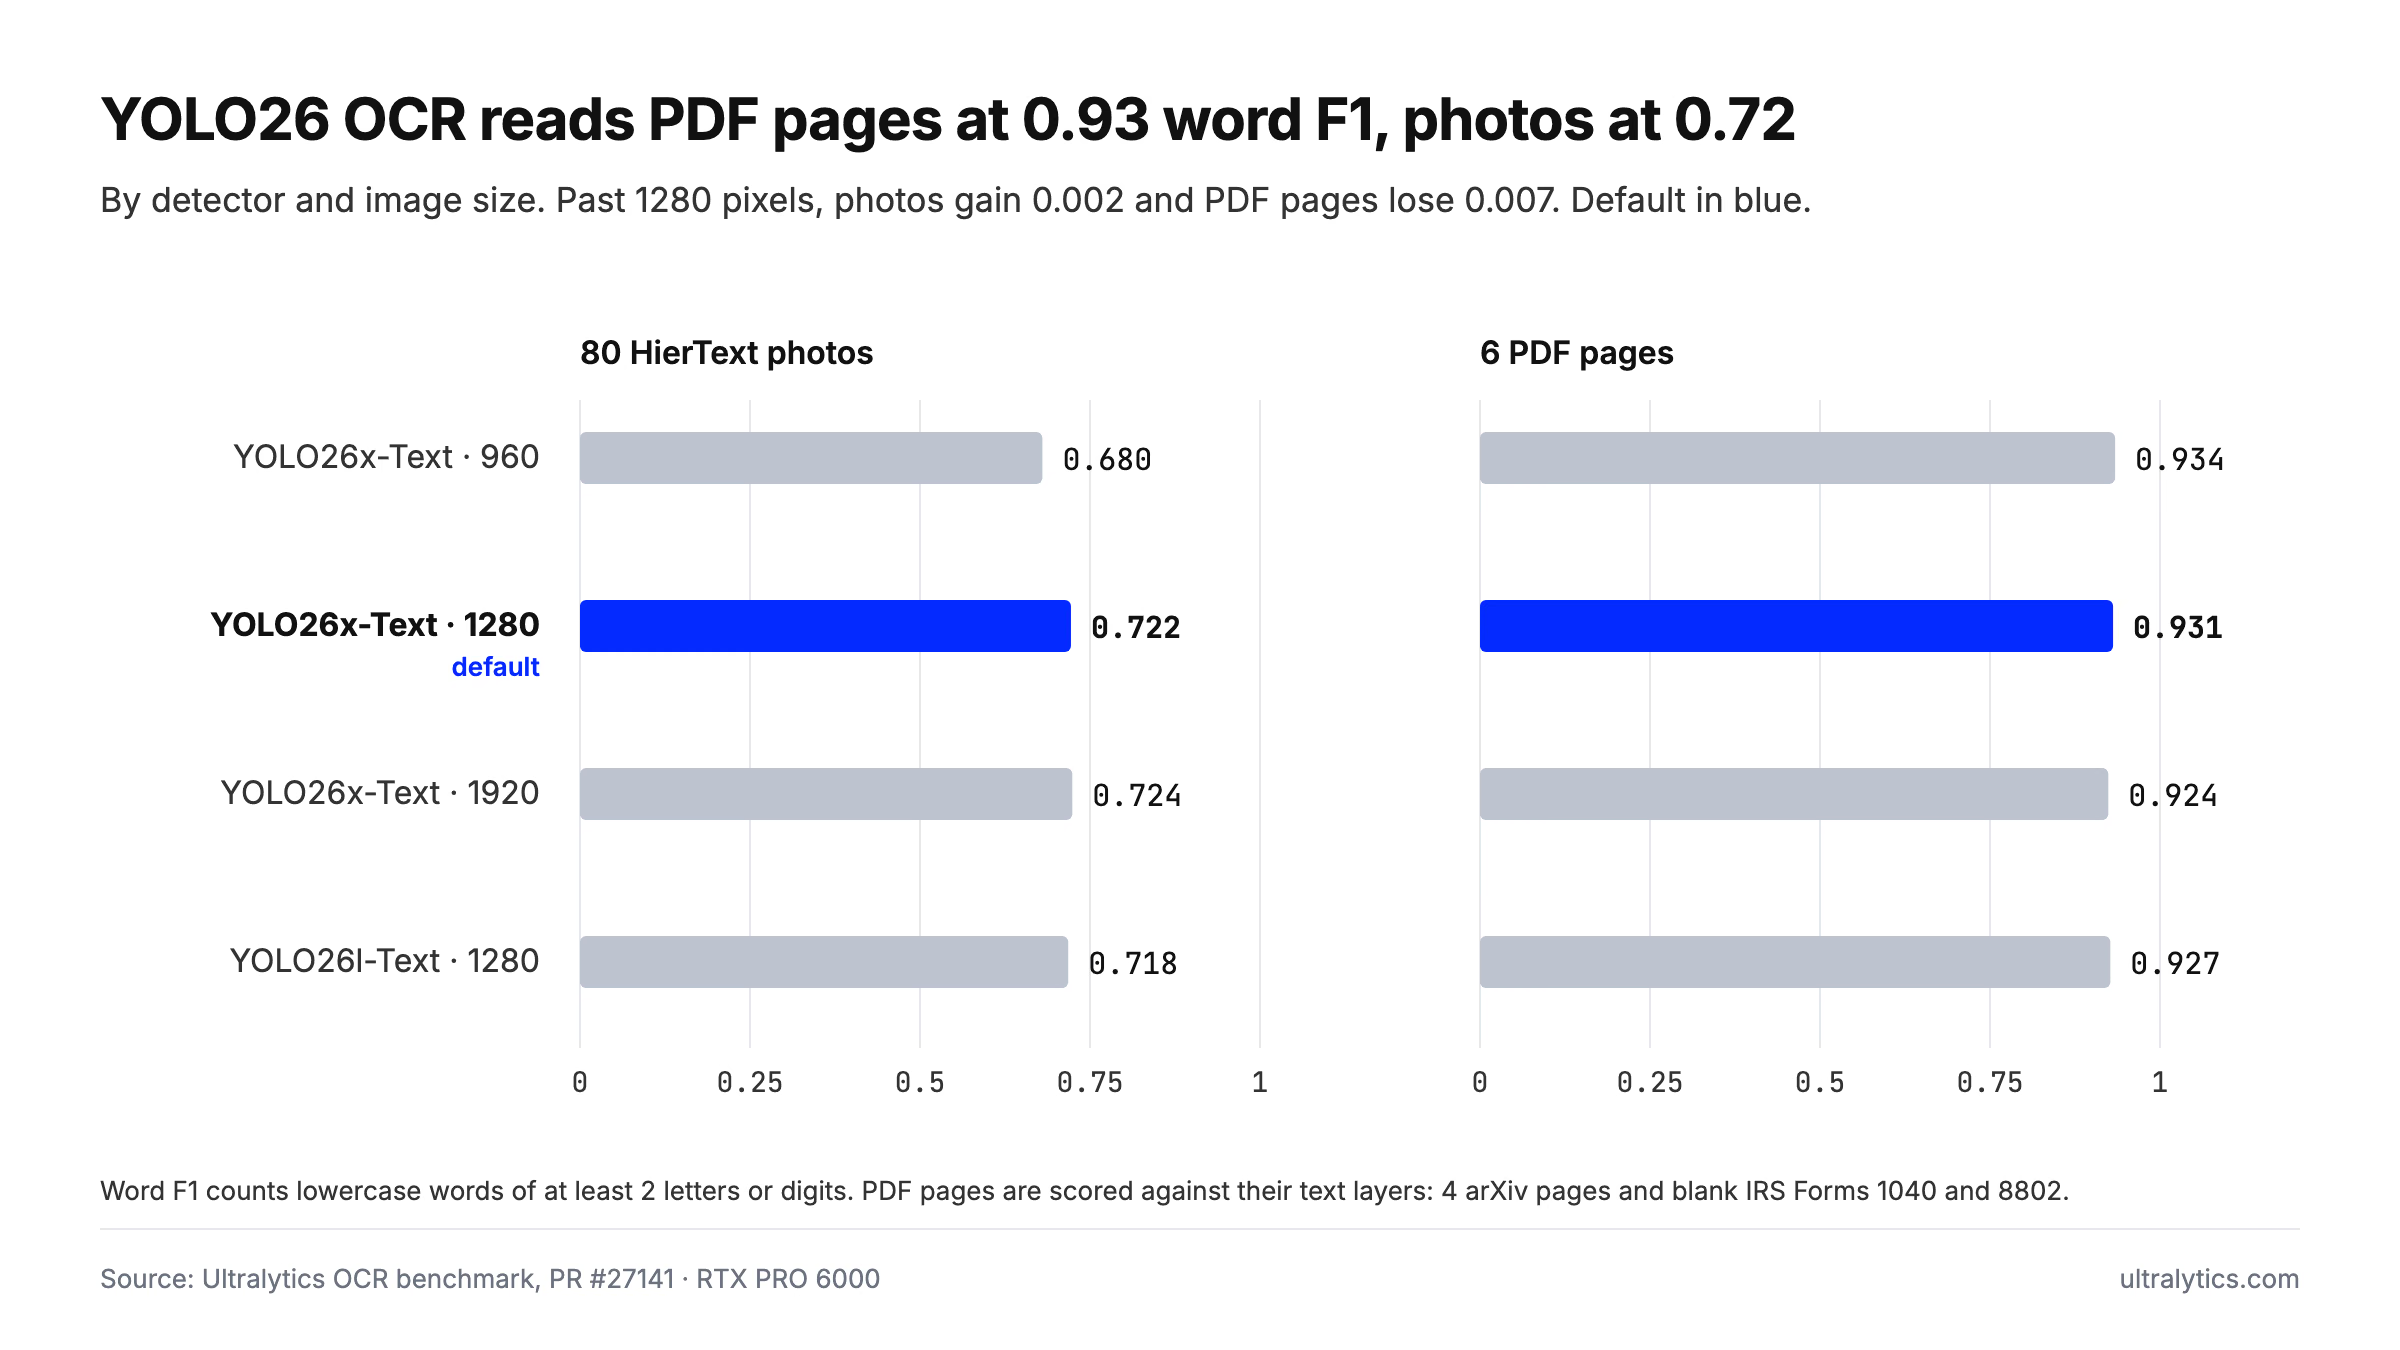
RTX PRO 6000 üzerinde, algılayıcıya ve görüntü boyutuna göre 80 HierText fotoğrafı ve 6 PDF sayfasında PP-OCRv6 ile YOLO26-Text'in sözcük F1 puanı.
Temiz PDF sayfaları her ayarda sahne metni içeren fotoğraflardan çok daha iyi okunuyor. Ölçümlere göre belirlenen üç varsayılan değer şunlar:
yolo26x-textiçinimgsz=1280. 960'a düşürmek fotoğraflarda 0.042 F1 puanına mal oldu; 1920'ye çıkarmak fotoğraflarda 0.002 puan kazandırırken PDF sayfalarında 0.007 puan kaybettirdi. Daha küçük görüntüler 1280'e büyütülmez; kendi boyutlarında, modelin 32 piksellik adımına yukarı yuvarlanarak işlenir.- Sözcükleri tek tek oku. Tek tek sözcükleri okumak, fotoğraflarda tüm satırları okumaktan 4 F1 puanı daha iyi sonuç verdi.
max_det=1000. Yoğun bir belge sayfasında alışılmış 300 algılamadan fazlası bulunur.
Daha hafif bir algılayıcıya ihtiyacın varsa YOLO26l-Text, her iki veri kümesinde de x modelinden yarım puandan daha az geride kaldı.
YOLO26 ile Python'da OCR nasıl çalıştırılır?#
pip install -U "ultralytics>=8.4.211" ile yükle veya yükselt. İlk OCR çağrısı YOLO26x-Text ile PP-OCRv6'yı indirir ve ONNX Runtime'ı yükler; CUDA kullanılabiliyorsa onnxruntime-gpu kullanılır. Varsayılan ONNX Runtime tanıyıcısı Python 3.11+ ve ONNX Runtime 1.26+ gerektirir.
Görüntü oku#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text, imgsz=1280 ve PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # açıklama eklenmiş görüntü

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
Komut satırından yolo solutions ocr source="path/to/video.mp4" her karede aynı işlemi yapar. Kareler izleme yapılmadan, birbirinden bağımsız okunur.
PDF oku#
Çözüm görüntülerle çalışır; bu nedenle önce her PDF sayfasını görüntüye dönüştür. Bunu PyMuPDF ile yapabilirsin:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # zaten okuma sırasına göre sıralanmış
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
result.texts zaten sıralı olduğundan düz metni yeniden oluşturmak için bir sözlük ve birleştirme işlemi yeterlidir. Çokgenleri kullanarak, örneğin bir tutarın "Total" sözcüğünün yanında olup olmadığını da kontrol edebilirsin.
Modeli, cihazı ve tanıyıcıyı seç#
- Daha küçük algılayıcı:
solutions.OCR(model="yolo26s-text.pt"), daha küçük ve hızlı bir algılayıcı yükler; doğruluğunu kendi sayfalarında kontrol et. Beş boyutun tümü otomatik indirilir. - CPU veya GPU: Bir CUDA GPU'su seçildiğinde ve ONNX Runtime'ın CUDA yürütme sağlayıcısı kullanılabilir olduğunda tanıyıcı CUDA üzerinde, aksi durumda CPU'da çalışır. Böylece aynı betik dizüstü bilgisayarda veya sunucuda çalışır.
- Kendi tanıyıcın:
recognizerolarak bir işlev geçir. İşlev her BGR sözcük kırpımını alıp(text, confidence)döndürür; çözüm ise algılama, döndürme ve sıralama işlemlerini bu tanıyıcının çevresinde sürdürür.
def recognize(crop):
    # Herhangi bir tanıma modelini BGR sözcük kırpımında çalıştır
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
TensorRT, yoğun fotoğraflardaki sözcükleri 2,5 ila 3 kat daha hızlı okuyor#
Yoğun sayfalarda yaptığımız GPU testlerinde zamanın çoğunu algılama değil, tanıma aldı. Önceki bir optimizasyon, 250 ms'lik bir isteğin yaklaşık 11 ms'sini algılamanın aldığını ölçtü. TensorRT çekme isteği ise kalan tanıma süresinin büyük kısmının hesaplamadan ziyade başlatma yükünün baskın olduğu 33 küçük toplu işlemden kaynaklandığını gösterdi. Ultralytics 8.4.211 bunun için bir bağımsız değişken ekliyor:
ocr = solutions.OCR(recognizer="tensorrt") # NVIDIA GPU'larında FP16 TensorRT motoruİlk çalıştırma yaklaşık 30 saniyede bir FP16 TensorRT motoru oluşturur ve bunu TensorRT sürümü ile GPU mimarisi başına bir kez PP-OCRv6 modelinin yanına önbelleğe alır. Sonraki yüklemeler 0,05 ila 0,2 saniye sürer. Sürüm notlarında yoğun sayfalarda ONNX Runtime'dan yaklaşık 2,5 kat daha hızlı olduğu belirtiliyor.
Dört sahne metni fotoğrafında algılamadan sonra gelen, sözcükleri kırpan, döndüren, tanıyan ve sıralayan read_words adımının süresini ölçtük. 195 ila 263 sözcük içeren üç fotoğrafta FP16 motoru, CUDA üzerindeki ONNX Runtime'dan 2,5 ila 3 kat daha hızlıydı; 48 sözcüklü bir fotoğrafta ise 1,4 kat daha hızlıydı:
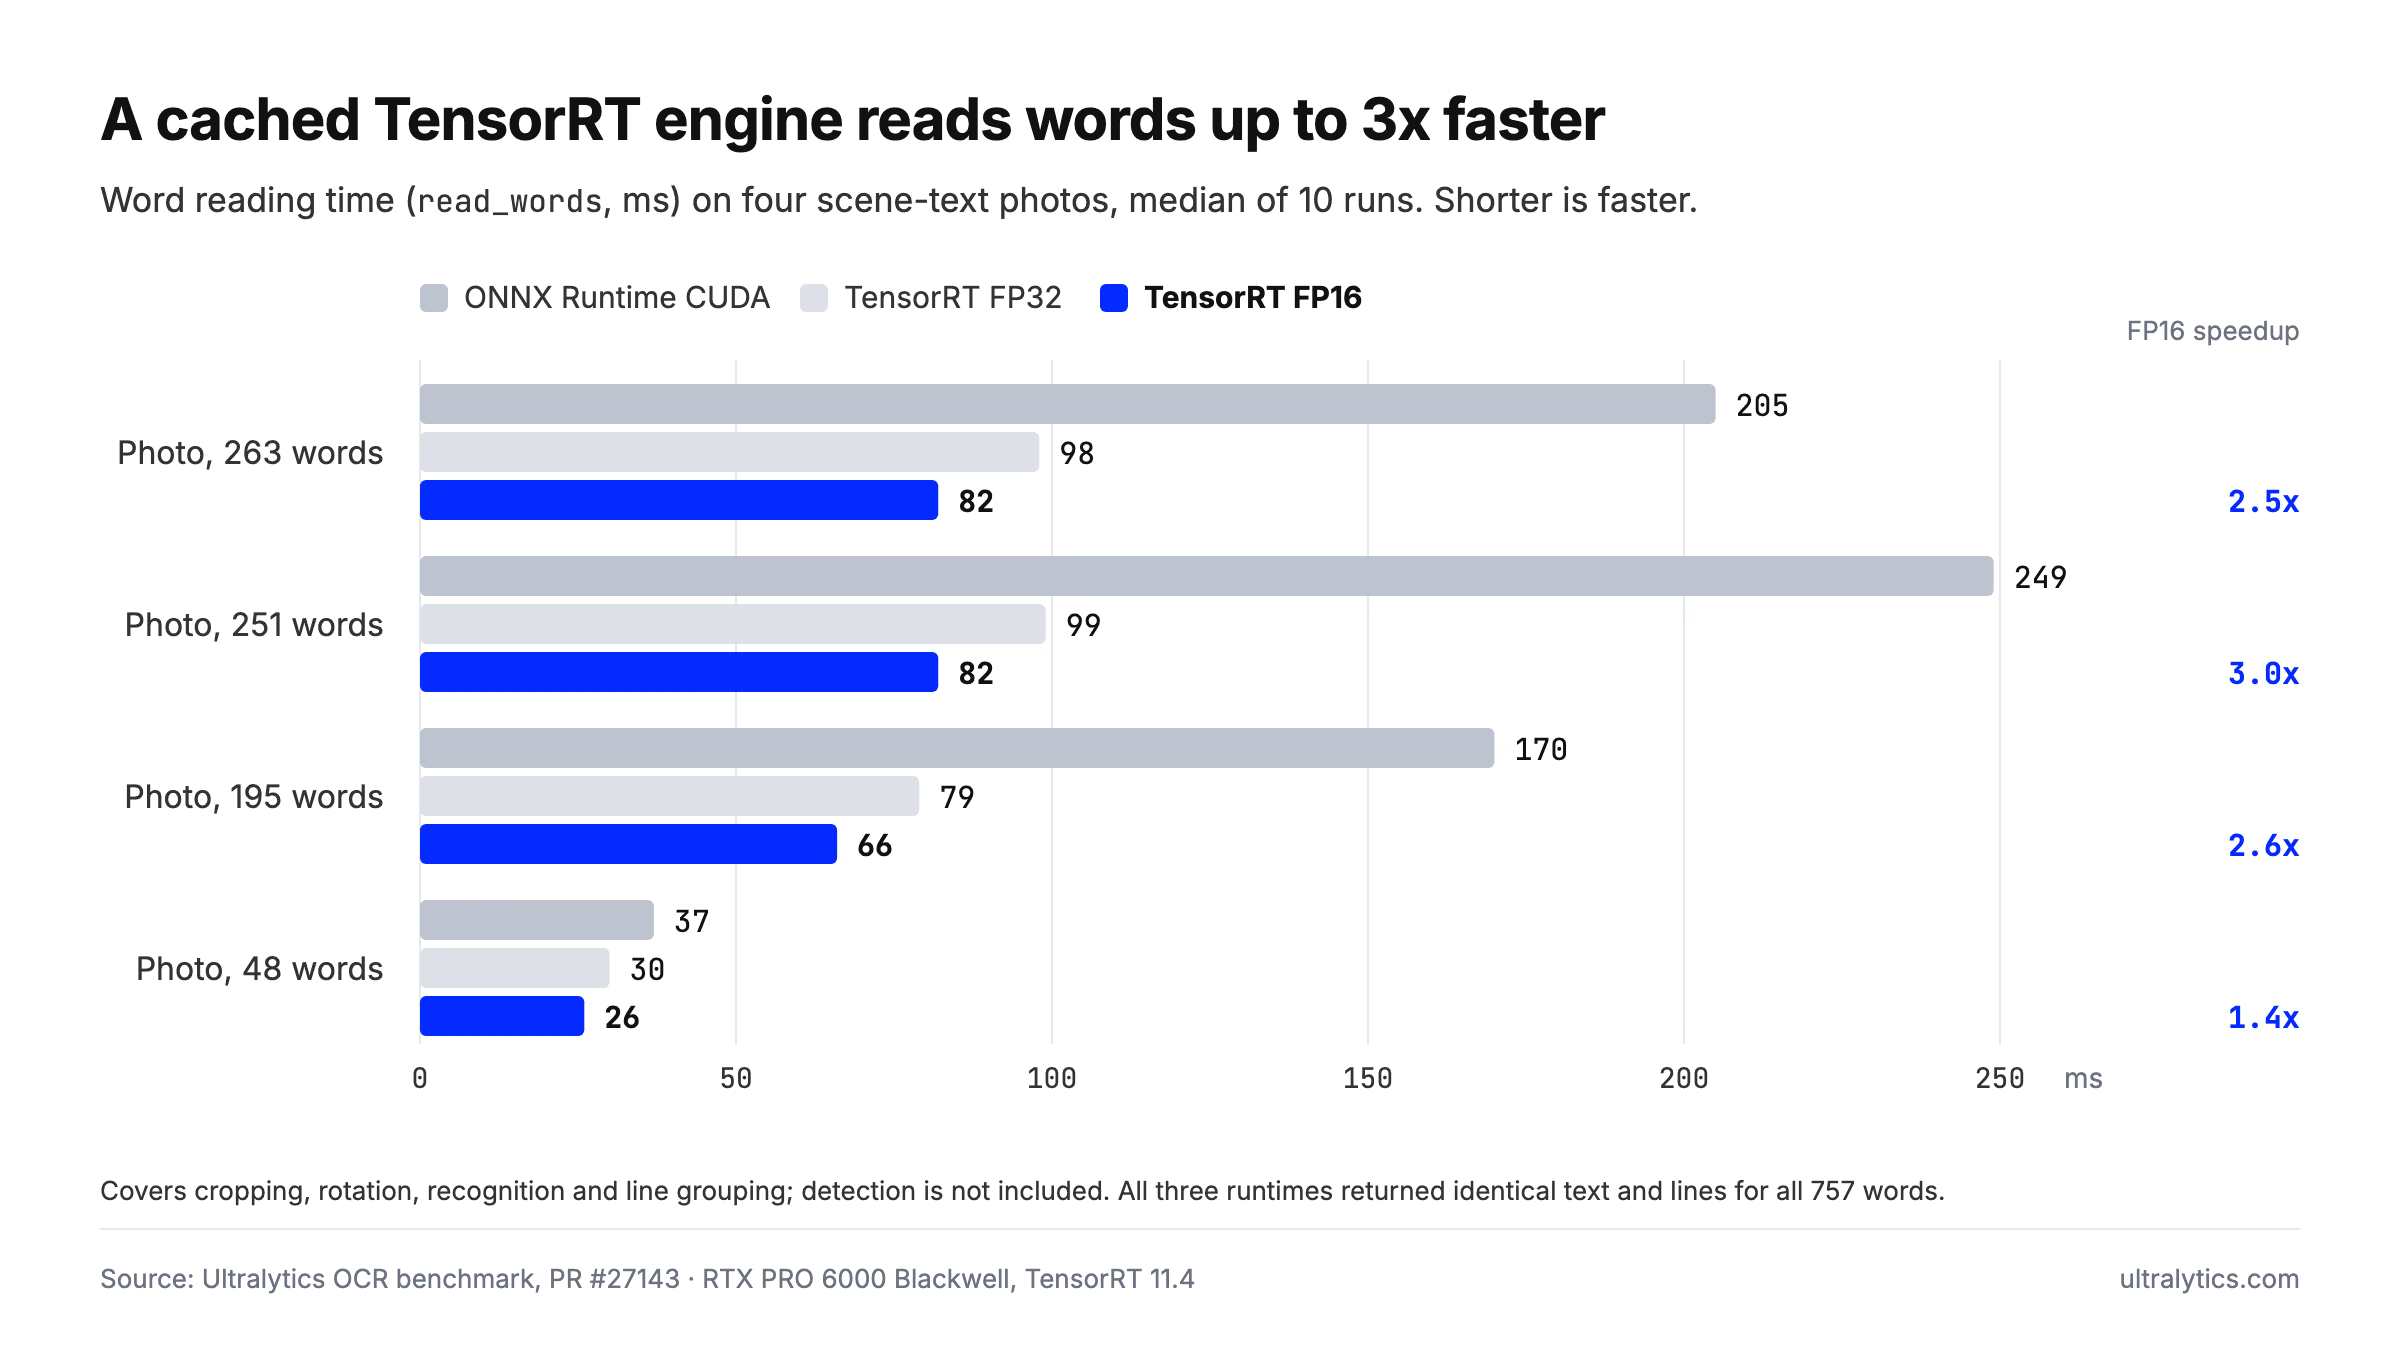
TensorRT 11.4 ile RTX PRO 6000 Blackwell üzerinde 10 çalıştırmanın ortancası; dört sahne metni fotoğrafında ONNX Runtime CUDA ve FP32 ile FP16 TensorRT motorlarıyla sözcük okuma süresi.
Yoğun bir sayfadaki tam OCR çağrısı 182 ms'den 94 ms'ye düştü. Bu dört fotoğrafta hız artışı çıktıyı değiştirmedi: 757 sözcüğün tamamında ONNX Runtime ve her iki motor da aynı metni ve satır gruplamasını döndürdü.
İlk derlemeyi bekleyemiyorsan veya NVIDIA donanımı kullanmıyorsan varsayılan recognizer="paddleocr" seçeneğini kullan. Hiçbir şey derlemez ve yaklaşık bir saniyede başlar. ONNX ve TensorRT karşılaştırmamız, algılama modelleri için aynı ödünleşimi ele alıyor; TensorRT entegrasyon kılavuzu ise kurulumu anlatıyor.
Bugün Çince, Japonca ve Latin alfabeleri destekleniyor#
PP-OCRv6 yalnızca yerleşik 18.708 karakterlik kümesindeki karakterleri üretebilir. YOLO26-Text algılayıcısı bu karakter kümesine bağlı değildir ve diğer alfabelerde de sözcükleri bulur; ancak küme dışındaki bir sözcük, benzer karakterlerle döndürülür. Örneğin Rusça ТЕКСТ, çoğu zaman yüksek güvenle "TEKCT" olarak okunur.
- Destekleniyor: Basitleştirilmiş ve Geleneksel Çince (yaklaşık 15.600 CJK karakteri), Japonca (hiragana, katakana ve kanji) ve İngilizce, Fransızca, Almanca, İspanyolca, Portekizce, İtalyanca, Hollandaca, İsveççe, Fince, Danca, Norveççe, Lehçe, Çekçe, Macarca, Romence, Türkçe, Hırvatça, Endonezce ve Malayca dahil Latin alfabesini kullanan diller. Almancadaki büyük ẞ ve İspanyolcadaki ¡ dışında tüm harfler ve aksanlı harfler desteklenir.
- Kısmen: Ton işaretli ünlülerin çoğunun eksik olduğu Vietnamca ve yalnızca temel harflerin desteklendiği Yunanca.
- Henüz desteklenmiyor: Kiril, Korece (Hangul), Arapça, İbranice, Devanagari ve Tayca.
Desteklenmeyen bir alfabe için YOLO26-Text algılayıcısını kullanmaya devam et ve bu alfabe için eğitilmiş bir tanıyıcıyı recognizer olarak geçir. Tam kapsam tablosu OCR kılavuzunun desteklenen diller bölümünde bulunuyor.
Belgelenmiş özelliklere göre Python OCR kütüphanelerinin karşılaştırması#
Tek bir en iyi OCR modeli yoktur; doğru seçim sayfalarına, dillerine ve kodun nerede çalıştığına bağlıdır. Tabloda, her projenin herkese açık sayfalarında 12 Kasım 2026'da kontrol edildiği şekliyle belgelenen özellikler karşılaştırılıyor; ölçüm sonuçları karşılaştırılmıyor. Seçenekler alfabetik sırayla listelenmiştir.
| Seçenek | Çalışma zamanı | Döndürülmüş metin | Belgelerde belirtildiği şekliyle diller | Çıktı |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info, her metin kutusu için 90°, 180° ve 270° dönüşlerini dener | Kiril, Arapça, Devanagari, Korece ve Tayca dahil 80'den fazla dil | Kutular, metin ve güven puanı |
| PaddleOCR | PaddlePaddle | İsteğe bağlı yön sınıflandırması | 100'den fazla dil (PP-OCRv6 tek modelde 50 dili kapsar) | Kutular, metin ve güven puanı |
| Tesseract (pytesseract) | Yerel ikili dosya, CPU | Yön ve alfabe algılama (image_to_osd); okumadan önce görüntüyü döndür | 100+ | Metin ve isteğe bağlı sözcük verileri |
| Ultralytics YOLO26 OCR | PyTorch algılayıcısı; ONNX Runtime üzerinde veya NVIDIA GPU'larında TensorRT ile çalışan tanıyıcı | Sayfanın dönüşü, algılanan metinden tahmin edilir; 0° ile 180° arasındaki yön otomatik belirlenir | Çince, Japonca ve Latin alfabeleri; diğerleri özel tanıyıcıyla | Okuma sırasındaki sözcükler; satır numaraları, çokgenler ve ayrı algılama ile tanıma güven puanları |
Güncel seçenekleri kontrol etmek için EasyOCR belgelerine, PaddleOCR deposuna, Tesseract belgelerine ve pytesseract sayfasına bak. Bu motorların nasıl çalıştığı hakkında bilgi için popüler açık kaynak OCR modelleri hakkındaki genel bakışımıza göz at.
Ultralytics nerede yer alıyor?#
Ultralytics YOLO26 OCR; taranmış formlar, PDF sayfaları, ekran görüntüleri ve etiketlerle tabelaların fotoğrafları gibi çeşitli girdilerden metin alması gereken, sözcükleri okuma sırasıyla ve kontrol edebilecekleri koordinatlarla birlikte isteyen Python geliştiricileri için tasarlandı. Sayfalar öngörülemeyen açılarda geldiğinde, OCR'ı kendi makinelerinde çalıştırmak istediğinde veya zaten Ultralytics YOLO26 modellerini kullanıp aynı pakette OCR istediğinde iyi bir seçenektir. NVIDIA GPU'larında yüksek hacimli işlemler için recognizer="tensorrt" ekle.
Algılayıcı sıradan bir Ultralytics modeli olduğundan diğer modeller gibi eğitilir, doğrulanır ve dışa aktarılır. Ultralytics Platform'daki YOLO26-Text projesinde n'den x'e kadar beş boyutun tümü bulunur. Eğitim eğrilerini karşılaştırabilir ve projeyi kopyalayarak bu modelleri temel alabilirsin.
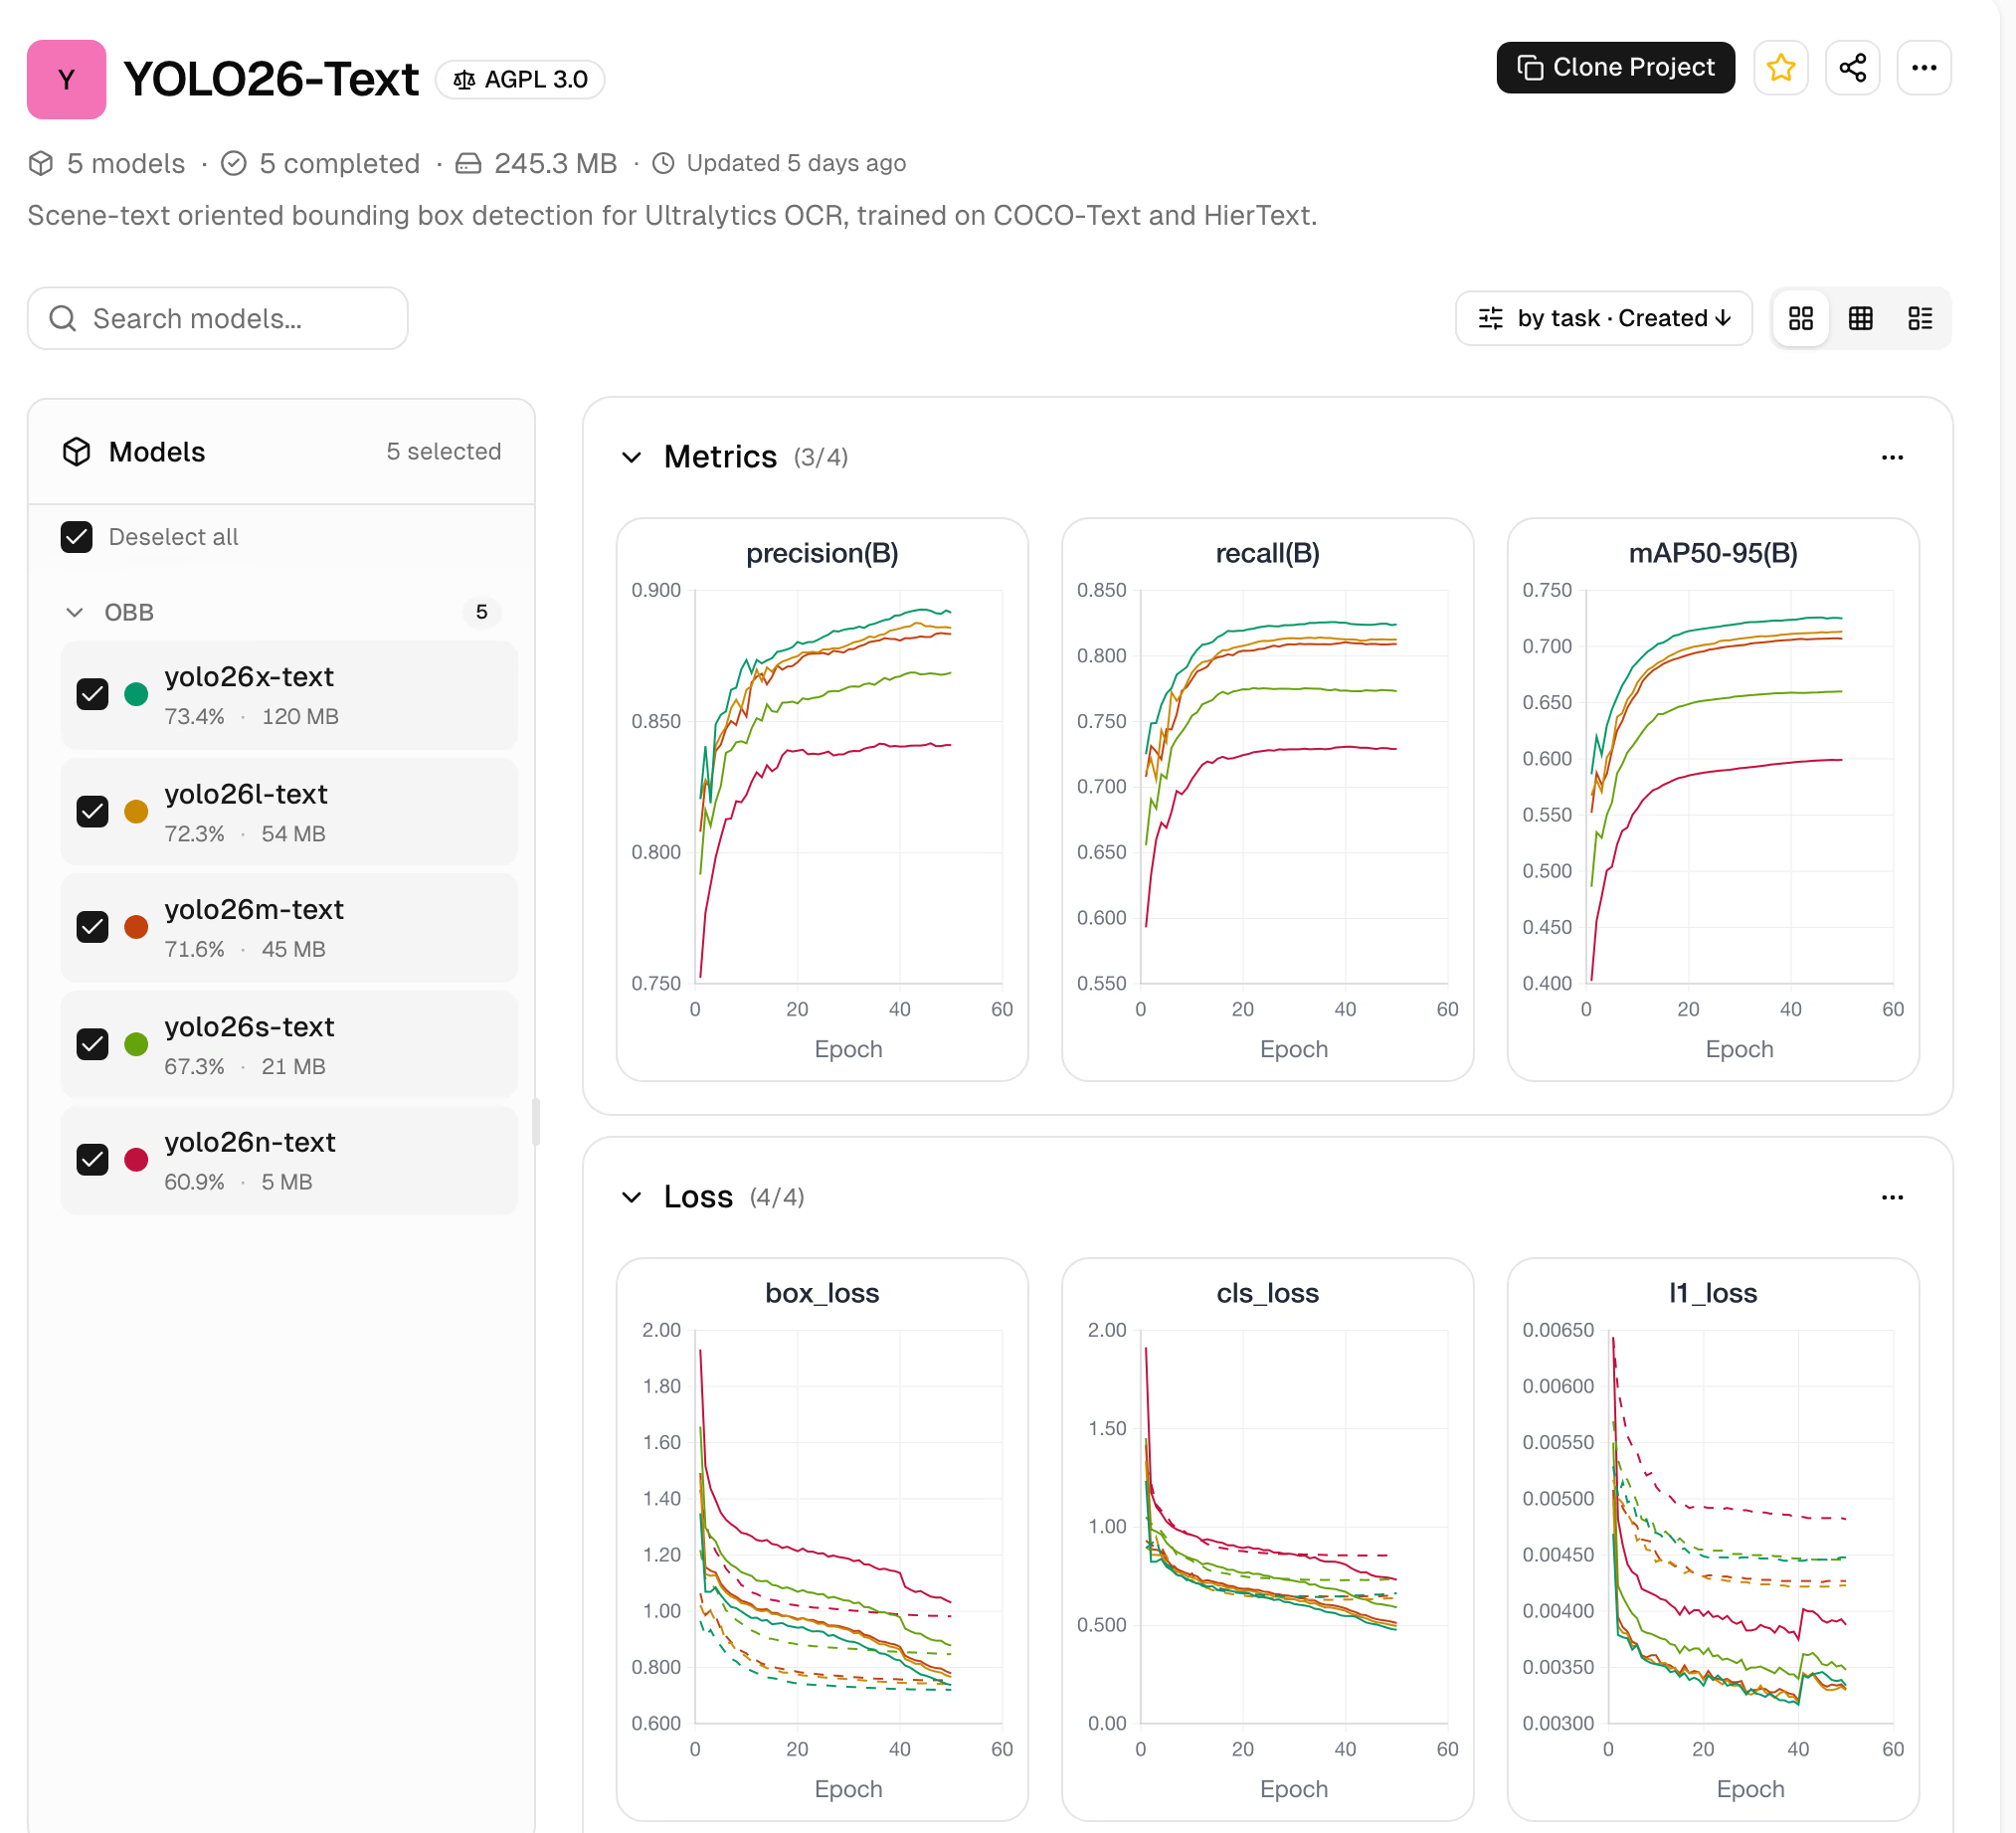
Ultralytics Platform'daki YOLO26-Text projesi: eğitim sırasında beş algılayıcı boyutunun tümü ve bunların kesinlik, duyarlılık, mAP50-95 ile kayıp eğrileri.
Belgelerine uyarlamak için, COCO-Text ile HierText'i yaklaşık 1,29 milyon sözcük çokgenine sahip 65.325 görüntüde birleştiren Scene Text OBB veri kümesiyle başla.
Sınırlamaları şunlardır:
- Alfabeler. Varsayılan tanıyıcı henüz Kiril, Korece, Arapça, İbranice, Devanagari veya Tayca okuyamıyor. Algılayıcıyı kendi tanıyıcınla eşleştir veya bu alfabeleri kapsayan bir motor seç.
- Birden çok yön. Çözüm tüm sayfayı baskın metin yönüne göre döndürür; bu nedenle tek sayfada farklı yönlerde ilerleyen metinler, örneğin dikey bir kenar notu, daha kötü okunabilir.
- Dışa aktarma. Tanıyıcı, dışa aktarılmış algılayıcı dosyasına gömülü değildir. Bu nedenle algılayıcıyı ve tanıma çalışma zamanını yan yana dağıt veya bağlayıcı olarak Python çözümünü kullanmaya devam et.
- Rust. Ultralytics Inference, Rust'ta aynı PP-OCRv6 tanıyıcısını
ultralytics-inference predict --ocrüzerinden kullanarak sahne metnini okur; ancak yönü, Python çözümündeki sayfa döndürme adımı yerine bir sınıflandırıcıyla ele alır. - Gizlilik. Python çözümü kendi donanımında çalışır; böylece sayfaların makinelerinden ayrılması gerekmez. Tarayıcı demosu ise çıkarım için sayfaları yükler. Okunmaması gereken alanlar için OCR çalışmadan önce bilinen bölgeleri opak bir maskeyle kapat.
Formlar ve sözleşmeler için özel bir YOLO modeli önce alanları, tabloları, imzaları ve damgaları bulabilir; böylece yalnızca ihtiyacın olan bölgeleri okursun. Ultralytics Platform'daki Signature veri kümesi ve akıllı belge analizi kılavuzumuz iyi başlangıç noktalarıdır. Ayrıca Ultralytics Platform, sayfaları etiketlemene ve bu modeli tek bir yerde eğitmene olanak tanır. Kendi sayfanda OCR'ı önceden denemek için bir görüntüyü veya PDF'yi canlı OCR demosuna bırak.
Sık sorulan sorular
pip install -U "ultralytics>=8.4.211"ile Ultralytics paketini yükle, ardından OpenCV ile yüklediğin görüntü üzerindesolutions.OCR()çağrısını yap. Çağrı, tanınan sözcükleri metinleri, güven puanları, satır numaraları ve çokgenleriyle birlikte okuma sırasına göre döndürür. İlk çalıştırmada YOLO26-Text algılayıcısı ile PP-OCRv6 tanıyıcısı otomatik olarak indirilir.Seçim belgelerine, dillerine ve donanımına bağlıdır; popüler açık kaynak OCR modelleri hakkındaki genel bakışımız başlıca seçenekleri karşılaştırıyor. Görüntü boyutunun 1280 olduğu RTX PRO 6000 üzerindeki kıyaslamamızda PP-OCRv6 ile YOLO26x-Text, altı PDF sayfasında 0.931 ve 80 HierText fotoğrafında 0.722 sözcük F1 puanı aldı; ayrıca sayfaları her dönüş açısında okuyabiliyor. Henüz kapsamadığı Kiril veya Korece gibi alfabeler için o alfabede eğitilmiş bir tanıyıcı kullan.
Bir YOLO modeli metni algılar ama okuyamaz. Ultralytics YOLO26-Text, metni yönlendirilmiş kutular olarak algılar; OCR çözümü ise her kırpımı PP-OCRv6 tanıyıcısına aktarır. Böylece ikisi birlikte, tek çağrıda tam OCR gerçekleştirir.
Evet. Her PDF sayfasını bir görüntüye dönüştür; örneğin PyMuPDF'nin
get_pixmapözelliğini kullan, görüntüyü BGR'ye çevir vesolutions.OCR()'e ilet. Tarayıcıda demo ve Platform Predict sekmesi bir PDF kabul eder ve ilk sayfasını okur.Evet. PP-OCRv6, CPU'da ONNX Runtime veya CUDA GPU'larda çalışır ve aynı betik her ikisinde de çalışır. İsteğe bağlı TensorRT tanıyıcısı için NVIDIA GPU gerekir.
Varsayılan tanıyıcıyla henüz değil. PP-OCRv6 Çince, Japonca ve Latin alfabesi kullanan dilleri destekler; ancak Kiril alfabesini, Hangıl'ı, Arap alfabesini, İbraniceyi, Devanagari'yi veya Taycayı desteklemez. YOLO26-Text algılayıcısını kullanmaya devam edip bu yazı sistemi için eğitilmiş bir tanıyıcı iletebilirsin.
Yazan
Kıdemli Makine Öğrenimi Mühendisi · Ultralytics
Yorumlar
Soru sor, sonuçlarını paylaş veya başka birine yardım et.









