Phân đoạn ngữ nghĩa và phân đoạn instance: Cách chọn tác vụ phù hợp
Phân đoạn ngữ nghĩa gán nhãn lớp cho từng pixel; phân đoạn instance tách riêng từng đối tượng. Tìm hiểu tác vụ nào phù hợp với dự án computer vision của bạn và lý do.
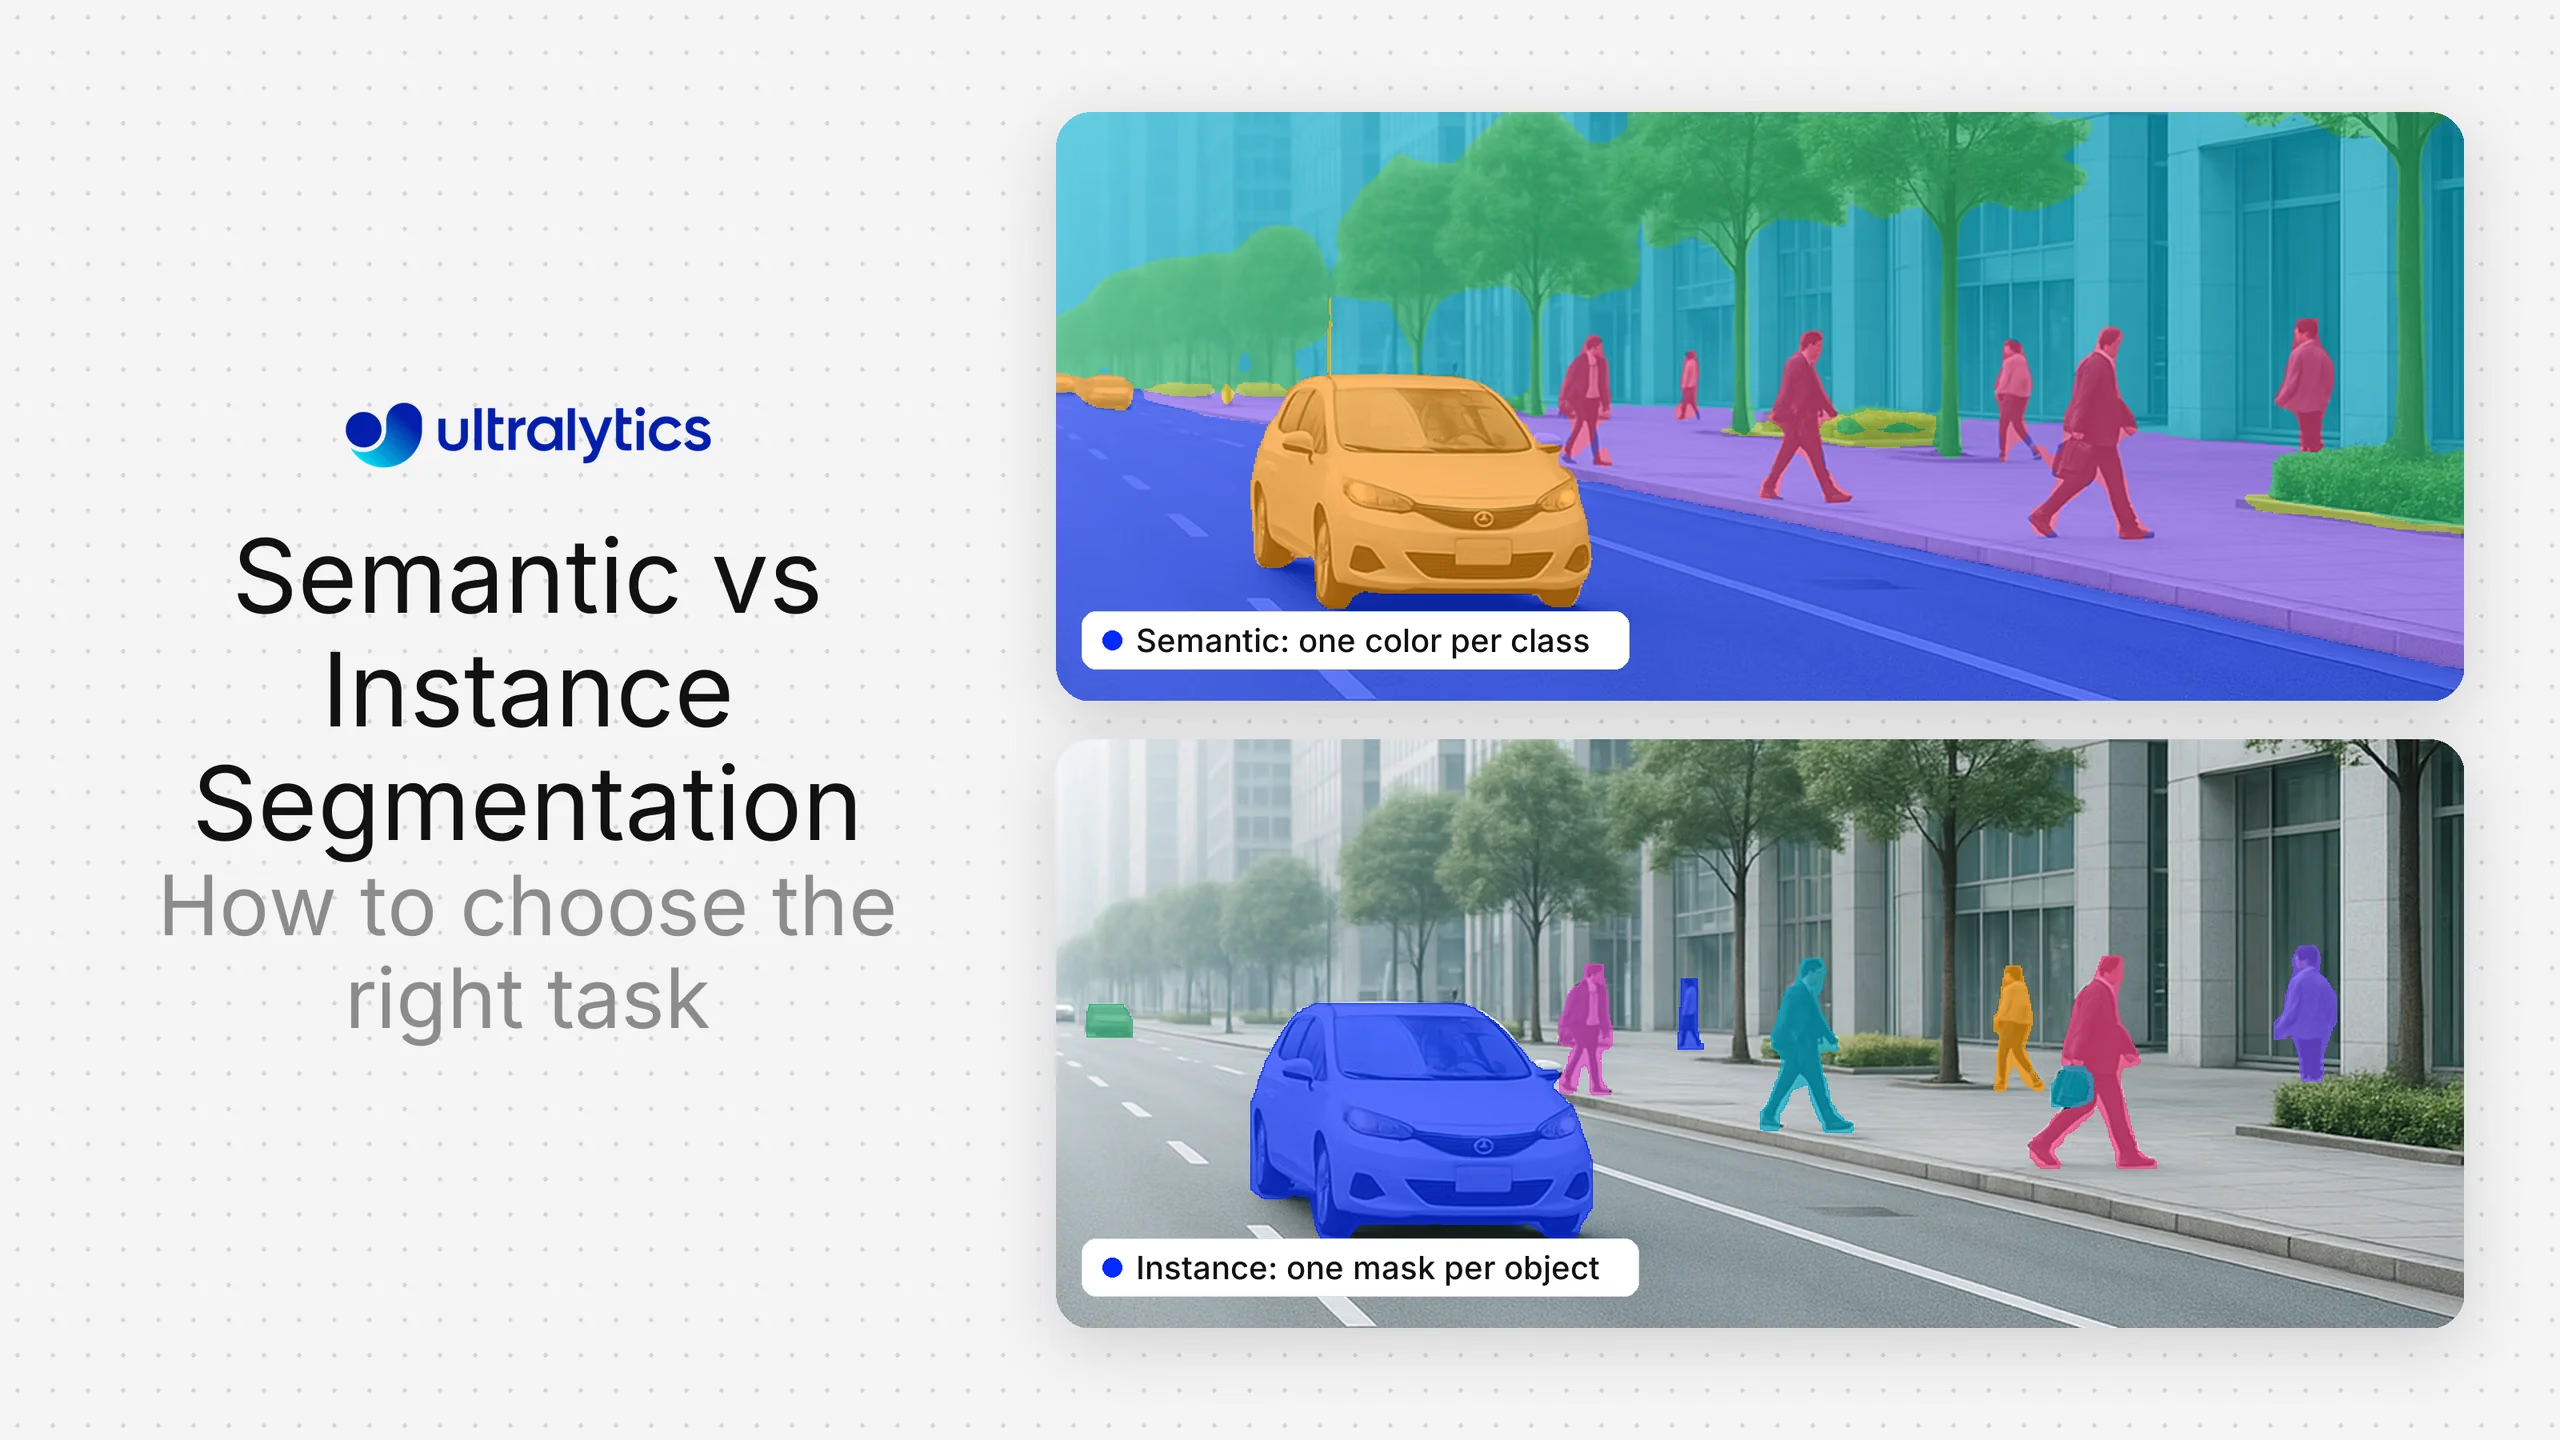
Semantic segmentation và instance segmentation đều gán nhãn ảnh ở cấp pixel, nhưng trả lời các câu hỏi khác nhau. Semantic segmentation gán một lớp cho từng pixel, vì vậy tất cả ô tô trong cảnh sẽ hợp thành một vùng "car". Instance segmentation tách từng đối tượng, nên mỗi ô tô có mask riêng. Việc lựa chọn phụ thuộc vào một câu hỏi: bạn cần biết đối tượng gì nằm ở mỗi pixel, hay pixel đó thuộc về đối tượng nào? Hướng dẫn này giúp bạn đưa ra lựa chọn. Hướng dẫn cũng đề cập chi phí gán nhãn cho từng tác vụ và cách đánh giá chúng. Ultralytics YOLO hỗ trợ cả hai tác vụ trong cùng một framework.
Khác biệt trong một câu#
- Semantic segmentation phân loại từng pixel thành một nhóm, chẳng hạn như đường, trời, người hoặc ô tô. Các đối tượng cùng lớp được gộp thành một vùng. Xem mục thuật ngữ semantic segmentation.
- Instance segmentation phát hiện từng đối tượng riêng lẻ và cấp cho mỗi đối tượng một mask cùng ID riêng. Tác vụ này thường bao gồm các đối tượng có thể đếm được và bỏ qua nền như trời hoặc cỏ. Xem mục thuật ngữ instance segmentation.
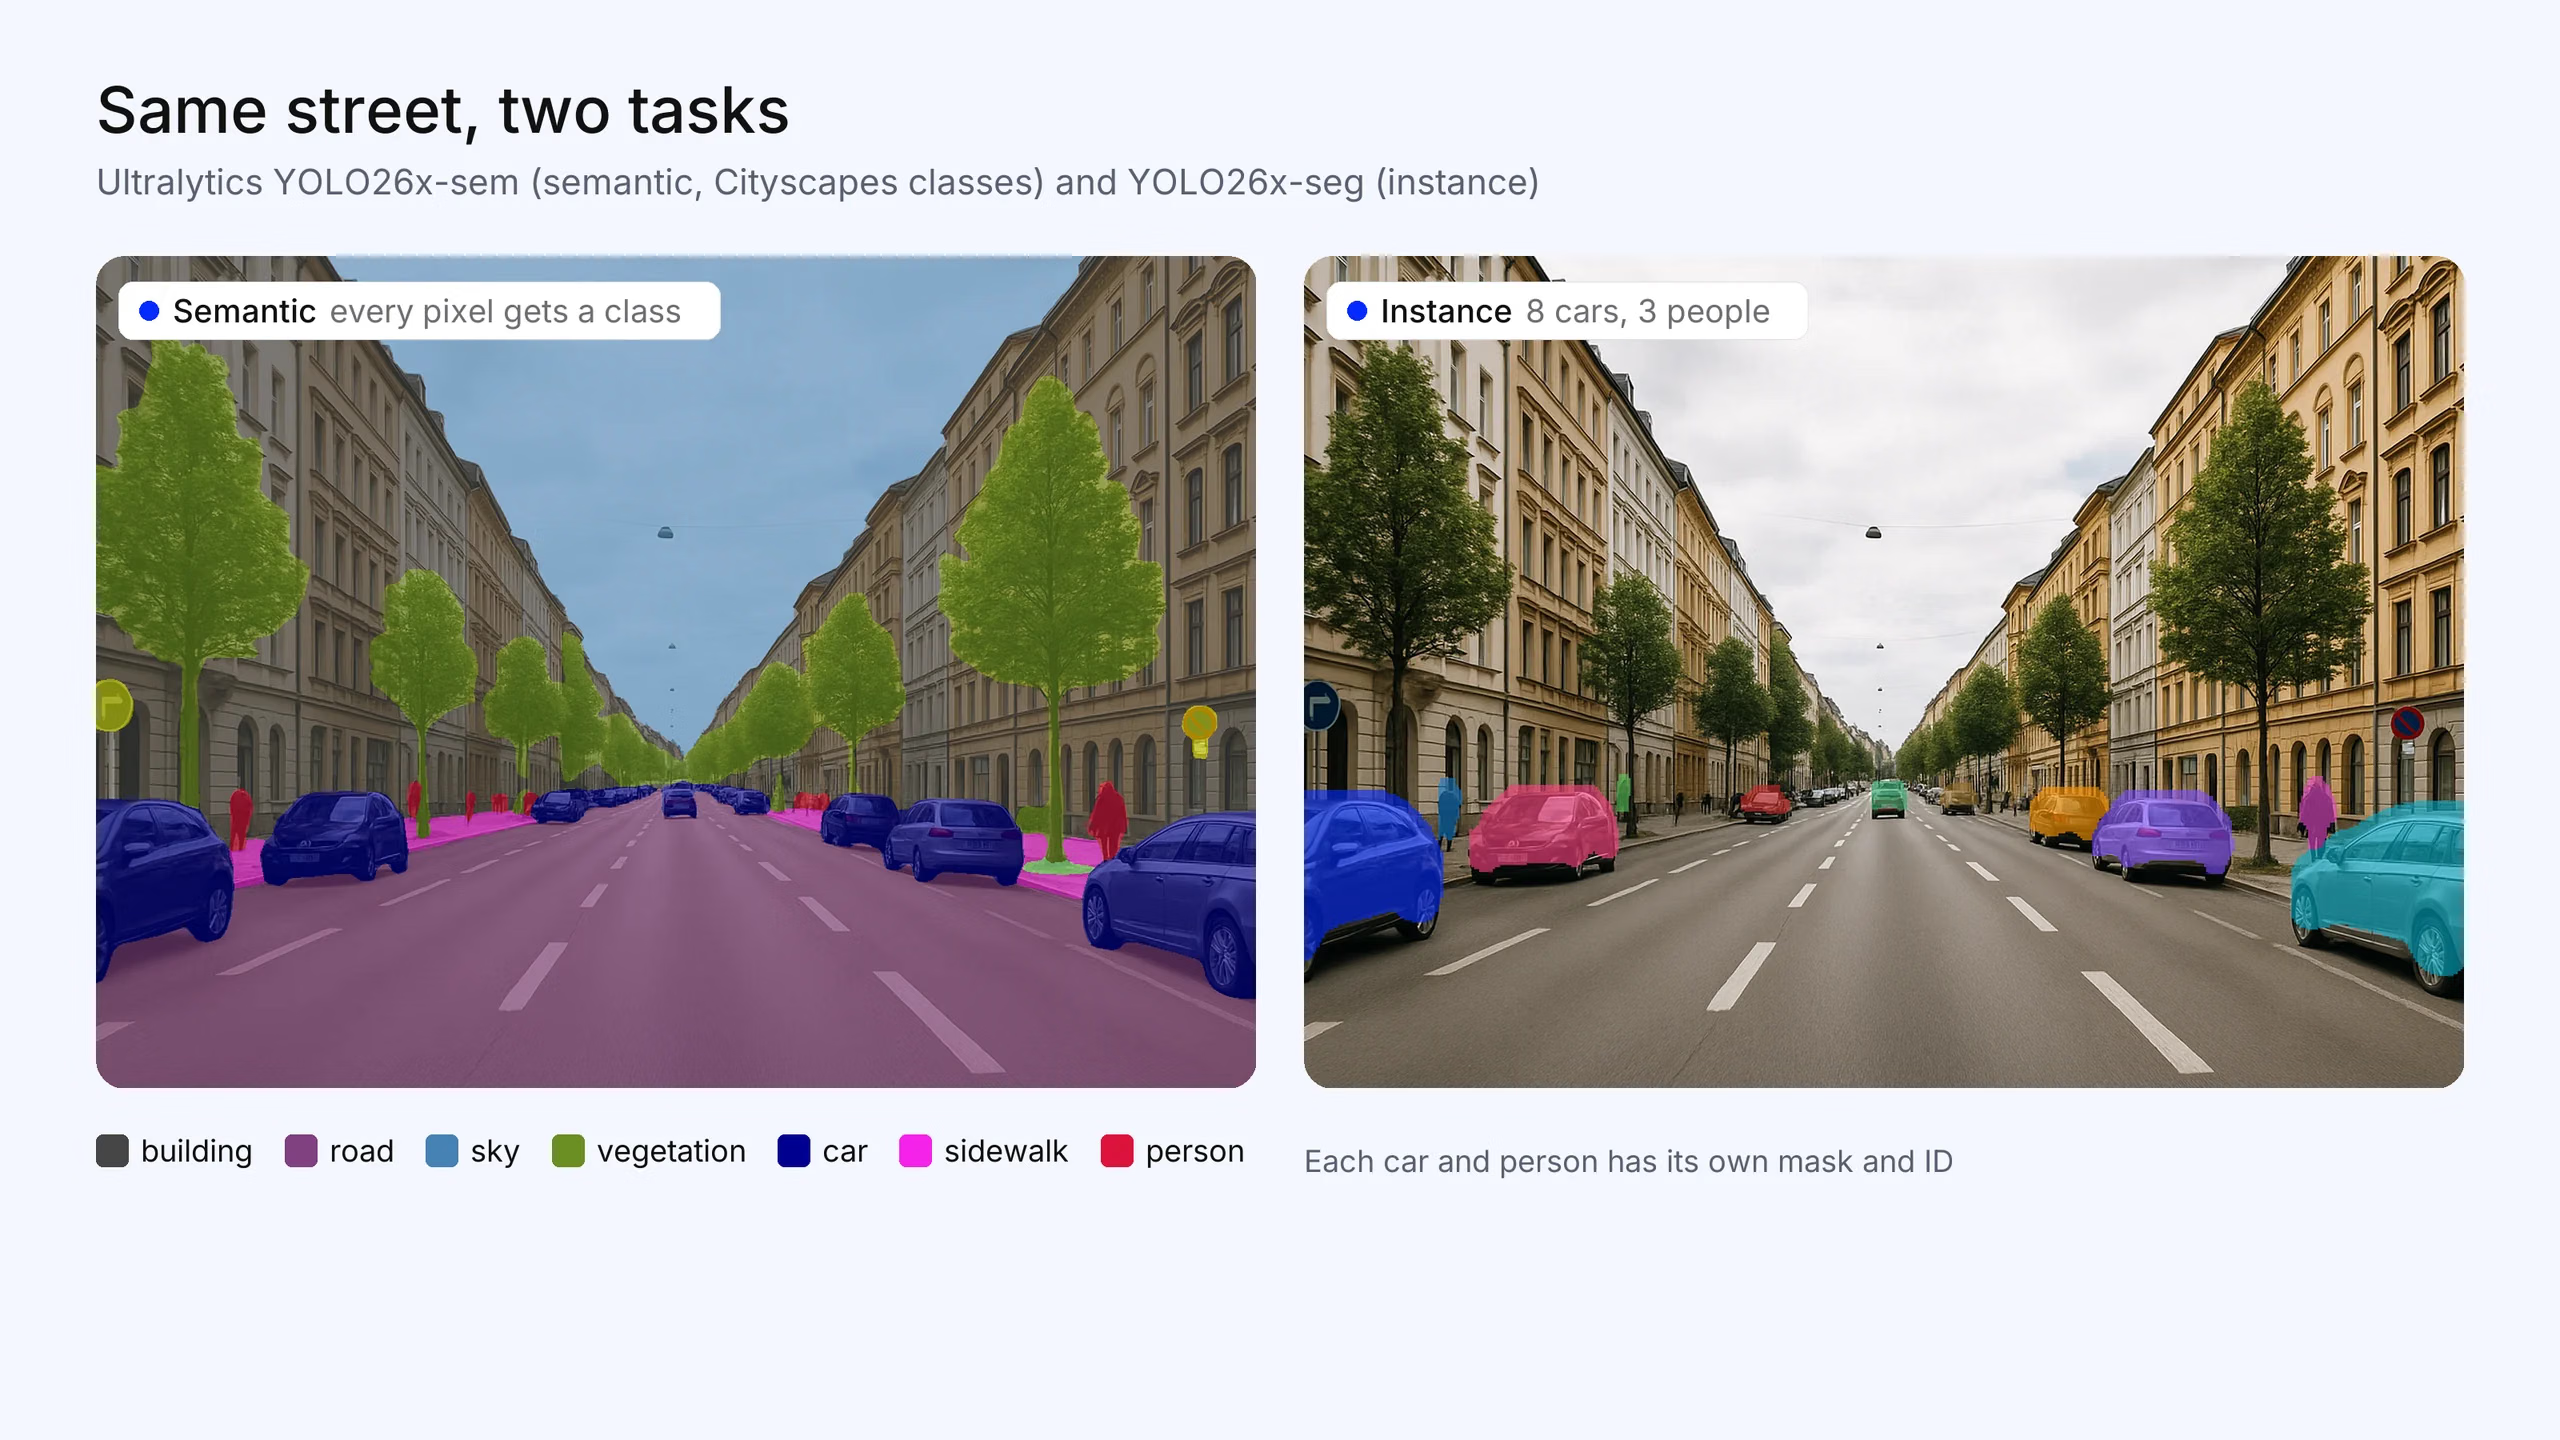
Hình 1. Cùng một con phố với cả hai tác vụ. Ultralytics YOLO26x-sem (các lớp Cityscapes) gán nhãn từng pixel, nên tất cả ô tô đều thuộc cùng lớp "car". Ultralytics YOLO26x-seg cấp mask riêng cho từng chiếc trong số 8 ô tô và 3 người được phát hiện (độ tin cậy từ 0.5 trở lên). Ảnh được tạo cho bài viết này; các mask là đầu ra thực tế của model.
Dự án của bạn cần tác vụ nào?#
Hãy bắt đầu từ câu hỏi mà ứng dụng của bạn cần trả lời:
| Nếu ứng dụng của bạn cần… | Sử dụng | Ví dụ |
|---|---|---|
| Biết phần nào của cảnh thuộc một lớp nhất định | Semantic | Vùng đường có thể chạy xe, tỷ lệ diện tích cây trồng so với cỏ dại, lớp phủ đất |
| Gán nhãn các vùng nền cẩn thận như các đối tượng | Semantic | Bầu trời, nước, thảm thực vật, loại mô trong ảnh chụp quét |
| Đếm đối tượng | Instance | Quả trên cây, người xếp hàng |
| Theo dõi đối tượng qua các frame video | Instance, kết hợp tracker | Người hoặc phương tiện di chuyển trong cảnh |
| Đo lường hoặc tác động lên từng đối tượng | Instance | Robot gắp một bộ phận khỏi đống, đo kích thước từng lỗi |
| Thực hiện cả hai: bao phủ toàn bộ cảnh và tách riêng từng đối tượng | Panoptic | Cảnh đường phố dành cho xe tự hành |
Nếu chưa chắc chắn, hãy tự hỏi liệu có cần phân biệt hai đối tượng cùng lớp đang chạm vào nhau hay không. Nếu có, bạn cần instance segmentation (hoặc panoptic). Nếu không, semantic segmentation đơn giản hơn và thường cần ít tài nguyên chạy hơn.
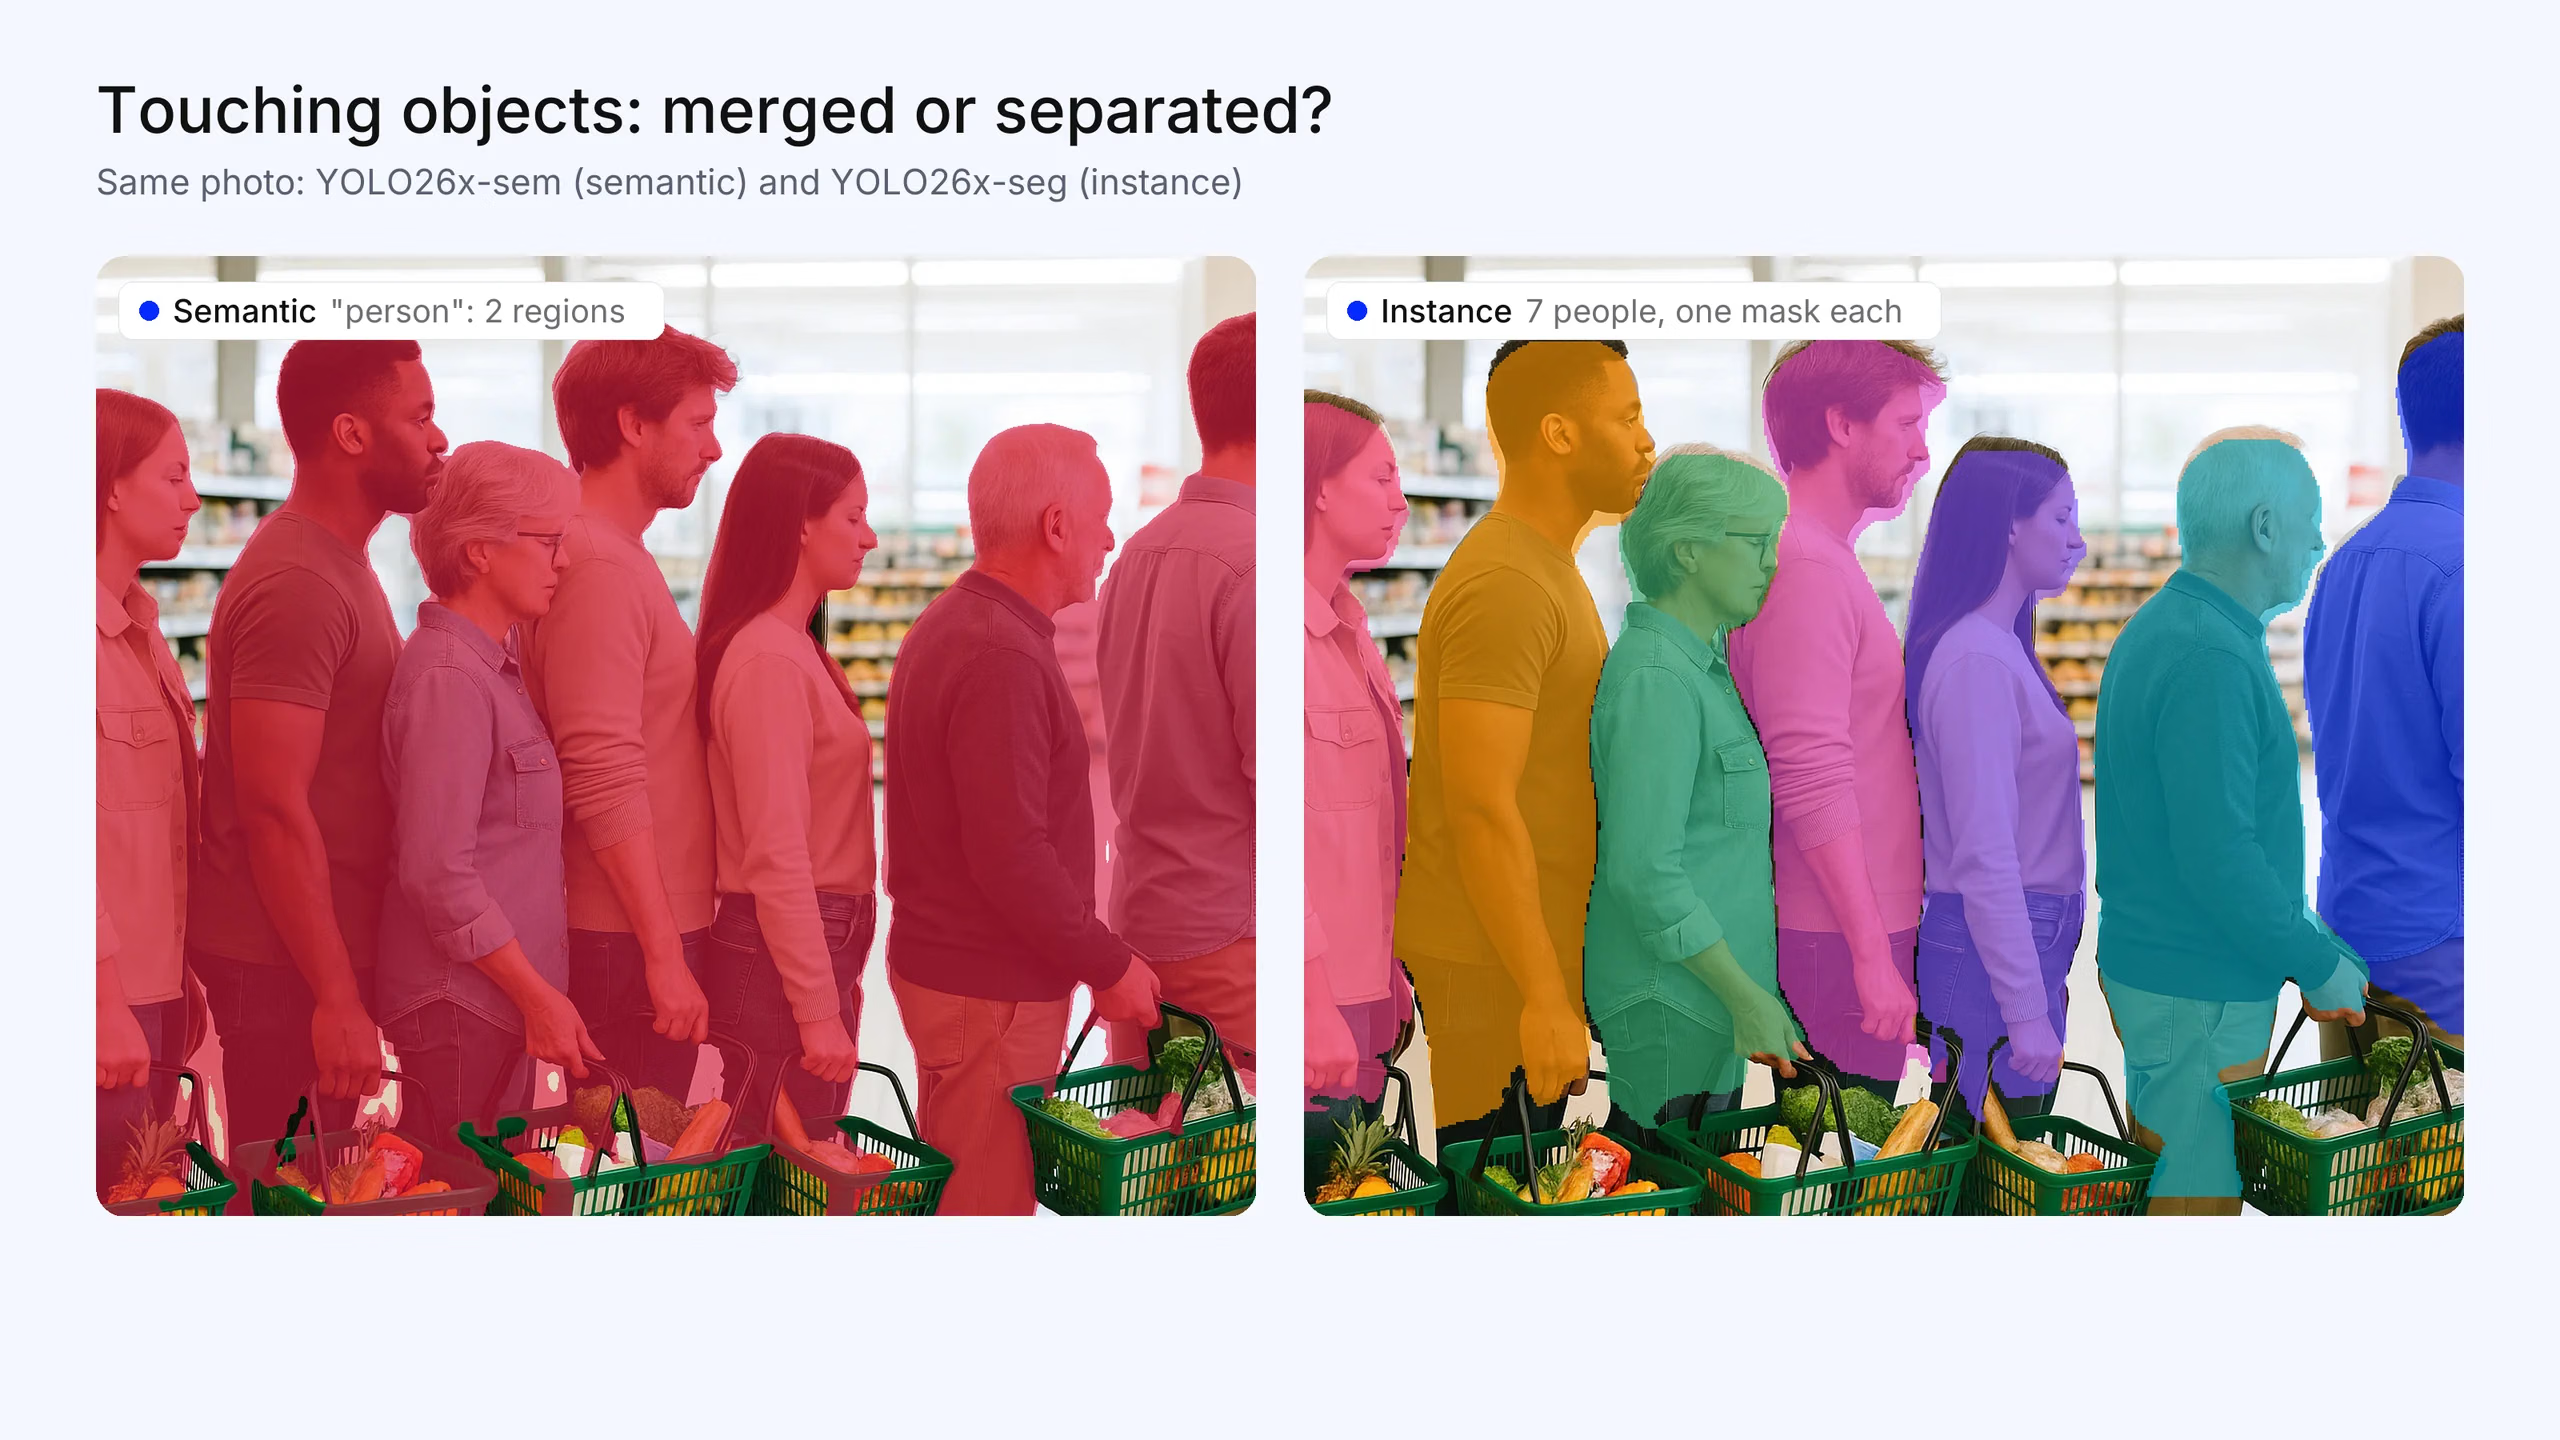
Hình 2. Bảy người mua sắm đứng sát nhau trong hàng chờ thanh toán. Trong đầu ra semantic (Ultralytics YOLO26x-sem), họ được gộp thành hai vùng "person" liền nhau, nên không thể đếm họ từ đầu ra này. Đầu ra instance (Ultralytics YOLO26x-seg) tách riêng cả 7 người. Ảnh được tạo cho bài viết này; các mask là đầu ra thực tế của model.
Các điểm khác biệt chính trong nháy mắt#
| Tiêu chí | Semantic segmentation | Phân đoạn đối tượng riêng lẻ |
|---|---|---|
| Câu hỏi được trả lời | Mỗi pixel thuộc lớp nào? | Mỗi pixel thuộc về đối tượng nào? |
| Các đối tượng cùng lớp | Được gộp thành một vùng | Được tách riêng, mỗi đối tượng có mask và ID riêng |
| Mức độ bao phủ | Mọi pixel, bao gồm cả nền | Thường chỉ bao gồm các đối tượng cần quan tâm |
| Đầu ra | Một bản đồ lớp có kích thước bằng ảnh | Danh sách mask, mỗi mask có lớp và độ tin cậy |
| Có thể đếm đối tượng không? | Không trực tiếp | Có |
| Metric chính | Intersection over Union trung bình (mIoU) | Average Precision trung bình của mask (mask mAP) |
| Độ phức tạp tương đối | Thấp hơn: phân loại theo từng pixel | Cao hơn: phát hiện kết hợp mask cho từng đối tượng |
Chi phí gán nhãn cho từng tác vụ#
Trong thực tế, công sức gán nhãn thường là yếu tố quyết định lựa chọn.
- Dataset semantic gán một lớp cho từng pixel trong mỗi ảnh, bao gồm cả nền. Chúng thường được lưu dưới dạng ảnh mask một kênh. Mỗi ảnh được gán nhãn đầy đủ, vì vậy không thể bỏ qua pixel nào trừ khi pixel đó được đánh dấu rõ ràng là "ignore".
- Dataset instance khoanh riêng từng đối tượng cần quan tâm bằng polygon hoặc mask. Có thể để nền không được gán nhãn, nhưng mỗi đối tượng cần có đường viền riêng, và cảnh đông đúc làm khối lượng công việc tăng lên nhiều lần.
Cả hai đều tốn nhiều công sức. Gán nhãn có hỗ trợ, trong đó thao tác nhấp hoặc box được chuyển thành mask, giúp giảm công sức cho cả hai tác vụ. Nếu bạn chỉ cần kết quả ở cấp vùng, đừng tốn chi phí cho nhãn instance.
Cách đánh giá từng tác vụ#
- Semantic segmentation chủ yếu được đo bằng mIoU: mức độ chồng lấp giữa vùng dự đoán và vùng thực tế, lấy trung bình trên các lớp. Độ chính xác pixel cũng được báo cáo. IoU là cùng một thước đo mức độ chồng lấp được dùng trong detection.
- Instance segmentation được đo bằng mask mAP, tức mean Average Precision dùng trong detection nhưng được tính dựa trên mức độ chồng lấp của mask. Metric này đánh giá khả năng tìm ra từng đối tượng, chứ không chỉ bao phủ đúng các pixel.
Không thể so sánh trực tiếp các metric này với nhau. mIoU cao không cho biết liệu các đối tượng riêng lẻ đã được tách biệt hay chưa.
Panoptic segmentation: khi bạn cần cả hai#
Panoptic segmentation gán một lớp cho mọi pixel và cấp ID instance cho các đối tượng có thể đếm được. Các vùng nền như đường và trời được gán nhãn theo ngữ nghĩa. Các đối tượng tiền cảnh như ô tô và người được tách riêng từng đối tượng. Tác vụ này được đo bằng Panoptic Quality (PQ). Hãy chọn khi bạn đồng thời cần bao phủ toàn bộ cảnh và tách riêng từng đối tượng. Xem panoptic segmentation.
Tóm tắt cách hoạt động của từng loại#
Model semantic segmentation thường là mạng encoder-decoder dự đoán một lớp cho từng pixel. U-Net, DeepLab và SegFormer là những ví dụ nổi tiếng. Model instance segmentation thường được xây dựng dựa trên object detection. Mask R-CNN dự đoán mask bên trong từng box được phát hiện, trong khi model một giai đoạn như YOLACT và model segmentation Ultralytics YOLO dự đoán box và mask trong một lượt để phục vụ ứng dụng thời gian thực. Các kiến trúc phổ quát như Mask2Former xử lý semantic, instance và panoptic segmentation trong cùng một model. Để tìm hiểu thêm về instance segmentation, hãy xem instance segmentation là gì.
Cả hai tác vụ trong Ultralytics YOLO#
Ultralytics YOLO chạy cả hai tác vụ thông qua cùng một Python API và CLI:
- Phân đoạn instance sử dụng tác vụ
segment. - Phân đoạn ngữ nghĩa sử dụng tác vụ
semantic. Các model ngữ nghĩa YOLO26 có hậu tố-semvà được huấn luyện trước trên Cityscapes và ADE20K. Trang tác vụ có bảng minh họa chính xác sự khác biệt giữa đầu ra của hai tác vụ trong code.
Có thể huấn luyện cả hai tác vụ trên máy cục bộ hoặc trên cloud thông qua Ultralytics Platform.
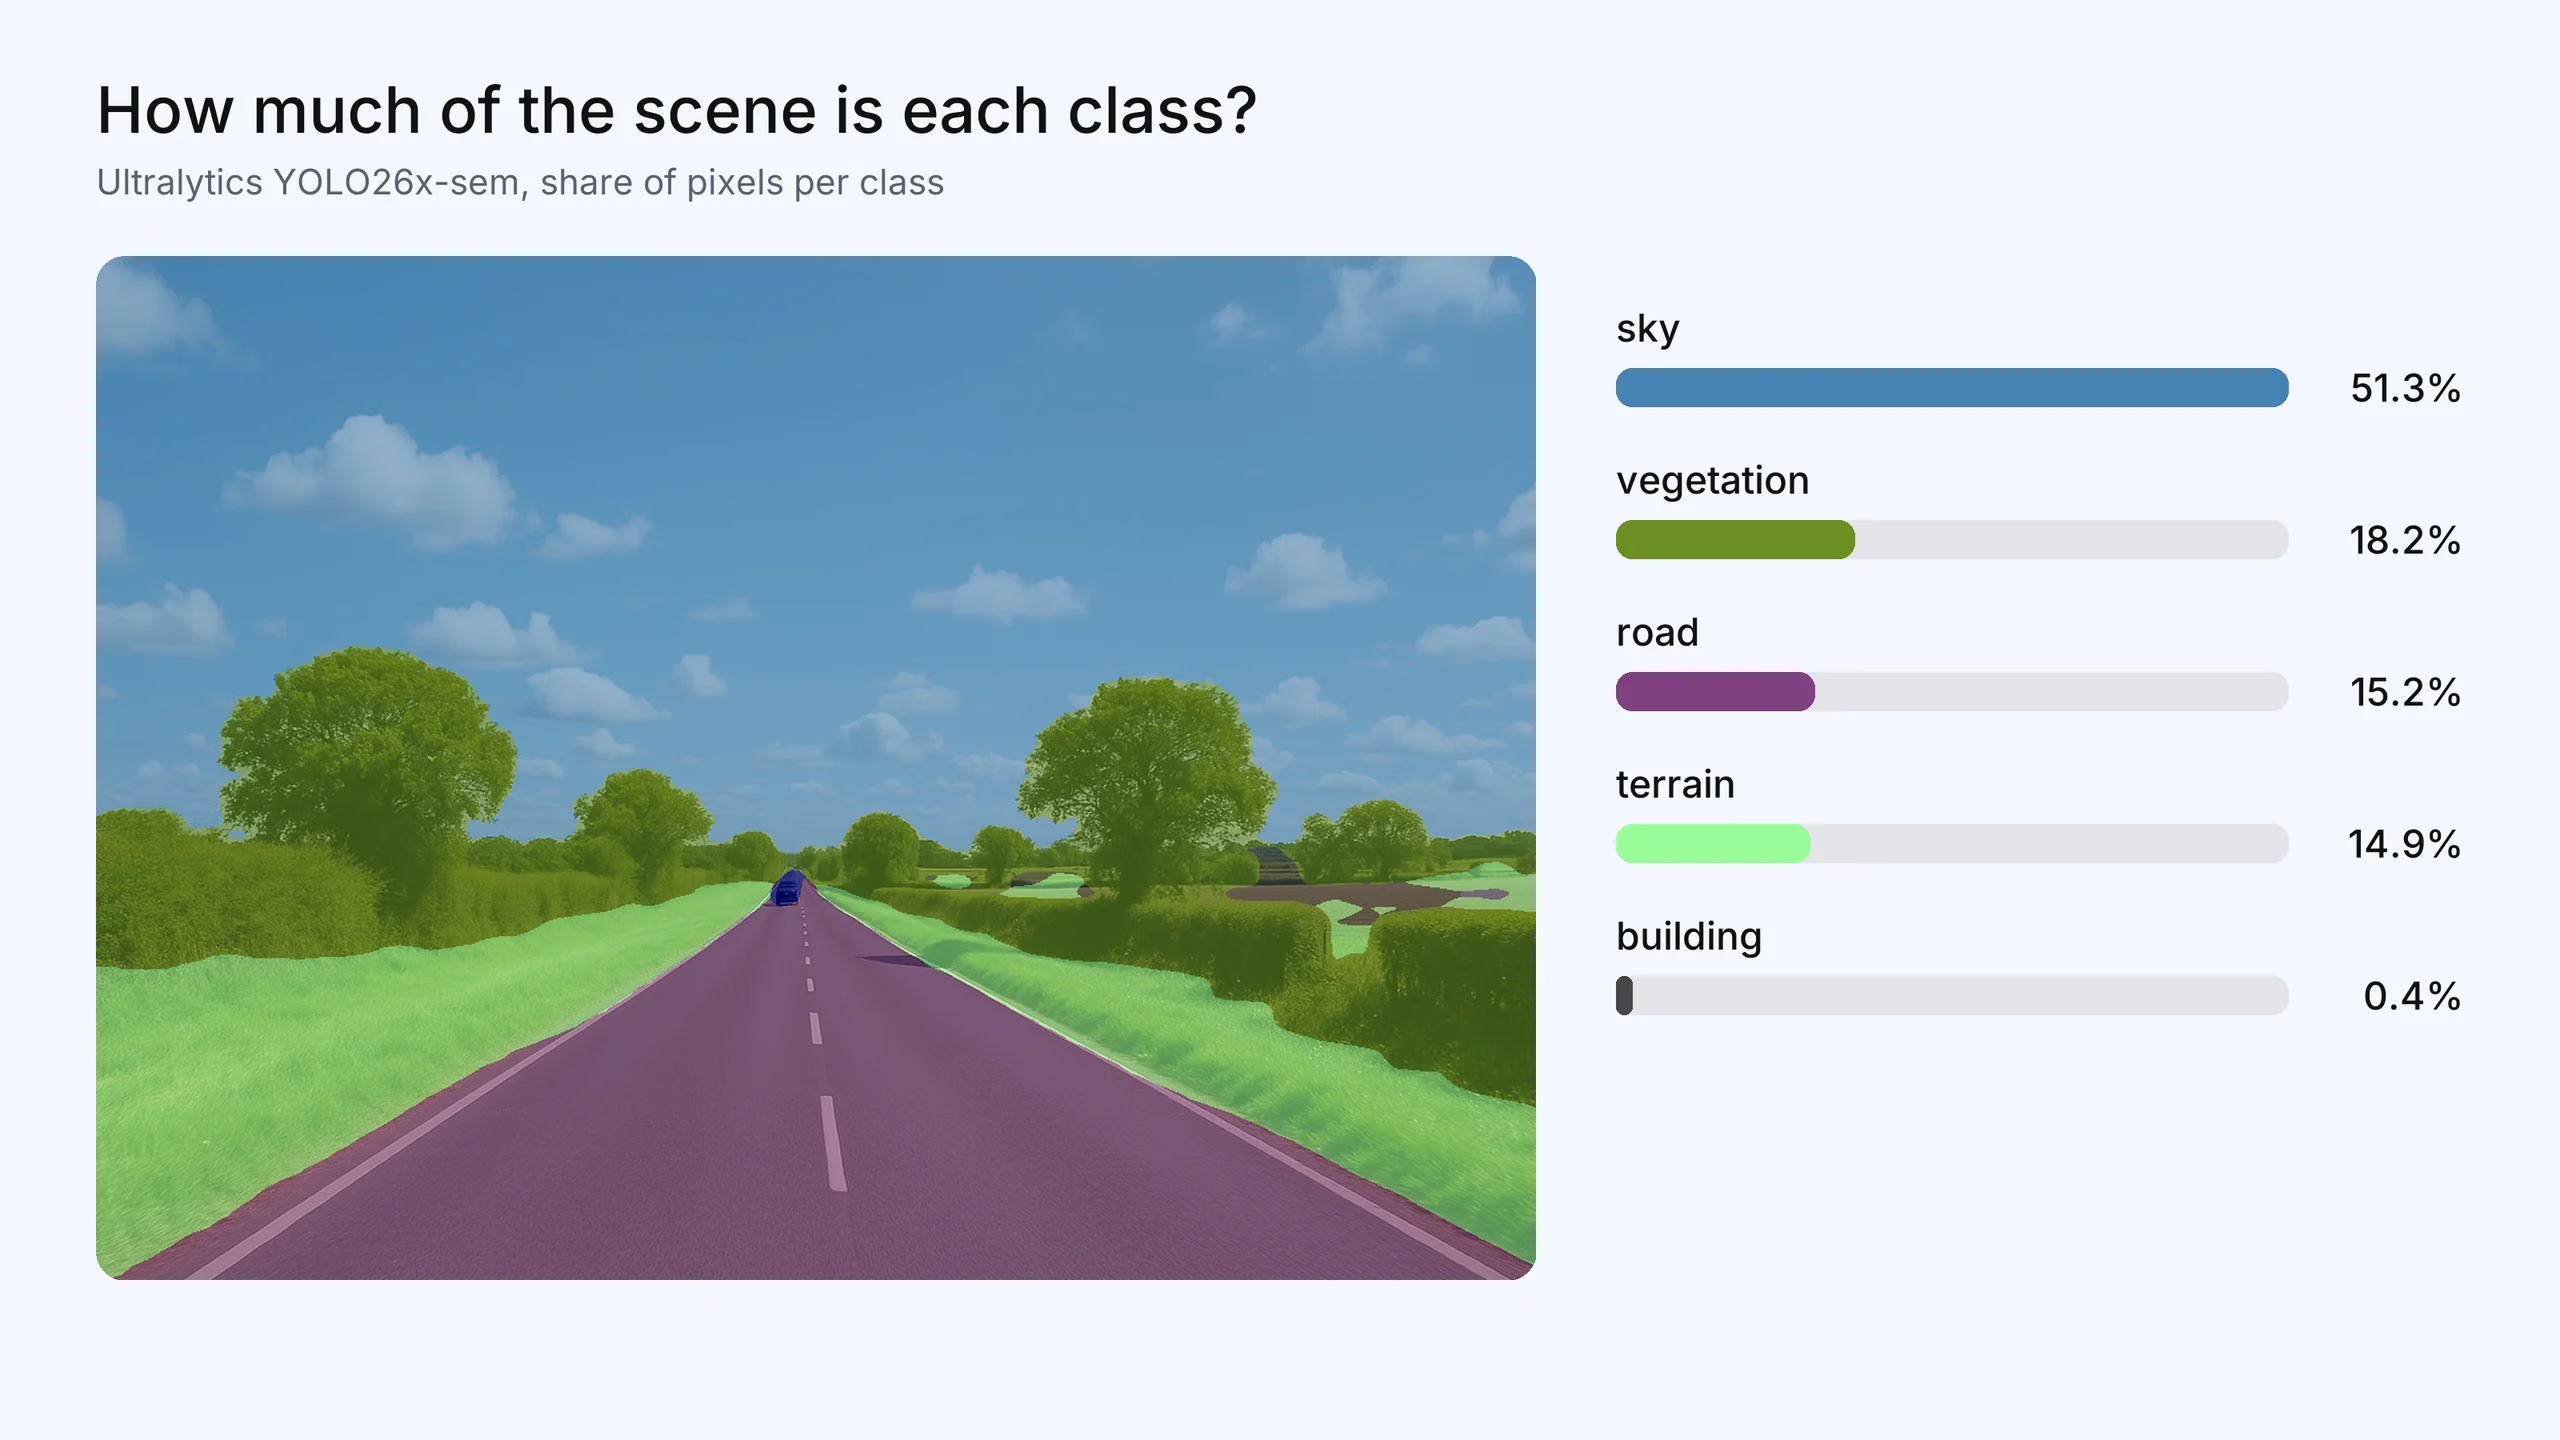
Hình 3. Phân đoạn ngữ nghĩa trả lời câu hỏi "mỗi lớp chiếm bao nhiêu phần của cảnh". Ultralytics YOLO26x-sem gán nhãn 51.3% khung hình này là bầu trời, 18.2% là thảm thực vật, 15.2% là đường và 14.9% là địa hình. Ảnh được tạo cho bài viết này; bản đồ lớp và tỷ lệ là đầu ra thực tế của model.
Câu hỏi thường gặp
Phân đoạn ngữ nghĩa gán nhãn một lớp cho từng pixel nhưng xem tất cả đối tượng cùng lớp là một vùng duy nhất. Phân đoạn instance tách từng đối tượng thành mask riêng, nhờ đó có thể đếm và theo dõi riêng từng đối tượng cùng lớp.
Hãy cân nhắc xem có cần phân biệt hai đối tượng cùng lớp đang chạm nhau hay không. Nếu cần đếm, theo dõi hoặc tác động lên từng đối tượng riêng lẻ, hãy dùng phân đoạn instance. Nếu chỉ cần biết các vùng thuộc lớp nào, phân đoạn ngữ nghĩa sẽ đơn giản hơn.
Mask R-CNN là model phân đoạn instance. Model phát hiện từng đối tượng, sau đó dự đoán một mask pixel riêng bên trong bounding box của đối tượng đó.
Phân đoạn instance thường khó hơn. Phương pháp này phải phân loại pixel đồng thời tách riêng các đối tượng cùng lớp, đòi hỏi cả phát hiện lẫn phân đoạn.
Chủ yếu bằng giao trên hợp trung bình (mIoU), tức mức độ chồng lấp trung bình giữa các vùng dự đoán và vùng thực tế trên các lớp. Phân đoạn instance sử dụng mAP của mask, còn phân đoạn toàn cảnh sử dụng Chất lượng toàn cảnh (PQ).









