Các model phân loại ảnh tốt nhất: Cách lựa chọn
So sánh các model phân loại ảnh hàng đầu, từ ConvNeXt V2 và DINOv3 đến EfficientNetV2, ViT và Ultralytics YOLO26-cls, đồng thời tìm hiểu cách lựa chọn.
Không có một model phân loại ảnh nào tốt nhất trong mọi trường hợp. Lựa chọn phù hợp phụ thuộc vào lượng dữ liệu đã gán nhãn bạn có, nơi model cần chạy và việc giấy phép của model có cho phép bạn sử dụng hay không. Năm 2026, các ứng dụng ưu tiên độ chính xác tập trung vào những backbone Transformer lớn và tự giám sát như DINOv3 và EVA-02. Để triển khai trên phần cứng hạn chế, các model nhỏ hơn, chủ yếu dựa trên tích chập, như ConvNeXt V2, EfficientNetV2, MobileNetV4 và Ultralytics YOLO26-cls thường thiết thực hơn, tùy thuộc vào kích thước checkpoint, quy trình huấn luyện và phần cứng đích. Hãy so sánh độ chính xác và độ trễ trên workload của riêng bạn. Hướng dẫn này giải thích bốn họ model, so sánh mười model được sử dụng rộng rãi và đưa ra quy trình lựa chọn.
Nếu bạn chưa quen với chính tác vụ này, hãy bắt đầu với tìm hiểu phân loại ảnh là gì. Trang này tập trung vào việc chọn model.
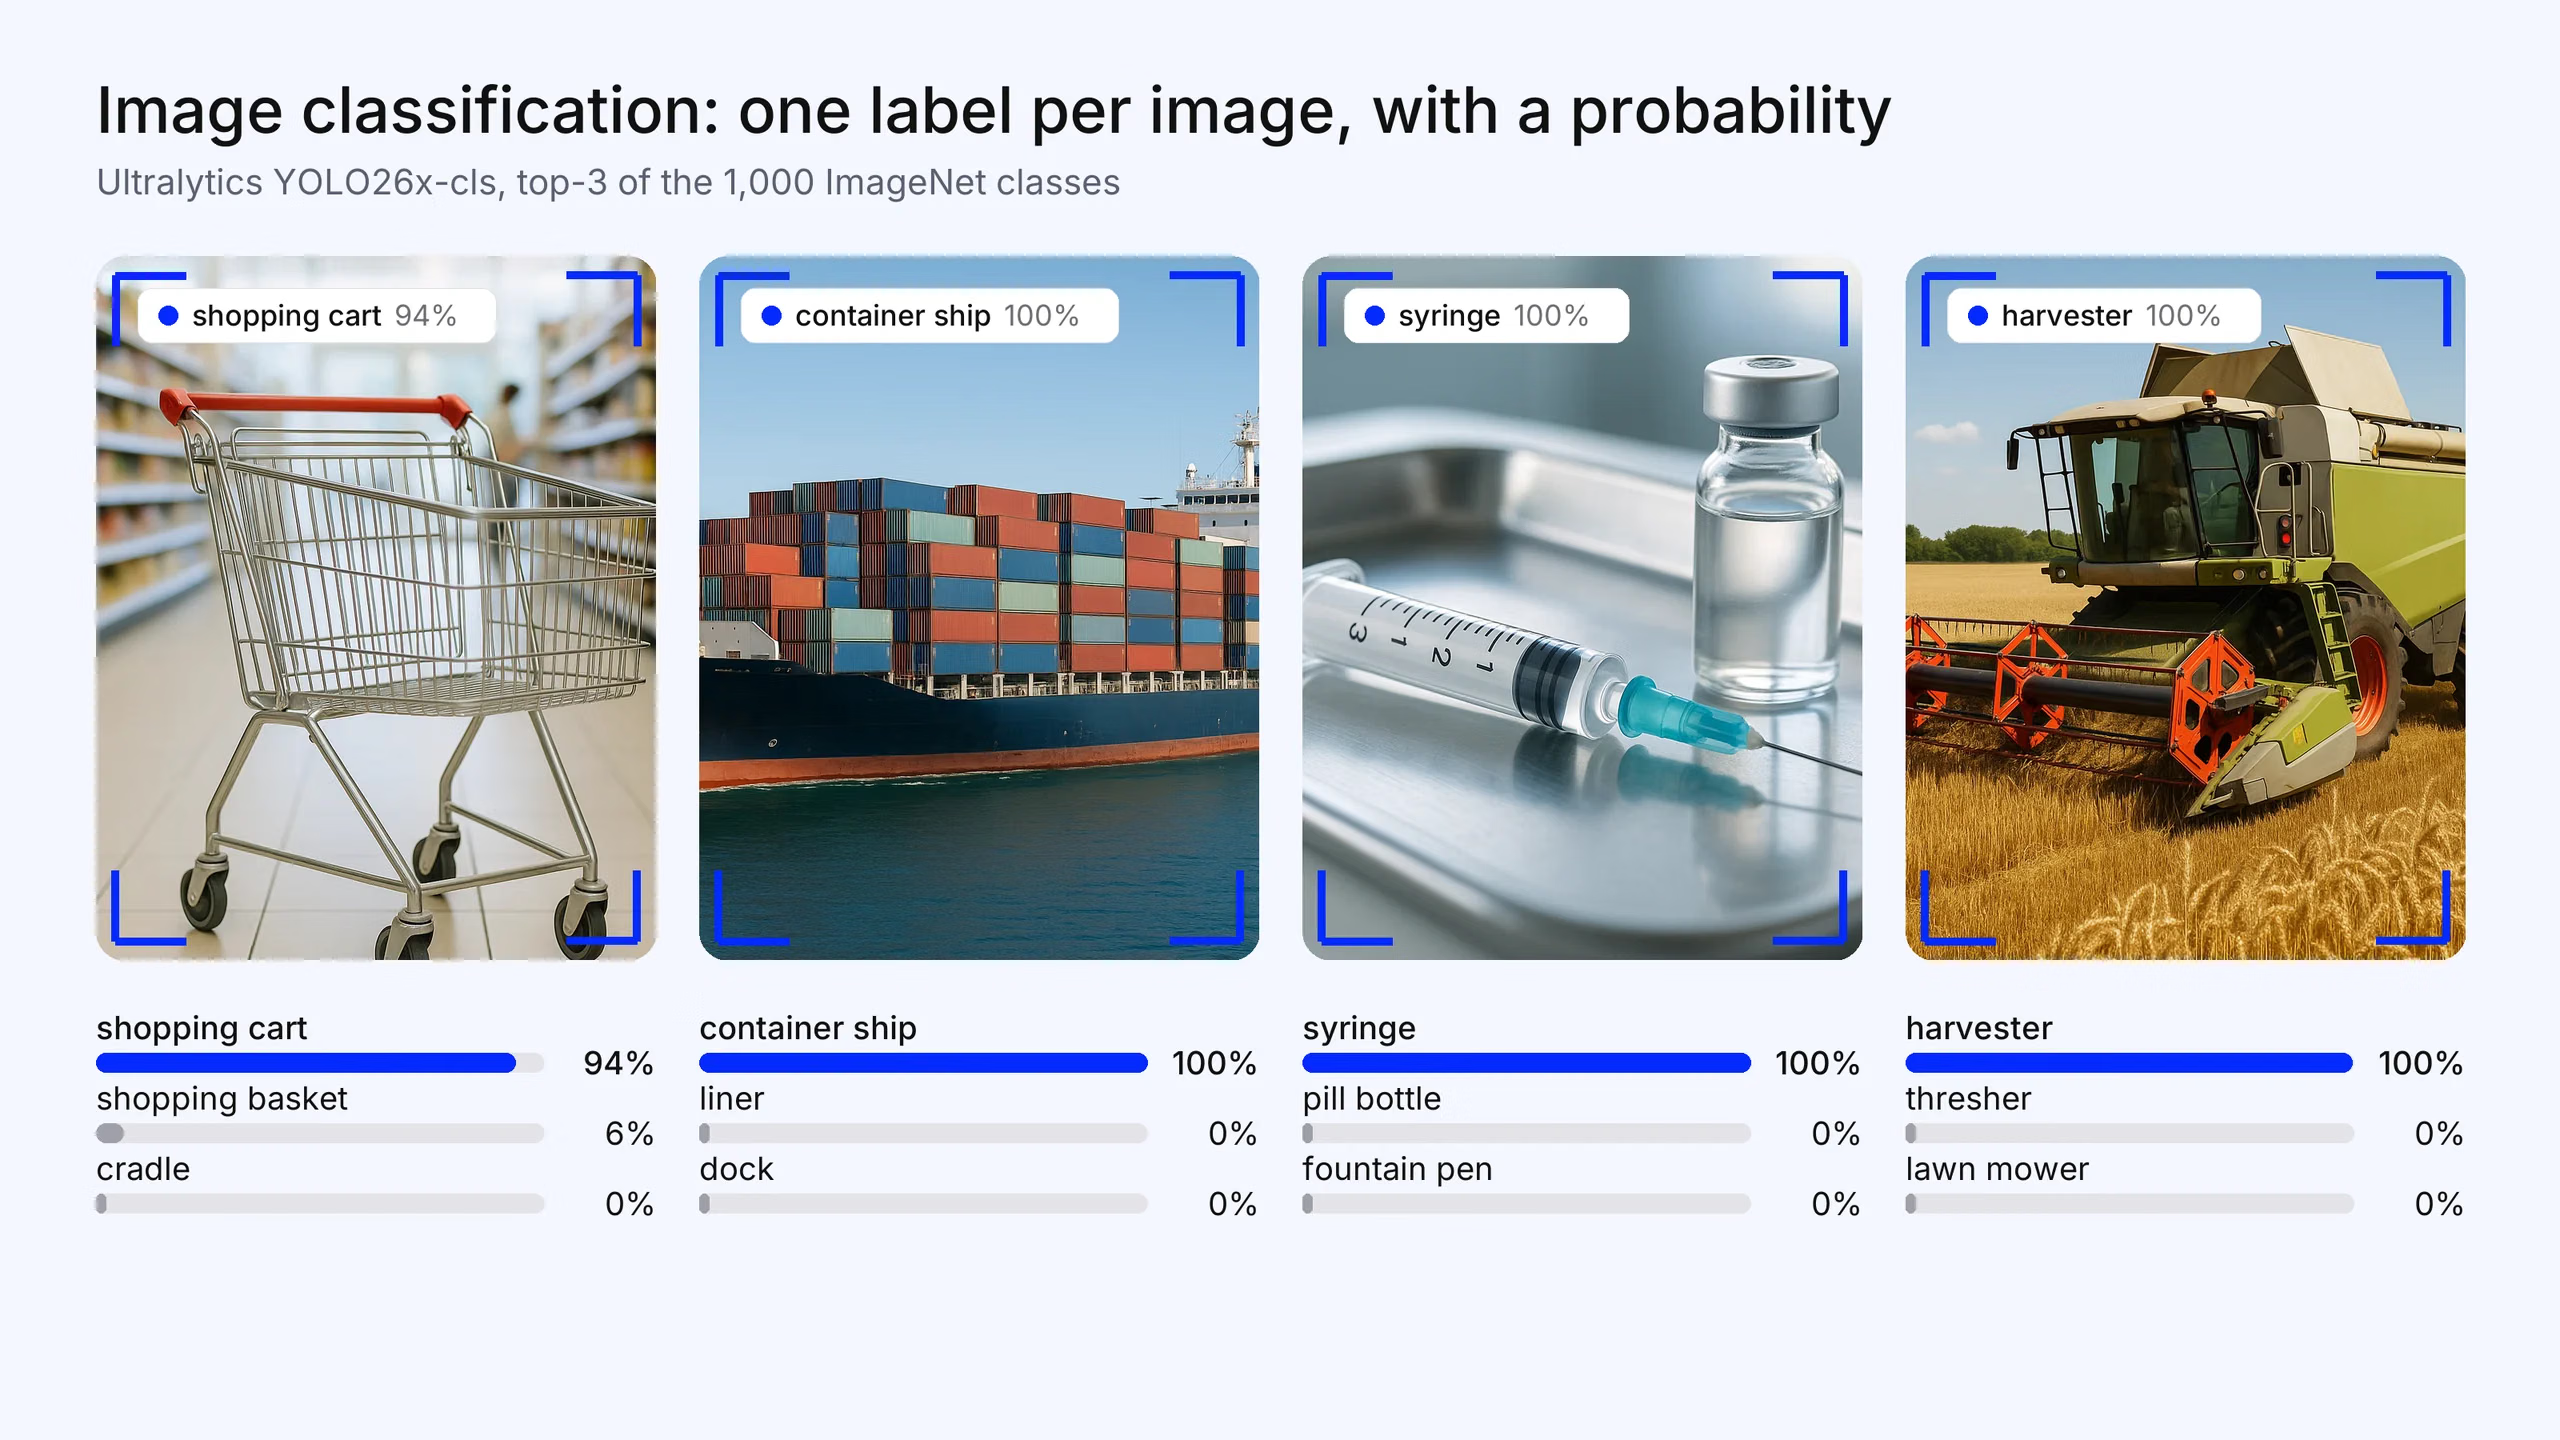
Hình 1. Phân loại ảnh trả về một nhãn cho toàn bộ ảnh, cùng xác suất cho từng lớp: các ví dụ thuộc lĩnh vực bán lẻ, logistics, chăm sóc sức khỏe và nông nghiệp. 3 dự đoán hàng đầu từ Ultralytics YOLO26x-cls, được tiền huấn luyện trên 1.000 lớp ImageNet. Ảnh được tạo riêng cho bài viết này; các dự đoán là đầu ra thực tế của model.
“Tốt nhất” có nghĩa là gì đối với một model phân loại ảnh#
Bảng xếp hạng sắp thứ tự các model theo độ chính xác top-1 trên tập validation ImageNet. Con số này hữu ích, nhưng được đo ở độ phân giải cố định, trên một dataset và thường dựa vào quá trình tiền huấn luyện quy mô rất lớn. Bốn yếu tố khác thường quyết định lựa chọn cho dự án thực tế:
- Dữ liệu. Số lượng ảnh đã gán nhãn cho mỗi lớp và mức độ tương đồng của chúng với dữ liệu tiền huấn luyện.
- Compute và độ trễ. Inference chạy trên GPU trung tâm dữ liệu, CPU hay NPU của điện thoại hoặc camera.
- Quy trình triển khai. Model có thể export thuận lợi sang runtime bạn cần hay không, chẳng hạn như ONNX, TensorRT, Core ML hoặc TFLite.
- Giấy phép. Code và, riêng biệt, trọng số tiền huấn luyện có cho phép mục đích sử dụng của bạn hay không.
Một model có độ chính xác trên ImageNet thấp hơn vài điểm nhưng fine-tune tốt trên ảnh của bạn và chạy theo thời gian thực trên phần cứng của bạn thường là lựa chọn tốt hơn.
Bốn họ model phân loại ảnh#
Mạng nơ-ron tích chập (CNNs)#
CNNs trượt các bộ lọc đã học trên ảnh, vì vậy chúng giả định rằng các pixel gần nhau có liên quan. Giả định tích hợp sẵn này (inductive bias) giúp chúng học tốt từ các dataset nhỏ và vừa, đồng thời chạy hiệu quả trên phần cứng khiêm tốn. ResNet và EfficientNet là những ví dụ kinh điển.
- Ưu điểm: tiết kiệm dữ liệu, nhanh, dễ lượng tử hóa và triển khai.
- Đánh đổi: ngữ cảnh toàn cục ở mỗi layer hạn chế hơn; lợi ích khi mở rộng quy mô thường bão hòa sớm hơn so với Transformer.
Vision transformer (ViT)#
Vision Transformer chia ảnh thành các patch và xử lý chúng như một chuỗi bằng self-attention, nhờ đó mỗi patch có thể liên hệ với mọi patch khác. ViT hoạt động tốt nhất khi được tiền huấn luyện trên lượng dữ liệu lớn rồi chuyển giao sang tác vụ khác.
- Ưu điểm: mở rộng tốt theo dữ liệu và kích thước model; khả năng chuyển giao mạnh; nền tảng tự nhiên cho huấn luyện tự giám sát và đa phương thức.
- Đánh đổi: cần tiền huấn luyện quy mô lớn hoặc regularization mạnh; inference thường chậm và tốn tài nguyên hơn CNN có độ chính xác tương đương.
Các model CNN-Transformer lai#
Các model lai dùng tích chập ở những giai đoạn đầu để xử lý chi tiết cục bộ và attention ở các giai đoạn sau để nắm bắt ngữ cảnh toàn cục. CoAtNet là thiết kế tiêu biểu: các tác giả nhận thấy việc xếp chồng các layer tích chập và attention theo thứ tự có nguyên tắc giúp cải thiện khả năng tổng quát hóa, năng lực và hiệu quả.
- Ưu điểm: cân bằng tốt trên các dataset cỡ trung bình.
- Đánh đổi: phức tạp hơn khi triển khai, tinh chỉnh và export so với từng thiết kế thuần.
Backbone tự giám sát và thị giác-ngôn ngữ#
Họ model mới nhất không được xác định bởi kiến trúc mà bởi cách huấn luyện. Các model tự giám sát như DINOv2 và DINOv3 học từ ảnh chưa gán nhãn. Các encoder thị giác-ngôn ngữ như SigLIP 2 học từ các cặp ảnh-văn bản. Cả hai đều tạo ra đặc trưng đa dụng mà bạn có thể phân loại bằng một linear head nhỏ; riêng với model thị giác-ngôn ngữ, bạn cũng có thể dùng prompt văn bản mà không cần huấn luyện (học zero-shot). Meta đã huấn luyện DINOv3 với 7 tỷ tham số trên 1,7 tỷ ảnh, tăng từ 1,1 tỷ tham số và 142 triệu ảnh của DINOv2.
- Ưu điểm: đặc trưng mạnh dù có ít dữ liệu gán nhãn; một backbone có thể phục vụ nhiều tác vụ.
- Đánh đổi: các checkpoint lớn nhất quá nặng để chạy trên thiết bị biên; giấy phép khác nhau và cần được kiểm tra.
So sánh các model phân loại ảnh#
Các model được liệt kê theo thứ tự bảng chữ cái, không phải thứ hạng. Chúng tôi không đưa ra số liệu độ chính xác: các số liệu ImageNet đã công bố khác nhau về độ phân giải, dữ liệu tiền huấn luyện và quy trình đánh giá nên không thể so sánh giữa các hàng này. Bài báo hoặc tài liệu của từng model, được liên kết bên dưới, sẽ cung cấp số liệu riêng.
| Model | Họ model | Tổ chức | Tiền huấn luyện | Phù hợp nhất cho | Đánh đổi chính |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | Tự giám sát bằng masked autoencoding (FCMAE), sau đó fine-tune có giám sát | CNN chính xác, dễ triển khai với nhiều kích thước | Trọng số ImageNet theo giấy phép CC-BY-NC (phi thương mại) |
| DINOv3 | Tự giám sát (ViT và ConvNeXt) | Meta | Tự giám sát trên 1,7 tỷ ảnh | Đặc trưng từ backbone đóng băng mạnh, cần ít dữ liệu gán nhãn | Giấy phép DINOv3 riêng; model lớn nhất có 7 tỷ tham số |
| EfficientNetV2 | CNN | Có giám sát | Huấn luyện nhanh, fine-tune hiệu quả | Thiết kế cũ; các backbone mới hơn có độ chính xác cao hơn | |
| EVA-02 | ViT | BAAI | Mô hình hóa ảnh bị che trên đặc trưng CLIP | Nghiên cứu ưu tiên độ chính xác và fine-tune | Các biến thể lớn tốn nhiều tài nguyên khi inference |
| MobileNetV4 | CNN và model lai (di động) | Có giám sát | Điện thoại, NPU và bộ tăng tốc biên | Trần độ chính xác thấp hơn các model cấp máy chủ | |
| ResNet | CNN | Microsoft Research | Có giám sát | Các baseline, giảng dạy, pipeline cũ | Không còn cạnh tranh về độ chính xác trên mỗi FLOP |
| SigLIP 2 | Thị giác-ngôn ngữ (ViT) | Các cặp ảnh-văn bản, đa ngôn ngữ | Phân loại zero-shot và open-vocabulary | Hãy xác thực kết quả zero-shot trên các lớp dự định sử dụng trước khi tin cậy vào chúng | |
| Swin Transformer | ViT (phân cấp) | Microsoft Research | Có giám sát | Đầu vào độ phân giải cao hơn, tái sử dụng backbone | Nặng hơn CNN có độ chính xác tương đương |
| Ultralytics YOLO26-cls | CNN | Ultralytics | Huấn luyện có giám sát trên ImageNet | Classifier tùy chỉnh nhanh, export ra thiết bị biên, một API dùng chung với detection | Trần độ chính xác thấp hơn các Transformer tiền huấn luyện quy mô lớn |
| ViT | ViT | Có giám sát, thường trên các dataset lớn | Học chuyển giao ở quy mô lớn | Cần nhiều dữ liệu nếu không được tiền huấn luyện quy mô lớn |
Tìm hiểu chi tiết hơn về các model#
Liệt kê theo thứ tự bảng chữ cái.
ConvNeXt V2#
ConvNeXt V2 kết hợp masked autoencoder tích chập hoàn toàn (FCMAE) với một layer Global Response Normalization. Model có tám kích thước, từ Atto (3,7 triệu tham số) đến Huge (660 triệu), nên một họ model đáp ứng cả thiết bị biên lẫn máy chủ. Đây là lựa chọn mặc định đáng tin cậy khi bạn muốn độ chính xác ngang thời Transformer nhưng vẫn dễ triển khai như CNN. Đánh đổi: code được cấp phép MIT, nhưng trọng số ImageNet tiền huấn luyện và fine-tune được cấp phép CC-BY-NC, không cho phép sử dụng thương mại các trọng số này.
DINOv3#
DINOv3 là backbone thị giác tự giám sát của Meta. Model được phát hành dưới dạng các model ViT từ ViT-S/16 đến ViT-7B/16, cùng các model ConvNeXt đã chưng cất để sử dụng trên thiết bị. Meta đánh giá model khi backbone được đóng băng; repository cũng bao gồm classification head ImageNet cho model 7B. Đây là model nên thử khi bạn có ít nhãn và cần các đặc trưng có khả năng chuyển giao. Đánh đổi: model được phát hành theo Giấy phép DINOv3 riêng thay vì giấy phép nguồn mở tiêu chuẩn, và các kết quả nổi bật nhất đến từ model lớn nhất.
EfficientNetV2#
EfficientNetV2 của Google sử dụng phương pháp học tăng dần: tăng kích thước ảnh trong quá trình huấn luyện và điều chỉnh regularization cho phù hợp. Nhờ đó, model huấn luyện nhanh hơn và dùng ít tham số hơn các model trước đây. Đây vẫn là lựa chọn đáng tin cậy để fine-tune trên các dataset nhỏ đến trung bình. Đánh đổi: model ra đời trước các backbone giai đoạn 2023–2025 và không còn dẫn đầu về độ chính xác. Để tìm hiểu thiết kế ban đầu, xem tổng quan về EfficientNet của chúng tôi.
EVA-02#
EVA-02 là Transformer thuần được tiền huấn luyện bằng phương pháp mô hình hóa ảnh bị che để tái tạo đặc trưng từ một encoder thị giác CLIP lớn. Bốn kích thước có từ 6 triệu đến 304 triệu tham số. Model có trên timm để fine-tune. Đánh đổi: các biến thể lớn tốn kém khi fine-tune và triển khai, đồng thời quá mức cần thiết đối với các classifier miền đơn giản.
MobileNetV4#
MobileNetV4 là họ model di động mới nhất của Google, được thiết kế để hoạt động hiệu quả trên CPU di động, DSP, GPU, Apple Neural Engine và Google Pixel EdgeTPU. Đây là lựa chọn tự nhiên cho điện thoại hoặc bộ tăng tốc công suất thấp. Đánh đổi: model hy sinh độ chính xác tối đa để giảm độ trễ.
ResNet#
ResNet giới thiệu kết nối residual và vẫn là baseline tiêu chuẩn, được mọi framework hỗ trợ. Đánh đổi: các CNN mới hơn đạt độ chính xác cao hơn với cùng lượng compute. Xem ResNet-50 là gì để tìm hiểu kiến trúc.
SigLIP 2#
SigLIP 2 (xem mục từ điển thuật ngữ SigLIP của chúng tôi) là họ encoder thị giác-ngôn ngữ đa ngôn ngữ của Google. Model có thể phân loại ảnh dựa trên danh sách nhãn văn bản mà không cần huấn luyện (có cách tiếp cận tương tự CLIP); biến thể NaFlex giữ nguyên tỷ lệ khung hình gốc của đầu vào. Đây là lựa chọn phù hợp nhất khi tập nhãn thay đổi thường xuyên hoặc bạn chưa có dữ liệu gán nhãn. Đánh đổi: chất lượng zero-shot thay đổi theo từng miền, vì vậy hãy xác thực trên các lớp dự định sử dụng (ví dụ: loại lỗi) trước khi tin cậy vào kết quả. Nếu hiệu quả chưa đạt yêu cầu, hãy huấn luyện classification head hoặc fine-tune.
Swin Transformer#
Swin Transformer tính attention bên trong các cửa sổ cục bộ dịch chuyển, giúp compute tăng tuyến tính theo kích thước ảnh và phù hợp với đầu vào độ phân giải cao hơn. Đánh đổi: model nặng hơn CNN có độ chính xác tương đương; ConvNeXt được thiết kế để cạnh tranh với model này bằng các phép tích chập thuần.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls là biến thể phân loại của Ultralytics YOLO26. Model có năm kích thước (n, s, m, l, x), từ 2,8 triệu đến 29,6 triệu tham số (sau khi hợp nhất), nhận đầu vào 224 pixel và được tiền huấn luyện trên ImageNet. Tài liệu báo cáo độ chính xác top-1 và top-5 trên tập validation ImageNet, cùng độ trễ trên CPU và GPU cho từng kích thước. Cùng một Python API và CLI dùng để huấn luyện, validation và export model phân loại, detection, segmentation và pose; các classifier có thể export sang những định dạng như ONNX, TensorRT, Core ML, OpenVINO và LiteRT. Các model YOLO11-cls trước đó sử dụng cùng năm kích thước và kích thước đầu vào. Đánh đổi:
- Trần độ chính xác. Ngay cả model x cũng nhỏ hơn nhiều so với các Transformer tiền huấn luyện lớn như EVA-02 hoặc DINOv3, vì vậy model này không phù hợp với nghiên cứu ưu tiên độ chính xác.
- Mặc định crop vuông. Quá trình huấn luyện dùng random resized crop và validation dùng center crop, có thể cắt mất một phần ảnh có tỷ lệ khung hình cực đoan. Tài liệu hướng dẫn cách thay bằng resize thông thường.
- Giấy phép. Các model Ultralytics được cấp phép AGPL-3.0. Việc sử dụng thương mại với mã nguồn đóng cần có giấy phép Ultralytics Enterprise.
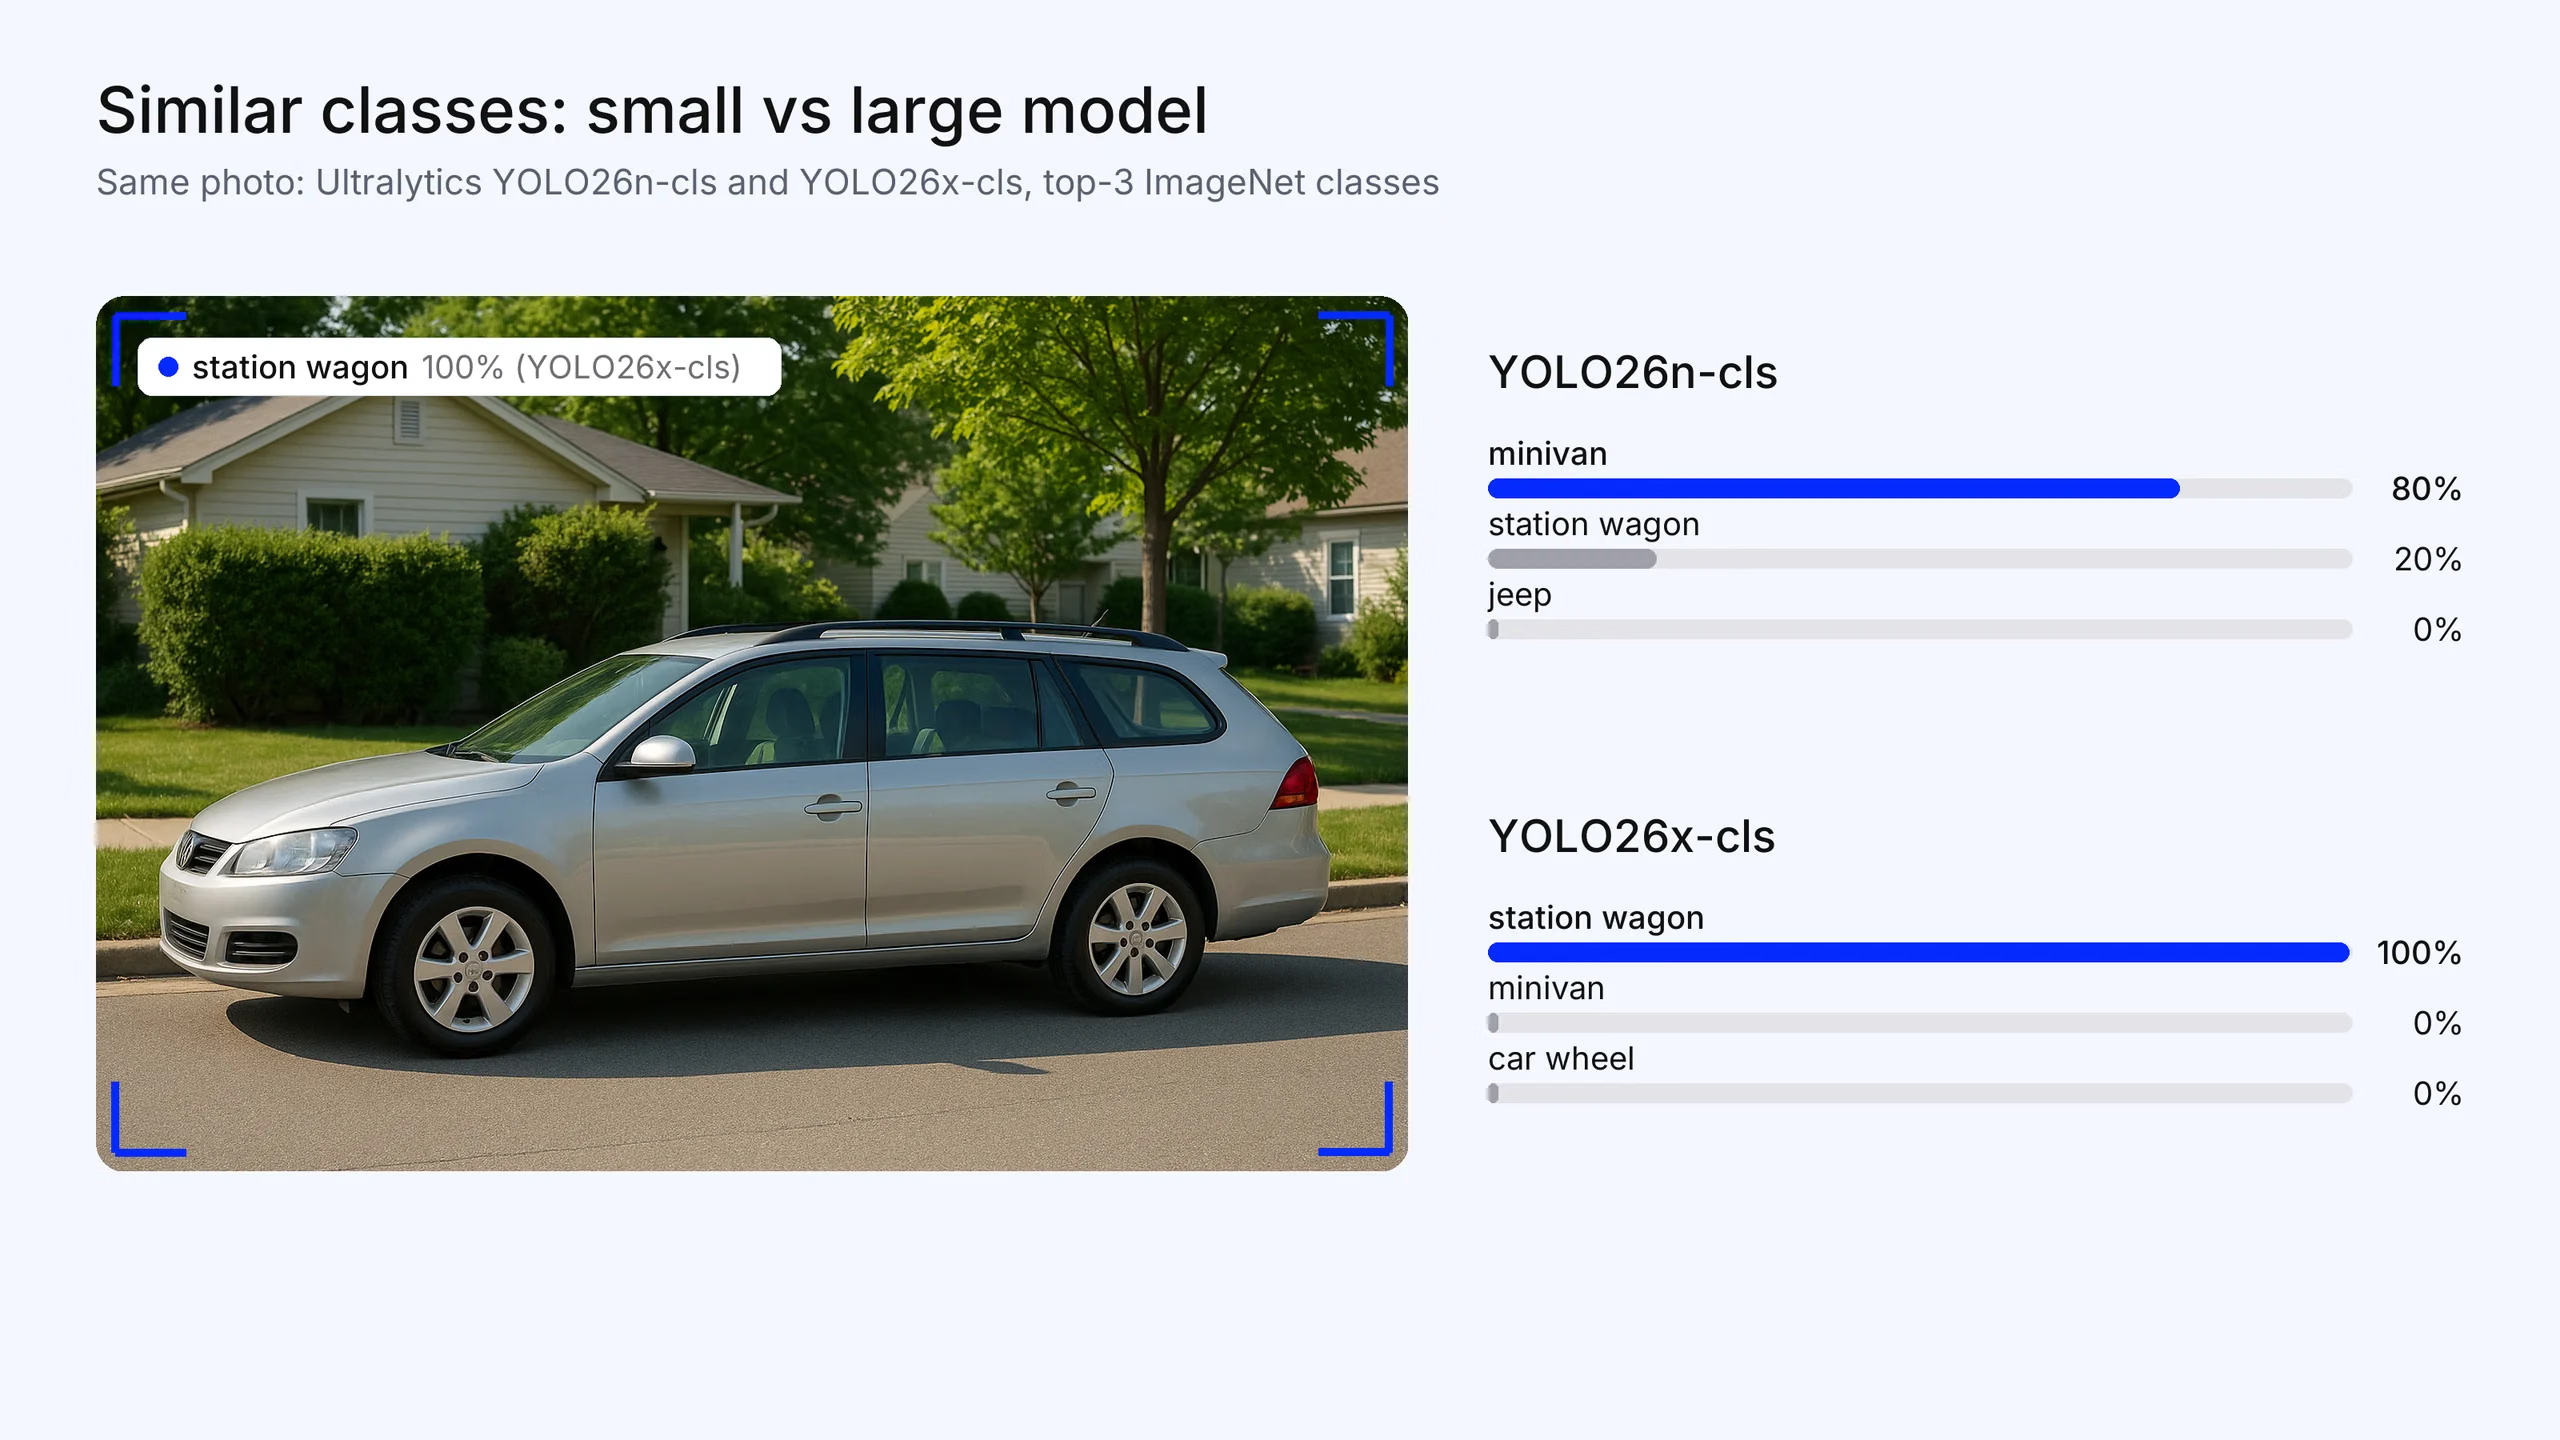
Hình 2. Kích thước model thể hiện rõ khi phân biệt các lớp tương tự nhau. Với ảnh chiếc station wagon này, Ultralytics YOLO26n-cls xếp "minivan" ở vị trí đầu tiên (80%), trong khi YOLO26x-cls xếp station wagon ở vị trí đầu tiên (100%, hiển thị dưới lớp ImageNet "beach wagon, station wagon"). Hãy kiểm tra các lớp có độ chi tiết cao như thế này trên tập validation của riêng bạn. Ảnh được tạo cho bài viết này; các dự đoán là đầu ra thực tế của model.
ViT#
Vision Transformer ban đầu của Google cho thấy Transformer thuần trên các patch ảnh có thể ngang bằng hoặc vượt CNN khi được tiền huấn luyện trên lượng dữ liệu lớn. Đánh đổi: nếu không được tiền huấn luyện trên quy mô lớn, model hoạt động kém hơn CNN trên các tập dữ liệu nhỏ và cần nhiều compute hơn khi suy luận.
Cách chọn model phân loại ảnh#
Hãy lần lượt trả lời các câu hỏi sau:
- Bạn có dữ liệu đã gán nhãn không? Nếu chưa có ví dụ được gán nhãn, hãy bắt đầu với model thị giác-ngôn ngữ như SigLIP 2 để phân loại zero-shot. Với tập dữ liệu đã gán nhãn nhỏ, hãy đánh giá thêm backbone DINOv3 đóng băng cùng một linear head đã huấn luyện.
- Model sẽ chạy ở đâu? Trên điện thoại hoặc NPU, hãy đưa MobileNetV4 hoặc CNN nhỏ như YOLO26n-cls hay ConvNeXt V2 bản nhỏ vào danh sách lựa chọn. Trên edge GPU hoặc CPU theo thời gian thực, hãy cân nhắc YOLO26-cls, EfficientNetV2 hoặc ConvNeXt V2. Trên server không bị giới hạn nghiêm ngặt về độ trễ, hãy cân nhắc EVA-02, Swin hoặc DINOv3 ViT.
- Có bao nhiêu dữ liệu được gán nhãn cho mỗi lớp? Với vài trăm đến vài nghìn ảnh, transfer learning từ CNN đã tiền huấn luyện hoặc backbone tự giám sát đóng băng là lựa chọn an toàn nhất. Khi có hàng chục nghìn ảnh trở lên, fine-tune toàn bộ Transformer bắt đầu mang lại hiệu quả.
- Bạn có thể sử dụng giấy phép không? Hãy kiểm tra weights, không chỉ mã nguồn: weights ImageNet của ConvNeXt V2 không được dùng cho mục đích thương mại, DINOv3 có giấy phép riêng, còn model Ultralytics được cấp phép theo AGPL-3.0 trừ khi bạn có giấy phép Enterprise.
- Model có thể export sang runtime của bạn không? Hãy xác nhận có quy trình được hỗ trợ để chuyển sang ONNX, TensorRT, Core ML hoặc TFLite trước khi quyết định.
Sau đó, hãy fine-tune hai hoặc ba model trong danh sách rút gọn và so sánh chúng trên phần chia validation của riêng bạn.
Khi nào model khác sẽ phù hợp hơn YOLO#
YOLO26-cls được xây dựng để tạo classifier tùy chỉnh nhanh, dễ triển khai. Với một số tác vụ, model khác sẽ là lựa chọn tốt hơn:
- Nghiên cứu ưu tiên độ chính xác hoặc công việc benchmark: sử dụng EVA-02, ConvNeXt V2 hoặc ViT thông qua timm, nơi có sẵn recipe và weights để tái lập kết quả cấp ImageNet.
- Rất ít nhãn hoặc cần thực hiện nhiều tác vụ downstream từ một backbone: sử dụng feature DINOv3 với linear head.
- Tập nhãn mở hoặc thường xuyên thay đổi: sử dụng SigLIP 2 zero-shot.
- NPU trên điện thoại như Apple Neural Engine hoặc EdgeTPU: MobileNetV4 được thiết kế và kiểm thử chính xác trên các nền tảng này.
Nếu bạn cũng cần xác định vị trí của các đối tượng, chứ không chỉ biết ảnh thể hiện điều gì, bạn cần một detector. Xem phần so sánh model phát hiện đối tượng của chúng tôi.
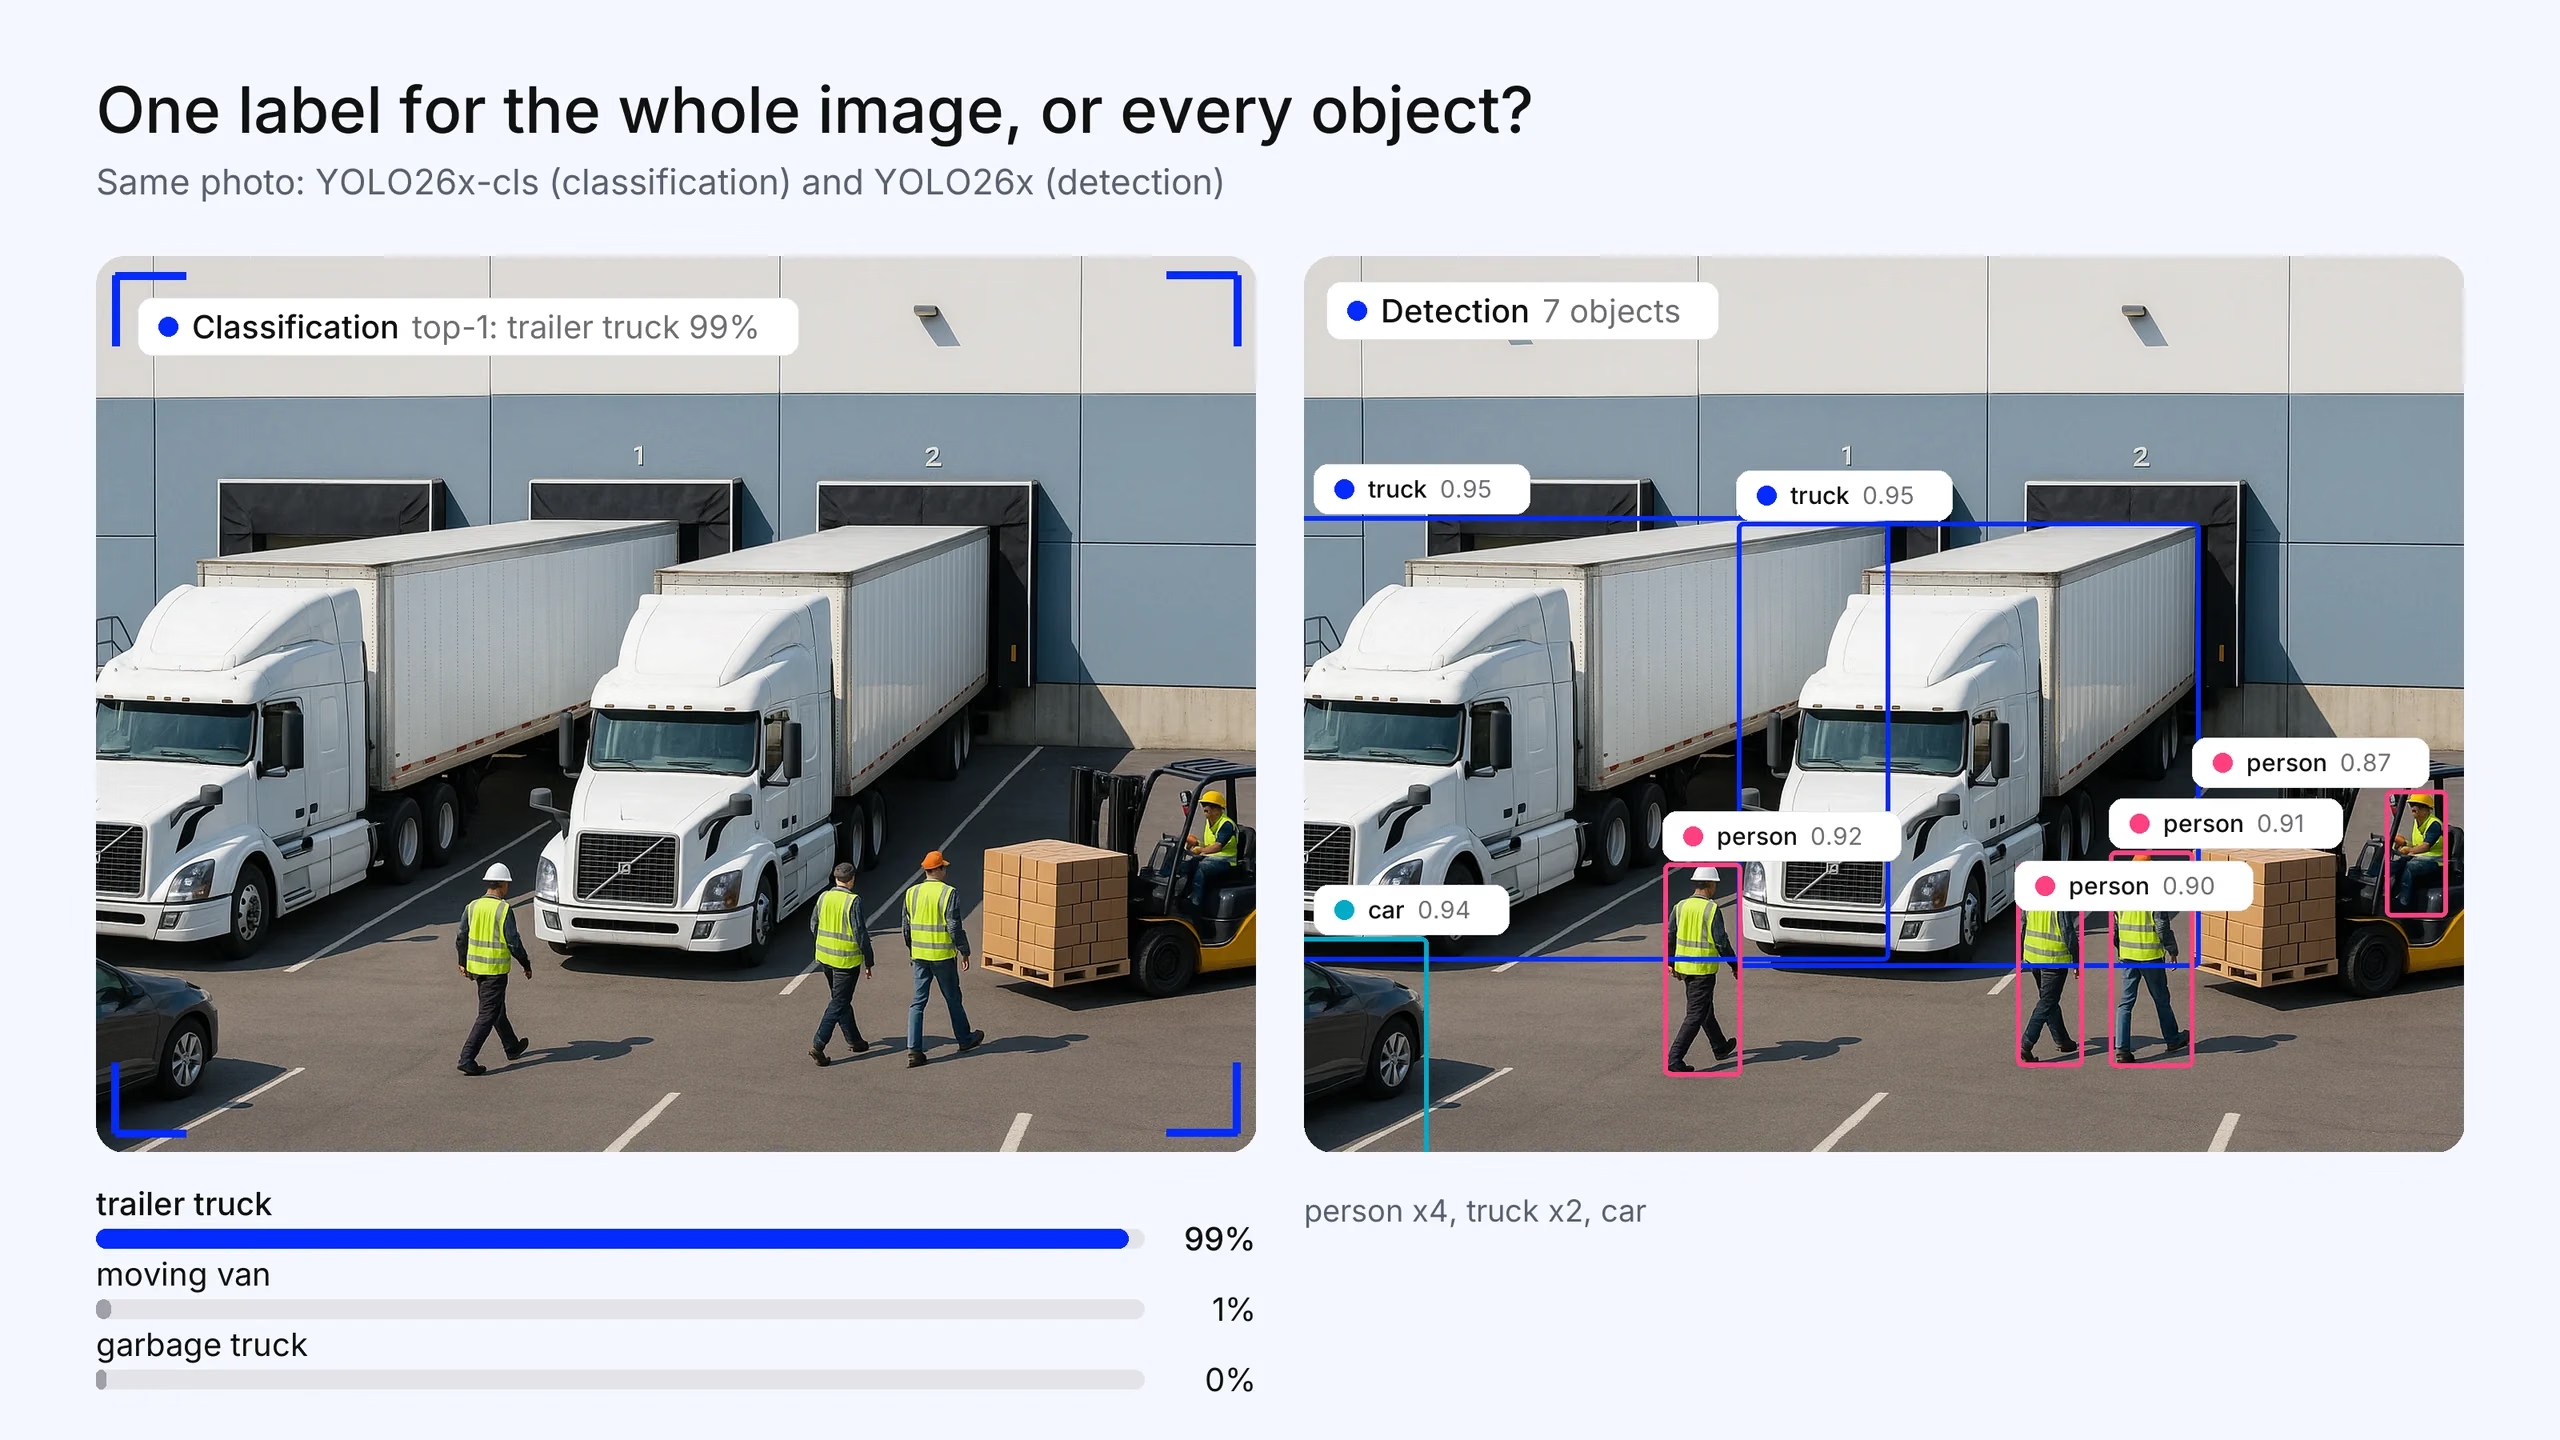
Hình 3. Trong cảnh có nhiều đối tượng, classifier vẫn chỉ trả về một nhãn: Ultralytics YOLO26x-cls gán nhãn "trailer truck" cho bãi tập kết này với độ tin cậy 99%. Ultralytics YOLO26x detection tìm thấy 7 đối tượng gồm 4 người, 2 xe tải và 1 ô tô, mỗi đối tượng có box riêng (độ tin cậy từ 0.5 trở lên). Ảnh được tạo cho bài viết này; các đầu ra là kết quả thực tế.
Nơi tải model tiền huấn luyện và huấn luyện model của riêng bạn#
- timm (Các model ảnh PyTorch) tập hợp hầu hết backbone kể trên, từ ViT và ConvNeXt đến MobileNetV4, EVA và DINOv3, cùng các script huấn luyện và đánh giá. Mã nguồn sử dụng Apache 2.0; giấy phép của weights khác nhau.
- Hugging Face lưu trữ hầu hết classifier Transformer, bao gồm SigLIP 2 và DINOv3, với pipeline zero-shot và phân loại ảnh dựng sẵn.
- Gói Python của Ultralytics huấn luyện YOLO26-cls trên thư mục ảnh được sắp xếp theo lớp. Xem định dạng dataset phân loại và hướng dẫn tác vụ classify.
- Ultralytics Platform bổ sung gán nhãn và huấn luyện trên cloud cho cùng các model đó. Nền tảng ra mắt vào năm 2026, vì vậy mới hơn các dịch vụ huấn luyện lưu trữ đã có tên tuổi. Để triển khai model sau khi huấn luyện, hãy xem phần so sánh nền tảng suy luận thị giác máy tính của chúng tôi.
Câu hỏi thường gặp
Không có model nào phù hợp với mọi trường hợp. Với công việc ưu tiên độ chính xác và có nhiều compute, các backbone Transformer lớn và tự giám sát như EVA-02 và DINOv3 là những lựa chọn nên đánh giá đầu tiên. Để đưa vào production trên phần cứng hạn chế, CNN như ConvNeXt V2, EfficientNetV2, MobileNetV4 và Ultralytics YOLO26-cls thực tế hơn. Để phân loại khi không có dữ liệu được gán nhãn, SigLIP 2 hỗ trợ phân loại zero-shot.
Transformer thường cho kết quả tốt hơn khi được tiền huấn luyện trên tập dữ liệu rất lớn và không bị hạn chế compute. CNN thường hiệu quả hơn trên tập dữ liệu nhỏ đến trung bình và phần cứng edge, vì các giả định tích hợp về cấu trúc cục bộ giúp chúng tiết kiệm dữ liệu và chạy nhanh. CNN hiện đại như ConvNeXt đã thu hẹp khoảng cách về độ chính xác, còn các mô hình lai như CoAtNet kết hợp cả hai.
Có. DINOv3 là backbone đa dụng. Bạn trích xuất feature bằng model đóng băng rồi huấn luyện một classifier tuyến tính nhỏ ở phía trên; repository của Meta cũng có classification head ImageNet dành cho model lớn nhất. Hãy kiểm tra giấy phép DINOv3 trước khi sử dụng cho mục đích thương mại.
Chủ yếu bằng độ chính xác top-1 (dự đoán đứng đầu là chính xác) và top-5 (lớp đúng nằm trong năm dự đoán có điểm cao nhất), thường được đo trên tập validation ImageNet. Với dataset tùy chỉnh mất cân bằng, precision, recall hoặc F1 theo từng lớp cung cấp nhiều thông tin hơn độ chính xác tổng thể.









