OCR bằng Python với Ultralytics YOLO26: đọc tài liệu, ảnh và PDF ở mọi góc độ
Đọc văn bản trong ảnh và các trang PDF ở mọi góc xoay bằng Ultralytics YOLO26-Text và PP-OCRv6 chỉ với vài dòng Python, chạy trên CPU hoặc GPU, có thể tùy chọn TensorRT.
 Jing Qiu16 phút đọc
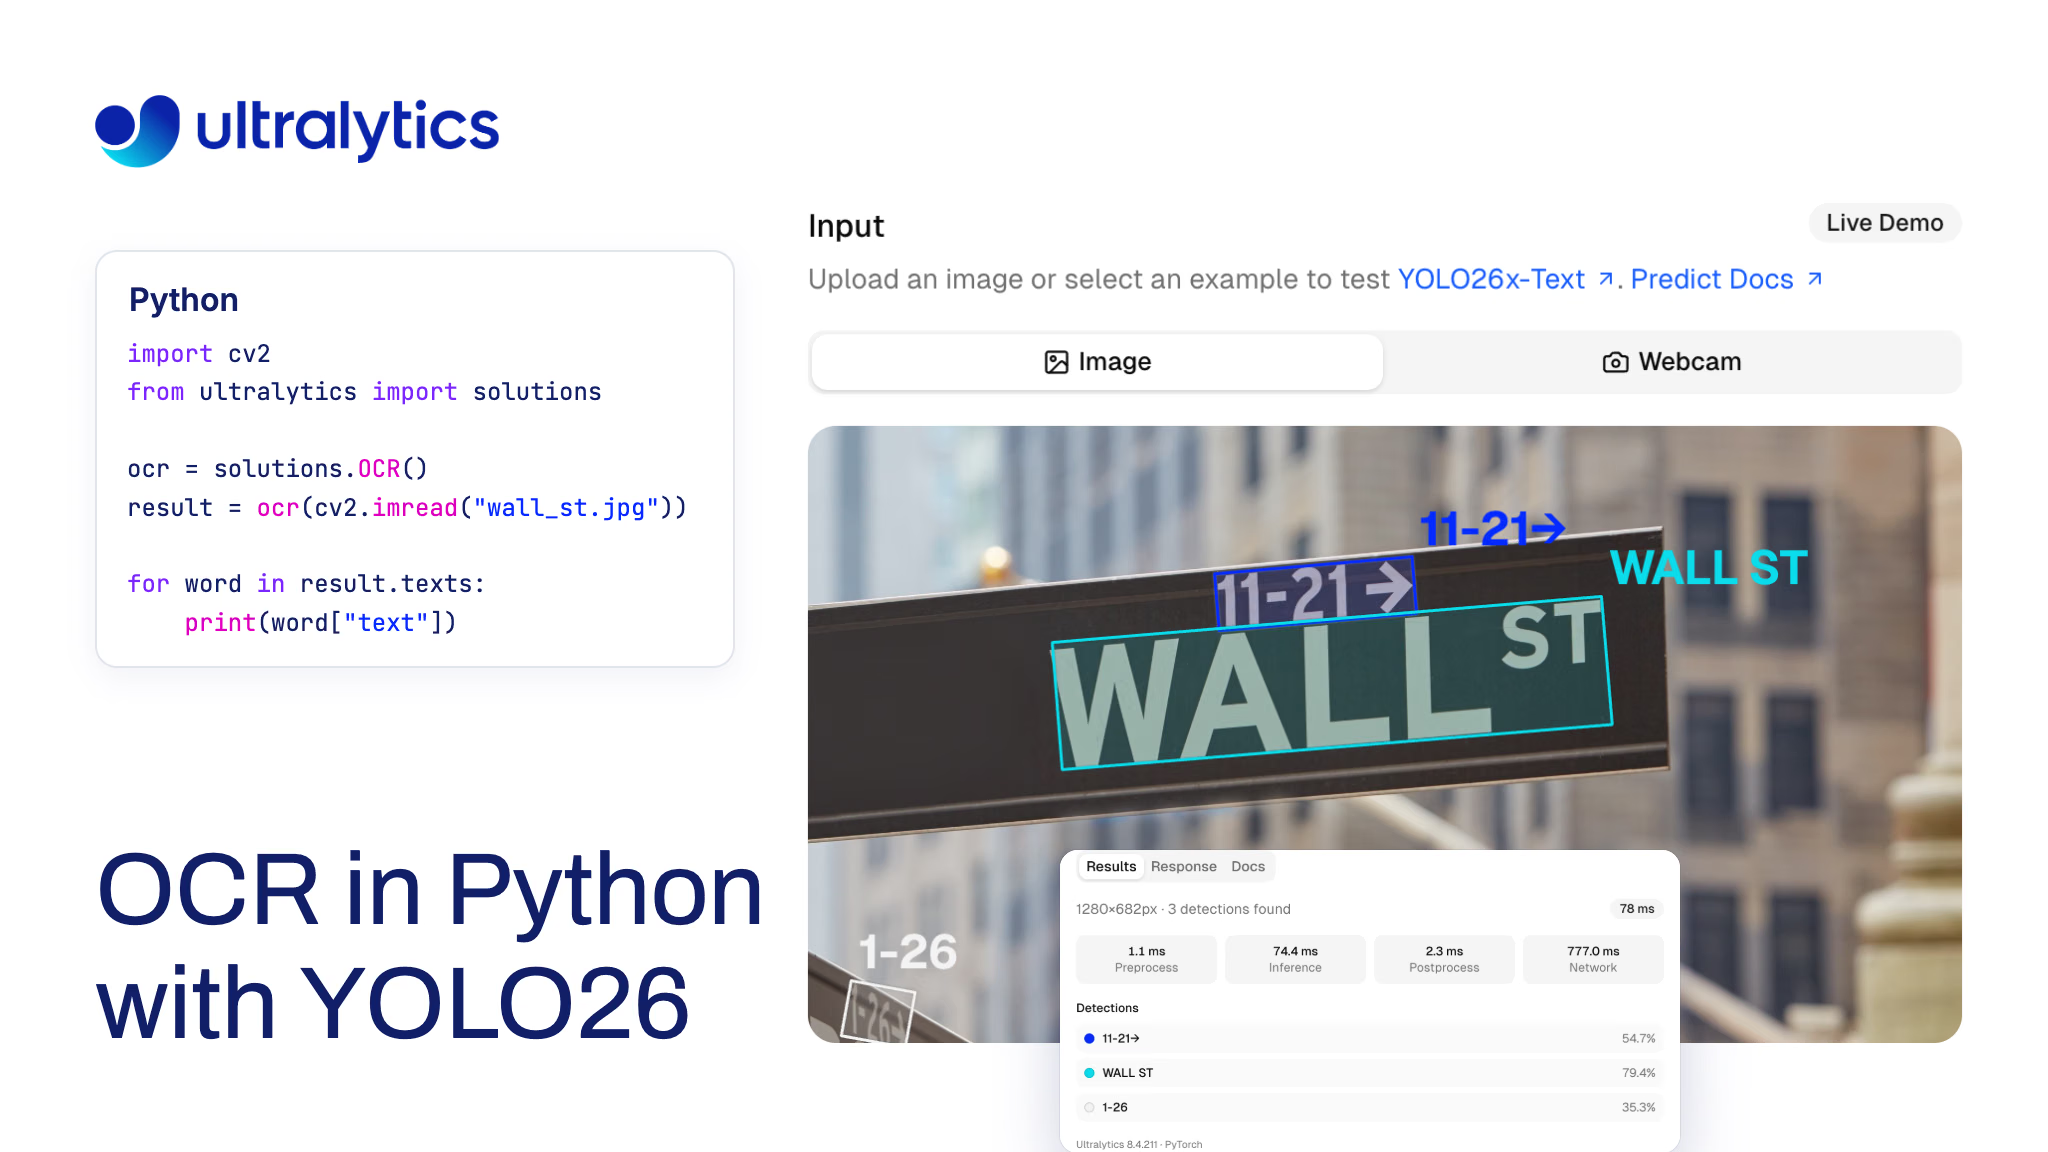
Làm thế nào để chạy OCR bằng Python trên bản quét nằm ngang, ảnh chụp biển báo bằng điện thoại hoặc trang PDF, rồi nhận lại các từ theo đúng thứ tự con người đọc? Với package Ultralytics, bạn chỉ cần một class: solutions.OCR() phát hiện văn bản bằng model YOLO26-Text của Ultralytics, đọc từng từ bằng recognizer PP-OCRv6 của PaddleOCR và trả về các từ đã nhận diện theo từng dòng, ở mọi góc xoay trang, trên CPU hoặc GPU.
Pipeline này là mới. Ultralytics 8.4.210 xây dựng lại giải pháp OCR dựa trên PP-OCRv6 chạy trên ONNX Runtime, bổ sung xử lý góc xoay và thứ tự đọc; 8.4.211 bổ sung recognizer TensorRT tùy chọn. Trong benchmark của chúng tôi ở kích thước ảnh 1280, cấu hình mặc định đạt word F1 0.931 trên sáu trang PDF và 0.722 trên 80 ảnh HierText. Trên RTX PRO 6000, engine TensorRT FP16 đã cache đọc 251 từ được phát hiện trong một ảnh trong 82 ms, so với 249 ms khi dùng ONNX Runtime trên CUDA.
Hướng dẫn này trình bày cách pipeline hoạt động, cách chạy pipeline trên ảnh và PDF, tốc độ xử lý và các ngôn ngữ hiện được hỗ trợ. Ultralytics phát triển một trong các tùy chọn OCR được so sánh bên dưới, vì vậy phần so sánh chỉ dựa trên các khả năng được từng dự án tài liệu hóa.
YOLO26 OCR đọc trang qua hai bước, sau đó sắp xếp các từ theo thứ tự#
Nhận dạng ký tự quang học (OCR) có hai nhiệm vụ: tìm văn bản rồi đọc văn bản. Giải pháp OCR của Ultralytics tách riêng hai nhiệm vụ này:
- Phát hiện: model YOLO26-Text, một detector bounding box định hướng, vẽ các box xoay quanh văn bản. Model có các kích cỡ n, s, m, l và x; mặc định là model x.
- Nhận dạng: PP-OCRv6 medium đọc từng crop. Model chạy trên ONNX Runtime từ bản phát hành assets của Ultralytics, nên bạn không cần cài PaddlePaddle. Các crop không đọc được nội dung nào sẽ bị loại bỏ.
- Sắp xếp: các từ được nhóm thành dòng và trả về theo thứ tự từ trên xuống dưới, từ trái sang phải; mỗi từ được gắn số dòng.
Mỗi từ được trả về dưới dạng một bản ghi gồm văn bản, confidence nhận dạng, confidence của detector, số dòng và polygon theo tọa độ ảnh gốc. Vì hai confidence được giữ riêng biệt, bạn có thể chuyển từ được phát hiện với confidence cao nhưng đọc chưa chắc chắn cho người kiểm tra thay vì mặc định tin vào kết quả.
Hai giai đoạn hoạt động độc lập. Bạn có thể thay bằng detector nhỏ hơn, model phát hiện hoặc phân đoạn của riêng mình, hay recognizer khác; phần xử lý góc xoay và thứ tự đọc vẫn hoạt động. Bạn có thể thử cùng luồng mã trong trình duyệt tại trang xử lý tài liệu của chúng tôi trước khi cài đặt bất cứ thứ gì.
Đọc trang bị xoay hoặc lộn ngược theo đúng thứ tự#
Giải pháp xác định góc xoay của trang dựa trên văn bản được phát hiện, vì vậy bạn không cần căn thẳng hoặc xoay trang trước:
- Xác định hướng văn bản. Giải pháp tính trung bình góc cạnh dài của các box được phát hiện, có trọng số theo mức độ kéo dài của từng box. Các box có tỷ lệ kéo dài dưới 2:1, chẳng hạn như chữ số đơn, sẽ không tham gia tính toán.
- Xoay trang. Giải pháp xoay trang để văn bản chạy từ trái sang phải, crop từng từ theo chiều đứng và nhóm các từ thành dòng.
- Phân định 0° hay 180°. Box không thể cho biết văn bản đang đúng chiều hay ngược chiều, vì vậy giải pháp đọc 8 từ rộng nhất theo cả hai chiều và chọn hướng cho kết quả có confidence cao hơn. Văn bản lộn ngược tạo ra kết quả nhiễu có confidence thấp, giúp xác định đáp án đúng.
Khi xoay 8 tài liệu và ảnh chụp màn hình, cùng 12 bức ảnh, sang 90°, 180° và 270°, word F1 đạt 0.925 trên tài liệu và 0.654 trên ảnh. Trên IRS Form 8802 trống, giải pháp đọc được 404, 401 và 399 từ ở các góc 0°, 180° và 90°, với các dòng đầu tiên giống hệt nhau. Phiên bản trước giả định mọi trang đều đúng chiều.
Các giá trị mặc định dựa trên benchmark, không phải phỏng đoán#
Chúng tôi thiết lập các giá trị mặc định chính bằng cách đo lường. Benchmark chạy trên RTX PRO 6000 với image Platform dùng trong production; ảnh tải lên được gửi dưới dạng JPEG với cạnh dài tối đa 1280 pixel. Benchmark sử dụng 80 ảnh validation từ dataset HierText của Google cùng bản phiên âm các từ đọc được, 6 trang PDF được chấm điểm dựa trên lớp văn bản của chúng (4 trang từ một bài báo arXiv cùng các IRS Form 1040 và 8802 trống), một ảnh chụp màn hình tổng hợp và một ảnh tổng hợp. Chỉ số là điểm F1 ở cấp từ, cân bằng giữa precision và recall, tính các từ viết thường có ít nhất 2 ký tự chữ-số.
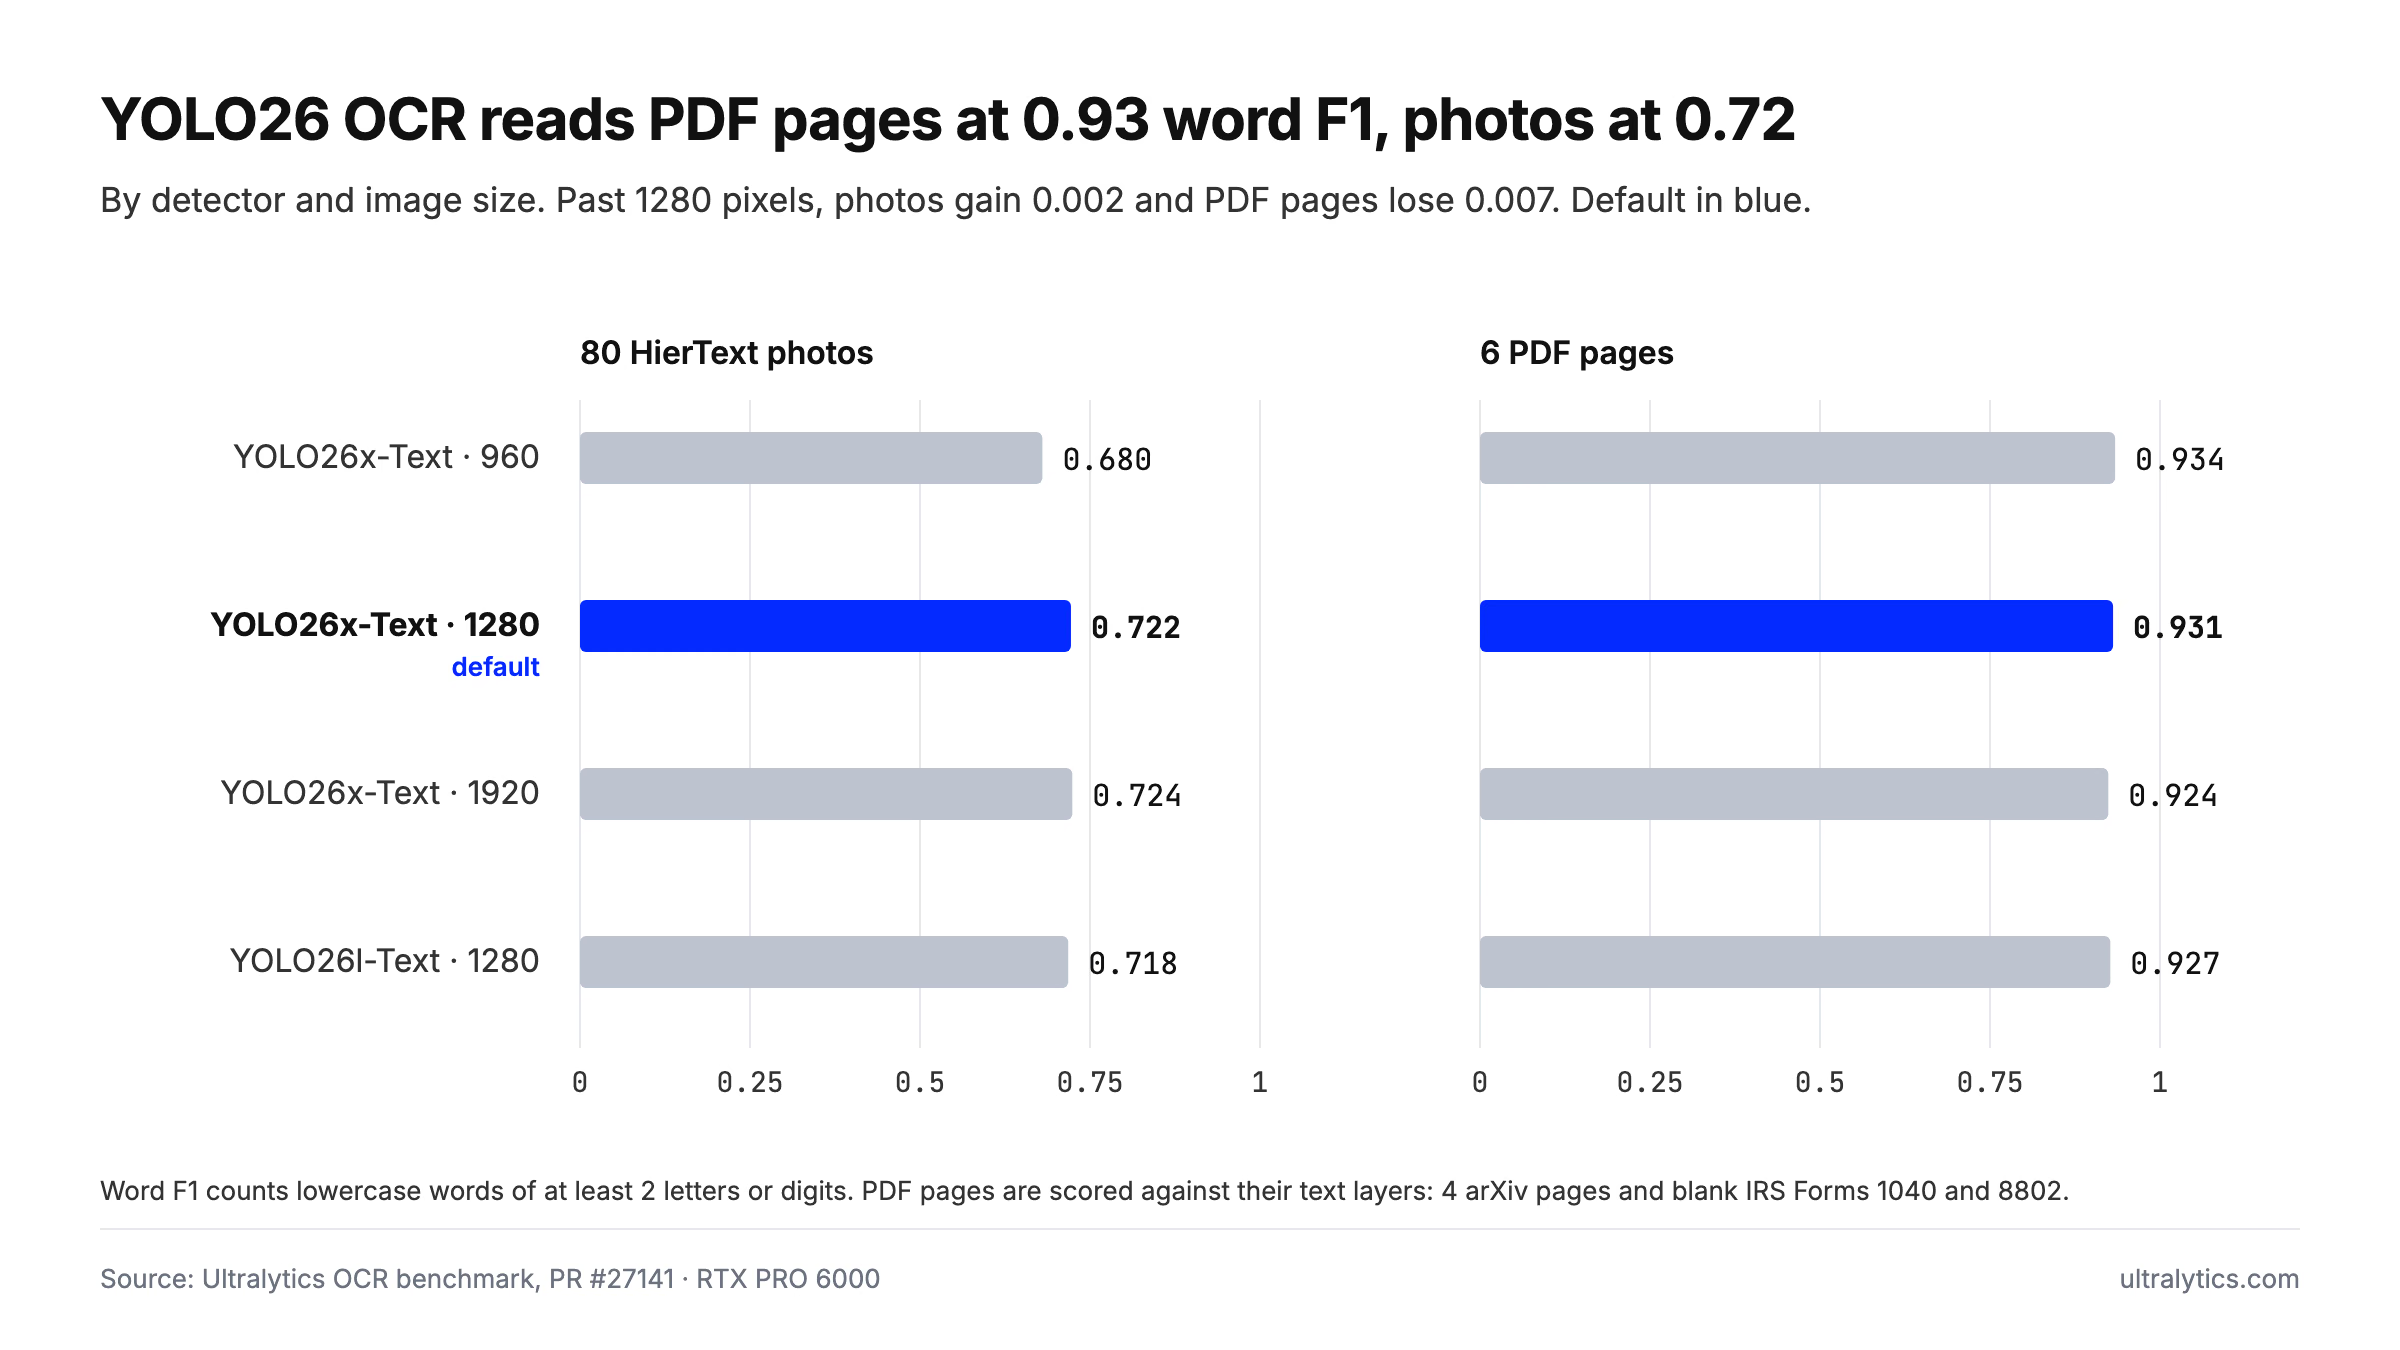
Word F1 của YOLO26-Text với PP-OCRv6 trên 80 ảnh HierText và 6 trang PDF, phân theo detector và kích thước ảnh, trên RTX PRO 6000.
Trang PDF sạch được đọc chính xác hơn nhiều so với ảnh chụp văn bản trong môi trường thực tế ở mọi cấu hình; các số liệu dẫn đến ba thiết lập mặc định:
yolo26x-textởimgsz=1280. Giảm xuống 960 làm F1 trên ảnh giảm 0.042, trong khi tăng lên 1920 giúp F1 trên ảnh tăng 0.002 nhưng làm F1 trên trang PDF giảm 0.007. Ảnh nhỏ hơn không được phóng lên 1280; chúng được xử lý ở kích thước gốc, làm tròn lên theo stride 32 của model.- Đọc từng từ. Đọc từng từ riêng lẻ đạt F1 cao hơn 4 điểm so với đọc cả dòng trên ảnh.
max_det=1000. Một trang tài liệu dày đặc có nhiều hơn 300 detection thông thường.
Nếu cần detector nhẹ hơn, YOLO26l-Text vẫn đạt kết quả thấp hơn model x chưa đến nửa điểm trên cả hai tập.
Cách chạy OCR bằng Python với YOLO26#
Cài đặt hoặc nâng cấp bằng pip install -U "ultralytics>=8.4.211". Lần gọi OCR đầu tiên sẽ tải YOLO26x-Text và PP-OCRv6, đồng thời cài ONNX Runtime; khi CUDA khả dụng, hệ thống dùng onnxruntime-gpu. Recognizer ONNX Runtime mặc định yêu cầu Python 3.11+ và ONNX Runtime 1.26+.
Đọc ảnh#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text với imgsz=1280 và PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # ảnh đã chú thích

for word in result.texts:
    print(word["line"], word["text"], round(word["confidence"], 2))
Từ command line, yolo solutions ocr source="path/to/video.mp4" thực hiện tương tự trên mọi frame. Mỗi frame được đọc độc lập, không tracking.
Đọc PDF#
Giải pháp nhận đầu vào là ảnh, vì vậy trước tiên hãy render từng trang PDF. PyMuPDF là một lựa chọn:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # đã theo đúng thứ tự đọc
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
Vì result.texts đã được sắp xếp sẵn, việc dựng lại văn bản thuần chỉ cần một dictionary và thao tác join. Polygon cho phép bạn xử lý sâu hơn, chẳng hạn kiểm tra một số tiền có nằm cạnh từ "Total" hay không.
Chọn model, thiết bị và recognizer#
- Detector nhỏ hơn:
solutions.OCR(model="yolo26s-text.pt")tải detector nhỏ hơn, nhanh hơn; hãy kiểm tra độ chính xác trên các trang của riêng bạn. Cả năm kích cỡ đều được tải tự động. - CPU hoặc GPU: recognizer chạy trên CUDA khi chọn GPU CUDA và có execution provider CUDA của ONNX Runtime; nếu không thì chạy trên CPU, nhờ đó cùng một script có thể chạy trên laptop hoặc server.
- Recognizer của riêng bạn: truyền một function làm
recognizer. Function nhận từng crop từ chứa từ ở định dạng BGR và trả về(text, confidence); giải pháp vẫn thực hiện phát hiện, xử lý góc xoay và sắp xếp xung quanh function đó.
def recognize(crop):
    # Chạy bất kỳ model nhận dạng nào trên crop từ BGR
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
TensorRT đọc từ nhanh hơn 2.5x đến 3x trên ảnh dày đặc#
Trong các bài kiểm tra GPU trên trang dày đặc, nhận dạng chiếm phần lớn thời gian, không phải phát hiện. Tối ưu hóa trước đây đo thời gian phát hiện khoảng 11 ms trong một request 250 ms; pull request TensorRT xác định phần lớn thời gian nhận dạng còn lại đến từ 33 batch nhỏ, bị chi phối bởi overhead khởi chạy thay vì tính toán. Ultralytics 8.4.211 bổ sung một tham số cho việc này:
ocr = solutions.OCR(recognizer="tensorrt") # Engine TensorRT FP16 trên GPU NVIDIALần chạy đầu tiên tạo engine TensorRT FP16 trong khoảng 30 giây và cache engine bên cạnh model PP-OCRv6, riêng cho từng phiên bản TensorRT và kiến trúc GPU. Các lần tải sau mất 0.05 đến 0.2 giây. Bản phát hành báo cáo tốc độ trên trang dày đặc nhanh hơn ONNX Runtime khoảng 2.5x.
Chúng tôi đo thời gian chạy read_words — bước sau phát hiện để crop, xoay, nhận dạng và sắp xếp từ — trên bốn ảnh chụp văn bản trong môi trường thực tế. Trên ba ảnh có 195 đến 263 từ, engine FP16 nhanh hơn ONNX Runtime trên CUDA từ 2.5x đến 3x; trên ảnh có 48 từ, engine nhanh hơn 1.4x:
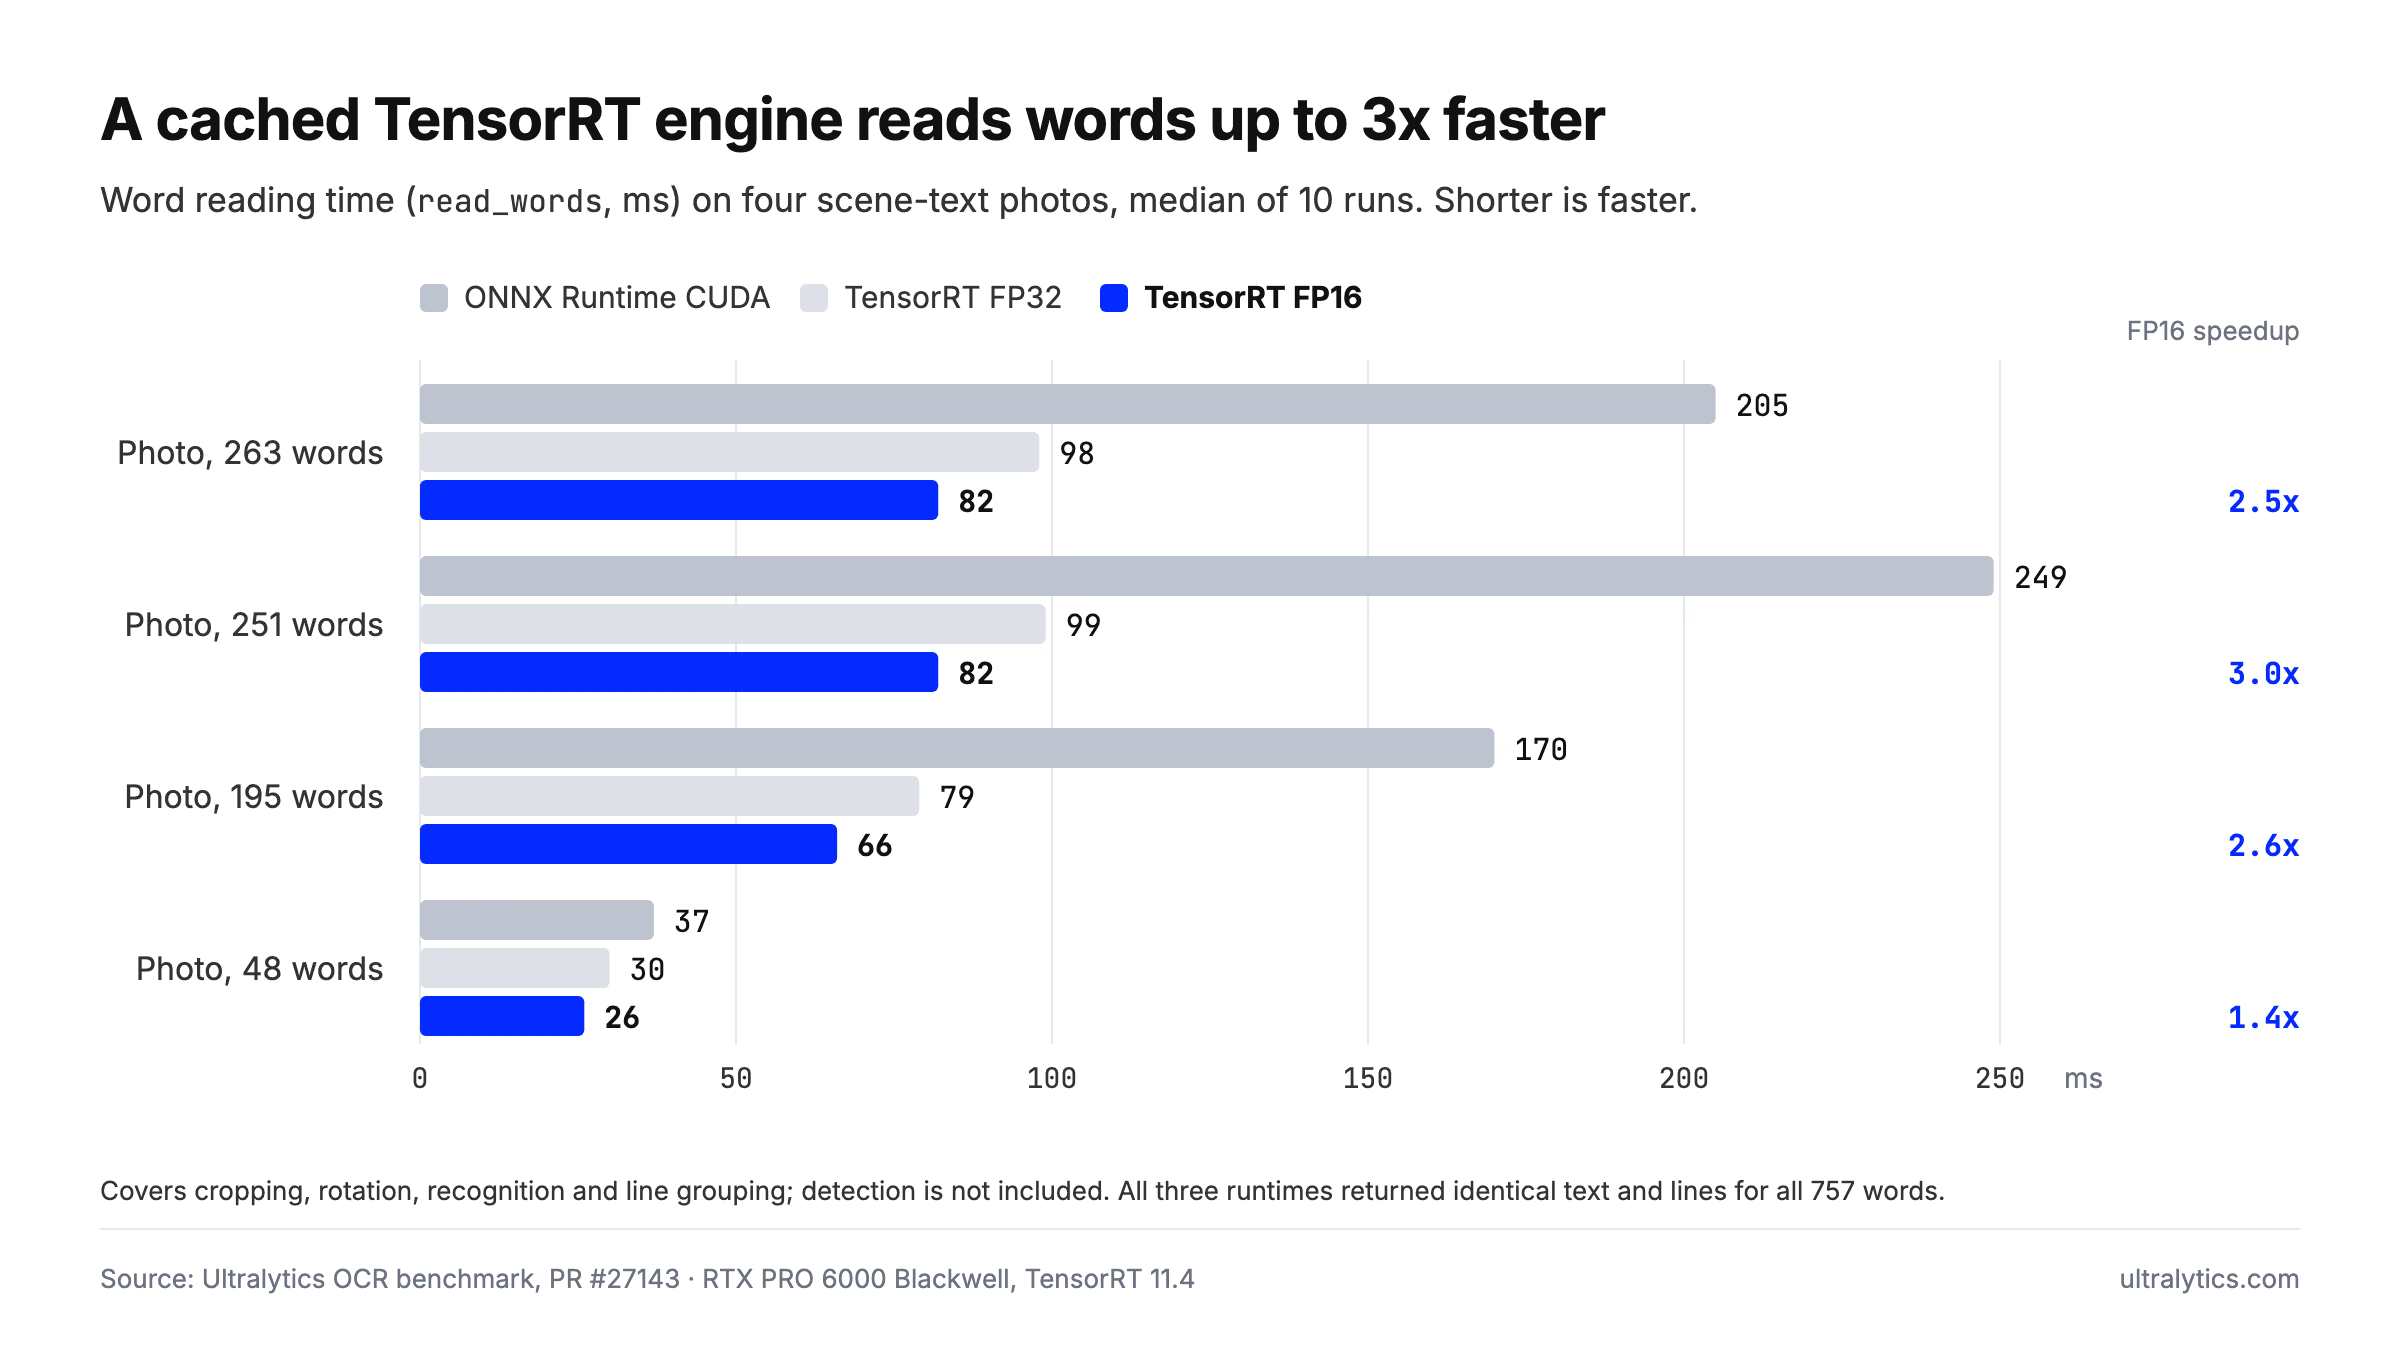
Thời gian đọc từ trên bốn ảnh chụp văn bản trong môi trường thực tế với ONNX Runtime CUDA và engine TensorRT FP32, FP16; trung vị của 10 lần chạy trên RTX PRO 6000 Blackwell với TensorRT 11.4.
Một lần gọi OCR đầy đủ trên trang dày đặc giảm thời gian từ 182 ms xuống 94 ms. Trên bốn ảnh này, tốc độ tăng không làm thay đổi đầu ra: với cả 757 từ, ONNX Runtime và cả hai engine đều trả về văn bản và cách nhóm dòng giống hệt nhau.
Giữ recognizer="paddleocr" mặc định nếu bạn không thể chờ lần build đầu tiên hoặc không dùng phần cứng NVIDIA. Cấu hình này không cần build và khởi động trong khoảng một giây. So sánh ONNX và TensorRT của chúng tôi trình bày cùng sự đánh đổi này đối với các model phát hiện, còn hướng dẫn tích hợp TensorRT trình bày cách thiết lập.
Hiện hỗ trợ chữ viết tiếng Trung, tiếng Nhật và chữ Latin#
PP-OCRv6 chỉ có thể xuất các ký tự trong bộ ký tự tích hợp gồm 18,708 ký tự. Detector YOLO26-Text không phụ thuộc vào bộ ký tự đó và vẫn tìm được từ trong các hệ chữ khác, nhưng từ nằm ngoài bộ ký tự sẽ được trả về dưới dạng các ký tự trông giống nhau. Chẳng hạn, tiếng Nga ТЕКСТ được đọc thành "TEKCT", thường với confidence cao.
- Được hỗ trợ: tiếng Trung giản thể và phồn thể (khoảng 15,600 ký tự CJK), tiếng Nhật (hiragana, katakana và kanji), cùng các ngôn ngữ dùng chữ Latin gồm tiếng Anh, Pháp, Đức, Tây Ban Nha, Bồ Đào Nha, Ý, Hà Lan, Thụy Điển, Phần Lan, Đan Mạch, Na Uy, Ba Lan, Séc, Hungary, Romania, Thổ Nhĩ Kỳ, Croatia, Indonesia và Malaysia. Hỗ trợ mọi chữ cái và chữ cái có dấu, ngoại trừ chữ ẞ viết hoa của tiếng Đức và ¡ của tiếng Tây Ban Nha.
- Hỗ trợ một phần: tiếng Việt, trong đó thiếu phần lớn nguyên âm có dấu thanh, và tiếng Hy Lạp, trong đó chỉ hỗ trợ các chữ cái cơ bản.
- Chưa hỗ trợ: chữ Cyrillic, tiếng Hàn (Hangul), tiếng Ả Rập, tiếng Hebrew, chữ Devanagari và tiếng Thái.
Với hệ chữ chưa được hỗ trợ, hãy giữ detector YOLO26-Text và truyền recognizer được huấn luyện cho hệ chữ đó làm recognizer. Bảng phạm vi hỗ trợ đầy đủ nằm trong phần ngôn ngữ được hỗ trợ của hướng dẫn OCR.
So sánh các thư viện OCR Python dựa trên khả năng được tài liệu hóa#
Không có một model OCR tốt nhất cho mọi trường hợp; lựa chọn phù hợp phụ thuộc vào trang, ngôn ngữ và môi trường chạy mã của bạn. Bảng so sánh các khả năng được tài liệu hóa, không phải kết quả đo lường, dựa trên các trang công khai của từng dự án được kiểm tra vào ngày 12 tháng 11 năm 2026. Các lựa chọn được liệt kê theo thứ tự bảng chữ cái.
| Lựa chọn | Môi trường chạy | Văn bản xoay | Ngôn ngữ theo tài liệu | Đầu ra |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info thử các góc 90°, 180° và 270° cho từng hộp văn bản | Hơn 80, gồm Cyrillic, tiếng Ả Rập, Devanagari, tiếng Hàn và tiếng Thái | Box, văn bản và confidence |
| PaddleOCR | PaddlePaddle | Phân loại hướng tùy chọn | Hơn 100 (PP-OCRv6 hỗ trợ 50 ngôn ngữ trong một model) | Box, văn bản và confidence |
| Tesseract (pytesseract) | Binary gốc, CPU | Phát hiện hướng và hệ chữ (image_to_osd); xoay ảnh trước khi đọc | 100+ | Văn bản, có thể kèm dữ liệu từ |
| Ultralytics YOLO26 OCR | Detector PyTorch; recognizer chạy trên ONNX Runtime hoặc TensorRT trên GPU NVIDIA | Ước tính góc xoay trang từ văn bản được phát hiện; tự động phân định 0° và 180° | Tiếng Trung, tiếng Nhật, chữ Latin; có thể hỗ trợ các hệ chữ khác bằng recognizer tùy chỉnh | Các từ theo thứ tự đọc, kèm số dòng, polygon và confidence phát hiện, nhận dạng riêng biệt |
Tài liệu EasyOCR, repository PaddleOCR, tài liệu Tesseract và pytesseract là những nơi bạn có thể kiểm tra các tùy chọn hiện tại. Để tìm hiểu cách các engine này hoạt động, hãy xem phần tổng quan về các model OCR mã nguồn mở phổ biến của chúng tôi.
Ultralytics phù hợp ở đâu#
Ultralytics YOLO26 OCR được xây dựng cho các nhà phát triển Python cần trích xuất văn bản từ nhiều loại đầu vào như biểu mẫu quét, trang PDF, ảnh chụp màn hình và ảnh chụp nhãn, biển báo; kết quả gồm các từ theo thứ tự đọc cùng tọa độ để kiểm tra. Giải pháp phù hợp khi trang được gửi đến ở các góc độ khó đoán, khi bạn muốn chạy OCR trên máy của mình hoặc khi bạn đã chạy các model Ultralytics YOLO26 và muốn tích hợp OCR trong cùng package. Thêm recognizer="tensorrt" để xử lý khối lượng lớn trên GPU NVIDIA.
Detector là một model Ultralytics thông thường, nên có thể train, validation và export như mọi model khác. Dự án YOLO26-Text trên Ultralytics Platform có đủ năm kích cỡ từ n đến x; tại đây, bạn có thể so sánh các đường cong huấn luyện và clone dự án để bắt đầu từ những model này.
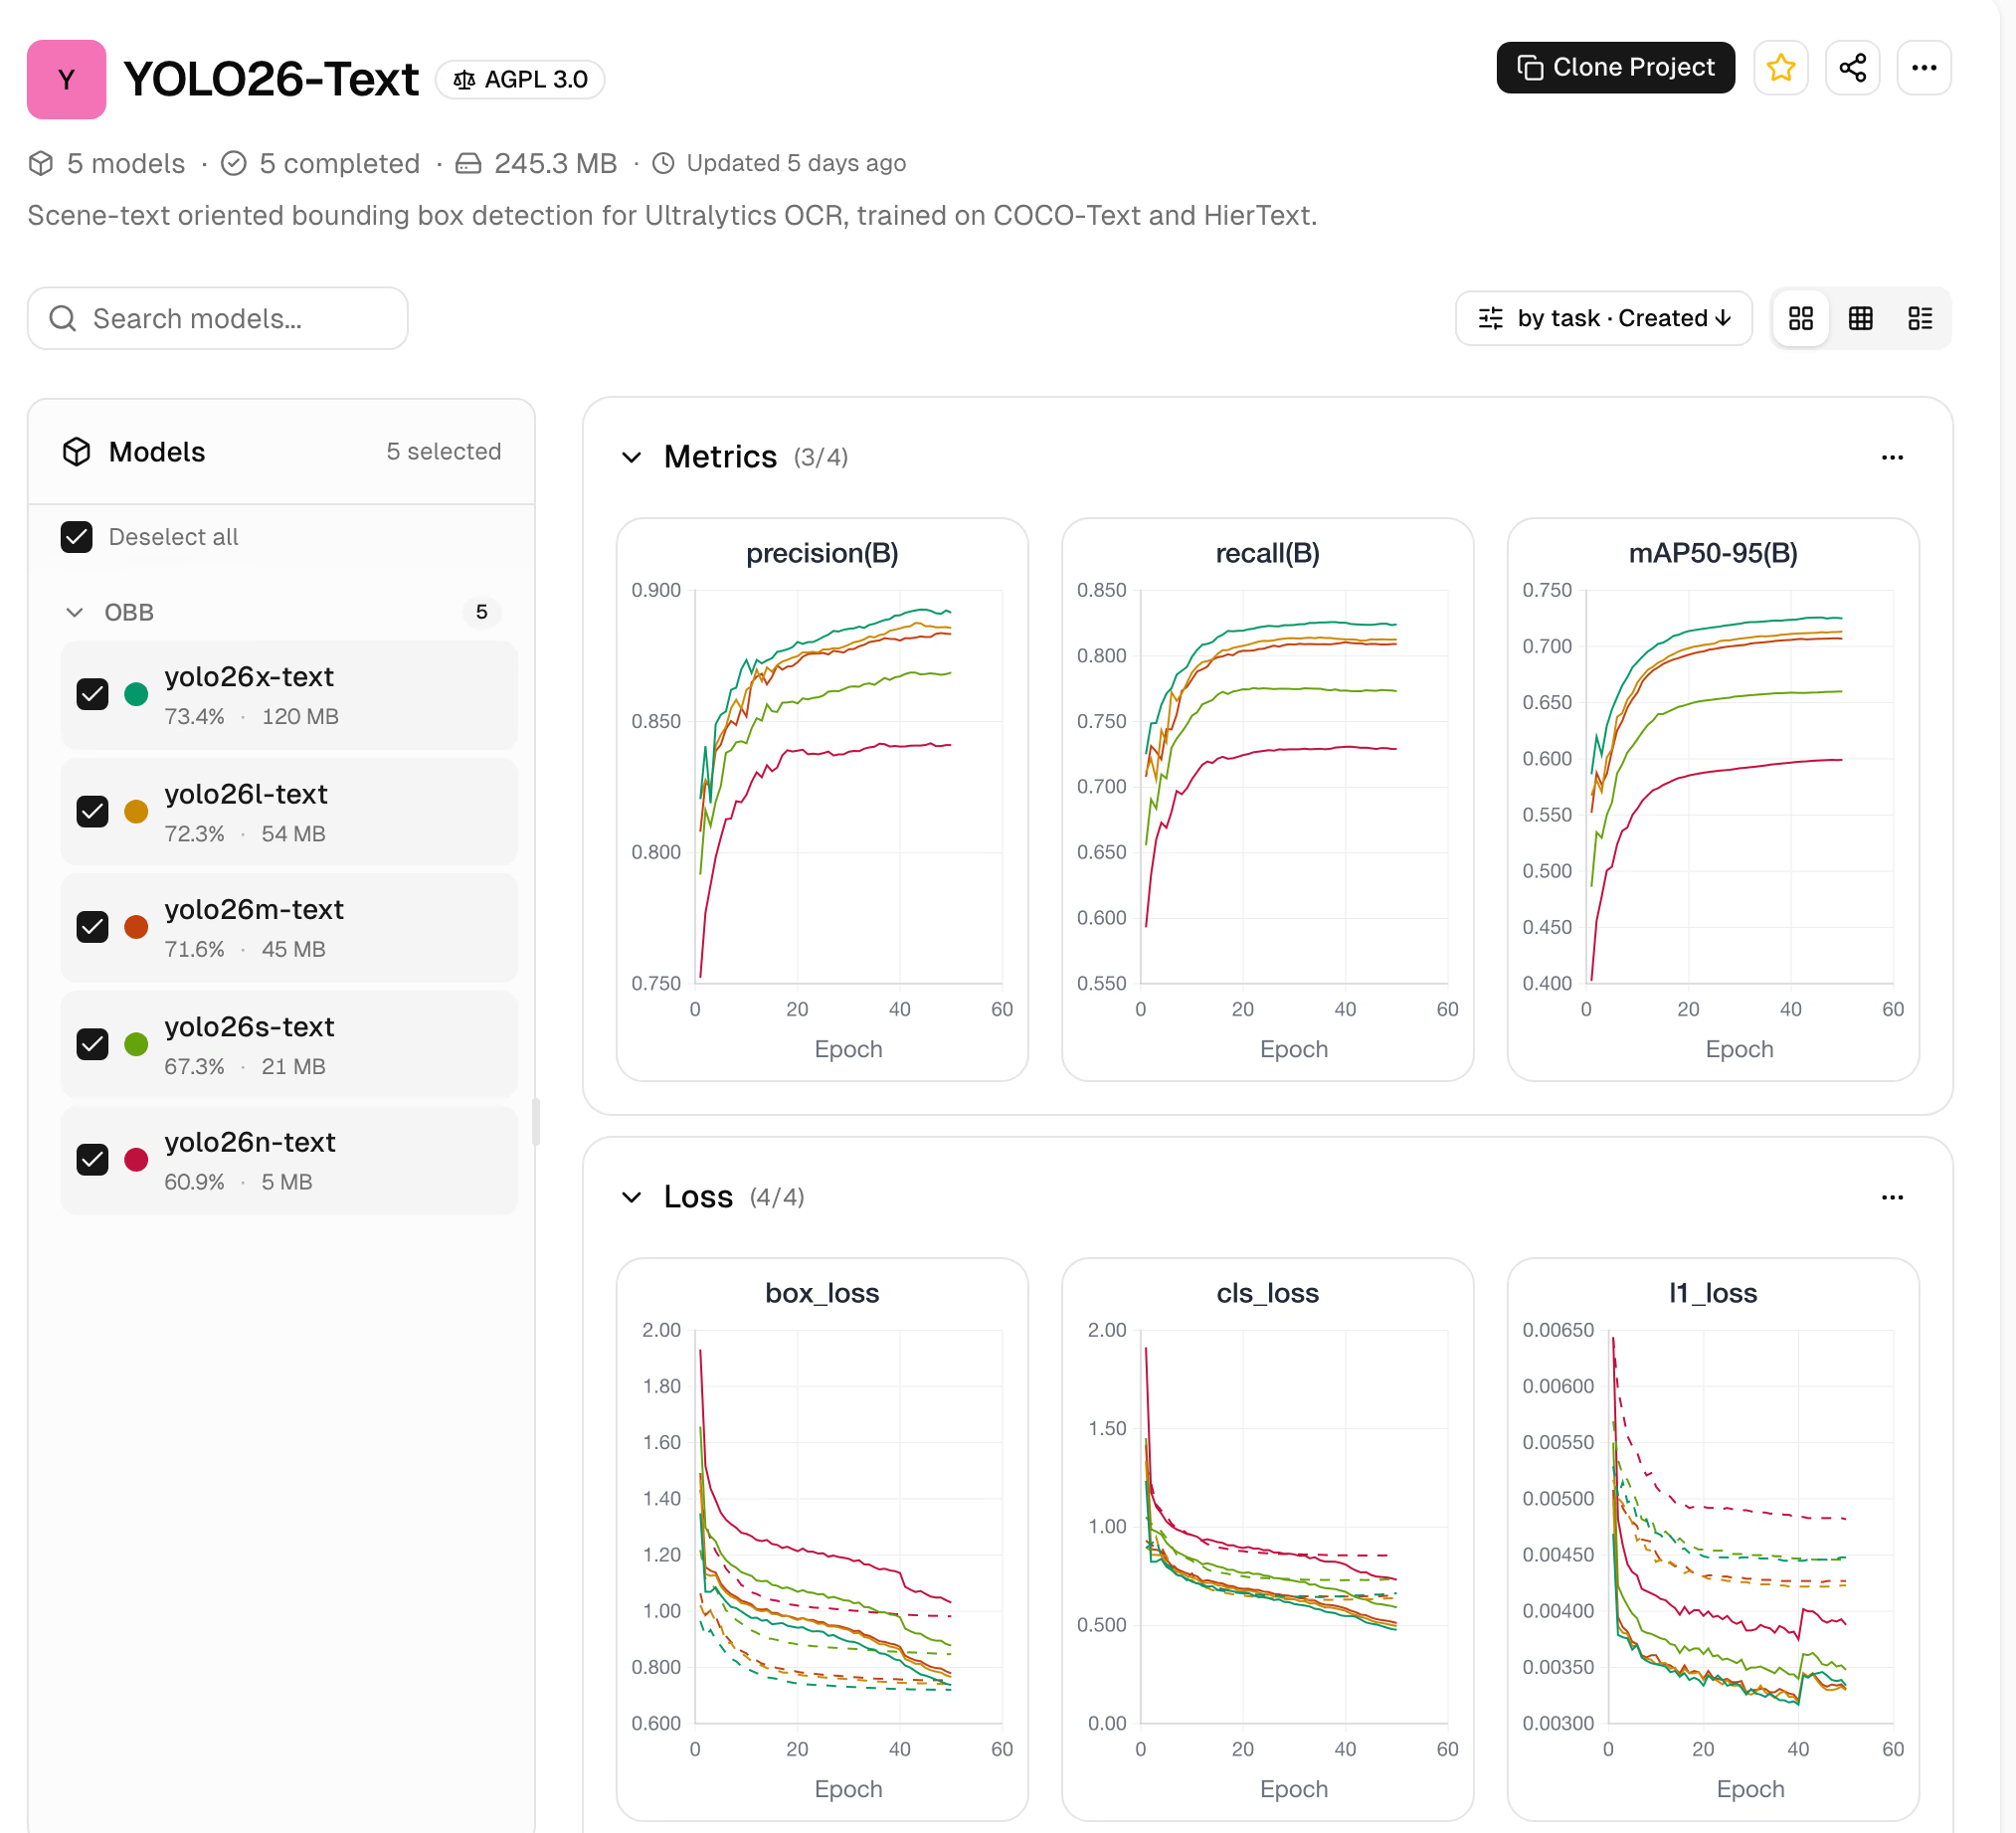
Dự án YOLO26-Text trên Ultralytics Platform: đủ năm kích cỡ detector cùng các đường cong precision, recall, mAP50-95 và loss trong quá trình huấn luyện.
Để điều chỉnh model cho tài liệu của bạn, hãy bắt đầu với dataset Scene Text OBB, kết hợp COCO-Text và HierText thành 65,325 ảnh với khoảng 1.29 triệu polygon từ.
Các hạn chế của giải pháp gồm:
- Hệ chữ. Recognizer mặc định hiện chưa đọc được chữ Cyrillic, tiếng Hàn, tiếng Ả Rập, tiếng Hebrew, chữ Devanagari hoặc tiếng Thái. Hãy ghép detector với recognizer của riêng bạn hoặc chọn engine hỗ trợ các hệ chữ này.
- Nhiều hướng văn bản. Giải pháp xoay toàn bộ trang theo hướng văn bản chiếm ưu thế, vì vậy văn bản chạy theo nhiều hướng trên cùng một trang, chẳng hạn ghi chú dọc ở lề, có thể được đọc kém chính xác hơn.
- Export. Recognizer không được nhúng vào file detector đã export, vì vậy hãy triển khai detector và runtime nhận dạng cạnh nhau hoặc dùng giải pháp Python làm lớp kết nối.
- Rust. Ultralytics Inference đọc văn bản trong môi trường thực tế bằng Rust với cùng recognizer PP-OCRv6 thông qua
ultralytics-inference predict --ocr, nhưng xử lý hướng bằng classifier thay vì bước xoay trang của giải pháp Python. - Quyền riêng tư. Giải pháp Python chạy trên phần cứng của bạn, nên trang không cần rời khỏi máy; bản demo trên trình duyệt tải trang lên để inference. Với các trường không được phép đọc, hãy che các vùng đã biết bằng mask đục trước khi chạy OCR.
Với biểu mẫu và hợp đồng, model YOLO tùy chỉnh có thể tìm các trường, bảng, chữ ký và con dấu trước, nhờ đó bạn chỉ cần đọc những vùng cần thiết. Dataset Signature trên Ultralytics Platform và hướng dẫn về phân tích tài liệu thông minh là những điểm bắt đầu phù hợp; Ultralytics Platform cho phép bạn gán nhãn trang và train model đó tại cùng một nơi. Để thử OCR trên trang của riêng bạn trước, hãy thả ảnh hoặc PDF vào bản demo OCR trực tiếp.
Câu hỏi thường gặp
Cài package Ultralytics bằng
pip install -U "ultralytics>=8.4.211", sau đó gọisolutions.OCR()trên ảnh được tải bằng OpenCV. Kết quả trả về các từ đã nhận dạng cùng văn bản, confidence, số dòng và polygon theo thứ tự đọc. Lần chạy đầu tiên tự động tải detector YOLO26-Text và recognizer PP-OCRv6.Điều này tùy thuộc vào tài liệu, ngôn ngữ và phần cứng của bạn; phần tổng quan về các model OCR mã nguồn mở phổ biến của chúng tôi so sánh các lựa chọn chính. Trong benchmark ở kích thước ảnh 1280 trên RTX PRO 6000, YOLO26x-Text với PP-OCRv6 đạt word F1 0.931 trên sáu trang PDF và 0.722 trên 80 ảnh HierText, đồng thời đọc được trang ở mọi góc xoay. Với các hệ chữ chưa được hỗ trợ, chẳng hạn Cyrillic hoặc tiếng Hàn, hãy dùng recognizer được huấn luyện cho hệ chữ đó.
Model YOLO phát hiện văn bản nhưng không đọc văn bản. Ultralytics YOLO26-Text phát hiện văn bản dưới dạng các box định hướng; giải pháp OCR chuyển từng crop cho recognizer PP-OCRv6, nhờ đó hai thành phần kết hợp thực hiện OCR đầy đủ chỉ với một lần gọi.
Có. Kết xuất từng trang PDF thành ảnh, chẳng hạn bằng
get_pixmapcủa PyMuPDF, chuyển ảnh sang BGR rồi truyền ảnh chosolutions.OCR(). Trong trình duyệt, bản demo và tab Platform Predict chấp nhận PDF và đọc trang đầu tiên.Có. PP-OCRv6 chạy trên ONNX Runtime bằng CPU hoặc GPU CUDA, và cùng một script hoạt động trên cả hai. Bộ nhận dạng TensorRT tùy chọn cần GPU NVIDIA.
Hiện tại, bộ nhận dạng mặc định chưa hỗ trợ. PP-OCRv6 hỗ trợ tiếng Trung, tiếng Nhật và các ngôn ngữ dùng chữ cái Latinh, nhưng không hỗ trợ chữ Cyrillic, Hangul, chữ Ả Rập, chữ Hebrew, Devanagari hoặc tiếng Thái. Bạn có thể tiếp tục dùng bộ phát hiện YOLO26-Text và truyền vào bộ nhận dạng được huấn luyện cho hệ chữ đó.
Được viết bởi
Senior Machine Learning Engineer · Ultralytics
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









