Los mejores modelos de detección de objetos
Descubre los mejores modelos de detección de objetos de 2026, desde Ultralytics YOLO hasta RT-DETR, con una comparativa de arquitecturas, compromisos de rendimiento y factores de despliegue.
 Abirami Vina14 min de lectura
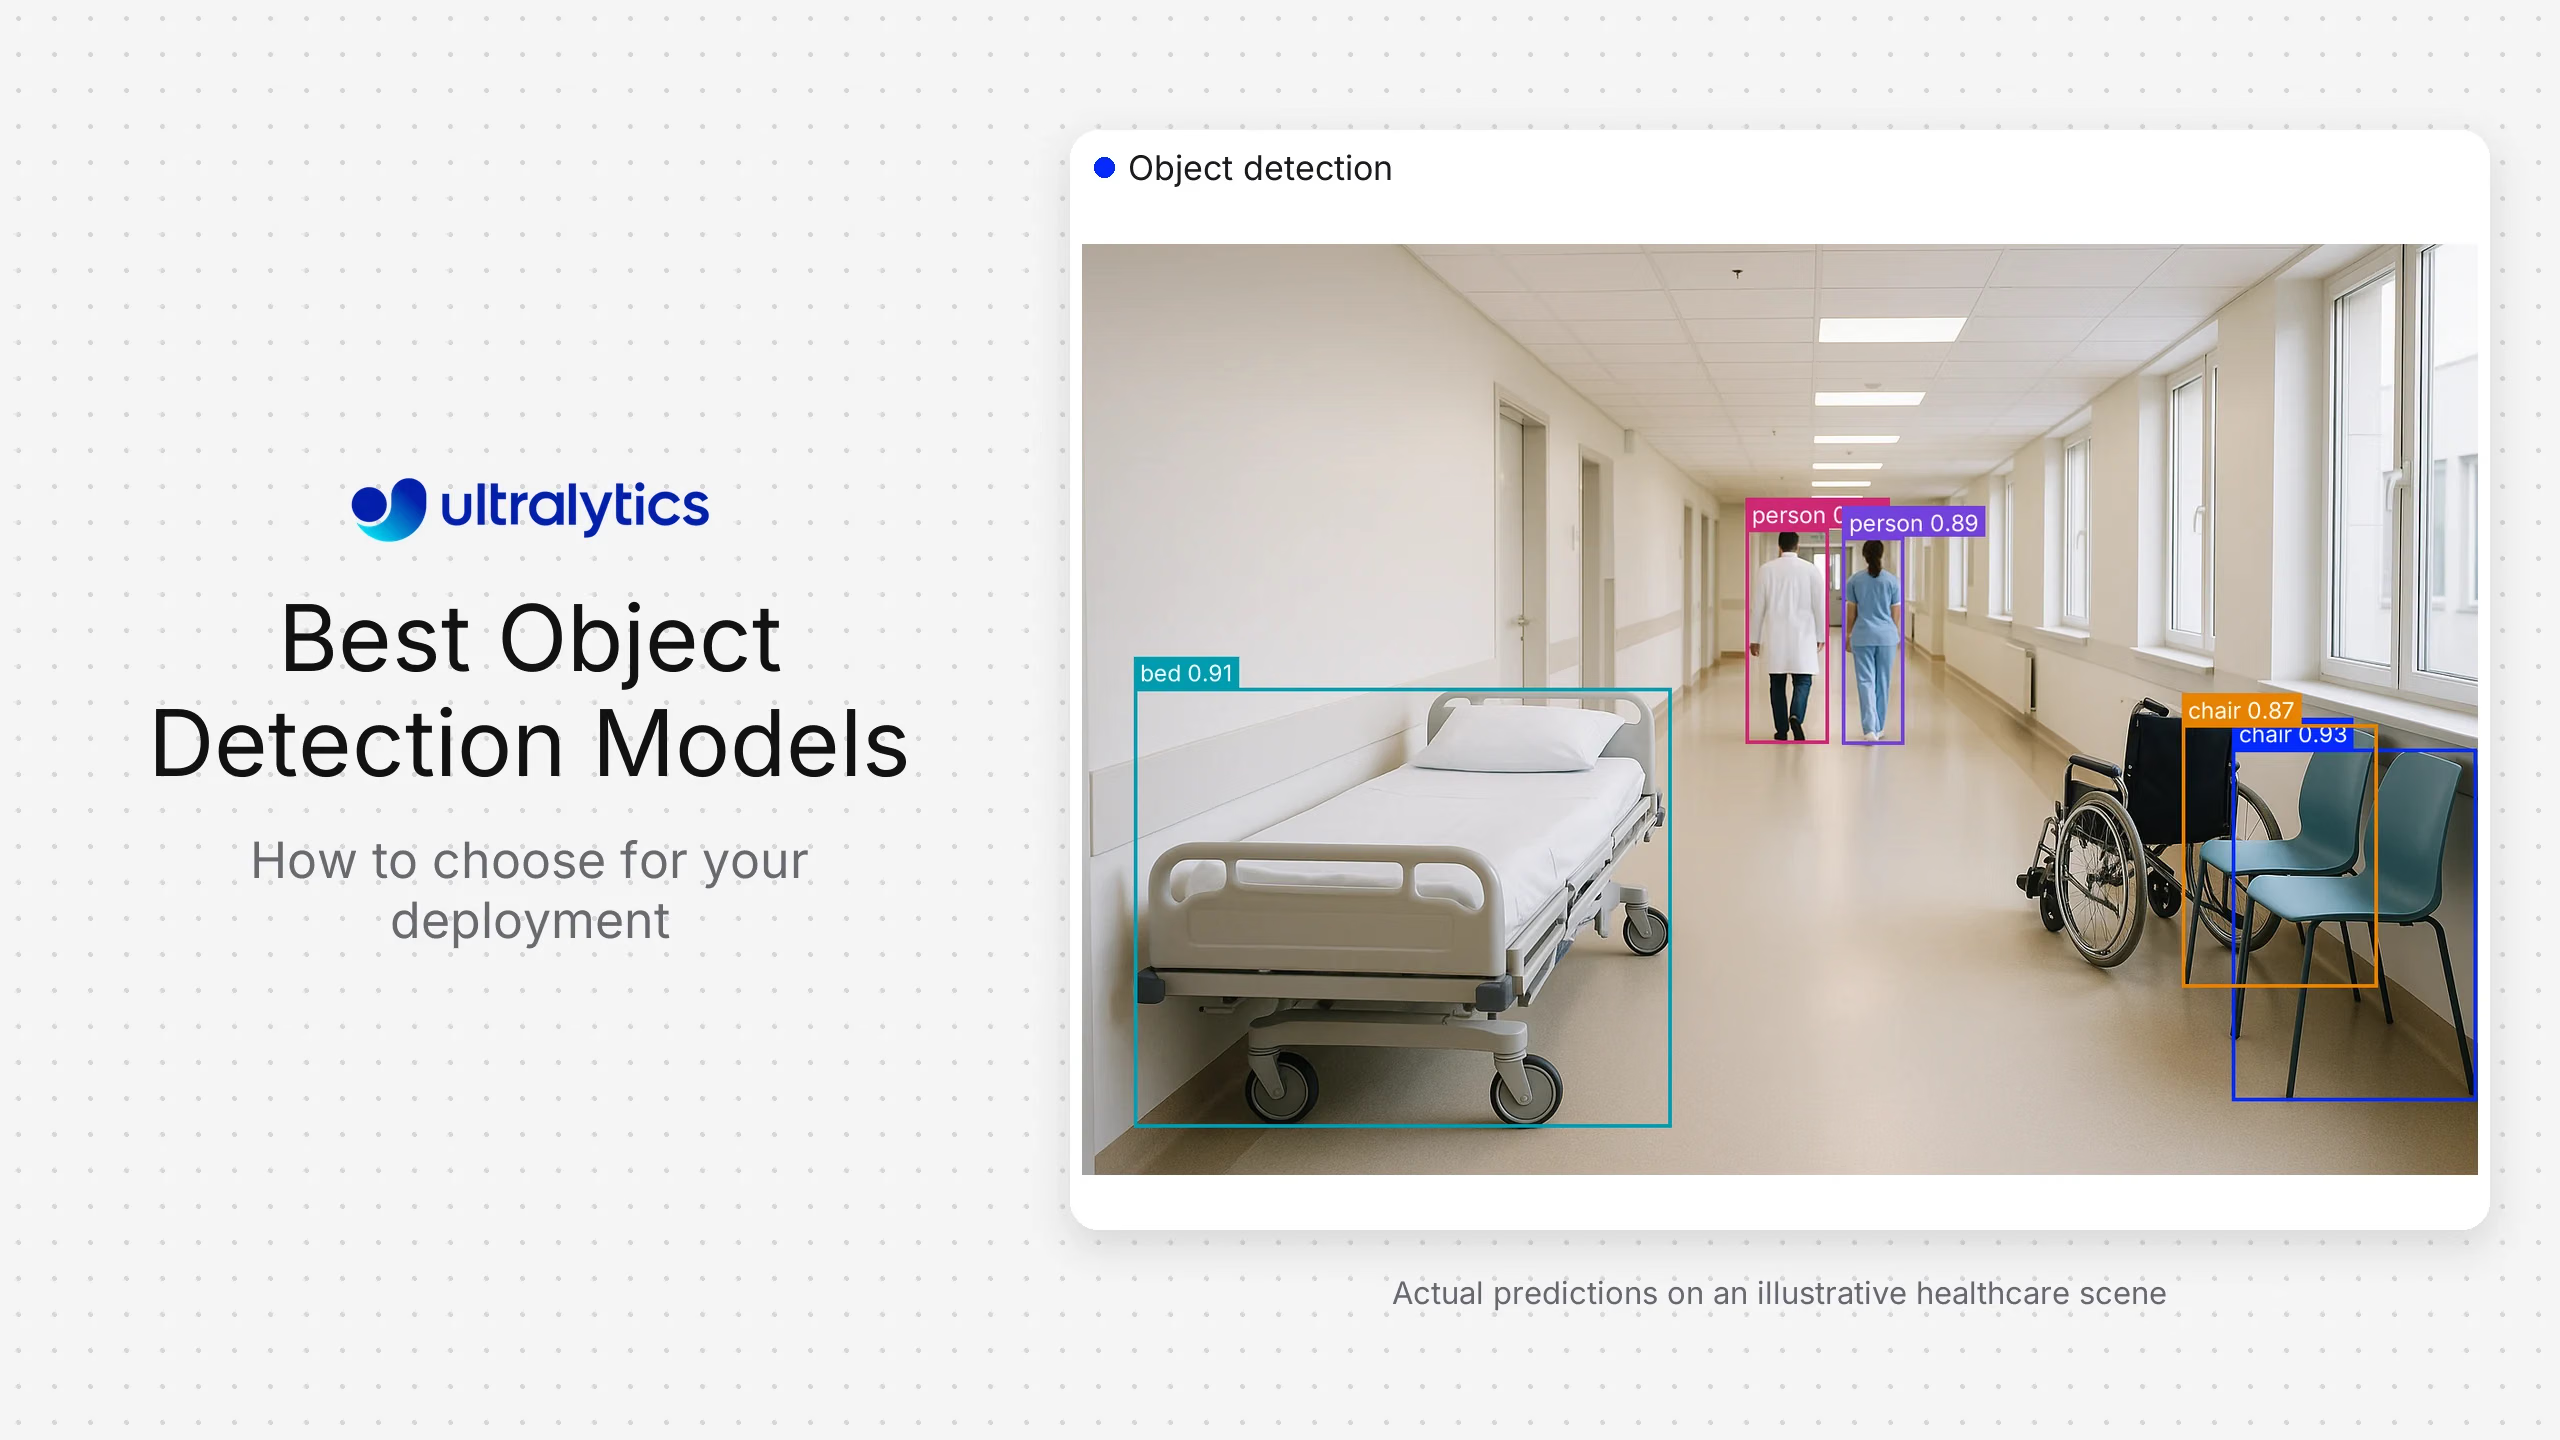
A principios de este año, Andrew Ng, pionero de la IA y el aprendizaje automático, presentó el concepto de detección de objetos agéntica. Este enfoque usa un agente de razonamiento para detectar objetos a partir de una indicación de texto, sin necesidad de grandes cantidades de datos de entrenamiento.
Poder identificar objetos en imágenes y vídeos sin necesitar conjuntos de datos etiquetados enormes es un paso hacia sistemas de visión artificial más inteligentes y flexibles. Sin embargo, la IA de visión agéntica aún está en sus primeras etapas.
Aunque puede realizar tareas generales, como detectar personas o señales de tráfico en una imagen, las aplicaciones de visión artificial más precisas siguen dependiendo de los modelos tradicionales de detección de objetos. Estos modelos se entrenan con conjuntos de datos grandes y cuidadosamente etiquetados para aprender exactamente qué buscar y dónde se encuentran los objetos.
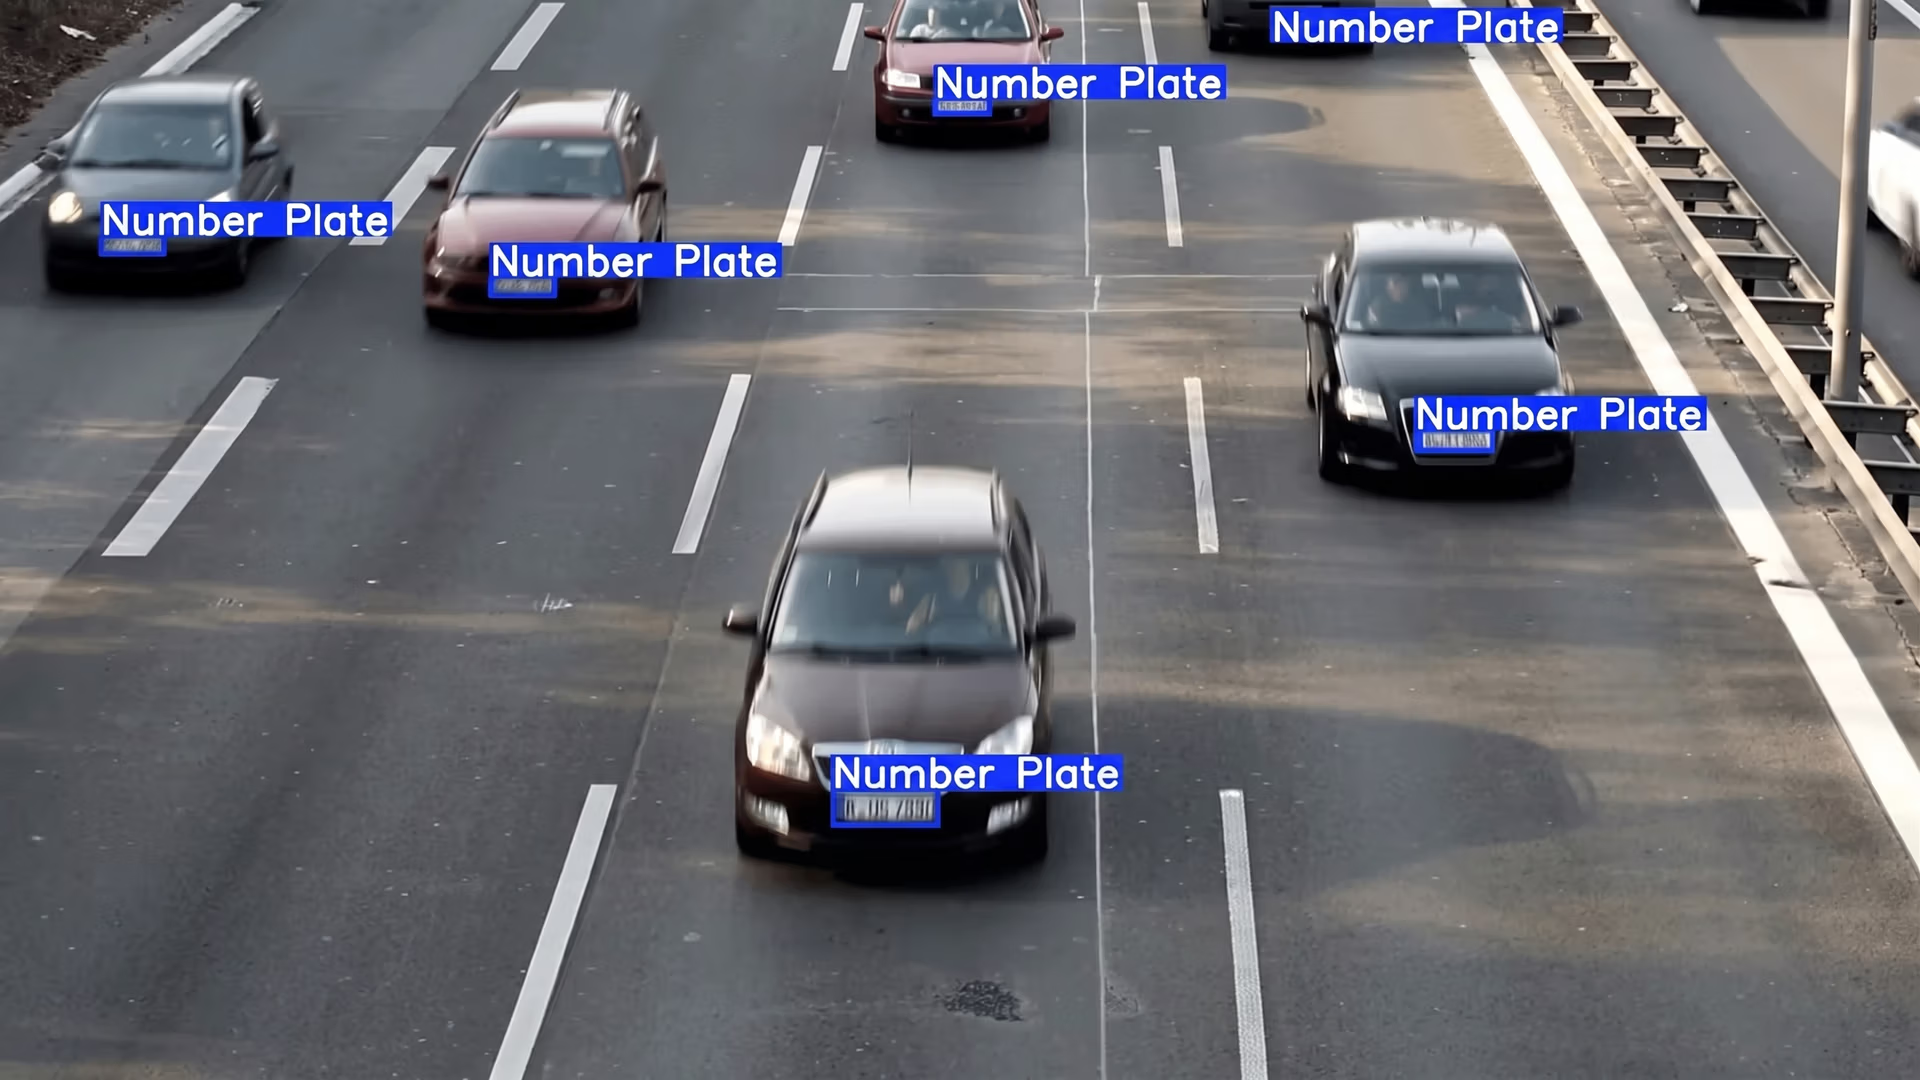
Fig. 1. Ejemplo de detección de objetos. (Fuente)
La detección de objetos tradicional es esencial porque ofrece tanto reconocimiento —identifica qué es el objeto— como localización —determina exactamente dónde está en la imagen—. Esta combinación permite que las máquinas realicen de forma fiable tareas complejas del mundo real, desde la conducción autónoma hasta la automatización industrial y el diagnóstico sanitario.
Los modelos de detección de objetos siguen mejorando: son más rápidos, más precisos y se adaptan mejor a entornos reales. En este artículo, repasaremos algunos de los mejores modelos de detección de objetos disponibles actualmente.
La necesidad de detectar objetos#
Tareas de visión artificial como la clasificación de imágenes permiten determinar si una imagen contiene un coche, una persona u otro objeto. Sin embargo, no permiten determinar dónde se encuentra el objeto dentro de la imagen.
Aquí es donde entra en juego la detección de objetos. Los modelos de detección de objetos pueden identificar qué objetos hay y señalar también su ubicación exacta. Este proceso, conocido como localización, permite a las máquinas comprender las escenas con mayor precisión y responder adecuadamente, ya sea deteniendo un coche autónomo, guiando el brazo de un robot o señalando una zona en imágenes médicas.
El auge del aprendizaje profundo ha transformado la detección de objetos. En lugar de depender de reglas programadas manualmente, los modelos modernos aprenden patrones directamente de las anotaciones y los datos visuales. Estos conjuntos de datos enseñan a los modelos qué aspecto tienen los objetos, dónde suelen aparecer y cómo afrontar desafíos como los objetos pequeños, las escenas abarrotadas o las condiciones de iluminación cambiantes.
De hecho, los sistemas de detección de objetos más avanzados pueden detectar varios objetos a la vez con precisión. Esto convierte la detección de objetos en una tecnología fundamental para aplicaciones como la conducción autónoma, la robótica, la sanidad y la automatización industrial.
Cómo funcionan las tareas de detección de objetos#
La entrada de un modelo de detección de objetos es una imagen, que puede proceder de una cámara, un fotograma de vídeo o incluso una prueba médica de imagen. La imagen de entrada se procesa mediante una red neuronal, normalmente una red neuronal convolucional (CNN), entrenada para reconocer patrones en datos visuales.
Dentro de la red, la imagen se analiza por etapas. A partir de las características que detecta, el modelo predice qué objetos están presentes y dónde aparecen.
Estas predicciones se representan mediante recuadros delimitadores, es decir, rectángulos dibujados alrededor de cada objeto detectado. Para cada recuadro delimitador, el modelo asigna una etiqueta de clase (por ejemplo, coche, persona o perro) y una puntuación de confianza que indica cuánta certeza tiene sobre la predicción (también se puede interpretar como una probabilidad).
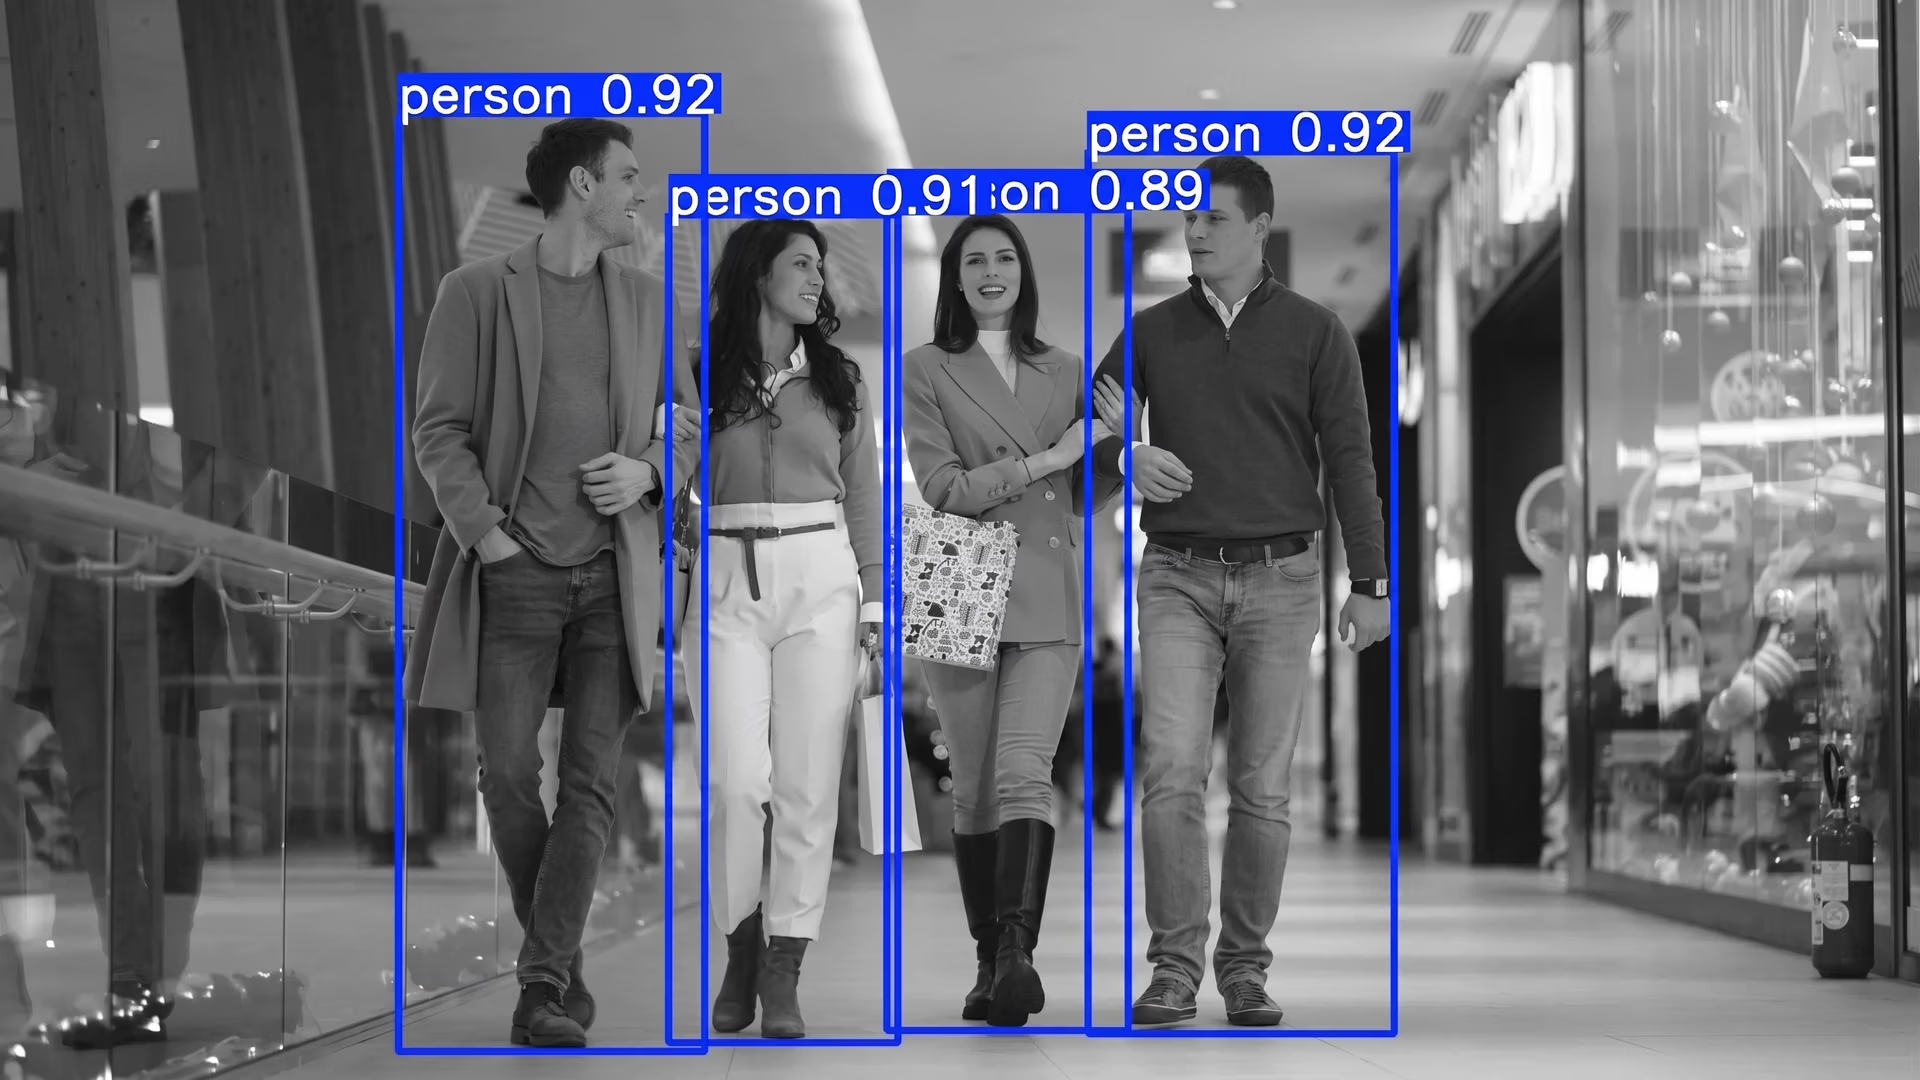
Fig. 2. Las predicciones de detección de objetos se pueden visualizar mediante recuadros delimitadores.
El proceso general depende en gran medida de la extracción de características. El modelo aprende a identificar patrones visuales útiles, como bordes, formas, texturas y otras características distintivas. Estos patrones se codifican en mapas de características, que ayudan a la red a comprender la imagen con distintos niveles de detalle.
Detección de objetos: dos etapas y una etapa#
Según la arquitectura del modelo, los detectores de objetos usan distintas estrategias para localizar objetos y equilibrar velocidad, precisión y complejidad.
Muchos modelos de detección de objetos, en particular los detectores de dos etapas como Faster R-CNN, se centran en partes concretas de la imagen denominadas regiones de interés (ROIs). Al centrarse en estas zonas, el modelo prioriza las regiones con más probabilidades de contener objetos, en lugar de analizar todos los píxeles por igual.
En cambio, los modelos de una etapa, como los primeros modelos YOLO, no seleccionan regiones de interés (ROIs) específicas como los modelos de dos etapas. En su lugar, dividen la imagen en una cuadrícula y usan recuadros predefinidos, denominados recuadros de anclaje, junto con mapas de características para predecir objetos en toda la imagen en una sola pasada.
Muchos modelos modernos de detección de objetos, incluidos los modelos recientes de Ultralytics YOLO, utilizan enfoques sin anclajes. A diferencia de los modelos tradicionales de una sola etapa, que dependen de cajas de anclaje predefinidas, los modelos sin anclajes predicen directamente la ubicación y el tamaño de los objetos a partir de mapas de características. Esto puede simplificar la arquitectura, reducir la carga computacional y mejorar el rendimiento, especialmente al detectar objetos de distintas formas y tamaños.
Un repaso a los mejores modelos de detección de objetos#
Hoy en día hay muchos modelos de detección de objetos, cada uno diseñado con objetivos concretos. Algunos están optimizados para ofrecer un rendimiento en tiempo real, mientras que otros se centran en alcanzar la máxima precisión. La elección del modelo adecuado para una solución de visión artificial suele depender del caso de uso específico y de los requisitos de rendimiento.
A continuación, descubre algunos de los mejores modelos de detección de objetos de 2026.
1. Modelos Ultralytics YOLO#
Una de las familias de modelos de detección de objetos más utilizadas hoy en día es la familia de modelos Ultralytics YOLO. YOLO, siglas de You Only Look Once, es popular en distintos sectores porque ofrece un alto rendimiento de detección y, a la vez, es rápido, fiable y fácil de usar.
La familia Ultralytics YOLO incluye Ultralytics YOLOv5, Ultralytics YOLOv8, Ultralytics YOLO11 y el último modelo, Ultralytics YOLO26, con distintas opciones para satisfacer requisitos de rendimiento y casos de uso. Gracias a su diseño ligero y a la optimización de su velocidad, los modelos Ultralytics YOLO son ideales para la detección en tiempo real y se pueden implementar en dispositivos edge con una potencia de cálculo y una memoria limitadas.
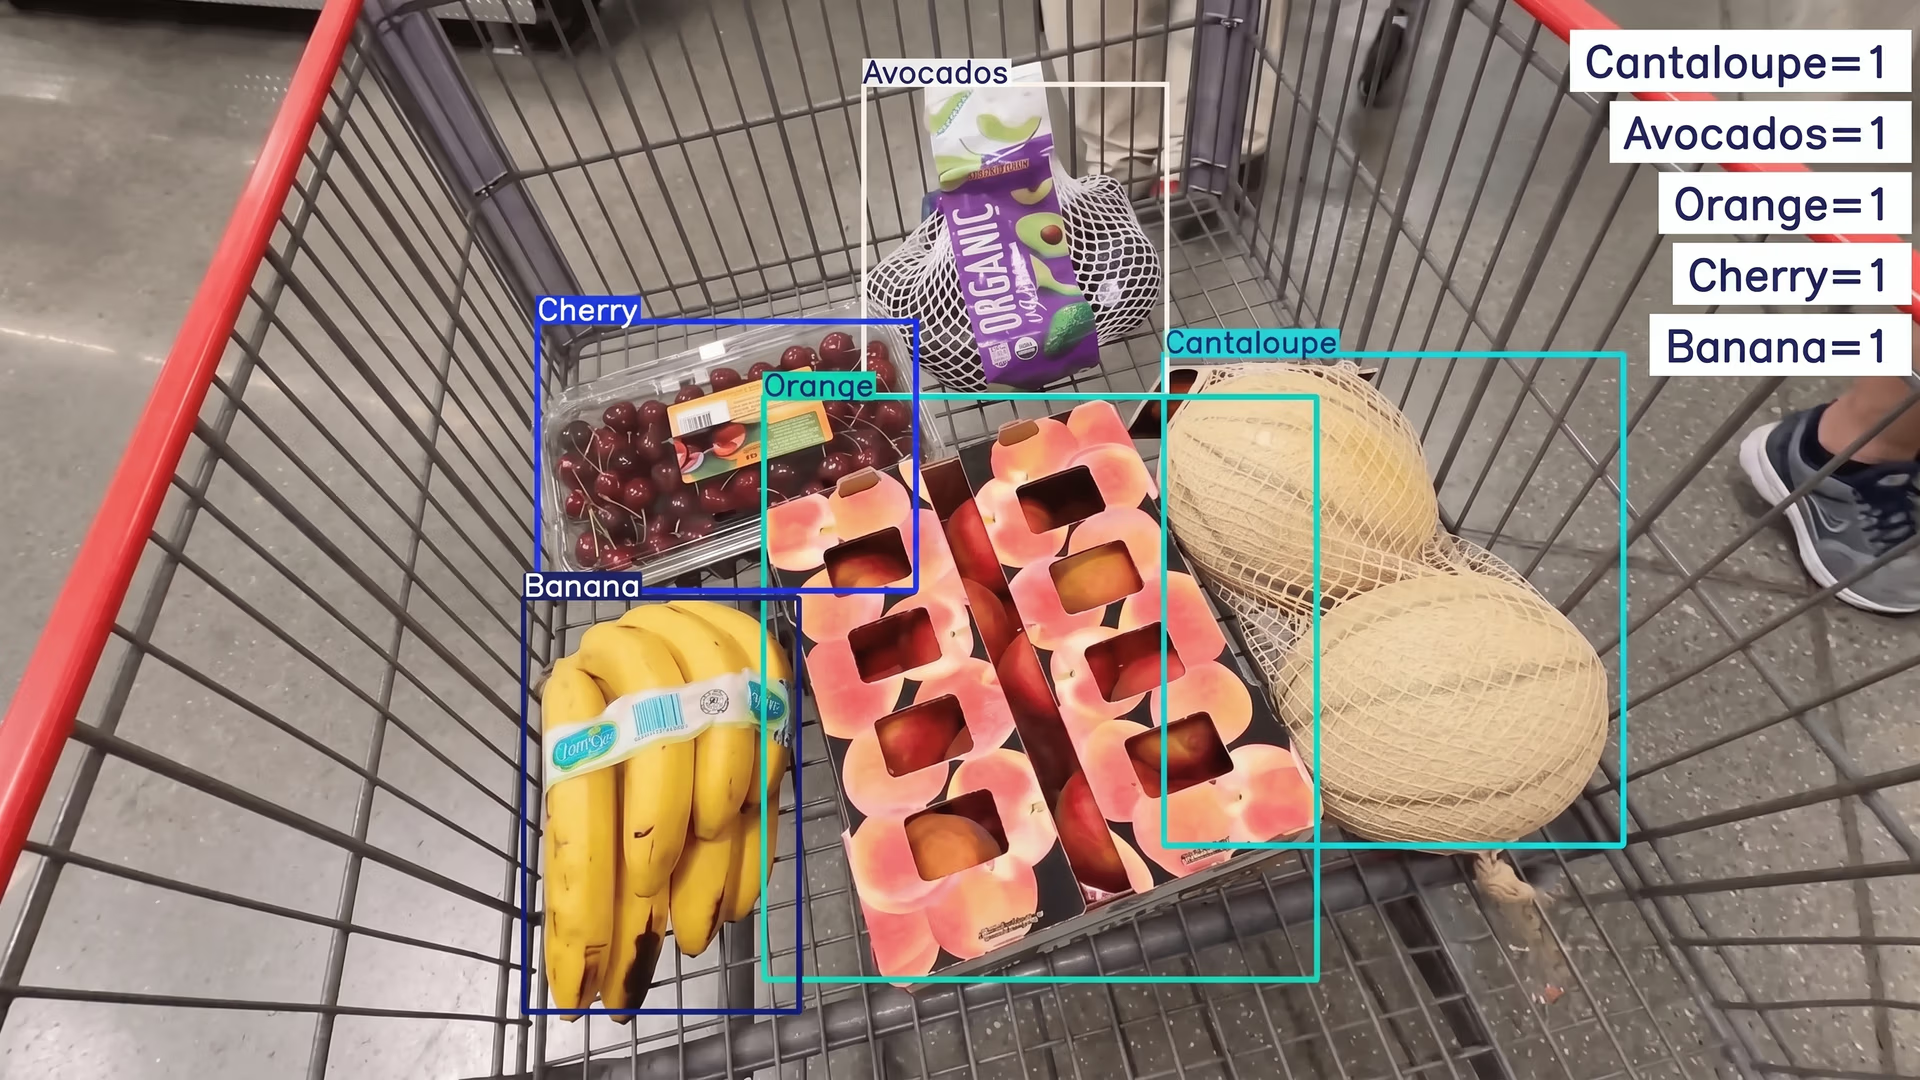
Fig. 3. Uso de Ultralytics YOLO11 para la detección de objetos (Fuente)
Además de la detección básica de objetos, estos modelos son muy versátiles. También admiten tareas como la segmentación de instancias, que delimita los objetos a nivel de píxel, y la estimación de pose, que identifica puntos clave en personas u objetos. Esta flexibilidad convierte los modelos Ultralytics YOLO en una opción preferente para una amplia variedad de aplicaciones, desde la agricultura y la logística hasta el comercio minorista y la fabricación.
Otra razón clave de la popularidad de los modelos Ultralytics YOLO es el paquete de Python de Ultralytics, que ofrece una interfaz sencilla y fácil de usar para entrenar, ajustar e implementar modelos. Los desarrolladores pueden empezar con pesos preentrenados, personalizar los modelos para sus propios conjuntos de datos e implementarlos con solo unas pocas líneas de código.
2. RT-DETR y RT-DETRv2#
RT‑DETR (Transformer de detección en tiempo real) y la versión más reciente, RT‑DETRv2, son modelos de detección de objetos diseñados para usarse en tiempo real. A diferencia de muchos modelos tradicionales, pueden recibir una imagen y generar directamente las detecciones finales sin utilizar la supresión no máxima (NMS).
NMS es un paso que elimina las cajas superpuestas sobrantes cuando un modelo predice el mismo objeto más de una vez. Omitir NMS simplifica y acelera el proceso de detección.
Estos modelos combinan CNN con transformers. La CNN detecta detalles visuales como bordes y formas, mientras que el transformer es un tipo de red neuronal capaz de analizar toda la imagen a la vez y comprender cómo se relacionan sus distintas partes. Esta comprensión global permite al modelo detectar objetos cercanos o superpuestos.
RT‑DETRv2 mejora el modelo original con funciones como la detección multiescala, que ayuda a encontrar objetos tanto pequeños como grandes, y una mejor gestión de escenas complejas. Estos cambios mantienen la velocidad del modelo y mejoran su precisión.
3. RF-DETR#
RF‑DETR es un modelo en tiempo real basado en Transformer, diseñado para combinar la precisión de las arquitecturas Transformer con la velocidad necesaria para las aplicaciones reales. Al igual que RT‑DETR y RT‑DETRv2, utiliza un Transformer para analizar toda la imagen y una CNN para extraer características visuales detalladas, como bordes, formas y texturas.
El modelo predice objetos directamente a partir de la imagen de entrada, sin utilizar cajas de anclaje ni supresión no máxima, lo que simplifica el proceso de detección y mantiene rápida la inferencia. RF‑DETR también admite la segmentación de instancias, por lo que puede delimitar los objetos a nivel de píxel además de predecir cajas delimitadoras.
4. EfficientDet#
Lanzado a finales de 2019, EfficientDet es un modelo de detección de objetos diseñado para ofrecer un escalado eficiente y un alto rendimiento. Lo que distingue a EfficientDet es el escalado compuesto, un método que escala simultáneamente la resolución de entrada, la profundidad de la red y su anchura, en lugar de ajustar un solo factor. Este enfoque ayuda al modelo a mantener una precisión estable, tanto si se amplía para tareas de alto rendimiento como si se reduce para implementarlo en dispositivos ligeros.
Otro componente clave de EfficientDet es su red piramidal de características eficiente (FPN), que permite al modelo analizar imágenes a varias escalas. Este análisis multiescala es fundamental para detectar objetos de distintos tamaños y permite a EfficientDet identificar de forma fiable objetos pequeños y grandes en una misma imagen.
5. PP-YOLOE+#
Lanzado en 2022, PP-YOLOE+ es un modelo de detección de objetos al estilo YOLO, es decir, detecta y clasifica objetos en una sola pasada por la imagen. Este enfoque lo hace rápido y adecuado para aplicaciones en tiempo real, sin dejar de ofrecer una gran precisión.
Una de las principales mejoras de PP-YOLOE+ es el aprendizaje alineado con la tarea, que ayuda a que las puntuaciones de confianza del modelo reflejen la precisión con la que se localizan los objetos. Esto resulta especialmente útil para detectar objetos pequeños o superpuestos.
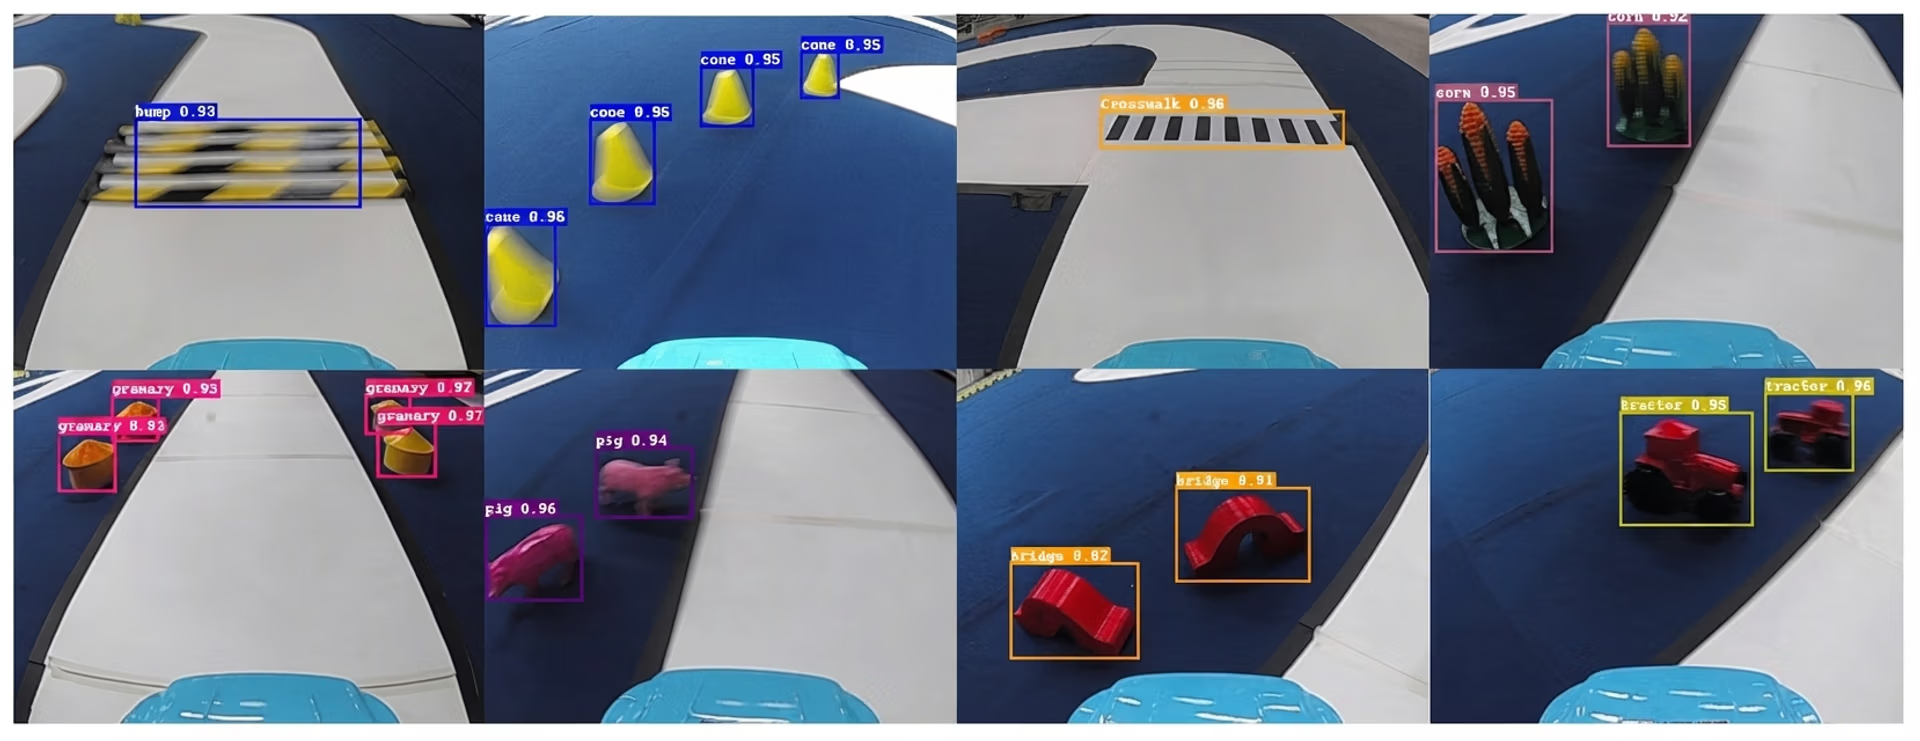
Fig. 4. Detección de objetos con PP-YOLOE+ (Fuente)
El modelo también utiliza una arquitectura de cabezal desacoplado, que separa las tareas de predecir las ubicaciones de los objetos y sus etiquetas de clase. Esto le permite dibujar cajas delimitadoras con mayor precisión y clasificar correctamente los objetos.
6. GroundingDINO#
GroundingDINO es un modelo de detección de objetos basado en Transformer que combina visión y lenguaje. En lugar de depender de un conjunto fijo de categorías, permite detectar objetos mediante indicaciones de texto en lenguaje natural.
Al alinear las características visuales de una imagen con descripciones de texto, el modelo puede localizar objetos aunque esas etiquetas exactas no estuvieran en sus datos de entrenamiento. Esto significa que puedes darle indicaciones con descripciones como «una persona con casco» o «un coche rojo cerca de un edificio», y dibujará cajas delimitadoras alrededor de los objetos que coincidan.
Además, al admitir la detección de disparo cero, GroundingDINO reduce la necesidad de volver a entrenar o ajustar el modelo para cada nuevo caso de uso, lo que le permite adaptarse a una amplia variedad de aplicaciones. Para ver cómo se compara con otros detectores de vocabulario abierto y modelos de lenguaje y visión en conjuntos de datos del mundo real, consulta la clasificación de modelos VLM.
Métricas habituales para evaluar detectores de objetos#
Al comparar distintos modelos de detección de objetos, quizá te preguntes cómo saber cuál ofrece realmente el mejor rendimiento. Es una buena pregunta porque, además de la arquitectura del modelo y la calidad de los datos, muchos factores pueden afectar al rendimiento.
Los investigadores suelen recurrir a benchmarks compartidos y métricas de rendimiento estándar para evaluar los modelos de forma coherente, comparar resultados y comprender las ventajas e inconvenientes en cuanto a velocidad y precisión. Los benchmarks estándar son especialmente importantes porque muchos modelos de detección de objetos se evalúan con los mismos conjuntos de datos, como COCO.
Medición de la precisión y la velocidad de detección#
Estas son algunas de las métricas habituales que se utilizan para evaluar los modelos de detección de objetos:
- Intersección sobre unión (IoU): esta métrica mide cuánto se solapa una caja delimitadora predicha con el objeto real de una imagen. Compara la caja dibujada por el modelo con la caja de referencia, que indica la ubicación del objeto tal como está etiquetada en el conjunto de datos. El IoU se calcula dividiendo el área de solapamiento entre el área de unión de las dos cajas. Un IoU más alto indica que el modelo coloca la caja con más precisión, mientras que un IoU más bajo significa que la predicción es menos precisa. En pocas palabras, el IoU muestra hasta qué punto coinciden las predicciones del modelo con las ubicaciones reales de los objetos.
- Precisión media promedio (mAP): Es la métrica principal para evaluar el rendimiento general de la detección de objetos. Tiene en cuenta tanto el número de objetos que el modelo detecta correctamente como la precisión de esas detecciones en distintos niveles de confianza y categorías de objetos.
- Fotogramas por segundo (FPS) y latencia: FPS indica cuántas imágenes o fotogramas de vídeo puede procesar un modelo en un segundo. Por ejemplo, un modelo que funciona a 30 FPS puede procesar 30 fotogramas por segundo. Un FPS más alto significa que el sistema puede responder con mayor rapidez, algo importante en casos de uso como el vídeo en directo, la vigilancia del tráfico o la robótica. La latencia, por otro lado, mide cuánto tarda el modelo en procesar una sola imagen o fotograma desde que lo recibe hasta que el resultado está listo.
Ventajas e inconvenientes de los algoritmos de detección de objetos#
Estas son algunas de las principales ventajas de utilizar modelos de detección de objetos en aplicaciones reales:
- Aplicable a distintos sectores: La detección de objetos puede utilizarse en una amplia variedad de casos, desde la vigilancia del tráfico y el análisis del comercio minorista hasta la sanidad, la agricultura y la fabricación.
- Reduce el trabajo manual: Automatizar las tareas de inspección visual y supervisión reduce la necesidad de vigilancia humana constante y ayuda a los equipos a centrarse en tareas de mayor valor.
- Aprovecha los ecosistemas de código abierto: Las comunidades activas de código abierto y los recursos disponibles en GitHub facilitan el acceso a modelos preentrenados, la experimentación y la personalización de soluciones.
A pesar de estas ventajas, existen limitaciones prácticas que pueden afectar al rendimiento de los modelos de detección de objetos. Estos son algunos factores importantes que debes tener en cuenta:
- Requisitos de datos de alta calidad: Los modelos de detección de objetos dependen de conjuntos de datos grandes y bien anotados para el entrenamiento. Crear y mantener estos datos puede llevar mucho tiempo, ser costoso y resultar difícil de escalar.
- Exigencias computacionales: Los modelos que ofrecen mayor precisión de detección suelen requerir una gran capacidad de procesamiento, tanto durante el entrenamiento como en el despliegue en tiempo real. Esto suele implicar el uso de GPU de alto rendimiento, lo que puede aumentar los costes de infraestructura.
- Sensibilidad a las condiciones reales: Las variaciones de iluminación, los ángulos de cámara, el tiempo y las escenas concurridas pueden afectar al rendimiento de la detección, por lo que es necesario realizar pruebas y ajustes continuos.
Conclusiones clave#
El mejor modelo de detección de objetos para tu proyecto de visión artificial depende de tu caso de uso, la configuración de los datos, los requisitos de rendimiento y las limitaciones del hardware. Algunos modelos están optimizados para la velocidad, mientras que otros se centran en la precisión; la mayoría de las aplicaciones reales necesitan un equilibrio entre ambas. Gracias a los frameworks de código abierto y a las comunidades activas de GitHub, cada vez es más fácil evaluar, adaptar y desplegar estos modelos para usos prácticos.
Para obtener más información, explora nuestro repositorio de GitHub. Únete a nuestra comunidad y consulta nuestras páginas de soluciones para leer sobre aplicaciones como la IA en la sanidad y la visión artificial en el sector de la automoción. Descubre nuestras opciones de licencia y empieza hoy mismo con la IA visual.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









