RTM es una empresa de inteligencia artificial industrial con sede en Seúl. Su unidad de visión crea monitorización de seguridad impulsada por inteligencia artificial para sitios de fabricación: las cámaras ya montadas en la planta de producción son supervisadas las 24 horas del día por modelos de Ultralytics YOLO26 que detectan personas, caídas, intrusiones en zonas de peligro y fuego o humo, ejecutándose en cualquier PC que el cliente ya posea, desde gráficos integrados hasta una GPU dedicada.
Vigilar las cámaras que nadie vigila#
Los accidentes industriales tienden a ocurrir en el hueco que nadie cubre. Las fábricas ya tienen cámaras en cada línea, pero nadie puede vigilar cada flujo de vídeo en todo momento. RTM construyó un sistema para hacer esto de forma continua: cada canal de cámara ejecuta dos modelos de Ultralytics YOLO26, uno entrenado para la detección de personas y otro para fuego y humo, alimentando una capa de eventos determinista que activa alarmas por caídas de trabajadores e intrusiones en zonas de peligro.
Durante los últimos seis meses, la solución de inteligencia artificial para la seguridad industrial de RTM se ha implementado las 24 horas del día, los 7 días de la semana o se encuentra bajo evaluación in situ en 21 empresas de fabricación que abarcan la fabricación de acero, baterías, productos químicos y plásticos, alimentación y robótica. Conectado al circuito cerrado de televisión existente, el sistema detecta cuando un trabajador entra en una zona peligrosa o cae, y activa alertas a través de sistemas internos o, mediante integración de PLC, controla directamente los equipos de fábrica conectados.
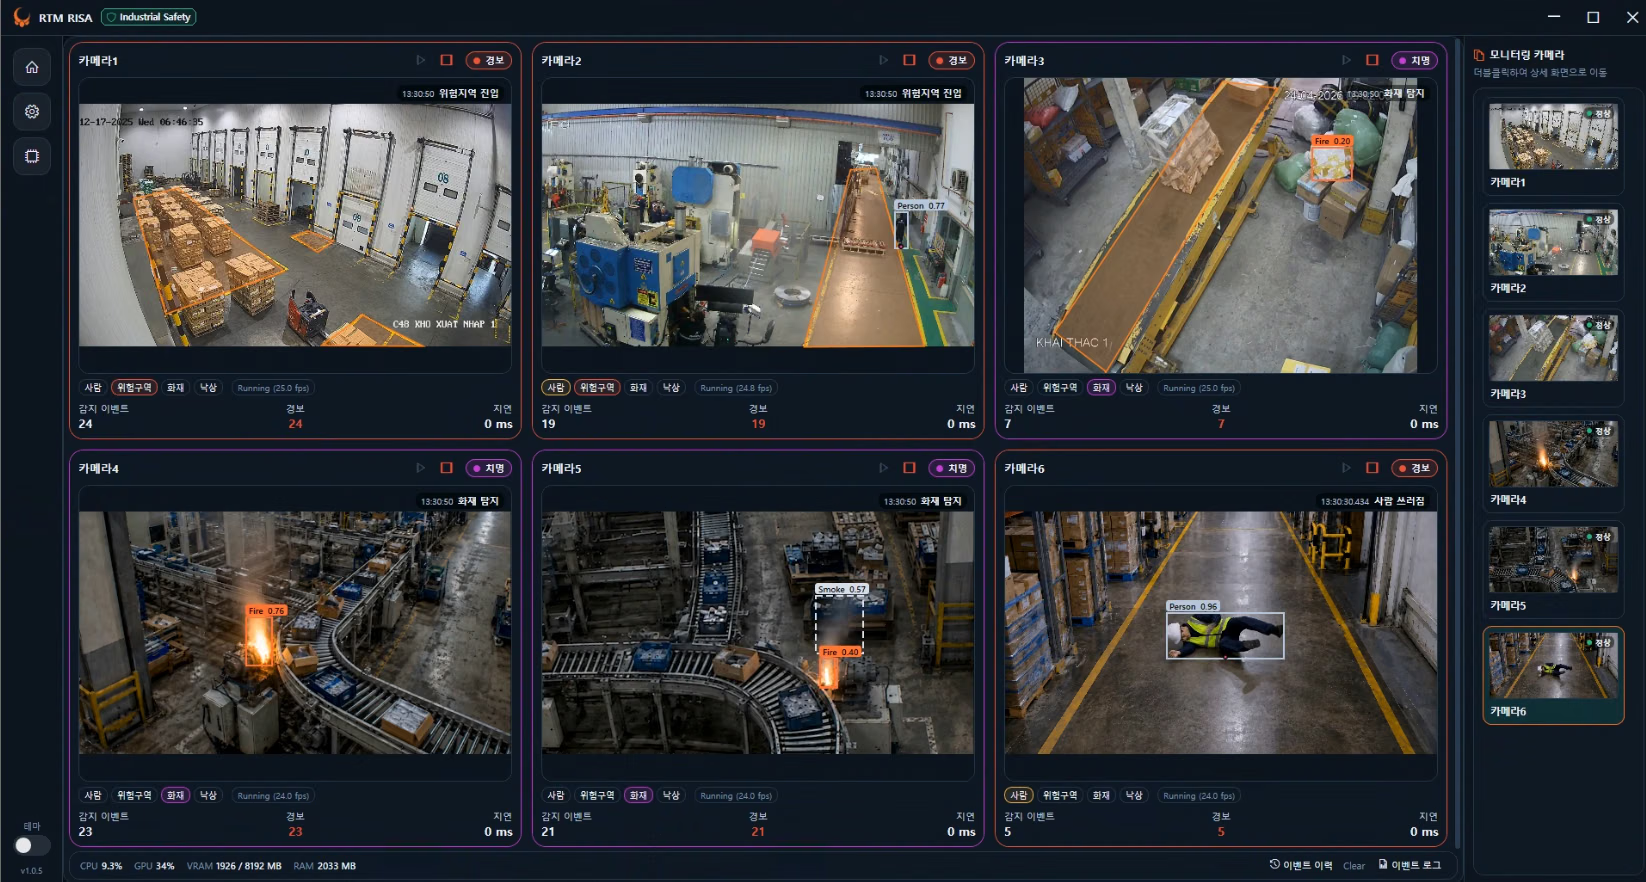 Fig 1. Flujo en directo de detección de caídas de RTM aprovechando Ultralytics YOLO. (Fuente de la imagen: RTM)
Solucionar el problema del hardware que nadie quiere comprar#
La monitorización de seguridad compite con la opción de no instalar nada. Si un sistema requiere nuevo hardware de servidor antes de poder vigilar una sola cámara, la evaluación a menudo se detiene antes de empezar. El statu quo para los fabricantes ha sido una elección entre hardware dedicado caro y ninguna monitorización automatizada en absoluto.
RTM se propuso eliminar ese compromiso: un despliegue que se ejecuta en cualquier PC que ya esté en la sala de control, desde gráficos integrados de Intel hasta una NVIDIA RTX 3090, sin necesidad de una compilación independiente por cada sitio.
Para lograrlo, RTM exporta ambos modelos de YOLO26 a ONNX con una forma estática y los ejecuta a través de ONNX Runtime en cinco proveedores de ejecución: TensorRT, CUDA, OpenVINO, DirectML y CPU. Al iniciarse, la biblioteca de inferencia detecta el fabricante de la GPU instalada y selecciona automáticamente la cadena de proveedores adecuada, por lo que el mismo archivo de 36 MB por modelo se ejecuta sin modificaciones tanto si la máquina de destino no tiene ninguna GPU dedicada como si cuenta con una tarjeta de gama alta. No hay dependencia de Python o PyTorch en la aplicación desplegada ni ninguna pista de lanzamiento por proveedor que mantener.
La cabeza de detección de extremo a extremo de YOLO26 hizo que ese enfoque de artefacto único fuera práctico: dado que el modelo genera las detecciones finales directamente, la capa de inferencia en C++ de RTM solo necesita un umbral de confianza y una transformación inversa de letterbox, sin NMS que reimplementar y sin brecha de paridad que depurar entre la ruta de entrenamiento en Python y la ruta de despliegue en C++, un tipo de error que suele aparecer cada vez que un detector cruza los límites del lenguaje.
Lo que compra una GPU, medido#
RTM evaluó ambos modelos YOLO26-small (persona y fuego/humo) a dos resoluciones de entrada en una NVIDIA RTX 3090 (ONNX Runtime 1.26.0, proveedor de ejecución CUDA, FP32, lote 1, solo pase hacia adelante). A 640×640, el modelo de persona se ejecuta a 4.20 ms por fotograma y el modelo de fuego/humo a 4.34 ms; a 1280×1280, ambos ascienden a aproximadamente 12.5 ms, y la memoria de la GPU aumenta de 406 MB a 1,302 MB. Eso hace que 640×640 sea unas 2.9 veces más económico por fotograma y 3.2 veces más ligero en memoria, mientras que la entrada más grande mejora la detección de objetos pequeños y lejanos. RTM ofrece 640×640 como valor predeterminado y mantiene la exportación a 1280×1280 disponible para los sitios que tienen margen de GPU para gastar en margen de detección en lugar de en recuento de canales.
Pasar de CUDA en FP32 a TensorRT en FP16 redujo el coste combinado por fotograma para ambos modelos de 8.68 ms a 6.26 ms, una reducción del 28%, equivalente a unos 39.9 FPS en cuatro canales en una sola GPU en lugar de 28.8 FPS. RTM verificó que la conversión a FP16 no costó nada en precisión antes de enviarlo: la recuperación se mantuvo sin cambios en cada grupo de tamaño de objeto y a nivel de evento tanto para el fuego como para el humo. En la aplicación desplegada, una máquina con especificaciones recomendadas (un Intel Core i7 de clase de 16 núcleos o superior, 32 GB de RAM, RTX 5060 de 8 GB o superior) mantiene 6 canales simultáneos, mientras que una máquina de gama baja con solo gráficos integrados todavía mantiene 1, frente a un límite de producto de 10 canales por caja.
¿Por qué aprovechar Ultralytics YOLO26?#
RTM entrena su detector de personas y su detector de fuego/humo a través de la misma base de código de entrenamiento de Ultralytics, y ambos comparten 352 líneas de código sin ninguna ramificación específica de dominio. Lo único que cambia entre un detector que vigila personas y uno que vigila fuego es un archivo de configuración: tamaño de entrada, épocas, tasa de aprendizaje y composición del dataset. Eso es una consecuencia directa de cómo está construido Ultralytics YOLO. Una arquitectura y una API de entrenamiento únicas y coherentes en todas las tareas de detección significan que un nuevo dominio de detección es un cambio de configuración en lugar de una nueva canalización, lo que permitió a un pequeño equipo de ingeniería crear dos modelos de calidad de producción sin necesidad de mantener dos bases de código.
Esa misma coherencia hizo que el paso a YOLO26 fuera de bajo riesgo. RTM adoptó YOLO26 a los cuatro días de comenzar el proyecto, en mayo de 2026, y la migración no requirió cambiar ni una sola línea del código de entrenamiento existente, solo un punto de control diferente. Como Ultralytics mantiene la interfaz de entrenamiento estable entre generaciones de modelos, actualizar a la arquitectura más nueva no significaba reescribir una canalización que RTM ya había construido y probado.
"Incluso en el mismo dataset, el tamaño de entrada y la aumentación cambian el rendimiento del modelo. Con Ultralytics todo eso vive en un solo archivo de configuración, así que cambiamos unos pocos valores, ejecutamos varias variaciones en paralelo y tomamos la mejor. Nunca tocamos el código para nada de eso, por lo que alinear diez ejecuciones requiere casi el mismo trabajo que ejecutar una". - Ingeniero de IA, RTM
Esa estabilidad también dio sus frutos en precisión. Consolidar un plan de estudio de entrenamiento secuencial de cinco etapas en una sola ejecución conjunta mejoró el mAP50 de validación de 0.672 a 0.689 con un umbral operativo sin cambios, una ganancia que RTM pudo obtener simplemente reentrenando en la misma arquitectura YOLO26 en lugar de rediseñar el modelo. Y como YOLO26 se exporta limpiamente a un artefacto ONNX de forma fija con los umbrales de detección enviados como un archivo adjunto en lugar de compilados en la aplicación, el campo absorbió esa ganancia de precisión intercambiando un archivo ONNX, sin ningún cambio en la aplicación host. Eso es lo que permite a un pequeño equipo de ingeniería enviar actualizaciones de modelos a cada sitio sin un lanzamiento coordinado, y es una consecuencia directa de construir sobre YOLO26 en lugar de sobre una arquitectura a medida.
Lo que se sitúa por encima de la detección#
Las alarmas de RTM no son detecciones sin procesar: una persona en el fotograma no es un evento, pero una persona que ha caído y sigue en el suelo sí lo es. Una capa de eventos determinista se sitúa por encima de los dos modelos YOLO26, combinando el seguimiento, el estado de la postura, la pertenencia a zonas y una votación de ventana deslizante antes de que se dispare cualquier alarma. Mantener esa lógica separada del modelo es lo que permite que un solo detector de personas sirva para todos los sitios, a pesar de que la altura de la cámara, el ángulo y la iluminación varían enormemente de una fábrica a otra. También significa que los nuevos comportamientos de seguridad pueden reutilizar las detecciones existentes: RTM está construyendo ahora la monitorización del cumplimiento de los EPI sobre la misma salida de detección de personas, sin necesidad de un nuevo modelo ni de nuevo hardware en los sitios equipados con GPU.
El impacto general#
El impacto se muestra con mayor claridad en los clientes de integración de robots colaborativos de RTM, que suministran e instalan cobots en todas las fábricas y que durante mucho tiempo habían lidiado con trabajadores chocando contra robots a pesar de las vallas de seguridad físicas o láser. Con el sistema de RTM, la intrusión en la zona de peligro se detecta e inmediatamente activa una parada conectada por PLC en el robot sin retraso, y estos integradores lo han adoptado desde entonces como su dispositivo de seguridad predeterminado en lugar del vallado físico.
Un cliente de fabricación de acero informó de que la capacidad de Ultralytics YOLO para adaptar los escenarios de detección a diferentes sitios les permitió reducir a más de 100 empleados de monitorización de seguridad que anteriormente patrullaban la planta. Más ampliamente, los fabricantes describen la solución de RTM como la más fácil de instalar y la más rentable entre las opciones de monitorización de seguridad que evaluaron, con la detección de zonas de peligro, caídas y fuego/humo cubriendo lo que más necesitan.
Escalando aún más con los mismos modelos#
El siguiente paso de RTM es la detección del cumplimiento de los EPI, construida íntegramente sobre su salida de detección de personas existente. No hay ningún modelo nuevo que entrenar y, en los sitios con margen de GPU, ningún hardware nuevo que instalar. A medida que el despliegue continúa en sitios de fabricación adicionales y niveles de hardware, la misma exportación ONNX única por modelo sigue soportando la carga, desde el PC con gráficos integrados de menores especificaciones hasta el servidor GPU de gama más alta de la planta.
¿Te interesa crear tus propias soluciones de visión artificial? Explora nuestros modelos de Ultralytics YOLO, descubre cómo se utilizan en diferentes industrias, incluida la visión artificial en la fabricación, y consulta las opciones de licencia para empezar.








