Meilleurs modèles de détection d’objets
Découvre les meilleurs modèles de détection d’objets en 2026, d’Ultralytics YOLO à RT-DETR, avec une comparaison des architectures, des compromis de performances et des facteurs de déploiement.
 Abirami Vina14 min de lecture
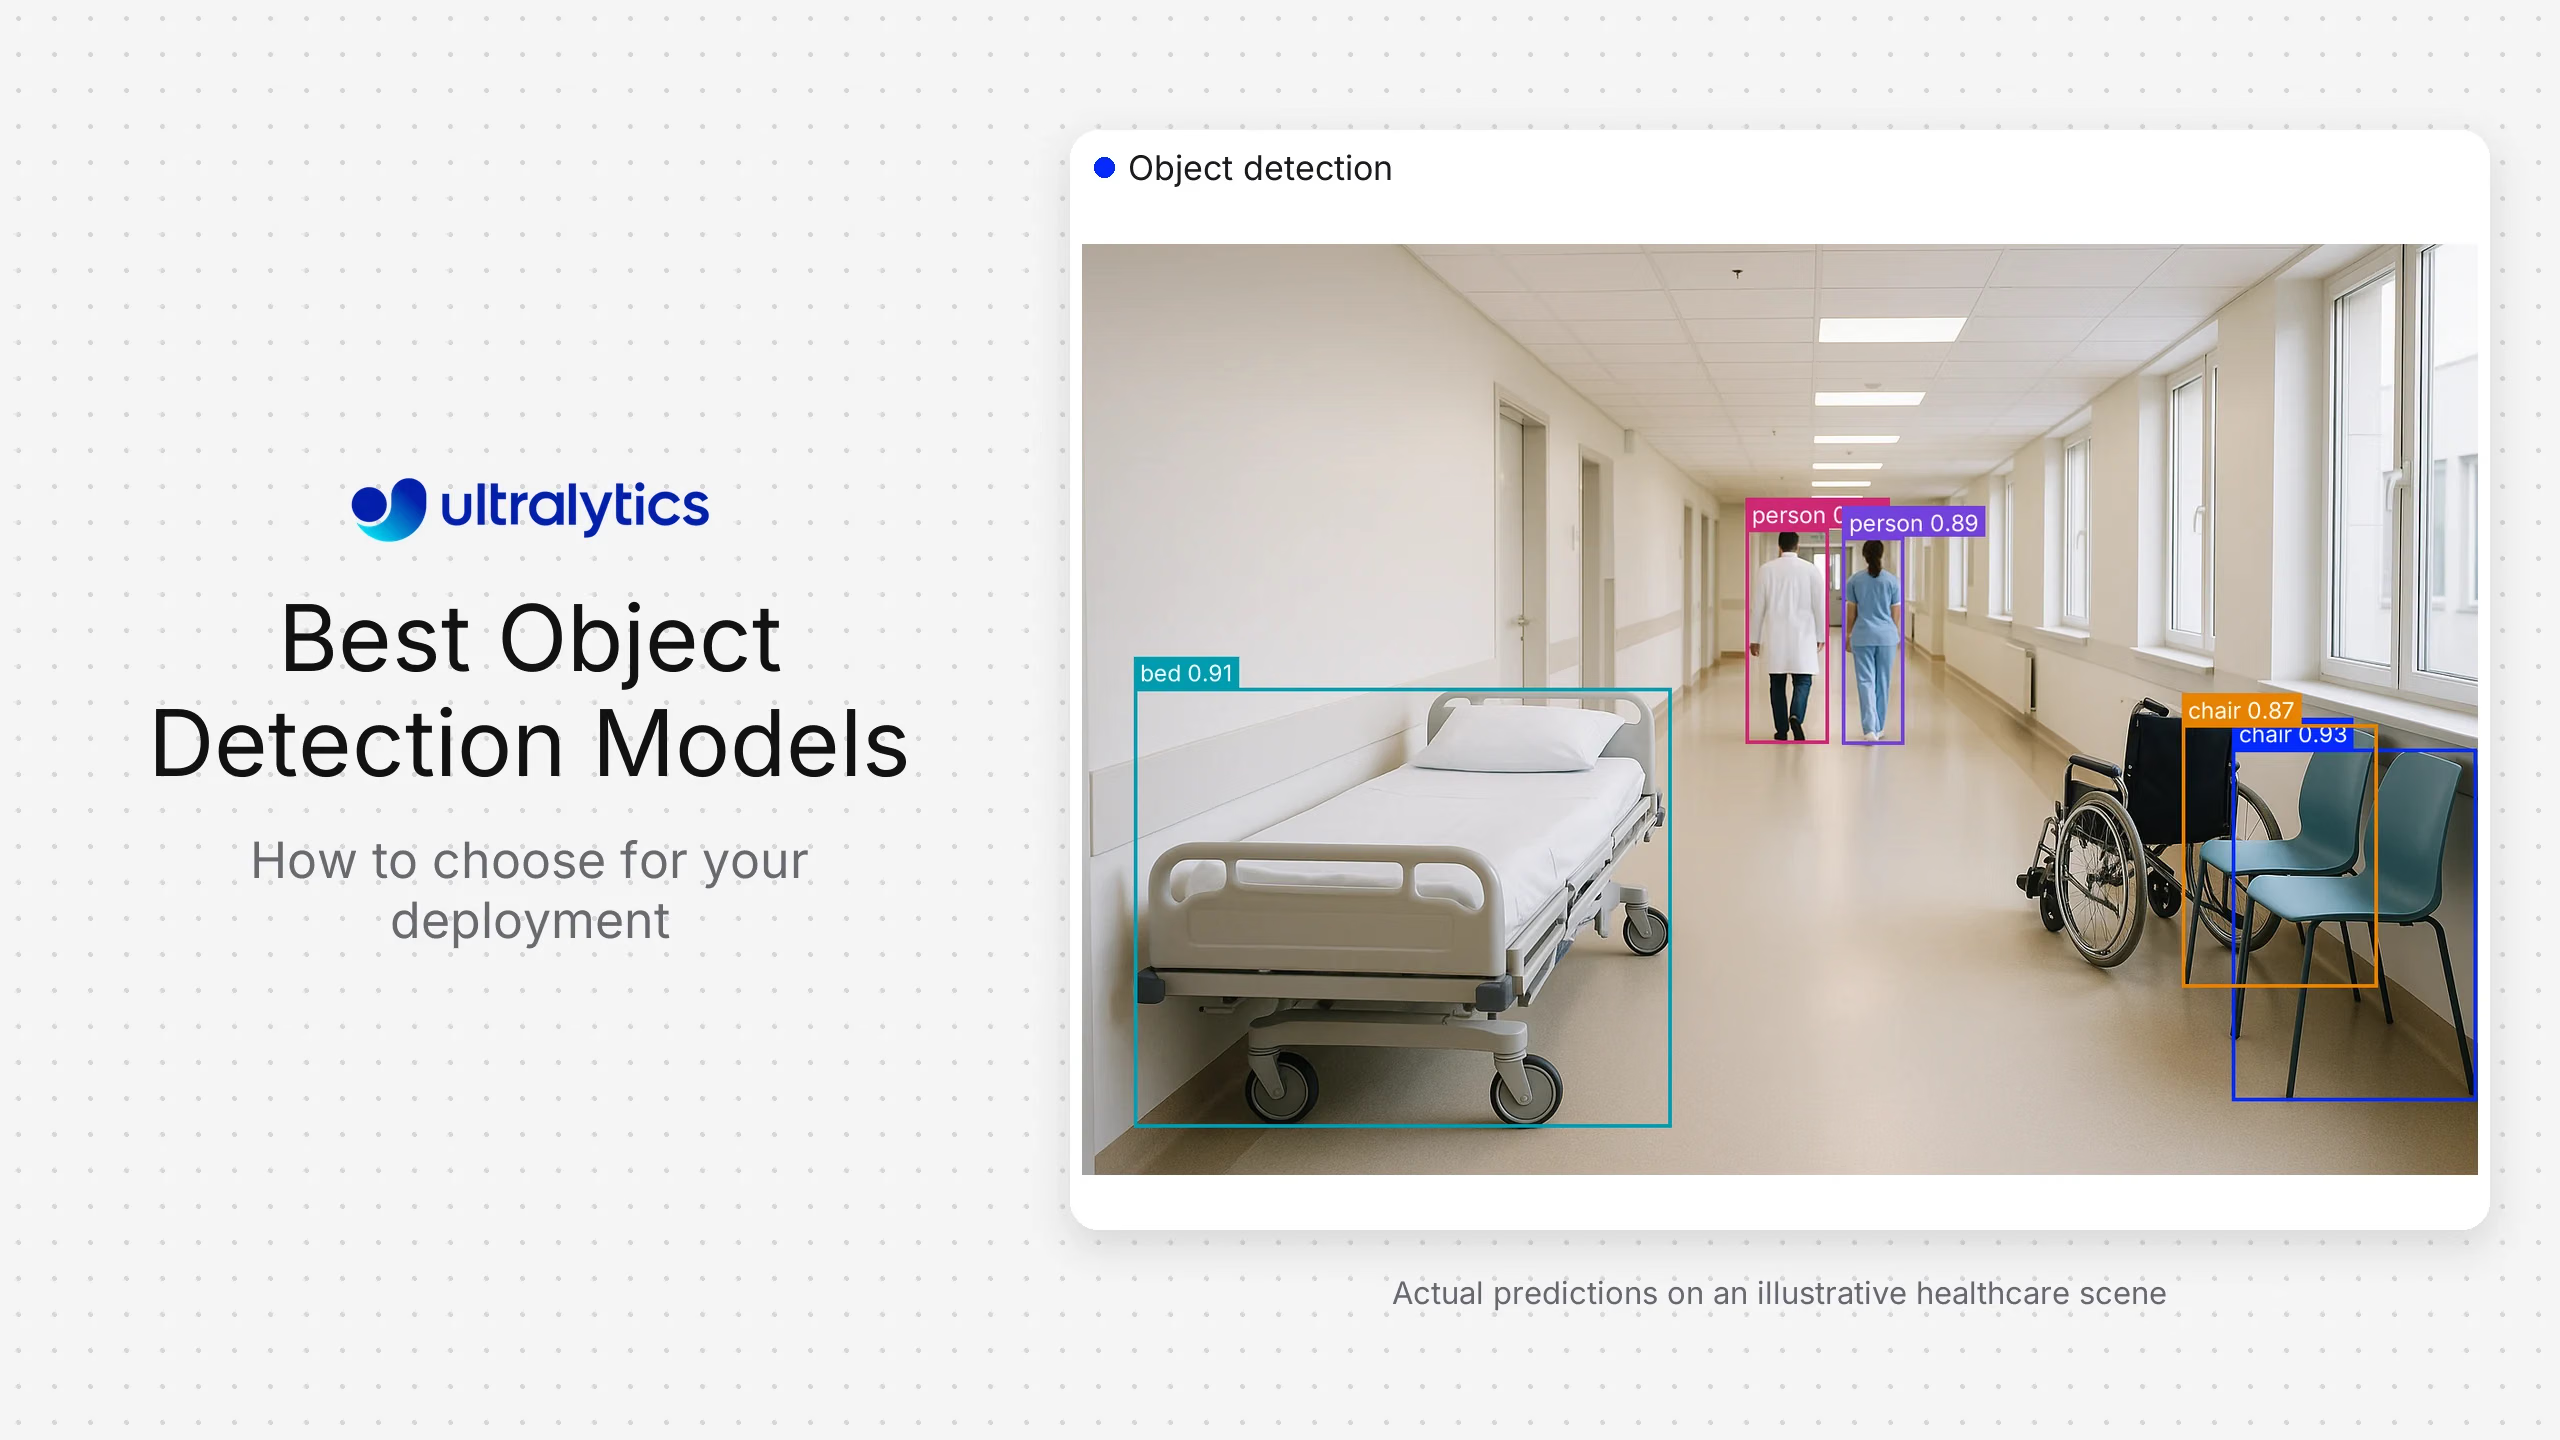
Plus tôt cette année, Andrew Ng, pionnier de l’IA et de l’apprentissage automatique, a présenté le concept de détection d’objets agentique. Cette approche utilise un agent de raisonnement pour détecter des objets à partir d’une invite textuelle, sans nécessiter de grandes quantités de données d’entraînement.
Pouvoir identifier des objets dans des images et des vidéos sans avoir besoin d’immenses jeux de données annotées constitue une étape vers des systèmes de vision par ordinateur plus intelligents et plus flexibles. Toutefois, l’IA visuelle agentique n’en est encore qu’à ses débuts.
Même si ces modèles peuvent gérer des tâches générales, comme détecter des personnes ou des panneaux de signalisation dans une image, les applications de vision par ordinateur plus précises reposent toujours sur des modèles traditionnels de détection d’objets. Ces modèles sont entraînés sur de vastes jeux de données soigneusement annotées afin d’apprendre précisément quoi rechercher et où se trouvent les objets.
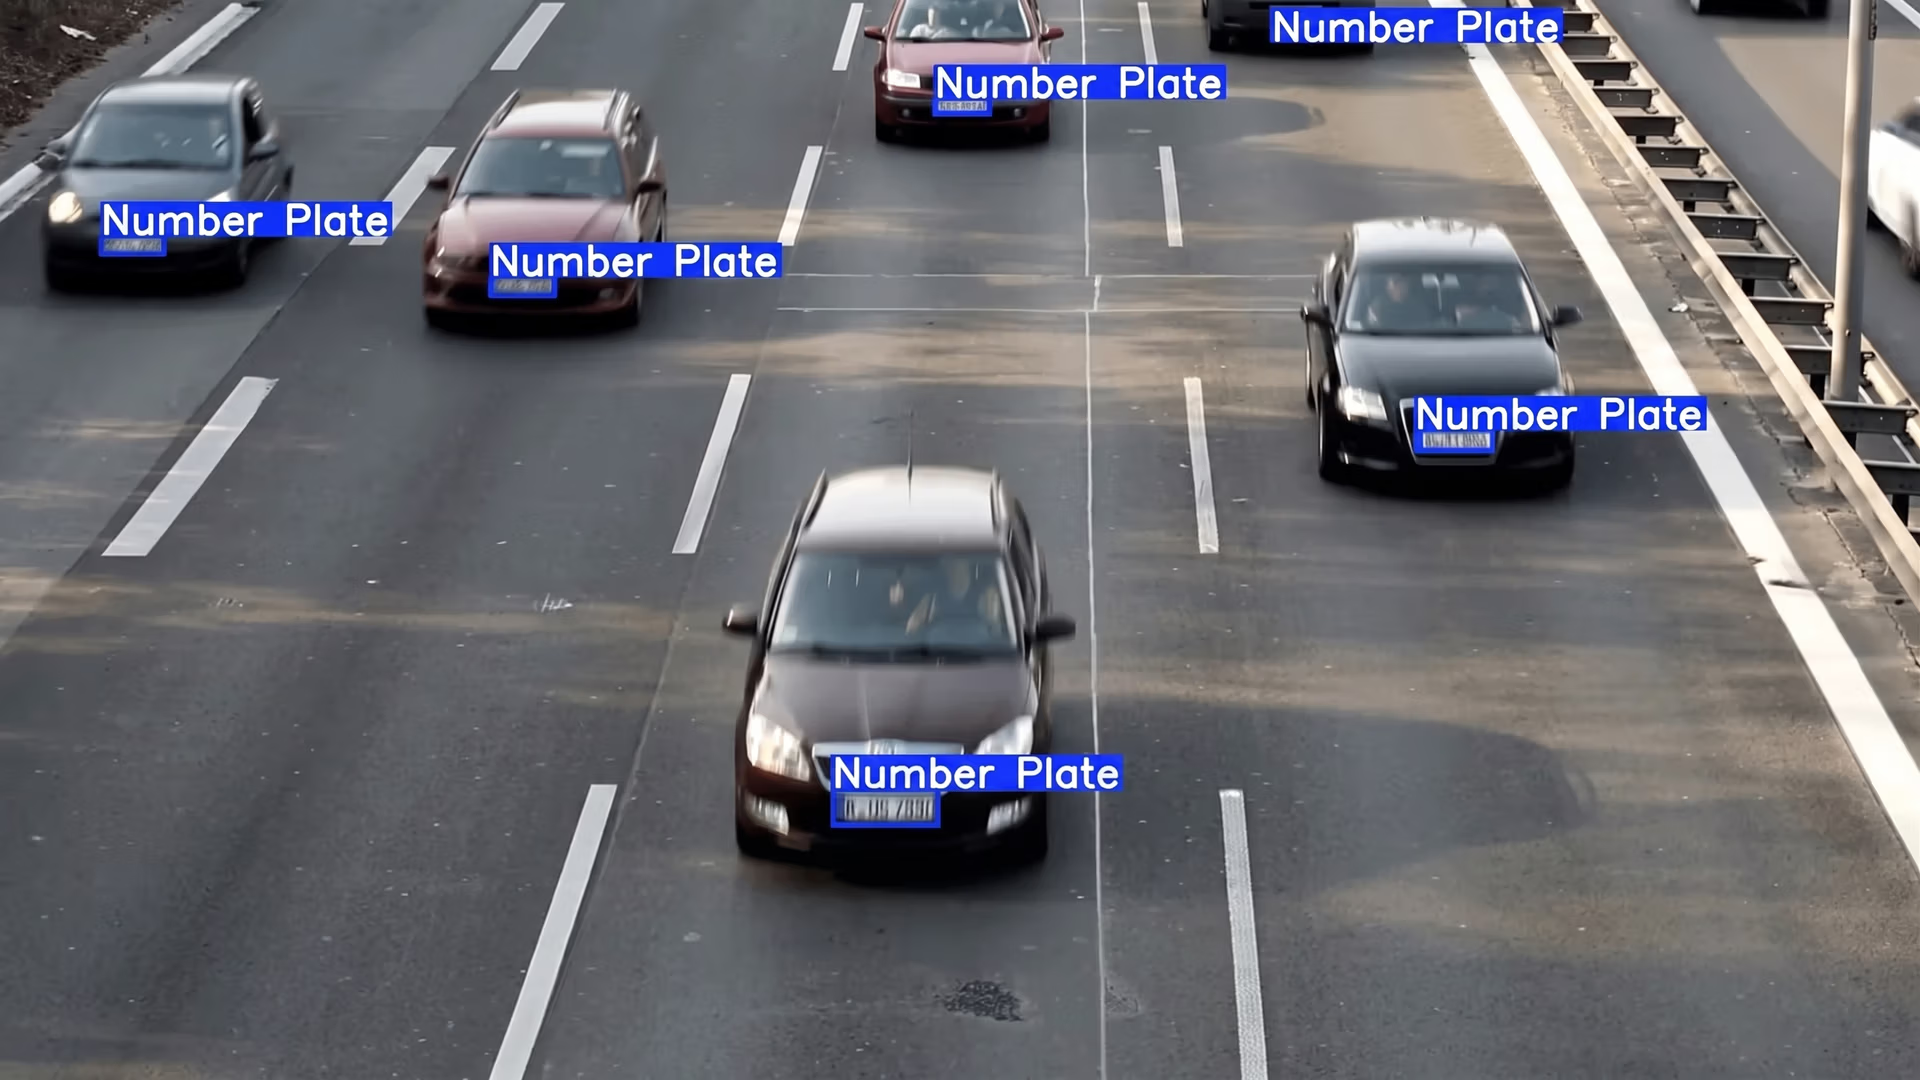
Fig. 1. Exemple de détection d’objets. (Source)
La détection d’objets traditionnelle est essentielle, car elle assure à la fois la reconnaissance — identifier l’objet — et la localisation — déterminer exactement où il se trouve dans l’image. Cette combinaison permet aux machines d’effectuer de manière fiable des tâches complexes du monde réel, des véhicules autonomes à l’automatisation industrielle et au diagnostic médical.
Les modèles de détection d’objets continuent de s’améliorer : ils deviennent plus rapides, plus précis et mieux adaptés aux environnements réels. Dans cet article, nous allons passer en revue quelques-uns des meilleurs modèles de détection d’objets actuellement disponibles.
Pourquoi la détection d’objets est nécessaire#
Les tâches de vision par ordinateur, comme la classification d’images, permettent de déterminer si une image contient une voiture, une personne ou un autre objet. Cependant, elles ne permettent pas de savoir où se trouve l’objet dans l’image.
C’est là qu’intervient la détection d’objets. Les modèles de détection d’objets peuvent identifier les objets présents et déterminer leur emplacement exact. Ce processus, appelé localisation, permet aux machines de comprendre les scènes avec plus de précision et d’agir en conséquence, qu’il s’agisse d’arrêter une voiture autonome, de guider un bras robotisé ou de mettre en évidence une zone sur une image médicale.
L’essor de l’apprentissage profond a transformé la détection d’objets. Au lieu de s’appuyer sur des règles codées manuellement, les modèles modernes apprennent directement à partir des annotations et des données visuelles. Ces jeux de données leur apprennent à quoi ressemblent les objets, où ils apparaissent généralement et comment gérer des difficultés comme les petits objets, les scènes encombrées ou les variations d’éclairage.
En fait, les systèmes de détection d’objets de pointe peuvent détecter avec précision plusieurs objets à la fois. La détection d’objets est donc une technologie essentielle pour des applications comme la conduite autonome, la robotique, la santé et l’automatisation industrielle.
Fonctionnement des tâches de détection d’objets#
Le modèle de détection d’objets reçoit une image en entrée, qui peut provenir d’une caméra, d’une image vidéo ou même d’un examen médical. L’image est traitée par un réseau neuronal, généralement un réseau neuronal convolutif (CNN), entraîné à reconnaître des motifs dans les données visuelles.
Au sein du réseau, l’image est analysée par étapes. À partir des caractéristiques qu’il détecte, le modèle prédit quels objets sont présents et où ils apparaissent.
Ces prédictions sont représentées par des boîtes englobantes, des rectangles tracés autour de chaque objet détecté. Pour chaque boîte englobante, le modèle attribue une étiquette de classe (par exemple, voiture, personne ou chien) et un score de confiance qui indique le degré de certitude de la prédiction (on peut aussi l’interpréter comme une probabilité).
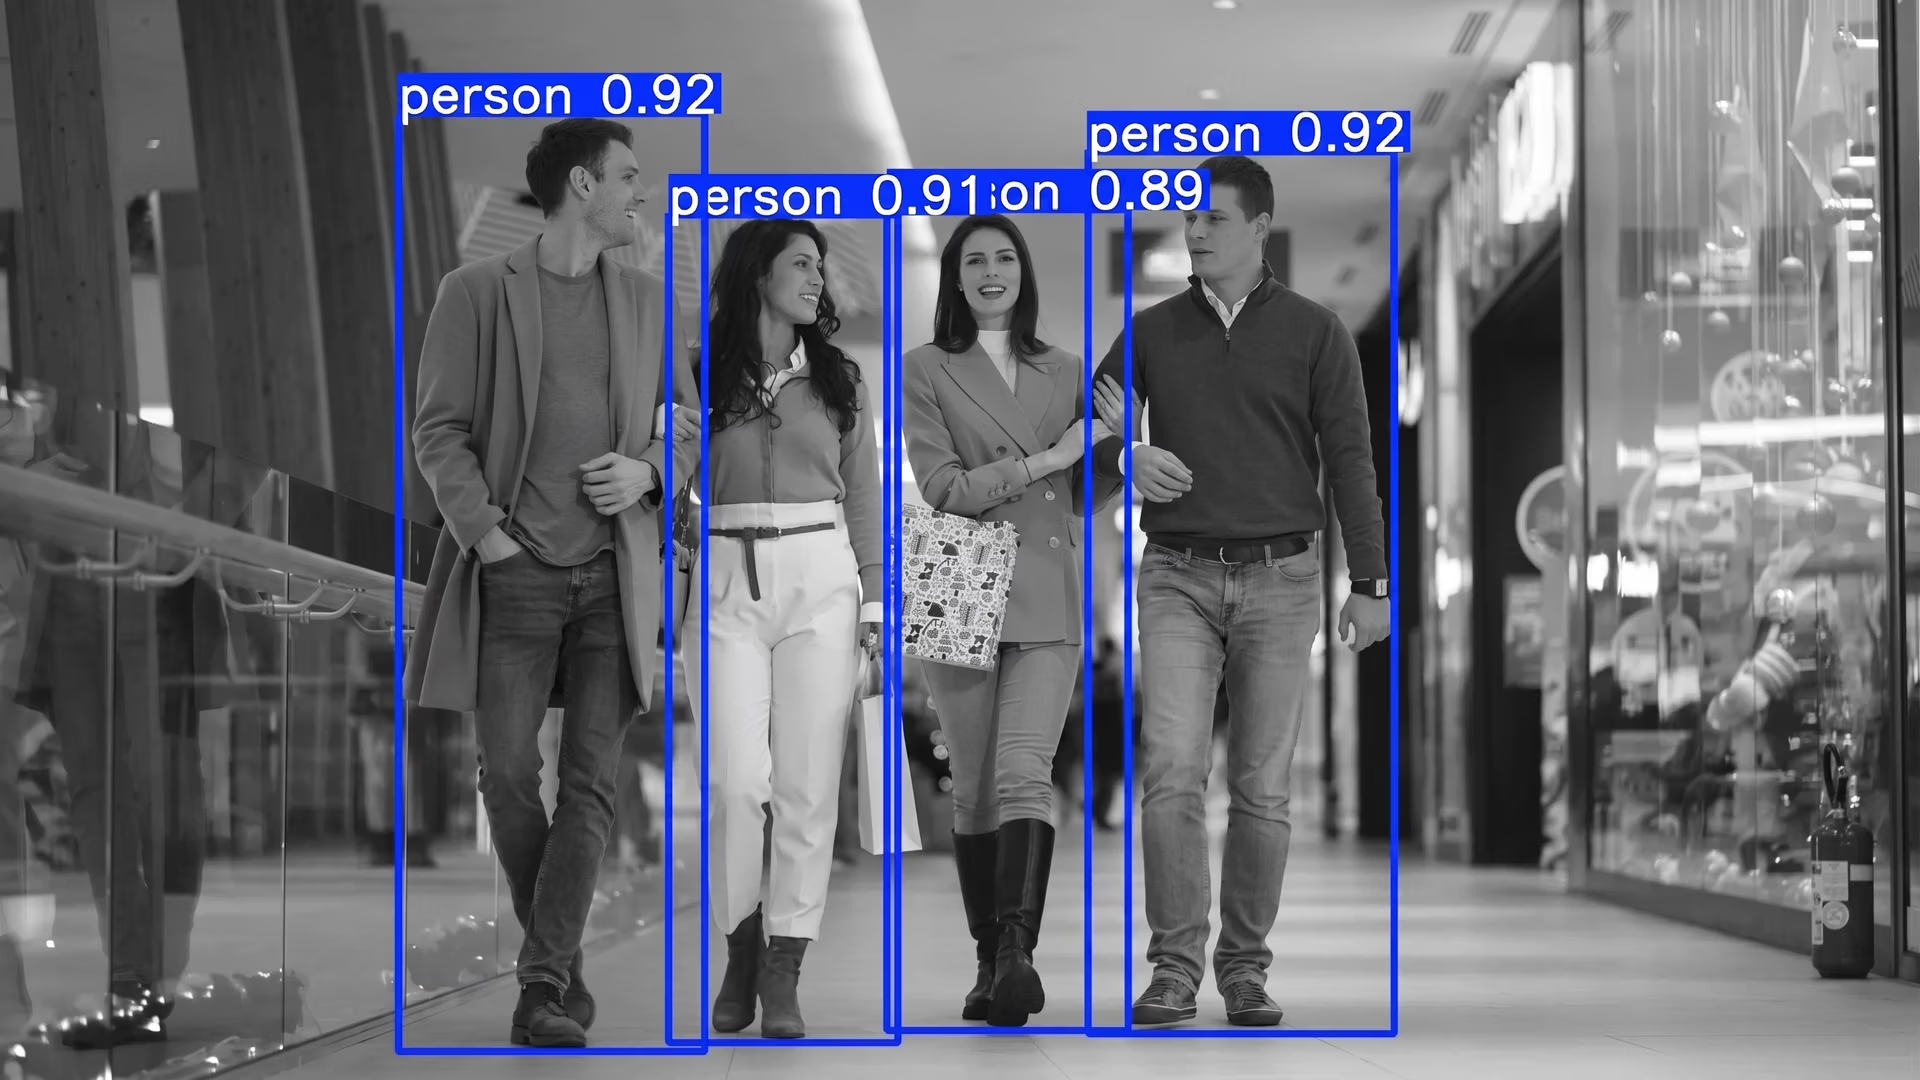
Fig. 2. Les prédictions de détection d’objets peuvent être visualisées à l’aide de boîtes englobantes.
Le processus dans son ensemble repose largement sur l’extraction de caractéristiques. Le modèle apprend à identifier des motifs visuels utiles, comme les contours, les formes, les textures et d’autres caractéristiques distinctives. Ces motifs sont encodés dans des cartes de caractéristiques, qui aident le réseau à comprendre l’image à plusieurs niveaux de détail.
Détection d’objets : modèles à deux étapes et à une étape#
Selon leur architecture, les détecteurs d’objets utilisent différentes stratégies pour localiser les objets, en équilibrant vitesse, précision et complexité.
De nombreux modèles de détection d’objets, en particulier les détecteurs à deux étapes comme Faster R-CNN, se concentrent sur certaines parties de l’image appelées régions d’intérêt (ROIs). En se focalisant sur ces zones, le modèle donne la priorité aux régions susceptibles de contenir des objets au lieu d’analyser chaque pixel de la même manière.
À l’inverse, les modèles à une étape, comme les premiers modèles YOLO, ne sélectionnent pas de régions d’intérêt spécifiques, contrairement aux modèles à deux étapes. Ils divisent plutôt l’image en une grille et utilisent des boîtes prédéfinies, appelées boîtes d’ancrage, ainsi que des cartes de caractéristiques pour prédire les objets dans l’image entière en un seul passage.
De nombreux modèles modernes de détection d’objets, notamment les modèles Ultralytics YOLO récents, utilisent des approches sans ancres. Contrairement aux modèles traditionnels à une seule étape qui s’appuient sur des boîtes d’ancrage prédéfinies, les modèles sans ancres prédisent directement l’emplacement et la taille des objets à partir des cartes de caractéristiques. Cette méthode peut simplifier l’architecture, réduire la charge de calcul et améliorer les performances, en particulier pour détecter des objets de formes et de tailles variées.
Tour d’horizon des meilleurs modèles de détection d’objets#
Il existe aujourd’hui de nombreux modèles de détection d’objets, chacun conçu pour répondre à des objectifs spécifiques. Certains sont optimisés pour les performances en temps réel, tandis que d’autres visent la précision maximale. Le choix du bon modèle pour une solution de vision par ordinateur dépend souvent de ton cas d’usage et de tes exigences en matière de performances.
Découvrons maintenant quelques-uns des meilleurs modèles de détection d’objets de 2026.
1. Modèles Ultralytics YOLO#
L’une des familles de modèles de détection d’objets les plus utilisées aujourd’hui est celle des modèles Ultralytics YOLO. YOLO, qui signifie « You Only Look Once », est populaire dans de nombreux secteurs, car il offre d’excellentes performances de détection tout en étant rapide, fiable et facile à utiliser.
La famille Ultralytics YOLO comprend Ultralytics YOLOv5, Ultralytics YOLOv8, Ultralytics YOLO11 et le tout dernier Ultralytics YOLO26, offrant plusieurs options adaptées à différentes exigences de performances et à différents cas d’usage. Grâce à leur conception légère et à l’optimisation de leur vitesse, les modèles Ultralytics YOLO sont idéaux pour la détection en temps réel et peuvent être déployés sur des appareils en périphérie disposant d’une puissance de calcul et d’une mémoire limitées.
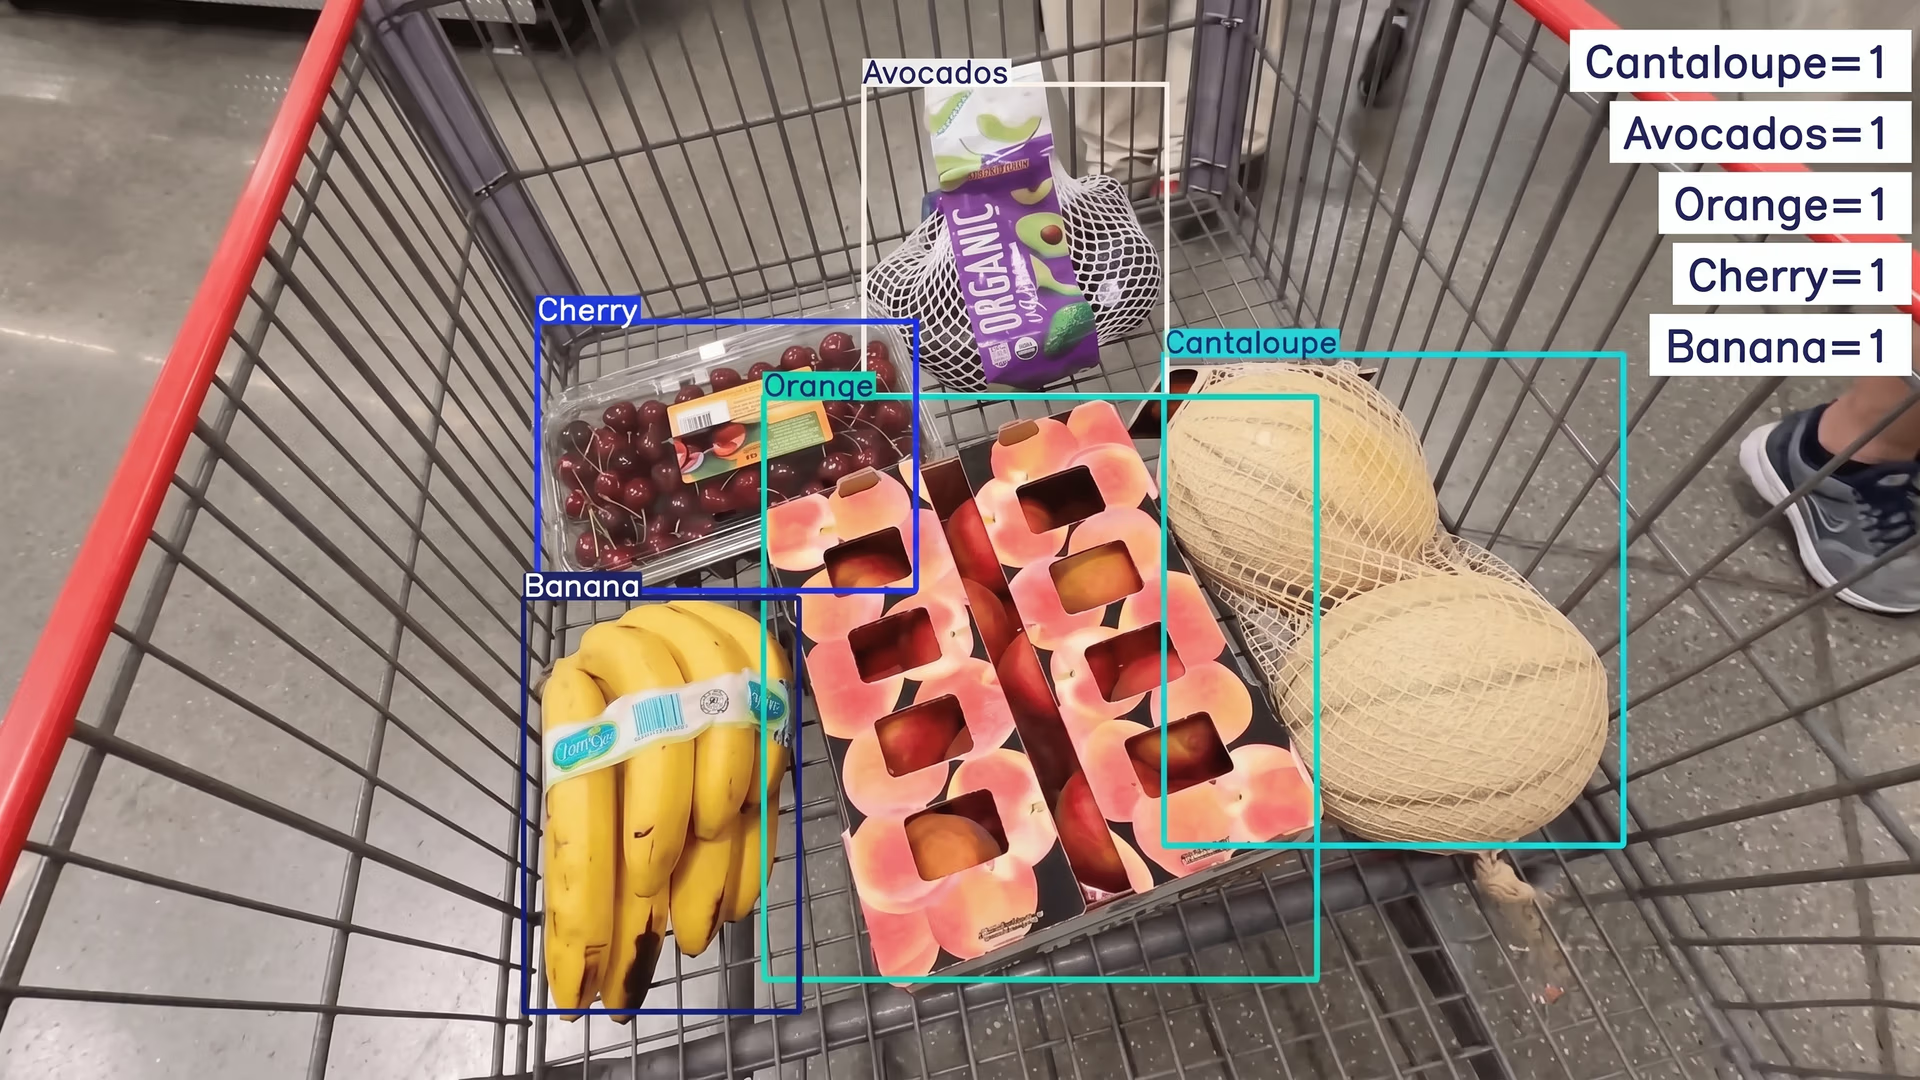
Fig. 3. Utilisation d’Ultralytics YOLO11 pour la détection d’objets (Source)
Au-delà de la détection d’objets classique, ces modèles sont très polyvalents. Ils prennent également en charge des tâches comme la segmentation d’instances, qui délimite les objets au niveau des pixels, et l’estimation de pose, qui identifie les points clés sur des personnes ou des objets. Cette flexibilité fait des modèles Ultralytics YOLO une solution de choix pour un large éventail d’applications, de l’agriculture et de la logistique au commerce de détail et à l’industrie manufacturière.
Une autre raison majeure de la popularité des modèles Ultralytics YOLO est le package Python Ultralytics, qui fournit une interface simple et conviviale pour entraîner, ajuster et déployer les modèles. Les développeurs peuvent commencer avec des poids préentraînés, personnaliser les modèles pour leurs propres jeux de données et les déployer en quelques lignes de code.
2. RT-DETR et RT-DETRv2#
RT‑DETR (Transformer de détection en temps réel) et le plus récent RT‑DETRv2 sont des modèles de détection d’objets conçus pour une utilisation en temps réel. Contrairement à de nombreux modèles traditionnels, ils peuvent traiter une image et fournir directement les détections finales, sans utiliser la suppression des non-maxima (NMS).
La NMS est une étape qui élimine les boîtes superflues qui se chevauchent lorsque le modèle prédit plusieurs fois le même objet. L’omission de la NMS simplifie et accélère le processus de détection.
Ces modèles associent des CNN à des transformers. Le CNN repère les détails visuels comme les contours et les formes, tandis que le transformer est un type de réseau de neurones capable d’examiner toute l’image à la fois et de comprendre les liens entre ses différentes parties. Cette compréhension globale permet au modèle de détecter des objets proches les uns des autres ou qui se chevauchent.
RT‑DETRv2 améliore le modèle d’origine grâce à des fonctionnalités comme la détection multi-échelle, qui aide à repérer les petits comme les grands objets, et à une meilleure gestion des scènes complexes. Ces changements préservent la rapidité du modèle tout en améliorant sa précision.
3. RF-DETR#
RF‑DETR est un modèle en temps réel basé sur un transformer, conçu pour associer la précision des architectures Transformer à la vitesse requise par les applications concrètes. Comme RT‑DETR et RT‑DETRv2, il utilise un transformer pour analyser l’image dans son ensemble et un CNN pour extraire des caractéristiques visuelles fines comme les contours, les formes et les textures.
Le modèle prédit directement les objets à partir de l’image d’entrée, sans boîtes d’ancrage ni suppression non maximale, ce qui simplifie le processus de détection et accélère l’inférence. RF‑DETR prend également en charge la segmentation d’instances, ce qui lui permet de délimiter les objets au niveau des pixels en plus de prédire des boîtes englobantes.
4. EfficientDet#
Publié fin 2019, EfficientDet est un modèle de détection d’objets conçu pour une mise à l’échelle efficace et des performances élevées. EfficientDet se distingue par la mise à l’échelle composée, une méthode qui ajuste simultanément la résolution d’entrée, la profondeur et la largeur du réseau, plutôt qu’un seul facteur. Cette approche permet au modèle de conserver une précision stable, qu’il soit mis à l’échelle pour des tâches exigeantes ou réduit pour des déploiements légers.
Un autre élément clé d’EfficientDet est son réseau pyramidal de caractéristiques (FPN) efficace, qui permet au modèle d’analyser les images à plusieurs échelles. Cette analyse multi-échelle est essentielle pour détecter des objets de différentes tailles et permet à EfficientDet d’identifier de manière fiable les petits comme les grands objets dans une même image.
5. PP-YOLOE+#
Publié en 2022, PP-YOLOE+ est un modèle de détection d’objets de type YOLO, c’est-à-dire qu’il détecte et classe les objets en un seul passage sur l’image. Cette approche le rend rapide et adapté aux applications en temps réel, tout en conservant une grande précision.
L’une des principales améliorations de PP-YOLOE+ est l’apprentissage aligné sur la tâche, qui aide les scores de confiance du modèle à refléter la précision de la localisation des objets. Cette fonctionnalité est particulièrement utile pour détecter les objets petits ou qui se chevauchent.
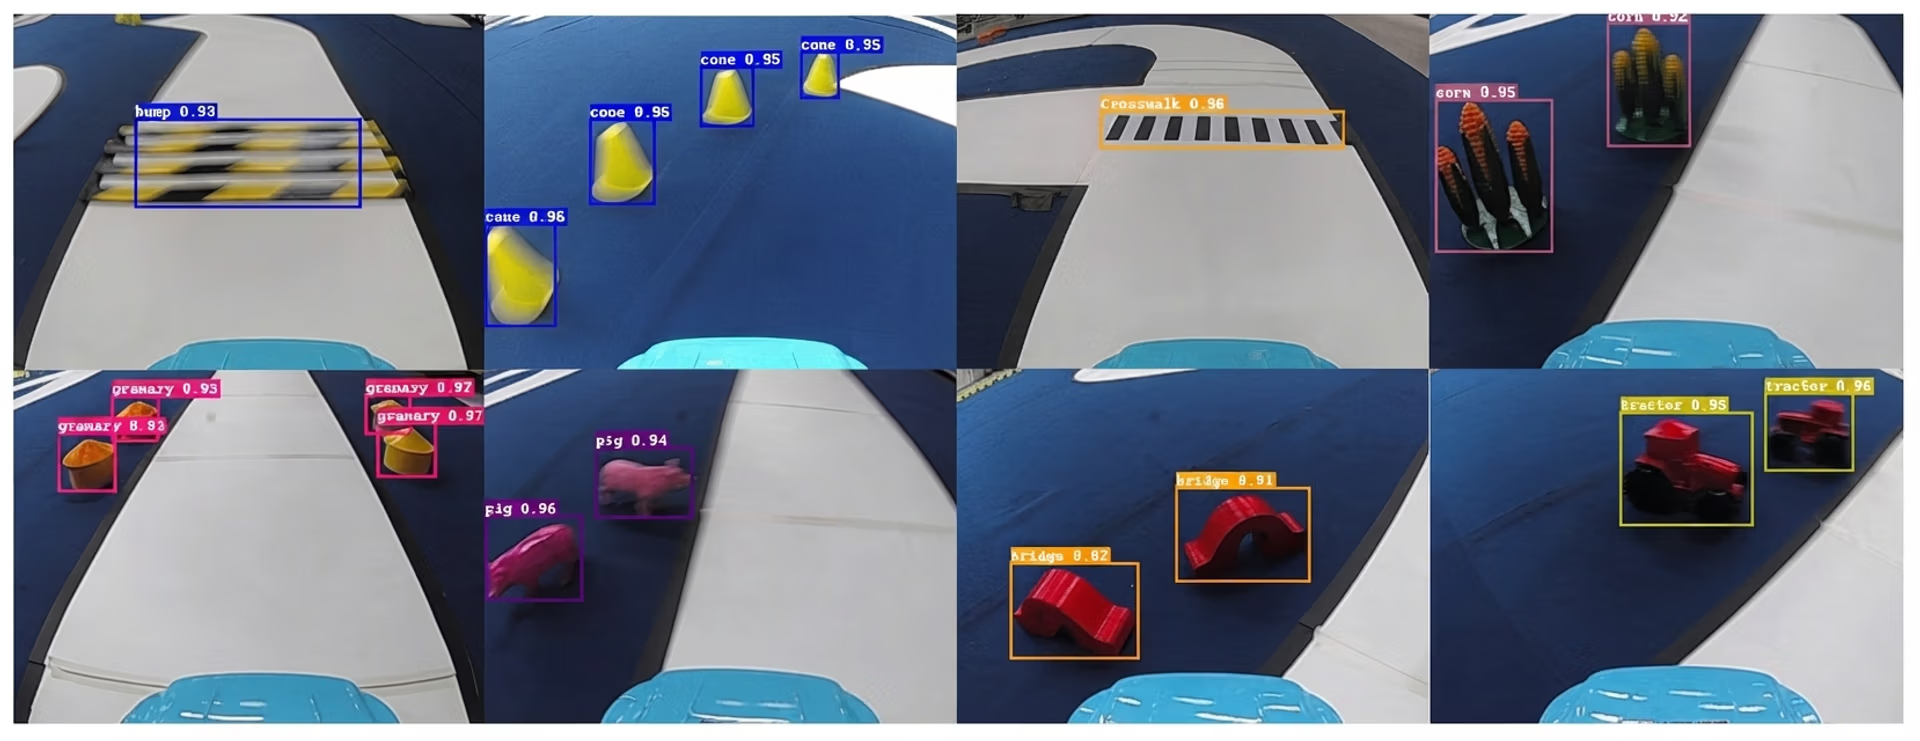
Fig. 4. Détection d’objets avec PP-YOLOE+ (Source)
Le modèle utilise également une architecture à tête découplée, qui sépare la prédiction de l’emplacement des objets de celle de leurs étiquettes de classe. Il peut ainsi tracer des boîtes englobantes avec plus de précision tout en classant correctement les objets.
6. GroundingDINO#
GroundingDINO est un modèle de détection d’objets basé sur un Transformer qui combine vision et langage. Au lieu de s’appuyer sur un ensemble fixe de catégories, il permet aux utilisateurs de détecter des objets à l’aide d’invites textuelles en langage naturel.
En alignant les caractéristiques visuelles d’une image sur des descriptions textuelles, le modèle peut localiser des objets même si les étiquettes correspondantes ne figuraient pas dans ses données d’entraînement. Tu peux donc lui fournir des descriptions comme « une personne portant un casque » ou « une voiture rouge près d’un bâtiment », et il tracera des boîtes englobantes autour des objets correspondants.
En prenant également en charge la détection zero-shot, GroundingDINO réduit la nécessité de réentraîner ou d’ajuster le modèle pour chaque nouveau cas d’usage, ce qui le rend adapté à un large éventail d’applications. Pour voir comment il se compare à d’autres détecteurs à vocabulaire ouvert et à des modèles de langage visuel sur des jeux de données réels, consulte le classement VLM.
Métriques courantes pour évaluer les détecteurs d’objets#
Lorsque tu compares différents modèles de détection d’objets, tu te demandes peut-être comment déterminer lequel est le plus performant. C’est une bonne question, car au-delà de l’architecture du modèle et de la qualité de tes données, de nombreux facteurs peuvent influer sur les performances.
Les chercheurs s’appuient souvent sur des benchmarks communs et des métriques de performance standard pour évaluer les modèles de façon cohérente, comparer les résultats et comprendre les compromis entre vitesse et précision. Les benchmarks standard sont particulièrement importants, car de nombreux modèles de détection d’objets sont évalués sur les mêmes jeux de données, comme COCO.
Mesurer la précision et la vitesse de détection#
Voici un aperçu de quelques métriques courantes utilisées pour évaluer les modèles de détection d’objets :
- Intersection sur union (IoU) : Cette métrique mesure le chevauchement entre une boîte englobante prédite et l’objet réel dans une image. Elle compare la boîte tracée par le modèle à la boîte de vérité terrain, qui indique l’emplacement de l’objet tel qu’il est annoté dans le jeu de données. L’IoU se calcule en divisant la surface de chevauchement par la surface de l’union des deux boîtes. Une IoU plus élevée indique que le modèle place la boîte avec davantage de précision, tandis qu’une IoU plus faible signifie que la prédiction est moins précise. En termes simples, l’IoU mesure à quel point les prédictions du modèle correspondent à l’emplacement réel des objets.
- Précision moyenne moyenne (mAP) : c’est la principale métrique utilisée pour évaluer les performances globales en détection d’objets. Elle prend en compte le nombre d’objets correctement détectés par le modèle ainsi que la précision de ces détections selon différents seuils de confiance et catégories d’objets.
- Images par seconde (FPS) et latence : le FPS indique combien d’images ou d’images vidéo un modèle peut traiter en une seconde. Par exemple, un modèle fonctionnant à 30 FPS peut traiter 30 images par seconde. Un FPS élevé signifie que le système peut réagir plus rapidement, ce qui est important pour des cas d’usage comme la vidéo en direct, la surveillance du trafic ou la robotique. La latence, quant à elle, mesure le temps nécessaire au modèle pour traiter une seule image ou trame, de sa réception à la disponibilité du résultat.
Avantages et inconvénients des algorithmes de détection d’objets#
Voici quelques-uns des principaux avantages des modèles de détection d’objets dans des applications concrètes :
- Adaptation à différents secteurs : La détection d’objets s’applique à de nombreux cas d’usage, de la surveillance du trafic et de l’analyse du commerce de détail aux soins de santé, à l’agriculture et à l’industrie manufacturière.
- Réduction du travail manuel : L’automatisation des tâches d’inspection visuelle et de surveillance réduit le besoin d’une supervision humaine constante et aide les équipes à se concentrer sur des tâches à plus forte valeur ajoutée.
- Avantages des écosystèmes open source : Les communautés et les ressources open source actives sur GitHub facilitent l’accès aux modèles préentraînés, l’expérimentation et la personnalisation des solutions.
Malgré ces avantages, certaines limites pratiques peuvent influer sur les performances des modèles de détection d’objets. Voici quelques facteurs essentiels à prendre en compte :
- Exigences en matière de qualité des données : Les modèles de détection d’objets s’appuient sur de grands jeux de données bien annotés pour l’entraînement. La création et la gestion de ces données peuvent prendre du temps, coûter cher et être difficiles à faire évoluer.
- Besoins en calcul : Les modèles qui offrent une meilleure précision de détection nécessitent souvent une puissance de traitement importante, aussi bien pendant l’entraînement que lors du déploiement en temps réel. Cela implique généralement d’utiliser des GPU hautes performances, ce qui peut augmenter les coûts d’infrastructure.
- Sensibilité aux conditions réelles : Les variations d’éclairage, d’angle de caméra, de météo et de densité des scènes peuvent nuire aux performances de détection, ce qui rend nécessaires des tests et des réglages continus.
Points clés à retenir#
Le meilleur modèle de détection d’objets pour ton projet de vision par ordinateur dépend de ton cas d’usage, de la configuration de tes données, de tes exigences en matière de performances et de tes contraintes matérielles. Certains modèles sont optimisés pour la vitesse, tandis que d’autres privilégient la précision ; la plupart des applications concrètes nécessitent un équilibre entre les deux. Grâce aux frameworks open source et aux communautés actives sur GitHub, ces modèles sont de plus en plus faciles à évaluer, à adapter et à déployer dans des conditions réelles.
Pour en savoir plus, explore notre dépôt GitHub. Rejoins notre communauté et consulte nos pages consacrées aux solutions pour découvrir des applications comme l’IA dans le secteur de la santé et la vision par ordinateur dans l’industrie automobile. Découvre nos options de licence pour te lancer dès aujourd’hui dans l’IA visuelle.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









