Comment choisir un GPU cloud pour entraîner des modèles d’IA pour la vision sur Ultralytics Platform
Découvre comment choisir le bon GPU cloud pour l’entraînement en vision par ordinateur sur Ultralytics Platform, en fonction de facteurs comme la taille du jeu de données, la complexité du modèle et le coût.
Le mois dernier, nous avons présenté Ultralytics Platform, un environnement de bout en bout conçu pour simplifier l’ensemble du flux de travail de vision par ordinateur, de la gestion des jeux de données à l’entraînement et au déploiement des modèles. Ultralytics Platform réunit tout le nécessaire pour créer et faire évoluer des modèles d’IA visuelle au sein d’une expérience unifiée.
L’entraînement des modèles est une étape clé de ce flux de travail : les réseaux neuronaux y apprennent des motifs à partir des données afin de produire des prédictions précises, et l’accès aux bonnes ressources de calcul joue un rôle essentiel. Nous avons précédemment expliqué comment Ultralytics Platform prend en charge l’entraînement de modèles dans le cloud, avec des unités de traitement graphique (GPU), permettant aux utilisateurs d’entraîner des modèles de vision par ordinateur sans gérer d’infrastructure locale.
Grâce à l’accès à la demande à de puissants GPU NVIDIA, les utilisateurs — des étudiants et des startups aux chercheurs et aux grandes organisations — peuvent exécuter des charges de travail d’IA plus efficacement que jamais. Même si démarrer un entraînement dans le cloud est simple, le choix du bon GPU dépend de facteurs comme la taille du jeu de données, la complexité du modèle et le coût.
Avec le large éventail d’options disponibles aujourd’hui, des GPU RTX économiques aux NVIDIA H100 haute performance et au matériel Blackwell de nouvelle génération, le choix de la configuration adéquate peut avoir un impact considérable sur le développement du modèle et son coût.
Dans cet article, nous allons examiner l’entraînement cloud sur GPU pour la vision par ordinateur avec Ultralytics Platform et voir comment choisir le matériel adapté à ta charge de travail. C’est parti !
Présentation de l’entraînement dans le cloud avec Ultralytics Platform#
Avant de voir comment choisir un GPU pour l’entraînement dans le cloud avec Ultralytics Platform, prenons un peu de recul et examinons le fonctionnement de cet entraînement.
Qu’est-ce que l’entraînement sur GPU dans le cloud ?#
L’entraînement sur GPU dans le cloud consiste à utiliser des GPU hébergés dans un environnement de cloud computing pour entraîner des modèles d’apprentissage automatique et d’apprentissage profond, plutôt que de dépendre de ton propre matériel ou poste de travail local. Avec Ultralytics Platform, tu peux accéder à de puissants GPU à la demande et lancer des tâches d’entraînement à distance, sans avoir besoin de ta propre configuration.
Tu peux ainsi adapter facilement tes ressources à ta charge de travail. Tu peux choisir des GPU plus puissants ou augmenter la capacité selon tes besoins, sans être limité par les capacités de ton système. Imagine que tu accèdes à de puissantes machines, ou nœuds, dans des centres de données distants, dont tu peux augmenter ou réduire les ressources selon tes besoins.
Cela élimine également la nécessité d’installer et de maintenir du matériel coûteux. Tu n’as pas besoin d’acheter des GPU, d’installer des pilotes ni de gérer des problèmes de compatibilité.
Ultralytics Platform prend tout en charge grâce à des services cloud gérés, de l’allocation des ressources à la configuration de l’environnement, à l’orchestration et à l’exécution des tâches d’entraînement. Tu peux ainsi te concentrer sur l’entraînement, l’expérimentation et l’amélioration de tes modèles.
Fonctionnement de l’entraînement des modèles sur Ultralytics Platform#
Sur Ultralytics Platform, le flux de travail d’entraînement accéléré par GPU est simple. Tu peux commencer par importer ton jeu de données de plusieurs façons.
Tu peux importer tes propres données, utiliser les jeux de données publics disponibles sur la plateforme ou cloner ceux partagés par la communauté pour t’appuyer sur des travaux existants. Le clonage crée une copie du jeu de données dans ton espace de travail, que tu peux modifier et compléter tout en conservant l’original intact.
Une fois le jeu de données sélectionné, tu peux examiner et organiser tes images et annotations pour vérifier que tout est correctement structuré. La plateforme comprend également des outils d’annotation intégrés qui te permettent d’étiqueter les données pour des tâches comme la détection d’objets, la segmentation et la classification, ou d’accélérer le processus grâce à des fonctionnalités assistées par l’IA.
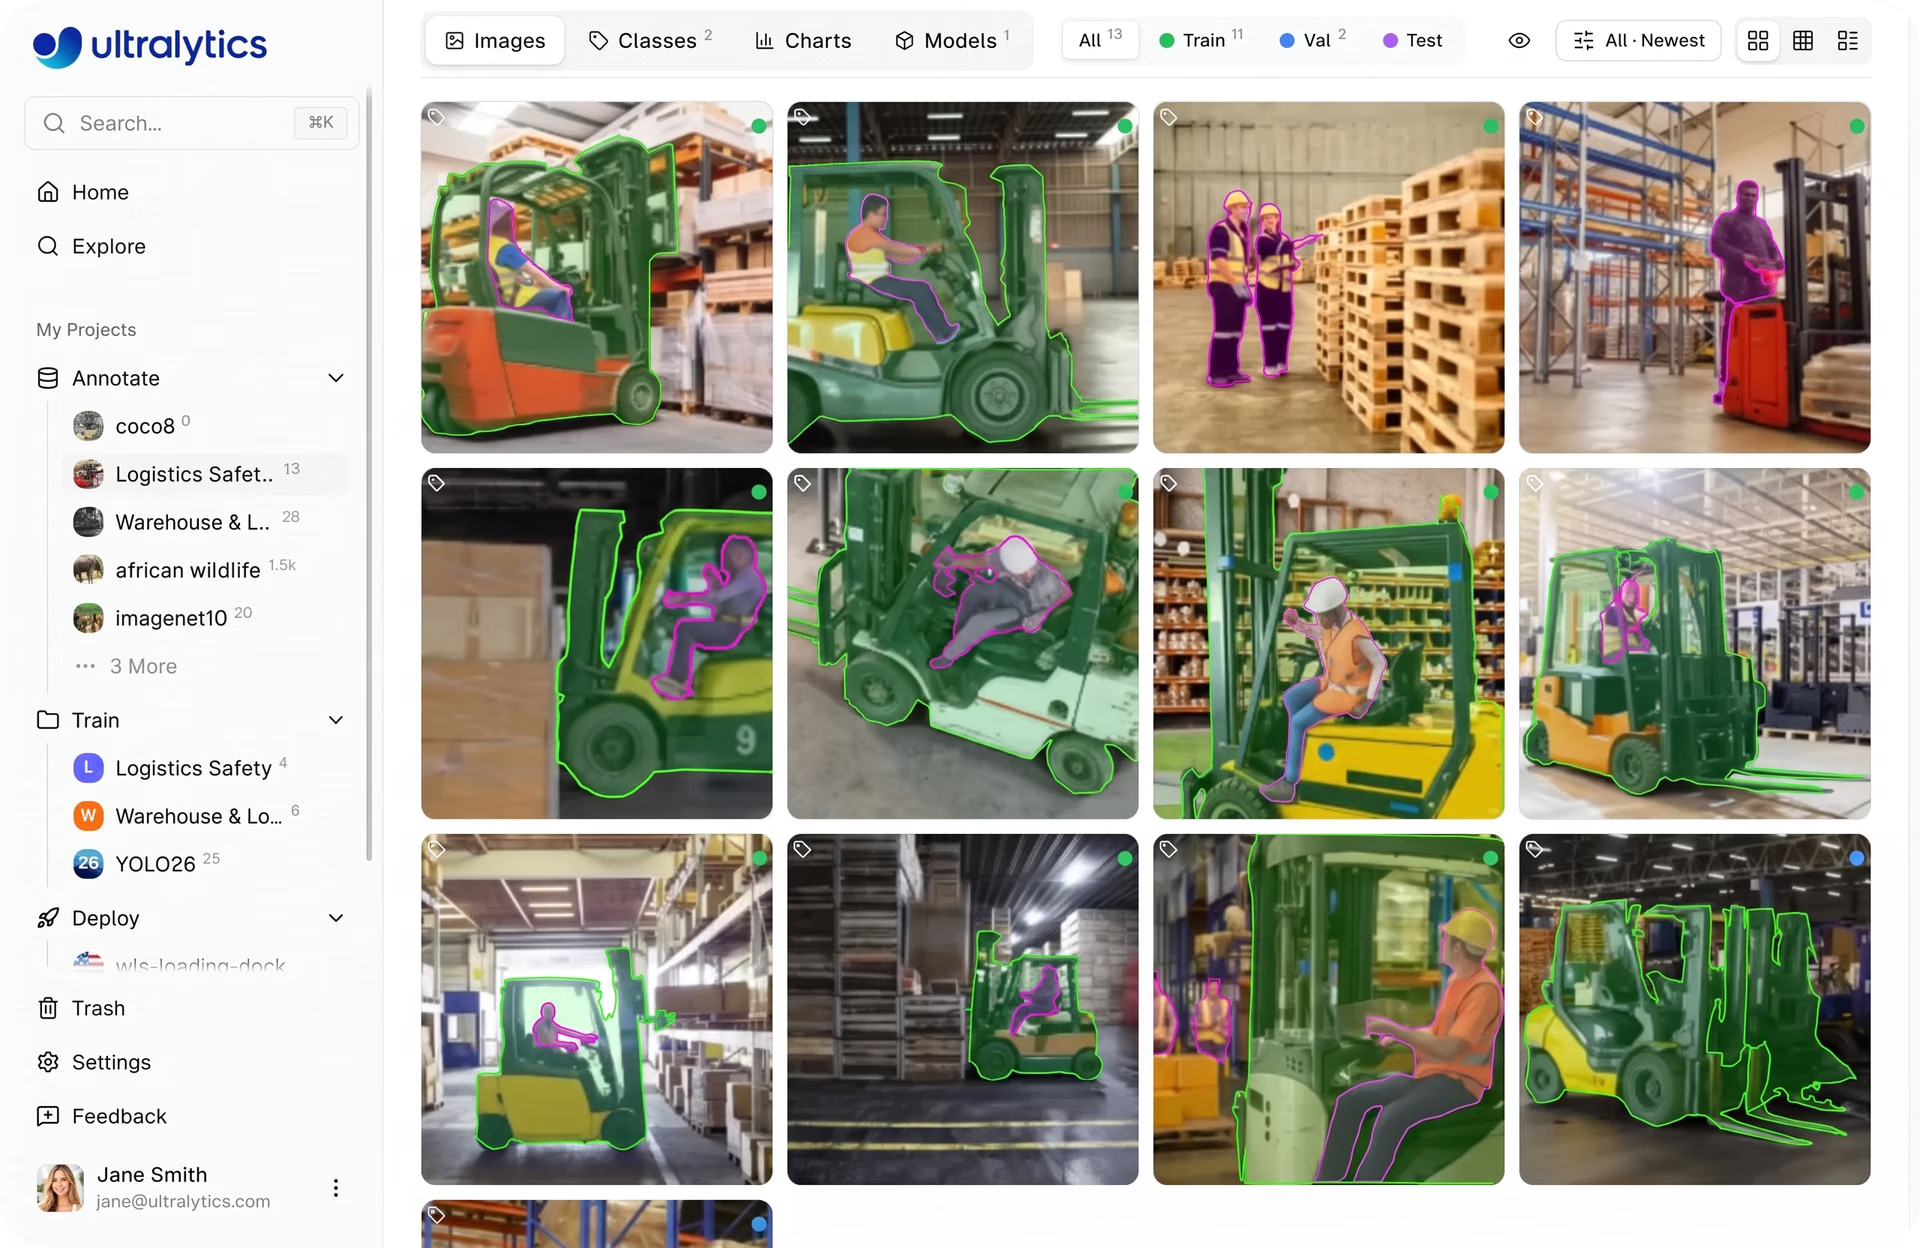
Fig. 1. Consultation d’un jeu de données dans Ultralytics Platform (Source)
Ensuite, tu peux sélectionner ou créer un projet pour gérer tes entraînements. Les projets t’aident à organiser et comparer les modèles, à suivre les indicateurs de performance et à regrouper les expériences associées au même endroit.
Tu peux ensuite passer à l’entraînement dans le cloud, où tu choisis un modèle, configures les paramètres et sélectionnes un GPU en fonction de tes besoins en matière de performances et de budget. La plateforme gère l’infrastructure cloud sous-jacente pour toi.
La plateforme provisionne l’instance GPU sélectionnée, prépare ton jeu de données et exécute la tâche d’entraînement dans le cloud. À mesure que l’entraînement progresse, tu peux suivre les indicateurs, les journaux et les performances du système en temps réel, sans avoir à gérer la configuration, les environnements CUDA, les frameworks comme PyTorch ou TensorFlow, ni le matériel.
Principales fonctionnalités d’entraînement sur GPU d’Ultralytics Platform#
Voici quelques fonctionnalités clés de l’entraînement sur GPU dans le cloud avec Ultralytics Platform :
- Entraînement en un clic : lance des tâches d’entraînement avec une configuration minimale et passe rapidement du jeu de données à l’entraînement du modèle, sans configuration complexe.
- GPU à la demande : choisis parmi différentes options de GPU selon tes besoins et adapte les ressources sans engagement à long terme.
- Suivi en temps réel : suis la progression de l’entraînement grâce à des graphiques et des journaux actualisés en direct, et consulte en temps réel les indicateurs système comme l’utilisation du GPU et de la mémoire.
- Points de contrôle automatiques : la progression de l’entraînement est enregistrée à intervalles réguliers, ce qui facilite la reprise ou la récupération du travail si nécessaire.
- Déploiement facile : une fois l’entraînement terminé, tu peux déployer tes modèles entraînés et les utiliser dans des applications ou des flux de travail au moyen d’API d’inférence partagées, de points de terminaison dédiés ou en les exportant pour les utiliser sur des systèmes externes. Ces options de déploiement permettent une inférence à faible latence et alimentent ainsi des applications en temps réel, comme l’analyse vidéo, les systèmes d’automatisation et les solutions d’IA interactives.
Différentes options de GPU cloud sur Ultralytics Platform#
Maintenant que nous avons vu le fonctionnement de l’entraînement sur la plateforme, examinons les différentes options de GPU disponibles. Le GPU choisi peut influer sur la vitesse d’entraînement de ton modèle, ses performances et son coût.
Ultralytics Platform propose un large éventail de GPU, à commencer par des options comme les RTX 2000 Ada et RTX A4500, puis les RTX 4000 Ada, RTX A5000, RTX 3090 et RTX A6000, jusqu’aux options plus puissantes comme les RTX 4090 et RTX PRO 6000.
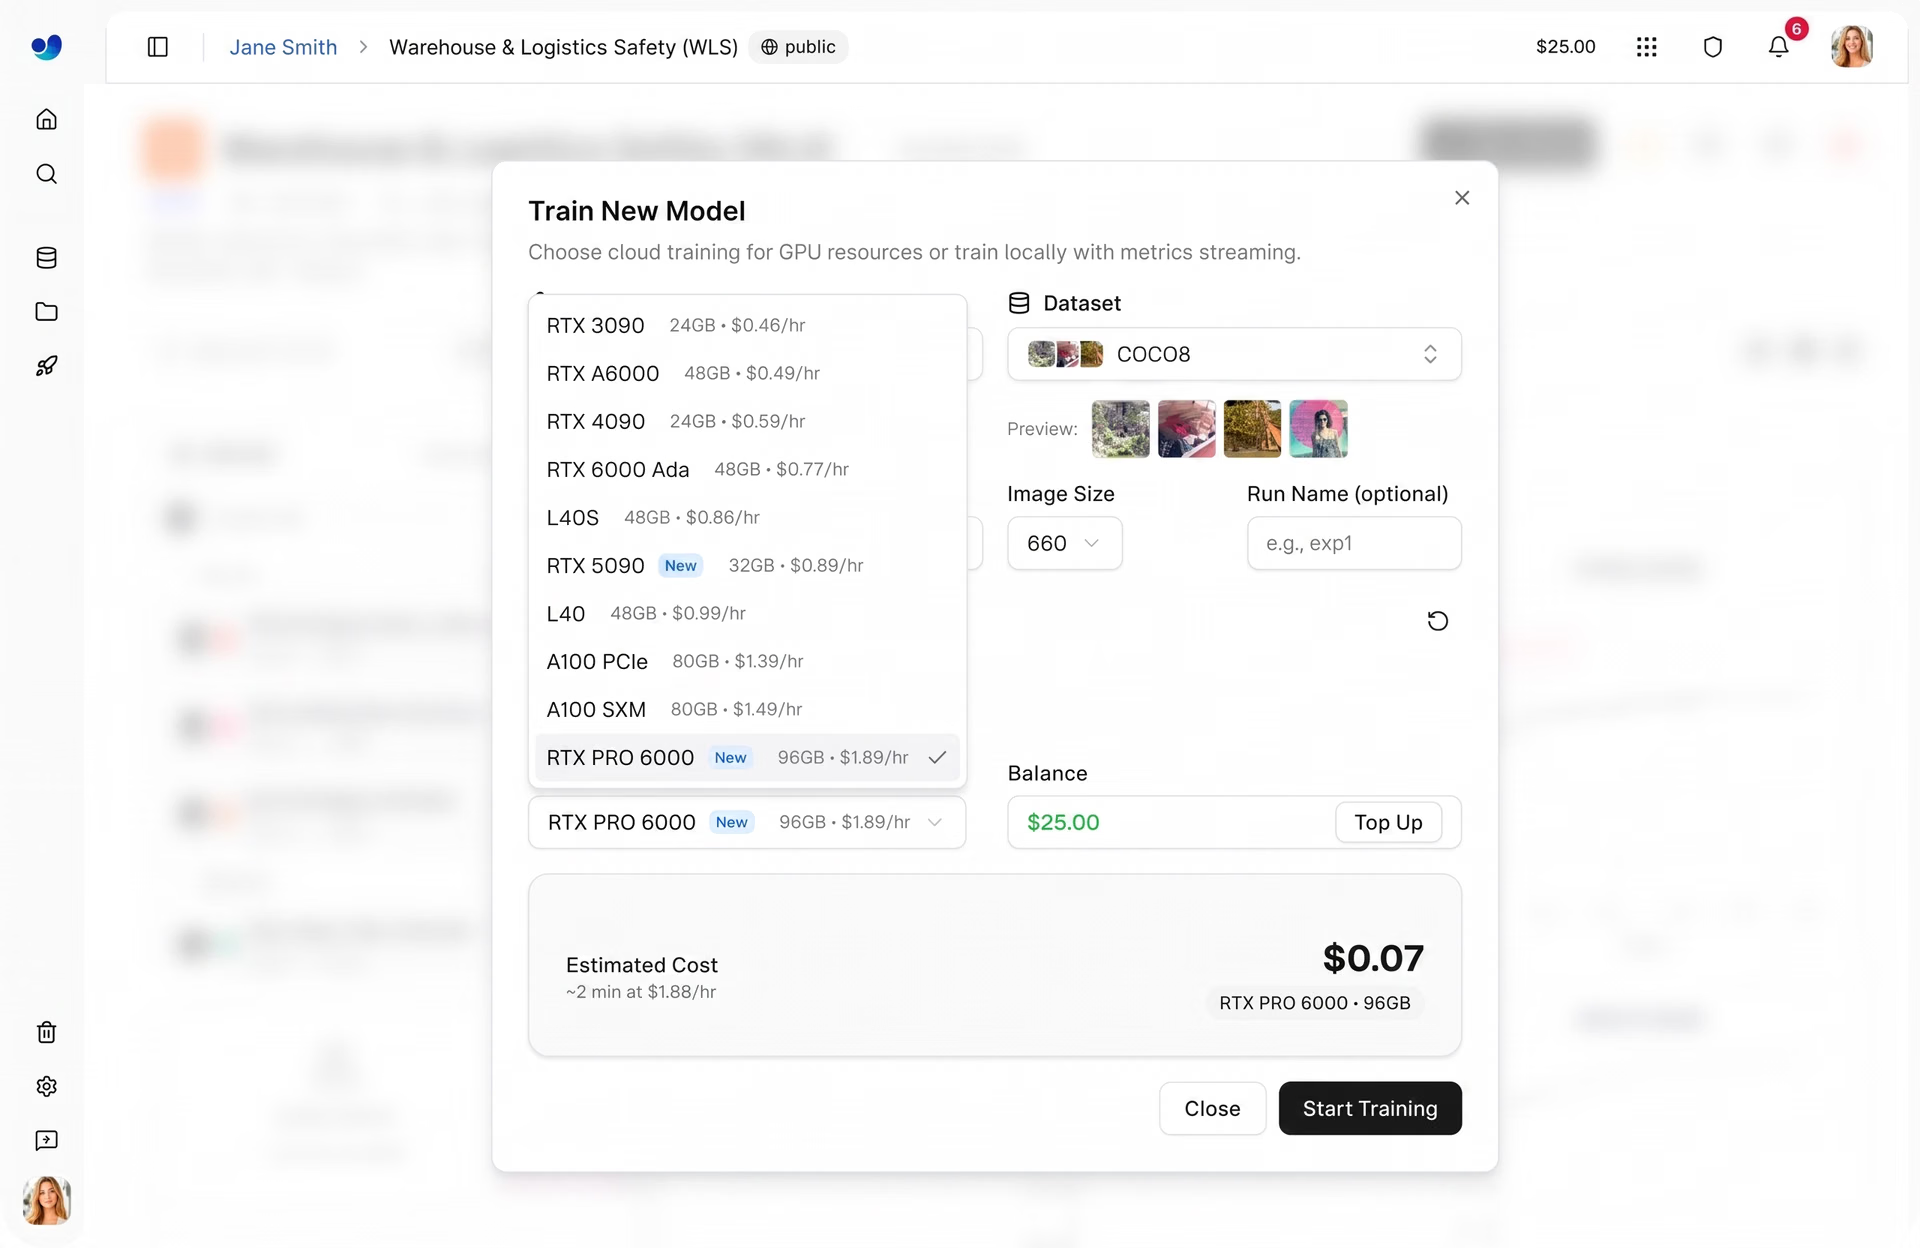
Fig. 2. Exemple des différentes options de GPU prises en charge par Ultralytics Platform (Source)
Pour la plupart des utilisateurs, la RTX PRO 6000 est un choix par défaut équilibré. Elle offre des performances fiables pour diverses charges de travail sans nécessiter beaucoup de réglages. La RTX 4090 est une autre option populaire, qui offre de solides performances pour son prix.
Pour les tâches plus modestes, comme les expérimentations rapides, le prototypage ou le travail avec des jeux de données légers, les GPU comme la RTX 2000 Ada et la RTX A4500 constituent un bon point de départ. À mesure que ta charge de travail augmente, des options comme les RTX 4000 Ada, RTX A5000 et RTX 3090 offrent des performances plus constantes pour l’entraînement général.
Dans le haut de gamme, les GPU comme les A100 (Ampere), H100 et H200 (Hopper), ainsi que B200 (Blackwell), sont conçus pour les charges de travail à grande échelle. Ils conviennent particulièrement à l’entraînement de très grands modèles, au traitement de jeux de données massifs ou à l’exécution de tâches où la vitesse et les performances sont essentielles.
Comprendre les différents types de GPU et leurs cas d’utilisation#
Examinons ensuite les différences entre les types de GPU et les usages auxquels ils sont le mieux adaptés.
Les GPU RTX de NVIDIA sont généralement plus économiques et sont couramment utilisés pour l’entraînement quotidien, l’expérimentation et les charges de travail petites à moyennes. Ils offrent un bon équilibre entre performances et accessibilité, ce qui les rend adaptés à un large éventail de cas d’utilisation.
En comparaison, les GPU comme les A100, A40 et L40 sont conçus pour les charges de travail plus lourdes et l’entraînement à plus grande échelle. Ils offrent une meilleure stabilité et une évolutivité supérieure, en particulier avec des jeux de données plus volumineux ou des modèles plus complexes.
Dans le haut de gamme, les GPU comme le H100 et ceux reposant sur l’architecture Blackwell de NVIDIA représentent du matériel d’IA plus récent. Ils sont conçus pour les charges de travail haute performance et sont généralement utilisés pour l’entraînement à grande échelle, la recherche avancée ou les tâches urgentes.
La gamme de GPU proposée sur Ultralytics Platform offre de la flexibilité pour différentes charges de travail. Selon tes besoins, tu peux commencer par une configuration modeste et l’augmenter au fur et à mesure.
Comment choisir le bon GPU cloud pour ton projet#
Pour choisir un GPU destiné à l’entraînement dans le cloud sur Ultralytics Platform, plusieurs facteurs sont à prendre en compte, notamment la taille du jeu de données, la complexité du modèle et le coût. Examinons chacun de ces facteurs.
Adapter la puissance du GPU à la taille du jeu de données#
La taille de ton jeu de données est l’un des principaux facteurs à prendre en compte lors du choix d’un GPU, car elle influe sur la durée de l’entraînement et la puissance de calcul nécessaire.
Pour les petits jeux de données, généralement de moins de 1 000 images, un GPU léger comme le RTX 2000 suffit souvent. Il convient parfaitement aux expérimentations rapides et aux entraînements de courte durée.
Pour les jeux de données de taille moyenne, d’environ 1 000 à 10 000 images, des GPU comme le RTX 4090 ou le RTX A6000 offrent un meilleur équilibre entre performances et efficacité, et facilitent l’entraînement sans longs délais.
Pour les grands jeux de données, de plus de 10 000 images, tu auras probablement besoin d’un matériel plus puissant pour maintenir des durées d’entraînement raisonnables. Les GPU H100 sont mieux adaptés aux charges de travail lourdes et à une mise à l’échelle efficace.
Dans l’ensemble, il s’agit d’adapter la taille de ton jeu de données à la puissance de calcul et aux capacités de traitement parallèle dont tu as besoin.
Choisir un GPU en fonction de la taille et de la complexité du modèle#
La taille et la complexité de ton modèle d’IA visuelle sont un autre facteur important dans le choix d’un GPU. Les modèles de différentes tailles nécessitent des puissances de calcul différentes.
Par exemple, les modèles plus petits nécessitent moins de puissance de calcul GPU et peuvent fonctionner efficacement sur des GPU comme les RTX 2000 Ada et RTX A4500, voire sur la RTX 4090 si tu veux obtenir des résultats plus rapidement. Ils sont idéaux pour les expérimentations rapides, le prototypage et les tâches simples, car ils te permettent d’itérer plus vite et de tester des idées sans coûts de calcul élevés.
En revanche, les modèles plus grands et plus complexes nécessitent beaucoup plus de mémoire et de puissance de traitement. Les GPU comme les RTX A6000 et RTX PRO 6000, ainsi que les options haut de gamme comme le H100, sont mieux adaptés à ces charges de travail. Ils peuvent gérer des architectures plus grandes, réduire la durée d’entraînement et éviter les problèmes de mémoire, ce qui est particulièrement important avec des images haute résolution, des tailles de lot importantes ou des architectures de modèles plus avancées.
Comparer la taille des lots et la mémoire du GPU#
De même, la taille du lot joue un rôle important dans l’entraînement des modèles. Elle correspond au nombre d’exemples d’entraînement que le modèle traite simultanément en une seule étape.
Une taille de lot plus importante peut améliorer l’efficacité de l’entraînement en traitant davantage de données à la fois, mais elle nécessite également plus de mémoire GPU (VRAM). En général, les GPU offrant une bande passante mémoire supérieure peuvent prendre en charge des lots plus importants, tandis que ceux disposant de moins de mémoire peuvent nécessiter des lots plus petits.
Par exemple, les GPU comme les RTX A6000, RTX PRO 6000 ou A100 peuvent traiter plus facilement des lots plus importants grâce à leur mémoire supérieure, tandis que des options comme les RTX 4090 ou RTX 2000 Ada peuvent nécessiter des lots plus petits selon la charge de travail.
Cependant, il n’est pas toujours nécessaire d’utiliser le GPU le plus puissant. Les GPU haut de gamme peuvent améliorer la vitesse et la capacité, mais ils coûtent aussi plus cher. Dans bien des cas, ajuster la taille des lots sur un GPU moins puissant peut être plus efficace.
L’objectif est donc de trouver le bon équilibre entre la taille des lots, la mémoire GPU disponible et le coût, en fonction de ton modèle et de ton jeu de données.
Impact de la configuration de l’entraînement sur les performances du GPU#
La configuration de l’entraînement est un autre facteur qui influe sur les performances du GPU. Elle comprend des paramètres comme le nombre d’époques, la taille des images et d’autres réglages qui déterminent le déroulement de l’entraînement du modèle.
Par exemple, une taille d’image plus importante augmente la quantité de calcul nécessaire à chaque étape. Cela peut ralentir l’entraînement et nécessiter davantage de puissance de calcul ou de mémoire pour maintenir de bonnes performances.
De même, augmenter le nombre d’époques prolonge la durée totale de l’entraînement, surtout sur du matériel moins puissant. Une époque correspond à un passage complet dans l’ensemble du jeu de données pendant l’entraînement.
Les techniques comme l’augmentation de données ajoutent également du traitement pendant l’entraînement. L’augmentation de données applique des transformations comme le retournement, la rotation ou le redimensionnement pour accroître la diversité des données et améliorer les performances du modèle. Si elle peut renforcer la robustesse du modèle, elle peut aussi ralentir l’entraînement.
En général, les GPU plus puissants peuvent gérer ces exigences supplémentaires plus efficacement, mais leur impact dépend de la configuration globale et de la charge de travail.
Équilibrer le coût et la durée d’entraînement#
Lors du choix d’un GPU pour ton projet, il faut souvent trouver un compromis entre la vitesse d’entraînement et le prix du GPU.
Ultralytics Platform facilite l’estimation et la compréhension des coûts avant le lancement d’une tâche d’entraînement. En fonction de ta configuration, notamment de la taille du jeu de données, du modèle et du GPU, tu peux consulter à l’avance le coût et la durée estimés.
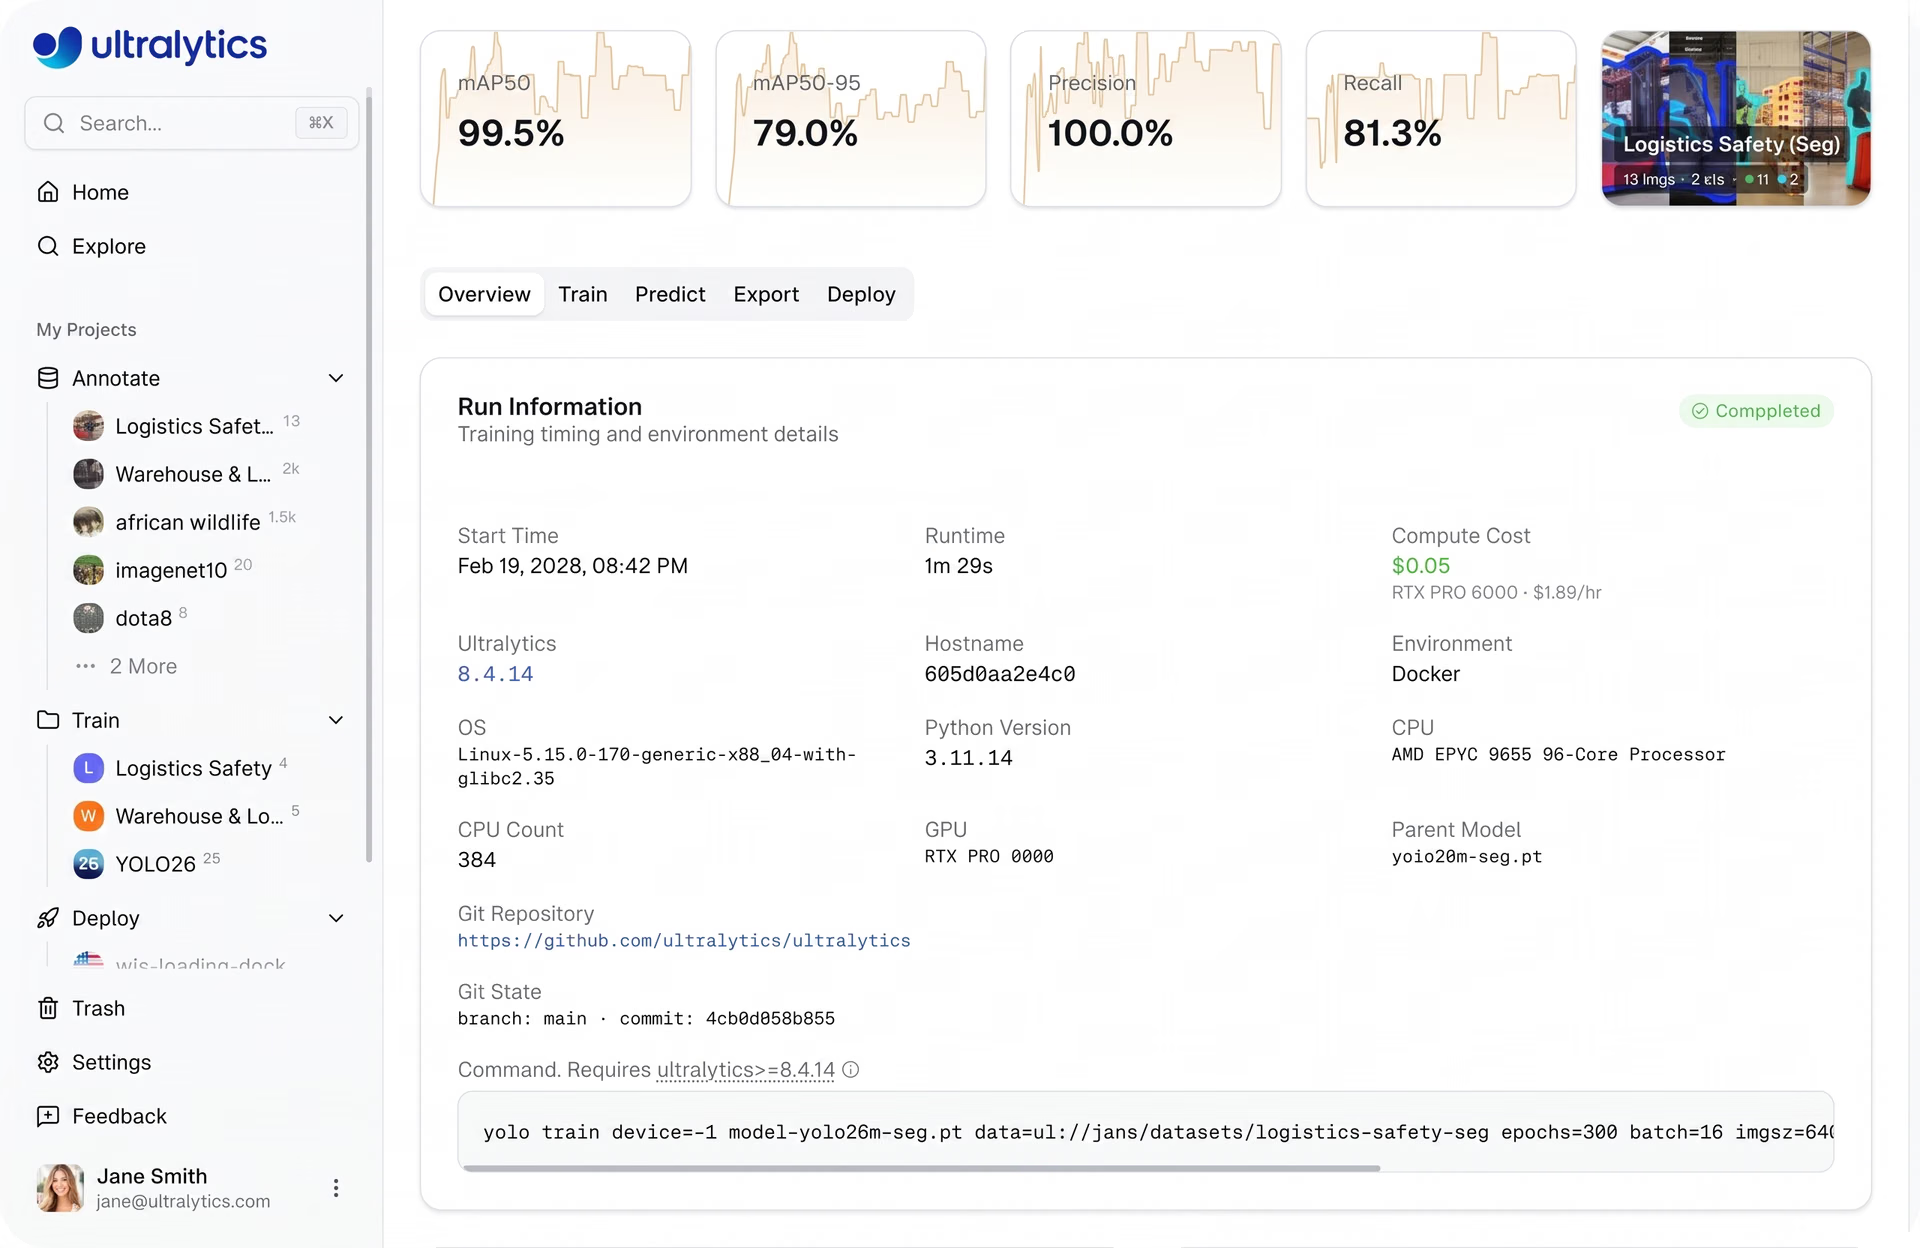
Fig. 3. Ultralytics Platform facilite l’estimation et la compréhension des coûts du cloud. (Source)
Les GPU plus rapides coûtent généralement plus cher à l’heure, mais peuvent réduire la durée totale de l’entraînement. Les GPU comme les RTX 4090, RTX PRO 6000 et H100 peuvent généralement terminer l’entraînement plus rapidement grâce à leurs performances supérieures.
Les GPU plus lents coûtent généralement moins cher à l’heure, mais mettent plus de temps à terminer l’entraînement. Par exemple, les GPU comme les RTX 2000 Ada et RTX A4500 sont souvent utilisés pour les charges de travail plus modestes ou les tâches de longue durée où la priorité est de réduire les coûts.
De plus, certains des GPU les plus haut de gamme, comme les H200 et B200, ne sont disponibles qu’avec les offres Pro ou Enterprise, tandis que la plupart des autres options sont également accessibles avec l’offre Free.
Aperçu des stratégies d’optimisation des coûts#
Au-delà du choix du bon GPU, il existe quelques moyens pratiques de maîtriser les coûts d’entraînement. L’une des approches les plus efficaces consiste à commencer par de petits tests avant de passer à l’échelle supérieure.
Au lieu de passer directement à un entraînement complet, commence par un nombre réduit d’époques pour vérifier que ta configuration fonctionne comme prévu. Cela t’aide à valider rapidement tes données, tes annotations et la configuration de ton modèle, et t’évite de consacrer du temps et des ressources de calcul à des exécutions qui risquent de ne produire aucun résultat utile.
À mesure que l’entraînement progresse, surveille tes métriques et arrête les exécutions rapidement si les performances plafonnent ou cessent de s’améliorer. Le suivi des courbes d’entraînement peut t’aider à décider s’il faut continuer ou ajuster ta configuration.
Tu peux aussi ajuster des paramètres comme la taille de lot et la taille des images. Des valeurs plus faibles réduisent l’utilisation de la mémoire et des ressources de calcul, ce qui facilite les expérimentations, les essais de différentes configurations ou l’exécution de simulations à petite échelle avant de passer à l’échelle supérieure.
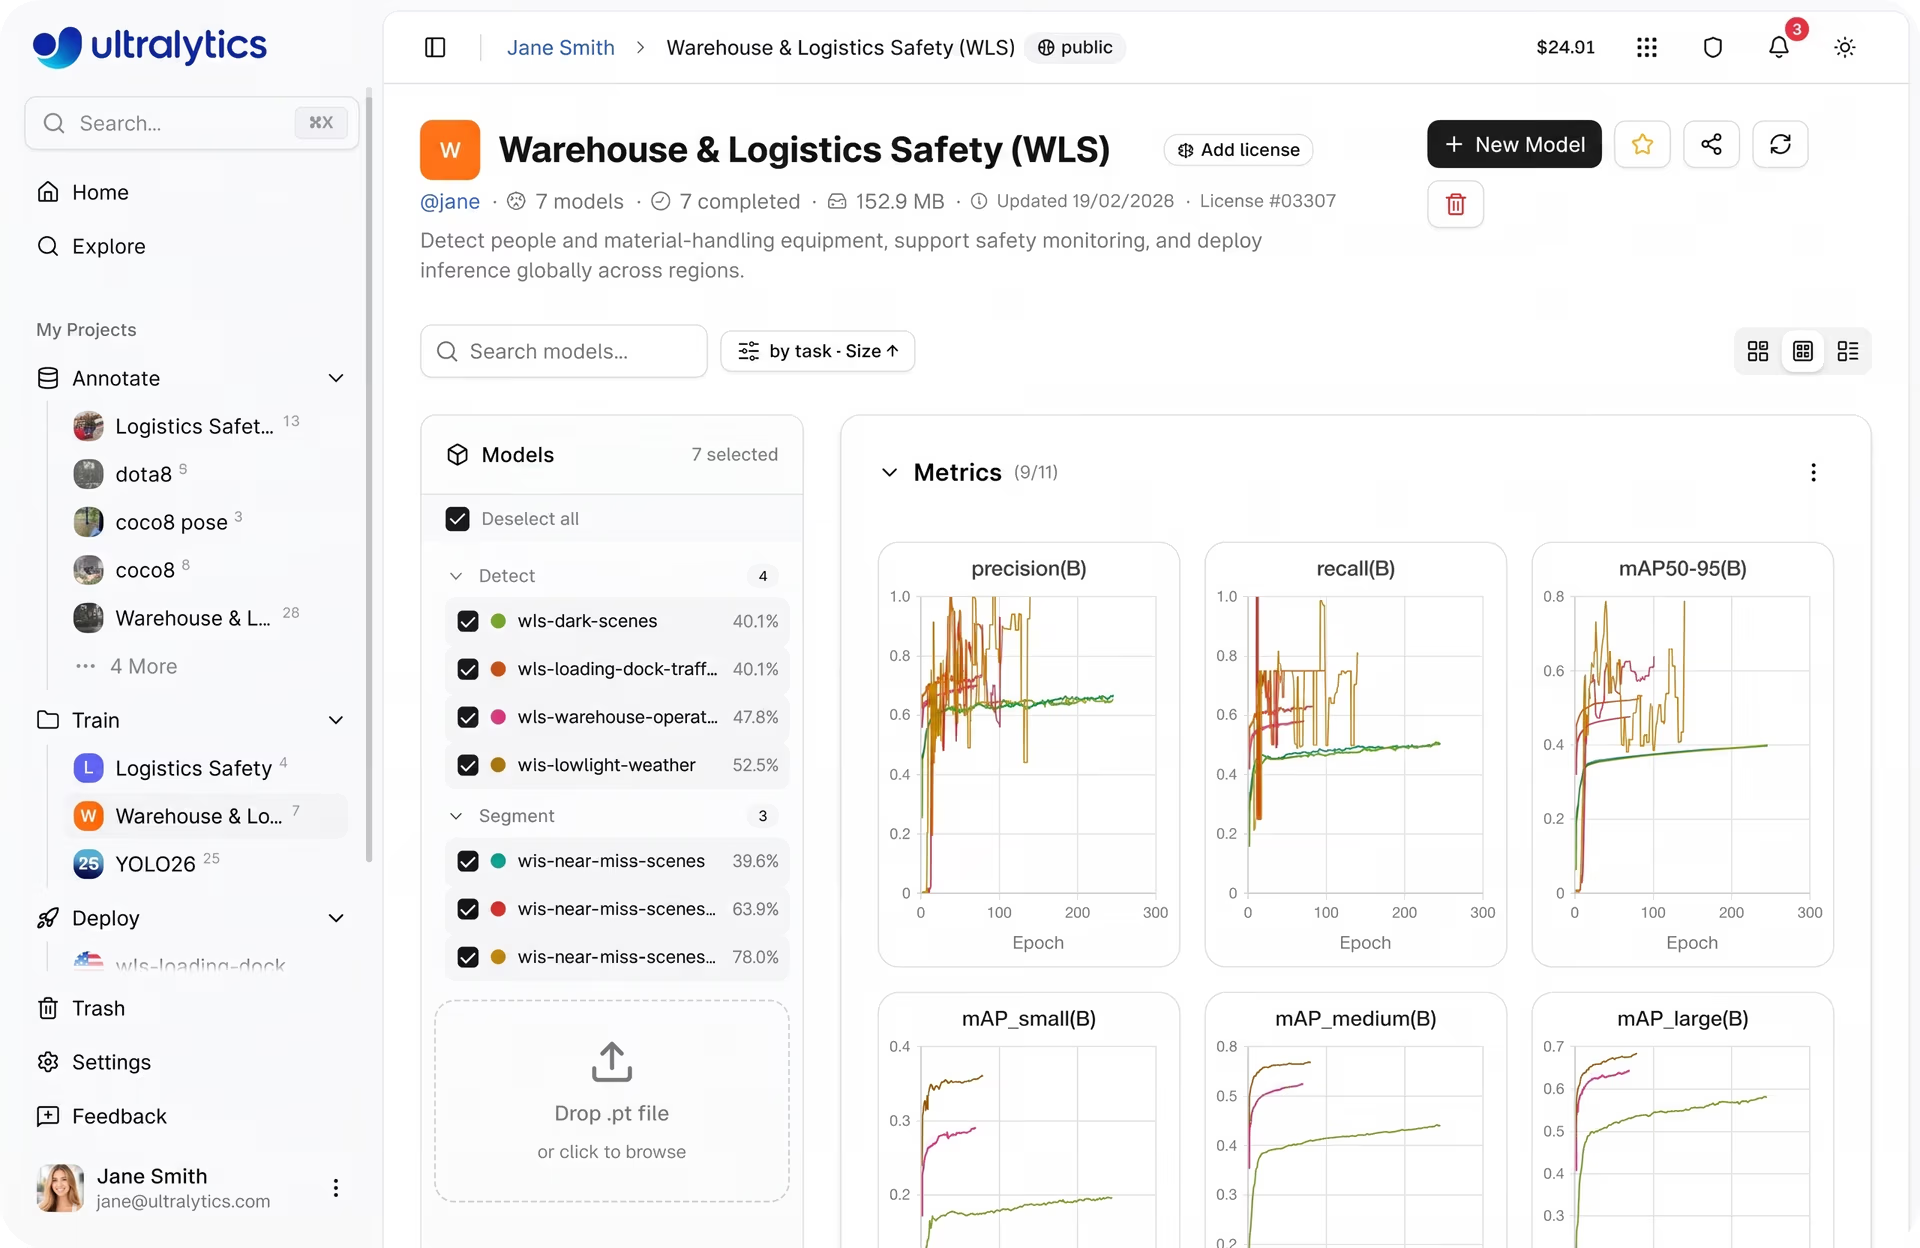
Fig. 4. Visualisations des métriques d’entraînement sur Ultralytics Platform (Source)
En outre, Ultralytics Platform simplifie la gestion des coûts. La plateforme intègre une estimation des coûts qui te permet de connaître les dépenses prévues avant de lancer une tâche.
Avec un système de crédits à l’usage, tu ne paies que le temps de calcul que tu utilises réellement. Tu peux ainsi plus facilement respecter ton budget et passer à l’échelle supérieure une fois que tu as confiance en ta configuration d’entraînement.
Bonnes pratiques pour l’entraînement sur GPU cloud en vision par ordinateur#
Voici quelques bonnes pratiques à garder à l’esprit pour l’entraînement sur GPU cloud avec Ultralytics Platform :
- Valide les jeux de données avant l’entraînement : vérifie que ton jeu de données est propre, bien annoté et cohérent avant de commencer. Repérer les problèmes tôt permet d’éviter de gaspiller des ressources de calcul et d’améliorer les performances du modèle.
- Commence par des expérimentations rapides : lance de petits essais avec moins d’époques pour vérifier ta configuration. Tu peux ainsi repérer les problèmes tôt sans t’engager dans de longs entraînements coûteux. En quelque sorte, tu crées un modèle que tu pourras réutiliser et adapter à plus grande échelle lorsque tout fonctionnera comme prévu.
- Surveille les métriques clés : suis des métriques comme la loss, mAP, la précision et le rappel tout au long de l’entraînement. Ces métriques servent de références pour évaluer les performances du modèle et t’aident à décider quand l’ajuster ou l’arrêter.
- Optimise les pipelines de traitement des données : assure-toi que le chargement et le prétraitement des données sont efficaces, car ces opérations dépendent des ressources du CPU et peuvent devenir des goulots d’étranglement qui nuisent aux performances globales de l’entraînement.
- Utilise les outils intégrés : utilise les graphiques, les journaux de la console et les métriques système pour suivre l’entraînement en temps réel et prendre rapidement des décisions éclairées.
Points clés à retenir#
Pour choisir le GPU cloud adapté à la vision par ordinateur sur Ultralytics Platform, tu dois comprendre ta charge de travail, notamment la taille du jeu de données, la complexité du modèle et la configuration d’entraînement. Avec un éventail d’options GPU reposant sur une infrastructure cloud et des machines virtuelles, tu peux commencer par un choix équilibré et passer à l’échelle supérieure à mesure que tes besoins d’entraînement ou d’affinage de modèle augmentent. En associant le matériel adapté à de bonnes pratiques, comme le suivi des performances et la maîtrise des coûts, tu peux entraîner efficacement des modèles d’intelligence artificielle de pointe tout en tirant pleinement parti de la flexibilité du calcul haute performance.
Découvre notre communauté grandissante et notre dépôt GitHub pour en savoir plus sur la vision par ordinateur. Si tu souhaites créer des solutions de vision, consulte nos options de licence. Explore nos pages de solutions pour en savoir plus sur les avantages de la vision par ordinateur dans l’industrie manufacturière et de l’IA dans l’agriculture.









