Claude Fable 5.2 è arrivato e si rifiuta di esaminare le radiografie di sicurezza
Claude Fable 5.2 è arrivato e si rifiuta di etichettare il dataset di radiografie di sicurezza IEDXray su Ultralytics Platform: tutte e 10 le scansioni bloccate, mentre i modelli open hanno risposto.
 Glenn Jocher16 min di lettura
Anthropic ha rilasciato Claude Fable 5.2 il 9 novembre 2026, affermando che è «un gradino sopra Opus 5.5 in quasi tutte le capacità che abbiamo valutato». Lo abbiamo sottoposto al nostro benchmark benchmark UL37, composto da 36 dataset di rilevamento, lo stesso giorno. Su uno di questi dataset, si è rifiutato di esaminare anche una sola immagine.
La prima scansione mostra un laptop stipato in una borsa, con la scheda elettronica visibile attraverso la custodia e due batterie incastrate accanto. Abbiamo chiesto a Claude Fable 5.2 di disegnare riquadri di delimitazione intorno agli oggetti. In meno di due secondi, l'API di Anthropic ha risposto con un blocco: «Questa richiesta ha attivato restrizioni sui contenuti relativi allo sviluppo di esplosivi ad alto potenziale e è stata bloccata in base alla Usage Policy di Anthropic».
Ha fatto lo stesso con tutte e 10 le scansioni a raggi X di sicurezza del dataset, comprese cinque che contengono solo un normale telefono, laptop, cercapersone o walkie-talkie. Nessun altro modello che abbiamo testato si è rifiutato di analizzare una scansione: né GPT-6.1, Gemini o Grok, né un modello open-weights o cinese, e nemmeno gli stessi Claude Opus 5.5, Sonnet 5.5 e Haiku 5.5 di Anthropic.
In tutti gli altri casi, l'annotazione automatica con Claude Fable 5.2 è eccellente. Ha ottenuto 0.544 mAP50, piazzandosi secondo su 44 modelli nella nostra classifica VLM, dietro a GPT-6.1 Terra, e i suoi riquadri sono i più precisi che abbiamo misurato. È disponibile da oggi su Ultralytics Platform. Di seguito vediamo cosa rifiuta, cosa fa benissimo e se è adatto al tuo flusso di lavoro di etichettatura.
Il filtro di Anthropic ha bloccato tutte le radiografie di sicurezza in UL37#
UL37 misura quanto i riquadri di un modello corrispondono alle etichette umane su 360 immagini: 10 per ciascuno dei 36 veri dataset di rilevamento di oggetti. Uno di questi è IEDXray, un insieme di radiografie da scanner per bagagli creato per addestrare rilevatori di minacce per aeroporti, frontiere e sicurezza degli eventi. Le sue 11 classi comprendono dispositivi elettronici di uso quotidiano (laptop, telefoni, cercapersone, walkie-talkie, batterie), le versioni modificate di ciascuno e gli esplosivi.
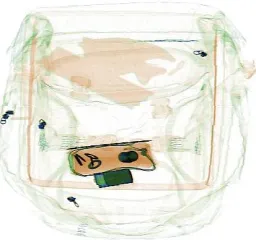 anteprima 1 di IEDXray Improvised Device X-raySovrapposizione delle annotazioni: visualizzate 2 etichette
 anteprima 2 di IEDXray Improvised Device X-raySovrapposizione delle annotazioni: visualizzata 1 etichetta
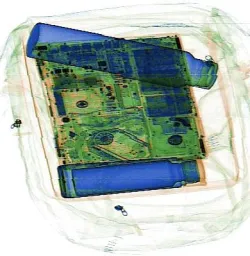 anteprima 3 di IEDXray Improvised Device X-raySovrapposizione delle annotazioni: visualizzata 1 etichetta
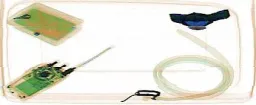 anteprima 4 di IEDXray Improvised Device X-raySovrapposizione delle annotazioni: visualizzata 1 etichetta
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
Fable 5.2 ha rifiutato tutte e 10 le immagini. Ogni richiesta ha ricevuto risposta in 1,0-4,7 secondi con il motivo di interruzione refusal di Anthropic e senza riquadri. La Platform mostra all'utente il messaggio «si è interrotto prima di completare il rilevamento (rifiuto). Prova un altro modello».
Per capire esattamente il motivo, il 10 novembre abbiamo riprodotto direttamente sull'API di Anthropic la richiesta di produzione di Platform per tutte e dieci le scansioni. Tutte e dieci hanno restituito lo stesso risultato: motivo di interruzione refusal, categoria general_harms, zero token di output e il messaggio sugli «esplosivi ad alto potenziale» citato sopra. Il messaggio suggerisce di richiedere «un'esenzione in base al modo in cui usi Claude» tramite il centro assistenza di Anthropic. Per chi integra le API, rimanda alla documentazione sui rifiuti di Anthropic, che suggerisce di configurare un modello di riserva.
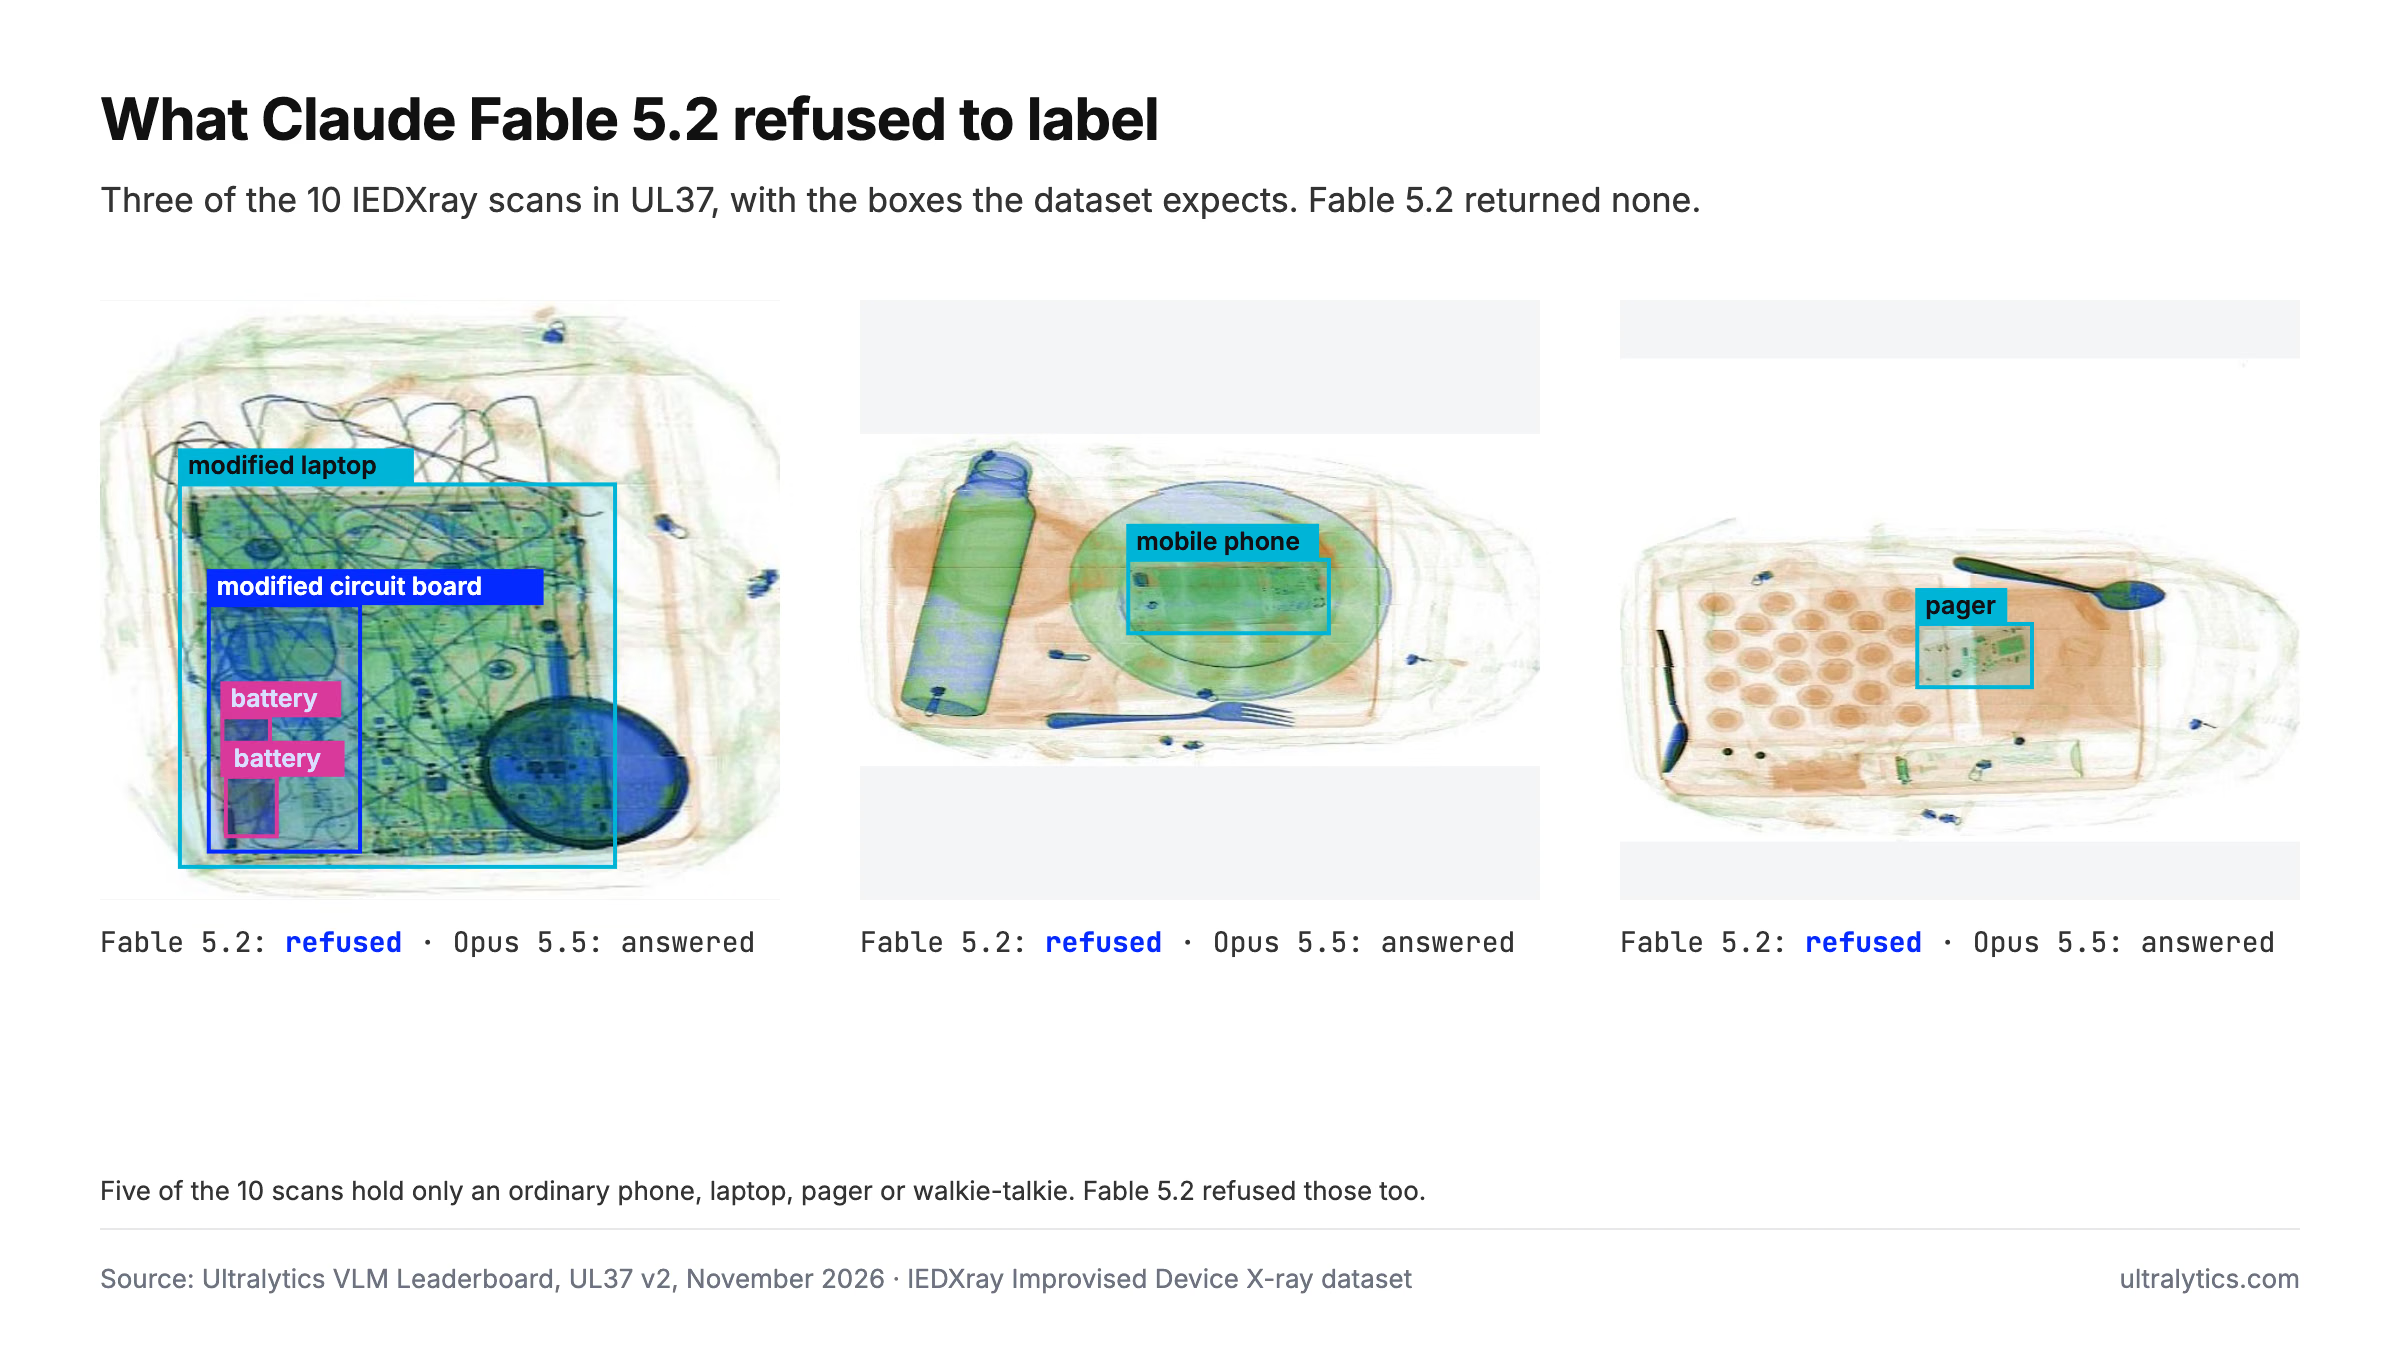
Tre delle 10 scansioni IEDXray con i riquadri attesi. Claude Fable 5.2 le ha rifiutate tutte e tre; Claude Opus 5.5 ha risposto per tutte e dieci le scansioni nella stessa esecuzione.
Il blocco non dipende dal contenuto dell'immagine. Il cellulare al centro è solo un cellulare. Cinque delle dieci scansioni non contengono alcun dispositivo modificato né esplosivo, e Fable 5.2 le ha rifiutate tutte. Il filtro sembra reagire al compito in sé: un dataset di sicurezza il cui elenco di classi menziona gli esplosivi.
Fable 5.2 rifiuta più richieste di Fable 5.1, non meno#
L'annuncio del lancio di Anthropic afferma che le misure di sicurezza di Fable 5.2 per la cybersicurezza e la biologia «producono meno blocchi non necessari» rispetto a quelle di Fable 5.1, circa il 55% in meno nei test iniziali. Sulle radiografie di sicurezza abbiamo osservato il contrario: Fable 5.1 ha rifiutato una scansione su dieci e Fable 5.2 le ha rifiutate tutte e dieci.
Anthropic afferma inoltre che Fable 5.2 e Claude Mythos 5.2 sono lo stesso modello sottostante. Mythos 5.2 viene distribuito senza alcune misure di sicurezza per la cybersicurezza e la biologia e solo alle organizzazioni verificate da Anthropic. In altre parole, le misure di sicurezza sono un livello deciso dal fornitore, separato dalla capacità del modello di vedere. Fable 5.1 ha risposto a nove delle stesse scansioni e ha ottenuto 0.15.
Per un team che sviluppa un rilevatore per lo screening dei bagagli, il risultato pratico è semplice. Il modello Claude più costoso non aiuterà a etichettare i dati e le policy sono cambiate da una versione all'altra.
Tutti i modelli open-weights hanno etichettato le scansioni rifiutate da Fable#
Tra tutti i 44 modelli della nostra classifica, solo due si sono mai rifiutati di analizzare una scansione IEDXray, ed entrambi sono Claude Fable: 5.1 ne ha rifiutata una, 5.2 dieci. Nessun altro modello ne ha rifiutata una, che provenisse da OpenAI, Google, xAI, Meta, un laboratorio cinese o dalle linee Opus, Sonnet e Haiku di Anthropic.
Questo include tutti i 19 modelli che ospitiamo sui server di Platform, modelli open-weights come Qwen3.8 27B, Gemma 4 26B, Nemotron 3 Nano Omni, SAM 3.1 Text e Moondream 3.1. Nessuno di loro ha rifiutato una sola scansione. Moondream 3.1, un modello open-weights che non richiede una chiave API su Platform, ha ottenuto 0.27 mAP50 su IEDXray, secondo solo a Gemini 4 Argon con 0.30 e davanti a ogni modello Claude.
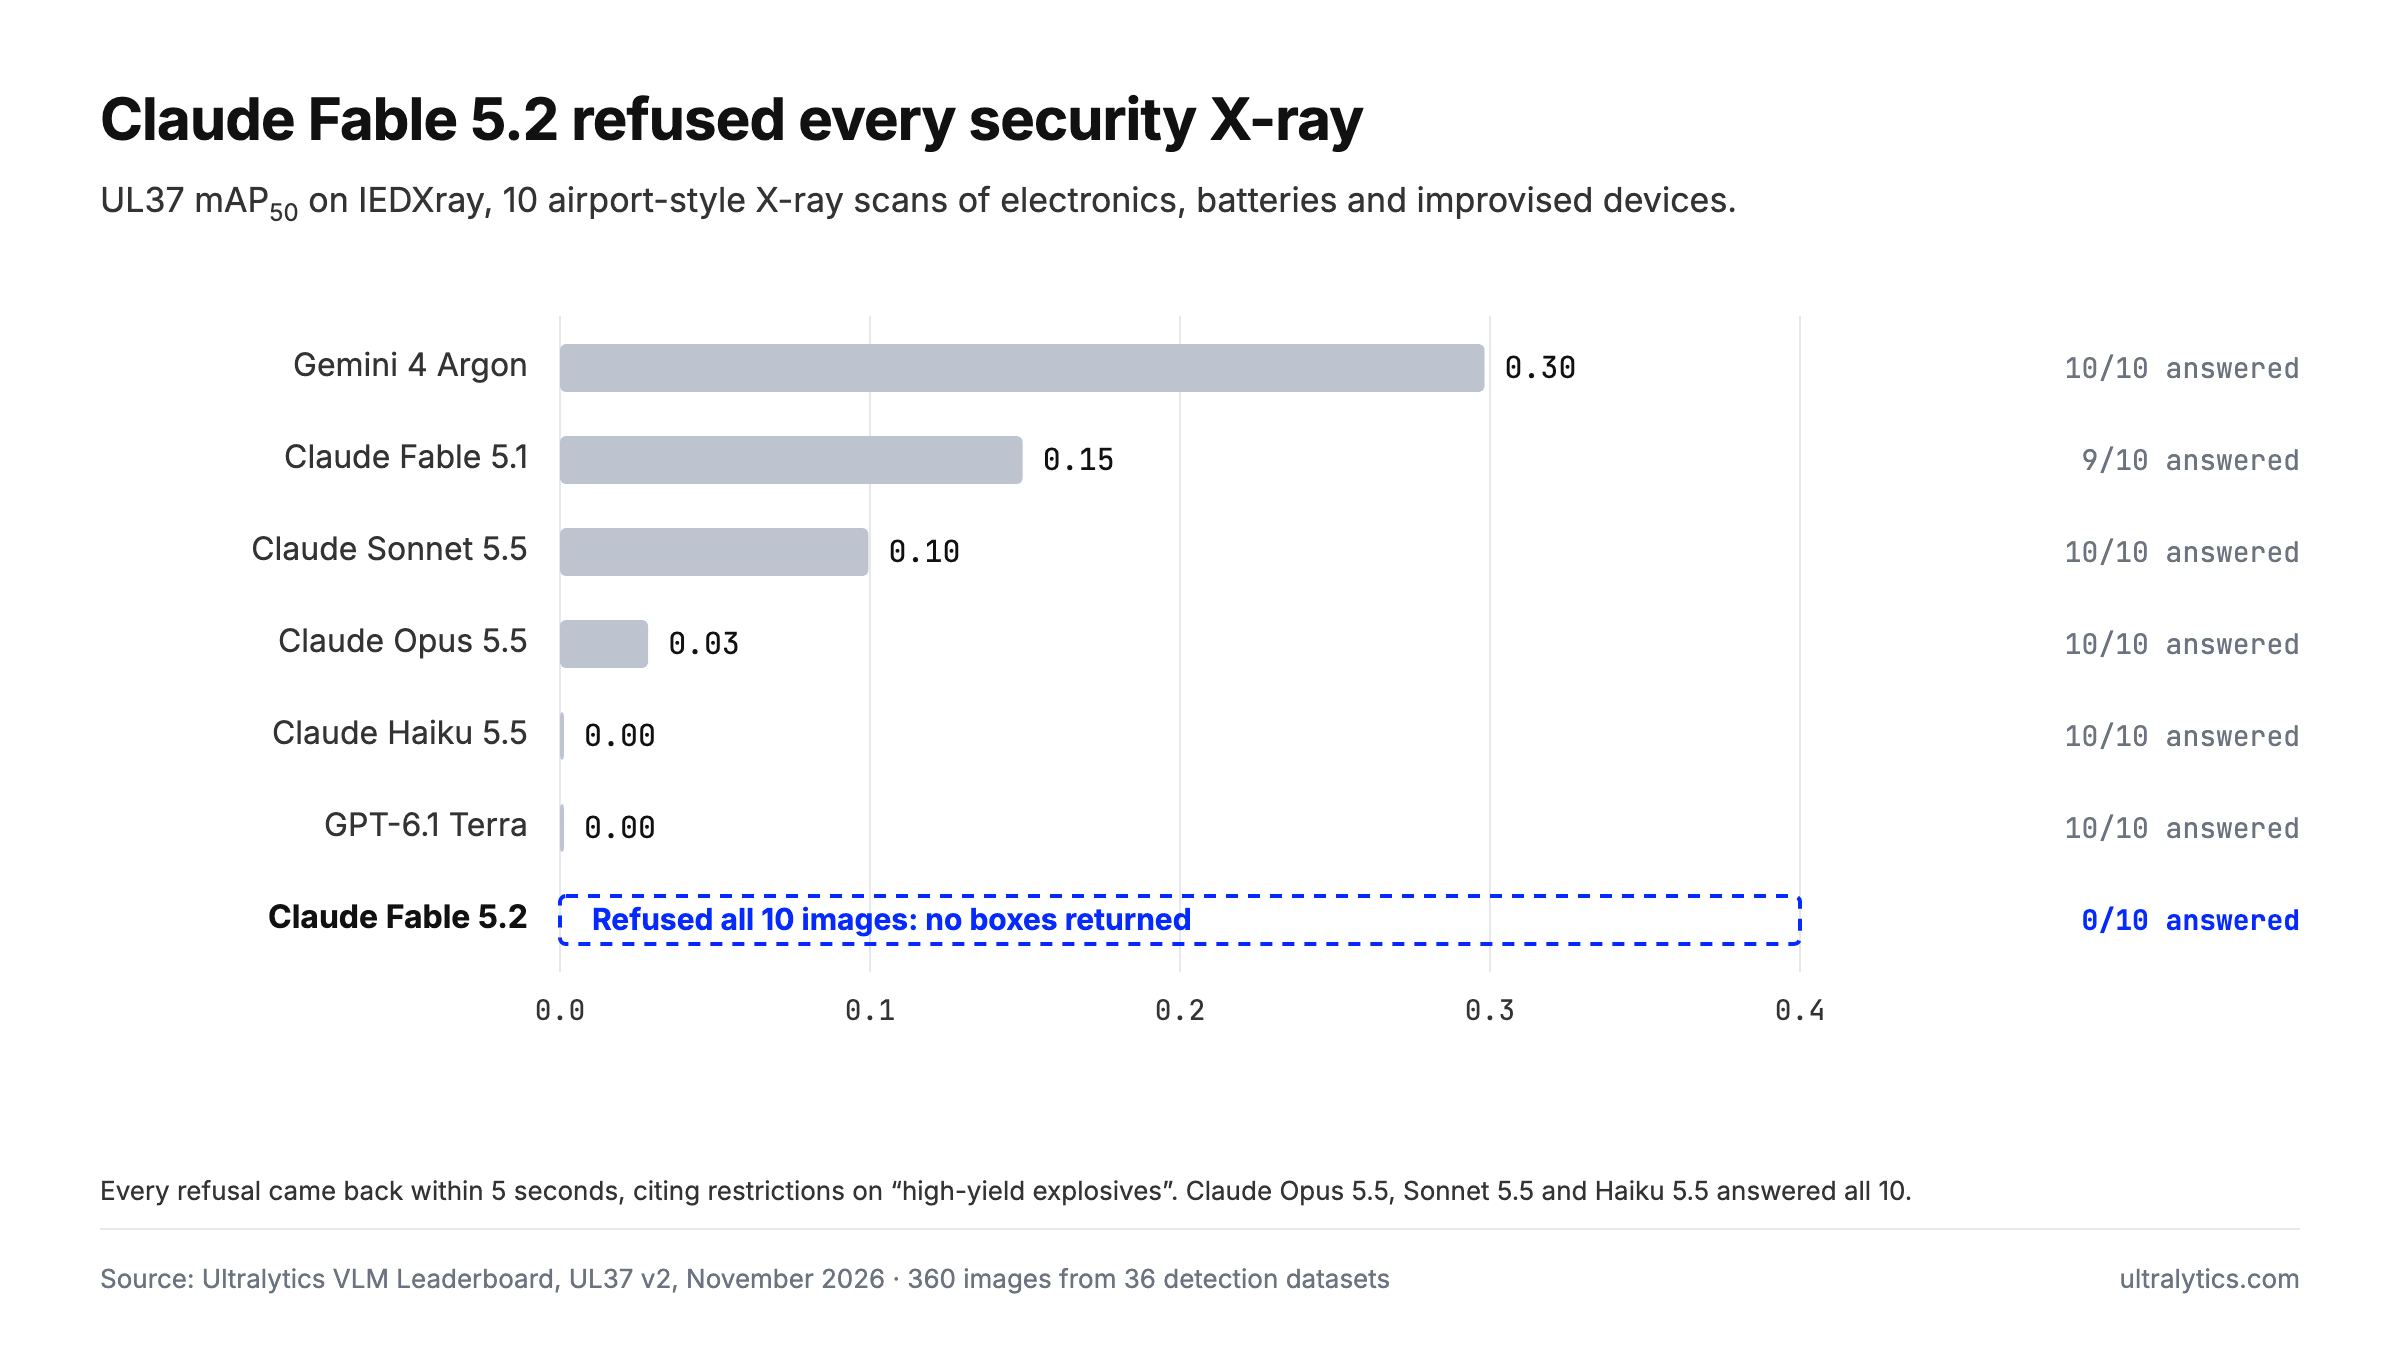
mAP50 su IEDXray per la gamma Anthropic e i due leader della classifica, UL37 v2, intensità di ragionamento predefinita. Fable 5.2 non ha risposto a nessuna delle 10 scansioni.
Di solito i modelli cinesi fanno notizia per ciò che non vogliono dire. Qui la situazione si è capovolta: un importante laboratorio americano ha censurato i risultati, mentre tutti i modelli cinesi che abbiamo testato hanno risposto senza esitazioni. Qwen di Alibaba, Kimi di Moonshot, DeepSeek, GLM di Zhipu, MiMo di Xiaomi, MiniMax e HY4 di Tencent non hanno rifiutato nessuna delle dieci scansioni, e i modelli Qwen open-weights che ospitiamo hanno risposto a tutte. Il modello di punta di Anthropic, a 8 $ per milione di token di input, ha rifiutato di esaminarle.
Le radiografie di sicurezza sono difficili per ogni modello. La maggior parte ottiene meno di 0.15 su IEDXray, quindi i riquadri prodotti da qualsiasi modello sono solo una prima bozza. Ma una bozza può essere corretta nell'editor di annotazione. Un rifiuto ti lascia il compito di disegnare ogni riquadro a mano. I pesi aperti significano anche che il modello convalidato oggi si comporterà allo stesso modo domani, perché nessuna policy del fornitore si frappone tra te e il suo output. Una volta etichettati i dati, addestrare il tuo rilevatore Ultralytics YOLO26 ti dà anche il pieno controllo sul modello distribuito.
Al di fuori delle radiografie di sicurezza, Claude Fable 5.2 è il secondo miglior annotatore che abbiamo testato#
Ogni immagine UL37 passa attraverso la stessa pipeline di produzione a disposizione degli utenti di Platform, con i nomi delle classi del dataset, e SAM 3.1 rifinisce poi ogni riquadro. La metodologia è pubblica. Ecco i risultati di Fable 5.2:
- mAP50: 0.544, secondo su 44
- mAP50-95: 0.347, primo su 44, appena sopra lo 0.345 di GPT-6.1 Terra
- Precisione e richiamo: 0.602 e 0.620
- Costo del fornitore: 37,55 $ ogni 1.000 immagini
- Tempo mediano per immagine: 4,6 s
- Richieste non riuscite: 11 su 360: i 10 rifiuti più una richiesta che ha superato il limite di 115 secondi di Platform
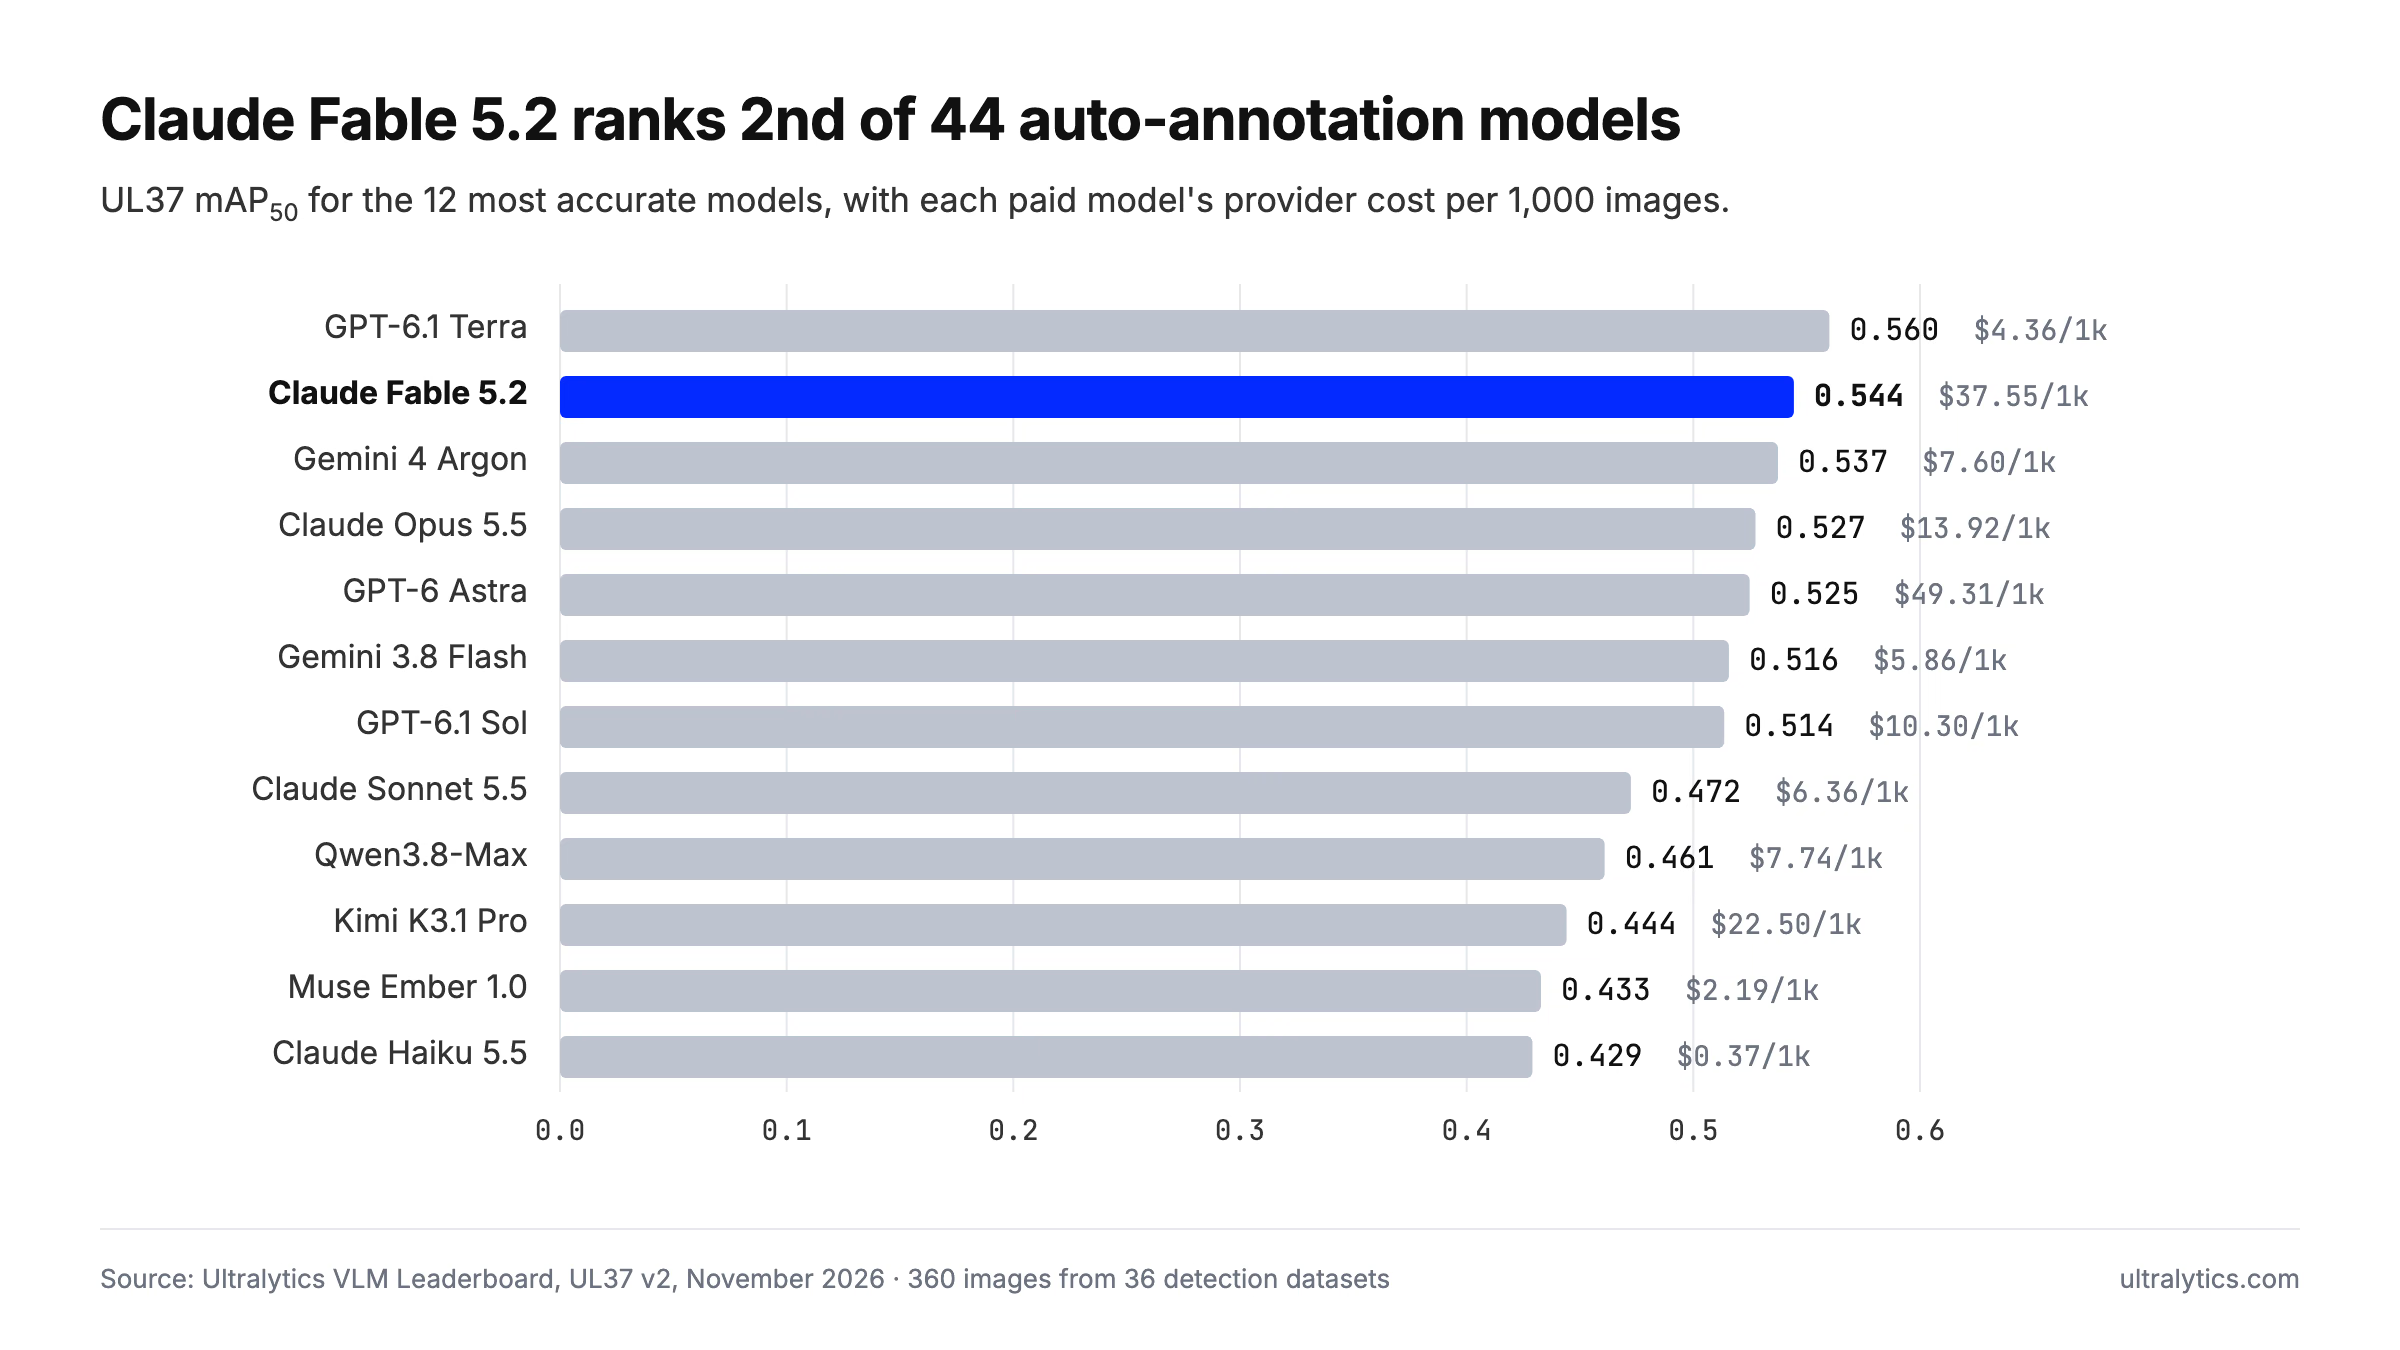
mAP50 UL37 dei 12 modelli più accurati su 44, con costo del fornitore ogni 1.000 immagini, 10 novembre 2026.
Il primo posto nel mAP50-95 è significativo. Questo punteggio più rigoroso calcola la media delle soglie di sovrapposizione dei riquadri dal 50% al 95%, quindi premia i riquadri che aderiscono a ogni oggetto anziché limitarsi a coprirlo approssimativamente. I riquadri grezzi di Fable 5.2 ottengono già 0.538 mAP50 prima del perfezionamento con SAM 3.1, che li porta a 0.544.
Si piazza tra i primi cinque su 22 dei 36 dataset e si classifica nettamente primo in tre: vassoi dei pasti scolastici UEC (0.96), rilevamento di palloni da basket e canestri (0.85) e malattie fogliari PlantDoc (0.52). Per settore, è primo nel commercio al dettaglio e, per un soffio davanti a Claude Opus 5.5, in natura e agricoltura. Sulle 10 immagini di riferimento COCO 2017, valutate separatamente, raggiunge 0.686, il miglior risultato di qualsiasi modello linguistico, superato solo dai modelli di segmentazione SAM 3 e SAM 3.1 Text.
I rifiuti sono costati a Fable 5.2 uno zero pieno su un dataset, ma non il primo posto. Escludendo IEDXray, Fable 5.2 ha una media di 0.560, mentre Terra, che ha ottenuto zero senza però rifiutarsi, ha una media di 0.576.
Un enorme passo avanti rispetto a Claude Fable 5.1#
Fable 5.2 supera Claude Fable 5.1 su 31 dataset su 36 e costa meno per immagine.
| Risultato UL37 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| Precisione / richiamo | 0.602 / 0.620 | 0.506 / 0.485 |
| Posizione in classifica | Secondo su 44 | 13° su 44 |
| Costo del provider per 1.000 immagini | $37.55 | $43.75 |
| Tempo mediano per immagine | 4.6 s | 2,6 s |
| Immagini IEDXray rifiutate | 10 | 1 |
La precisione e il richiamo sono aumentati insieme, il che significa sia meno riquadri falsi da eliminare sia meno oggetti mancati da disegnare. I miglioramenti maggiori sono notevoli. Sulle teste di grano GWHD, Fable 5.1 ha ottenuto 0.24 e Fable 5.2 ottiene 0.77. I prodotti RPC retail checkout sono passati da 0.57 a 0.90, le immagini termiche di droni HIT-UAV da 0.17 a 0.48 e le ecografie tiroidee TN5000 da 0.03 a 0.44.
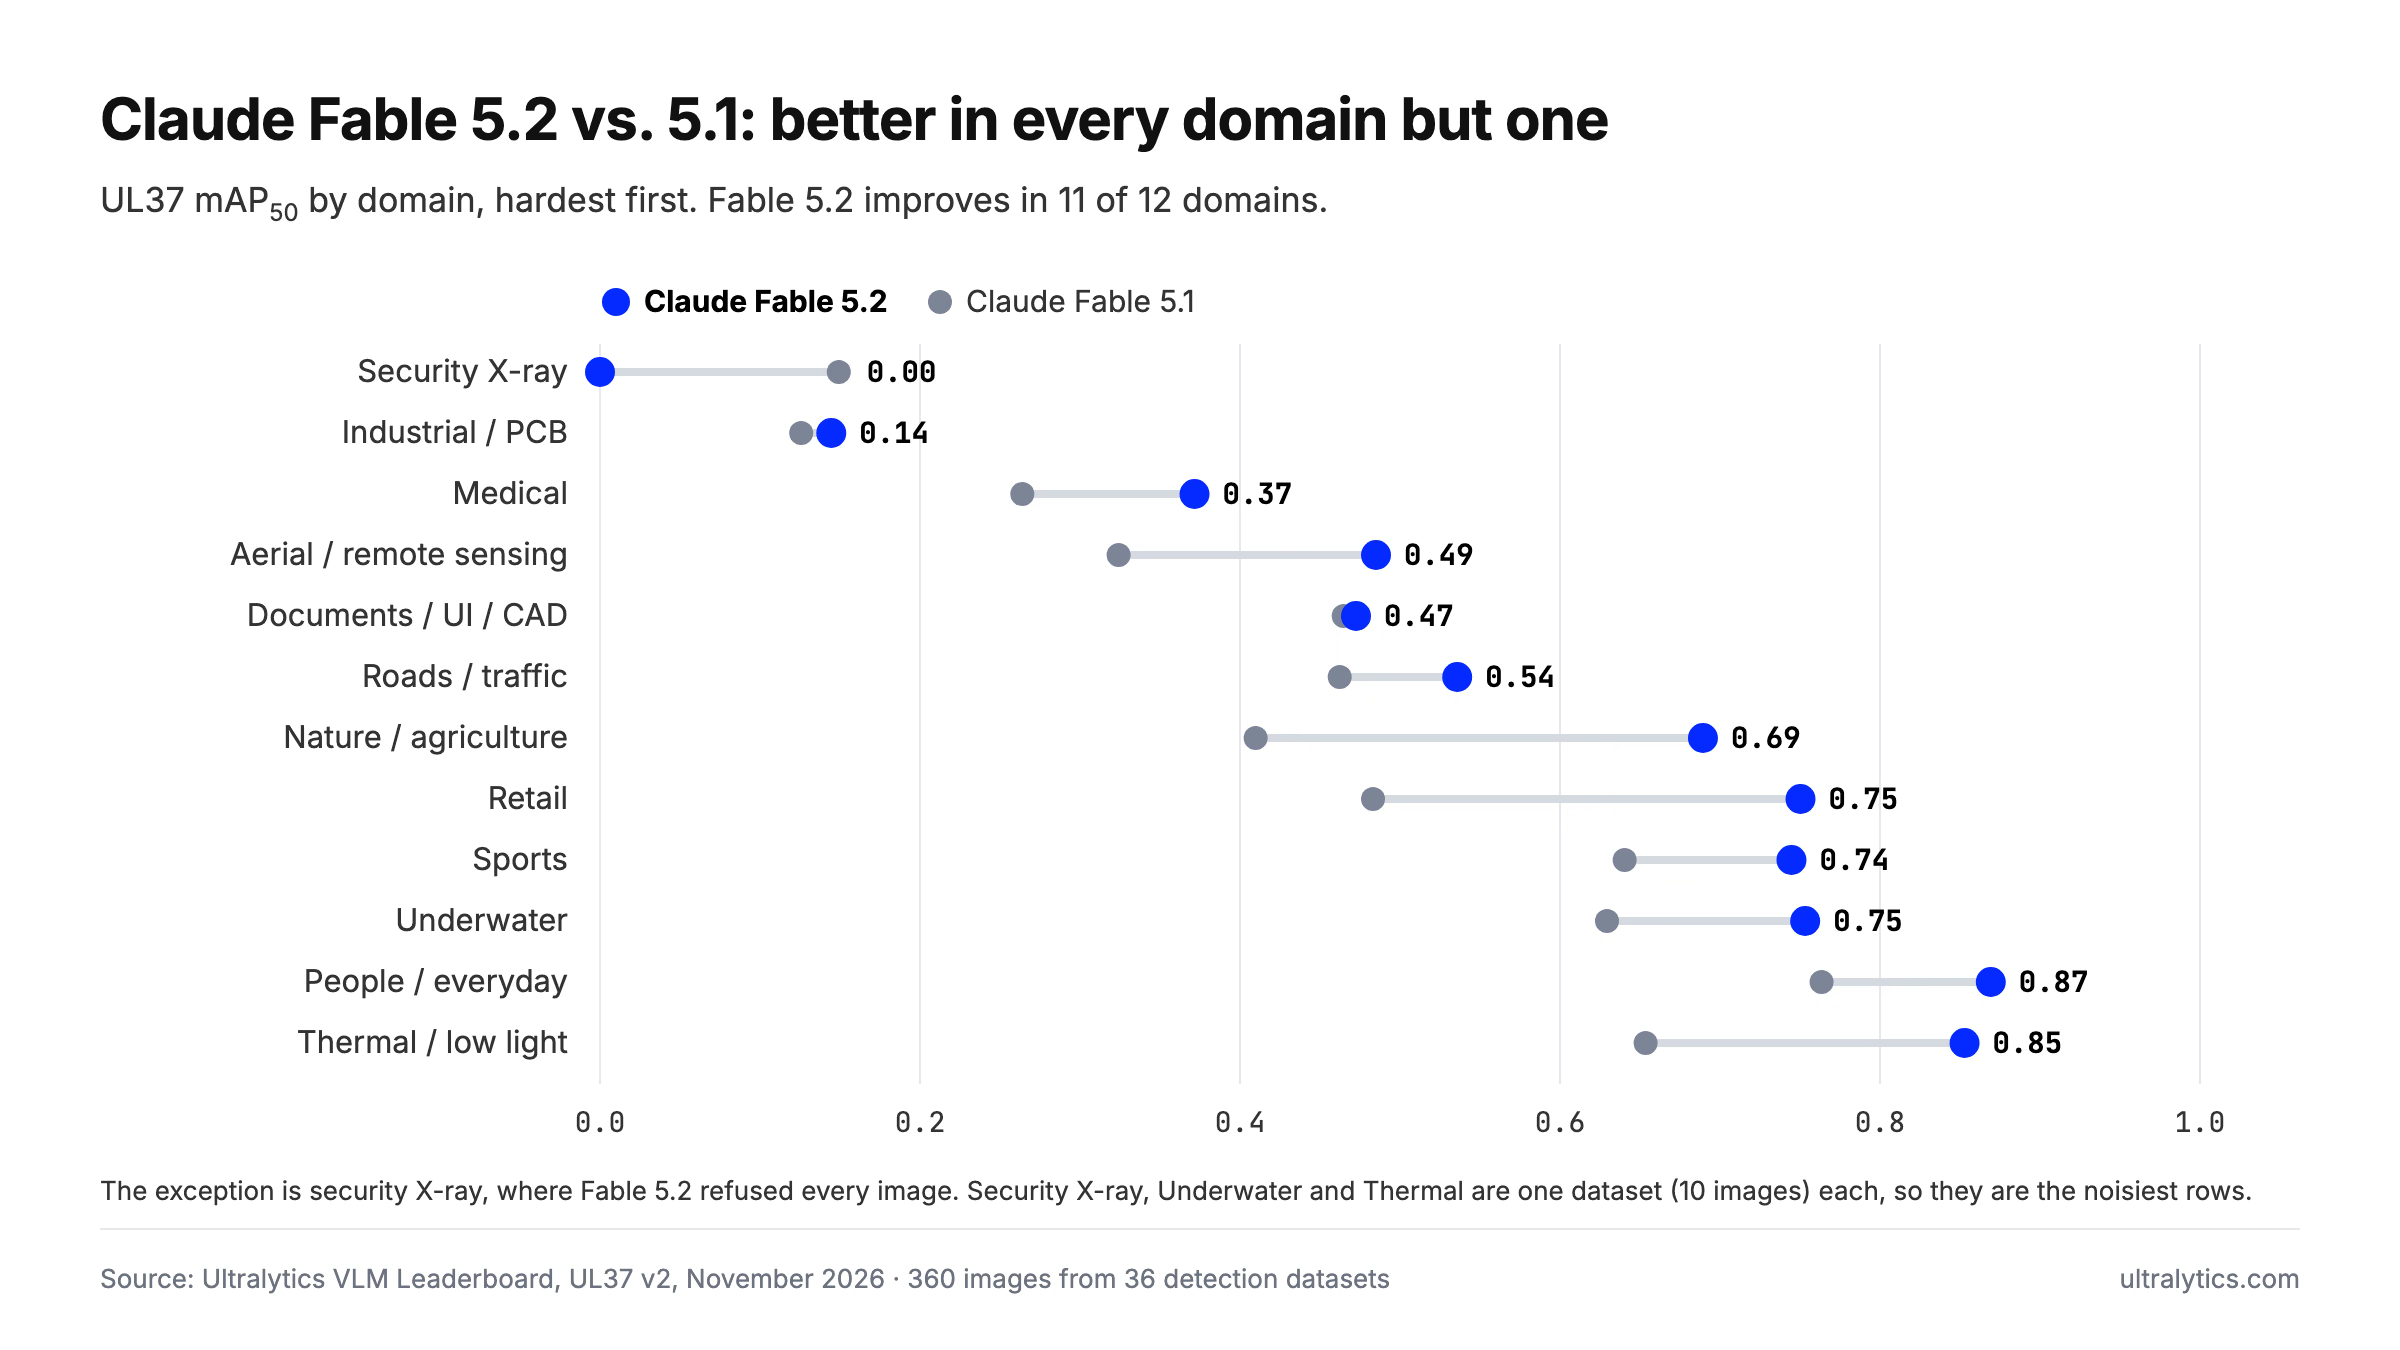
mAP50 UL37 per settore, dal più difficile al meno difficile, Claude Fable 5.2 rispetto a Claude Fable 5.1 con l'intensità predefinita di Anthropic.
Undici settori su dodici sono migliorati. L'unico peggioramento è quello delle radiografie di sicurezza, da 0.15 a zero, dovuto al rifiuto e non alla capacità visiva del modello. Sono peggiorati anche i segnali stradali CeyMo, da 0.85 a 0.74.
Claude Fable 5.2 contro GPT-6.1 Terra, Gemini 4 Argon e Claude Opus 5.5#
| Modello | mAP50 su UL37 | mAP50-95 | Precisione | Richiamo | Costo per 1.000 immagini | Tempo mediano per immagine |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2,7 s |
Nel confronto diretto, Fable 5.2 supera Terra su 18 dataset e perde su 16, con due pareggi. Supera Argon per 21 a 15 e Opus 5.5 per 22 a 14. Ha il richiamo più alto dei quattro, quindi manca il minor numero di oggetti, ma la sua precisione è la più bassa, perciò aspettati qualche riquadro in più da eliminare. La nostra guida a scegliere un VLM in base a precisione e richiamo spiega come valutare questo compromesso in base ai tuoi dati.
Oltre alle radiografie, Fable 5.2 è meno efficace nell'imaging medico, dove ha una media di 0.372 su otto dataset contro 0.505 di Terra, e sulle schede elettroniche, dove ottiene 0.00 su DeepPCB. Ogni dataset contiene solo 10 immagini, quindi considera i punteggi dei singoli dataset come indicazioni, non come verdetti.
Anthropic stessa consiglia di iniziare la maggior parte dei lavori con Claude Opus 5.5, il suo «strumento più potente per l'uso quotidiano», e passare a Fable solo quando un'attività lo richiede. Per l'annotazione, il consiglio vale. Opus 5.5 raggiunge il 97% del mAP50 di Fable 5.2 al 37% del costo, risponde in 2,7 s e non ha rifiutato nessuna radiografia.
Quanto costa un lotto di Claude Fable 5.2#
I 37,55 $ ogni 1.000 immagini sono il costo del fornitore, calcolato in base all'utilizzo di token dichiarato da Anthropic, ai prezzi di listino di 8 $ per milione di token di input e 40 $ per milione di token di output, secondo la pagina dei prezzi di Anthropic. Fable 5.2 opera con l'intensità di ragionamento elevata predefinita di Anthropic. Batch Annotation aggiunge una commissione di elaborazione di Platform pari a 1,00 $ ogni 1.000 immagini, quindi un'esecuzione su 1.000 immagini costa circa 38,55 $.
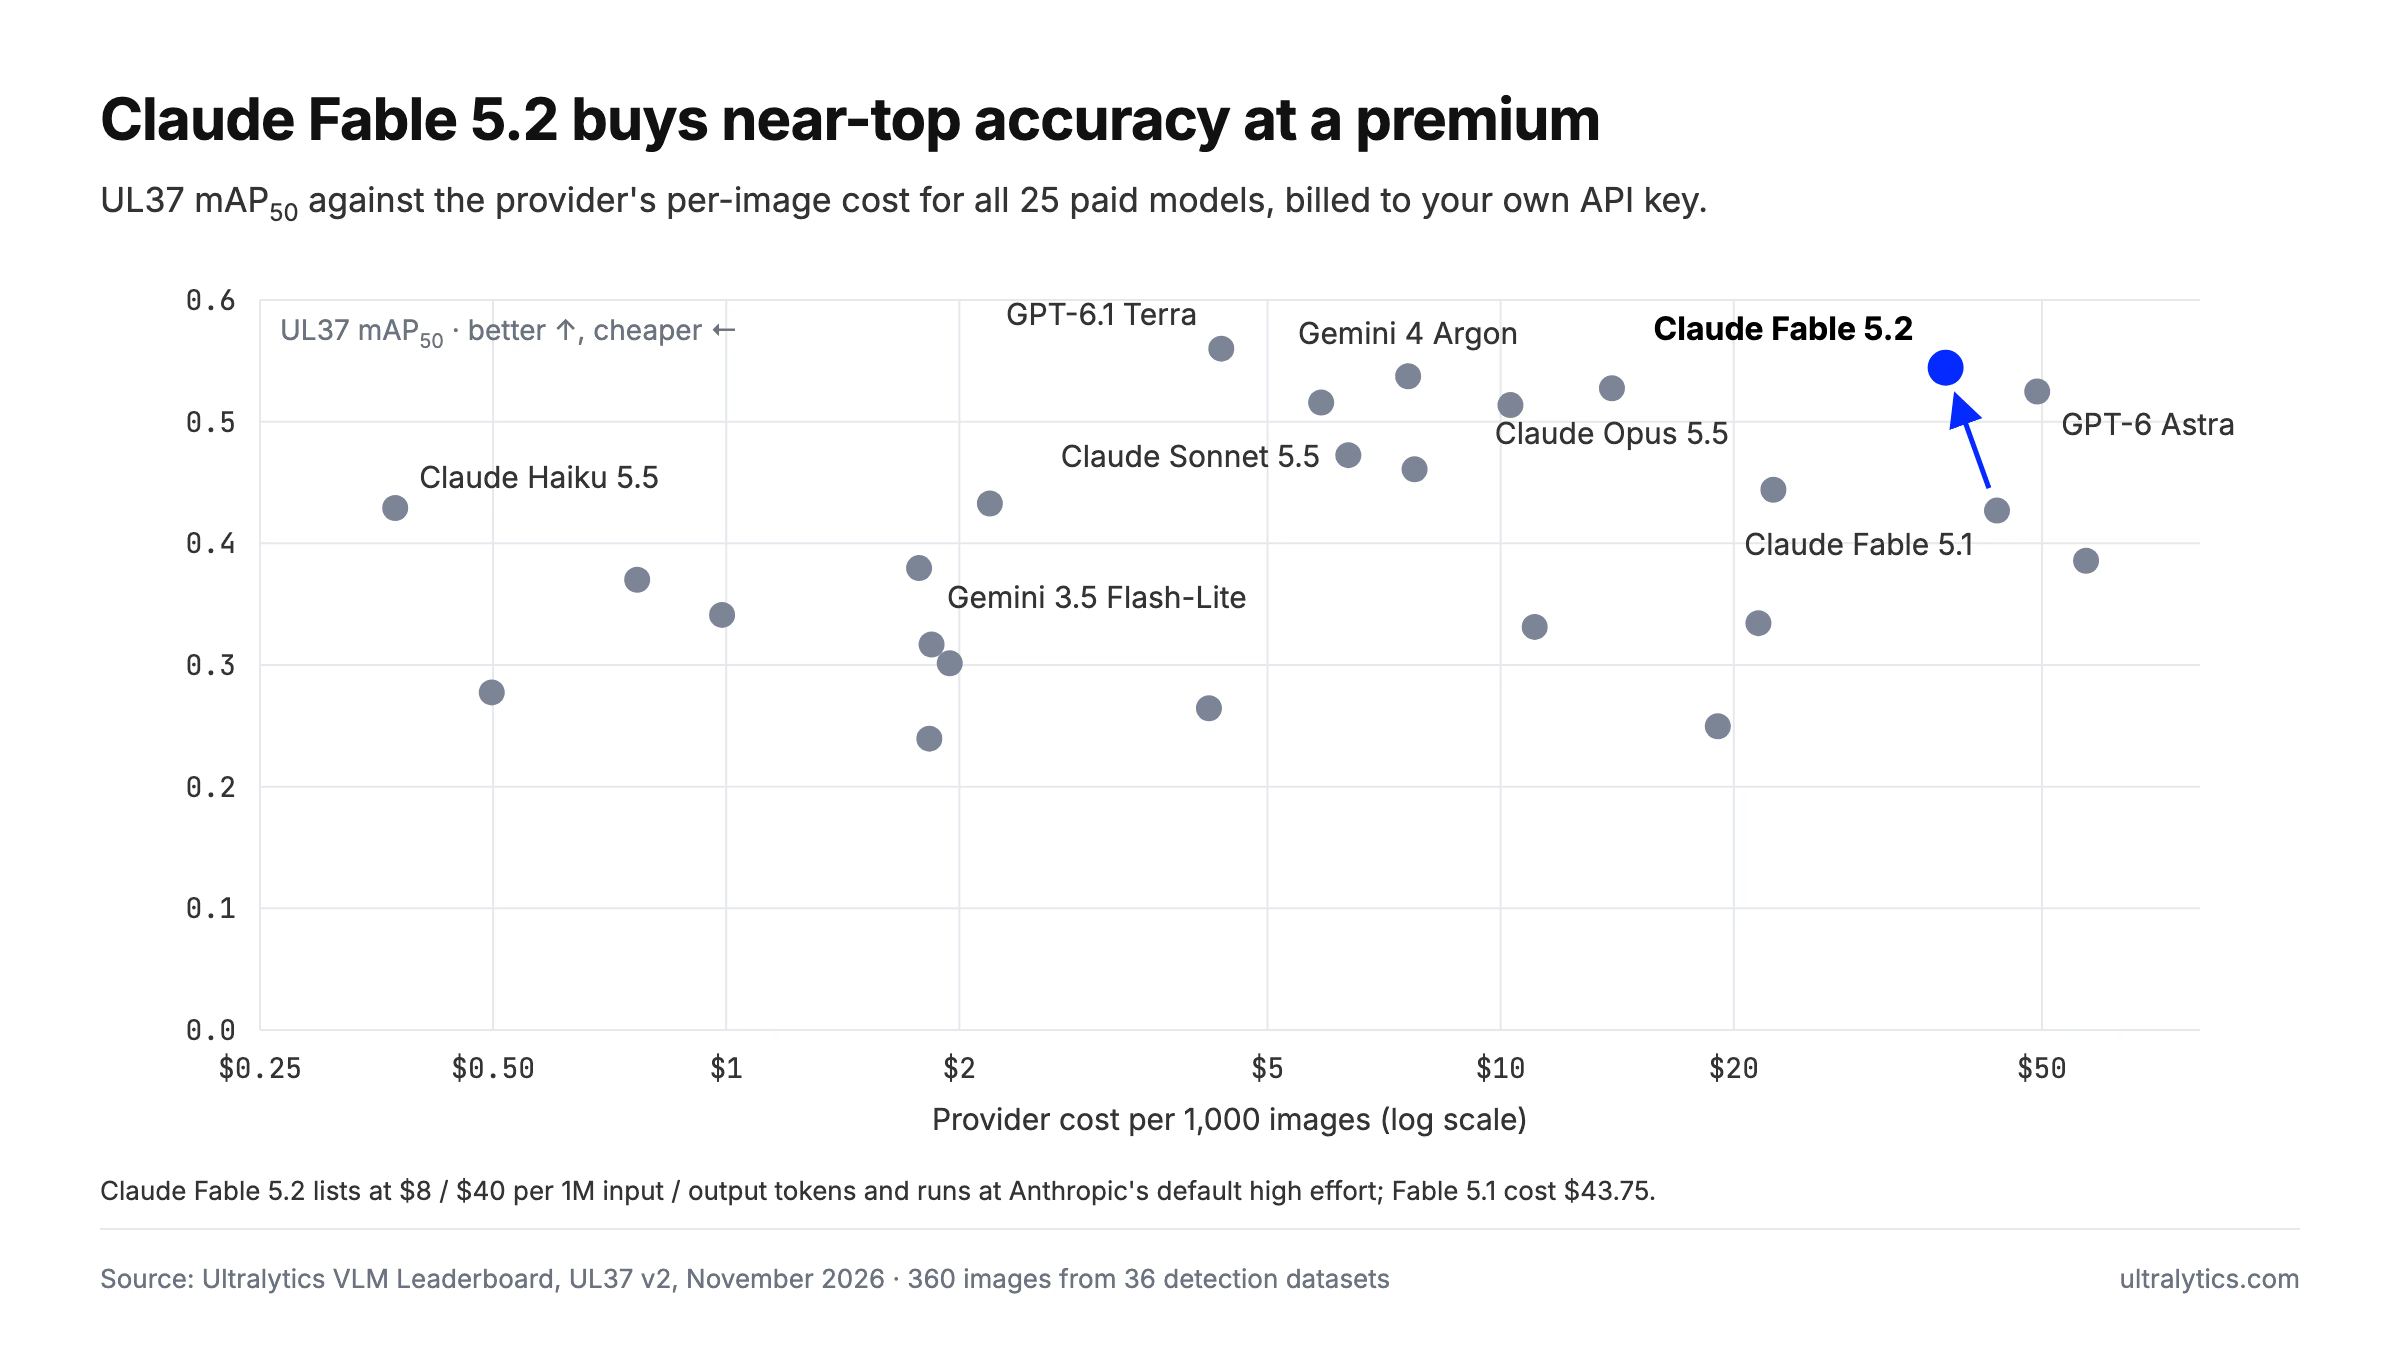
mAP50 UL37 rispetto al costo del fornitore ogni 1.000 immagini per tutti i 25 modelli a pagamento, prezzi di listino, 10 novembre 2026.
È oltre otto volte il costo di Terra, pari a 4,36 $, per un mAP50 inferiore di 0.016. Fable 5.2 vale il suo prezzo solo quando la precisione dei riquadri conta più del budget. Se il costo è importante, Claude Haiku 5.5 ottiene 0.429 a 0,37 $ e i modelli open-weights ospitati non richiedono alcuna chiave API.
Come eseguire l'annotazione automatica con Claude Fable 5.2 sul tuo dataset#
Fable 5.2 è un modello guidato dalle classi per dataset di rilevamento con da 1 a 200 classi. Restituisce i riquadri per i nomi delle classi del tuo dataset, che puoi esaminare prima di salvarli.
- Crea una chiave nella pagina delle chiavi API di Claude.
- Aggiungila in Impostazioni > Chiavi API nell'area di lavoro di Platform che contiene il tuo dataset. Anthropic ti addebita direttamente i costi e Ultralytics non applica alcun sovrapprezzo ai token. La documentazione sulle chiavi del fornitore illustra i dettagli.
- Nell'editor di annotazione, passa alla modalità Smart e scegli Claude Fable 5.2 sotto Anthropic. Premi Predict o
Pper etichettare l'immagine corrente. - Per etichettare tutte le immagini non ancora etichettate, scegli Altre azioni > Batch Annotation nella pagina del dataset. Platform salva prima una versione del dataset, così puoi ripristinarla.
- Se alcune immagini vengono rifiutate, esegui di nuovo Batch Annotation con un altro modello, come Gemini 4 Argon o un modello open-weights ospitato. Verranno etichettate solo le immagini ancora prive di etichette.
- Esamina i riquadri, salvali e addestra un modello YOLO26 sul risultato nella stessa area di lavoro.
Prima di impegnarti su un dataset di grandi dimensioni, apri la pagina del modello. Questa riproduce i riquadri registrati di Fable 5.2 su ogni dataset di benchmark, affiancandoli a quelli attesi, e mostra il punteggio ottenuto su ciascuno.
Pagina del modello Claude Fable 5.2
Per scoprire come questi modelli si integrano nell'editor, consulta come Ultralytics Platform usa l'IA per automatizzare l'annotazione e perché la revisione con intervento umano rimane essenziale.
Chi dovrebbe usare Claude Fable 5.2#
Scegli Claude Fable 5.2 quando la precisione dei riquadri conta più di tutto e il budget meno: sport, commercio al dettaglio, agricoltura e scene quotidiane, ambiti in cui è ai vertici o quasi rispetto a ogni modello che abbiamo testato. Il vantaggio nel mAP50-95 lo rende un'ottima prima bozza per i dataset su cui intendi addestrare con soglie IoU rigorose.
Evitalo per i dati relativi a sicurezza, difesa e screening. Il filtro di Anthropic ha rifiutato tutte le scansioni del nostro dataset di radiografie di sicurezza, anche quelle con solo un telefono, e Platform non offre alcun modo per aggirare il blocco. Per questi progetti, usa Gemini 4 Argon o un modello open-weights che controlli tu. Per la maggior parte degli altri lavori di etichettatura, GPT-6.1 Terra o Claude Opus 5.5 offre riquadri quasi identici a una frazione del prezzo.
Domande frequenti
L'API di Anthropic blocca le richieste di annotazione di radiografie di sicurezza che coinvolgono classi di esplosivi. Per tutte e 10 le scansioni IEDXray del nostro benchmark, ha restituito il motivo di interruzione
refusalcon la categoriageneral_harms, citando «restrizioni sui contenuti relativi allo sviluppo di esplosivi ad alto potenziale», anche per scansioni che contengono solo un normale telefono o laptop. Premere di nuovo Predict non serve: usa un altro modello per quelle immagini.Nessun altro modello della nostra classifica ha rifiutato una scansione IEDXray: questo vale per tutti i 19 modelli che ospitiamo, ogni modello di un laboratorio cinese e gli stessi Claude Opus 5.5, Sonnet 5.5 e Haiku 5.5 di Anthropic. Gemini 4 Argon ha ottenuto il punteggio più alto, 0.30 mAP50, seguito dal modello open-weights Moondream 3.1 con 0.27. La precisione sulle radiografie di sicurezza è bassa per tutti i modelli, quindi controlla ogni riquadro.
Sì. Ottiene 0.544 mAP50 su 36 veri dataset di rilevamento, secondo su 44 modelli, e si classifica primo nel più rigoroso mAP50-95 con 0.347. È più efficace nel commercio al dettaglio, negli sport, in agricoltura e nelle scene quotidiane, e meno efficace con le radiografie di sicurezza, l'imaging medico e i difetti delle schede elettroniche.
Ottiene 0.544 mAP50 rispetto allo 0.427 di Fable 5.1 e vince su 31 dataset su 36, costando 37,55 $ ogni 1.000 immagini invece di 43,75 $. È più lento, con 4,6 s per immagine contro 2,6 s, e ha rifiutato tutte e 10 le radiografie di sicurezza, mentre Fable 5.1 ne ha rifiutata una.
Circa 37,55 $ di costi Anthropic, in base all'utilizzo di token dichiarato dal fornitore, a 8 $ per milione di token di input e 40 $ per milione di token di output. Batch Annotation su Ultralytics Platform aggiunge una commissione di elaborazione di 1,00 $ ogni 1.000 immagini. Paghi direttamente Anthropic con la tua chiave API.
Terra ottiene un mAP50 più alto, 0.560 contro 0.544, e costa circa un ottavo. Fable 5.2 produce riquadri leggermente più precisi, con 0.347 mAP50-95 contro lo 0.345 di Terra, e vince su 18 dataset contro i 16 di Terra. Per la maggior parte dei team, Terra è la scelta predefinita migliore; Fable 5.2 è indicato quando la precisione dei riquadri conta più del costo.
Scritto da
Fondatore e CEO · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









