Orientamento EXIF in Ultralytics YOLO: perché le foto ruotate compromettono i dataset
I valori di orientamento EXIF da 5 a 8 scambiano larghezza e altezza di un'immagine. Scopri come un tag ignorato disallinea le etichette e come ora Ultralytics legge correttamente le immagini con tag.
 Sergiu Waxmann15 min di lettura
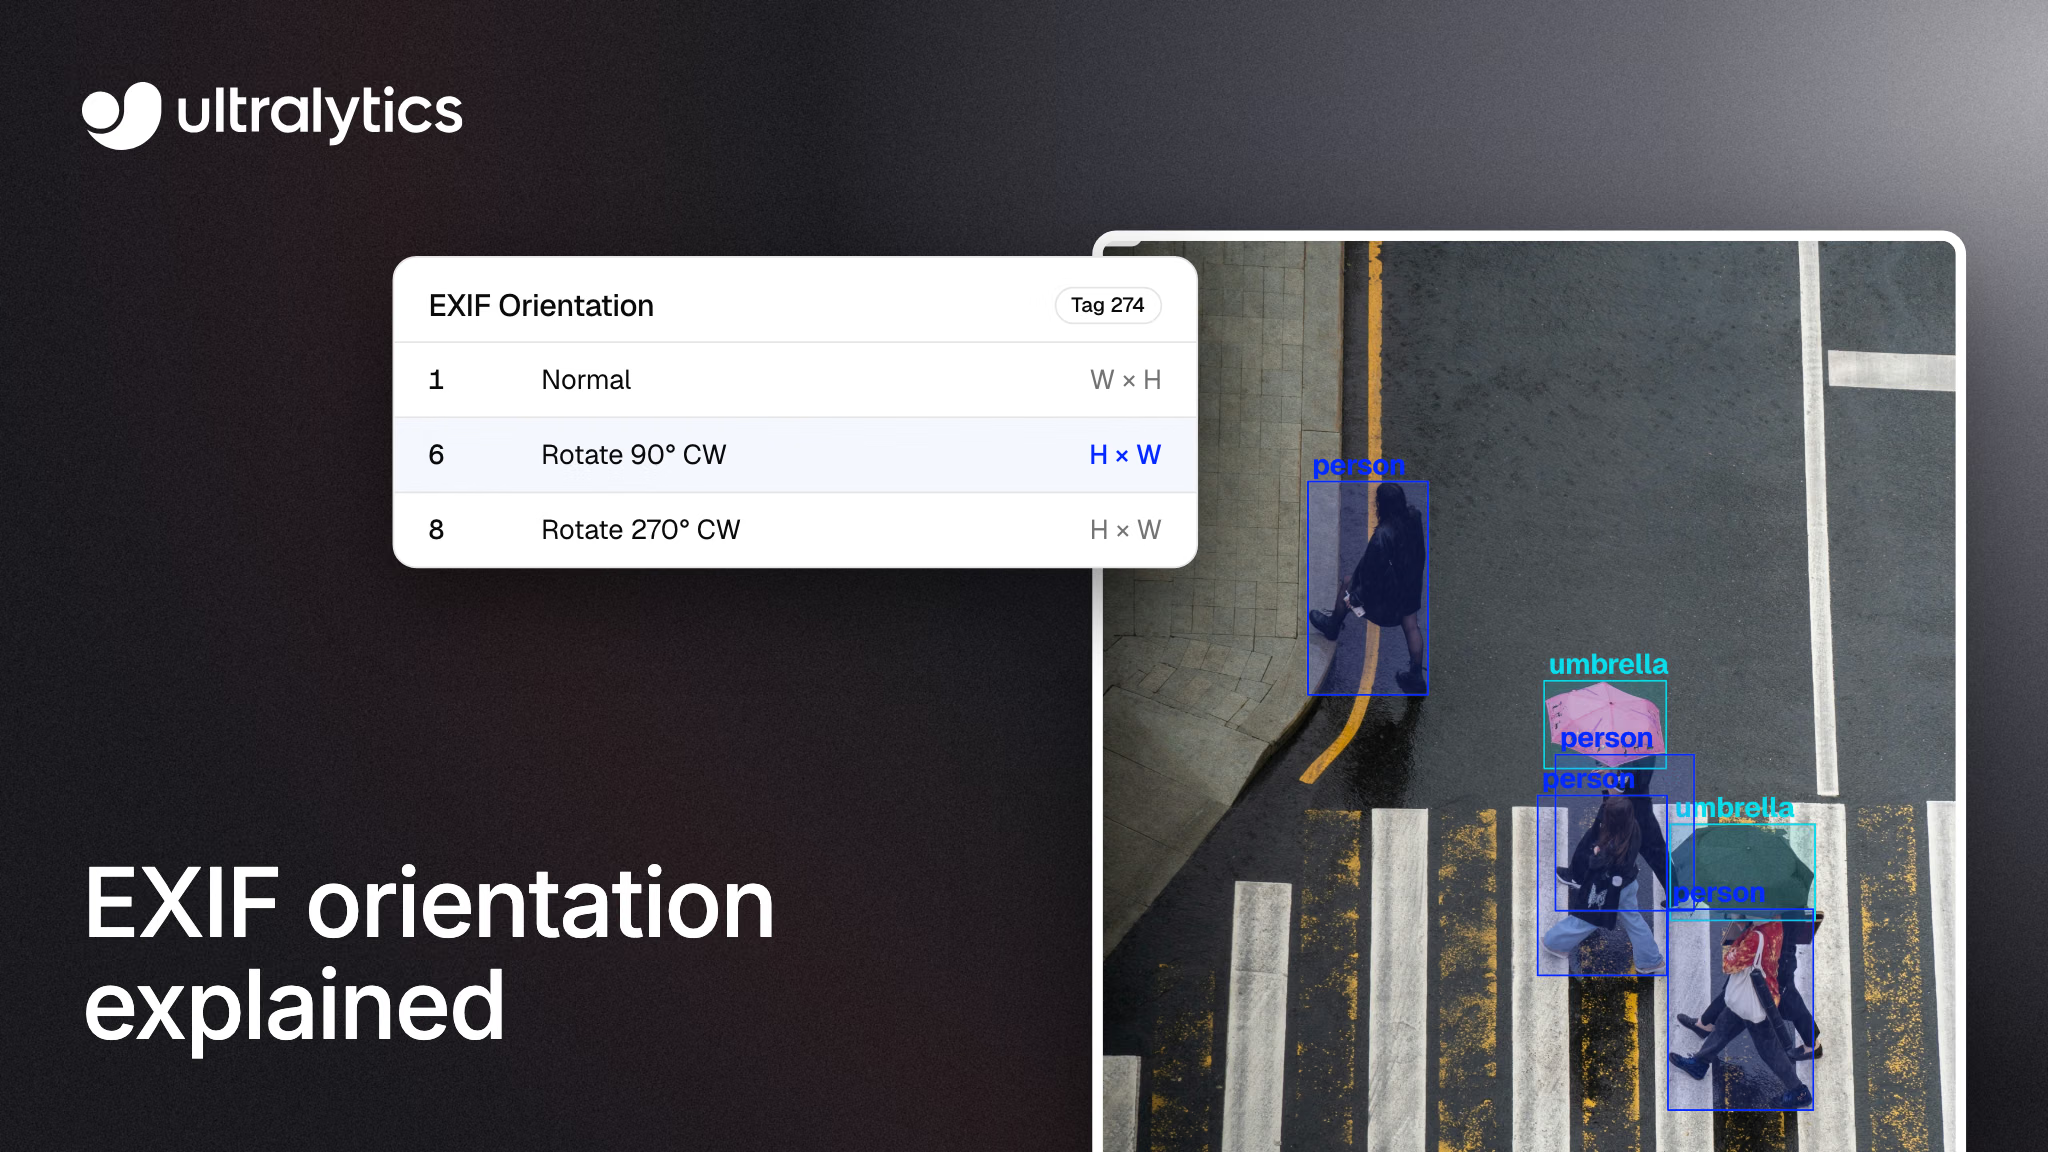
Una foto appare correttamente orientata nella galleria, nel browser e nello strumento di annotazione. Poi uno script di training la legge ruotata e i riquadri che hai disegnato possono finire sulla parte sbagliata dell'immagine. Non si verifica alcun arresto anomalo. Il modello impara semplicemente da etichette che non corrispondono più ai pixel.
Etichette e pixel non corrispondono più ogni volta che due strumenti usano riferimenti diversi per lo stesso file, e l'orientamento EXIF è uno dei motivi: un piccolo tag di metadati che indica al software come ruotare un'immagine per visualizzarla, mentre i pixel restano come li ha salvati la fotocamera. Alcuni lettori applicano il tag, altri no. Questa guida spiega il tag, come può compromettere l'annotazione dei dati e il training, e come verificare un dataset. Inoltre, presenta due novità che abbiamo appena rilasciato: Ultralytics 8.4.214 ora applica l'orientamento EXIF in modo coerente quando legge le immagini, e Ultralytics Platform ora può ruotare insieme un'immagine e le relative annotazioni per i file i cui pixel sono semplicemente ruotati.
L'orientamento EXIF è un'istruzione di visualizzazione, non una rotazione#
Una fotocamera può salvare i pixel così come li ha acquisiti il sensore e scrivere un valore Orientation nei metadati EXIF del file (tag 274, o 0x0112), invece di ruotare la griglia di pixel. Un visualizzatore che rispetta il tag ruota l'immagine prima di mostrarla; uno che lo ignora mostra la griglia originale. Altri dispositivi ruotano i dati dei pixel prima di salvarli, quindi la presenza del tag in una determinata foto dipende dal dispositivo e dal software che l'ha elaborata in seguito.
Il tag può avere uno degli otto valori elencati nella guida di riferimento ai tag EXIF di ExifTool:
| Valore | Significato | Larghezza e altezza visualizzate |
|---|---|---|
| 1 | Normale, nessuna modifica | Come memorizzata |
| 2 | Rifletti orizzontalmente | Come memorizzata |
| 3 | Ruota di 180° | Come memorizzata |
| 4 | Rifletti verticalmente | Come memorizzata |
| 5 | Rifletti orizzontalmente e ruota di 270° in senso orario | Invertite |
| 6 | Ruota di 90° in senso orario | Invertite |
| 7 | Rifletti orizzontalmente e ruota di 90° in senso orario | Invertite |
| 8 | Ruota di 270° in senso orario | Invertite |
Per la visione artificiale sono importanti due dettagli. I valori da 5 a 8 scambiano larghezza e altezza visualizzate, quindi un'immagine memorizzata a 4000 x 3000 diventa 3000 x 4000 sullo schermo. Inoltre, i valori 2, 4, 5 e 7 includono un riflesso, perciò un'immagine può sembrare più o meno correttamente orientata, ma avere il testo e la disposizione da sinistra a destra invertiti. Una foto verticale con tag 6 è il classico caso di immagine ruotata.
Perché le foto ruotate compromettono silenziosamente i dataset di visione artificiale#
I riquadri di delimitazione, i poligoni e i keypoint sono memorizzati come coordinate relative a un'immagine e, nel formato Ultralytics YOLO, queste coordinate sono normalizzate rispetto alla larghezza e all'altezza dell'immagine. Hanno significato solo se tutti gli strumenti concordano sul riferimento a cui si riferiscono.
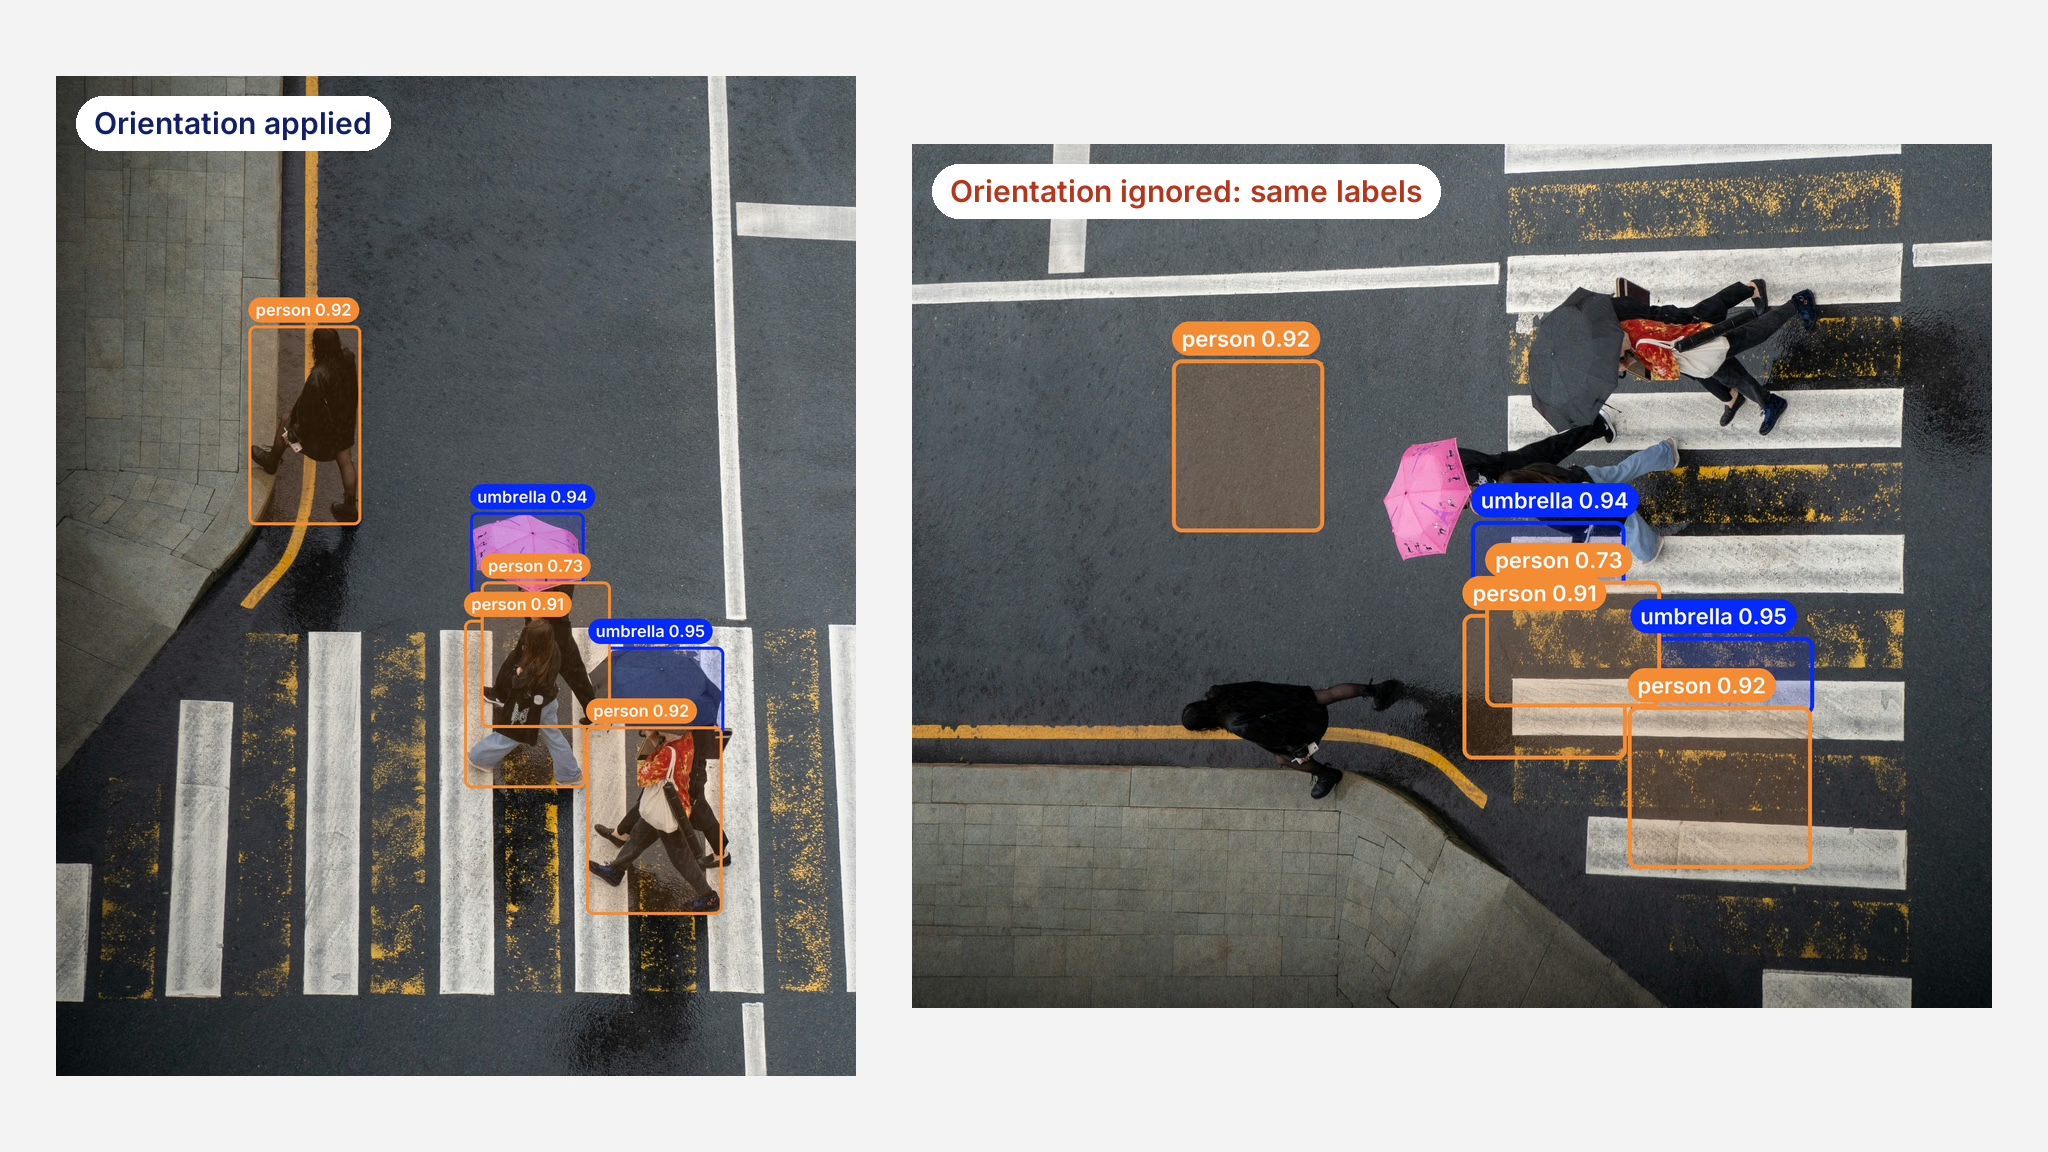
Un JPEG con Orientation 6, letto in due modi. A sinistra: orientamento applicato, con rilevamenti YOLO26x. A destra: orientamento ignorato, con le stesse etichette normalizzate posizionate sui pixel memorizzati.
Ecco come può verificarsi una discrepanza in un dataset con immagini dotate di tag:
- Un annotatore etichetta la vista correttamente orientata. Se il browser o lo strumento di annotazione applica il tag, il riquadro intorno a una persona si trova nel punto in cui la persona appare sullo schermo.
- Un loader di training legge la griglia memorizzata. Se il suo decoder ignora il tag, lo stesso riquadro normalizzato viene posizionato su pixel ruotati di 90 gradi, dove può coprire l'oggetto sbagliato o non coprire nulla.
- Il training viene comunque eseguito. Le coordinate restano comprese tra 0 e 1, quindi nessun controllo del formato rileva errori. Il modello impara da coppie non corrispondenti, il che può peggiorare le sue previsioni sulle immagini reali. Se la suddivisione di validazione presenta la stessa discrepanza, la precisione media può trarti in inganno invece di segnalare il problema.
Le immagini riflesse sono più difficili da individuare, perché un'immagine capovolta può superare un controllo visivo rapido. Invertire il testo e, per la stima della posa, spostare i punti di riferimento del corpo a sinistra e a destra rispetto alle relative etichette.
Inoltre, è facile che il problema passi inosservato. Un dataset creato con caricamenti da telefono, ispezioni sul campo o foto raccolte da una comunità può contenere sia file con tag sia file senza tag; solo le immagini lette con un riferimento diverso da quello delle etichette risultano disallineate. Il danno sembra dovuto a etichette imprecise, anziché a un bug della pipeline.
Lo stesso file può essere letto in due modi diversi in OpenCV#
Se leggi le immagini con OpenCV, l'applicazione del tag dipende da come lo richiami. La documentazione di OpenCV imread specifica che l'orientamento EXIF viene applicato a meno che non venga passato IMREAD_IGNORE_ORIENTATION o IMREAD_UNCHANGED. È facile ricorrere a questo secondo flag: è il modo per mantenere un canale alfa o bande aggiuntive.
Durante la verifica del pacchetto Ultralytics, abbiamo scoperto che il percorso di lettura dipendeva dal flag, dal formato e dalla versione di OpenCV. Prima di PR #27168, il nostro imread si comportava così per gli orientamenti da 2 a 8:
| Lettura | Risultato prima della versione 8.4.214 |
|---|---|
JPEG, PNG o WebP letti con IMREAD_UNCHANGED (dataset e modelli con channels diverso da 1 o 3) | Come memorizzati, in tutte le versioni di OpenCV |
| WebP con qualsiasi flag, OpenCV prima della versione 5.0 | Come memorizzato |
predict("a.webp") vs. predict(Image.open("a.webp")), OpenCV prima della versione 5.0 | Due riferimenti diversi |
| JPEG e PNG, a colori o in scala di grigi | Corretta orientazione |
Le immagini JPEG e PNG a colori e in scala di grigi erano già correttamente orientate. Il rischio riguardava i dataset con channels diverso da 1 o 3, i file WebP su OpenCV 4.x e i confronti tra previsioni su un file WebP e su un'immagine PIL. Con channels: 4, per esempio, la forma dell'immagine nella cache era già quella correttamente orientata, ma i pixel non lo erano, quindi i riquadri, i batch rettangolari e il ridimensionamento delle maschere usavano una forma trasposta.
Ultralytics 8.4.214 applica l'orientamento EXIF in modo coerente#
Dalla versione 8.4.214, rilasciata il 15 novembre 2026, imread applica l'orientamento EXIF alle letture a colori, in scala di grigi e senza modifiche, in tutti i formati supportati e in tutte le versioni di OpenCV, salvo le poche eccezioni elencate di seguito. Il riferimento di imread esplicita l'obiettivo: etichette e previsioni condividono il riferimento mostrato dai visualizzatori. Anche la documentazione dei dataset di rilevamento specifica ora lo stesso principio per le coordinate delle etichette, così la convenzione è documentata nel punto in cui la consultano gli autori dei dataset.
Ecco una breve spiegazione del funzionamento:
- Letture coerenti in tutti i percorsi. Il caricamento delle immagini dei dataset e la previsione su singoli percorsi immagine passano attraverso
imreadinultralytics/utils/patches.py; ora lo usano anche i dataset di classificazione e la suddivisione DOTA. I percorsi immagine passati apredictcome elenco vengono aperti con Pillow e trasposti secondo EXIF; anche gli input immagine PIL vengono trasposti secondo EXIF. Di conseguenza, al di fuori delle eccezioni indicate di seguito, producono tutti lo stesso riferimento correttamente orientato. - Tag applicati quando OpenCV li ignora. Per le letture senza modifiche e per tutte le letture WebP, l'immagine viene decodificata con
IMREAD_IGNORE_ORIENTATIONe il tag viene poi applicato all'array, così il risultato non dipende dalla versione di OpenCV. - Il passaggio EXIF controlla il contenuto del file. Il tag viene applicato ai dati JPEG, WebP e PNG con un chunk eXIf, anche in presenza di un'estensione non corrispondente, come un JPEG denominato
.webp. I dati TIFF vengono lasciati al decoder TIFF di OpenCV, che applica l'orientamento autonomamente; per AVIF e HEIC viene usatoexif_transposedi Pillow. - Pillow solo quando serve. I chunk PNG vengono esaminati per primi, quindi Pillow viene chiamato solo quando è presente un chunk eXIf.
Abbiamo convalidato la modifica con OpenCV 5.0.0, 4.12.0 e 4.7.0 e Pillow 13.0.0, confrontando i pixel con exif_transpose di Pillow. Tutti gli otto orientamenti sono stati letti correttamente per JPEG, PNG (RGB e RGBA) e WebP (RGB e RGBA), nelle modalità a colori, in scala di grigi e senza modifiche: 45 combinazioni in tutto. Le immagini senza tag vengono decodificate negli stessi array di prima.
In alcuni casi limite viene mantenuto l'orientamento memorizzato: un JPEG salvato con estensione .tif o .tiff (tranne nelle letture in scala di grigi), le letture di JPEG e PNG per le quali passi deliberatamente IMREAD_IGNORE_ORIENTATION (i file WebP vengono comunque ruotati correttamente) e, con il limite di pixel predefinito di Pillow, le letture senza modifiche di JPEG o PNG e le letture di WebP per immagini oltre circa 179 megapixel. In questi casi, incorpora l'orientamento nei pixel prima del training (vedi i passaggi di verifica qui sotto).
La versione della cache del dataset è passata a 1.0.13, quindi le cache delle etichette che contengono le vecchie forme vengono ricreate una volta alla successiva esecuzione. C'è un'eccezione: per un PNG il cui chunk eXIf segue i dati dell'immagine, i pixel vengono letti correttamente, ma la forma memorizzata nella cache può restare quella originale. Incorpora l'orientamento in questi PNG e ricrea la cache.
Ruota un'immagine e le relative etichette in Ultralytics Platform#
Un lettore migliore gestisce i file con tag. Non può aiutarti quando sono i pixel stessi a essere orientati male: una scansione acquisita ruotata, una foto esportata capovolta o un tag rimosso a monte, lasciando solo la griglia memorizzata. I metadati non possono indicare in che direzione dovrebbero essere orientate queste immagini. Serve una rotazione effettiva e anche le etichette devono ruotare insieme alle immagini.
Ultralytics Platform ora offre questa funzione nel visualizzatore a schermo intero della galleria dei dataset. Se hai accesso in modifica, premi R o il pulsante di rotazione per ruotare l'immagine e le relative annotazioni di 90 gradi in senso orario. I riquadri, i poligoni e i keypoint si spostano insieme ai pixel, quindi le annotazioni restano sugli oggetti che descrivono.
Come vengono gestiti i tuoi dati:
- Nessun deterioramento cumulativo. Platform conserva l'immagine così come è stata memorizzata inizialmente e genera ogni rotazione a partire dall'originale, quindi le rotazioni ripetute non la deteriorano e tornando all'orientamento iniziale si ripristina l'originale.
- Vengono usati i pixel ruotati. Platform ruota i pixel memorizzati invece di scrivere un flag di rotazione, quindi i dataset esportati non includono nuovi campi e Download salva l'immagine a dimensione intera ruotata come appare.
La rotazione non è disponibile per i dataset di profondità, i dataset multispettrali, le immagini memorizzate in formato TIFF o i dataset con archiviazione cloud e On Premise.
La normalizzazione dei caricamenti di Platform applica l'orientamento EXIF. Quando il tag descrive correttamente il file, l'immagine viene caricata già orientata correttamente e i valori da 5 a 8 ne scambiano larghezza e altezza per adeguarle. Usa Ruota se l'immagine è ancora orientata nel verso sbagliato.
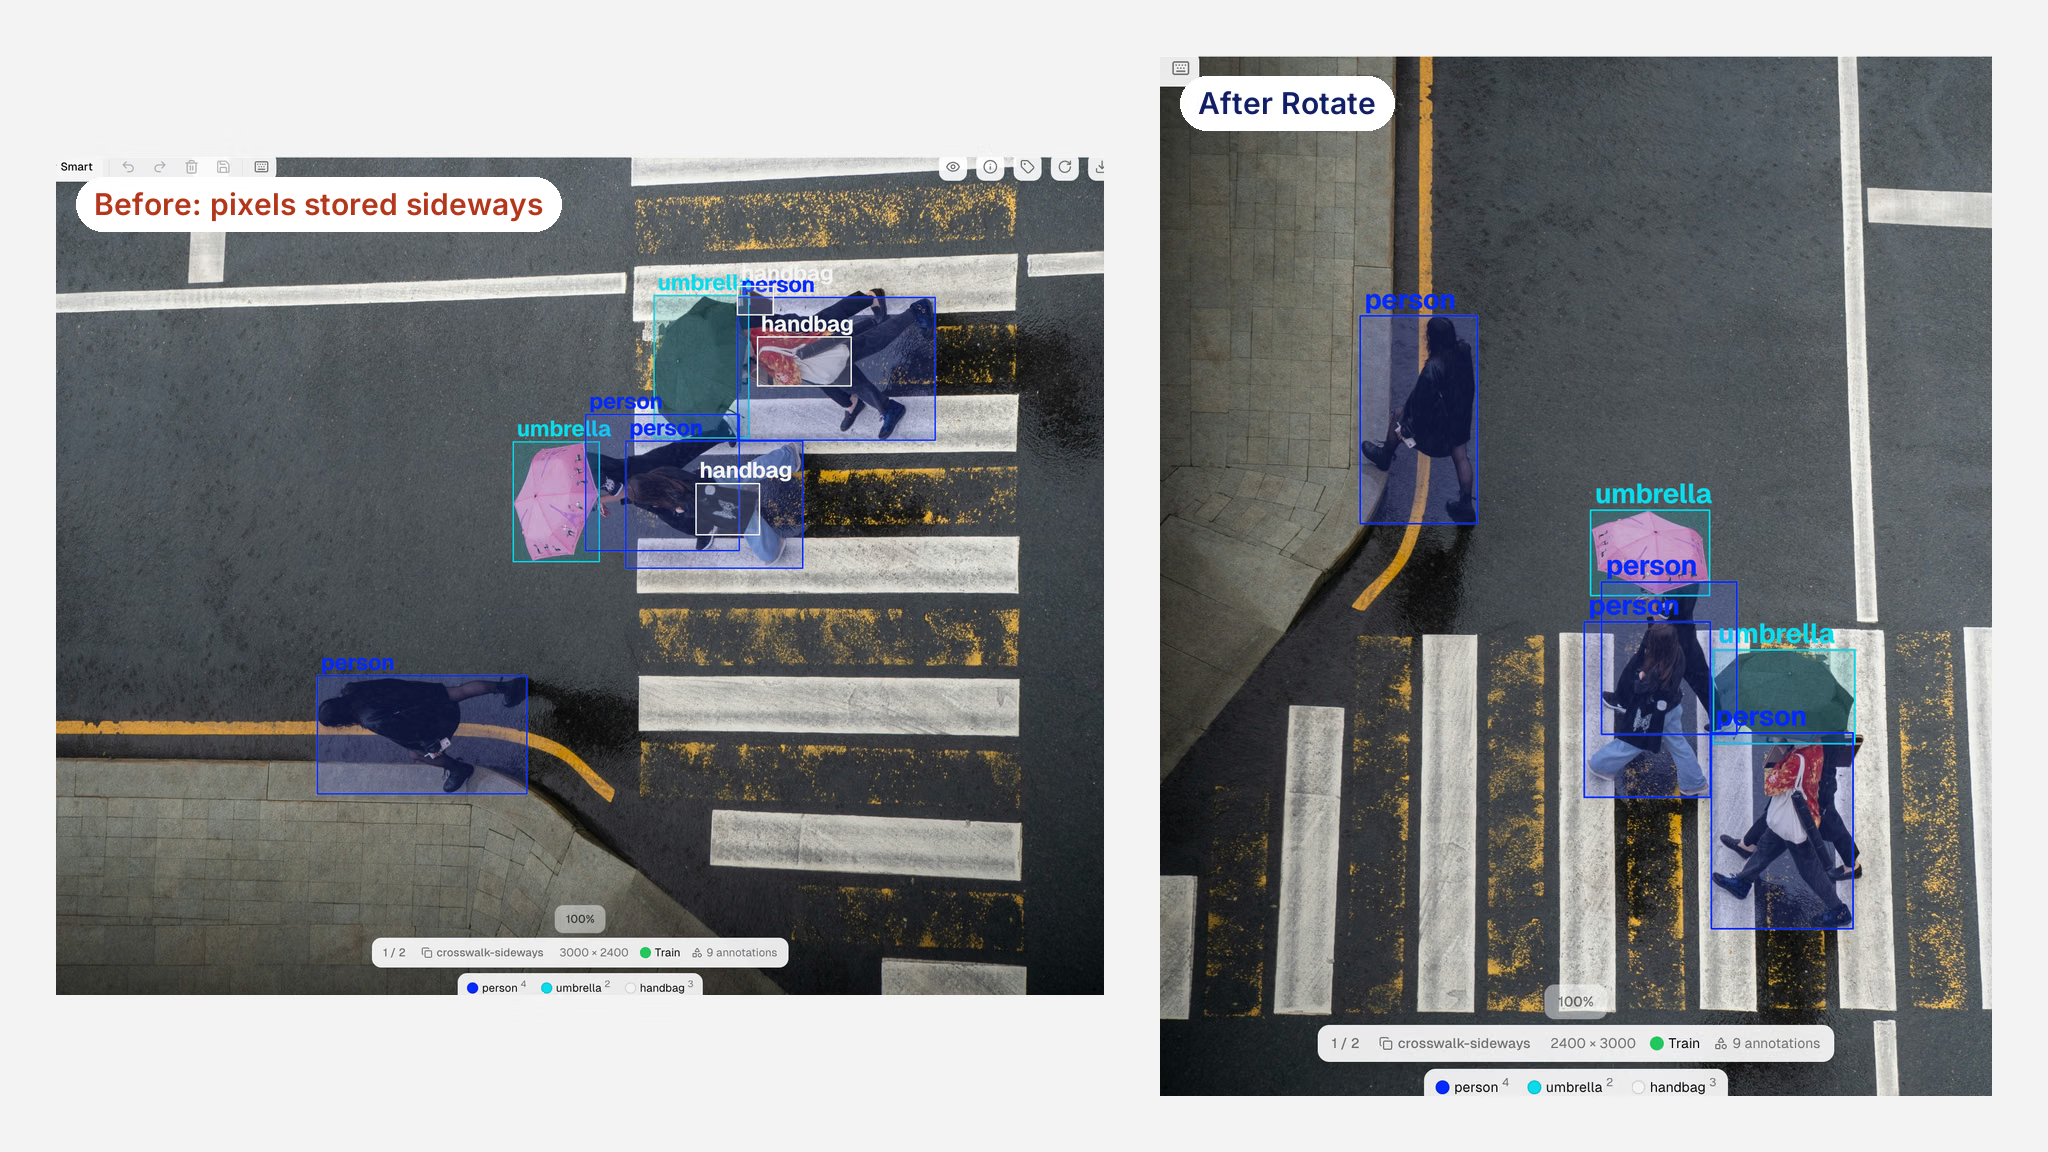
Immagine ruotata nel visualizzatore a schermo intero di Ultralytics Platform, prima e dopo aver usato Ruota. L'immagine passa da 3000 x 2400 a 2400 x 3000 e ogni annotazione ruota insieme a essa.
Come verificare e correggere l'orientamento EXIF nel tuo dataset#
Inizia cercando i tag. Questo script segnala i file JPEG, PNG e WebP in una cartella il cui tag Orientation ha un valore diverso da 1:
from pathlib import Path

from PIL import Image

for path in Path("datasets/my_data/images").rglob("*"):
    if path.suffix.lower() in {".jpg", ".jpeg", ".png", ".webp"}:
        with Image.open(path) as im:
            orientation = im.getexif().get(274, 1)  # 274 è il tag EXIF Orientation
        if orientation != 1:
            print(path, orientation)
Un risultato pulito significa che nessuno di quei file ha un valore Orientation diverso da 1. Non rileva file con un'estensione fuorviante, immagini i cui pixel memorizzati sono ruotati o etichette disegnate con un riferimento diverso. Poi verifica cosa vedrà Ultralytics: con la versione 8.4.214 o successive, imread restituisce l'immagine come viene visualizzata, salvo le eccezioni indicate sopra:
import cv2

from ultralytics.utils.patches import imread

img = imread("datasets/my_data/images/train/photo.jpg", cv2.IMREAD_UNCHANGED)
print(img.shape)  # (height, width, channels) come li visualizzano i visualizzatori
A questo punto, la soluzione dipende da come sono state create le etichette:
- Aggiorna. Esegui
pip install -U ultralyticsper ottenere la versione 8.4.214 o successive, in modo che training, validazione e previsione leggano i file immagine con tag e le immagini PIL nel riferimento visualizzato, tenendo conto delle eccezioni indicate sopra. Gli array NumPy e i tensori non contengono tag EXIF, quindi assicurati che siano già orientati correttamente prima di passarli apredict. - Elimina le vecchie cache delle immagini. Se le esecuzioni precedenti hanno creato cache immagini
.npyaccanto alle immagini, elimina questi file generati da Ultralytics prima di verificare o ripetere il training, anche se la prossima esecuzione usacache=False, perché il loader potrebbe comunque riutilizzare le cache esistenti. Non modificare i file NumPy non correlati; le cache delle etichette vengono ricreate automaticamente. - Controlla alcune immagini con tag confrontandole con le etichette. Disegna le etichette sull'immagine orientata correttamente. Se gli annotatori hanno usato uno strumento che rispetta il tag, i riquadri saranno allineati.
- Se le etichette sono state disegnate sulla griglia memorizzata, cosa che può accadere con script o strumenti che ignorano il tag, rietichetta quelle immagini oppure trasforma le etichette per adattarle alla vista correttamente orientata. Ruotare solo i pixel sposta semplicemente la discrepanza.
- Correggi le immagini i cui pixel sono orientati nel verso sbagliato con l'azione Ruota di Platform, che ruota anche le annotazioni, poi ripeti il training.
Per ottenere file dall'aspetto identico in tutti gli strumenti e gestire la maggior parte dei casi limite descritti sopra, incorpora l'orientamento nei pixel con ImageOps.exif_transpose di Pillow e salva una copia. Fallo prima dell'annotazione oppure trasforma anche le etichette. Pillow avvisa quando viene superato il limite di pixel predefinito e rifiuta le immagini oltre il doppio di tale limite, circa 179 megapixel. Per immagini più grandi di cui ti fidi, aumenta Image.MAX_IMAGE_PIXELS prima di aprirle.
Per una checklist più ampia prima del training, le lezioni Academy su controllo della qualità dei dataset e qualità delle annotazioni trattano gli altri controlli da eseguire insieme a questo.
L'aumento dei dati con rotazioni non corregge una discrepanza di orientamento#
È facile pensare che le rotazioni casuali durante il training rendano irrilevante l'orientamento. L'aumento dei dati, per esempio tramite l'impostazione degrees in YOLO augmentation, ruota insieme l'immagine e le relative etichette, mantenendole allineate e insegnando al modello a gestire gli oggetti inclinati. Una lettura EXIF errata separa immagini ed etichette prima ancora che venga eseguito l'aumento dei dati; ruotarle entrambe in seguito le mantiene separate.
Lo stesso principio vale per le attività con una direzione di riferimento fissa. Se il tuo modello legge il testo, come nella nostra guida a OCR in Python con Ultralytics YOLO26, o distingue la sinistra dalla destra, un orientamento speculare cambia il significato dell'immagine, non solo il suo angolo.
Chi dovrebbe verificare l'orientamento EXIF#
Esegui il controllo se una di queste descrizioni si applica ai tuoi dati:
- Foto scattate con telefoni o tablet, per ispezioni sul campo, verifiche nei negozi, richieste di risarcimento assicurativo o raccolte tramite crowdsourcing.
- Fonti diverse riunite in un unico dataset, dove alcuni file potrebbero avere tag e altri no.
- Dataset WebP o dataset con
channelsdiverso da 1 o 3, usati per il training con versioni di Ultralytics precedenti alla 8.4.214. - Documenti acquisiti tramite scansione, le cui pagine possono avere i pixel ruotati e richiedere una rotazione effettiva.
Una volta sistemati i dati, puoi annotare e addestrare un modello Ultralytics YOLO26 nello stesso spazio di lavoro, con ogni etichetta posizionata sui pixel che descrive. Per ulteriori informazioni su come mantenere efficiente un dataset in Platform, consulta gestione intelligente dei dataset con Ultralytics Platform.
Domande frequenti
L'orientamento EXIF è un valore di metadati da 1 a 8, memorizzato nel tag 274 di un file immagine, che indica al software come ruotare o riflettere i pixel memorizzati per visualizzarli. Il valore 1 significa nessuna modifica; il valore 6 significa ruotare di 90 gradi in senso orario. I pixel stessi non vengono ruotati, quindi gli strumenti che ignorano il tag mostrano l'immagine così come è memorizzata, spesso ruotata.
Spesso il file contiene un tag Orientation che lo strumento ricevente non applica. Il telefono e il browser rispettano il tag, quindi la foto appare correttamente orientata, mentre un decoder che lo ignora mostra la griglia memorizzata. Se i pixel memorizzati sono ruotati e nessun tag li corregge, ruota l'immagine stessa.
Di solito.
imreaddi OpenCV applica il tag, a meno che tu non passiIMREAD_IGNORE_ORIENTATIONoIMREAD_UNCHANGED; inoltre, le versioni precedenti alla 5.0 lasciavano i file WebP come memorizzati. Dalla versione 8.4.214,imreaddi Ultralytics applica il tag alle letture a colori, in scala di grigi e senza modifiche in tutte le versioni di OpenCV che abbiamo testato.Sì. Dalla versione 8.4.214 di Ultralytics, i file immagine e le immagini PIL vengono letti applicando l'orientamento EXIF, salvo alcuni casi limite, come un JPEG salvato con estensione
.tif; le coordinate delle etichette si riferiscono allo stesso riferimento visualizzato. Gli array NumPy e i tensori non hanno tag EXIF, quindi devono essere orientati correttamente prima della previsione.Apri l'immagine nel visualizzatore a schermo intero del dataset e premi
Ro il pulsante di rotazione; ogni pressione ruota l'immagine e le relative annotazioni di 90 gradi in senso orario. Ti serve l'accesso in modifica; la rotazione non è disponibile per le immagini di profondità, multispettrali o TIFF, né per i dataset su storage cloud o On Premise.
Scritto da
Ingegnere software capo · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









