GPT-6.1 Terra conquista il primo posto nell'auto-annotazione, superando gli stessi modelli di punta di OpenAI
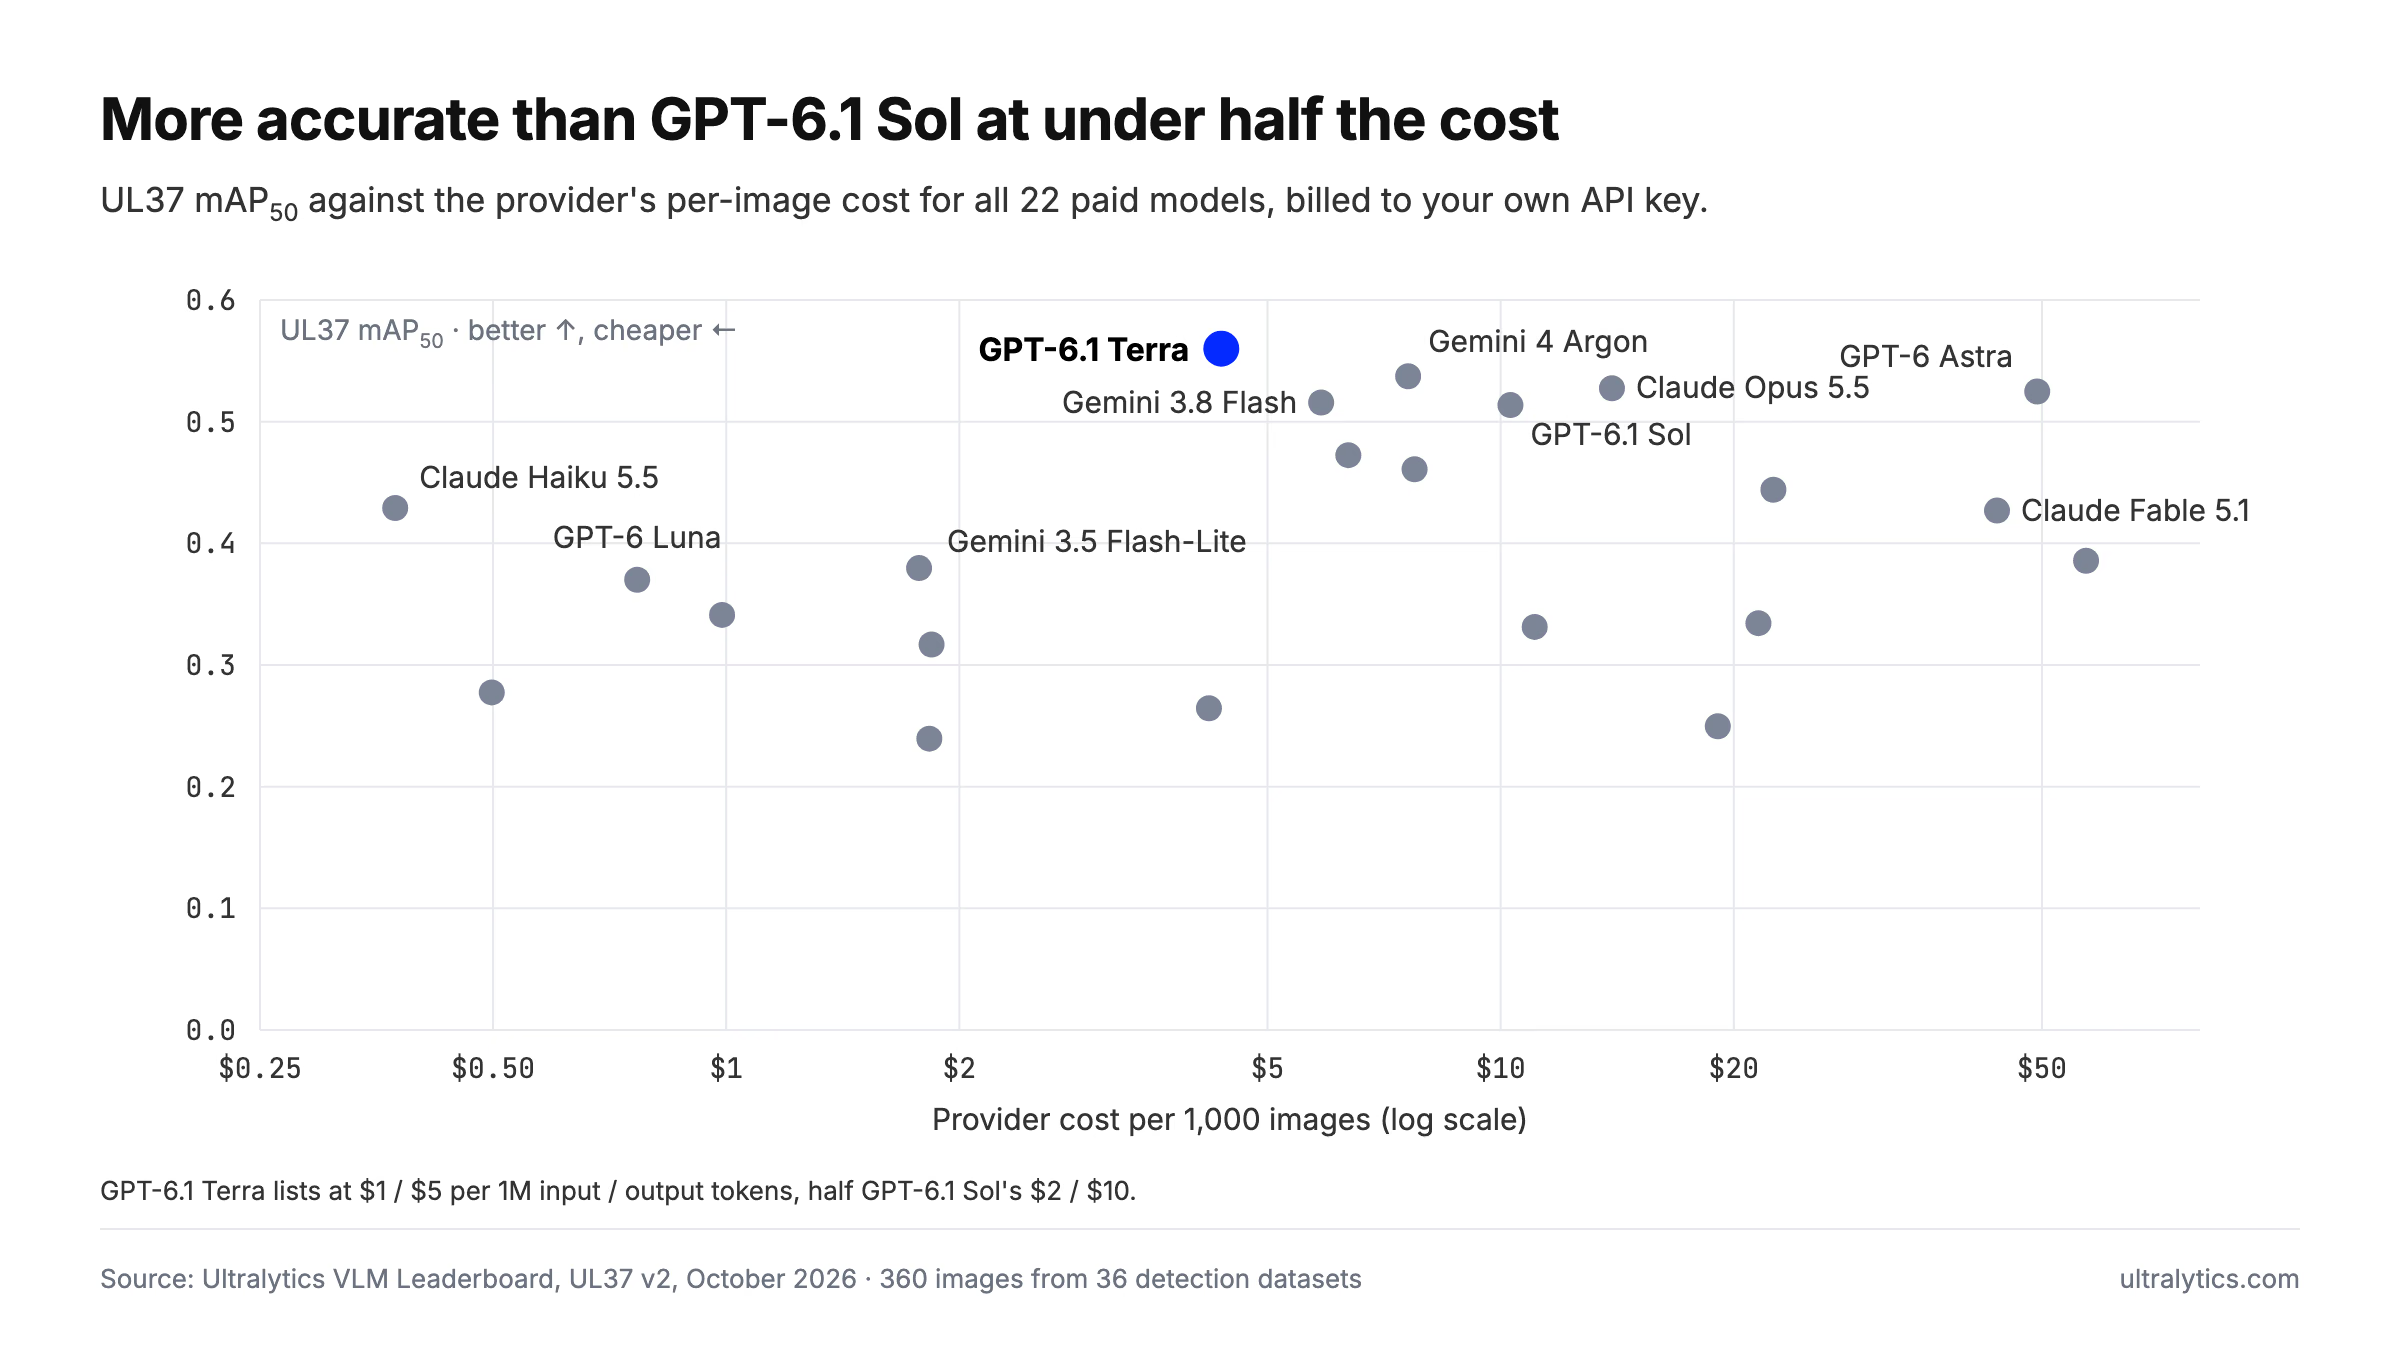
L'auto-annotazione con GPT-6.1 Terra supera 39 modelli nella nostra VLM Leaderboard: 0.560 mAP50 a 4,36 $ per 1.000 immagini, davanti a GPT-6.1 Sol e Gemini 4 Argon.
I materiali di lancio di OpenAI affermano che GPT-6.1 Terra quasi eguaglia i suoi modelli fratelli maggiori nel ragionamento visivo. Quando gli abbiamo chiesto di disegnare bounding box, «quasi» si è rivelata la parola sbagliata.
Abbiamo testato l'auto-annotazione con GPT-6.1 Terra su UL37, il nostro benchmark di rilevamento su 36 dataset, il 26 ottobre 2026, il giorno del suo rilascio da parte di OpenAI. Ha ottenuto 0.560 mAP50, il miglior risultato tra tutti i 39 modelli nella nostra VLM Leaderboard. Il modello di fascia media di OpenAI ha superato GPT-6.1 Sol, il modello di punta GPT-6 Astra e Gemini 4 Argon, che aveva mantenuto il primo posto fino a questa settimana.
Ha raggiunto questo risultato spendendo 4,36 $ ogni 1.000 immagini, impiegando 5,1 secondi per immagine e senza una sola richiesta non riuscita. Puoi usarlo oggi stesso su Ultralytics Platform. Qui sotto vediamo dove dà il meglio, dove inciampa e come decidere se inserirlo nel tuo flusso di lavoro di etichettatura.
GPT-6.1 Terra conquista il primo posto su UL37#
UL37 misura quanto le box di un modello corrispondono alle etichette umane su 360 immagini: 10 per ciascuno dei 36 dataset reali di rilevamento degli oggetti, che coprono scansioni mediche, immagini aeree, scaffali di negozi, sport, documenti, circuiti stampati e altro. Ogni immagine passa attraverso la stessa pipeline di produzione disponibile agli utenti di Platform, usando i nomi delle classi del dataset e con SAM 3.1 che rifinisce ogni box. La metodologia è pubblica.
Ecco la scheda dei risultati di Terra:
- mAP50: 0.560, #1 su 39
- mAP50-95: 0.345, anche in questo caso #1: significa che le sue box aderiscono strettamente agli oggetti, non solo in modo approssimativo
- Precisione e richiamo: 0.646 e 0.613
- Costo del provider: 4,36 $ per 1.000 immagini
- Tempo mediano per immagine: 5,1 s
- Richieste non riuscite: nessuna
Sei modelli ottengono più di 0.51 su UL37, tra cui Claude Opus 5.5, al terzo posto. Terra è il più preciso dei sei e anche il più economico.
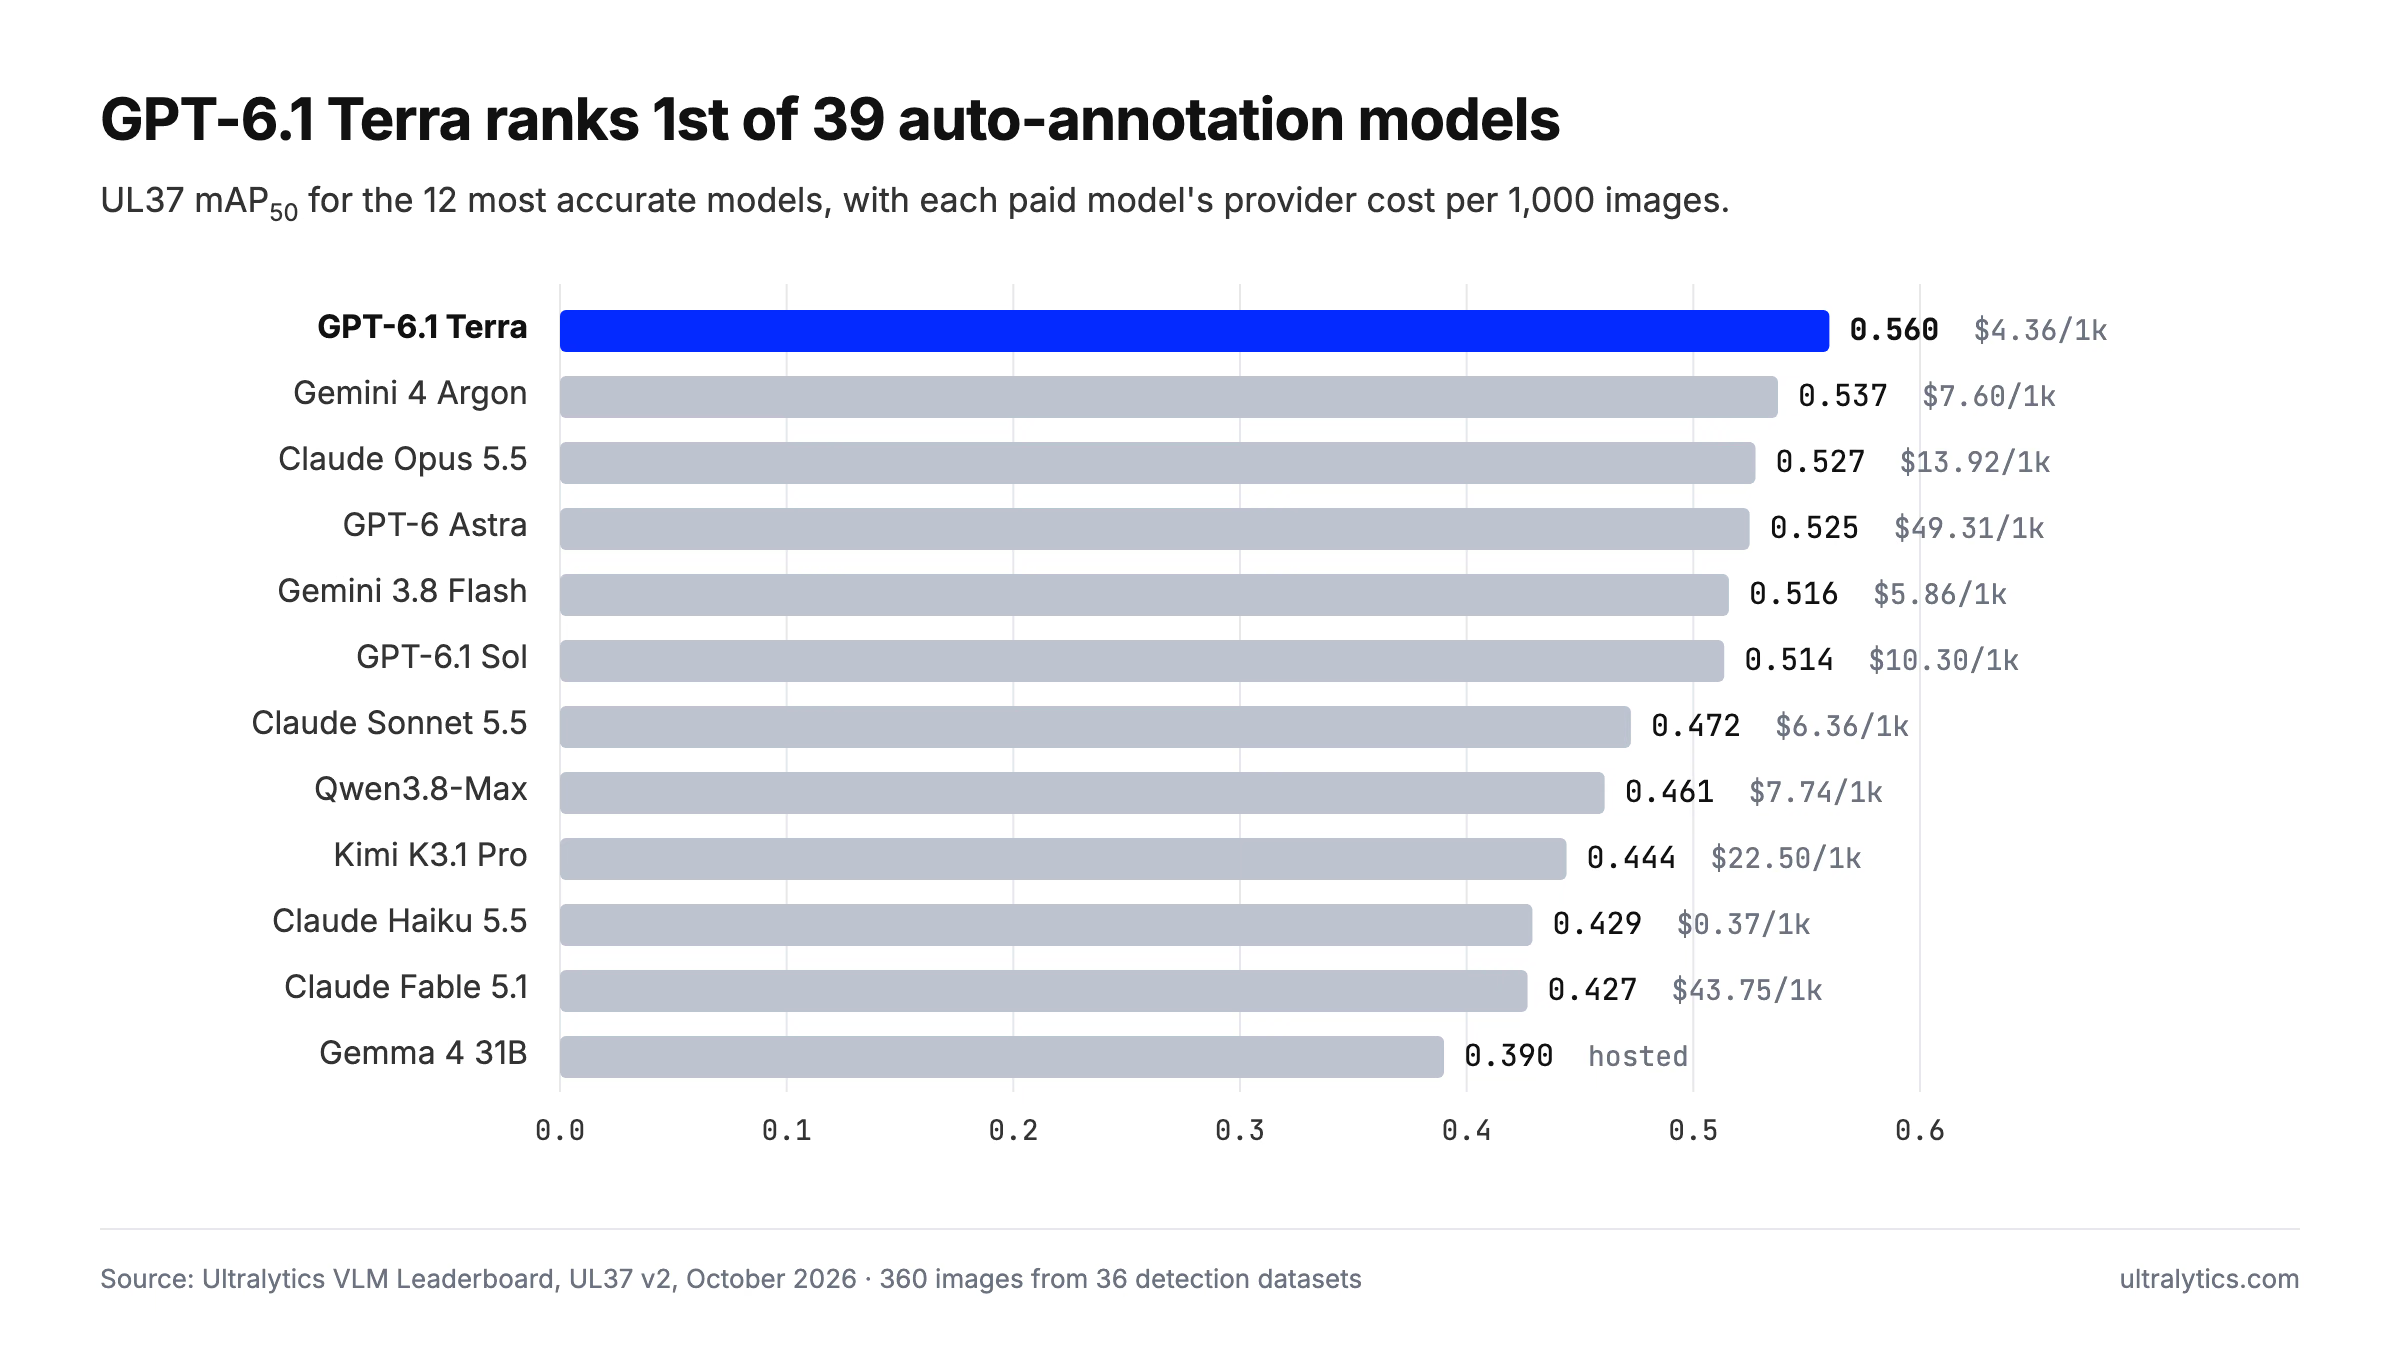
Dietro al risultato non c'è stato alcun rompicapo di ottimizzazione. Terra funziona con il livello di ragionamento predefinito di OpenAI, indicato come medio nella documentazione del modello. Riceve la stessa richiesta di tutti gli altri modelli OpenAI su Platform, con le coordinate delle box su una griglia da 0 a 1000. Lo abbiamo integrato e ha raggiunto subito la vetta.
Un modello di fascia media che supera i modelli di punta di OpenAI#
OpenAI presenta GPT-6.1 Terra come il modello veloce ed efficiente di fascia intermedia della sua gamma. Secondo gli articoli sul lancio di The Decoder e BleepingComputer, succede a GPT-5.6 Terra ed è pensato per l'uso del computer, il ragionamento visivo, la programmazione e le attività quotidiane. È disponibile tramite API come gpt-6.1-terra e in ChatGPT Work e Codex per gli utenti Plus, Pro, Enterprise ed Edu. La documentazione di OpenAI lo descrive come «un modello veloce ed efficiente per il ragionamento visivo, l'uso preciso del computer e una scrittura chiara e naturale», con input di testo e immagini e una finestra di contesto da 1.050.000 token.
Il prezzo è di 1 $ per milione di token in input e 5 $ per milione di token in output, con input memorizzato nella cache a 0,05 $. Si tratta della metà rispetto ai 2 $ e 10 $ di GPT-6.1 Sol e di un decimo rispetto ai 10 $ e 50 $ di GPT-6 Astra, secondo le pagine di OpenAI dedicate a GPT-6.1 Sol e GPT-6 Astra.
Nei benchmark di lancio, OpenAI presenta Terra come vicino ai modelli fratelli maggiori, non superiore. Su MMMU-Pro, un test di ragionamento visivo, OpenAI dichiara che Terra quasi eguaglia Astra e Sol. Su Terminal-Bench 4.0, dichiara un risultato del 50,3%, rispetto al 21,5% di GPT-5.6 Terra. E continua a consigliare Sol o Astra per le attività di programmazione più difficili.
Sulla carta, Terra è la scelta di compromesso. Nel nostro benchmark, è il miglior detector di OpenAI.
| Modello OpenAI | mAP50 su UL37 | Costo per 1.000 immagini | Tempo mediano per immagine |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5,1 s |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terra costa meno della metà per immagine rispetto a GPT-6.1 Sol e meno di un decimo rispetto a GPT-6 Astra. Risponde anche circa il doppio più velocemente di entrambi. Nel confronto diretto, batte Sol in 22 dei 36 dataset.
OpenAI afferma che Terra completa le attività più di tre volte più velocemente di Sol e Astra: un dato riferito ai carichi di lavoro degli agenti. L'annotazione è un'attività diversa e, in questo caso, abbiamo misurato una velocità circa doppia rispetto a Sol, un vantaggio che si fa sentire quando devi etichettare migliaia di immagini.
Il vantaggio di Terra su Sol è la precisione#
I due modelli individuano una quota simile degli oggetti etichettati. Il richiamo di Terra è 0.613 e quello di Sol è 0.618. La differenza emerge nella precisione: 0.646 per Terra contro 0.551 per Sol. Una quota molto maggiore delle box di Terra corrisponde a un oggetto reale con l'etichetta giusta.
SKU110K rende la differenza evidente. Le immagini mostrano scaffali di supermercato stipati di prodotti da un bordo all'altro, tutti appartenenti a un'unica classe. In questo caso entrambi i modelli raggiungono un richiamo simile: 0.73 per Terra e 0.77 per Sol. Ma la precisione di Sol su questi scaffali è 0.49, mentre quella di Terra è 0.79. Circa la metà delle box di Sol sono falsi positivi, contro circa una su cinque per Terra. Il risultato di 0.62 mAP50 di Terra su SKU110K è il più alto mai ottenuto da un modello.
Questo è importante per l'etichettatura dei dati, perché gli errori non hanno tutti lo stesso costo. Un prodotto mancato richiede di disegnare una box. Una box falsa costringe a individuarla tra decine di box corrette e a eliminarla. Meno falsi positivi offrono ai revisori una prima bozza più pulita.
L'imaging medico è il punto di forza distintivo di GPT-6.1 Terra#
Il tratto più distintivo dei risultati di Terra riguarda l'ambito medico. UL37 comprende otto dataset medici e Terra raggiunge una media di 0.505 mAP50 su questi dataset, al primo posto tra 39 modelli. Seguono Gemini 3.8 Flash con 0.387 e Gemini 4 Argon con 0.379. Nessun altro modello in classifica ha un vantaggio più ampio in un altro ambito.
Ecco i risultati sugli otto dataset, a confronto con il migliore degli altri 38 modelli per ciascuno:
| Dataset | GPT-6.1 Terra | Miglior altro modello |
|---|---|---|
| Ecografia tiroidea (TN5000) | 0.94 | Gemini 3.8 Flash, 0.88 |
| Risonanza magnetica di tumori cerebrali (Cheng) | 0.90 | Gemma 4 31B, 0.80 |
| Microscopia delle cellule del sangue (TXL-PBC) | 0.89 | Gemini 4 Argon, 0.78 |
| Endoscopia di polipi del colon (Kvasir-SEG) | 0.71 | Sette modelli a pari merito, tra cui Gemini 4 Argon, 0.81 |
| Radiografia pediatrica del polso (GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0.35 |
| Radiografia toracica, tubercolosi (TBX11K) | 0.14 | GPT-6 Astra, 0.33 |
| Lesioni retiniche (DDR) | 0.13 | Claude Opus 5.5, 0.13 |
| Radiografia dentale (DENTEX) | 0.06 | Gemini 4 Argon, 0.21 |
I primi tre risultati determinano il vantaggio, e nessuno di questi consiste semplicemente nel trovare il punto giusto. Su TN5000, ogni box include anche l'etichetta del dataset che indica se il nodulo è benigno o maligno, proprio il tipo di valutazione che un medico deve confermare. Gemini 4 Argon ottiene 0.29 e GPT-6.1 Sol 0.53. Le classi delle risonanze magnetiche cerebrali sono meningioma, glioma e tumore ipofisario; Sol ottiene 0.52. Nel dataset delle cellule del sangue, Terra deve distinguere globuli bianchi, globuli rossi e piastrine.
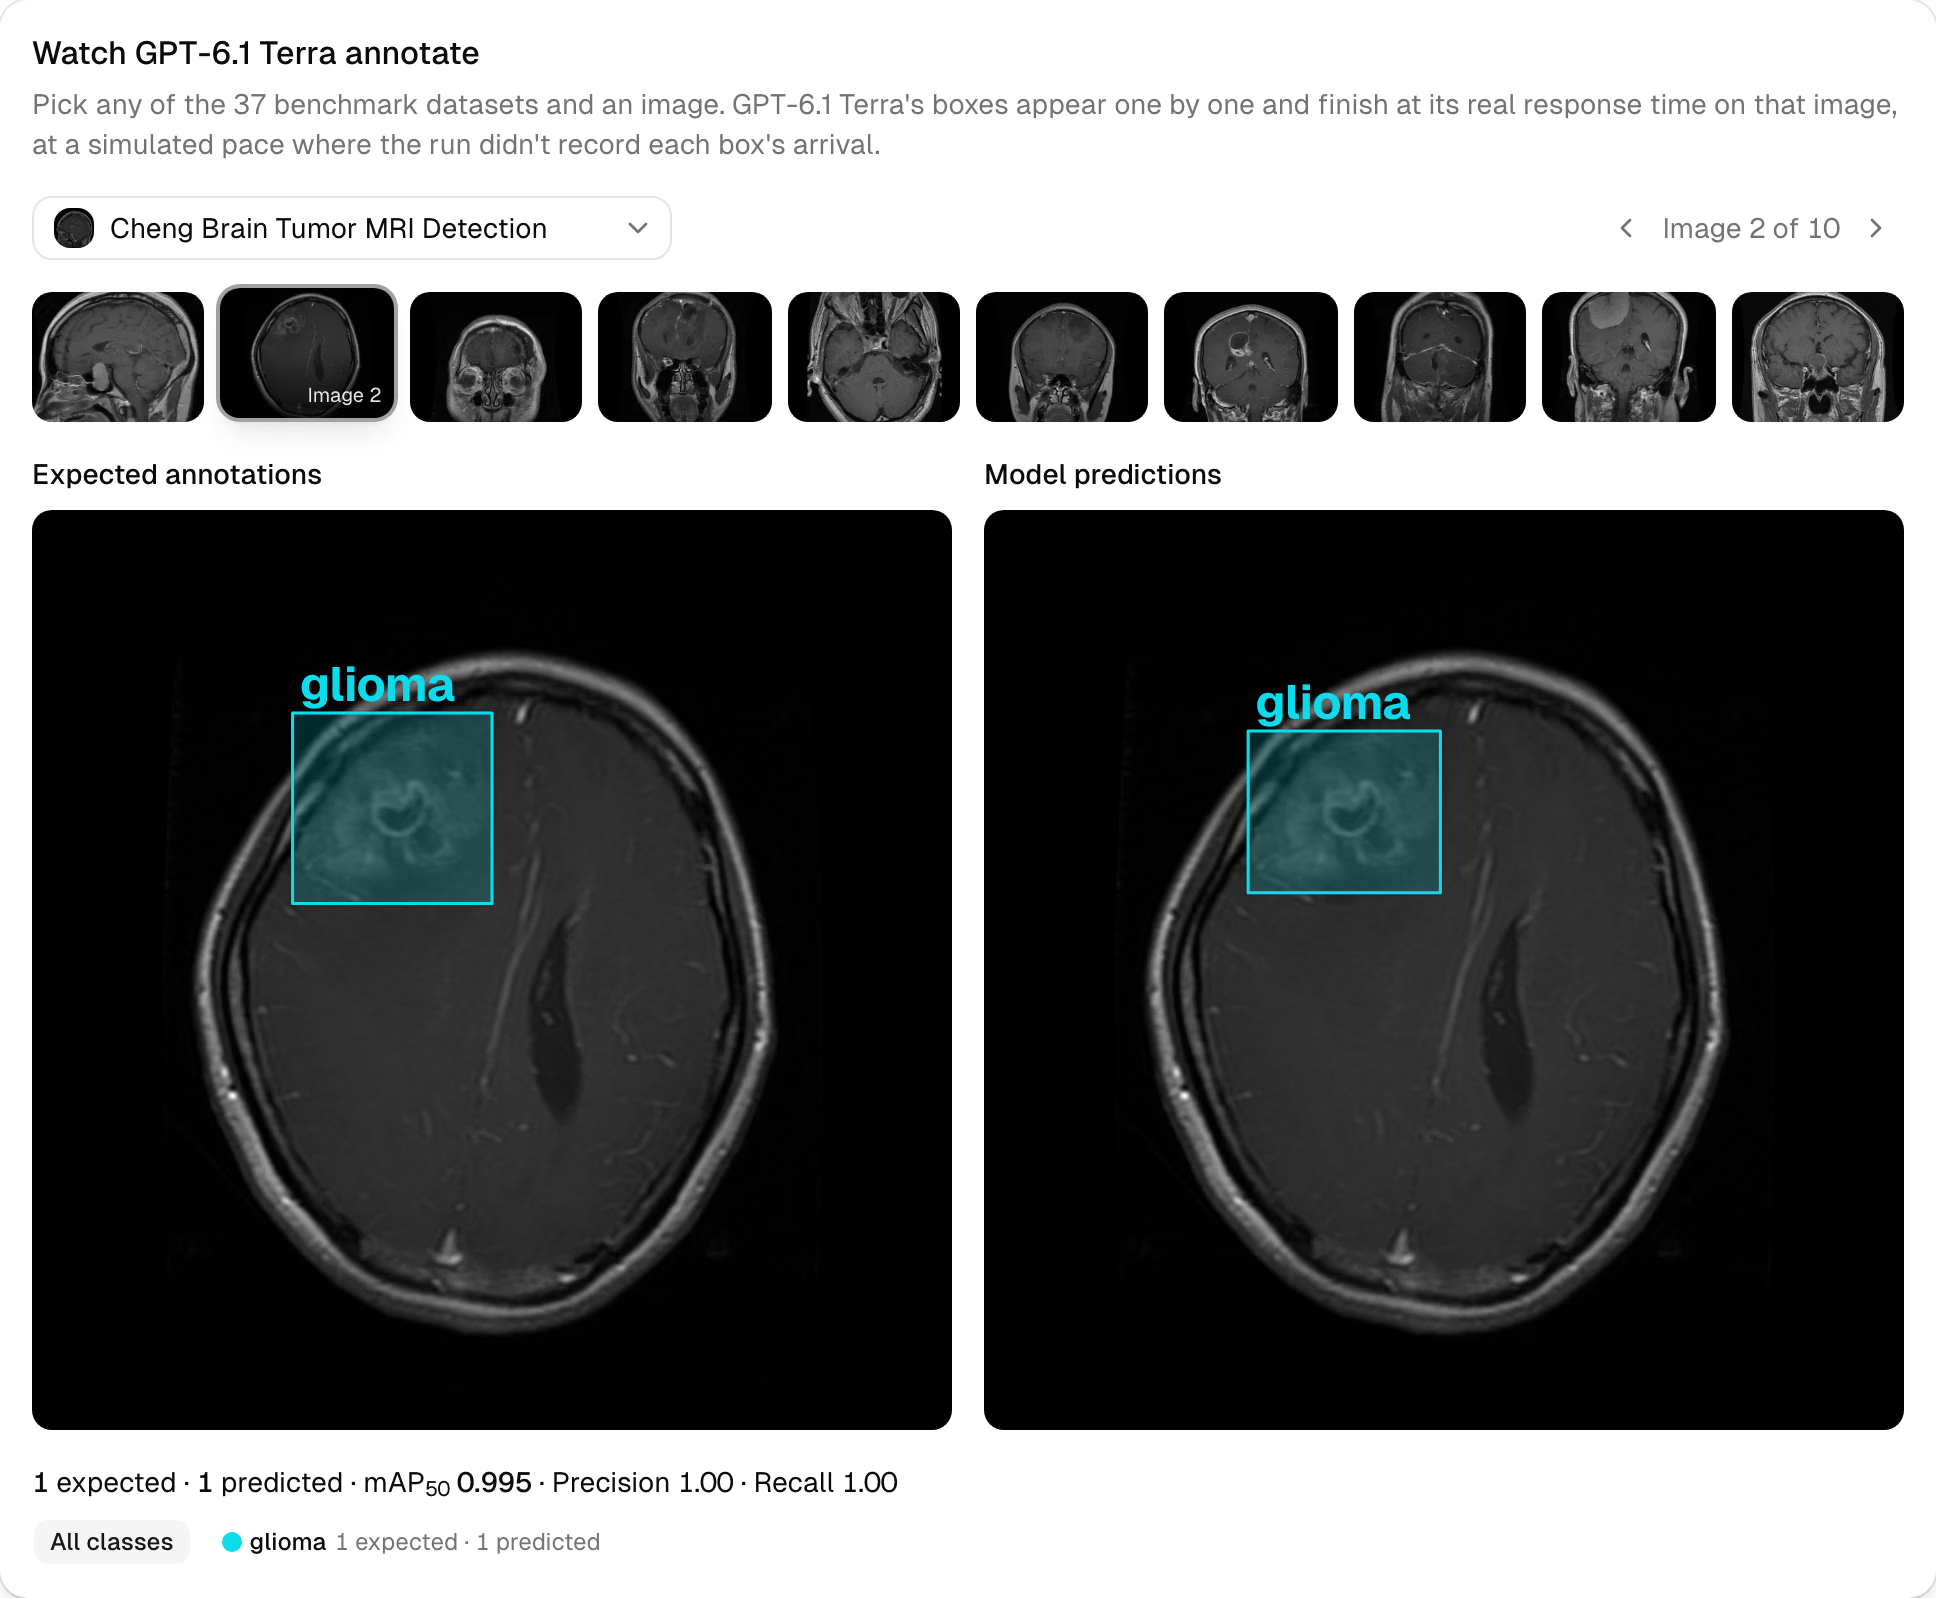
La riproduzione qui sopra, dalla pagina del modello Terra, mostra un risultato tipico: un glioma in una risonanza magnetica cerebrale, una box di Terra posizionata ed etichettata in modo da corrispondere all'annotazione attesa.
Questi numeri vanno considerati con due precisazioni. Primo, ogni dataset contribuisce con 10 immagini: il punteggio di un singolo dataset è un'indicazione da approfondire, non un verdetto. Secondo, questi risultati non costituiscono una diagnosi. Per un team che si occupa di analisi di immagini mediche, Terra è un modo rapido per creare una prima bozza di box su ecografie, risonanze magnetiche e immagini al microscopio, che gli esperti clinici possono poi controllare, correggere e approvare. La revisione con intervento umano è il fulcro del flusso di lavoro, non un'aggiunta facoltativa.
Dove GPT-6.1 Terra non è all'altezza: radiografie e circuiti stampati#
La parte bassa della tabella mostra una tendenza chiara. Su tutti i dataset di radiografie di UL37, medici o meno, un altro modello ottiene risultati migliori. Terra è indietro rispetto al leader nelle radiografie pediatriche del polso, del torace e dentali, e i risultati sono ancora peggiori nelle radiografie di sicurezza: 0.00 su IEDXray, mentre Gemini 4 Argon raggiunge 0.30.
IEDXray è l'errore più netto. Le scansioni mostrano laptop, telefoni, cercapersone, batterie e dispositivi artigianali, e Terra non ha prodotto box corrette per nessuno di questi.
I circuiti stampati sono l'altro punto cieco. Terra ha una media di 0.13 sui nostri dataset di PCB industriali, mentre GPT-6.1 Sol raggiunge 0.39. Su DeepPCB, che comprende difetti delle schede nude come circuiti aperti, cortocircuiti, segni di morsicatura e sbavature, Terra ottiene 0.03 contro lo 0.39 di Sol. Per i dati di ispezione dei PCB, Sol è la scelta migliore tra i modelli OpenAI.
Prima di etichettare un dataset di grandi dimensioni in uno di questi ambiti, apri la pagina del modello GPT-6.1 Terra. Mostra le box registrate da Terra su tutti e 36 i dataset del benchmark e su COCO, affiancate alle box attese, e riporta il punteggio per ciascun dataset.
GPT-6.1 Terra contro Gemini 4 Argon: una sfida più serrata di quanto suggerisca la classifica#
Gemini 4 Argon era in testa alla classifica prima dell'arrivo di Terra e i due modelli sono vicini. Terra ottiene risultati migliori su 19 dataset, Argon su 16 e i due sono a pari merito su uno.
Gran parte del vantaggio di 0.023 di Terra deriva da un unico dataset. Nell'ecografia tiroidea TN5000, Terra ottiene 0.94 e Argon 0.29. Escludendo quel dataset, le medie sono 0.549 per Terra e 0.544 per Argon: praticamente alla pari. Il primo posto di Terra è meritato, ma dipende in gran parte dall'imaging medico.
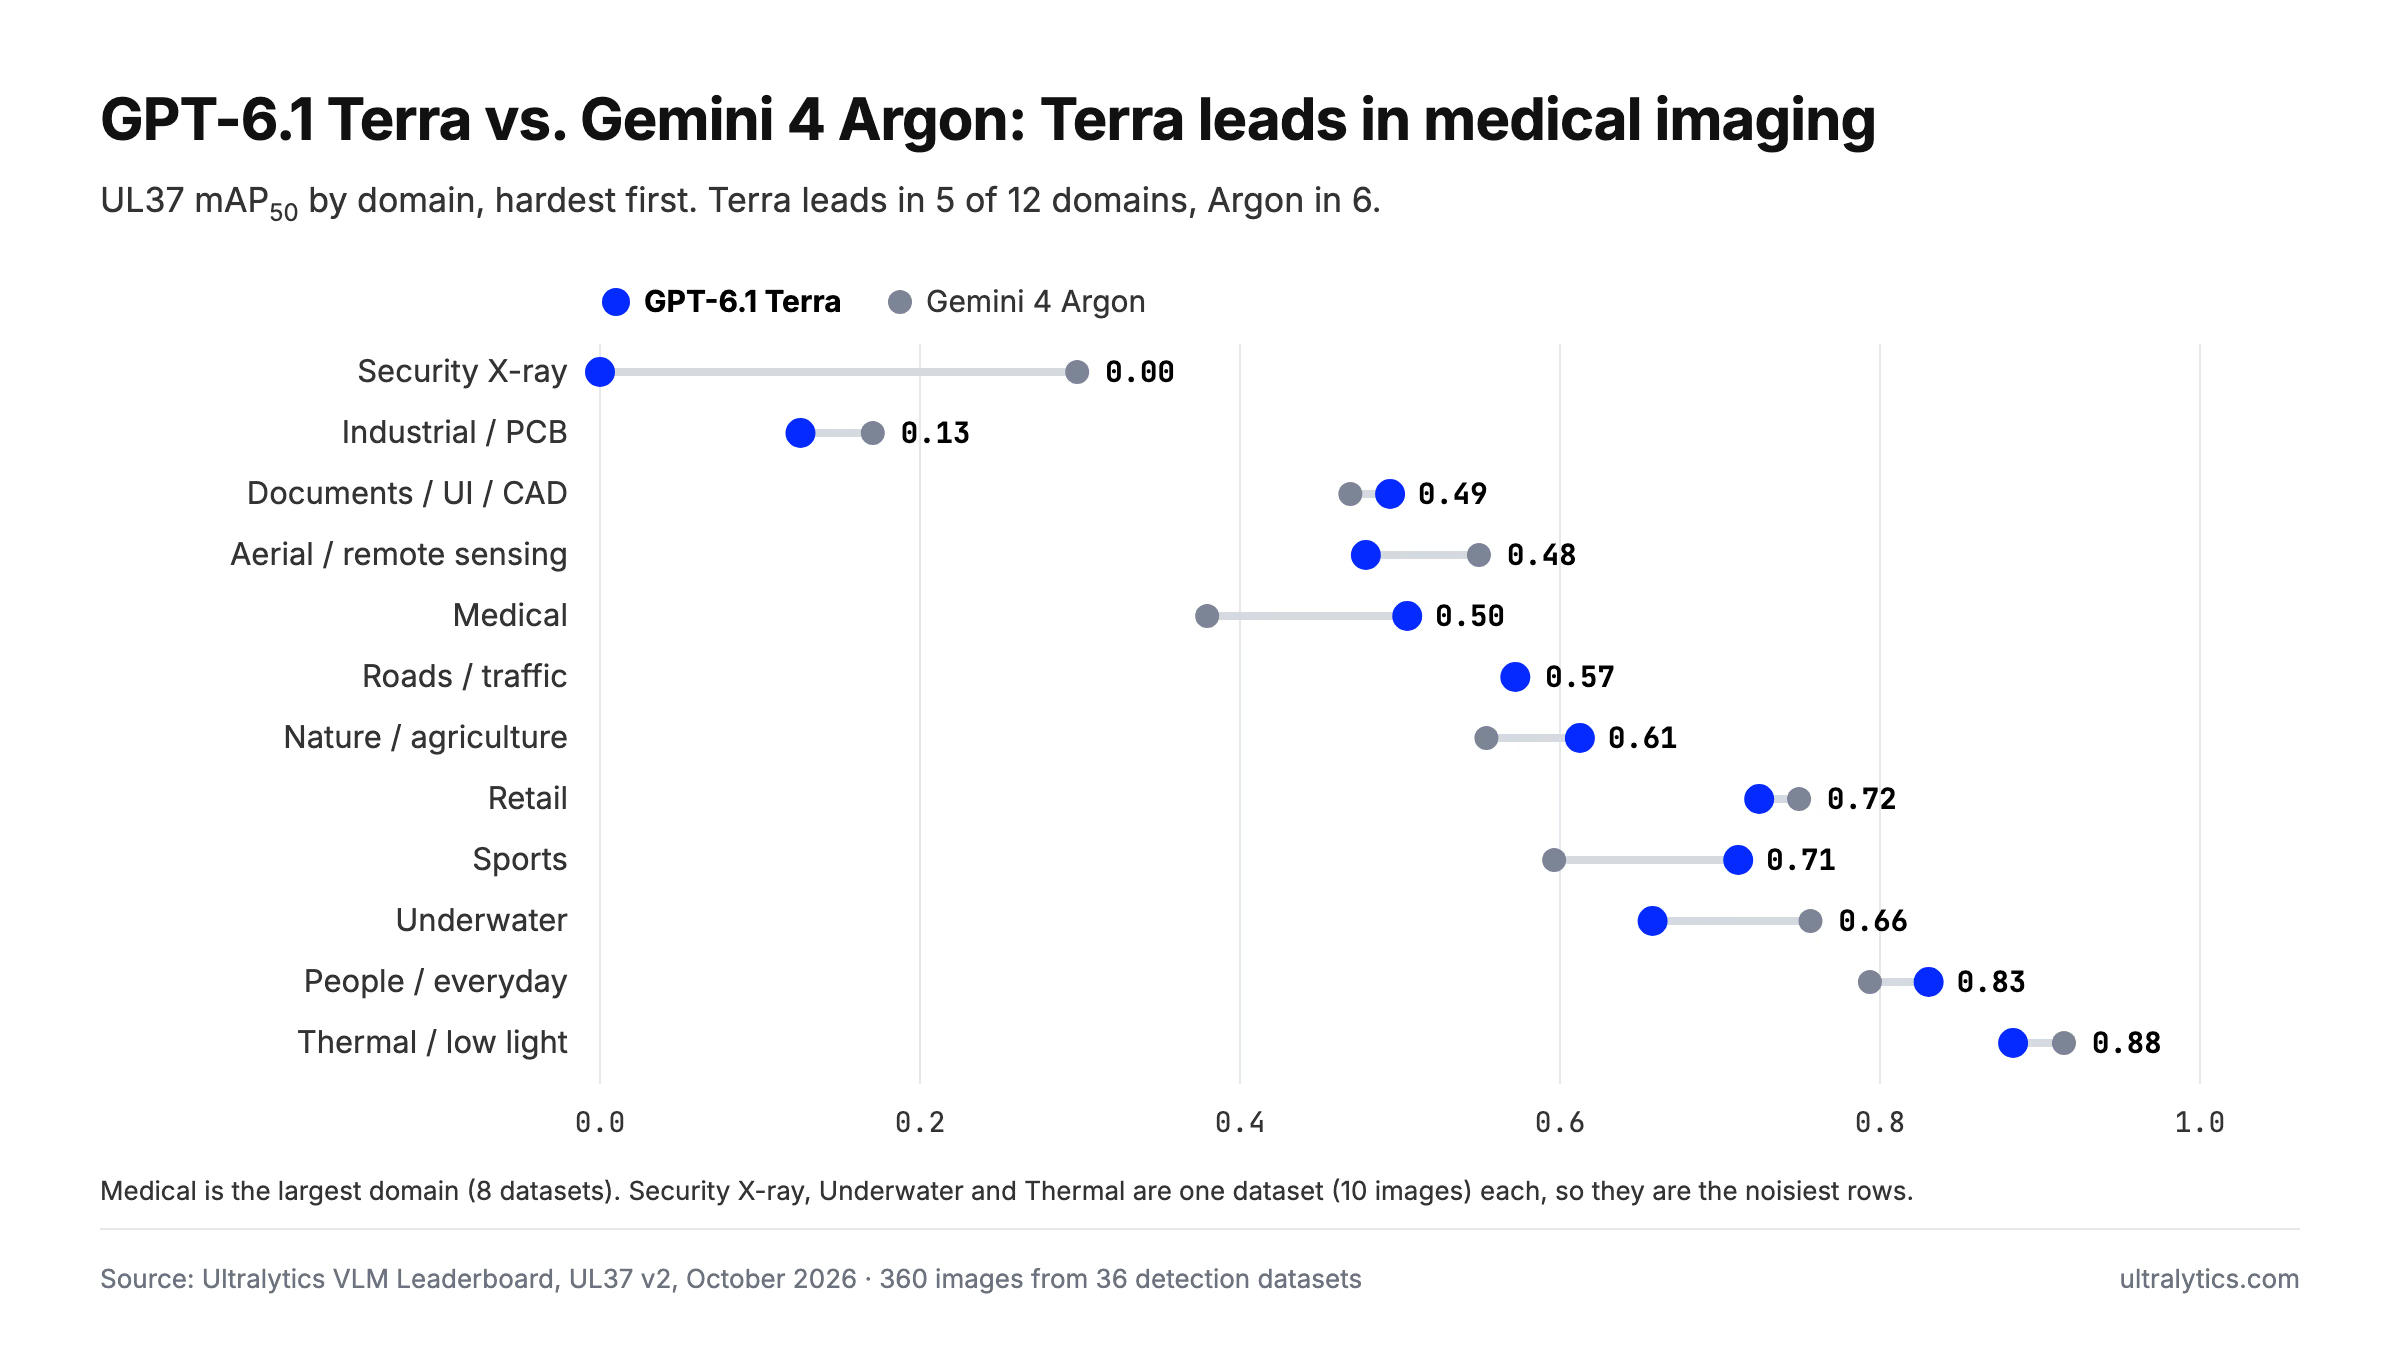
Per ambito, Terra è in vantaggio in cinque e si classifica al primo posto tra tutti i 39 modelli in due: ambito medico e documenti, interfacce utente e CAD. Argon è in vantaggio in sei e mantiene il primato nelle categorie aeree, subacquee e termiche. Strade e traffico è un pareggio.
I due modelli commettono anche tipi diversi di errori. Argon è leggermente più preciso, con 0.667 contro 0.646, mentre Terra individua più oggetti, con un richiamo di 0.613 contro 0.585. Terra costa 4,36 $ per 1.000 immagini, contro i 7,60 $ di Argon ai prezzi di lancio di Google. Argon è un po' più veloce: 4,6 s per immagine.
La scelta pratica: punta su Terra per immagini mediche, documenti e sport. Scegli Argon per immagini aeree, subacquee, termiche e di sicurezza. I nostri risultati dell'auto-annotazione con Gemini 4 Argon raccontano l'altra parte della storia.
Quanto costa un batch con GPT-6.1 Terra#
I 4,36 $ per 1.000 immagini corrispondono alla spesa per il provider, calcolata in base all'utilizzo di token dichiarato da OpenAI ai prezzi di listino. Un'immagine mediana ha utilizzato circa 1.300 token in input e 370 in output. Batch Annotation aggiunge una commissione di elaborazione di Platform pari a 1,00 $ per 1.000 immagini, quindi un'elaborazione di 1.000 immagini costa circa 5,36 $ in totale.
Altri tre dettagli dell'esecuzione:
- Nessuna richiesta non riuscita. Tutte le richieste del benchmark a Terra sono state completate entro il limite di 115 secondi di Platform. GPT-6.1 Sol non ha completato 2 immagini e GPT-6 Astra 4.
- Le box grezze sono già valide. Prima del perfezionamento con SAM 3.1, le box di Terra ottengono 0.559 mAP50. Il perfezionamento porta il risultato a 0.560, quindi il modello svolge praticamente tutto il lavoro da solo.
- Nessuna configurazione necessaria. Sono bastati il livello di ragionamento predefinito e la richiesta standard di OpenAI.
Se il budget conta più degli ultimi punti di accuratezza, ci sono alternative più economiche. Claude Haiku 5.5 ottiene 0.429 a 0,37 $ per 1.000 immagini, mentre Gemini 3.5 Flash-Lite ottiene 0.380 a 1,77 $. I modelli ospitati come Qwen3.8 27B, Gemma 4 26B e SAM 3.1 Text non richiedono una chiave API, così come i tuoi modelli Ultralytics YOLO.
Dalla chiave OpenAI al dataset etichettato#
GPT-6.1 Terra è un modello guidato da prompt di classe per dataset di rilevamento con da 1 a 200 classi. Restituisce bounding box con i nomi delle classi del tuo dataset e puoi rivederle prima di salvarle. Per configurarlo:
- Crea una chiave nella pagina delle chiavi API di OpenAI.
- Aggiungila in Impostazioni > Chiavi API nell'area di lavoro di Platform che contiene il tuo dataset. OpenAI ti addebita direttamente i costi e Ultralytics non applica alcun ricarico ai token. Consulta la documentazione sulle chiavi dei provider per tutti i dettagli.
- Nell'editor di annotazione, passa alla modalità Smart e seleziona GPT-6.1 Terra nella sezione OpenAI del selettore di modelli.
- Premi Prevedi oppure
Pper etichettare l'immagine corrente. Prima di aumentare la scala, prova alcune immagini rappresentative dei tuoi dati. - Quando il risultato ti soddisfa, vai alla pagina del dataset e scegli Altre azioni > Annotazione batch per etichettare tutte le immagini non ancora etichettate in una volta sola. Platform salva prima una versione del dataset, così puoi ripristinare quella precedente.
- Rivedi le box, salvale e addestra un modello Ultralytics YOLO26 sul risultato, nella stessa area di lavoro. La documentazione sull'addestramento ti guida nella procedura.
Per approfondire come questi modelli si integrano nell'editor, leggi come Ultralytics Platform usa l'IA per automatizzare l'annotazione e la nostra introduzione ai modelli visione-linguaggio.
A chi conviene passare a GPT-6.1 Terra#
Imposta GPT-6.1 Terra come modello a pagamento predefinito per l'etichettatura generica degli oggetti. È il modello più accurato tra quelli che abbiamo valutato, il meno costoso dei primi sei e, nella nostra esecuzione, non ha mai fallito una richiesta.
È particolarmente efficace per creare una prima bozza di annotazioni su ecografie, risonanze magnetiche e immagini al microscopio da sottoporre alla revisione di esperti, nonché su scaffali di negozi affollati, dove le box false si accumulano rapidamente. Per le radiografie di qualsiasi tipo e per i difetti dei PCB, scegli un altro modello: Gemini 4 Argon, GPT-6 Astra o GPT-6.1 Sol ottengono risultati migliori.
Se al momento paghi Sol o Astra solo per etichettare immagini, passare a Terra è semplice: ottieni box migliori a meno della metà del costo di Sol.
Domande frequenti
Sì. Nel nostro benchmark UL37, GPT-6.1 Terra ottiene una media di 0.560 mAP50 su 36 dataset reali di rilevamento, il risultato più alto tra i 39 modelli nella Ultralytics VLM Leaderboard. È al primo posto anche con la metrica più rigorosa mAP50-95, con un punteggio di 0.345. I suoi punti deboli sono le immagini radiografiche e i difetti dei circuiti stampati.
Nel nostro benchmark, sì. Terra ottiene 0.560 mAP50 contro 0.514 di Sol, vince su 22 dei 36 dataset e costa 4,36 $ per 1.000 immagini contro 10,30 $, funzionando circa il doppio più velocemente. Sol rimane la scelta migliore tra i modelli OpenAI per il rilevamento dei difetti nei PCB.
Terra è in vantaggio con 0.560 contro 0.537 mAP50 e costa meno per immagine, ma la sfida è serrata: Terra vince su 19 dataset, Argon su 16 e uno finisce in parità. Senza il dataset di ecografie tiroidee TN5000, i due modelli sono praticamente alla pari. Scegli Terra per immagini mediche e documenti, e Argon per immagini aeree, subacquee, termiche e radiografie di sicurezza.
Circa 4,36 $ di costi OpenAI, in base al consumo di token dichiarato dal provider e alle tariffe di listino di 1 $ per milione di token in input e 5 $ per milione di token in output. La funzione di annotazione in batch di Ultralytics Platform aggiunge una tariffa di elaborazione di 1,00 $ ogni 1.000 immagini. Paghi direttamente OpenAI usando la tua chiave API.
È il modello più performante sui nostri otto dataset medici, con una mAP50 media di 0,505 e i punteggi più alti nelle ecografie della tiroide, nelle risonanze magnetiche dei tumori cerebrali e nella microscopia delle cellule del sangue. È molto meno efficace con le radiografie e ottiene risultati inferiori nelle endoscopie dei polipi del colon. Usalo per creare bozze di riquadri da sottoporre alla revisione di esperti, mai come strumento diagnostico.
No. Platform lo usa con il livello di ragionamento predefinito di OpenAI, medio, e con la stessa richiesta di riquadri usata per tutti i modelli OpenAI; SAM 3.1 poi perfeziona ogni riquadro. Nel nostro benchmark la richiesta mediana ha richiesto 5,1 secondi e non si è verificato alcun errore.









