Jetson Orin Nano Super vs Raspberry Pi 5 per il rilevamento degli oggetti con YOLO26
Inferenza di YOLO26n: 4.57 ms su Jetson Orin Nano Super (TensorRT FP16) contro 67.03 ms su CPU Pi 5, in test separati. Scegli in base al modello, agli FPS e alle telecamere.
 Onuralp Sezer17 min di lettura
Dovresti eseguire il rilevamento degli oggetti su un Raspberry Pi 5 o su un NVIDIA Jetson Orin Nano? Per una telecamera, un obiettivo di frame rate basso e un modello piccolo, la CPU di un Pi 5 può bastare: nel nostro benchmark pubblicato, Ultralytics YOLO26n esportato in NCNN richiede 67.03 ms di inferenza per immagine sui suoi quattro core Arm, circa 15 frame al secondo in inferenza. Se ti servono più telecamere, un modello più grande o più margine sul frame rate di quanto possa offrirti il Pi, Jetson è la scelta giusta: su un Jetson Orin Nano Super Developer Kit, lo stesso modello richiede 4.57 ms come motore TensorRT FP16.
Ultralytics pubblica questo confronto e sviluppa YOLO26, che funziona su entrambe le schede; non produciamo nessuna delle due schede. I nostri dati Jetson provengono dall'Orin Nano Super Developer Kit, il kit di sviluppo Orin entry-level di NVIDIA, e i dati Pi da un Raspberry Pi 5, in test separati. Molte persone cercano ancora "Jetson Nano", la scheda originale del 2019. Esegue YOLO26 tramite JetPack 4, ma la nostra guida Jetson non include benchmark di YOLO26 per questa scheda, che viene quindi citata qui solo per le specifiche.
Di seguito: confronto tra le schede in base alle dimensioni del modello, al frame rate obiettivo e al numero di flussi delle telecamere; perché gli FPS diminuiscono quando aggiungi telecamere; come misurare entrambe le schede autonomamente; e quale scheda è adatta al tuo progetto. Le istruzioni di configurazione sono nella guida NVIDIA Jetson e nella guida Raspberry Pi, mentre la nostra guida pratica sul rilevamento degli oggetti su CPU Raspberry Pi 5 approfondisce il lato Pi.
Pi 5 esegue YOLO sulla CPU; Orin Nano Super mette a disposizione una GPU#
Le schede risolvono lo stesso problema con silicio diverso. Raspberry Pi 5 è un computer generico con quattro core Arm Cortex-A76 e senza acceleratore AI dedicato, quindi i nostri benchmark sul Pi eseguono YOLO sulla CPU. Jetson Orin Nano Super Developer Kit abbina un modulo Orin Nano, basato su una GPU Ampere, a una scheda carrier, mentre il runtime TensorRT di NVIDIA compila i modelli per quella GPU. È una piattaforma edge AI progettata per questo tipo di carico di lavoro.
| Jetson Nano 4GB (2019) | Jetson Orin Nano Super | Raspberry Pi 5 | |
|---|---|---|---|
| Elaborazione per YOLO | GPU Maxwell a 128 core | GPU Ampere a 1024 core, 32 Tensor Cores | CPU Arm Cortex-A76 a 4 core |
| CPU | Cortex-A57 a 4 core, 1.43 GHz | Cortex-A78AE a 6 core, fino a 1.7 GHz | Cortex-A76 a 4 core, fino a 2.4 GHz |
| Memoria | 4 GB LPDDR4, 25.6 GB/s | 8 GB LPDDR5, 102 GB/s | Varia in base al modello |
| Prestazioni AI (valore massimo dichiarato da NVIDIA) | 472 GFLOPS | 67 TOPS INT8 sparsi | — |
| JetPack / sistema operativo | Solo JetPack 4 | Da JetPack 5 a 7 | Raspberry Pi OS |
| Percorso di distribuzione Ultralytics | TensorRT, incluso DeepStream | TensorRT (il più veloce nel nostro benchmark) | NCNN (il più veloce nel nostro benchmark) |
Specifiche, non misurazioni, verificate il 19 novembre 2026. I valori massimi dichiarati da NVIDIA usano formati numerici diversi e non sono quindi direttamente confrontabili. I 67 TOPS di Orin Nano Super sono un valore INT8 sparso; NVIDIA dichiara 33 TOPS densi. Le righe Jetson provengono dalle tabelle di confronto e di JetPack nella guida NVIDIA Jetson e dalla guida DeepStream; le righe Pi 5 dalla documentazione Raspberry Pi.
Anche il consumo energetico incide sulla scelta. NVIDIA dichiara per Orin Nano Super Developer Kit un consumo da 7 W a 25 W. Quando la scheda è configurata con una versione abilitata per Super, Orin Nano 8GB offre modalità di alimentazione da 15 W, 25 W e MAXN SUPER; con la configurazione predefinita mantiene le modalità originali da 7 W e 15 W. Qualunque scheda tu scelga, misura l'assorbimento dell'intero sistema con le telecamere collegate: è quello che l'alimentatore e il contenitore dovranno supportare.
Valuta il costo dell'intera configurazione, non solo quello della scheda: archiviazione, alimentazione, raffreddamento e telecamere si sommano per entrambe. Raspberry Pi ha aumentato più volte i prezzi di Pi 5 nel 2026, con l'aumento dei costi della memoria. A novembre 2026, il Pi 5 da 2GB costa $77.50 e la scheda da 16GB costa $385. Per informazioni aggiornate su prezzi e disponibilità di Jetson, consulta la pagina dei kit di sviluppo NVIDIA e aggiungi il costo di qualsiasi acceleratore necessario al Pi, come il Raspberry Pi AI HAT+. Per la produzione, NVIDIA vende moduli Jetson da usare con una scheda carrier progettata da te; il kit di sviluppo che abbiamo sottoposto a benchmark è destinato allo sviluppo e alla prototipazione.
La CPU di Pi 5 è adatta ai carichi di lavoro YOLO26n a FPS bassi#
Pi 5 gestisce il rilevamento con una sola telecamera senza hardware aggiuntivo se il frame rate richiesto è modesto. Nel benchmark Ultralytics (esportazione FP32, input da 640 pixel, COCO128, Ultralytics 8.4.108, solo tempo di inferenza), NCNN è stato il formato di esportazione più veloce: 67.03 ms per immagine con YOLO26n e 0.4784 mAP50-95. Sono circa 15 FPS in inferenza, adeguati per una postazione di conteggio, una telecamera su uno scaffale o un prototipo di robotica che non deve gestire movimenti rapidi. Valida l'intera pipeline della telecamera, non solo l'inferenza. Arm pubblica anche un runtime open source per YOLO26n su Pi 5, che nei propri test ha misurato più veloce di NCNN; la nostra guida pratica per Raspberry Pi 5 confronta i due.
È con i modelli più grandi che Pi mostra i suoi limiti. Il modello più grande YOLO26s richiede 172.88 ms con NCNN su Pi 5, meno di 6 FPS in inferenza. Il confronto tra più formati nella guida Raspberry Pi (Ultralytics 8.4.108) riguarda solo n e s. Il precedente confronto ONNX (Ultralytics 8.4.14) riporta anche m, l e x; in quel test, YOLO26m richiede 993.78 ms. Se gli oggetti piccoli o le classi difficili da distinguere ti spingono a scegliere un modello più grande o una dimensione di input maggiore, prova il modello sulla scheda prima di decidere.
Aggiungere un AI HAT+ a Pi 5#
C'è una terza configurazione da considerare: un Pi 5 con AI HAT+ di Raspberry Pi, che aggiunge un acceleratore Hailo in versione da 13 TOPS o 26 TOPS. Nel benchmark di integrazione Hailo di Ultralytics (Ultralytics 8.4.174, COCO128), YOLO26n esportato per la versione Hailo-8 da 26 TOPS richiede 21.7 ms per immagine con 0.455 mAP50-95, contro i 364.6 ms del modello PyTorch non esportato sullo stesso Pi. Il test non specifica la dimensione di input e usa INT8, quindi consideralo un benchmark separato, non una riga del confronto qui sotto. I modelli Hailo richiedono una fase di compilazione: controlla quindi l'accuratezza sulle tue immagini dopo l'esportazione.
Su Orin Nano Super, da YOLO26n a YOLO26l richiedono meno di 18 ms#
Su Jetson, i modelli più grandi diventano praticabili. Nei benchmark Ultralytics su Orin Nano Super Developer Kit (input da 640 pixel, COCO128, Ultralytics 8.4.33, solo inferenza), ogni dimensione, da n a l, richiede meno di 18 ms di inferenza per immagine con un motore TensorRT FP16:
| Modello YOLO26 | CPU Raspberry Pi 5 (ms/immagine) | Orin Nano Super, TensorRT FP16 (ms/immagine) | Orin Nano Super mAP50-95, FP16 |
|---|---|---|---|
| YOLO26n | 67.03 (NCNN FP32, 8.4.108) | 4.57 | 0.4800 |
| YOLO26s | 172.88 (NCNN FP32, 8.4.108) | 7.17 | 0.5649 |
| YOLO26m | 993.78 (test ONNX precedente, 8.4.14) | 13.59 | 0.6225 |
| YOLO26l | 1259.46 (test ONNX precedente, 8.4.14) | 17.42 | 0.6225 |
Risultati pubblicati da test separati. Orin Nano Super: Ultralytics 8.4.33. Tutte le righe con input da 640 pixel e solo tempo di inferenza, senza pre- e post-elaborazione.
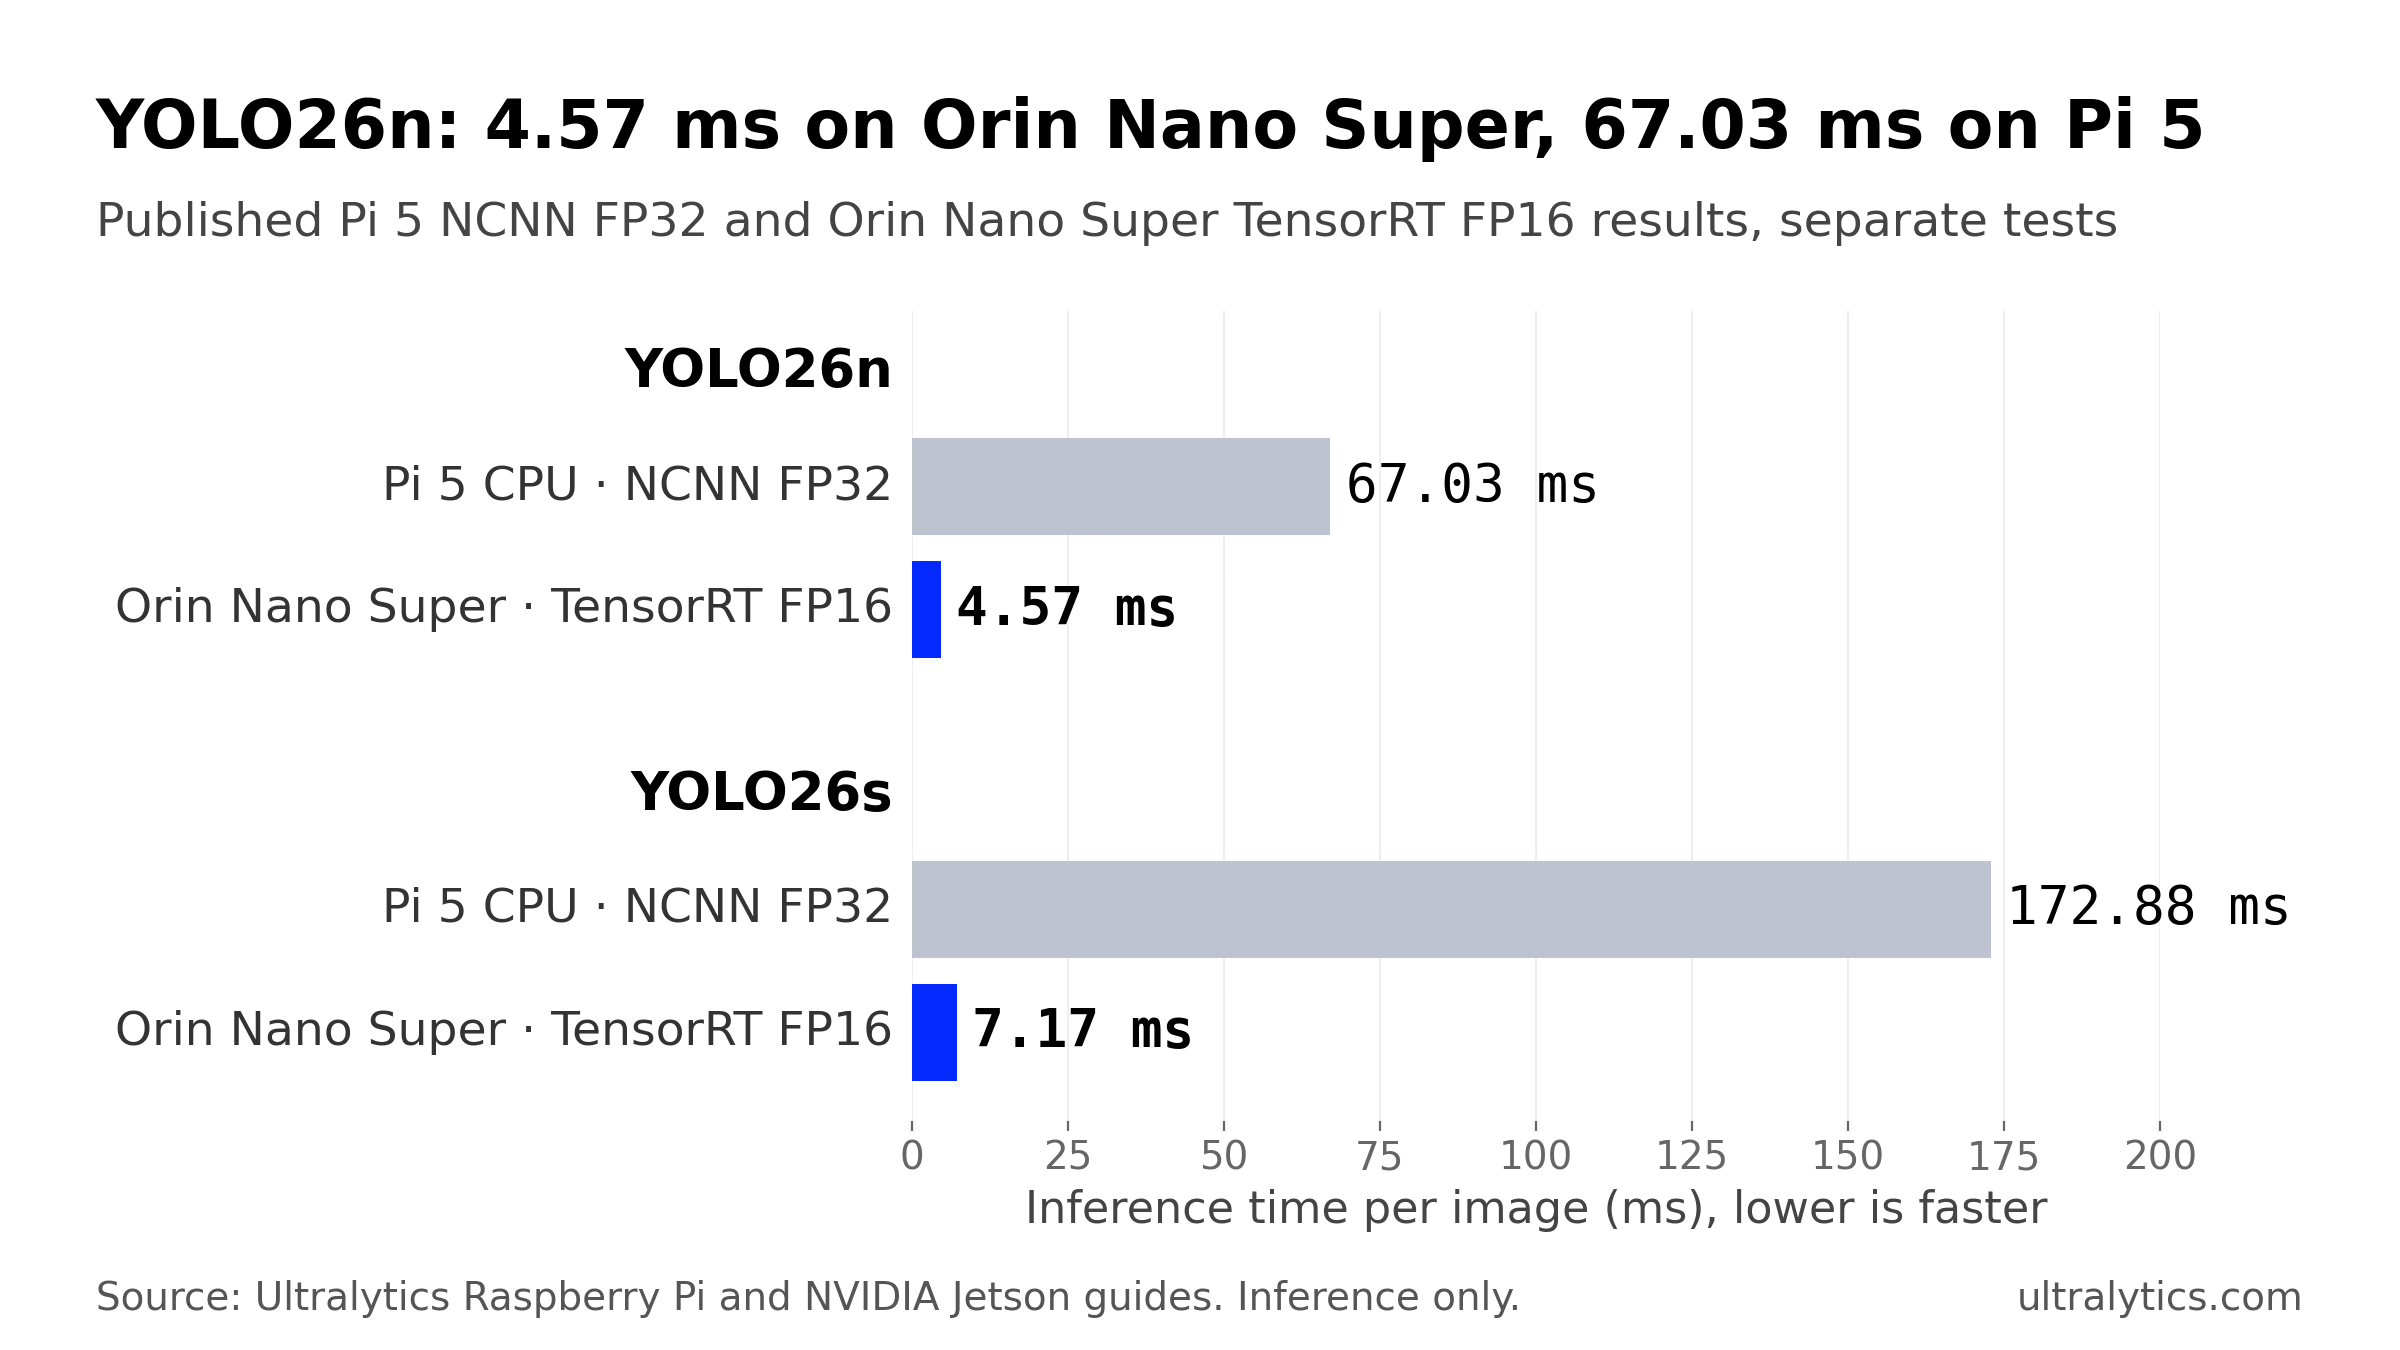
Risultati pubblicati NCNN FP32 e TensorRT FP16 da test separati: Raspberry Pi 5 con Ultralytics 8.4.108, Orin Nano Super Developer Kit con Ultralytics 8.4.33. Solo inferenza, senza pre- e post-elaborazione. Fonte: guide Ultralytics Raspberry Pi e NVIDIA Jetson.
Per YOLO26n, il tempo di inferenza è inferiore di circa il 93% rispetto alla CPU di Pi 5. Parte del divario è dovuta alla precisione, quindi confronta anche le esportazioni FP32: il motore TensorRT FP32 di Orin Nano Super richiede 7.53 ms, quasi nove volte meno dell'esportazione NCNN FP32 del Pi, anche se i runtime e le versioni dei test sono diversi. Il dato più significativo riguarda YOLO26m: 0.6225 mAP50-95 a 13.59 ms, mentre nel precedente test ONNX la CPU di Pi 5 eseguiva il modello a circa un fotogramma al secondo.
INT8 riduce ancora un po' i tempi. YOLO26n scende a 3.80 ms come motore INT8, ma il suo mAP50-95 passa da 0.4800 a 0.4490 su COCO128: parti da FP16 e passa alla quantizzazione INT8 solo se FP16 non rispetta il tuo budget e puoi calibrare sulle immagini delle tue telecamere. La nostra lezione dell'Academy sull'ottimizzazione con TensorRT illustra questa scelta.
Gli FPS diminuiscono quando aggiungi telecamere perché tutti i flussi condividono lo stesso budget#
Uno scenario frequente quando si aumenta la scala: una telecamera funziona senza problemi, ma il frame rate elaborato cala quando ne aggiungi una terza o una quarta. Ogni fotogramma richiede decodifica, pre-elaborazione, inferenza e post-elaborazione, e tutte le telecamere attingono alle stesse risorse di calcolo. Su Pi 5, gli stessi quattro core CPU decodificano il video ed eseguono il modello, quindi ogni flusso aggiuntivo sottrae tempo a entrambe le attività.
Ultralytics gestisce le operazioni tecniche. Elenca una sorgente per riga in un file .streams e passalo alla modalità Predict: ogni flusso ottiene il proprio thread di lettura e il loader raggruppa in un batch l'ultimo fotogramma di ogni telecamera; di conseguenza, una sorgente lenta o interrotta può bloccare il batch. I backend che accettano batch lo eseguono con un unico passaggio forward; NCNN elabora i fotogrammi uno alla volta, mentre con un motore TensorRT a forma fissa il batch viene suddiviso o completato con padding per adattarsi alla dimensione di esportazione. Per impostazione predefinita (stream_buffer=False), se il modello è lento salta i fotogrammi non più aggiornati invece di accodarli: così il backlog nell'applicazione resta breve, anche se il buffering nella telecamera, nel decoder o nella rete può comunque aggiungere latenza.
La latenza di una singola immagine è un punto di partenza, non un conteggio delle telecamere. Il batching modifica il throughput, mentre decodifica, tracking e disegno comportano costi aggiuntivi. La lezione sull'inferenza multi-stream di Ultralytics Academy spiega la regola di dimensionamento: i flussi per dispositivo sono all'incirca pari al throughput sostenuto alla dimensione di batch reale diviso per gli FPS richiesti da ogni flusso, con un margine del 20-30% per i picchi. Misura il throughput sulla scheda con le telecamere collegate, come descritto nella sezione pratica qui sotto. Per le pipeline multi-telecamera su Jetson, DeepStream esegue più sorgenti tramite un unico motore TensorRT in un'applicazione a riquadri.
Scegli in base agli FPS misurati per telecamera, alle dimensioni del modello e all'accuratezza#
Inizia con la scheda meno costosa che potrebbe funzionare, misurala con le tue telecamere e passa a una superiore solo se non basta:
| Se le tue misurazioni mostrano che… | Inizia con |
|---|---|
| YOLO26n soddisfa i tuoi requisiti di accuratezza e FPS per telecamera | CPU Pi 5 con NCNN. Un'attività a bassi FPS potrebbe gestire più di una telecamera. |
| Il Pi non raggiunge il frame rate richiesto, ma vuoi continuare a usarlo | Un Pi 5 con un acceleratore come Hailo-8 AI HAT+ o DEEPX DX-M1. Entrambi eseguono modelli quantizzati e richiedono una fase di compilazione, quindi controlla l'accuratezza dopo l'esportazione. |
| Ti serve un modello più grande a FPS più elevati, più flussi di quanti il Pi riesca a sostenere o tempo CPU per altri software | Jetson Orin Nano Super con TensorRT; passa a Orin NX o AGX Orin se il throughput misurato non è sufficiente. |
Il frame rate è un requisito aziendale prima ancora di essere un valore di benchmark. La nostra guida agli FPS nella computer vision spiega come determinarli in base alla velocità di ciò che osservi, mentre scegliere il dispositivo edge giusto tratta schede diverse da queste due.
Misura entrambe le schede con le tue telecamere#
I valori qui sopra sono stati misurati in condizioni controllate; i tuoi varieranno in base al raffreddamento, alla modalità di alimentazione, all'immagine del sistema operativo, alla versione del software e al tuo modello. Il pacchetto Ultralytics usa la stessa API su entrambe le schede, quindi puoi eseguire la stessa misurazione su ciascuna. I comandi qui sotto sono stati verificati con Ultralytics 8.4.215.
Passaggio 1: confronta i formati di esportazione su ciascuna scheda#
Esegui yolo benchmark model=yolo26n.pt data=coco128.yaml imgsz=640 sulla scheda. La modalità Benchmark riporta dimensioni, mAP50-95 e tempo di inferenza per ogni formato di esportazione supportato dalla scheda; aggiungi quantize=16 o quantize=8 per misurare FP16 o INT8 quando il formato lo supporta. Su Orin Nano Super Developer Kit configurato con una versione abilitata per Super, seleziona prima la modalità di alimentazione MAXN SUPER; nel post di NVIDIA sulla Super Mode per JetPack 6.2 su Orin Nano, corrisponde a sudo nvpmodel -m 2. Poi esegui sudo jetson_clocks. Controlla le temperature durante le esecuzioni lunghe.
Passaggio 2: esporta il formato più veloce su ciascuna scheda#
Su Raspberry Pi 5, esporta in NCNN seguendo la nostra guida pratica per Raspberry Pi 5. Su Jetson, crea il motore direttamente sul dispositivo, perché i motori TensorRT dipendono dalla GPU e dalla versione di TensorRT usate per crearli. Un motore esportato senza dynamic ha una forma di input fissa. Un'opzione consiste nell'impostare batch sul numero di telecamere e riesportare con un imgsz più piccolo se ti serve più velocità:
from ultralytics import YOLO

# Solo Jetson: richiede una GPU NVIDIA. Motore TensorRT FP16, 640 pixel, batch di quattro telecamere
YOLO("yolo26n.pt").export(format="engine", quantize=16, imgsz=640, batch=4)  # writes yolo26n.engine
Passaggio 3: misura gli FPS elaborati per telecamera#
Inserisci un URL RTSP per riga in cams.streams, esegui su di esso il modello della scheda per circa un minuto e confronta gli FPS elaborati di ciascuna telecamera con il frame rate trasmesso. Il timer parte dopo il primo batch completo, una volta connessi i flussi e a regime il modello, e si ferma al completamento di un batch:
import time
from collections import Counter

from ultralytics import YOLO

model = YOLO("yolo26n.engine")  # on the Pi 5: YOLO("yolo26n_ncnn_model")
cameras = open("cams.streams").read().split()
n_streams = len(cameras)

frames, start = Counter(), None
for i, result in enumerate(model("cams.streams", stream=True)):
    if i < n_streams:  # first batch: connection and warm-up
        if i == n_streams - 1:
            start = time.perf_counter()
        continue
    frames[i % n_streams] += 1  # results arrive in stream order within each batch
    if (i + 1) % n_streams == 0 and time.perf_counter() - start > 60:
        break

elapsed = time.perf_counter() - start
for slot, count in sorted(frames.items()):
    print(f"{cameras[slot]}: {count / elapsed:.1f} processed FPS")
Questa misurazione rileva il throughput dei risultati elaborati da questa pipeline. Se, man mano che aggiungi flussi, gli FPS elaborati di una telecamera restano molto al di sotto del suo frame rate, la scheda non riesce a tenere il passo. Verifica con contatori espliciti dei fotogrammi persi per flusso, usando l'esempio producer-consumer della lezione multi-stream dell'Academy; aggiungi il tracking o il disegno richiesti dall'applicazione, poi riesporta con un imgsz più piccolo, passa a un modello più piccolo o a un'esportazione più veloce, oppure aggiorna l'hardware, quindi ripeti la misurazione.
Se preferisci non configurare un ambiente di compilazione, la scheda Export di Ultralytics Platform crea motori TensorRT per i dispositivi Jetson, incluso Orin Nano 8GB Super. Le configurazioni Orin vengono create su AGX Orin e la convalida su Orin Nano è ancora in sospeso: verifica quindi che TensorRT e il runtime CUDA del tuo dispositivo siano compatibili con il motore e convalida ogni motore sul dispositivo di destinazione. Per un confronto tra ONNX Runtime e TensorRT su GPU NVIDIA, consulta ONNX vs TensorRT.
Quale scheda scegliere#
Scegli Raspberry Pi 5 quando YOLO26n soddisfa i tuoi requisiti di accuratezza e gli FPS elaborati che misuri sulla scheda sono sufficienti per tutte le telecamere necessarie. Con circa 15 FPS in inferenza, è una soluzione semplice per casse di negozi, conteggio su nastri trasportatori, telecamere per la fauna selvatica e per la casa, e primi prototipi di robot. Aggiungi un acceleratore se ti servono più fotogrammi ma vuoi continuare a usare Pi.
Scegli Jetson Orin Nano Super quando ti serve un modello più grande di nano a un frame rate utilizzabile, più flussi di quanti il Pi riesca a sostenere o risorse CPU disponibili per tracking, navigazione e il resto dell'applicazione. Da YOLO26s a YOLO26l richiedono meno di 18 ms di inferenza per immagine e questo margine ti permette di aggiungere telecamere. Misura l'applicazione completa per verificarlo.
Il ruolo di Ultralytics#
Ultralytics non produce nessuna delle due schede: sviluppiamo i modelli e gli strumenti che funzionano su entrambe. Gli stessi pesi YOLO26 si esportano in NCNN per Pi 5, in Hailo per un Pi con AI HAT+ e in TensorRT per Jetson; puoi quindi prototipare su Pi e passare a Jetson quando il carico di lavoro cresce, senza riaddestrare. Convalida l'accuratezza dopo ogni esportazione. Ultralytics Platform gestisce le fasi precedenti alla distribuzione: annota un dataset, esegui il training nel cloud se il progetto richiede più risorse di training di quelle disponibili localmente ed esporta per una delle due schede.
Limiti: i benchmark pubblicati riguardano solo l'inferenza e sono stati misurati sui dispositivi di test indicati, non sulle tue telecamere, nel tuo contenitore o sul tuo modulo di produzione; inoltre, la nostra guida Jetson non include risultati di YOLO26 per il Jetson Nano originale. Ultralytics YOLO è disponibile con licenza AGPL-3.0 o Ultralytics Enterprise License; consulta le licenze Ultralytics per capire quale serve alla tua distribuzione.
Domande frequenti
È molto più veloce per immagine. Nei nostri benchmark pubblicati, condotti in test separati, YOLO26n richiede 4.57 ms come motore TensorRT FP16 su Jetson Orin Nano Super Developer Kit, contro 67.03 ms con NCNN sulla CPU di Raspberry Pi 5 (input da 640 pixel, solo inferenza); YOLO26m richiede 13.59 ms su Jetson. La necessità di queste prestazioni dipende dal modello, dal numero di telecamere e dagli FPS obiettivo: se le tue misurazioni confermano che Pi 5 soddisfa i requisiti, è la soluzione più semplice.
No. Il Jetson Nano originale è stato lanciato nel 2019 con una GPU Maxwell a 128 core e 4 GB di memoria, e supporta solo JetPack 4. Jetson Orin Nano è un modulo più recente con una GPU Ampere a 1024 core; il Jetson Orin Nano Super Developer Kit sottoposto al nostro benchmark ha 8 GB di memoria e supporta JetPack dalla versione 5 alla 7. Il confronto delle prestazioni in questo articolo riguarda Orin Nano Super, non il Nano originale.
Sì. Jetson Nano del 2019 supporta JetPack 4, Ultralytics fornisce un'immagine Docker per JetPack 4 e la nostra guida DeepStream per YOLO26 con TensorRT è stata testata su Jetson Nano 4GB con JetPack 4.6.4. La nostra guida Jetson non include un benchmark di YOLO26 per questa scheda e il suo hardware è molto meno potente di quello di Orin Nano Super.
Tutti i flussi condividono le risorse di calcolo della scheda: ogni telecamera aggiunta richiede la propria decodifica, pre-elaborazione, inferenza e post-elaborazione. Con un file
.streams, Ultralytics raggruppa in batch i fotogrammi di tutte le telecamere e salta quelli non più aggiornati quando il modello rimane indietro; di conseguenza, gli FPS elaborati per ogni telecamera possono diminuire quando la pipeline condivisa diventa il collo di bottiglia. Un'esportazione più veloce, un modello più piccolo oimgsz, oppure hardware più potente li aumentano.Sì. Esegui il training una volta, poi esporta gli stessi pesi con
format="ncnn"per Pi 5 eformat="engine"per Jetson, creando il motore TensorRT sul dispositivo di destinazione o per quel dispositivo. Convalida l'accuratezza sui tuoi dati dopo ogni esportazione.
Scritto da
Senior Machine Learning Engineer · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









