Семантическая сегментация и сегментация экземпляров: как выбрать подходящую задачу
Семантическая сегментация присваивает класс каждому пикселю, а сегментация экземпляров выделяет каждый объект отдельно. Узнай, что нужно твоему проекту в области компьютерного зрения и почему.
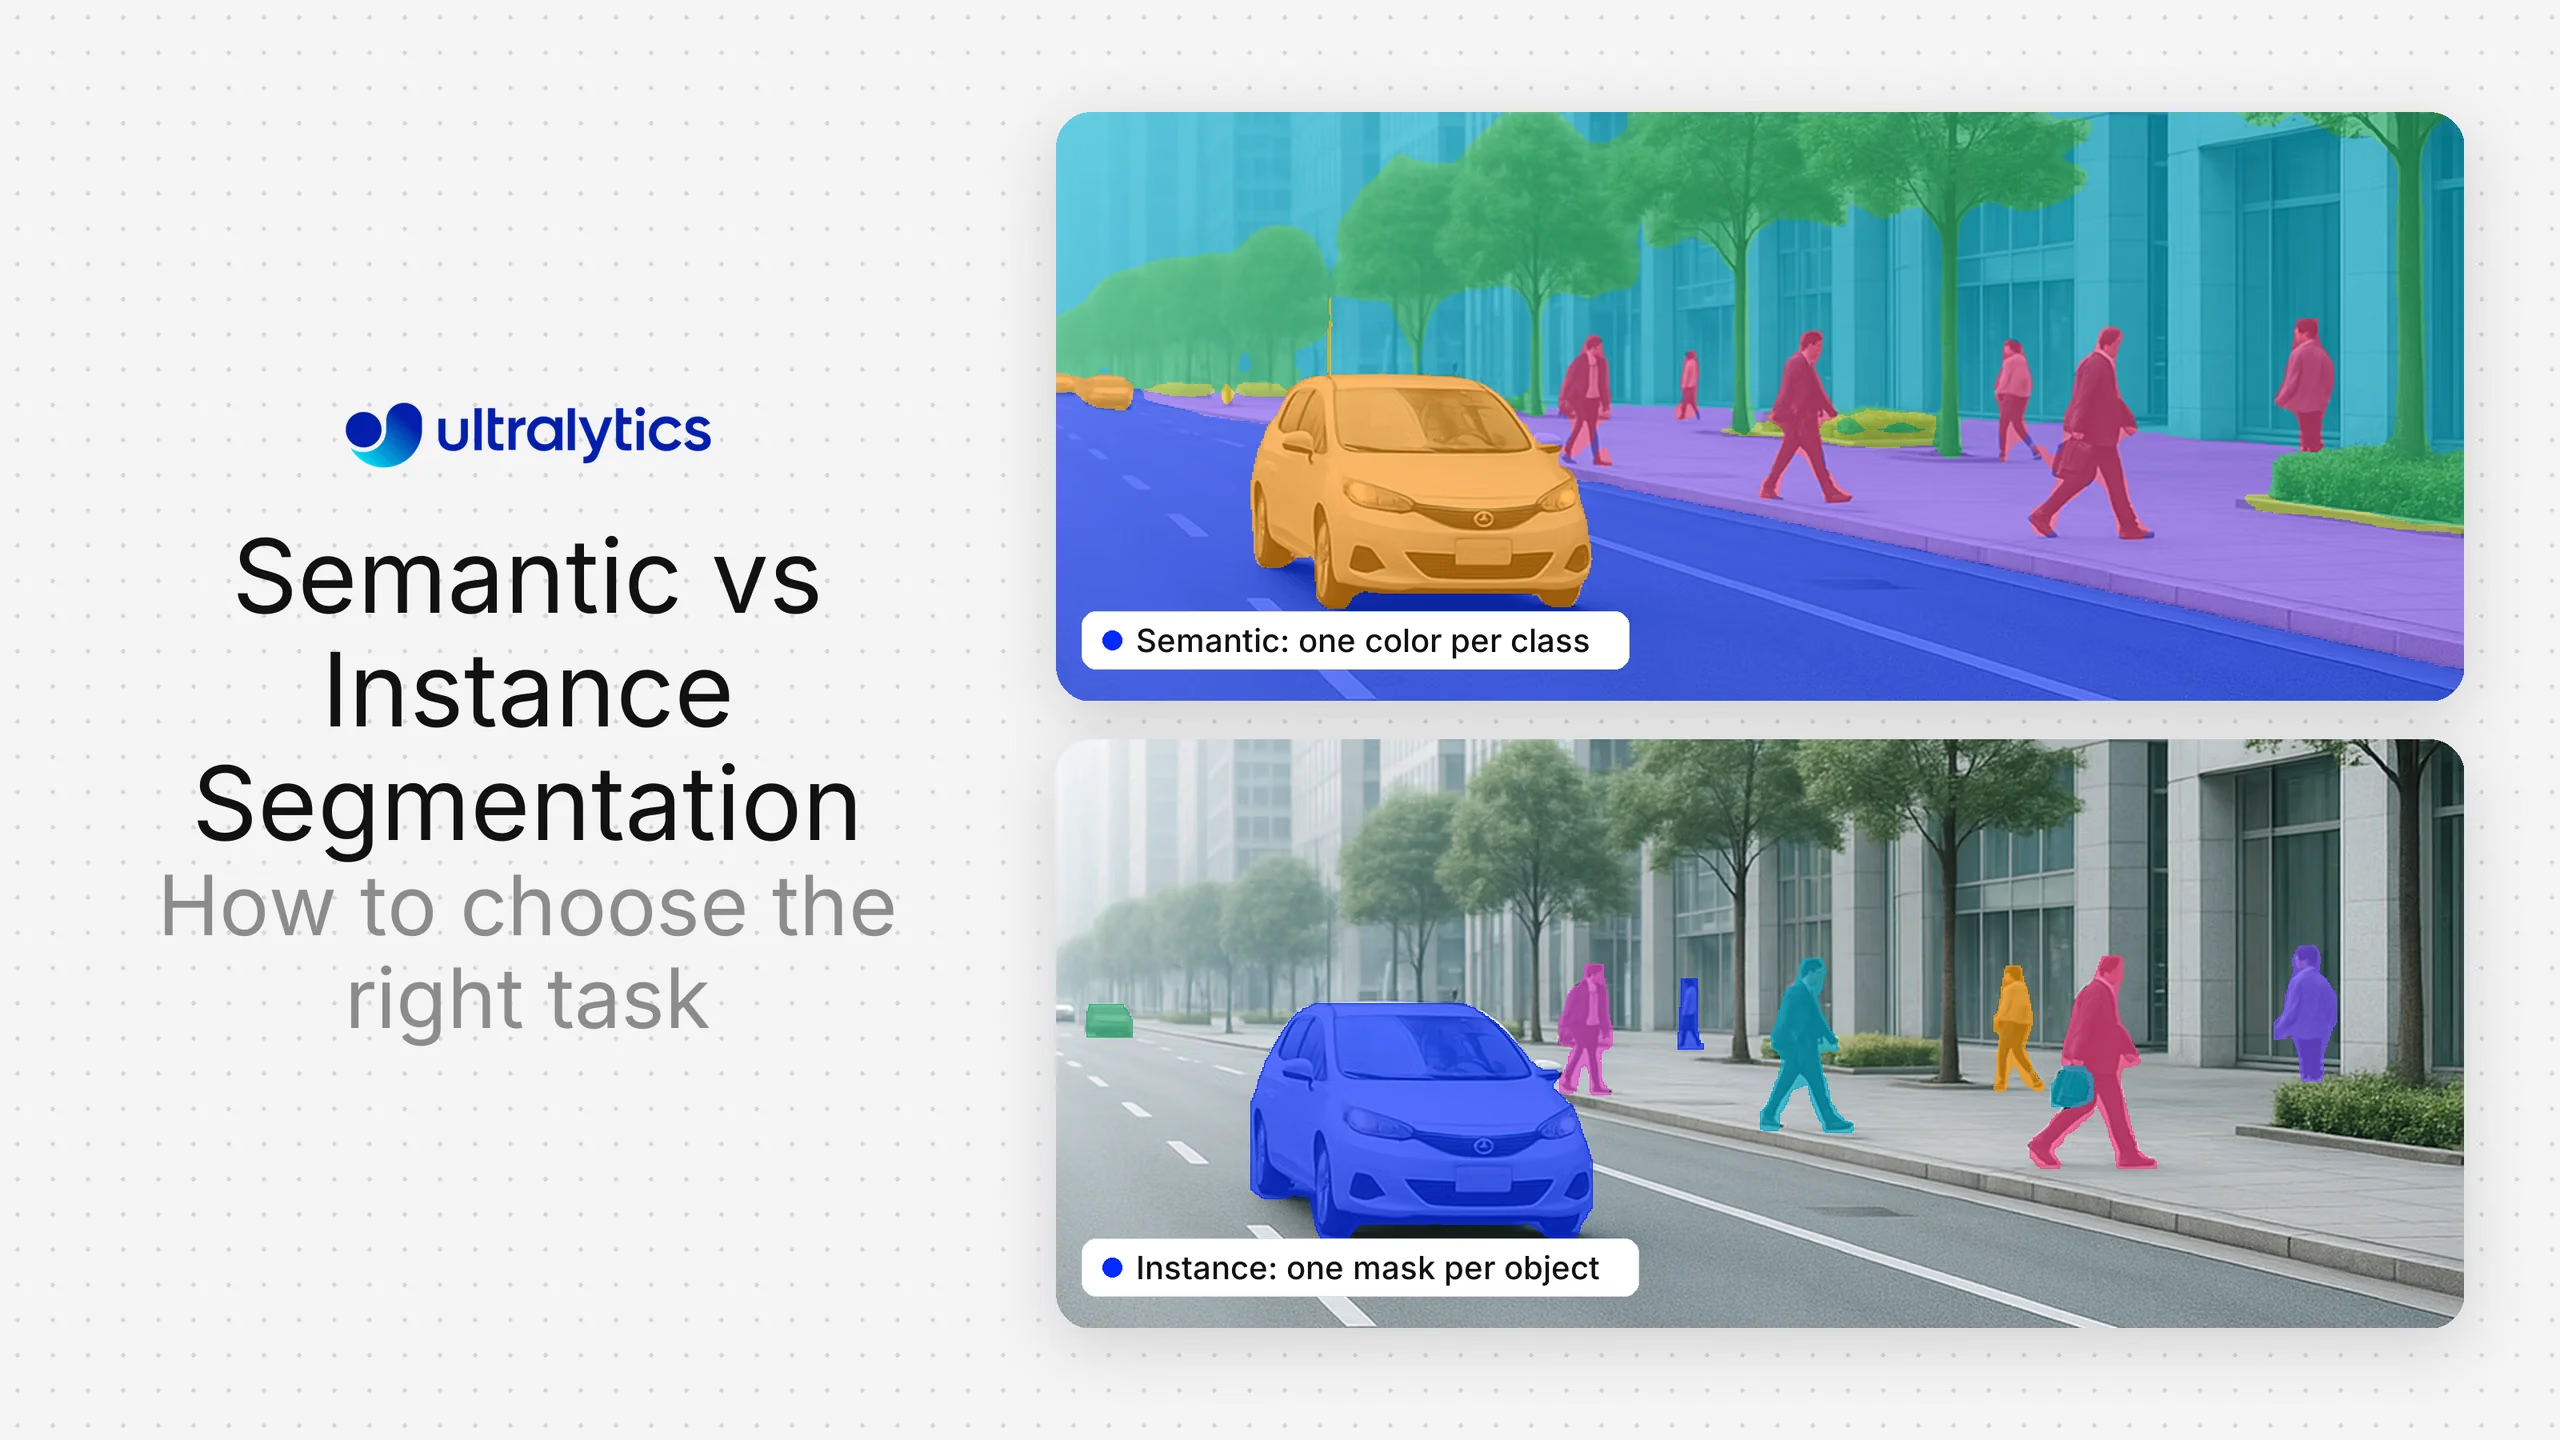
Семантическая сегментация и сегментация экземпляров обе размечают изображения на уровне пикселей, но отвечают на разные вопросы. Семантическая сегментация присваивает класс каждому пикселю, поэтому все автомобили на сцене объединяются в одну область «автомобиль». Сегментация экземпляров разделяет каждый объект, поэтому каждый автомобиль получает собственную маску. Чтобы выбрать подход, ответь на один вопрос: нужно ли тебе знать, что находится в каждом пикселе, или какому объекту принадлежит каждый пиксель? Это руководство поможет определиться. В нём также рассказывается о стоимости разметки каждой задачи и способах её оценки. Ultralytics YOLO поддерживает обе задачи в рамках одной платформы.
Главное различие в одной строке#
- Семантическая сегментация относит каждый пиксель к категории, например к дороге, небу, человеку или автомобилю. Объекты одного класса объединяются в одну область. См. статью глоссария о семантической сегментации.
- Сегментация экземпляров находит каждый отдельный объект и присваивает ему собственную маску и ID. Обычно она охватывает объекты, которые можно посчитать, и игнорирует фон, например небо или траву. См. статью глоссария о сегментации экземпляров.
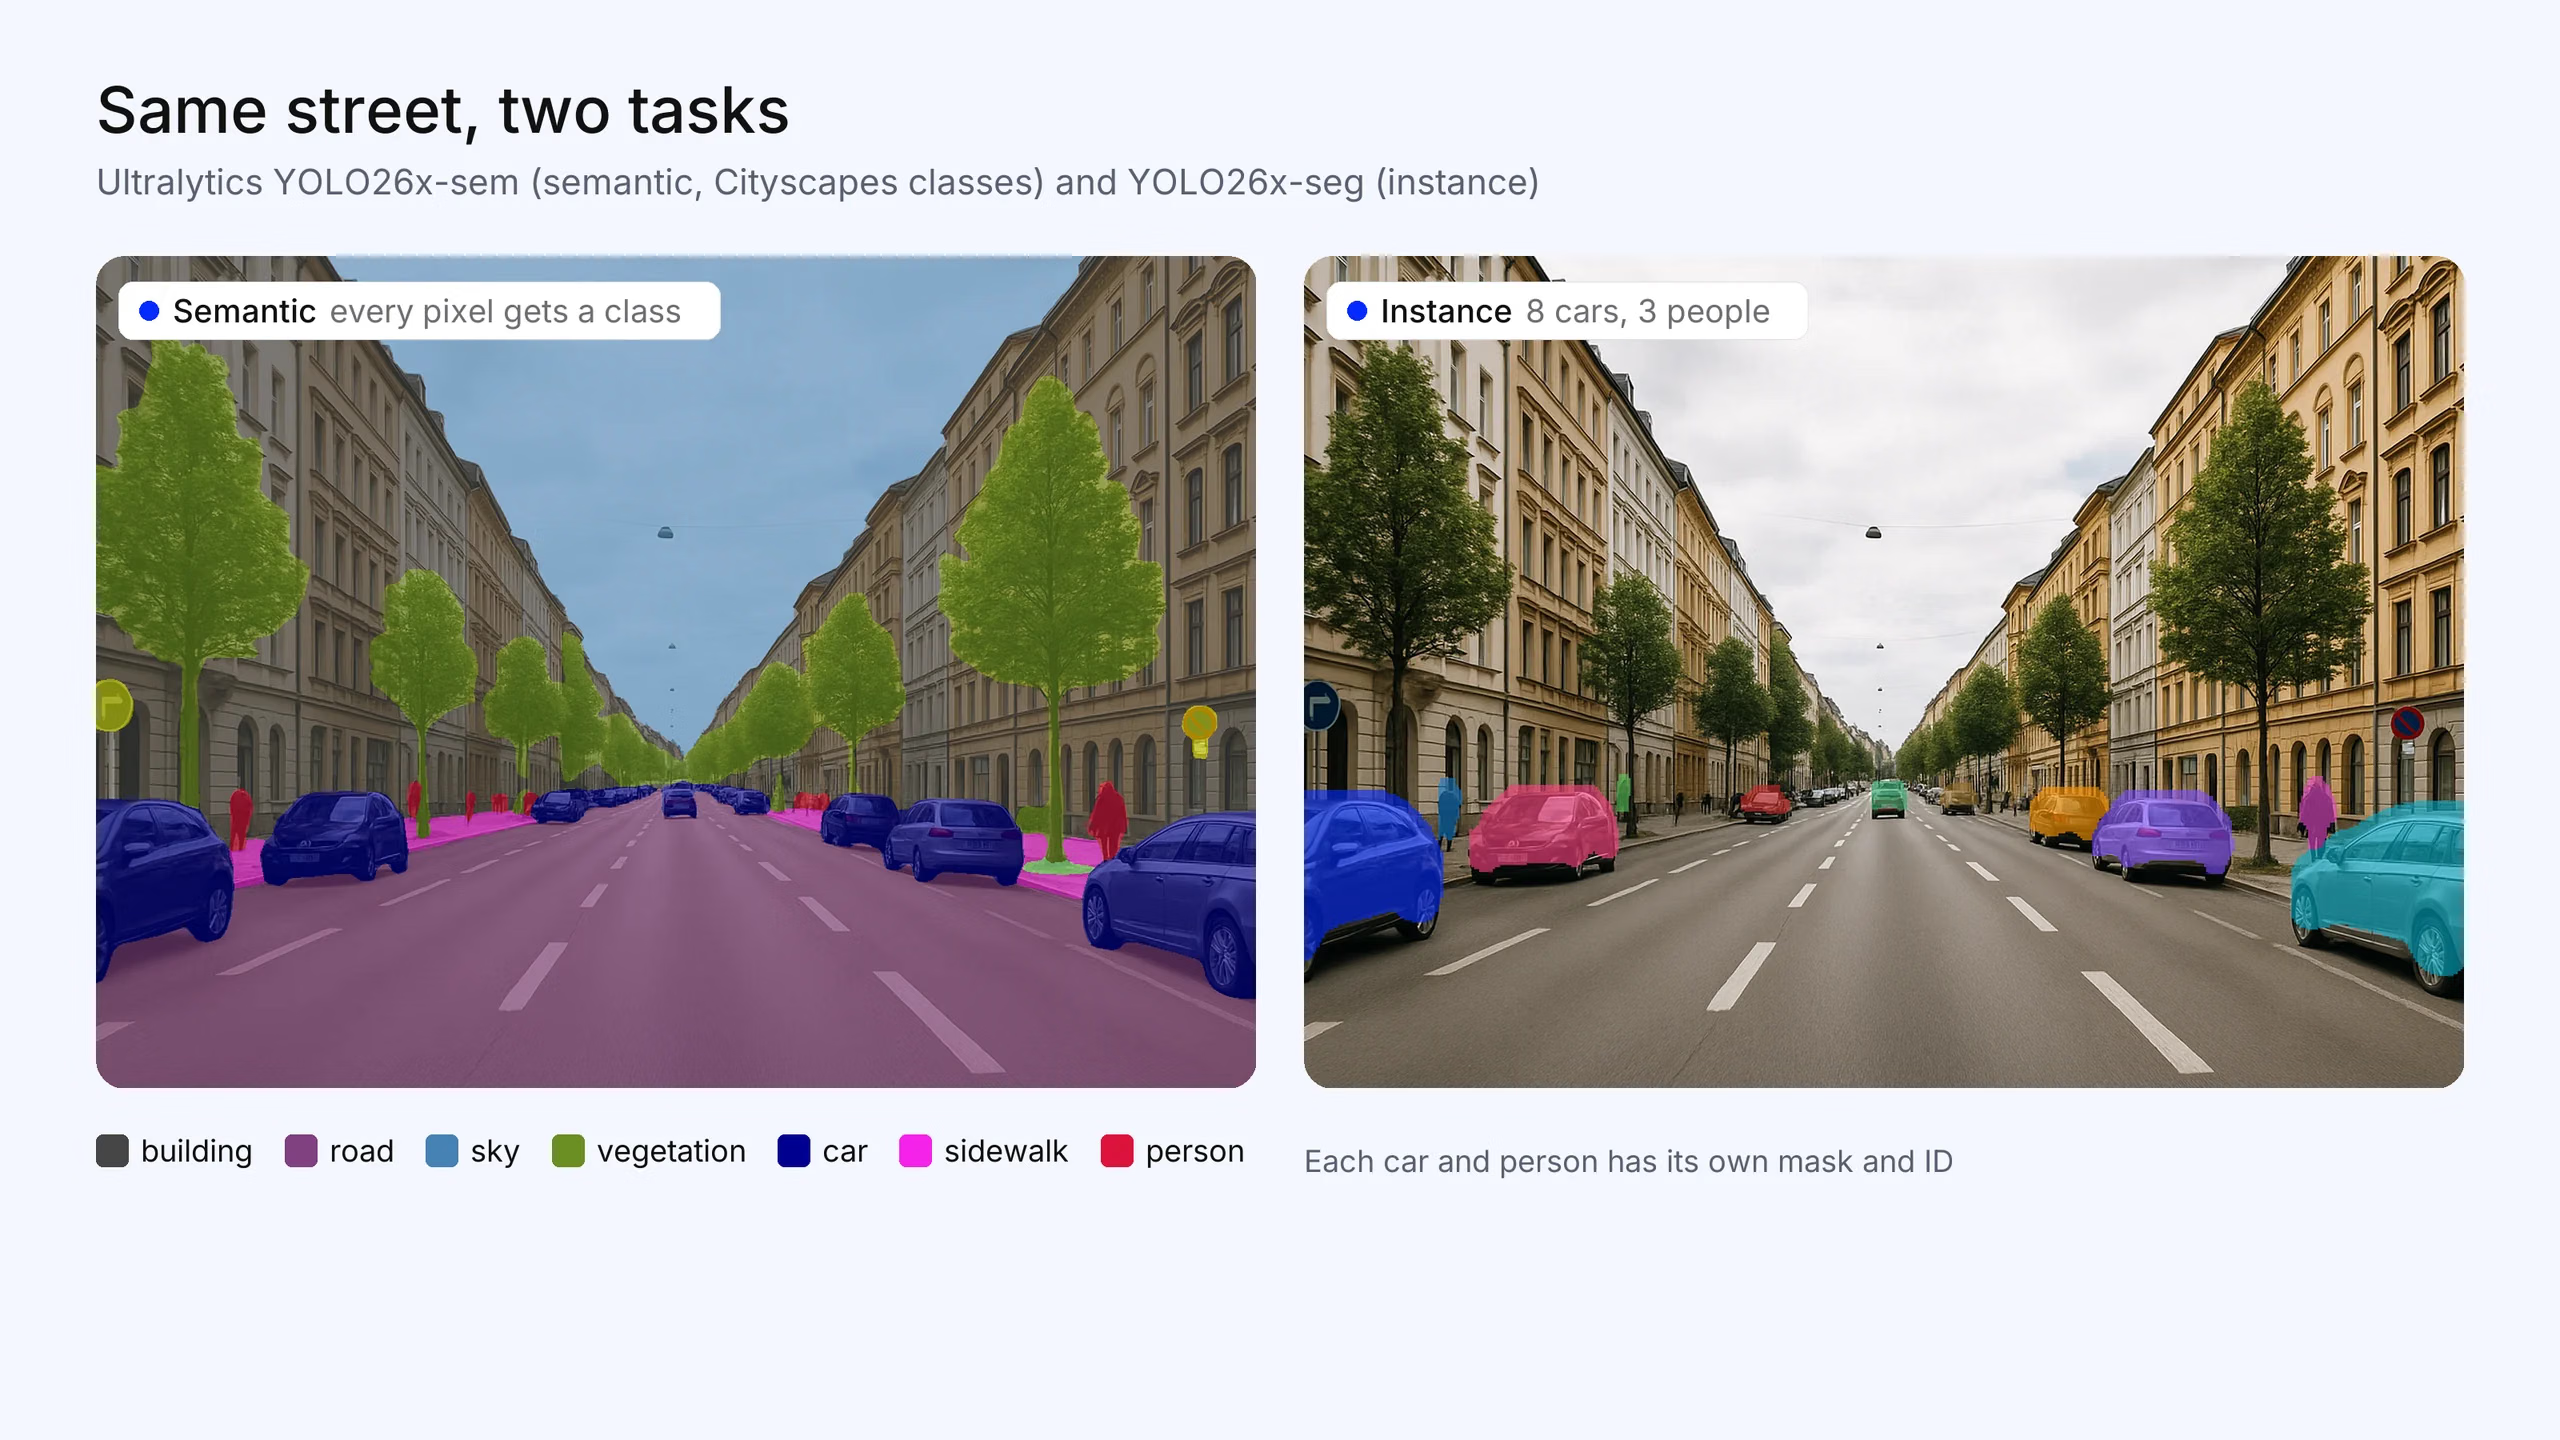
Рис. 1. Одна и та же улица с результатами обеих задач. Ultralytics YOLO26x-sem (классы Cityscapes) размечает каждый пиксель, поэтому все автомобили относятся к одному классу «автомобиль». Ultralytics YOLO26x-seg присваивает каждому из 8 найденных автомобилей и 3 людей собственную маску (уверенность 0,5 или выше). Фотография создана для этой статьи; маски — реальные выходные данные моделей.
Какая задача нужна твоему проекту?#
Отталкивайся от вопроса, на который должно отвечать твоё приложение:
| Если приложению нужно… | Используй | Пример |
|---|---|---|
| Узнать, какую долю сцены занимает заданный класс | Семантическая сегментация | Проезжая часть, доля посевов и сорняков, земной покров |
| Тщательно размечать области фона, как и объекты | Семантическая сегментация | Небо, вода, растительность, типы тканей на снимке |
| Считать объекты | Сегментация экземпляров | Фрукты на дереве, люди в очереди |
| Отслеживать объекты между кадрами видео | Сегментация экземпляров и трекер | Люди или транспортные средства, движущиеся по сцене |
| Измерять параметры отдельного объекта или воздействовать на него | Сегментация экземпляров | Робот берёт одну деталь из кучи, измеряет каждый дефект |
| Нужно и полностью сегментировать сцену, и разделять объекты | Паноптическая сегментация | Уличные сцены для автономного вождения |
Если сомневаешься, подумай, нужно ли различать два соприкасающихся объекта одного класса. Если да, тебе нужна сегментация экземпляров (или паноптическая). Если нет, семантическая сегментация будет проще и обычно обойдётся дешевле.
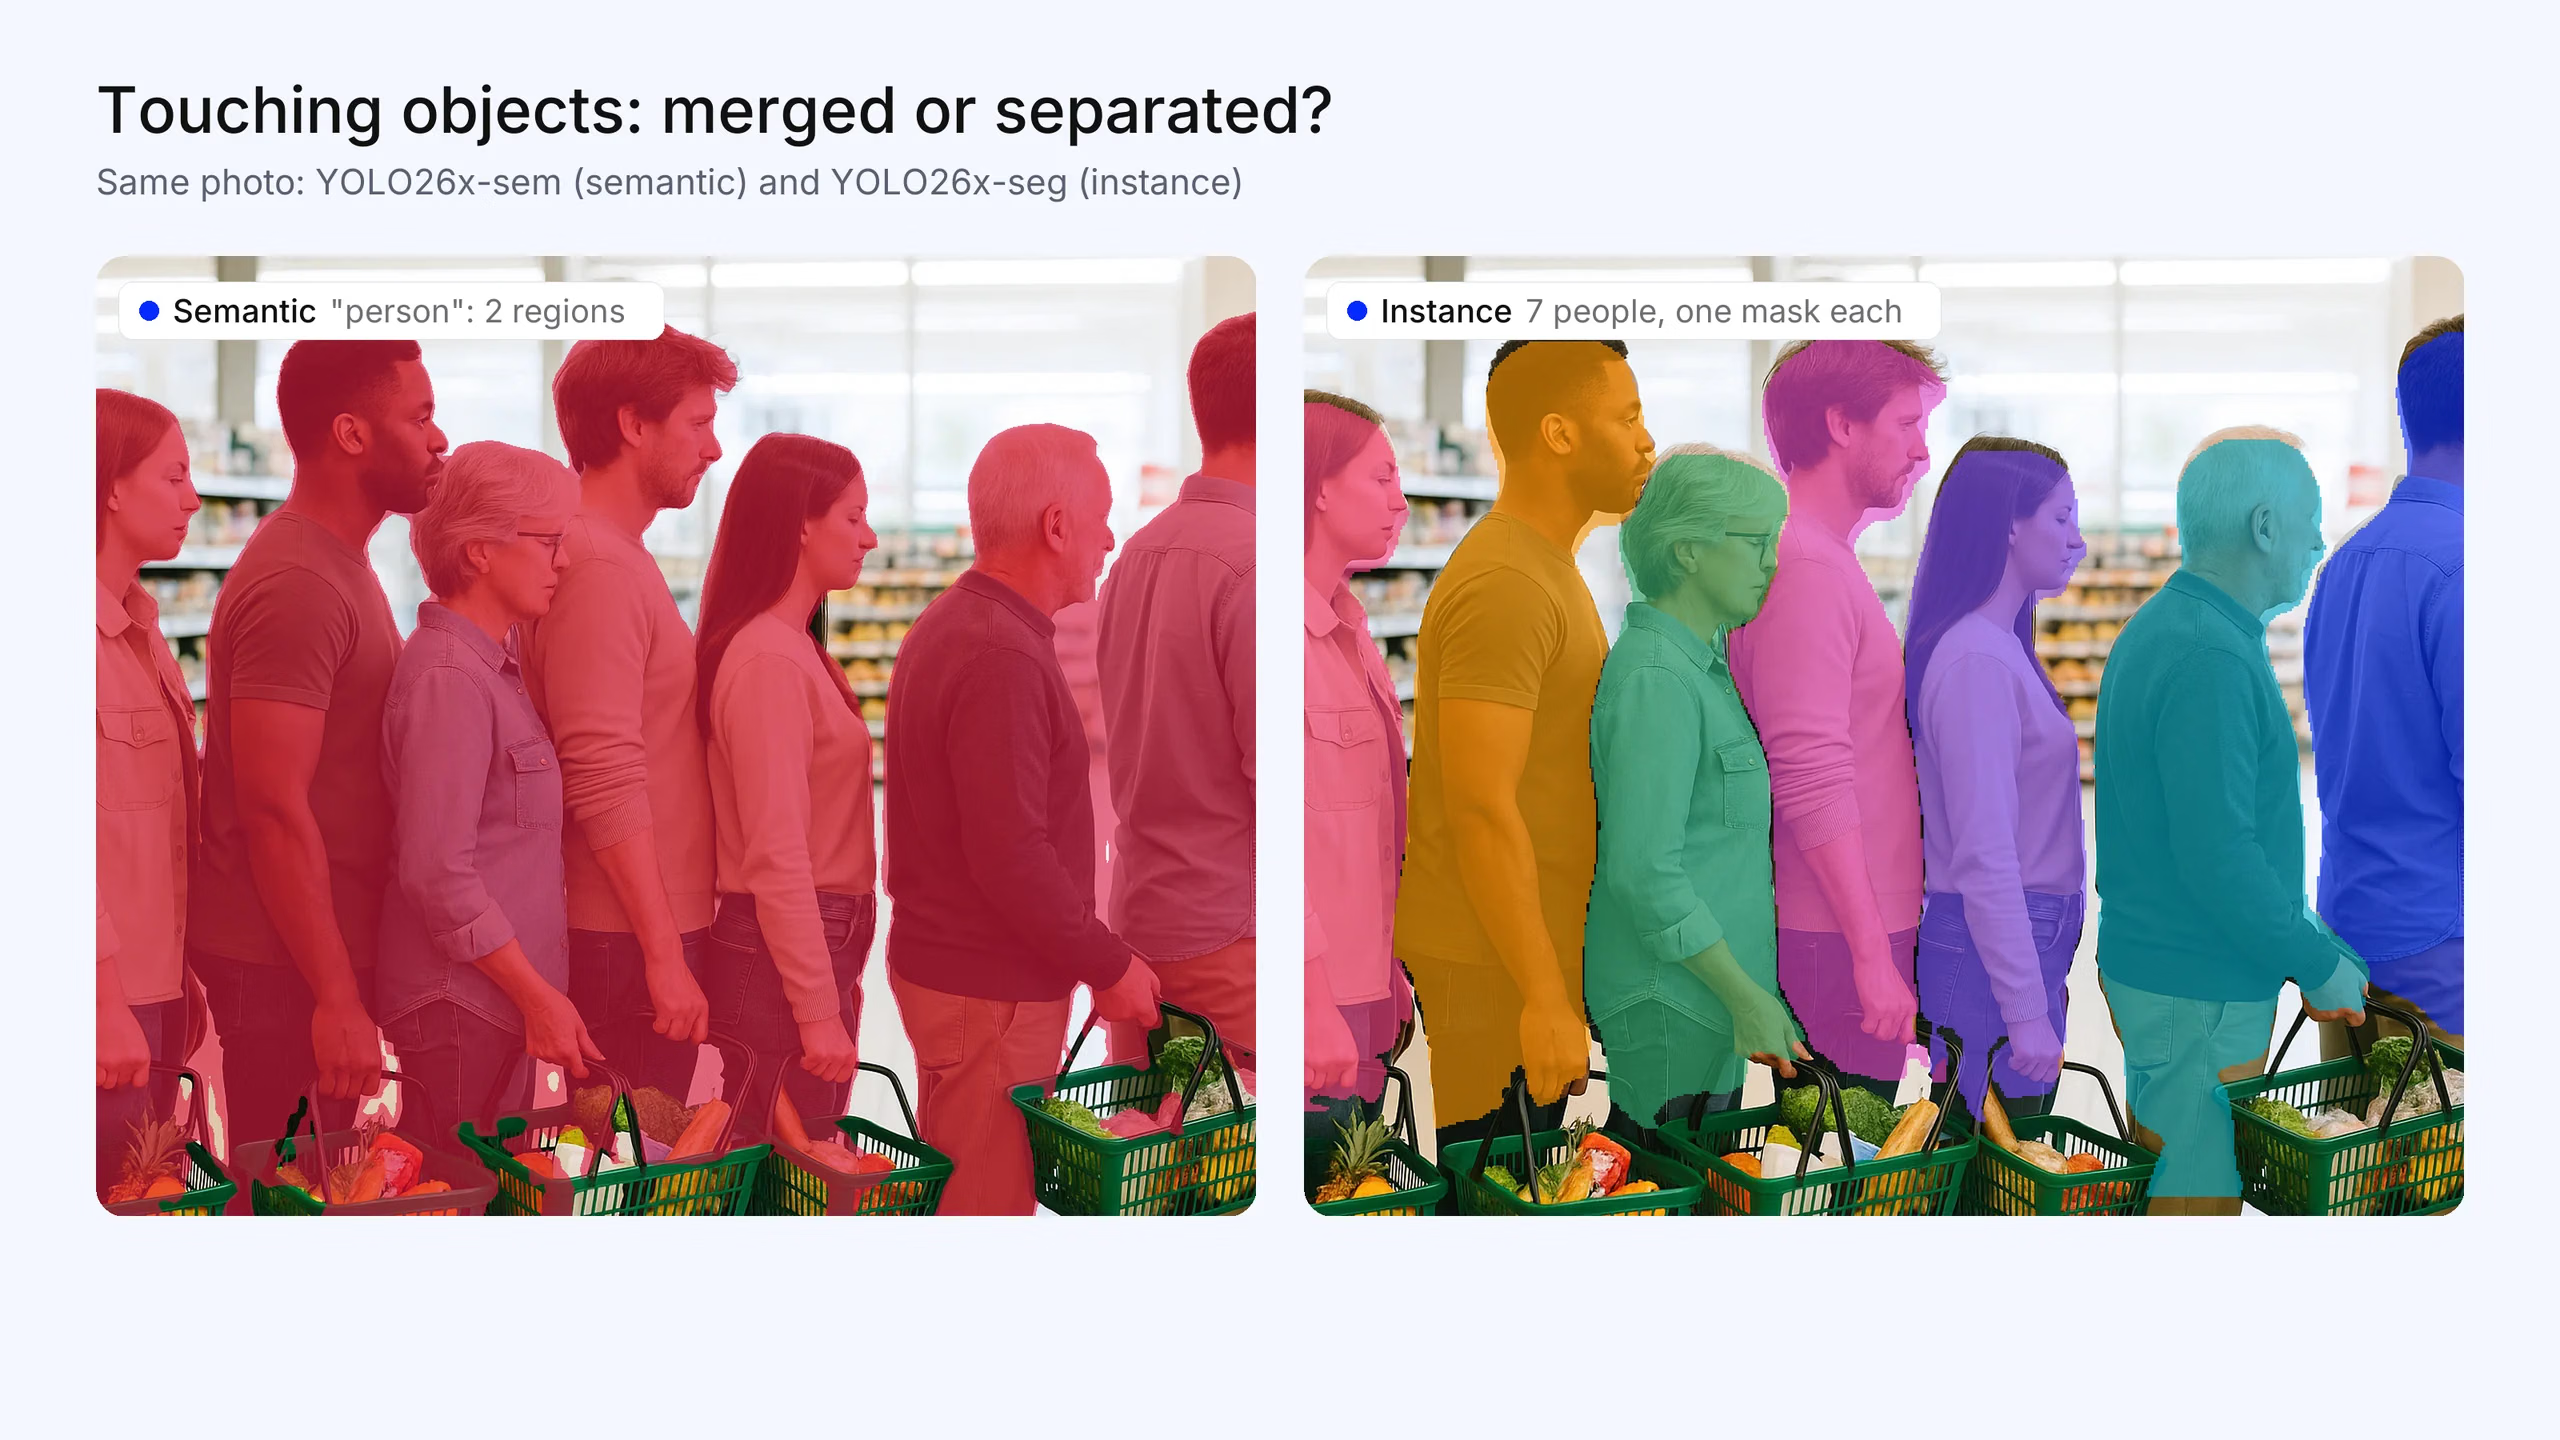
Рис. 2. Семь покупателей стоят вплотную друг к другу в очереди на кассу. В результате семантической сегментации (Ultralytics YOLO26x-sem) они сливаются в две связанные области класса «человек», поэтому посчитать их не получится. Результат сегментации экземпляров (Ultralytics YOLO26x-seg) разделяет всех 7 покупателей. Фотография создана для этой статьи; маски — реальные выходные данные моделей.
Ключевые различия вкратце#
| Критерий | Семантическая сегментация | Сегментация экземпляров |
|---|---|---|
| На какой вопрос отвечает | К какому классу относится каждый пиксель? | Какому объекту принадлежит каждый пиксель? |
| Объекты одного класса | Объединены в одну область | Разделены; у каждого своя маска и ID |
| Охват | Каждый пиксель, включая фон | Обычно только интересующие объекты |
| Результат | Одна карта классов размером с изображение | Список масок с классом и уверенностью для каждой |
| Можно ли посчитать объекты? | Не напрямую | Да |
| Основная метрика | Среднее пересечение по объединению (mIoU) | Средняя точность масок (mask mAP) |
| Относительная сложность | Ниже: классификация каждого пикселя | Выше: обнаружение объектов и маски для каждого объекта |
Стоимость разметки каждой задачи#
На практике выбор часто определяется трудозатратами на разметку.
- Наборы данных для семантической сегментации задают класс каждому пикселю каждого изображения, включая фон. Обычно их хранят в виде одноканальных изображений масок. Каждое изображение размечено полностью, поэтому пропускать пиксели нельзя, если только они явно не помечены как «игнорировать».
- Наборы данных для сегментации экземпляров содержат отдельные контуры каждого интересующего объекта в виде полигонов или масок. Фон можно не размечать, но каждому объекту нужен собственный контур, а в загруженных сценах объём работы возрастает многократно.
Обе задачи требуют больших трудозатрат. Аннотирование с помощью моделей, при котором щелчок или рамка превращаются в маску, сокращает усилия для любой из задач. Если тебе нужны ответы только на уровне областей, не трать ресурсы на разметку экземпляров.
Как оценивают каждую задачу#
- Семантическую сегментацию главным образом оценивают с помощью mIoU: области предсказания и эталонные области пересекаются, а результат усредняется по классам. Также приводят точность на уровне пикселей. IoU — та же метрика перекрытия, что используется при обнаружении объектов.
- Сегментацию экземпляров оценивают с помощью mask mAP — средней точности, используемой при обнаружении объектов, но рассчитываемой по перекрытию масок. Метрика поощряет обнаружение каждого объекта, а не просто покрытие нужных пикселей.
Эти метрики нельзя напрямую сравнивать. Высокое значение mIoU ничего не говорит о том, разделены ли отдельные объекты.
Паноптическая сегментация: когда нужны оба подхода#
Паноптическая сегментация присваивает каждому пикселю класс, а объектам, которые можно посчитать, — ID экземпляра. Фоновая «масса», например дорога и небо, размечается семантически. Объекты переднего плана, например автомобили и люди, разделяются по отдельности. Метрика оценки — паноптическое качество (PQ). Выбирай этот подход, если нужно одновременно полностью сегментировать сцену и разделять отдельные объекты. См. статью о паноптической сегментации.
Кратко о принципе работы#
Модели семантической сегментации обычно представляют собой сети «кодировщик-декодировщик», предсказывающие класс каждого пикселя. Среди известных примеров — U-Net, DeepLab и SegFormer. Модели сегментации экземпляров обычно строятся на основе обнаружения объектов. Mask R-CNN предсказывает маску внутри каждой найденной рамки, тогда как одностадийные модели, например YOLACT и модели сегментации Ultralytics YOLO, за один проход предсказывают рамки и маски для работы в реальном времени. Универсальные архитектуры, например Mask2Former, выполняют семантическую, экземплярную и паноптическую сегментацию в одной модели. Подробнее о сегментации экземпляров читай в статье что такое сегментация экземпляров.
Обе задачи в Ultralytics YOLO#
Ultralytics YOLO выполняет обе задачи через один и тот же Python API и CLI:
- Сегментация экземпляров использует задачу
segment. - Семантическая сегментация использует задачу
semantic. Семантические модели YOLO26 имеют суффикс-semи предварительно обучены на наборах данных Cityscapes и ADE20K. На странице задачи есть таблица, в которой точно показано, чем различаются выходные данные этих двух задач в коде.
Обе модели можно обучать локально или в облаке на Ultralytics Platform.
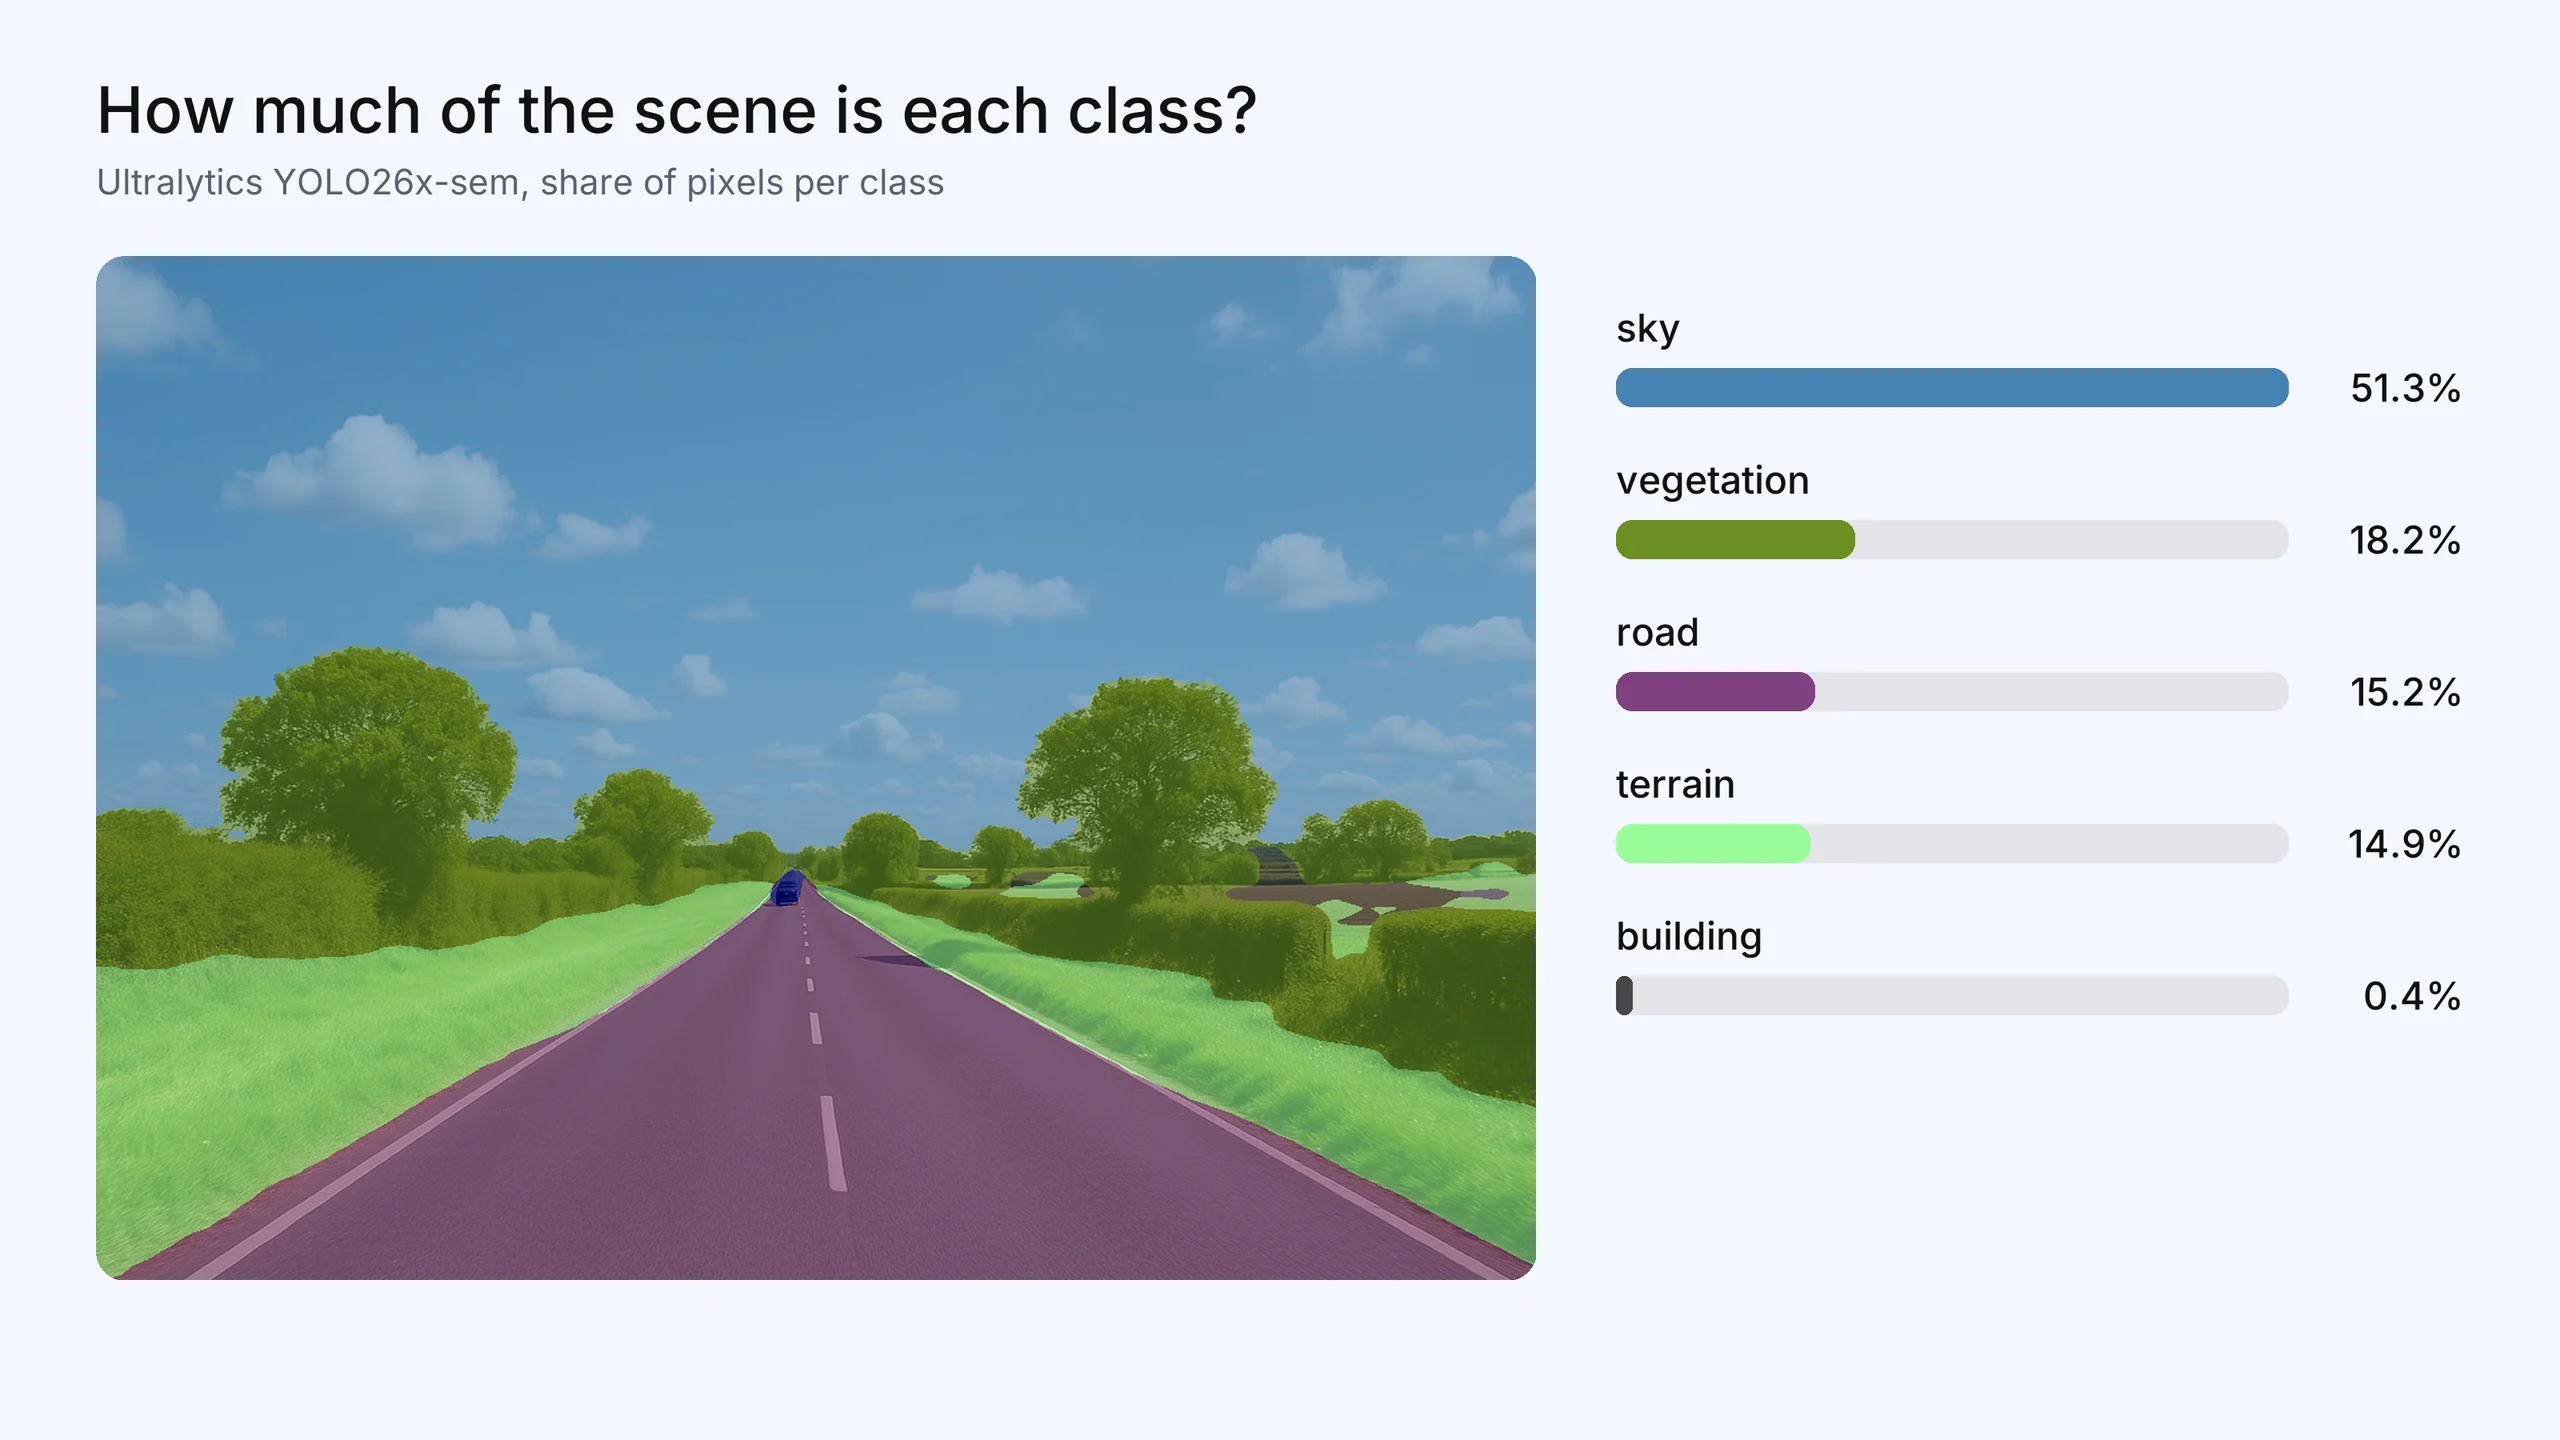
Рис. 3. Семантическая сегментация отвечает на вопрос: «Какую часть сцены занимает каждый класс?» YOLO26x-sem от Ultralytics относит 51,3% этого изображения к небу, 18,2% — к растительности, 15,2% — к дороге и 14,9% — к местности. Фотография создана для этой статьи; карта классов и их доли — реальные выходные данные модели.
Часто задаваемые вопросы
Семантическая сегментация присваивает каждому пикселю метку класса, но считает все объекты одного класса одной областью. Сегментация экземпляров выделяет каждый объект в отдельную маску, поэтому объекты одного класса можно считать и отслеживать по отдельности.
Подумай, нужно ли различать два соприкасающихся объекта одного класса. Если тебе нужно считать, отслеживать отдельные объекты или совершать с ними действия, используй сегментацию экземпляров. Если нужно только знать, какие области относятся к каким классам, проще использовать семантическую сегментацию.
Mask R-CNN — это модель сегментации экземпляров. Она обнаруживает каждый объект, а затем предсказывает отдельную попиксельную маску внутри ограничивающей рамки этого объекта.
Сегментация экземпляров обычно сложнее. Нужно не только классифицировать пиксели, но и разделять объекты одного класса, поэтому требуются и обнаружение объектов, и сегментация.
В основном с помощью среднего пересечения по объединению (mIoU) — среднего перекрытия предсказанных и истинных областей по всем классам. Для сегментации экземпляров используют mAP по маскам, а для паноптической сегментации — качество паноптической сегментации (PQ).









