Лучшие модели классификации изображений: как выбрать
Сравни ведущие модели классификации изображений — от ConvNeXt V2 и DINOv3 до EfficientNetV2, ViT и Ultralytics YOLO26-cls — и узнай, как выбрать подходящую.
Не существует единственной лучшей модели классификации изображений. Выбор зависит от объёма размеченных данных, среды запуска модели и допустимости её лицензии для твоих задач. В 2026 году для максимальной точности используют крупные Transformer- и самообучающиеся бэкбоны, например DINOv3 и EVA-02. Для запуска на ограниченном оборудовании чаще подходят небольшие, преимущественно свёрточные модели, например ConvNeXt V2, EfficientNetV2, MobileNetV4 и Ultralytics YOLO26-cls, — в зависимости от размера чекпойнта, конфигурации обучения и целевого оборудования. Сравни их точность и задержку на собственных задачах. В этом руководстве рассматриваются четыре семейства моделей, сравниваются десять широко используемых моделей и предлагается алгоритм выбора.
Если ты только знакомишься с самой задачей, начни с материала о том, что такое классификация изображений. Эта страница посвящена выбору модели.
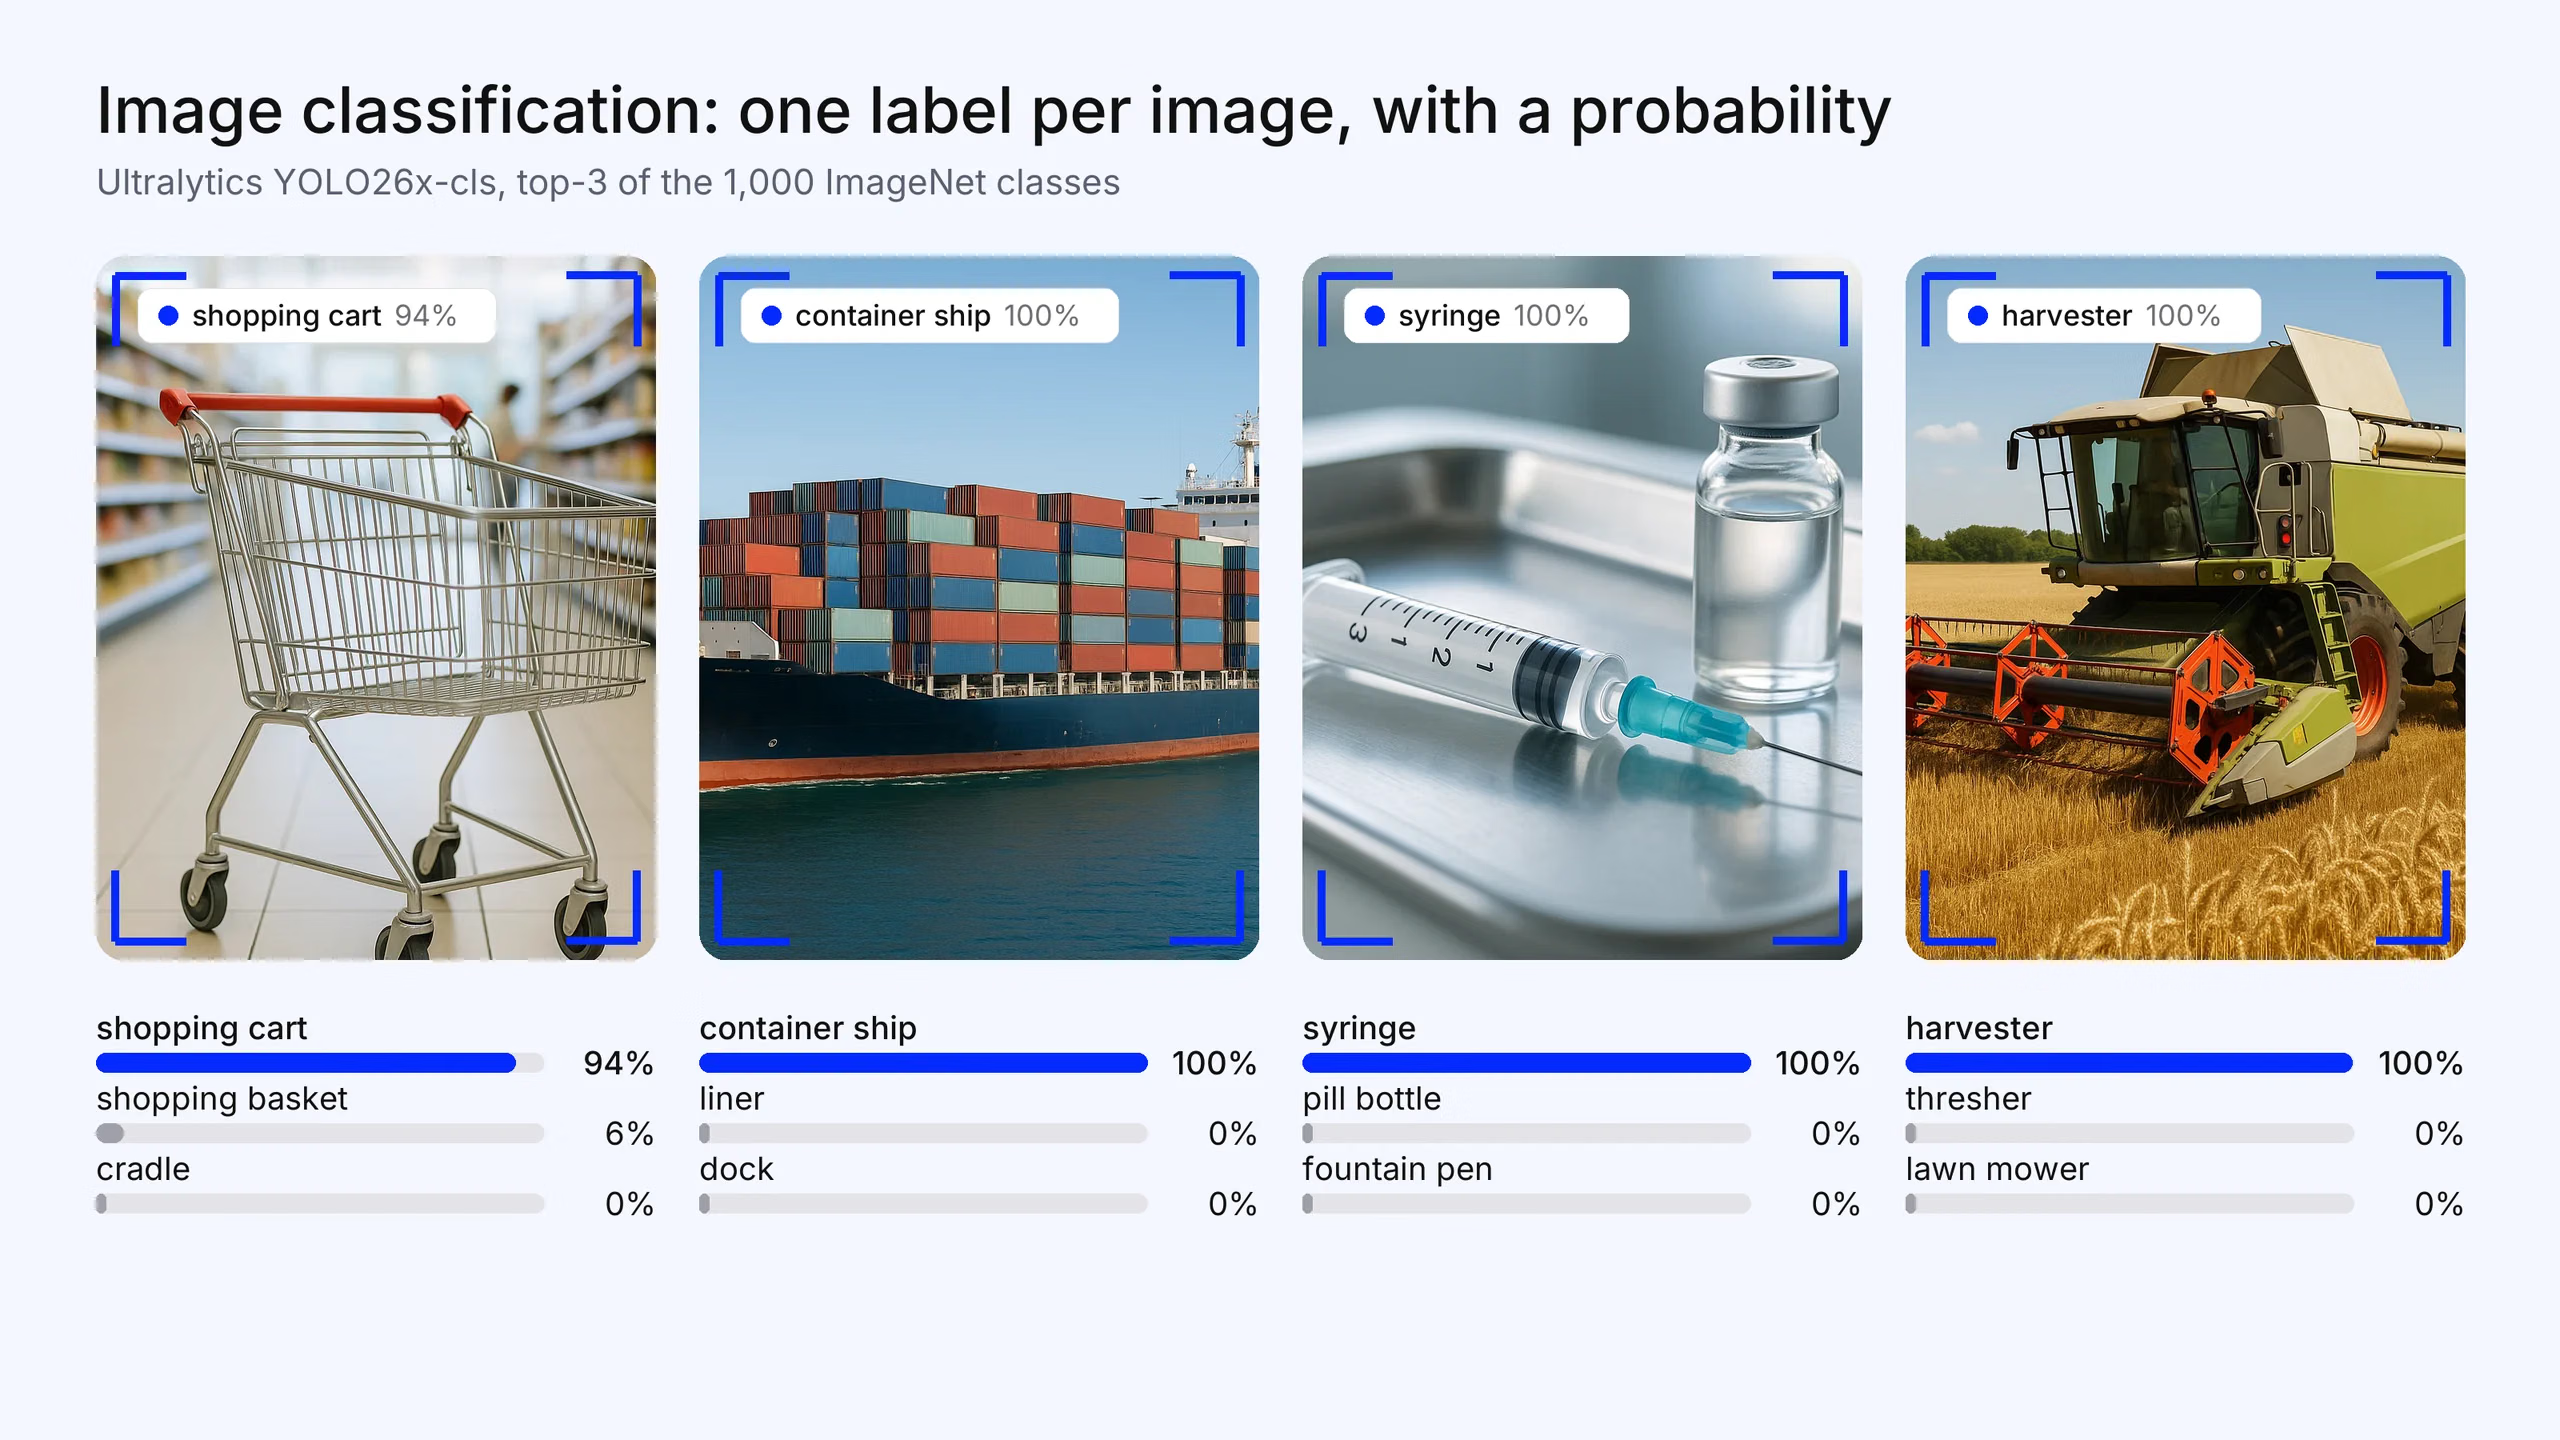
Рис. 1. Классификация изображений присваивает всему изображению одну метку и вычисляет вероятность для каждого класса: примеры из розничной торговли, логистики, здравоохранения и сельского хозяйства. Три главных предсказания Ultralytics YOLO26x-cls, предварительно обученной на 1 000 классов ImageNet. Фотографии созданы для этой статьи; предсказания получены реальной моделью.
Что означает «лучшая» модель классификации изображений#
Рейтинги ранжируют модели по точности top-1 на валидационном наборе ImageNet. Этот показатель полезен, но измеряется при фиксированном разрешении, на одном наборе данных и часто с использованием очень масштабного предварительного обучения. Обычно выбор для реального проекта определяют четыре других фактора:
- Данные. Сколько размеченных изображений есть для каждого класса и насколько они похожи на данные для предварительного обучения.
- Вычислительные ресурсы и задержка. Где выполняется инференс: на серверном GPU, CPU, телефоне или NPU камеры.
- Развёртывание. Насколько легко экспортировать модель в нужную среду выполнения, например ONNX, TensorRT, Core ML или TFLite.
- Лицензия. Разрешают ли код и отдельно предобученные веса нужное тебе использование.
Модель, уступающая несколько пунктов на ImageNet, но хорошо дообучаемая на твоих изображениях и работающая в реальном времени на твоём оборудовании, обычно оказывается лучшим выбором.
Четыре семейства моделей классификации изображений#
Свёрточные нейронные сети (CNNs)#
CNN применяют обученные фильтры ко всему изображению, исходя из того, что близкие пиксели связаны между собой. Это встроенное предположение (индуктивное смещение) позволяет им эффективно обучаться на небольших и средних наборах данных и работать на не самом мощном оборудовании. Классические примеры — ResNet и EfficientNet.
- Преимущества: эффективное обучение на небольшом объёме данных, высокая скорость, простота квантования и развёртывания.
- Компромиссы: меньше глобального контекста на каждом слое; при масштабировании прирост обычно раньше начинает снижаться, чем у Transformer-моделей.
Визуальные трансформеры (ViTs)#
Визуальный Transformer разбивает изображение на фрагменты и обрабатывает их как последовательность с помощью механизма self-attention, поэтому каждый фрагмент может учитывать все остальные. ViT лучше всего работают, если предварительно обучены на большом объёме данных, а затем перенесены на новую задачу.
- Преимущества: хорошо масштабируются с ростом объёма данных и размера модели; эффективно переносят знания; служат естественной основой для самообучения и мультимодального обучения.
- Компромиссы: требуют масштабного предварительного обучения или сильной регуляризации; обычно при инференсе медленнее и ресурсоёмнее, чем CNN сопоставимой точности.
Гибридные модели CNN-Transformer#
В гибридных моделях свёртки на ранних этапах извлекают локальные детали, а внимание на поздних — глобальный контекст. CoAtNet — эталонная архитектура: её авторы показали, что последовательное объединение свёрточных слоёв и слоёв внимания в обоснованном порядке улучшает обобщающую способность, вместимость и эффективность.
- Преимущества: хороший баланс на наборах данных среднего размера.
- Компромиссы: сложнее в реализации, настройке и экспорте, чем модели с чисто свёрточной или чисто трансформерной архитектурой.
Самообучающиеся бэкбоны и модели «зрение — язык»#
Новейшее семейство определяется не архитектурой, а способом обучения. Модели с самообучением, например DINOv2 и DINOv3, обучаются на неразмеченных изображениях. Энкодеры для задач «зрение — язык», например SigLIP 2, обучаются на парах изображений и текста. Обе группы создают универсальные признаки, которые можно классифицировать с помощью небольшой линейной головы или, в случае моделей «зрение — язык», текстовых запросов без какого-либо обучения (обучение без примеров). Meta обучила DINOv3 с 7 миллиардами параметров на 1,7 миллиарда изображений; у DINOv2 было 1,1 миллиарда параметров и 142 миллиона изображений.
- Преимущества: качественные признаки при небольшом объёме размеченных данных; один бэкбон подходит для множества задач.
- Компромиссы: самые крупные чекпойнты слишком тяжёлые для периферийных устройств; лицензии различаются, поэтому их нужно проверять.
Сравнение моделей классификации изображений#
Модели перечислены в алфавитном порядке, а не по рейтингу. Мы не приводим показатели точности: опубликованные результаты ImageNet зависят от разрешения, данных для предварительного обучения и методики оценки, поэтому значения в этих строках несопоставимы. Результаты для каждой модели указаны в её статье или документации по ссылке ниже.
| Модель | Семейство | Разработчик | Предварительное обучение | Лучше всего подходит для | Основной компромисс |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | Самообучающееся маскированное автокодирование (FCMAE), затем обучение с учителем | Точная CNN, готовая к развёртыванию, в нескольких размерах | Веса ImageNet распространяются по лицензии CC-BY-NC (некоммерческое использование) |
| DINOv3 | Самообучающаяся (ViT и ConvNeXt) | Meta | Самообучение на 1,7 млрд изображений | Качественные признаки при замороженной модели, мало размеченных данных | Собственная лицензия DINOv3; у крупнейшей модели 7 млрд параметров |
| EfficientNetV2 | CNN | Обучение с учителем | Быстрое обучение, эффективное дообучение | Архитектура предыдущего поколения; новые бэкбоны точнее | |
| EVA-02 | ViT | BAAI | Моделирование маскированных изображений на признаках CLIP | Исследования и дообучение с приоритетом точности | Крупные варианты ресурсоёмки при инференсе |
| MobileNetV4 | CNN и гибридная модель (мобильная) | Обучение с учителем | Телефоны, NPU и периферийные ускорители | Ниже максимальная точность, чем у серверных моделей | |
| ResNet | CNN | Microsoft Research | Обучение с учителем | Базовые модели, обучение, устаревшие пайплайны | Уже не конкурентоспособна по точности на FLOP |
| SigLIP 2 | Модель «зрение — язык» (ViT) | Пары изображений и текста, мультиязычность | Классификация без примеров и с открытым словарём классов | Проверь результаты классификации без примеров на нужных тебе классах, прежде чем полагаться на них | |
| Swin Transformer | ViT (иерархическая) | Microsoft Research | Обучение с учителем | Входные данные высокого разрешения, повторное использование бэкбона | Тяжелее CNN сопоставимой точности |
| Ultralytics YOLO26-cls | CNN | Ultralytics | Обучение с учителем на ImageNet | Быстрые классификаторы для пользовательских задач, экспорт на периферийные устройства, единый API для обнаружения объектов | Ниже максимальная точность, чем у крупных предварительно обученных Transformer-моделей |
| ViT | ViT | Обучение с учителем, часто на крупных наборах данных | Масштабное трансферное обучение | Требует много данных без масштабного предварительного обучения |
Подробнее о моделях#
Перечислены в алфавитном порядке.
ConvNeXt V2#
ConvNeXt V2 объединяет полностью свёрточный маскированный автокодировщик (FCMAE) со слоем нормализации глобального отклика (Global Response Normalization). Доступно восемь размеров — от Atto (3,7 млн параметров) до Huge (660 млн), поэтому семейство охватывает устройства от периферийных до серверных. Это хороший вариант по умолчанию, если нужна точность уровня Transformer-моделей и простота развёртывания CNN. Компромисс: код распространяется по лицензии MIT, но предварительно обученные и дообученные на ImageNet веса — по лицензии CC-BY-NC, которая запрещает коммерческое использование этих весов.
DINOv3#
DINOv3 — это самообучающийся бэкбон для компьютерного зрения от Meta. Он выпущен в виде моделей ViT от ViT-S/16 до ViT-7B/16, а также дистиллированных моделей ConvNeXt для устройств. Meta оценивает его с замороженным бэкбоном; в репозитории также есть голова классификации ImageNet для модели 7B. Попробуй эту модель, если у тебя мало меток и нужны переносимые признаки. Компромисс: модель выпущена по собственной лицензии DINOv3, а не по стандартной лицензии с открытым исходным кодом; основные результаты получены на самой крупной модели.
EfficientNetV2#
EfficientNetV2 от Google использует прогрессивное обучение: во время обучения размер изображений постепенно увеличивается, а регуляризация подстраивается соответствующим образом. Благодаря этому модель обучается быстрее и содержит меньше параметров, чем более ранние модели. Она по-прежнему остаётся надёжным выбором для дообучения на небольших и средних наборах данных. Компромисс: эта архитектура появилась до бэкбонов 2023–2025 годов и уже не лидирует по точности. Об исходной архитектуре читай в нашем обзоре EfficientNet.
EVA-02#
EVA-02 — это стандартный Transformer, предварительно обученный с помощью моделирования маскированных изображений для восстановления признаков крупного визуального энкодера CLIP. Доступны четыре размера — от 6 млн до 304 млн параметров. Модель доступна в timm для дообучения. Компромисс: крупные варианты дорого дообучивать и обслуживать, а для простых классификаторов предметной области их возможности избыточны.
MobileNetV4#
MobileNetV4 — новейшее мобильное семейство Google, рассчитанное на эффективную работу с мобильными CPU, DSP и GPU, Apple Neural Engine и Google Pixel EdgeTPU. Это естественный выбор для телефона или энергоэффективного ускорителя. Компромисс: ради минимальной задержки приходится жертвовать пиковой точностью.
ResNet#
ResNet представила остаточные связи и до сих пор остаётся стандартной базовой моделью, которую поддерживают все фреймворки. Компромисс: новые CNN обеспечивают более высокую точность при тех же вычислительных затратах. Архитектура описана в материале о ResNet-50.
SigLIP 2#
SigLIP 2 (см. нашу словарную статью о SigLIP) — это семейство мультиязычных энкодеров «зрение — язык» от Google. Модель классифицирует изображения по списку текстовых меток без обучения (подход схож с CLIP), а вариант NaFlex сохраняет исходное соотношение сторон входного изображения. Это оптимальный выбор, если набор меток часто меняется или у тебя пока нет размеченных данных. Компромисс: качество классификации без примеров зависит от предметной области, поэтому проверь модель на нужных тебе классах (например, типах дефектов), прежде чем полагаться на неё. Если качество недостаточно, обучи классификационную голову или дообучи модель.
Swin Transformer#
Swin Transformer вычисляет внимание внутри сдвинутых локальных окон, благодаря чему вычислительная сложность линейно растёт с размером изображения, а модель подходит для входных данных высокого разрешения. Компромисс: она тяжелее CNN сопоставимой точности; ConvNeXt создавался, чтобы конкурировать с ней, используя обычные свёртки.
Ultralytics YOLO26-cls#
Ultralytics YOLO26-cls — вариант Ultralytics YOLO26 для классификации. Доступно пять размеров (n, s, m, l, x) — от 2,8 млн до 29,6 млн параметров (после слияния); модель принимает изображения размером 224 пикселя и предварительно обучена на ImageNet. В документации приведены точность top-1 и top-5 на валидационном наборе ImageNet, а также задержка на CPU и GPU для каждого размера. Один и тот же Python API и CLI позволяют обучать, валидировать и экспортировать модели классификации, обнаружения объектов, сегментации и оценки поз; классификаторы экспортируются, в частности, в ONNX, TensorRT, Core ML, OpenVINO и LiteRT. В более ранних моделях YOLO11-cls используются те же пять размеров и размер входных данных. Компромиссы:
- Предел точности. Даже модель размера x мала по сравнению с крупными предварительно обученными Transformer-моделями, например EVA-02 или DINOv3, поэтому она не подходит для исследований с приоритетом точности.
- По умолчанию используются квадратные кадрирования. При обучении применяется случайное кадрирование с изменением размера, а при валидации — центральное кадрирование. Из-за этого у изображений с очень вытянутым соотношением сторон могут обрезаться части. В документации показано, как заменить кадрирование обычным изменением размера.
- Лицензия. Модели Ultralytics распространяются по лицензии AGPL-3.0. Для коммерческого использования в закрытом коде нужна лицензия Ultralytics Enterprise.
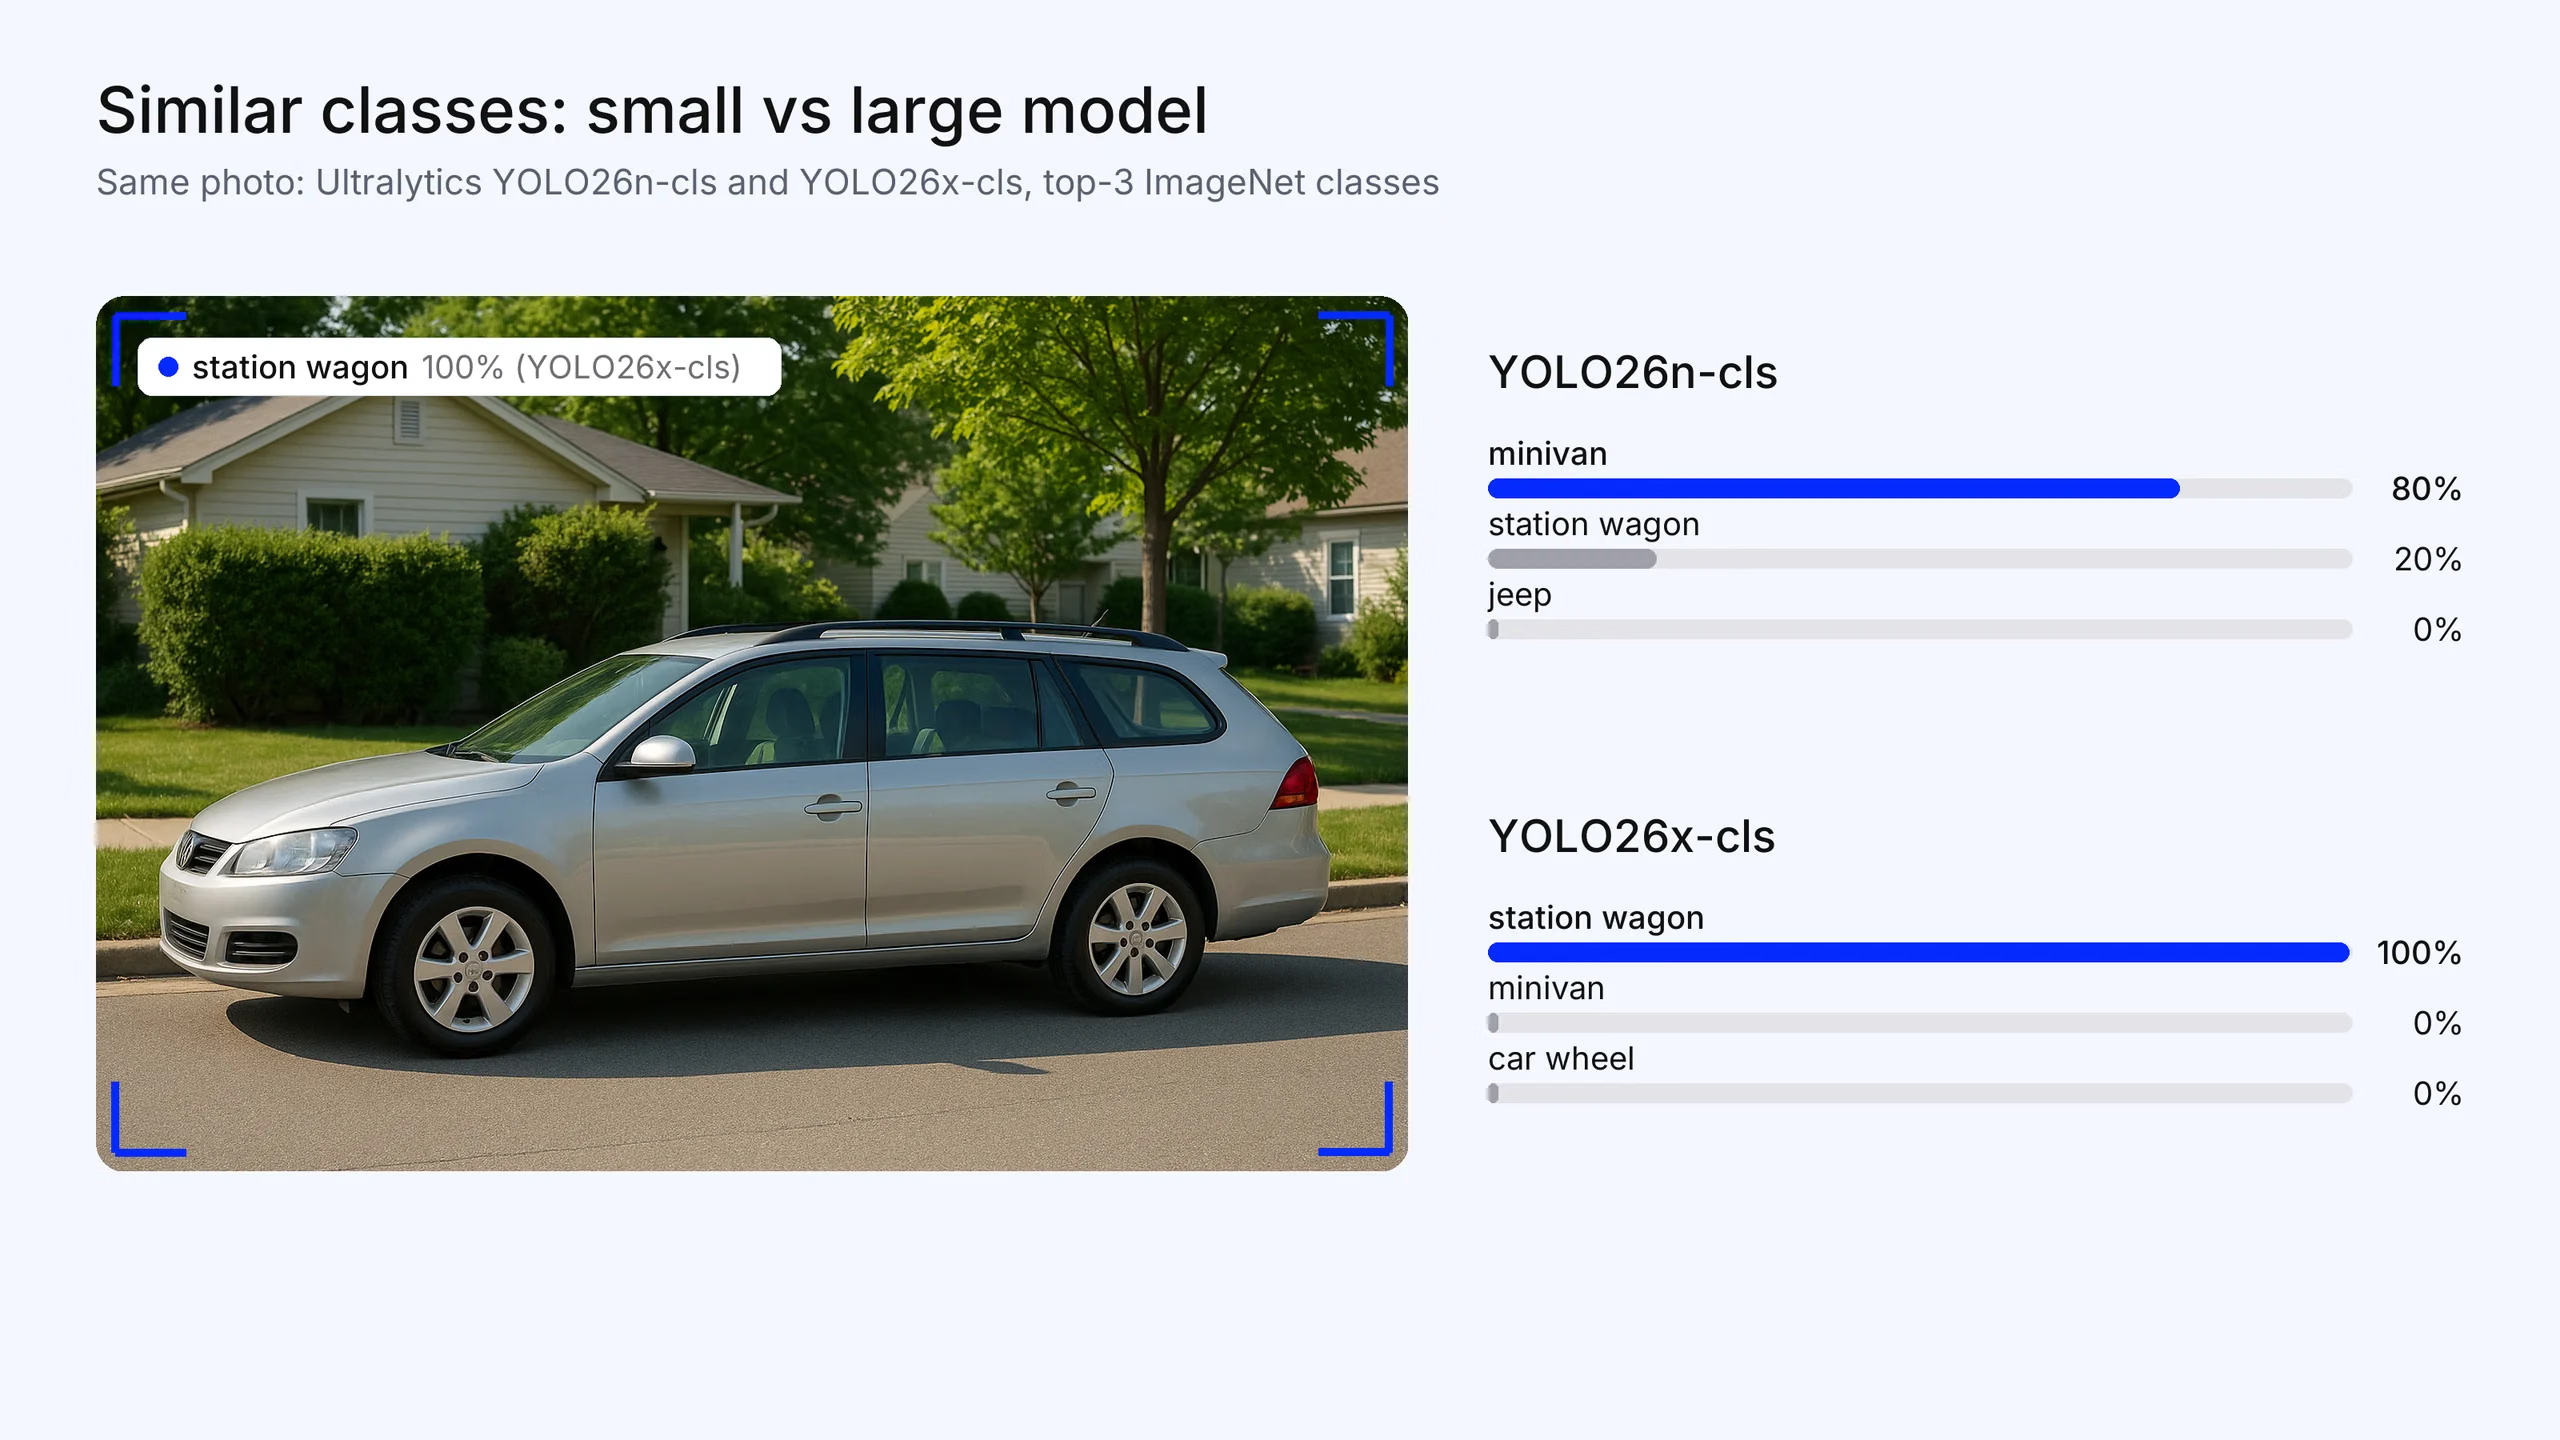
Рис. 2. Сходные классы — вот где заметна разница в размере модели. На этой фотографии универсала Ultralytics YOLO26n-cls ставит на первое место «минивэн» (80%), а YOLO26x-cls — универсал (100%, класс ImageNet «пляжный универсал, универсал»). Проверяй такие тонкие различия между классами на собственной валидационной выборке. Фотография создана для этой статьи; предсказания — реальные выходные данные моделей.
ViT#
Оригинальный Vision Transformer от Google показал, что чистый трансформер, работающий с фрагментами изображений, при предварительном обучении на больших объёмах данных может не уступать CNN или превосходить их. Компромисс: без масштабного предварительного обучения он уступает CNN на небольших наборах данных и требует больше вычислительных ресурсов при инференсе.
Как выбрать модель классификации изображений#
Последовательно ответь на эти вопросы:
- Есть ли у тебя размеченные данные? Если размеченных примеров нет, начни с мультимодальной модели для зрения и языка, например SigLIP 2, для классификации с нулевым числом примеров. Если размеченный набор небольшой, также оцени замороженный бэкбон DINOv3 с обученной линейной головкой.
- Где будет работать модель? Для телефона или NPU включи в список кандидатов MobileNetV4 или небольшую CNN, например YOLO26n-cls либо небольшую ConvNeXt V2. Для инференса в реальном времени на периферийном GPU или CPU рассмотри YOLO26-cls, EfficientNetV2 или ConvNeXt V2. Для сервера без жёстких ограничений по задержке подойдут EVA-02, Swin или DINOv3 ViT.
- Сколько размеченных данных приходится на класс? Если у тебя от нескольких сотен до нескольких тысяч изображений, безопаснее всего использовать трансферное обучение на предварительно обученной CNN или замороженном бэкбоне с самообучением. При наличии десятков тысяч изображений или больше начинают окупаться трансформеры с полным дообучением.
- Подходит ли тебе лицензия? Проверяй лицензии на веса, а не только на код: веса ConvNeXt V2 для ImageNet предназначены только для некоммерческого использования, у DINOv3 своя лицензия, а модели Ultralytics распространяются по AGPL-3.0, если у тебя нет лицензии Enterprise.
- Можно ли экспортировать модель для твоей среды выполнения? Прежде чем принять решение, проверь, есть ли поддерживаемый путь экспорта в ONNX, TensorRT, Core ML или TFLite.
Затем дообучи две или три модели из списка кандидатов и сравни их на собственной валидационной выборке.
Когда другая модель подойдёт лучше YOLO#
YOLO26-cls создана для быстрой разработки и удобного развёртывания пользовательских классификаторов. Для некоторых задач лучше подойдёт другая модель:
- Исследования или бенчмарки, где важна прежде всего точность: используй EVA-02, ConvNeXt V2 или ViT через timm — для них есть рецепты обучения и веса, позволяющие воспроизводить результаты уровня ImageNet.
- Очень мало разметки или много последующих задач на одном бэкбоне: используй признаки DINOv3 с линейной головкой.
- Открытый или часто меняющийся набор меток: используй SigLIP 2 в режиме zero-shot.
- Мобильные NPU, например Apple Neural Engine или EdgeTPU: MobileNetV4 была разработана и протестирована именно для таких платформ.
Если тебе нужно не только понять, что изображено, но и найти расположение объектов, понадобится детектор. Смотри наше сравнение моделей обнаружения объектов.
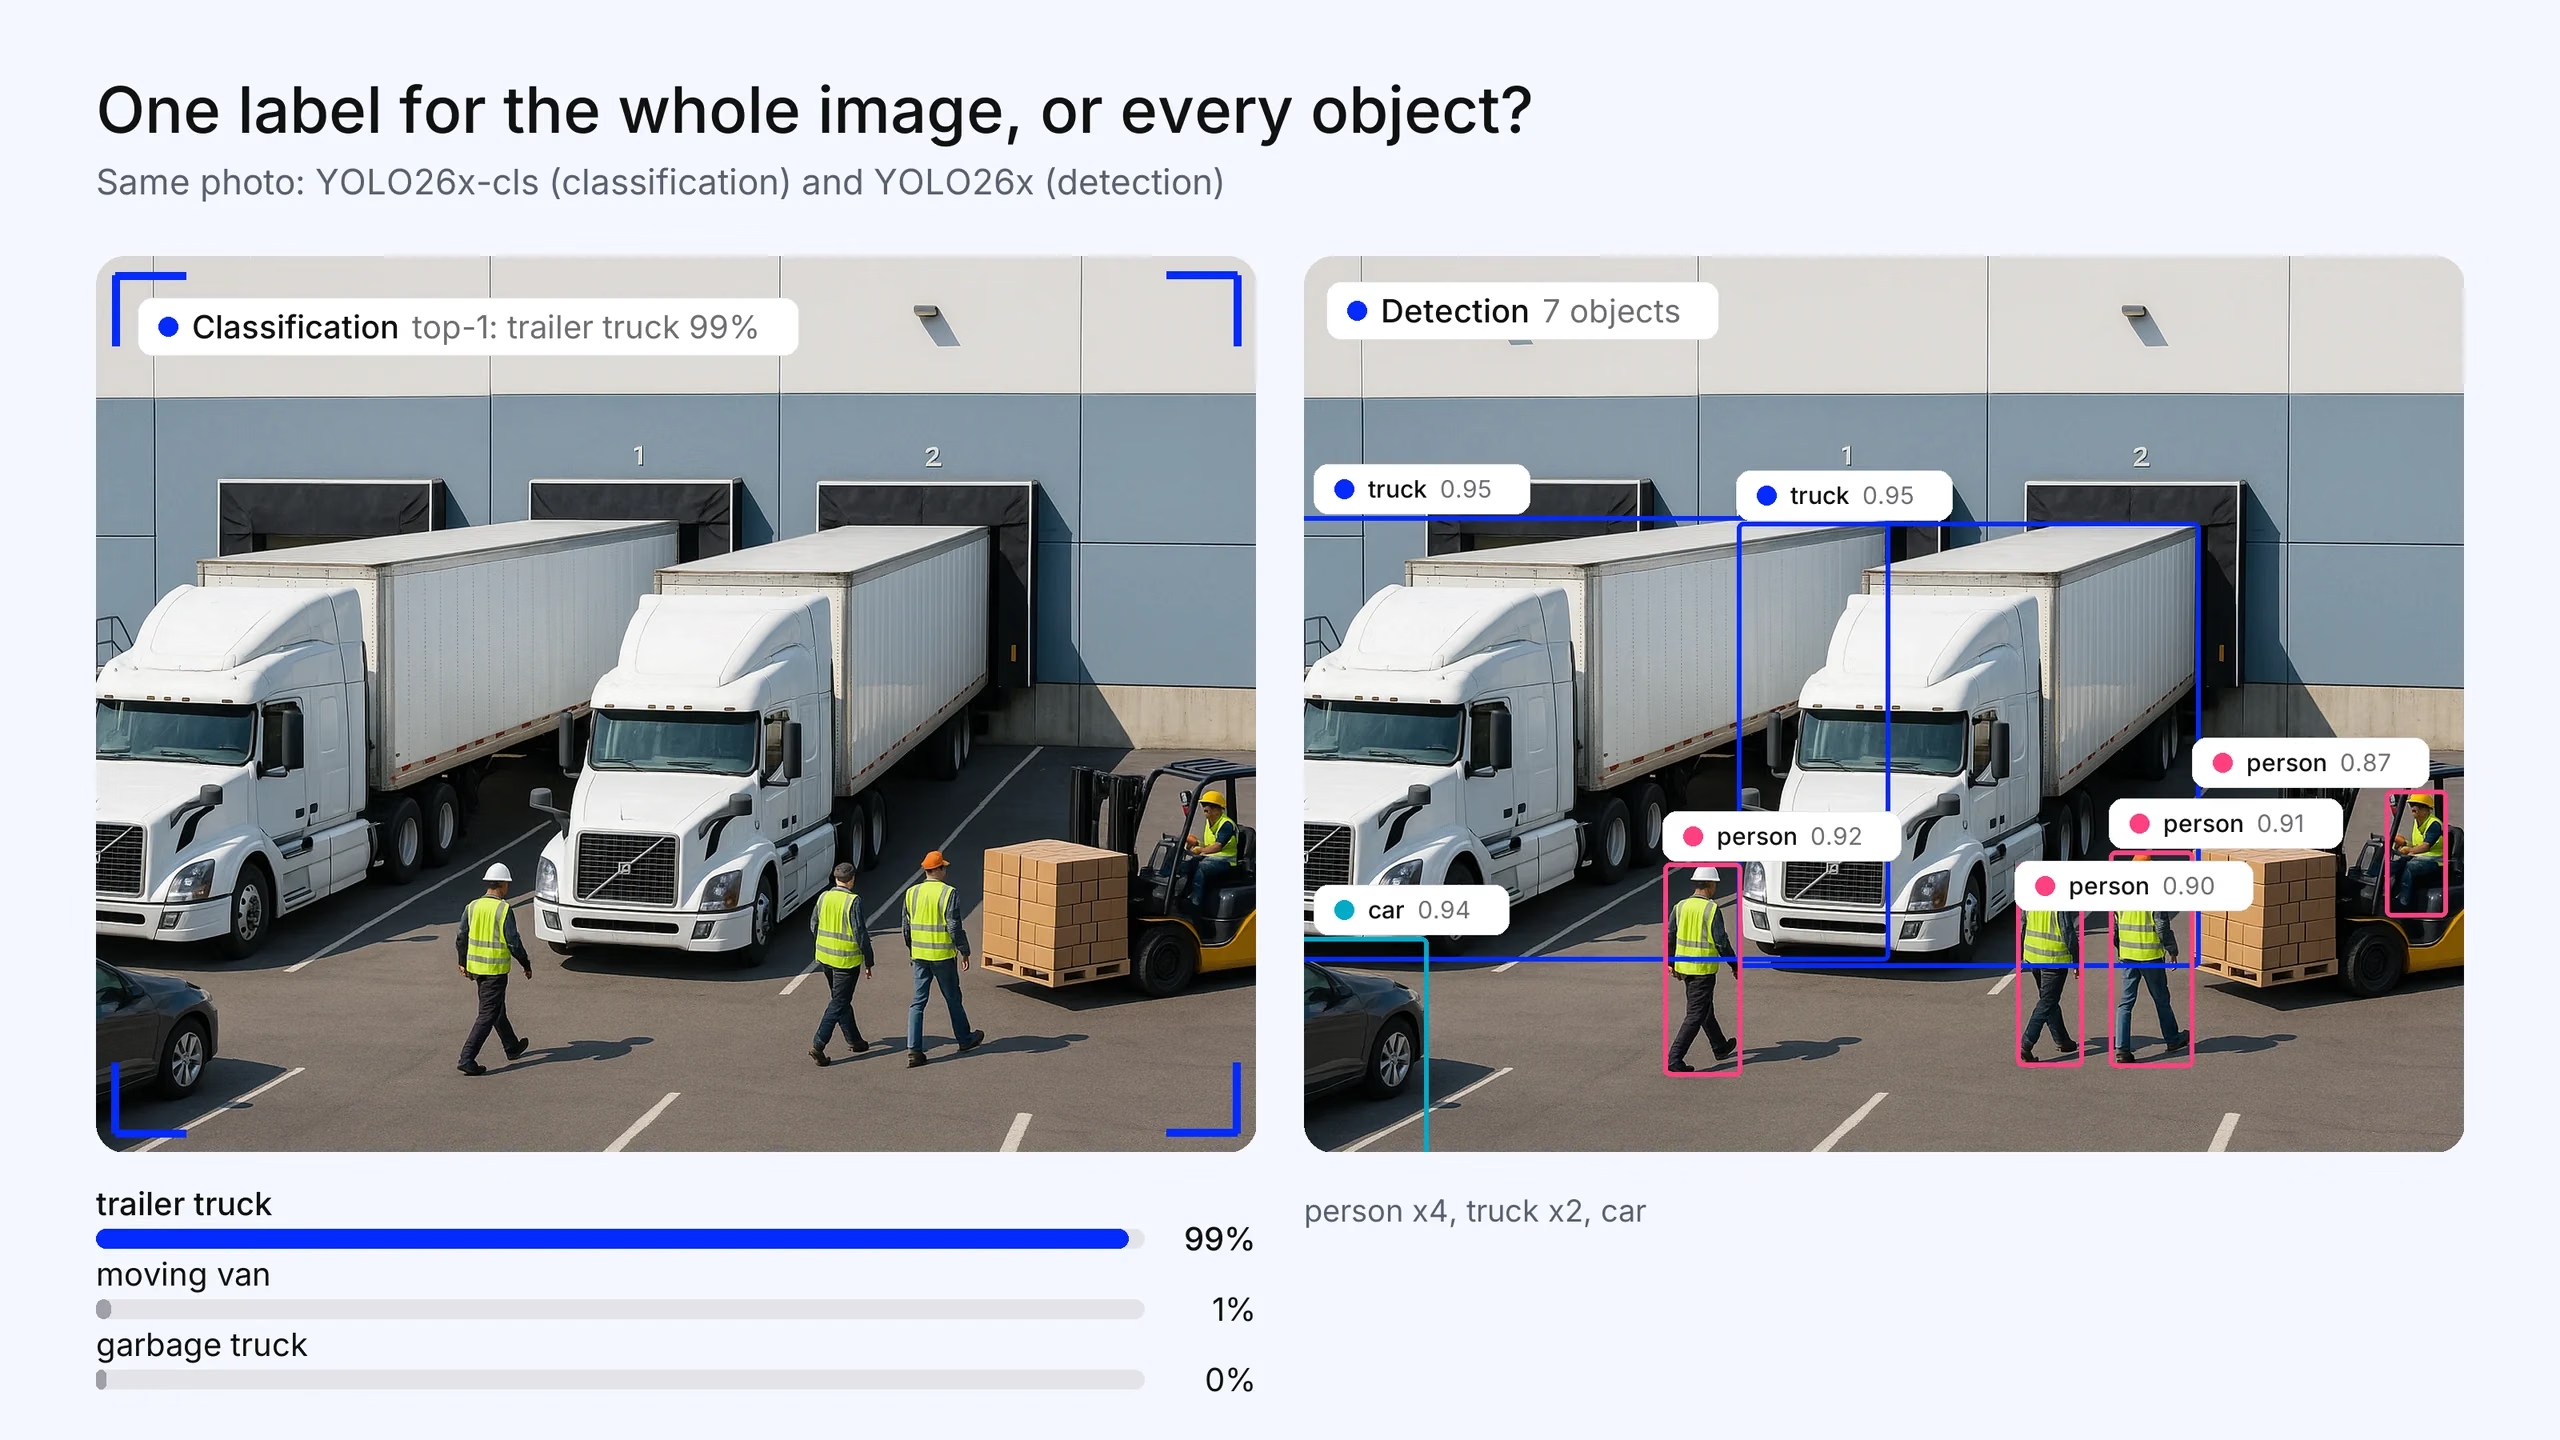
Рис. 3. На сцене со множеством объектов классификатор по-прежнему выдаёт одну метку: Ultralytics YOLO26x-cls классифицирует эту площадку для грузовиков как «грузовик с прицепом» с вероятностью 99%. Детектор Ultralytics YOLO26 находит 7 объектов: 4 человека, 2 грузовика и легковой автомобиль, каждый со своей рамкой (уверенность 0,5 или выше). Фотография создана для этой статьи; результаты — настоящие.
Где найти предварительно обученные модели и обучить собственную#
- timm (модели изображений PyTorch) объединяет большинство упомянутых выше бэкбонов — от ViT и ConvNeXt до MobileNetV4, EVA и DINOv3 — и предоставляет скрипты для обучения и оценки. Код распространяется по лицензии Apache 2.0; лицензии на веса различаются.
- Hugging Face размещает большинство трансформерных классификаторов, включая SigLIP 2 и DINOv3, а также готовые пайплайны для zero-shot и классификации изображений.
- Пакет Ultralytics для Python обучает YOLO26-cls на папке с изображениями, отсортированными по классам. Смотри формат набора данных для классификации и руководство по задаче классификации.
- Платформа Ultralytics добавляет аннотирование и обучение в облаке для тех же моделей. Она запущена в 2026 году, поэтому новее давно работающих облачных сервисов для обучения. Сравнение платформ для запуска обученных моделей смотри в нашем обзоре платформ для инференса компьютерного зрения.
Часто задаваемые вопросы
Универсального ответа нет. Для задач, где прежде всего важна точность и доступно достаточно вычислительных ресурсов, в первую очередь стоит оценить крупные трансформерные бэкбоны и бэкбоны с самообучением, например EVA-02 и DINOv3. Для запуска в production на ограниченном оборудовании практичнее CNN, например ConvNeXt V2, EfficientNetV2, MobileNetV4 и Ultralytics YOLO26-cls. Для классификации без размеченных данных подходит SigLIP 2 с классификацией zero-shot.
Трансформеры обычно выигрывают при предварительном обучении на очень больших наборах данных и отсутствии жёстких ограничений на вычисления. CNN обычно выигрывают на небольших и средних наборах данных и на периферийном оборудовании: заложенные в них предположения о локальной структуре помогают эффективнее использовать данные и работать быстрее. Современные CNN, например ConvNeXt, сократили разрыв в точности, а гибриды, например CoAtNet, объединяют оба подхода.
Да. DINOv3 — бэкбон общего назначения. Извлеки признаки с помощью замороженной модели и обучи поверх них небольшой линейный классификатор; в репозитории Meta также есть голова классификации ImageNet для самой крупной модели. Перед коммерческим использованием проверь лицензию DINOv3.
В основном используют точность top-1 (верно предсказан класс с наивысшей оценкой) и top-5 (верный класс входит в пятёрку предсказаний с наивысшими оценками), обычно на валидационной выборке ImageNet. Для несбалансированных пользовательских наборов данных информативнее точность, полнота или F1 по каждому классу, чем общая точность.









