Cách huấn luyện YOLO trên dữ liệu Amazon S3 và triển khai API được lưu trữ bằng Ultralytics Platform
Từng bước huấn luyện Ultralytics YOLO26 trên hình ảnh trong bucket Amazon S3 và triển khai dưới dạng API được lưu trữ bằng Ultralytics Platform, so sánh với SageMaker.
 Miles Deans17 phút đọc
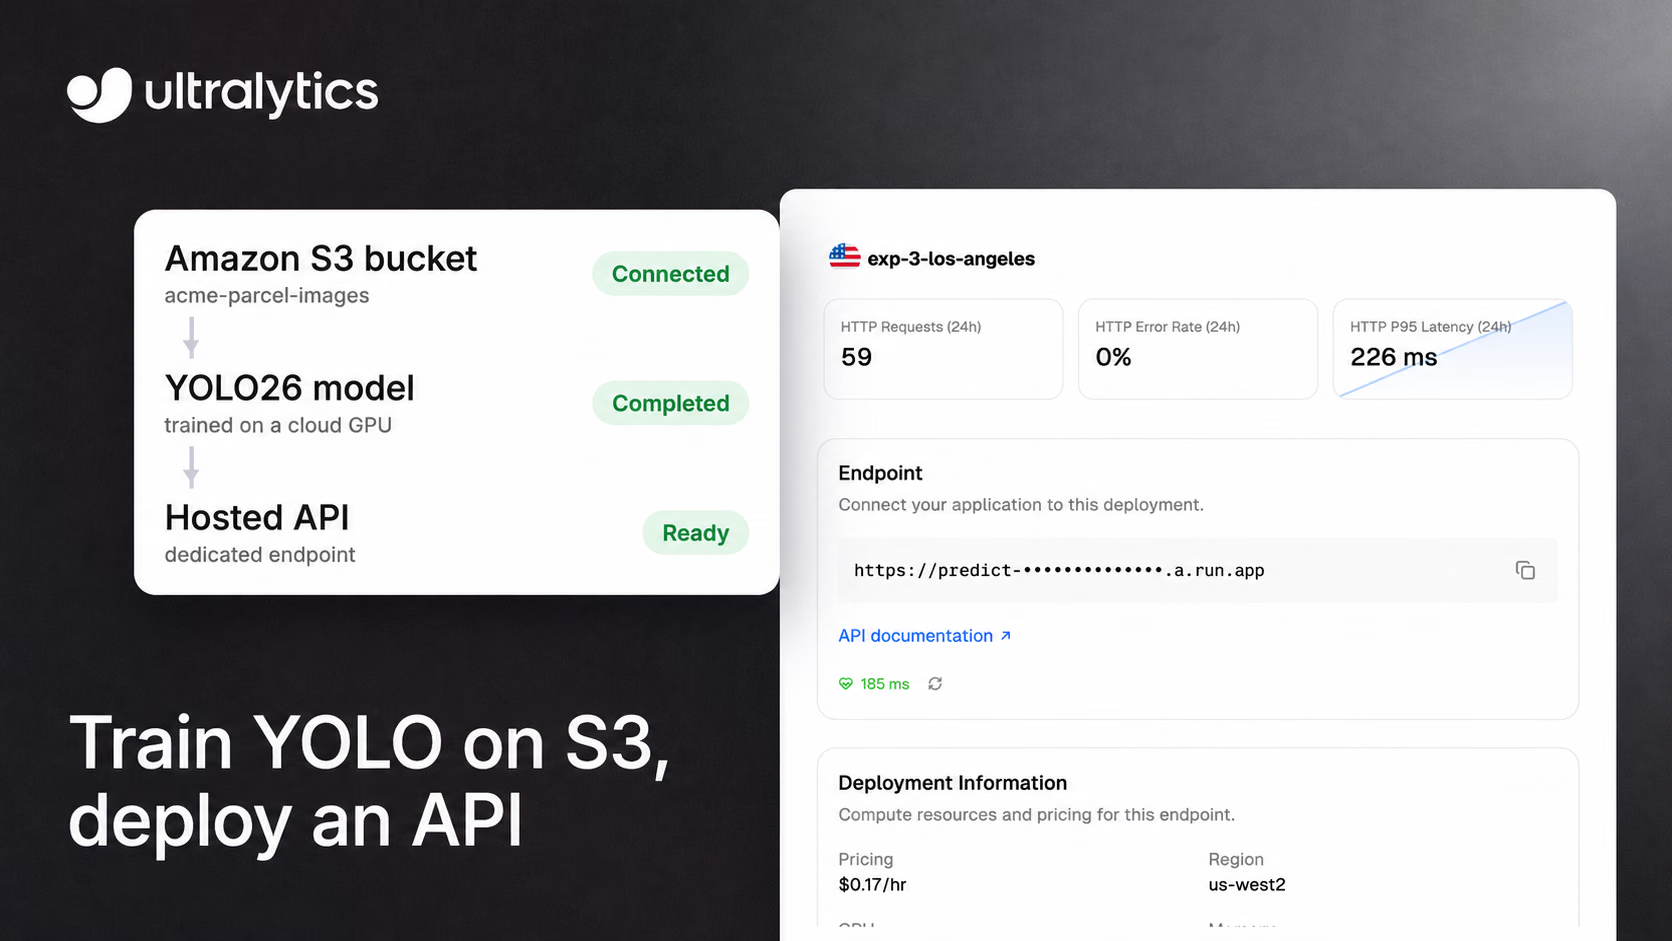
Nếu hình ảnh của bạn đã nằm trong bucket Amazon S3, bạn có thể huấn luyện model Ultralytics YOLO trên đó và triển khai thành API được lưu trữ mà không cần tải lên bản sao thứ hai của dataset. Ultralytics Platform lập chỉ mục bucket tại chỗ, cho phép bạn gắn nhãn và huấn luyện YOLO26 trên GPU đám mây, rồi triển khai model đã huấn luyện lên endpoint chuyên dụng mà bạn gọi qua HTTPS. Hướng dẫn này trình bày từng bước, từ chính sách IAM đến dự đoán đầu tiên, đồng thời so sánh quy trình với Amazon SageMaker, Google Vertex AI và Azure Machine Learning.
Quy trình tương tự áp dụng cho Google Cloud Storage và Azure Blob Storage, thay khóa truy cập AWS bằng khóa JSON của tài khoản dịch vụ hoặc chuỗi kết nối khóa truy cập tài khoản.
Quy trình hoạt động như thế nào#
Pipeline gồm năm giai đoạn. Hình ảnh gốc vẫn nằm trong bucket của bạn, còn quá trình huấn luyện trên đám mây sử dụng các bản sao tạm thời trong suốt mỗi lượt chạy:
- Kết nối bucket S3 bằng người dùng IAM chỉ có quyền đọc.
- Lập chỉ mục một thư mục làm dataset trên Platform. Platform đọc kích thước hình ảnh và mọi nhãn YOLO tìm thấy, đồng thời không lưu trữ bản sao thứ hai của hình ảnh.
- Gắn nhãn hình ảnh trên trình duyệt hoặc giữ nguyên các nhãn YOLO đã có trong bucket.
- Huấn luyện model YOLO26 trên GPU đám mây. Quá trình huấn luyện dùng các bản sao tạm thời của hình ảnh trong suốt lượt chạy.
- Triển khai model lên endpoint chuyên dụng tại một trong 42 khu vực và gửi hình ảnh đến đó bằng API key.
Các dataset phát hiện, phân đoạn, tư thế và hộp giới hạn định hướng (OBB) được nhận diện dựa trên cấu trúc nhãn, vì vậy các bước tương tự áp dụng cho từng tác vụ thị giác máy tính.
Trước khi bắt đầu: gói dịch vụ, quyền và ranh giới dữ liệu#
Bạn cần ba thứ:
- Không gian làm việc Pro hoặc Enterprise. Dataset Amazon S3, Google Cloud Storage và Azure Blob Storage yêu cầu gói Pro hoặc Enterprise. Pro có giá $29 mỗi chỗ mỗi tháng và bao gồm $30 tín dụng mỗi chỗ mỗi tháng cho tài nguyên tính toán tính phí theo mức sử dụng, chẳng hạn như huấn luyện trên đám mây.
- Vai trò quản trị viên hoặc chủ sở hữu không gian làm việc, cần thiết để kết nối bộ lưu trữ đám mây.
- Người dùng AWS IAM có quyền liệt kê và đọc bucket.
Bạn nên nắm rõ dữ liệu nào rời khỏi bucket trước khi kết nối. Platform truyền trực tiếp dữ liệu gốc theo yêu cầu để duyệt và chú giải, còn hình ảnh đã lập chỉ mục không tính vào hạn mức lưu trữ Platform. Mỗi kết nối có công tắc Tính năng AI, được bật theo mặc định. Khi bật, GPU Ultralytics có thể đọc hình ảnh để chú giải, tìm kiếm hình ảnh tương tự và huấn luyện trên đám mây. Các nhà cung cấp AI bên ngoài cũng có thể xử lý hình ảnh cho những model chú giải có tính phí bằng khóa nhà cung cấp trong không gian làm việc của bạn, cũng như tạo hình ảnh khi quyền ghi được bật. Huấn luyện trên đám mây dùng các bản sao tạm thời trong suốt lượt chạy; tính năng tìm kiếm hình ảnh tương tự giữ lại embedding cho đến khi hình ảnh bị xóa khỏi Platform. Tắt tính năng này sẽ ngăn bắt đầu các tác vụ AI mới (tác vụ đang chạy sẽ hoàn tất), trong khi chú giải thủ công và huấn luyện cục bộ vẫn hoạt động. Platform không bao giờ sửa đổi hoặc xóa đối tượng của bạn.
Bước 1: Tạo người dùng IAM chỉ có quyền đọc#
Trong bảng điều khiển AWS, mở IAM > Users, tạo người dùng không có quyền truy cập bảng điều khiển và gắn chính sách cấp quyền liệt kê và đọc bucket:
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}
s3:ListAllMyBuckets là tùy chọn. Tính năng này cho phép Platform tìm các bucket để bạn không phải nhập tên bucket.
Sau đó, mở tab Security credentials của người dùng và tạo access key. Platform yêu cầu khóa người dùng IAM có thời hạn dài: Platform từ chối thông tin xác thực AWS STS tạm thời, bao gồm thông tin xác thực phiên vai trò và khóa IAM Identity Center, vì chúng sẽ hết hạn khi dataset vẫn còn được kết nối. Hãy dùng một người dùng chuyên biệt cho mục đích này, tuyệt đối không dùng thông tin xác thực root. Platform mã hóa khóa khi lưu trữ bằng AES-256-GCM và không bao giờ để lộ khóa cho các workload huấn luyện; bạn có thể thu hồi quyền truy cập bất cứ lúc nào bằng cách vô hiệu hóa khóa trong IAM.
Bước 2: Kết nối bucket với Ultralytics Platform#
- Trong Platform, mở Settings > Integrations và chọn Amazon S3.
- Nhập access key ID, secret access key và khu vực của bucket, ví dụ
us-east-1. - Nhấp Find available buckets và chọn các bucket cần kết nối, hoặc nhập tên bucket nếu chính sách không cho phép tìm kiếm.
- Nhấp Connect. Platform kiểm tra khả năng liệt kê và đọc từng bucket trước khi lưu bất kỳ thông tin nào.
Một kết nối chỉ đọc bucket trong một khu vực, vì vậy hãy kết nối một lần cho mỗi khu vực nếu dữ liệu của bạn nằm rải rác ở nhiều khu vực. Hướng dẫn tích hợp Amazon S3 trình bày quyền ghi tùy chọn được dùng để tạo hình ảnh.
Bước 3: Tạo dataset từ bucket#
Nhấp New Dataset, mở tab Cloud, chọn bucket, duyệt đến thư mục chứa dữ liệu và tạo dataset. Platform liệt kê thư mục một lần rồi lập chỉ mục những gì tìm thấy:
- Hình ảnh: các đối tượng
.jpg,.jpeg,.png,.webpvà.avif. - Nhãn: các tệp YOLO
.txt, được ghép theo cấu trúc chuẩnimages/đếnlabels/hoặc dưới dạng tệp nằm cạnh từng hình ảnh. - Lớp: tệp
data.yamlcung cấp tên lớp, như trong một dataset YOLO thông thường. - Phân chia: tên thư mục
train,valvàtesttự động gán các phân chia.
Một lần nhập có thể lập chỉ mục tối đa 500.000 đối tượng, vì vậy hãy chia các bucket lớn hơn thành nhiều dataset. Xem các đối tượng đã lập chỉ mục là bất biến: mỗi hình ảnh được gắn với ETag của đối tượng S3 tương ứng và Platform sẽ ngừng cung cấp hình ảnh nếu hình ảnh bị ghi đè. Để bổ sung dữ liệu sau này, hãy tải lên các đối tượng mới và tạo dataset mới, vì chỉ mục được tạo một lần khi dataset được tạo.
Bước 4: Gắn nhãn hoặc kiểm tra hình ảnh#
Mở dataset để xem lại các nhãn đã nhập trong trình chỉnh sửa chú giải. Nếu bucket chưa có nhãn, bạn có thể tự vẽ bounding box và mask hoặc, khi bật tính năng AI, dùng chú giải thông minh (SAM cho phát hiện, phân đoạn và OBB; YOLO cho tư thế) cùng tính năng tự động chú giải để tăng tốc quy trình. Nhãn được lưu trong Platform, còn các đối tượng trong bucket không thay đổi.
Bước 5: Huấn luyện YOLO26 trên GPU đám mây#
Nhấp New Model trên dataset hoặc dự án, chọn model cơ sở và bắt đầu lượt chạy trên đám mây:
- Model cơ sở: chọn model Ultralytics chính thức (khuyến nghị YOLO26) hoặc một model của riêng bạn để fine-tune. Chỉ các model tương thích với tác vụ của dataset mới được liệt kê.
- Tham số: đặt số epoch, kích thước hình ảnh và batch size, hoặc giữ nguyên giá trị mặc định.
- GPU: chọn GPU từ Ultralytics Cloud. Hộp thoại hiển thị mức giá theo giờ và ước tính thời lượng cùng tổng chi phí của lượt chạy trước khi bạn bắt đầu. Hướng dẫn chọn GPU đám mây của chúng tôi giúp bạn cân nhắc các phương án.
Các chỉ số, đầu ra console và biểu đồ hệ thống được truyền trực tiếp đến trình duyệt trong khi lượt chạy đang hoạt động, còn checkpoint được tự động lưu. Khi quá trình huấn luyện hoàn tất, trang model hiển thị các chỉ số và, khi có kết quả validation, phân tích chi tiết như ma trận nhầm lẫn.
Bước 6: Triển khai model dưới dạng API được lưu trữ#
Mở tab Deploy của model. Bản đồ và bảng liệt kê 42 khu vực, được sắp xếp theo độ trễ đo được từ vị trí của bạn. Nhấp Deploy tại khu vực mong muốn, xem lại CPU, bộ nhớ và giá, rồi nhấp Create Deployment.
Kích thước bạn chọn quyết định cách tính phí:
- Kích thước mặc định (1 vCPU, 2 GiB): miễn phí và giảm về 0 khi không hoạt động.
- Kích thước tùy chỉnh (tối đa 8 vCPU và 32 GiB): duy trì một instance luôn sẵn sàng và tính phí theo mức giá mỗi giờ được hiển thị của khu vực, từ khi endpoint sẵn sàng đến khi bạn dừng endpoint, kể cả thời gian nhàn rỗi.
Mỗi endpoint chuyên dụng là dịch vụ dành riêng cho một tenant, có URL và tính năng giám sát riêng, đồng thời được liên kết với một API key từ không gian làm việc của bạn. Không gian làm việc miễn phí có thể chạy 3 deployment, gói Pro có thể chạy 10 và gói Enterprise không giới hạn. Để biết khi nào endpoint chuyên dụng là lựa chọn tốt hơn so với suy luận dùng chung, hãy xem hướng dẫn suy luận chuyên dụng và suy luận dùng chung của chúng tôi.
Bước 7: Gọi endpoint#
Cài đặt Requests bằng python -m pip install requests và lưu hình ảnh dưới tên image.jpg. Thay URL ví dụ bằng URL đã sao chép của deployment, theo sau là /predict, rồi thay YOUR_API_KEY bằng khóa được liên kết với deployment đó:
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
Yêu cầu tương tự bằng cURL:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
  -F "imgsz=640"
Mỗi endpoint cũng cung cấp tài liệu tham khảo API tương tác tại /docs và một bước kiểm tra /health. Yêu cầu trực tiếp bỏ qua giới hạn tốc độ của Platform API, nhưng mỗi endpoint chỉ có một instance phục vụ: các yêu cầu không thể được xử lý kịp thời sẽ nhận 429 cùng header Retry-After, còn phần thân yêu cầu bị giới hạn ở 32 MB. Khi endpoint hoạt động, bạn có thể giám sát các yêu cầu, lỗi và độ trễ từ trang deployment.
Tổng quan về chi phí, giới hạn và bảo mật#
| Hạng mục | Thông tin cần biết |
|---|---|
| Gói | Gói Pro ($29 mỗi chỗ mỗi tháng) hoặc Enterprise cho dataset S3, Google Cloud Storage và Azure Blob |
| Lưu trữ | Hình ảnh đã lập chỉ mục vẫn nằm trong bucket của bạn và không dùng hạn mức lưu trữ Platform |
| Huấn luyện | Tính phí theo thời gian sử dụng GPU, trừ vào tín dụng; hộp thoại ước tính chi phí trước khi bạn bắt đầu |
| Endpoint | Kích thước mặc định miễn phí và giảm về 0 khi không hoạt động; kích thước tùy chỉnh tính phí theo giờ khi đang chạy |
| Quy mô nhập dữ liệu | Tối đa 500.000 đối tượng cho mỗi lần nhập |
| Thông tin xác thực | Khóa người dùng IAM có thời hạn dài, được mã hóa khi lưu trữ và không bao giờ để lộ cho workload huấn luyện |
| Không khả dụng trên dataset S3 | Sao chép dataset, snapshot phiên bản, làm mờ khuôn mặt, dán hình ảnh từ dataset khác |
Ultralytics Platform so với SageMaker, Vertex AI và Azure ML#
Các nền tảng ML đám mây đa dụng cũng có thể huấn luyện trên dữ liệu trong bộ lưu trữ riêng và phục vụ model. Các cột về lưu trữ và phục vụ bên dưới dựa trên tài liệu của từng nền tảng; cột cuối là đánh giá của chúng tôi.
| Nền tảng | Vị trí lưu dữ liệu huấn luyện | Các tùy chọn phục vụ model | Trường hợp phù hợp được đề xuất (đánh giá của chúng tôi) |
|---|---|---|---|
| Ultralytics Platform với Ultralytics YOLO | Lập chỉ mục tại chỗ từ S3, Google Cloud Storage hoặc Azure Blob | Endpoint chuyên dụng dùng một instance tại 42 khu vực; kích thước mặc định hỗ trợ giảm về 0 | Các nhóm muốn đưa tính năng phát hiện, phân đoạn, tư thế hoặc OBB bằng YOLO từ bucket lên API mà không cần viết mã huấn luyện hay phục vụ model |
| Amazon SageMaker AI | Các job huấn luyện đọc dữ liệu từ Amazon S3, Amazon EFS hoặc Amazon FSx for Lustre | Endpoint thời gian thực với tự động mở rộng quy mô, serverless và suy luận bất đồng bộ | Các nhóm đã chạy pipeline ML trên AWS và muốn tự chọn container cùng tùy chọn phục vụ model |
| Google Vertex AI | Job huấn luyện serverless gắn các bucket Cloud Storage có thể truy cập vào /gcs/ | Endpoint được quản lý cho suy luận trực tuyến | Các nhóm đã chuẩn hóa trên dữ liệu và công cụ của Google Cloud |
| Azure Machine Learning | Kho dữ liệu tham chiếu đến bộ lưu trữ Azure hiện có, chẳng hạn như Blob Storage | Endpoint trực tuyến được quản lý cho suy luận thời gian thực | Các nhóm đã chuẩn hóa trên Azure |
Tài liệu về dữ liệu huấn luyện của SageMaker liệt kê S3, EFS và FSx for Lustre là các nguồn dữ liệu với chế độ đầu vào truyền trực tiếp và tải xuống. Suy luận serverless của SageMaker tự quản lý việc mở rộng quy mô, phù hợp với lưu lượng có những khoảng thời gian nhàn rỗi và có thể chấp nhận khởi động nguội; bạn có thể dùng container do SageMaker cung cấp hoặc tự mang container. Vertex AI chạy huấn luyện tùy chỉnh từ ứng dụng Python trên container dựng sẵn hoặc container tùy chỉnh, còn Azure Machine Learning kết nối với bộ lưu trữ Azure hiện có thông qua kho dữ liệu và phục vụ model bằng endpoint trực tuyến được quản lý. Phạm vi rộng đó là thế mạnh của một nền tảng đa dụng. Theo đánh giá của chúng tôi, quy trình YOLO tùy chỉnh cần cấu hình nhiều hơn; yêu cầu về container phụ thuộc vào tùy chọn huấn luyện và phục vụ model đã chọn. Nếu muốn tiếp tục sử dụng AWS, hướng dẫn triển khai SageMaker của chúng tôi trình bày cách phục vụ model YOLO trên nền tảng đó.
Ultralytics Platform được thiết kế có chủ đích với phạm vi hẹp hơn. Nền tảng này được xây dựng xoay quanh các model Ultralytics YOLO, vì vậy các bước trên thay thế script huấn luyện và container phục vụ model. Nền tảng này kém phù hợp hơn nếu tổ chức của bạn yêu cầu thông tin xác thực STS tạm thời cho mọi tích hợp hoặc nếu một endpoint phải mở rộng trên nhiều instance khi có tải đồng thời lớn. Nếu vẫn đang cân nhắc nơi chạy suy luận, hướng dẫn đám mây so với tự lưu trữ của chúng tôi so sánh chi phí, độ trễ và quyền kiểm soát dữ liệu.
Câu hỏi thường gặp
Ultralytics Platform kết nối bucket S3, lập chỉ mục hình ảnh tại chỗ, huấn luyện YOLO26 trên GPU đám mây và triển khai model lên endpoint HTTPS chuyên dụng. Amazon SageMaker AI cũng huấn luyện từ S3 và cung cấp suy luận thời gian thực, serverless và bất đồng bộ, với container do SageMaker cung cấp hoặc container tùy chỉnh tùy theo tùy chọn phục vụ model. Google Vertex AI và Azure Machine Learning cung cấp quy trình tương tự, được xây dựng quanh bộ lưu trữ riêng của chúng—Cloud Storage và bộ lưu trữ Azure—thay vì bucket S3 hiện có.
Platform không giữ bản sao thứ hai của dataset: Platform lập chỉ mục hình ảnh và truyền dữ liệu gốc theo yêu cầu. Khi bật tính năng AI, quá trình huấn luyện trên đám mây sử dụng các bản sao tạm thời bên ngoài bucket của bạn trong suốt lượt chạy, còn tính năng tìm kiếm hình ảnh tương tự lưu giữ embedding của từng hình ảnh. Platform không bao giờ sửa đổi hoặc xóa đối tượng của bạn.
Hiện tại chưa thể. Platform yêu cầu access key có thời hạn dài từ một người dùng IAM chuyên biệt và từ chối thông tin xác thực STS vì chúng hết hạn trong khi dataset vẫn đang kết nối. Giới hạn người dùng ở quyền liệt kê và đọc, đồng thời vô hiệu hóa khóa trong IAM để thu hồi quyền truy cập.
Dataset S3 cần gói Pro ($29 mỗi chỗ mỗi tháng, kèm $30 tín dụng hằng tháng cho mỗi chỗ) hoặc Enterprise. Chi phí huấn luyện được tính theo thời gian sử dụng GPU và hộp thoại huấn luyện ước tính chi phí trước khi bạn bắt đầu. Kích thước endpoint mặc định miễn phí và giảm về 0 khi không hoạt động; kích thước tùy chỉnh tính phí theo giờ khi chạy.
Có. Google Cloud Storage kết nối bằng khóa JSON của tài khoản dịch vụ và vai trò Storage Object Viewer, còn Azure Blob Storage kết nối bằng chuỗi kết nối khóa truy cập tài khoản HTTPS (không chấp nhận chuỗi token SAS). Các bước về dataset, huấn luyện và triển khai đều giống nhau.
Dataset được lập chỉ mục một lần khi tạo, vì vậy các object mới sẽ không được tự động nhận diện. Hãy thêm object mới thay vì ghi đè object hiện có, sau đó tạo một dataset mới bao gồm các object đó rồi huấn luyện hoặc fine-tune lại.
Có. Tải xuống trọng số hoặc xuất model sang các định dạng như ONNX, TensorRT và CoreML từ trang model, sau đó chạy model trên máy chủ hoặc thiết bị edge của riêng bạn bằng package Ultralytics Python.
Được viết bởi
Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.









