Ultralytics YOLO und NVIDIA Cosmos Data Factory: Synthetische Daten zur Fehlererkennung
Synthetische Daten aus NVIDIA Cosmos Data Factory und eine automatisierte, agentengesteuerte, datengestützte Trainingsschleife von NVIDIA helfen Ultralytics YOLO, mit einem Bruchteil der Labels die Genauigkeit eines Trainings mit dem vollständigen Datensatz zu erreichen.
Ultralytics und NVIDIA haben sich zusammengeschlossen, um zu zeigen, was gezielt ausgewählte Trainingsdaten für Ultralytics YOLO leisten können. Die agentengesteuerte, datengestützte Trainingsschleife von NVIDIA ermittelt, welche Bilder ein Modell benötigt, NVIDIA Cosmos Data Factory erzeugt Bilder, die noch nicht existieren, und Ultralytics YOLO ist das Modell, das mit den Ergebnissen trainiert wird. Unser Team für maschinelles Lernen (ML) hat die Kombination anhand von 19 öffentlichen Benchmarks für die industrielle Inspektion getestet und Ultralytics YOLO26, trainiert mit der agentengesteuerten Pipeline von NVIDIA und synthetischen Daten aus Cosmos Data Factory, mit demselben Modell verglichen, das auf herkömmliche Weise trainiert wurde. Dieser Beitrag stellt die Ergebnisse vor.
Mehr Daten sind nicht die Lösung. Die richtigen Daten sind es.#
Jedes Inspektionsteam kennt dieses Muster: Ein Modell zur Fehlererkennung erzielt gute Ergebnisse bei Fehlern, die es häufig gesehen hat, übersieht dann aber den seltenen Kratzer, die ungewöhnliche Beleuchtung oder den ungewohnten Kamerawinkel, der in der Produktionslinie am wichtigsten ist. Üblicherweise sammelt und beschriftet man einfach mehr von allem. Das ist langsam, teuer und liefert meist zusätzliche Bilder, mit denen das Modell bereits gut zurechtkommt.
Das automatisierte, agentengesteuerte Training von NVIDIA verfolgt einen anderen Ansatz: Es ermittelt gezielt Schwachstellen in einem Datensatz und behebt sie mit bereits vorhandenen realen Bildern oder – wenn es keine realen Beispiele gibt – mit synthetischen Bildern aus Cosmos Data Factory. In Kombination mit Ultralytics YOLO bedeutet das, dass ein Modell genau mit den Daten trainiert wird, die ihm noch fehlen.
Wie funktioniert die datengestützte Trainingsschleife von NVIDIA?#
Die agentengesteuerte, datengestützte Trainingsschleife von NVIDIA für Ultralytics YOLO ist eine Pipeline zur Modellverbesserung, die die Trainingsschleife umschließt und entscheidet, welche Daten das Modell als Nächstes benötigt:
• Durchsucht reale Daten. Sie durchsucht vorhandene Bildsammlungen nach realen Beispielen, die gezielte Lücken im Trainingssatz schließen.
• Erzeugt synthetische Daten. Wenn es keine realen Beispiele gibt, erzeugt sie mithilfe von Cosmos Data Factory Bilder seltener Sonderfälle.
• Beschriftet automatisch. Eine Komponente namens AnomalyGen beschriftet die synthetischen Bilder, sodass vor dem erneuten Training keine manuelle Annotation erforderlich ist.
Die Leitidee ist, gezielt Daten auszuwählen, statt einfach den Datenbedarf zu senken. Es geht nicht bloß darum, mit weniger Daten zu trainieren. Stattdessen sollen die Lücken in einem Datensatz, in denen das Modell Schwächen zeigt, präzise geschlossen werden – durch das Auffinden oder Erzeugen von Daten – und das Modell anschließend mit diesem erweiterten Satz erneut trainiert werden. Wenn dies gut umgesetzt wird, ist das Training mit weniger Bildern oft ein Nebeneffekt, wie die folgenden Ergebnisse zeigen.
Die Pipeline wurde ausführlich mit Ultralytics YOLO getestet. Alle Ergebnisse in diesem Artikel basieren auf Ultralytics YOLO26.
Die Rolle von NVIDIA Cosmos Data Factory#
Cosmos Data Factory ist die Plattform von NVIDIA zur Auswahl, Verarbeitung und Erzeugung von Daten. Sie basiert auf den Weltmodellen von Cosmos. In der agentengesteuerten Trainingsschleife erzeugt sie Bilder für Szenarien, die ein realer Datensatz nur unzureichend abdeckt, etwa bestimmte Fehlerarten in der Fertigung oder die Verzerrung durch Fischaugenobjektive in Verkehrsvideos.
Die Übergabe ist einfach: Cosmos erzeugt Bilder seltener Sonderfälle, AnomalyGen beschriftet sie und Ultralytics YOLO wird mit dem kombinierten Satz aus realen und synthetischen Daten mithilfe der standardmäßigen Ultralytics-Trainingspipeline erneut trainiert.
Cosmos Data Factory im Test mit 19 öffentlichen Datensätzen#
Um zu sehen, was sich mit Cosmos Data Factory + Ultralytics YOLO erreichen lässt, ließ unser ML-Team die agentenbasierte Pipeline zur datenangereicherten Feinabstimmung mit 19 öffentlichen Datensätzen zur industriellen Inspektion laufen, die Stahl, Leiterplatten, Textilien, Metalloberflächen und Konsumgüter abdeckten und insgesamt etwa 91.000 Trainingsbilder umfassten. Bei jedem Durchlauf kam ein einzelner Host mit 8 GPUs zum Einsatz.
Der Vergleich ist bewusst streng angelegt. Die Baseline und das Modell mit Cosmos Data Factory wurden mit identischen Einstellungen trainiert: Ultralytics YOLO26x, 100 Epochen, derselbe Optimierer, dieselbe Lernrate und derselbe Startwert. Beide wurden mit demselben zurückgehaltenen Testsatz bewertet. Der einzige Unterschied besteht darin, mit welchen Bildern die Modelle trainiert wurden. Für die Baseline werden alle beschrifteten Bilder verwendet (und beim Test mit synthetischen Daten ausschließlich reale Bilder).
1. Dieselbe Genauigkeit mit einem Bruchteil der Labels#
Bei 11 der 19 Datensätze erreichte Ultralytics YOLO26x, trainiert mit der agentengesteuerten Pipeline, dieselbe Leistung wie das mit dem vollständigen Datensatz trainierte Modell. Bei diesen 11 Datensätzen waren 53 % der beschrifteten Bilder entbehrlich.
| Datensatz | beschriftet | verwendet | nicht benötigt | mAP@0.5 vollständig | mAP@0.5 kuratiert |
|---|---|---|---|---|---|
| DAGM Klasse 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| DAGM Klasse 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| DAGM Klasse 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| DAGM Klasse 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| DAGM Klasse 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| DAGM Klasse 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| DAGM Klasse 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| DAGM Klasse 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
Tabelle 1. Datensätze, bei denen Cosmos Data Factory das Modell mit vollständigen Daten erreichte. mAP@0.5 auf demselben zurückgehaltenen Testsatz.
Bei den DAGM-Datensätzen erreichte die agentenbasierte Pipeline mit nur einem Zehntel der Labels denselben Wert bei mAP@0.5 und lag bei zwei Klassen leicht vor dem Modell, das mit allen Daten trainiert wurde. Bei pcb-defect ließ die Pipeline 7.000 von 20.924 Bildern weg; der Genauigkeitsunterschied war viermal kleiner als die Schwankungen zwischen den Durchläufen.
Für Teams, die für Annotation bezahlen, ist das die zentrale Erkenntnis: Bei diesen Datensätzen floss der Großteil des Beschriftungsbudgets in Bilder, die das Ergebnis nicht veränderten.
2. Bis zu 74 % schnelleres Training#
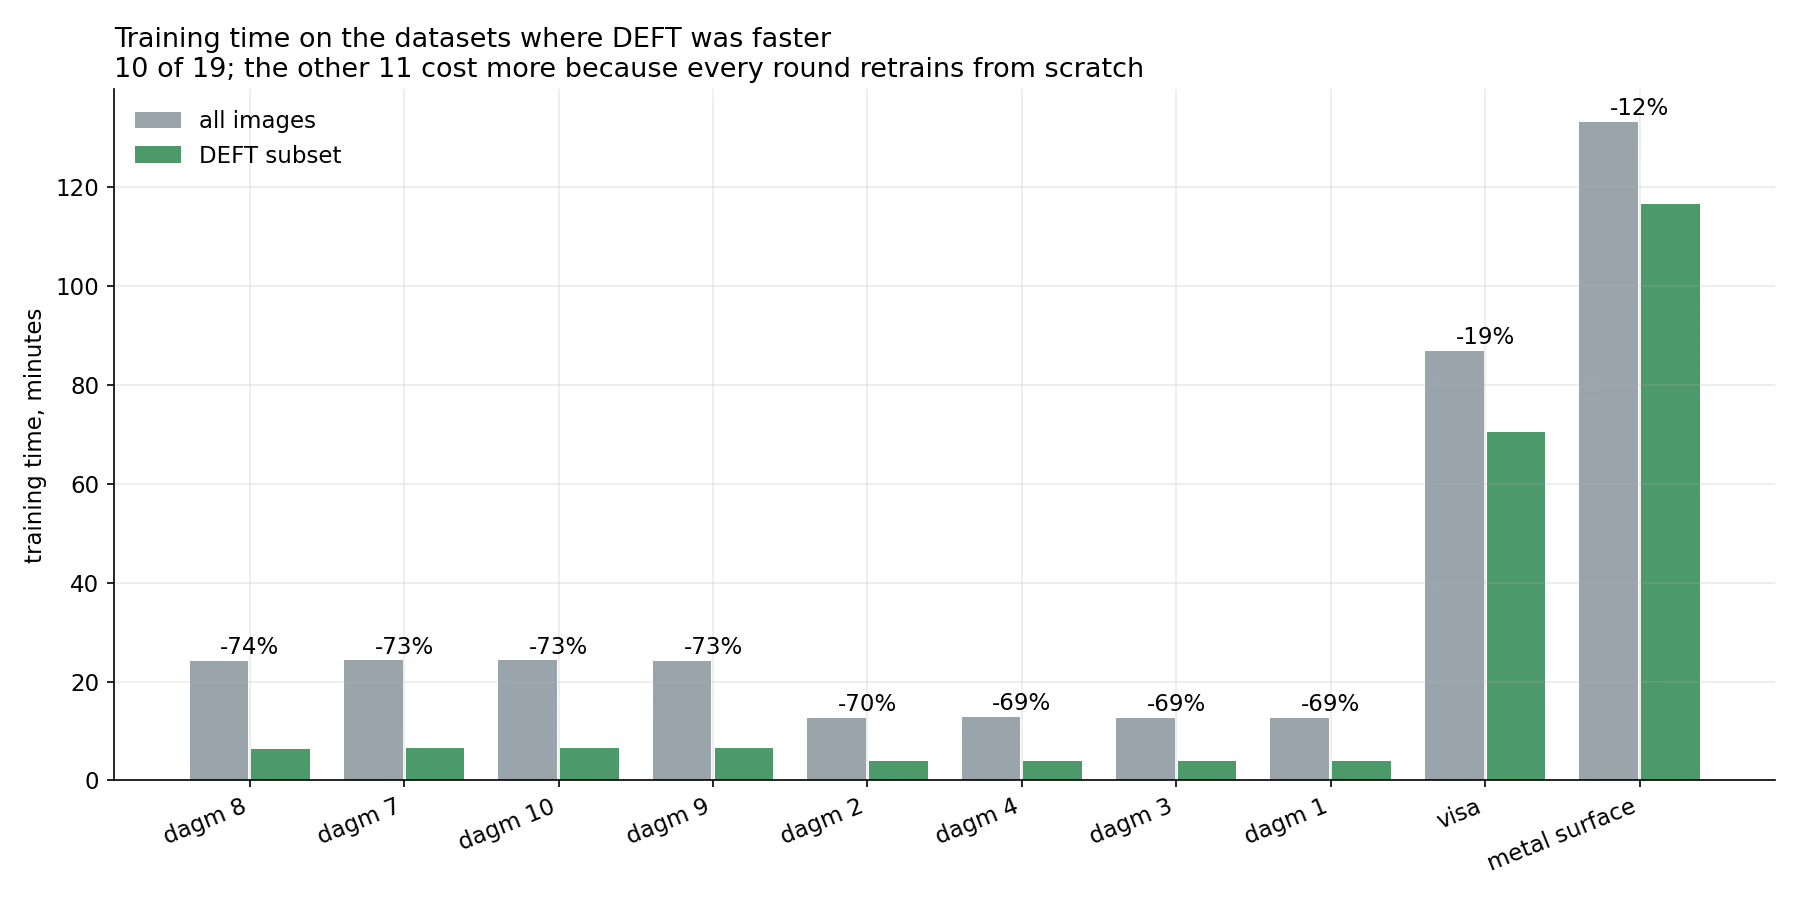
Abbildung 1. Trainingszeit mit dem vollständigen Datensatz im Vergleich zum Teilsatz aus Cosmos Data Factory bei den Datensätzen, mit denen Cosmos Data Factory schneller war.
Das Training von Ultralytics YOLO mit einem kleineren, gezielt zusammengestellten Satz senkt auch den Rechenaufwand. Bei 10 der 19 Datensätze war das Training mit der agentengesteuerten Pipeline schneller. Bei DAGM sank die Trainingszeit von 13–24 Minuten auf 4–7 Minuten, also um 69–74 %. Bei den größeren Datensätzen waren die Einsparungen geringer, aber dennoch messbar: 19 % bei VisA und 12 % bei metal-surface-defect.
Die Zeitersparnis ist nicht immer gegeben. Bei den übrigen neun Datensätzen dauerte die agentengesteuerte Pipeline länger als ein einzelner Durchlauf mit vollständigen Daten, da das Training in jeder kuratierten Runde von Grund auf neu beginnt. Ist der kuratierte Teilsatz kaum kleiner als der ursprüngliche Datensatz, überwiegt der zusätzliche Aufwand die Einsparungen.
3. Erzeugte Fehlerbilder präzisieren die Boxen#
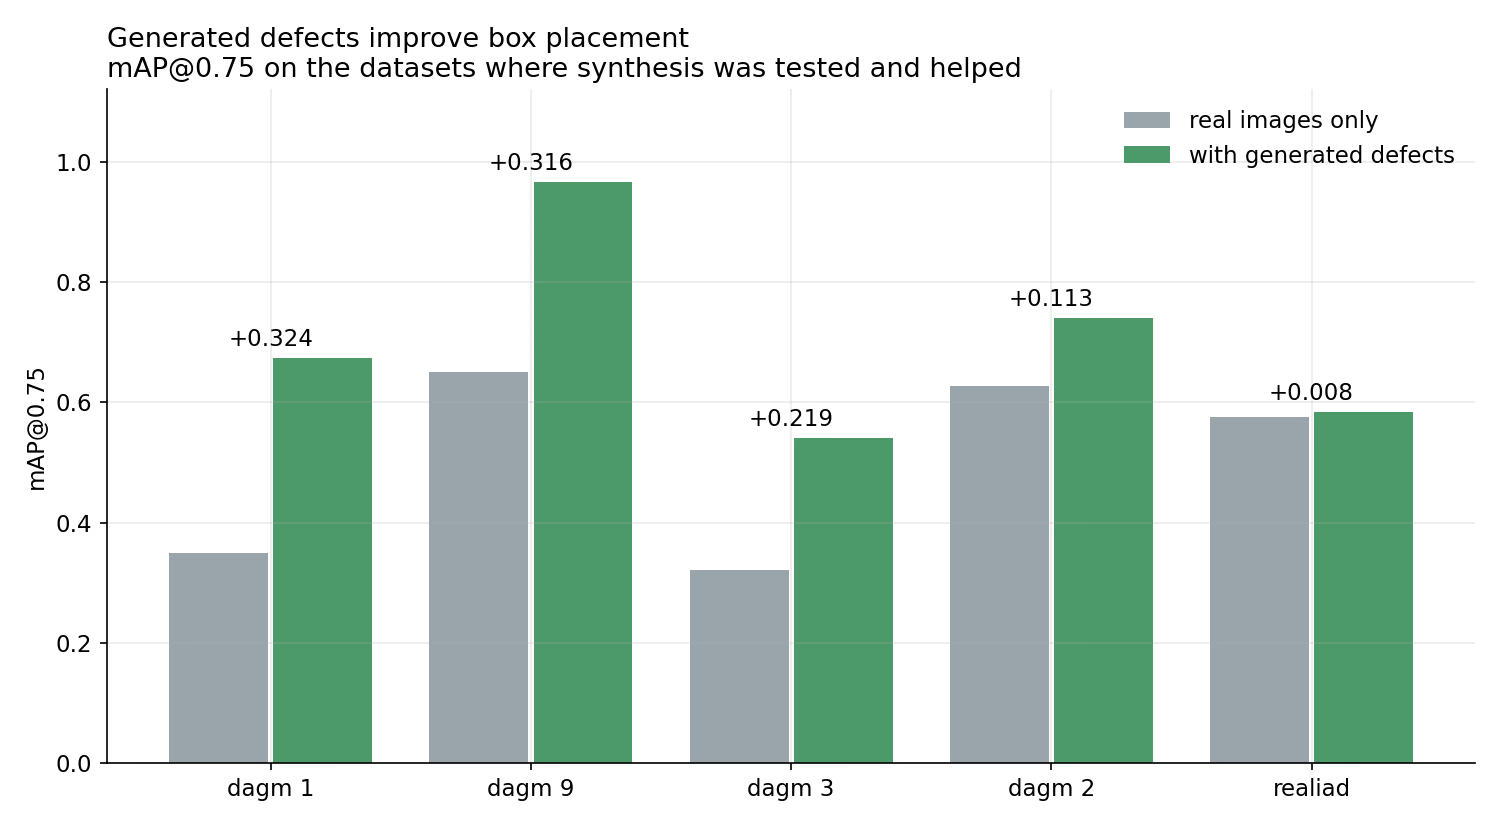
Abbildung 2. mAP@0.75 nur mit realen Bildern im Vergleich zu erzeugten Fehlerbildern bei den Datensätzen, bei denen die Erzeugung getestet wurde und Verbesserungen brachte.
Im dritten Test wurde die Wirkung synthetischer Daten isoliert betrachtet. Bei Datensätzen mit Polygonannotationen ergänzten wir die mit Cosmos Data Factory erzeugten und von AnomalyGen beschrifteten Fehlerbilder und verglichen das resultierende Ultralytics-YOLO-Modell mit einem Modell, das ausschließlich mit realen Bildern trainiert wurde.
Wir geben mAP@0.75 an, eine strengere Metrik als mAP@0.5: Eine Vorhersage zählt nur dann, wenn sich ihre Box zu mindestens 75 % mit dem tatsächlichen Fehler überschneidet. Die Metrik misst, wie präzise das Modell einen Fehler lokalisiert, nicht nur, ob es ihn überhaupt findet. Durch das Hinzufügen erzeugter Fehlerbilder stieg mAP@0.75 bei den DAGM-Klassen um 0,11 bis 0,32, und der Recall verbesserte sich bei allen getesteten Datensätzen. Der größte Sprung zeigte sich bei DAGM Klasse 9: von 0,650 auf 0,966. Bei Real-IAD fiel der Zugewinn gering aus (+0,008).
Fehler treten naturgemäß selten auf, daher gibt es von einer bestimmten Fehlerart immer nur wenige reale Beispiele. Wenn Ultralytics YOLO bereits beschriftete, erzeugte Beispiele erhält, kann das Modell Form und Ausmaß eines Fehlers exakt lernen, ohne dass jemand ein Polygon zeichnen muss.
Umfang der verwendeten synthetischen Daten#
Jeder Erzeugungslauf umfasst drei Schritte. Cosmos Data Factory ermittelt zunächst plausible Fehlerstellen in den realen Bildern (platziert). Anschließend erzeugt das Modell an diesen Stellen Bilder mit Fehlern (erzeugt), und nur eine festgelegte Höchstzahl wird in den Trainingssatz aufgenommen (behalten). Wir testeten zwei Höchstwerte: synthetische Bilder in einer Menge von 25 % oder 100 % der realen Bilder im Trainingssatz.
In 18 Erzeugungsrunden (9 Baseline- und 9 Syntheserunden) erzeugte die Pipeline 11.448 Bilder. Nur 1.481 davon – etwa jedes achte Bild – wurden behalten. Somit bestimmte der Höchstwert, wie viele synthetische Daten jedes Ultralytics-YOLO-Modell sah, nicht die Menge der erzeugten Bilder. Bei einem Höchstwert von 100 % enthielt jeder Trainingssatz ein synthetisches Bild pro realem Bild; bei 25 % etwa eines pro vier reale Bilder. Die absoluten Mengen sind gering: Bei DAGM waren es 90–180 reale Bilder und höchstens ebenso viele synthetische Bilder.
| Datensatz | Höchstwert | platziert | erzeugt | verworfen | behalten | real | Verhältnis |
|---|---|---|---|---|---|---|---|
| DAGM Klasse 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| DAGM Klasse 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| DAGM Klasse 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| DAGM Klasse 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| DAGM Klasse 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| DAGM Klasse 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| DAGM Klasse 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| Gesamt | 11,448 | 0 | 1,481 |
Tabelle 2. Erzeugte Bilder und Verhältnis von realen zu synthetischen Daten, basierend auf den Aufzeichnungen zur Erzeugung und Aufnahme aus jedem Durchlauf.
Was das für Teams bedeutet, die Inspektionsmodelle entwickeln#
Für Teams, die bereits mit Ultralytics YOLO trainieren, fügen sich Cosmos Data Factory und das automatisierte, agentengesteuerte Training von NVIDIA in die bestehende und vertraute Arbeitsweise ein: dieselben Modelle und dieselben Trainingseinstellungen, aber mit intelligenter ausgewählten Daten.
• Decke seltene Sonderfälle ab, die du nicht erfassen kannst. Automatisch beschriftete synthetische Fehlerbilder helfen Ultralytics YOLO, Fehler zu lokalisieren, für die es nur wenige reale Beispiele gibt.
• Setze das Beschriftungsbudget dort ein, wo es zählt. Bei mehr als der Hälfte der getesteten Datensätze waren die meisten Labels überflüssig. Durch gezielte Auswahl findest du die wichtigen Bilder.
• Arbeite schneller. Kleinere, kuratierte Trainingssätze verkürzen die Trainingsläufe von Ultralytics YOLO und ermöglichen bei vielen Datensätzen schnellere Experimente.
Verfügbarkeit#
Der auf Cosmos basierende Schritt zur Erzeugung synthetischer Daten ist derzeit als Beispiel und Demo verfügbar, aber noch nicht als ausgelieferte Integration.
Wenn du Cosmos Data Factory mit deinen eigenen Ultralytics-YOLO-Modellen ausprobieren möchtest, wende dich an die Teams von Ultralytics. Wir werden weiter mit NVIDIA zusammenarbeiten, während der Schritt zur Erzeugung synthetischer Daten zu einer vollständigen Integration weiterentwickelt wird.
Anhang: Testaufbau und Datensätze#
Alle Durchläufe: Ultralytics YOLO26x, 100 Epochen, identischer Optimierer, identische Lernrate und identischer Startwert für Baseline und Cosmos Data Factory; ein Host mit 8 GPUs; derselbe zurückgehaltene Testsatz für jeden Datensatz. Bei den 11 Datensätzen mit Polygonannotationen können erzeugte Fehlerbilder verwendet werden.
| Datensatz | Trainingsbilder | Annotation | Quelle |
|---|---|---|---|
| DAGM Klasse 1, 2, 3, 4 | jeweils 1.035 | Polygon | DAGM 2007 |
| DAGM Klasse 7, 8, 9, 10 | jeweils 2.070 | Polygon | DAGM 2007 |
| pcb-defect | 20,924 | Box | PCB defect |
| dspcbsd | 6,575 | Box | DsPCBSD+ |
| deeppcb | 1,000 | Box | DeepPCB |
| hripcb | 559 | Box | HRIPCB |
| metal-surface-defect | 11,845 | Box | NEU surface defect |
| tianchifabric | 10,332 | Box | Tianchi fabric |
| severstal | 10,061 | Polygon | Severstal steel |
| mvtec-ad | 4,637 | Box | MVTec AD |
| visa | 7,794 | Polygon | VisA |
| realiad-bottle-cap | 3,581 | Polygon | Real-IAD |
| Riss | 1,290 | Box | Risssegmentierung |
Tabelle 3. Die 19 Datensätze (DAGM zählt als acht, einer pro Klasse).









