GPT-6.2 Sol ou Astra pour l’annotation automatique : scores similaires, points forts différents
GPT-6.2 Sol et Astra obtiennent des scores de 0,551 et 0,546 mAP50 sur 36 jeux de données de détection, mais Sol coûte 8,10 $ pour 1 000 images contre 31,88 $. Voici lequel choisir.
 Glenn Jocher14 min de lecture
OpenAI a lancé GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026, en présentant Astra comme son modèle le plus performant et Sol comme son modèle de prédilection pour le travail quotidien. Quand nous leur avons demandé de tracer des boîtes englobantes, leurs précisions se sont révélées proches. Pas leurs prix.
Nous avons évalué les deux modèles avec UL37, notre benchmark de détection sur 36 jeux de données, le jour de leur lancement. GPT-6.2 Sol a obtenu 0,551 mAP50 et GPT-6.2 Astra 0,546, se classant quatrième et cinquième parmi 50 modèles sur notre classement VLM. Sol l’a fait pour 8,10 $ par tranche de 1 000 images. Astra a coûté 31,88 $, soit presque quatre fois plus.
Les options OpenAI Sol et Astra sont désormais disponibles pour l’annotation automatique dans Ultralytics Platform, en remplacement de GPT-6.1 Sol et GPT-6 Astra. Voici comment elles se comparent, où chacune se démarque, combien coûte un lot d’annotations et dans quels cas GPT-6.1 Terra d’OpenAI reste le meilleur choix.
Les scores de GPT-6.2 Sol et Astra ne diffèrent que d’environ 0,005 sur UL37#
UL37 mesure à quel point les boîtes d’un modèle correspondent aux annotations humaines sur 360 images : 10 provenant de chacun de 36 véritables jeux de données de détection d’objets, allant des scans médicaux et des images aériennes aux rayons de magasins, au sport, aux documents et aux circuits imprimés. Chaque image passe par le même pipeline de production que celui utilisé par les utilisateurs de Platform, avec les noms de classes propres au jeu de données et SAM 3.1 qui affine chaque boîte ; les scores décrivent donc ce pipeline de production affiné plutôt que la sortie brute du modèle. La méthodologie est publique.
Résultats UL37 du classement VLM d’Ultralytics, mis à jour le 17 novembre 2026.
Dans cet essai, les deux modèles obtiennent des résultats proches en matière de précision. Leurs scores mAP50-95, qui récompensent les boîtes bien ajustées, ne diffèrent que de 0,001, et leurs précisions de 0,003. Sol repère un peu plus d’objets annotés : son rappel de 0,643 est le plus élevé des 50 modèles du classement, juste devant les 0,642 de Gemini 4 Carbon. C’est aussi le plus rapide des sept premiers modèles, à 3,4 secondes par image.
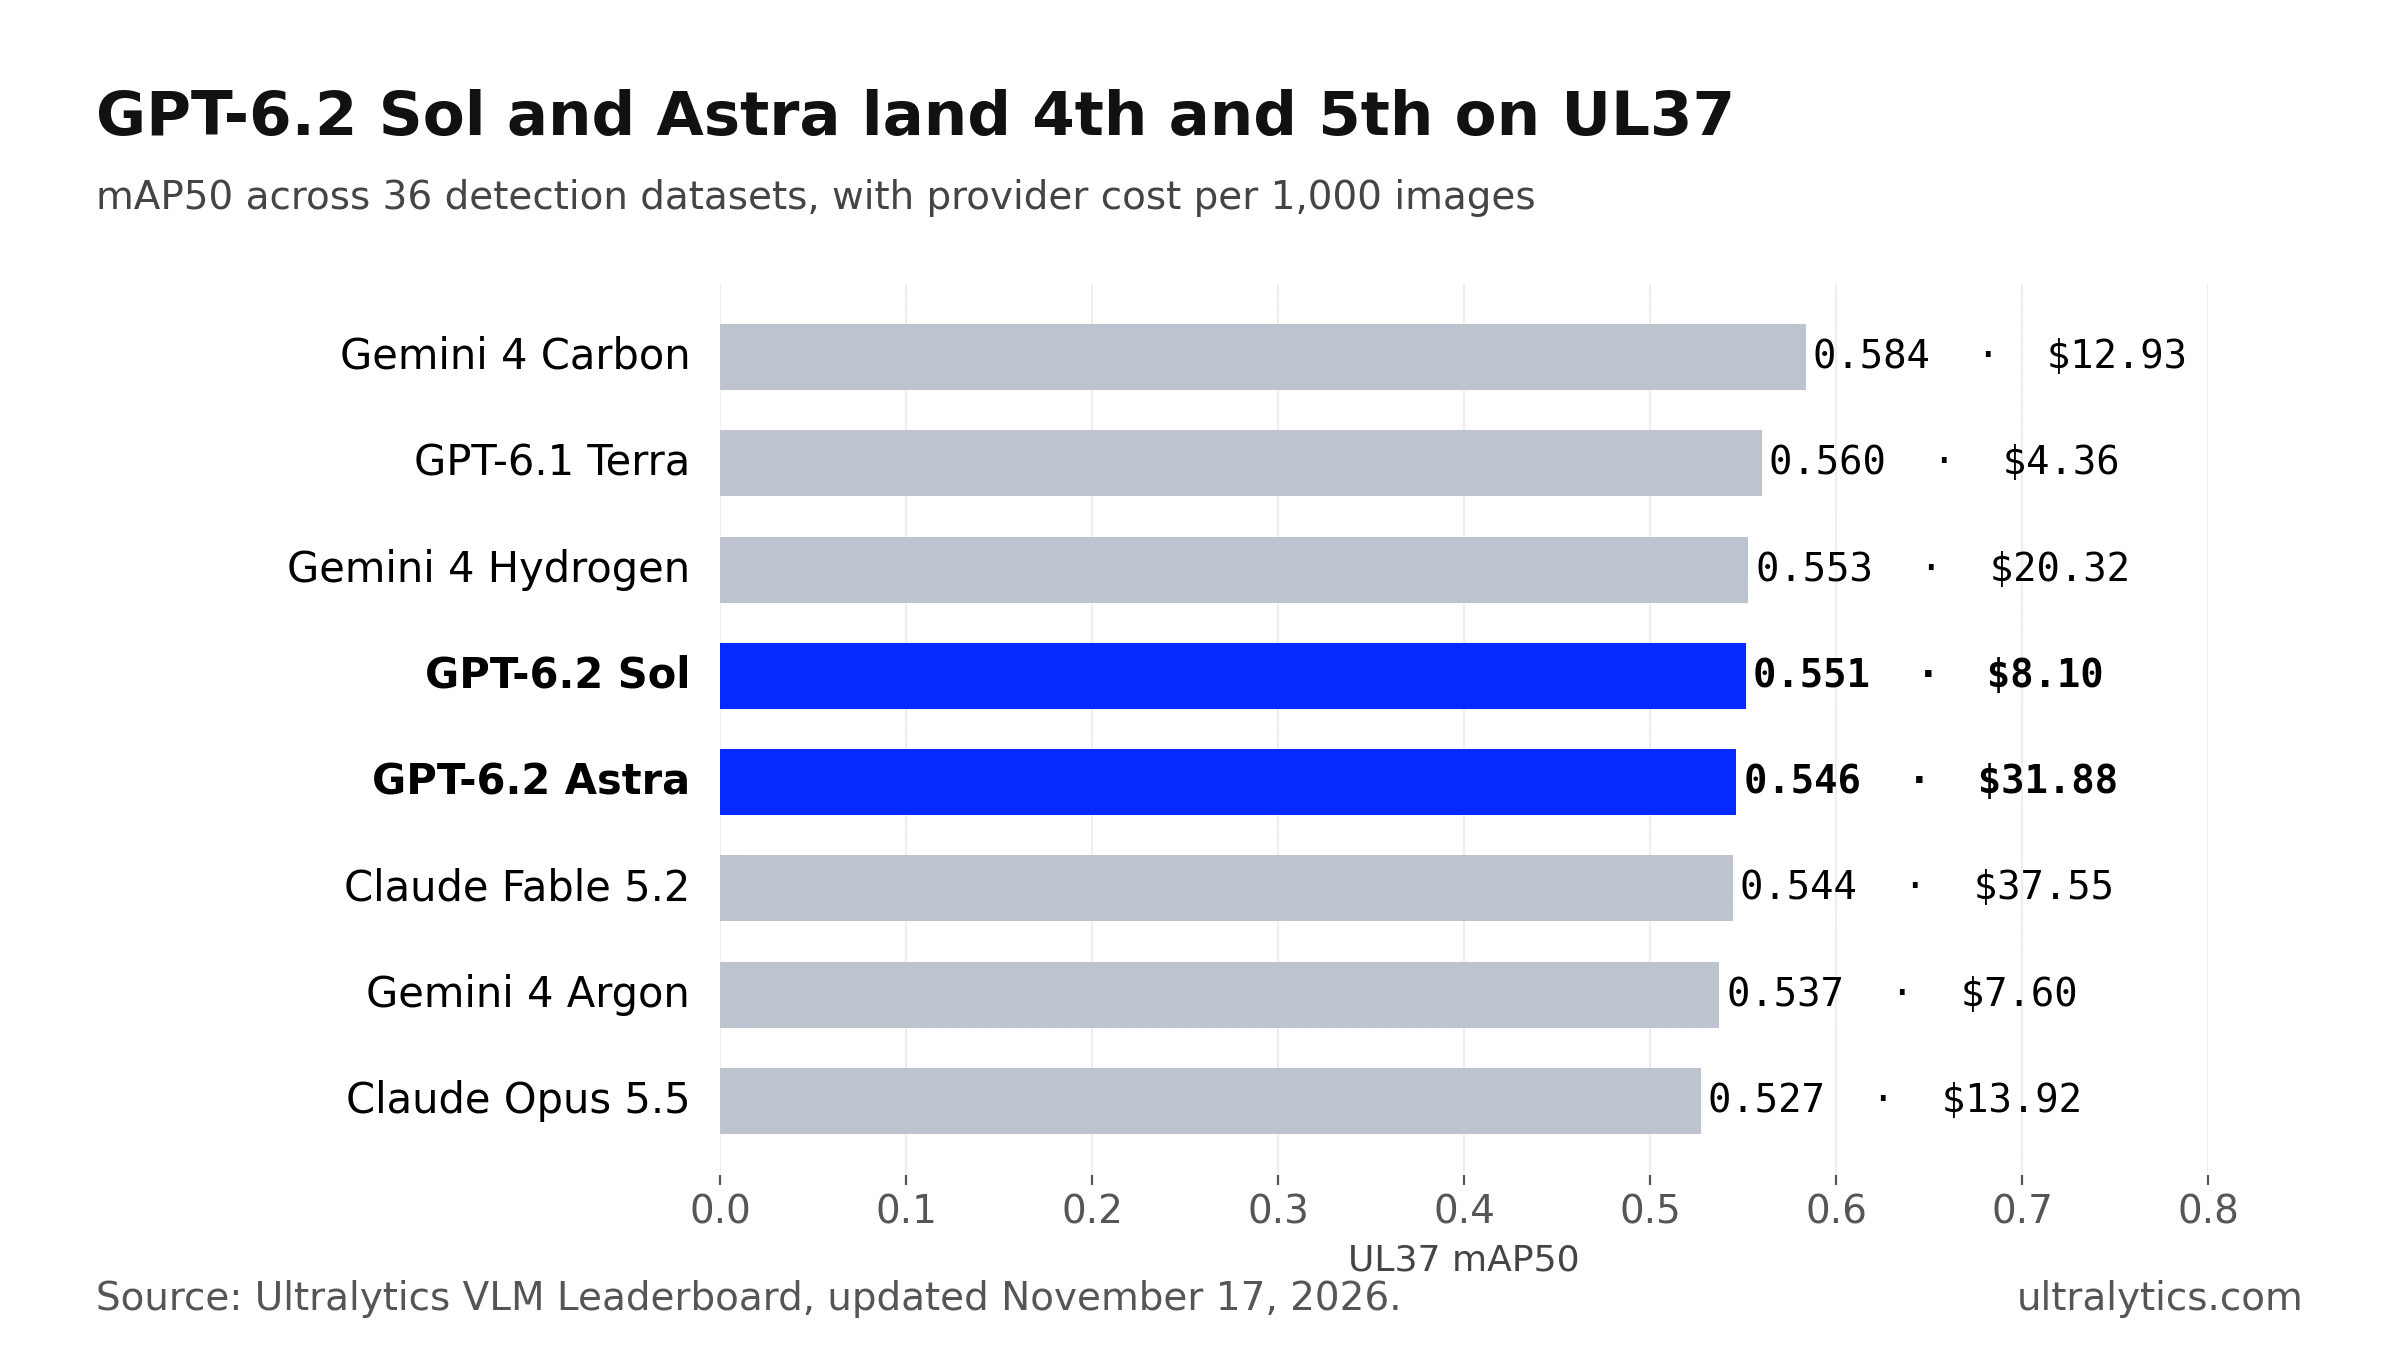
Les huit modèles les mieux classés sur UL37, avec le coût du fournisseur par tranche de 1 000 images.
Les objectifs d’OpenAI avec GPT-6.2#
OpenAI destine les deux modèles à des tâches différentes. Son journal des modifications recommande GPT-6.2 Astra « pour les tâches exigeantes de raisonnement et de programmation » et GPT-6.2 Sol « pour la programmation quotidienne et les flux de travail avec des agents ». Les deux acceptent du texte et des images, renvoient du texte et sont disponibles dans l’API Responses et Chat Completions.
Les prix reflètent cette différence. D’après les pages de modèles d’OpenAI, GPT-6.2 Sol coûte 2 $ par million de jetons en entrée et 10 $ par million de jetons en sortie, tandis que GPT-6.2 Astra coûte 8 $ et 40 $. Le prix des jetons d’Astra est exactement quatre fois celui de Sol.
Les deux sont des modèles polyvalents plutôt que des détecteurs spécialisés ; nous avons donc mesuré leurs performances pour cette tâche. Platform fait appel aux deux avec le niveau d’effort de raisonnement par défaut d’OpenAI, en utilisant la même demande de boîtes que celle envoyée à chaque modèle OpenAI.
Astra remporte plus de jeux de données, et un jeu d’échographie fait toute la différence sur la moyenne#
L’avance de Sol sur la moyenne ne signifie pas qu’il l’emporte plus souvent. Sur les 36 jeux de données, Astra obtient un score supérieur dans 17 cas, Sol dans 15, et quatre se terminent à égalité.
Un jeu de données explique la différence. Sur l’échographie thyroïdienne TN5000, où chaque boîte comporte aussi une étiquette bénigne ou maligne, Sol obtient 0,995 contre 0,769 pour Astra. Ce seul résultat augmente la moyenne de Sol d’environ 0,006. Sans TN5000, les deux moyennes sont de 0,539 pour Sol et 0,540 pour Astra.
Sur ce benchmark, les deux modèles sont suffisamment proches en précision pour que les différences les plus nettes concernent le domaine et le coût.
Les domaines où GPT-6.2 Sol et Astra se démarquent#
En moyenne par domaine, Astra arrive en tête dans sept des 12 domaines d’UL37 et Sol dans quatre ; les radiographies de sécurité sont à égalité.
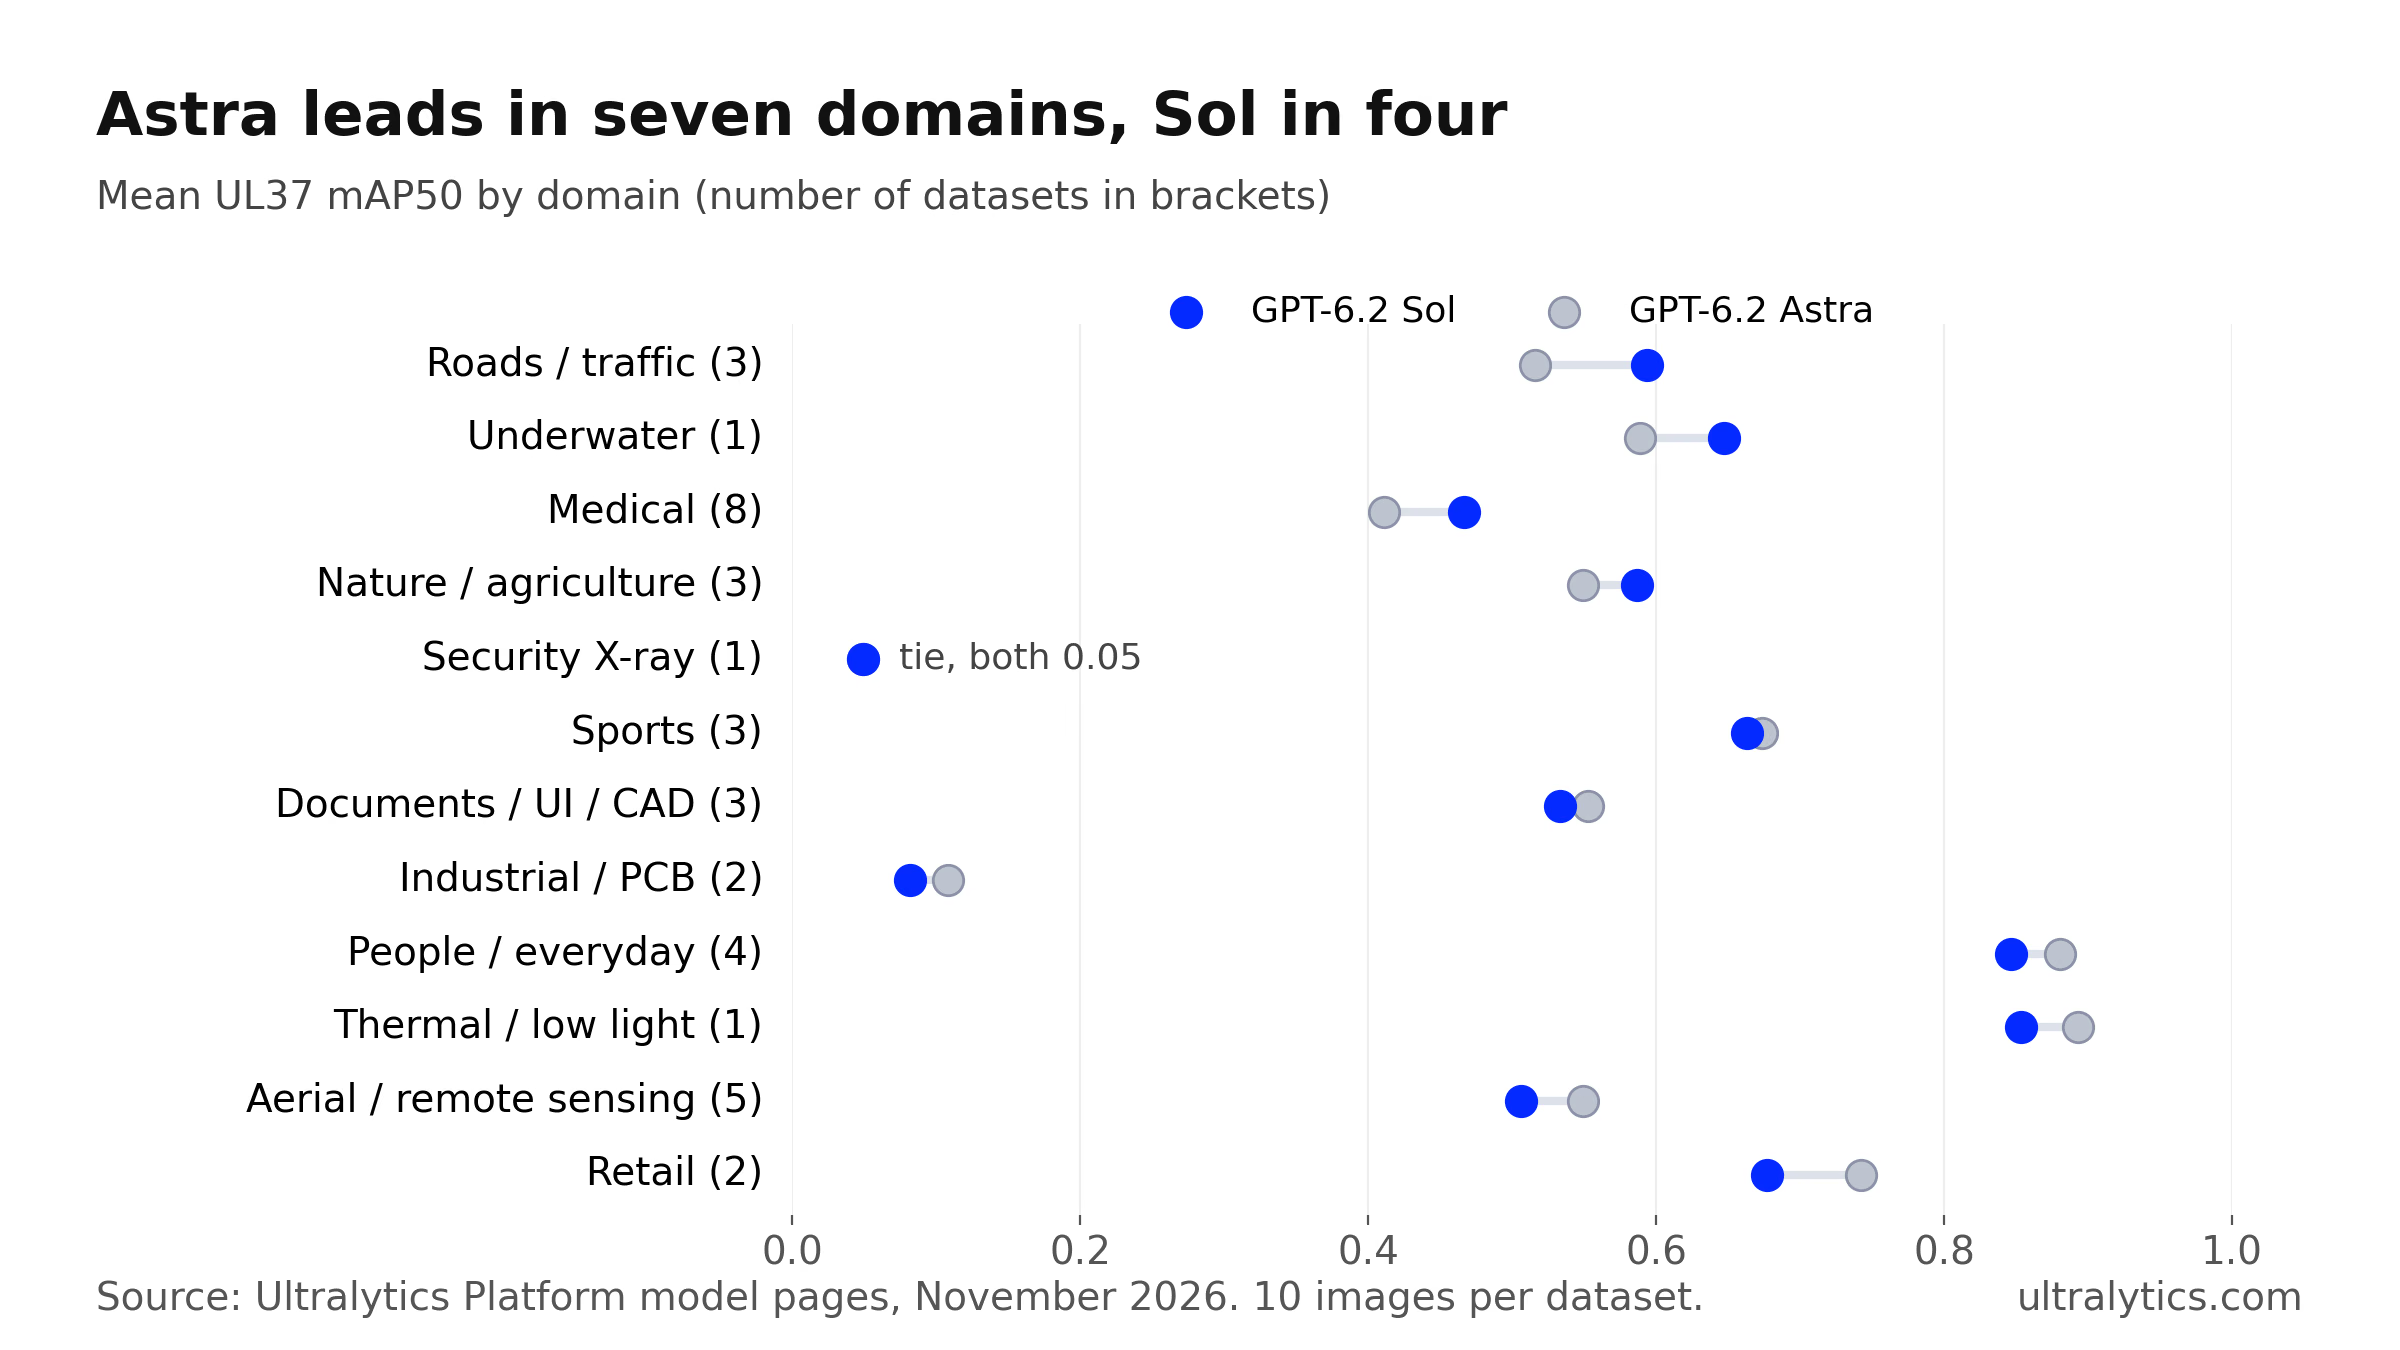
Chaque domaine comprend entre un et huit jeux de données, avec 10 images par jeu.
GPT-6.2 Sol est plus performant sur les images médicales, de routes et de nature. Sa moyenne sur les huit jeux de données médicaux est de 0,466 contre 0,411 pour Astra, grâce à TN5000 et aux polypes du côlon de Kvasir-SEG, avec un score de 0,805 contre 0,707. Pour les épis de blé de GWHD, il obtient 0,684 contre 0,537 pour Astra, et pour le marquage routier de CeyMo, 0,843 contre 0,705.
GPT-6.2 Astra est plus performant sur les images aériennes, de commerce de détail, de documents et de personnes. Sa moyenne sur les cinq jeux de données aériens est de 0,550 contre 0,506 pour Sol, grâce notamment aux navires dans les images radar de SSDD, avec un score de 0,880 contre 0,749. Pour les produits à la caisse dans RPC, il obtient 0,978 contre 0,823 pour Sol, et il est aussi en tête pour la détection des EPI, des déchets et des joueurs de basket.
| Jeu de données | Domaine | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| Échographie thyroïdienne TN5000 | Médical | 0.995 | 0.769 |
| Épis de blé GWHD | Nature / agriculture | 0.684 | 0.537 |
| Marquage routier CeyMo | Routes / circulation | 0.843 | 0.705 |
| SoccerDB | Sports | 0.748 | 0.631 |
| Caisse de magasin RPC | Commerce de détail | 0.823 | 0.978 |
| Basket et panier | Sports | 0.726 | 0.872 |
| Maladies des plantes PlantDoc | Nature / agriculture | 0.302 | 0.447 |
| Navires SAR SSDD | Aérien / télédétection | 0.749 | 0.880 |
Les quatre plus grands écarts dans chaque sens, mAP50 UL37.
Chaque jeu de données contribue à hauteur de 10 images ; un score isolé est donc une indication à tester, pas une conclusion. Avant d’annoter un grand jeu de données, consulte les pages des modèles GPT-6.2 Sol et GPT-6.2 Astra : elles affichent, pour chaque jeu de données du benchmark, les boîtes enregistrées de chaque modèle à côté des annotations de référence.
Une nette amélioration par rapport à GPT-6.1 Sol et GPT-6 Astra, sauf sur les circuits imprimés#
Par rapport aux modèles qu’ils remplacent dans Platform, les deux sont plus précis, plus rapides et moins chers par image.
| mAP50 | Coût pour 1 000 images | Temps médian par image | |
|---|---|---|---|
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6.2 Sol | 0.551 | $8.10 | 3,4 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
| GPT-6.2 Astra | 0.546 | $31.88 | 4,3 s |
GPT-6.2 Sol surpasse GPT-6.1 Sol sur 23 jeux de données et obtient un score inférieur sur 12 ; il est environ trois fois plus rapide. Son coût par image, réduit de 21 %, s’accompagne de prix des jetons inchangés. GPT-6.2 Astra surpasse GPT-6 Astra sur 24 jeux de données et obtient un score inférieur sur 11 ; son coût par image est inférieur de 35 % et le prix de ses jetons est plus bas : OpenAI affiche GPT-6 Astra à 10 $ et 50 $ par million de jetons.
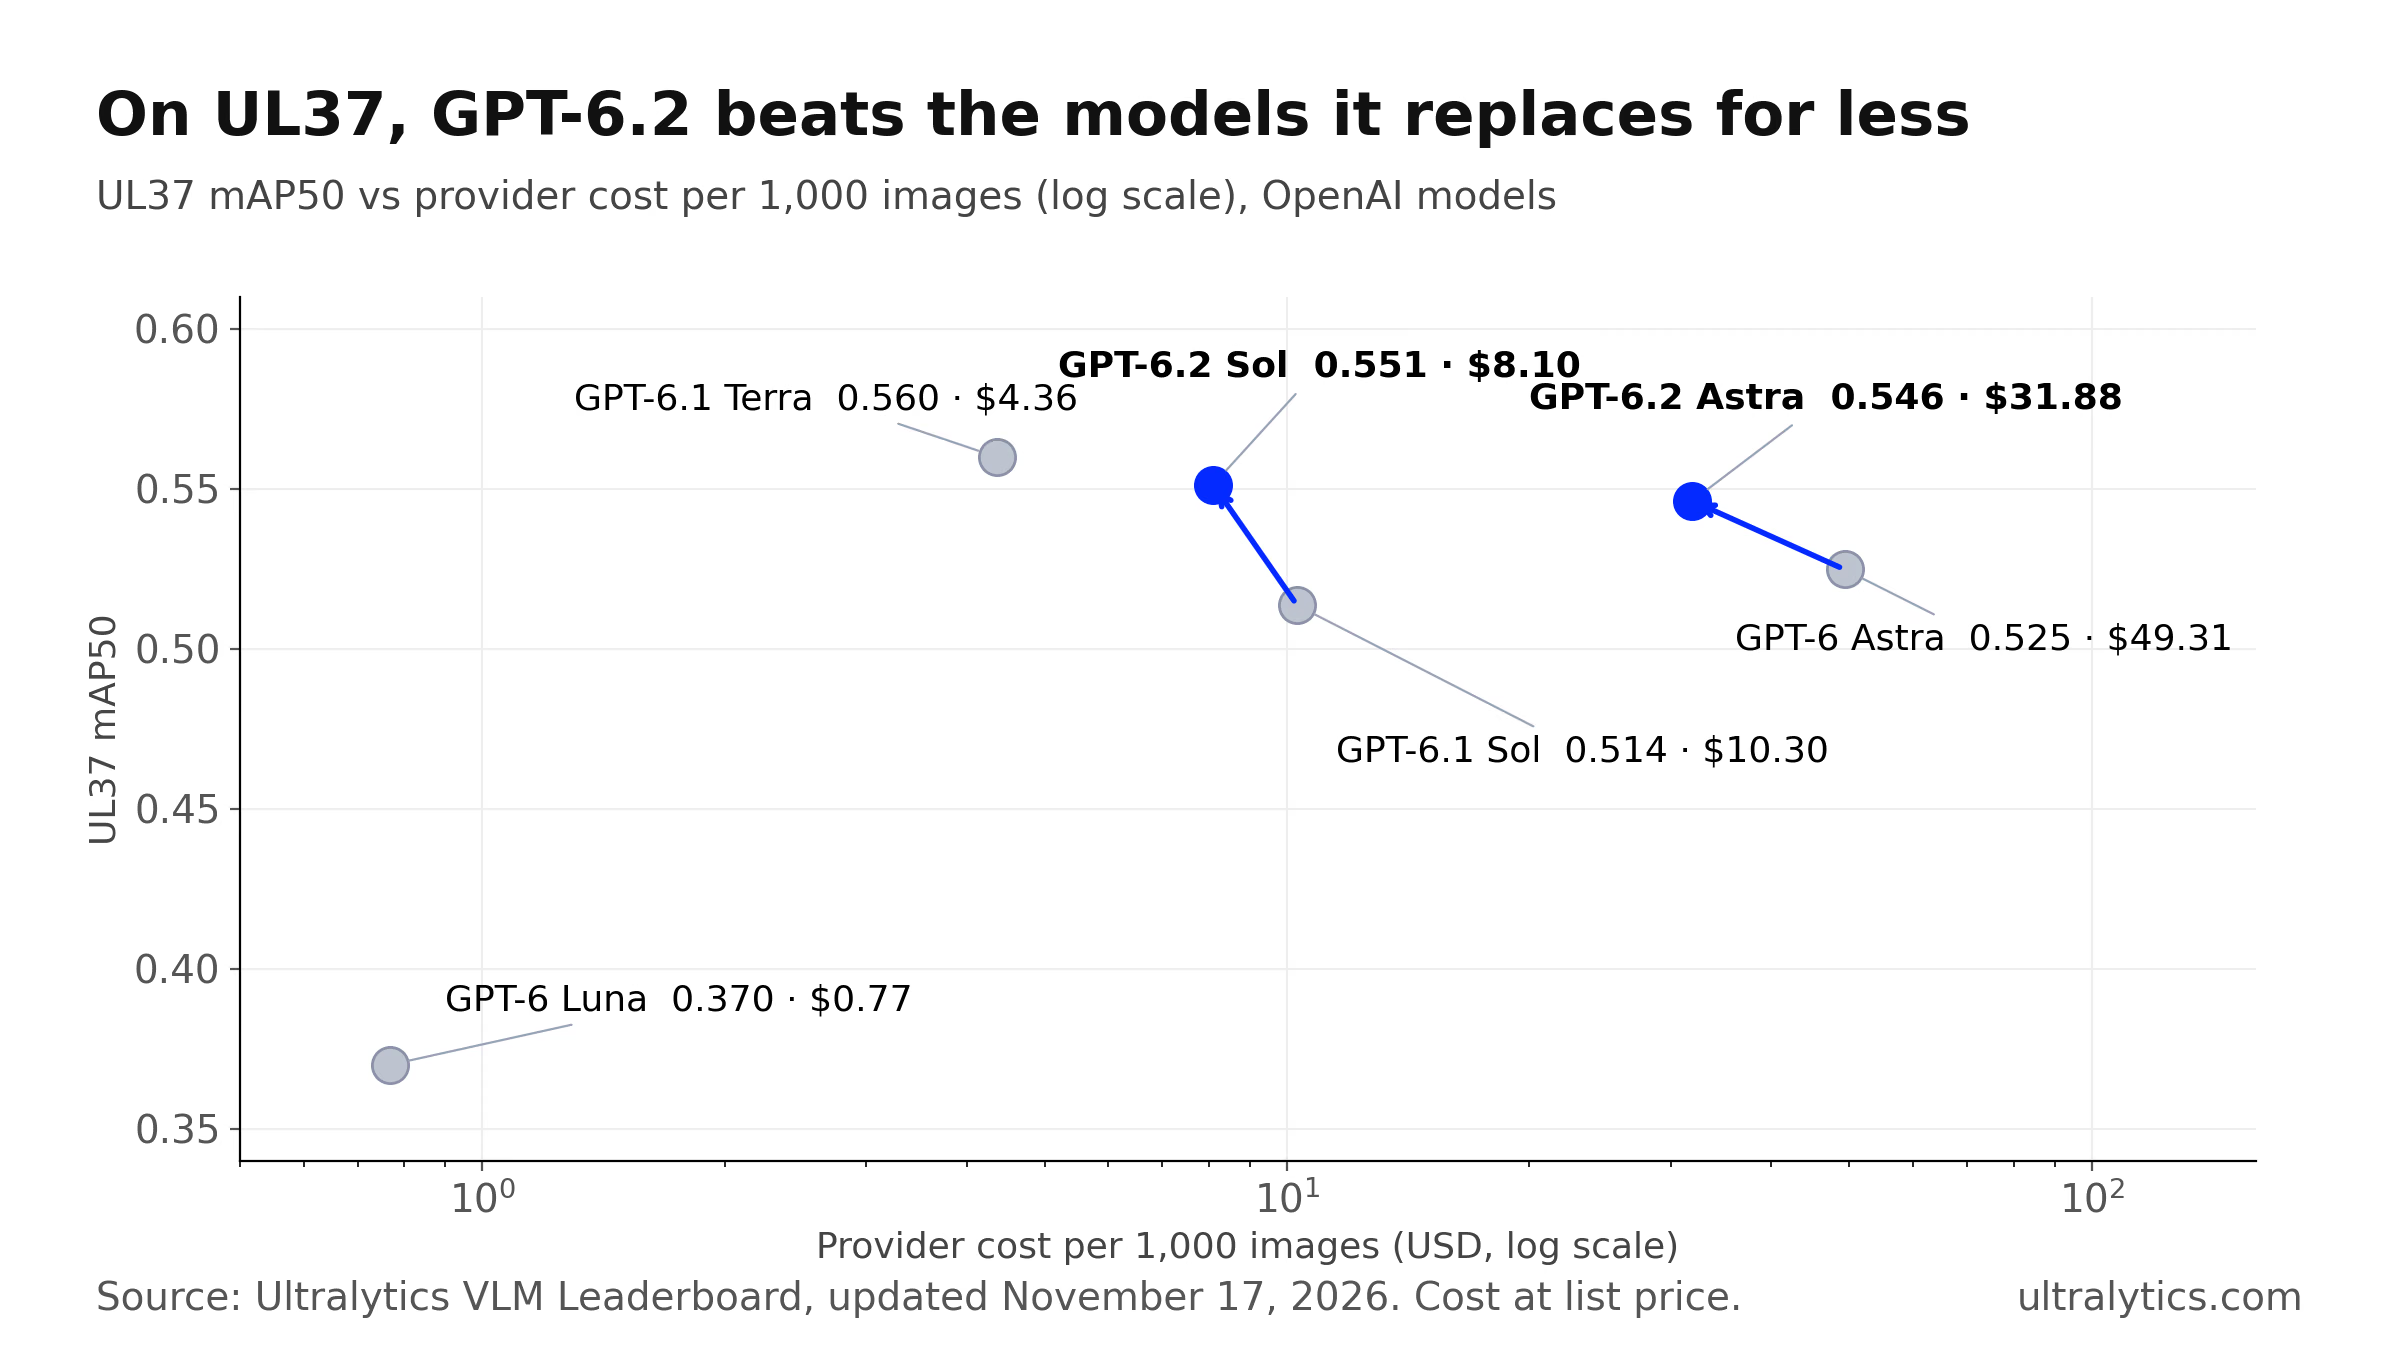
Les flèches comparent chaque modèle GPT-6.2 au modèle qu’il remplace dans Ultralytics Platform.
Les circuits imprimés font exception. Pour les défauts de circuits nus de DeepPCB, les deux modèles GPT-6.2 obtiennent 0,000, contre 0,393 pour GPT-6.1 Sol. Pour les défauts de surface de DsPCBSD+, Sol passe de 0,392 à 0,164 et Astra obtient 0,216. Les radiographies de sécurité donnent aussi de faibles résultats : les deux modèles obtiennent 0,05 sur IEDXray, tandis que Gemini 4 Argon atteint 0,30. Si tes données concernent l’inspection de circuits imprimés ou le contrôle de sécurité, teste d’autres modèles sur un échantillon avant de t’engager.
GPT-6.1 Terra reste le meilleur annotateur d’OpenAI sur UL37#
Aucun des deux nouveaux modèles ne dépasse GPT-6.1 Terra, qui reste deuxième du classement avec 0,560 mAP50 pour 4,36 $ par tranche de 1 000 images. Terra et GPT-6.2 Sol remportent chacun 17 jeux de données, avec deux égalités : l’écart est donc faible. Terra est plus précis, avec 0,646 contre 0,623, et coûte environ deux fois moins cher. Sol détecte plus d’objets et répond plus vite : 3,4 secondes contre 5,1.
En tête du classement, Gemini 4 Carbon reste premier avec 0,584 mAP50 pour 12,93 $ par tranche de 1 000 images. Nos résultats détaillés sur GPT-6.1 Terra et Gemini 4 Carbon couvrent ces modèles.
Coût d’un lot d’annotations avec GPT-6.2#
Le coût fournisseur est calculé à partir de l’utilisation de jetons déclarée par OpenAI, aux tarifs catalogue ; tes propres images peuvent utiliser plus ou moins de jetons. Batch Annotation ajoute des frais de traitement Platform de 1,00 $ par tranche de 1 000 images, avec un minimum de 0,01 $ par exécution.
| Par tranche de 1 000 images | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Facturation d’OpenAI | $8.10 | $31.88 |
| Traitement par Ultralytics Platform | $1.00 | $1.00 |
| Total | $9.10 | $32.88 |
Tu paies directement OpenAI avec ta propre clé API, y compris pour les prédictions de test que tu exécutes d’abord, et Ultralytics n’applique aucune majoration sur les jetons. Pour un jeu de données de 10 000 images, cela revient à environ 91 $ avec Sol et 329 $ avec Astra.
Comment lancer l’annotation automatique avec GPT-6.2 Sol ou Astra dans Ultralytics Platform#
GPT-6.2 Sol et Astra sont des modèles guidés par les classes, destinés aux jeux de données de détection comprenant de 1 à 200 classes. Ils renvoient des boîtes englobantes associées aux noms de classes propres à ton jeu de données ; tu les vérifies avant de les enregistrer.
- Crée une clé sur la page des clés API OpenAI.
- Demande au propriétaire de l’espace de travail d’ajouter la clé dans Settings > API Keys, dans l’espace de travail Platform qui contient ton jeu de données. La documentation sur les clés du fournisseur donne plus de détails.
- Dans l’éditeur d’annotations, passe en mode Smart et choisis GPT-6.2 Sol ou GPT-6.2 Astra sous OpenAI dans le sélecteur de modèles.
- Clique sur Predict, ou
P, pour quelques images représentatives de tes données, puis compare les deux modèles sur les mêmes images. - Quand le résultat te convient, ouvre la page du jeu de données et choisis More actions > Batch Annotation pour annoter chaque image non annotée. Batch Annotation fonctionne avec les jeux de données hébergés sur Platform qui comportent jusqu’à trois canaux d’image. Platform enregistre d’abord une version du jeu de données, ce qui te permet de revenir en arrière.
- Vérifie les boîtes, enregistre-les et entraîne un modèle Ultralytics YOLO26 sur le résultat dans le même espace de travail.
La documentation sur les annotations explique en détail le mode Smart et Batch Annotation, et notre guide pour choisir un VLM selon la précision et le rappel t’aide à adapter le modèle à ton processus de vérification.
GPT-6.2 Sol, GPT-6.2 Astra ou GPT-6.1 Terra : lequel choisir#
| Si tu as besoin de… | Commencer par |
|---|---|
| D’un annotateur OpenAI polyvalent au coût le plus bas | GPT-6.1 Terra : meilleur score UL37 des trois, à environ la moitié du prix de Sol |
| De vitesse ou de détecter le plus grand nombre d’objets | GPT-6.2 Sol : 3,4 s par image et le rappel le plus élevé du classement |
| D’images médicales, routières ou agricoles | GPT-6.2 Sol, puis vérifie Terra sur les données médicales |
| D’images aériennes, de caisses de magasin, de documents ou d’EPI | GPT-6.2 Astra, si son avantage en précision sur tes données justifie un coût environ quatre fois supérieur à celui de Sol |
| De défauts de circuits imprimés ou de radiographies de sécurité | Teste d’abord d’autres modèles ; les deux modèles GPT-6.2 obtiennent de faibles scores sur UL37 dans ces domaines |
Pour la plupart des travaux d’annotation, GPT-6.2 Sol est le meilleur choix parmi les deux nouveaux modèles : son score UL37 est similaire à celui d’Astra pour environ un quart du prix. Choisis Astra si un test sur tes propres images montre qu’il est plus performant dans ton domaine.
Foire aux questions
Sur notre benchmark UL37, les résultats sont proches : GPT-6.2 Sol obtient 0,551 mAP50 et GPT-6.2 Astra 0,546 ; Astra remporte légèrement plus de jeux de données, 17 contre 15. La différence la plus nette concerne le coût : Sol coûte 8,10 $ par tranche de 1 000 images en frais OpenAI, contre 31,88 $ pour Astra. Sol est meilleur sur les images médicales, de routes et de nature ; Astra sur les images aériennes, de commerce de détail, de documents et de personnes.
Oui. Les deux modèles GPT-6.2 figurent parmi les cinq premiers des 50 modèles du classement VLM d’Ultralytics, sans aucune requête échouée. GPT-6.2 Sol affiche le rappel le plus élevé du classement, à 0,643. Les deux modèles sont peu performants sur les défauts de circuits imprimés et les radiographies de sécurité.
Environ 8,10 $ avec GPT-6.2 Sol et 31,88 $ avec GPT-6.2 Astra en frais OpenAI, d’après l’utilisation de jetons déclarée et les tarifs catalogue. Ultralytics Platform ajoute des frais de Batch Annotation de 1,00 $ par tranche de 1 000 images, soit un total d’environ 9,10 $ et 32,88 $.
Sur UL37, oui, de peu. GPT-6.1 Terra obtient 0,560 mAP50 pour 4,36 $ par tranche de 1 000 images, devançant en moyenne les deux modèles GPT-6.2 et leur coût. GPT-6.2 Sol remporte autant de jeux de données que Terra, 17 chacun, et il est plus rapide tout en détectant davantage d’objets.
Oui, en moyenne. GPT-6.2 Sol surpasse GPT-6.1 Sol sur 23 des 36 jeux de données, avec une vitesse environ trois fois supérieure et un coût par image inférieur de 21 %. GPT-6.2 Astra surpasse GPT-6 Astra sur 24 jeux de données, pour un coût inférieur de 35 %. Les deux anciens modèles donnaient de meilleurs résultats sur les défauts de circuits imprimés.
Ajoute ta clé API OpenAI dans Settings > API Keys, puis choisis GPT-6.2 Sol ou GPT-6.2 Astra en mode Smart dans l’éditeur d’annotations. Teste quelques images, puis utilise Batch Annotation pour annoter l’ensemble du jeu de données, vérifier les boîtes et entraîner un modèle Ultralytics YOLO26 dans le même espace de travail.
Écrit par
Fondateur et PDG · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









