Segmentation Ultralytics YOLO dans les scènes denses : 1 000 masques
Dans Ultralytics 8.4.213, YOLO26n-seg prédit et résume 1 000 masques sur une image synthétique 1080p en 56.4 ms sur une RTX PRO 6000, contre 821.2 ms auparavant.
 Glenn Jocher13 min de lecture
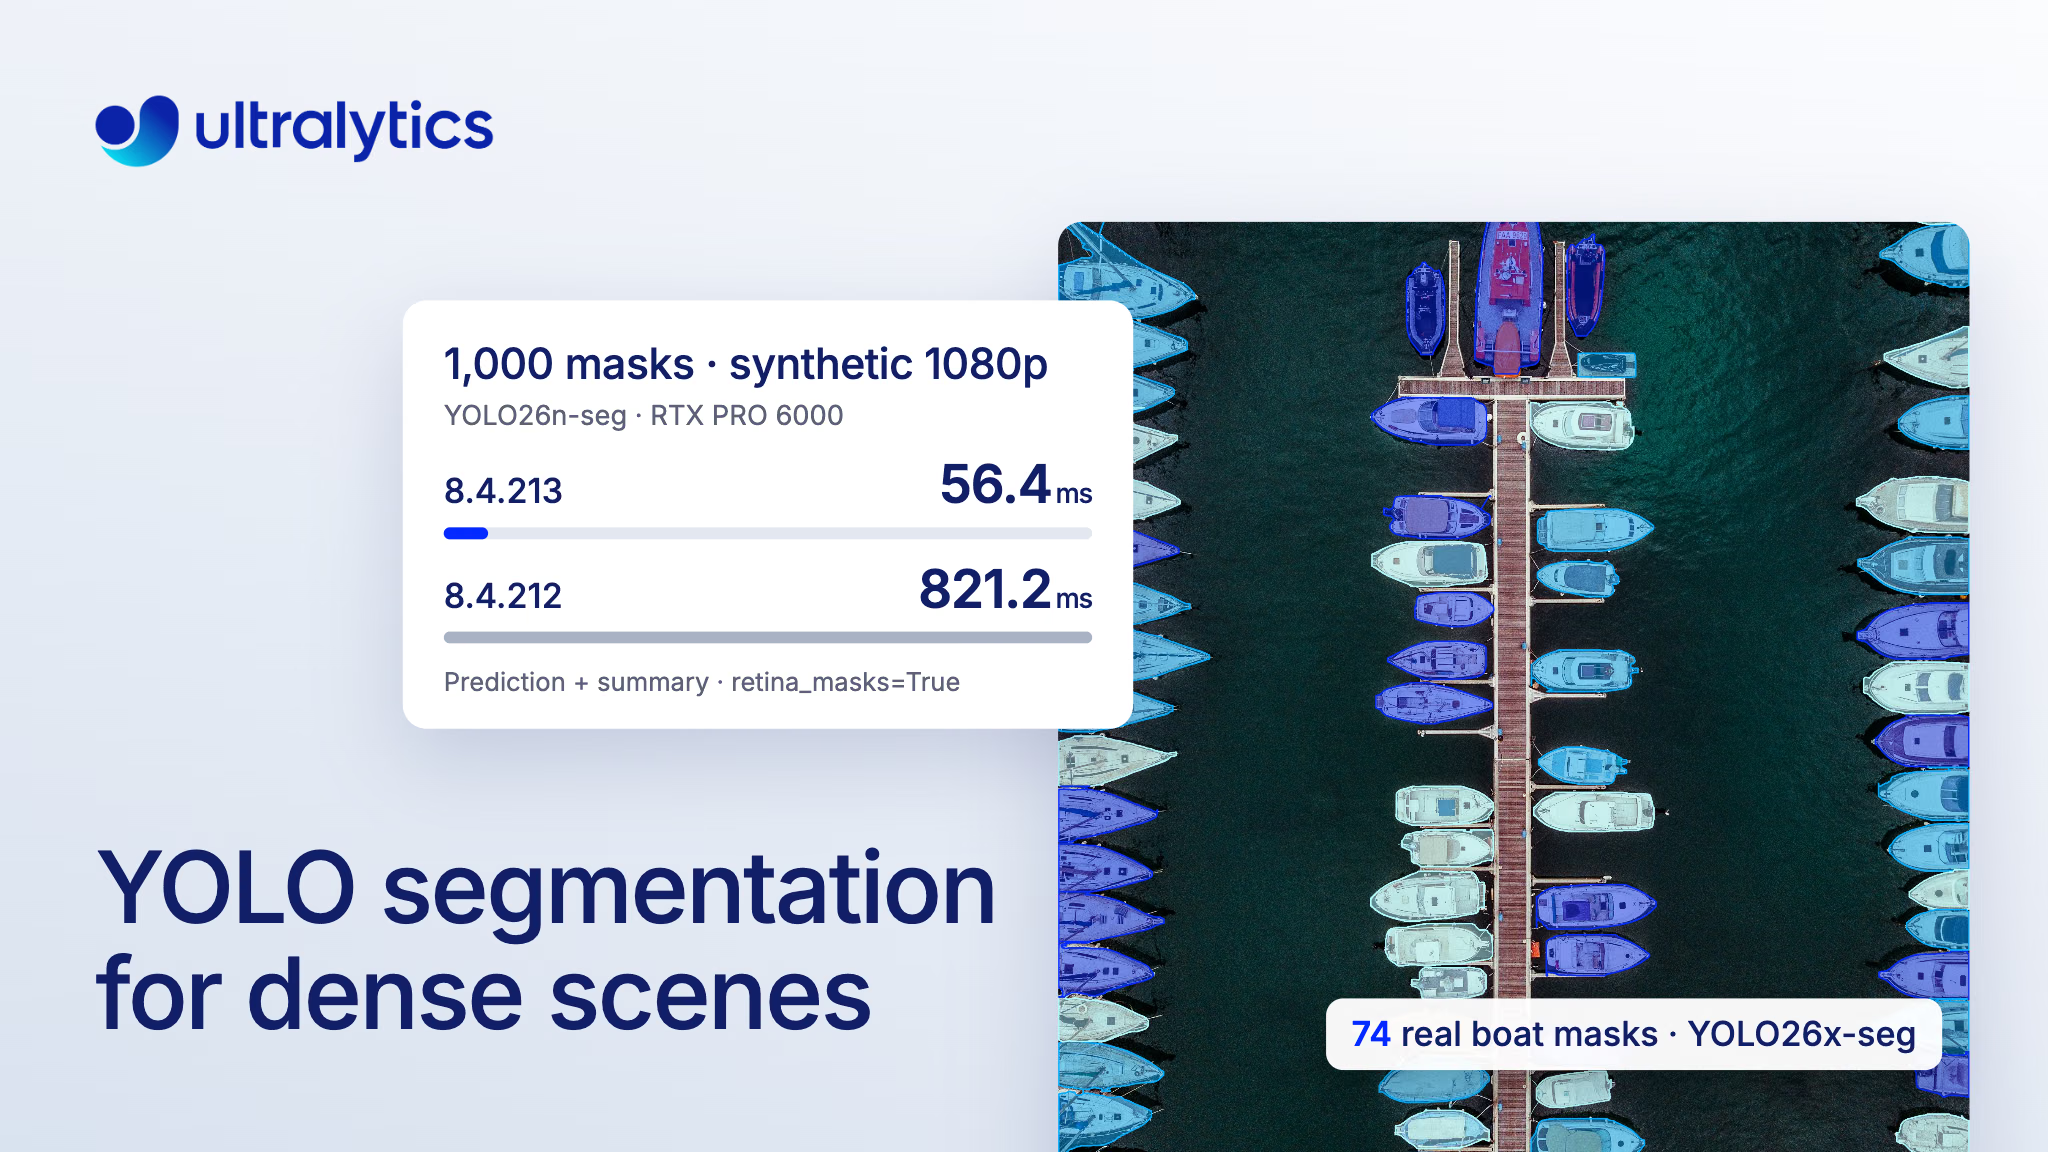
Ultralytics 8.4.213, publié le 14 novembre 2026, accélère la segmentation YOLO dans les scènes denses en décodant les grandes piles de masques à l’intérieur de chaque boîte de détection. Si tu segmentes des rayons, des colis, des foules ou des images aériennes, tu as probablement déjà rencontré le cas où un modèle de segmentation détecte les objets, mais où l’étape de création des masques qui suit manque de temps ou de mémoire ; cette version repousse nettement cette limite. Dans notre benchmark sur une image synthétique 1080p densément quadrillée, YOLO26n-seg a généré 1 000 masques d’instances en pleine résolution (retina_masks=True), avec la prédiction et un résumé des résultats, en 56.4 ms et avec un pic d’utilisation de mémoire GPU de 321 MiB sur une RTX PRO 6000, contre 821.2 ms et 4 291 MiB dans la version 8.4.212.
Le modèle lui-même n’a pas changé. Ce qui a changé, c’est la façon dont YOLO segmentation transforme la sortie du modèle en masques : les grandes piles de masques sont désormais décodées dans la boîte de chaque objet plutôt que sur l’image entière. Dans Ultralytics Platform, l’onglet Predict et l’API renvoient jusqu’à 1 000 résultats par image. Cet article explique pourquoi les scènes denses étaient coûteuses, ce que 8.4.213 fait différemment, les résultats mesurés et comment exécuter toi-même des prédictions avec 1 000 masques.
Les scènes denses payaient autrefois le coût des pixels situés hors de chaque boîte#
La segmentation d’instances attribue son propre masque à chaque objet, ce qui est nécessaire pour mesurer une surface, détourer des objets ou distinguer des éléments qui se touchent. Un modèle de segmentation YOLO prédit un petit ensemble de masques prototypes partagés, ainsi que quelques coefficients par détection, et le post-traitement les combine pour produire un masque par objet.
Jusqu’à présent, cette étape construisait chaque masque à la taille de l’image : par défaut, à la taille d’inférence du modèle, ou à la taille de l’image d’origine avec retina_masks=True ou le tuilage. Pour N objets dans une image H x W, elle allouait, recadrait, filtrait et parcourait une pile N x H x W, même si chaque masque est nul partout en dehors de sa boîte englobante. Dans une scène dense en 1080p, la somme des surfaces de 1 000 boîtes, chevauchements compris, représente environ deux fois la surface de l’image, alors que la pile représentait 1 000 fois cette surface. Le coût augmentait avec max_det et la taille de l’image, plutôt qu’avec le nombre de boîtes dans l’image.
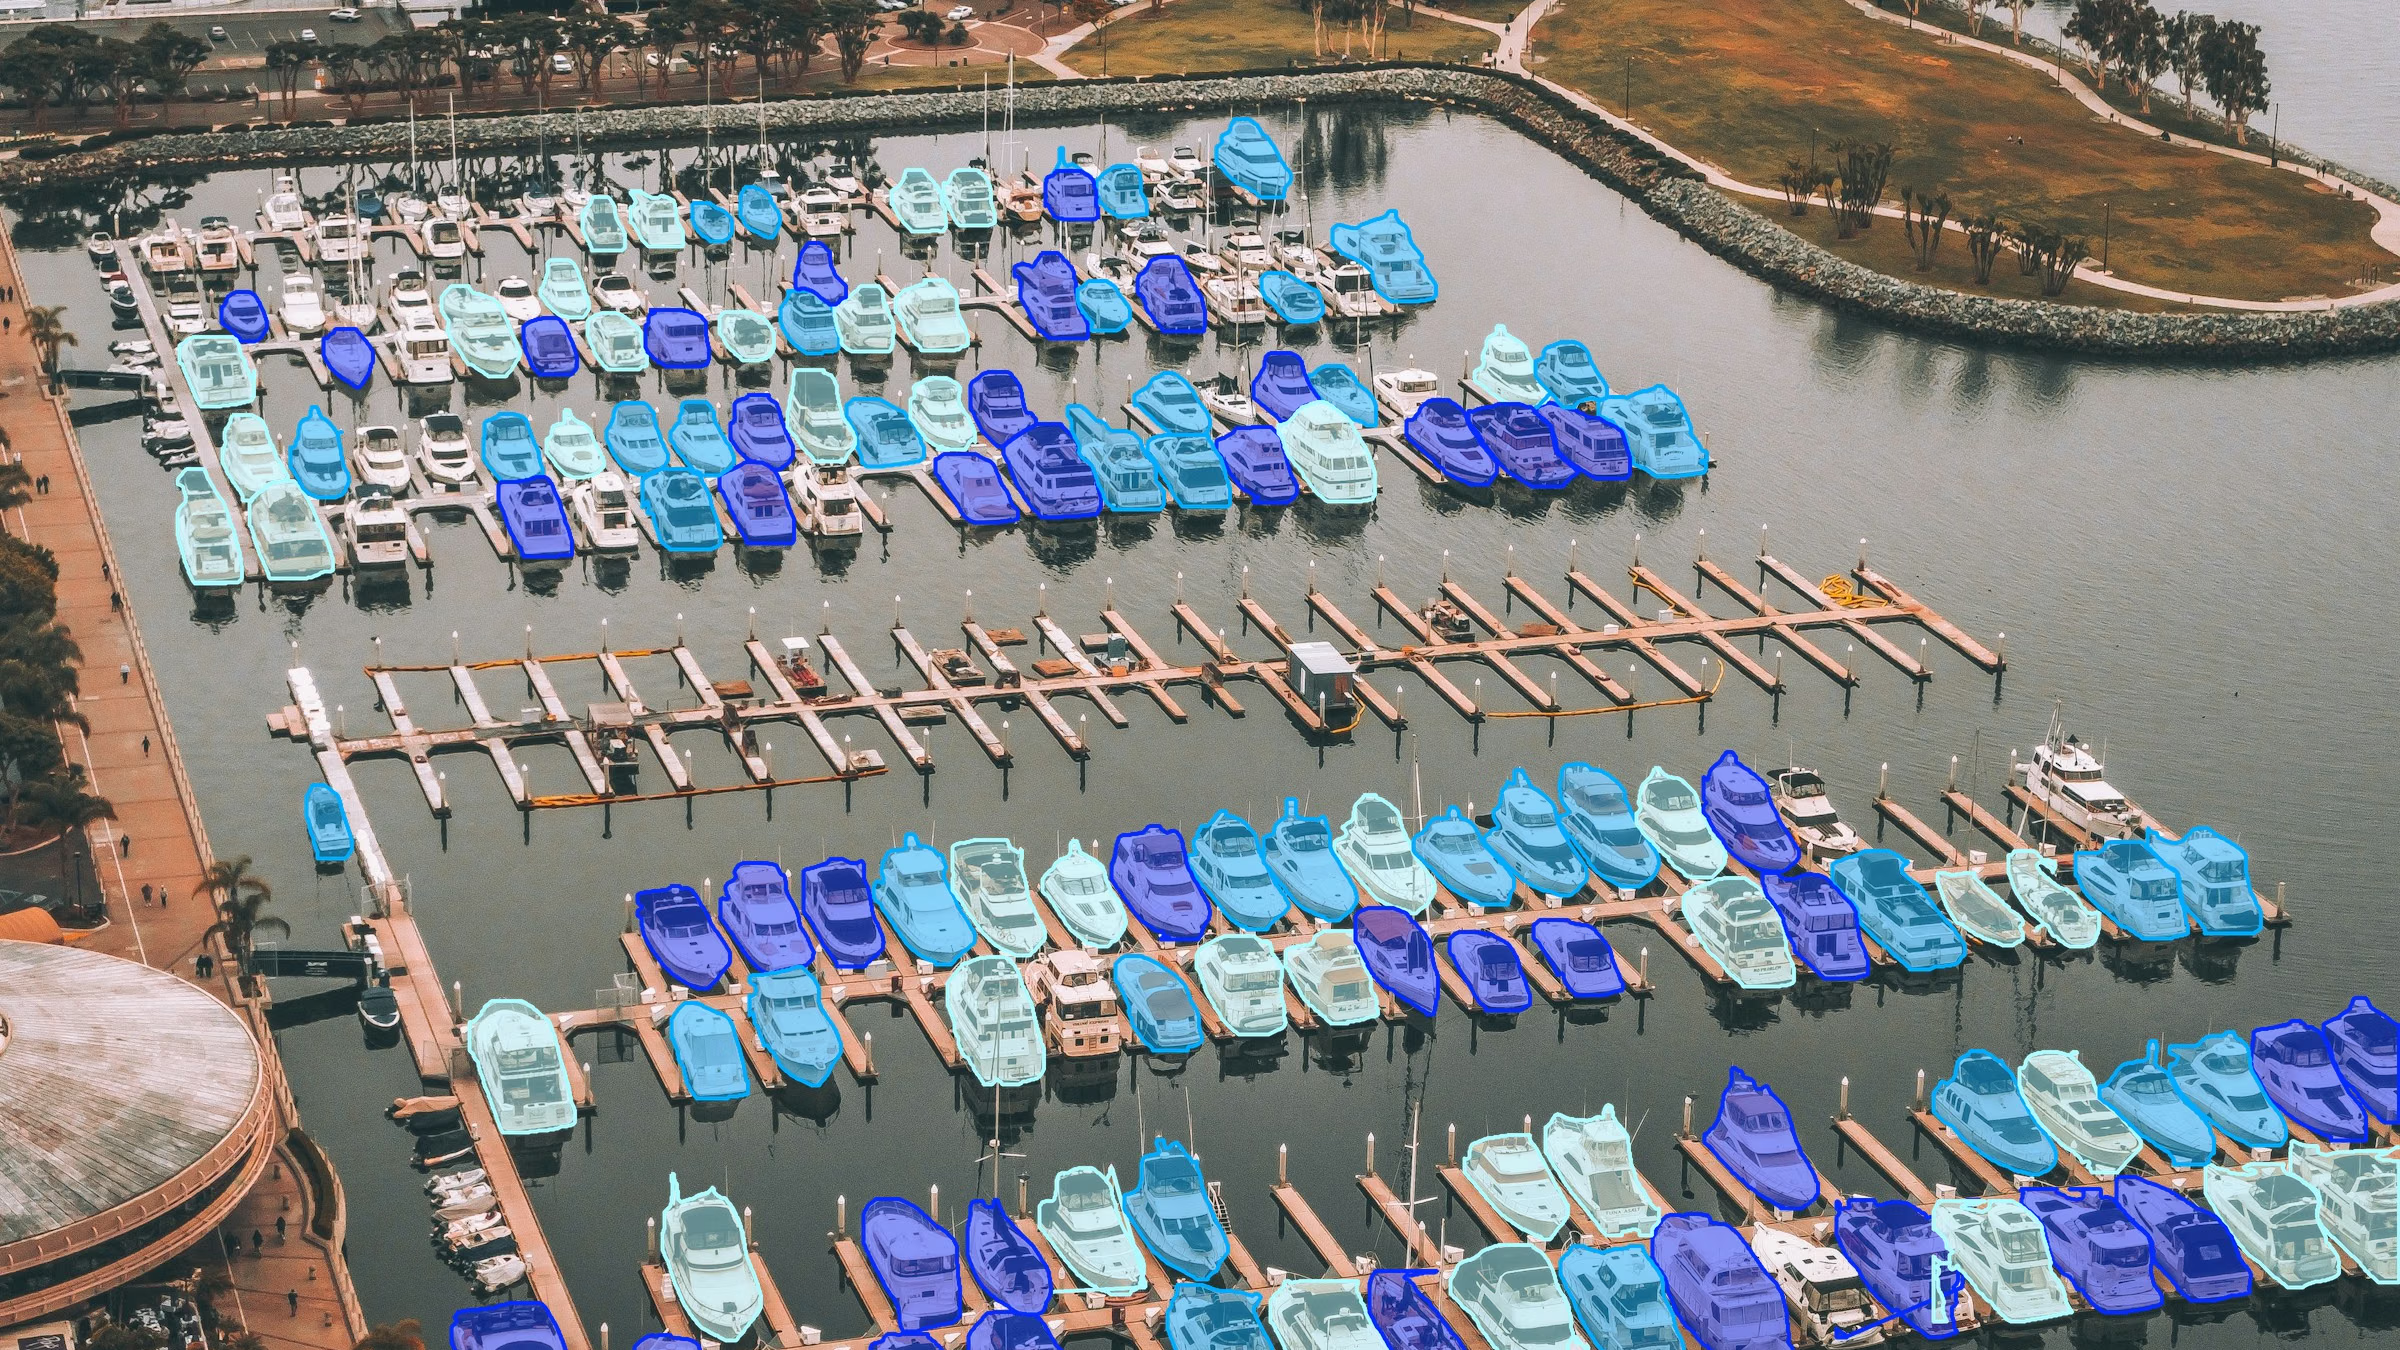
YOLO26x-seg a renvoyé 127 masques de bateaux sur cette photo de marina, affichés après recadrage (imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). Photo : Unsplash.
C’est pourquoi augmenter max_det au-delà de sa valeur par défaut de 300 n’était pas pratique pour la segmentation, et pourquoi les grandes images contenant de nombreuses instances pouvaient épuiser la mémoire. Les rayons denses comme SKU-110K, les piles de colis et les images aériennes sont précisément les scènes où tu as besoin de dépasser 300 objets.
Ultralytics 8.4.213 décode les grandes piles de masques dans chaque boîte#
Le nouveau chemin, issu de PR #27197, interpole les logits des prototypes uniquement aux pixels de chaque boîte. Il utilise un échantillonnage bilinéaire séparable, identique à celui de l’interpolation de PyTorch, et regroupe les boîtes de tailles similaires. Pour les grandes piles, le coût du décodage dépend désormais de la somme des surfaces des boîtes.
Trois détails sont importants en pratique :
- Il s’active au-delà d’une taille fixe de pile de masques. Le prédicteur de segmentation utilise des masques limités aux boîtes lorsque la pile dense dépasserait 33 554 432 pixels sur CUDA ou 4 194 304 pixels sur CPU et les autres appareils. Les piles plus petites conservent le chemin dense existant, qui est aussi rapide ou plus rapide pour quelques masques.
- Avec ce chemin, les contours sont directement générés à partir des masques limités aux boîtes.
masks.xyetmasks.xyntracent les polygones boîte par boîte, doncsummary(),to_json()etsave_txtne construisent pas la pile complète. - Le format de sortie reste inchangé.
masks.datarenvoie toujours un tenseur dense N x H x W. Avec le chemin limité aux boîtes, il est construit à la première lecture.
La lecture du tenseur dense nécessite toujours son allocation, mais la PR a mesuré une réduction : sur GPU, la lecture de masks.data pour 300 masques en 1080p avec retina_masks=True est passée de 14,1 ms et 1 366 MiB à 9,1 ms et 795 MiB.
1 000 masques en 1080p : de 821,2 ms à 56,4 ms sur GPU#
La PR évalue YOLO26n-seg en exécutant l’ensemble de model.predict(...) et result.summary() (boîtes et polygones), et indique la médiane des exécutions à chaud avec un processus par ligne. Les scènes denses sont une image synthétique carrelée à conf=0.01 et imgsz=1280 ; la scène typique est le bus.jpg standard avec les paramètres par défaut et 5 masques. « Avant » correspond à la version 8.4.212. Ces mesures, dominées par le post-traitement, portent sur la prédiction et le résumé, et non sur la vitesse d’inférence en général.
| Scène (GPU, RTX PRO 6000) | Masques | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
Typique (bus.jpg) | 5 | Faux | 4,3 ms, 59 MiB | 4,4 ms, 59 MiB |
| 1920 x 1080 | 300 | Faux | 118,5 ms, 1 673 MiB | 16,3 ms, 174 MiB |
| 1920 x 1080 | 300 | Vrai | 248,7 ms, 1 366 MiB | 18,0 ms, 201 MiB |
| 1920 x 1080 | 1,000 | Vrai | 821,2 ms, 4 291 MiB | 56,4 ms, 321 MiB |
| 4000 x 3000 | 300 | Vrai | 1 352,1 ms, 7 070 MiB | 26,5 ms, 172 MiB |
| 4000 x 3000 | 1,000 | Vrai | 4 323,1 ms, 23 305 MiB | 130,7 ms, 258 MiB |
Temps et mémoire GPU maximale, PyTorch 2.15.0 avec CUDA 13.2. Source : PR #27197.
L’image typique avec cinq masques ne change pas, comme prévu. Les gains apparaissent lorsque l’ancienne pile devenait volumineuse et sont les plus importants pour les masques en pleine résolution, qui étaient auparavant le cas le plus coûteux.
Les grandes images nécessitent une fraction de la mémoire#
Pour une image de 4000 x 3000 pixels avec 1 000 masques prédits, l’ancien chemin atteignait un pic de 23 305 MiB de mémoire GPU. Le nouveau chemin a atteint 258 MiB et s’est terminé en 130,7 ms au lieu de 4 323,1 ms. Cette réduction laisse davantage de mémoire GPU disponible pour le reste du pipeline lorsque tu traites des images de drones, de satellites et d’inspection de 12 mégapixels.
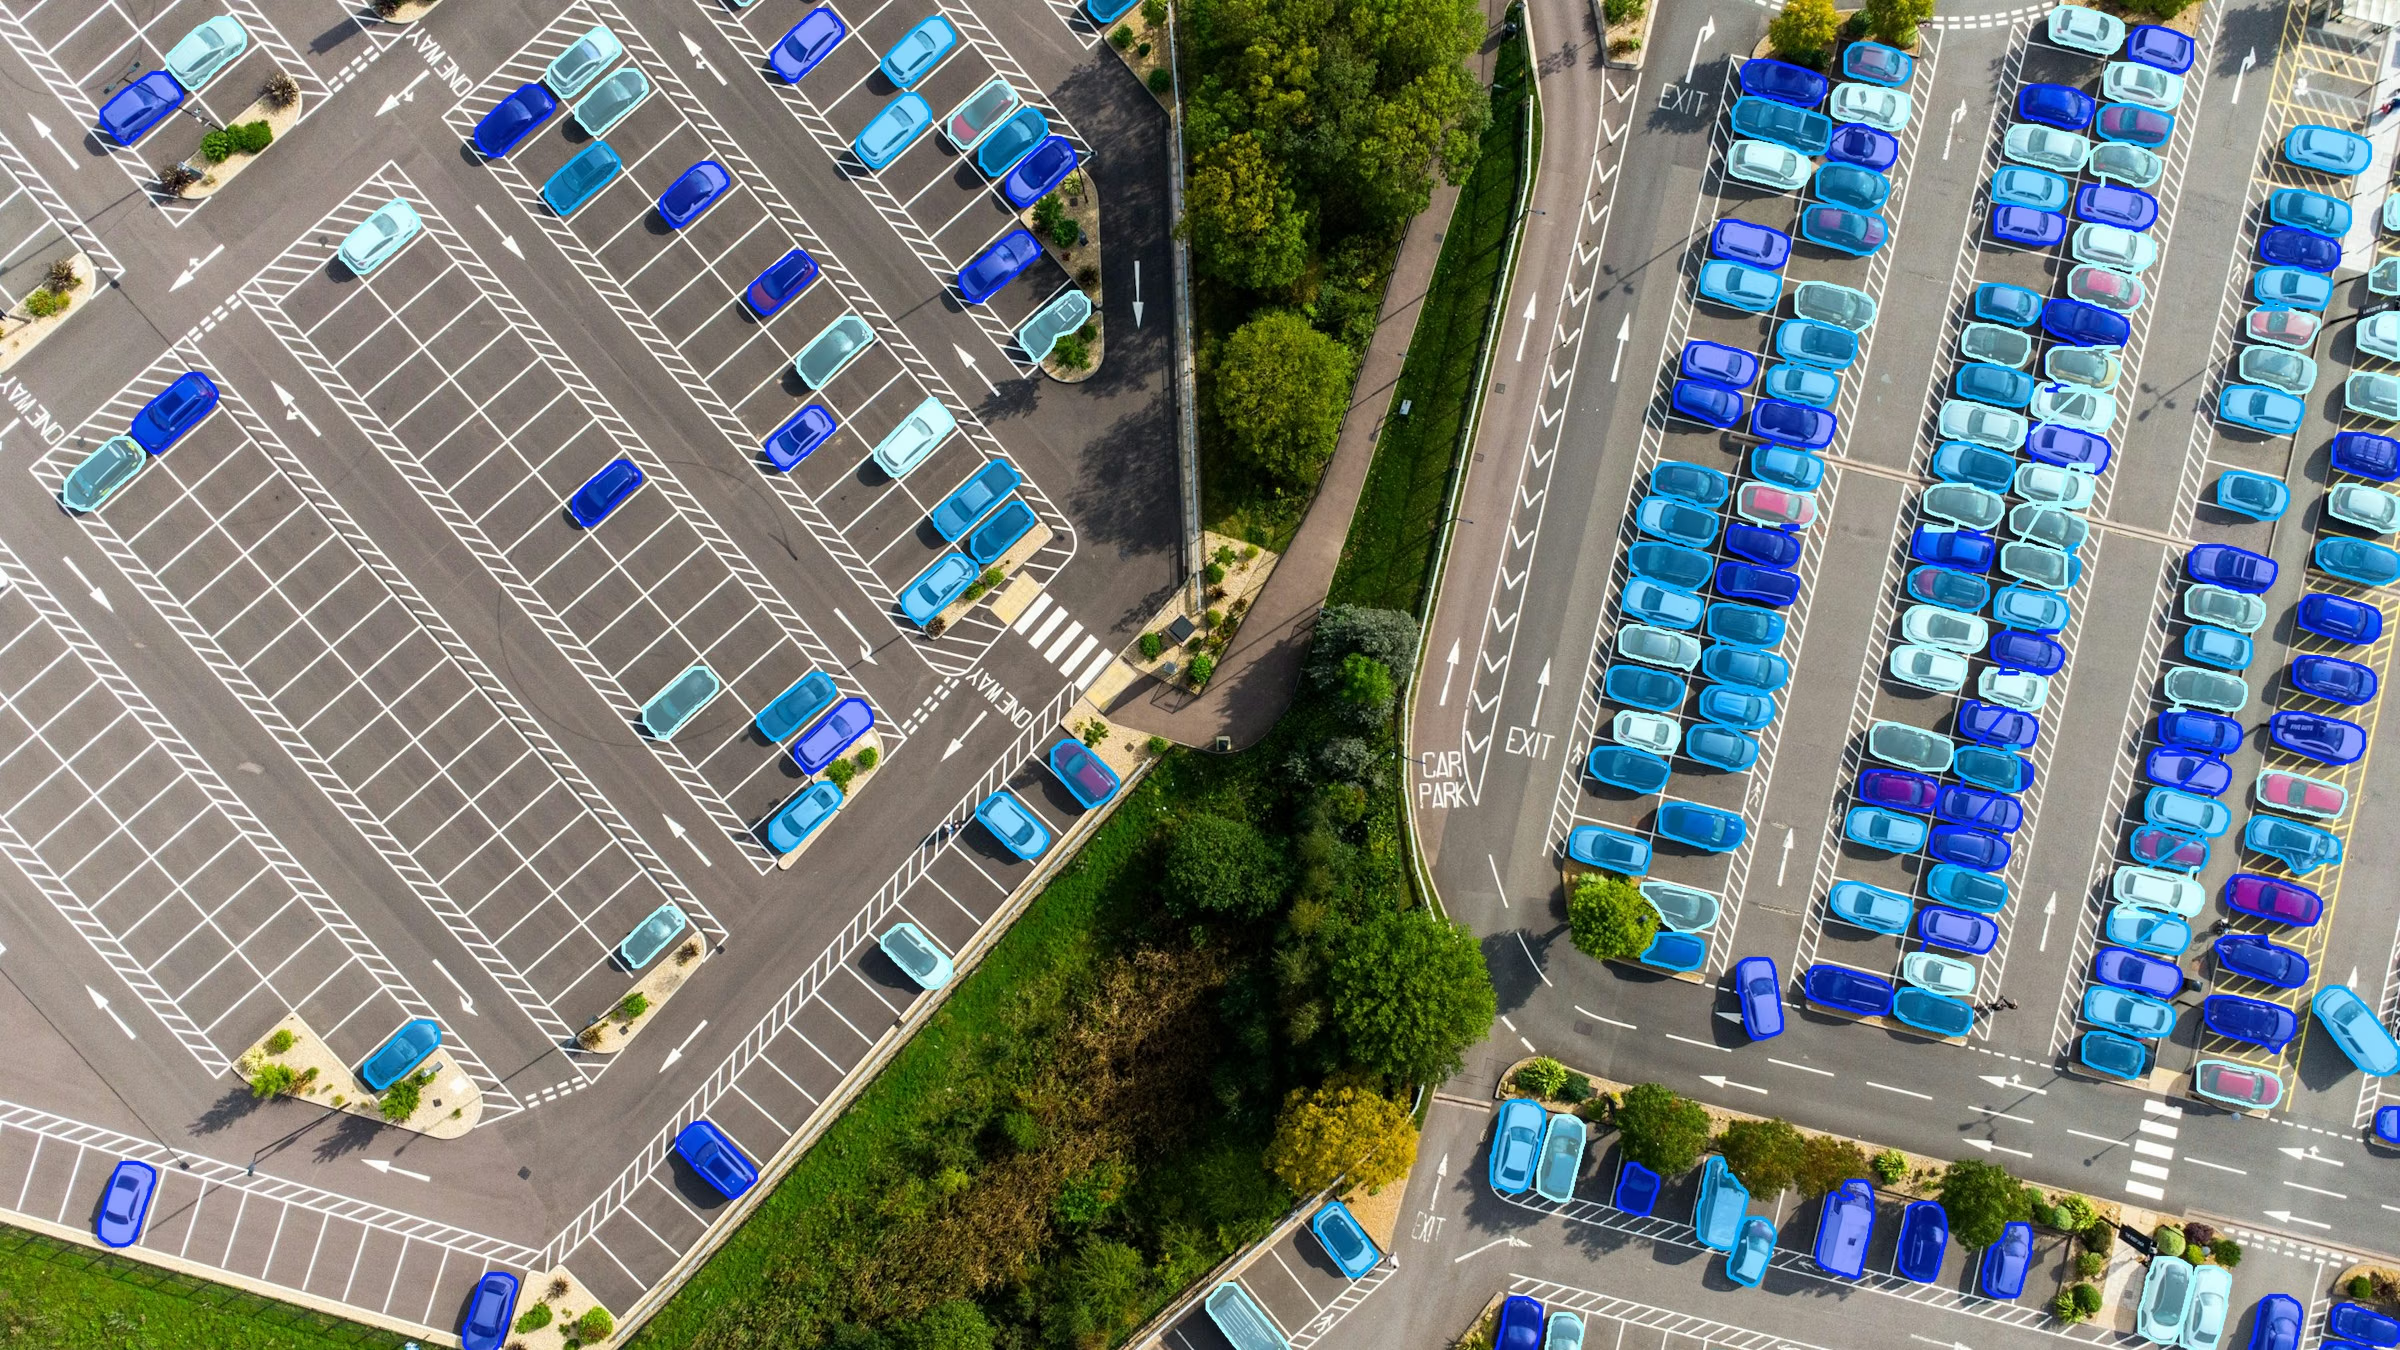
YOLO26x-seg a renvoyé 222 masques de voitures sur cette image aérienne (imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). Photo : Unsplash.
Les prédictions sur CPU sont aussi beaucoup plus rapides#
Sur un CPU Linux x86 à 8 threads, le processus occupe environ 840 MiB avant la création de tout masque. En 1080p avec 1 000 masques en pleine résolution, la mémoire maximale du processus est passée de 5 217 MiB à 1 072 MiB, et le temps a diminué comme indiqué ci-dessous.
300 et 1 000 masques en 1920 x 1080, et 300 masques en 4000 x 3000 (12 MP). YOLO26n-seg, prédiction et résumé, 8.4.212 avant et 8.4.213 après. Source : PR #27197.
Les masques correspondent à ceux de la version 8.4.212, avec de légères différences sur les bords dans un mode#
Un chemin plus rapide n’est utile que s’il renvoie le même résultat. La PR a comparé 8.4.213 à 8.4.212 sur 96 prédictions, avec YOLO26n-seg et YOLO11n-seg sur deux images à six tailles, conf de 0,25 et 0,01, les deux modes de masque, et le chemin limité aux boîtes forcé :
- Masques par défaut (
retina_masks=False) : les boîtes, les masques et les polygones sont identiques ; aucun des 7,6 millions de pixels de masque ne diffère. - Masques en pleine résolution (
retina_masks=True) : ils sont identiques lorsque l’ancien code effectuait une seule interpolation. Pour les autres formes d’image, 0,07 % des pixels de masque diffèrent (18 105 sur 24,8 millions), tous sur les bords des masques, car l’ancien code y effectuait deux interpolations, alors que le nouveau échantillonne les prototypes une seule fois aux coordonnées exactes. - Apple MPS : les masques, les boîtes et les polygones sont identiques sur une scène dense en 1080p comportant 179 masques, dans les deux modes de masque.
Comment segmenter 1 000 objets par image en Python#
Mets à niveau avec pip install -U ultralytics (8.4.213 ou version ultérieure), puis augmente max_det au-delà de sa valeur par défaut de 300. Le reste de ton code ne change pas.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # Classes COCO ; charge ton propre modèle entraîné pour les rayons ou les colis
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # un tableau (P, 2) par objet, en pixels de l’image d’origine
rows = r.summary()  # boîtes et polygones
max_det est une limite maximale, pas une cible : le nombre d’objets renvoyés dépend toujours du modèle, de l’image et de ton seuil de confiance. Pour tirer le meilleur parti de cette amélioration :
- Lis les contours lorsque c’est possible.
masks.xy(pixels) etmasks.xyn(normalisés) sont issus des masques limités aux boîtes avec le chemin pour grandes piles, tout commeto_json()etsave_txt. La référence Results répertorie tous les attributs. - Lis
masks.datapour effectuer directement des calculs sur les pixels. Le calcul des surfaces et des chevauchements est plus simple avec le tenseur dense ; tu peux aussi créer des découpes à partir des contoursmasks.xy. Notre leçon de l’Academy sur l’utilisation des masques dans le code explique quand utiliser chaque vue, et le guide d’isolation d’objets montre comment créer des découpes à partir des contours. - Utilise
retina_masks=Truelorsque tu as besoin de masques à la résolution de l’image source. Dans le benchmark GPU avec 300 masques en 1080p, ce mode prend désormais 18,0 ms, contre 16,3 ms pour les masques par défaut. Pour les objets minuscules dans de très grandes images, consulte notre article sur la détection de petits objets avec le tuilage d’images et le guide du tuilage haute résolution. La prédiction par tuiles renvoie des masques à la taille de l’image source ; une exécution avec tuilage nécessite donc toujours une mémoire proportionnelle à l’image d’origine. - Ajuste
confetioupour les scènes encombrées. Augmentermax_detconserve davantage de détections qui dépassent déjàconf; diminuerconfaccepte les détections moins sûres. Les paramètres de prédiction détaillentconf,iouetmax_det, et notre guide sur le seuil IoU de NMS explique comment traiter les objets qui se touchent.
Cette modification intervient dans le post-traitement Python ; elle s’applique donc au modèle PyTorch ainsi qu’aux modèles exportés exécutés via l’API predict d’Ultralytics. La PR a testé YOLO26n-seg et YOLO11n-seg, et le même post-traitement s’applique à tous les modèles de segmentation YOLO26 et YOLO11, de YOLO26n-seg avec 2,7 M de paramètres fusionnés à YOLO26x-seg avec 62,8 M. Pour en entraîner un sur tes propres données denses, suis notre guide sur l’entraînement personnalisé de YOLO26 pour la segmentation d’instances.
Ultralytics Platform renvoie désormais jusqu’à 1 000 résultats par image#
La même limite s’applique désormais dans Ultralytics Platform. L’onglet Predict d’un modèle renvoie jusqu’à 1 000 résultats par image, tout comme la REST API qui se trouve derrière. Les modèles RT-DETR font exception, avec une limite de 300, correspondant au nombre de requêtes de leur décodeur.
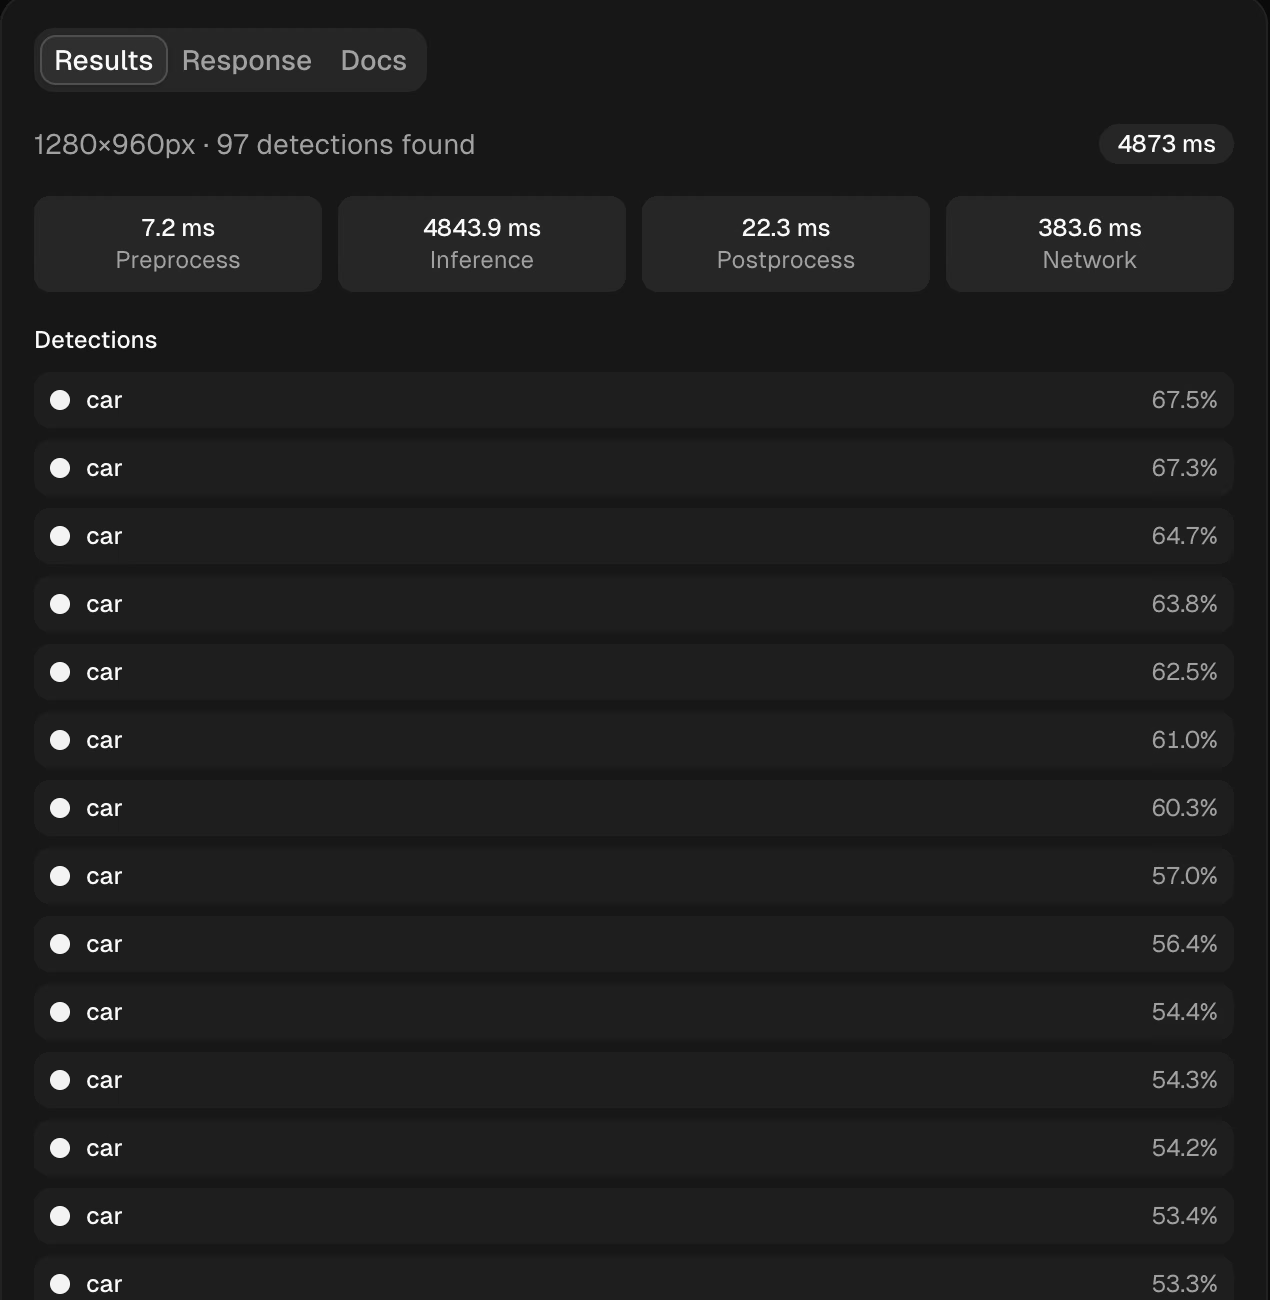
L’onglet Predict pour YOLO26x-seg avec une taille d’image de 1280, affichant 97 détections de voitures sur la photo aérienne ci-dessus. La documentation sur l’inférence de Platform décrit le panneau en détail.
Le panneau des résultats a été conçu pour les longues listes. Au-delà de 10 résultats, l’image affiche des boîtes sans étiquettes afin qu’elles ne masquent pas les objets, la liste nomme chaque résultat et l’image agrandie conserve les étiquettes. Survole une ligne pour mettre en évidence son objet, ou survole un objet pour trouver sa ligne.
Pour essayer avec tes propres données, pars du jeu de données de segmentation de colis Package-Seg, entraîne ton modèle dans le cloud et exécute le résultat dans l’onglet Predict ou derrière un point de terminaison dédié.
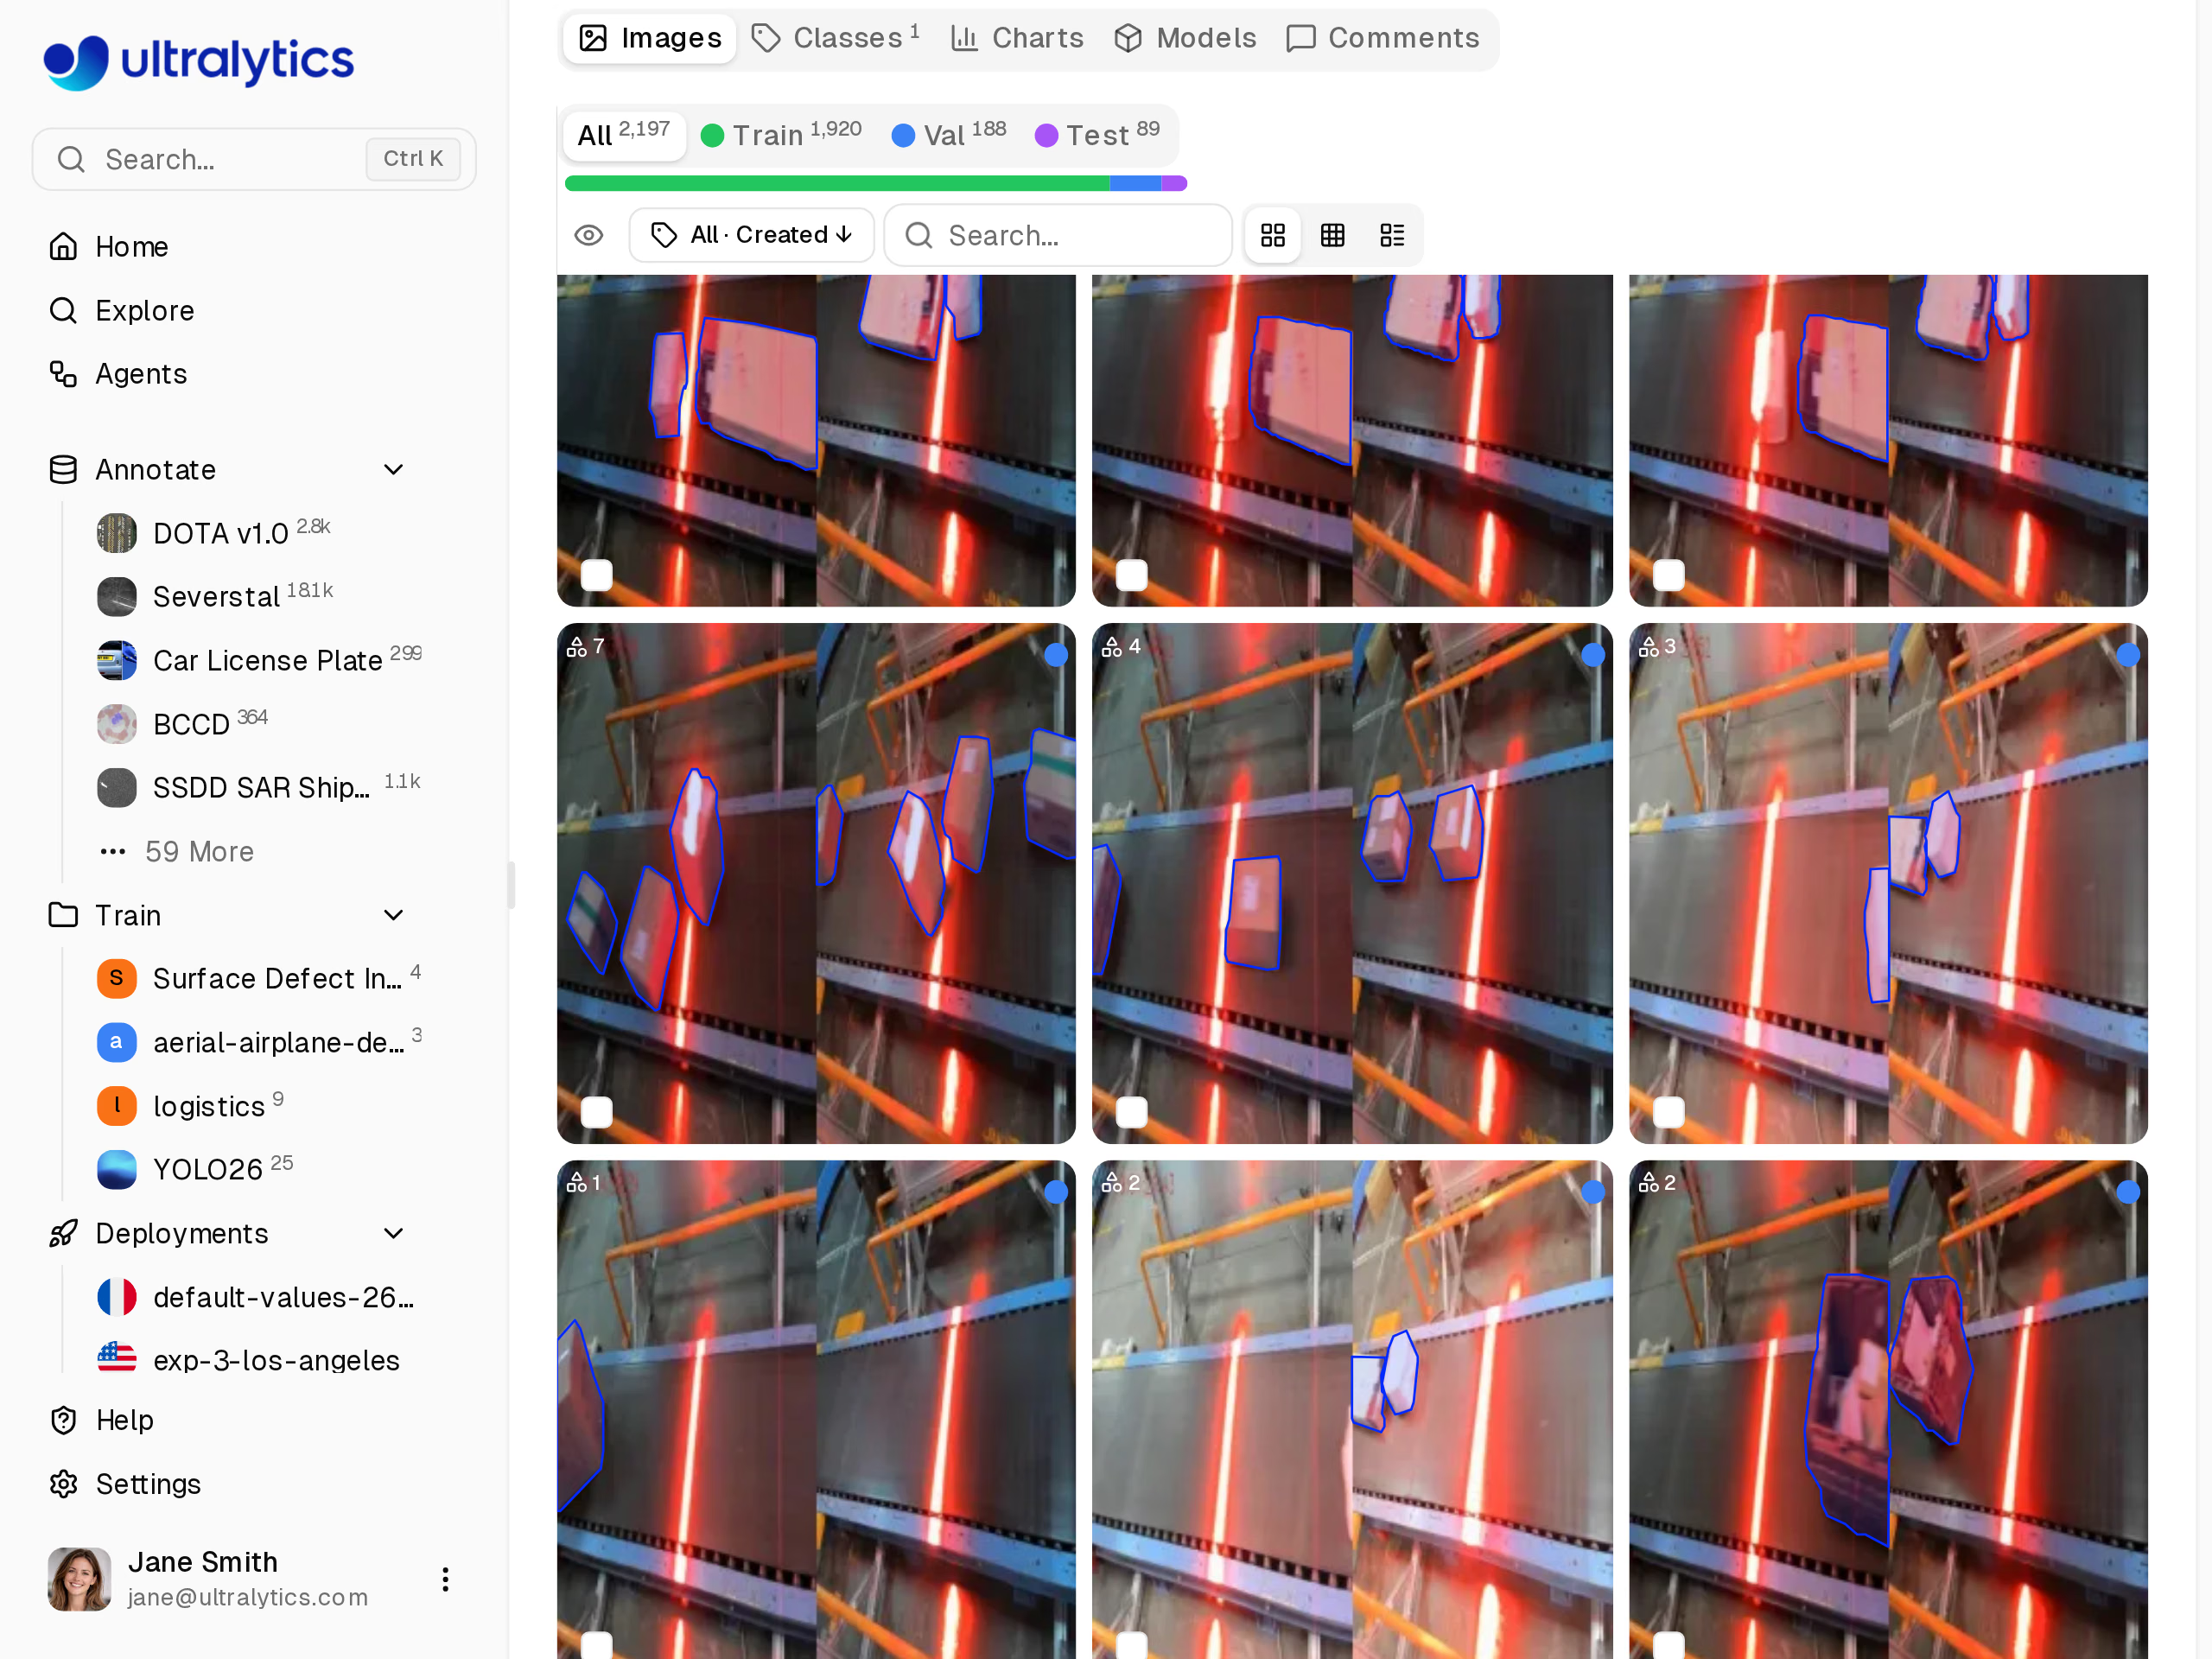
Le jeu de données Package-Seg sur Ultralytics Platform, un point de départ prêt à l’emploi pour la segmentation en logistique.
Qui devrait effectuer la mise à niveau#
Mets à niveau dès maintenant si tu segmentes des scènes encombrées ou de grandes images : rayons de magasins, tri de colis, relevés aériens et par drone, microscopie cellulaire, ou tout autre cas où tu as plafonné max_det, réduit la taille des images ou supprimé retina_masks pour respecter les limites de mémoire. Tu peux revenir sur ces solutions de contournement.
Si tes piles de masques restent sous le seuil, elles conservent le chemin dense existant ; note que le seuil dépend du nombre d’objets multiplié par la taille de l’image, de sorte que même quelques masques sur une très grande image peuvent le dépasser. Si ton pipeline lit toujours masks.data, le tenseur dense est tout de même créé ; dans le test GPU de la PR avec 300 masques en 1080p, il nécessitait moins de temps et de mémoire qu’auparavant. Pour revoir si tu as vraiment besoin de masques d’instances, consulte la segmentation sémantique ou par instances.
Foire aux questions
La segmentation YOLO est la tâche de segmentation d’instances de Ultralytics YOLO : pour chaque objet, le modèle renvoie une classe, une boîte, un score de confiance et un masque de pixels. Les modèles de segmentation YOLO26 existent en cinq tailles, de YOLO26n-seg à YOLO26x-seg, préentraînés sur les 80 classes de COCO et prêts à être affinés sur tes propres données.
max_detdéfinit la limite, 300 par défaut ; le nombre renvoyé dépend aussi du modèle, de l’image et du seuil de confiance. Depuis la version 8.4.213, une limite de 1 000 est pratique pour des charges de travail comme celle du benchmark : sur une image synthétique en 1080p, YOLO26n-seg a prédit et résumé 1 000 masques en pleine résolution en 56,4 ms avec un pic de mémoire de 321 MiB sur une RTX PRO 6000. Ultralytics Platform renvoie jusqu’à 1 000 résultats par image.Les versions précédentes construisaient chaque masque à la taille de l’image ; la mémoire augmentait donc en fonction du nombre d’objets multiplié par la surface de l’image. Dans le benchmark synthétique en 4000 x 3000 avec 1 000 masques en pleine résolution, le pic atteignait 23 305 MiB de mémoire GPU. La version 8.4.213 décode les grandes piles dans chaque boîte et a atteint un pic de 258 MiB pour le même cas.
Mets à niveau vers
ultralytics8.4.213 ou une version ultérieure ; aucune autre modification du code n’est nécessaire, car le chemin limité aux boîtes s’active automatiquement pour les grandes piles de masques.masks.dataconserve le même format dense, donc le code existant continue de fonctionner ; liremasks.xyou appelersummary()à la place évite de le construire avec ce chemin.retina_masks=Truerenvoie les masques à la résolution de l’image d’origine plutôt qu’à la taille d’inférence du modèle, ce qui aligne le masque dense sur l’image d’origine. Avec 300 masques sur une image synthétique en 1080p, la prédiction et le résumé de YOLO26n-seg sur une RTX PRO 6000 ont pris 248,7 ms dans la version 8.4.212 et 18,0 ms dans la version 8.4.213 avec ce paramètre activé.
Écrit par
Fondateur et PDG · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









