Data Curation
La curation des données est le processus continu qui consiste à organiser, valider, documenter et maintenir des jeux de données fiables pour l’apprentissage automatique et l’évaluation.
La curation des données est le processus continu qui consiste à sélectionner, organiser, vérifier, documenter et maintenir les données afin qu'elles restent utiles pour un objectif précis. En apprentissage automatique, elle façonne les exemples à partir desquels un modèle apprend et les éléments probants utilisés pour l'évaluer. Un jeu de données sélectionné avec soin rassemble des échantillons pertinents, des annotations cohérentes pour les tâches supervisées, des informations contextuelles et des versions traçables.
Curation, nettoyage et prétraitement#
La curation couvre le cycle de vie du jeu de données. Le nettoyage des données corrige les erreurs et supprime les enregistrements inutilisables ; le prétraitement des données transforme les entrées au moyen d'opérations telles que le redimensionnement ou la normalisation. L'annotation des données, également appelée étiquetage des données, ajoute les cibles utilisées en apprentissage supervisé. La curation coordonne ces activités tout en déterminant quels échantillons inclure, comment définir les catégories et comment la collection évolue au fil du temps. Des définitions de catégories et des règles d'annotation cohérentes aident les modèles à apprendre des relations fiables entre les images et les cibles.
La curation devient ainsi une composante pratique de l'IA centrée sur les données, qui améliore les systèmes en améliorant leurs données.
Fonctionnement de la curation des données#
Le processus commence par une spécification du jeu de données : la tâche de prédiction, les catégories cibles, les conditions opérationnelles et les critères d'inclusion. Pour la détection d'objets, cela comprend les règles concernant les boîtes englobantes et les objets partiellement visibles. L'examen de la fréquence des catégories et des conditions de capture met en évidence les biais du jeu de données, notamment les classes ou les environnements sous-représentés.
Les contrôles qualité combinent une inspection automatisée et une vérification humaine. Les contrôles de fichiers repèrent les images illisibles ; les contrôles des annotations détectent les coordonnées invalides et les classes incohérentes. Les empreintes des fichiers détectent les copies identiques, tandis que les plongements—représentations numériques du contenu des images—aident à repérer les échantillons visuellement similaires. La vérification permet de distinguer les erreurs réparables des enregistrements inutilisables et de conserver les exemples valides et difficiles qui représentent la tâche.
Un audit par empreinte de fichier peut conserver un chemin par fichier unique. Cet exemple vérifie les images fournies avec le package ultralytics, installé avec pip install ultralytics :
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
Les nombres indiquent combien de fichiers restent après la déduplication exacte ; des nombres égaux signifient que tous les fichiers échantillonnés ont des empreintes distinctes.
Le découpage préserve l'indépendance des données d'entraînement, des données de validation et des données de test. Les images vidéo consécutives partagent le contenu de la scène ; les répartir entre les partitions entraîne une fuite de données et gonfle les scores d'évaluation. Le regroupement par session d'enregistrement, caméra ou site fait en sorte que l'évaluation reflète la tâche de généralisation visée. Une version fixe du jeu de données préserve ces affectations ainsi que ses annotations.
Ultralytics Platform facilite la curation grâce à des graphiques de répartition des classes et au regroupement des images, qui font ressortir les lacunes de couverture, les doublons et les valeurs aberrantes. Ses outils de gestion des jeux de données permettent aux équipes d'examiner ces groupes et de mettre à jour les images, les annotations et les affectations aux partitions.
Le rôle d'un curateur de données#
Un curateur de données préserve la signification et l'utilité de la collection. Ses responsabilités comprennent la documentation des sources, la coordination des consignes d'annotation, la résolution des désaccords d'étiquetage et l'enregistrement des modifications. Les métadonnées — des informations décrivant les échantillons — consignent l'heure d'acquisition, le capteur, l'emplacement et l'état de l'annotation. Maintenir des données réutilisables implique de préserver les descriptions et la documentation d'accompagnement.
La provenance des données indique l'origine des échantillons et les transformations qu'ils ont subies. Le lien entre les versions du jeu de données et le suivi des expériences rend les comparaisons de modèles reproductibles. Après le déploiement, l'apprentissage actif donne la priorité aux échantillons informatifs à examiner ; la surveillance détecte la dérive des données, ce qui peut inciter à recueillir de nouvelles données.
Exemples en vision par ordinateur#
En perception automobile, la collection BDD100K d'origine contient 100 000 vidéos de conduite couvrant des lieux aux États-Unis, différentes conditions météorologiques ainsi que des scènes de jour et de nuit. Ses attributs environnementaux permettent une évaluation dans diverses conditions de capture. L'édition Platform contient 99 996 images clés pour la détection.
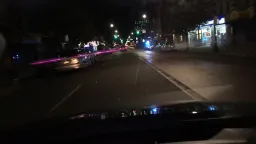 Aperçu 1 de BDD100K
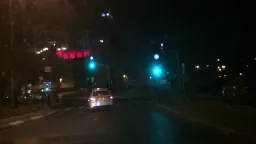 Aperçu 2 de BDD100K
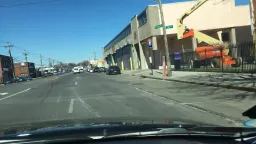 Aperçu 3 de BDD100K
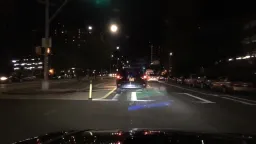 Aperçu 4 de BDD100K
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
Pour la classification d'images, la correction ciFAIR a remplacé les quasi-doublons dans les jeux de test d'origine de CIFAR-10 et de CIFAR-100. Les correspondances avec des images d'entraînement ou d'autres images de test concernaient respectivement 3,25 % et 10 % de leurs jeux de test d'origine. Sans modifier l'entraînement, l'erreur de classification de ResNeXt-29 (8x64d) est passée de 3,56 % sur CIFAR-10 à 3,95 % sur ciFAIR-10.









