Confronto tra piattaforme di addestramento gestito e GPU autogestite per la visione artificiale
Confronta piattaforme gestite per l'addestramento su GPU, servizi cloud di machine learning, GPU a noleggio e hardware di proprietà per la visione artificiale: costi, configurazione, punto di pareggio e casi d'uso.
 Miles Deans11 min di lettura
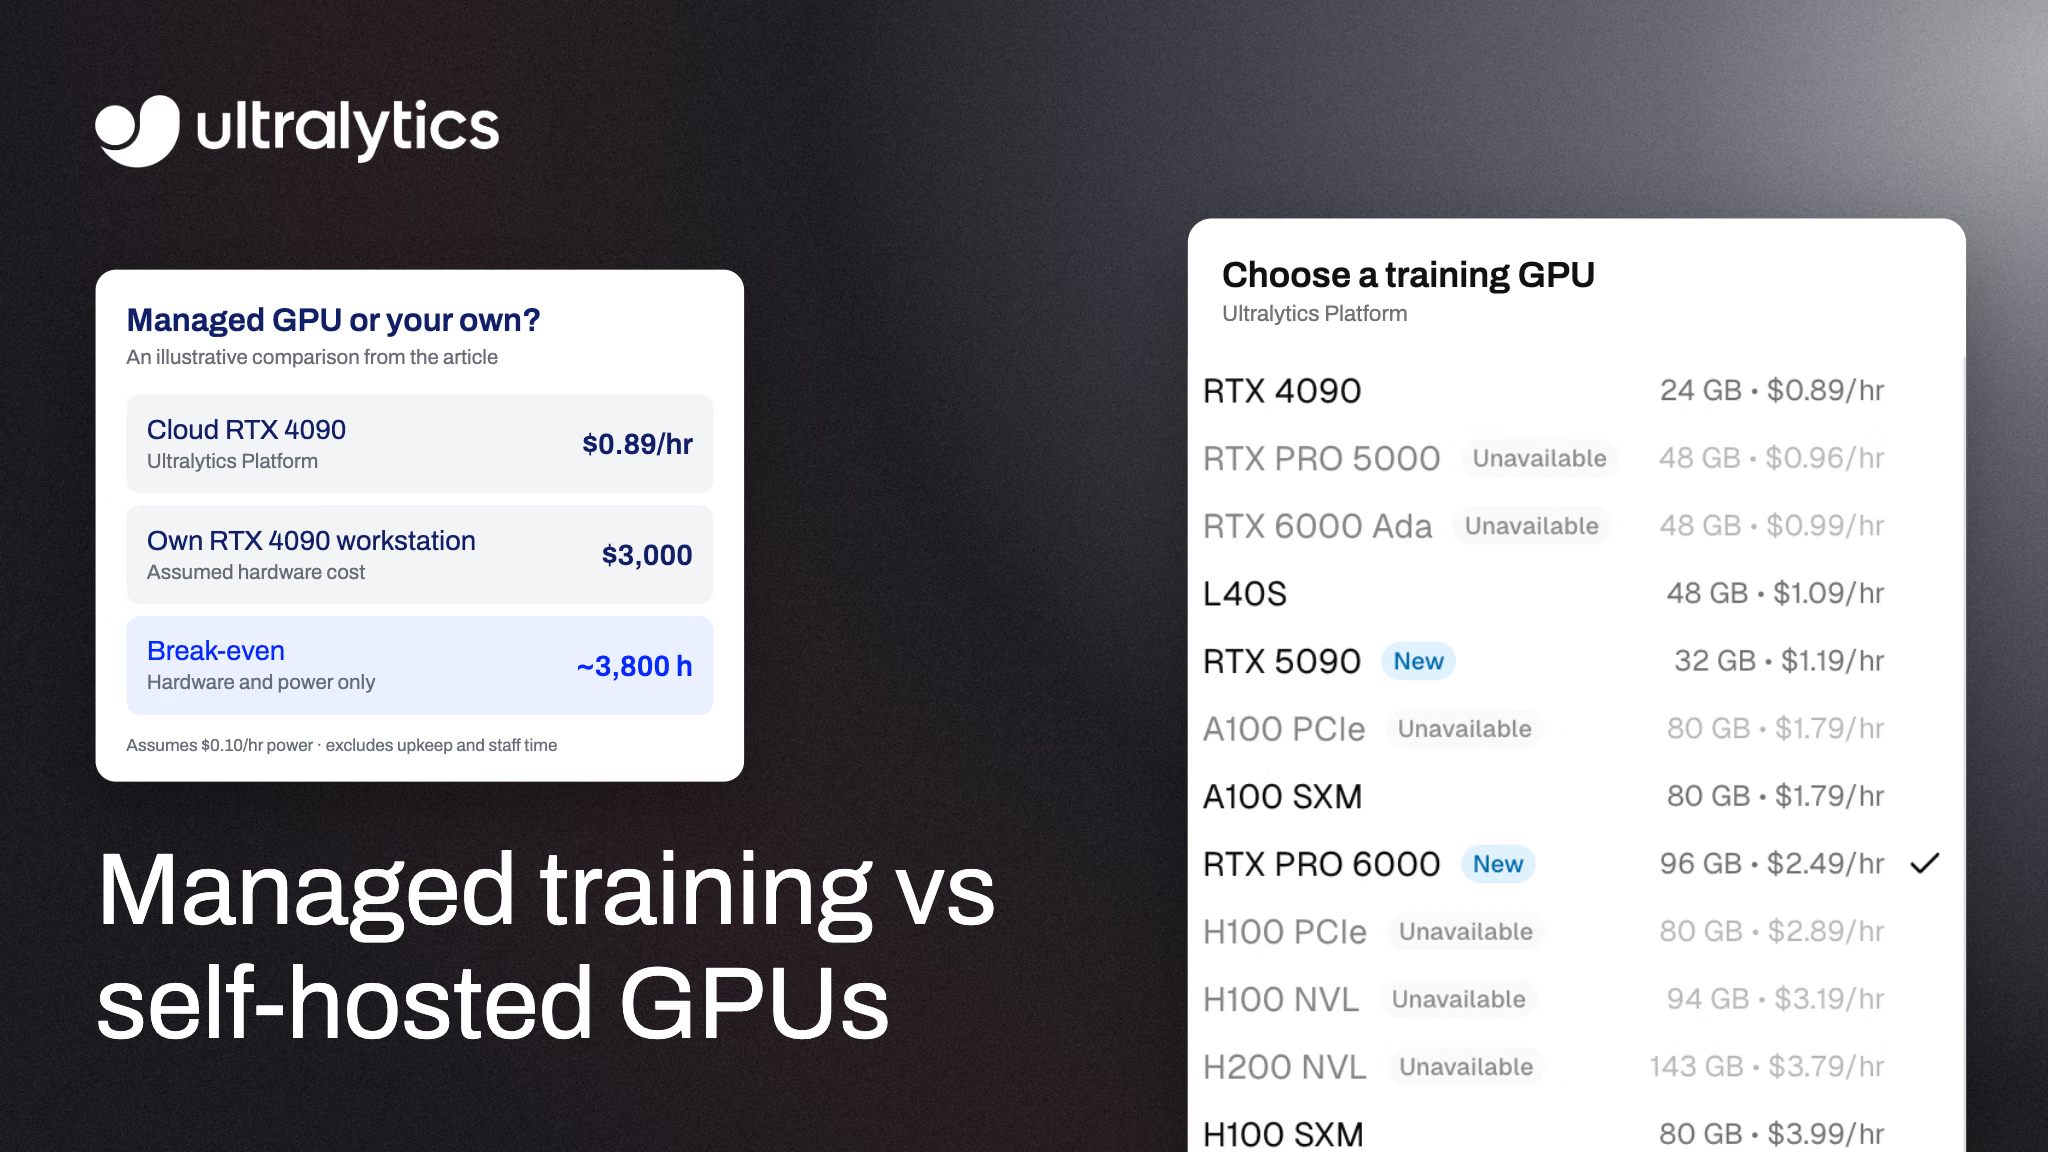
Le piattaforme di addestramento gestito si occupano dell'infrastruttura di addestramento e addebitano il tempo di utilizzo della GPU; con le GPU autogestite, il tuo team è responsabile dell'hardware e dell'ambiente, sia che noleggi le macchine sia che le acquisti. L'addestramento gestito è in genere adatto a carichi di lavoro intermittenti e ai team che vogliono ridurre il lavoro sull'infrastruttura. Possedere GPU può costare meno con un utilizzo costante, ma il risultato dipende da quanto vengono usate le GPU, dalla loro vita utile, dal costo dell'elettricità e dal tempo dedicato all'ingegneria.
Questa guida confronta quattro opzioni comuni per addestrare modelli di visione nel 2026, mostra come calcolare il punto di pareggio per il tuo carico di lavoro e spiega come si inserisce Ultralytics Platform.
Le quattro opzioni per addestrare un modello di visione#
L'espressione «gestito o autogestito» di solito comprende quattro configurazioni diverse:
- Una piattaforma gestita per l'addestramento di modelli di visione. Carichi o colleghi un dataset, scegli un modello e una GPU, e la piattaforma esegue l'addestramento. Ultralytics Platform funziona così per i modelli YOLO.
- Una piattaforma ML generica. Servizi come Amazon SageMaker, Google Vertex AI e Azure Machine Learning eseguono processi di addestramento su istanze cloud per molti framework. Configuri il processo di addestramento, il relativo ambiente, le autorizzazioni e lo storage; il calcolo e i servizi correlati sono fatturati separatamente, quindi confronta le pagine ufficiali dei prezzi di ciascun fornitore, non solo le tariffe delle GPU.
- Una GPU cloud a noleggio. I servizi cloud con GPU, come RunPod e Lambda, ti noleggiano una macchina in base al tempo di utilizzo. A meno che l'immagine del fornitore non includa già ciò che ti serve, devi configurare i driver, CUDA, i pacchetti Python e il codice di addestramento, e arrestare l'istanza al termine.
- Una GPU di proprietà. Una workstation o un server nel tuo ufficio o centro dati. Acquisti l'hardware una volta sola e paghi l'elettricità, il raffreddamento, la manutenzione e il tempo necessario per mantenerlo operativo.
Confronto a colpo d'occhio tra addestramento gestito e GPU autogestite#
| Fattore decisionale | Piattaforma gestita per la visione artificiale | Piattaforma ML generica | GPU cloud a noleggio | GPU di proprietà |
|---|---|---|---|---|
| È necessario acquistare l'hardware | No | No | No | Sì |
| Paghi per | Tempo di utilizzo della GPU | Tempo di utilizzo dell'istanza e servizi correlati | Tempo di utilizzo dell'istanza mentre è in esecuzione | Hardware, elettricità, manutenzione |
| Configurazione prima della prima esecuzione | Scegli dataset, modello e GPU | Configura processo, ambiente, autorizzazioni e storage | Configura o verifica ambiente, codice e dipendenze | Hardware, sistema operativo, driver, pacchetti |
| Ambiente di addestramento | Gestito dalla piattaforma; scegli tu le impostazioni | Condiviso tra il servizio e il tuo team | Per lo più gestito dal tuo team | Il tuo team |
| Come ottenere una GPU più potente | Seleziona un'altra GPU disponibile | Seleziona un altro tipo di istanza | Noleggia un'altra macchina | Acquista un'altra GPU |
| Posizione dei dati | Storage della piattaforma, bucket cloud collegato (Pro ed Enterprise) o dati on-premise (Enterprise) | Il tuo account cloud | Dove li copi | Nei tuoi locali |
| Da prendere in considerazione quando | Vuoi un addestramento di modelli di visione rapido e ripetibile | I team hanno già standardizzato gli strumenti ML di un provider cloud | Gli ingegneri sono a proprio agio nella gestione delle macchine | L'addestramento è costante e quasi continuo oppure vigono rigidi requisiti on-premise |
Come viene fatturato l'addestramento gestito su GPU#
Su Ultralytics Platform, il costo della GPU per un'esecuzione di addestramento è semplice da stimare:
GPU cost = selected GPU hourly rate × billable GPU hoursQuando confronti i fornitori, usa lo stesso carico di lavoro e lo stesso obiettivo di accuratezza, e aggiungi eventuali costi di abbonamento, storage, trasferimento dei dati e tempo di ingegneria.
Ultralytics Platform elenca 26 tipi di GPU NVIDIA, con prezzi a partire da $0.24/hr, senza importi minimi né vincoli; il piano Free ne consente 24, mentre i piani Pro ed Enterprise le includono tutte e 26. Ecco alcune opzioni comuni:
| GPU | VRAM | Prezzo orario |
|---|---|---|
| RTX 4090 | 24 GB | $0.89 |
| A100 SXM | 80 GB | $1.79 |
| RTX PRO 6000 (opzione predefinita consigliata) | 96 GB | $2.49 |
| H100 SXM | 80 GB | $3.99 |
| B200 (piani Pro ed Enterprise) | 180 GB | $7.99 |
La fatturazione si basa sul tempo effettivo di utilizzo della GPU. Le esecuzioni completate, annullate e quelle che non vanno a buon fine dopo l'avvio della GPU vengono addebitate per il tempo di utilizzo della GPU trascorso; un errore prima dell'avvio della GPU non comporta costi. La finestra di dialogo dell'addestramento stima durata e costo prima dell'avvio, e ogni stima riserva dal saldo almeno 15 minuti di utilizzo della GPU; la prenotazione determina il saldo necessario per avviare l'esecuzione, mentre la fatturazione si basa sul tempo effettivo di utilizzo della GPU.
Per contestualizzare, i tempi di addestramento tipici di Ultralytics per 1.000 immagini e 100 epoche su una RTX PRO 6000 sono circa 15 minuti per YOLO26m e circa 30 minuti per YOLO26x. A $2.49 l'ora, si tratta rispettivamente di circa $0.62 e $1.25 di utilizzo della GPU. I tempi effettivi variano in base alla dimensione delle immagini, all'aumento dei dati e alla dimensione del batch, quindi considera questi valori un punto di partenza, non un preventivo.
Il costo effettivo delle GPU autogestite#
Una GPU di proprietà non comporta una tariffa oraria, ma il suo utilizzo non è gratuito. Il costo totale comprende:
- L'hardware, oltre al resto della workstation o del server che ospita la GPU.
- Elettricità e raffreddamento per ogni ora di addestramento.
- Tempo di ingegneria per i driver, le versioni di CUDA, i conflitti tra pacchetti e gli ambienti non funzionanti.
- Tempo di inattività. Una GPU che lavora due ore al giorno resta inattiva per il resto del tempo, e il costo per ora di addestramento aumenta di conseguenza.
- Limiti di capacità. Se un modello richiede più VRAM di quella disponibile o più esperimenti devono essere eseguiti contemporaneamente, devi aspettare o acquistare altro hardware.
Un confronto semplificato tra hardware ed elettricità, supponendo che la GPU di proprietà sia veloce quanto quella cloud, è il seguente:
Break-even hours = hardware cost ÷ (cloud hourly rate − your power cost per hour)A titolo di esempio e usando valori ipotetici, supponiamo che una workstation con RTX 4090 ti costi $3,000 e che l'elettricità costi circa $0.10 per ora di addestramento. Rispetto a una RTX 4090 a $0.89 l'ora, raggiunge il punto di pareggio dopo circa 3,800 ore di addestramento: circa 5.3 mesi di utilizzo continuo, 24 ore su 24, oppure 15.8 mesi usandola otto ore al giorno. Il calcolo esclude raffreddamento, consumo elettrico in inattività, riparazioni, finanziamento, valore di rivendita e il tuo tempo; acquistare l'hardware conviene solo se riesci a fare tutte quelle ore di addestramento entro la sua vita utile. Usa il preventivo effettivo dell'hardware, il costo dell'elettricità e le ore di addestramento previste: il risultato varia molto in base all'utilizzo.
Quando conviene usare GPU autogestite#
Possedere l'hardware è la scelta migliore quando:
- Le tue GPU sono molto utilizzate. Il riaddestramento continuo, le ricerche estese di iperparametri o un team che condivide una macchina per tutto il giorno aumentano l'utilizzo, avvicinandolo al punto di pareggio.
- I dati non possono uscire dai tuoi locali. Alcuni ambienti regolamentati o isolati dalla rete escludono del tutto l'addestramento nel cloud.
- Hai già l'hardware. Se una GPU adeguata è inutilizzata, confronta il costo di esercizio e il tempo di addestramento con le opzioni cloud prima di acquistarne altre.
- Hai bisogno del pieno controllo di driver, kernel o codice di addestramento personalizzato non supportato da una piattaforma gestita.
Quando conviene l'addestramento gestito#
Una piattaforma gestita è la scelta migliore quando:
- L'addestramento è discontinuo. Addestri quando cambiano i dati, poi non lo fai per giorni.
- Vuoi iniziare subito. Prima della prima esecuzione non devi installare driver, risolvere incompatibilità di CUDA né fare debug dell'ambiente.
- Le dimensioni dei modelli variano. Puoi addestrare un modello nano su una GPU piccola e un modello grande su una GPU da 80 GB o più, senza acquistare né l'una né l'altra.
- Più persone si occupano dell'addestramento. Esecuzioni, metriche e checkpoint si trovano tutti nello stesso posto, anziché su macchine individuali.
La soluzione ibrida: GPU di proprietà e dashboard gestita#
Non devi scegliere tra l'una e l'altra opzione. Ultralytics Platform supporta l'addestramento remoto: esegui l'addestramento sulla tua GPU con il pacchetto ultralytics, trasmetti le metriche in tempo reale alla stessa dashboard di Platform usata per le esecuzioni cloud e carichi i pesi finali al termine dell'addestramento. Le esecuzioni remote usano la tua GPU, non le GPU cloud di Ultralytics, quindi non consumano tempo di utilizzo delle GPU cloud.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=100,
    project="username/my-project",  # il tuo progetto Platform
    name="local-gpu-run",
)
Imposta prima la tua chiave API con export ULTRALYTICS_API_KEY="YOUR_API_KEY". L'integrazione con Platform richiede Python 3.11 o versioni successive e ultralytics 8.4.120 o versioni successive. Un approccio comune consiste nell'eseguire esperimenti rapidi su una GPU locale, per poi inviare al cloud le esecuzioni più lunghe o urgenti quando la macchina locale è occupata.
Come addestrare YOLO26 su una GPU gestita con Ultralytics Platform#
- Crea un account su platform.ultralytics.com. I nuovi account ricevono un credito di iscrizione di $5, oppure di $25 dopo aver verificato un indirizzo email aziendale.
- Aggiungi un dataset caricando immagini ed etichette oppure collega un bucket Amazon S3 con un piano Pro o Enterprise.
- Apri la finestra di dialogo dell'addestramento, scegli un modello YOLO26 e imposta le epoche e la dimensione delle immagini.
- Scegli una GPU. RTX PRO 6000 è l'opzione predefinita consigliata; consulta come scegliere una GPU cloud per valutare i compromessi.
- Controlla la stima dei costi, avvia l'addestramento e monitora le metriche in tempo reale fino al termine dell'esecuzione.
Il piano Free consente di eseguire fino a 3 processi di addestramento cloud contemporaneamente. Il piano Pro, a $29 per utente al mese, aumenta il limite a 10 e include $30 di credito mensile per utente.
Al termine dell'addestramento, puoi esportare il modello o distribuirlo come API. Se stai anche decidendo dove eseguire l'inferenza, la nostra guida a IA per la visione nel cloud o autogestita confronta costi, latenza e controllo dei dati per la distribuzione.
Domande frequenti
Può costare meno, soprattutto se l'addestramento è intermittente, perché paghi solo le ore di utilizzo effettivo della GPU. Confronta il costo totale e il tempo necessario per completare lo stesso carico di lavoro; il calcolo del punto di pareggio riportato sopra (costo dell'hardware diviso per la tariffa oraria del cloud meno il costo orario dell'elettricità) è un punto di partenza, non una garanzia.
Una GPU cloud a noleggio ti fornisce una macchina, mentre il tuo team configura il carico di lavoro di addestramento e verifica o configura l'ambiente. Una piattaforma di addestramento gestito si occupa di una parte maggiore del flusso di lavoro: su Ultralytics Platform scegli un dataset, un modello e una GPU; la piattaforma assegna la GPU, esegue l'addestramento, trasmette le metriche e salva i checkpoint.
Su Ultralytics Platform, un'esecuzione che non va a buon fine dopo l'avvio della GPU cloud viene addebitata per il tempo di utilizzo della GPU trascorso; un errore prima dell'avvio della GPU non comporta costi. Le esecuzioni annullate vengono addebitate per il tempo di utilizzo della GPU fino all'annullamento.
Sì. L'addestramento remoto viene eseguito sul tuo hardware, trasmette le metriche in tempo reale a Platform e carica i pesi finali, senza usare tempo di utilizzo delle GPU cloud.
La RTX PRO 6000 (96 GB) è l'opzione predefinita consigliata per la maggior parte dei processi. Ultralytics consiglia la RTX 4090 per l'addestramento generico, la A100 SXM per batch di grandi dimensioni o modelli più grandi e le GPU H100, H200, B200 e B300 per i carichi di lavoro più urgenti, che richiedono molta memoria o sono di dimensioni maggiori.
I nuovi account Ultralytics Platform ricevono un credito di registrazione di $5, che sale a $25 dopo la verifica di un'email di lavoro. I piani Pro includono $30 di credito al mese per ogni postazione.
No. Kubernetes può pianificare i carichi di lavoro GPU, ma la documentazione sulla pianificazione delle GPU richiede driver GPU e un plugin per i dispositivi del fornitore sui nodi. Un cluster di addestramento gestito autonomamente richiede comunque che qualcuno si occupi degli ambienti, delle autorizzazioni, del monitoraggio dei job e dei checkpoint, quindi prevedi un budget per questo lavoro oltre ai costi di calcolo.
Scritto da
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









