ONNX vs TensorRT per l'inferenza di visione artificiale: benchmark e come scegliere
ONNX Runtime vs TensorRT per l'inferenza di visione artificiale: velocità e accuratezza misurate di Ultralytics YOLO26 su 19 GPU NVIDIA e come scegliere.
 Miles Deans12 min di lettura
ONNX e TensorRT non sono davvero concorrenti. ONNX è un formato di modello, mentre TensorRT è il motore di inferenza di NVIDIA, che di solito riceve in input un file ONNX. La vera scelta riguarda come eseguire quel file: con ONNX Runtime, compatibile con hardware diversi e in grado persino di delegare il lavoro a TensorRT, oppure compilato in un motore TensorRT autonomo, che funziona solo sulle GPU NVIDIA. Nei benchmark di Ultralytics Platform di Ultralytics YOLO26 su 19 GPU NVIDIA, TensorRT FP16 è risultato più veloce dei risultati ONNX FP16 pubblicati su ogni GPU e per ogni dimensione del modello, con un'accuratezza entro 0.001 mAP50-95. Gli speedup mediani erano compresi tra 1.85x e 2.55x a seconda delle dimensioni del modello. Il benchmark non specifica quale execution provider di ONNX Runtime abbia prodotto i risultati ONNX, quindi non chiarisce come si confronti ONNX Runtime in generale, né con il proprio execution provider TensorRT. Per Ultralytics YOLO26 sulle GPU NVIDIA, inizia con TensorRT FP16 quando la latenza è importante e usa ONNX Runtime quando un unico file di modello deve funzionare su più tipi di hardware. Ultralytics YOLO esporta in entrambi i formati con un solo argomento.
Da dove iniziare con Ultralytics YOLO:
| Distribuzione | Inizia con | Esportazione di Ultralytics YOLO |
|---|---|---|
| GPU NVIDIA, latenza importante | TensorRT FP16 | format="engine", quantize=16 |
| CPU, hardware non NVIDIA o flotte miste | ONNX Runtime | format="onnx" |
| API di ONNX Runtime su una GPU NVIDIA | ONNX Runtime con l'execution provider TensorRT | format="onnx" |
ONNX vs TensorRT: formato, runtime e motore#
Il confronto nasconde tre elementi diversi:
- ONNX (scambio aperto di reti neurali) è un formato di file che archivia il grafo e i pesi di un modello addestrato in modo indipendente dal framework. Esporta da PyTorch a ONNX affinché altri strumenti possano leggere il modello.
- ONNX Runtime esegue modelli ONNX. Delega il lavoro ai back-end hardware chiamati execution provider, come CPU, CUDA e TensorRT, così lo stesso file può funzionare su una CPU di laptop o su una GPU cloud.
- TensorRT legge un modello, in genere un file ONNX, tramite il parser ONNX. Fonde i layer, seleziona il kernel più veloce per ogni operazione sulla GPU di destinazione e scrive un motore ottimizzato.
Quindi il vero confronto è ONNX Runtime vs TensorRT. ONNX Runtime può anche richiamare TensorRT tramite il proprio execution provider TensorRT, consentendoti di mantenere l'API di ONNX Runtime mentre TensorRT esegue i sottografi supportati. ONNX Runtime consiglia di registrare l'execution provider CUDA dopo quello TensorRT, in modo che i nodi non supportati da TensorRT possano essere eseguiti su CUDA.
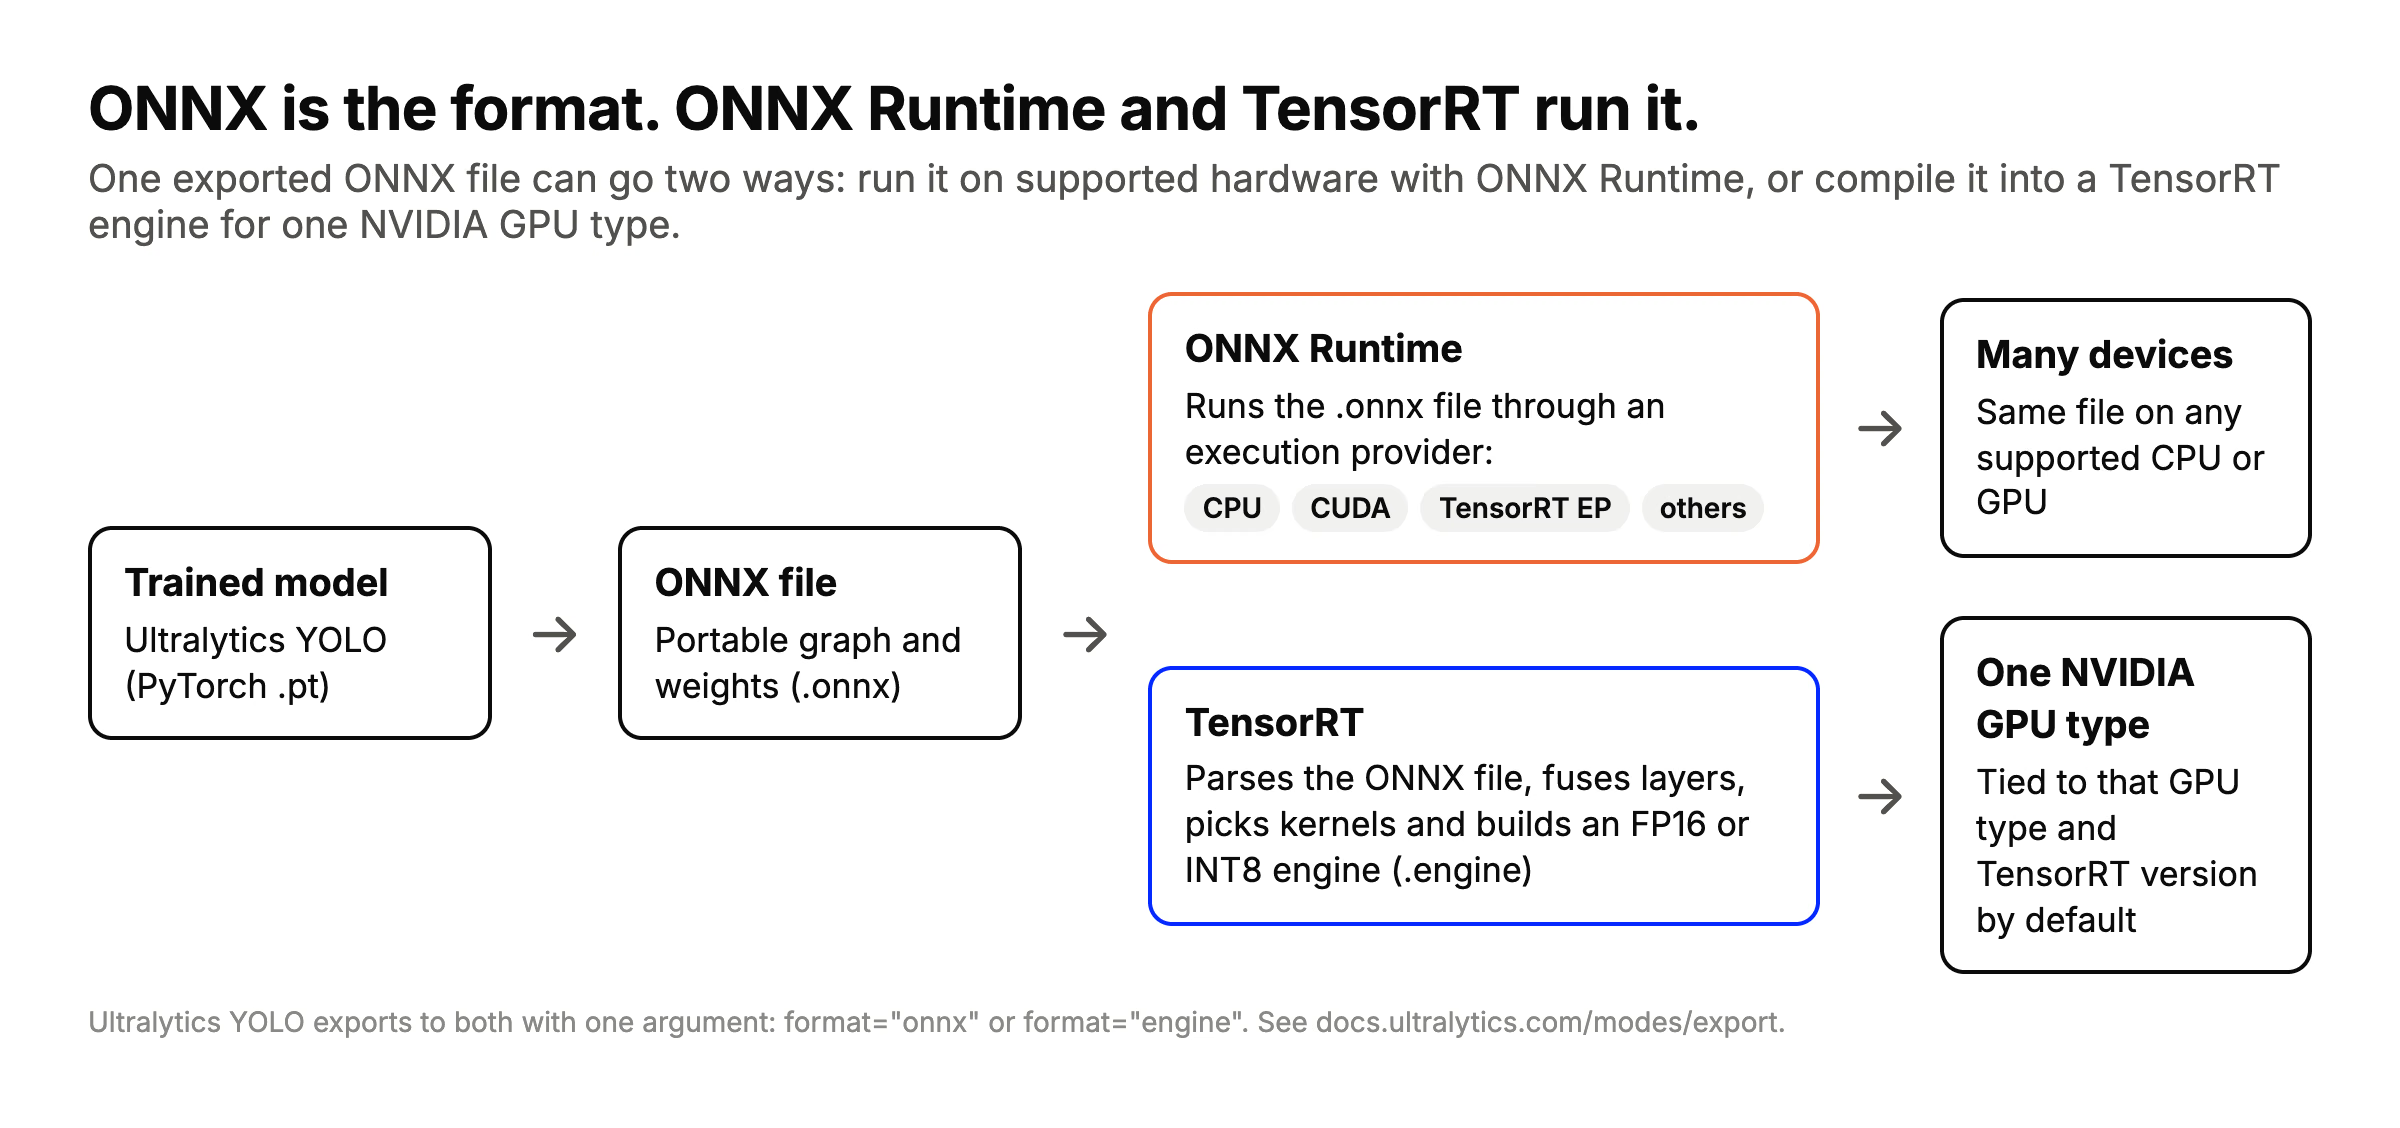
Un solo file ONNX, due percorsi: ONNX Runtime lo esegue sull'hardware supportato, mentre TensorRT lo compila in un motore per un tipo specifico di GPU NVIDIA. Ultralytics YOLO esporta in entrambi i formati.
Benchmark: YOLO26 con ONNX Runtime vs TensorRT#
I numeri riportati di seguito provengono dai benchmark di inferenza di Ultralytics Platform. Ogni modello di rilevamento Ultralytics YOLO26 è stato esportato nel formato indicato, quindi la sua latenza di inferenza è stata misurata sulle GPU di Ultralytics Platform con batch 1 e 640 pixel su COCO val2017, escludendo il riscaldamento e applicando il sigma clipping ai tempi delle singole esecuzioni. L'accuratezza è mAP50-95 su COCO val2017, misurata una volta per formato e precisione. Il confronto usa le 19 GPU NVIDIA (Ampere, Ada e Hopper) per cui sono disponibili risultati in tutti e quattro i formati.
La pagina dei benchmark non indica quale execution provider di ONNX Runtime abbia prodotto i risultati ONNX e non segnala risultati ottenuti con l'execution provider TensorRT di ONNX Runtime, che delega a TensorRT le parti del modello supportate. Questi risultati ONNX descrivono la configurazione sottoposta a benchmark; le prestazioni possono variare in base all'execution provider di ONNX Runtime. Se vuoi usare l'API di ONNX Runtime con TensorRT come motore sottostante, esegui il benchmark di questa combinazione sul tuo hardware.
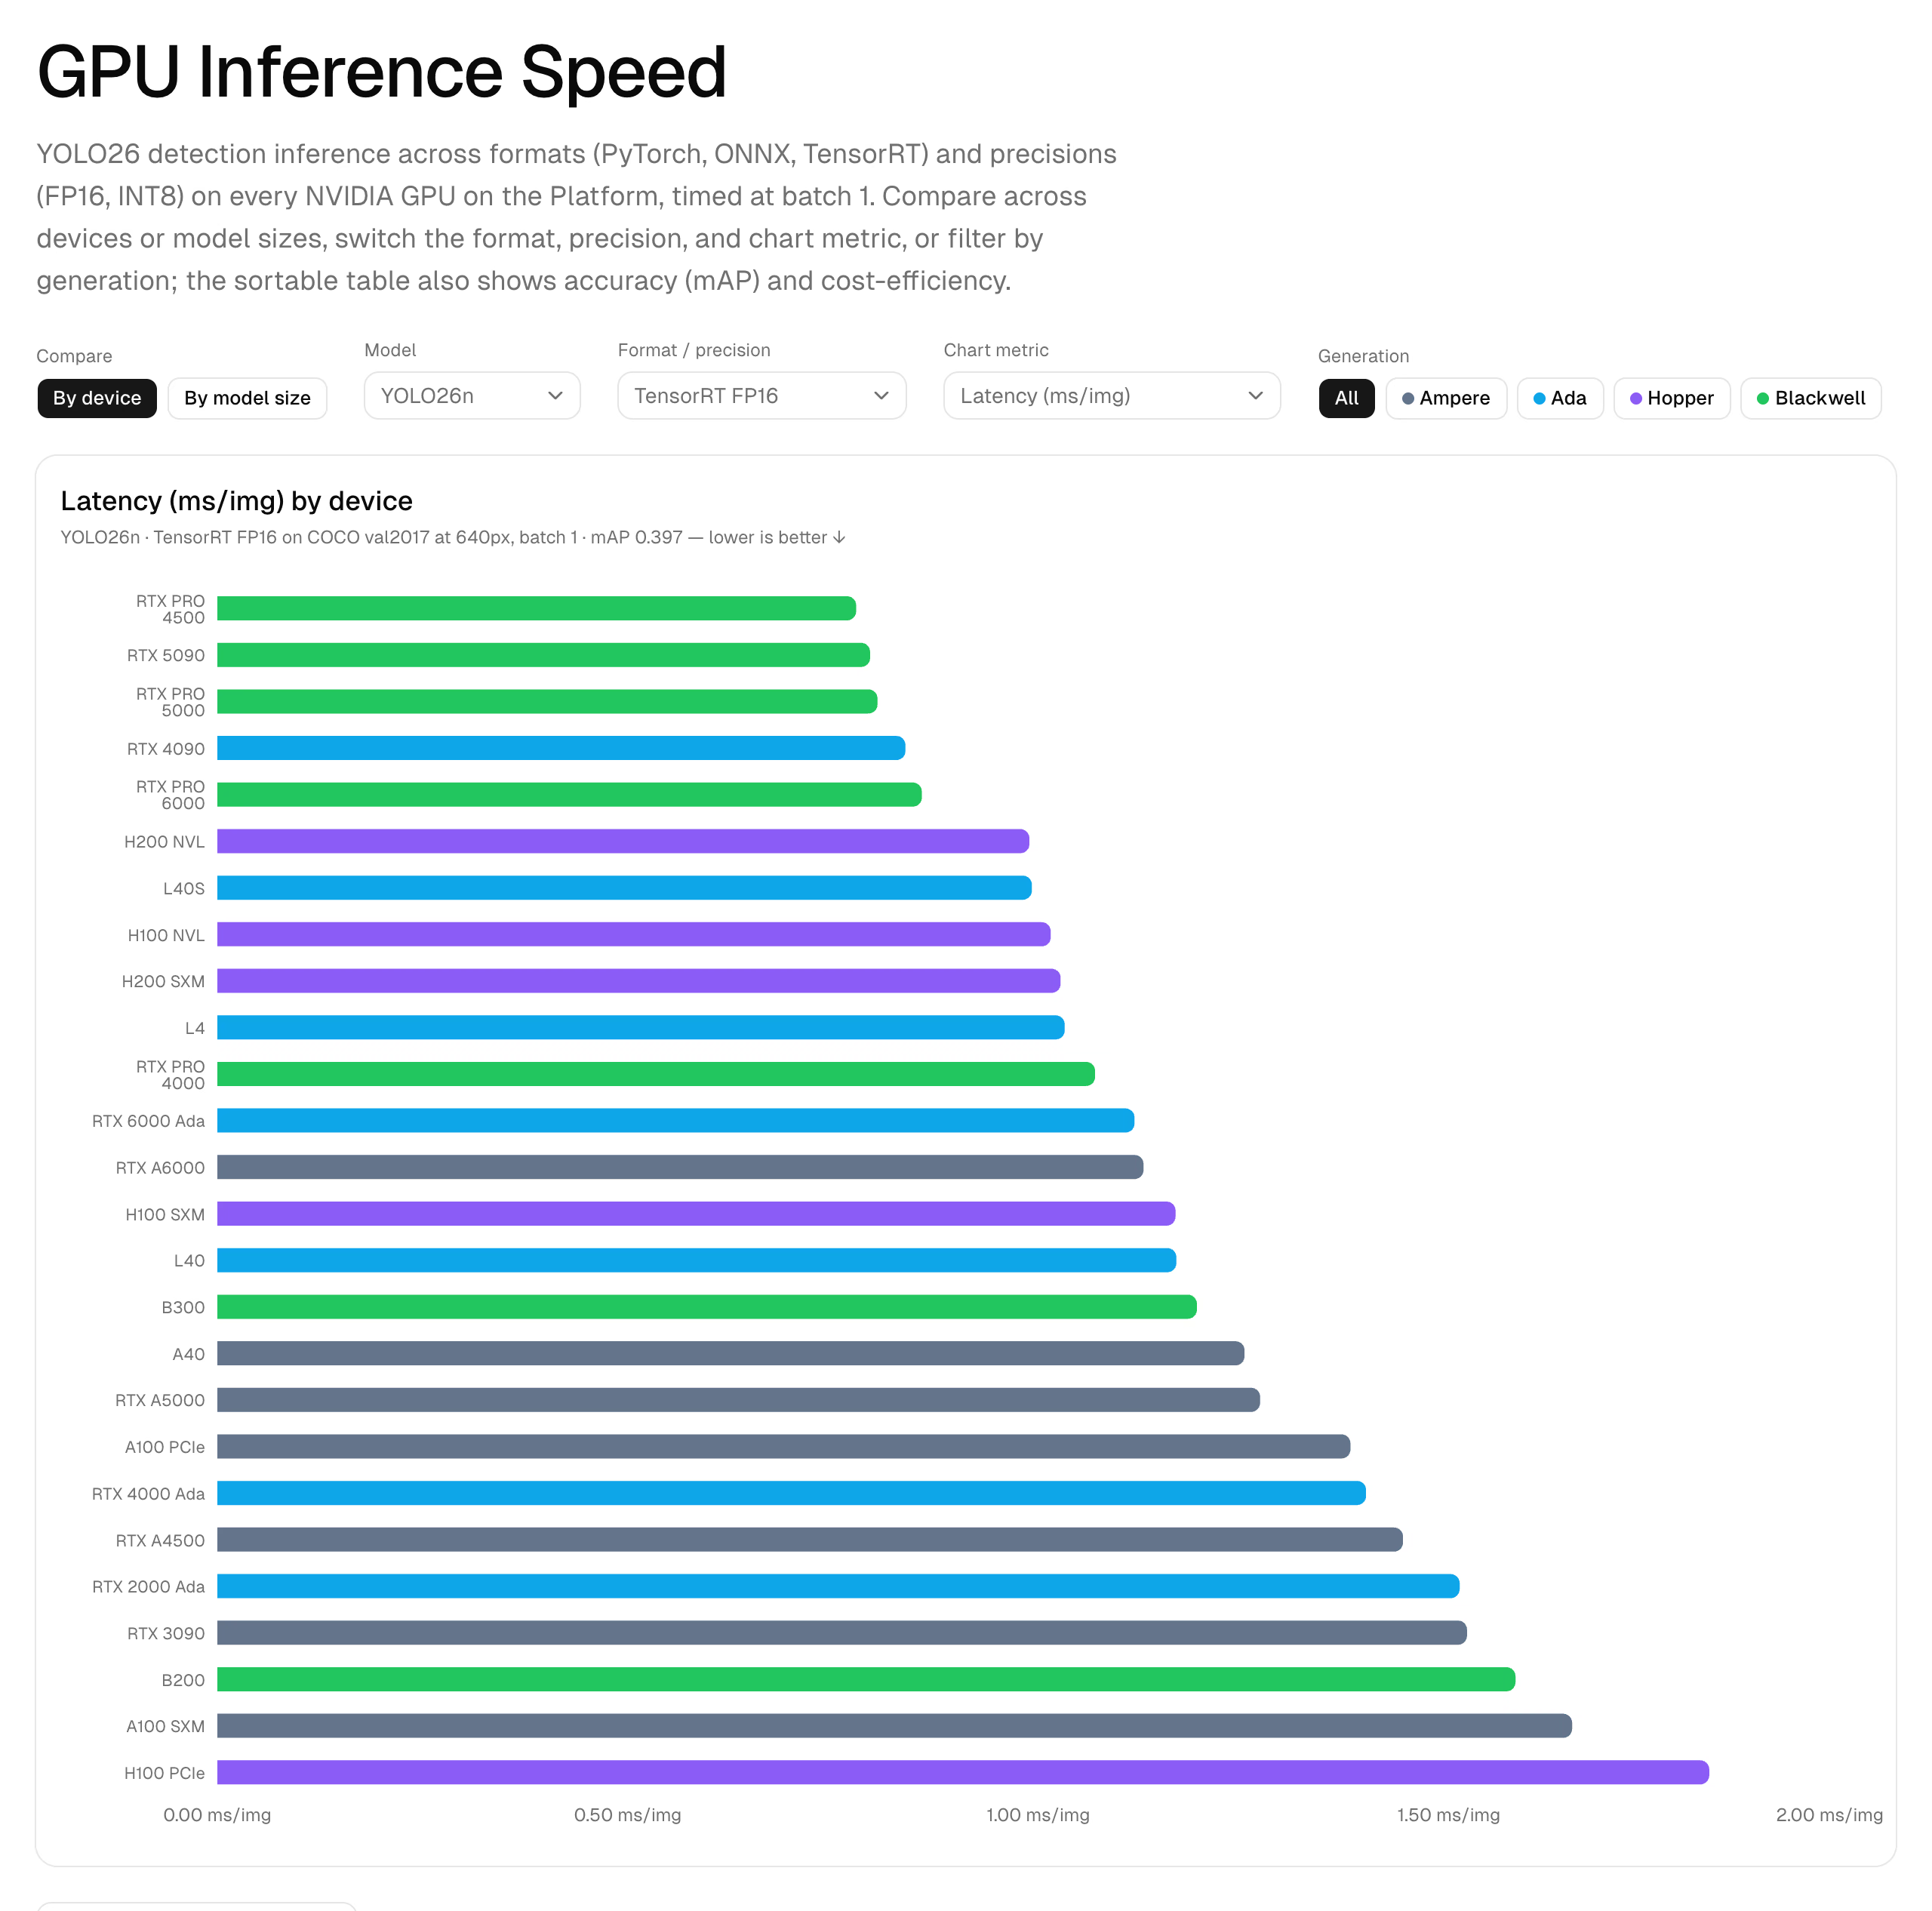
La scheda Inference ti consente di cambiare dimensione del modello, formato e precisione, quindi ordinare tutte le GPU per latenza, accuratezza o costo.
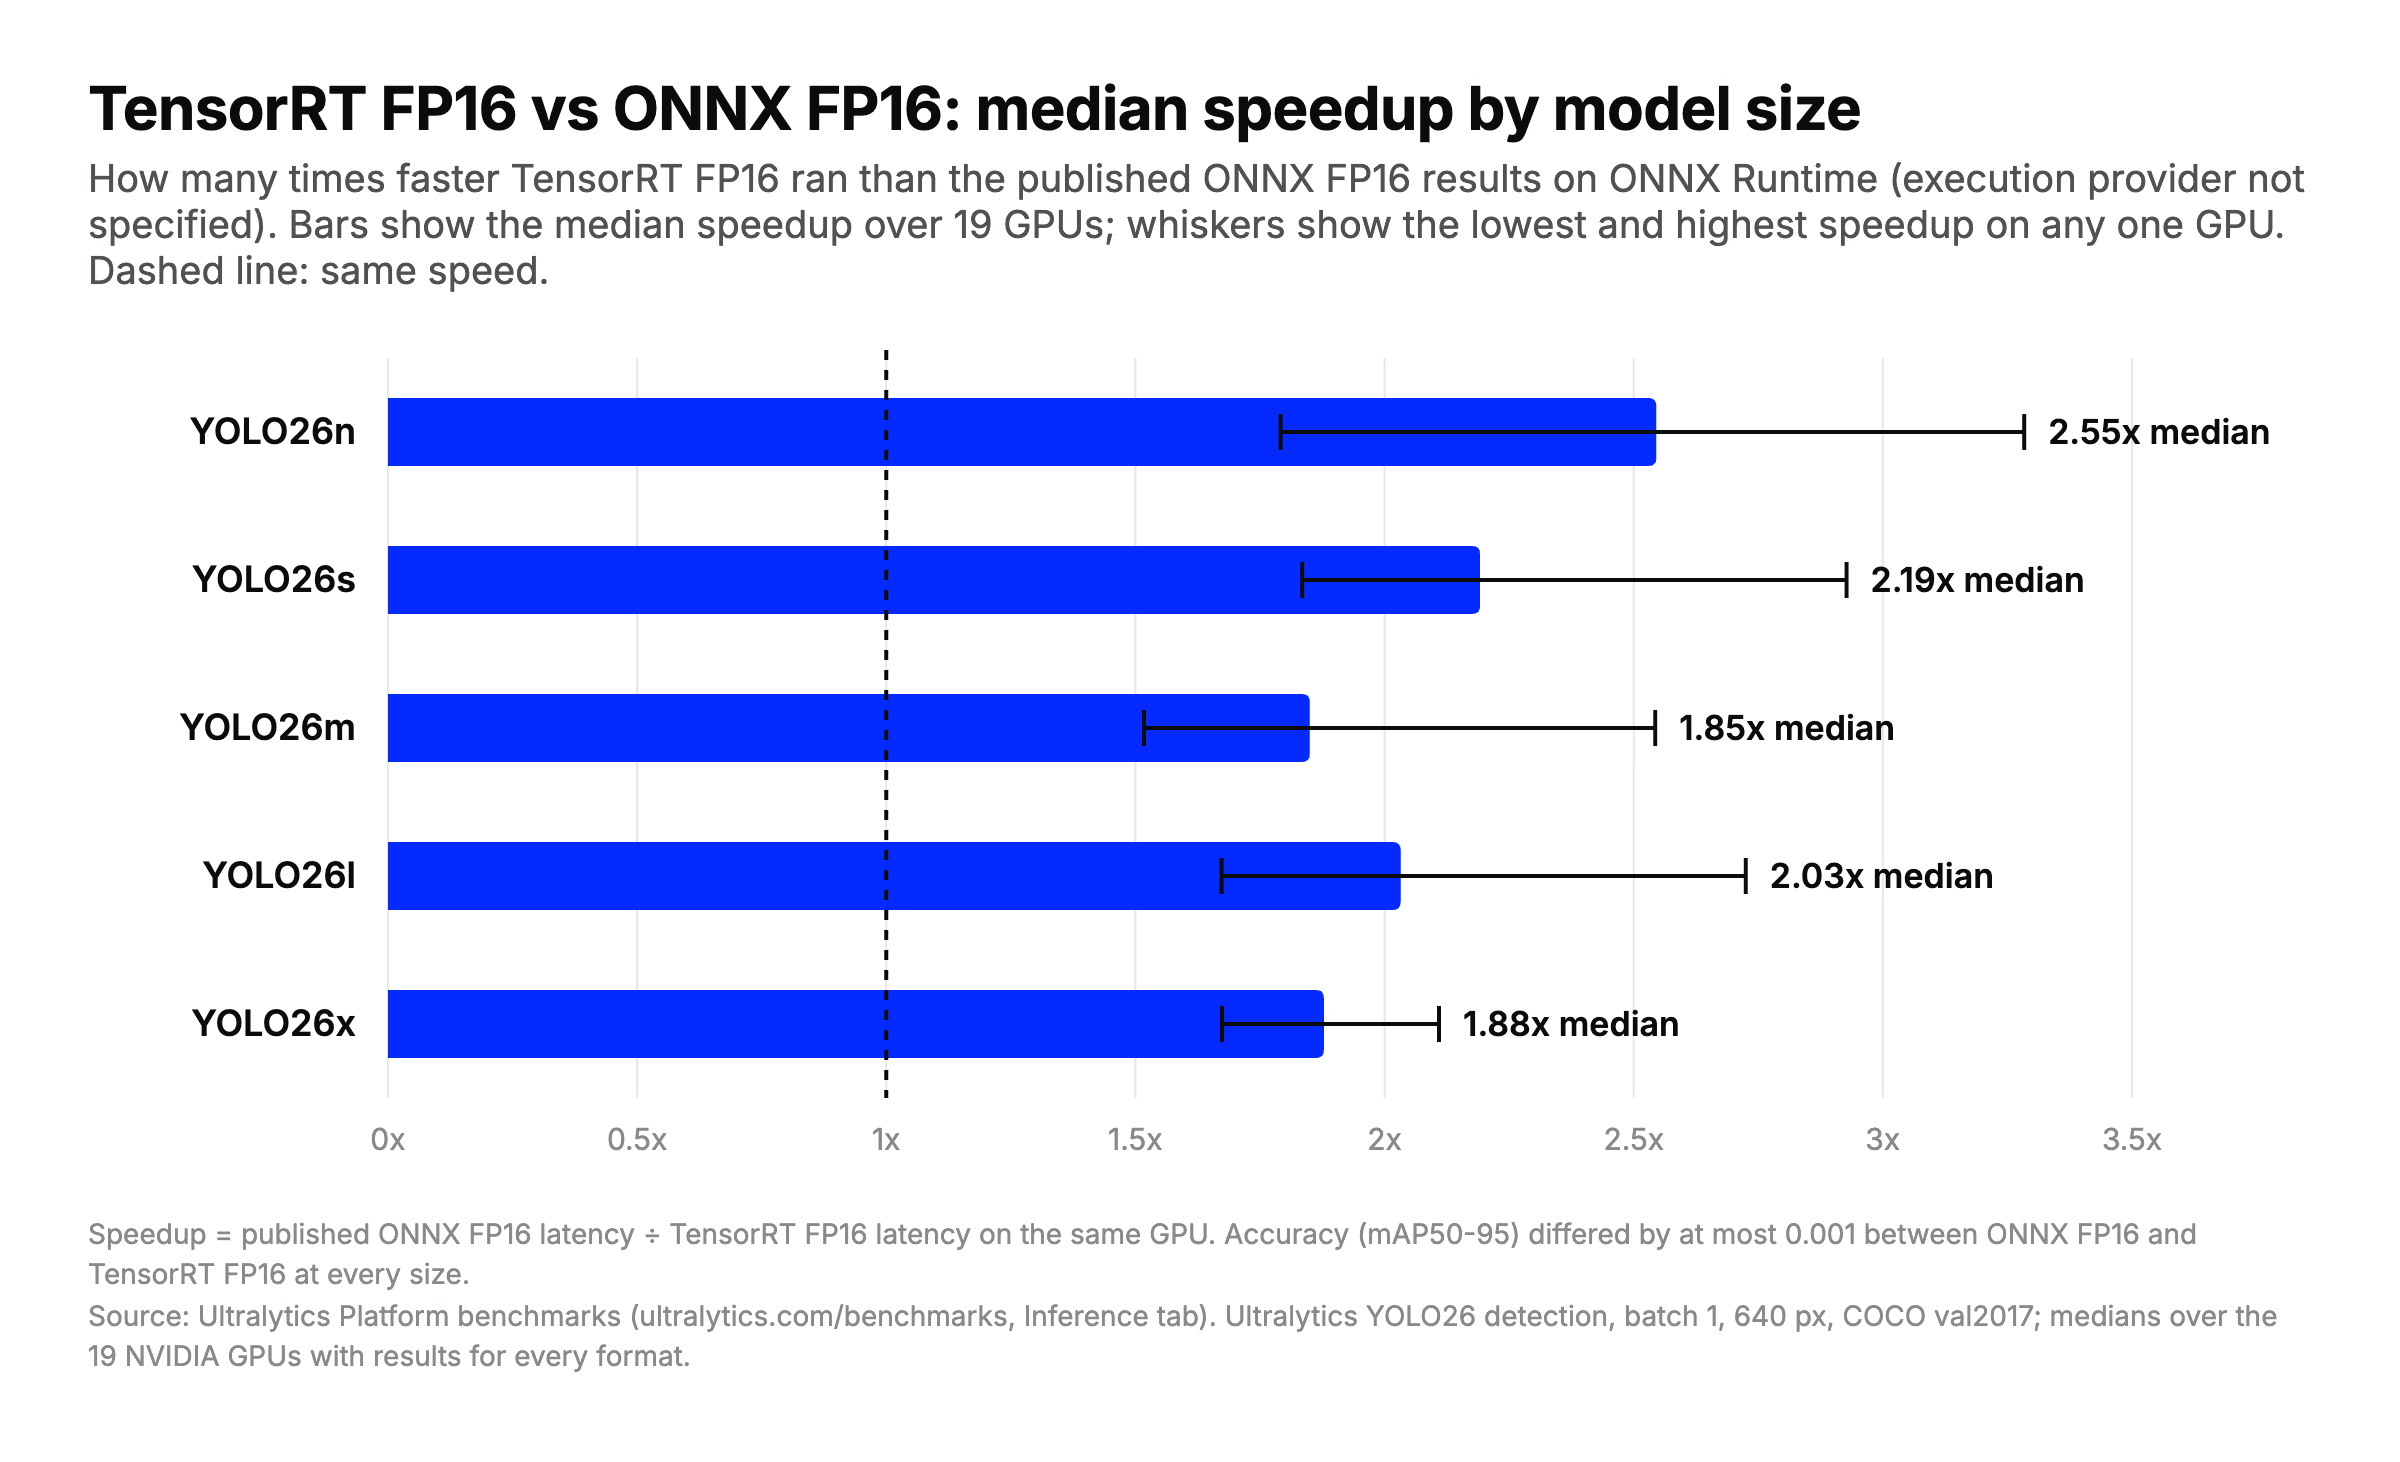
TensorRT FP16 è risultato più veloce dei risultati ONNX FP16 pubblicati su ogni GPU e per ogni dimensione del modello; la pagina non specifica quale execution provider di ONNX Runtime li abbia prodotti. Le barre mostrano lo speedup mediano su 19 GPU; i baffi indicano lo speedup minimo e massimo su una singola GPU. Calcolato dai benchmark di inferenza di Ultralytics Platform.
| Modello | mAP50-95: ONNX FP16 | mAP50-95: TensorRT FP16 | mAP50-95: TensorRT INT8 | Speedup di TensorRT FP16 rispetto a ONNX FP16 (mediana, intervallo) | Speedup di TensorRT INT8 rispetto a TensorRT FP16 (mediana, intervallo) |
|---|---|---|---|---|---|
| YOLO26n | 0.397 | 0.397 | 0.357 | 2.55x (1.79–3.28x) | 0.90x (0.79–1.07x) |
| YOLO26s | 0.471 | 0.471 | 0.436 | 2.19x (1.83–2.93x) | 1.04x (0.89–1.19x) |
| YOLO26m | 0.519 | 0.519 | 0.470 | 1.85x (1.52–2.54x) | 1.20x (0.90–1.38x) |
| YOLO26l | 0.536 | 0.535 | 0.501 | 2.03x (1.67–2.73x) | 1.08x (0.92–1.33x) |
| YOLO26x | 0.563 | 0.564 | 0.488 | 1.88x (1.67–2.11x) | 1.19x (0.92–1.67x) |
Calcolato dai benchmark di inferenza di Ultralytics Platform. Lo speedup è la latenza di ONNX FP16 ÷ la latenza di TensorRT FP16, oppure la latenza di TensorRT FP16 ÷ la latenza di TensorRT INT8, sulla stessa GPU: i valori superiori a 1x indicano quindi che TensorRT FP16 (o INT8) è più veloce. Le mediane si basano sulle 19 GPU NVIDIA con risultati in tutti e quattro i formati; gli intervalli indicano i rapporti minimo e massimo tra queste GPU. L'accuratezza è il valore mAP50-95 riportato per ciascun formato e precisione. ONNX FP16 indica i risultati ONNX Runtime pubblicati, il cui execution provider non è specificato.
Latenza su quattro GPU comuni, in millisecondi per immagine, come pubblicato nella pagina dei benchmark:
| GPU | Modello | PyTorch FP16 | ONNX FP16 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| L4 | YOLO26n | 4.98 | 2.04 | 1.03 | 1.09 |
| L4 | YOLO26x | 7.76 | 9.80 | 5.73 | 3.43 |
| RTX 4090 | YOLO26n | 6.67 | 2.56 | 0.84 | 1.00 |
| RTX 4090 | YOLO26x | 10.94 | 5.20 | 2.68 | 2.25 |
| A100 SXM | YOLO26n | 8.72 | 3.98 | 1.65 | 1.79 |
| A100 SXM | YOLO26x | 15.02 | 7.25 | 3.86 | 3.91 |
| H100 SXM | YOLO26n | 6.36 | 3.09 | 1.17 | 1.48 |
| H100 SXM | YOLO26x | 10.26 | 5.53 | 2.66 | 2.62 |
Emergono tre aspetti:
- TensorRT FP16 ha superato i risultati ONNX FP16 pubblicati su ogni GPU e per ogni dimensione del modello, con un'accuratezza entro 0.001 mAP50-95. Se distribuisci su queste GPU NVIDIA e hai bisogno di una latenza bassa, inizia con TensorRT FP16.
- INT8 non è automaticamente la scelta migliore. Su YOLO26n è risultato più lento di TensorRT FP16 su 17 delle 19 GPU e ha comportato una perdita di 0.04 mAP50-95. Sui modelli più grandi è stato utile più spesso, fino a 1.67x su YOLO26x con L4, ma ha comportato una perdita da 0.034 a 0.076 mAP50-95.
- Non ci sono risultati ONNX per le sette GPU Blackwell. La pagina dei benchmark attribuisce questa mancanza all'assenza di kernel Blackwell di ONNX Runtime nell'ambiente di test. TensorRT è stato eseguito su tutte e sette.
Questi risultati riguardano la configurazione descritta nella pagina dei benchmark, con batch 1 a 640 pixel: prima di scegliere, esegui un benchmark del tuo modello sul dispositivo di destinazione e con i tuoi dati.
FP16 vs INT8 con TensorRT#
La precisione inferiore è l'altra leva importante e il benchmark mostra perché è necessario fare dei test:
- FP16 (precisione dimezzata) dimezza le dimensioni dei pesi e delle attivazioni rispetto a FP32. Nei benchmark di Ultralytics Platform, TensorRT FP16 ha raggiunto un'accuratezza entro 0.003 mAP50-95 rispetto a ONNX FP16 e PyTorch FP16.
- INT8 memorizza pesi e attivazioni come interi a 8 bit, una forma di quantizzazione del modello. Richiede la calibrazione: si esegue il modello su un insieme rappresentativo di immagini per misurare gli intervalli delle attivazioni. Il benchmark di Ultralytics Platform ha usato NVIDIA ModelOpt con COCO128 come dati di calibrazione.
Come indicato nella metodologia del benchmark, INT8 è più vantaggioso sui modelli più grandi e limitati dalla capacità di calcolo. Sui modelli più piccoli, il lavoro aggiuntivo di quantizzazione può pareggiare le prestazioni di FP16 o persino rallentarle. Calibra il modello con immagini del tuo dominio, quindi convalida l'accuratezza sui tuoi dati prima di distribuire un motore INT8.
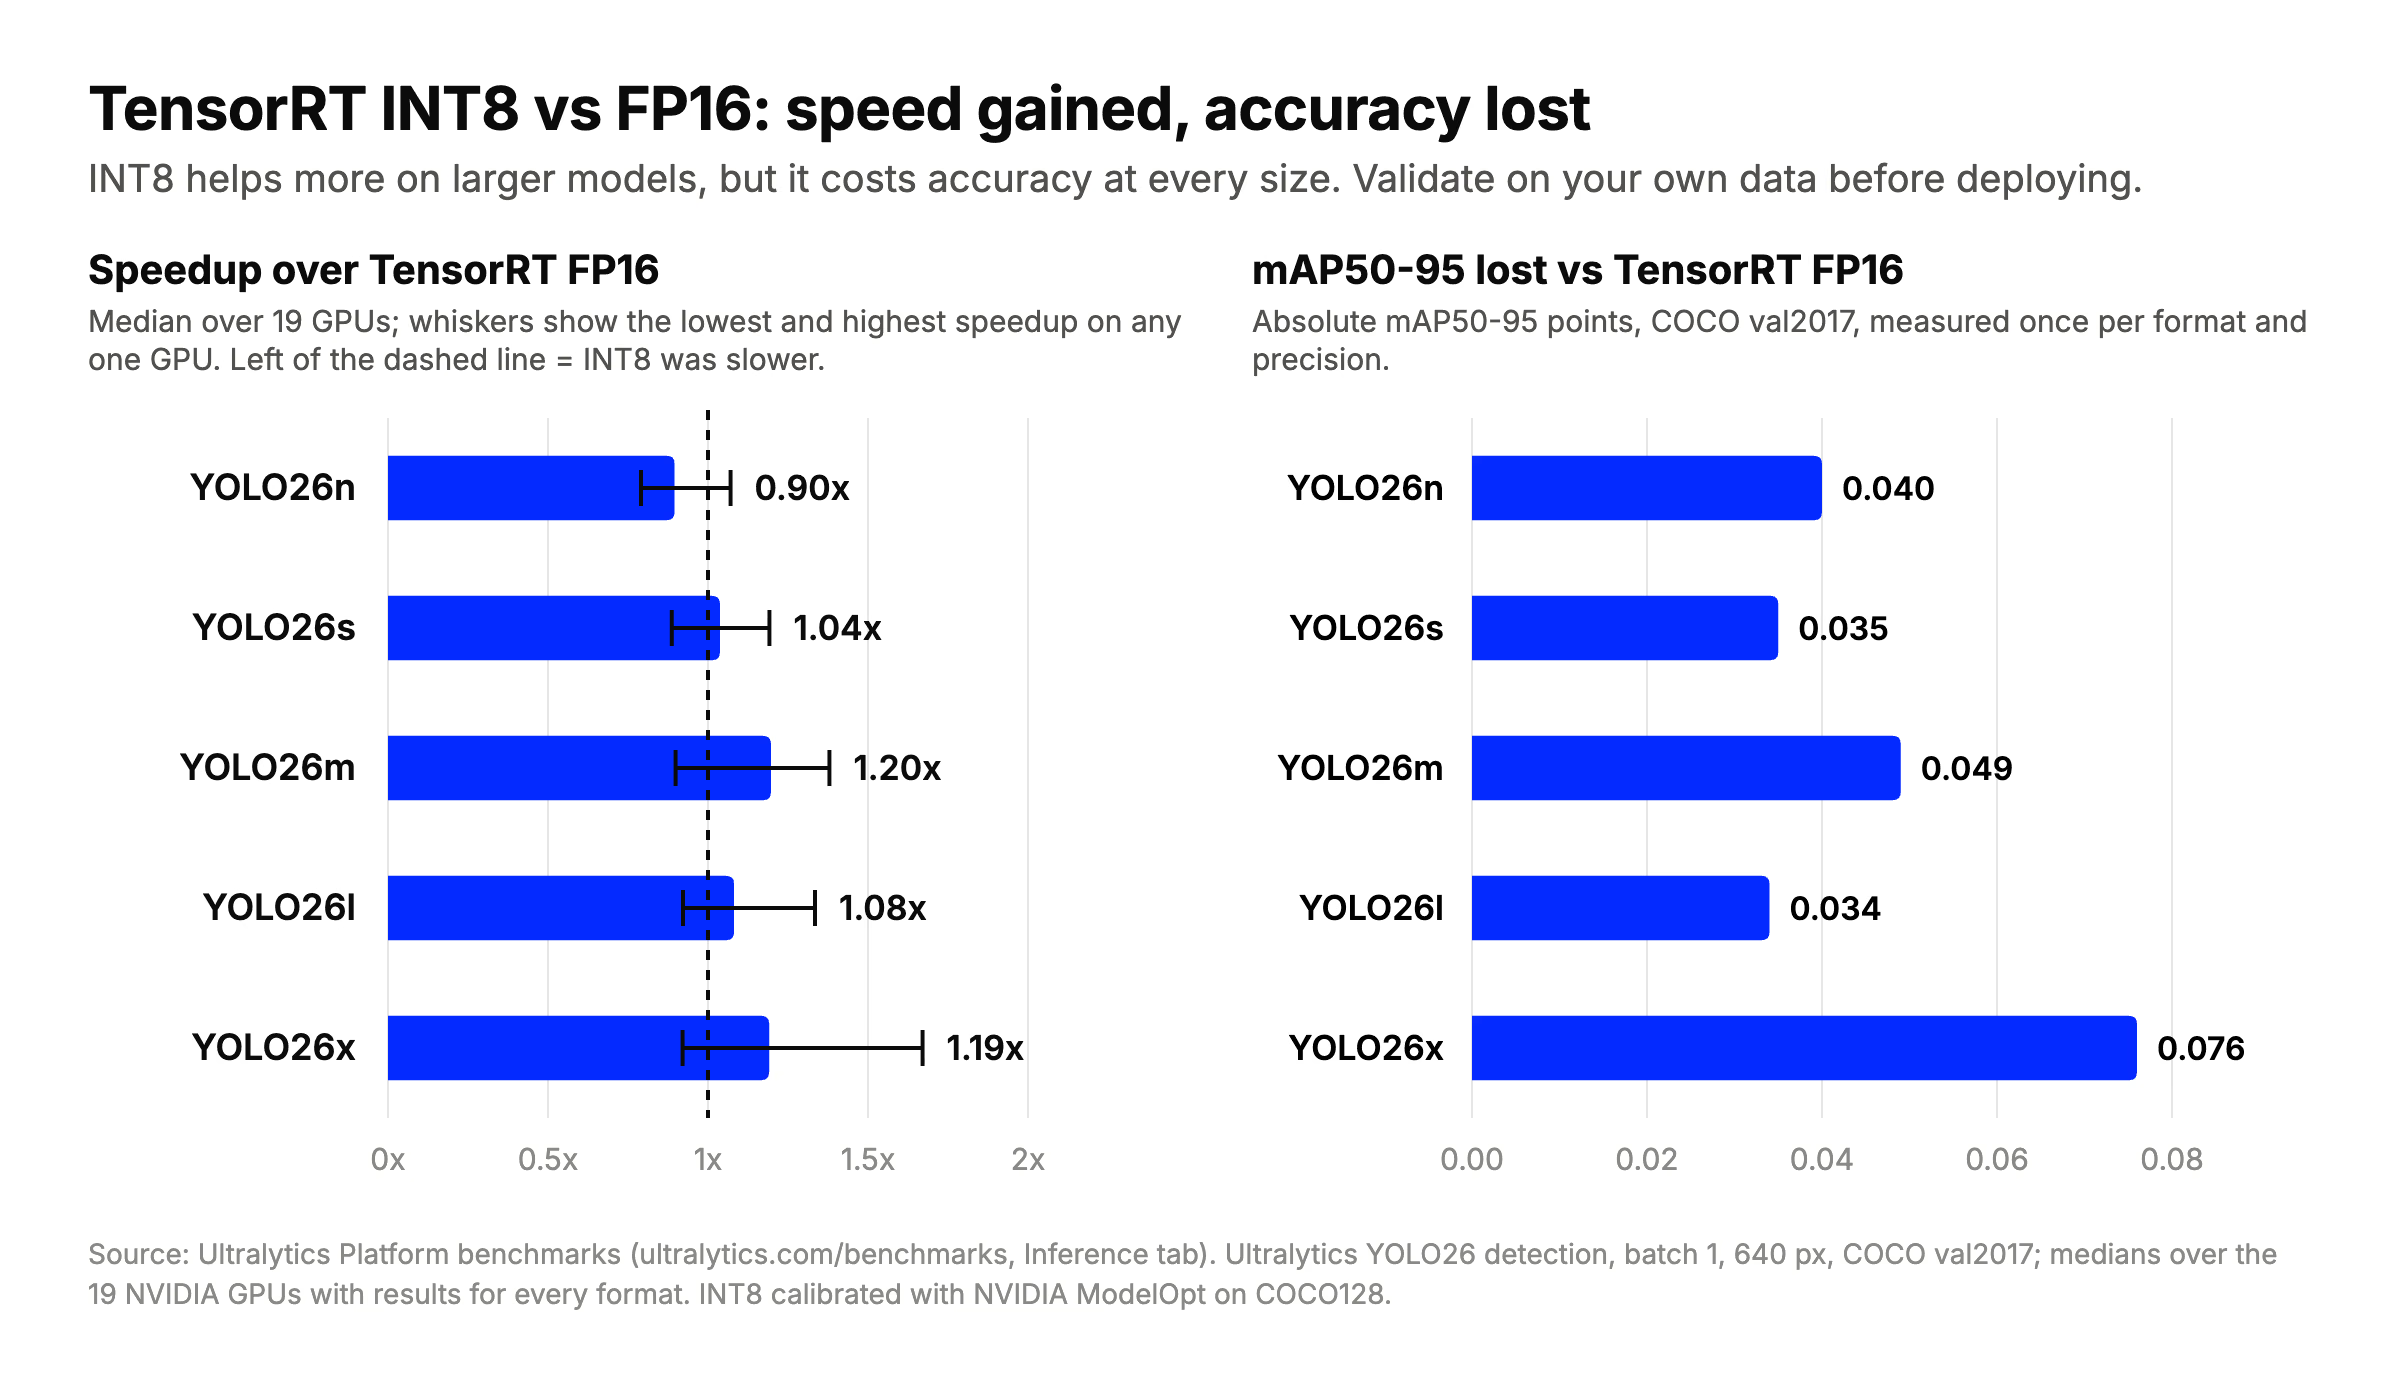
Come valore mediano, INT8 è risultato più lento di FP16 su YOLO26n e fino a circa 1.2x più veloce sui modelli più grandi sulle 19 GPU, con una perdita da 0.034 a 0.076 mAP50-95 per ogni dimensione. Calcolato dai benchmark di inferenza di Ultralytics Platform.
Portabilità del motore e dimensioni di input dinamiche#
Per impostazione predefinita, un motore TensorRT è vincolato alla GPU su cui viene compilato e alla versione di TensorRT usata per compilarlo: quindi, un motore compilato su RTX 4090 non è destinato a essere copiato su H100 o Jetson. TensorRT offre opzioni di compatibilità hardware e tra versioni che attenuano questo vincolo, ma la scelta più sicura è compilare sul dispositivo di destinazione, o per quel dispositivo, e ricompilare dopo un aggiornamento di TensorRT. Per questo, nella scheda Export di Ultralytics Platform devi scegliere un tipo di GPU per le esportazioni TensorRT. Un file ONNX non ha questo vincolo: lo stesso file funziona ovunque siano disponibili ONNX Runtime e un execution provider adeguato.
Entrambi i formati supportano dimensioni di input variabili. Per TensorRT, le forme dinamiche richiedono un profilo di ottimizzazione che definisca le dimensioni minime, ottimali e massime dell'input, e gli input al momento dell'esecuzione devono rientrare in questo intervallo. Quando esporti modelli Ultralytics YOLO, dynamic=True abilita le forme di input dinamiche per ONNX e TensorRT. Le forme fisse offrono a TensorRT più margine di ottimizzazione, come spiega la guida di NVIDIA alle forme dinamiche: usa quindi forme dinamiche quando gli input variano davvero e confronta le prestazioni di entrambe le opzioni.
Quando scegliere ONNX Runtime e quando TensorRT#
- GPU NVIDIA nel cloud o on-premise, latenza importante: TensorRT, iniziando da FP16. Prova INT8 sui modelli più grandi dopo averlo calibrato e convalidato.
- NVIDIA Jetson all'edge: TensorRT. Consulta la guida NVIDIA Jetson.
- CPU, hardware non NVIDIA o flotte miste: ONNX con ONNX Runtime, usando l'execution provider supportato da ciascuna macchina.
- Non conosci ancora l'hardware di distribuzione: esporta prima in ONNX. In seguito puoi creare un motore TensorRT dallo stesso modello.
- CPU, GPU o NPU Intel: valuta OpenVINO, il toolkit di inferenza di Intel.
Per l'elenco completo dei formati e un confronto, consulta la guida alle opzioni di distribuzione dei modelli. La precisione non è l'unica leva: contano anche le dimensioni del modello e la risoluzione di input; la nostra guida al pruning e alla quantizzazione illustra altri due modi per ridurre le dimensioni di un modello.
Esportazione di Ultralytics YOLO in ONNX e TensorRT#
Ultralytics YOLO esporta in entrambi i formati con un solo argomento format; puoi eseguire direttamente la predizione o la validazione sul modello esportato:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="onnx", quantize=16)  # ONNX FP16, per ONNX Runtime
model.export(format="engine", quantize=16)  # Motore TensorRT FP16, compilato su questa GPU
# Per usare INT8, calibra invece il modello con un file YAML del dataset (coco8.yaml è un piccolo set dimostrativo; usa il tuo):
# model.export(format="engine", quantize=8, data="coco8.yaml")

trt_model = YOLO("yolo26n.engine")
results = trt_model("https://ultralytics.com/images/bus.jpg")
quantize=16 seleziona FP16 e quantize=8 seleziona INT8. Entrambe le esportazioni del motore generano yolo26n.engine, quindi esegui l'una o l'altra. Per INT8, imposta data sul file YAML del tuo dataset, così la calibrazione usa immagini simili a quelle su cui distribuirai il modello. Consulta gli argomenti di esportazione e le guide di integrazione ONNX e TensorRT per tutte le opzioni, oppure segui i nostri post passo passo sull'esportazione in ONNX e sull'ottimizzazione con TensorRT. Puoi anche esportare i modelli addestrati dal browser su Ultralytics Platform.
Domande frequenti
ONNX è un formato di modello, non un motore, quindi il confronto corretto è ONNX Runtime vs TensorRT. Nei benchmark di Ultralytics Platform di Ultralytics YOLO26 su 19 GPU NVIDIA, TensorRT FP16 è risultato più veloce dei risultati ONNX FP16 pubblicati con ONNX Runtime su ogni GPU, con speedup mediani calcolati tra 1.85x e 2.55x a seconda delle dimensioni del modello e differenze di mAP50-95 non superiori a 0.001. Il benchmark non specifica quale execution provider di ONNX Runtime abbia prodotto i risultati ONNX, e nessuno di essi è indicato come risultato ottenuto con il suo execution provider TensorRT; prova quindi tu stesso questa combinazione se ti serve l'API di ONNX Runtime.
Sì. ONNX è il consueto input di TensorRT: il parser ONNX legge il modello e ne crea un motore. ONNX Runtime può anche richiamare TensorRT tramite il proprio execution provider TensorRT.
No. Nei benchmark di Ultralytics Platform, TensorRT INT8 è risultato più lento di TensorRT FP16 per YOLO26n su 17 delle 19 GPU. Sui modelli più grandi è risultato più veloce più spesso, con una mediana di circa 1.2x su YOLO26m e YOLO26x tra le 19 GPU su cui sono stati eseguiti tutti i formati. Ogni volta ha comportato una perdita da 0.034 a 0.076 mAP50-95, quindi convalida prima il modello INT8 sui tuoi dati.
Non farci affidamento. Per impostazione predefinita, un motore TensorRT è vincolato alla GPU e alla versione di TensorRT con cui è stato compilato: compilalo quindi sul dispositivo di destinazione, o per quel dispositivo. Conserva il file ONNX come copia portatile e ricompila il motore per ogni dispositivo di destinazione.
Di solito si sceglie TensorRT: NVIDIA JetPack include TensorRT e compilare il motore direttamente su Jetson lo ottimizza per quel dispositivo. I benchmark qui sopra non includono Jetson, quindi misura le prestazioni sul tuo modulo prima di decidere. La guida NVIDIA Jetson illustra la configurazione e l'esportazione per Ultralytics YOLO.
Scritto da
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









