Qwen4-Max per l'annotazione automatica: dataset di spicco, miglioramenti disomogenei
Qwen4-Max si classifica al 13º posto su 51 nel nostro benchmark di annotazione automatica, al primo posto nelle radiografie dei polsi e al secondo sugli scaffali dei negozi. Accuratezza, costi e come usarlo.
 Miles Deans13 min di lettura
Alibaba ha rilasciato Qwen4-Max il 16 novembre 2026, definendolo il modello più capace della famiglia Qwen fino a oggi, con visione nativa e una finestra di contesto da un milione di token. Lo stesso giorno lo abbiamo sottoposto a UL37, il nostro benchmark di rilevamento su 36 dataset.
Nel complesso, Qwen4-Max si classifica al 13º posto su 51 modelli nella nostra classifica VLM, con 0.474 mAP50 al costo di $5.68 per 1.000 immagini. Questa media nasconde un risultato più notevole. Nelle radiografie pediatriche dei polsi ottiene il punteggio più alto tra tutti i modelli che abbiamo testato ed è secondo solo a Gemini 4 Carbon nelle scene subacquee e sugli scaffali dei negozi molto affollati.
Qwen4-Max è ora l'opzione Alibaba per l'annotazione automatica in Ultralytics Platform e sostituisce Qwen3.8-Max. Di seguito vediamo dove si distingue, dove è carente, come si confronta con i modelli che prenderesti in considerazione e quanto costa un lotto di annotazioni.
Qwen4-Max si classifica al 13º posto su 51 in UL37 e al primo posto nelle radiografie dei polsi#
UL37 misura quanto le bounding box di un modello corrispondono alle etichette umane su 360 immagini: 10 per ciascuno dei 36 dataset reali di rilevamento di oggetti, dalle scansioni mediche e immagini aeree agli scaffali dei negozi, allo sport e ai circuiti stampati. Ogni dataset pesa allo stesso modo nella media e tutte le immagini passano attraverso la stessa pipeline di produzione disponibile agli utenti di Platform, con i nomi delle classi specifici del dataset e SAM 3.1 che perfeziona ogni box; i punteggi descrivono quindi la pipeline perfezionata, non l'output grezzo del modello. La metodologia è pubblica.
| Qwen4-Max | Qwen3.8-Max | GPT-6.1 Terra | Gemini 3.8 Flash | Kimi K3.1 Pro | |
|---|---|---|---|---|---|
| Posizione in classifica | #13 su 51 | #15 su 51 | #3 su 51 | #11 su 51 | #16 su 51 |
| mAP50 | 0.474 | 0.461 | 0.560 | 0.516 | 0.444 |
| mAP50-95 | 0.301 | 0.295 | 0.345 | 0.321 | 0.281 |
| Precisione | 0.595 | 0.572 | 0.646 | 0.656 | 0.560 |
| Richiamo | 0.561 | 0.524 | 0.613 | 0.555 | 0.483 |
| Costo del provider per 1.000 immagini | $5.68 | $7.74 | $4.36 | $5.86 | $22.50 |
| Tempo mediano per immagine | 12.4 s | 13.1 s | 5.1 s | 7.4 s | 22.2 s |
| Richieste non riuscite | 0% | 1.7% | 0% | 0% | 6.4% |
Risultati UL37 dalla classifica VLM di Ultralytics, aggiornata al 19 novembre 2026. Qwen3.8-Max non è più disponibile su Platform.
Qwen4-Max migliora rispetto a Qwen3.8-Max in tutte le metriche principali, costa meno per immagine e ha completato tutte le richieste del benchmark. Tuttavia, in media è ancora molto indietro rispetto ai leader: GPT-6.1 Terra ottiene 0.560 a un costo inferiore e in meno della metà del tempo.
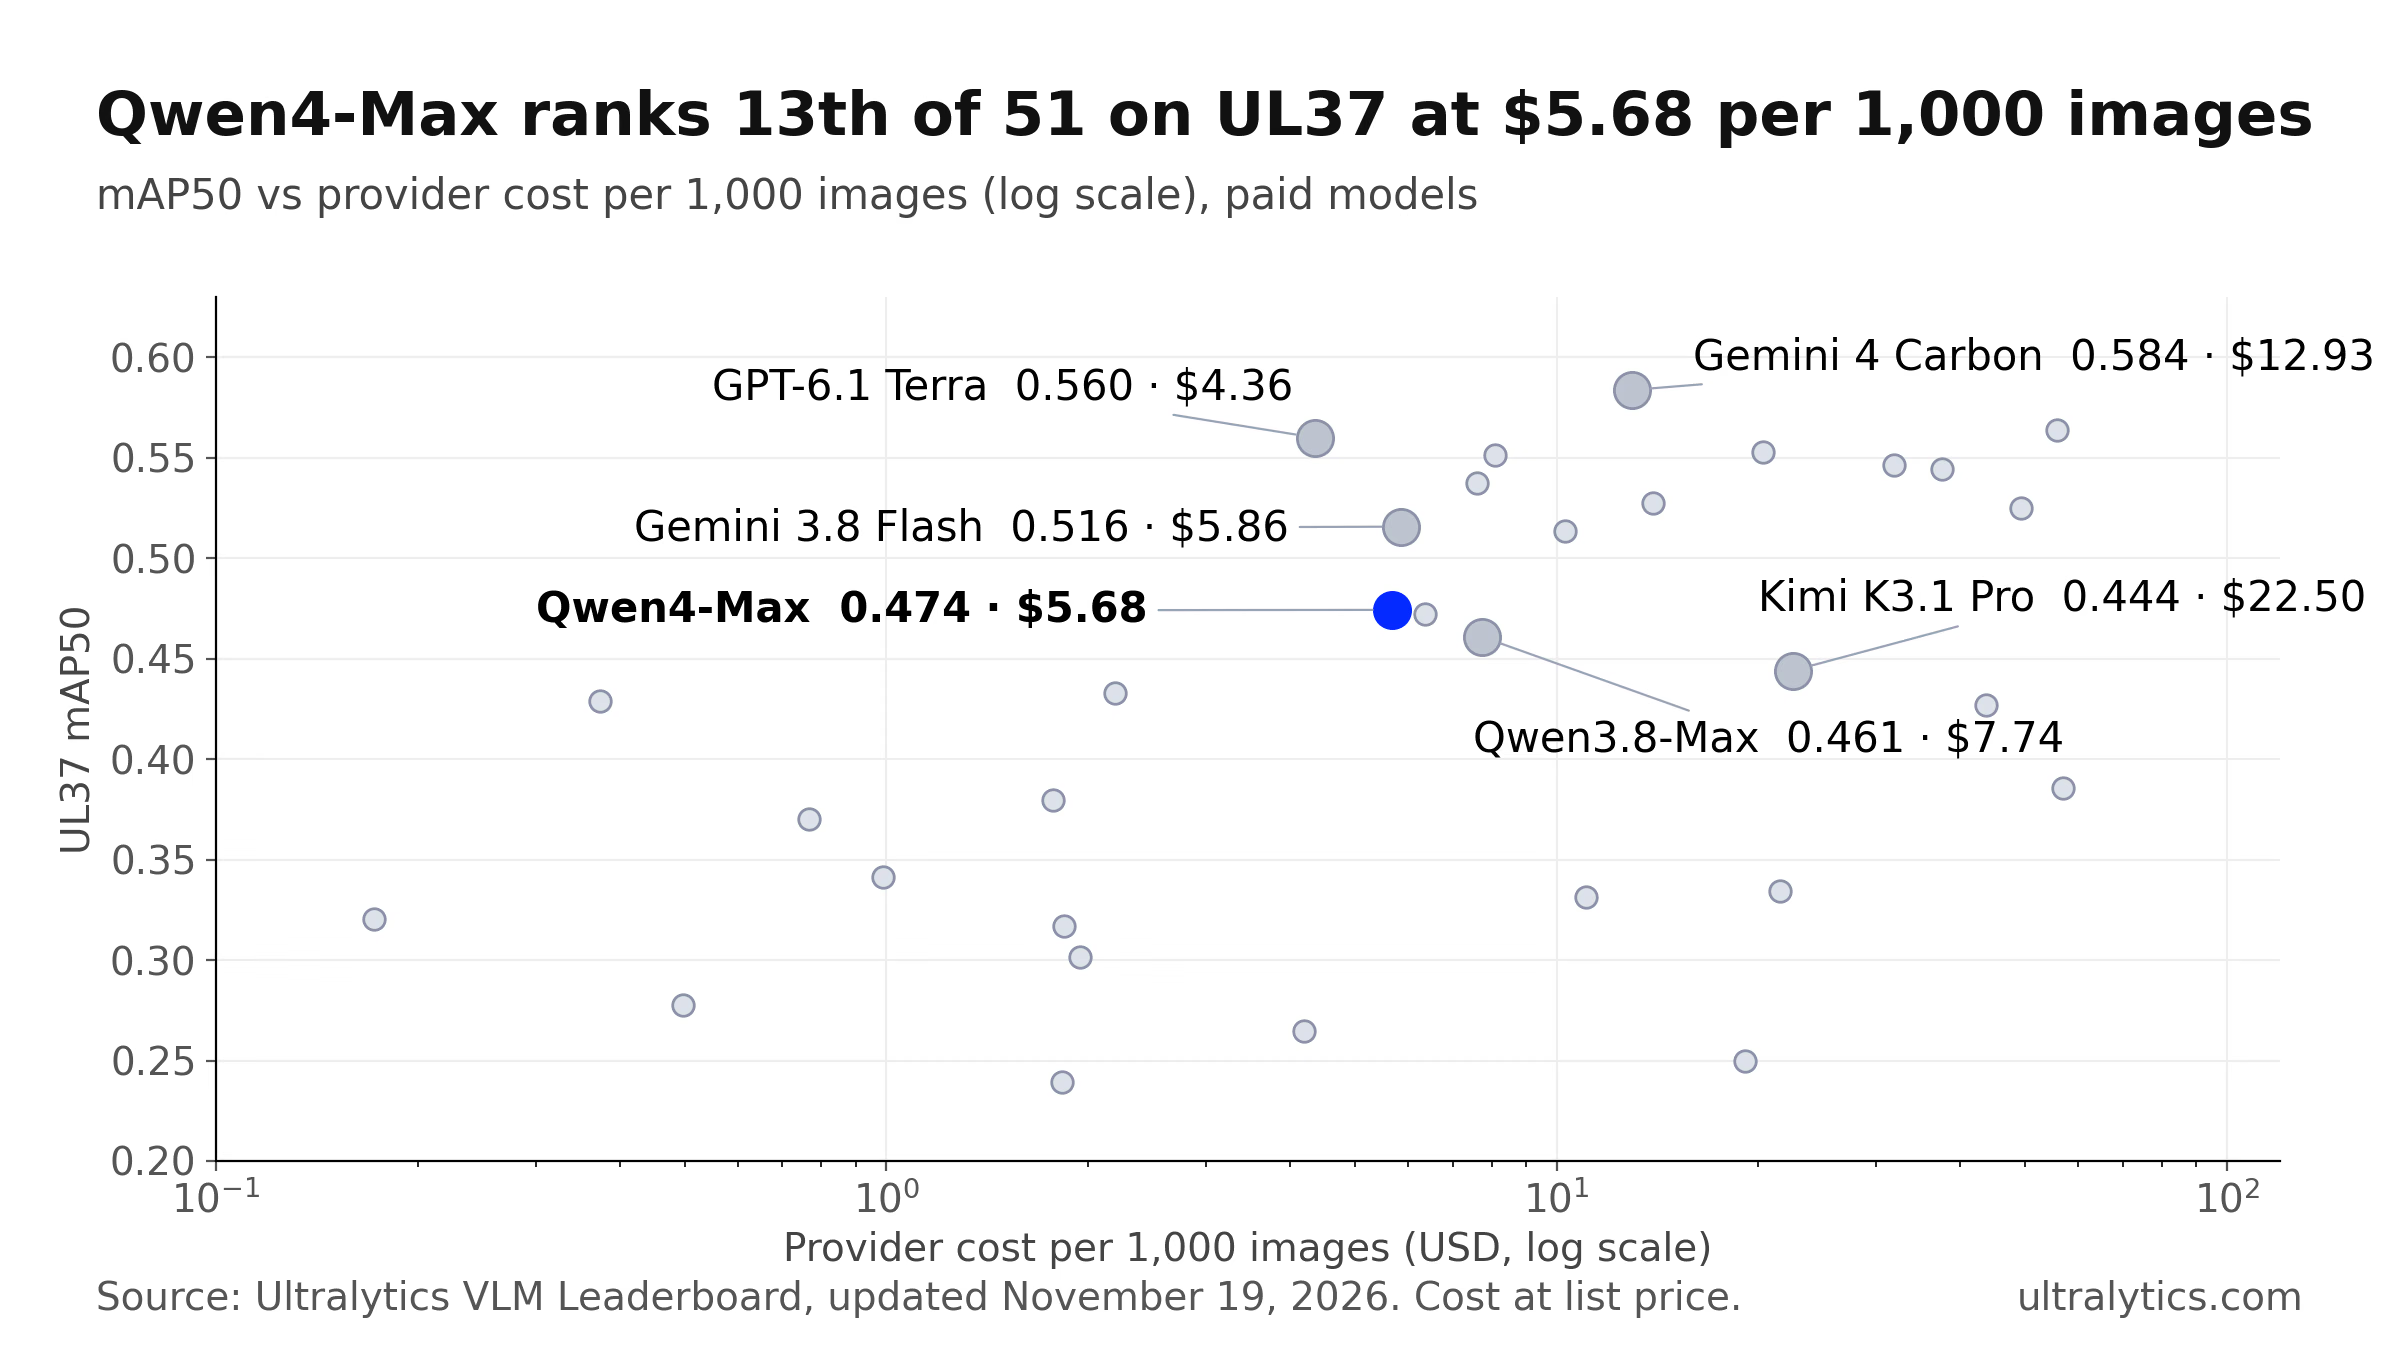
Ogni punto rappresenta un modello a pagamento nella classifica VLM di Ultralytics.
Per cosa Alibaba ha creato Qwen4-Max#
Nel suo annuncio di lancio, Alibaba descrive Qwen4-Max come un modello Mixture-of-Experts sparso con 2.4 trilioni di parametri totali, di cui 71 miliardi attivi per token, e con visione nativa. Sottolinea le capacità di programmazione, i compiti agentici e il ragionamento visivo e riferisce che, nel suo benchmark Work360, Qwen4-Max supera Qwen3.8-Max riducendo al contempo il costo medio per attività di circa il 60%.
Le note di rilascio di Alibaba Cloud Model Studio lo definiscono "il modello multimodale di punta di nuova generazione della famiglia Qwen, che combina generazione di testo, comprensione di immagini e video e ragionamento approfondito". Il prezzo internazionale è di $1.50 per milione di token in input e $4.50 per milione di token in output, in calo rispetto a $2 e $6 per Qwen3.8-Max. Il modello è disponibile tramite l'API di Alibaba; Alibaba afferma che seguiranno modelli Qwen4 open-weight più piccoli.
Né l'annuncio né le note di rilascio riportano risultati di rilevamento di oggetti, quindi è ciò che abbiamo misurato.
Qwen4-Max e Qwen3.8-Max a confronto: costa meno, ma i miglioramenti sono disomogenei#
Qwen4-Max supera il suo predecessore in 19 dataset, è inferiore in 16 e pareggia in uno. Il miglioramento medio di 0.013 mAP50 deriva da grandi progressi in alcuni dataset che compensano cali evidenti in altri.
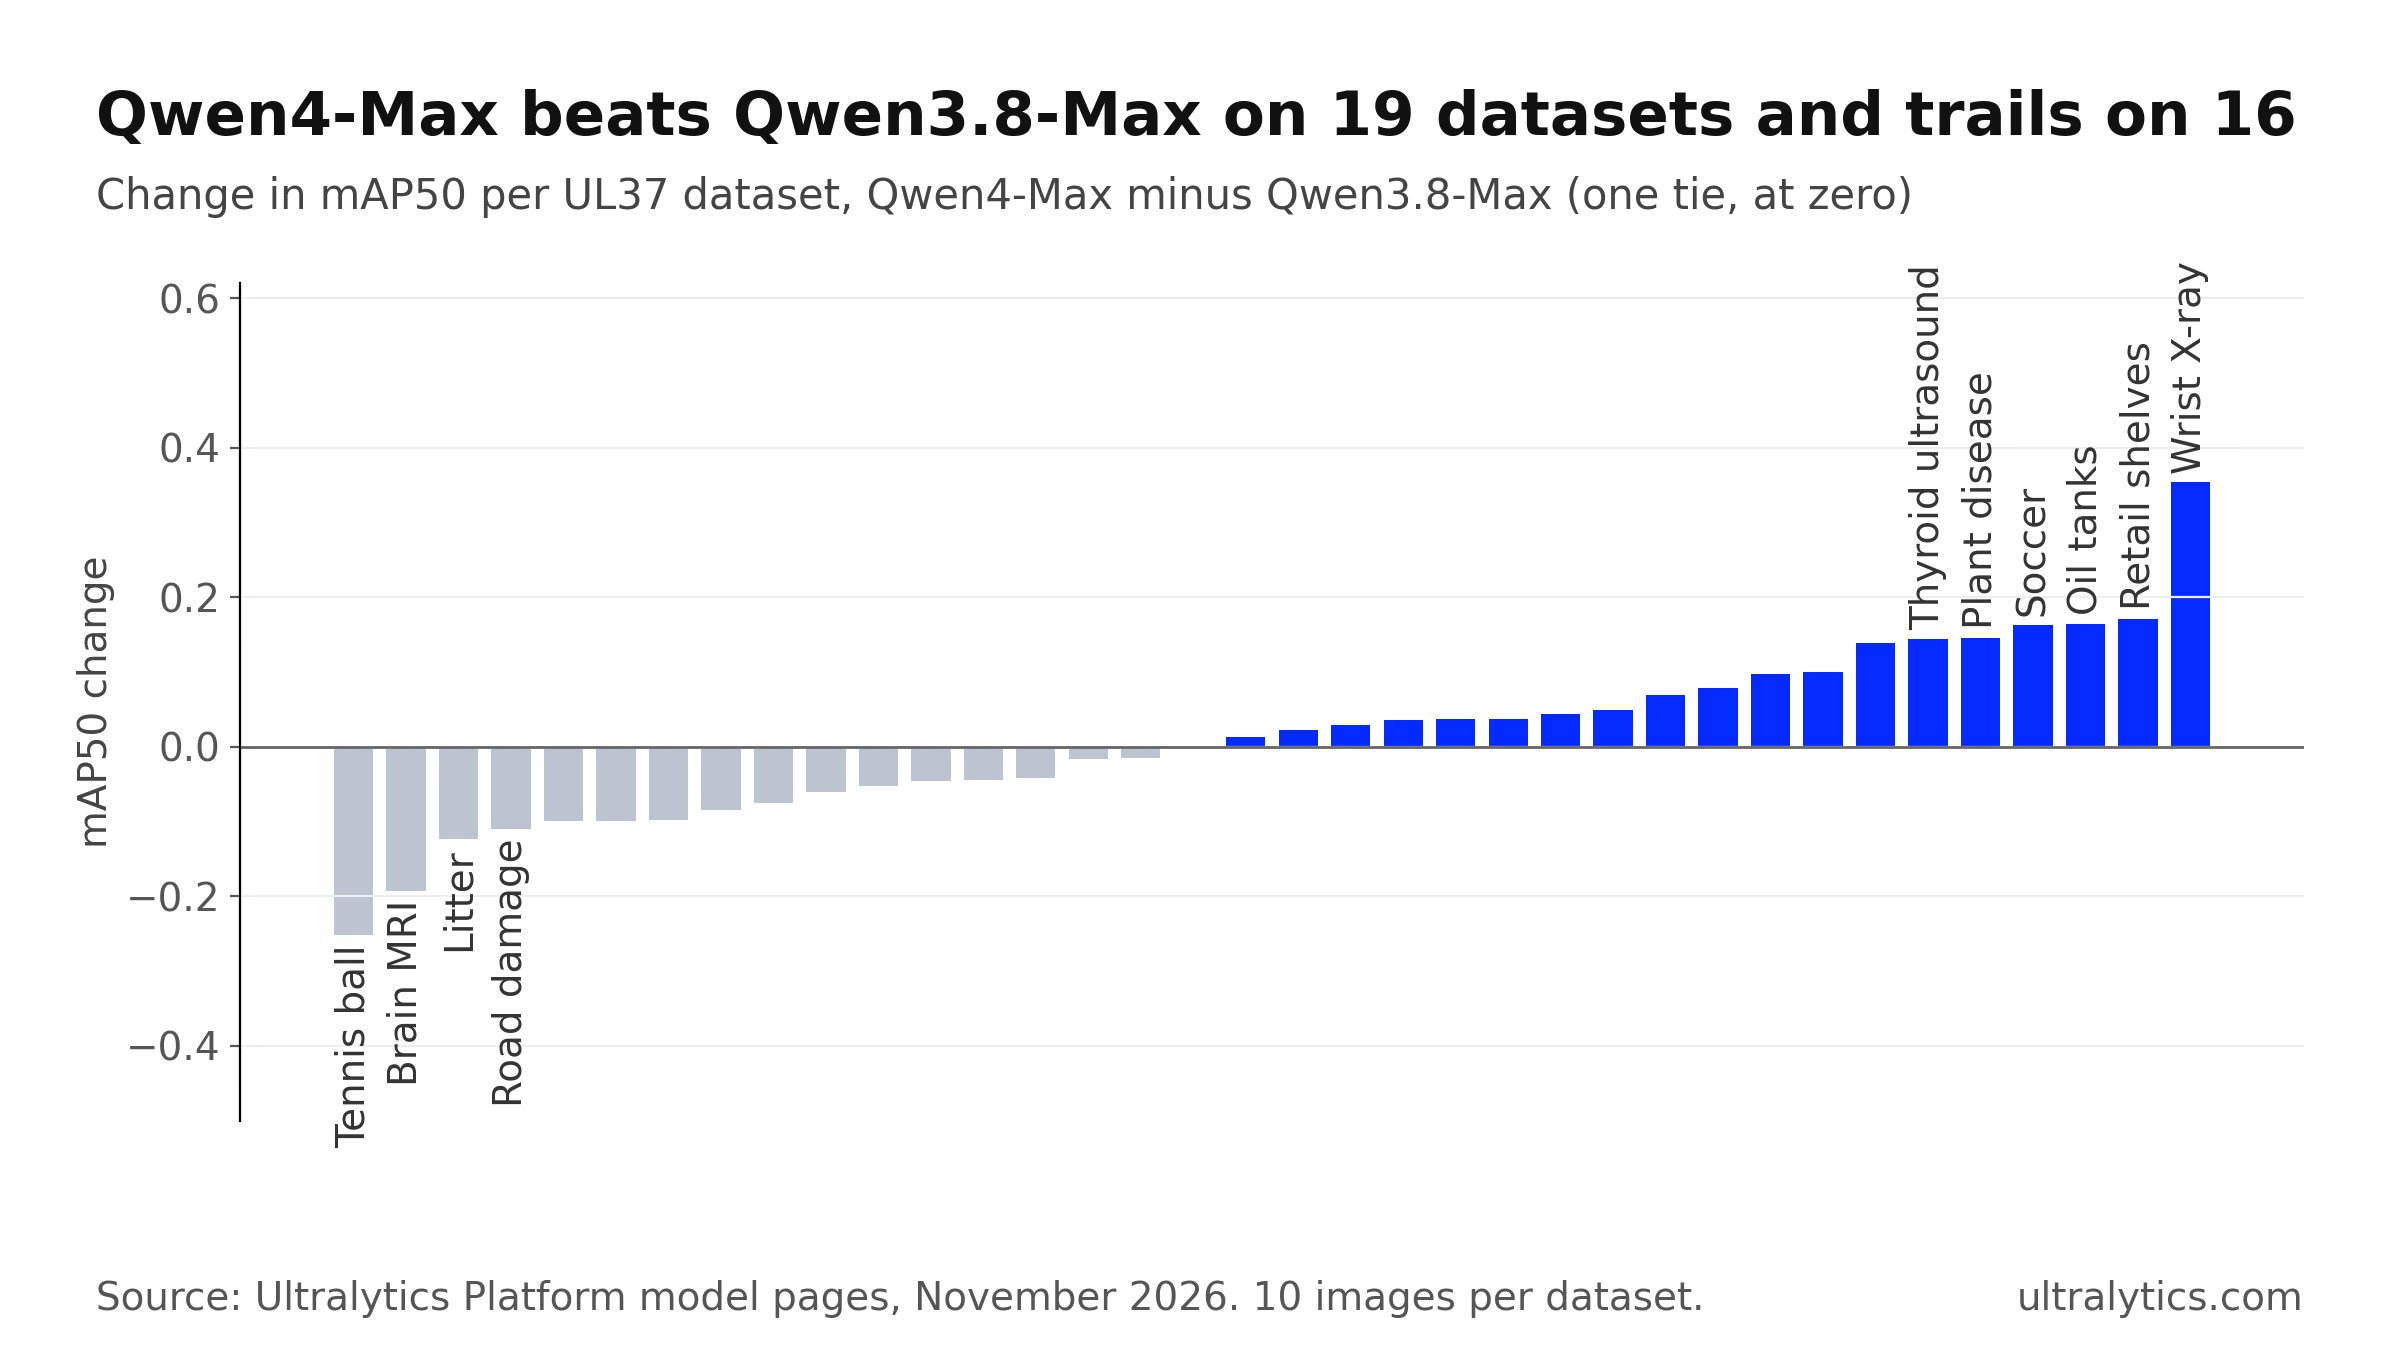
Ogni barra rappresenta un dataset UL37, ordinato dal calo maggiore al miglioramento maggiore.
| Dataset | Qwen4-Max | Qwen3.8-Max | Variazione |
|---|---|---|---|
| GRAZPEDWRI-DX radiografie pediatriche dei polsi | 0.4975 | 0.1437 | +0.3538 |
| SKU110K scaffali di negozi molto affollati | 0.6230 | 0.4516 | +0.1714 |
| Airbus serbatoi di stoccaggio del petrolio | 0.3005 | 0.1363 | +0.1642 |
| SoccerDB calcio | 0.8345 | 0.6715 | +0.1630 |
| RacketVision pallina da tennis | 0.3775 | 0.6299 | −0.2524 |
| Cheng risonanza magnetica per tumore cerebrale | 0.4421 | 0.6350 | −0.1929 |
mAP50 UL37 per dataset, 10 immagini ciascuno, mostrato con quattro decimali così che ogni variazione corrisponda ai due punteggi.
La riduzione dei costi è più evidente. A $5.68 per 1.000 immagini contro $7.74, nella nostra esecuzione Qwen4-Max costa circa il 27% in meno per immagine. La cifra di circa il 60% indicata da Alibaba deriva da un benchmark diverso e da impostazioni diverse, quindi i due valori non sono direttamente confrontabili.
Dove Qwen4-Max si distingue#
Tre risultati collocano Qwen4-Max ai vertici dell'intera classifica, non solo della famiglia Qwen.
| Dataset | Qwen4-Max | Posizione su 51 | Leader |
|---|---|---|---|
| Radiografie pediatriche dei polsi GRAZPEDWRI-DX | 0.4975 | 1st | Qwen4-Max (prossimo: Muse Ember 1.0, 0.378) |
| RUOD oggetti subacquei | 0.774 | 2nd | Gemini 4 Carbon, 0.788 |
| SKU110K scaffali di negozi molto affollati | 0.623 | 2nd | Gemini 4 Carbon, 0.671 |
mAP50 UL37 per dataset. Posizione tra tutti i 51 modelli nella classifica VLM di Ultralytics.
Radiografie dei polsi. Nelle radiografie pediatriche dei polsi dopo un trauma, Qwen4-Max ottiene 0.4975, superando tutti gli altri modelli che abbiamo testato e più che triplicando il risultato di Qwen3.8-Max. Ogni dataset include 10 immagini, quindi considera questo dato un forte segnale per fare una prova, non una conclusione. Non si tratta inoltre di diagnosi o validazione clinica: per l'annotazione di ricerca nell'analisi di immagini mediche, Qwen4-Max può generare bozze di box che gli esperti clinici possono controllare e correggere.
Scaffali dei negozi. Calcolando la media sui due dataset retail di UL37, Qwen4-Max ottiene 0.752, superando lo 0.724 di GPT-6.1 Terra. Su SKU110K, dove gli scaffali sono stipati di prodotti fino ai bordi e raggruppati in un'unica classe, è secondo solo a Gemini 4 Carbon.
Scene subacquee. Sugli oggetti subacquei di RUOD, il suo 0.774 è il secondo punteggio su 51, superiore allo 0.658 di GPT-6.1 Terra.
Dove Qwen4-Max è carente#
I limiti sono evidenti quanto i punti di forza. Qwen4-Max ottiene 0.000 sui difetti di schede nude in DeepPCB e 0.05 sulle scansioni di sicurezza in IEDXray, dove i modelli Gemini 4 raggiungono circa 0.30. Il punteggio nelle radiografie toraciche per la tubercolosi è 0.037 e, nel dataset di risonanze magnetiche per tumori cerebrali, resta indietro rispetto a GPT-6.1 Terra: 0.442 contro 0.904.
Anche calcolando la media per dominio, è inferiore a GPT-6.1 Terra nei documenti, nelle interfacce utente e nei disegni CAD (0.357 contro 0.494), nelle strade e nel traffico (0.396 contro 0.572) e nell'imaging medico nel complesso (0.325 contro 0.505). Prima di etichettare un dataset di grandi dimensioni in uno di questi ambiti, apri la pagina del modello Qwen4-Max, che mostra le sue box registrate su ogni dataset del benchmark accanto alle etichette attese.
Qwen4-Max a confronto con GPT-6.1 Terra, Gemini 3.8 Flash e Kimi K3.1 Pro#
| Confronto diretto su 36 dataset UL37 | Vittorie di Qwen4-Max | Sconfitte | Pareggi |
|---|---|---|---|
| contro GPT-6.1 Terra | 11 | 23 | 2 |
| contro Gemini 3.8 Flash | 17 | 18 | 1 |
| contro Kimi K3.1 Pro | 21 | 14 | 1 |
| contro Qwen3.8-Max | 19 | 16 | 1 |
GPT-6.1 Terra è la scelta generale più valida: vince su 23 dataset contro gli 11 di Qwen4-Max, costa meno e ha un tempo di risposta mediano inferiore alla metà. Gemini 3.8 Flash è quasi alla pari sui dataset a un prezzo simile, ma ottiene un punteggio medio più alto. Contro Kimi K3.1 Pro, Qwen4-Max vince su 21 dataset contro 14, a circa un quarto del costo per immagine.
Come Ultralytics Platform esegue Qwen4-Max#
Due impostazioni influenzano i risultati di Qwen4-Max su Platform. Primo, viene eseguito con il livello di ragionamento "low" di Alibaba anziché con l'impostazione predefinita "high". Nei test di Ultralytics sulle 370 immagini del benchmark (le 360 immagini valutate più 10 immagini di riferimento COCO), l'impostazione predefinita non ha rispettato il limite di 115 secondi per richiesta su 11 immagini, mentre "low" non l'ha rispettato su 3, con lo stesso mAP50. Secondo, Platform richiede ai modelli Qwen un output JSON compatto, perché senza di esso perdono circa 0.02 mAP50.
Non devi intervenire su nessuna delle due impostazioni: seleziona Qwen4-Max nel selettore dei modelli e Platform applicherà entrambe.
Quanto costa un lotto di annotazioni con Qwen4-Max#
Il costo del provider è calcolato sul consumo di token dichiarato da Alibaba, applicando le tariffe di Platform per il modello, per 1.000 immagini annotate correttamente; le tue immagini potrebbero richiedere più o meno token. Batch Annotation aggiunge una tariffa di elaborazione di Platform di $1.00 ogni 1.000 immagini, con un minimo di $0.01 per esecuzione.
| Per 1.000 immagini | Qwen4-Max |
|---|---|
| Costi addebitati da Alibaba | $5.68 |
| Elaborazione di Ultralytics Platform | $1.00 |
| Totale | $6.68 |
Paghi direttamente Alibaba tramite la tua chiave API personale, anche per le predizioni di prova che esegui in precedenza, e Ultralytics non applica alcun ricarico sui token. Se preferisci non usare affatto una chiave a pagamento, il modello ospitato Qwen3.8 27B è disponibile su Platform senza chiave e ottiene 0.351 mAP50 su UL37.
Come eseguire l'annotazione automatica con Qwen4-Max in Ultralytics Platform#
Qwen4-Max è un modello guidato da prompt di classe per dataset di rilevamento con da 1 a 200 classi. Restituisce le bounding box per i nomi delle classi del tuo dataset, che potrai poi controllare e correggere.
- Crea una chiave API in Model Studio di Alibaba Cloud per la regione internazionale (Singapore), che corrisponde all'endpoint usato da Platform.
- Chiedi al proprietario del workspace di aggiungere la chiave nella sezione Alibaba in Impostazioni > Chiavi API del workspace che contiene il tuo dataset. La documentazione sulle chiavi del provider spiega i dettagli.
- Nell'editor di annotazione, passa alla modalità Smart e seleziona Qwen4-Max sotto Alibaba nel selettore dei modelli.
- Premi Predici oppure
Psu alcune immagini rappresentative dei tuoi dati. - Quando sei soddisfatto, apri la pagina del dataset e scegli Altre azioni > Annotazione batch per etichettare tutte le immagini non etichettate. Batch Annotation funziona con i dataset ospitati su Platform con un massimo di tre canali immagine; prima, Platform salva una versione del dataset, così puoi ripristinarla.
- Controlla i riquadri, salvali e addestra un modello Ultralytics YOLO26 sul risultato nello stesso spazio di lavoro.
La documentazione sull'annotazione illustra nel dettaglio la modalità Smart e Batch Annotation, mentre la nostra guida a come scegliere un VLM in base a precisione e richiamo ti aiuta ad abbinare un modello al tuo flusso di revisione.
Chi dovrebbe usare Qwen4-Max#
| Se ti serve… | Inizia con |
|---|---|
| Un annotatore a pagamento per uso generale | GPT-6.1 Terra: punteggio UL37 più alto, costo inferiore e velocità maggiore di Qwen4-Max |
| Bozze di radiografie pediatriche dei polsi da sottoporre alla revisione di esperti | Qwen4-Max: il punteggio UL37 più alto tra i 51 modelli su questo dataset |
| Scaffali di negozi molto affollati o scene subacquee | Qwen4-Max, da confrontare con Gemini 4 Carbon sulle tue immagini |
| Un modello Alibaba o il passaggio da Qwen3.8-Max | Qwen4-Max: punteggi più alti, costo inferiore per immagine, nessuna richiesta non riuscita nei nostri test |
| Nessuna chiave API a pagamento | Qwen3.8 27B, Gemma 4 26B ospitati oppure SAM 3.1 Text su Platform |
Per la maggior parte dei lavori di etichettatura, GPT-6.1 Terra resta la scelta predefinita migliore. Qwen4-Max è la scelta giusta quando i tuoi dati assomigliano a quelli dei suoi dataset di punta: provalo prima su un campione delle tue immagini.
Domande frequenti
Si classifica al 13º posto su 51 nel nostro benchmark, con alcuni risultati di spicco. Nel benchmark UL37 ottiene 0.474 mAP50, si classifica al 13º posto su 51 modelli e non ha richieste non riuscite. È al primo posto su 51 nelle radiografie pediatriche dei polsi e al secondo negli oggetti subacquei e sugli scaffali dei negozi molto affollati, ma ottiene risultati scarsi nei difetti dei circuiti stampati e nelle radiografie di sicurezza.
In media, sì. Qwen4-Max ottiene 0.474 mAP50 contro 0.461, costa $5.68 contro $7.74 per 1.000 immagini e ha completato tutte le richieste, mentre Qwen3.8-Max ne ha fallito l'1.7%. I miglioramenti sono disomogenei: Qwen4-Max supera Qwen3.8-Max in 19 dataset ed è inferiore in 16, con cali marcati nel rilevamento di palline da tennis e nelle risonanze magnetiche cerebrali.
Per l'etichettatura generale, GPT-6.1 Terra: ottiene 0.560 mAP50, supera Qwen4-Max in 23 dei 36 dataset, costa $4.36 ogni 1.000 immagini e ha un tempo di risposta mediano di 5.1 secondi. Scegli Qwen4-Max quando i tuoi dati somigliano a quelli dei suoi dataset più efficaci, come radiografie del polso, scaffali di negozi molto affollati o scene sottomarine, e verifica le prestazioni sulle tue immagini.
Può generare bozze di riquadri per annotazioni di ricerca che saranno poi esaminate da esperti; non formula diagnosi. Ottiene il punteggio UL37 più alto tra 51 modelli sulle radiografie pediatriche del polso, con 0.4975 mAP50, ma ha una media di 0.325 sugli otto dataset medici, inferiore allo 0.505 di GPT-6.1 Terra, e ottiene risultati scarsi sulle radiografie del torace.
Circa $5.68 di costi Alibaba: utilizzo dei token dichiarato da Alibaba, calcolato alle tariffe Platform per il modello, ogni 1.000 immagini annotate correttamente. Il prezzo di listino internazionale di Alibaba è di $1.50 per milione di token di input e $4.50 per milione di token di output. Ultralytics Platform aggiunge una tariffa di $1.00 per l'annotazione in batch ogni 1.000 immagini, per un totale di circa $6.68.
Crea una chiave API internazionale di Alibaba Cloud Model Studio, chiedi al proprietario del tuo workspace di aggiungerla in Alibaba nella sezione Settings > API Keys, poi seleziona Qwen4-Max nella modalità Smart dell'editor di annotazione. Prova alcune immagini, avvia l'annotazione in batch, controlla i riquadri e addestra un modello Ultralytics YOLO26 nello stesso workspace.
Scritto da
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









