おすすめの画像分類モデル:選び方
ConvNeXt V2やDINOv3からEfficientNetV2、ViT、Ultralytics YOLO26-clsまで、主要な画像分類モデルを比較し、選び方を解説します。
画像分類モデルに唯一の最適解はありません。適切なモデルは、ラベル付きデータの量、モデルの実行環境、ライセンスを利用できるかどうかによって異なります。2026年の精度重視の用途では、DINOv3やEVA-02などの大規模なTransformerや自己教師ありバックボーンが中心です。限られたハードウェアへのデプロイでは、チェックポイントのサイズ、トレーニング設定、対象ハードウェアによって異なりますが、ConvNeXt V2、EfficientNetV2、MobileNetV4、Ultralytics YOLO26-clsなどの小型で主に畳み込みを用いるモデルがより実用的な場合がよくあります。実際のワークロードで精度とレイテンシを比較してください。このガイドでは、4つのモデルファミリーを解説し、広く使われている10種類のモデルを比較したうえで、選択の手順を紹介します。
タスクそのものについて初めて学ぶ場合は、まず画像分類とは何かをご覧ください。このページではモデルの選び方を説明します。
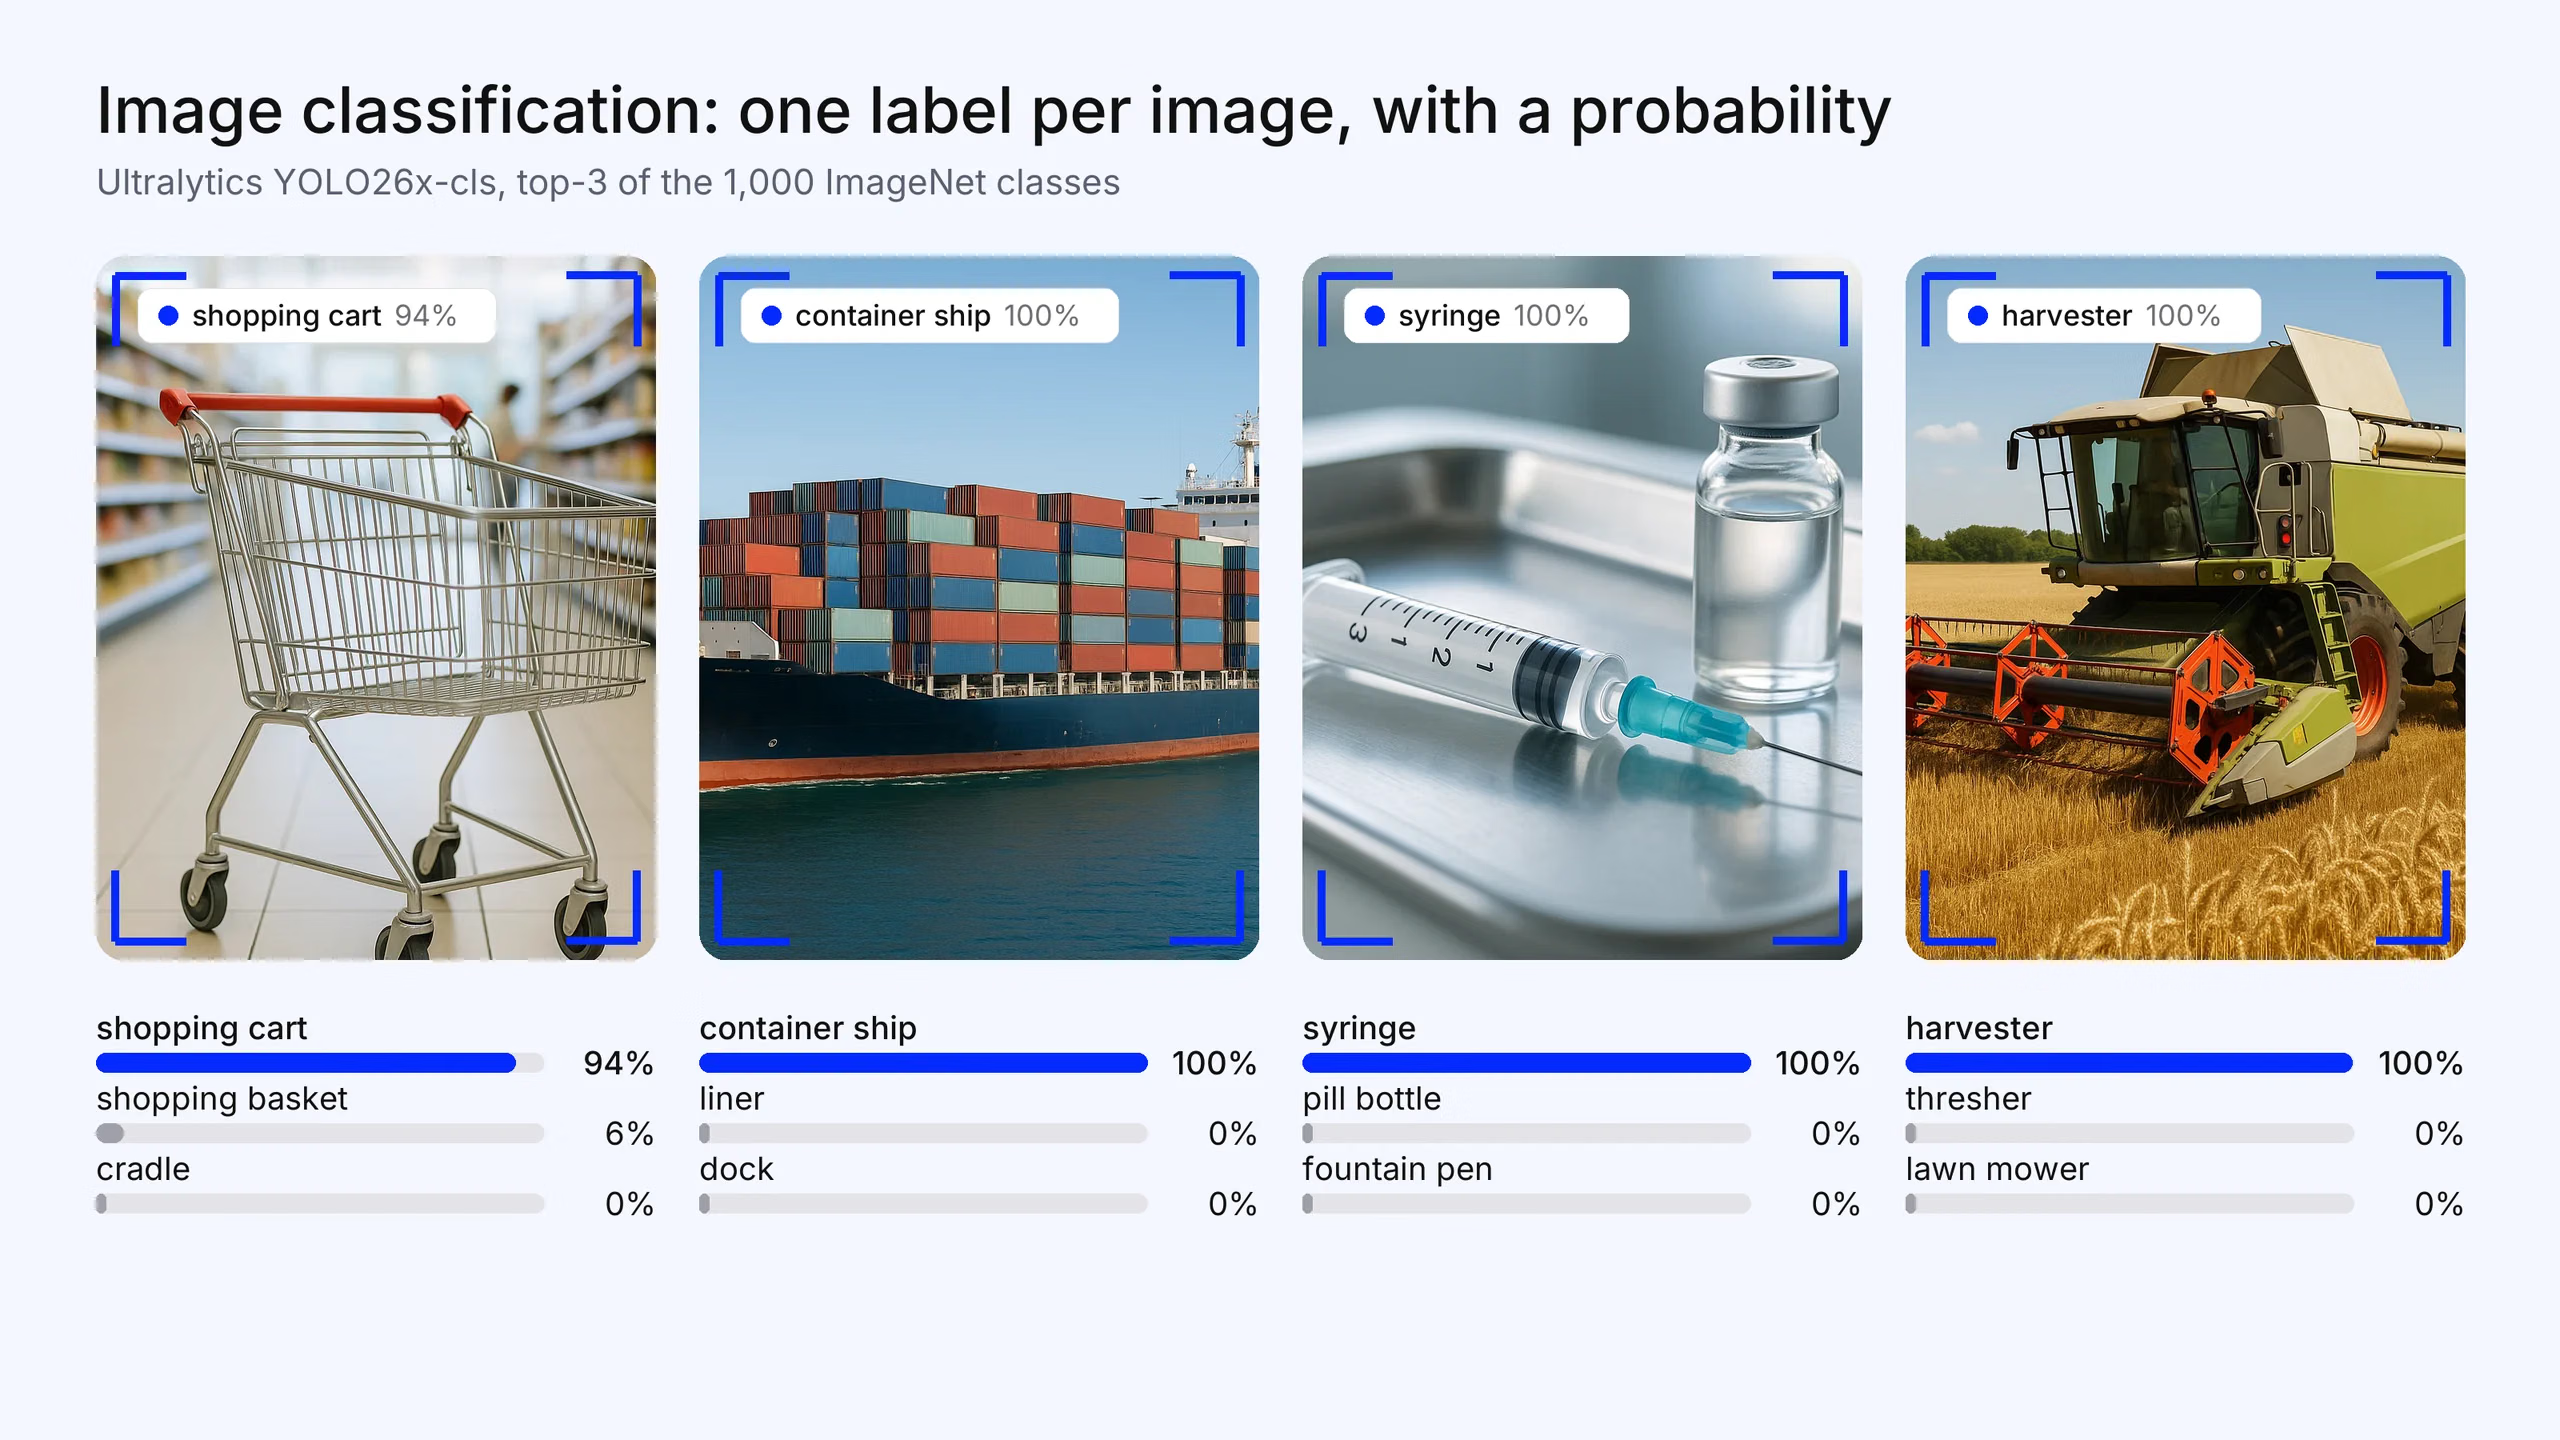
図1. 画像分類は画像全体に1つのラベルを返し、各クラスの確率を示します。小売、物流、医療、農業の例です。ImageNetの1,000クラスで事前学習したUltralytics YOLO26x-clsによる上位3件の予測です。写真はこの記事のために生成したものですが、予測は実際のモデル出力です。
画像分類モデルにおける「最適」とは#
ベンチマークでは、ImageNet検証セットでのtop-1精度に基づいてモデルを順位付けします。この数値は参考になりますが、固定解像度で単一のデータセットを使って測定されており、多くの場合、その背後には非常に大規模な事前学習があります。実際のプロジェクトでは、通常、次の4つの要因が判断を左右します。
- データ。 クラスごとのラベル付き画像の枚数と、事前学習データとの近さ。
- 計算リソースとレイテンシ。 推論をデータセンターのGPU、CPU、スマートフォン、カメラのNPUのどれで実行するか。
- デプロイ方法。 ONNX、TensorRT、Core ML、TFLiteなど、必要なランタイムにモデルを問題なくエクスポートできるかどうか。
- ライセンス。 コードと、別途、事前学習済み重みの使用が許可されているかどうか。
ImageNetでの精度が数ポイント低くても、手元の画像でファインチューニングしやすく、ハードウェア上でリアルタイムに動作するモデルのほうが、通常は適切な選択です。
画像分類モデルの4つのファミリー#
畳み込みニューラルネットワーク(CNNs)#
CNNsは学習したフィルターを画像全体に適用するため、近接するピクセル同士には関連性があると仮定します。この組み込みの仮定(帰納バイアス)により、小規模から中規模のデータセットでも効率よく学習でき、比較的低性能なハードウェアでも効率的に動作します。ResNetとEfficientNetが代表的な例です。
- 強み: データ効率が高く、高速で、量子化とデプロイが容易です。
- トレードオフ: 各層が捉えるグローバルなコンテキストは限られます。Transformerと比べて、モデルのスケールアップによる性能向上が早い段階で頭打ちになる傾向があります。
Vision Transformer (ViT)#
ビジョンTransformerは画像をパッチに分割し、自己注意機構を用いて系列として処理するため、各パッチがほかのすべてのパッチと関連付けられます。ViTは、大量のデータで事前学習してから転移学習すると、優れた性能を発揮します。
- 強み: データ量とモデルサイズに応じて適切にスケールし、転移性能に優れています。自己教師あり学習やマルチモーダル学習の自然な基盤です。
- トレードオフ: 大規模な事前学習か強い正則化が必要です。同程度の精度のCNNより、推論が遅く、計算負荷も高い傾向があります。
CNNとTransformerのハイブリッドモデル#
ハイブリッドモデルは、初期段階で畳み込みを使って局所的な詳細を捉え、後期段階で注意機構を使ってグローバルなコンテキストを捉えます。CoAtNetは代表的な設計です。提案者は、畳み込み層と注意層を原則に沿った順序で積み重ねることで、汎化性能、モデル容量、効率性が向上することを示しました。
- 強み: 中規模データセットでバランスの取れた性能を発揮します。
- トレードオフ: 純粋なCNNやTransformerと比べて、実装、調整、エクスポートが複雑です。
自己教師あり学習とビジョン・ランゲージのバックボーン#
最新のファミリーは、アーキテクチャではなく学習方法によって定義されます。DINOv2やDINOv3などの自己教師ありモデルは、ラベルのない画像から学習します。SigLIP 2などのビジョン・ランゲージエンコーダーは、画像とテキストのペアから学習します。どちらも汎用的な特徴を生成し、小さな線形ヘッドで分類できます。また、ビジョン・ランゲージモデルでは、テキストプロンプトを使って学習なしで分類することもできます(ゼロショット学習)。MetaはDINOv3を17億枚の画像で学習させました。DINOv2の11億パラメーター、1億4,200万枚の画像に対し、DINOv3は70億パラメーターです。
- 強み: ラベル付きデータが少なくても高品質な特徴を得られ、1つのバックボーンを複数のタスクに使用できます。
- トレードオフ: 最大サイズのチェックポイントはエッジデバイスには重すぎます。ライセンスはさまざまなため、確認が必要です。
画像分類モデルの比較#
モデルは順位順ではなく、アルファベット順に掲載しています。精度の数値は記載していません。公開されているImageNetの数値は、解像度、事前学習データ、評価方法によって異なるため、ここに並べたモデル間では比較できません。各モデルの論文またはドキュメントに、個別の数値が記載されています。
| モデル | ファミリー | 開発元 | 事前学習 | 最適な用途 | 主なトレードオフ |
|---|---|---|---|---|---|
| ConvNeXt V2 | CNN | Meta | 自己教師ありマスクオートエンコーディング(FCMAE)、続いて教師ありファインチューニング | さまざまなサイズで高精度かつデプロイしやすいCNN | ImageNetの重みはCC-BY-NC(非商用)です |
| DINOv3 | 自己教師あり(ViTおよびConvNeXt) | Meta | 17億枚の画像で自己教師あり学習 | ラベル付きデータが少なくても、凍結したバックボーンから高品質な特徴を取得 | 独自のDINOv3 License。最大モデルは70億パラメーター |
| EfficientNetV2 | CNN | 教師あり | 高速なトレーニング、効率的なファインチューニング | 設計が古く、精度では新しいバックボーンが優位 | |
| EVA-02 | ViT | BAAI | CLIPの特徴を用いたマスク画像モデリング | 精度重視の研究とファインチューニング | 大規模なバリエーションは推論時の負荷が高い |
| MobileNetV4 | CNNおよびハイブリッド(モバイル向け) | 教師あり | スマートフォン、NPU、エッジアクセラレーター | サーバークラスのモデルより精度の上限が低い | |
| ResNet | CNN | Microsoft Research | 教師あり | ベースライン、教育、レガシーパイプライン | FLOPあたりの精度では、もはや競争力がありません |
| SigLIP 2 | ビジョン・ランゲージ(ViT) | 画像とテキストのペア、多言語対応 | ゼロショット分類とオープンボキャブラリー分類 | ゼロショットの結果を利用する前に、対象クラスで検証してください | |
| Swin Transformer | ViT(階層型) | Microsoft Research | 教師あり | 高解像度入力、バックボーンの再利用 | 同程度の精度のCNNより計算負荷が高い |
| Ultralytics YOLO26-cls | CNN | Ultralytics | ImageNetで教師あり学習 | カスタム分類器の高速な実行、エッジへのエクスポート、検出と共通のAPI | 大規模な事前学習済みTransformerより精度の上限が低い |
| ViT | ViT | 教師あり学習。多くの場合、大規模データセットを使用 | 大規模な転移学習 | 大規模な事前学習がない場合、データを大量に必要とする |
各モデルの詳細#
アルファベット順に掲載しています。
ConvNeXt V2#
ConvNeXt V2は、完全畳み込み型マスクオートエンコーダー(FCMAE)とGlobal Response Normalization層を組み合わせています。Atto(370万パラメーター)からHuge(6億6,000万パラメーター)まで8つのサイズがあり、エッジからサーバーまで、1つのファミリーで幅広く対応できます。Transformer時代の精度とCNNのデプロイ性を両立したい場合に、有力なデフォルト選択肢です。トレードオフ: コードはMITライセンスですが、ImageNetで事前学習およびファインチューニングした重みはCC-BY-NCのため、商用利用できません。
DINOv3#
DINOv3は、Metaの自己教師ありビジョンバックボーンです。ViT-S/16からViT-7B/16までのViTモデルに加え、デバイス上での利用向けに蒸留したConvNeXtモデルも公開されています。Metaはバックボーンを凍結して評価しており、リポジトリには7Bモデル用のImageNet分類ヘッドが含まれています。ラベルが少なく、転移可能な特徴が必要な場合に試すべきモデルです。トレードオフ: 標準的なオープンソースライセンスではなく、独自のDINOv3 Licenseで公開されています。また、注目される性能は最大モデルによるものです。
EfficientNetV2#
GoogleのEfficientNetV2は、段階的学習を採用しています。トレーニング中に画像サイズを大きくし、それに合わせて正則化を調整します。そのため、以前のモデルより高速に学習でき、パラメーター数も少なくなります。小規模から中規模のデータセットでファインチューニングする場合、今でも信頼できる選択肢です。トレードオフ: 2023~2025年のバックボーンより前のモデルであり、精度では最先端ではありません。初期の設計については、EfficientNetの概要をご覧ください。
EVA-02#
EVA-02は、マスク画像モデリングを用いて、大規模なCLIPビジョンエンコーダーの特徴を再構成するよう事前学習した標準的なTransformerです。600万から3億400万パラメーターまで、4つのサイズがあります。ファインチューニング用にtimmで利用できます。トレードオフ: 大規模なバリエーションはファインチューニングと推論のコストが高く、単純なドメイン分類には過剰な性能です。
MobileNetV4#
MobileNetV4は、Googleの最新のモバイル向けファミリーです。モバイルCPU、DSP、GPU、Apple Neural Engine、Google Pixel EdgeTPUで効率的に動作するよう設計されています。スマートフォンや低消費電力アクセラレーターに適した自然な選択肢です。トレードオフ: 最小レイテンシを優先する代わりに、最高精度を犠牲にします。
ResNet#
ResNetは残差接続を導入したモデルであり、現在も標準的なベースラインとして、あらゆるフレームワークでサポートされています。トレードオフ: 新しいCNNは、同じ計算量でより高い精度を実現します。アーキテクチャについては、ResNet-50とは何かをご覧ください。
SigLIP 2#
SigLIP 2(SigLIPの用語集の項目もご覧ください)は、Googleの多言語ビジョン・ランゲージエンコーダーファミリーです。学習なしでテキストラベルのリストと画像を照合して分類でき(アプローチはCLIPに類似)、NaFlexバリエーションでは入力画像のネイティブのアスペクト比が維持されます。ラベルセットが頻繁に変わる場合や、まだラベル付きデータがない場合に最適です。トレードオフ: ゼロショットの品質はドメインによって異なるため、利用する前に対象クラス(たとえば欠陥の種類)で検証してください。性能が不十分な場合は、分類ヘッドを学習するか、ファインチューニングしてください。
Swin Transformer#
Swin Transformerは、シフトした局所ウィンドウ内で注意機構を計算するため、計算量が画像サイズに対して線形になり、高解像度入力に適しています。トレードオフ: 同程度の精度のCNNより計算負荷が高くなります。ConvNeXtは、標準的な畳み込みを使ってSwin Transformerと競合できるよう設計されました。
Ultralytics YOLO26-cls#
Ultralytics YOLO26-clsは、Ultralytics YOLO26の分類バリエーションです。2.8Mから29.6Mパラメーター(融合後)までの5つのサイズ(n、s、m、l、x)があり、224ピクセルの入力を受け取り、ImageNetで事前学習されています。ドキュメントには、ImageNet検証セットでの各サイズのtop-1精度とtop-5精度、およびCPUとGPUのレイテンシが記載されています。同じPython APIとCLIを使って、分類、検出、セグメンテーション、ポーズの各モデルをトレーニング、検証、エクスポートできます。分類モデルは、ONNX、TensorRT、Core ML、OpenVINO、LiteRTなどの形式にエクスポートできます。以前のYOLO11-clsモデルも、同じ5つのサイズと入力サイズを使用します。トレードオフ:
- 精度の上限。 xモデルでさえ、EVA-02やDINOv3などの大規模な事前学習済みTransformerと比べると小さいため、精度重視の研究には適していません。
- デフォルトでは正方形にクロップ。 トレーニングではランダムなリサイズクロップを、検証ではセンタークロップを使用します。そのため、アスペクト比が極端な画像では、一部が切り落とされることがあります。ドキュメントでは、単純なリサイズに切り替える方法を紹介しています。
- ライセンス。 UltralyticsのモデルはAGPL-3.0です。クローズドソースで商用利用するには、Ultralytics Enterpriseライセンスが必要です。
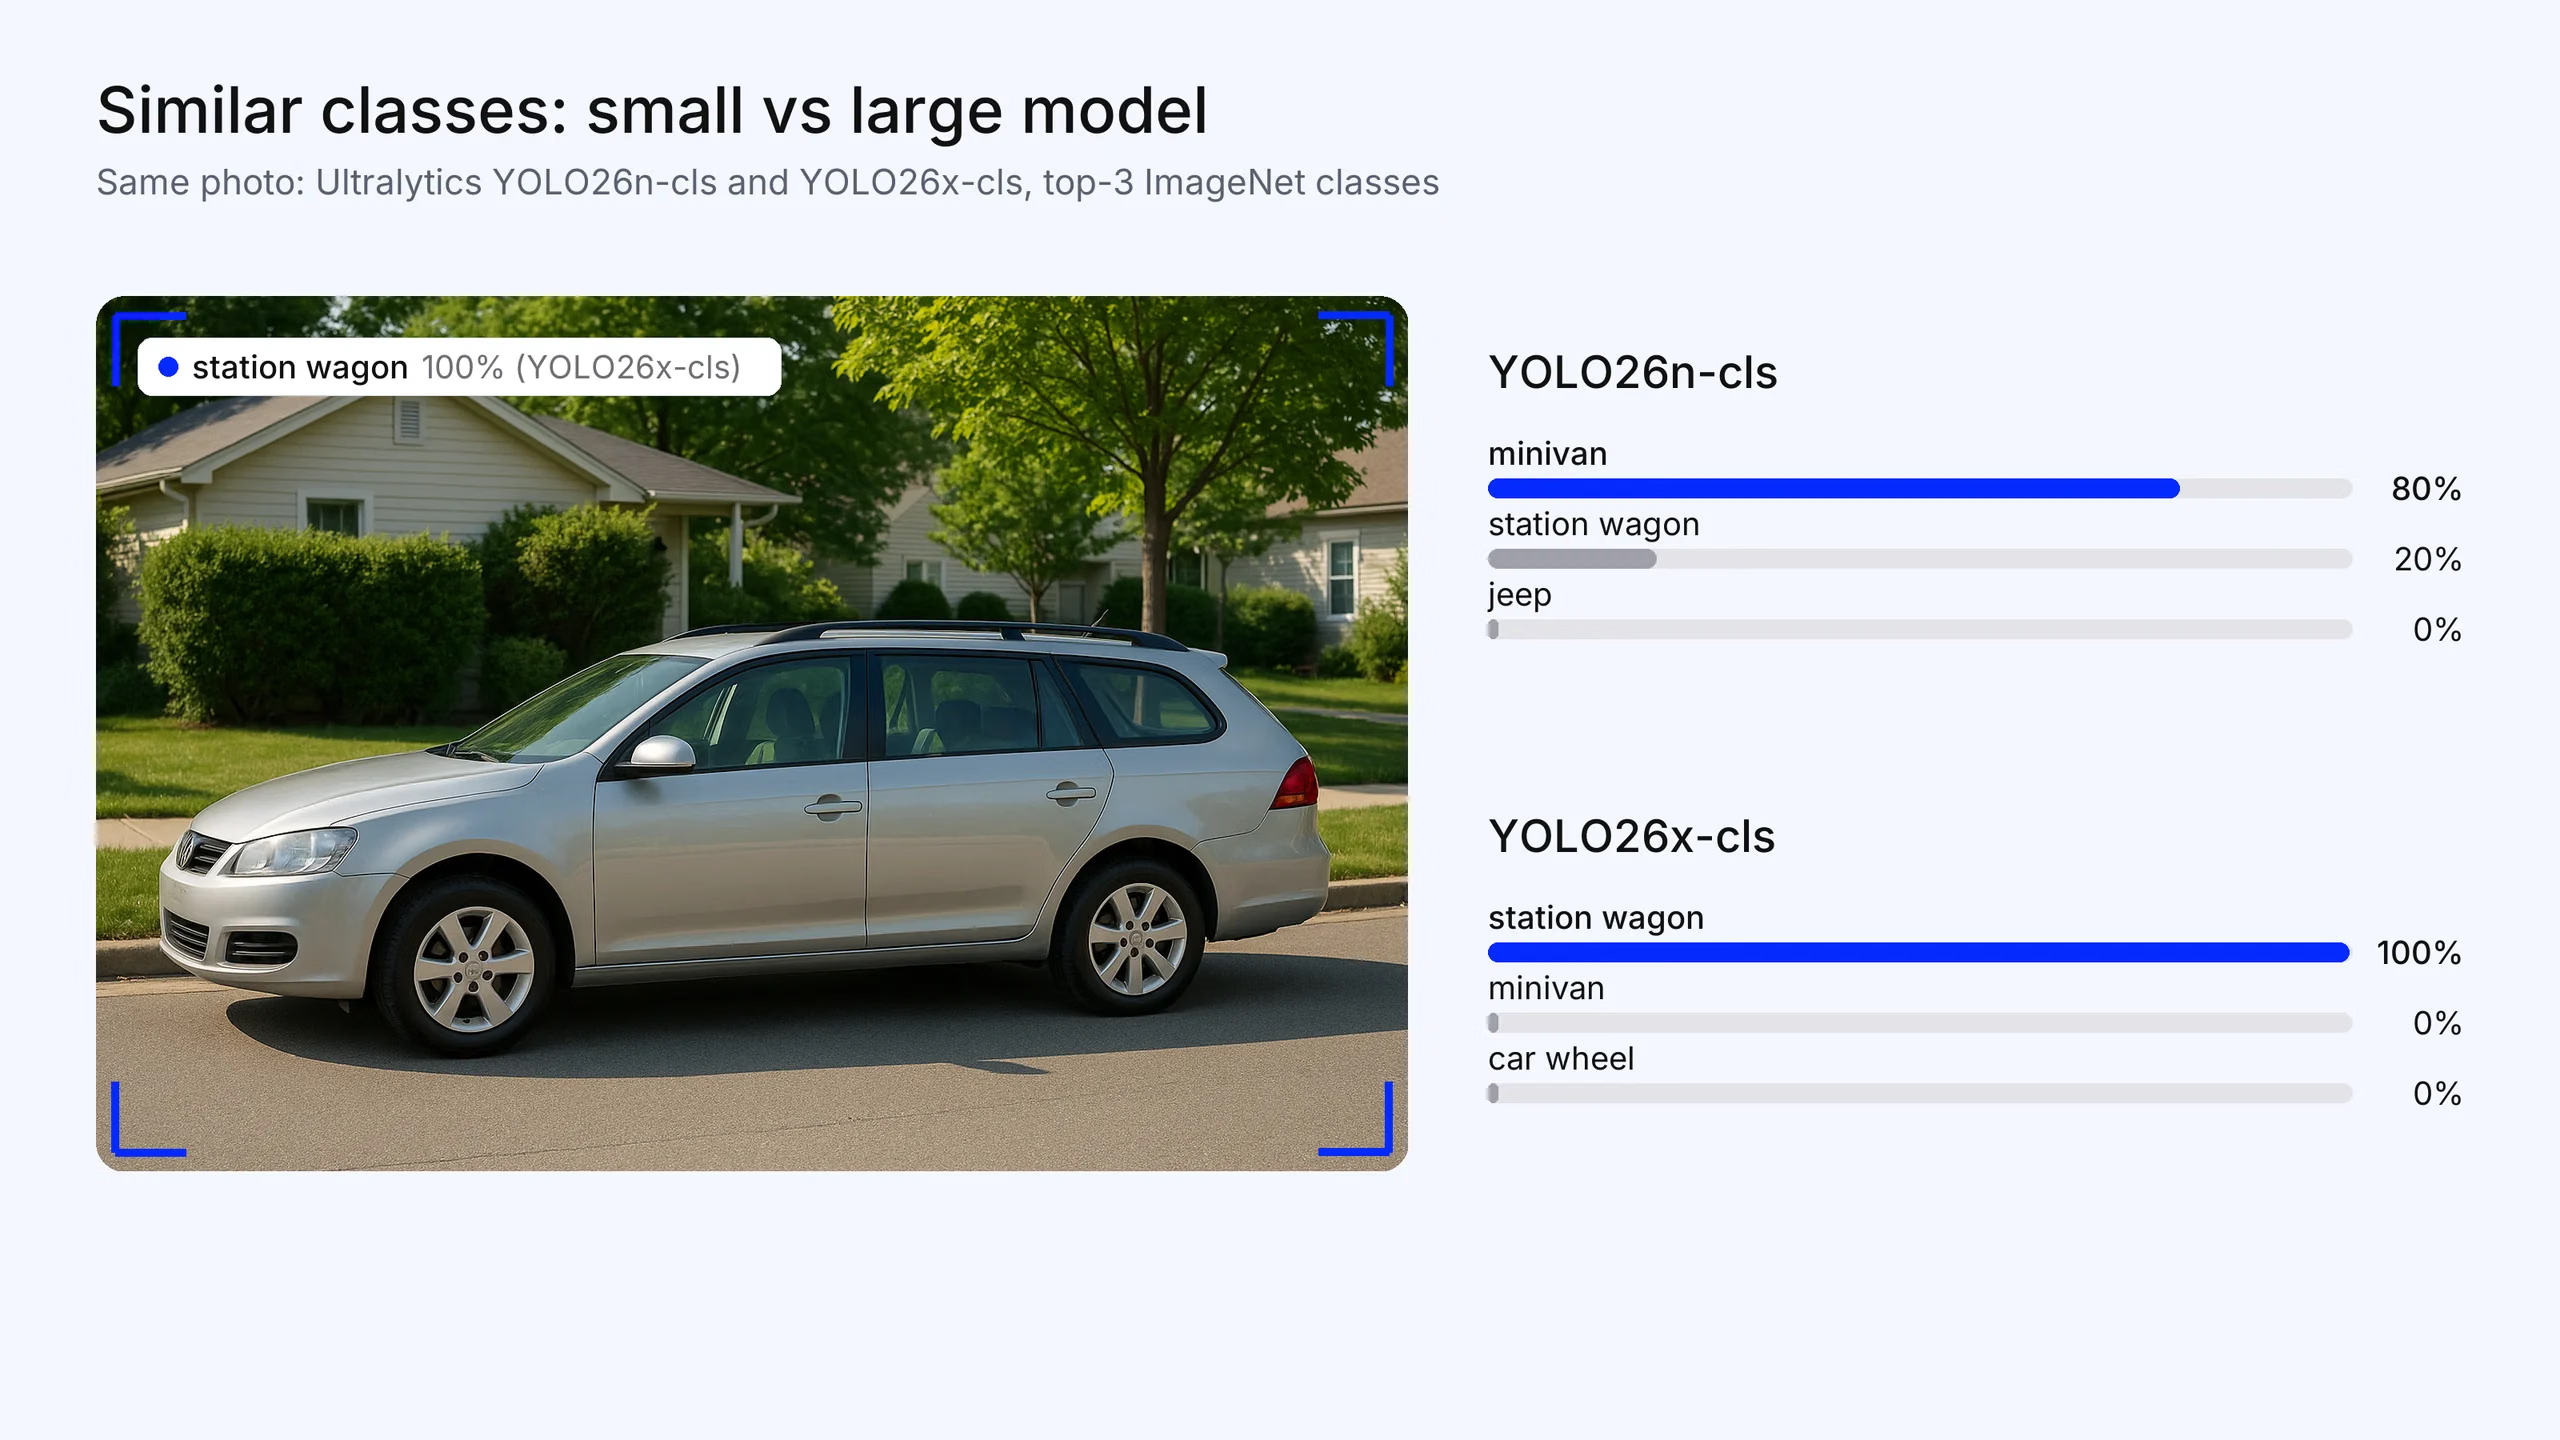
図2. 類似クラスでは、モデルサイズの違いが表れます。ステーションワゴンのこの写真では、Ultralytics YOLO26n-clsは「ミニバン」を1位(80%)にランク付けする一方、YOLO26x-clsはステーションワゴンを1位(100%、ImageNetの「beach wagon, station wagon」クラスとして表示)にランク付けします。このような細分類クラスは、独自の検証セットで確認してください。写真はこの記事用に生成したもので、予測結果は実際のモデル出力です。
ViT#
Googleが開発した最初のVision Transformerは、大量のデータで事前学習すれば、画像パッチに純粋なTransformerを適用する方法がCNNと同等以上の性能を発揮できることを示しました。トレードオフ: 大規模な事前学習がない場合、小規模なデータセットではCNNを下回り、推論時にもより多くの計算リソースが必要です。
画像分類モデルの選び方#
次の質問に順番に答えてください。
- ラベル付きデータはありますか? ラベル付きの例がない場合は、SigLIP 2などの視覚言語モデルを使ったゼロショット分類から始めてください。ラベル付きデータセットが小規模な場合は、凍結したDINOv3バックボーンと学習済みの線形ヘッドも評価してください。
- どこで実行しますか? スマートフォンやNPUで実行する場合は、MobileNetV4、YOLO26n-clsのような小規模CNN、または小規模なConvNeXt V2を候補にしてください。エッジGPUまたはCPUでリアルタイムに実行する場合は、YOLO26-cls、EfficientNetV2、ConvNeXt V2を検討してください。レイテンシの厳しい制約がないサーバーでは、EVA-02、Swin、DINOv3 ViTが候補になります。
- クラスごとのラベル付きデータはどのくらいありますか? 数百から数千枚程度の場合は、事前学習済みCNNまたは凍結した自己教師ありバックボーンからの転移学習が最も安全な方法です。数万枚以上ある場合は、Transformerを全面的にファインチューニングするメリットが出てきます。
- ライセンスを利用できますか? コードだけでなく、重みのライセンスも確認してください。ConvNeXt V2のImageNet重みは商用利用不可で、DINOv3には独自のライセンスがあります。また、Enterpriseライセンスを保有していない場合、UltralyticsモデルにはAGPL-3.0が適用されます。
- 使用するランタイムにエクスポートできますか? 導入を決める前に、ONNX、TensorRT、Core ML、TFLiteへの対応済みエクスポート経路を確認してください。
次に、候補を2~3モデルに絞ってファインチューニングし、独自の検証用分割データで比較してください。
YOLO以外のモデルが適しているケース#
YOLO26-clsは、高速でデプロイしやすいカスタム分類器向けに設計されています。一方、用途によっては別のモデルが適しています。
- 精度優先の研究やベンチマーク: ImageNetレベルの結果を再現するためのレシピと重みが揃っているEVA-02、ConvNeXt V2、またはtimm経由のViTを使用してください。
- ラベルが非常に少ない場合、または1つのバックボーンで多数の下流タスクに対応する場合: DINOv3の特徴量と線形ヘッドを使用してください。
- ラベルセットがオープンである場合、または頻繁に変わる場合: SigLIP 2のゼロショット分類を使用してください。
- Apple Neural EngineやEdgeTPUなどのスマートフォン向けNPU: MobileNetV4は、まさにこれらのターゲット向けに設計され、テストされています。
画像に何が写っているかだけでなく、物体の位置も特定する必要がある場合は、検出モデルが必要です。物体検出モデルの比較をご覧ください。
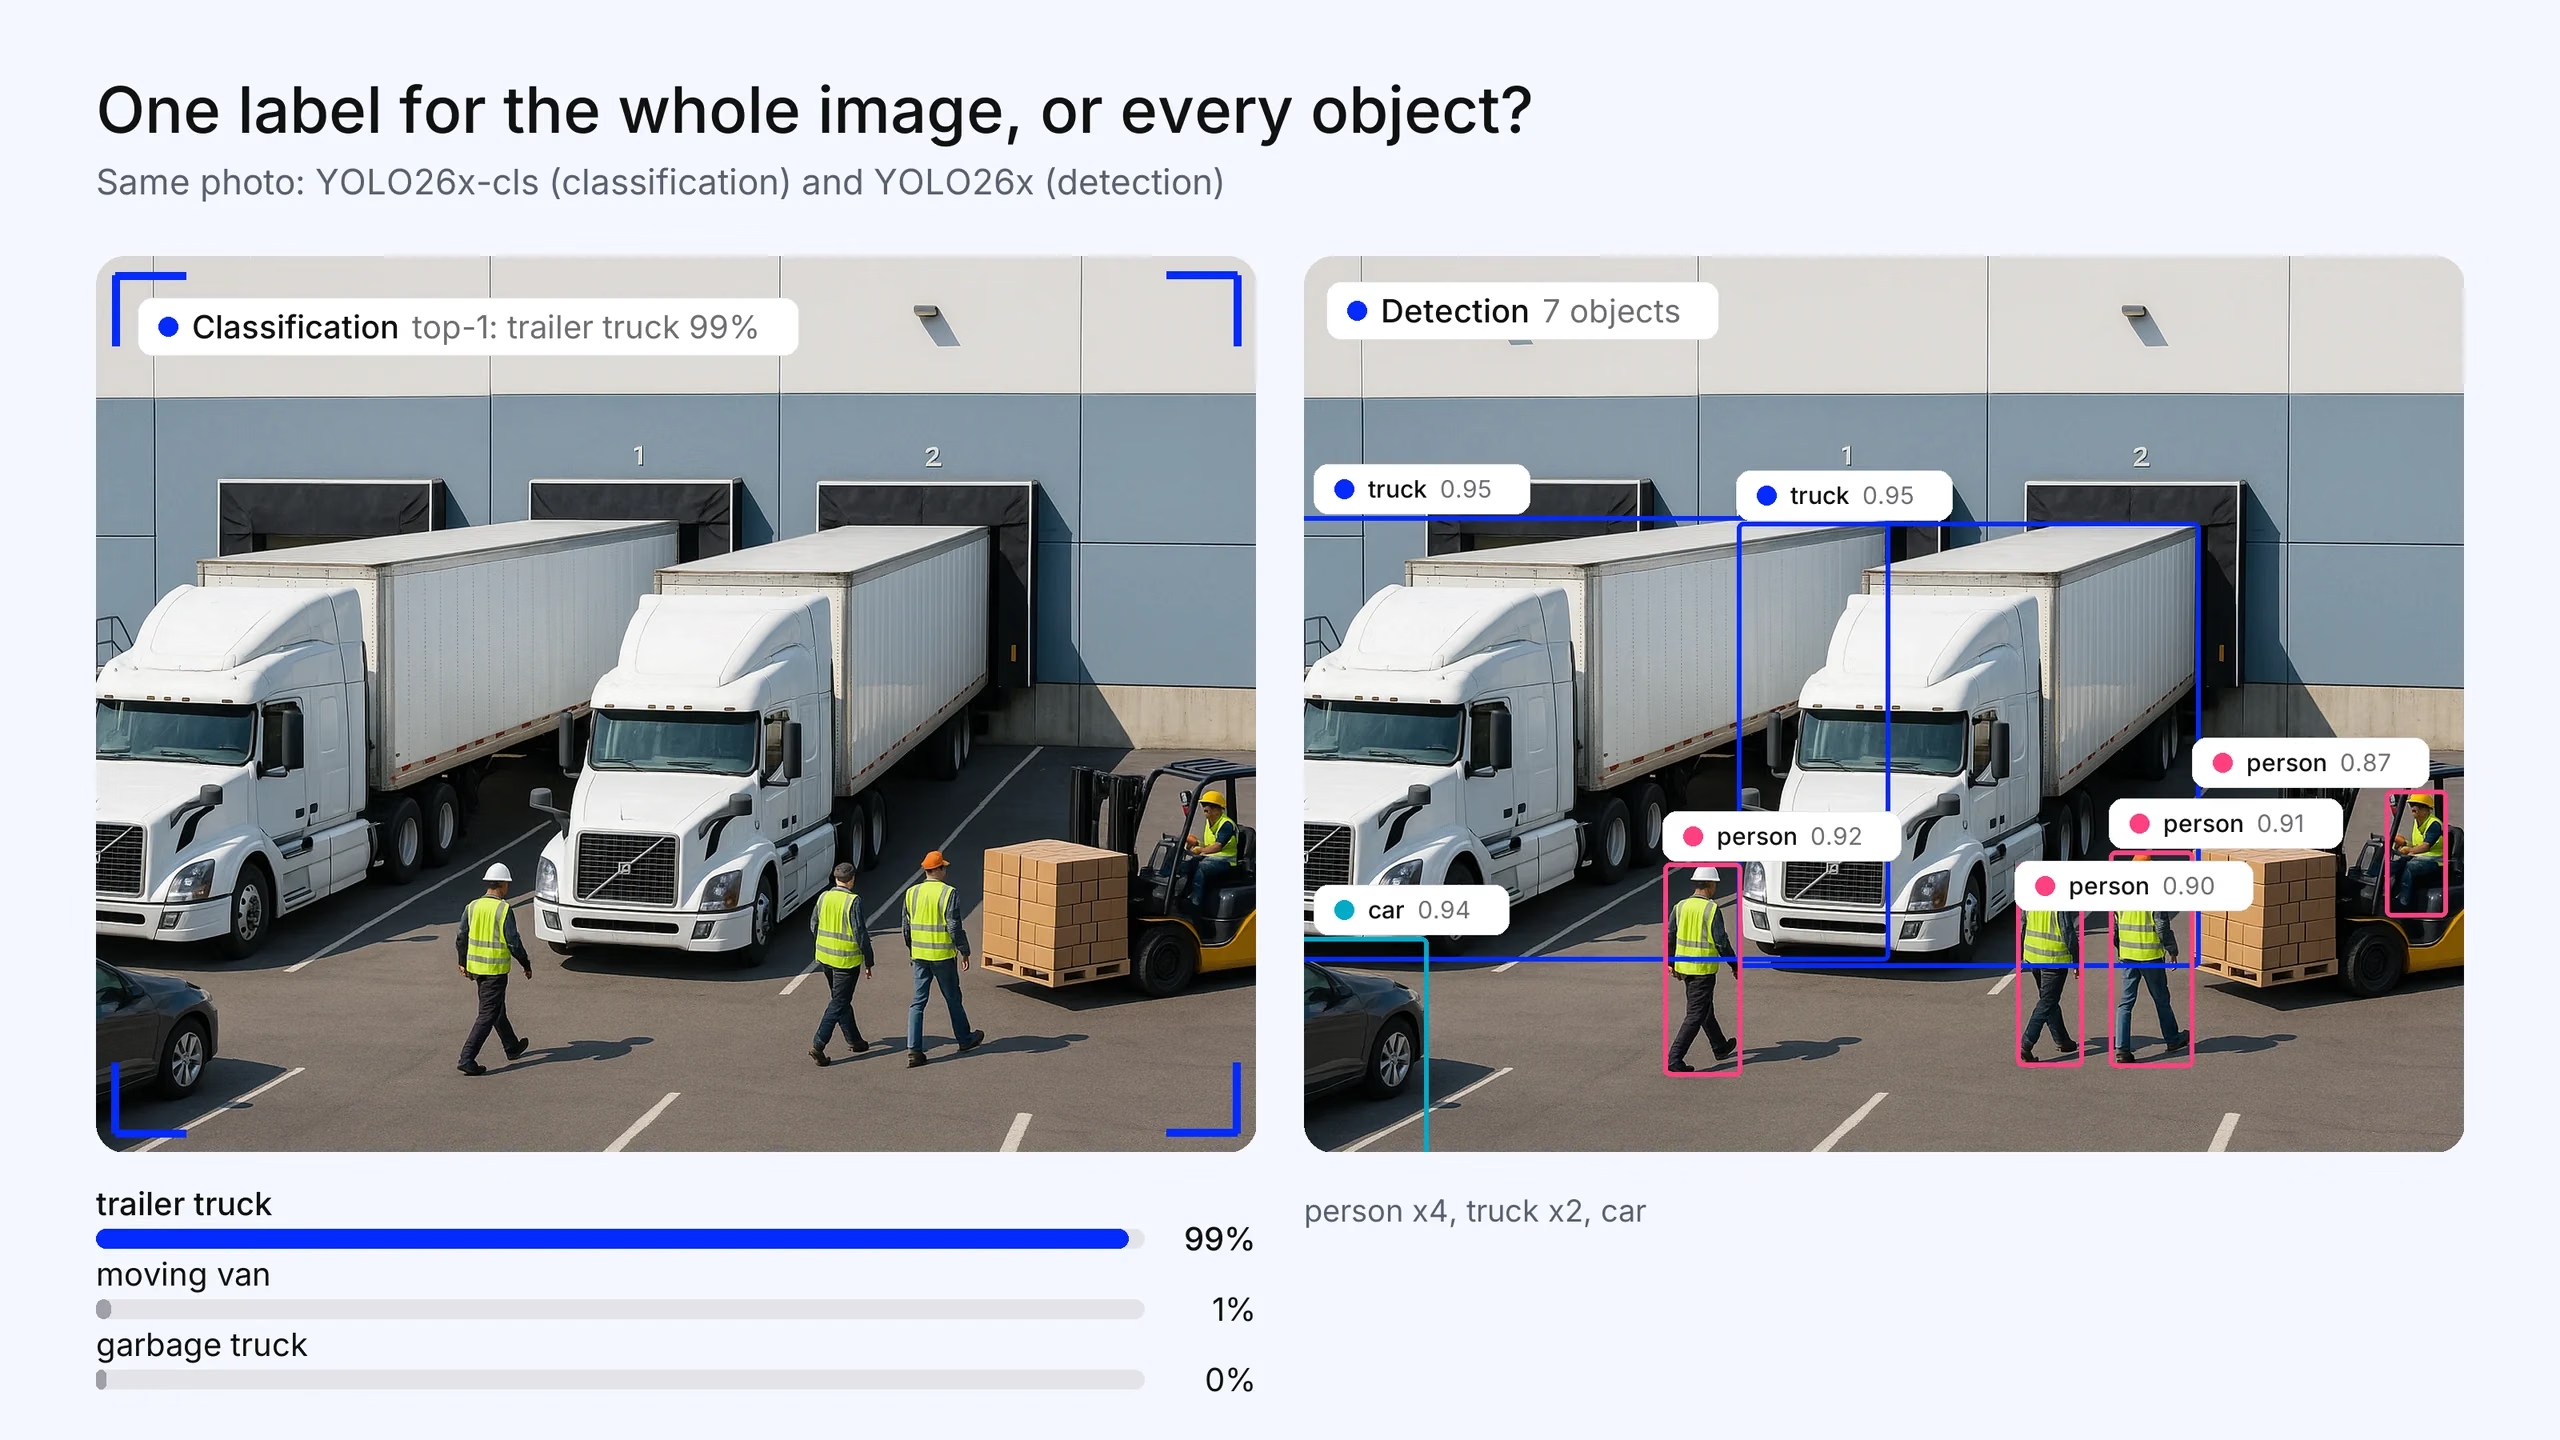
図3. 多数の物体があるシーンでも、分類器が返すラベルは1つです。Ultralytics YOLO26x-clsは、この流通ヤードを「トレーラートラック」と99%の確信度で分類します。Ultralytics YOLO26xの検出では、7個の物体(人4人、トラック2台、車1台)が見つかり、それぞれに独自のボックスが付与されます(確信度0.5以上)。写真はこの記事用に生成したもので、出力は実際のものです。
事前学習済みモデルの入手先と独自モデルの学習方法#
- timm (PyTorch Image Models)には、ViTやConvNeXtからMobileNetV4、EVA、DINOv3まで、上記のバックボーンの多くが収録されており、学習・評価用スクリプトも含まれています。コードはApache 2.0ライセンスですが、重みのライセンスはモデルによって異なります。
- Hugging Faceでは、SigLIP 2やDINOv3を含む多くのTransformer分類器が公開されており、ゼロショットや画像分類のパイプラインをすぐに利用できます。
- Ultralytics Pythonパッケージでは、クラスごとに整理した画像フォルダーを使ってYOLO26-clsを学習できます。分類データセット形式と分類タスクガイドをご覧ください。
- Ultralytics Platformでは、同じモデル向けにアノテーションとクラウド学習も利用できます。2026年にリリースされたため、既存のホステッド学習サービスより新しいサービスです。学習後のモデル提供については、コンピュータービジョン推論プラットフォームの比較をご覧ください。
よくある質問
あらゆるケースに最適なモデルはありません。十分な計算リソースがあり、精度を最優先する場合は、EVA-02やDINOv3のような大規模Transformerおよび自己教師ありバックボーンを最初に評価する候補としてください。限られたハードウェアで本番環境に導入する場合は、ConvNeXt V2、EfficientNetV2、MobileNetV4、Ultralytics YOLO26-clsなどのCNNがより実用的です。ラベル付きデータなしで分類する場合は、SigLIP 2でゼロショット分類を利用できます。
非常に大規模なデータセットで事前学習され、計算リソースに余裕がある場合は、Transformerが優位になる傾向があります。一方、小規模から中規模のデータセットやエッジハードウェアではCNNが優位になる傾向があります。局所構造に関する組み込みの前提により、少ないデータで効率よく学習でき、高速に動作するためです。ConvNeXtのような最新CNNは精度の差を縮めており、CoAtNetのようなハイブリッドモデルは両者を組み合わせています。
はい。DINOv3は汎用バックボーンです。凍結モデルで特徴量を抽出し、その上に小規模な線形分類器を学習できます。また、Metaのリポジトリには、最大モデル向けのImageNet分類ヘッドが含まれています。商用利用の前にDINOv3ライセンスを確認してください。
主にtop-1精度(最上位の予測が正解である割合)とtop-5精度(正解クラスがスコア上位5件に含まれる割合)を、通常はImageNet検証セットで測定します。クラスの分布が不均衡なカスタムデータセットでは、全体の精度よりもクラスごとの適合率、再現率、F1のほうが有用です。









