セマンティックセグメンテーションとインスタンスセグメンテーション:適切なタスクの選び方
セマンティックセグメンテーションはすべてのピクセルにクラスラベルを付け、インスタンスセグメンテーションは各オブジェクトを個別に分離します。コンピュータービジョンプロジェクトでどちらが必要か、またその理由を解説します。
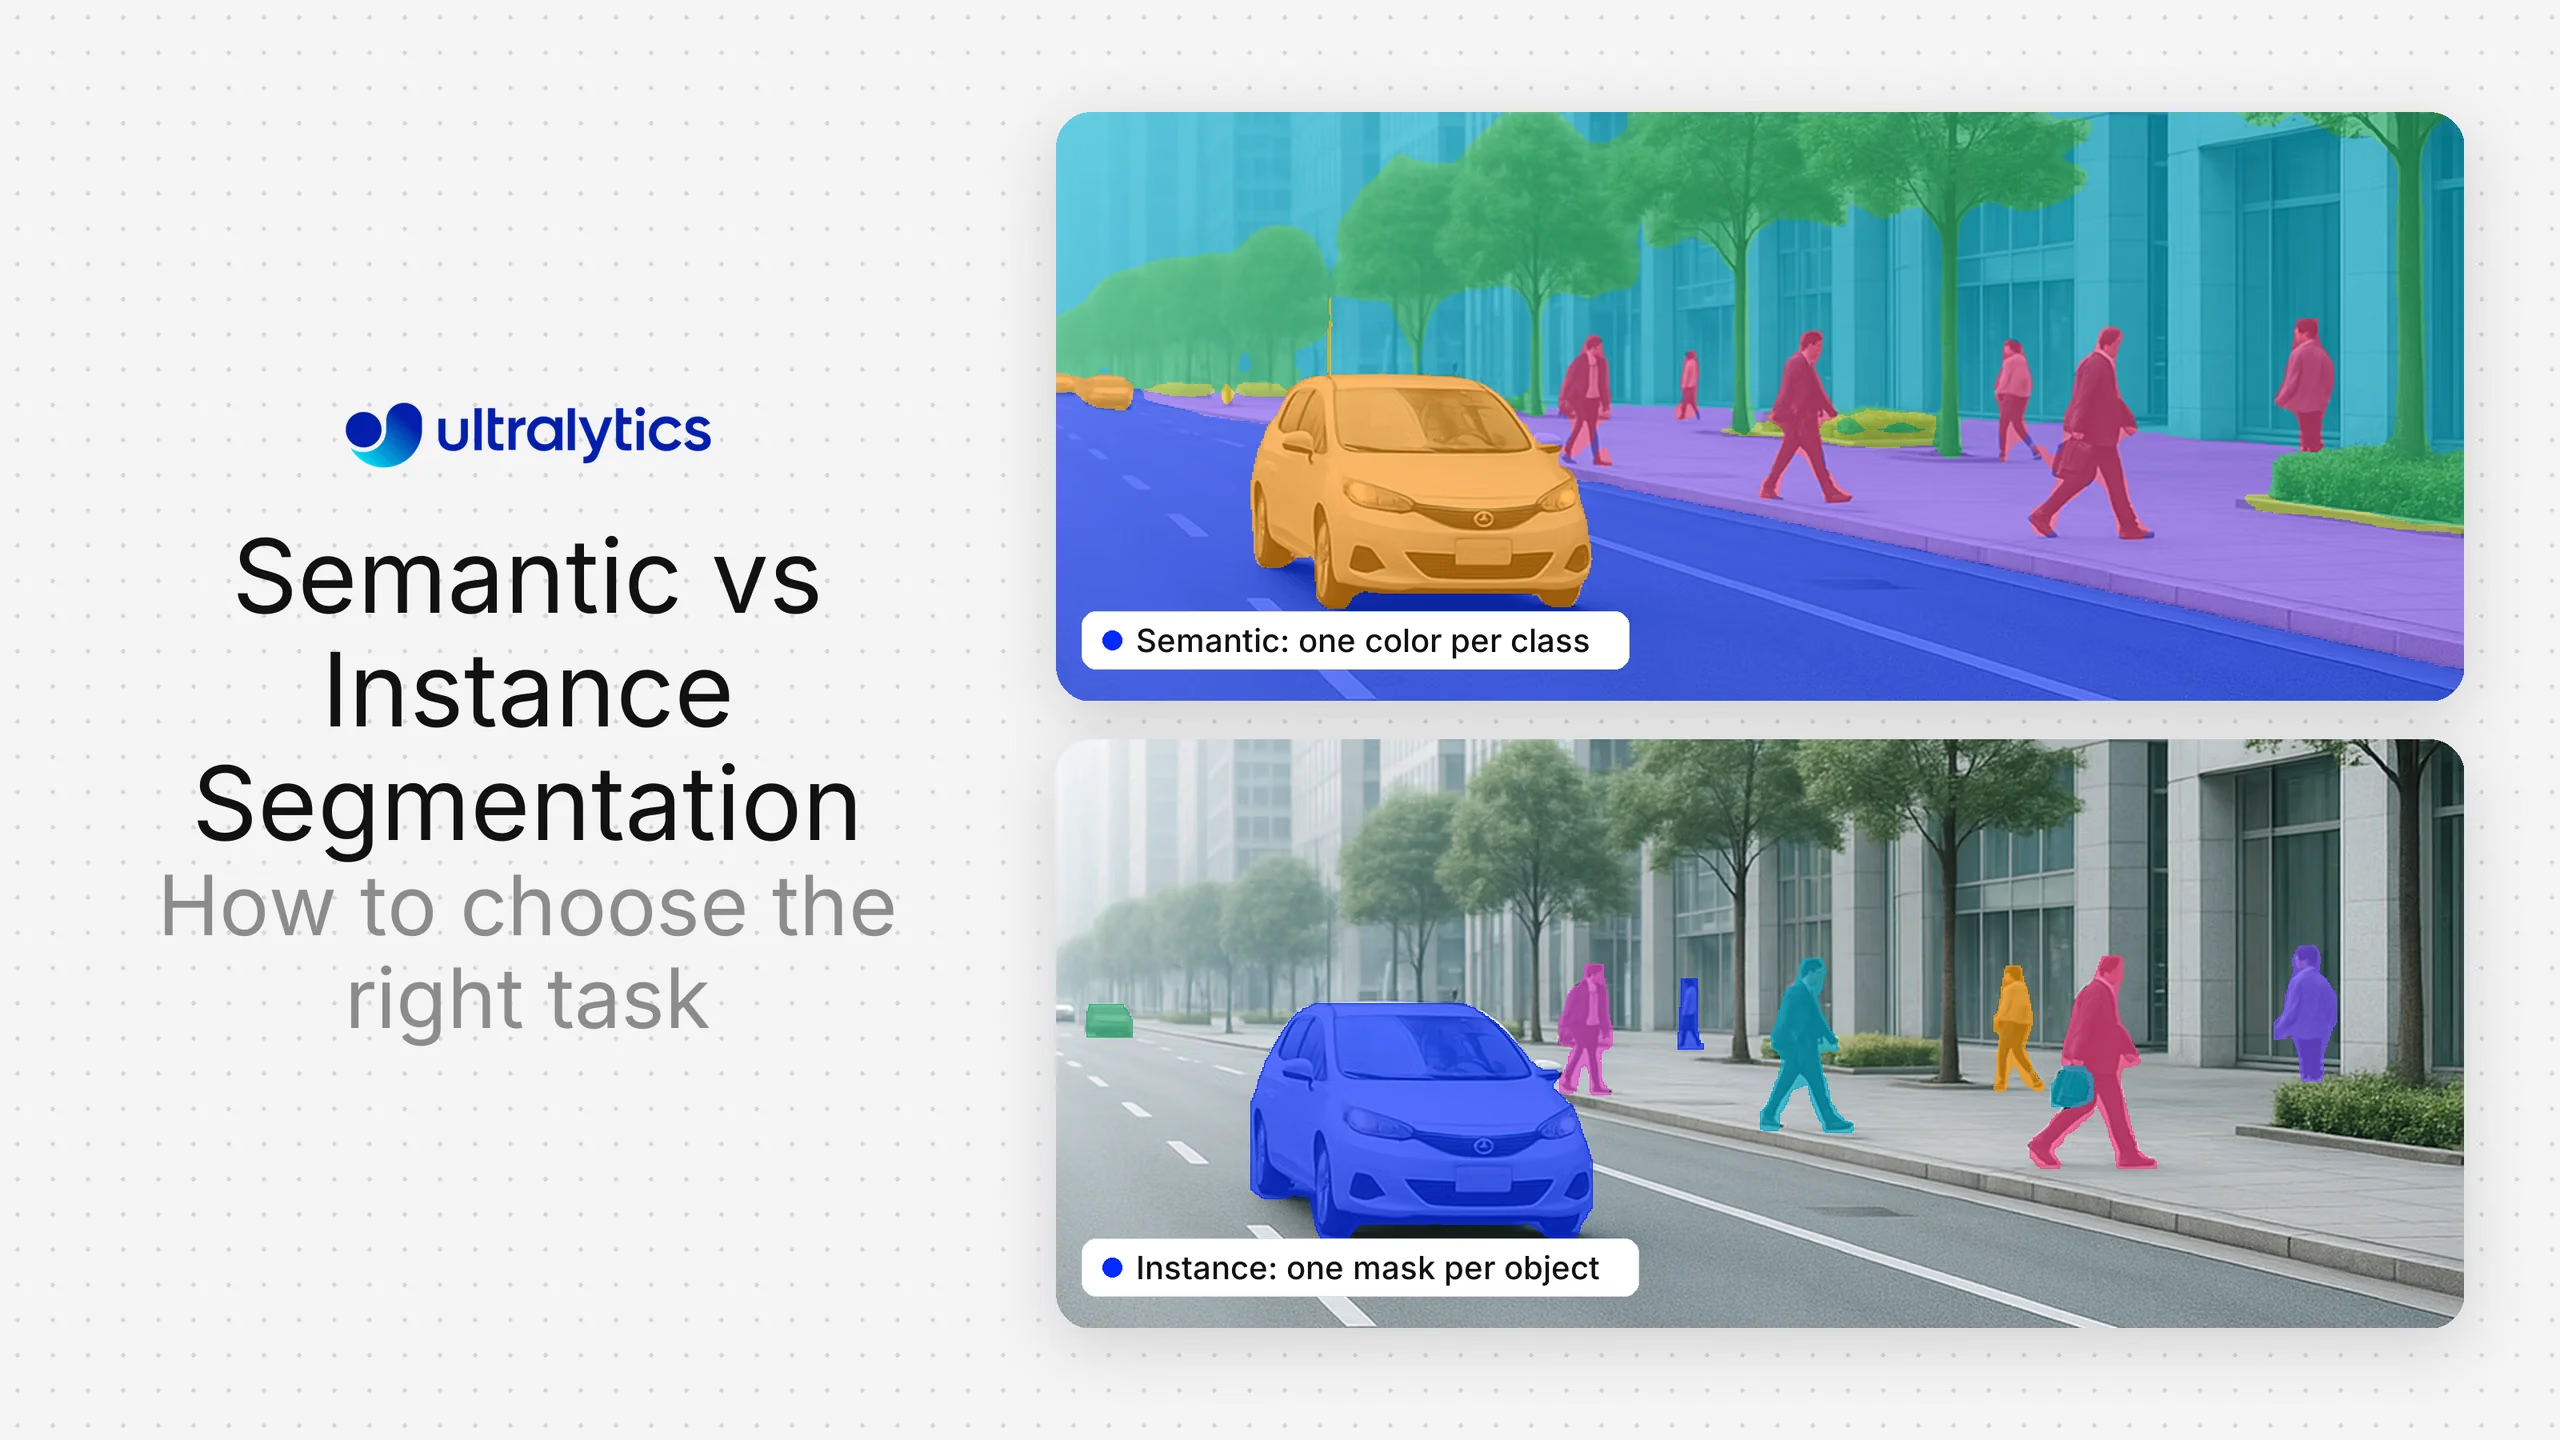
セマンティックセグメンテーションとインスタンスセグメンテーションは、どちらも画像にピクセル単位でラベルを付けますが、答える問いは異なります。セマンティックセグメンテーションではすべてのピクセルにクラスを割り当てるため、シーン内の車はすべて1つの「車」領域になります。インスタンスセグメンテーションでは個々の物体を分離するため、車ごとに独自のマスクが割り当てられます。どちらを選ぶかは、「各ピクセルに 何が あるか」と「各ピクセルが どの物体に 属するか」のどちらを知る必要があるかで決まります。このガイドでは、選択方法に加え、各タスクのアノテーションコストと評価方法も解説します。Ultralytics YOLOは、同じフレームワーク内で両方のタスクに対応しています。
違いを一言で#
- セマンティックセグメンテーションでは、道路、空、人、車などのカテゴリにすべてのピクセルを分類します。同じクラスの物体は1つの領域に統合されます。用語の詳細は、セマンティックセグメンテーションの用語集をご覧ください。
- インスタンスセグメンテーションでは、個々の物体を検出し、それぞれに独自のマスクとIDを割り当てます。通常、数えられる物体が対象となり、空や草などの背景は対象外です。用語の詳細は、インスタンスセグメンテーションの用語集をご覧ください。
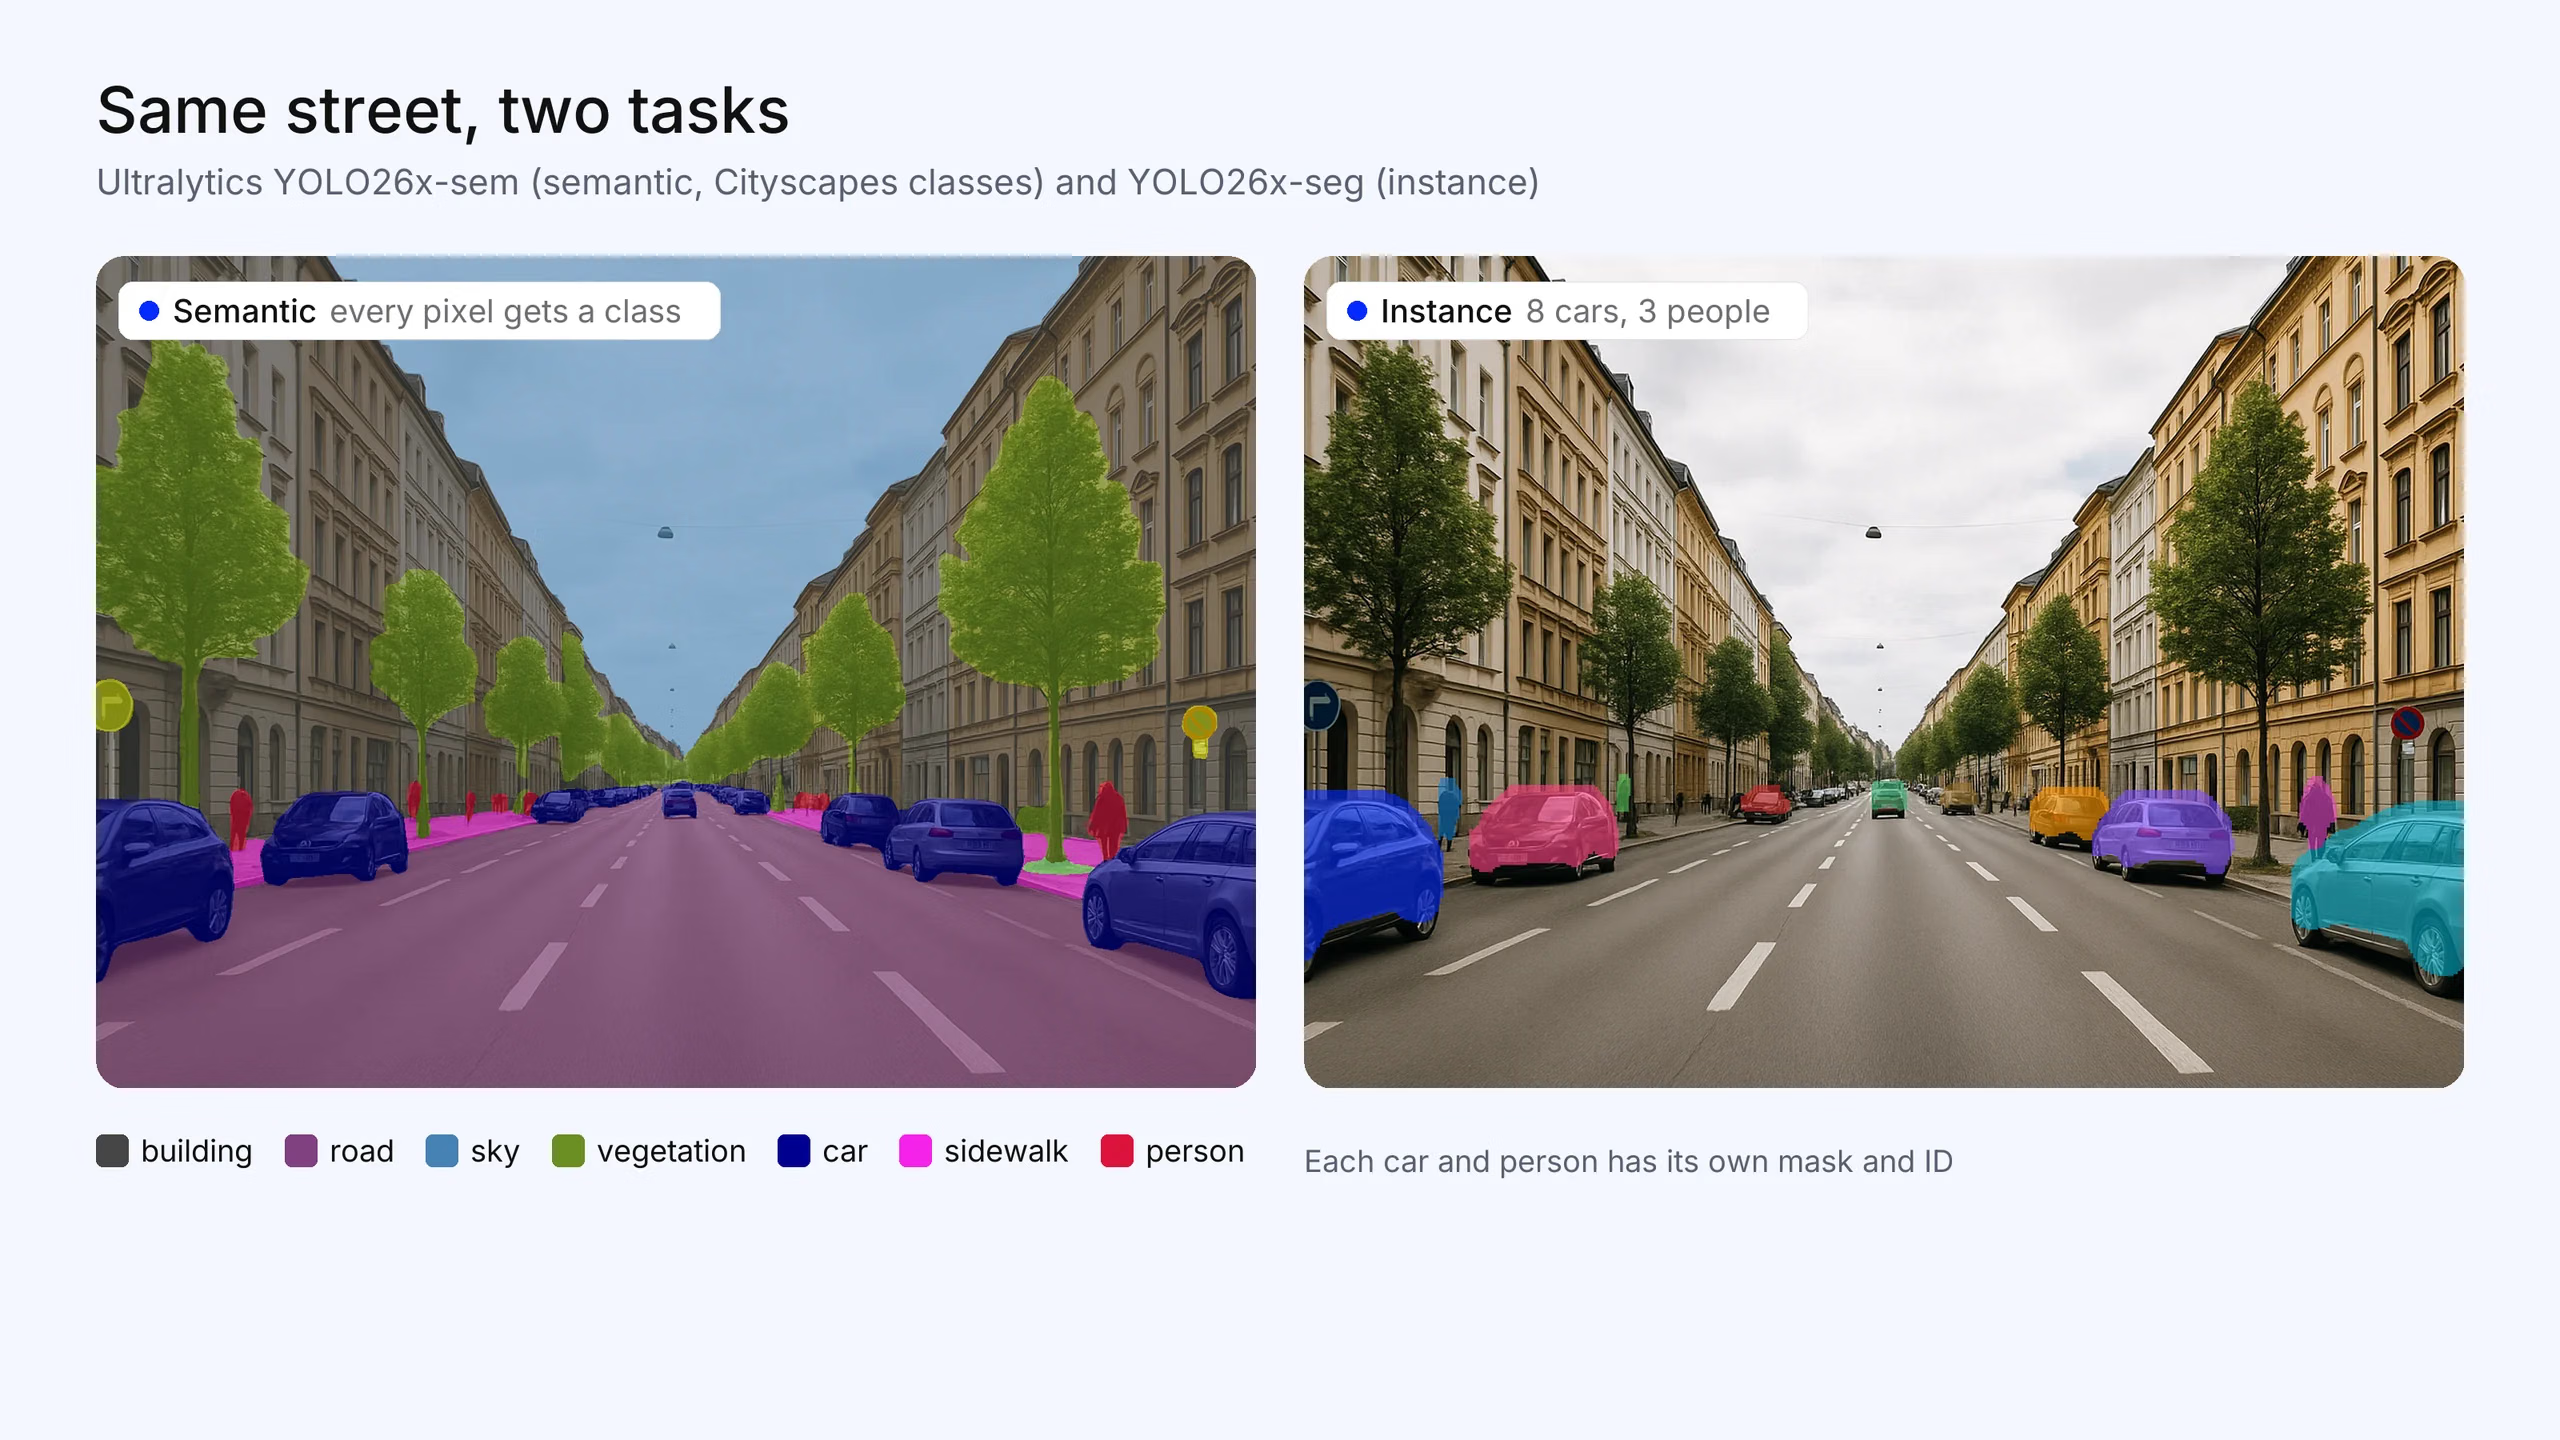
図1. 同じ道路に2つのタスクを適用した例です。Ultralytics YOLO26x-sem(Cityscapesクラス)はすべてのピクセルにラベルを付けるため、すべての車が同じ「車」クラスになります。Ultralytics YOLO26x-segは、検出した車8台と人3人にそれぞれ独自のマスクを付与します(確信度0.5以上)。写真はこの記事用に生成したもので、マスクは実際のモデル出力です。
プロジェクトに必要なタスクはどれですか?#
アプリケーションが答える必要のある問いから考えてください。
| アプリケーションで必要なこと… | 使用するもの | 例 |
|---|---|---|
| シーン内で特定のクラスが占める面積を把握する | セマンティック | 走行可能な道路の領域、作物と雑草の占有率、土地被覆 |
| 物体だけでなく背景領域にも注意深くラベルを付ける | セマンティック | 空、水、植生、スキャン画像内の組織タイプ |
| 物体を数える | インスタンス | 木になっている果実、列に並ぶ人 |
| 動画フレーム間で物体を追跡する | インスタンスとトラッカー | シーン内を移動する人や車両 |
| 物体ごとに計測する、または処理を行う | インスタンス | 山積みの部品から1つをつかむロボット、欠陥ごとのサイズ測定 |
| シーン全体をカバーしながら、個々の物体も分離する | パノプティック | 自動運転向けの道路シーン |
判断に迷う場合は、同じクラスの接触した2つの物体を区別する必要があるか考えてください。必要な場合は、インスタンスセグメンテーション(またはパノプティックセグメンテーション)が必要です。不要な場合は、セマンティックセグメンテーションのほうがシンプルで、通常は実行コストも低くなります。
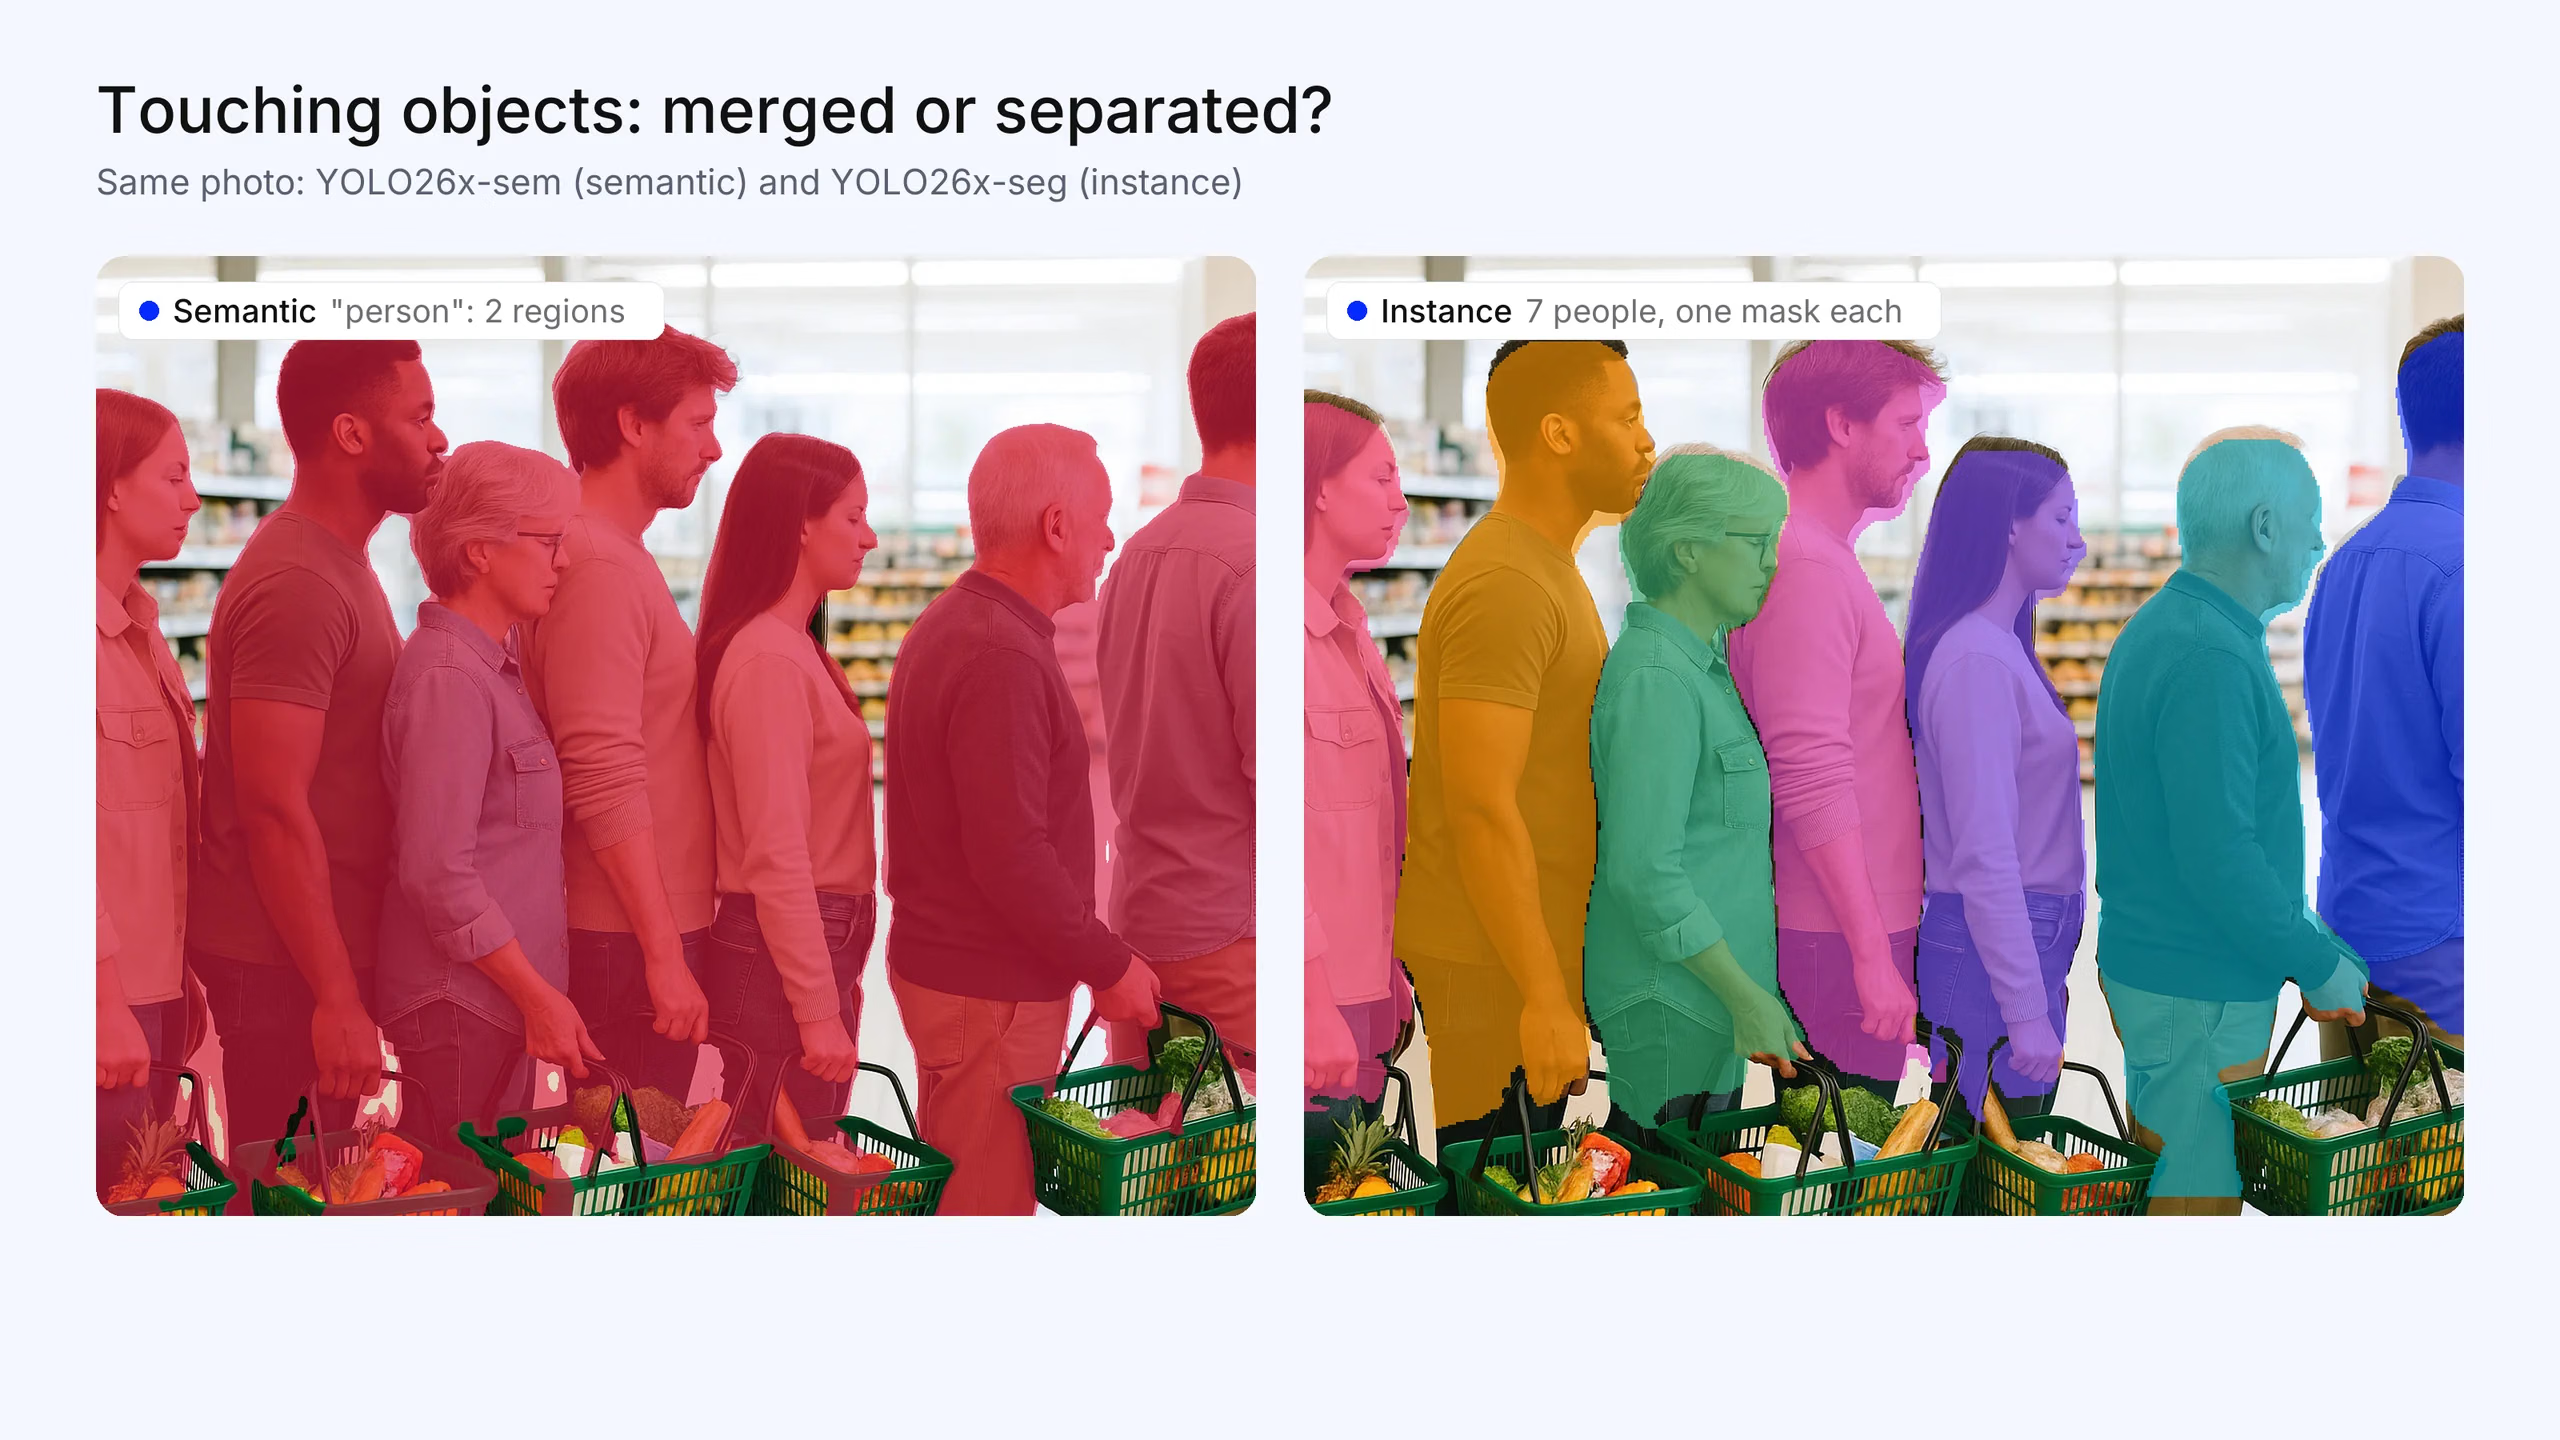
図2. レジ待ち列に近く並んで立つ7人の買い物客。セマンティック出力(Ultralytics YOLO26x-sem)では2つの連結した「人」領域に統合されるため、出力から人数を数えることはできません。インスタンス出力(Ultralytics YOLO26x-seg)では7人全員が分離されます。写真はこの記事用に生成したもので、マスクは実際のモデル出力です。
主な違いの一覧#
| 基準 | セマンティックセグメンテーション | インスタンスセグメンテーション |
|---|---|---|
| 答える問い | 各ピクセルのクラスは何ですか? | 各ピクセルはどの物体に属しますか? |
| 同じクラスの物体 | 1つの領域に統合 | 分離され、それぞれに独自のマスクとIDを付与 |
| カバー範囲 | 背景を含むすべてのピクセル | 通常は対象物体のみ |
| 出力 | 画像と同じサイズのクラスマップ1つ | クラスと確信度を持つマスクのリスト |
| 物体を数えられますか? | 直接はできません | あり |
| 主な指標 | 平均IoU (mIoU) | マスク平均適合率 (mask mAP) |
| 相対的な複雑さ | 低い:ピクセル単位の分類 | 高い:検出と物体ごとのマスク生成 |
各タスクのアノテーションコスト#
実際には、アノテーションの作業量が選択を左右することがよくあります。
- セマンティックデータセットでは、背景を含む画像内のすべてのピクセルにクラスを割り当てます。通常、単一チャンネルのマスク画像として保存されます。各画像に完全なラベル付けが必要なため、「ignore」と明示的に指定しない限り、ピクセルを省略できません。
- インスタンスデータセットでは、対象となる各物体の輪郭をポリゴンまたはマスクとして個別に指定します。背景のラベル付けは省略できますが、すべての物体に個別の輪郭が必要です。また、物体が密集したシーンでは作業量が増えます。
どちらのタスクも労力がかかります。クリックやボックスからマスクを生成するアノテーション支援を利用すれば、どちらのタスクでも作業量を削減できます。領域単位の結果だけが必要な場合は、インスタンスラベルにコストをかける必要はありません。
各タスクの評価方法#
- セマンティックセグメンテーションは主にmIoUで評価します。予測領域と正解領域の重なりをクラス間で平均した値です。ピクセル精度も報告されます。IoUは、物体検出でも使われる同じ重なり指標です。
- インスタンスセグメンテーションはmask mAPで評価します。これは物体検出で使われる平均適合率を、マスクの重なりに基づいて計算した指標です。正しいピクセルを覆うだけでなく、個々の物体を検出することが評価されます。
これらの指標は相互に比較できません。mIoUが高くても、個々の物体が分離されているかどうかは分かりません。
パノプティックセグメンテーション:両方が必要な場合#
パノプティックセグメンテーションでは、すべてのピクセルにクラスを割り当て、数えられる物体にはインスタンスIDも付与します。道路や空などの背景の「stuff」はセマンティックにラベル付けされます。車や人などの前景の「things」は1つずつ分離されます。評価にはパノプティック品質 (PQ) が使われます。シーン全体をカバーしつつ、物体ごとの分離も必要な場合に選択してください。パノプティックセグメンテーションをご覧ください。
各タスクの仕組み:概要#
セマンティックセグメンテーションモデルは通常、すべてのピクセルのクラスを予測するエンコーダー・デコーダーネットワークです。U-Net、DeepLab、SegFormerがよく知られた例です。インスタンスセグメンテーションモデルは、通常、物体検出をベースに構築されます。Mask R-CNNは検出した各ボックス内のマスクを予測し、YOLACTやUltralytics YOLOのセグメンテーションモデルのようなシングルステージモデルは、リアルタイム処理向けに1回の推論でボックスとマスクを予測します。Mask2Formerのような汎用アーキテクチャは、1つのモデルでセマンティック、インスタンス、パノプティックの各セグメンテーションに対応します。インスタンスセグメンテーションの詳細は、インスタンスセグメンテーションとはをご覧ください。
Ultralytics YOLOで両方のタスクに対応#
Ultralytics YOLOは、同じPython APIとCLIで両方のタスクを実行できます。
- インスタンスセグメンテーションでは、
segmentタスクを使用します。 - セマンティックセグメンテーションでは、
semanticタスクを使用します。YOLO26のセマンティックモデルには-semというサフィックスが付き、CityscapesとADE20Kで事前学習されています。タスクのページには、コード上で2つのタスクの出力がどのように異なるかを正確に示す表があります。
どちらも、Ultralytics Platform上でローカルまたはクラウド環境にてトレーニングできます。
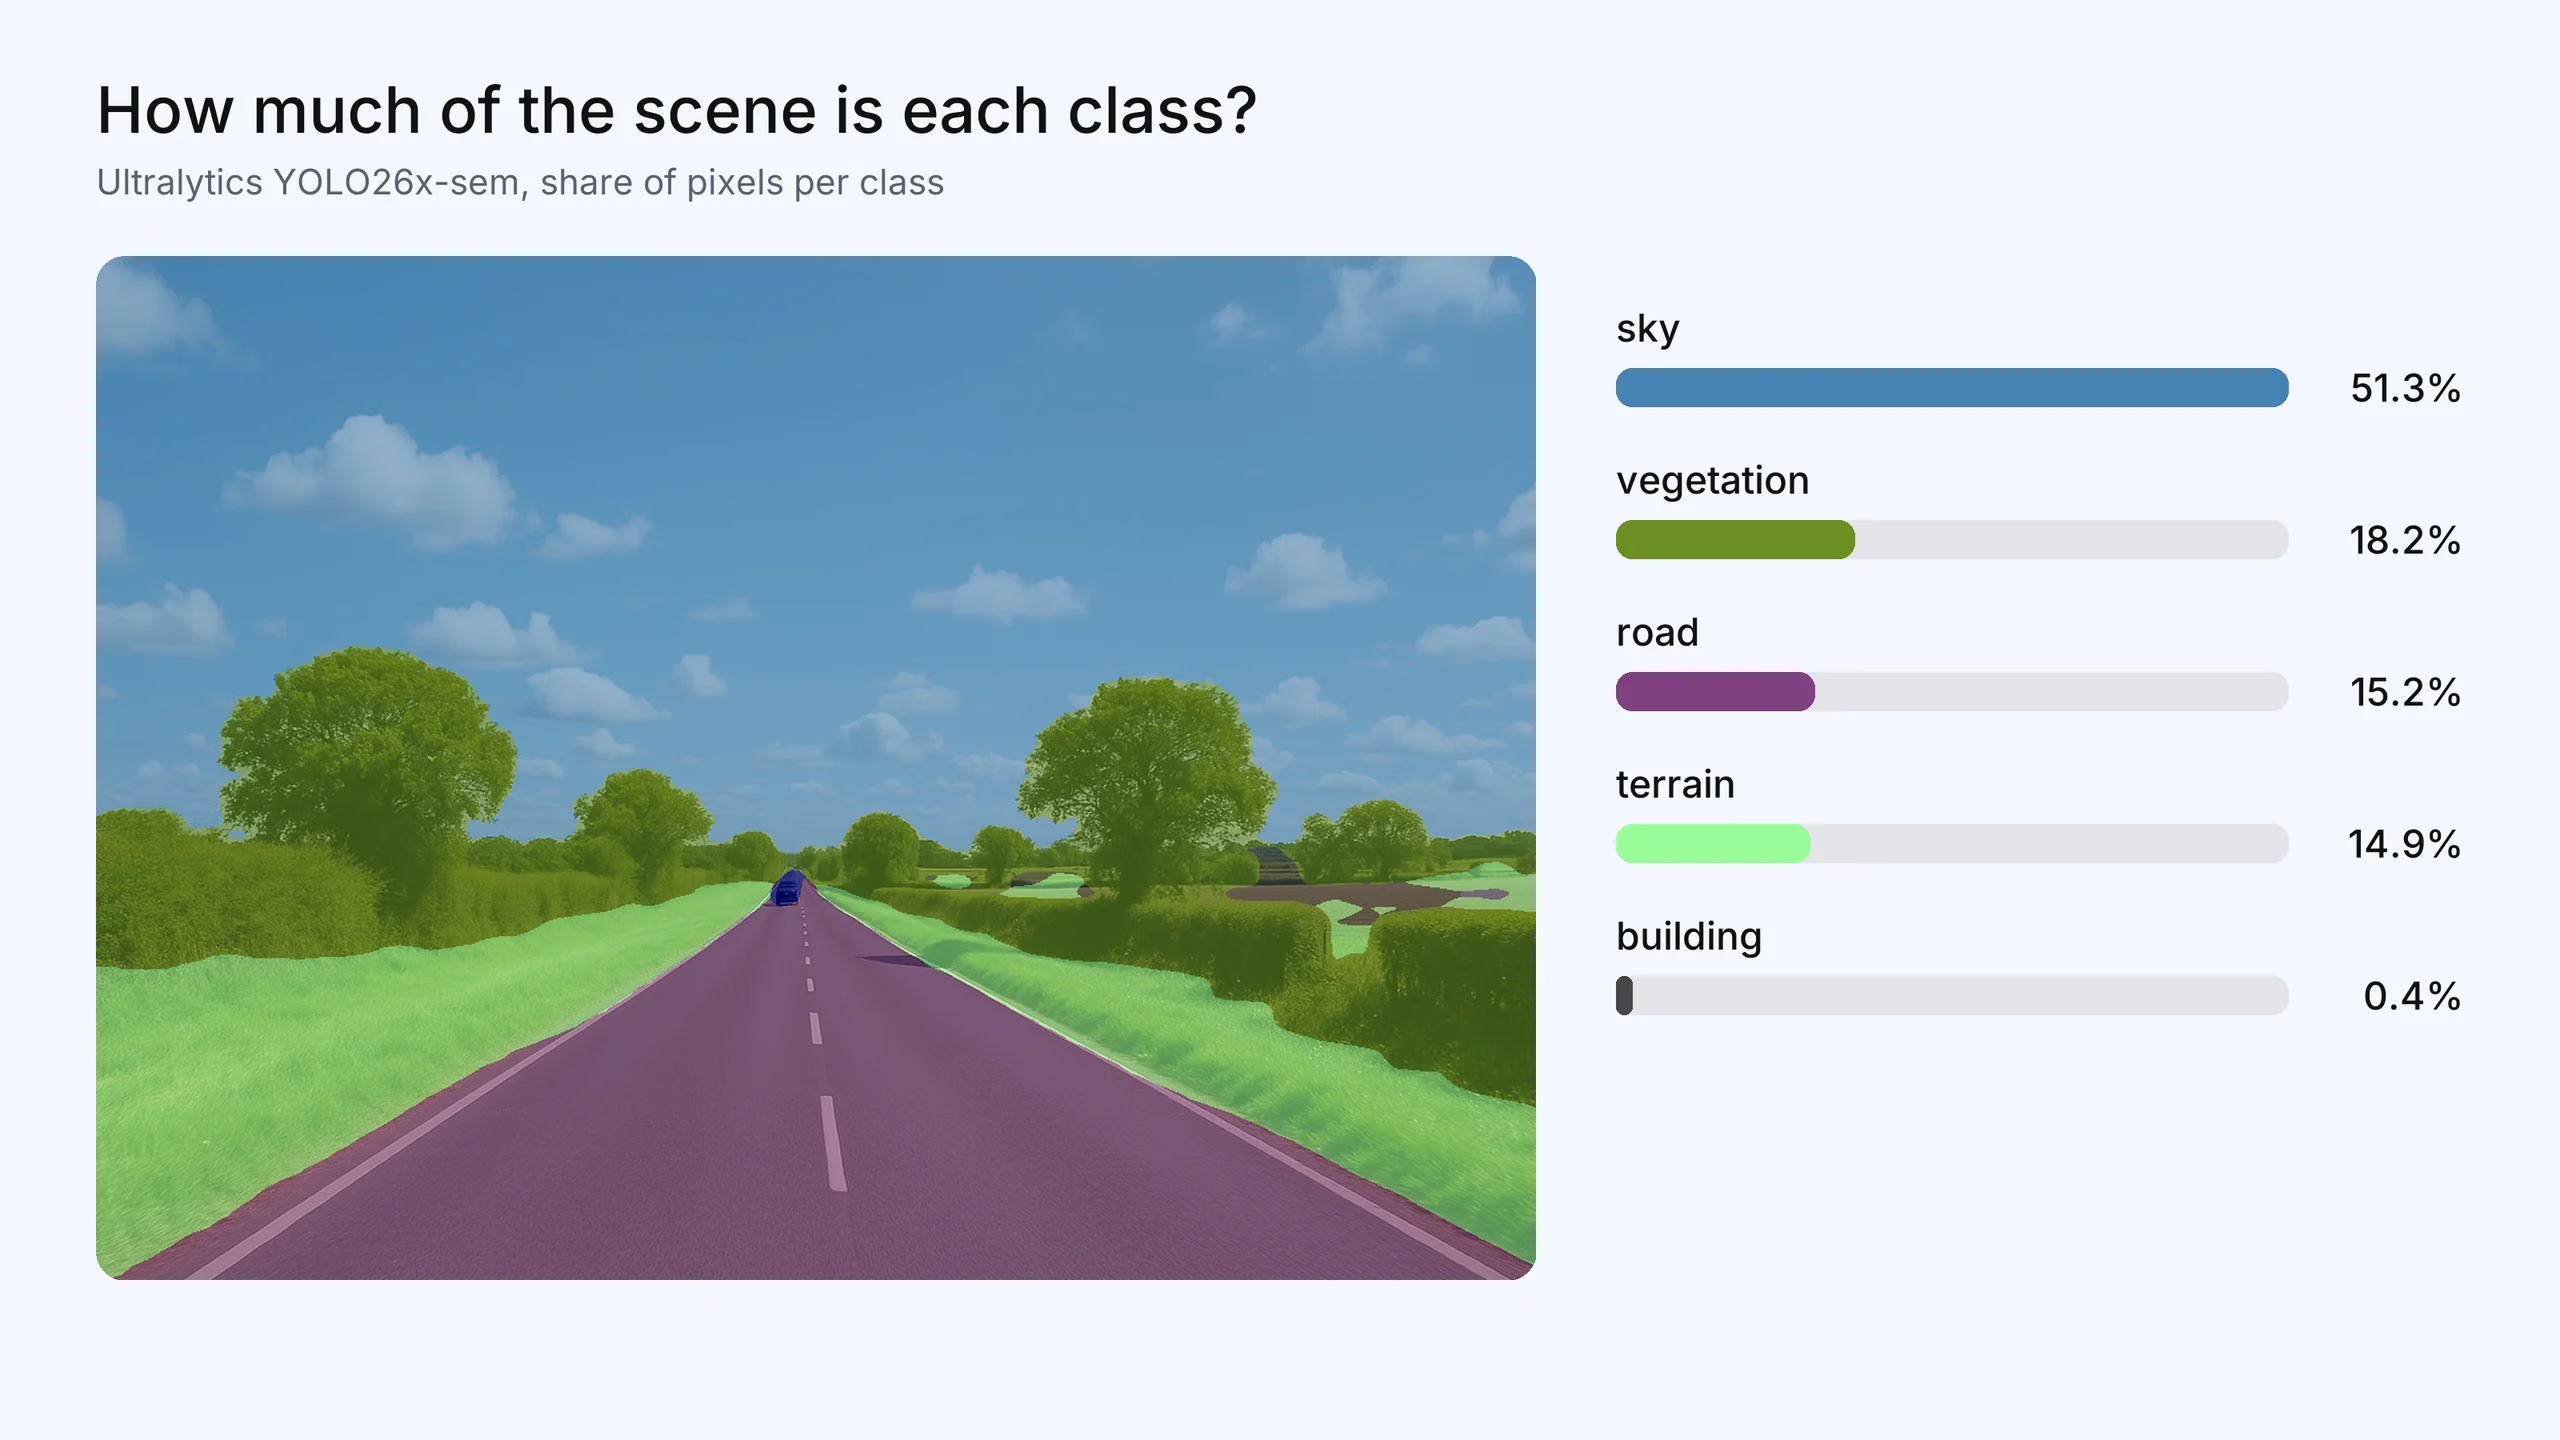
図3. セマンティックセグメンテーションは、「シーン内の各クラスがどれだけの割合を占めているか」に答えます。Ultralytics YOLO26x-semは、この画像の51.3%を空、18.2%を植生、15.2%を道路、14.9%を地面としてラベル付けしています。写真はこの記事用に生成したもので、クラスマップと割合は実際のモデル出力です。
よくある質問
セマンティックセグメンテーションはすべてのピクセルにクラスを割り当てますが、同じクラスの物体はすべて1つの領域として扱います。インスタンスセグメンテーションは各物体を個別のマスクに分けるため、同じクラスの物体を個別にカウントして追跡できます。
同じクラスの接触している2つの物体を区別する必要があるかどうかを考えてください。個々の物体をカウント、追跡、または操作する必要がある場合は、インスタンスセグメンテーションを使用します。どの領域がどのクラスに属するかを知るだけでよい場合は、セマンティックセグメンテーションのほうがシンプルです。
Mask R-CNNはインスタンスセグメンテーションモデルです。各物体を検出し、その後、物体のバウンディングボックス内で個別のピクセルマスクを予測します。
一般に、インスタンスセグメンテーションのほうが難しいです。ピクセルを分類するだけでなく、同じクラスの物体を個別に分ける必要があるため、セグメンテーションだけでなく検出も必要になります。
主に平均交差比(mIoU)で評価します。これは、クラスごとに予測領域と正解領域の重なりを求め、その平均を取る指標です。インスタンスセグメンテーションではマスクmAPを、パノプティックセグメンテーションではパノプティック品質(PQ)を使用します。









