Ultralytics YOLO и NVIDIA Cosmos Data Factory: синтетические данные для обнаружения дефектов
Синтетические данные из NVIDIA Cosmos Data Factory и автоматизированный цикл обучения с агентами и обогащением данными на базе NVIDIA помогают Ultralytics YOLO достигать точности на полном наборе данных, используя лишь часть разметки.
Ultralytics и NVIDIA объединили усилия, чтобы показать, на что способны целевые обучающие данные для Ultralytics YOLO. Цикл обучения с агентами и обогащением данными от NVIDIA определяет, какие изображения нужны модели, NVIDIA Cosmos Data Factory генерирует те, которых ещё нет, а Ultralytics YOLO обучается на полученном наборе. Наша команда машинного обучения (ML) проверила это сочетание на 19 открытых бенчмарках промышленного контроля, сравнив Ultralytics YOLO26, обученную с помощью агентного конвейера NVIDIA и синтетических данных Cosmos Data Factory, с той же моделью, обученной традиционным способом. В этой статье мы рассказываем о результатах.
Больше данных — не всегда решение. Важно подобрать правильные данные.#
Каждой команде, занимающейся инспекцией, знакома такая ситуация. Модель обнаружения дефектов хорошо работает с дефектами, которые часто встречались в обучении, но пропускает редкую царапину, необычное освещение или нестандартный ракурс камеры — именно то, что важнее всего на производственной линии. Обычно проблему решают так: собирают и размечают больше всего подряд. Это медленно, дорого и в основном добавляет изображения, с которыми модель уже хорошо справляется.
Автоматизированное агентное обучение на базе NVIDIA использует другой подход: оно находит конкретные слабые места в наборе данных и устраняет их с помощью уже существующих реальных изображений или синтетических изображений из Cosmos Data Factory, если реальных примеров нет. В сочетании с Ultralytics YOLO это позволяет обучить модель именно на тех данных, которых ей не хватает.
Как работает цикл обучения с обогащением данных от NVIDIA?#
Цикл обучения Ultralytics YOLO с агентами и обогащением данных от NVIDIA — это конвейер улучшения модели, который дополняет цикл обучения и определяет, какие данные нужны модели на следующем этапе:
• Ищет реальные данные. Он просматривает имеющиеся наборы изображений в поисках реальных примеров, которые восполняют конкретные пробелы в обучающей выборке.
• Генерирует синтетические данные. Если реальных примеров нет, он создаёт изображения для редких случаев с помощью Cosmos Data Factory.
• Автоматически размечает данные. Компонент AnomalyGen размечает синтетические изображения, поэтому перед повторным обучением не требуется ручная аннотация.
Основной принцип — целевой подбор данных для повышения эффективности. Цель не просто в том, чтобы обучать модель на меньшем объёме данных. Нужно точно восполнить пробелы в наборе данных, выявив слабые места модели, а затем дообучить её на обогащённой выборке. Если всё сделать правильно, модель часто обучается на меньшем количестве изображений — это побочный эффект, как показывают результаты ниже.
Конвейер подробно проверили на Ultralytics YOLO; все результаты в этой статье получены с помощью Ultralytics YOLO26.
Какую роль играет NVIDIA Cosmos Data Factory#
Cosmos Data Factory — платформа NVIDIA для отбора, обработки и генерации данных, созданная на основе мировых моделей Cosmos. В цикле агентного обучения она генерирует изображения для сценариев, которые недостаточно представлены в реальном наборе данных: например, для определённых типов дефектов в производстве или искажений от объективов «рыбий глаз» на транспортных видеозаписях.
Передача данных проста. Cosmos генерирует изображения для редких случаев, AnomalyGen размечает их, а Ultralytics YOLO повторно обучается на объединённом наборе реальных и синтетических данных с помощью стандартного конвейера обучения Ultralytics.
Проверка Cosmos Data Factory на 19 открытых наборах данных#
Чтобы оценить возможности Cosmos Data Factory + Ultralytics YOLO, наша команда ML запустила конвейер тонкой настройки с агентами и обогащением данных на 19 открытых наборах данных для промышленного контроля: сталь, печатные платы, ткань, металлические поверхности и потребительские товары. Всего в них было около 91 000 обучающих изображений. Для каждого запуска использовался один узел с 8 GPU.
Сравнение намеренно строгое. Базовая модель и модель с Cosmos Data Factory обучались по идентичному сценарию: Ultralytics YOLO26x, 100 эпох, одинаковые оптимизатор, скорость обучения и начальное значение генератора случайных чисел; обе оценивались на одной и той же отложенной тестовой выборке. Различались только изображения, на которых обучалась каждая модель. Базовая модель обучалась на всех размеченных изображениях (а в тесте с синтетическими данными — только на реальных изображениях).
1. Та же точность при использовании лишь части разметки#
На 11 из 19 наборов данных Ultralytics YOLO26x, обученная с помощью агентного конвейера, показала такой же результат, как та же модель, обученная на полном наборе данных. Для этих 11 наборов не понадобилось 53% размеченных изображений.
| набор данных | размечено | использовано | не потребовалось | mAP@0.5 на полном наборе | mAP@0.5 на отобранном наборе |
|---|---|---|---|---|---|
| dagm класс 1 | 1,035 | 90 | 91% | 0.9923 | 0.9998 |
| dagm класс 2 | 1,035 | 90 | 91% | 1.0000 | 0.9999 |
| dagm класс 3 | 1,035 | 90 | 91% | 1.0000 | 0.9987 |
| dagm класс 4 | 1,035 | 90 | 91% | 1.0000 | 0.9991 |
| dagm класс 7 | 2,070 | 180 | 91% | 1.0000 | 0.9995 |
| dagm класс 8 | 2,070 | 178 | 91% | 0.9991 | 1.0000 |
| dagm класс 9 | 2,070 | 180 | 91% | 1.0000 | 0.9992 |
| dagm класс 10 | 2,070 | 180 | 91% | 1.0000 | 1.0000 |
| pcb-defect | 20,924 | 13,903 | 34% | 0.9900 | 0.9893 |
| hripcb | 559 | 414 | 26% | 0.9891 | 0.9754 |
| deeppcb | 1,000 | 900 | 10% | 0.9887 | 0.9885 |
Таблица 1. Наборы данных, на которых Cosmos Data Factory показала результат на уровне модели, обученной на полном объёме данных. mAP@0.5 на одной и той же отложенной выборке.
На наборах DAGM агентный конвейер достиг того же значения mAP@0.5, используя десятую часть разметки, а на двух классах немного превзошёл модель, обученную на полном объёме данных. На pcb-defect он исключил 7 000 из 20 924 изображений, при этом разница в точности оказалась в четыре раза меньше, чем шум от запуска к запуску.
Для команд, которые оплачивают разметку, главный вывод таков: на этих наборах данных большая часть бюджета на разметку ушла на изображения, которые не повлияли на результат.
2. Обучение до 74% быстрее#
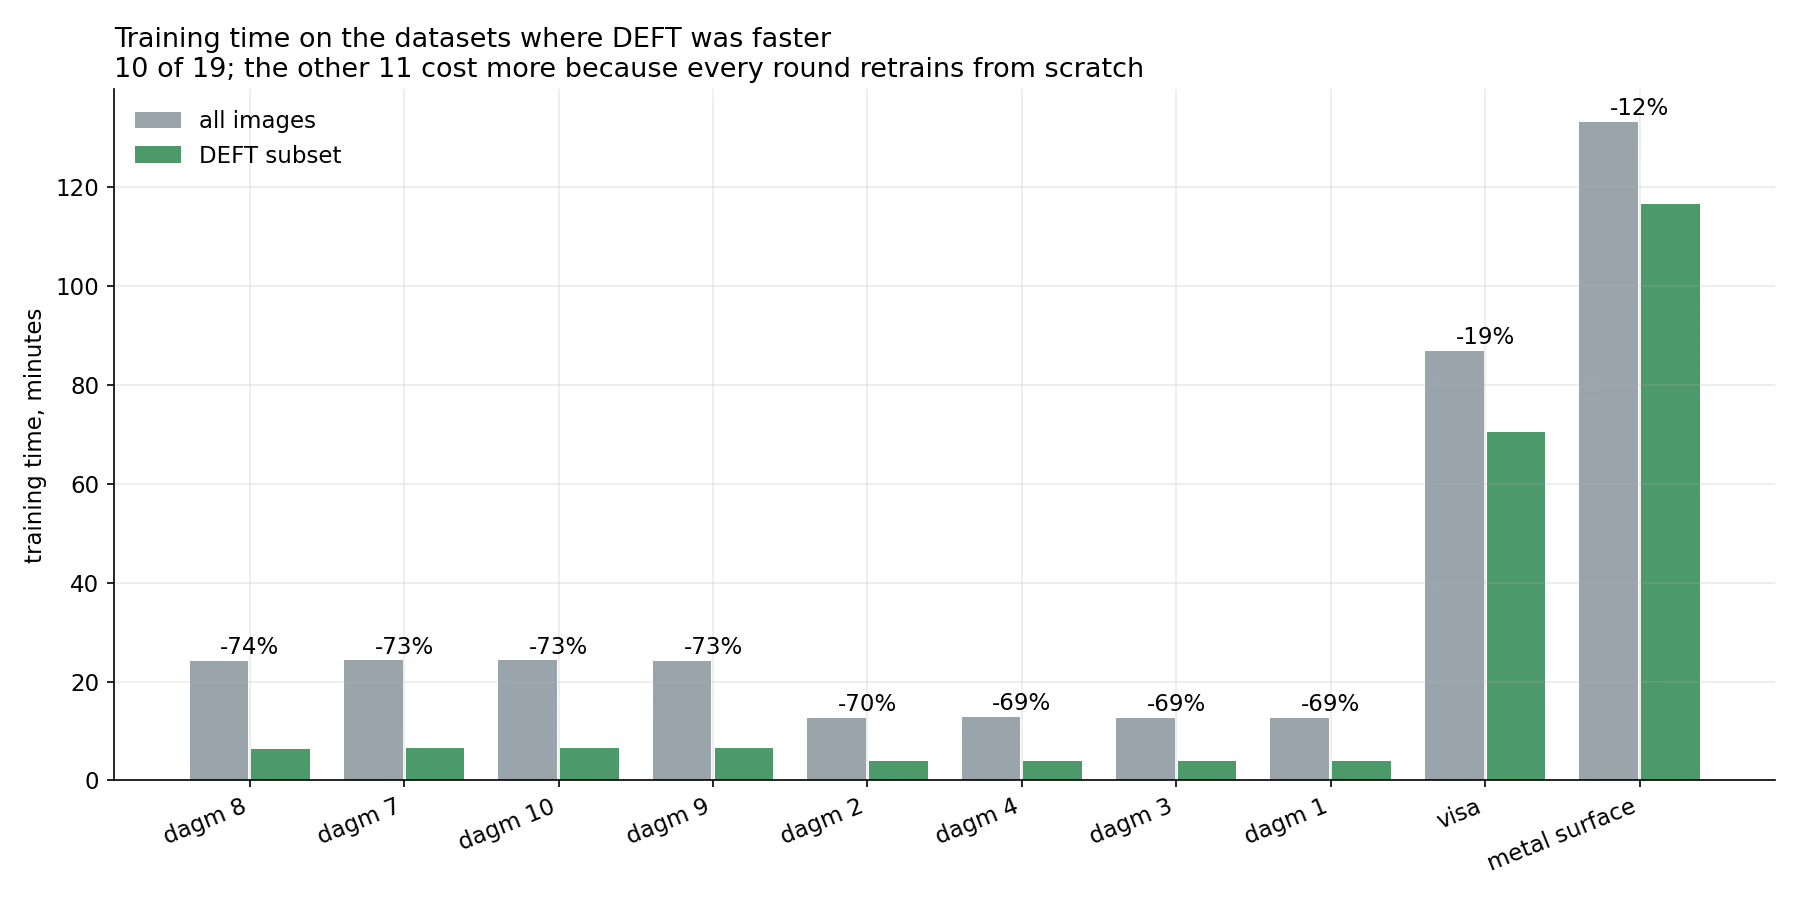
Рисунок 1. Время обучения на полном наборе данных и подмножестве Cosmos Data Factory для наборов, на которых Cosmos Data Factory ускорила обучение.
Обучение Ultralytics YOLO на меньшей, целевой выборке также сокращает вычислительные затраты. На 10 из 19 наборов данных агентный конвейер ускорил обучение. На DAGM время обучения сократилось с 13–24 минут до 4–7 минут, то есть на 69–74%. На более крупных наборах экономия была меньше, но ощутимой: 19% на VisA и 12% на metal-surface-defect.
Экономия достигается не всегда. На остальных девяти наборах агентный конвейер работал дольше, чем один запуск на полном наборе данных, поскольку на каждом цикле отбора модель обучается заново. Если отобранная подвыборка лишь ненамного меньше исходной, дополнительные циклы перевешивают экономию.
3. Сгенерированные дефекты повышают точность рамок#
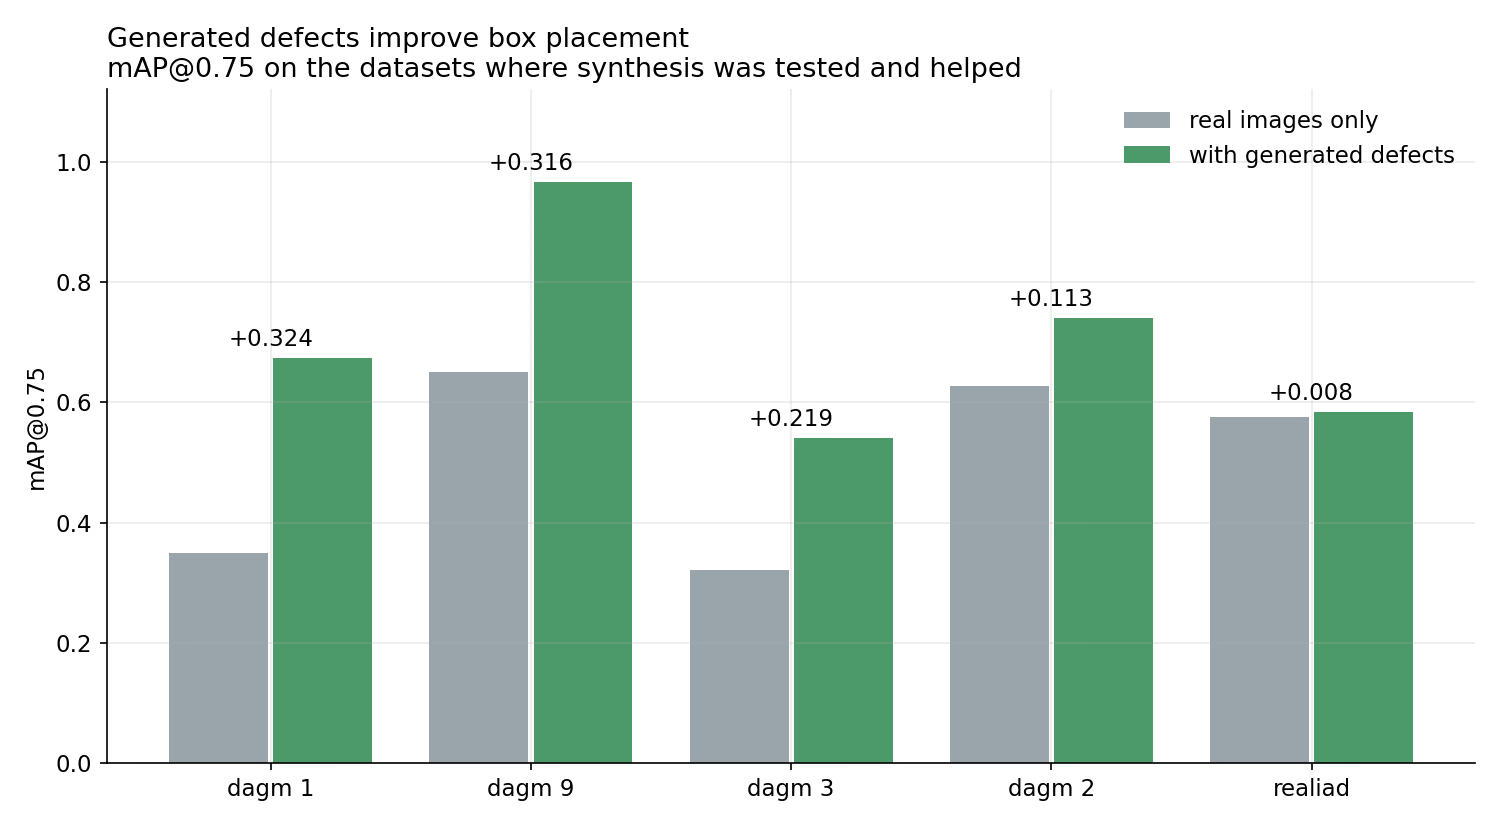
Рисунок 2. mAP@0.75 только на реальных изображениях и с добавлением сгенерированных дефектов для наборов, на которых проверили синтез и получили улучшение.
В третьем тесте отдельно оценивались синтетические данные. Для наборов с полигональной разметкой мы добавили дефекты, сгенерированные Cosmos Data Factory и размеченные AnomalyGen, а затем сравнили полученную модель Ultralytics YOLO с моделью, обученной только на реальных изображениях.
Мы приводим mAP@0.75 — более строгую метрику, чем mAP@0.5: предсказание засчитывается, только если рамка перекрывает истинный дефект не менее чем на 75%. Эта метрика показывает, насколько точно модель определяет местоположение дефекта, а не просто обнаруживает его. Добавление сгенерированных дефектов повысило mAP@0.75 на 0.11–0.32 для классов DAGM, а полнота выросла на каждом проверенном наборе данных. Наибольший прирост показал DAGM класс 9: с 0.650 до 0.966. На Real-IAD прирост был незначительным (+0.008).
Дефекты по своей природе встречаются редко, поэтому реальных примеров каждого их типа всегда мало. Генерация уже размеченных примеров позволяет Ultralytics YOLO изучать точную форму и размер дефекта без ручной обводки полигона.
Сколько синтетических данных использовалось#
Генерация проходит в три этапа. Сначала Cosmos Data Factory находит на реальных изображениях правдоподобные места для дефектов (размещено), затем генератор создаёт изображения дефектов в этих местах (сгенерировано), и только заданное предельное количество изображений попадает в обучающую выборку (оставлено). Мы проверили два ограничения: синтетические изображения составляли 25% или 100% от количества реальных изображений в обучающей выборке.
За 18 циклов генерации (9 базовых и 9 синтетических) конвейер создал 11 448 изображений. В выборку попало лишь 1 481 из них — примерно каждое восьмое. Таким образом, предельное количество определяло объём синтетических данных, которые получала каждая модель Ultralytics YOLO, а не количество изображений, созданных генератором. При ограничении в 100% на каждое реальное изображение в обучающей выборке приходилось одно синтетическое; при 25% — примерно одно синтетическое на четыре реальных. В абсолютных числах объёмы невелики: для DAGM это 90–180 реальных изображений и не более такого же количества синтетических.
| набор данных | ограничение | размещено | сгенерировано | отклонено | оставлено | реальные | соотношение |
|---|---|---|---|---|---|---|---|
| dagm класс 1 | 25% | 870 | 440 | 0 | 22 | 90 | 1 : 0.24 |
| dagm класс 1 | 100% | 870 | 400 | 0 | 90 | 90 | 1 : 1.00 |
| dagm класс 2 | 25% | 606 | 254 | 0 | 22 | 90 | 1 : 0.24 |
| dagm класс 2 | 100% | 606 | 304 | 0 | 90 | 90 | 1 : 1.00 |
| dagm класс 3 | 25% | 900 | 370 | 0 | 22 | 90 | 1 : 0.24 |
| dagm класс 3 | 100% | 900 | 370 | 0 | 90 | 90 | 1 : 1.00 |
| dagm класс 9 | 100% | 1,800 | 620 | 0 | 180 | 180 | 1 : 1.00 |
| realiad | 25% | 9,534 | 4,440 | 0 | 193 | 772 | 1 : 0.25 |
| realiad | 100% | 9,534 | 4,250 | 0 | 772 | 772 | 1 : 1.00 |
| Итого | 11,448 | 0 | 1,481 |
Таблица 2. Количество сгенерированных изображений и соотношение реальных и синтетических изображений по данным записей о генерации и добавлении в выборку для каждого запуска.
Что это значит для команд, создающих модели для инспекции#
Для команд, которые уже обучают Ultralytics YOLO, Cosmos Data Factory и автоматизированное агентное обучение на базе NVIDIA вписываются в привычный рабочий процесс: те же модели, тот же сценарий обучения, но более подходящие данные.
• Покрывай редкие случаи, которые невозможно собрать. Автоматически размеченные синтетические дефекты помогают Ultralytics YOLO определять местоположение дефектов, для которых мало реальных примеров.
• Направляй бюджет на разметку туда, где он важнее всего. Более чем на половине проверенных наборов большинство меток оказались избыточными. Целевой отбор помогает находить важные изображения.
• Ускоряй итерации. Меньшие, тщательно отобранные обучающие выборки сокращают время обучения Ultralytics YOLO и ускоряют эксперименты на многих наборах данных.
Доступность#
Этап синтетической генерации на основе Cosmos сейчас доступен в виде примера и демонстрации и пока не входит в выпущенную интеграцию.
Чтобы попробовать Cosmos Data Factory со своими моделями Ultralytics YOLO, свяжись с командами Ultralytics. Мы продолжим сотрудничать с NVIDIA по мере подготовки этапа синтетической генерации к полноценной интеграции.
Приложение: настройка тестирования и наборы данных#
Все запуски: Ultralytics YOLO26x, 100 эпох, одинаковые оптимизатор, скорость обучения и начальное значение генератора случайных чисел для базовой модели и Cosmos Data Factory; один узел с 8 GPU; одна и та же отложенная тестовая выборка для каждого набора данных. На 11 наборах с полигональной разметкой можно использовать сгенерированные дефекты.
| набор данных | обучающие изображения | аннотация | источник |
|---|---|---|---|
| dagm классы 1, 2, 3, 4 | 1 035 каждый | полигон | DAGM 2007 |
| dagm классы 7, 8, 9, 10 | 2 070 каждый | полигон | DAGM 2007 |
| pcb-defect | 20,924 | рамка | PCB defect |
| dspcbsd | 6,575 | рамка | DsPCBSD+ |
| deeppcb | 1,000 | рамка | DeepPCB |
| hripcb | 559 | рамка | HRIPCB |
| metal-surface-defect | 11,845 | рамка | NEU surface defect |
| tianchifabric | 10,332 | рамка | Tianchi fabric |
| severstal | 10,061 | полигон | Severstal steel |
| mvtec-ad | 4,637 | рамка | MVTec AD |
| visa | 7,794 | полигон | VisA |
| realiad-bottle-cap | 3,581 | полигон | Real-IAD |
| трещина | 1,290 | рамка | сегментация трещин |
Таблица 3. 19 наборов данных (DAGM учитывается как восемь наборов — по одному на класс).









