Как выбрать VLM для автоматической разметки по точности и полноте
Выбирай VLM для автоматической разметки по точности и полноте: какие модели оставляют меньше лишних рамок, пропускают меньше объектов и как проверить их на собственных данных.
 Sergiu Waxmann14 мин. чтения
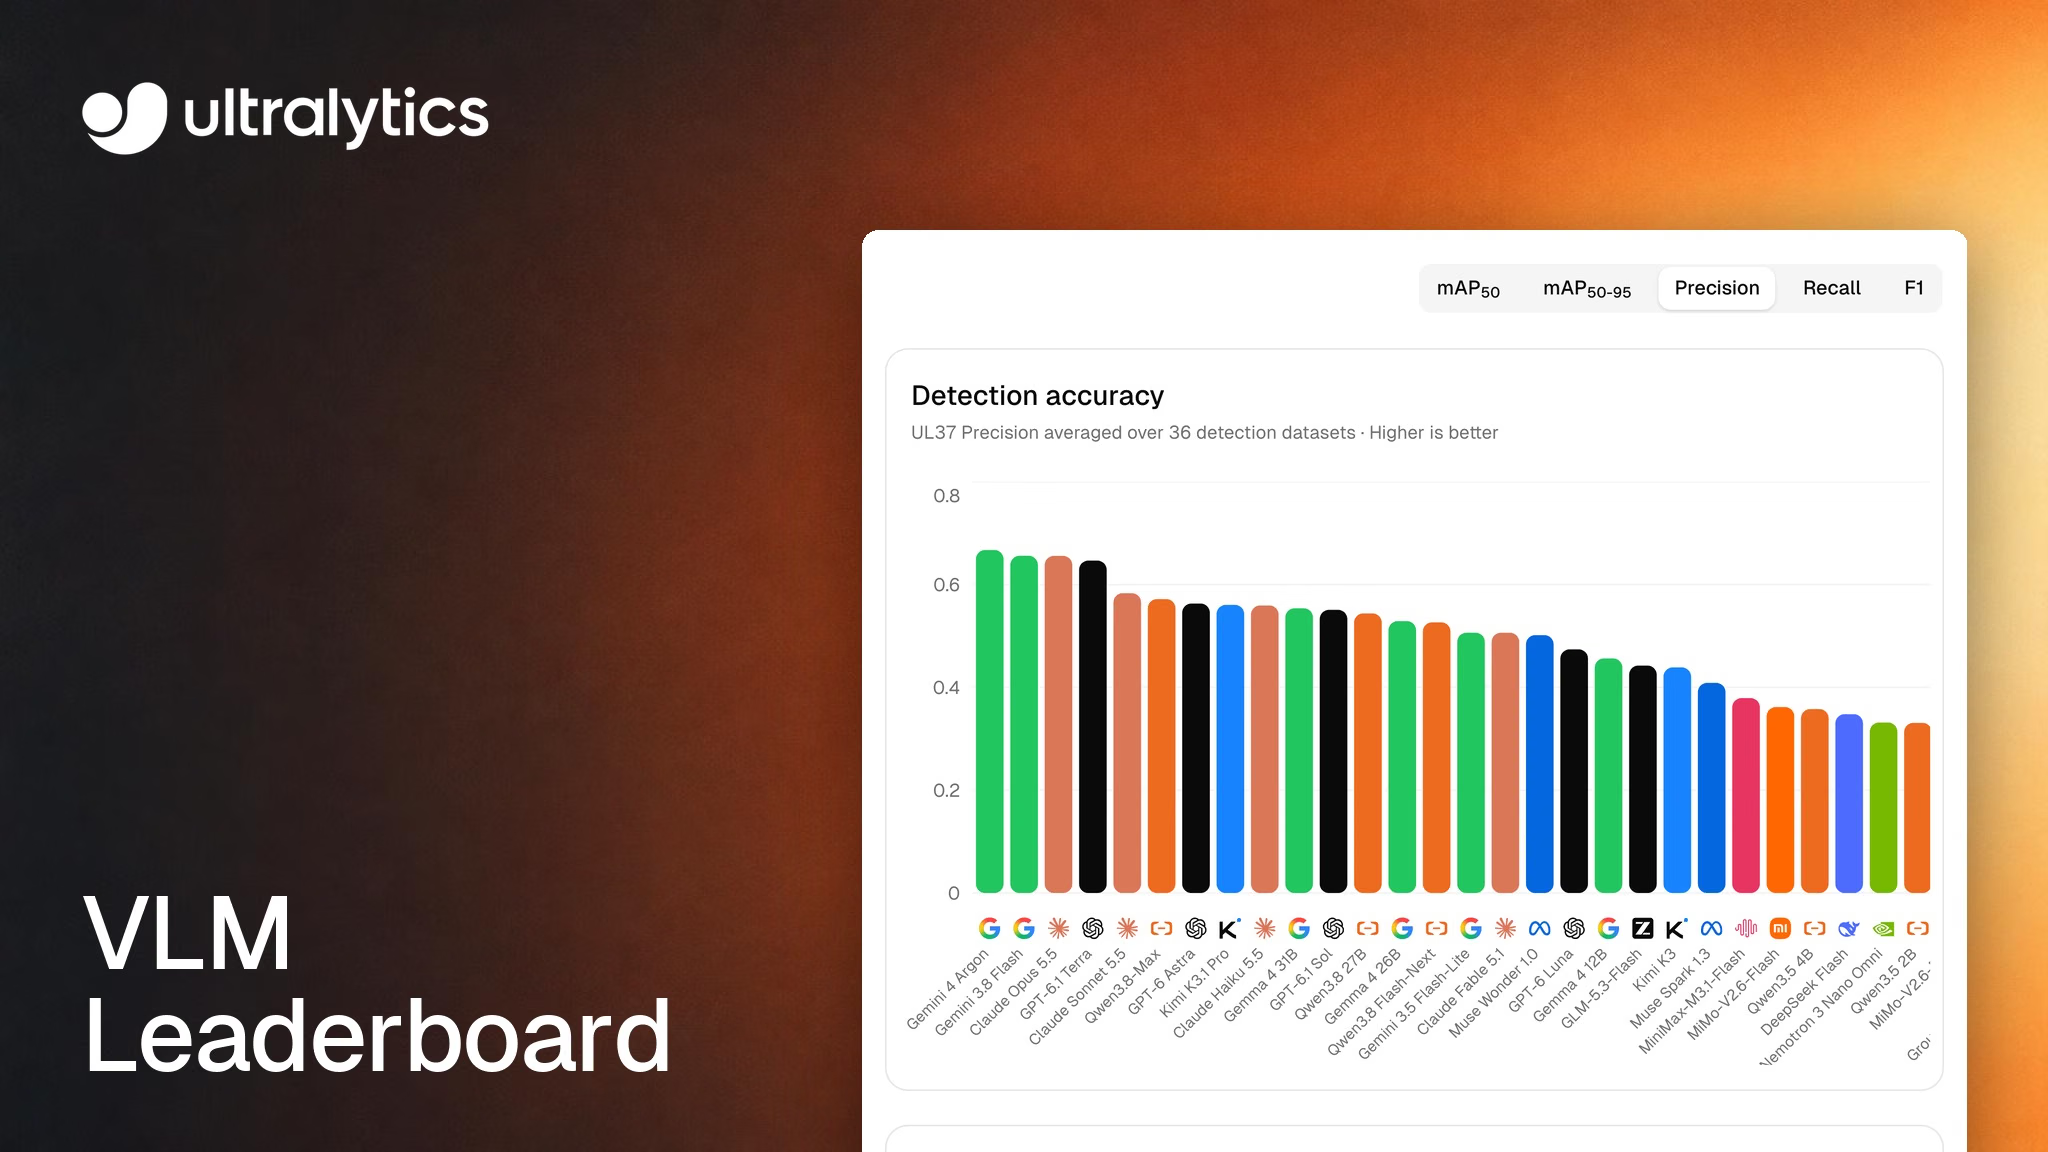
Выбор модели для автоматической разметки датасета зависит от того, какую работу по исправлению ошибок предпочитают выполнять проверяющие: удалять лишние рамки или добавлять пропущенные моделью. Теперь таблица лидеров Ultralytics VLM показывает этот компромисс для каждой модели с помощью точности (доли правильных рамок модели) и полноты (доли размеченных объектов, которые она находит) на основе результатов бенчмарка, опубликованных 28 октября 2026 года.
Чтобы получить самые чистые черновые разметки, начни с Gemini 4 Argon. Чтобы пропустить как можно меньше объектов, начни с GPT-6 Astra. Для оптимального баланса и самой низкой стоимости среди шести моделей с наивысшими оценками выбери GPT-6.1 Terra. Если у тебя нет собственного API-ключа поставщика ИИ, начни с размещённой в облаке Qwen3.8 27B или SAM 3.1 Text для переполненных сцен, в которых лишние рамки лучше удалить.
В этом руководстве объясняется, как читать показатели, для каких задач подходит каждая модель и как проверить свой выбор на собственных изображениях. Рейтинги и цены меняются после каждого запуска, поэтому воспринимай приведённые здесь цифры как примеры за октябрь 2026 года и проверяй актуальные результаты в таблице лидеров.
У моделей с подсказкой по классам нет регулятора уверенности, поэтому выбор модели и есть выбор порога#
С моделью Ultralytics YOLO в редакторе разметки ты сам настраиваешь компромисс. Повышаешь порог уверенности — получаешь меньше ложных рамок, но больше пропусков; понижаешь — и всё наоборот. Модели визуально-языкового взаимодействия (VLMs) с подсказкой по классам работают иначе. Как объясняется в документации редактора разметки, они обнаруживают классы твоего датасета, используя пороги, специфичные для каждой модели, и не возвращают оценки уверенности. Поэтому Ultralytics Platform скрывает настройки уверенности и IoU, пока выбрана такая модель.
Из-за этого меняется смысл точности и полноты в таблице лидеров. Согласно методологии бенчмарка, точность и полнота учитывают каждую рамку, возвращённую моделью при IoU 0,5, без скрытой рабочей точки. Эти показатели описывают рамки, которые на самом деле получают рецензенты.
В основе таблицы лидеров лежит бенчмарк UL37 v2: по 10 изображений из каждого из 36 реальных датасетов обнаружения объектов на Platform, а также 10 эталонных изображений COCO 2017, оцениваемых отдельно, — всего 370 изображений и 7 268 рамок. Каждое изображение проходит через тот же производственный конвейер, что и Smart и Batch Annotation, с названиями классов из самого датасета; SAM 3.1 уточняет рамки каждой модели, кроме SAM 3. Оценка выполняется с помощью собственных метрик обнаружения объектов пакета Ultralytics — того же кода, который проверяет модели YOLO; каждый датасет имеет одинаковый вес при вычислении среднего.
Точность отражает число несопоставленных рамок, полнота — число несопоставленных объектов#
Точность — это доля рамок модели, которые при IoU 0,5 соответствуют размеченному объекту правильного класса. Полнота — это доля размеченных объектов, которые нашла модель. С точки зрения проверки:
- Низкая точность означает больше рамок, которые нужно удалить, переметить или изменить в размере, чтобы они соответствовали объектам.
- Низкая полнота означает больше размеченных объектов, для которых нужно добавить рамку, изменить её размер или переметить объект.
- F1 — это гармоническое среднее двух показателей, 2 x P x R / (P + R), то есть одно число, объединяющее их. Оно не измеряет продолжительность проверки.
- mAP50 и mAP50-95 ранжируют модели по средней точности для разных классов при IoU 0,5 и при более строгих порогах от 0.50 до 0.95. В таблице лидеров сортировка выполняется по mAP50.
Вот шесть моделей с показателем mAP50 выше 0,51. Стоимость рассчитана на основе заявленного провайдерами расхода токенов на 1 000 успешно размеченных изображений из бенчмарка, а задержка — это медианное время запроса:
| Модель | mAP50 | mAP50-95 | Прецизионность | Полнота | F1 | Стоимость у провайдера / 1 000 изображений (расход в бенчмарке) | Задержка |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*Оценка стоимости Gemini 4 Argon основана на вступительных ценах Google, действующих до 30 ноября 2026 года. С 1 декабря стандартный тариф Google удвоится и составит около $15 за 1 000 изображений при том же расходе. Batch Annotation на Ultralytics Platform стоит $1.00 за 1 000 обработанных изображений для любой модели, включая размещённые.
Шесть моделей делятся на два лагеря. Argon, Opus 5.5 и Gemini 3.8 Flash показывают точность от 0,66 до 0,67, но полноту ниже 0,60: большая доля их рамок соответствует объектам, однако они находят меньшую долю размеченных объектов. Astra и Sol достигают полноты от 0,62 до 0,63 при точности от 0,55 до 0,56: они находят большую долю размеченных объектов, но меньшая доля их рамок соответствует объектам. Terra находится между этими группами и лидирует по mAP50 и F1.
Отдавай приоритет точности, если исправлять лишние рамки дорого#
Gemini 4 Argon показывает наивысшую общую точность среди 40 моделей бенчмарка — 0,667. Компромисс — средняя полнота 0,585, ниже, чем у лидеров по полноте.
Точность важнее всего, когда несопоставленные рамки сложно заметить. На загруженном изображении рецензенту приходится находить неправильную рамку среди множества правильных, прежде чем исправить её. Плотные полки магазинов из SKU110K показывают, насколько сильно может меняться точность на таких изображениях: в наших результатах GPT-6.1 Terra Terra показала точность 0,79 и полноту 0,73, тогда как у GPT-6.1 Sol эти показатели составили 0,49 и 0,77.
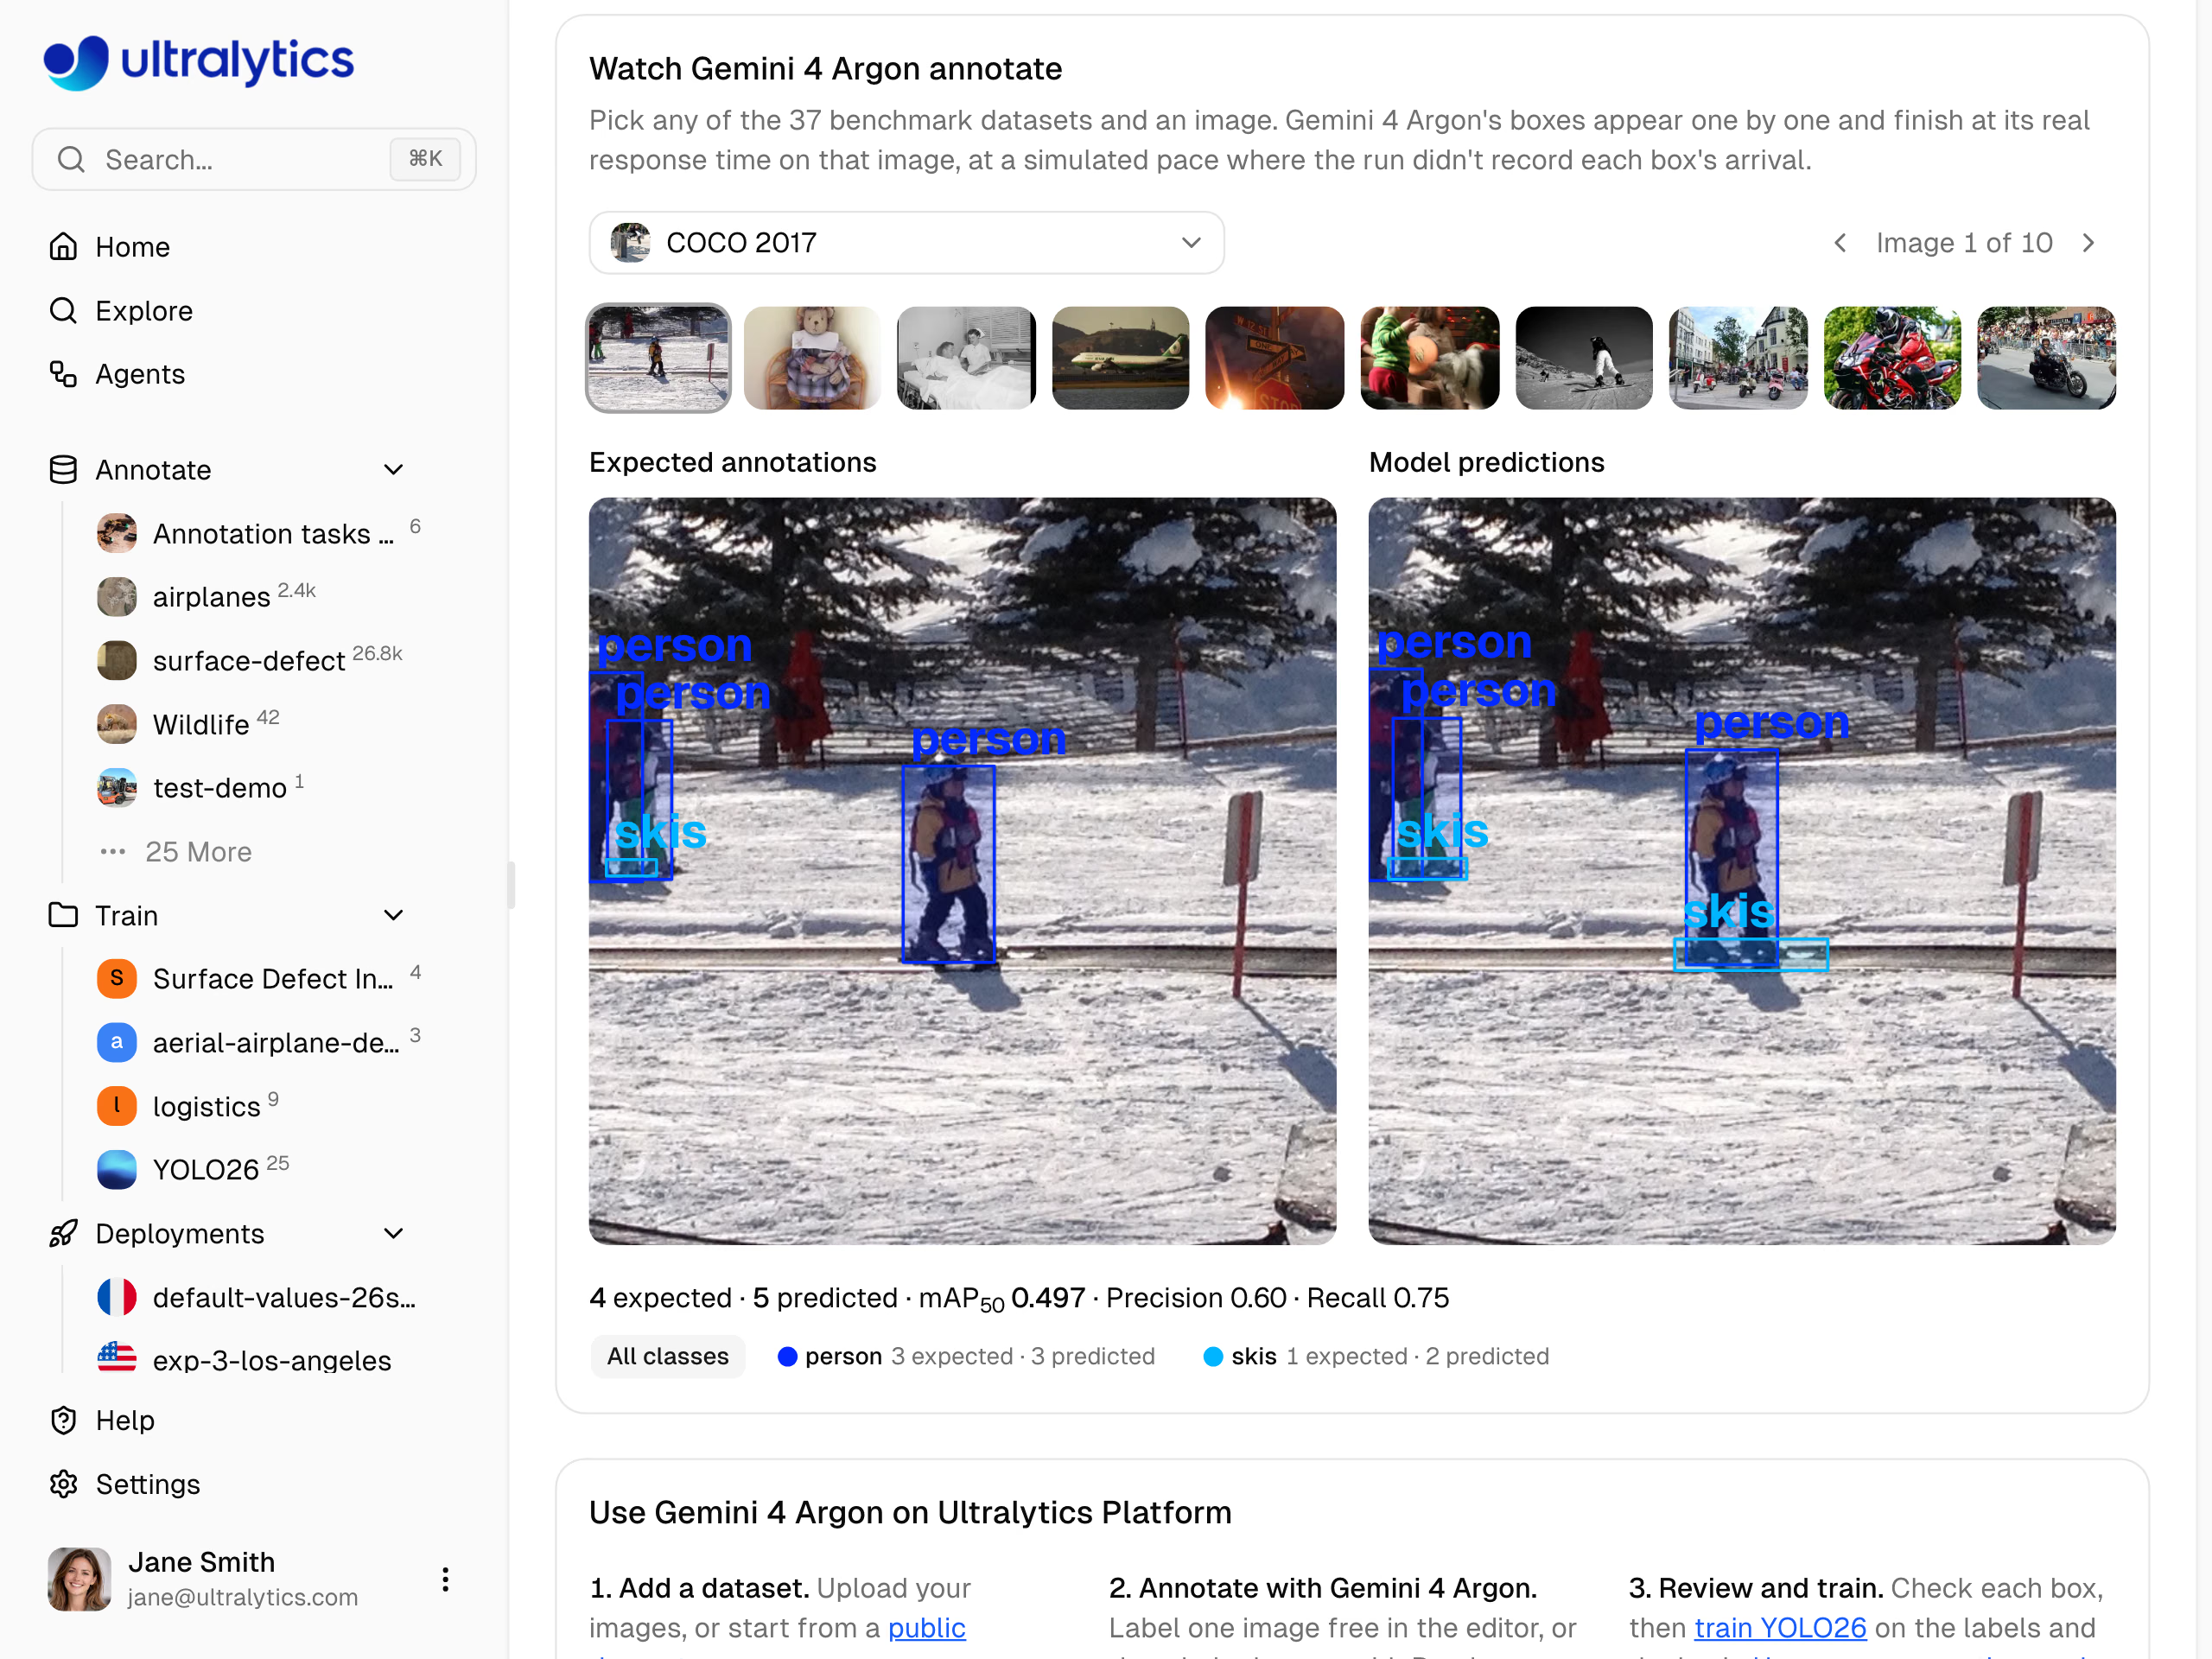
Gemini 4 Argon: предсказано 5 рамок для 4 размеченных объектов, точность 0,60, полнота 0,75.
В бенчмарке у Argon также не было неудачных запросов, а медианное время в 4,6 секунды — самое быстрое среди двух лидеров. Выбирай Argon, если твои данные похожи на те области, где модель показывает лучшие результаты: аэрофотосъёмка, подводные, тепловизионные изображения и рентгеновские снимки для досмотра (у неё лучший mAP50 на наборах рентгеновских снимков для досмотра IEDXray — 0,298), и если твоя команда предпочитает добавлять несколько пропущенных объектов, а не выискивать лишние рамки.
Отдавай приоритет полноте, если пропуск объекта обходится дорого#
GPT-6 Astra показывает самую высокую среднюю полноту в таблице — 0,627. За это приходится платить точностью 0,56.
Разметка с приоритетом полноты имеет смысл, когда пропущенный объект обходится дороже. Пропущенный дефект или поражение на снимке в обучающей выборке учит детектор считать этот объект фоном, а поиск пропущенной рамки означает, что нужно просматривать каждое изображение в поисках того, что не размечено. Astra показывает лучший mAP50 на 7 из 36 датасетов, включая рентгеновские снимки грудной клетки из TBX11K (0,330), рентгеновские снимки запястий детей из GRAZPEDWRI-DX (0,354) и дефекты поверхности печатных плат из DsPCBSD+ (0,394): это повод проверить её на похожих данных, но не доказательство того, что на твоих данных она пропускает меньше объектов.
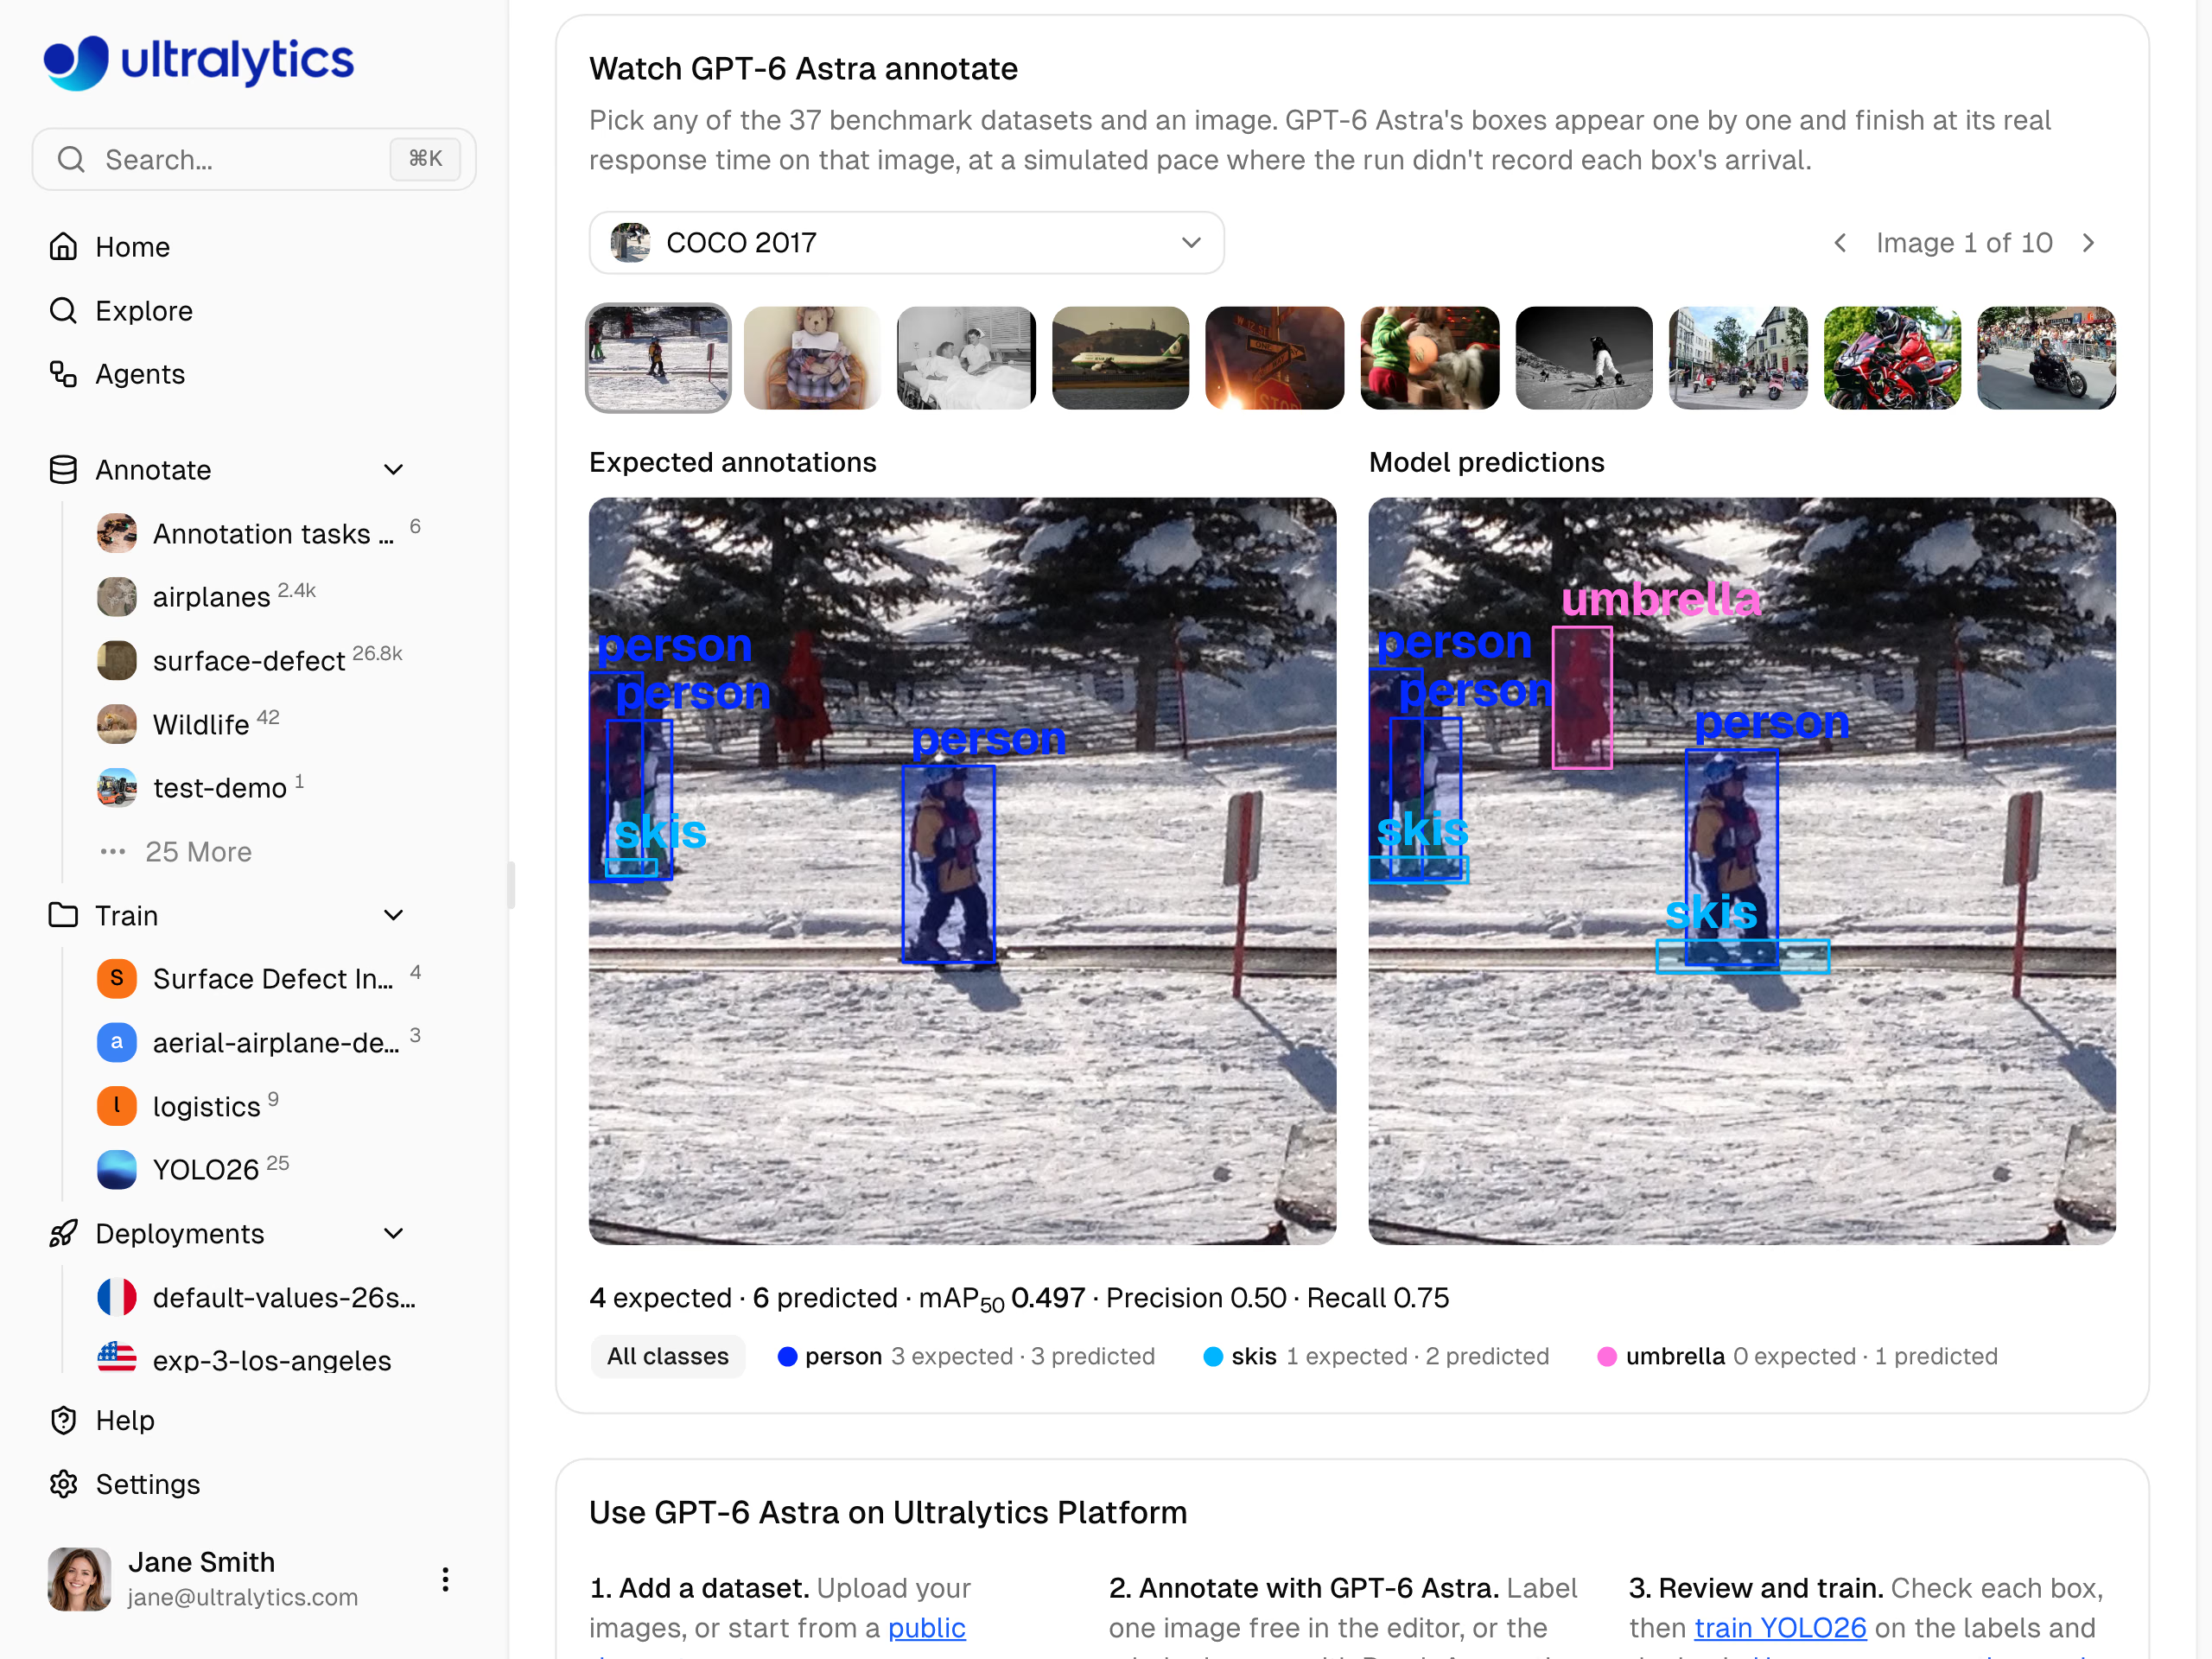
GPT-6 Astra: 6 рамок для тех же 4 объектов, включая зонт, отсутствующий в разметке COCO; точность — 0,50, полнота — 0,75.
У Astra самая высокая оценка стоимости среди шести лидеров — $49.31 за 1 000 изображений; медианное время составляет 11,6 секунды, а запросы завершаются с ошибкой для 1% изображений. По полноте близки к ней две другие модели OpenAI: у GPT-6.1 Sol показатель составляет 0,62 при оценке стоимости $10.30, а у GPT-6.1 Terra — 0,61 при оценке $4.36.
Учитывай оба типа ошибок с помощью mAP50-95 и F1#
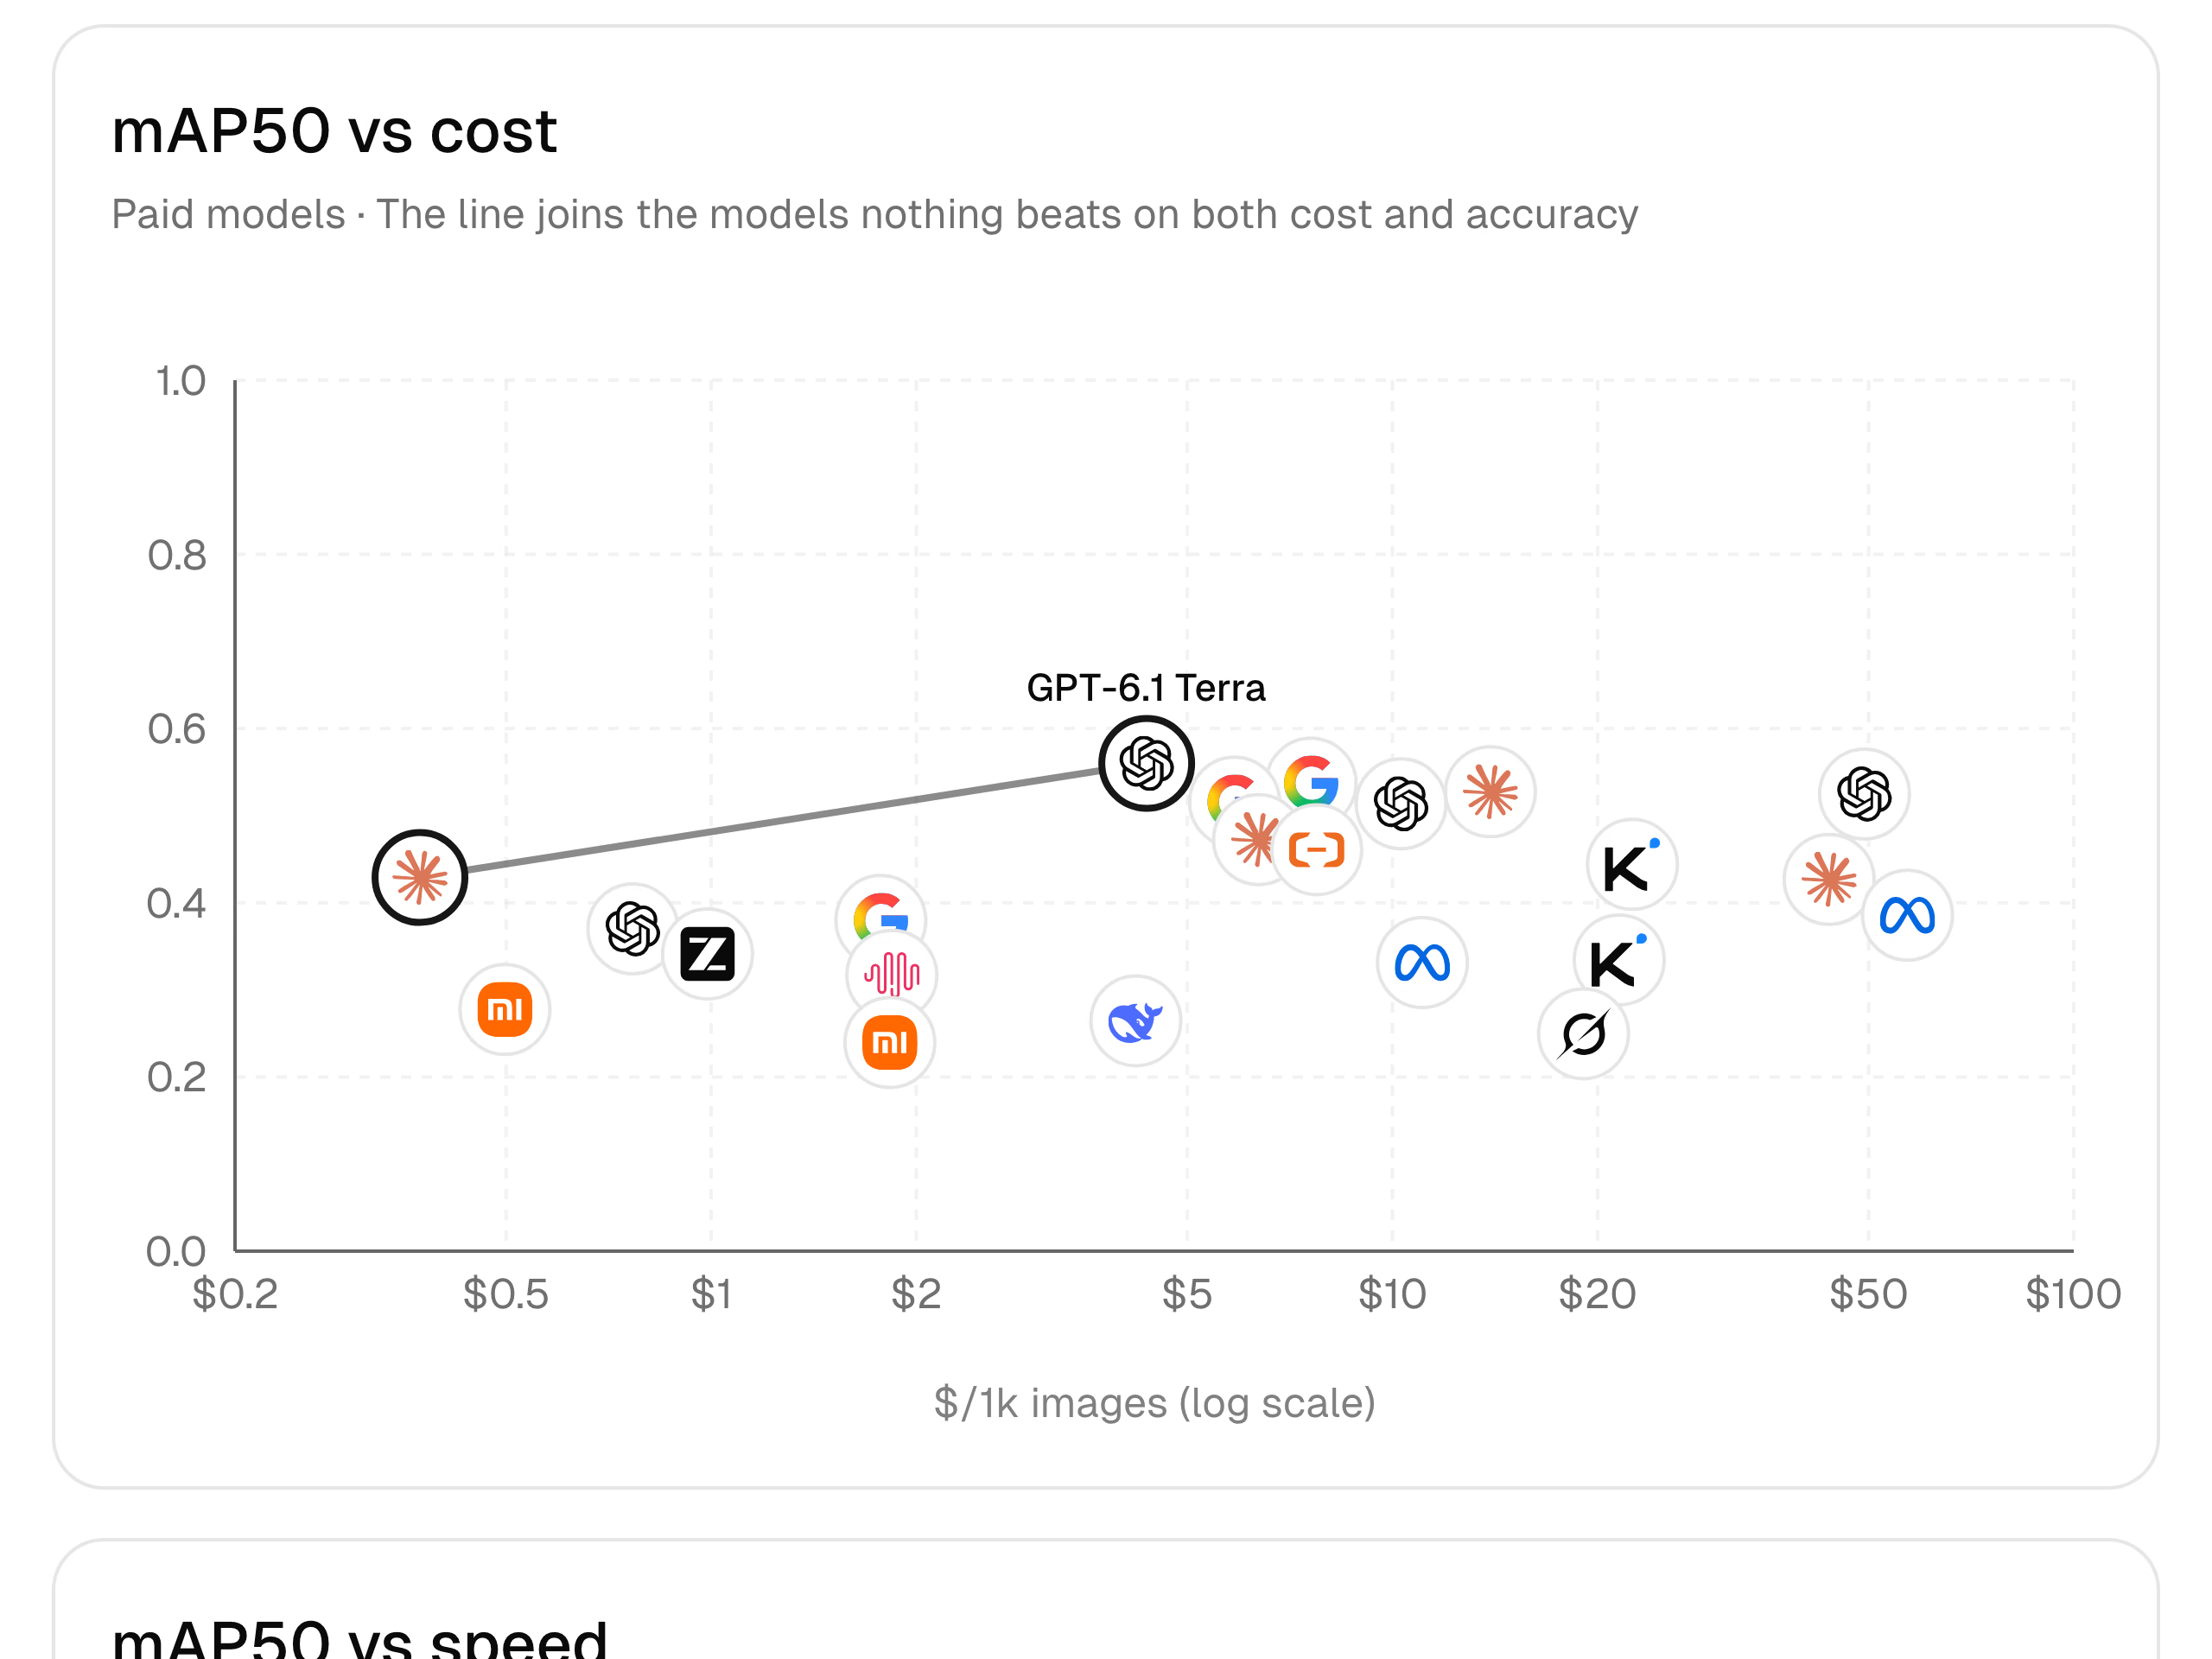
GPT-6.1 Terra лидирует в таблице с результатами 0,560 mAP50 и 0,345 mAP50-95. Её точность 0,646 и полнота 0,613 отстают от лидеров всего на несколько сотых, а F1 0,63 — лучший среди шести моделей, немного выше, чем у Argon и Opus 5.5 с показателем 0,62. Поскольку показатели F1 близки и F1 ничего не говорит о времени проверки, выбирай между ними по результатам для конкретных областей и теста на собственных изображениях.
Лидерство по mAP50-95 даёт дополнительный ориентир. Поскольку mAP50-95 усредняет значения при порогах перекрытия вплоть до 0,95, эта метрика поощряет модели, чьи сопоставленные рамки точно охватывают объекты, а также модели, которые находят нужные объекты; Terra лидирует и по этому показателю. Кроме того, у неё самая низкая оценка стоимости среди шести лидеров, и запросы ни разу не завершились с ошибкой; в таблице лидеров она отмечена как "Best value".
Размечай без ключа провайдера: размещённые модели и детекторы с открытым словарём#
Не каждая команда хочет использовать платный ключ провайдера. Размещённые на Platform модели работают без него, а их показатели выглядят иначе:
- SAM 3.1 Text: 0,332 mAP50, точность 0,19, полнота 0,47, 0,2 с на изображение. Среди всех 40 моделей она показывает лучшие результаты на VisDrone (0,479 mAP50) и дорожных сценах Fisheye8K (0,478).
- Qwen3.8 27B: 0,351 mAP50, точность 0,54, полнота 0,40, 1,5 с.
- Gemma 4 26B: 0,344 mAP50, точность 0,53, полнота 0,39, 0,9 с.
Детекторы с открытым словарём тоже размещены на Platform. В этом бенчмарке OWLv2 Large показала 0,133 mAP50, а Grounding DINO Base — 0,104; обе обрабатывали изображение за 0,2 секунды, тогда как SAM 3.1 Text показала 0,332. Эти показатели относятся к конвейеру Platform с подсказками по классам и уточнением рамок SAM 3.1, а не к исходным настройкам каждой модели.
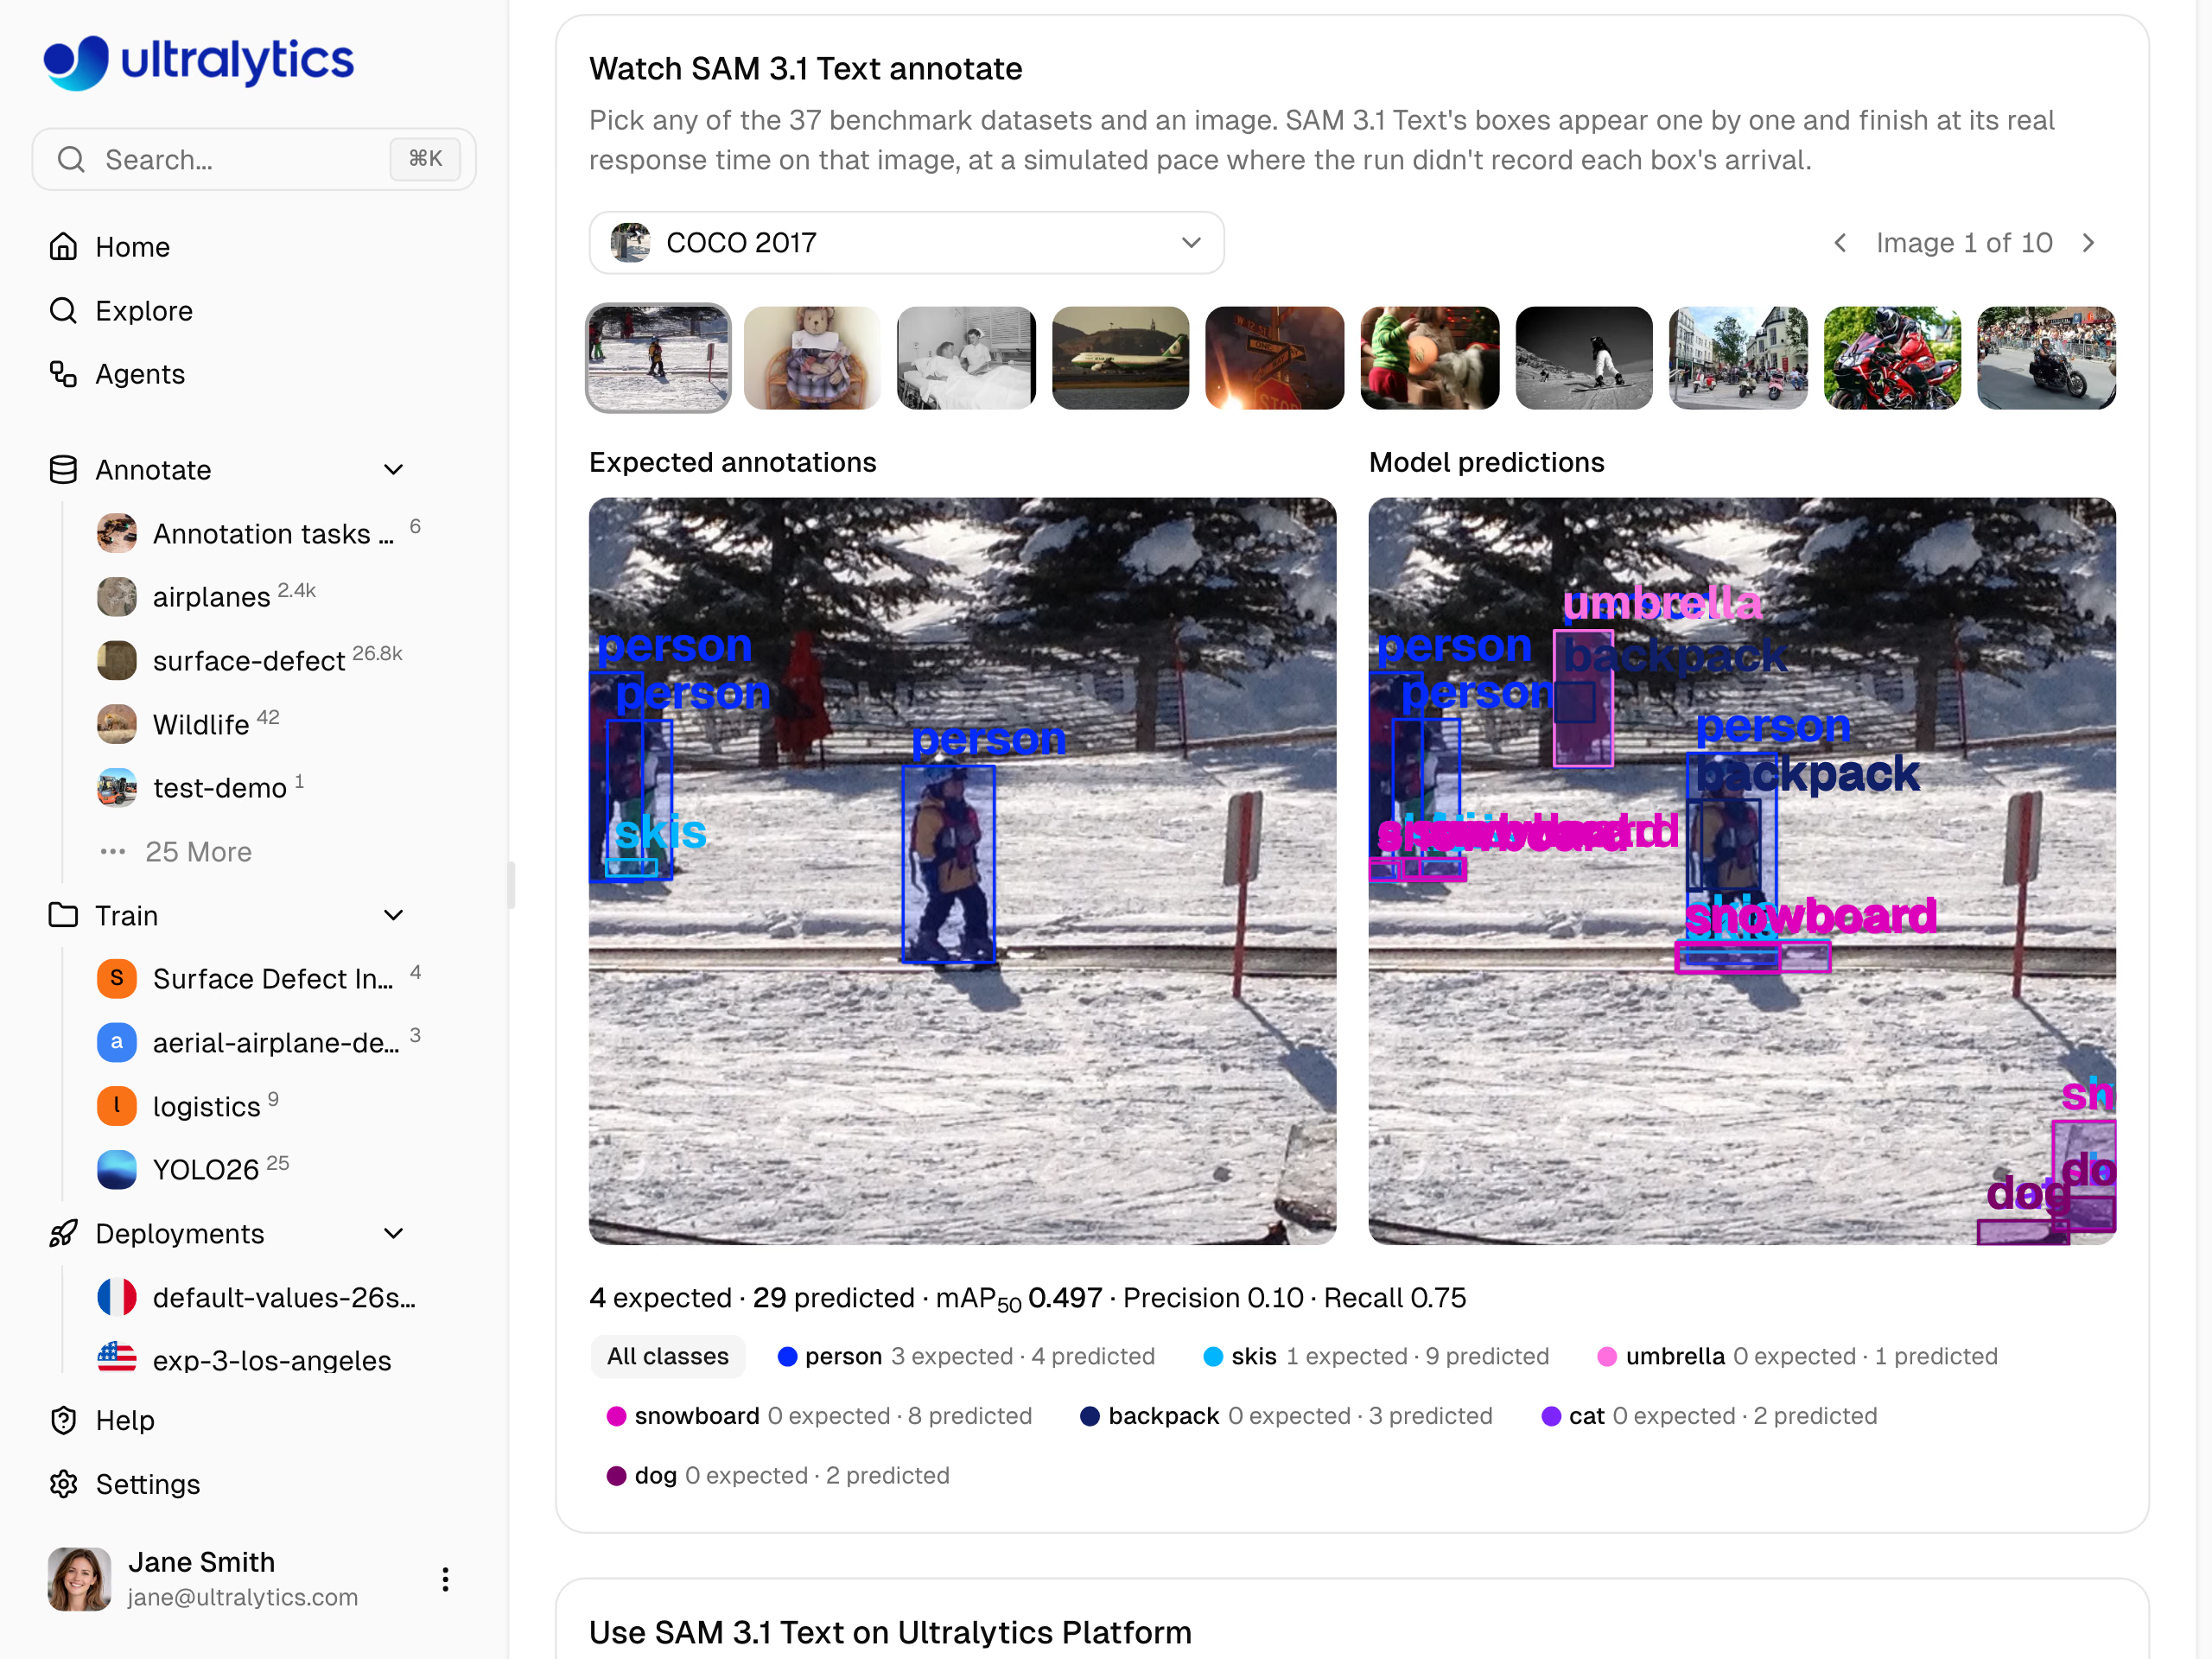
SAM 3.1 Text: 29 рамок для 4 объектов, точность 0,10, полнота 0,75. Все три модели в примерах находят 3 из 4 объектов; различается только число лишних рамок, которые рецензентам приходится удалять.
SAM 3.1 Text подойдёт для загруженных аэрофотоснимков и дорожных сцен, где рецензенты готовы сокращать щедрый черновой вариант. Qwen3.8 27B и Gemma 4 26B ведут себя как модели из аккуратного лагеря, но с меньшей точностью. Среди недорогих платных моделей Claude Haiku 5.5 показывает 0,429 mAP50, точность 0,56 и полноту 0,47 при расчётной стоимости $0.37 за 1 000 изображений; это ещё одна модель, отмеченная в таблице лидеров как "Best value".
Средние показатели по всей таблице не учитывают особенности твоей области — проверь таблицу датасетов#
Точность и полнота каждой модели усредняются по 36 датасетам, а твои данные относятся к одной области. В таблице датасетов таблицы лидеров VLM перечислены средние точность и полнота всех 40 моделей для каждого датасета, начиная с самого сложного, а также лучшая модель для каждого датасета.
Обращай внимание на тревожные сигналы. На Airbus Oil Storage Detection, где на 10 изображениях размечено 2 267 резервуаров, средняя точность моделей составляет 0,39, а полнота — 0,11; лучший mAP50 у Gemini 4 Argon — 0,347. На DeepPCB средние точность и полнота равны 0,03 и 0,04, а GPT-6.1 Sol выделяется результатом 0,393 mAP50.
Используй эти цифры, чтобы составить список кандидатов, а не вынести окончательный вердикт. В методологии указано, что 10 изображений на датасет достаточно для ранжирования моделей и областей, но недостаточно, чтобы подтвердить результат на отдельном датасете; при повторных запусках отдельные показатели меняются на несколько пунктов. На странице каждой модели в Platform результаты её зарегистрированных предсказаний показываются рядом с ожидаемыми рамками для бенчмарковых датасетов и COCO. Так ты сможешь проверить датасет, наиболее похожий на твой, ещё до запуска.
Подбери модель под рабочий процесс проверки за пять шагов#
Начни с главного критерия выбора, а затем проверь результат на собственных изображениях:
| Твой приоритет | Список кандидатов (результаты за октябрь 2026 года) |
|---|---|
| Приоритет точности | Gemini 4 Argon |
| Приоритет полноты | GPT-6 Astra или GPT-6.1 Sol |
| Учитывать оба показателя | GPT-6.1 Terra |
| Нет ключа провайдера | Размещённые в облаке модели: Qwen3.8 27B или SAM 3.1 Text |
Разметка с подсказками по классам подходит для датасетов обнаружения объектов с числом классов от 1 до 200.
- Составь короткий список на странице рейтинга. Отфильтруй рейтинг VLM для обнаружения объектов, оставив платные модели или размещённые в облаке (пропусти модели с пометкой «Недоступна на платформе»), прочитай столбец, соответствующий твоему приоритету, и проверь таблицу датасетов для своей предметной области.
- Добавь ключ провайдера. Для платной модели сохрани ключ в разделе Настройки > API Keys рабочего пространства, которому принадлежит датасет. Провайдер выставляет счёт напрямую за использование твоего ключа; инструкции по настройке есть в документации о ключах провайдеров.
- Проверь на размеченной выборке. Выбери несколько изображений, характерных для твоих данных и размеченных вручную. Открой редактор разметки, переключись в режим Smart, выбери модель в списке под именем её провайдера и нажми Predict (
P). Посчитай, сколько рамок ты удаляешь и добавляешь, а также сколько минут занимает проверка. - Разметь датасет. На странице датасета выбери More actions > Batch Annotation. Эта функция доступна для размещённых на Platform датасетов, содержащих до трёх каналов изображений. По умолчанию она размечает изображения без разметки, не меняет существующие метки и сначала сохраняет версию датасета, чтобы ты мог откатить изменения. Перед запуском проверь расчётную стоимость в диалоговом окне: Batch Annotation стоит $1.00 за 1 000 обработанных изображений плюс оплата провайдеру.
- Проверь разметку, затем обучи модель. Проверяй рамки с учётом слабой стороны выбранной модели, сохрани их и обучи модель Ultralytics YOLO на полученном датасете в том же рабочем пространстве.
Подробнее о том, как Ultralytics Platform использует ИИ для автоматизации разметки и почему проверка с участием человека остаётся частью рабочего процесса. Чтобы узнать, чем автоматическая разметка отличается от активного обучения в разных инструментах, прочитай наше сравнение автоматической разметки и активного обучения.
Краткий список моделей по задачам команды (результаты за октябрь 2026 года)#
- Рецензенты, которым проще дополнить черновик, чем исправлять его: Gemini 4 Argon — самая точная модель в целом, особенно хорошо работающая с аэрофотоснимками, подводными и тепловизионными изображениями, а также досмотровыми рентгеновскими снимками.
- Редкие объекты, пропуск которых портит обучающие данные: GPT-6 Astra для максимальной полноты или близкая к ней GPT-6.1 Sol.
- Универсальная разметка без явного предпочтения: GPT-6.1 Terra, лидер по mAP50, mAP50-95 и F1.
- Команды без ключа провайдера: SAM 3.1 Text для первых проходов с приоритетом полноты на загруженных сценах или Qwen3.8 27B для более аккуратного черновика.
Какую бы модель ты ни выбрал, таблица лидеров поможет заранее оценить объём проверки. Теорию этих метрик объясняет наше руководство по точности, precision и полноте, а урок Academy о метриках обнаружения объектов рассказывает больше.
Часто задаваемые вопросы
Отдавай приоритет точности, если удаление неправильных рамок занимает больше времени, например на загруженных изображениях, где лишняя рамка затеряна среди правильных. Отдавай приоритет полноте, если пропуск объекта обходится дороже, как в случае редких дефектов или поражений: неразмеченный объект учит детектор считать его фоном. Затем проверь свой выбор на вручную размеченной выборке собственных изображений.
Модели с подсказками по классам возвращают рамки без оценок уверенности и используют пороги, специфичные для каждой модели, поэтому Platform скрывает настройки уверенности и IoU, пока выбрана такая модель. Поэтому точность и полнота в таблице лидеров учитывают каждую рамку, возвращённую моделью при IoU 0,5. Чтобы изменить баланс между несопоставленными рамками и объектами, выбери другую модель.
Используй mAP50, чтобы узнать, находит ли модель нужные объекты и правильно ли их размечает, а mAP50-95 учитывает более строгие пороги перекрытия и поощряет рамки, точно охватывающие объекты. Обе метрики также учитывают пропуски и ложноположительные результаты, поэтому рассматривай их вместе с точностью и полнотой. В результатах за октябрь 2026 года GPT-6.1 Terra лидирует по обоим показателям — 0,560 и 0,345.
Да. Лучшая модель на UL37 v2 показывает в среднем 0,560 mAP50 (октябрь 2026 года), а на самых сложных датасетах, например с дефектами печатных плат и рентгеновскими снимками грудной клетки, средний результат 40 моделей ниже 0,05. Проверяй каждое изображение и особенно внимательно смотри на слабую сторону модели: лишние рамки у модели с приоритетом полноты и пропущенные объекты у модели с приоритетом точности.
Стоимость складывается из двух частей. Batch Annotation на Ultralytics Platform стоит $1.00 за 1 000 обработанных изображений (минимум $0.01) для любой модели, включая размещённые; одиночные предсказания размещённой моделью в редакторе бесплатны. За платные модели провайдеры также выставляют счёт за использование твоего API key. В бенчмарке за октябрь 2026 года оценка стоимости моделей из этого руководства у провайдера составляла от $0.37 за 1 000 изображений (Claude Haiku 5.5) до $49.31 (GPT-6 Astra). Если остановить запуск, оплачиваются уже обработанные изображения.
Да. Размещённые модели, например SAM 3.1 Text, Qwen3.8 27B и Gemma 4 26B, работают на Ultralytics Platform без ключа провайдера; то же относится к твоим моделям YOLO. Пакетная разметка по-прежнему стоит $1.00 за 1 000 обработанных изображений, а перед каждым запуском в диалоговом окне показывается оценка стоимости.
Зависит от задачи. VLM с подсказками по классам может подготовить черновую разметку новых классов, используя только их названия, но шесть моделей с наивысшими оценками в бенчмарке за октябрь 2026 года обрабатывали от 2,7 до 11,6 секунды на изображение, а оплата взимается за токены. Для обнаружения объектов в реальном времени часто используют такой подход: автоматически размечают изображения с помощью VLM, проверяют разметку и обучают модель Ultralytics YOLO на ней. Уже обученная модель YOLO также может автоматически размечать новые изображения в том же редакторе.
Автор
Ведущий инженер-программист · Ultralytics
Комментарии2
Задай вопрос, поделись результатами или помоги кому-нибудь.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









