Precision ve recall kullanarak otomatik etiketleme için VLM seçme
Otomatik etiketleme için precision ve recall değerlerine göre bir VLM seç: hangi modeller daha az fazladan kutu bırakıyor, hangileri daha az nesneyi kaçırıyor ve kendi verilerinle nasıl test edebilirsin.
 Sergiu Waxmann13 dakikalık okuma
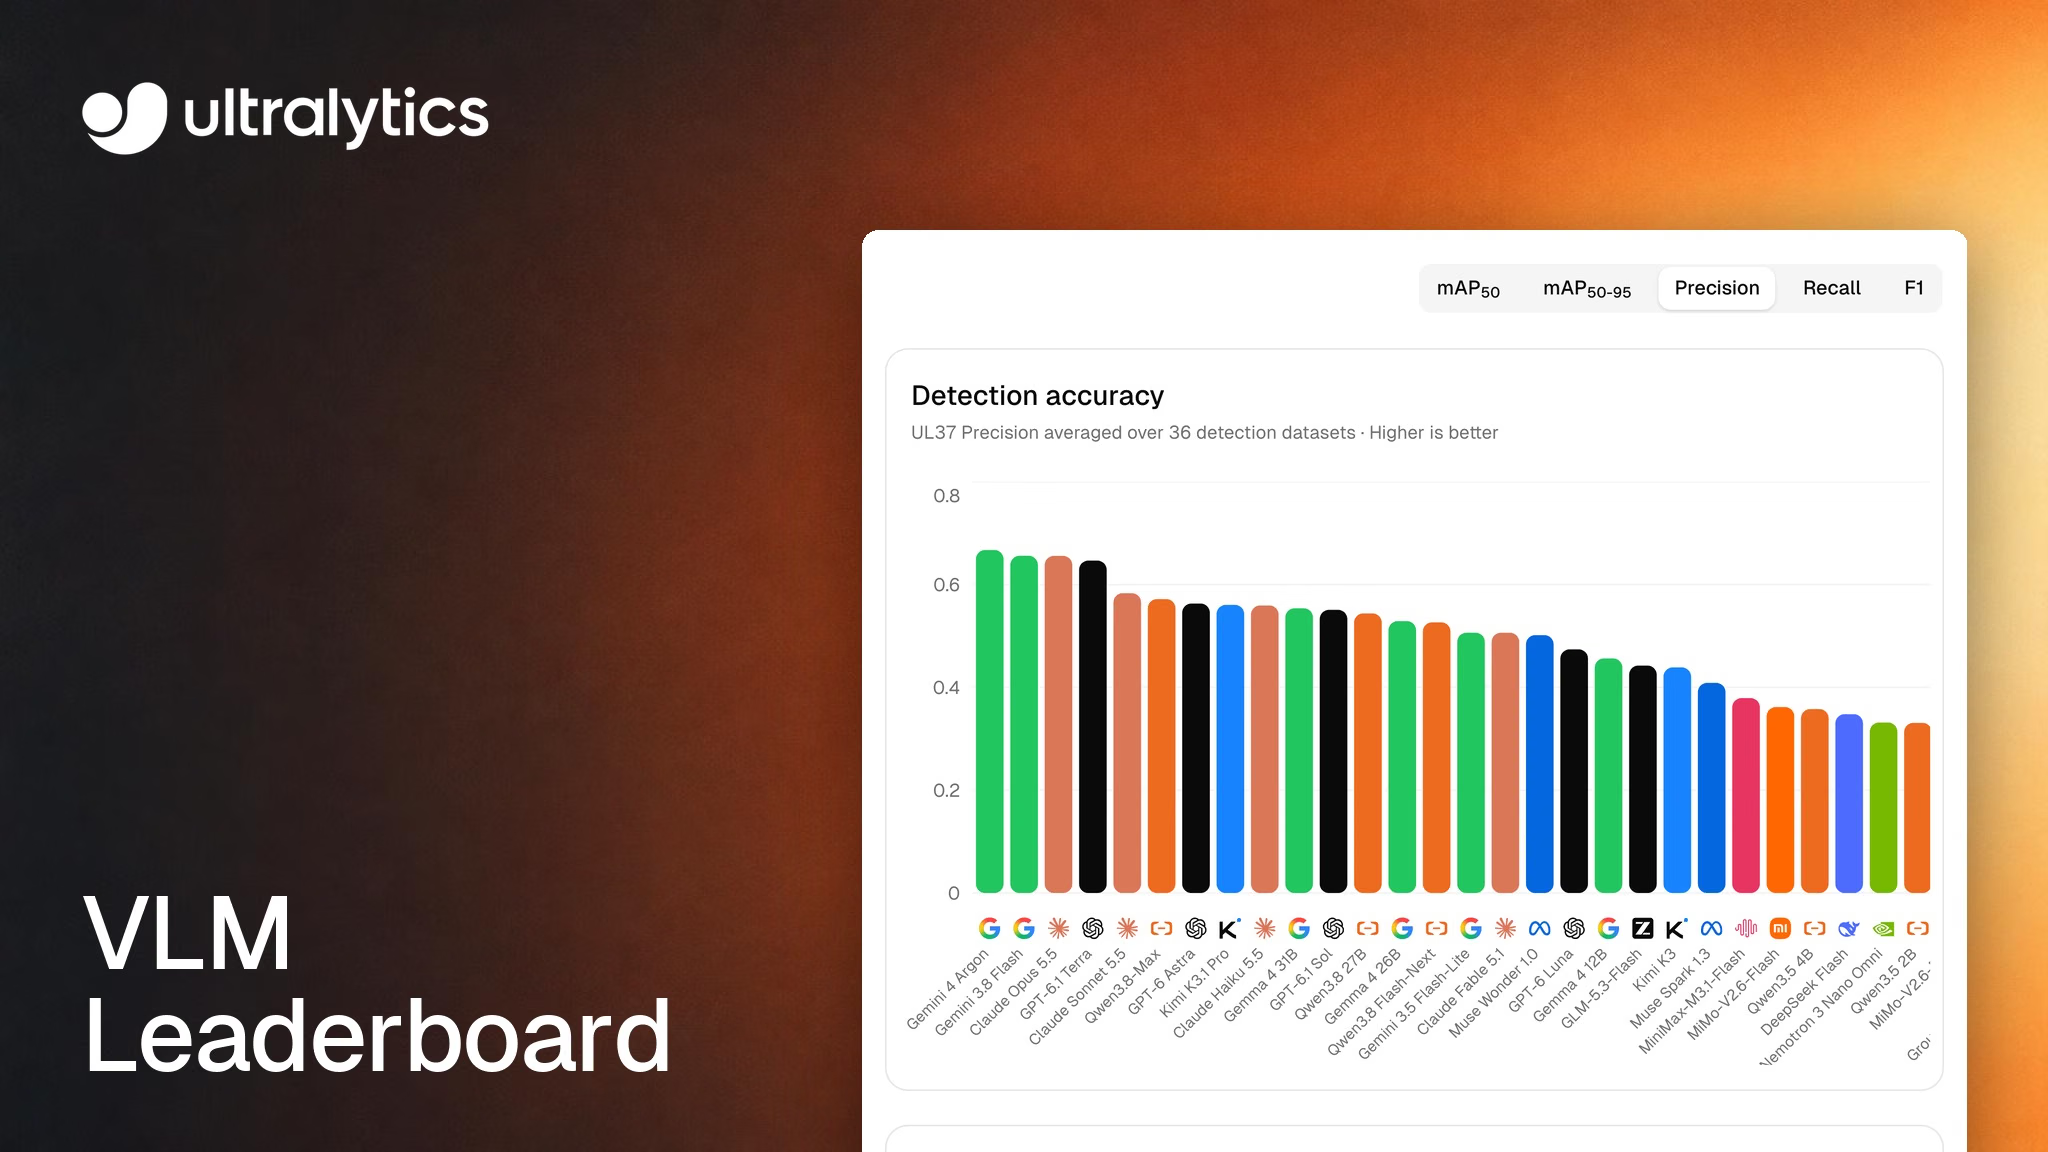
Bir veri kümesini otomatik olarak etiketlemek için model seçerken, gözden geçirenlerin hangi işi yapmayı tercih edeceğini düşün: fazladan kutuları silmek mi, yoksa modelin kaçırdıklarını eklemek mi? Ultralytics VLM Liderlik Tablosu artık her model için bu ödünleşimi; kesinlik (modelin kutularının doğru olanlarının oranı) ve duyarlılık (etiketli nesneler arasından modelin bulduklarının oranı) değerleriyle, 28 Ekim 2026'da yayımlanan kıyaslama sonuçlarına dayanarak gösteriyor.
En temiz ilk taslaklar için Gemini 4 Argon ile başla. En az nesneyi kaçırmak için GPT-6 Astra ile başla. En iyi denge ve en yüksek puanlı altı model arasındaki en düşük maliyet için GPT-6.1 Terra'yı seç. Kendi yapay zekâ sağlayıcının API anahtarı yoksa barındırılan Qwen3.8 27B ile veya kalabalık sahnelerde sonradan ayıklamayı tercih ediyorsan SAM 3.1 Text ile başla.
Bu kılavuz sayıları nasıl okuyacağını, her modelin hangi durumlarda uygun olduğunu ve seçimini kendi görüntülerinde nasıl doğrulayacağını açıklıyor. Sıralamalar ve fiyatlar her çalıştırmadan sonra değiştiğinden, buradaki rakamları Ekim 2026 örnekleri olarak değerlendir ve güncel sonuçlar için liderlik tablosunu kontrol et.
Sınıf istemiyle çalışan modellerde güven eşiği ayarı yoktur; bu nedenle model seçimin senin eşik değerindir.#
Etiket düzenleyicisinde bir Ultralytics YOLO modeli kullanırken bu dengeyi kendin ayarlarsın. Güven eşiğini yükseltirsen yanlış kutular azalır, kaçırılan nesneler artar; düşürürsen tersi olur. Sınıf istemiyle çalışan görsel dil modelleri (VLM) farklı çalışır. Etiket düzenleyicisi belgelerinde açıklandığı gibi, veri kümenin sınıflarını modele özgü eşiklerle algılar ve güven puanı döndürmezler. Bu nedenle Ultralytics Platform, bunlardan biri seçiliyken güven ve IoU ayarlarını gizler.
Bu durum, liderlik tablosundaki precision ve recall değerlerinin anlamını değiştirir. Kıyaslama metodolojisine göre precision ve recall, bir modelin döndürdüğü her kutuyu IoU 0.5 değerinde ve gizli bir çalışma noktası olmaksızın sayar. Bu değerler, inceleyenlerin gerçekte aldığı kutuları tanımlar.
Liderlik tablosunun temelindeki kıyaslama UL37 v2'dir: Platform'daki 36 gerçek nesne algılama veri kümesinin her birinden 10 görüntü ve ayrı puanlanan 10 COCO 2017 referans görüntüsü; toplamda 370 görüntü ve 7.268 kutu. Her görüntü, veri kümesinin kendi sınıf adları kullanılarak Smart ve Batch Annotation ile aynı üretim hattından geçirilir; SAM 3'ünki dışındaki her modelin kutularını SAM 3.1 iyileştirir. Puanlamada Ultralytics paketinin kendi algılama metrikleri, YOLO modellerini doğrulayan kod kullanılır ve ortalamada her veri kümesi eşit ağırlığa sahiptir.
Precision eşleşmeyen kutuları, recall ise eşleşmeyen nesneleri izler#
Precision, bir modelin kutularından IoU 0.5 değerinde doğru sınıfa ait etiketli bir nesneyle eşleşenlerin oranıdır. Recall, modelin eşleştirdiği etiketli nesnelerin oranıdır. İnceleme açısından:
- Düşük precision, eşleşene kadar silinmesi, yeniden etiketlenmesi veya boyutlandırılması gereken daha fazla kutu anlamına gelir.
- Düşük recall, kutu eklenmesi, yeniden boyutlandırılması veya yeniden etiketlenmesi gereken daha fazla etiketli nesne anlamına gelir.
- F1, ikisinin harmonik ortalamasıdır: 2 x P x R / (P + R). Her ikisini özetleyen tek bir sayıdır. İncelemenin ne kadar sürdüğünü ölçmez.
- mAP50 ve mAP50-95, modelleri sınıflar genelindeki ortalama precision değerine göre sıralar; IoU 0.5'te ve 0.50 ile 0.95 arasındaki daha katı eşiklerde ölçüm yapar. Liderlik tablosundaki sıralama ölçütü mAP50'dir.
İşte 0.51 mAP50'nin üzerinde puan alan altı model. Maliyet, başarıyla etiketlenen 1.000 kıyaslama görüntüsü başına sağlayıcının bildirdiği token kullanımına göre tahmin edilmiştir; gecikme ise istek süresinin medyanıdır:
| Model | mAP50 | mAP50-95 | Kesinlik | Duyarlılık | F1 | Sağlayıcı maliyeti / 1 bin görüntü (kıyaslama kullanımı) | Gecikme |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*Gemini 4 Argon'un tahmini, 30 Kasım 2026'ya kadar geçerli olan Google tanıtım fiyatlandırmasına dayanıyor. 1 Aralık'tan itibaren Google'ın standart ücreti iki katına çıkarak aynı kullanımda 1.000 görüntü başına yaklaşık 15 dolara ulaşıyor. Ultralytics Platform'daki Batch Annotation, barındırılanlar dâhil tüm modeller için işlenen 1.000 görüntü başına 1,00 dolar ekler.
Altı model iki gruba ayrılıyor. Argon, Opus 5.5 ve Gemini 3.8 Flash 0.66-0.67 precision değerlerine ve 0.60'ın altında recall değerlerine sahip: kutularının büyük bir kısmı eşleşiyor, ancak etiketli nesnelerin daha azını eşleştiriyorlar. Astra ve Sol ise 0.55-0.56 precision ile 0.62-0.63 recall değerlerine ulaşıyor: etiketli nesnelerin daha büyük kısmını eşleştirirken kutularının daha küçük bir kısmı eşleşiyor. Terra iki grubun arasında yer alıyor ve mAP50 ile F1'de önde.
Fazladan kutuları düzeltmek maliyetliyse precision'a öncelik ver#
0.667 değeriyle Gemini 4 Argon, kıyaslamadaki 40 model arasında genel precision değeri en yüksek modeldir. Bunun karşılığında ortalama recall değeri 0.585'tir ve recall liderlerinin gerisinde kalır.
Eşleşmeyen kutuları fark etmek zorsa precision daha önemlidir. Kalabalık bir görüntüde inceleyen kişi, düzeltmeden önce çok sayıda doğru kutu arasından hatalı olanı bulmalıdır. SKU110K veri kümesindeki yoğun perakende rafları, bu tür görüntülerde precision'ın ne kadar değişebildiğini gösteriyor: GPT-6.1 Terra sonuçlarımızda Terra burada 0.79 precision ve 0.73 recall kaydederken GPT-6.1 Sol 0.49 ve 0.77 değerlerine ulaştı.
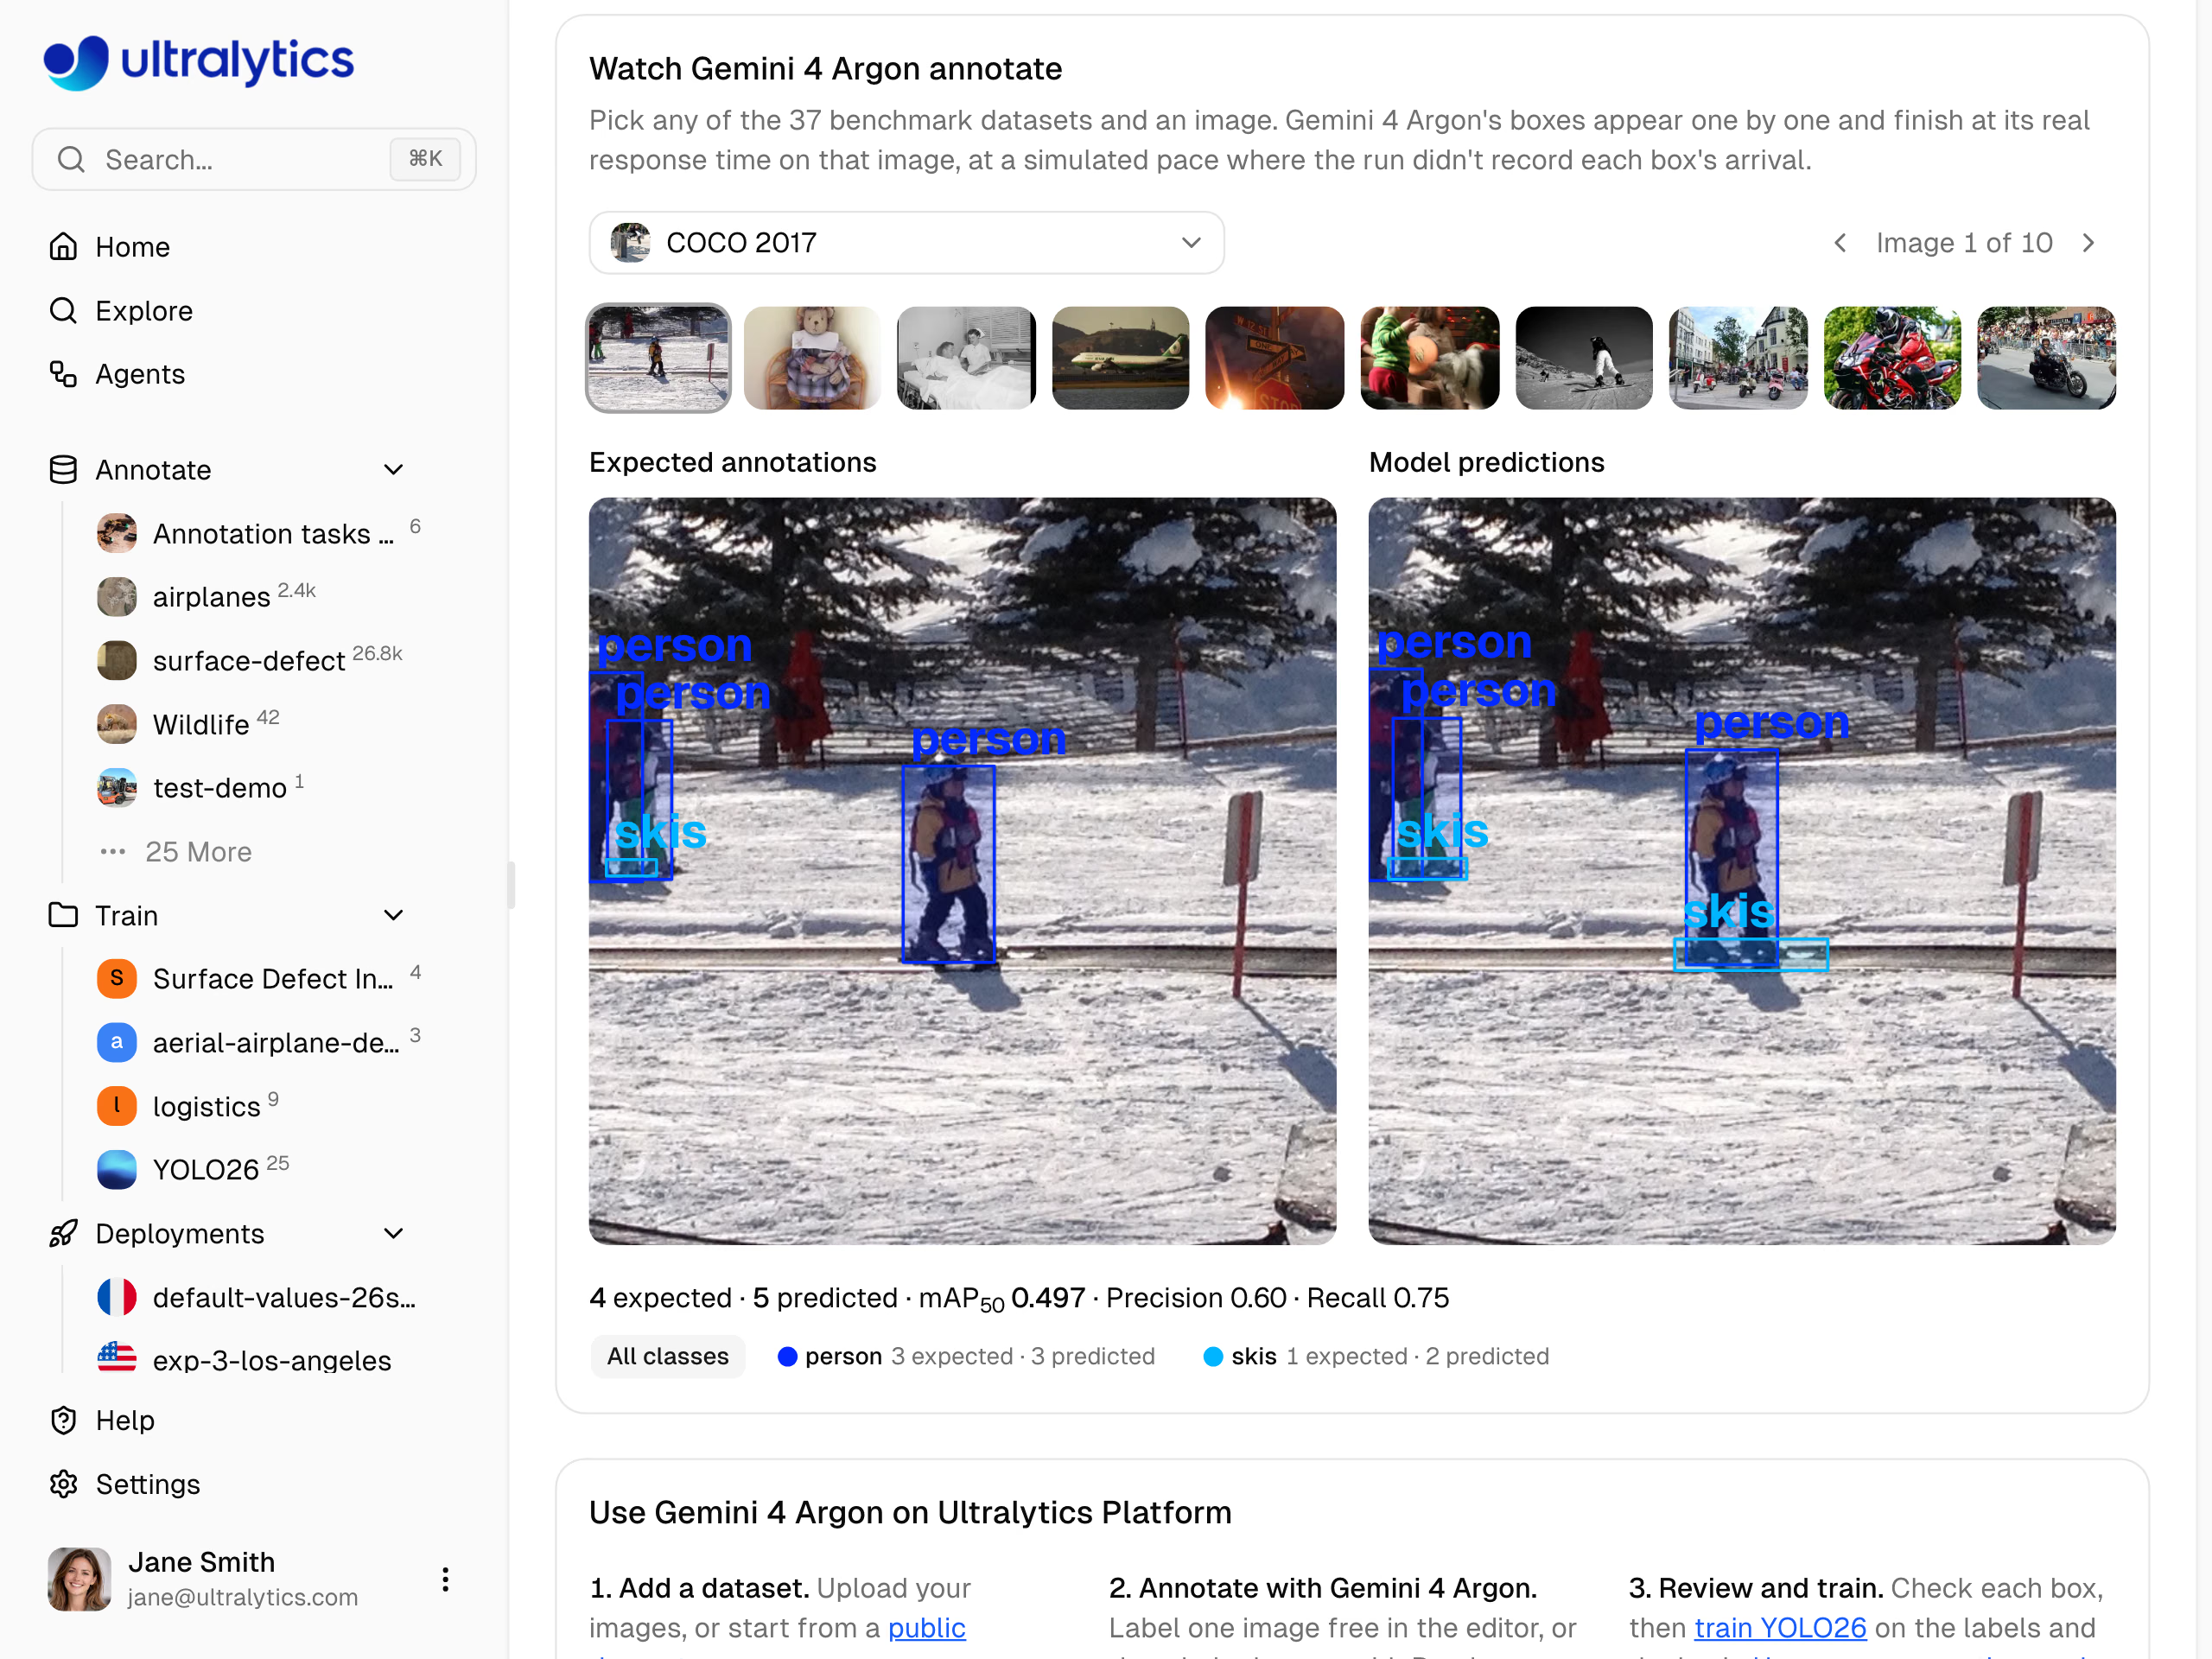
Gemini 4 Argon: Etiketli 4 nesne için 5 kutu tahmin edildi; precision 0.60, recall 0.75.
Argon ayrıca kıyaslamada başarısız istek vermedi ve 4,6 saniyelik medyan süresi ilk iki model arasındaki en hızlısı. Verilerin modelin güçlü olduğu alanlara (hava görüntüleri, su altı görüntüleri, termal görüntüler ve güvenlik amaçlı X-ışını görüntüleri) benzediğinde seç; IEDXray güvenlik taramalarında en iyi mAP50 değerini (0,298) elde ediyor. Ayrıca ekibin başıboş kutuları aramak yerine kaçırılan birkaç nesneyi tamamlamayı tercih ediyorsa da Argon'u seç.
Kaçırılan bir nesnenin hatası maliyetliyse recall'a öncelik ver#
GPT-6 Astra, 0.627 ile tablodaki en yüksek ortalama recall değerine sahip. 0.56'lık precision değeri bunun bedeli.
Etiketlemede duyarlılığı öncelemek, etiketsiz bir nesnenin daha maliyetli bir hata olduğu durumlarda mantıklıdır. Eğitim kümesindeki kaçırılmış bir kusur veya lezyon, algılayıcıya bu nesnenin arka plan olduğunu öğretir; eksik bir kutuyu bulmaksa işaretlenmemiş bir nesneyi bulmak için her görüntüyü taramak demektir. Astra, TBX11K göğüs röntgenleri (0,330), GRAZPEDWRI-DX pediatrik bilek röntgenleri (0,354) ve DsPCBSD+ PCB yüzey kusurları (0,394) dahil 36 veri kümesinin 7'sinde en iyi mAP50 değerini elde ediyor: bu, benzer verilerde Astra'yı denemek için bir neden; senin verilerinde daha az nesne kaçırdığının kanıtı değil.
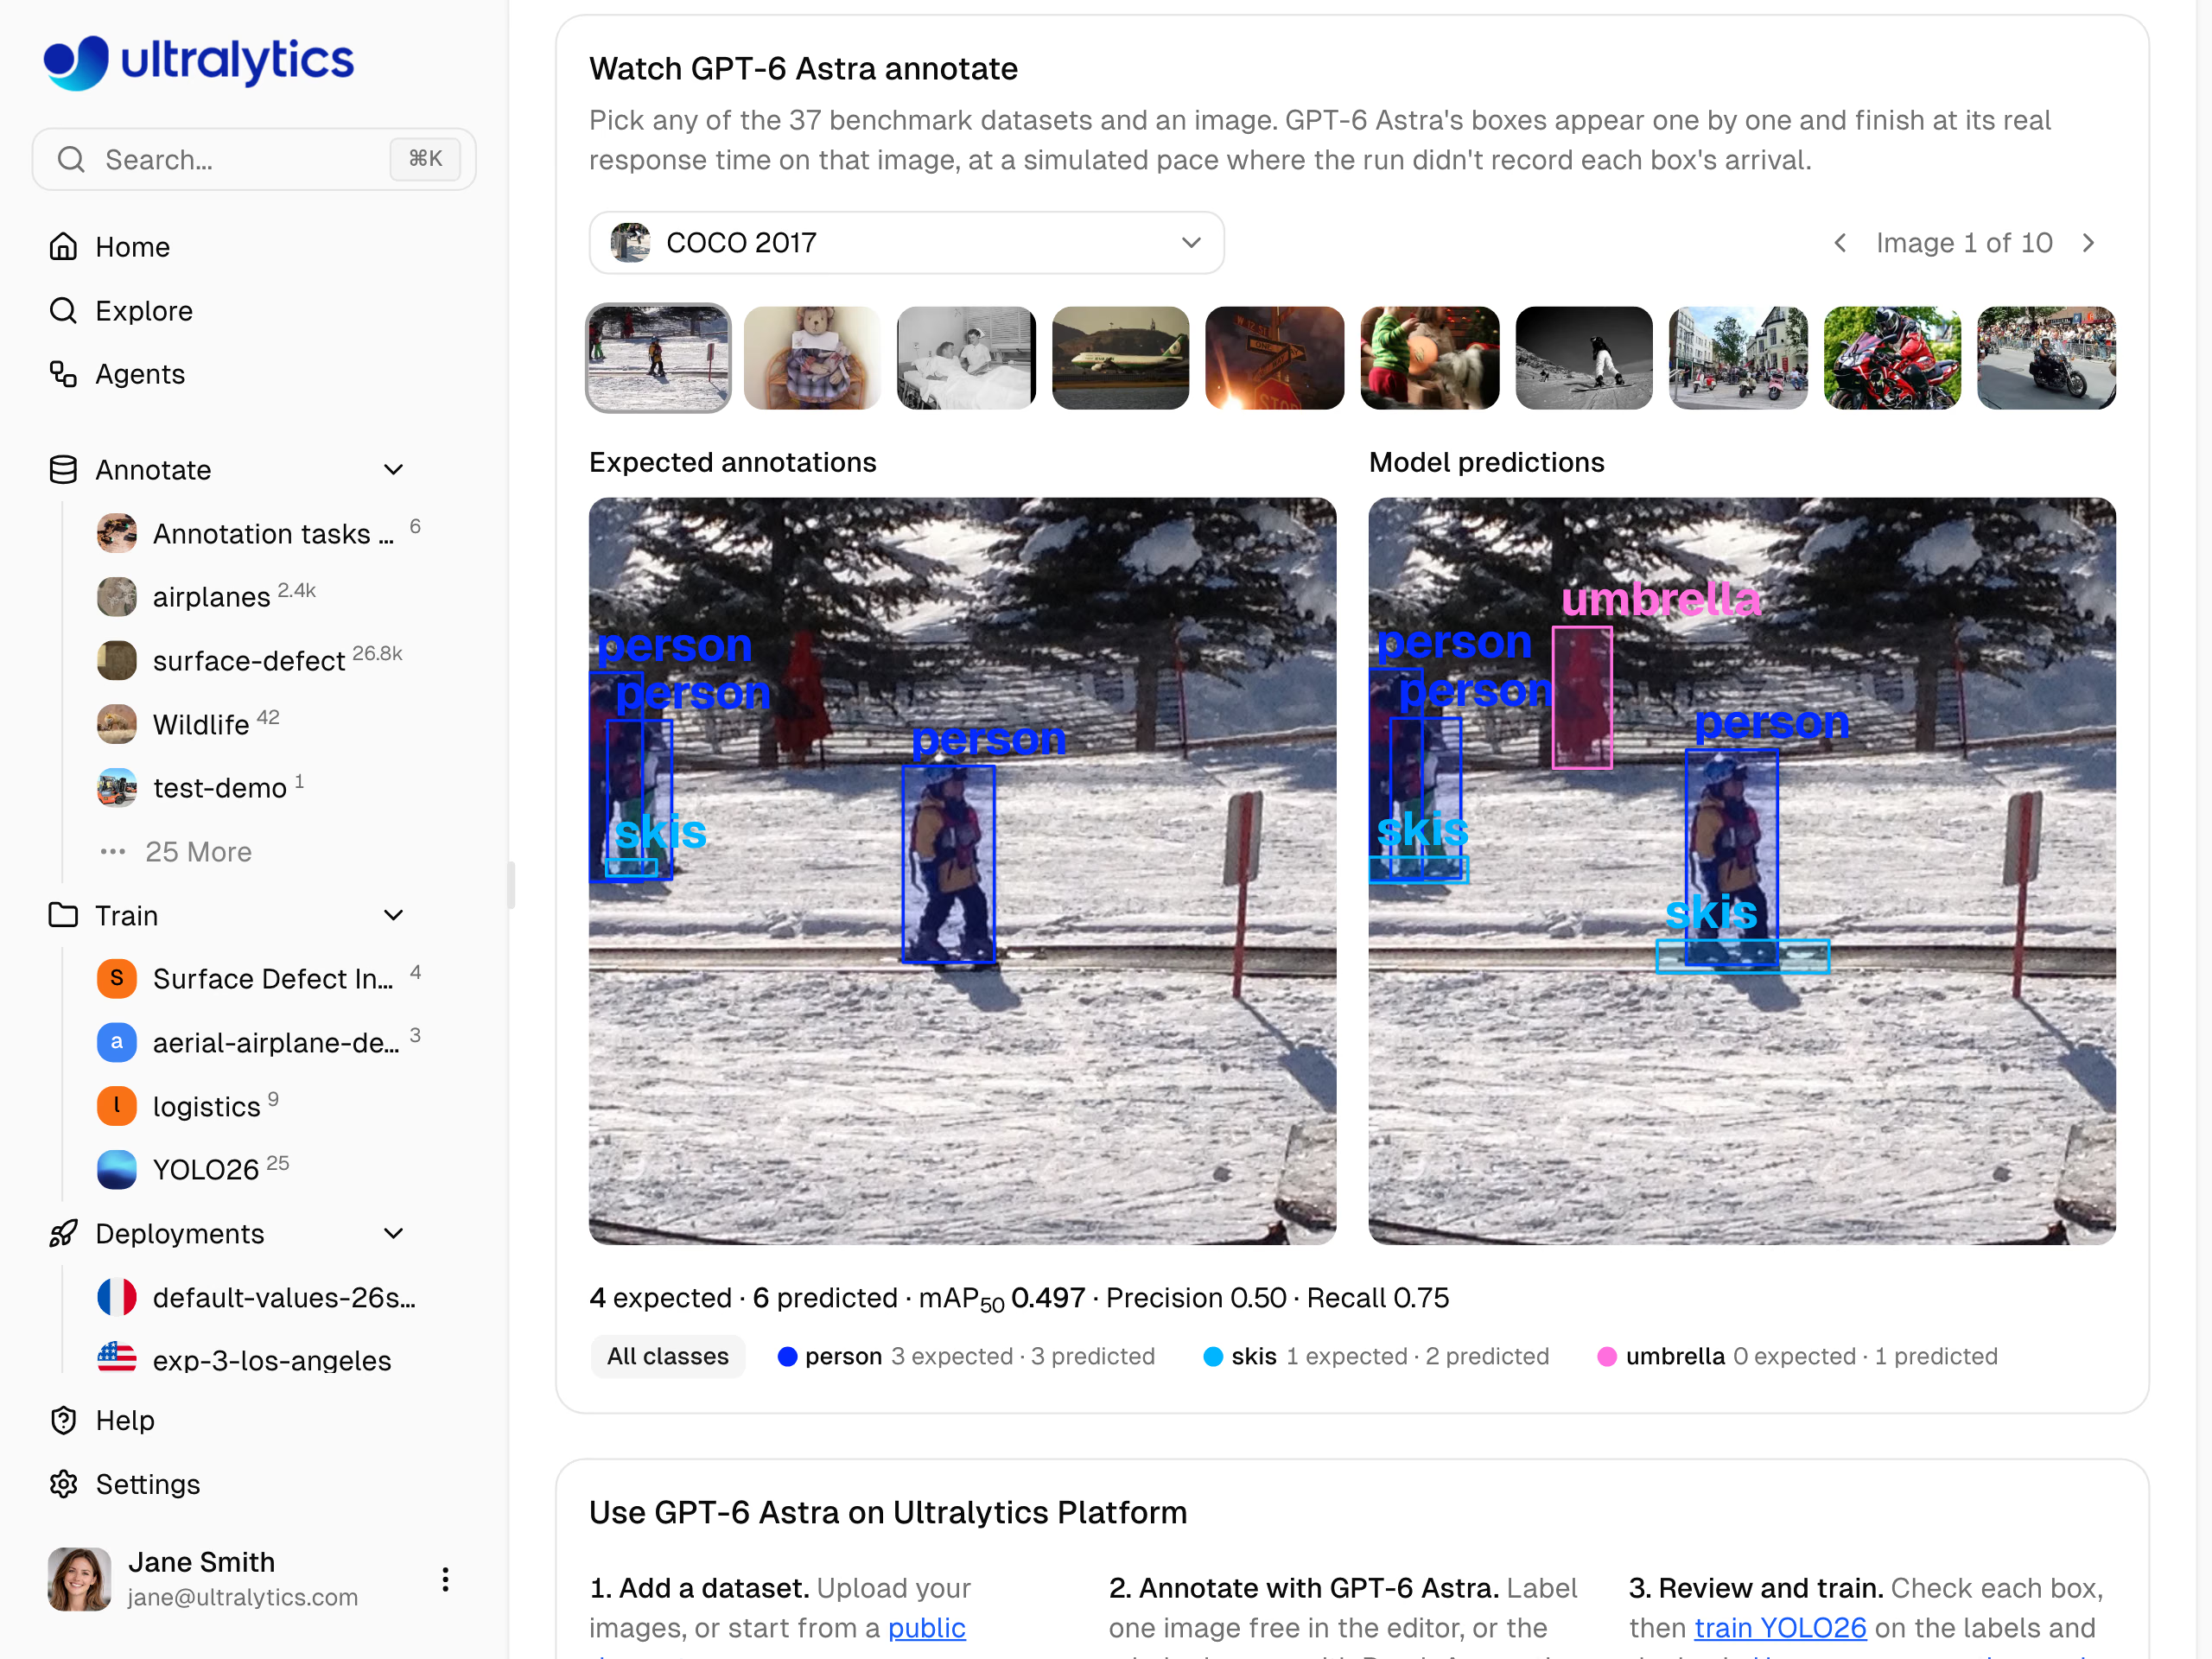
GPT-6 Astra: aynı 4 nesne için 6 kutu; bunların arasında COCO etiketlerinin dışarıda bıraktığı bir şemsiye de var; kesinlik 0,50, duyarlılık 0,75.
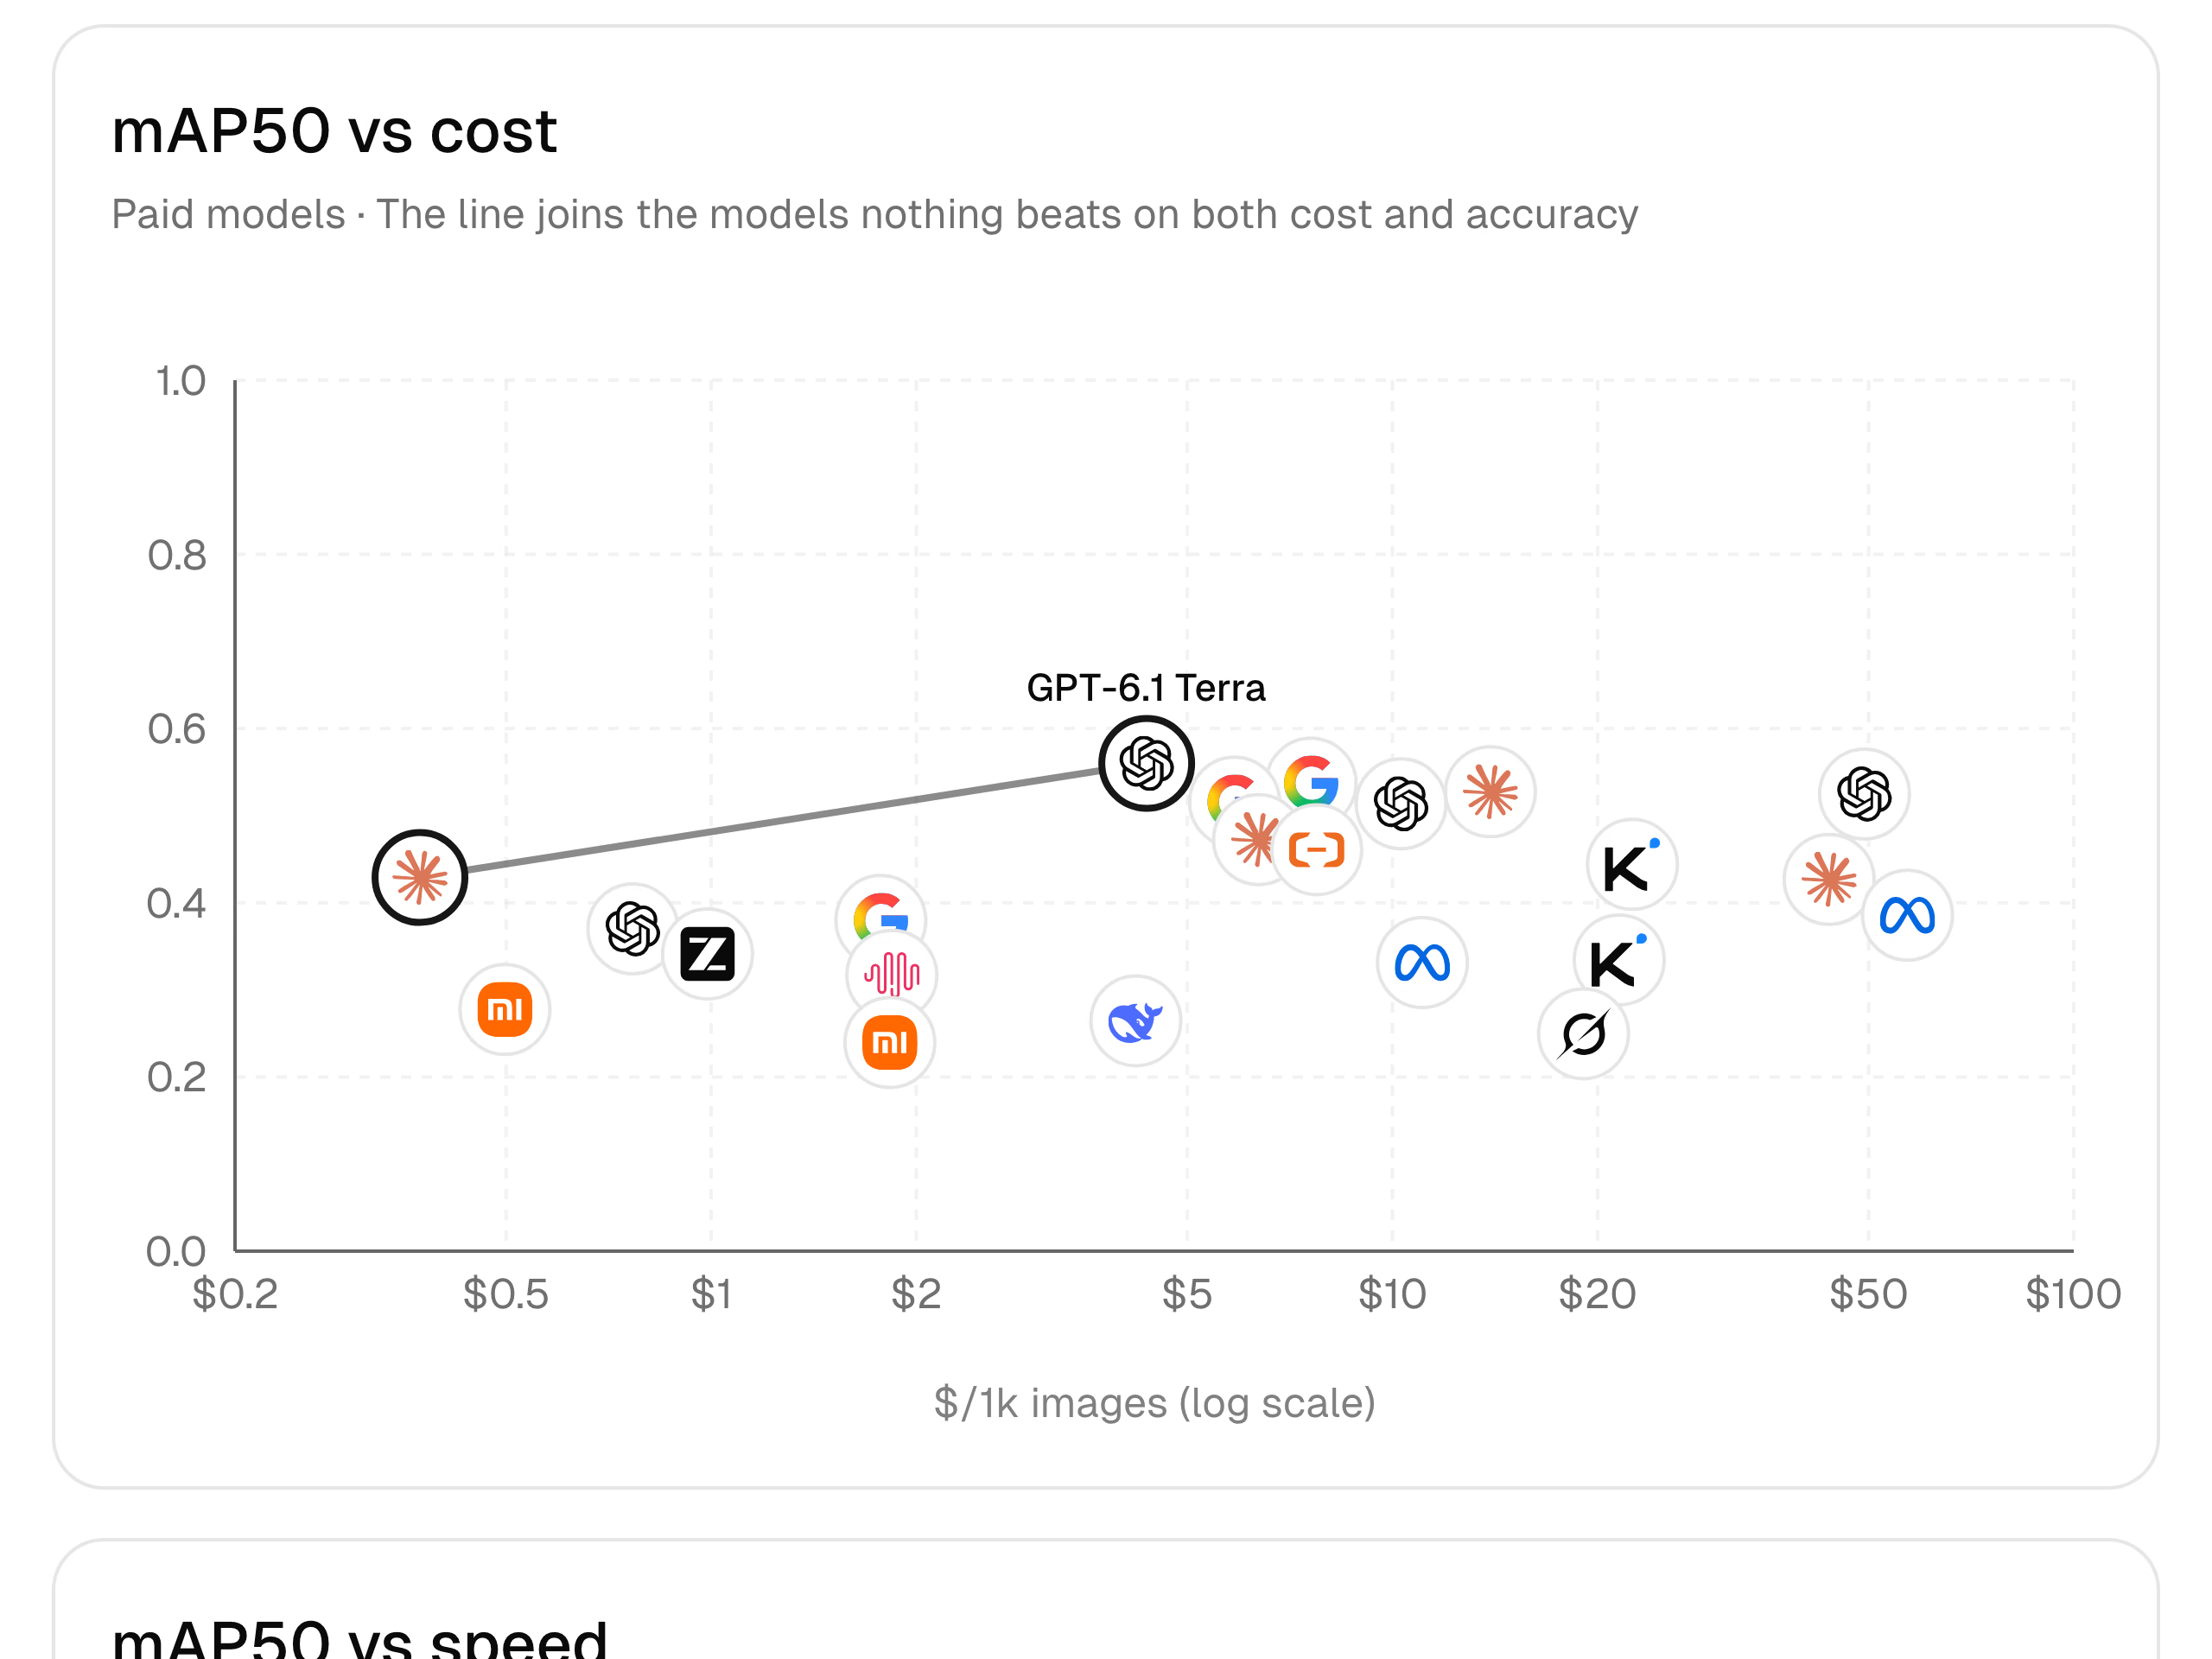
Astra, ilk altı model arasındaki en yüksek maliyet tahminine sahip: 1.000 görüntü başına 49,31 dolar. Medyan süresi 11,6 saniye ve görüntülerin %1'inde istek başarısız oldu. İki OpenAI modeli recall açısından ona yaklaşıyor: GPT-6.1 Sol 0.62 recall ve tahmini 10,30 dolar; GPT-6.1 Terra ise 0.61 recall ve tahmini 4,36 dolar.
Her iki hatayı mAP50-95 ve F1 ile değerlendir#
GPT-6.1 Terra, 0.560 mAP50 ve 0.345 mAP50-95 ile tablonun zirvesinde. 0.646 precision ve 0.613 recall değerleri liderlerin birkaç yüzde puanı yakınında; 0.63 F1 değeri ise Argon ve Opus 5.5'in 0.62 değerinin hemen önünde, altı model arasındaki en yüksek değerdir. F1 değerleri bu kadar yakınken ve F1 inceleme süresi hakkında hiçbir şey söylemezken aralarında seçim yapmak için alan başına sonuçları ve kendi görüntülerinde yapacağın testi kullan.
mAP50-95 liderliği ikinci bir gösterge sunuyor. mAP50-95, 0.95'e kadar olan örtüşme eşiklerinin ortalamasını aldığı için doğru nesneleri bulmanın yanı sıra eşleşen kutuları nesnelere yakın biçimde oturtan modelleri de ödüllendirir; Terra bu ölçütte de birinci sırada. Ayrıca ilk altı model arasındaki en düşük maliyet tahminine sahip, başarısız isteği olmadı ve liderlik tablosunda "En iyi fiyat-performans" olarak işaretlendi.
Sağlayıcı anahtarı olmadan etiketleme: barındırılan modeller ve açık kelime dağarcıklı algılayıcılar#
Her ekip ücretli bir sağlayıcı anahtarı kullanmak istemez. Platform'daki barındırılan modeller böyle bir anahtar olmadan çalışır ve sütunları farklı bir tablo ortaya koyar:
- SAM 3.1 Text: 0.332 mAP50, 0.19 precision, 0.47 recall, görüntü başına 0,2 sn. VisDrone (0.479 mAP50) ve Fisheye8K trafik görüntülerinde (0.478) 40 modelin tümü arasındaki en iyi modeldir.
- Qwen3.8 27B: 0.351 mAP50, 0.54 precision, 0.40 recall, 1,5 sn.
- Gemma 4 26B: 0.344 mAP50, 0.53 precision, 0.39 recall, 0,9 sn.
Açık kelime dağarcıklı algılayıcılar da barındırılır. Bu kıyaslamada OWLv2 Large 0.133 mAP50, Grounding DINO Base ise 0.104 puan aldı; her ikisi de görüntü başına 0,2 saniyede çalıştı. SAM 3.1 Text'in puanı 0.332 idi. Bu puanlar, her modelin özgün kurulumunu değil, SAM 3.1 kutu iyileştirmesinin de uygulandığı Platform'un sınıf istemli hattını ölçer.
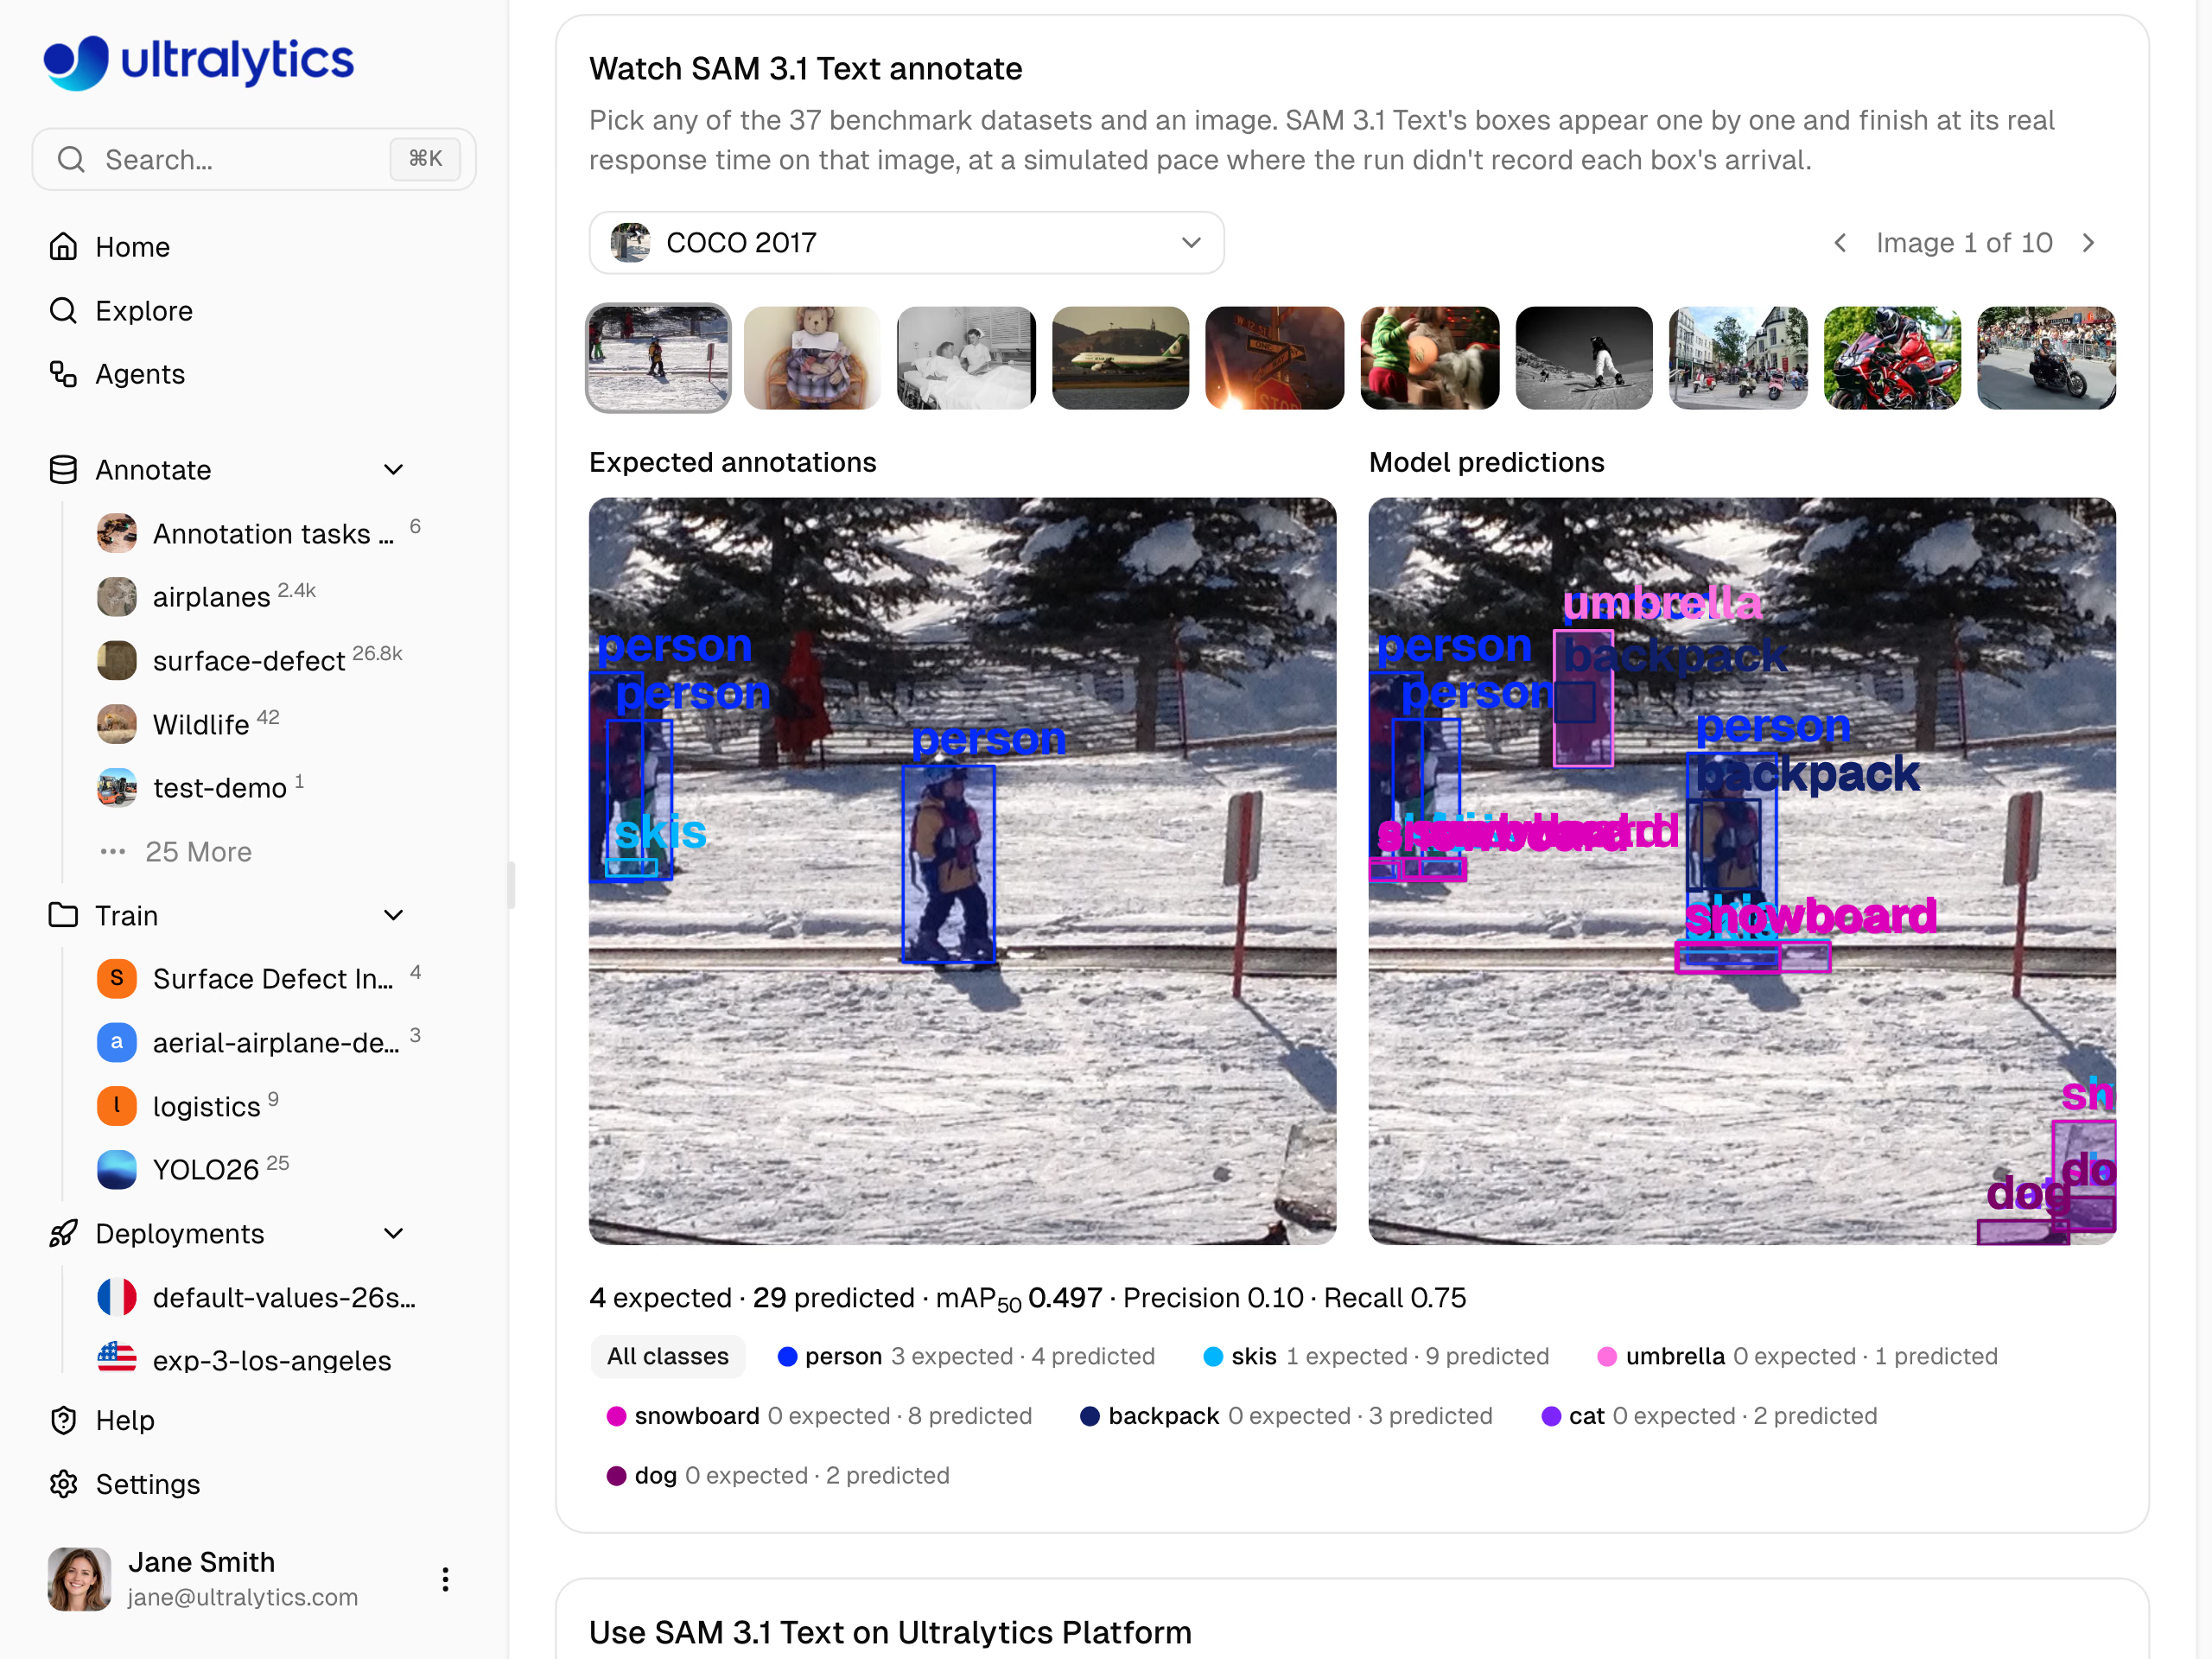
SAM 3.1 Text: 4 nesne için 29 kutu; precision 0.10, recall 0.75. Üç tekrar oynatımının tümü 4 nesnenin 3'ünü buluyor; değişen tek şey inceleyenlerin kaç fazla kutuyu sildiği.
SAM 3.1 Text, inceleyenlerin cömert bir taslağı budamasının beklendiği kalabalık hava ve trafik sahalarına uygundur. Qwen3.8 27B ve Gemma 4 26B, daha düşük doğrulukla dikkatli grup gibi davranır. Düşük maliyetli ücretli modeller arasında Claude Haiku 5.5, 0.56 precision ve 0.47 recall ile 0.429 mAP50 değerine ulaşır; tahmini maliyeti 1.000 görüntü başına 0,37 dolardır. Liderlik tablosunda "En iyi fiyat-performans" olarak işaretlenen diğer model de budur.
Genel ortalamalar senin alanını gizler; bu yüzden veri kümesi tablosunu kontrol et#
Her modelin precision ve recall ortalamaları 36 veri kümesine dayanır; senin verilerin ise tek bir alandır. VLM liderlik tablosunun veri kümesi tablosu, en zordan başlayarak tüm 40 modelin her veri kümesindeki ortalama precision ve recall değerlerini, ayrıca her birindeki en iyi modeli listeler.
Uyarı işaretleri için tabloyu incele. 10 görüntüde 2.267 etiketli tank bulunan Airbus Oil Storage Detection veri kümesinde modellerin ortalama precision değeri 0.39, recall değeri 0.11; en iyi mAP50 değeri ise Gemini 4 Argon'un 0.347 puanıdır. DeepPCB veri kümesinde ortalama precision ve recall sırasıyla 0.03 ve 0.04'tür; GPT-6.1 Sol ise 0.393 mAP50 ile öne çıkar.
Bu sayıları kesin hüküm değil, kısa liste oluşturmak için kullan. Metodoloji, veri kümesi başına 10 görüntünün modelleri ve alanları sıralamak için yeterli olduğunu ancak tek bir veri kümesinin puanını doğrulamaya yetmediğini belirtiyor; tekrarlanan çalıştırmalarda tekil değerler birkaç puan değişiyor. Platform'daki her model sayfası, kıyaslama veri kümelerinde ve COCO'da modelin kaydedilmiş kutularını beklenen kutuların yanında tekrar oynatır. Böylece çalıştırmaya başlamadan önce seninkine en yakın veri kümesini inceleyebilirsin.
Beş adımda modeli inceleme iş akışına uydur#
Önce seçim önceliğini belirle, sonra seçimini kendi görüntülerinde doğrula:
| Önceliğin | Kısa liste (Ekim 2026 sonuçları) |
|---|---|
| Precision'a öncelik ver | Gemini 4 Argon |
| Recall'a öncelik ver | GPT-6 Astra veya GPT-6.1 Sol |
| Her ikisini de değerlendir | GPT-6.1 Terra |
| Sağlayıcı anahtarı yok | Barındırılan: Qwen3.8 27B veya SAM 3.1 Text |
Sınıf istemli etiketleme, 1-200 sınıflı algılama veri kümelerinde çalışır.
- Liderlik tablosunda kısa liste oluştur. Nesne tespiti için VLM liderlik tablosunu Ücretli veya Barındırılan modelleri gösterecek şekilde filtrele (Platformda Yok olarak işaretlenenleri atla), önceliğine uyan sütunu oku ve kendi alanın için veri kümesi tablosunu kontrol et.
- Sağlayıcı anahtarı ekle. Ücretli bir model için anahtarını, veri kümesinin bulunduğu çalışma alanındaki Ayarlar > API Anahtarları bölümüne kaydet. Sağlayıcı ücreti doğrudan anahtarına yansıtır; sağlayıcı anahtarı belgelerinde kurulum açıklanır.
- İncelenmiş bir örnek üzerinde test et. Verilerini temsil eden ve elle etiketlediğin birkaç görüntü seç. Etiket düzenleyicisini aç, Smart moduna geç, model seçicisinde sağlayıcısının altındaki modeli seç ve Predict (
P) düğmesine bas. Sildiğin ve eklediğin kutuları ve incelemenin kaç dakika sürdüğünü say. - Veri kümesini etiketle. Veri kümesi sayfasında Diğer işlemler > Batch Annotation seçeneğini kullan. Bu özellik, en fazla üç görüntü kanalı olan Platform'da barındırılan veri kümelerinde kullanılabilir. Varsayılan olarak etiketsiz görüntüleri etiketler, mevcut etiketleri hiçbir zaman değiştirmez ve geri alabilmen için önce bir veri kümesi sürümü kaydeder. Başlamadan önce iletişim kutusundaki tahmini maliyeti incele: Batch Annotation, işlenen 1.000 görüntü başına 1,00 dolara ve varsa sağlayıcı ücretlerine mal olur.
- İncele, sonra eğit. Modelinin zayıf yönünü göz önünde bulundurarak kutuları kontrol et, kaydet ve sonucu aynı çalışma alanında bir Ultralytics YOLO modelini eğitmek için kullan.
Arka plan bilgisi için Ultralytics Platform'un etiketlemeyi otomatikleştirmek üzere yapay zekâyı nasıl kullandığına ve insan denetimli incelemenin neden işin bir parçası olmaya devam ettiğine bak. Otomatik etiketlemenin farklı araçlarda aktif öğrenmeyle karşılaştırmasını görmek için otomatik etiketleme ve aktif öğrenme karşılaştırmamızı oku.
Ekibe göre kısa liste (Ekim 2026 sonuçları)#
- Taslağı temizlemek yerine tamamlamayı tercih eden inceleyenler: Genel olarak en hassas model olan Gemini 4 Argon; hava, su altı, termal ve güvenlik amaçlı X-ışını verilerinde en güçlü sonuçları veriyor.
- Bir nesneyi kaçırmanın eğitim verisini bozduğu nadir nesneler: En yüksek recall için GPT-6 Astra veya hemen arkasından gelen GPT-6.1 Sol.
- Belirgin bir tercihi olmayan genel amaçlı etiketleme: mAP50, mAP50-95 ve F1'de birinci olan GPT-6.1 Terra.
- Sağlayıcı anahtarı olmayan ekipler: Kalabalık sahnelerde recall odaklı ilk geçişler için SAM 3.1 Text veya daha dikkatli bir taslak için Qwen3.8 27B.
Hangisini seçersen seç, liderlik tablosu başlamadan önce incelemenin nasıl geçeceğini öngörmeni sağlar. Bu metriklerin kuramsal arka planı için accuracy, precision ve recall kılavuzumuz temel bilgileri ele alıyor; Academy'deki algılama metriklerini okuma dersi ise daha ileri gidiyor.
Sık sorulan sorular
Yanlış kutuları silmek daha yavaş bir düzeltmeyse, örneğin kalabalık görüntülerde fazladan kutu doğru olanların arasında kayboluyorsa precision'a öncelik ver. Nadir kusur veya lezyonlarda olduğu gibi kaçırılan bir nesne daha maliyetliyse recall'a öncelik ver; çünkü etiketlenmemiş bir nesne algılayıcıya bunun arka plan olduğunu öğretir. Ardından seçimini kendi görüntülerinden elle incelediğin bir örnek üzerinde doğrula.
Sınıf istemli modeller güven puanı olmadan kutular döndürür ve modele özgü eşikler kullanır; bu nedenle Platform, bunlardan biri seçiliyken güven ve IoU ayarlarını gizler. Dolayısıyla liderlik tablosundaki precision ve recall, modelin IoU 0.5 değerinde döndürdüğü her kutuyu sayar. Eşleşmeyen kutular ile eşleşmeyen nesneler arasındaki dengeyi değiştirmek için farklı bir model seçersin.
Bir modelin doğru nesneleri bulup bulmadığını görmek için mAP50'yi kullan; kutuları nesnelere daha iyi oturdukları için ödüllendiren daha katı örtüşme eşiklerini de hesaba katmak için mAP50-95'i kullan. Her ikisi de kaçırılan nesneleri ve yanlış pozitifleri yansıtır; bu yüzden değerleri precision ve recall ile birlikte değerlendir. Ekim 2026 sonuçlarında GPT-6.1 Terra sırasıyla 0.560 ve 0.345 ile her iki ölçütte de lider.
Evet. UL37 v2'deki en iyi modelin ortalaması 0.560 mAP50'dir (Ekim 2026); PCB kusurları ve göğüs röntgenleri gibi en zor veri kümelerinde 40 modelin ortalaması 0.05'in altındadır. Her görüntüyü incele ve özellikle modelin zayıf yönüne dikkat et: recall odaklı bir modelin ek kutularına, precision odaklı bir modelin kaçırdığı nesnelere bak.
Maliyetin iki bölümü vardır. Ultralytics Platform'daki Batch Annotation, barındırılanlar dâhil tüm modeller için işlenen 1.000 görüntü başına 1,00 dolara (en az 0,01 dolar) mal olur; düzenleyicide barındırılan bir modelle yapılan tekil tahminler ücretsizdir. Ücretli sağlayıcı modellerinin ücretini de sağlayıcı kendi API anahtarına yansıtır. Ekim 2026 kıyaslamasında bu kılavuzdaki modellerin sağlayıcı maliyeti tahminleri, 1.000 görüntü başına 0,37 dolar (Claude Haiku 5.5) ile 49,31 dolar (GPT-6 Astra) arasında değişiyordu. Bir çalıştırmayı durdurduğunda, o ana kadar işlenen görüntülerin ücreti alınır.
Evet. SAM 3.1 Text, Qwen3.8 27B ve Gemma 4 26B gibi barındırılan modeller, kendi YOLO modellerin gibi Ultralytics Platform'da sağlayıcı anahtarı olmadan çalışır. Toplu çalıştırmalar işlenen 1.000 görüntü başına yine 1,00 dolara mal olur ve iletişim kutusunda her çalıştırmadan önce tahmini maliyet gösterilir.
İşin gereksinimlerine bağlı. Sınıf istemli bir VLM, yalnızca sınıf adlarını kullanarak yeni sınıflar için taslak etiketler oluşturabilir; ancak Ekim 2026 kıyaslamasında en yüksek puanlı altı model görüntü başına 2,7-11,6 saniye sürdü ve token başına ücretlendirilir. Gerçek zamanlı algılama için yaygın bir yaklaşım VLM ile otomatik etiketleme yapmak, etiketleri incelemek ve ardından bu verilerle bir Ultralytics YOLO modelini eğitmektir. Önceden eğittiğin bir YOLO modeli de aynı düzenleyicide yeni görüntüleri otomatik etiketleyebilir.
Yazan
Baş Yazılım Mühendisi · Ultralytics
Yorumlar2
Soru sor, sonuçlarını paylaş veya başka birine yardım et.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









