Cách chọn VLM để tự động gán nhãn bằng precision và recall
Chọn VLM để tự động gán nhãn dựa trên precision và recall: model nào tạo ít bbox thừa hơn, bỏ sót ít đối tượng hơn và cách kiểm thử trên dữ liệu của riêng bạn.
 Sergiu Waxmann19 phút đọc
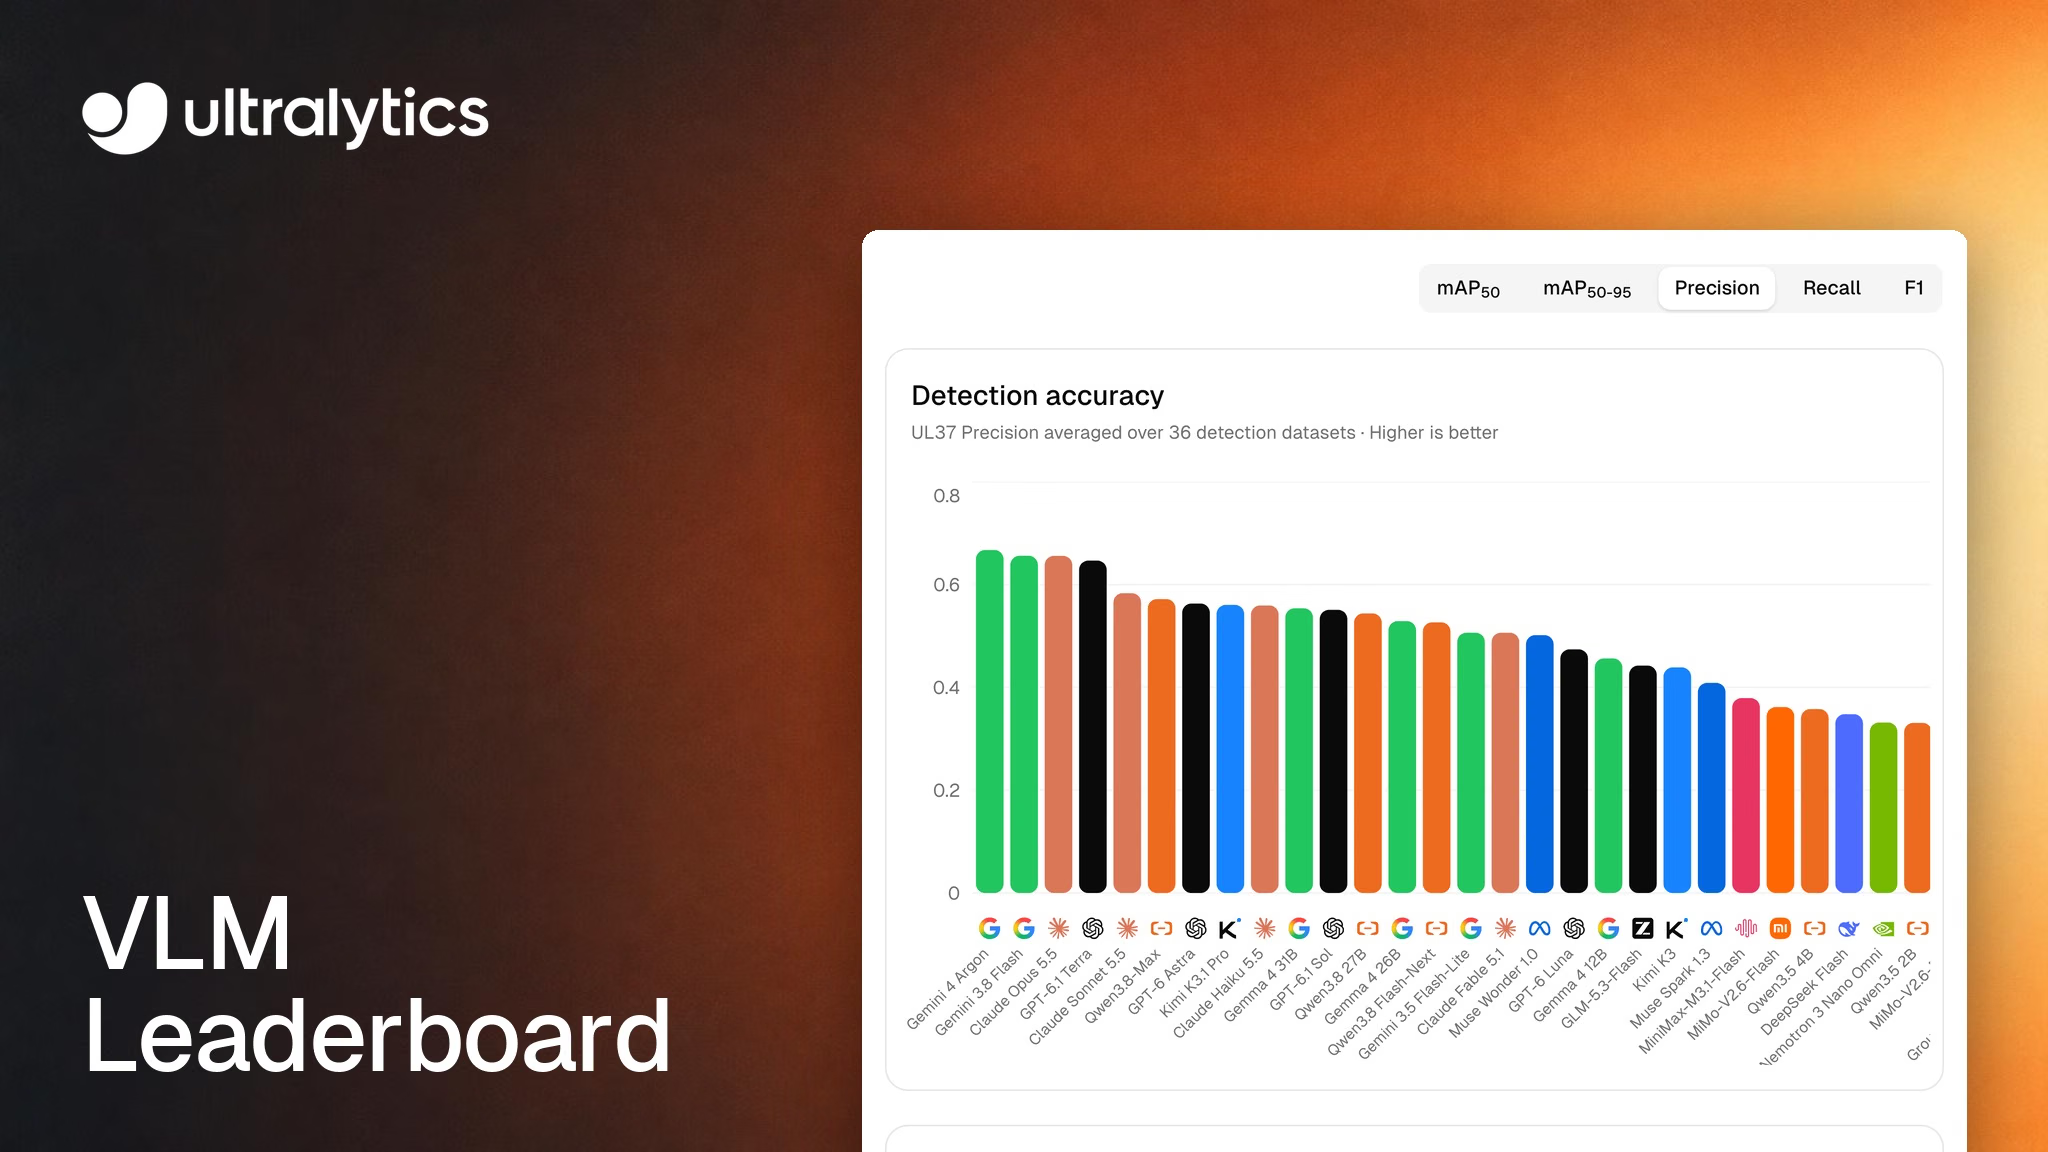
Việc chọn model để tự động gán nhãn cho dataset phụ thuộc vào loại lỗi mà người đánh giá muốn xử lý hơn: xóa các bounding box thừa hay thêm những bounding box mà model bỏ sót. Bảng xếp hạng VLM của Ultralytics hiện hiển thị sự đánh đổi này cho mọi model, cùng với precision (tỷ lệ bounding box của model là chính xác) và recall (tỷ lệ đối tượng đã gán nhãn mà model phát hiện được), dựa trên kết quả benchmark công bố ngày 28 tháng 10 năm 2026.
Để có bản nháp đầu tiên sạch nhất, hãy bắt đầu với Gemini 4 Argon. Để bỏ sót ít đối tượng nhất, hãy bắt đầu với GPT-6 Astra. Để có sự cân bằng tốt nhất và chi phí thấp nhất trong số sáu model đạt điểm cao nhất, hãy chọn GPT-6.1 Terra. Nếu không có API key của nhà cung cấp AI riêng, hãy bắt đầu với Qwen3.8 27B được lưu trữ sẵn, hoặc SAM 3.1 Text cho những cảnh đông đúc mà bạn muốn chủ động loại bỏ các phát hiện thừa.
Hướng dẫn này giải thích cách đọc các chỉ số, model nào phù hợp với từng trường hợp và cách xác nhận lựa chọn trên chính hình ảnh của bạn. Thứ hạng và giá thay đổi sau mỗi lần chạy, vì vậy hãy xem các số liệu ở đây là ví dụ của tháng 10 năm 2026 và kiểm tra bảng xếp hạng để biết kết quả hiện tại.
Model được nhắc bằng tên lớp không có thanh trượt confidence, vì vậy lựa chọn model chính là ngưỡng của bạn#
Với model Ultralytics YOLO trong trình chỉnh sửa chú thích, bạn tự điều chỉnh sự đánh đổi. Tăng ngưỡng confidence sẽ giảm bbox dương tính giả nhưng tăng số trường hợp bỏ sót; giảm ngưỡng thì ngược lại. Mô hình ngôn ngữ thị giác (VLMs) được nhắc bằng tên lớp hoạt động khác. Như tài liệu về trình chỉnh sửa chú thích giải thích, các model này phát hiện những lớp của dataset bằng ngưỡng riêng theo từng model và không trả về điểm confidence, nên Ultralytics Platform ẩn các cài đặt confidence và IoU khi một model như vậy được chọn.
Điều đó làm thay đổi ý nghĩa của precision và recall trên bảng xếp hạng. Theo phương pháp benchmark, precision và recall tính mọi bbox mà model trả về tại IoU bằng 0.5, không có điểm vận hành ẩn. Các chỉ số này mô tả những bbox mà người đánh giá thực sự nhận được.
Benchmark phía sau bảng xếp hạng là UL37 v2: 10 hình ảnh từ mỗi trong số 36 dataset phát hiện đối tượng thực tế trên Platform, cộng thêm 10 hình ảnh tham chiếu COCO 2017 được chấm điểm riêng, tổng cộng 370 hình ảnh và 7.268 bbox. Mỗi hình ảnh chạy qua cùng pipeline production như Smart và Batch Annotation, sử dụng tên lớp riêng của dataset; SAM 3.1 tinh chỉnh bbox của mọi model ngoại trừ bbox của SAM 3. Việc chấm điểm dùng các metric phát hiện đối tượng riêng của package Ultralytics, tức mã dùng để xác thực model YOLO, và mỗi dataset có trọng số ngang nhau trong phép tính trung bình.
Precision theo dõi bbox không khớp, recall theo dõi đối tượng không được tìm thấy#
Precision là tỷ lệ bbox của model khớp với đối tượng được gán nhãn đúng lớp tại IoU 0.5. Recall là tỷ lệ đối tượng được gán nhãn mà model khớp được. Khi xem xét nhãn:
- Precision thấp nghĩa là có nhiều bbox cần xóa, gán nhãn lại hoặc đổi kích thước cho đến khi khớp.
- Recall thấp nghĩa là có nhiều đối tượng được gán nhãn cần thêm bbox, đổi kích thước bbox hoặc gán nhãn lại.
- F1 là trung bình điều hòa của hai chỉ số, 2 x P x R / (P + R), một con số tóm lược cả hai. Chỉ số này không đo thời gian đánh giá.
- mAP50 và mAP50-95 xếp hạng model theo average precision trên các lớp, tại IoU 0.5 và trên các ngưỡng nghiêm ngặt hơn từ 0.50 đến 0.95. mAP50 là tiêu chí sắp xếp của bảng xếp hạng.
Dưới đây là sáu model đạt mAP50 trên 0.51. Chi phí được ước tính từ lượng token do nhà cung cấp báo cáo trên mỗi 1.000 hình ảnh benchmark được gán nhãn thành công, còn độ trễ là thời gian yêu cầu trung vị:
| Model | mAP50 | mAP50-95 | Precision | Recall | F1 | Chi phí nhà cung cấp / 1.000 hình ảnh (mức sử dụng trong benchmark) | Độ trễ |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.65 | 0.61 | 0.63 | $4.36 | 5.1 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.67 | 0.59 | 0.62 | $7.60* | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.66 | 0.59 | 0.62 | $13.92 | 2.7 s |
| GPT-6 Astra | 0.525 | 0.325 | 0.56 | 0.63 | 0.59 | $49.31 | 11.6 s |
| Gemini 3.8 Flash | 0.516 | 0.321 | 0.66 | 0.56 | 0.60 | $5.86 | 7.4 s |
| GPT-6.1 Sol | 0.514 | 0.318 | 0.55 | 0.62 | 0.58 | $10.30 | 10.5 s |
*Ước tính cho Gemini 4 Argon sử dụng mức giá ưu đãi ra mắt của Google, áp dụng đến ngày 30 tháng 11 năm 2026. Từ ngày 1 tháng 12, mức giá tiêu chuẩn của Google tăng gấp đôi, lên khoảng $15 cho mỗi 1.000 hình ảnh với cùng mức sử dụng. Batch Annotation trên Ultralytics Platform tính thêm $1.00 cho mỗi 1.000 hình ảnh được xử lý với mọi model, kể cả model được lưu trữ.
Sáu model chia thành hai nhóm. Argon, Opus 5.5 và Gemini 3.8 Flash có precision từ 0.66 đến 0.67 nhưng recall dưới 0.60: tỷ lệ bbox khớp cao, nhưng chúng khớp được ít đối tượng đã gán nhãn hơn. Astra và Sol đạt recall từ 0.62 đến 0.63 với precision từ 0.55 đến 0.56: chúng khớp được tỷ lệ đối tượng đã gán nhãn cao hơn, trong khi tỷ lệ bbox khớp thấp hơn. Terra nằm giữa hai nhóm và dẫn đầu về mAP50 và F1.
Ưu tiên precision khi xử lý bbox thừa tốn nhiều công sức#
Với 0.667, Gemini 4 Argon có precision tổng thể cao nhất trong 40 model của benchmark. Sự đánh đổi là recall trung bình 0.585, thấp hơn các model dẫn đầu về recall.
Precision quan trọng nhất khi khó phát hiện bbox không khớp. Trong ảnh đông đúc, người đánh giá phải tìm bbox sai giữa nhiều bbox đúng trước khi sửa. Các kệ hàng bán lẻ dày đặc trong SKU110K cho thấy precision có thể dao động nhiều thế nào trên những hình ảnh như vậy: trong kết quả GPT-6.1 Terra của chúng tôi, Terra đạt precision 0.79 và recall 0.73, so với 0.49 và 0.77 của GPT-6.1 Sol.
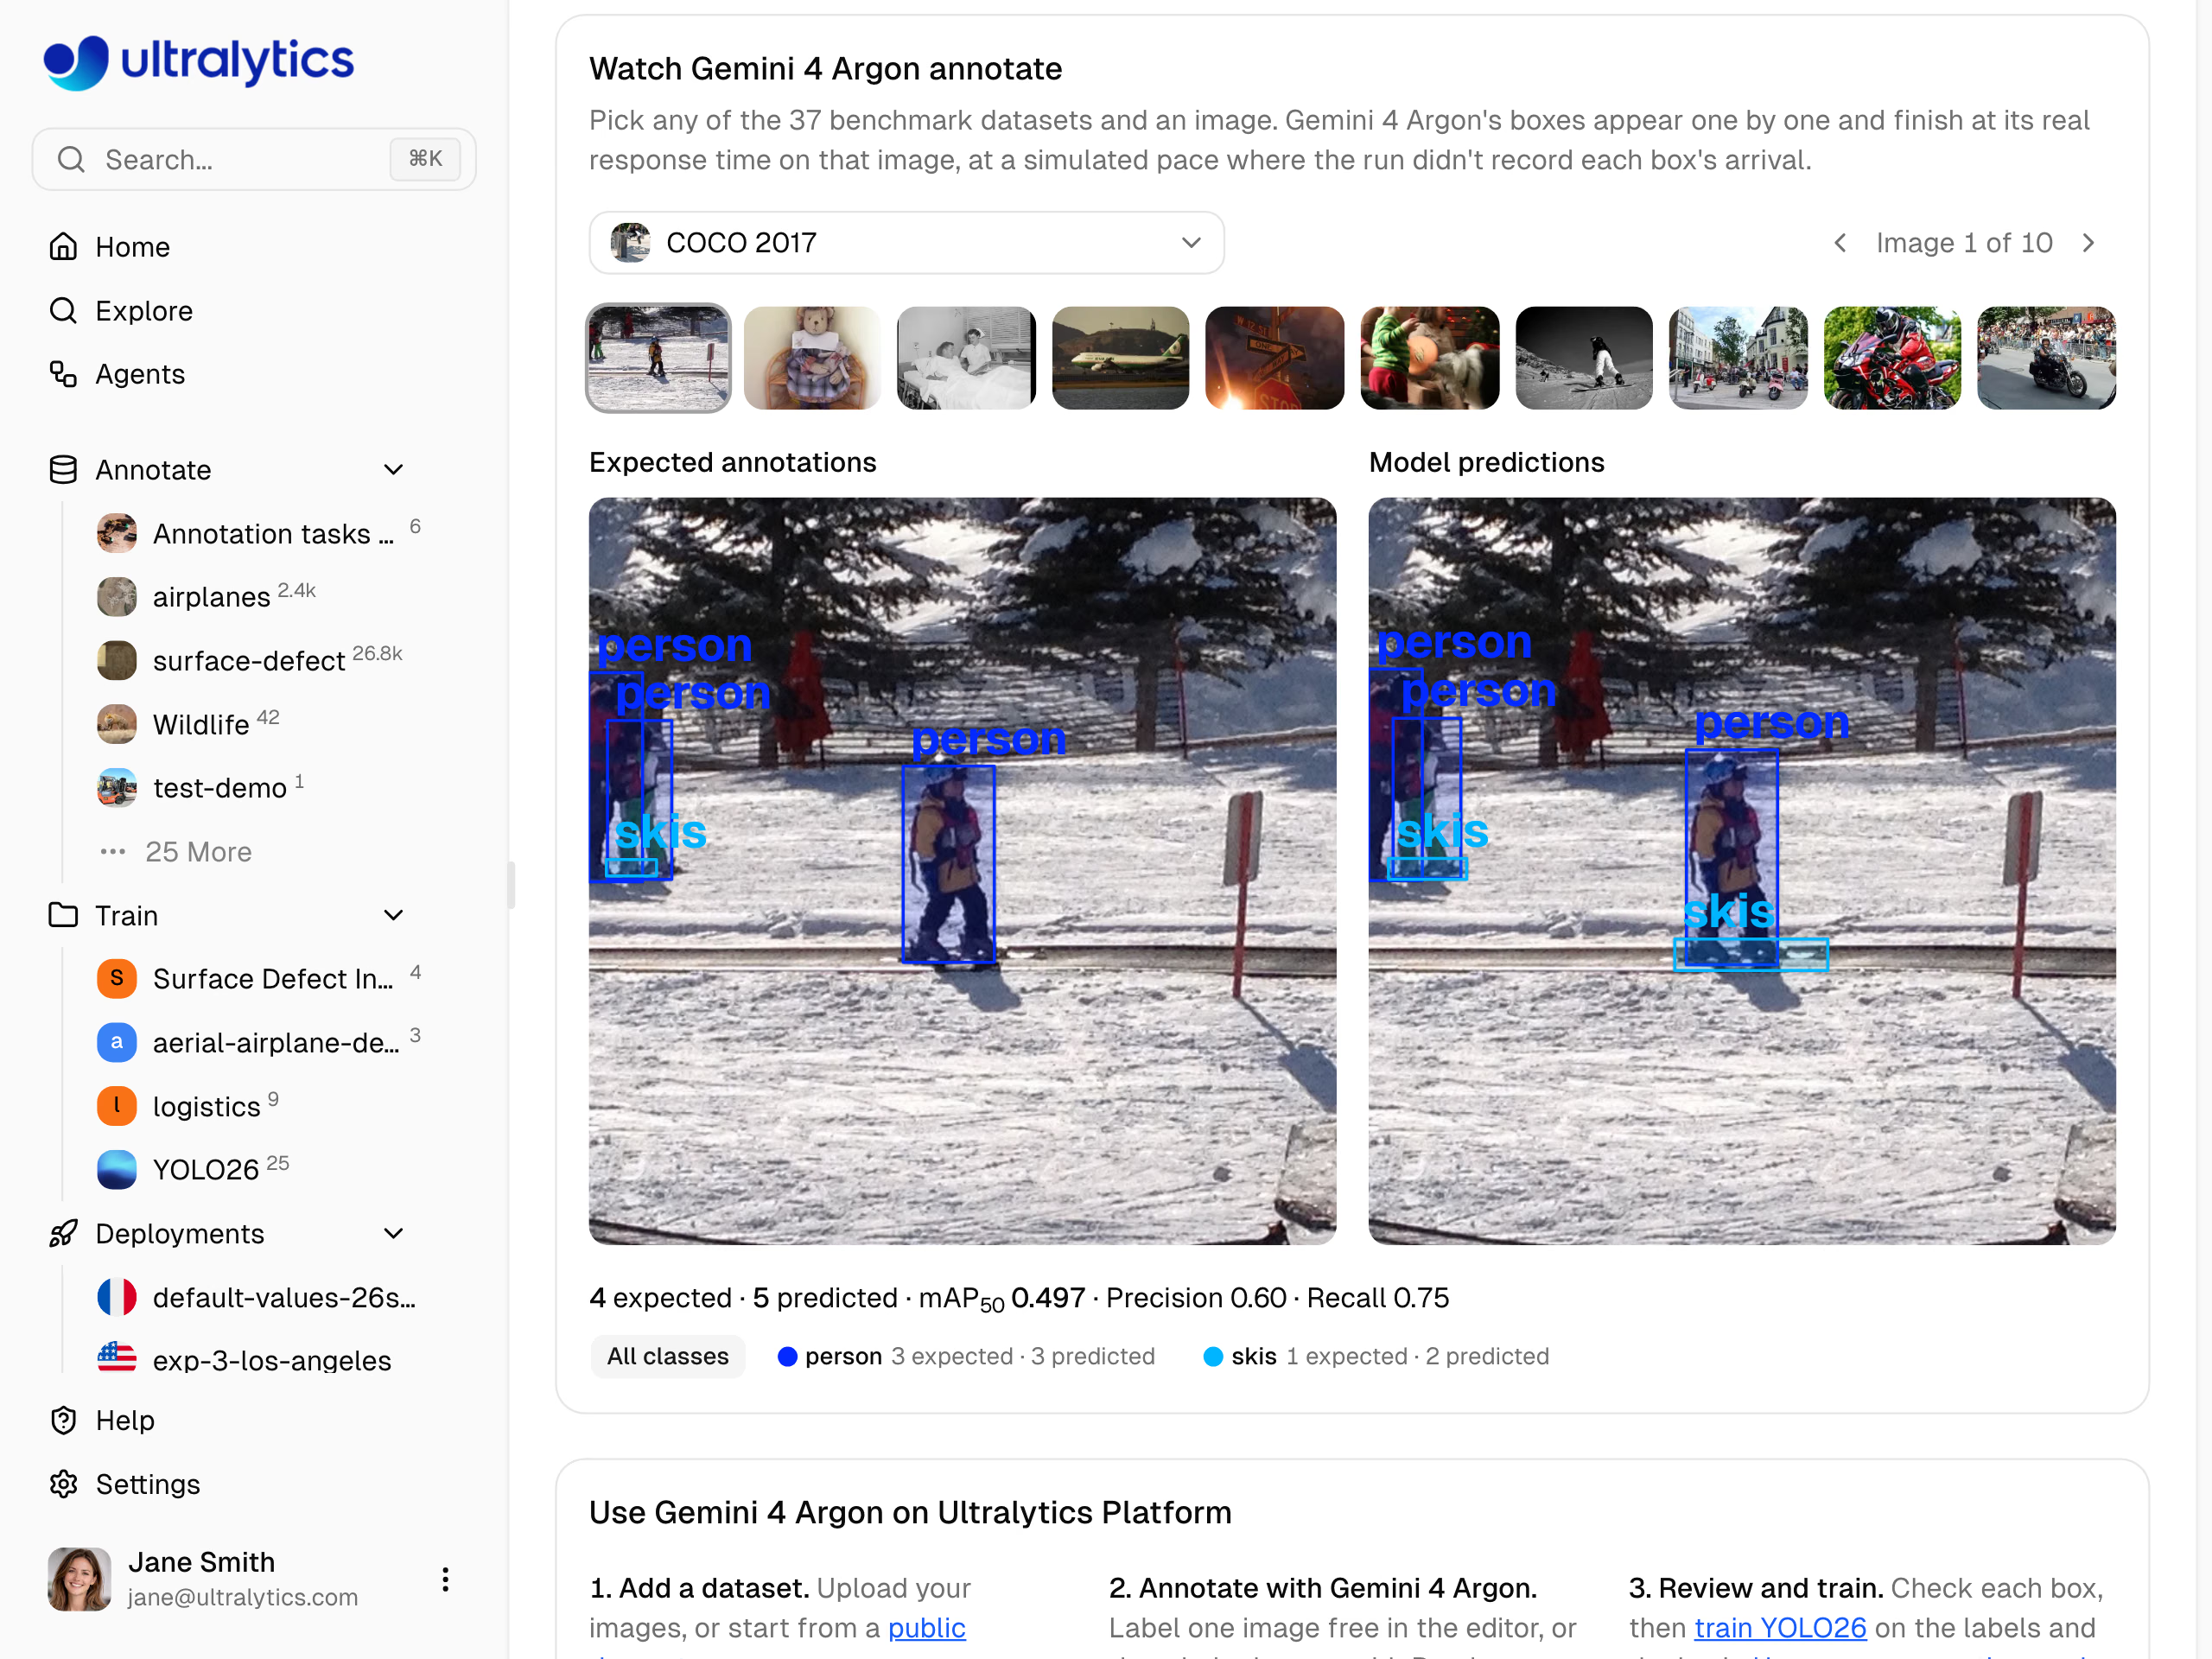
Gemini 4 Argon: dự đoán 5 bbox cho 4 đối tượng được gán nhãn, precision 0.60, recall 0.75.
Argon cũng không có yêu cầu nào thất bại trong benchmark, và thời gian trung vị 4,6 giây là nhanh nhất trong hai model đứng đầu. Hãy chọn Argon khi dữ liệu của bạn tương tự các lĩnh vực mà model đạt kết quả tốt nhất: ảnh trên không, dưới nước, ảnh nhiệt và ảnh X-quang an ninh (Argon có mAP50 tốt nhất trên các ảnh quét an ninh IEDXray, đạt 0,298), cũng như khi nhóm của bạn muốn bổ sung một vài đối tượng bị bỏ sót hơn là tìm các bounding box thừa.
Ưu tiên recall khi bỏ sót đối tượng là lỗi tốn kém#
GPT-6 Astra có recall trung bình cao nhất trên bảng, đạt 0.627. Đổi lại, precision của model là 0.56.
Gán nhãn ưu tiên recall phù hợp khi một đối tượng không được gán nhãn là lỗi tốn kém hơn. Một lỗi hoặc tổn thương bị bỏ sót trong tập huấn luyện khiến detector học rằng đối tượng đó là nền; để tìm bounding box bị thiếu, bạn phải quét mọi hình ảnh để tìm những thứ chưa được đánh dấu. Astra có mAP50 tốt nhất trên 7 trong số 36 dataset, bao gồm ảnh X-quang ngực TBX11K (0,330), ảnh X-quang cổ tay trẻ em GRAZPEDWRI-DX (0,354) và lỗi bề mặt PCB trong DsPCBSD+ (0,394): đây là lý do để thử nghiệm Astra trên dữ liệu tương tự, chứ không phải bằng chứng rằng Astra sẽ bỏ sót ít đối tượng hơn trên dữ liệu của bạn.
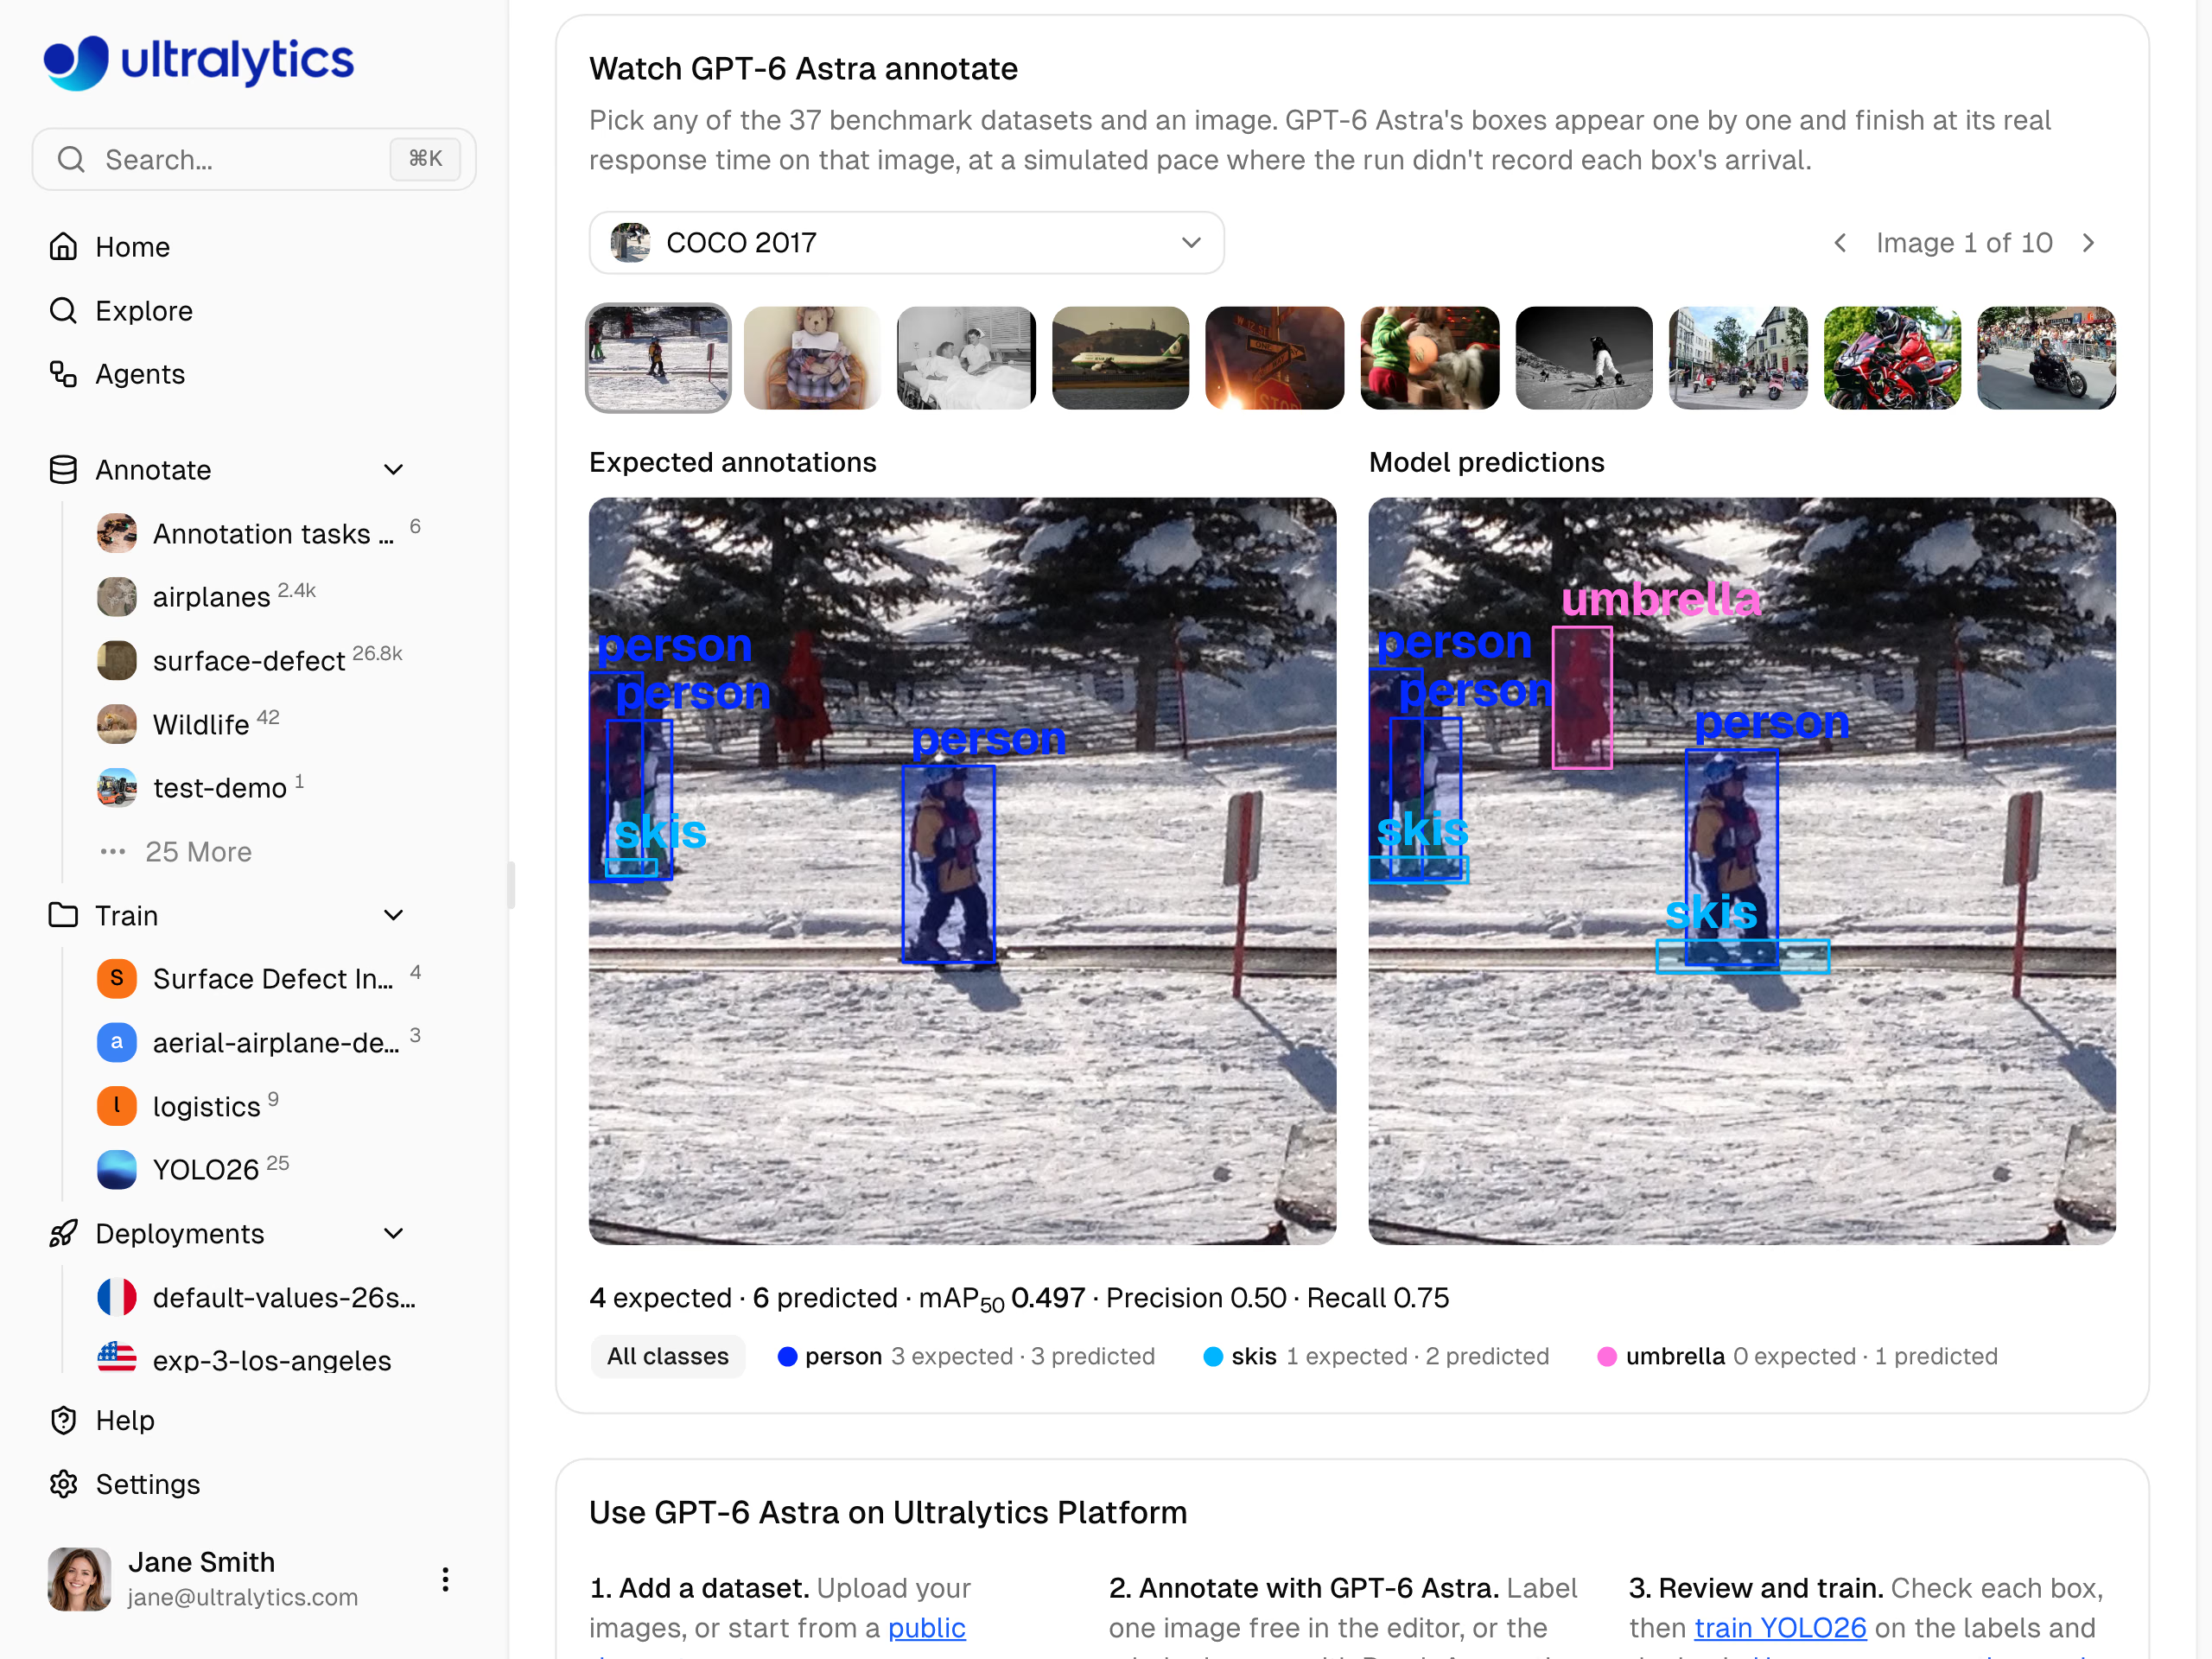
GPT-6 Astra: 6 bounding box cho cùng 4 đối tượng, trong đó có một chiếc ô bị thiếu trong nhãn COCO; precision 0.50, recall 0.75.
Astra có mức chi phí ước tính cao nhất trong sáu model dẫn đầu: $49.31 cho mỗi 1.000 hình ảnh, thời gian trung vị 11.6 giây và yêu cầu thất bại trên 1% hình ảnh. Hai model OpenAI khác có recall gần bằng: GPT-6.1 Sol đạt 0.62, ước tính $10.30, và GPT-6.1 Terra đạt 0.61, ước tính $4.36.
Cân nhắc cả hai loại lỗi bằng mAP50-95 và F1#
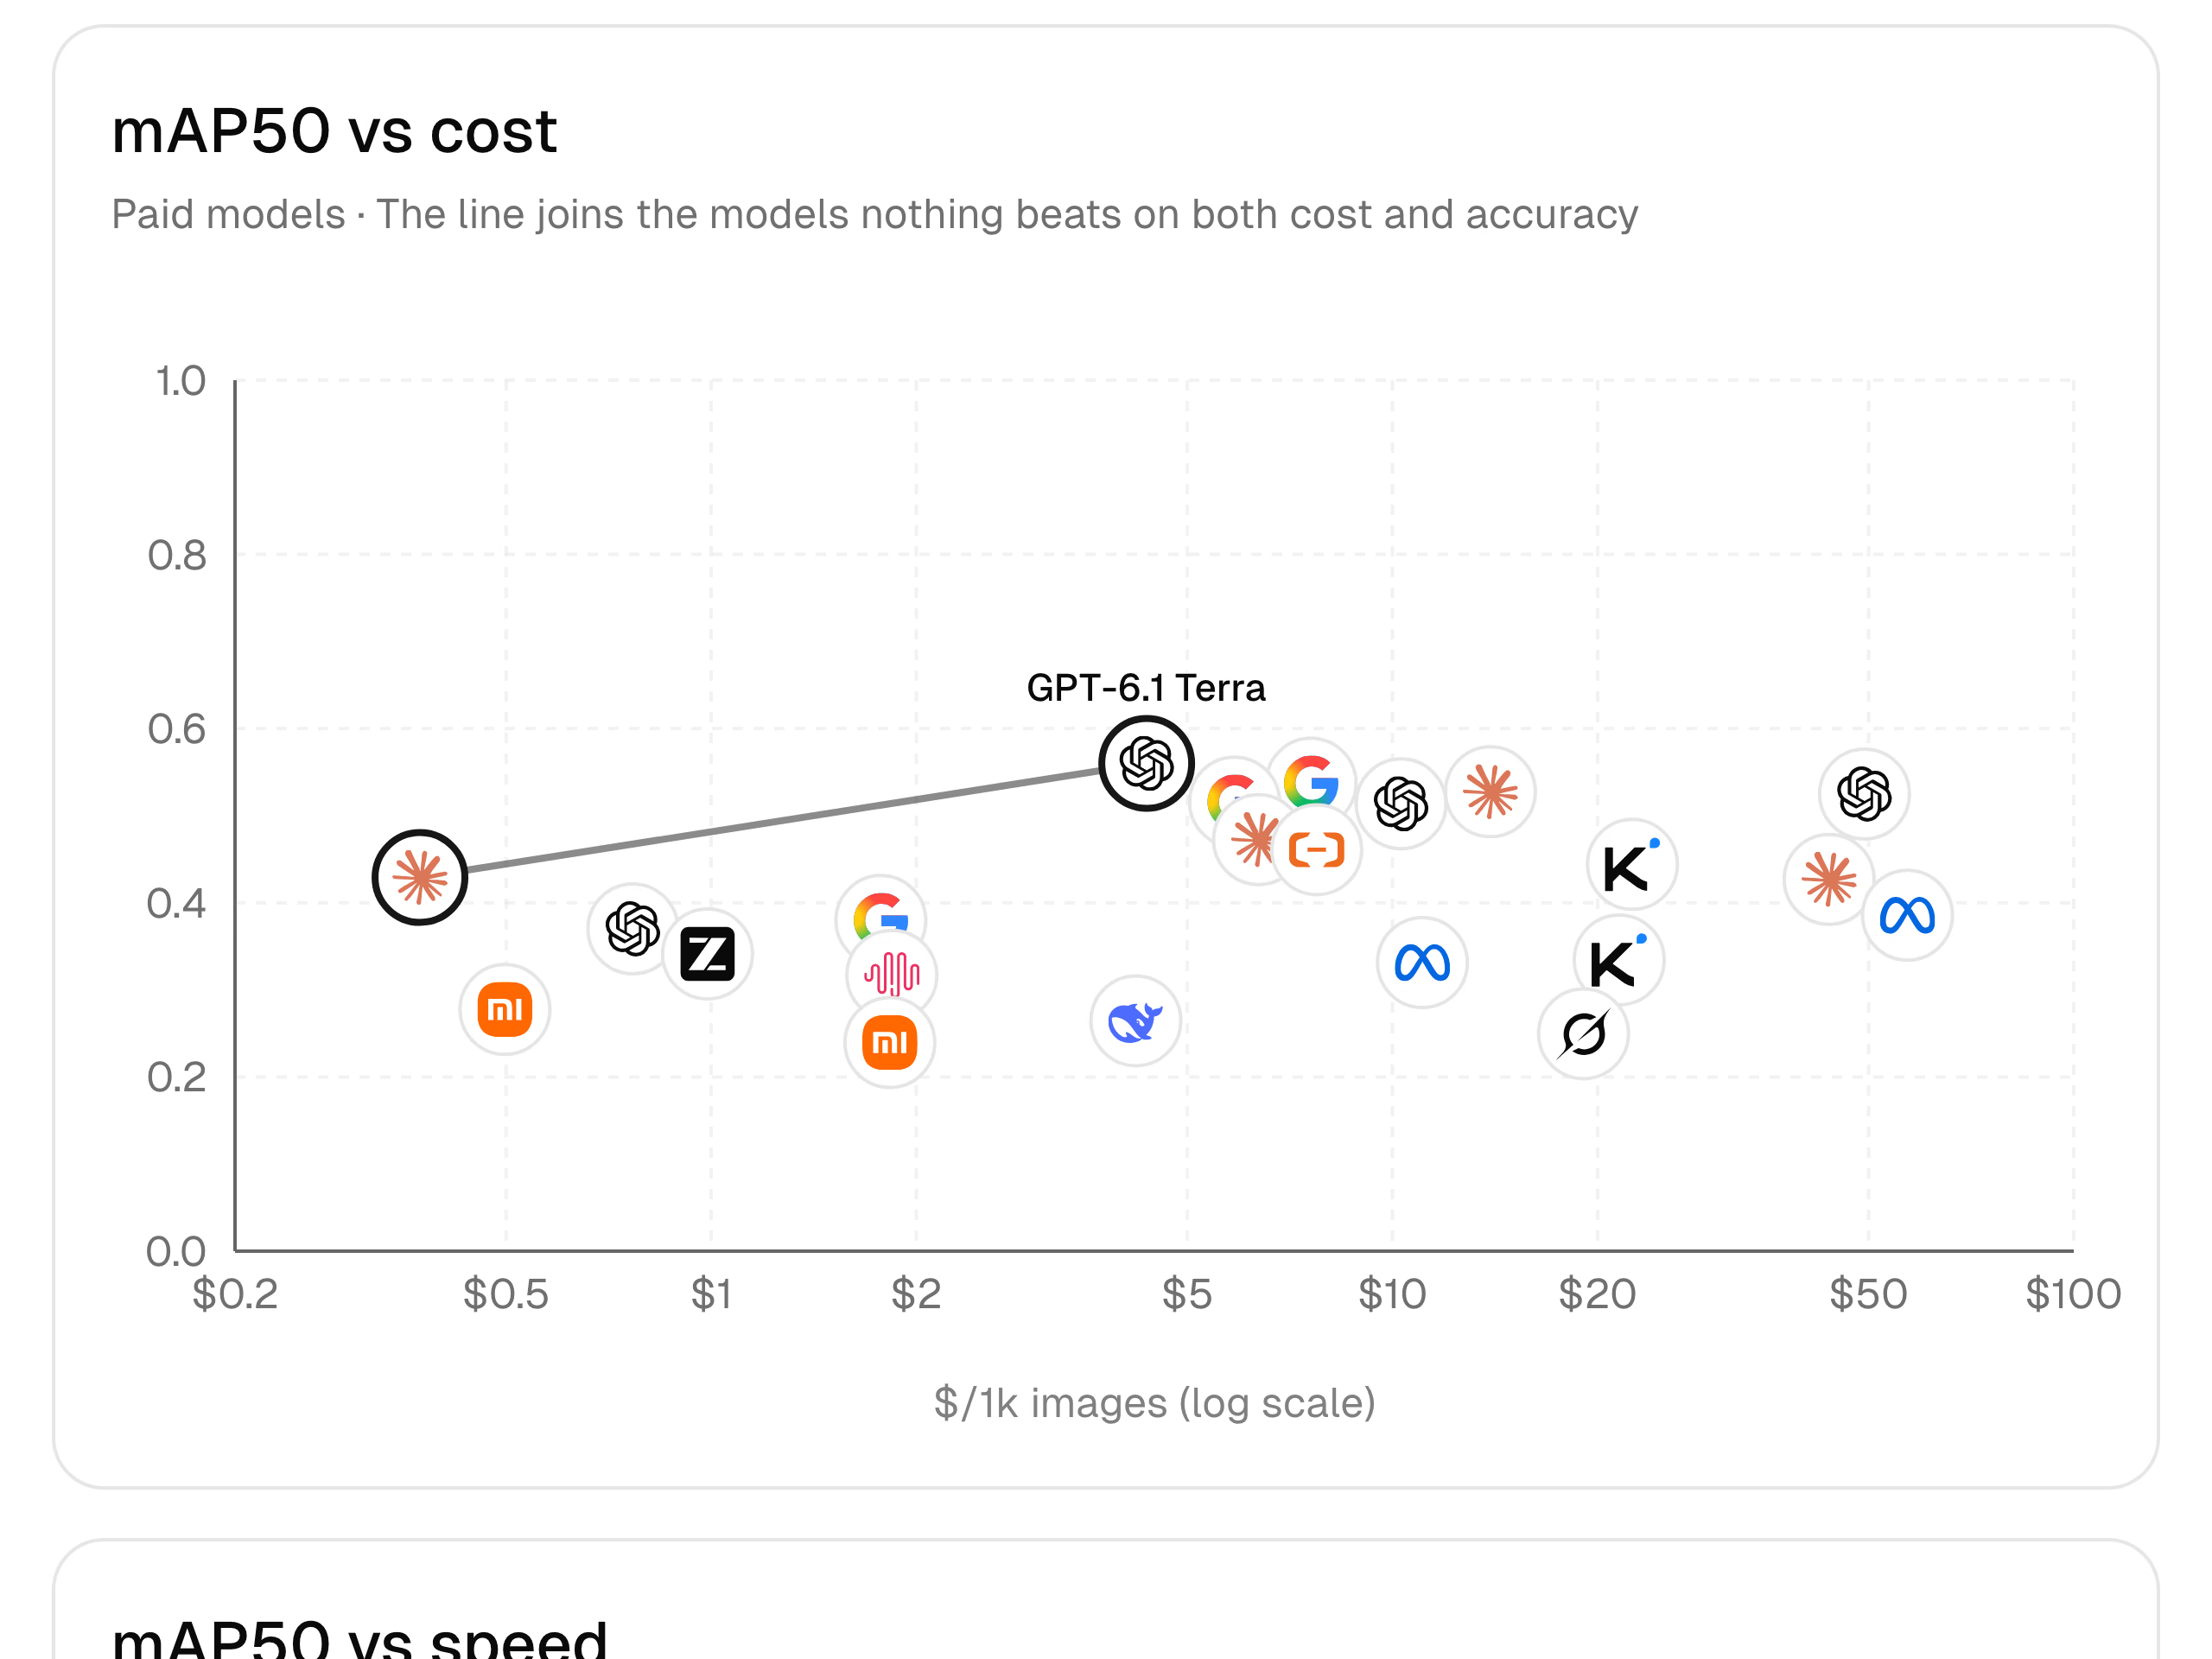
GPT-6.1 Terra dẫn đầu bảng với mAP50 0.560 và mAP50-95 0.345. Precision 0.646 và recall 0.613 của model đều chỉ cách các model dẫn đầu vài phần trăm, còn F1 0.63 là cao nhất trong sáu model, nhỉnh hơn Argon và Opus 5.5 ở mức 0.62. Khi F1 gần nhau như vậy, và vì F1 không cho biết thời gian đánh giá, hãy để kết quả theo từng lĩnh vực và phép thử trên hình ảnh của riêng bạn quyết định lựa chọn.
Vị trí dẫn đầu về mAP50-95 đem lại thêm một tín hiệu. Vì mAP50-95 lấy trung bình trên các ngưỡng chồng lấp đến 0.95, chỉ số này đánh giá cao cả model có bbox khớp sát lẫn model tìm đúng đối tượng; Terra cũng đứng đầu chỉ số này. Model cũng có mức chi phí ước tính thấp nhất trong sáu model dẫn đầu và không có yêu cầu thất bại nào; bảng xếp hạng đánh dấu model là "Giá trị tốt nhất".
Gán nhãn không cần API key của nhà cung cấp: model được lưu trữ và detector từ vựng mở#
Không phải nhóm nào cũng muốn dùng API key trả phí của nhà cung cấp. Các model được lưu trữ trên Platform chạy mà không cần API key, và kết quả của chúng cho thấy một bức tranh khác:
- SAM 3.1 Text: mAP50 0.332, precision 0.19, recall 0.47, 0.2 giây mỗi hình ảnh. Đây là model tốt nhất trong cả 40 model trên VisDrone (mAP50 0.479) và dữ liệu giao thông Fisheye8K (0.478).
- Qwen3.8 27B: mAP50 0.351, precision 0.54, recall 0.40, 1.5 giây.
- Gemma 4 26B: mAP50 0.344, precision 0.53, recall 0.39, 0.9 giây.
Các detector từ vựng mở cũng được lưu trữ. Trong benchmark này, OWLv2 Large đạt mAP50 0.133 và Grounding DINO Base đạt 0.104, cả hai đều xử lý mỗi hình ảnh trong 0.2 giây, so với 0.332 của SAM 3.1 Text. Các điểm số này đo pipeline trên Platform sử dụng tên lớp để nhắc model, có bước tinh chỉnh bbox bằng SAM 3.1, chứ không phải cấu hình ban đầu của từng model.
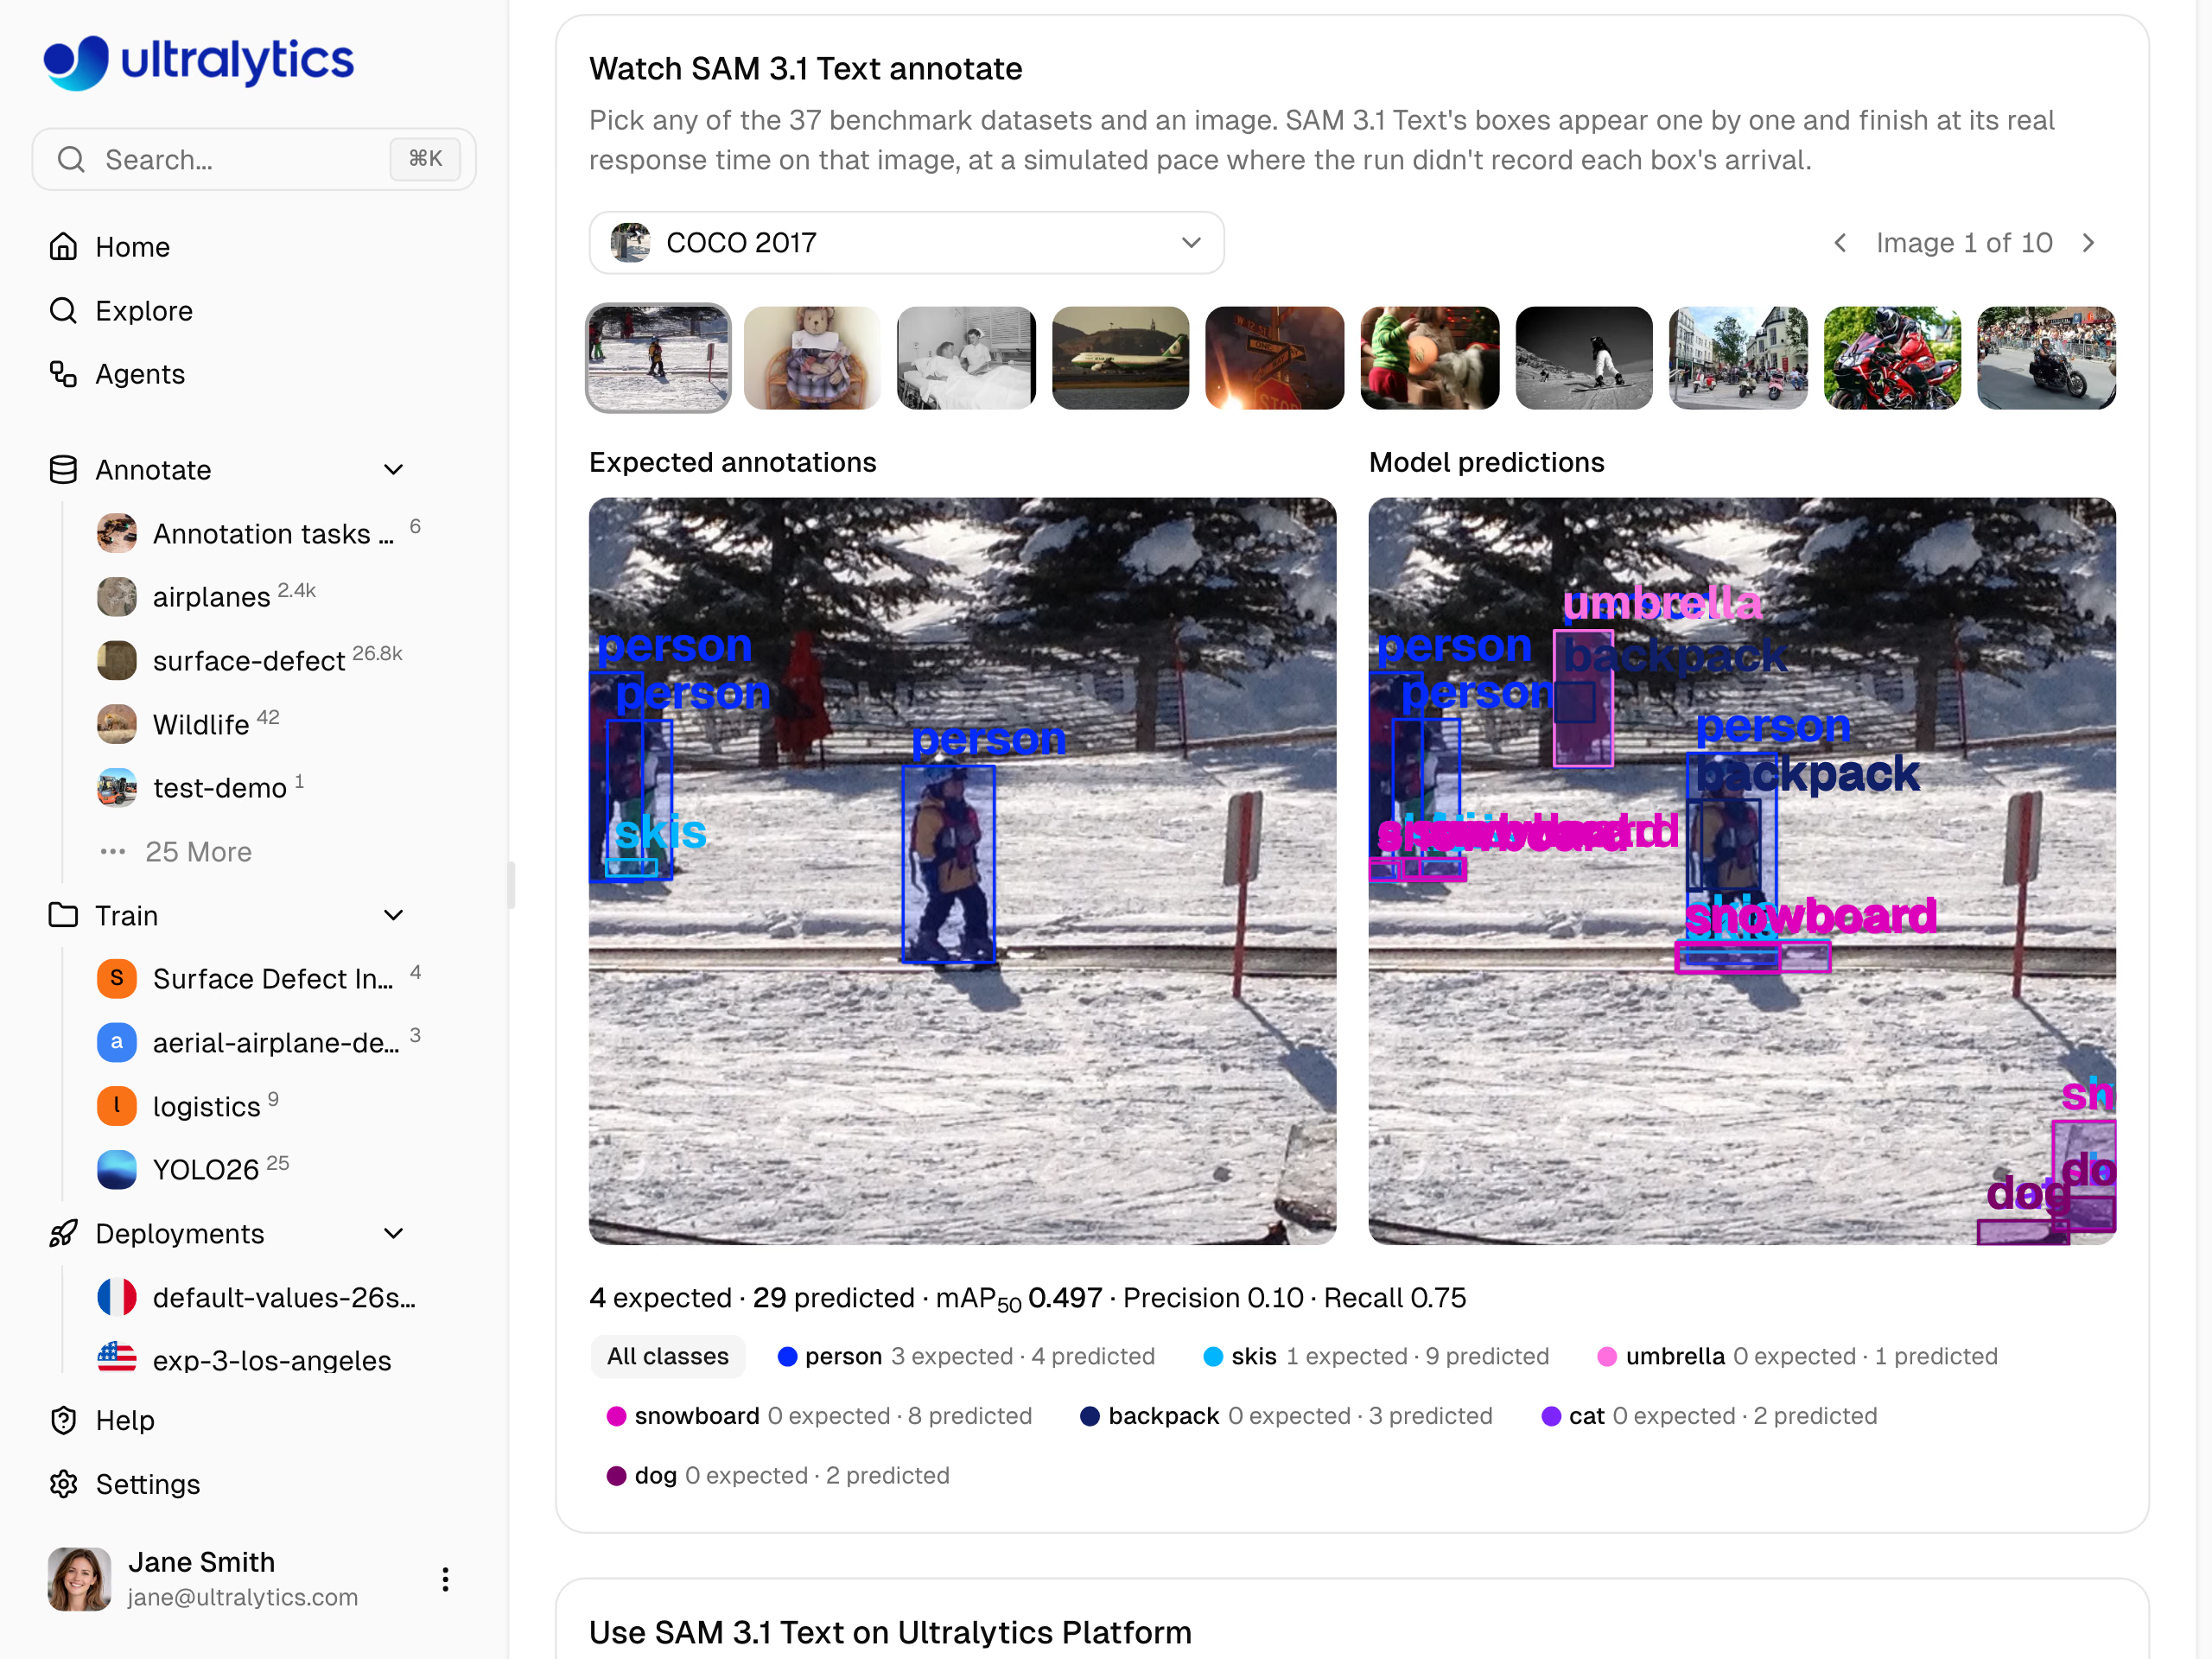
SAM 3.1 Text: 29 bbox cho 4 đối tượng, precision 0.10, recall 0.75. Cả ba lượt chạy lại đều tìm thấy 3 trong số 4 đối tượng; điểm khác biệt là người đánh giá phải xóa bao nhiêu bbox thừa.
SAM 3.1 Text phù hợp với cảnh giao thông và ảnh chụp từ trên không đông đúc, nơi người đánh giá dự kiến sẽ tinh giản bản nháp có nhiều bbox. Qwen3.8 27B và Gemma 4 26B có hành vi giống nhóm cẩn trọng nhưng độ chính xác thấp hơn. Trong nhóm model trả phí giá thấp, Claude Haiku 5.5 đạt mAP50 0.429, precision 0.56 và recall 0.47, với chi phí ước tính $0.37 cho mỗi 1.000 hình ảnh; đây là model còn lại được bảng xếp hạng đánh dấu "Giá trị tốt nhất".
Điểm trung bình toàn bảng che khuất đặc thù dữ liệu của bạn, vì vậy hãy xem bảng dataset#
Precision và recall của mỗi model là giá trị trung bình trên 36 dataset, còn dữ liệu của bạn thuộc một lĩnh vực cụ thể. Bảng dataset trong bảng xếp hạng VLM liệt kê precision và recall trung bình của cả 40 model trên từng dataset, xếp theo độ khó từ cao nhất, đồng thời nêu model tốt nhất trên mỗi dataset.
Hãy xem bảng để nhận biết dấu hiệu cảnh báo. Trên Airbus Oil Storage Detection, gồm 2.267 bồn chứa được gán nhãn trong 10 hình ảnh, các model đạt precision trung bình 0.39 và recall 0.11; mAP50 tốt nhất là 0.347 của Gemini 4 Argon. Trên DeepPCB, precision và recall trung bình lần lượt là 0.03 và 0.04; GPT-6.1 Sol nổi bật với mAP50 0.393.
Hãy xem các số liệu này là danh sách rút gọn, không phải kết luận cuối cùng. Phương pháp benchmark nêu rõ rằng 10 hình ảnh cho mỗi dataset đủ để xếp hạng model và lĩnh vực, nhưng không đủ để xác nhận điểm số của một dataset riêng lẻ; các lần chạy lặp lại có thể làm từng số liệu thay đổi vài điểm. Trang của mỗi model trên Platform phát lại bbox đã ghi nhận của model bên cạnh bbox kỳ vọng trên các dataset benchmark và COCO, để bạn có thể kiểm tra dataset gần với dữ liệu của mình nhất trước khi bắt đầu chạy.
Chọn model phù hợp với quy trình đánh giá của bạn qua năm bước#
Bắt đầu từ ưu tiên khi lựa chọn, sau đó xác nhận lựa chọn bằng hình ảnh của riêng bạn:
| Ưu tiên của bạn | Danh sách rút gọn (kết quả tháng 10 năm 2026) |
|---|---|
| Ưu tiên precision | Gemini 4 Argon |
| Ưu tiên recall | GPT-6 Astra hoặc GPT-6.1 Sol |
| Cân nhắc cả hai | GPT-6.1 Terra |
| Không có API key của nhà cung cấp | Được lưu trữ sẵn: Qwen3.8 27B hoặc SAM 3.1 Text |
Gán nhãn bằng cách nhắc model theo tên lớp hoạt động trên các dataset phát hiện đối tượng có từ 1 đến 200 lớp.
- Lập danh sách lựa chọn trên bảng xếp hạng. Lọc bảng xếp hạng VLM cho bài toán phát hiện đối tượng để chỉ hiển thị model Paid hoặc Hosted (bỏ qua mọi model được đánh dấu Not on Platform), đọc cột tương ứng với ưu tiên của bạn và kiểm tra bảng dataset để tìm lĩnh vực phù hợp.
- Thêm API key của nhà cung cấp. Với model trả phí, hãy lưu API key trong Settings > API Keys tại workspace sở hữu dataset. Nhà cung cấp tính phí trực tiếp vào API key của bạn; tài liệu về API key của nhà cung cấp hướng dẫn cách thiết lập.
- Kiểm thử trên mẫu đã được đánh giá. Chọn một vài hình ảnh đại diện cho dữ liệu của bạn và đã được gán nhãn thủ công. Mở trình chỉnh sửa chú thích, chuyển sang chế độ Smart, chọn model bên dưới nhà cung cấp tương ứng trong bộ chọn model rồi nhấn Predict (
P). Đếm số bbox bạn xóa, số bbox bạn thêm và số phút cần để đánh giá. - Gán nhãn dataset. Trên trang dataset, chọn More actions > Batch Annotation; tính năng này khả dụng với các dataset được lưu trữ trên Platform có tối đa ba kênh hình ảnh. Theo mặc định, tính năng gán nhãn cho hình ảnh chưa được gán nhãn, không bao giờ thay đổi nhãn hiện có và lưu phiên bản dataset trước để bạn có thể khôi phục. Hãy xem chi phí ước tính trong hộp thoại trước khi bắt đầu: Batch Annotation có giá $1.00 cho mỗi 1.000 hình ảnh được xử lý, cộng thêm mọi khoản phí của nhà cung cấp.
- Đánh giá rồi huấn luyện. Kiểm tra bbox, lưu ý điểm yếu của model, lưu bbox rồi huấn luyện model Ultralytics YOLO trên kết quả trong cùng workspace.
Để tìm hiểu thêm, xem cách Ultralytics Platform sử dụng AI để tự động hóa việc gán nhãn và lý do quy trình đánh giá có con người tham gia vẫn là một phần của công việc. Để biết cách tự động gán nhãn so sánh với active learning giữa các công cụ, hãy đọc bài so sánh tự động gán nhãn và active learning của chúng tôi.
Danh sách rút gọn theo nhóm (kết quả tháng 10 năm 2026)#
- Người đánh giá muốn hoàn thiện bản nháp hơn là dọn dẹp: Gemini 4 Argon, model chính xác nhất xét tổng thể, hoạt động tốt nhất trên dữ liệu ảnh chụp từ trên không, dưới nước, ảnh nhiệt và ảnh X-quang an ninh.
- Đối tượng hiếm mà bỏ sót sẽ làm sai lệch dữ liệu huấn luyện: GPT-6 Astra để tối đa hóa recall, hoặc GPT-6.1 Sol có kết quả sát nút.
- Gán nhãn đa dụng, không thiên về ưu tiên nào: GPT-6.1 Terra, dẫn đầu về mAP50, mAP50-95 và F1.
- Nhóm không có API key của nhà cung cấp: SAM 3.1 Text để tạo bản nháp đầu tiên ưu tiên recall trên cảnh đông đúc, hoặc Qwen3.8 27B để có bản nháp cẩn trọng hơn.
Dù chọn model nào, bảng xếp hạng cũng giúp bạn dự đoán công việc đánh giá trước khi bắt đầu. Để tìm hiểu lý thuyết đằng sau các metric này, hướng dẫn của chúng tôi về accuracy, precision và recall trình bày kiến thức cơ bản, còn bài học Academy về cách đọc các metric phát hiện đối tượng đi sâu hơn.
Câu hỏi thường gặp
Ưu tiên precision khi xóa bbox sai là cách sửa tốn thời gian hơn, chẳng hạn trên ảnh đông đúc nơi bbox thừa lẫn giữa các bbox đúng. Ưu tiên recall khi bỏ sót đối tượng gây hậu quả lớn hơn, như với khiếm khuyết hoặc tổn thương hiếm gặp, vì đối tượng không được gán nhãn khiến detector học rằng đó là nền. Sau đó, xác nhận lựa chọn bằng mẫu hình ảnh của riêng bạn đã được đánh giá thủ công.
Model được nhắc bằng tên lớp trả về bbox mà không có điểm confidence và sử dụng ngưỡng riêng theo từng model, nên Platform ẩn các cài đặt confidence và IoU khi một model như vậy được chọn. Vì thế, precision và recall trên bảng xếp hạng tính mọi bbox mà model trả về tại IoU 0.5. Để thay đổi sự cân bằng giữa bbox không khớp và đối tượng không được tìm thấy, bạn cần chọn model khác.
Dùng mAP50 để xem model có tìm và gán nhãn đúng đối tượng hay không; dùng mAP50-95 để bổ sung các ngưỡng chồng lấp nghiêm ngặt hơn, đánh giá cao bbox khớp sát. Cả hai chỉ số đều phản ánh trường hợp bỏ sót và dương tính giả, vì vậy hãy xem chúng cùng precision và recall. Trong kết quả tháng 10 năm 2026, GPT-6.1 Terra dẫn đầu cả hai chỉ số, lần lượt đạt 0.560 và 0.345.
Có. Model đứng đầu trên UL37 v2 đạt mAP50 trung bình 0.560 (tháng 10 năm 2026); trên các dataset khó nhất, chẳng hạn lỗi PCB và ảnh X-quang ngực, trung bình 40 model dưới 0.05. Hãy đánh giá mọi hình ảnh và tập trung vào điểm yếu của model: bbox thừa từ model thiên về recall, đối tượng bị bỏ sót từ model thiên về precision.
Chi phí gồm hai phần. Batch Annotation trên Ultralytics Platform có giá $1.00 cho mỗi 1.000 hình ảnh được xử lý (tối thiểu $0.01) với mọi model, kể cả model được lưu trữ; dự đoán đơn lẻ bằng model được lưu trữ trong trình chỉnh sửa là miễn phí. Model trả phí của nhà cung cấp cũng được tính phí trực tiếp vào API key của bạn. Trong benchmark tháng 10 năm 2026, chi phí nhà cung cấp ước tính cho các model trong hướng dẫn này dao động từ $0.37 cho mỗi 1.000 hình ảnh (Claude Haiku 5.5) đến $49.31 (GPT-6 Astra). Nếu dừng lượt chạy, bạn vẫn bị tính phí cho những hình ảnh đã xử lý.
Có. Các model được lưu trữ như SAM 3.1 Text, Qwen3.8 27B và Gemma 4 26B chạy trên Ultralytics Platform mà không cần API key của nhà cung cấp; model YOLO của riêng bạn cũng vậy. Các lượt chạy theo lô vẫn có giá $1.00 cho mỗi 1.000 hình ảnh được xử lý, và hộp thoại hiển thị chi phí ước tính trước mỗi lượt chạy.
Điều đó tùy thuộc vào công việc. VLM được nhắc bằng tên lớp có thể tạo bản nháp nhãn cho lớp mới chỉ dựa trên tên lớp, nhưng sáu model đạt điểm cao nhất trong benchmark tháng 10 năm 2026 mất từ 2.7 đến 11.6 giây cho mỗi hình ảnh và tính phí theo token. Với phát hiện theo thời gian thực, một cách làm phổ biến là dùng VLM để tự động gán nhãn, đánh giá nhãn rồi huấn luyện model Ultralytics YOLO trên các nhãn đó. Model YOLO bạn đã huấn luyện cũng có thể tự động gán nhãn cho hình ảnh mới ngay trong cùng trình chỉnh sửa.
Được viết bởi
Kỹ sư Phần mềm Trưởng nhóm · Ultralytics
Bình luận2
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
 Glenn JocherUltralytics
Great job Wax on your first blog!
 Sergiu WaxmannUltralytics
Appreciate it! More coming soon.









