GPT-6.2 Sol frente a Astra para el etiquetado automático: puntuaciones similares, fortalezas distintas
GPT-6.2 Sol y Astra obtienen 0.551 y 0.546 mAP50 en 36 conjuntos de datos de detección, pero Sol cuesta 8,10 $ por cada 1.000 imágenes, frente a 31,88 $. Descubre cuál te conviene.
 Glenn Jocher14 min de lectura
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. Describió Astra como su modelo más potente y Sol como su modelo de referencia para el trabajo diario. Cuando les pedimos que dibujaran cuadros delimitadores, su precisión fue similar. Sus precios, no.
Probamos ambos con UL37, nuestro benchmark de detección con 36 conjuntos de datos, el mismo día de su lanzamiento. GPT-6.2 Sol obtuvo 0.551 mAP50 y GPT-6.2 Astra, 0.546; quedaron en cuarto y quinto lugar entre 50 modelos en nuestra clasificación de VLM. Sol lo hizo por 8,10 $ por cada 1.000 imágenes. Astra costó 31,88 $, casi cuatro veces más.
Ahora, ambos son las opciones de OpenAI Sol y Astra para el etiquetado automático en Ultralytics Platform, donde sustituyen a GPT-6.1 Sol y GPT-6 Astra. A continuación comparamos ambos modelos, explicamos en qué destaca cada uno, cuánto cuesta etiquetar un lote y cuándo GPT-6.1 Terra de OpenAI sigue siendo la mejor opción.
GPT-6.2 Sol y Astra obtienen resultados con una diferencia de aproximadamente 0.005 en UL37#
UL37 mide cuánto se ajustan los cuadros de un modelo a las etiquetas humanas en 360 imágenes: 10 de cada uno de los 36 conjuntos de datos reales de detección de objetos, que abarcan desde imágenes médicas y aéreas hasta estanterías de tiendas, deportes, documentos y placas de circuitos. Todas las imágenes pasan por el mismo proceso de producción que usan los usuarios de Platform, con los nombres de clase propios del conjunto de datos y SAM 3.1 para perfeccionar cada cuadro. Por tanto, las puntuaciones describen ese proceso de producción refinado, no el resultado sin procesar del modelo. La metodología es pública.
| GPT-6.2 Sol | GPT-6.2 Astra | GPT-6.1 Terra | |
|---|---|---|---|
| Puesto en la clasificación | \n.º 4 de 50 | \n.º 5 de 50 | \n.º 2 de 50 |
| mAP50 | 0.551 | 0.546 | 0.560 |
| mAP50-95 | 0.346 | 0.345 | 0.345 |
| Precisión | 0.623 | 0.626 | 0.646 |
| Exhaustividad | 0.643 | 0.625 | 0.613 |
| Coste del proveedor por cada 1.000 imágenes | $8.10 | $31.88 | $4.36 |
| Tiempo mediano por imagen | 3.4 s | 4.3 s | 5.1 s |
| Solicitudes fallidas | 0% | 0% | 0% |
Resultados de UL37 de la clasificación de VLM de Ultralytics, actualizada el 17 de noviembre de 2026.
En esta prueba, los dos modelos ofrecen una precisión similar. Sus puntuaciones mAP50-95, que premian los cuadros ajustados, difieren en 0.001, y su precisión, en 0.003. Sol encuentra algo más de los objetos etiquetados: su exhaustividad de 0.643 es la más alta de los 50 modelos de la clasificación, justo por delante de 0.642 de Gemini 4 Carbon. También es el más rápido de los siete modelos mejor clasificados, con 3,4 segundos por imagen.
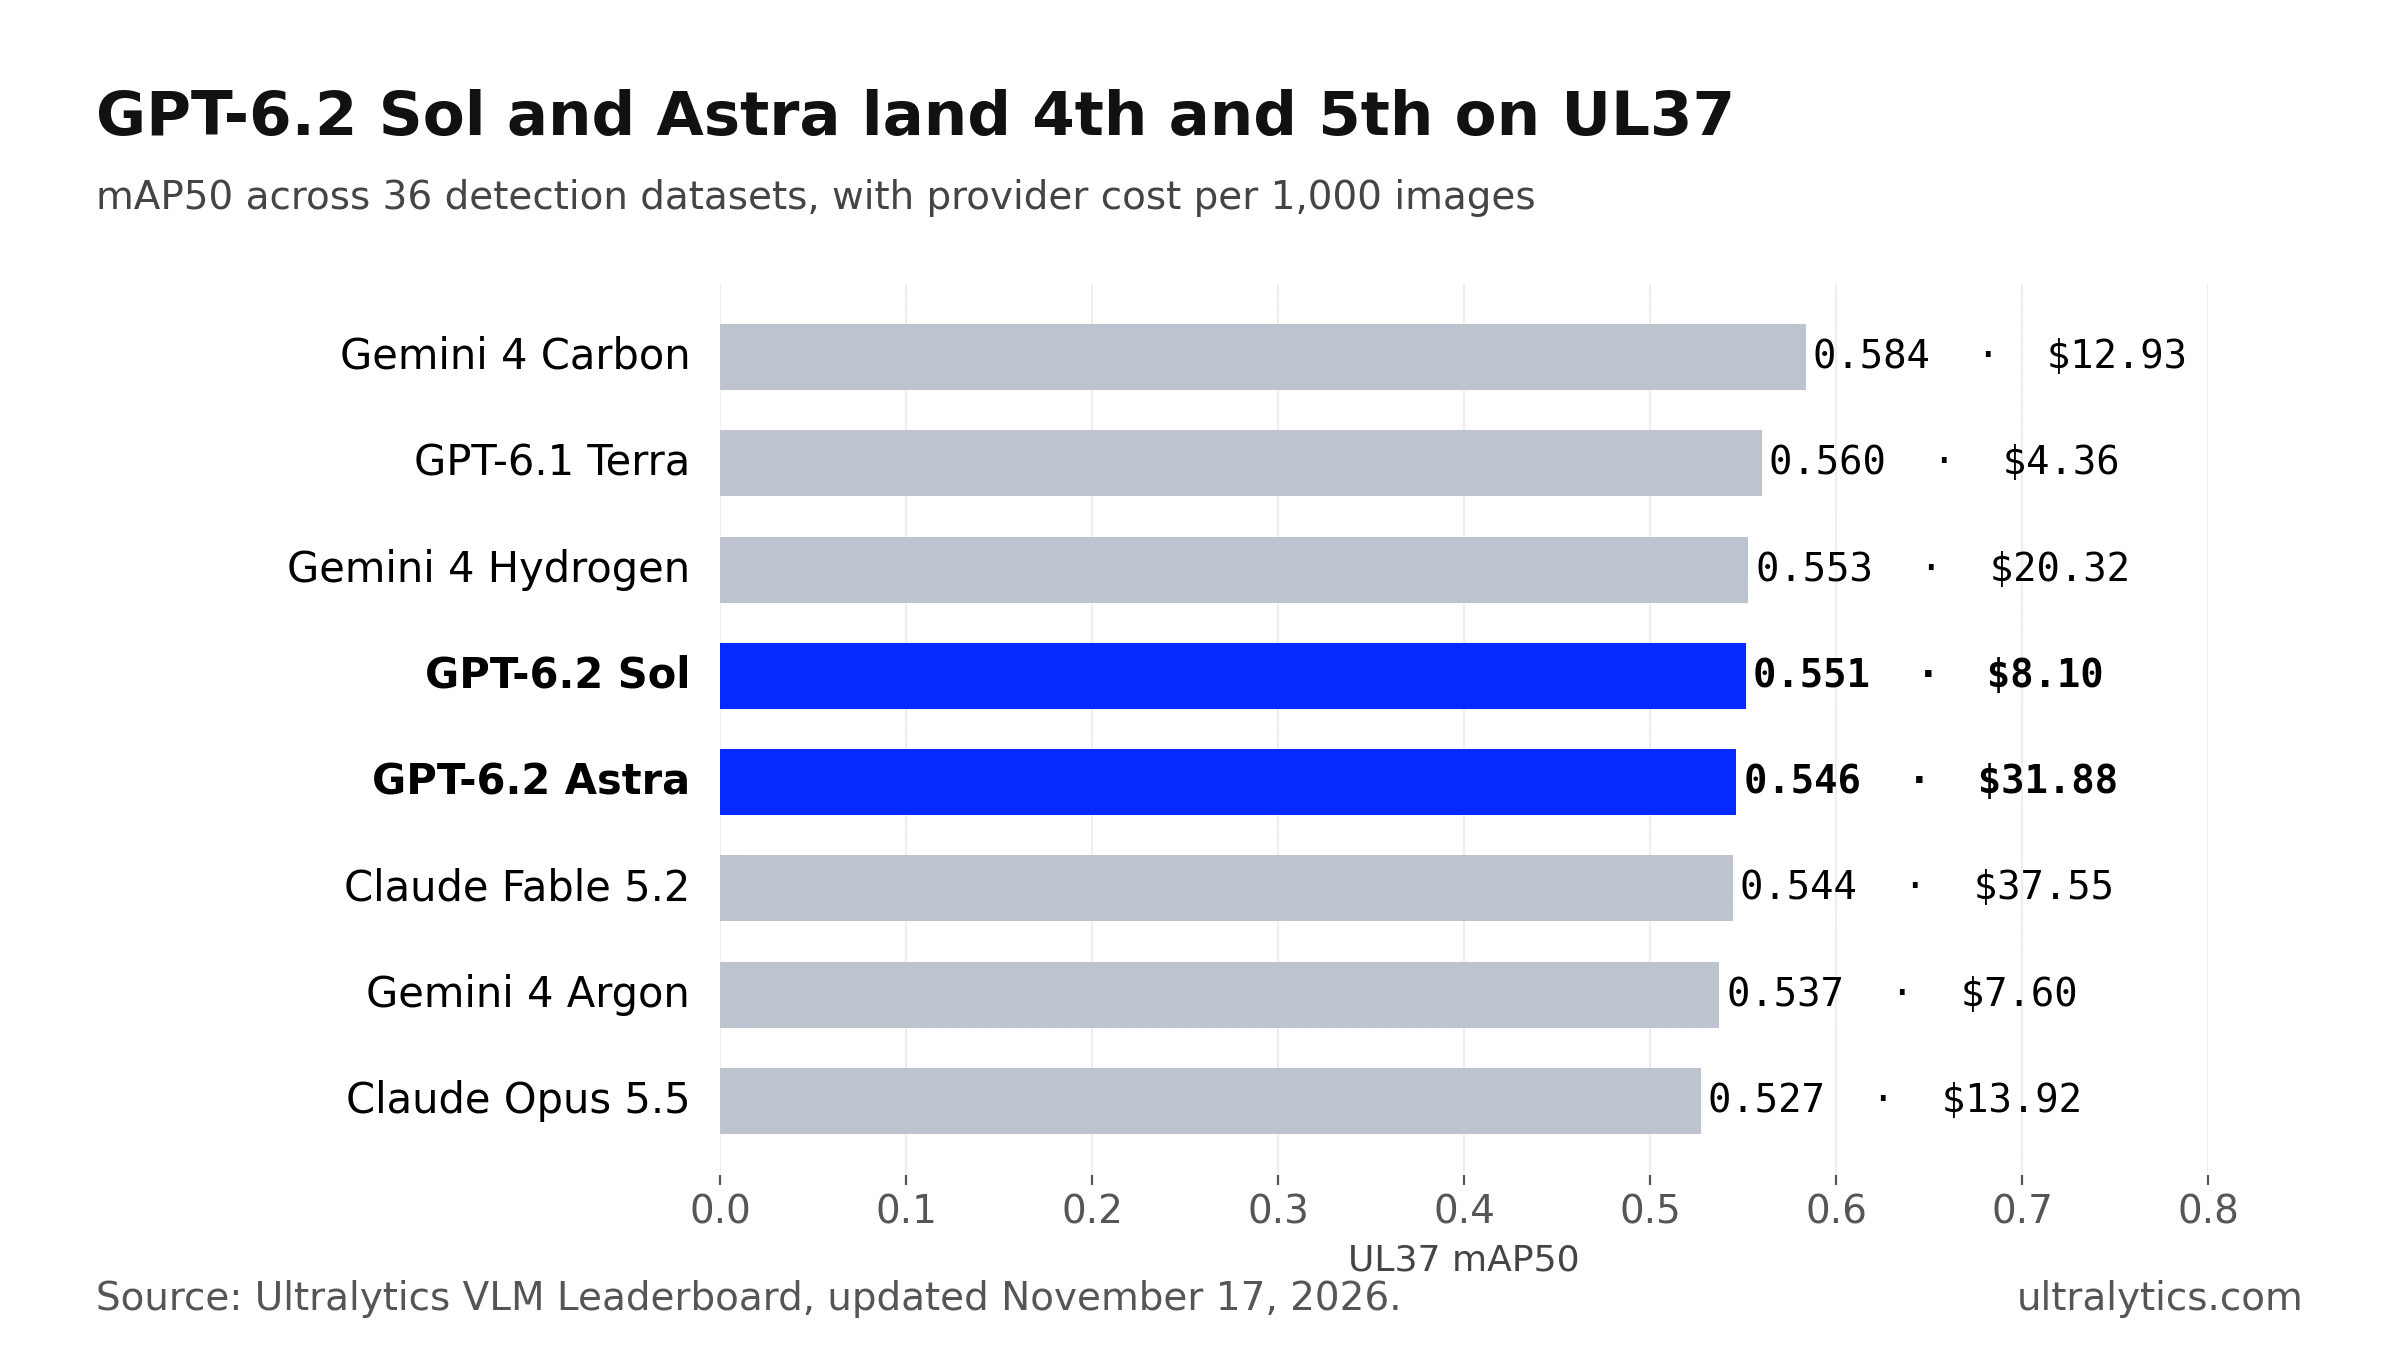
Los ocho modelos con mejores puntuaciones en UL37, con el coste del proveedor por cada 1.000 imágenes.
Para qué creó OpenAI GPT-6.2#
OpenAI destina los dos modelos a distintos tipos de trabajo. Su registro de cambios recomienda GPT-6.2 Astra «para tareas exigentes de razonamiento y programación» y GPT-6.2 Sol «para la programación diaria y los flujos de trabajo con agentes». Ambos aceptan texto e imágenes y devuelven texto, y están disponibles en Responses API y Chat Completions.
Los precios reflejan esa diferencia. Según las páginas de modelos de OpenAI, GPT-6.2 Sol cuesta 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida, mientras que GPT-6.2 Astra cuesta 8 $ y 40 $. El precio por token de Astra es exactamente cuatro veces el de Sol.
Ambos son modelos de propósito general, no detectores especializados, así que medimos cómo rinden en esa tarea. Platform utiliza ambos con el nivel de razonamiento predeterminado de OpenAI y la misma solicitud de cuadros que envía a todos los modelos de OpenAI.
Astra gana en más conjuntos de datos, pero un conjunto de ecografías determina la media#
La ventaja de Sol en la media no significa que gane más a menudo. En la comparación directa de los 36 conjuntos de datos, Astra obtiene mejores resultados en 17, Sol en 15 y hay cuatro empates.
Un conjunto de datos explica la diferencia. En TN5000, ecografías de tiroides, donde cada cuadro también incluye una etiqueta de benigno o maligno, Sol obtiene 0.995 frente a 0.769 de Astra. Ese único resultado eleva la media de Sol en aproximadamente 0.006. Si excluimos TN5000, las medias son 0.539 para Sol y 0.540 para Astra.
En este benchmark, la precisión de ambos es lo bastante similar como para que las diferencias más claras sean el ámbito y el coste.
En qué ámbitos destaca GPT-6.2 Sol y Astra#
Al calcular la media por ámbito, Astra destaca en siete de los 12 ámbitos de UL37 y Sol en cuatro; hay un empate en radiografías de seguridad.
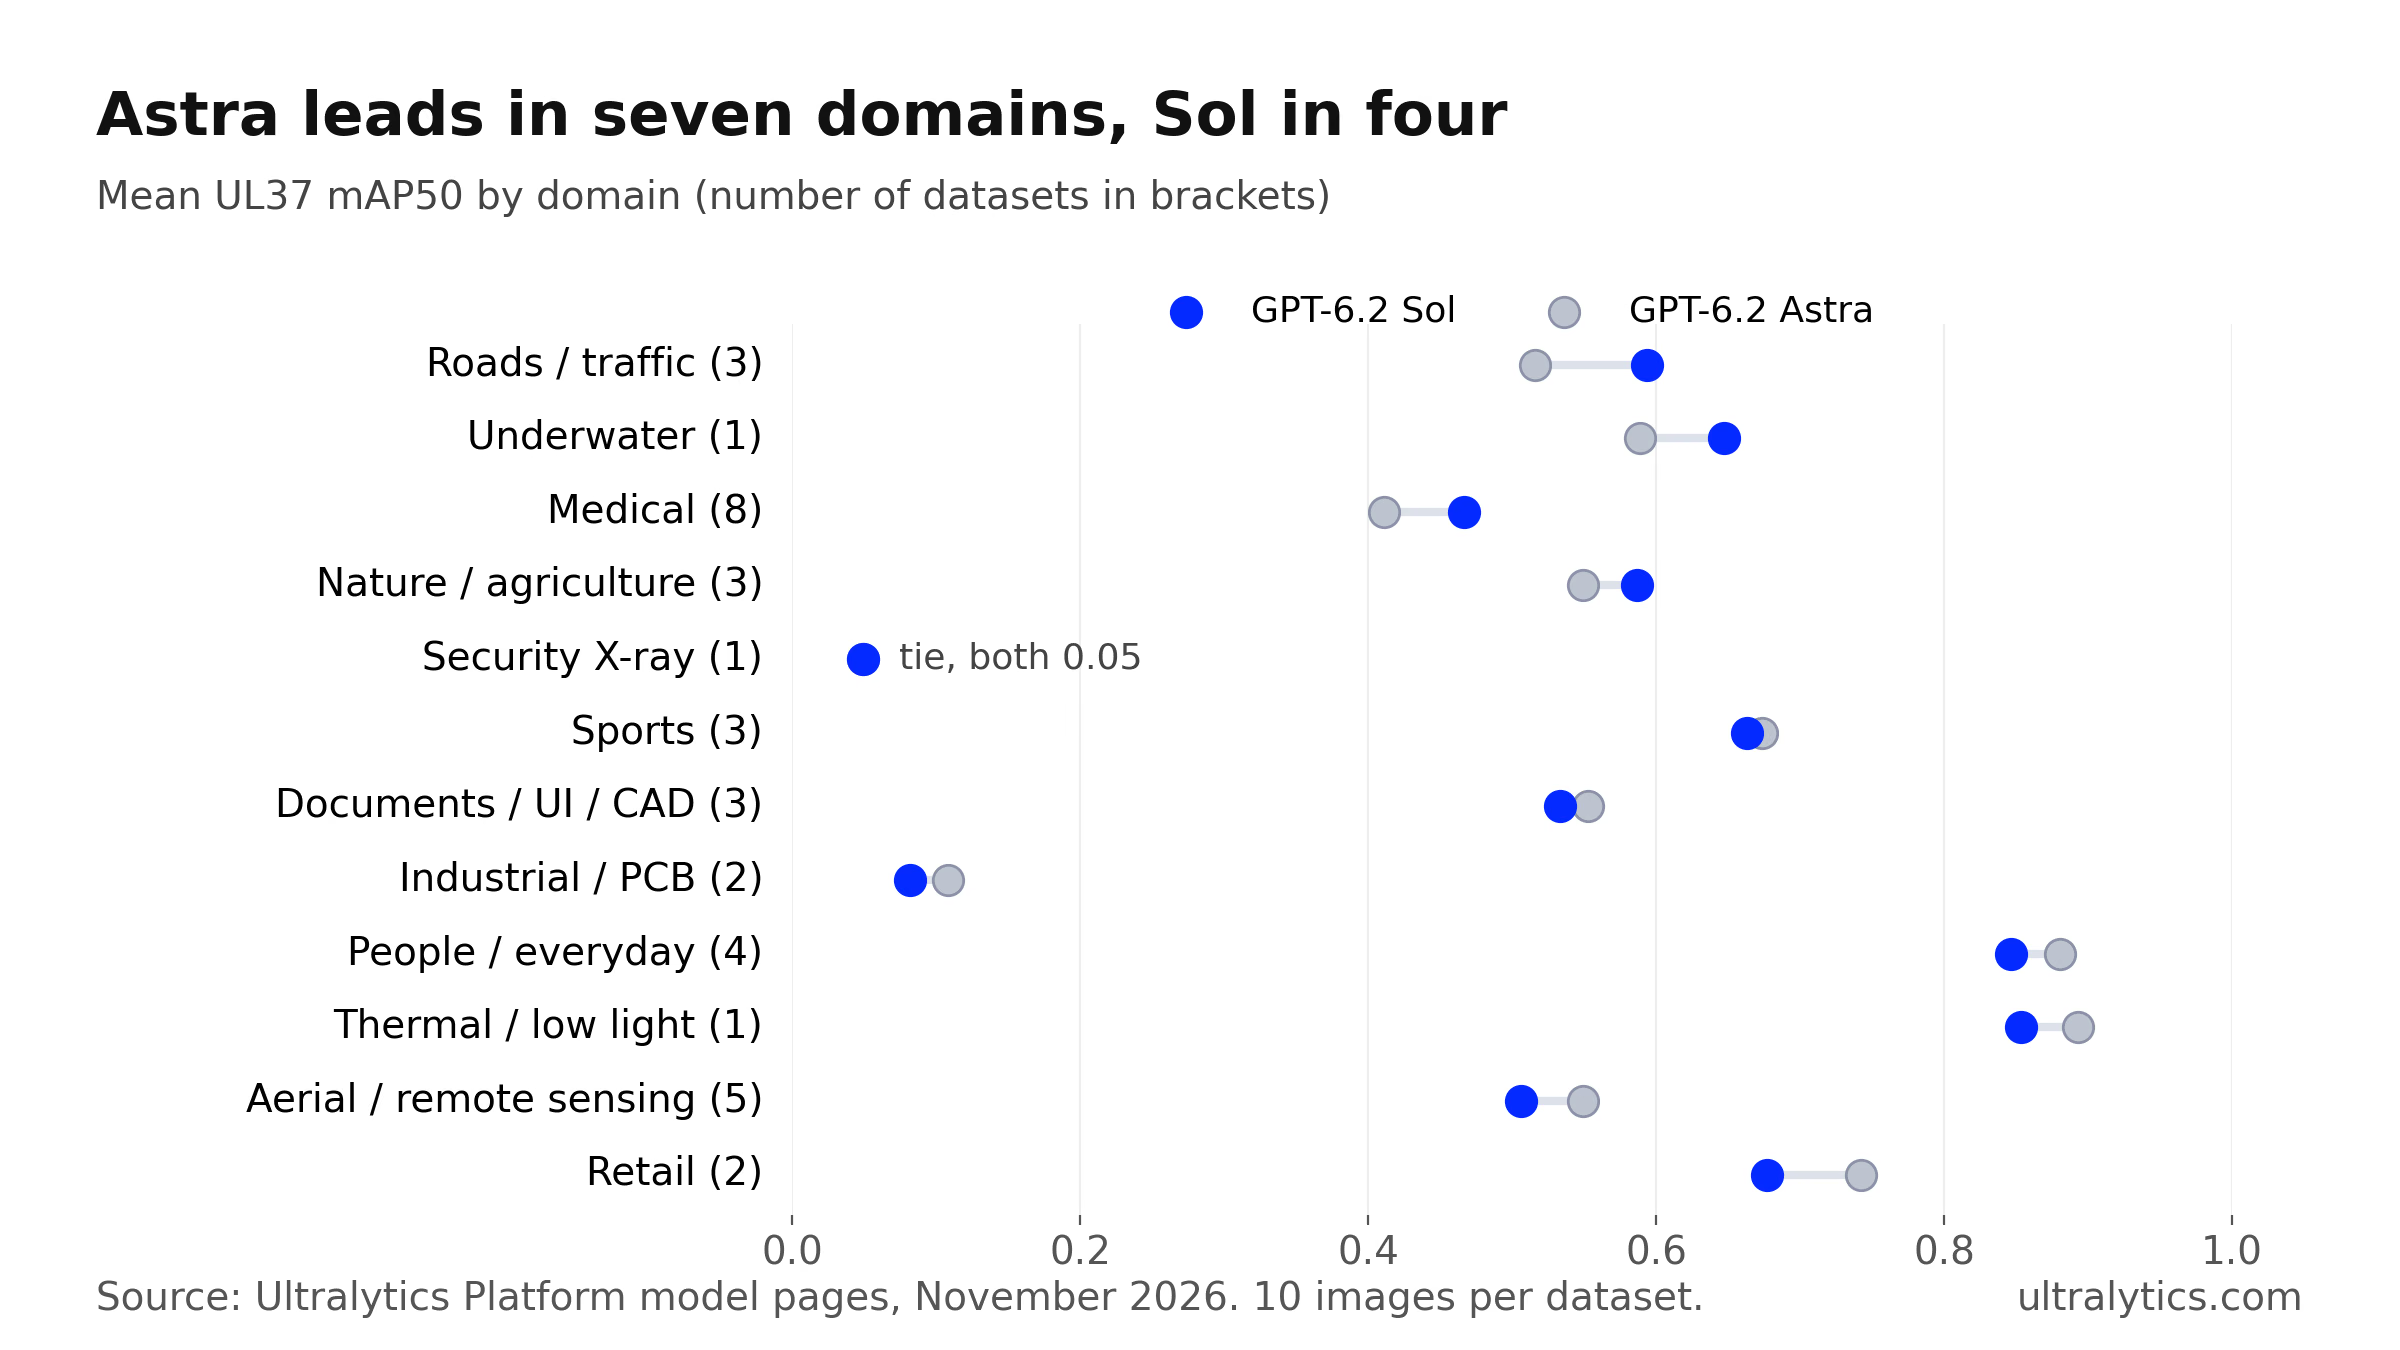
Cada ámbito incluye entre uno y ocho conjuntos de datos, con 10 imágenes por conjunto.
GPT-6.2 Sol destaca en imágenes médicas, de carreteras y de naturaleza. Su media en ocho conjuntos de datos médicos es de 0.466, frente a 0.411 de Astra; sobresalen TN5000 y los pólipos de colon de Kvasir-SEG, con 0.805 frente a 0.707. En las espigas de trigo de GWHD, obtiene 0.684 frente a 0.537 de Astra; y en las marcas viales de CeyMo, 0.843 frente a 0.705.
GPT-6.2 Astra destaca en imágenes aéreas, de comercios, documentos y personas. Su media en cinco conjuntos de datos aéreos es de 0.550, frente a 0.506 de Sol, gracias en parte a los barcos de las imágenes de radar de SSDD, con 0.880 frente a 0.749. En los productos de las cajas de pago de RPC, obtiene 0.978 frente a 0.823 de Sol. También destaca en la detección de EPI, basura y baloncesto.
| Conjunto de datos | Ámbito | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| Ecografías de tiroides de TN5000 | Medicina | 0.995 | 0.769 |
| Espigas de trigo de GWHD | Naturaleza / agricultura | 0.684 | 0.537 |
| Marcas viales de CeyMo | Carreteras / tráfico | 0.843 | 0.705 |
| SoccerDB | Deportes | 0.748 | 0.631 |
| Cajas de pago de RPC | Comercio minorista | 0.823 | 0.978 |
| Balón y canasta de baloncesto | Deportes | 0.726 | 0.872 |
| Enfermedades de plantas de PlantDoc | Naturaleza / agricultura | 0.302 | 0.447 |
| Barcos SAR de SSDD | Aéreo / teledetección | 0.749 | 0.880 |
Las cuatro mayores diferencias en cada dirección, mAP50 de UL37.
Cada conjunto de datos aporta 10 imágenes, por lo que una sola puntuación es una señal para hacer pruebas, no un veredicto. Antes de etiquetar un conjunto de datos grande, abre las páginas de los modelos GPT-6.2 Sol y GPT-6.2 Astra, donde se muestran los cuadros registrados de cada modelo en todos los conjuntos de datos del benchmark, junto a las etiquetas esperadas.
Un gran avance respecto a GPT-6.1 Sol y GPT-6 Astra, salvo en placas de circuitos#
En comparación con los modelos a los que sustituyen en Platform, ambos son más precisos, rápidos y baratos por imagen.
| mAP50 | Coste por cada 1.000 imágenes | Tiempo mediano por imagen | |
|---|---|---|---|
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6.2 Sol | 0.551 | $8.10 | 3,4 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
| GPT-6.2 Astra | 0.546 | $31.88 | 4,3 s |
GPT-6.2 Sol supera a GPT-6.1 Sol en 23 conjuntos de datos y queda por debajo en 12, y funciona aproximadamente tres veces más rápido. Su coste por imagen es un 21 % menor, con los mismos precios por token. GPT-6.2 Astra supera a GPT-6 Astra en 24 conjuntos de datos y queda por debajo en 11, con un coste por imagen un 35 % menor y precios por token más bajos: OpenAI indica que GPT-6 Astra cuesta 10 $ y 50 $ por millón de tokens.
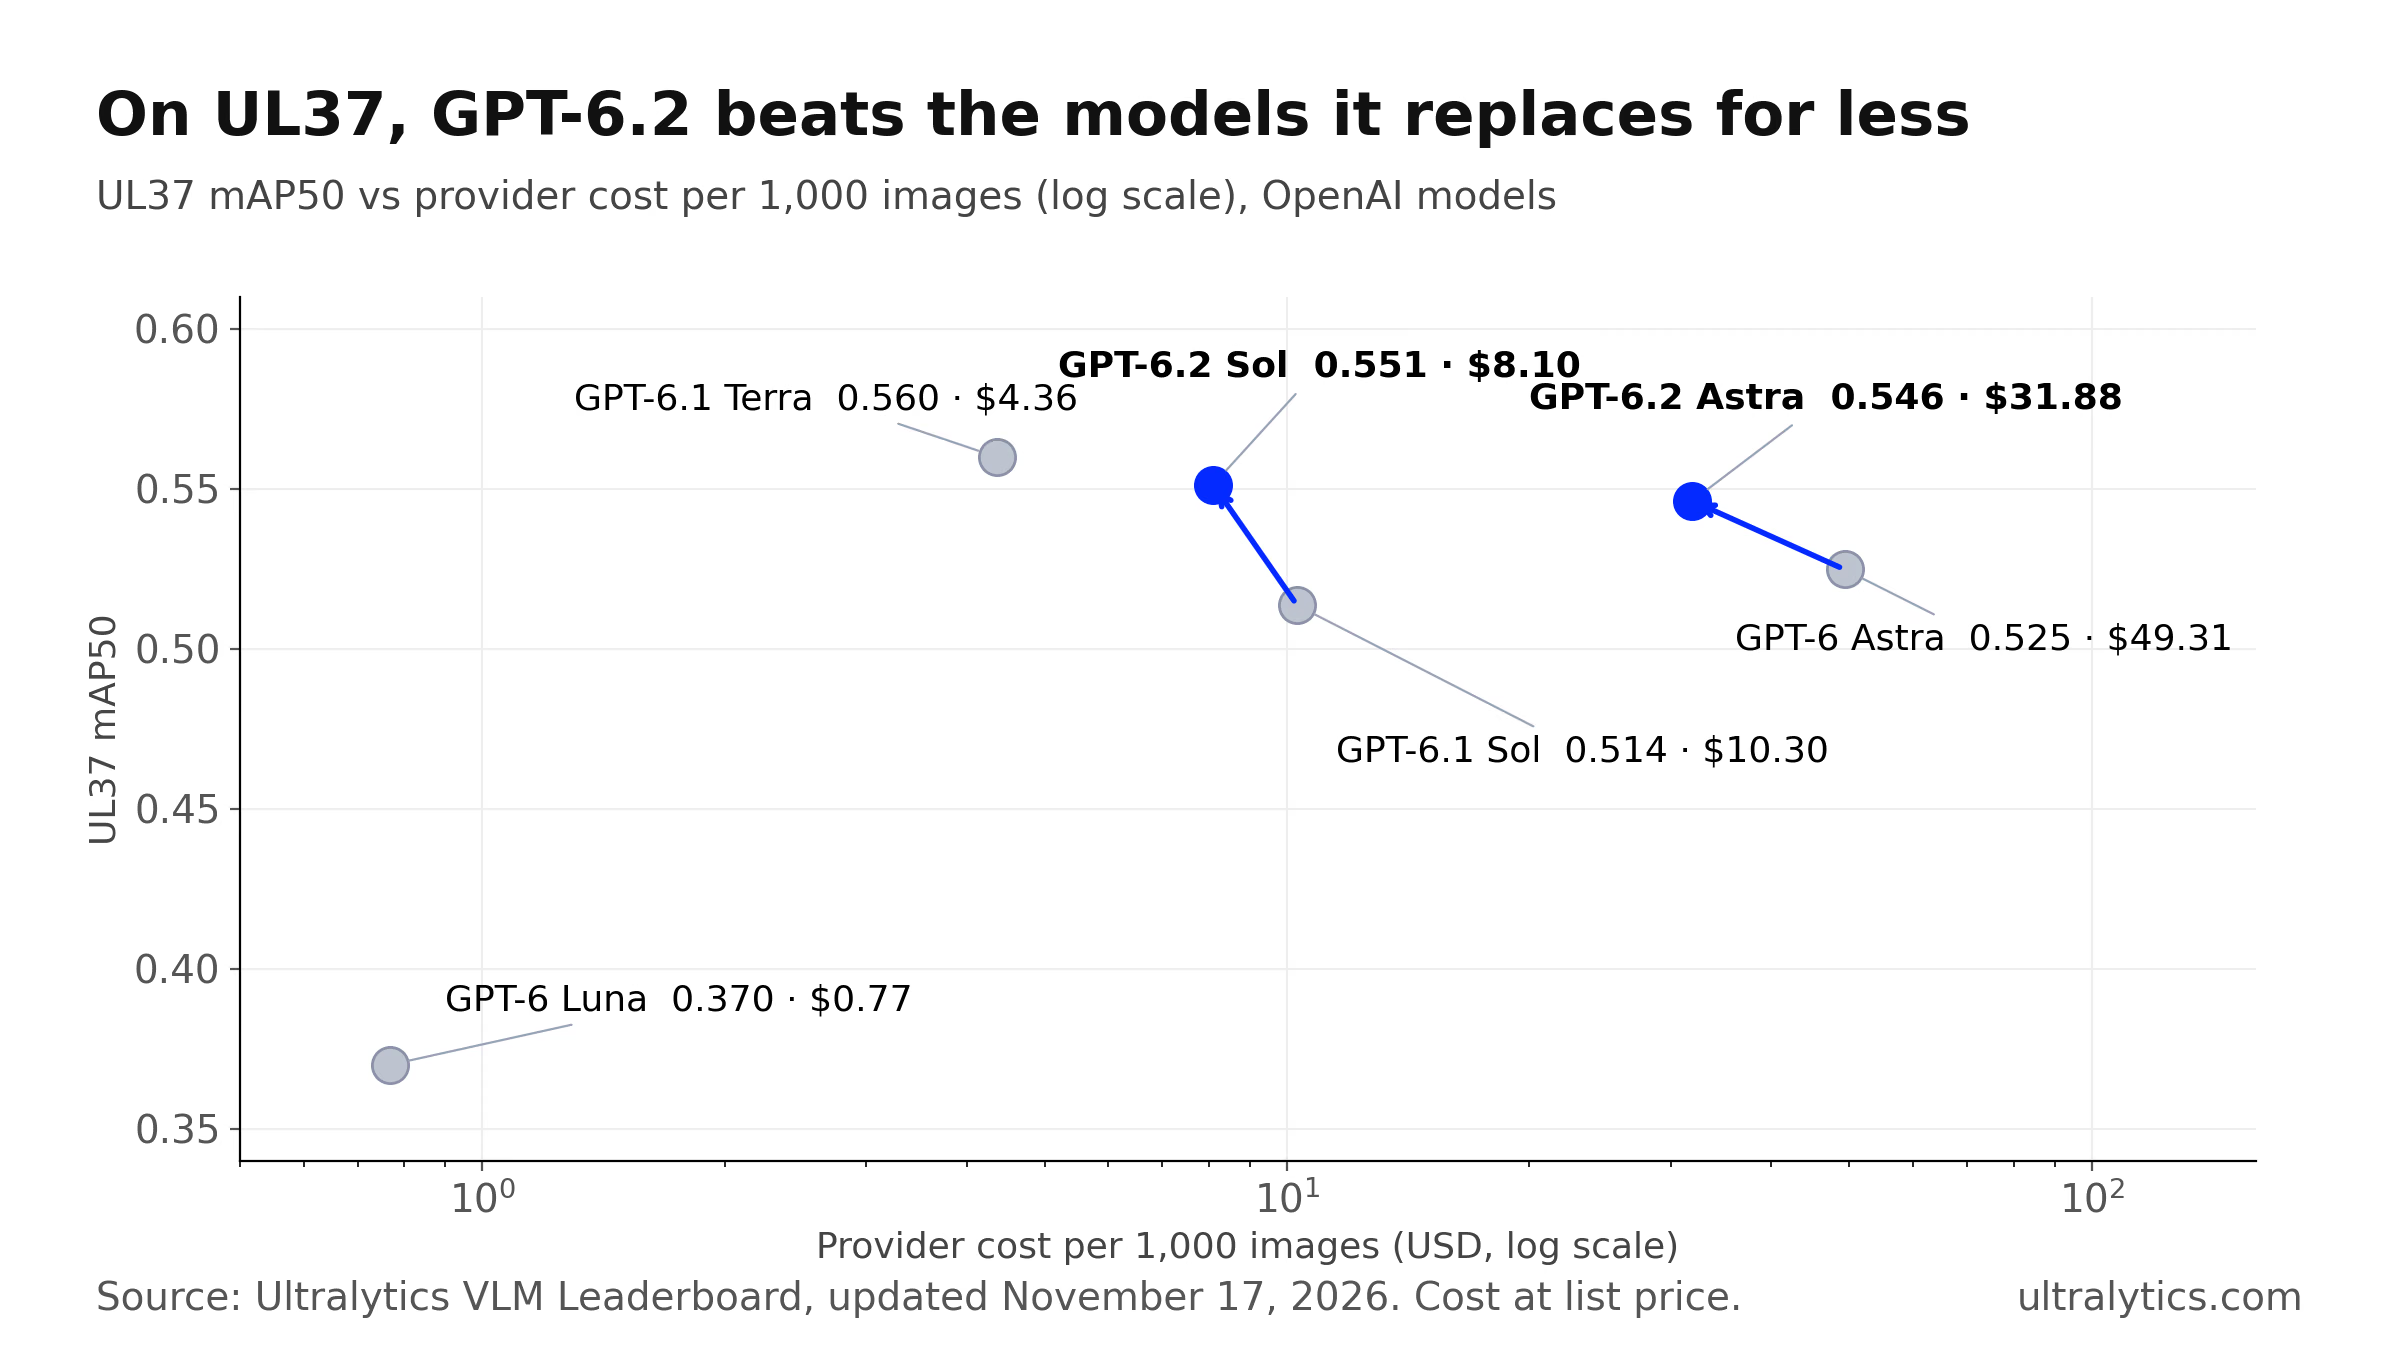
Las flechas comparan cada modelo GPT-6.2 con el modelo al que sustituye en Ultralytics Platform.
La excepción son las placas de circuitos. En los defectos de placas desnudas de DeepPCB, ambos modelos GPT-6.2 obtienen 0.000, mientras que GPT-6.1 Sol obtuvo 0.393. En los defectos de superficie de DsPCBSD+, Sol baja de 0.392 a 0.164 y Astra obtiene 0.216. Las radiografías de seguridad también son un punto débil: ambos obtienen 0.05 en IEDXray, donde Gemini 4 Argon alcanza 0.30. Si tus datos son de inspección de PCB o control de seguridad, prueba otros modelos con una muestra antes de decidirte.
GPT-6.1 Terra sigue siendo el mejor modelo de OpenAI para etiquetar en UL37#
Ninguno de los modelos nuevos supera a GPT-6.1 Terra, que se mantiene en segundo lugar de la clasificación con 0.560 mAP50 por 4,36 $ por cada 1.000 imágenes. Terra y GPT-6.2 Sol ganan 17 conjuntos de datos cada uno y empatan en dos, así que la diferencia es pequeña. Terra tiene más precisión, 0.646 frente a 0.623, y cuesta aproximadamente la mitad. Sol encuentra más objetos y responde más rápido: en 3,4 segundos, frente a 5,1.
En lo alto de la clasificación, Gemini 4 Carbon sigue a la cabeza con 0.584 mAP50 por 12,93 $ por cada 1.000 imágenes. Nuestros resultados de GPT-6.1 Terra y resultados de Gemini 4 Carbon analizan esos modelos en detalle.
Cuánto cuesta un lote de etiquetado con GPT-6.2#
El coste del proveedor se calcula a partir del uso de tokens indicado por OpenAI y según sus precios de lista; tus imágenes pueden consumir más o menos tokens. Batch Annotation añade una tarifa de procesamiento de Platform de 1,00 $ por cada 1.000 imágenes, con un mínimo de 0,01 $ por ejecución.
| Por cada 1.000 imágenes | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Coste de OpenAI | $8.10 | $31.88 |
| Procesamiento de Ultralytics Platform | $1.00 | $1.00 |
| Total | $9.10 | $32.88 |
Pagas directamente a OpenAI con tu propia clave de API, incluso por las predicciones de prueba que hagas primero, y Ultralytics no aplica ningún recargo a los tokens. Para un conjunto de datos de 10.000 imágenes, el coste será de unos 91 $ con Sol y 329 $ con Astra.
Cómo ejecutar el etiquetado automático con GPT-6.2 Sol o Astra en Ultralytics Platform#
GPT-6.2 Sol y Astra son modelos con indicaciones de clase para conjuntos de datos de detección con entre 1 y 200 clases. Devuelven cuadros delimitadores para los nombres de clase propios de tu conjunto de datos, que puedes revisar antes de guardarlos.
- Crea una clave en la página de claves de API de OpenAI.
- Pide al propietario del espacio de trabajo que añada la clave en Configuración > Claves de API del espacio de trabajo de Platform donde está tu conjunto de datos. La documentación sobre claves del proveedor explica los detalles.
- En el editor de anotaciones, cambia al modo Smart y elige GPT-6.2 Sol o GPT-6.2 Astra en OpenAI, dentro del selector de modelos.
- Pulsa Predecir o
Pen algunas imágenes representativas de tus datos y compara ambos modelos con las mismas imágenes. - Cuando estés conforme, abre la página del conjunto de datos y elige Más acciones > Anotación por lotes para etiquetar todas las imágenes sin etiquetar. Batch Annotation funciona con conjuntos de datos alojados en Platform que tengan hasta tres canales de imagen. Platform guarda primero una versión del conjunto de datos para que puedas volver atrás.
- Revisa los cuadros, guárdalos y entrena un modelo Ultralytics YOLO26 con el resultado en el mismo espacio de trabajo.
La documentación de anotación explica en detalle el modo Smart y Batch Annotation, y nuestra guía para elegir un VLM según su precisión y exhaustividad te ayudará a encontrar el modelo adecuado para tu flujo de revisión.
GPT-6.2 Sol, GPT-6.2 Astra o GPT-6.1 Terra: cuál elegir#
| Si necesitas… | Empieza con |
|---|---|
| Un modelo general de OpenAI para etiquetar al menor coste | GPT-6.1 Terra: la puntuación más alta de los tres en UL37, por aproximadamente la mitad del precio de Sol |
| Velocidad o encontrar el mayor número de objetos | GPT-6.2 Sol: 3,4 s por imagen y la mayor exhaustividad de la clasificación |
| Imágenes médicas, de carreteras o agrícolas | GPT-6.2 Sol; después, prueba Terra con datos médicos |
| Imágenes aéreas, de cajas de pago, documentos o EPI | GPT-6.2 Astra, si la mejora de precisión en tus datos justifica un coste aproximadamente cuatro veces superior al de Sol |
| Defectos de PCB o radiografías de seguridad | Prueba primero otros modelos: ambos modelos GPT-6.2 obtienen malos resultados en estos casos de UL37 |
Para la mayoría de las tareas de etiquetado, GPT-6.2 Sol es la mejor compra de los dos modelos nuevos: obtiene una puntuación similar a Astra en UL37 por aproximadamente una cuarta parte del coste. Elige Astra si las pruebas con tus propias imágenes muestran que destaca en tu ámbito.
Preguntas frecuentes
En nuestro benchmark UL37, sus resultados son similares: GPT-6.2 Sol obtiene 0.551 mAP50 y GPT-6.2 Astra, 0.546; Astra gana en algo más de conjuntos de datos, 17 frente a 15. La diferencia más clara es el coste: Sol cuesta 8,10 $ por cada 1.000 imágenes en cargos de OpenAI, frente a 31,88 $ de Astra. Sol destaca en imágenes médicas, de carreteras y de naturaleza; Astra, en imágenes aéreas, de comercios, documentos y personas.
Sí. Ambos modelos GPT-6.2 están entre los cinco mejores de los 50 modelos de la clasificación de VLM de Ultralytics y no tuvieron solicitudes fallidas. GPT-6.2 Sol tiene la mayor exhaustividad de la clasificación, con 0.643. Ambos son flojos en la detección de defectos en placas de circuitos y en radiografías de seguridad.
Los cargos de OpenAI son de unos 8,10 $ con GPT-6.2 Sol y 31,88 $ con GPT-6.2 Astra, según el uso de tokens indicado y los precios de lista. Ultralytics Platform añade una tarifa de Batch Annotation de 1,00 $ por cada 1.000 imágenes, con un total aproximado de 9,10 $ y 32,88 $, respectivamente.
En UL37, sí, aunque por poco. GPT-6.1 Terra obtiene 0.560 mAP50 por 4,36 $ por cada 1.000 imágenes, por delante de ambos modelos GPT-6.2 tanto en la media como en el coste. GPT-6.2 Sol empata con Terra en conjuntos de datos ganados, 17 cada uno, y es más rápido y encuentra más objetos.
Sí, en promedio. GPT-6.2 Sol supera a GPT-6.1 Sol en 23 de 36 conjuntos de datos, es aproximadamente tres veces más rápido y cuesta un 21 % menos por imagen. GPT-6.2 Astra supera a GPT-6 Astra en 24 conjuntos de datos y cuesta un 35 % menos. Ambos modelos anteriores obtuvieron mejores resultados en defectos de placas de circuitos.
Añade tu clave de API de OpenAI en Configuración > Claves de API y luego elige GPT-6.2 Sol o GPT-6.2 Astra en el modo Smart del editor de anotaciones. Prueba algunas imágenes y luego usa Batch Annotation para etiquetar todo el conjunto de datos, revisar los cuadros y entrenar un modelo Ultralytics YOLO26 en el mismo espacio de trabajo.
Escrito por
Fundador y director ejecutivo · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









