Segmentación de Ultralytics YOLO en escenas densas: 1.000 máscaras
En Ultralytics 8.4.213, YOLO26n-seg predice y resume 1.000 máscaras en una imagen sintética de 1080p en 56,4 ms con una RTX PRO 6000, frente a los 821,2 ms anteriores.
 Glenn Jocher13 min de lectura
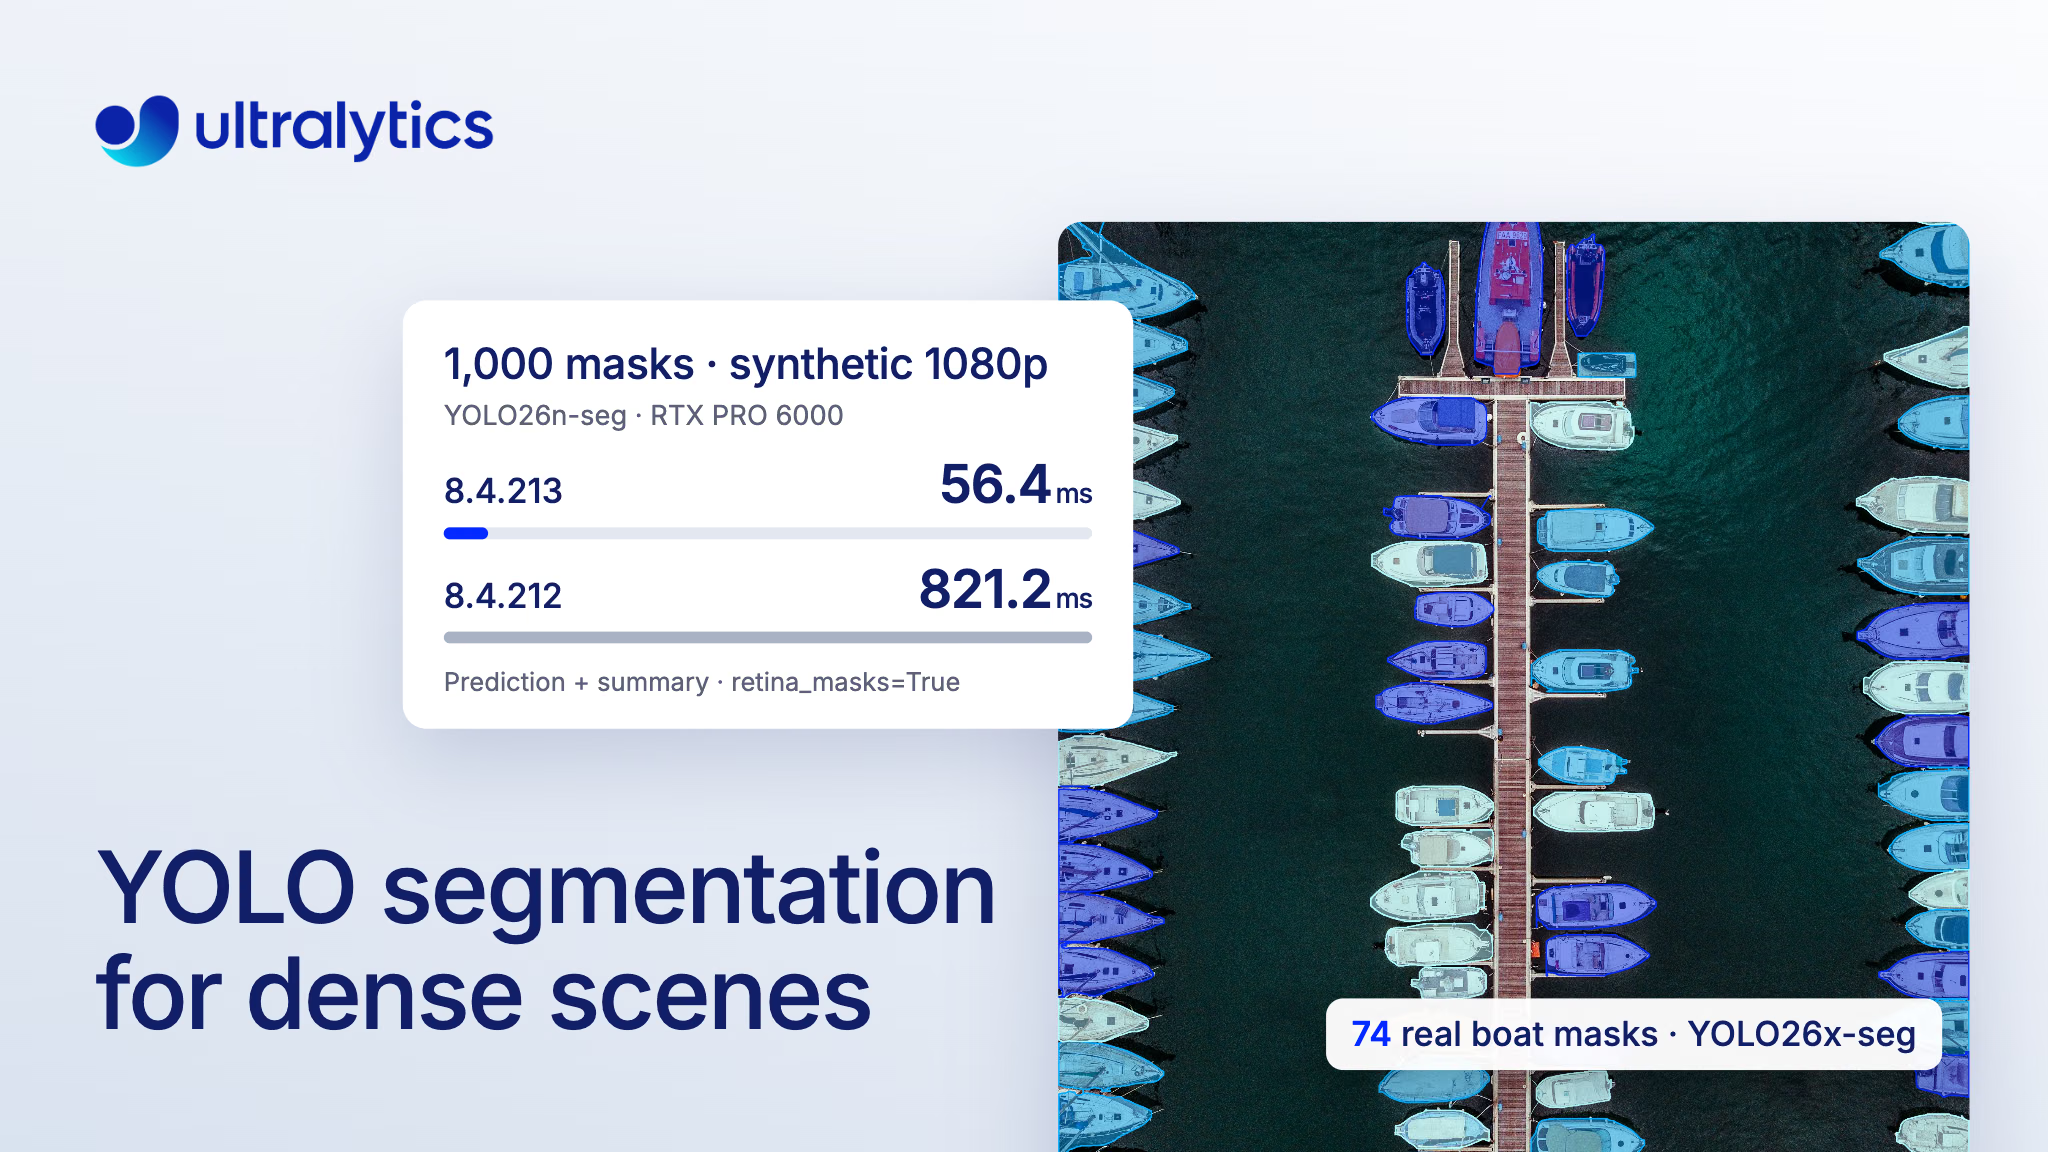
Ultralytics 8.4.213, publicado el 14 de noviembre de 2026, acelera la segmentación de YOLO en escenas densas al decodificar grandes pilas de máscaras dentro de cada caja de detección. Si segmentas estanterías, paquetes, multitudes o imágenes aéreas, probablemente te hayas topado con el punto en que un modelo de segmentación encuentra los objetos, pero la etapa posterior de generación de máscaras se queda sin tiempo o memoria; esta versión amplía considerablemente ese margen. En nuestro benchmark con una imagen sintética de 1080p densamente cubierta, YOLO26n-seg devolvió 1.000 máscaras de instancia de resolución completa (retina_masks=True), con la predicción y un resumen de resultados, en 56,4 ms y con un uso máximo de memoria de GPU de 321 MiB en una RTX PRO 6000, frente a los 821,2 ms y los 4.291 MiB de 8.4.212.
El modelo en sí no ha cambiado. Lo que ha cambiado es cómo YOLO segmentation convierte la salida del modelo en máscaras: ahora las grandes pilas de máscaras se decodifican dentro del cuadro de cada objeto en lugar de hacerlo en todo el fotograma. En Ultralytics Platform, la pestaña Predict y la API devuelven hasta 1.000 resultados por imagen. En esta publicación explicamos por qué las escenas densas eran costosas, qué hace de forma distinta la versión 8.4.213, cuáles son los resultados medidos y cómo ejecutar tus propias predicciones con 1.000 máscaras.
Las escenas densas antes pagaban por los píxeles que quedaban fuera de cada cuadro#
La segmentación de instancias asigna a cada objeto su propia máscara, algo necesario para medir áreas, recortar objetos o distinguir elementos que se tocan. Un modelo de segmentación YOLO predice un pequeño conjunto de máscaras de prototipo compartidas y unos pocos coeficientes por detección; el posprocesamiento los combina para crear una máscara por objeto.
Hasta ahora, este paso generaba todas las máscaras al tamaño del fotograma: por defecto, al tamaño de inferencia del modelo, o al tamaño de la imagen original con retina_masks=True o el teselado. Para N objetos en un fotograma de H x W, se asignaba, recortaba, filtraba y recorría una pila de N x H x W, aunque cada máscara valiera cero en todas partes fuera de su cuadro delimitador. En una escena densa de 1080p, el área total de 1.000 cuadros, contando los solapamientos, equivale aproximadamente al doble del área del fotograma; aun así, la pila ocupaba 1.000 veces el área del fotograma. El coste aumentaba con max_det y el tamaño de imagen, en lugar de hacerlo en función de los cuadros de la imagen.
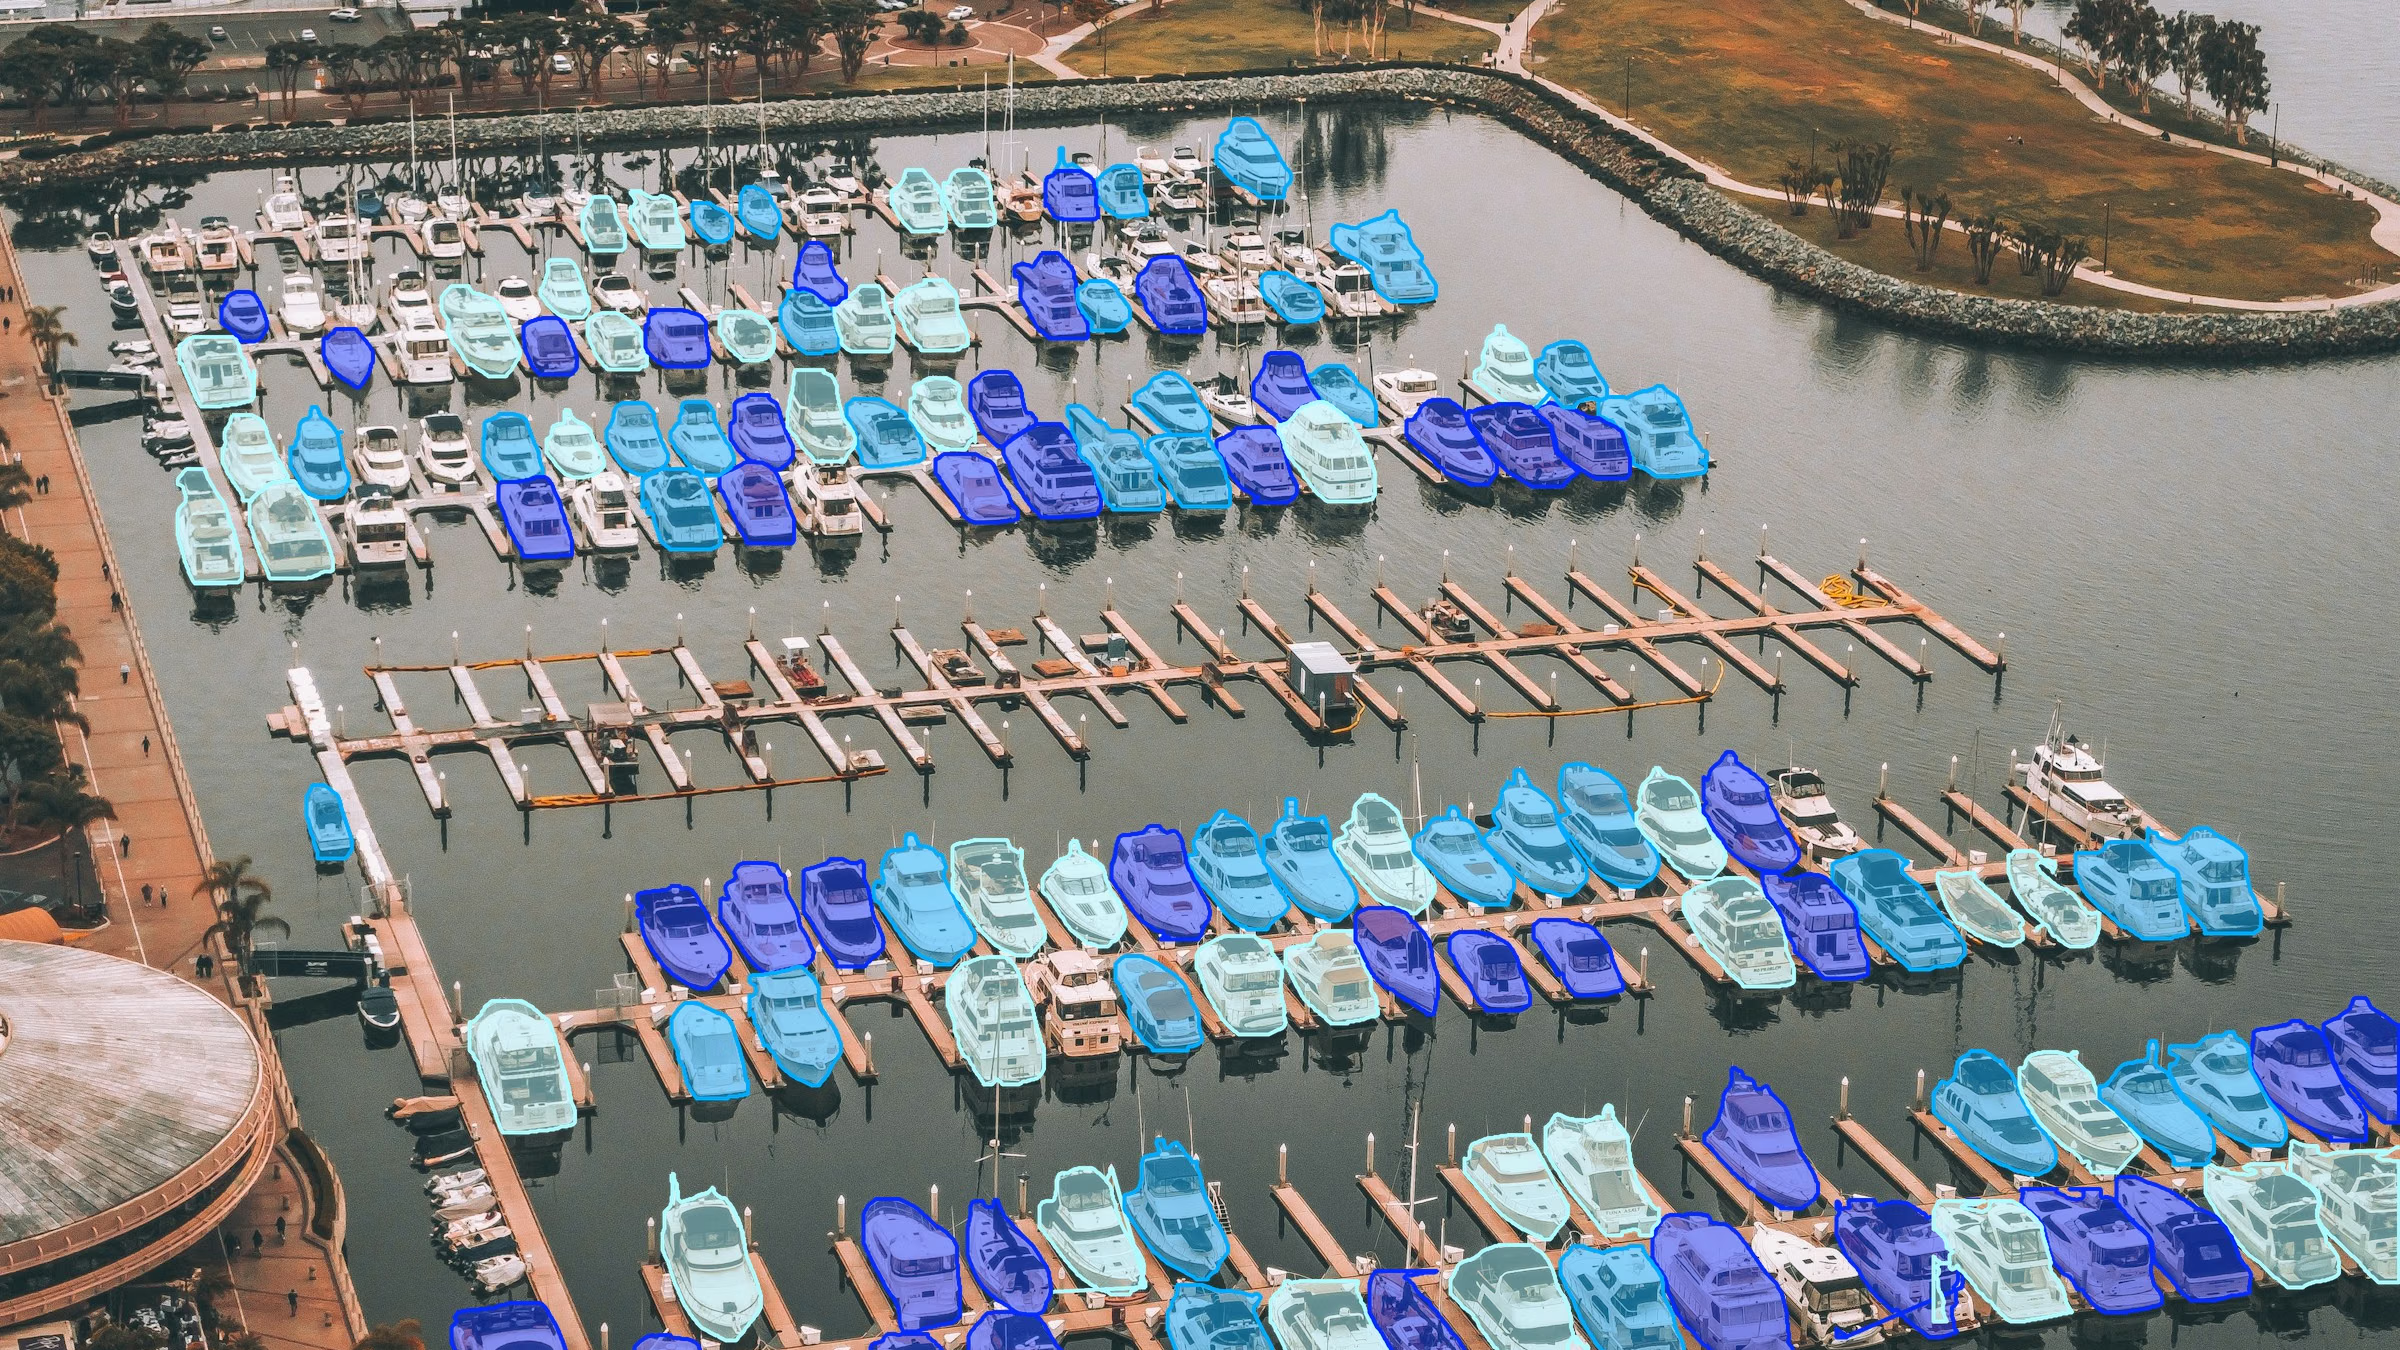
YOLO26x-seg devolvió 127 máscaras de barcos en esta foto del puerto deportivo, mostradas recortadas (imgsz=1920, conf=0.25, max_det=1000, retina_masks=True). Foto: Unsplash.
Por eso no era práctico aumentar max_det por encima de su valor predeterminado de 300 para la segmentación, y por eso las imágenes grandes con muchas instancias podían agotar la memoria. Los estantes de tiendas densamente cargados, como SKU-110K, las pilas de paquetes y los fotogramas aéreos son precisamente las escenas en las que necesitas admitir más de 300 objetos.
Ultralytics 8.4.213 decodifica las grandes pilas de máscaras dentro de cada cuadro#
La nueva ruta, introducida en la PR #27197, interpola los logits de los prototipos únicamente en los píxeles de cada cuadro. Utiliza muestreo bilineal separable, el mismo muestreo que usa la interpolación de PyTorch, y agrupa los cuadros de tamaño similar. Para las pilas grandes, el coste de decodificación ahora depende del área total de los cuadros.
En la práctica, importan tres detalles:
- Se activa al superar un tamaño fijo de pila de máscaras. El predictor de segmentación utiliza máscaras locales al cuadro cuando la pila densa superaría los 33.554.432 píxeles en CUDA o los 4.194.304 en CPU y otros dispositivos. Las pilas más pequeñas mantienen la ruta densa existente, que es igual de rápida o más rápida para un puñado de máscaras.
- En esa ruta, los contornos se obtienen directamente de las máscaras locales al cuadro.
masks.xyymasks.xyntrazan polígonos por cuadro, así quesummary(),to_json()ysave_txtno generan la pila completa. - El formato de salida no cambia.
masks.datasigue devolviendo un tensor denso de N x H x W. En la ruta local al cuadro, se crea la primera vez que lo lees.
Leer el tensor denso sigue teniendo el coste de asignarlo, pero la PR midió una reducción: en GPU, leer masks.data para 300 máscaras a 1080p con retina_masks=True pasó de 14,1 ms y 1.366 MiB a 9,1 ms y 795 MiB.
1.000 máscaras a 1080p pasaron de 821,2 ms a 56,4 ms en GPU#
La PR compara YOLO26n-seg ejecutando todo model.predict(...) más result.summary() (cuadros y polígonos) e informa de la mediana de ejecuciones en caliente, con un proceso por fila. Las escenas densas son una imagen sintética teselada con conf=0.01 y imgsz=1280; la escena típica es la bus.jpg estándar con los ajustes predeterminados y 5 máscaras. «Antes» corresponde a la versión 8.4.212. Son mediciones con mucho posprocesamiento de la predicción más el resumen, no una cifra general de velocidad de inferencia.
| Escena (GPU, RTX PRO 6000) | Máscaras | retina_masks | 8.4.212 | 8.4.213 |
|---|---|---|---|---|
Típica (bus.jpg) | 5 | Falso | 4,3 ms, 59 MiB | 4,4 ms, 59 MiB |
| 1920 x 1080 | 300 | Falso | 118,5 ms, 1.673 MiB | 16,3 ms, 174 MiB |
| 1920 x 1080 | 300 | Verdadero | 248,7 ms, 1.366 MiB | 18,0 ms, 201 MiB |
| 1920 x 1080 | 1,000 | Verdadero | 821,2 ms, 4.291 MiB | 56,4 ms, 321 MiB |
| 4000 x 3000 | 300 | Verdadero | 1.352,1 ms, 7.070 MiB | 26,5 ms, 172 MiB |
| 4000 x 3000 | 1,000 | Verdadero | 4.323,1 ms, 23.305 MiB | 130,7 ms, 258 MiB |
Tiempo y memoria GPU máxima, PyTorch 2.15.0 con CUDA 13.2. Fuente: PR #27197.
La imagen típica con cinco máscaras no cambia, tal como estaba previsto. Las mejoras aparecen cuando la pila antigua crecía mucho y son mayores en las máscaras a resolución completa, que antes eran el caso más costoso.
Las imágenes grandes necesitan una fracción de la memoria#
Con 4000 x 3000 píxeles y 1.000 máscaras predichas, la ruta antigua alcanzaba un máximo de 23.305 MiB de memoria GPU. La nueva ruta alcanzó un máximo de 258 MiB y terminó en 130,7 ms, en lugar de 4.323,1 ms. Esta reducción deja más memoria GPU disponible para el resto de la canalización cuando trabajas con fotogramas de 12 megapíxeles de drones, satélites y tareas de inspección.
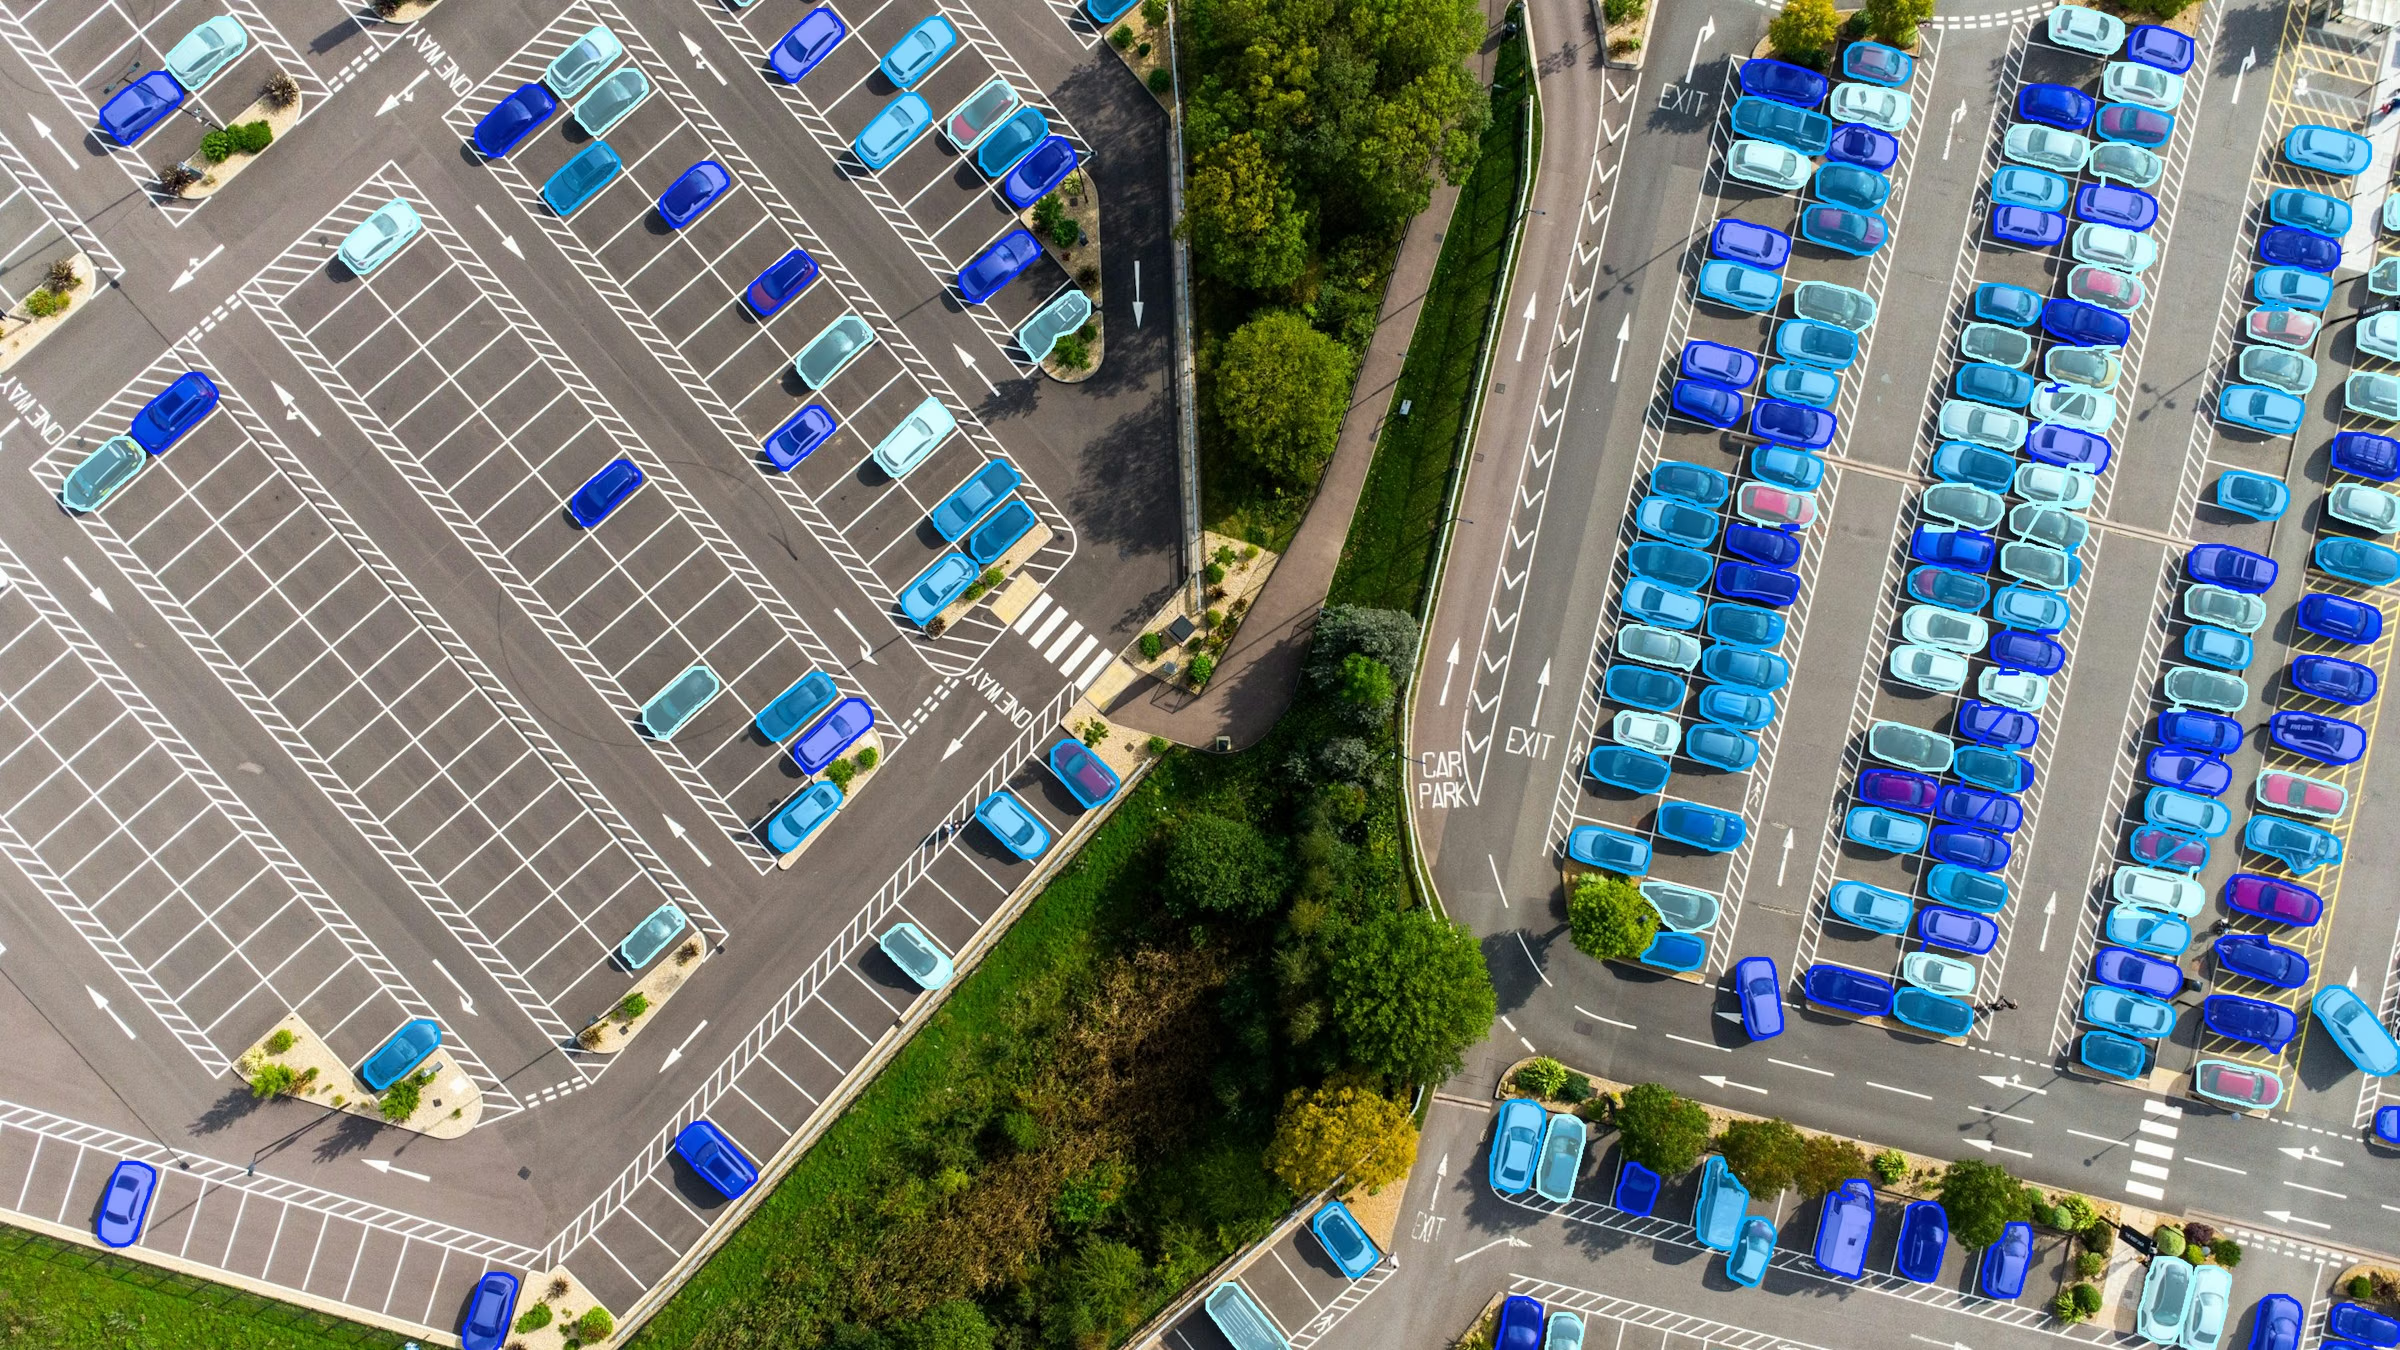
YOLO26x-seg devolvió 222 máscaras de coches en este fotograma aéreo (imgsz=1920, conf=0.15, max_det=1000, retina_masks=True). Foto: Unsplash.
Las predicciones en CPU también son mucho más rápidas#
En una CPU Linux x86 con 8 hilos, el proceso ocupa unos 840 MiB antes de generar ninguna máscara. A 1080p, con 1.000 máscaras a resolución completa, la memoria máxima del proceso bajó de 5.217 MiB a 1.072 MiB, y el tiempo se redujo como se muestra a continuación.
300 y 1.000 máscaras a 1920 x 1080, y 300 máscaras a 4000 x 3000 (12 MP). YOLO26n-seg, predicción más resumen, 8.4.212 antes y 8.4.213 después. Fuente: PR #27197.
Las máscaras coinciden con las de 8.4.212, con pequeñas diferencias en los bordes en uno de los modos#
Una ruta más rápida solo resulta útil si devuelve el mismo resultado. La PR comparó 8.4.213 con 8.4.212 en 96 predicciones, usando YOLO26n-seg y YOLO11n-seg en dos imágenes y seis tamaños, conf de 0.25 y 0.01, ambos modos de máscara y la ruta local al cuadro forzada:
- Máscaras predeterminadas (
retina_masks=False): los cuadros, las máscaras y los polígonos son idénticos; no difiere ninguno de los 7,6 millones de píxeles de máscara. - Máscaras a resolución completa (
retina_masks=True): son idénticas siempre que el código antiguo interpolaba una sola vez. En las otras formas de imagen, difiere el 0,07 % de los píxeles de máscara (18.105 de 24,8 millones), todos en los bordes de las máscaras, porque el código antiguo interpolaba dos veces en esos casos y el nuevo muestrea los prototipos una vez en la coordenada exacta. - Apple MPS: las máscaras, los cuadros y los polígonos son idénticos en una escena densa de 1080p con 179 máscaras, en ambos modos de máscara.
Cómo segmentar 1.000 objetos por imagen en Python#
Actualiza con pip install -U ultralytics (8.4.213 o posterior) y, después, aumenta max_det por encima de su valor predeterminado de 300. El resto de tu código no cambia.
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")  # Clases de COCO; carga tu propio modelo entrenado para estantes o paquetes
results = model.predict("crowd.jpg", imgsz=1280, conf=0.25, max_det=1000, retina_masks=True)

r = results[0]
print(len(r.boxes), "objects")
if r.masks is not None:
    polygons = r.masks.xy  # Una matriz (P, 2) por objeto, en píxeles de la imagen original
rows = r.summary()  # Cuadros y polígonos
max_det es un límite máximo, no un objetivo: el número de objetos devueltos sigue dependiendo del modelo, la imagen y tu umbral de confianza. Para aprovechar al máximo este cambio:
- Lee los contornos cuando puedas.
masks.xy(píxeles) ymasks.xyn(normalizados) se obtienen de las máscaras locales al cuadro en la ruta de pilas grandes, al igual queto_json()ysave_txt. La referencia de Results enumera todos los atributos. - Lee
masks.datapara realizar operaciones directas con píxeles. Las áreas y los solapamientos se calculan con mayor facilidad en el tensor denso; también puedes obtener recortes de los contornosmasks.xy. Nuestra lección de Academy sobre el uso de máscaras en el código explica cuándo usar cada vista, y la guía de aislamiento de objetos genera recortes a partir de contornos. - Usa
retina_masks=Truecuando necesites máscaras a la resolución de origen. En la prueba de referencia en GPU con 300 máscaras a 1080p, ahora tarda 18,0 ms, frente a los 16,3 ms de las máscaras predeterminadas. Para objetos pequeños en fotogramas muy grandes, consulta nuestra publicación sobre detección de objetos pequeños con teselado de imágenes y la guía de teselado de alta resolución. La predicción teselada devuelve máscaras del tamaño de la imagen de origen, por lo que una ejecución teselada sigue necesitando una cantidad de memoria proporcional a la imagen original. - Ajusta
confyioupara escenas abarrotadas. Al aumentarmax_det, se conservan más detecciones de las que ya superanconf; al reducirconf, se admiten detecciones menos seguras. Los ajustes de predicción explicanconf,iouymax_det, y nuestra guía sobre el umbral IoU de NMS explica cómo gestionar objetos que se tocan.
El cambio se encuentra en el posprocesamiento de Python, así que se aplica al modelo PyTorch y a los modelos exportados que se ejecutan mediante la API predict de Ultralytics. La PR probó YOLO26n-seg y YOLO11n-seg, y el mismo posprocesamiento sirve para todos los modelos de segmentación YOLO26 y YOLO11, desde YOLO26n-seg, con 2,7 M de parámetros fusionados, hasta YOLO26x-seg, con 62,8 M. Para entrenar uno con tus propios datos densos, sigue nuestra guía para entrenar YOLO26 con datos personalizados para la segmentación de instancias.
Ultralytics Platform ahora devuelve hasta 1.000 resultados por imagen#
El mismo límite máximo se aplica ahora en Ultralytics Platform. La pestaña Predict de un modelo devuelve hasta 1.000 resultados por imagen, al igual que la REST API que hay detrás. Los modelos RT-DETR son la excepción, con un límite de 300, que corresponde al número de consultas de su decodificador.
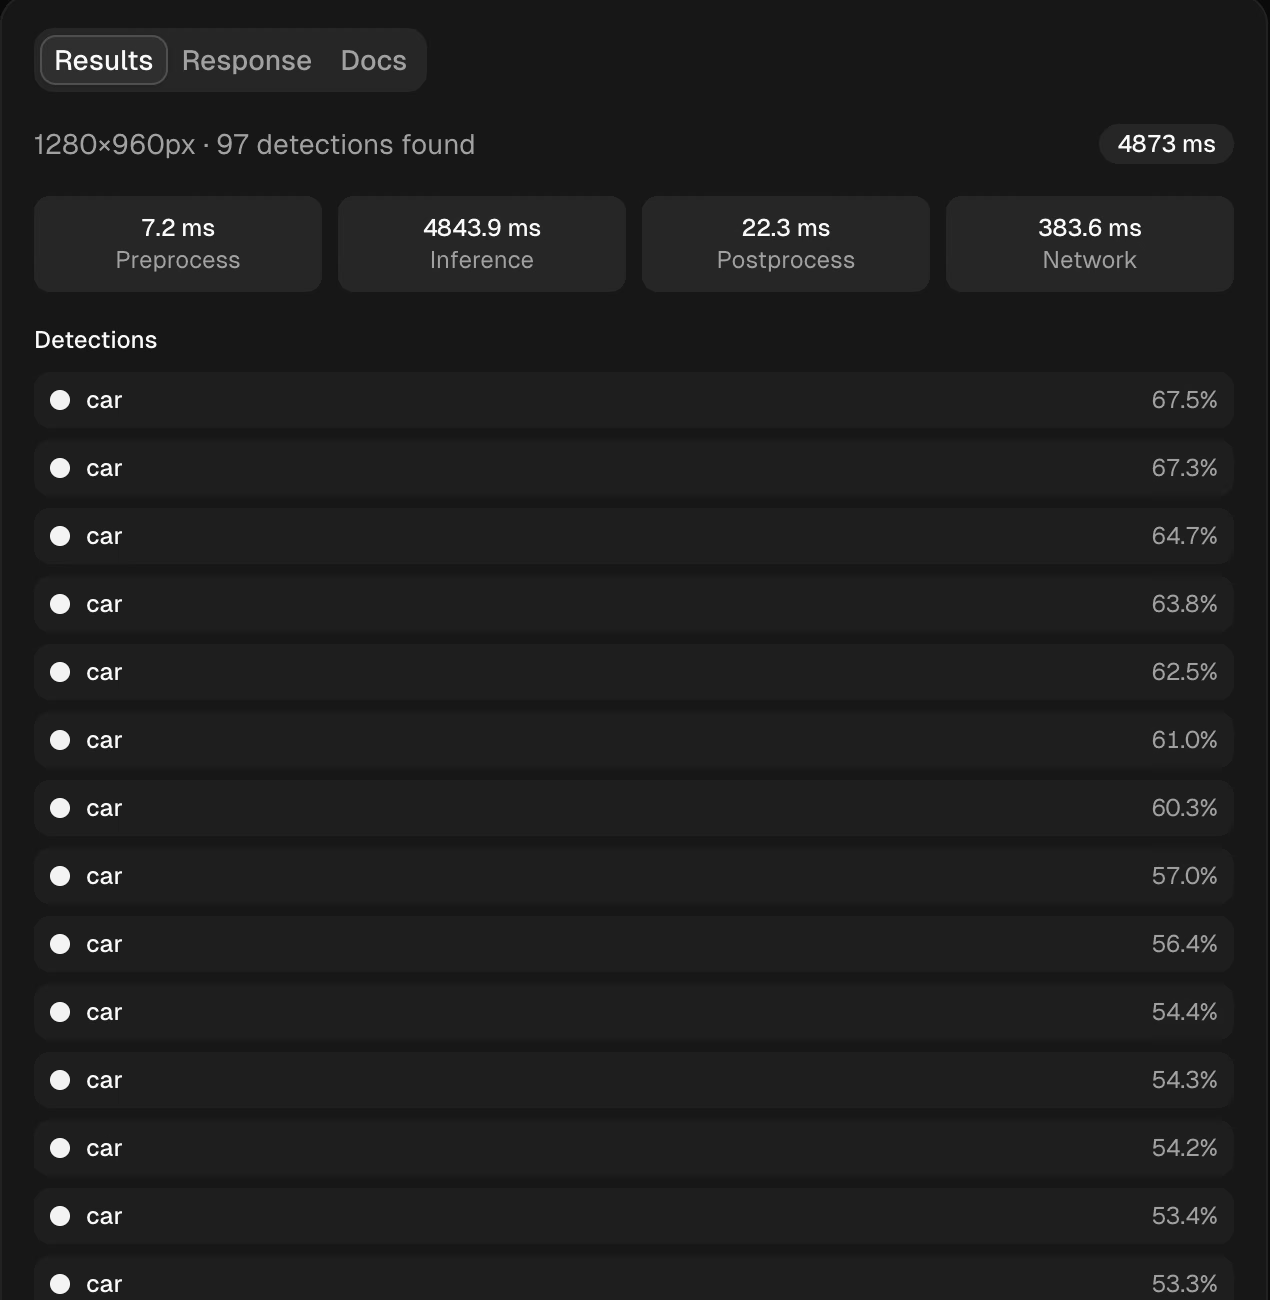
La pestaña Predict de YOLO26x-seg con un tamaño de imagen de 1280, que muestra 97 detecciones de coches en la foto aérea de arriba. La documentación de inferencia de Platform explica el panel en detalle.
El panel de resultados está diseñado para listas largas. Cuando hay más de 10 resultados, la imagen muestra cuadros sin etiquetas para que no oculten los objetos, la lista identifica cada resultado y la imagen ampliada mantiene las etiquetas. Pasa el cursor por una fila para resaltar su objeto o por un objeto para encontrar la fila correspondiente.
Para probarlo con tus propios datos, empieza con el conjunto de datos de segmentación de paquetes Package-Seg, entrena en la nube y ejecuta el resultado en la pestaña Predict o detrás de un punto de conexión dedicado.
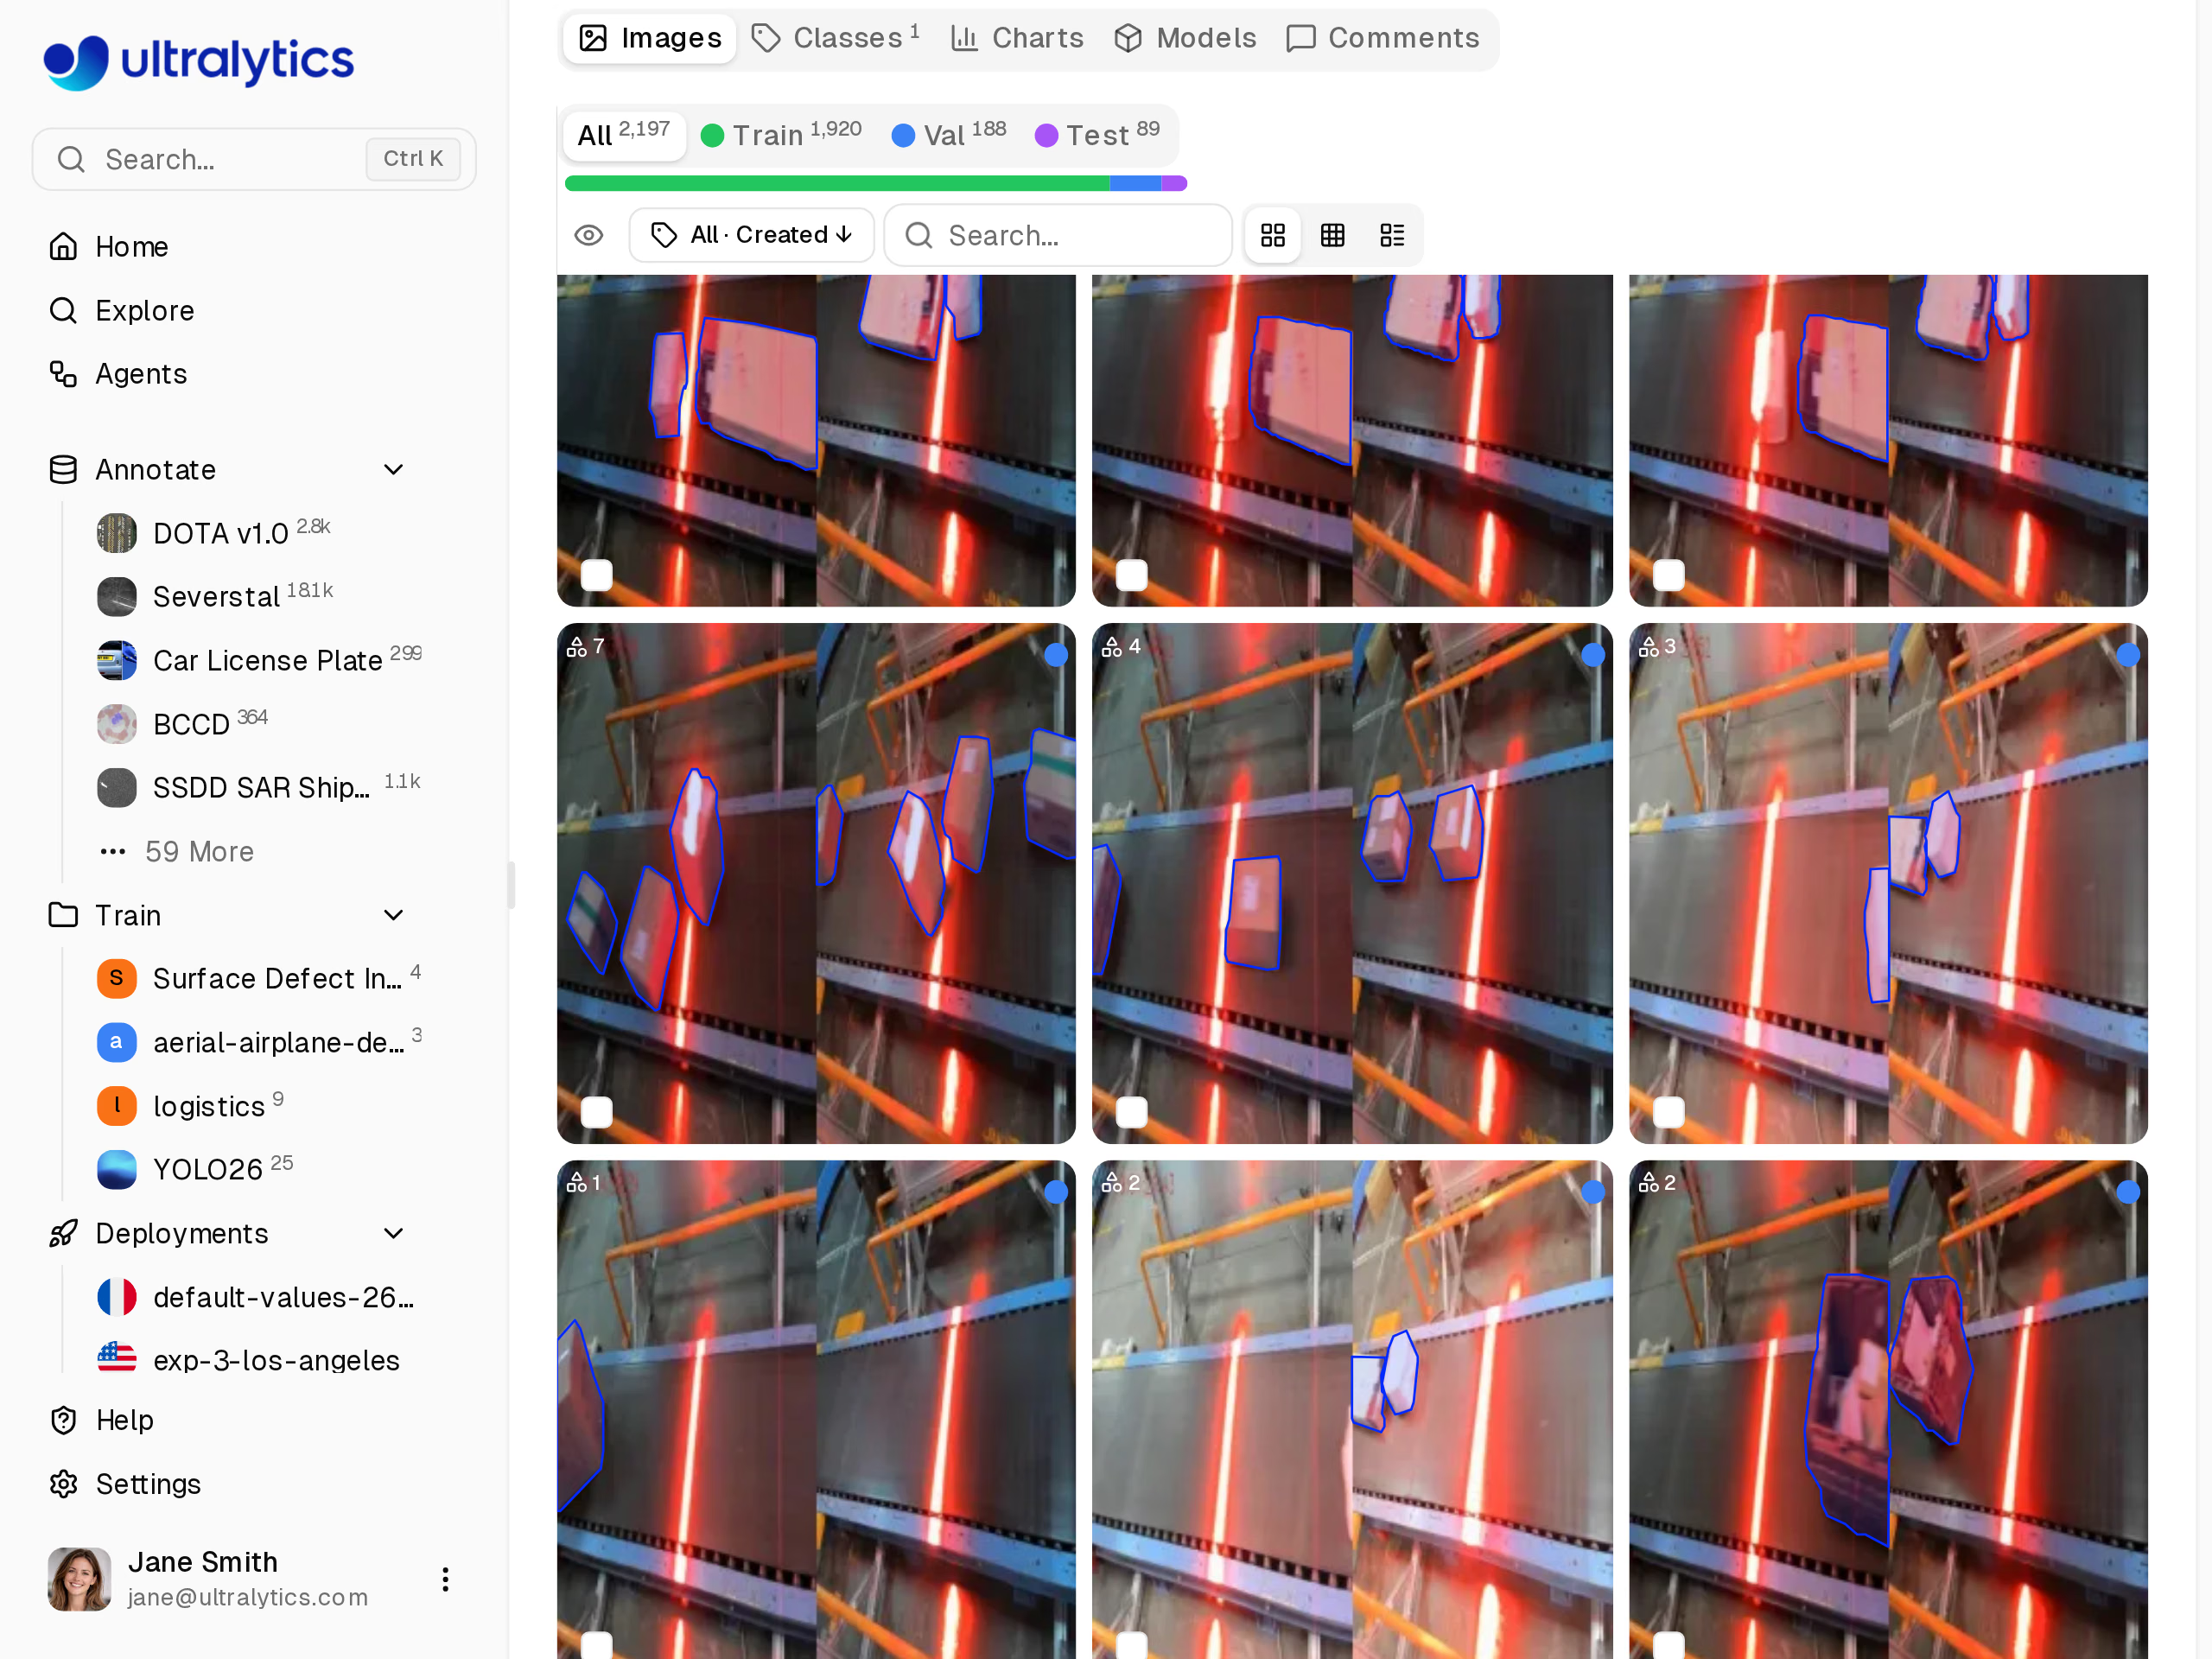
El conjunto de datos Package-Seg en Ultralytics Platform, un punto de partida listo para usar en tareas de segmentación logística.
Quién debería actualizar#
Actualiza ahora si segmentas escenas abarrotadas o imágenes grandes: estantes de tiendas, clasificación de paquetes, estudios aéreos y con drones, microscopía celular o cualquier otro caso en el que hayas limitado max_det, reducido el tamaño de imagen o eliminado retina_masks para no superar la memoria disponible. Puedes volver a plantearte esas soluciones provisionales.
Si tus pilas de máscaras no superan el umbral, siguen usando la ruta densa existente; ten en cuenta que el umbral cuenta el número de objetos multiplicado por el tamaño de la imagen, por lo que incluso unas pocas máscaras en una imagen muy grande pueden superarlo. Si tu canalización siempre lee masks.data, sigues creando el tensor denso; en la prueba de la PR con 300 máscaras a 1080p en GPU, consumió menos tiempo y memoria que antes. Si quieres repasar si realmente necesitas máscaras de instancias, consulta segmentación semántica frente a segmentación de instancias.
Preguntas frecuentes
La segmentación YOLO es la tarea de segmentación de instancias de Ultralytics YOLO: para cada objeto, el modelo devuelve una clase, un cuadro, una puntuación de confianza y una máscara de píxeles. Los modelos de segmentación YOLO26 están disponibles en cinco tamaños, desde YOLO26n-seg hasta YOLO26x-seg, preentrenados con las 80 clases de COCO y listos para ajustarlos con tus propios datos.
max_detestablece el límite máximo, 300 de forma predeterminada; el número devuelto también depende del modelo, la imagen y el umbral de confianza. Desde la versión 8.4.213, un límite de 1.000 resulta práctico para cargas de trabajo como la de la prueba de referencia: en una imagen sintética de 1080p, YOLO26n-seg predijo y resumió 1.000 máscaras a resolución completa en 56,4 ms, con un uso máximo de memoria de 321 MiB en una RTX PRO 6000. Ultralytics Platform devuelve hasta 1.000 resultados por imagen.Las versiones anteriores generaban todas las máscaras al tamaño del fotograma, por lo que la memoria aumentaba en función del número de objetos multiplicado por el área del fotograma. En la prueba sintética con 4000 x 3000 y 1.000 máscaras a resolución completa, el consumo máximo fue de 23.305 MiB de memoria GPU. La versión 8.4.213 decodifica las pilas grandes dentro de cada cuadro y alcanzó un máximo de 258 MiB en el mismo caso.
Actualiza a
ultralytics8.4.213 o posterior; no hace falta ningún otro cambio en el código, porque la ruta local al cuadro se activa automáticamente con las pilas de máscaras grandes.masks.dataconserva el mismo formato denso, así que el código existente sigue funcionando; leermasks.xyo llamar asummary()en su lugar evita generarlo en esa ruta.retina_masks=Truedevuelve máscaras a la resolución de la imagen original en lugar de al tamaño de inferencia del modelo, lo que alinea la máscara densa con la imagen original. Con 300 máscaras en una imagen sintética de 1080p, la predicción más el resumen de YOLO26n-seg en una RTX PRO 6000 tardó 248,7 ms en la versión 8.4.212 y 18,0 ms en la versión 8.4.213 con este ajuste activado.
Escrito por
Fundador y director ejecutivo · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









