Data Curation
La curación de datos es el proceso continuo de organizar, validar, documentar y mantener conjuntos de datos fiables para el aprendizaje automático y la evaluación.
La curación de datos es el proceso continuo de seleccionar, organizar, comprobar, documentar y mantener los datos para que sigan siendo útiles para un propósito concreto. En aprendizaje automático, determina los ejemplos de los que aprende un modelo y las pruebas que se utilizan para evaluarlo. Un conjunto de datos curado combina muestras pertinentes, etiquetas coherentes para tareas supervisadas, información contextual y versiones trazables.
Curación, limpieza y preprocesamiento#
La curación abarca todo el ciclo de vida del conjunto de datos. La limpieza de datos corrige errores y elimina registros inutilizables; el preprocesamiento de datos transforma las entradas mediante operaciones como el redimensionamiento o la normalización. La anotación de datos, también llamada etiquetado de datos, añade los objetivos utilizados en el aprendizaje supervisado. La curación coordina estas actividades y determina qué muestras incluir, cómo definir las categorías y cómo evoluciona la colección con el tiempo. Las definiciones coherentes de categorías y las reglas de etiquetado ayudan a los modelos a aprender relaciones fiables entre imágenes y objetivos.
Esto convierte la curación en un componente práctico de la IA centrada en los datos, que mejora los sistemas al mejorar sus datos.
Cómo funciona la curación de datos#
El proceso empieza con una especificación del conjunto de datos: la tarea de predicción, las categorías objetivo, las condiciones de funcionamiento y los criterios de inclusión. En la detección de objetos, esto incluye reglas para las cajas delimitadoras y los objetos parcialmente visibles. Revisar la frecuencia de las categorías y las condiciones de captura permite detectar el sesgo del conjunto de datos, incluidas las clases o entornos infrarrepresentados.
Las comprobaciones de calidad combinan la inspección automatizada con la revisión humana. Las comprobaciones de archivos detectan imágenes ilegibles; las de anotaciones identifican coordenadas no válidas y clases incoherentes. Los hashes de archivos exactos detectan copias idénticas, mientras que las representaciones vectoriales —representaciones numéricas del contenido de las imágenes— ayudan a localizar muestras visualmente similares. La revisión distingue los errores reparables de los registros inutilizables y conserva los ejemplos válidos y difíciles que representan la tarea.
Una auditoría de hashes de archivos puede conservar una ruta por cada archivo único. Este ejemplo comprueba las imágenes incluidas en el paquete ultralytics, instalado con pip install ultralytics:
from hashlib import sha256

from ultralytics.utils import ASSETS

paths = sorted(ASSETS.glob("*.jpg"))
unique = {}

# Keep the first image path for each file digest.
for path in paths:
    digest = sha256(path.read_bytes()).hexdigest()
    unique.setdefault(digest, path)

curated = list(unique.values())
print(f"Before: {len(paths)}, after deduplication: {len(curated)}")
Los recuentos muestran cuántos archivos quedan tras eliminar duplicados exactos; si los recuentos son iguales, todos los archivos muestreados tienen hashes distintos.
La división protege la independencia de los datos de entrenamiento, los datos de validación y los datos de prueba. Los fotogramas de vídeo cercanos comparten contenido de escena, por lo que repartirlos entre las particiones provoca fuga de datos e infla las puntuaciones de evaluación. Agrupar por sesión de grabación, cámara o ubicación hace que la evaluación refleje la tarea de generalización prevista. Una versión fija del conjunto de datos conserva esas asignaciones junto con sus etiquetas.
Ultralytics Platform facilita la curación con gráficos de distribución de clases y agrupación de imágenes, que permiten detectar carencias de cobertura, duplicados y valores atípicos. Sus herramientas de gestión de conjuntos de datos permiten a los equipos inspeccionar estos grupos y actualizar imágenes, etiquetas y asignaciones de particiones.
Qué hace un curador de datos#
Un curador de datos mantiene el significado y la utilidad de la colección. Entre sus responsabilidades están documentar las fuentes, coordinar las directrices de anotación, resolver desacuerdos de etiquetado y registrar los cambios. Los metadatos —información que describe las muestras— recogen la hora de adquisición, el sensor, la ubicación y el estado de anotación. Mantener datos reutilizables incluye conservar las descripciones y la documentación de apoyo.
La procedencia de los datos registra el origen de las muestras y cómo se han transformado. Vincular las versiones del conjunto de datos al seguimiento de experimentos permite reproducir las comparaciones de modelos. Tras la implementación, el aprendizaje activo prioriza las muestras informativas para su revisión; la supervisión detecta la deriva de datos, que puede motivar una nueva recopilación.
Ejemplos en visión artificial#
En la percepción automovilística, la colección original de BDD100K contiene 100.000 vídeos de conducción grabados en distintas ubicaciones de EE. UU., condiciones meteorológicas y situaciones diurnas y nocturnas. Sus atributos ambientales permiten evaluar distintas condiciones de captura. La edición de Platform contiene 99.996 imágenes de fotogramas clave para detección.
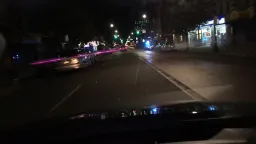 Vista previa 1 de BDD100K
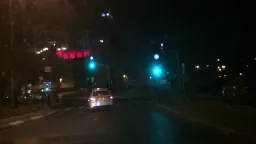 Vista previa 2 de BDD100K
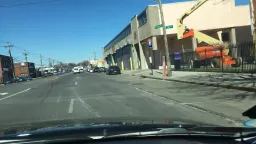 Vista previa 3 de BDD100K
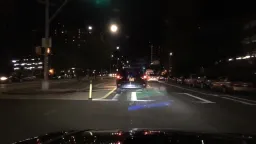 Vista previa 4 de BDD100K
Dashcam frames from crowdsourced US drives across cities, weather, and times of day, from UC Berkeley's BDD100K driving benchmark. Keyframes come from 40-second videos recorded largely in New York and the San Francisco Bay Area through Nexar, including night, rain, snow, and fog. Source: Yu, Chen, Wang, et al., "BDD100K: A Diverse Driving Dataset for Heterogeneous Multitask Learning," CVPR 2020; bdd100k.com. Free for educational, research, and non-profit use; commercial use requires UC Berkeley permission.
En la clasificación de imágenes, la corrección de ciFAIR sustituyó los casi duplicados de los conjuntos de prueba originales de CIFAR-10 y CIFAR-100. Las coincidencias con imágenes de entrenamiento u otras imágenes de prueba afectaban al 3,25 % y al 10 % de sus respectivos conjuntos de prueba originales. Sin modificar el entrenamiento, el error de clasificación de ResNeXt-29 (8x64d) pasó del 3,56 % en CIFAR-10 al 3,95 % en ciFAIR-10.









