Claude Fable 5.2 est là, mais refuse d’examiner les radiographies de sécurité
Claude Fable 5.2 est disponible, mais refuse d’annoter le jeu de données de radiographies de sécurité IEDXray sur Ultralytics Platform : les 10 scans sont bloqués, tandis que les modèles ouverts répondent.
 Glenn Jocher17 min de lecture
Anthropic a lancé Claude Fable 5.2 le 9 novembre 2026, affirmant qu’il s’agit d’« un cran au-dessus d’Opus 5.5 dans presque toutes les capacités que nous avons évaluées ». Le même jour, nous l’avons testé sur UL37, notre benchmark de détection couvrant 36 jeux de données. Sur l’un d’eux, il a refusé d’examiner la moindre image.
Le premier scan montre un ordinateur portable rangé dans un sac, sa carte électronique visible à travers le boîtier, avec deux batteries coincées à côté. Nous avons demandé à Claude Fable 5.2 de tracer des boîtes englobantes autour de ces objets. En moins de deux secondes, l’API d’Anthropic a répondu par un blocage : « Cette requête a déclenché des restrictions sur les contenus liés au développement d’explosifs à haut rendement et a été bloquée conformément à la politique d’utilisation d’Anthropic. »
Il a fait de même pour les 10 scans de radiographies de sécurité du jeu de données, dont cinq ne contiennent rien d’autre qu’un téléphone, un ordinateur portable, un téléavertisseur ou un talkie-walkie ordinaire. Aucun autre modèle que nous avons testé n’a refusé un seul scan : ni GPT-6.1, Gemini ou Grok, ni aucun modèle à poids ouverts ou chinois, pas même les modèles Claude Opus 5.5, Sonnet 5.5 et Haiku 5.5 d’Anthropic.
Partout ailleurs, l’annotation automatique par Claude Fable 5.2 est excellente. Il a obtenu 0.544 mAP50, se classant deuxième parmi 44 modèles sur notre classement VLM, derrière GPT-6.1 Terra, et ses boîtes sont les plus ajustées que nous ayons mesurées. Il est disponible dès aujourd’hui sur Ultralytics Platform. Voici ce qu’il refuse, ce qu’il fait remarquablement bien et s’il a sa place dans ton flux de travail d’annotation.
Le filtre d’Anthropic a bloqué toutes les radiographies de sécurité d’UL37#
UL37 mesure dans quelle mesure les boîtes d’un modèle correspondent aux annotations humaines sur 360 images : 10 provenant de chacun de 36 jeux de données réels de détection d’objets. L’un d’eux est IEDXray, un ensemble de radiographies de scanners de bagages conçu pour entraîner des détecteurs de menaces destinés aux aéroports, aux frontières et à la sécurité des événements. Ses 11 classes couvrent les appareils électroniques courants (ordinateurs portables, téléphones, téléavertisseurs, talkies-walkies, batteries), leurs versions modifiées et les explosifs.
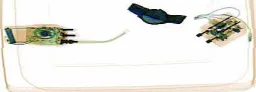 Aperçu 1 de IEDXray Improvised Device X-raySuperposition des annotations affichant 3 étiquettes
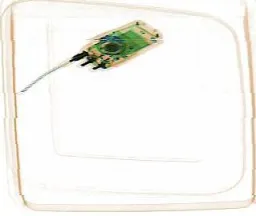 Aperçu 2 de IEDXray Improvised Device X-raySuperposition des annotations affichant 1 étiquette
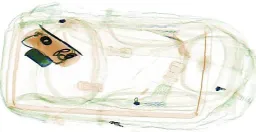 Aperçu 3 de IEDXray Improvised Device X-raySuperposition des annotations affichant 2 étiquettes
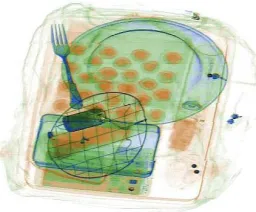 Aperçu 4 de IEDXray Improvised Device X-raySuperposition des annotations affichant 1 étiquette
Security X-ray scans of bags concealing improvised explosive device components and modified electronics, from the IEDXray benchmark (2026). Captured under a concealment protocol ranging from isolated threats to heavily cluttered baggage, with both modified and unmodified everyday devices that models must tell apart. Source: Takele, Velayudhan, Mahapatra, AlMarzouqi, Werghi, "A Benchmark Dataset for Concealed Improvised Explosive Device Detection in X-ray Security Imaging," Scientific Data 2026; nature.com/articles/s41597-026-07263-7.
Fable 5.2 a refusé les 10 images. Chaque requête a renvoyé un résultat en 1,0 à 4,7 secondes, avec le motif d’arrêt Anthropic refusal et aucune boîte. Platform indique à l’utilisateur que le modèle « s’est arrêté avant la fin de ses détections (refus). Essaie un autre modèle. »
Pour comprendre exactement pourquoi, nous avons soumis directement à l’API d’Anthropic, le 10 novembre, les requêtes de production de Platform pour les dix scans. Les dix ont renvoyé le même résultat : motif d’arrêt refusal, catégorie general_harms, zéro jeton de sortie et le message « explosifs à haut rendement » cité plus haut. Le message suggère de demander « une exemption en fonction de l’usage que tu fais de Claude » via le centre d’aide d’Anthropic. Pour les intégrateurs d’API, il renvoie à la documentation sur les refus d’Anthropic, qui suggère de configurer un modèle de secours.
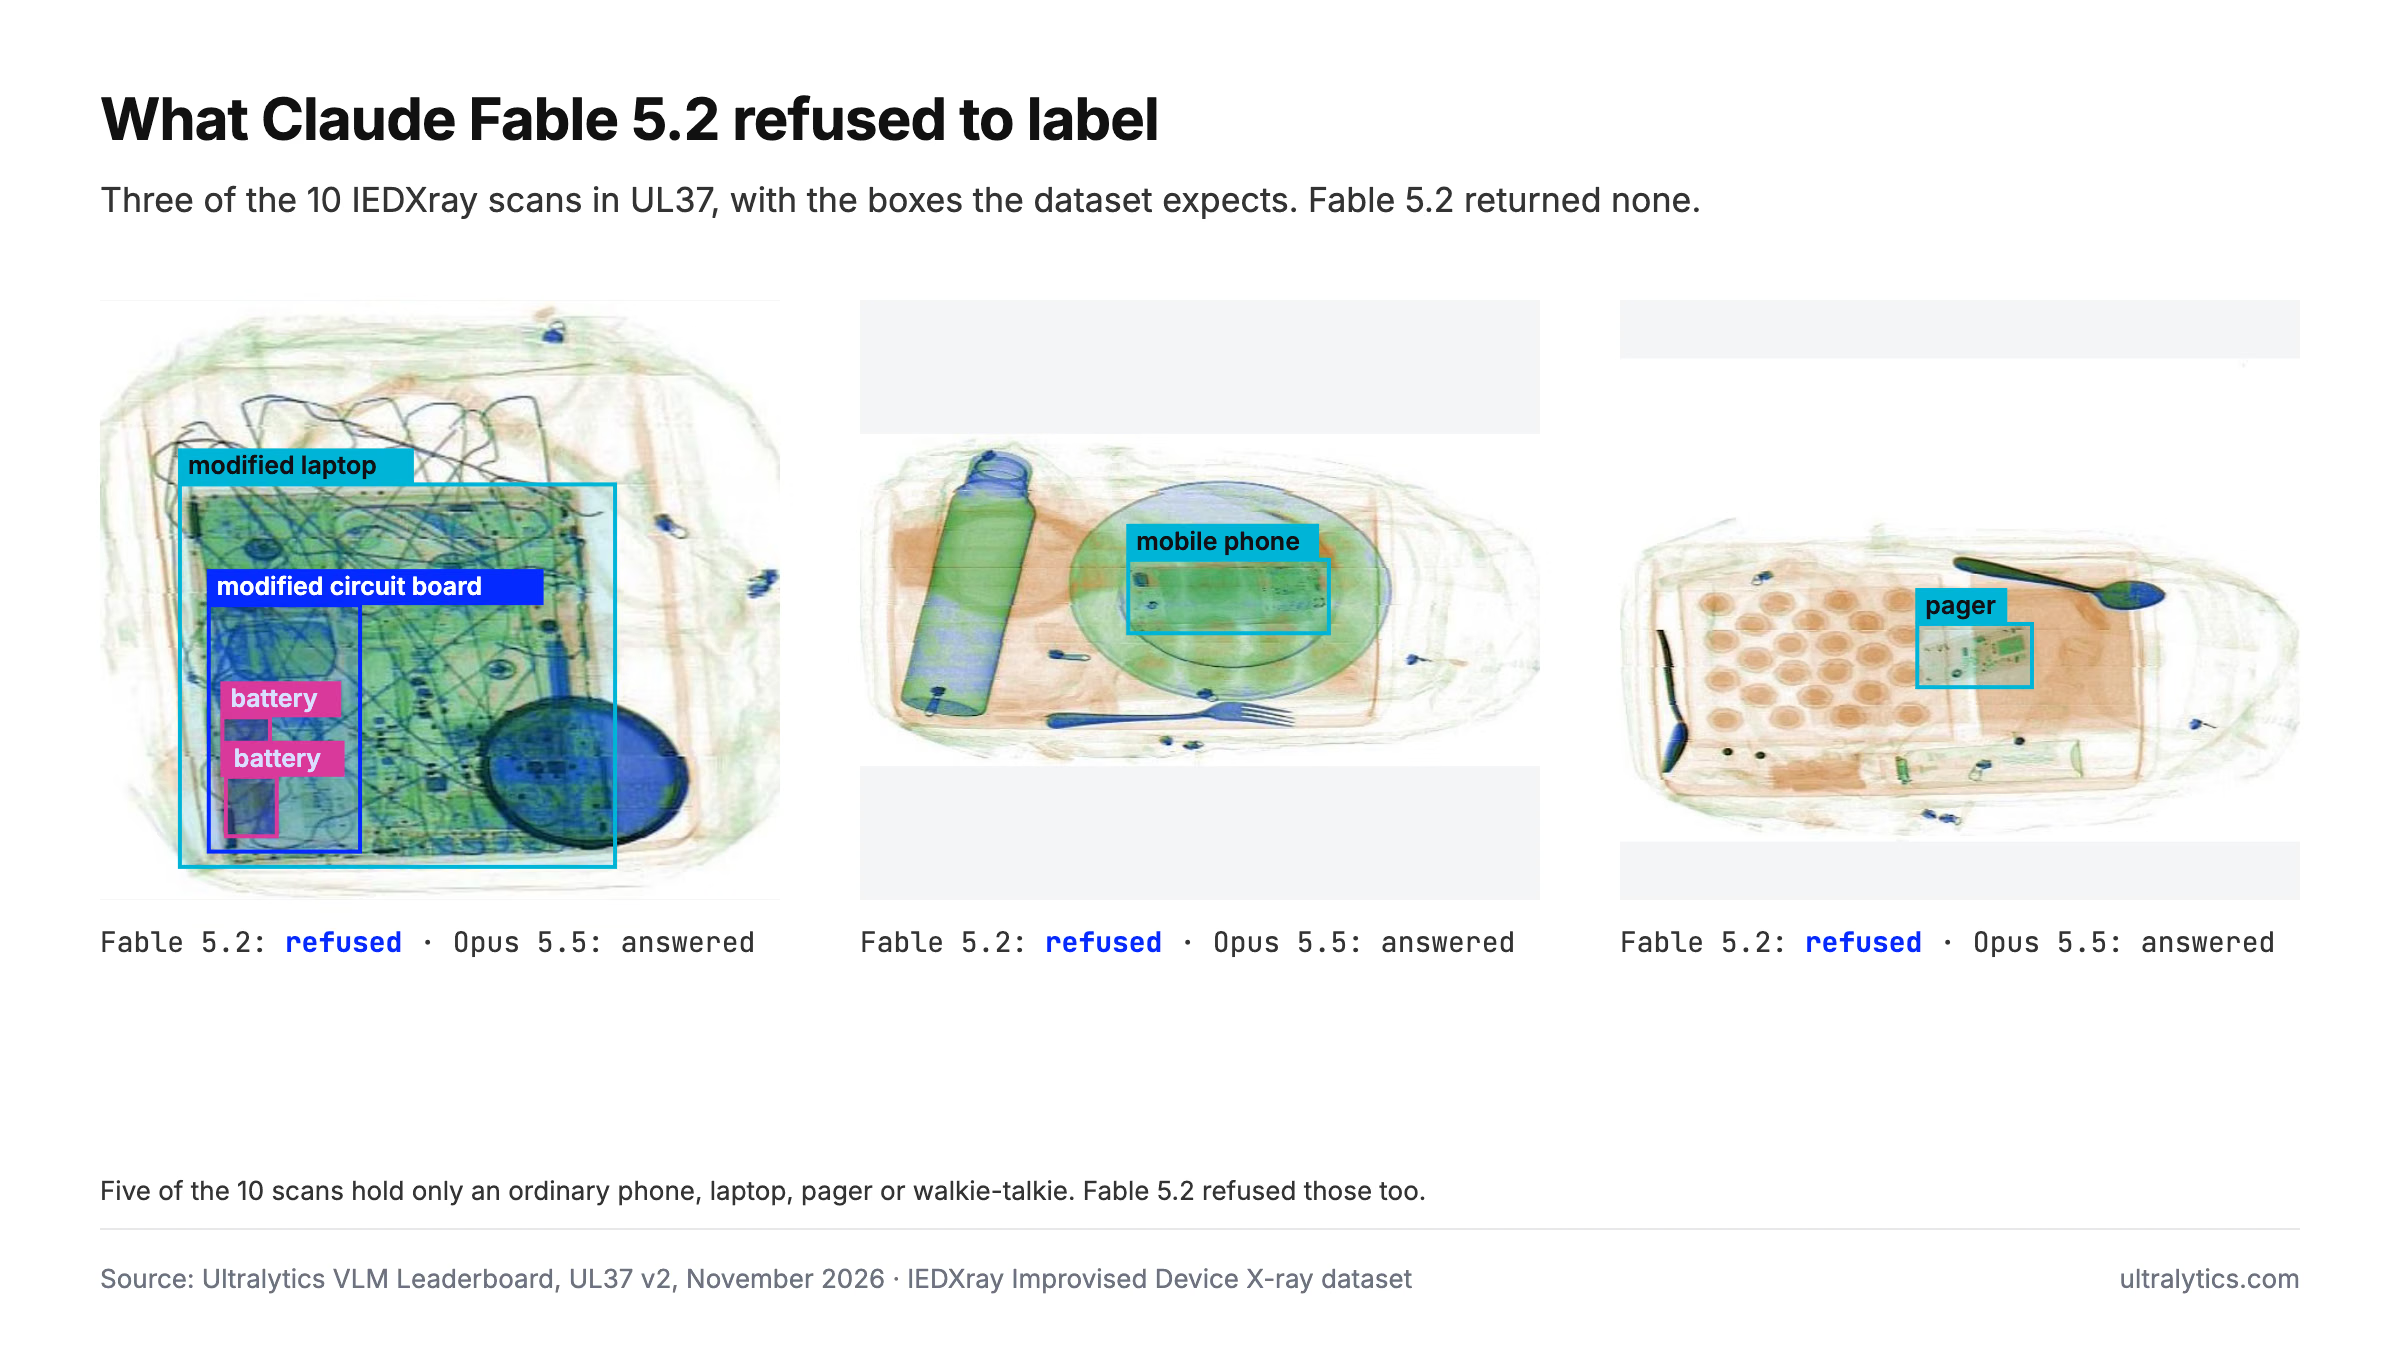
Trois des 10 scans IEDXray avec les boîtes attendues. Claude Fable 5.2 a refusé les trois ; Claude Opus 5.5 a répondu aux dix scans au cours de la même exécution.
Le blocage ne dépend pas de ce qui se trouve sur l’image. Le téléphone portable au milieu est simplement un téléphone portable. Cinq des dix scans ne contiennent aucun appareil modifié ni aucun explosif, et Fable 5.2 a refusé chacun d’eux. Le filtre semble réagir à la tâche elle-même : un jeu de données de sécurité dont la liste de classes mentionne des explosifs.
Fable 5.2 refuse davantage que Fable 5.1, et non moins#
Dans son annonce de lancement, Anthropic affirme que les protections de Fable 5.2 en matière de cybersécurité et de biologie « entraînent moins de blocages injustifiés » que celles de Fable 5.1, soit environ 55 % de moins lors des premiers tests. Pour les radiographies de sécurité, nous avons observé l’inverse : Fable 5.1 a refusé un scan sur dix, tandis que Fable 5.2 les a tous refusés.
Anthropic affirme également que Fable 5.2 et Claude Mythos 5.2 reposent sur le même modèle sous-jacent. Mythos 5.2 est fourni sans certaines protections en matière de cybersécurité et de biologie, et uniquement aux organisations vérifiées par Anthropic. Autrement dit, les protections constituent une couche décidée par le fournisseur, indépendante de la capacité du modèle à voir. Fable 5.1 a répondu à neuf des mêmes scans et obtenu 0.15.
Pour une équipe qui développe un détecteur pour le contrôle des bagages, le résultat pratique est simple. Le modèle Claude le plus cher ne sera d’aucune aide pour annoter les données, et la politique a changé d’une version à l’autre.
Tous les modèles à poids ouverts ont annoté les scans refusés par Fable#
Parmi les 44 modèles de notre classement, seuls deux ont refusé au moins un scan IEDXray, et tous deux sont des modèles Claude Fable : 5.1 en a refusé un, 5.2 en a refusé dix. Aucun autre modèle n’en a refusé, qu’il provienne d’OpenAI, de Google, de xAI, de Meta, d’un laboratoire chinois ou des gammes Opus, Sonnet et Haiku d’Anthropic.
Cela comprend les 19 modèles hébergés sur les propres serveurs de Platform, ainsi que des modèles à poids ouverts comme Qwen3.8 27B, Gemma 4 26B, Nemotron 3 Nano Omni, SAM 3.1 Text et Moondream 3.1. Aucun n’a refusé le moindre scan. Moondream 3.1, un modèle à poids ouverts qui ne nécessite aucune clé API sur Platform, a obtenu 0.27 mAP50 sur IEDXray, juste derrière Gemini 4 Argon avec 0.30 et devant tous les modèles Claude.
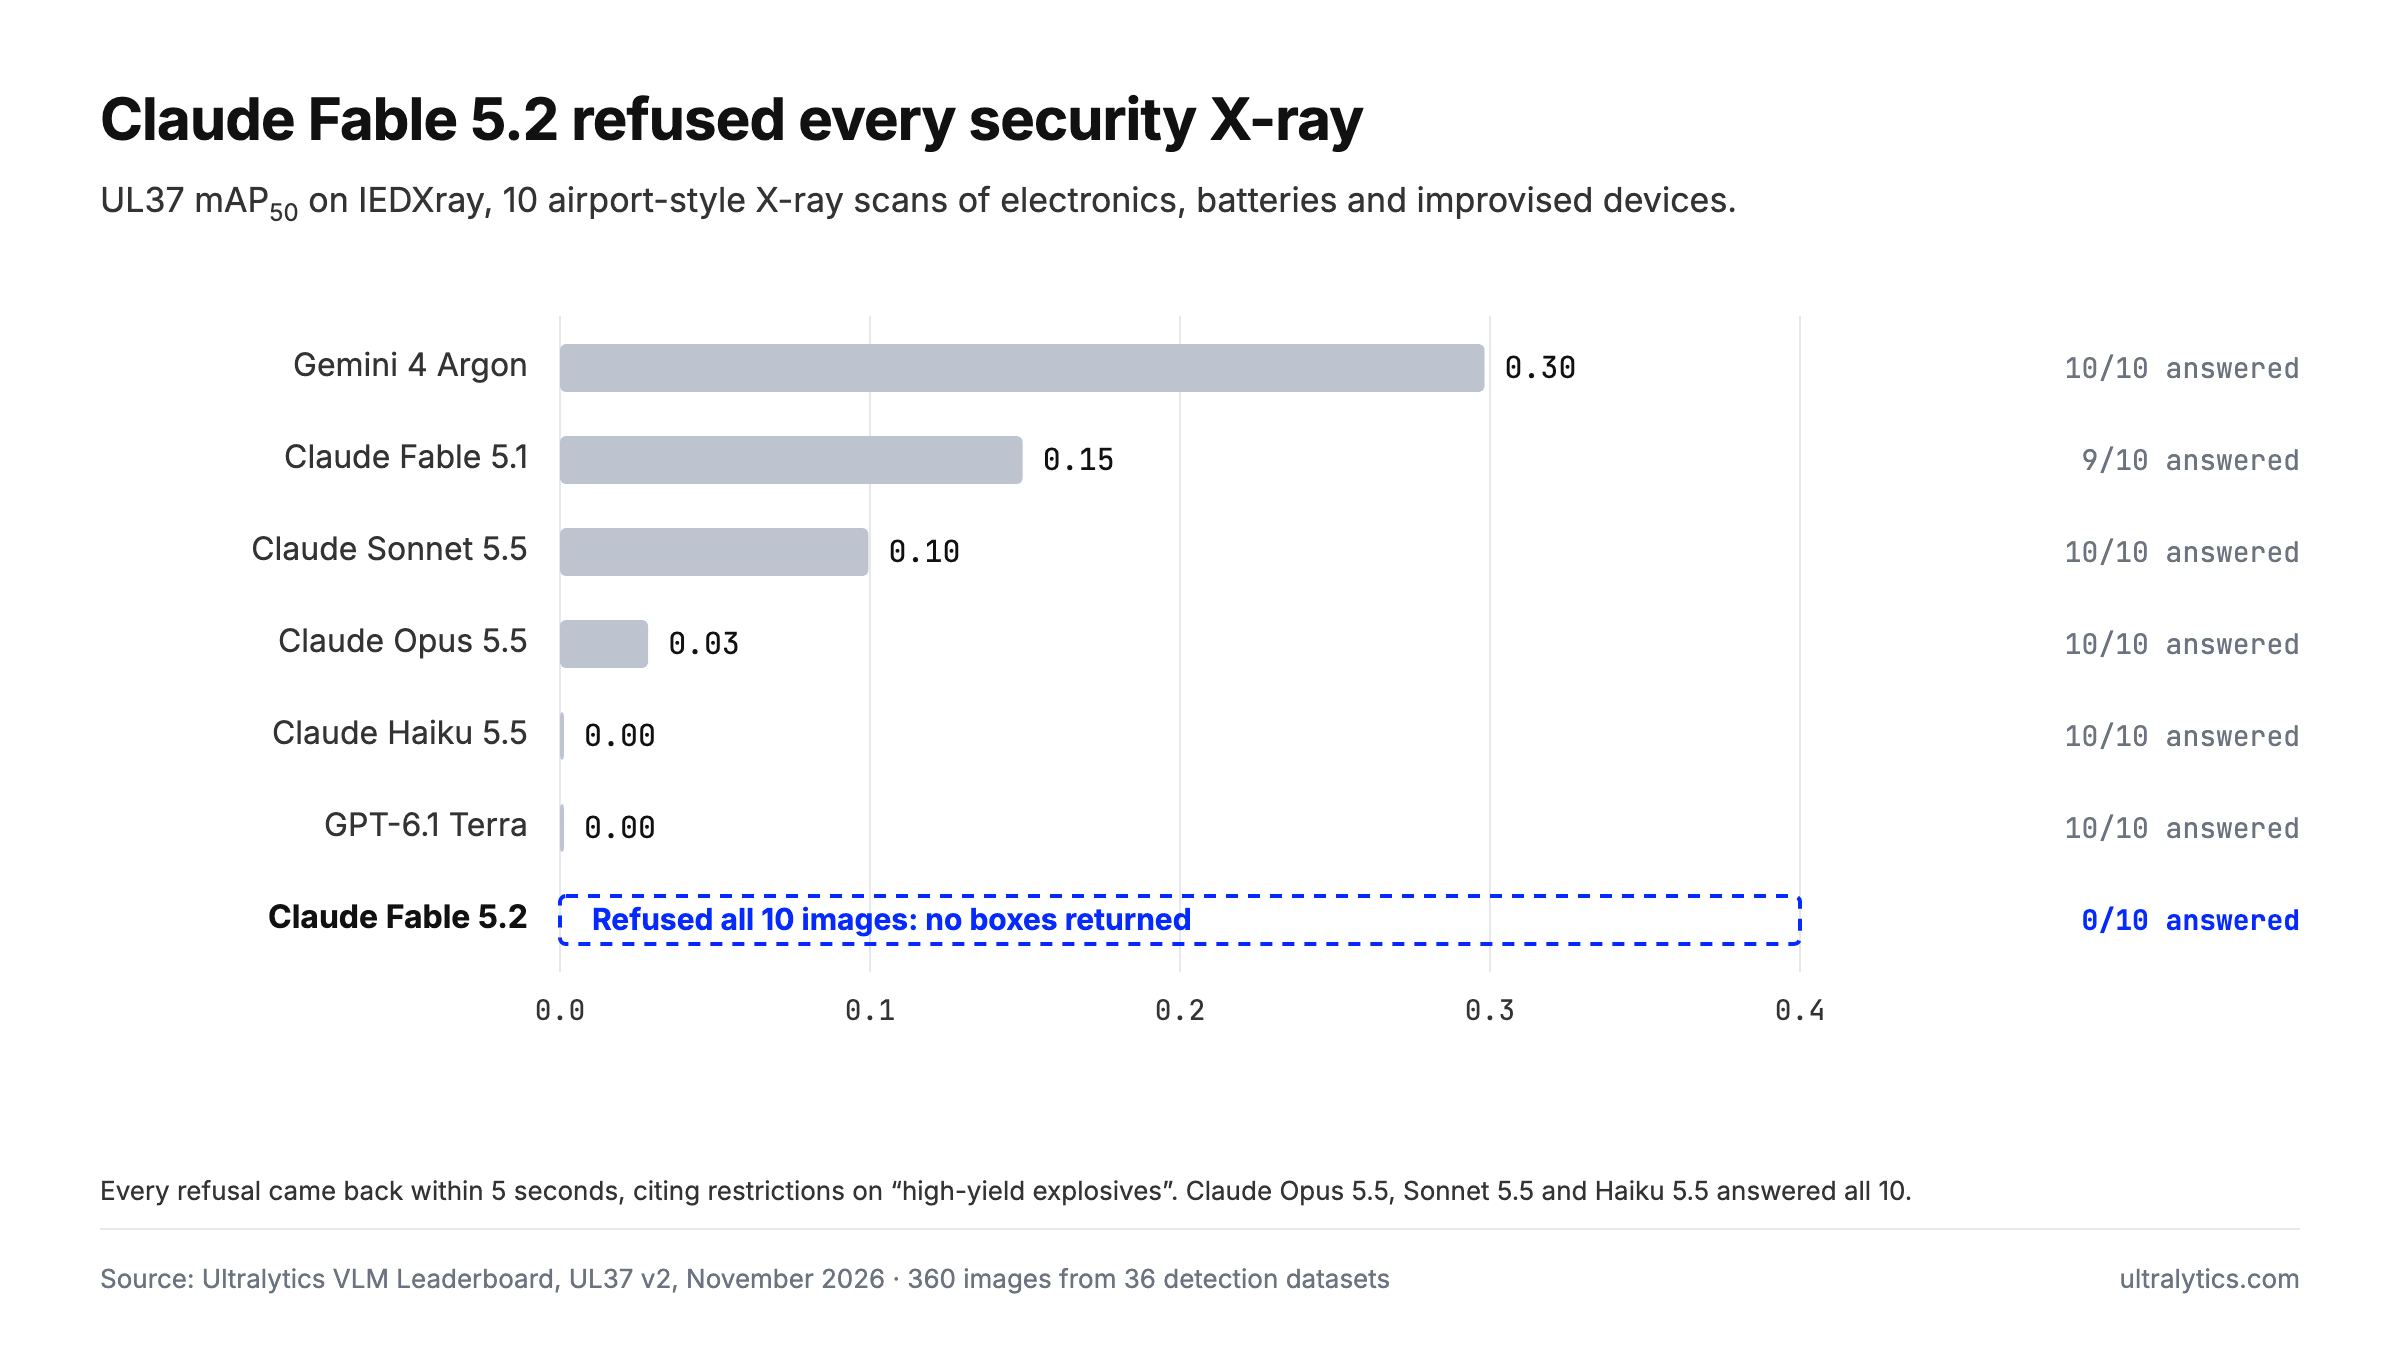
mAP50 sur IEDXray pour la gamme d’Anthropic et les deux meilleurs modèles du classement, UL37 v2, effort de raisonnement par défaut. Fable 5.2 n’a répondu à aucun des 10 scans.
Les modèles chinois font généralement la une pour ce qu’ils refusent de dire. Ici, la situation s’est inversée : un laboratoire américain de premier plan a censuré les résultats, tandis que tous les modèles chinois que nous avons testés ont répondu sans hésiter. Qwen d’Alibaba, Kimi de Moonshot, DeepSeek, GLM de Zhipu, MiMo de Xiaomi, MiniMax et HY4 de Tencent n’ont refusé aucun des dix scans, et les modèles Qwen à poids ouverts que nous hébergeons ont répondu à chacun d’eux. Le modèle phare d’Anthropic, à 8 $ par million de jetons d’entrée, a refusé de regarder.
Les radiographies de sécurité sont difficiles pour tous les modèles. La plupart obtiennent moins de 0.15 sur IEDXray, alors les boîtes de n’importe quel modèle ne constituent qu’une première ébauche. Mais une ébauche peut être corrigée dans l’éditeur d’annotations. Un refus t’oblige à dessiner chaque boîte à la main. Les poids ouverts garantissent aussi que le modèle validé aujourd’hui se comportera de la même façon demain, puisqu’aucune politique de fournisseur ne s’interpose entre toi et ses résultats. Une fois les données annotées, entraîner ton propre détecteur Ultralytics YOLO26 te donne également le contrôle total du modèle déployé.
En dehors des radiographies de sécurité, Claude Fable 5.2 est le deuxième meilleur outil d’annotation que nous ayons testé#
Chaque image d’UL37 passe par le même pipeline de production que celui utilisé par les utilisateurs de Platform, avec les propres noms de classes du jeu de données, puis SAM 3.1 affine chaque boîte. La méthodologie est publique. Voici le bilan de Fable 5.2 :
- mAP50 : 0.544, n° 2 sur 44
- mAP50-95 : 0.347, n° 1 sur 44, juste devant les 0.345 de GPT-6.1 Terra
- Précision et rappel : 0.602 et 0.620
- Coût fournisseur : 37,55 $ pour 1 000 images
- Temps médian par image : 4,6 s
- Requêtes échouées : 11 sur 360 : les 10 refus et une requête qui a dépassé la limite de 115 secondes de Platform
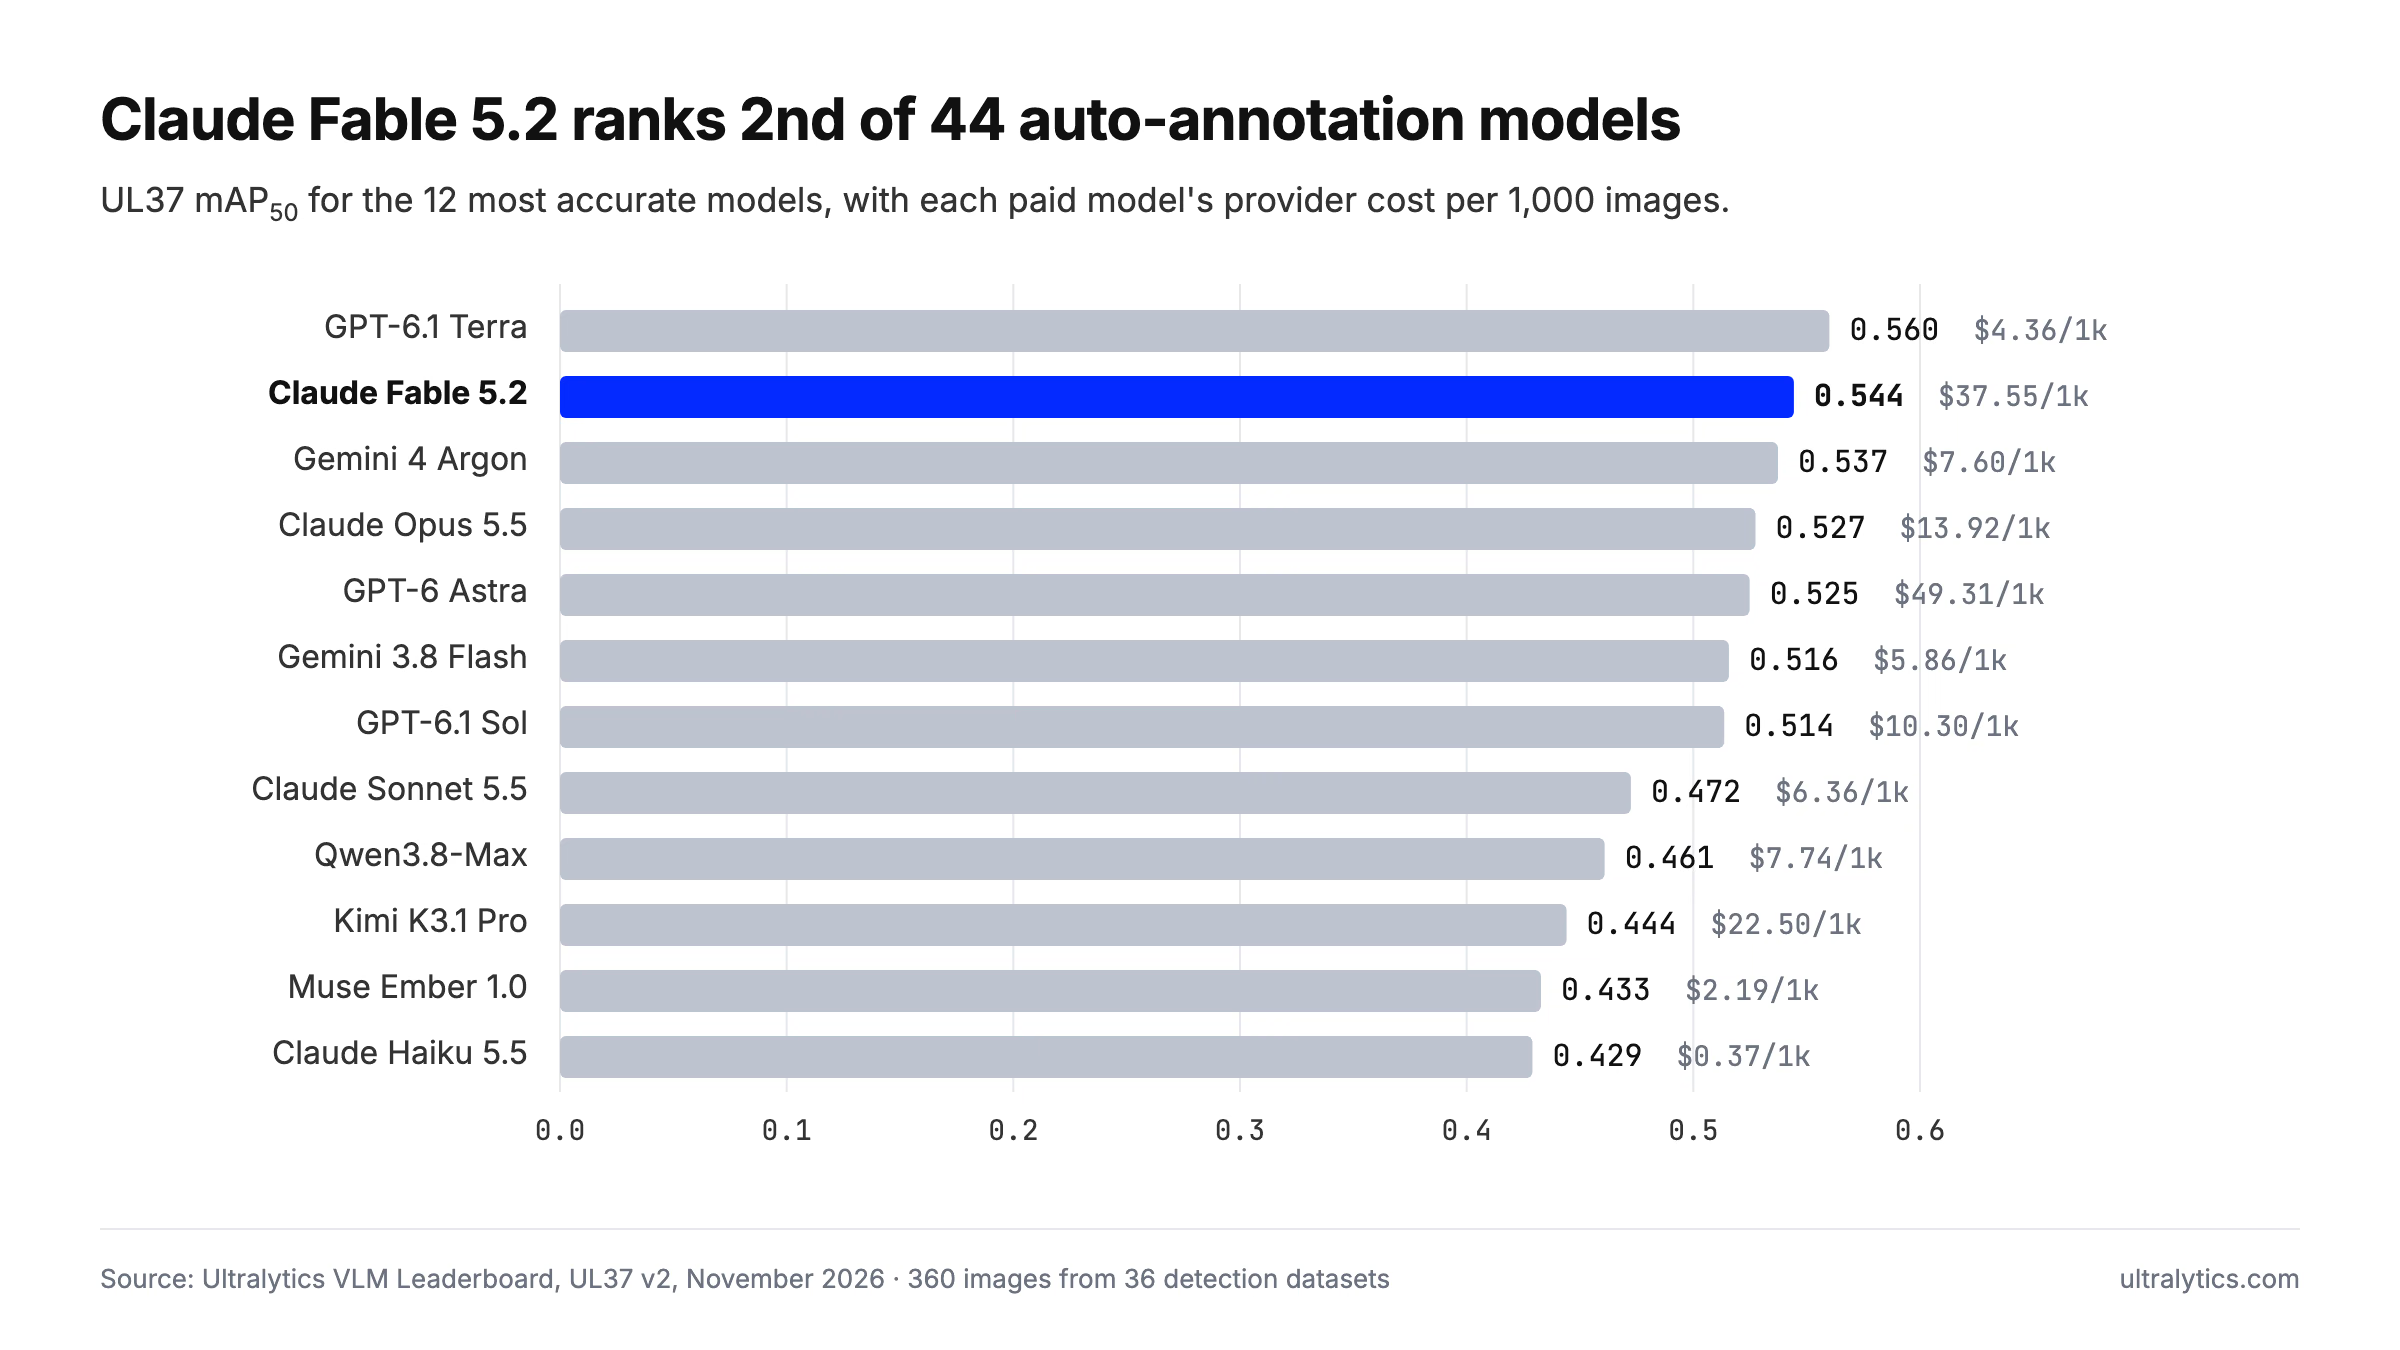
mAP50 sur UL37 pour les 12 modèles les plus précis sur 44, avec le coût fournisseur par tranche de 1 000 images, 10 novembre 2026.
La première place en mAP50-95 est importante. Ce score plus strict calcule la moyenne des seuils de chevauchement des boîtes de 50 % à 95 % ; il récompense donc les boîtes qui épousent chaque objet plutôt que de le couvrir approximativement. Les boîtes brutes de Fable 5.2 obtiennent déjà 0.538 mAP50 avant le raffinement par SAM 3.1, qui porte le score à 0.544.
Il figure parmi les cinq premiers sur 22 des 36 jeux de données et arrive nettement en tête sur trois : les plateaux-repas scolaires UEC (0.96), la détection de paniers et de ballons de basket (0.85) et les maladies foliaires de PlantDoc (0.52). Par domaine, il se classe premier dans le commerce de détail et, de justesse devant Claude Opus 5.5, dans les domaines de la nature et de l’agriculture. Sur les 10 images de référence COCO 2017, évaluées séparément, il atteint 0.686, le meilleur score de tous les modèles de langage, derrière seulement les modèles de segmentation SAM 3 et SAM 3.1 Text.
Les refus ont valu à Fable 5.2 un zéro complet sur un jeu de données, mais pas la première place. En excluant IEDXray, Fable 5.2 obtient une moyenne de 0.560, tandis que Terra, qui a également obtenu zéro sur ce jeu sans pour autant refuser, atteint 0.576.
Un bond considérable par rapport à Claude Fable 5.1#
Fable 5.2 surpasse Claude Fable 5.1 sur 31 des 36 jeux de données et coûte moins cher par image.
| Résultat UL37 | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| mAP50 | 0.544 | 0.427 |
| mAP50-95 | 0.347 | 0.262 |
| Précision / rappel | 0.602 / 0.620 | 0.506 / 0.485 |
| Classement | 2e sur 44 | 13e sur 44 |
| Coût fournisseur pour 1 000 images | $37.55 | $43.75 |
| Temps médian par image | 4.6 s | 2,6 s |
| Images IEDXray refusées | 10 | 1 |
La précision et le rappel ont augmenté ensemble, ce qui signifie qu’il y a à la fois moins de fausses boîtes à supprimer et moins d’objets manqués à dessiner. Les gains les plus importants sont spectaculaires. Pour les têtes de blé de GWHD, Fable 5.1 a obtenu 0.24, contre 0.77 pour Fable 5.2. Les produits de caisse de supermarché RPC sont passés de 0.57 à 0.90, l’imagerie thermique de drones HIT-UAV de 0.17 à 0.48, et les échographies thyroïdiennes TN5000 de 0.03 à 0.44.
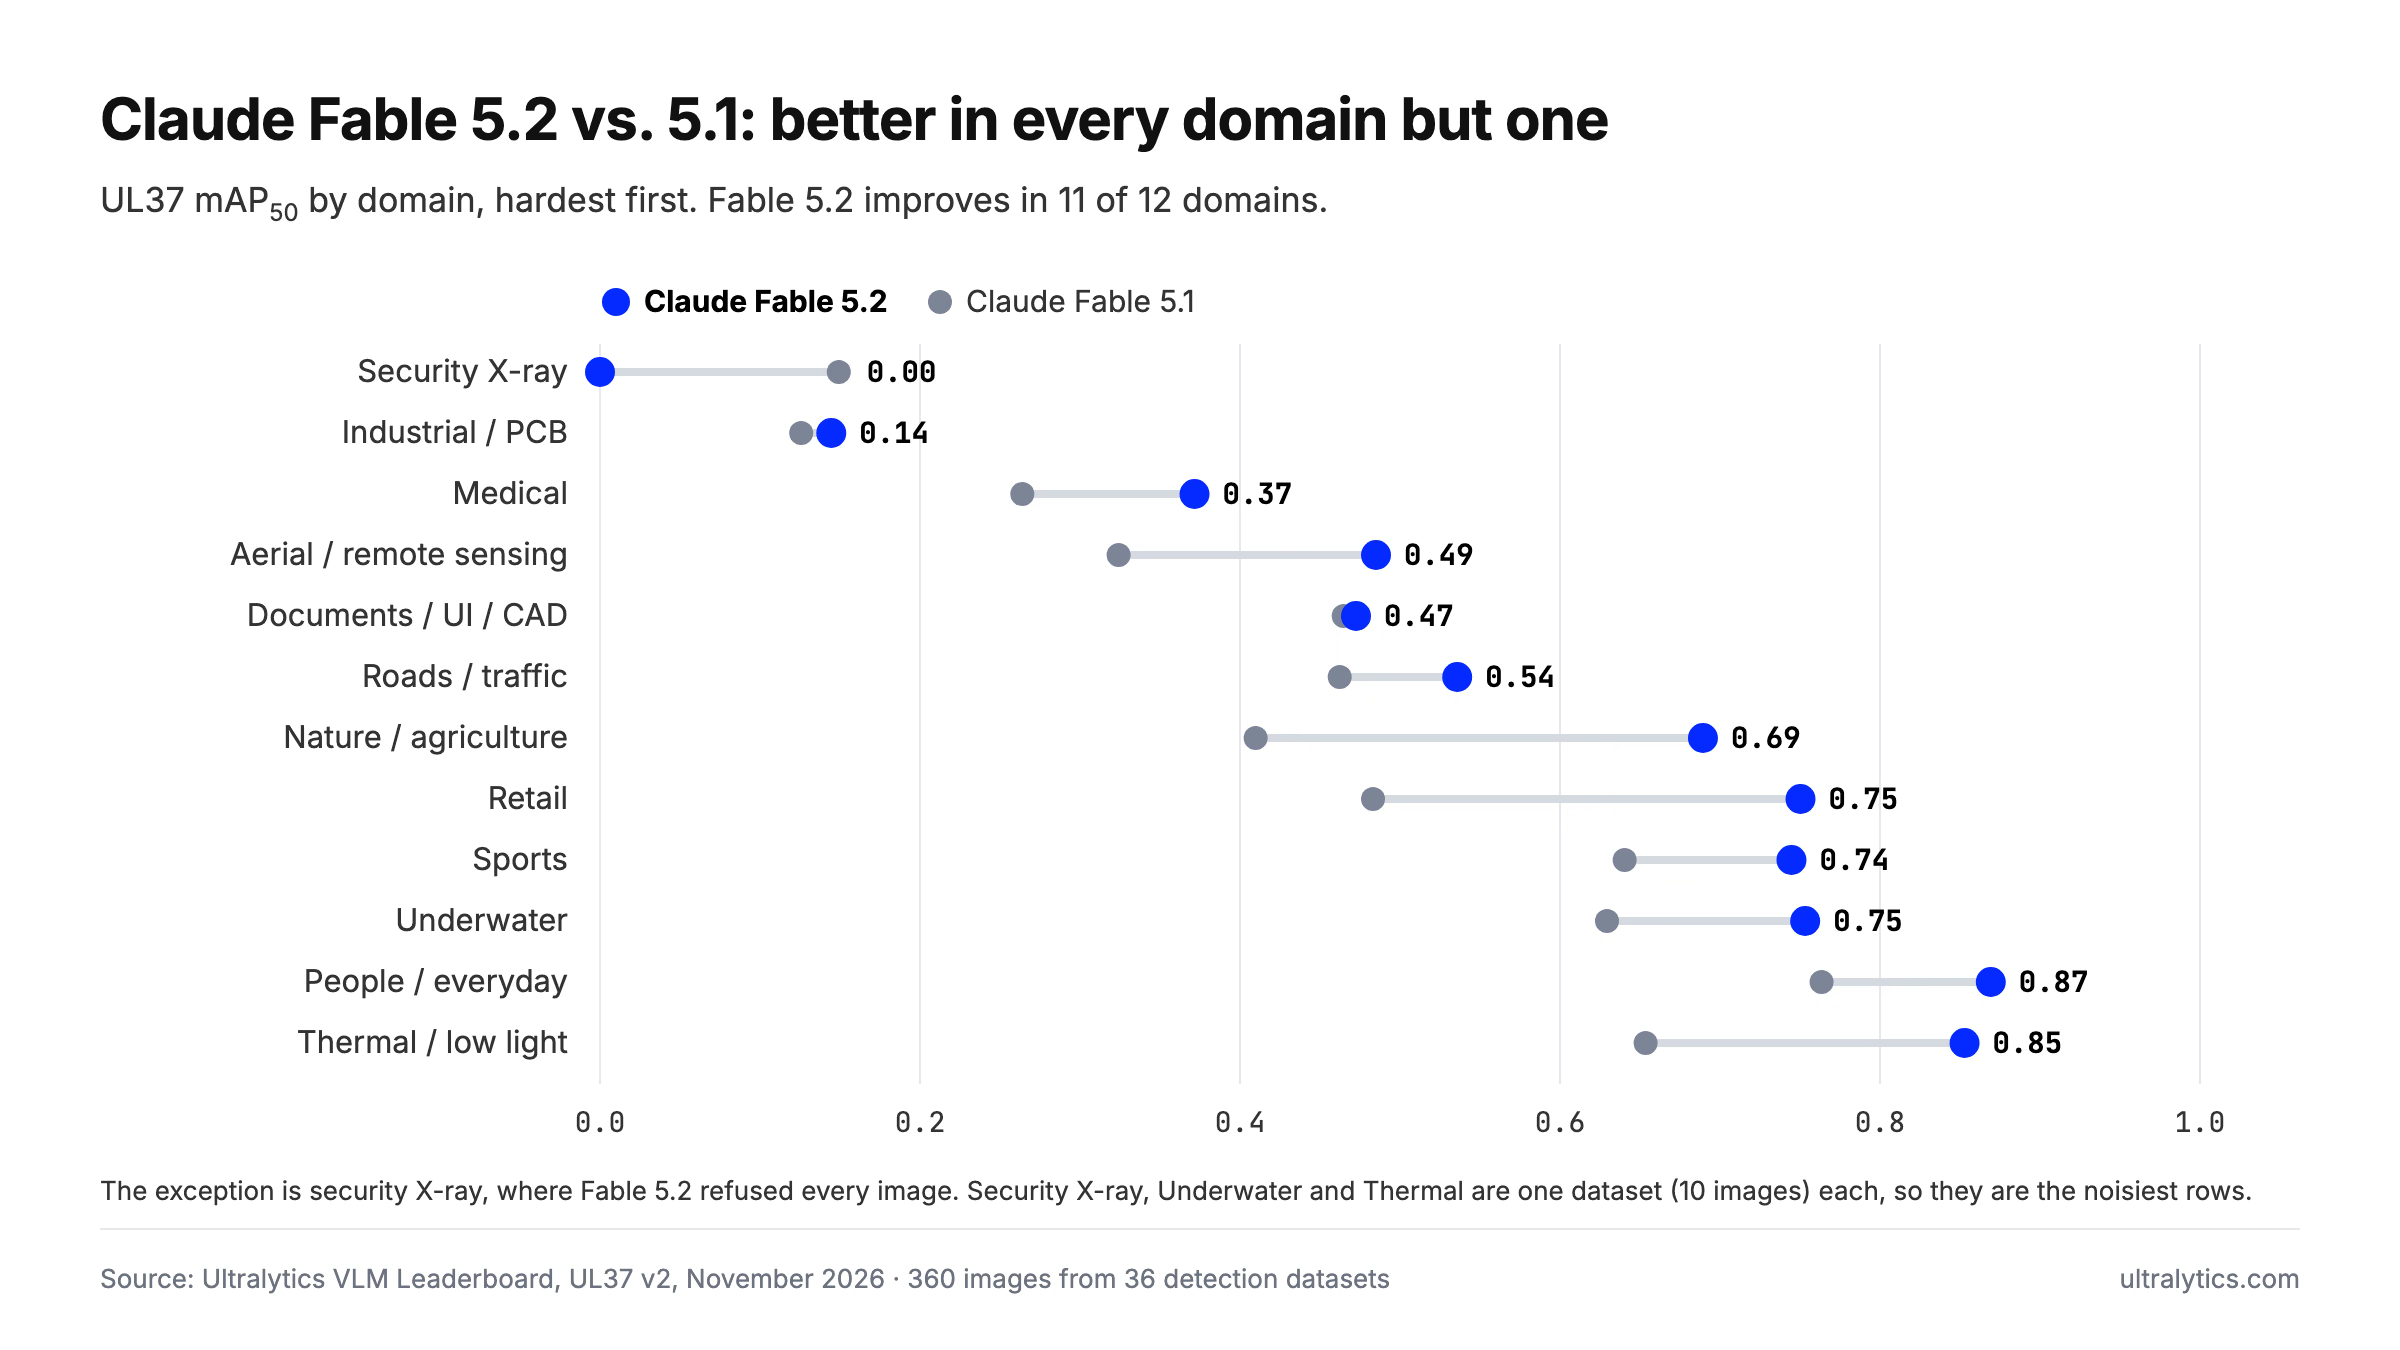
mAP50 sur UL37 par domaine, du plus difficile au plus facile, Claude Fable 5.2 contre Claude Fable 5.1 avec le niveau d’effort par défaut d’Anthropic.
Onze domaines sur douze se sont améliorés. Le seul en recul est celui des radiographies de sécurité, où le score est passé de 0.15 à zéro ; c’est dû au refus, et non à la capacité de vision du modèle. Les marquages routiers CeyMo ont également reculé, de 0.85 à 0.74.
Claude Fable 5.2 face à GPT-6.1 Terra, Gemini 4 Argon et Claude Opus 5.5#
| Modèle | mAP50 sur UL37 | mAP50-95 | Précision | Rappel | Coût pour 1 000 images | Temps médian par image |
|---|---|---|---|---|---|---|
| GPT-6.1 Terra | 0.560 | 0.345 | 0.646 | 0.613 | $4.36 | 5.1 s |
| Claude Fable 5.2 | 0.544 | 0.347 | 0.602 | 0.620 | $37.55 | 4.6 s |
| Gemini 4 Argon | 0.537 | 0.343 | 0.667 | 0.585 | $7.60 | 4.6 s |
| Claude Opus 5.5 | 0.527 | 0.333 | 0.656 | 0.595 | $13.92 | 2,7 s |
En comparaison directe, Fable 5.2 bat Terra sur 18 jeux de données et perd sur 16, avec deux égalités. Il bat Argon 21 à 15 et Opus 5.5 22 à 14. C’est celui des quatre qui a le rappel le plus élevé : il manque donc le moins d’objets, mais sa précision est la plus faible, alors attends-toi à devoir supprimer quelques boîtes supplémentaires. Notre guide pour choisir un VLM selon la précision et le rappel explique comment évaluer ce compromis pour tes données.
En dehors des radiographies, Fable 5.2 est moins performant en imagerie médicale, avec une moyenne de 0.372 sur huit jeux de données contre 0.505 pour Terra, ainsi que sur les cartes électroniques, où son score est de 0.00 sur DeepPCB. Chaque jeu de données ne comprenant que 10 images, considère les scores individuels comme des indications, et non comme des verdicts.
Anthropic recommande lui-même de commencer la plupart des tâches avec Claude Opus 5.5, son « meilleur modèle polyvalent au quotidien », et de passer à Fable uniquement lorsqu’une tâche l’exige. Ce conseil vaut pour l’annotation. Opus 5.5 atteint 97 % du mAP50 de Fable 5.2 pour 37 % du coût, répond en 2,7 s et n’a refusé aucune radiographie.
Combien coûte un lot traité par Claude Fable 5.2#
Les 37,55 $ par tranche de 1 000 images correspondent à la facture du fournisseur, calculée d’après l’utilisation de jetons déclarée par Anthropic et ses tarifs affichés de 8 $ par million de jetons d’entrée et de 40 $ par million de jetons de sortie, selon la page des tarifs d’Anthropic. Fable 5.2 fonctionne avec le niveau élevé d’effort de raisonnement par défaut d’Anthropic. L’annotation par lot ajoute des frais de traitement de Platform de 1,00 $ par tranche de 1 000 images ; un lot de 1 000 images revient donc à environ 38,55 $.
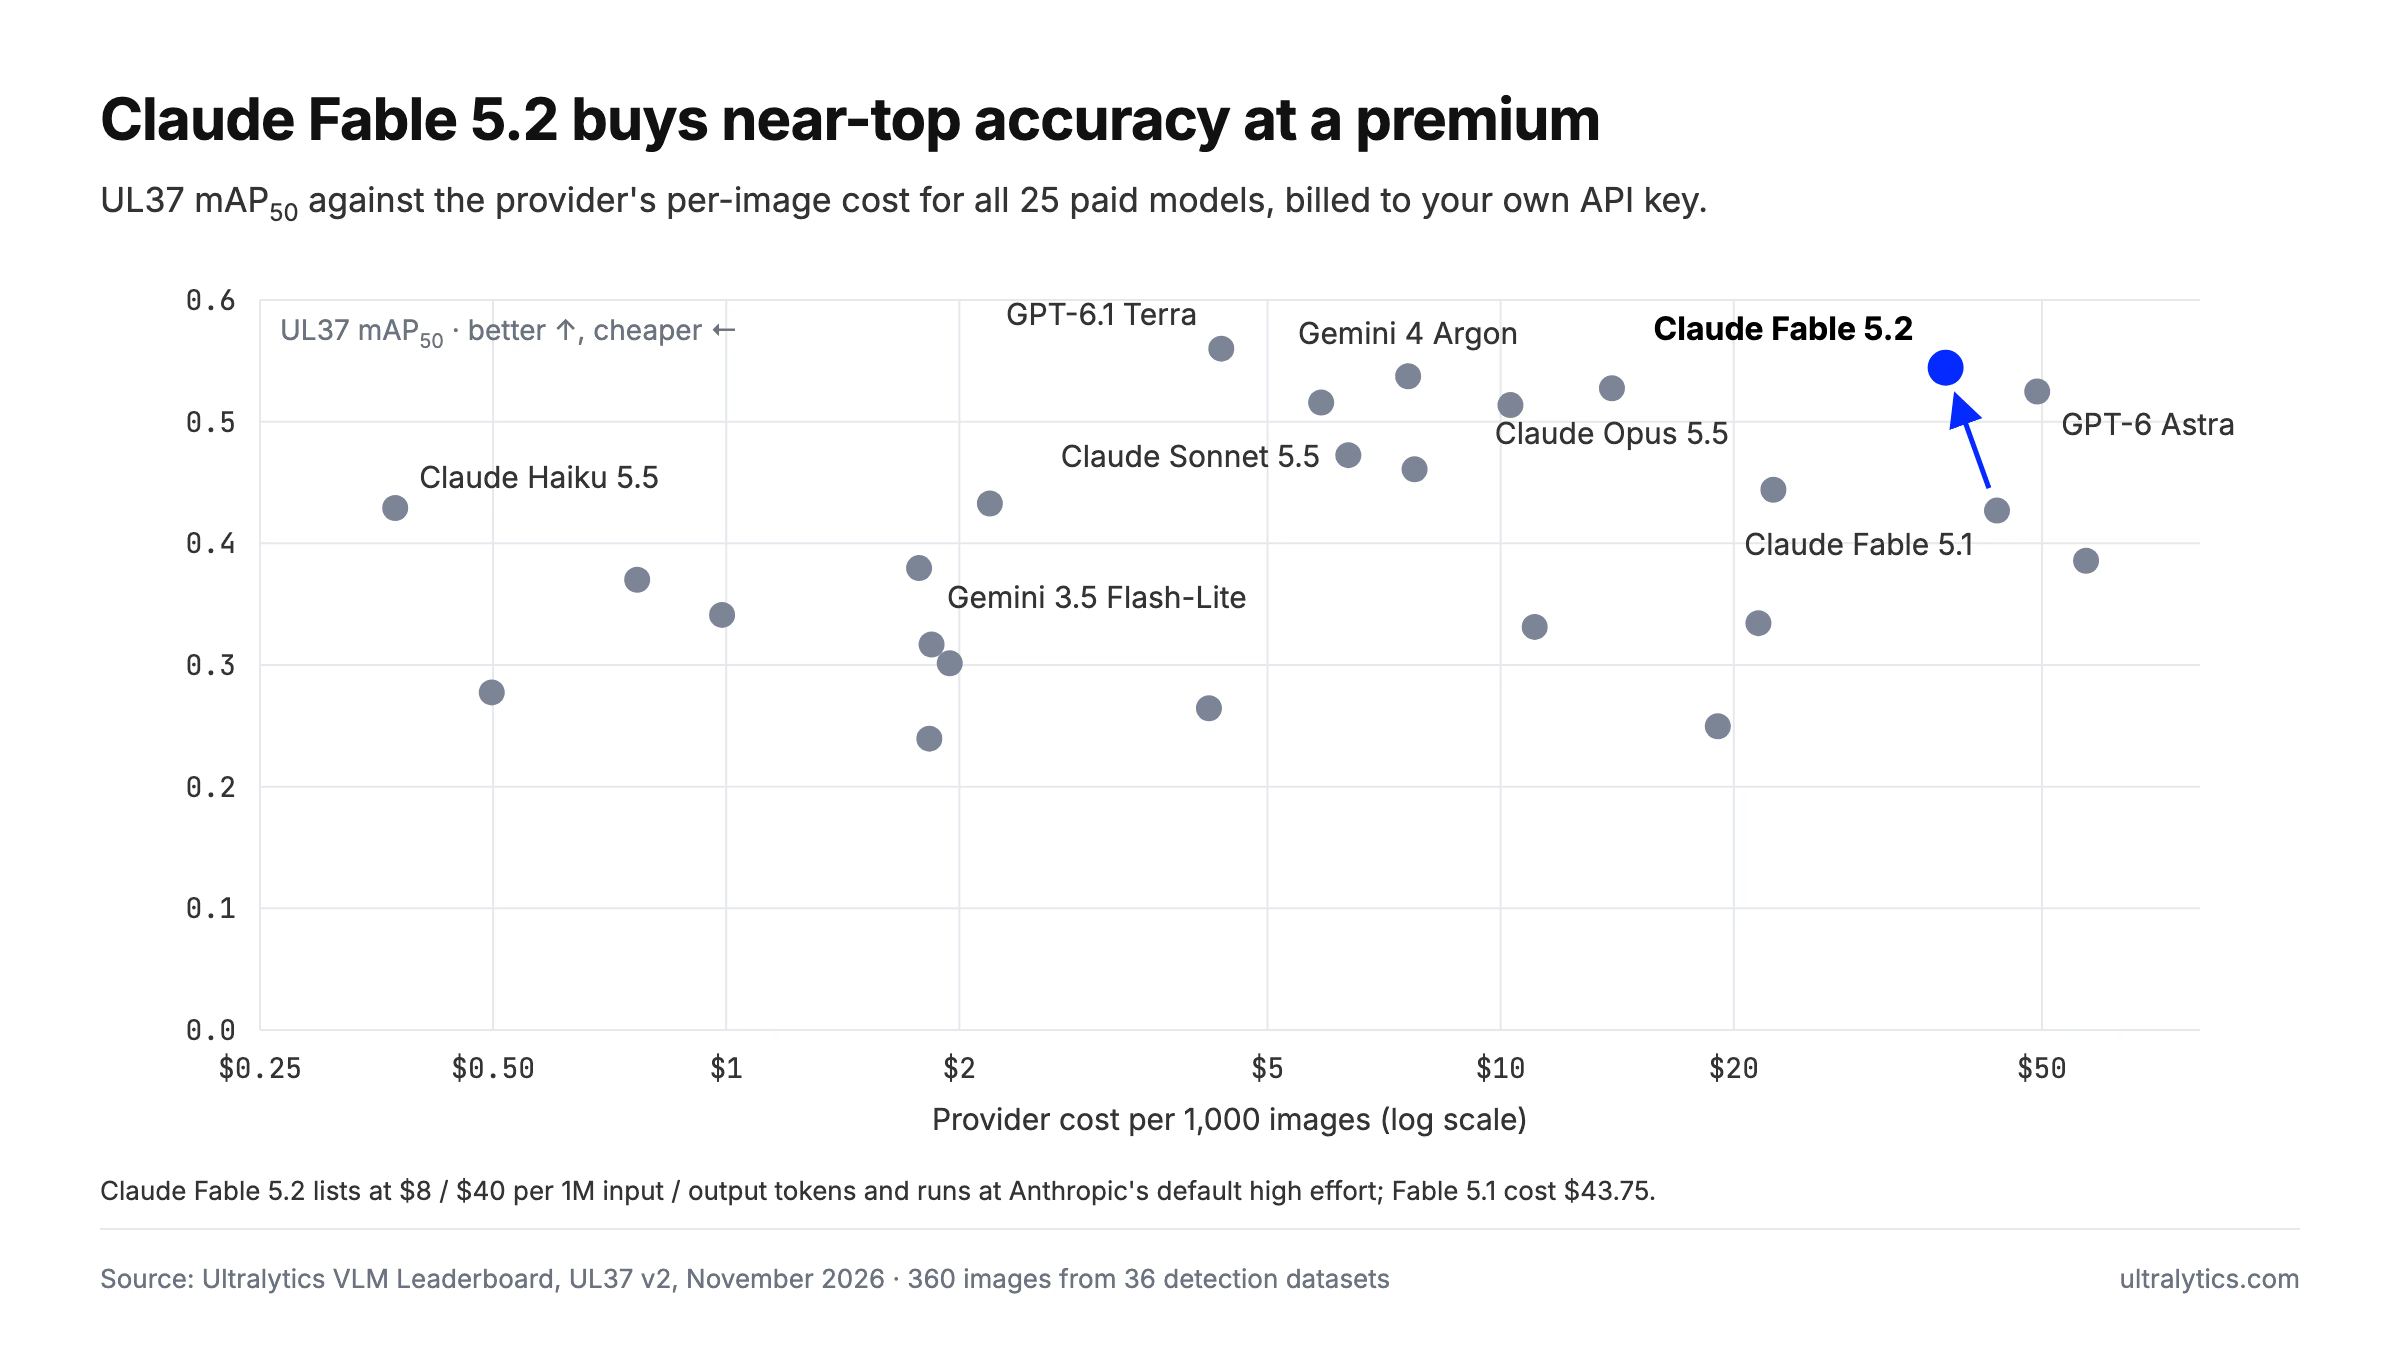
mAP50 sur UL37 en fonction du coût fournisseur par tranche de 1 000 images pour les 25 modèles payants, tarifs affichés, 10 novembre 2026.
Cela représente plus de huit fois les 4,36 $ de Terra pour un écart de seulement 0.016 en mAP50. Fable 5.2 ne justifie son prix que lorsque la précision de ses boîtes compte davantage que le budget. Si le coût est important, Claude Haiku 5.5 obtient 0.429 pour 0,37 $, et les modèles à poids ouverts hébergés ne nécessitent aucune clé API.
Comment exécuter l’annotation automatique avec Claude Fable 5.2 sur ton jeu de données#
Fable 5.2 est un modèle guidé par les classes pour les jeux de données de détection comprenant de 1 à 200 classes. Il renvoie des boîtes pour les noms de classes propres à ton jeu de données, que tu vérifies avant de les enregistrer.
- Crée une clé sur la page des clés API de Claude.
- Ajoute-la dans Paramètres > Clés API de l’espace de travail Platform qui possède ton jeu de données. Anthropic te facture directement et Ultralytics n’applique aucune majoration sur les jetons. La documentation sur les clés fournisseur explique les détails.
- Dans l’éditeur d’annotations, passe en mode Smart et choisis Claude Fable 5.2 sous Anthropic. Appuie sur Prédire, ou sur
P, pour annoter l’image en cours. - Pour annoter toutes les images non annotées, sélectionne Autres actions > Annotation par lot sur la page du jeu de données. Platform enregistre d’abord une version du jeu de données pour que tu puisses revenir en arrière.
- Si certaines images sont refusées, relance l’annotation par lot avec un autre modèle, par exemple Gemini 4 Argon ou un modèle à poids ouverts hébergé. Seules les images encore non annotées seront traitées.
- Vérifie les boîtes, enregistre-les et entraîne un modèle YOLO26 sur le résultat dans le même espace de travail.
Avant de valider un grand jeu de données, ouvre la page du modèle. Elle affiche les boîtes enregistrées de Fable 5.2 pour chaque jeu de données de référence, à côté des boîtes attendues, et indique le score obtenu sur chacun.
Page du modèle Claude Fable 5.2
Pour en savoir plus sur la façon dont ces modèles s’intègrent à l’éditeur, consulte l’utilisation de l’IA par Ultralytics Platform pour automatiser l’annotation et découvre pourquoi la vérification par un humain dans la boucle reste essentielle.
Qui devrait utiliser Claude Fable 5.2#
Choisis Claude Fable 5.2 lorsque la précision des boîtes compte le plus et que le budget importe peu : sports, commerce de détail, agriculture et scènes du quotidien, domaines où il se classe parmi les meilleurs, voire en tête, de tous les modèles que nous avons testés. Son avance en mAP50-95 en fait un excellent point de départ pour les jeux de données que tu prévois d’entraîner avec des seuils IoU stricts.
Évite-le pour les données de sécurité, de défense et de contrôle. Le filtre d’Anthropic a refusé tous les scans de notre jeu de données de radiographies de sécurité, même ceux ne contenant qu’un téléphone, et rien dans Platform ne permet de contourner ce blocage. Pour ces projets, utilise Gemini 4 Argon ou un modèle à poids ouverts que tu contrôles. Pour la plupart des autres tâches d’annotation, GPT-6.1 Terra ou Claude Opus 5.5 fournit des boîtes presque aussi bonnes pour une fraction du prix.
Foire aux questions
L’API d’Anthropic bloque les requêtes d’annotation de radiographies de sécurité qui impliquent des classes d’explosifs. Pour les 10 scans IEDXray de notre benchmark, elle a renvoyé le motif d’arrêt
refusalavec la catégoriegeneral_harms, en invoquant des « restrictions sur les contenus liés au développement d’explosifs à haut rendement », même pour les scans ne contenant qu’un téléphone ou un ordinateur portable ordinaire. Appuyer de nouveau sur Prédire ne changera rien ; utilise un autre modèle pour ces images.Aucun autre modèle de notre classement n’a refusé de scan IEDXray, y compris les 19 modèles que nous hébergeons, tous les modèles issus de laboratoires chinois et les modèles Claude Opus 5.5, Sonnet 5.5 et Haiku 5.5 d’Anthropic. Gemini 4 Argon a obtenu le meilleur score, avec 0.30 mAP50, suivi du modèle à poids ouverts Moondream 3.1 avec 0.27. La précision est faible pour tous les modèles sur les radiographies de sécurité ; vérifie donc chaque boîte.
Oui. Il obtient 0.544 mAP50 sur 36 jeux de données réels de détection, se classe deuxième sur 44 modèles et arrive en tête pour le score plus strict mAP50-95, avec 0.347. Il est particulièrement performant dans le commerce de détail, les sports, l’agriculture et les scènes du quotidien, et moins performant sur les radiographies de sécurité, l’imagerie médicale et les défauts de cartes électroniques.
Il obtient 0.544 mAP50, contre 0.427 pour Fable 5.1, et remporte 31 des 36 jeux de données, tout en coûtant 37,55 $ au lieu de 43,75 $ par tranche de 1 000 images. Il est plus lent, avec 4,6 s par image contre 2,6 s, et a refusé les 10 radiographies de sécurité, tandis que Fable 5.1 n’en a refusé qu’une.
Environ 37,55 $ de frais Anthropic, selon l’utilisation des jetons déclarée par le fournisseur, au tarif de 8 $ par million de jetons d’entrée et de 40 $ par million de jetons de sortie. L’annotation par lot sur Ultralytics Platform ajoute des frais de traitement de 1,00 $ par tranche de 1 000 images. Tu paies directement Anthropic avec ta propre clé API.
Terra obtient un meilleur mAP50, 0.560 contre 0.544, et coûte environ huit fois moins cher. Les boîtes de Fable 5.2 sont légèrement plus ajustées, avec 0.347 mAP50-95 contre 0.345 pour Terra, et il remporte 18 jeux de données contre 16 pour Terra. Pour la plupart des équipes, Terra constitue le meilleur choix par défaut ; Fable 5.2 est pertinent lorsque la précision des boîtes l’emporte sur le coût.
Écrit par
Fondateur et PDG · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









