GPT-6.1 Terra arrive en tête pour l’annotation automatique et bat les modèles phares d’OpenAI
GPT-6.1 Terra pour l’annotation automatique devance 39 modèles dans notre classement VLM : 0.560 mAP50 pour 4,36 $ par tranche de 1 000 images, devant GPT-6.1 Sol et Gemini 4 Argon.
Les documents de lancement d’OpenAI indiquent que GPT-6.1 Terra est presque au niveau de ses grands frères en raisonnement visuel. Quand nous lui avons demandé de tracer des boîtes englobantes, « presque » s’est révélé être le mauvais mot.
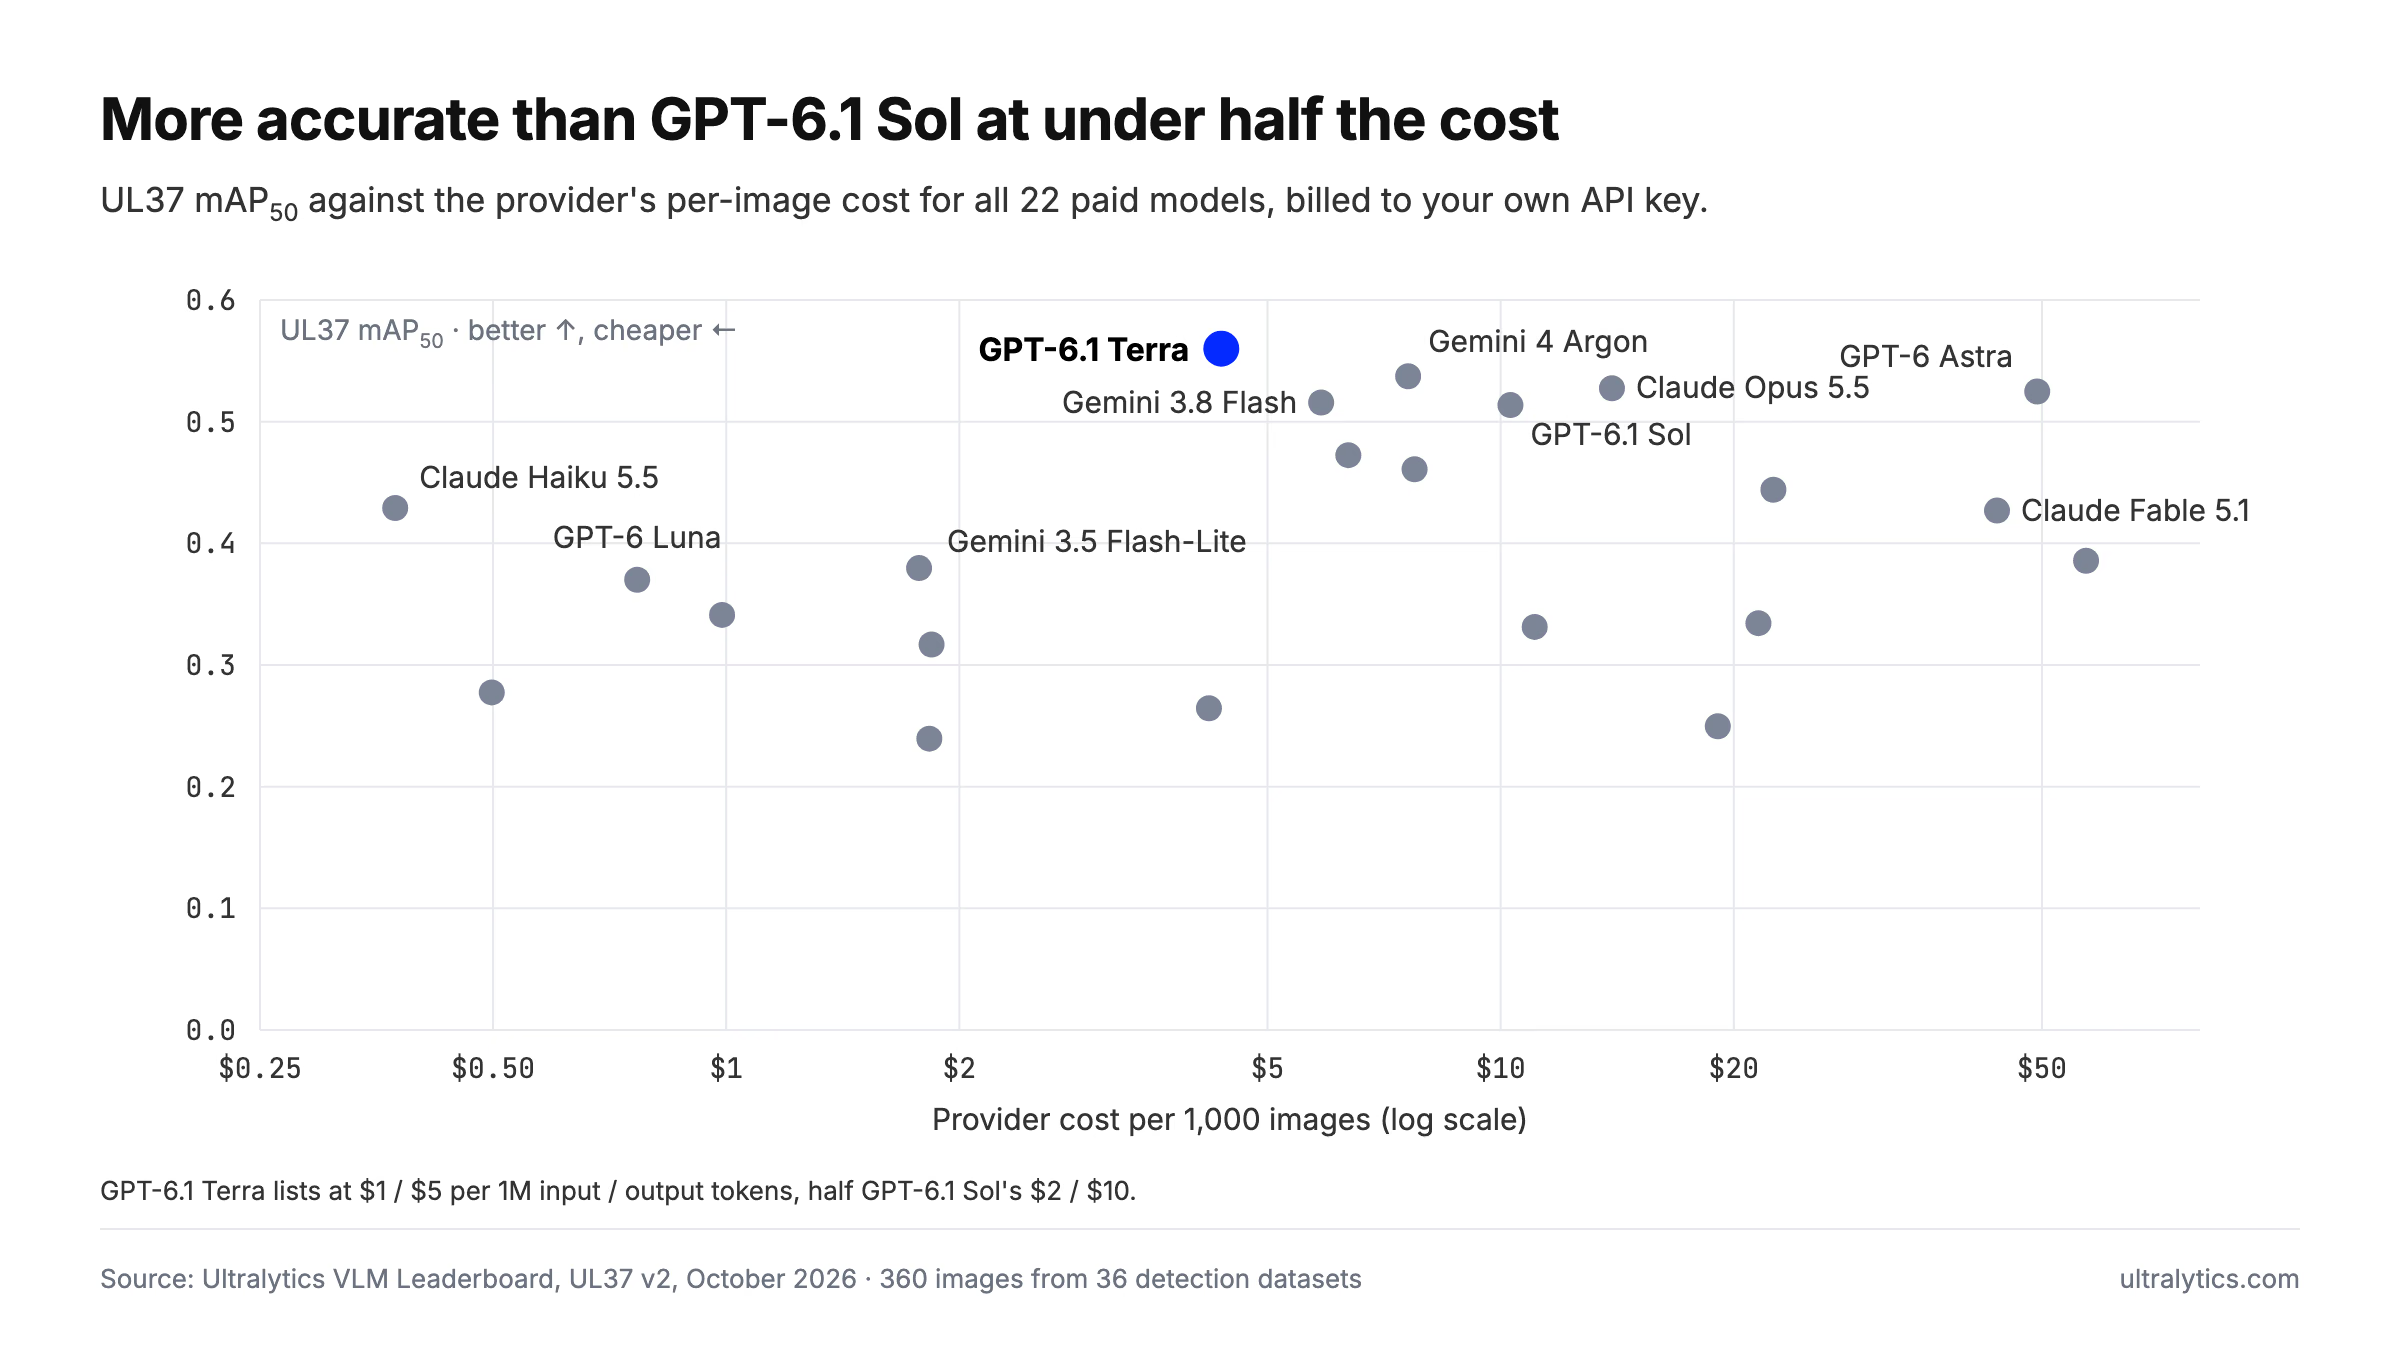
Nous avons évalué l’annotation automatique de GPT-6.1 Terra avec UL37, notre benchmark de détection sur 36 jeux de données, le 26 octobre 2026, jour de sa sortie par OpenAI. Il a obtenu 0.560 mAP50, le meilleur résultat des 39 modèles de notre classement VLM. Le modèle à prix intermédiaire d’OpenAI a devancé GPT-6.1 Sol, le modèle phare GPT-6 Astra et Gemini 4 Argon, qui occupait la première place jusqu’à cette semaine.
Il y est parvenu pour 4,36 $ par tranche de 1 000 images, à raison de 5,1 secondes par image, sans la moindre requête échouée. Tu peux l’utiliser dès aujourd’hui dans Ultralytics Platform. Voici ses points forts, ses difficultés et les critères à prendre en compte pour décider s’il a sa place dans ton flux de travail d’annotation.
GPT-6.1 Terra arrive en première place sur UL37#
UL37 mesure la ressemblance entre les boîtes d’un modèle et les annotations humaines sur 360 images : 10 images de chacun des 36 jeux de données réels de détection d’objets, couvrant l’imagerie médicale, les images aériennes, les rayons des magasins, le sport, les documents, les cartes électroniques et plus encore. Chaque image passe par le même pipeline de production que celui utilisé par les utilisateurs de Platform, avec les noms de classes propres au jeu de données et un ajustement de chaque boîte par SAM 3.1. La méthodologie est publique.
Voici le bilan de Terra :
- mAP50 : 0.560, n° 1 sur 39
- mAP50-95 : 0.345, également n° 1, ce qui signifie que ses boîtes épousent précisément les objets, et pas seulement de façon approximative
- Précision et rappel : 0.646 et 0.613
- Coût du fournisseur : 4,36 $ par tranche de 1 000 images
- Temps médian par image : 5,1 s
- Requêtes échouées : aucune
Six modèles dépassent 0.51 sur UL37, dont Claude Opus 5.5, en troisième place. Terra est le plus précis des six et aussi le moins cher.
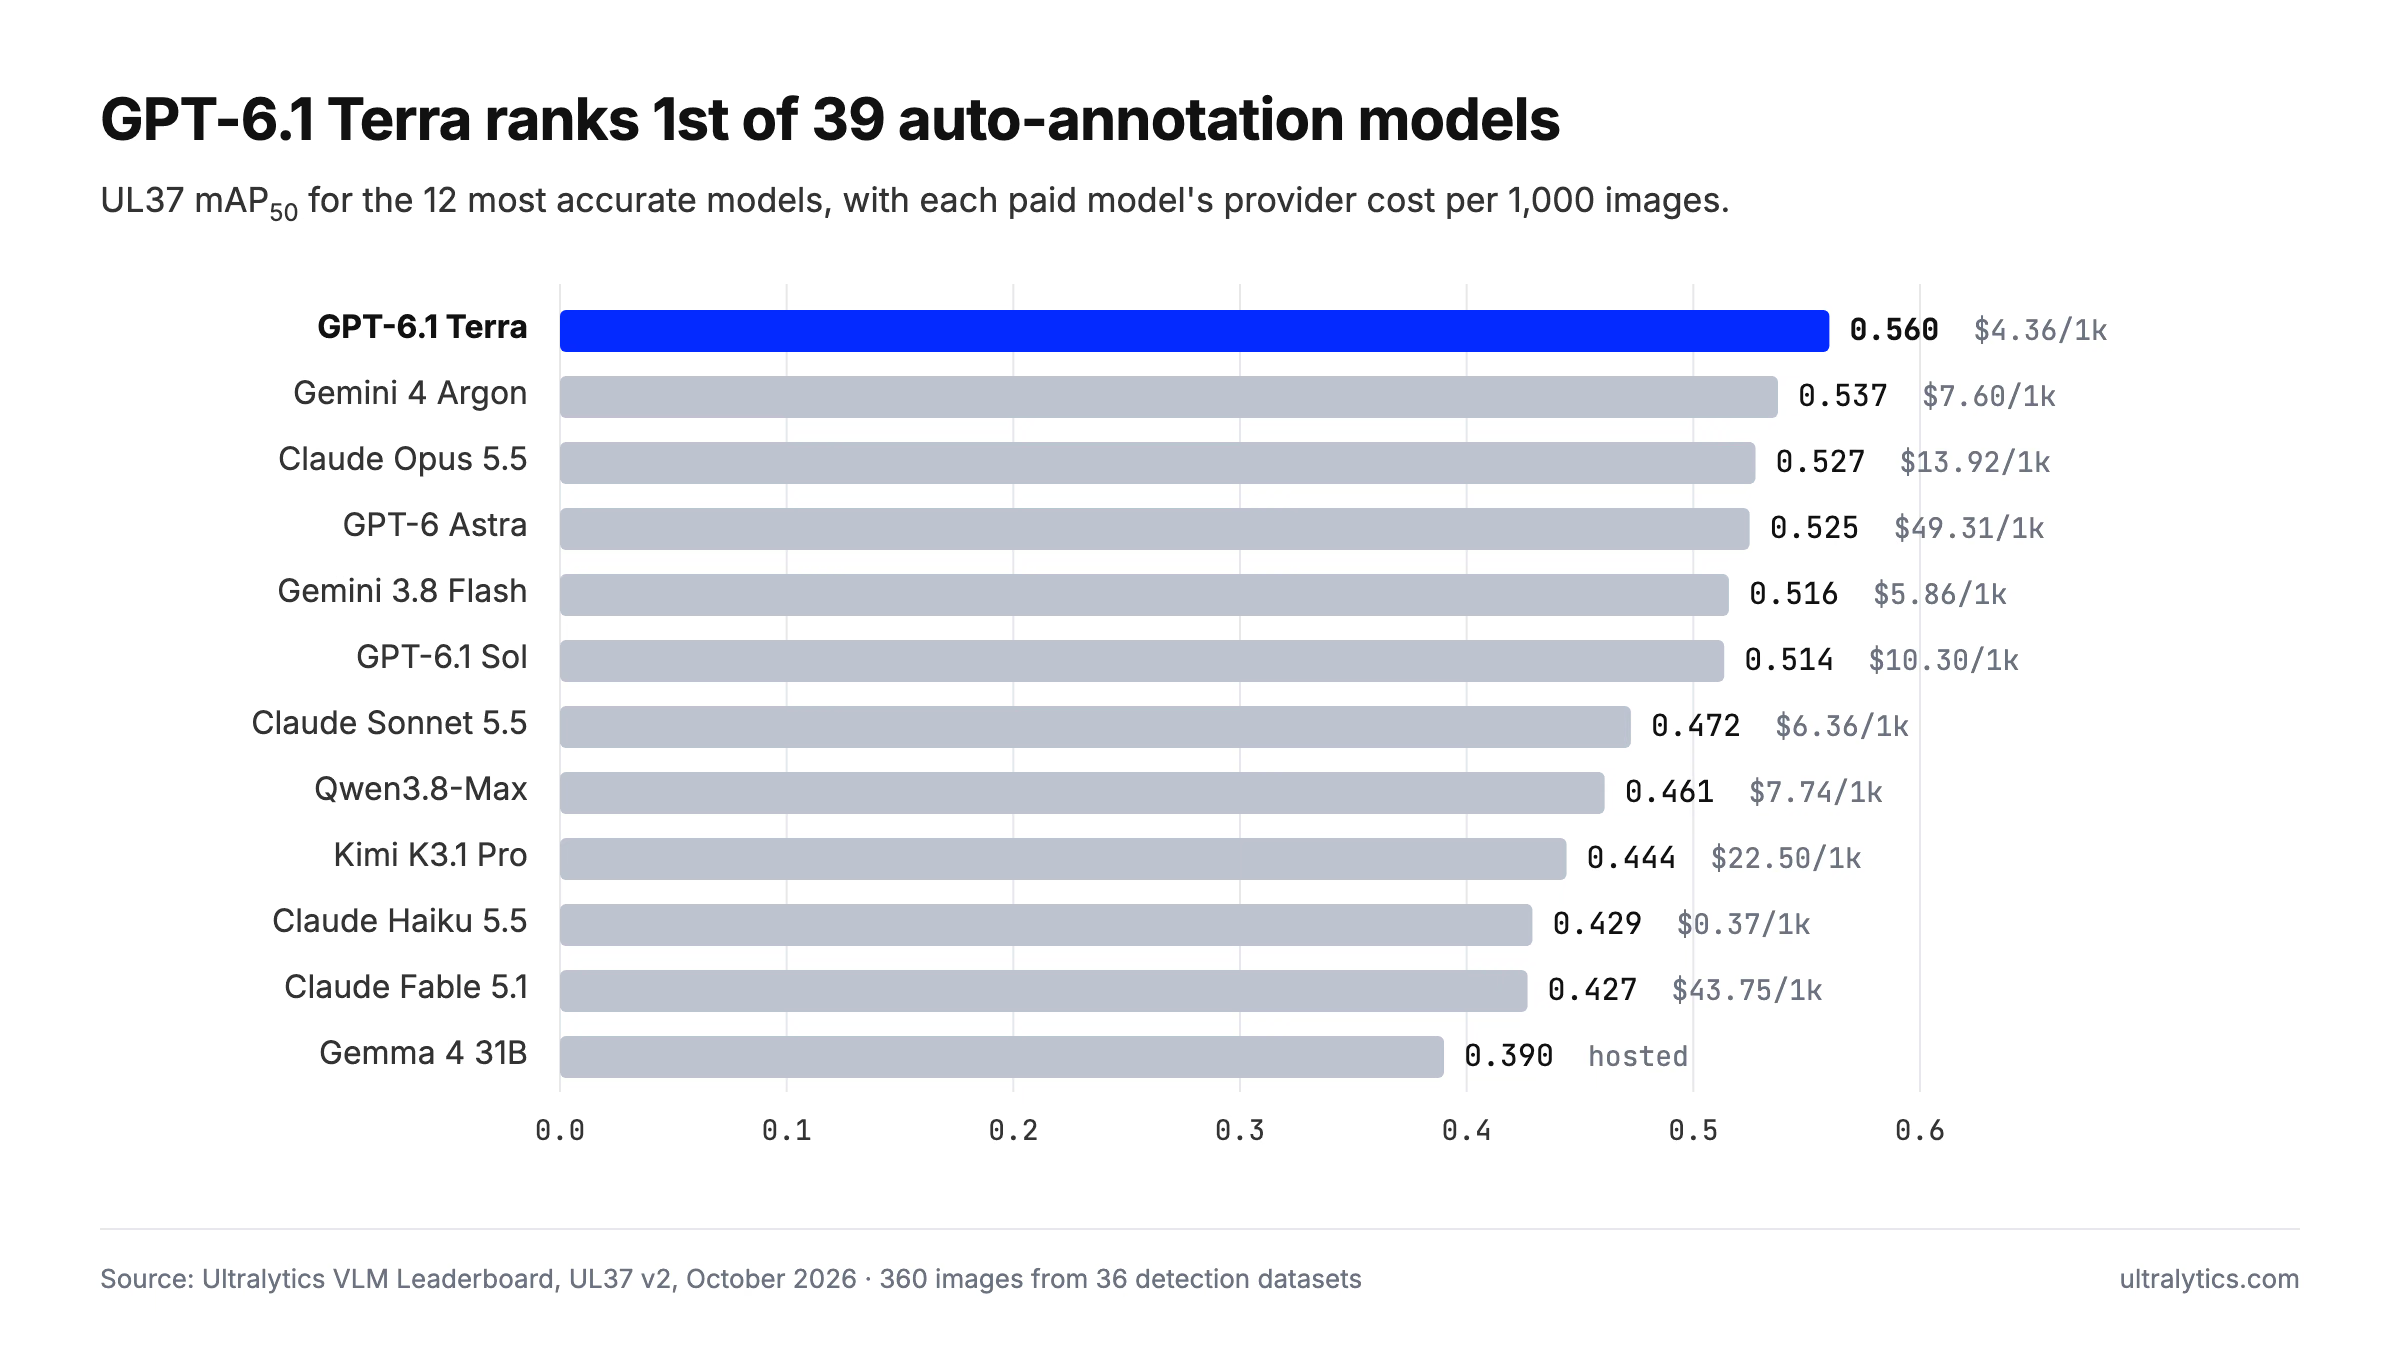
Aucun réglage particulier n’explique ce résultat. Terra utilise le niveau d’effort de raisonnement par défaut d’OpenAI, indiqué comme moyen dans sa documentation de modèle. Il reçoit la même requête que tous les autres modèles OpenAI dans Platform, avec des coordonnées de boîte sur une grille de 0–1000. Nous l’avons intégré, et il a directement pris la tête.
Un modèle à prix intermédiaire qui surclasse les modèles phares d’OpenAI#
OpenAI présente GPT-6.1 Terra comme le modèle rapide et efficace de milieu de gamme de son offre. Selon les articles de lancement de The Decoder et de BleepingComputer, il succède à GPT-5.6 Terra et vise l’utilisation de l’ordinateur, le raisonnement visuel, le codage et les tâches quotidiennes. Il est disponible dans l’API sous le nom gpt-6.1-terra, ainsi que dans ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Enterprise et Edu. OpenAI le décrit comme « un modèle rapide et efficace pour le raisonnement visuel, l’utilisation précise de l’ordinateur et la rédaction claire et naturelle », avec des entrées textuelles et des images et une fenêtre de contexte de 1 050 000 tokens.
Le tarif est de 1 $ par million de tokens en entrée et de 5 $ par million de tokens en sortie, avec les entrées mises en cache à 0,05 $. C’est la moitié des tarifs de GPT-6.1 Sol, à 2 $ et 10 $, et le dixième de ceux de GPT-6 Astra, à 10 $ et 50 $, selon les pages d’OpenAI consacrées à GPT-6.1 Sol et à GPT-6 Astra.
Les benchmarks de lancement d’OpenAI présentent Terra comme proche de ses grands frères, mais pas supérieur. Pour MMMU-Pro, un test de raisonnement visuel, OpenAI indique que Terra est presque au niveau d’Astra et de Sol. Sur Terminal-Bench 4.0, le score annoncé est de 50.3 %, contre 21.5 % pour GPT-5.6 Terra. OpenAI recommande toujours Sol ou Astra pour les tâches de codage les plus difficiles.
Sur le papier, Terra est le choix du compromis. Sur notre benchmark, c’est le meilleur détecteur d’OpenAI.
| Modèle OpenAI | mAP50 sur UL37 | Coût pour 1 000 images | Temps médian par image |
|---|---|---|---|
| GPT-6 Luna | 0.370 | $0.77 | 11.9 s |
| GPT-6.1 Terra | 0.560 | $4.36 | 5,1 s |
| GPT-6.1 Sol | 0.514 | $10.30 | 10.5 s |
| GPT-6 Astra | 0.525 | $49.31 | 11.6 s |
Terra coûte moins de la moitié du prix par image de GPT-6.1 Sol et moins d’un dixième de celui de GPT-6 Astra. Il répond aussi environ deux fois plus vite que l’un ou l’autre. En comparaison directe, il bat Sol sur 22 des 36 jeux de données.
OpenAI affirme que Terra accomplit les tâches plus de trois fois plus vite que Sol et Astra, une affirmation qui concerne les charges de travail des agents. L’annotation est une tâche différente : nous avons mesuré un gain d’environ 2x par rapport à Sol, ce qui représente tout de même un avantage quand tu étiquettes des milliers d’images.
L’avantage de Terra sur Sol tient à sa précision#
Les deux modèles détectent une proportion similaire des objets annotés. Le rappel de Terra est de 0.613 et celui de Sol de 0.618. L’écart apparaît au niveau de la précision : 0.646 pour Terra contre 0.551 pour Sol. Une proportion bien plus élevée des boîtes de Terra correspond à un objet réel avec la bonne étiquette.
SKU110K permet de voir clairement la différence. Ses images montrent des rayons de supermarché remplis de produits jusqu’aux bords, tous d’une seule classe. Les deux modèles obtiennent un rappel similaire, de 0.73 pour Terra et de 0.77 pour Sol. Mais la précision de Sol sur ces rayons est de 0.49, contre 0.79 pour Terra. Environ la moitié des boîtes de Sol sont de fausses détections, contre environ une sur cinq pour Terra. Le score mAP50 de 0.62 obtenu par Terra sur SKU110K est le plus élevé jamais atteint par un modèle.
C’est important pour l’étiquetage des données, car les erreurs n’ont pas toutes le même coût. Un produit manqué nécessite de tracer une boîte. Une boîte erronée oblige à la repérer parmi des dizaines de boîtes correctes et à la supprimer. Moins de fausses détections donnent aux réviseurs un premier brouillon plus propre.
L’imagerie médicale est le point fort de GPT-6.1 Terra#
Le résultat le plus distinctif de Terra concerne l’imagerie médicale. UL37 comprend huit jeux de données médicaux, sur lesquels Terra obtient une moyenne de 0.505 mAP50, la première place sur 39 modèles. Les suivants sont Gemini 3.8 Flash à 0.387 et Gemini 4 Argon à 0.379. Aucun autre modèle du classement ne domine autant un domaine.
Voici ses scores sur les huit jeux de données, comparés au meilleur résultat des 38 autres modèles pour chacun :
| Jeu de données | GPT-6.1 Terra | Meilleur autre modèle |
|---|---|---|
| Échographie de la thyroïde (TN5000) | 0.94 | Gemini 3.8 Flash, 0.88 |
| IRM de tumeur cérébrale (Cheng) | 0.90 | Gemma 4 31B, 0.80 |
| Microscopie des cellules sanguines (TXL-PBC) | 0.89 | Gemini 4 Argon, 0.78 |
| Endoscopie de polypes du côlon (Kvasir-SEG) | 0.71 | Égalité entre sept modèles, dont Gemini 4 Argon, à 0.81 |
| Radiographie du poignet pédiatrique (GRAZPEDWRI-DX) | 0.27 | GPT-6 Astra, 0.35 |
| Radiographie thoracique, tuberculose (TBX11K) | 0.14 | GPT-6 Astra, 0.33 |
| Lésions rétiniennes (DDR) | 0.13 | Claude Opus 5.5, 0.13 |
| Radiographie dentaire (DENTEX) | 0.06 | Gemini 4 Argon, 0.21 |
Les trois premières lignes expliquent le résultat, et il ne s’agit pas seulement de trouver le bon emplacement. Pour TN5000, chaque boîte indique aussi si le nodule est bénin ou malin, exactement le type de conclusion qu’un clinicien doit confirmer. Gemini 4 Argon obtient 0.29 sur ce jeu de données et GPT-6.1 Sol, 0.53. Les classes de l’IRM cérébrale sont le méningiome, le gliome et la tumeur hypophysaire ; Sol y obtient 0.52. Dans le jeu de données sur les cellules sanguines, Terra doit distinguer les globules blancs, les globules rouges et les plaquettes.
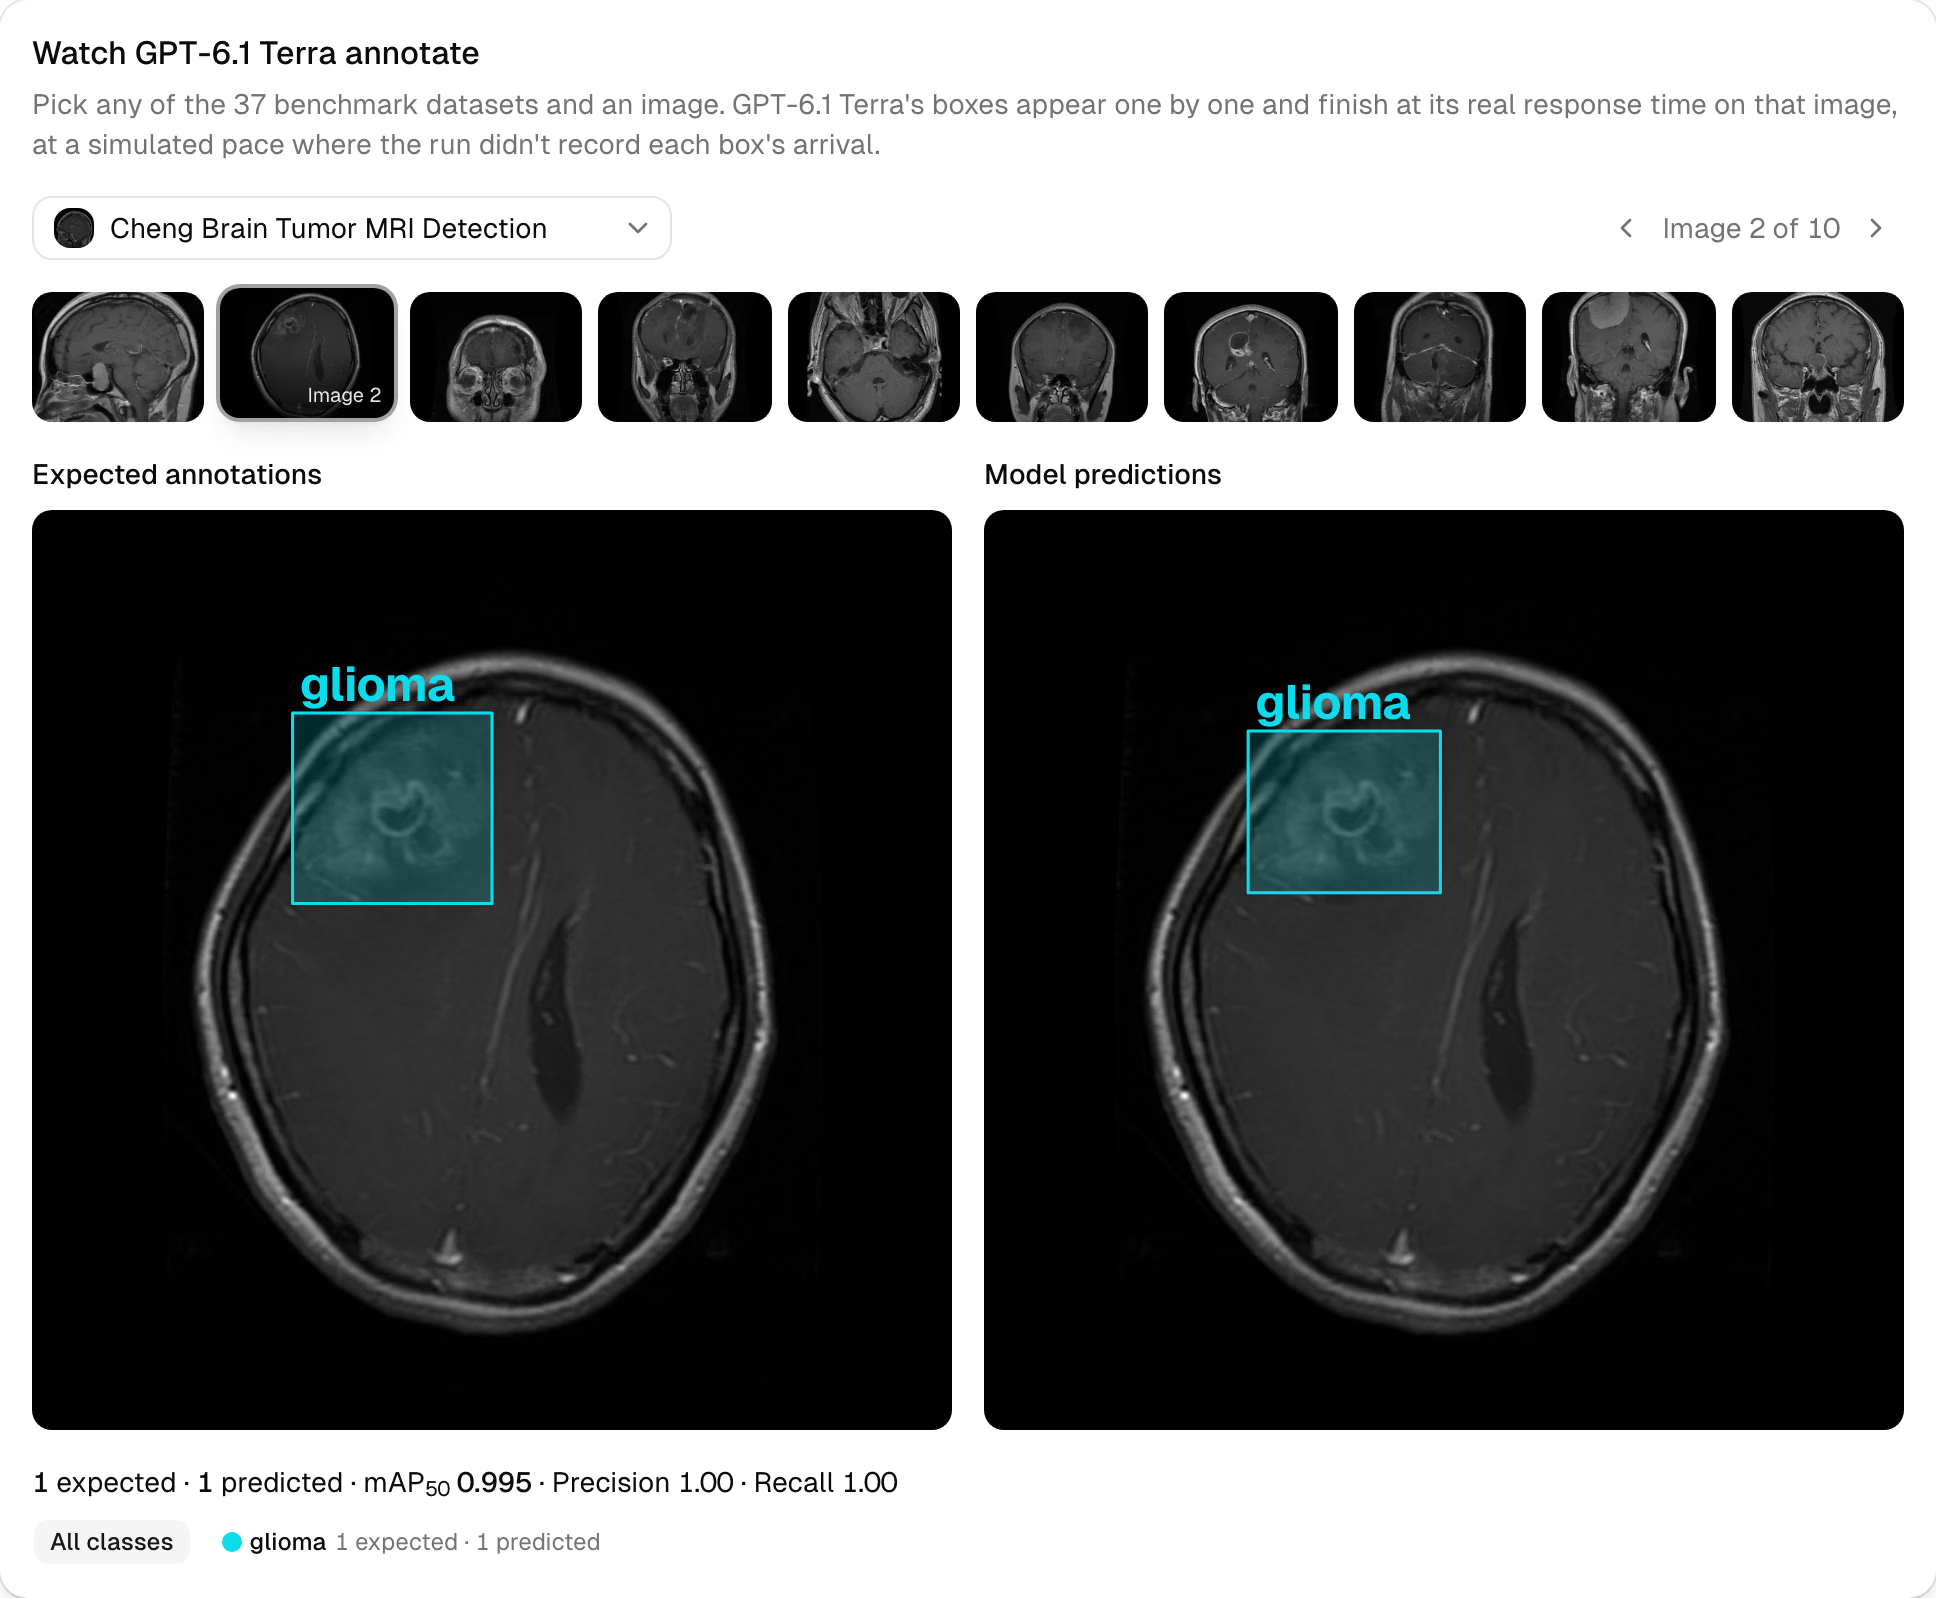
La relecture ci-dessus, depuis la page du modèle Terra, montre un cas de détection typique : un gliome sur une IRM cérébrale, une boîte de Terra, placée et étiquetée conformément à l’annotation attendue.
Deux réserves accompagnent ces chiffres. Premièrement, chaque jeu de données ne contribue qu’avec 10 images : son score constitue donc un signal à examiner, pas un verdict. Deuxièmement, il ne s’agit en aucun cas de diagnostic. Pour une équipe d’analyse d’images médicales, Terra permet de préparer rapidement des boîtes sur des échographies, des IRM et des images de microscopie, que les experts cliniques vérifient, corrigent et approuvent ensuite. Cette validation humaine dans la boucle est au cœur du flux de travail, et non une étape facultative.
Les limites de GPT-6.1 Terra : les radiographies et les cartes électroniques#
Le bas de ce tableau fait ressortir une tendance nette. Pour chaque jeu de données de radiographies dans UL37, médical ou non, un autre modèle obtient de meilleurs résultats. Terra est derrière le meilleur modèle pour les radiographies pédiatriques du poignet, thoraciques et dentaires. Les radiographies de sécurité sont encore plus difficiles : son score est de 0.00 sur IEDXray, contre 0.30 pour Gemini 4 Argon.
IEDXray est l’échec le plus net. Ses images montrent des ordinateurs portables, des téléphones, des pagers, des batteries et des engins improvisés. Terra n’y a produit aucune boîte correcte.
Les cartes électroniques constituent l’autre angle mort. Terra obtient une moyenne de 0.13 sur nos jeux de données de circuits imprimés industriels, tandis que GPT-6.1 Sol atteint 0.39. Sur DeepPCB, qui couvre les défauts de cartes nues tels que les circuits ouverts, les courts-circuits, les morsures et les excroissances de cuivre, Terra obtient 0.03 contre 0.39 pour Sol. Pour les données d’inspection de circuits imprimés, Sol est le meilleur choix chez OpenAI.
Avant d’étiqueter un grand jeu de données dans l’un de ces domaines, consulte la page du modèle GPT-6.1 Terra. Elle rejoue les boîtes enregistrées par Terra sur les 36 jeux de données du benchmark et COCO, côte à côte avec les boîtes attendues, et indique son score sur chacun.
GPT-6.1 Terra face à Gemini 4 Argon : une course plus serrée que le classement ne le laisse penser#
Gemini 4 Argon occupait la tête du classement avant l’arrivée de Terra, et les deux modèles sont proches. Terra obtient un meilleur score sur 19 jeux de données, Argon sur 16, et ils sont à égalité sur un.
Une grande partie de l’avance de 0.023 de Terra vient d’un seul jeu de données. Sur TN5000, l’échographie de la thyroïde, Terra obtient 0.94 contre 0.29 pour Argon. Si l’on exclut ce jeu de données, les moyennes sont de 0.549 pour Terra et de 0.544 pour Argon, soit des scores pratiquement équivalents. La première place de Terra est bien réelle, mais elle repose en grande partie sur l’imagerie médicale.
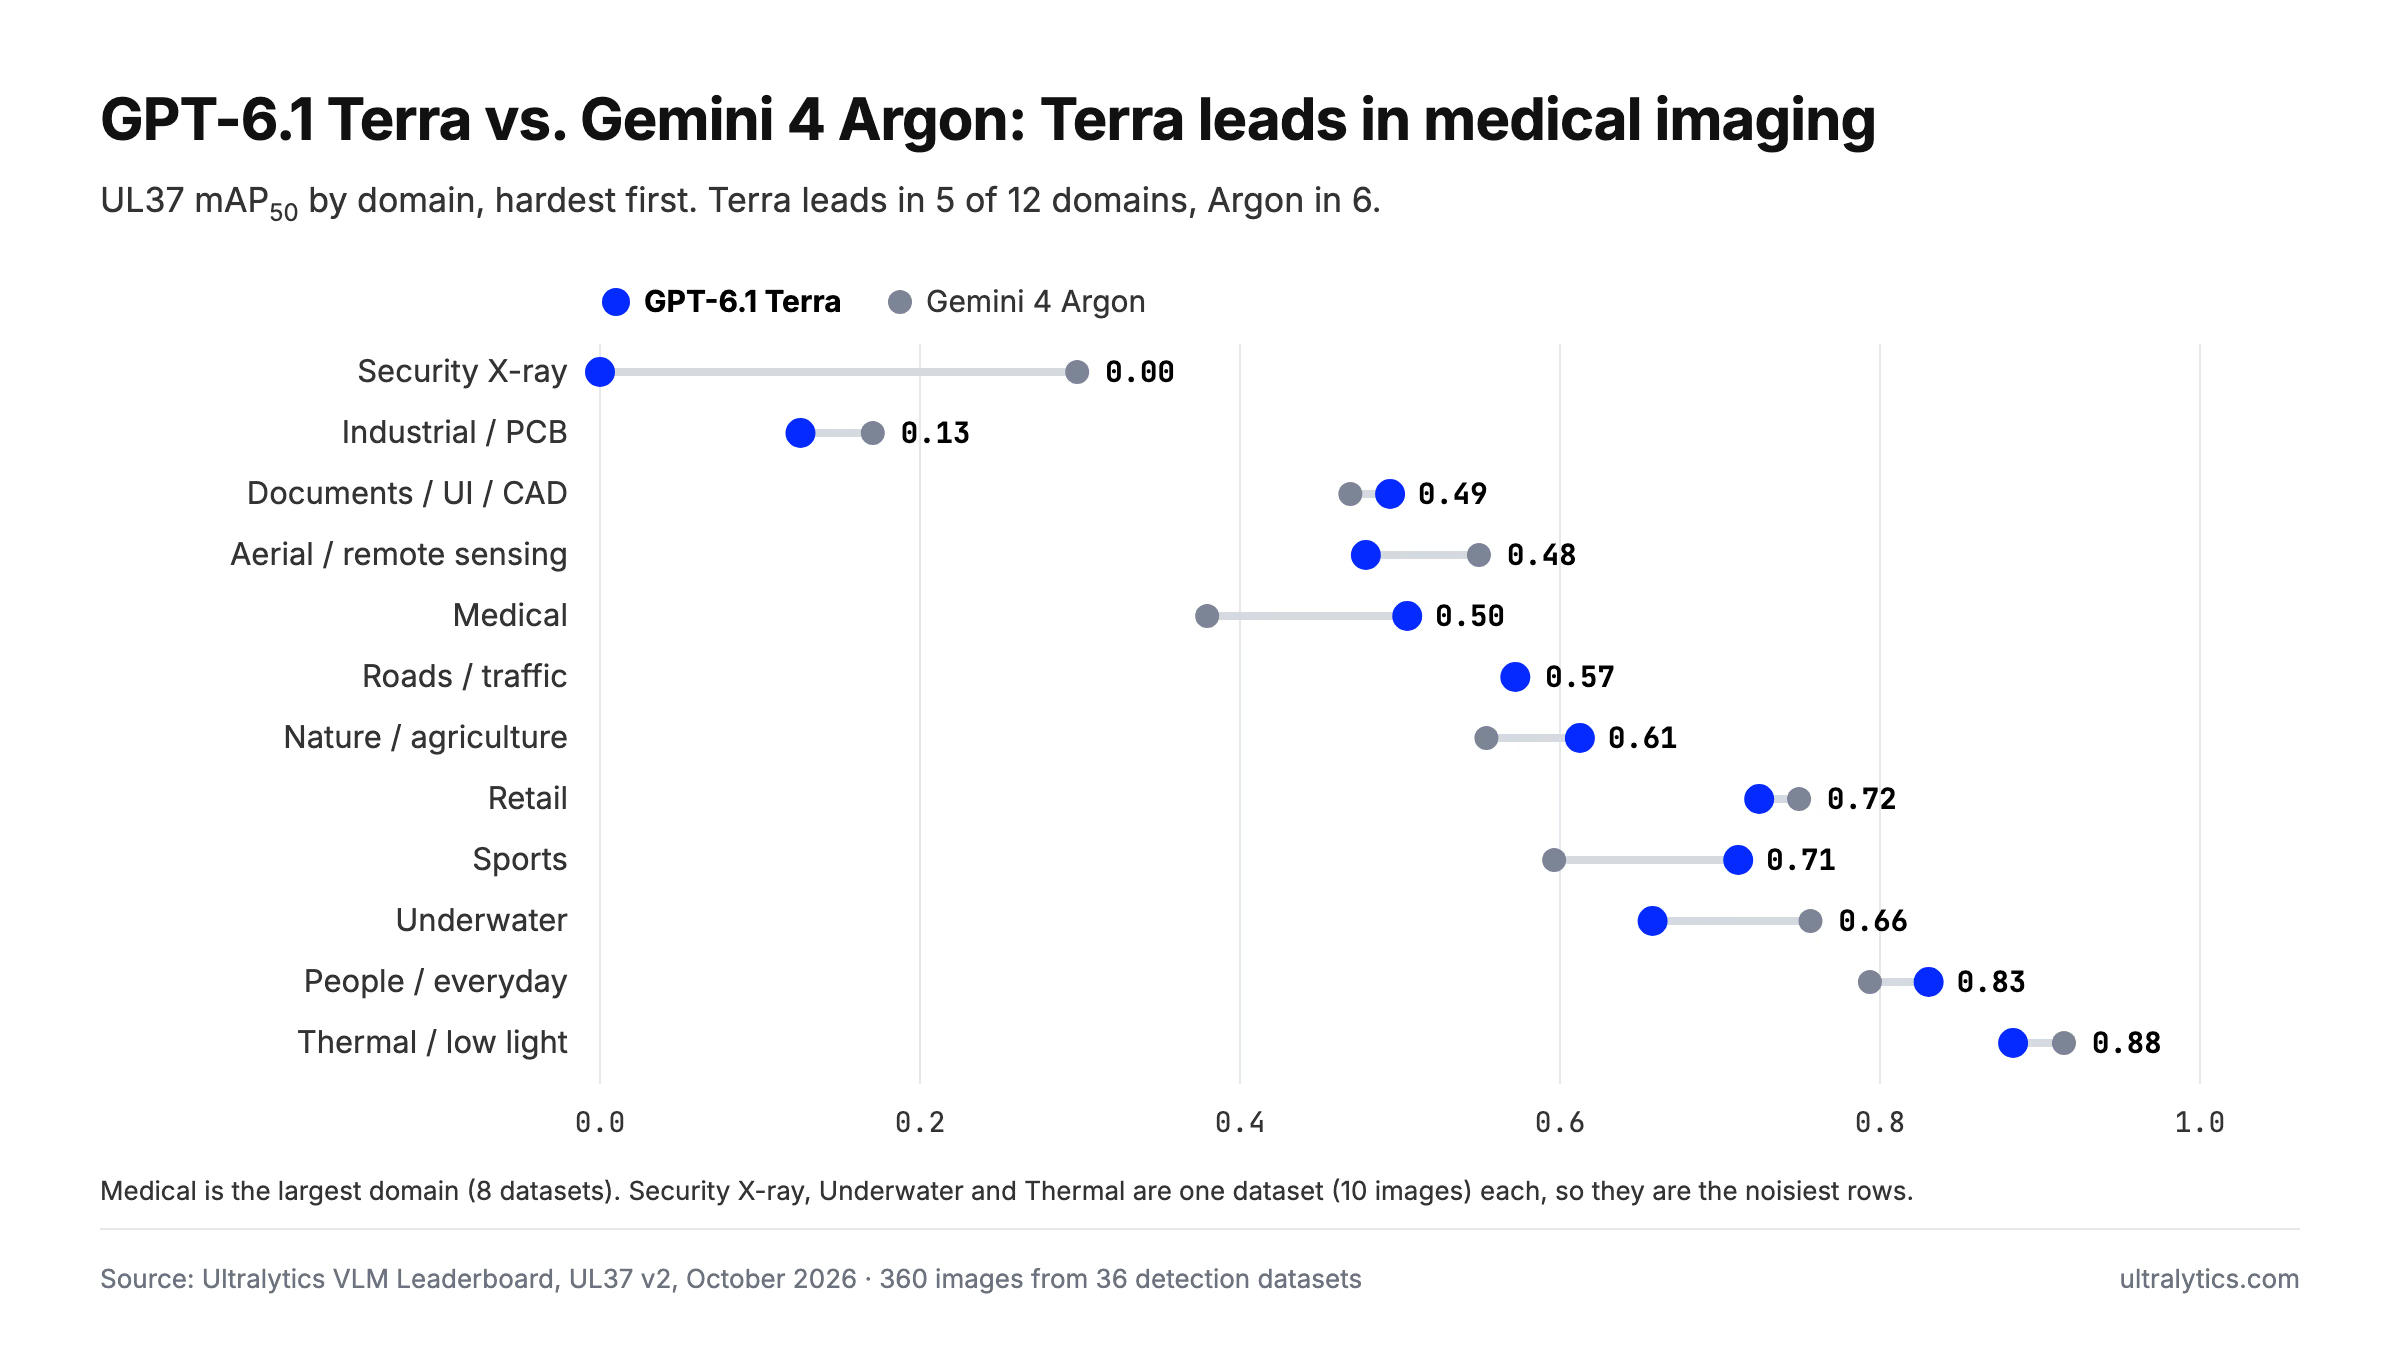
Par domaine, Terra est en tête dans cinq d’entre eux et se classe premier des 39 modèles dans deux : le domaine médical, et celui des documents, des interfaces utilisateur et de la CAO. Argon mène dans six domaines et conserve la tête pour les catégories aérienne, sous-marine et thermique. Les deux modèles sont à égalité pour les routes et la circulation.
Les deux modèles font aussi des erreurs différentes. Argon est légèrement plus précis, avec 0.667 contre 0.646, tandis que Terra détecte davantage d’objets, avec un rappel de 0.613 contre 0.585. Terra coûte 4,36 $ par tranche de 1 000 images, contre 7,60 $ pour Argon au tarif de lancement de Google. Argon est un peu plus rapide, à 4,6 s par image.
En pratique : choisis Terra pour les images médicales, les documents et le sport. Choisis Argon pour les images aériennes, sous-marines, thermiques et de sécurité. Nos résultats d’annotation automatique avec Gemini 4 Argon présentent les performances d’Argon.
Coût d’un lot d’images traité par GPT-6.1 Terra#
Le coût de 4,36 $ par tranche de 1 000 images correspond à la facture du fournisseur, calculée à partir de l’utilisation des tokens déclarée par OpenAI et de ses tarifs catalogue. Une image médiane utilisait environ 1 300 tokens en entrée et 370 en sortie. L’annotation par lots ajoute des frais de traitement Platform de 1,00 $ par tranche de 1 000 images : un lot de 1 000 images revient donc à environ 5,36 $ au total.
Trois autres détails sur l’évaluation :
- Aucune requête échouée. Toutes les requêtes de Terra pour le benchmark ont abouti dans la limite de 115 secondes de Platform. GPT-6.1 Sol a échoué sur 2 images et GPT-6 Astra sur 4.
- Ses boîtes brutes sont déjà de bonne qualité. Avant l’ajustement par SAM 3.1, les boîtes de Terra obtiennent 0.559 mAP50. L’ajustement porte ce score à 0.560 : le modèle fait donc presque tout le travail lui-même.
- Aucun réglage nécessaire. Le niveau d’effort de raisonnement par défaut et la requête OpenAI standard lui ont suffi.
Si le budget compte plus que les derniers points de précision, des solutions moins coûteuses existent. Claude Haiku 5.5 obtient 0.429 pour 0,37 $ par tranche de 1 000 images, et Gemini 3.5 Flash-Lite obtient 0.380 pour 1,77 $. Les modèles hébergés comme Qwen3.8 27B, Gemma 4 26B et SAM 3.1 Text ne nécessitent aucune clé API, tout comme tes propres modèles Ultralytics YOLO.
De la clé OpenAI au jeu de données annoté#
GPT-6.1 Terra est un modèle guidé par les classes, destiné aux jeux de données de détection comptant de 1 à 200 classes. Il renvoie des boîtes englobantes correspondant aux noms de classes de ton jeu de données ; tu les vérifies avant de les enregistrer. Pour le configurer :
- Crée une clé sur la page des clés API OpenAI.
- Ajoute-la dans Settings > API Keys, dans l’espace de travail Platform qui contient ton jeu de données. OpenAI te facture directement, et Ultralytics n’applique aucune marge sur les tokens. La documentation sur les clés fournisseur fournit tous les détails.
- Dans l’éditeur d’annotations, passe en mode Smart et sélectionne GPT-6.1 Terra sous OpenAI dans le sélecteur de modèles.
- Clique sur Predict, ou sur
P, pour annoter l’image en cours. Essaie d’abord quelques images représentatives de tes données avant de passer à l’échelle supérieure. - Quand le résultat te convient, ouvre la page du jeu de données et sélectionne More actions > Batch Annotation pour annoter toutes les images non annotées en une seule fois. Platform enregistre d’abord une version du jeu de données pour que tu puisses revenir en arrière.
- Vérifie et enregistre les boîtes, puis entraîne un modèle Ultralytics YOLO26 sur le résultat, dans le même espace de travail. La documentation sur l’entraînement te guide tout au long du processus.
Pour comprendre plus largement comment ces modèles s’intègrent à l’éditeur, consulte l’article sur l’automatisation des annotations par Ultralytics Platform grâce à l’IA et notre introduction aux modèles vision-langage.
À qui s’adresse GPT-6.1 Terra#
Fais de GPT-6.1 Terra ton modèle payant par défaut pour l’annotation générale en détection d’objets. C’est le modèle le plus précis de ceux que nous avons évalués, le moins cher des six meilleurs et il n’a jamais échoué lors de notre évaluation.
C’est un excellent outil pour créer un premier brouillon d’annotations sur des échographies, des IRM et des images de microscopie destinées à être examinées par des experts, ainsi que sur des rayons de magasins très denses où les fausses boîtes s’accumulent vite. Pour les radiographies, quel que soit leur type, et les défauts de circuits imprimés, choisis plutôt un autre modèle : Gemini 4 Argon, GPT-6 Astra ou GPT-6.1 Sol obtiennent de meilleurs résultats.
Si tu paies actuellement pour Sol ou Astra uniquement pour annoter des images, le changement est simple : Terra fournit de meilleures boîtes pour moins de la moitié du prix de Sol.
Foire aux questions
Oui. Sur notre benchmark UL37, GPT-6.1 Terra obtient 0.560 mAP50 en moyenne sur 36 jeux de données réels de détection, le meilleur résultat des 39 modèles du classement VLM d’Ultralytics. Il occupe aussi la première place selon la métrique plus stricte mAP50-95, avec un score de 0.345. Ses points faibles sont les images radiographiques et les défauts de cartes électroniques.
Oui, selon notre benchmark. Terra obtient 0.560 mAP50 contre 0.514 pour Sol, l’emporte sur 22 des 36 jeux de données, coûte 4,36 $ contre 10,30 $ par tranche de 1 000 images et tourne environ deux fois plus vite. Sol reste le meilleur choix chez OpenAI pour détecter les défauts des circuits imprimés.
Terra mène avec 0.560 contre 0.537 mAP50 et coûte moins cher par image, mais la course est serrée : Terra l’emporte sur 19 jeux de données, Argon sur 16, et un jeu se termine à égalité. Sans le jeu de données TN5000 sur l’échographie de la thyroïde, les deux modèles sont presque à égalité. Choisis Terra pour les images médicales et les documents, et Argon pour les images aériennes, sous-marines, thermiques et les radiographies de sécurité.
Environ 4,36 $ de frais OpenAI, d’après l’utilisation des jetons indiquée par le fournisseur, au tarif catalogue de 1 $ par million de jetons d’entrée et de 5 $ par million de jetons de sortie. L’annotation par lots sur la plateforme Ultralytics ajoute des frais de traitement de 1,00 $ par tranche de 1 000 images. Tu paies directement OpenAI avec ta propre clé API.
C’est le modèle le plus performant sur nos huit jeux de données médicaux, avec une moyenne de 0,505 mAP50 et les meilleurs scores en échographie thyroïdienne, en IRM des tumeurs cérébrales et en microscopie des cellules sanguines. Il est nettement moins performant sur les radiographies et obtient de moins bons résultats en endoscopie des polypes du côlon. Utilise-le pour générer des boîtes à faire vérifier par des experts, jamais comme outil de diagnostic.
Non. La plateforme l’appelle avec le niveau d’effort de raisonnement moyen par défaut d’OpenAI et lui demande des boîtes de la même manière qu’avec tous les modèles OpenAI ; SAM 3.1 affine ensuite chaque boîte. Dans notre benchmark, la requête médiane a pris 5,1 secondes et aucune requête n’a échoué.









